

Resumo
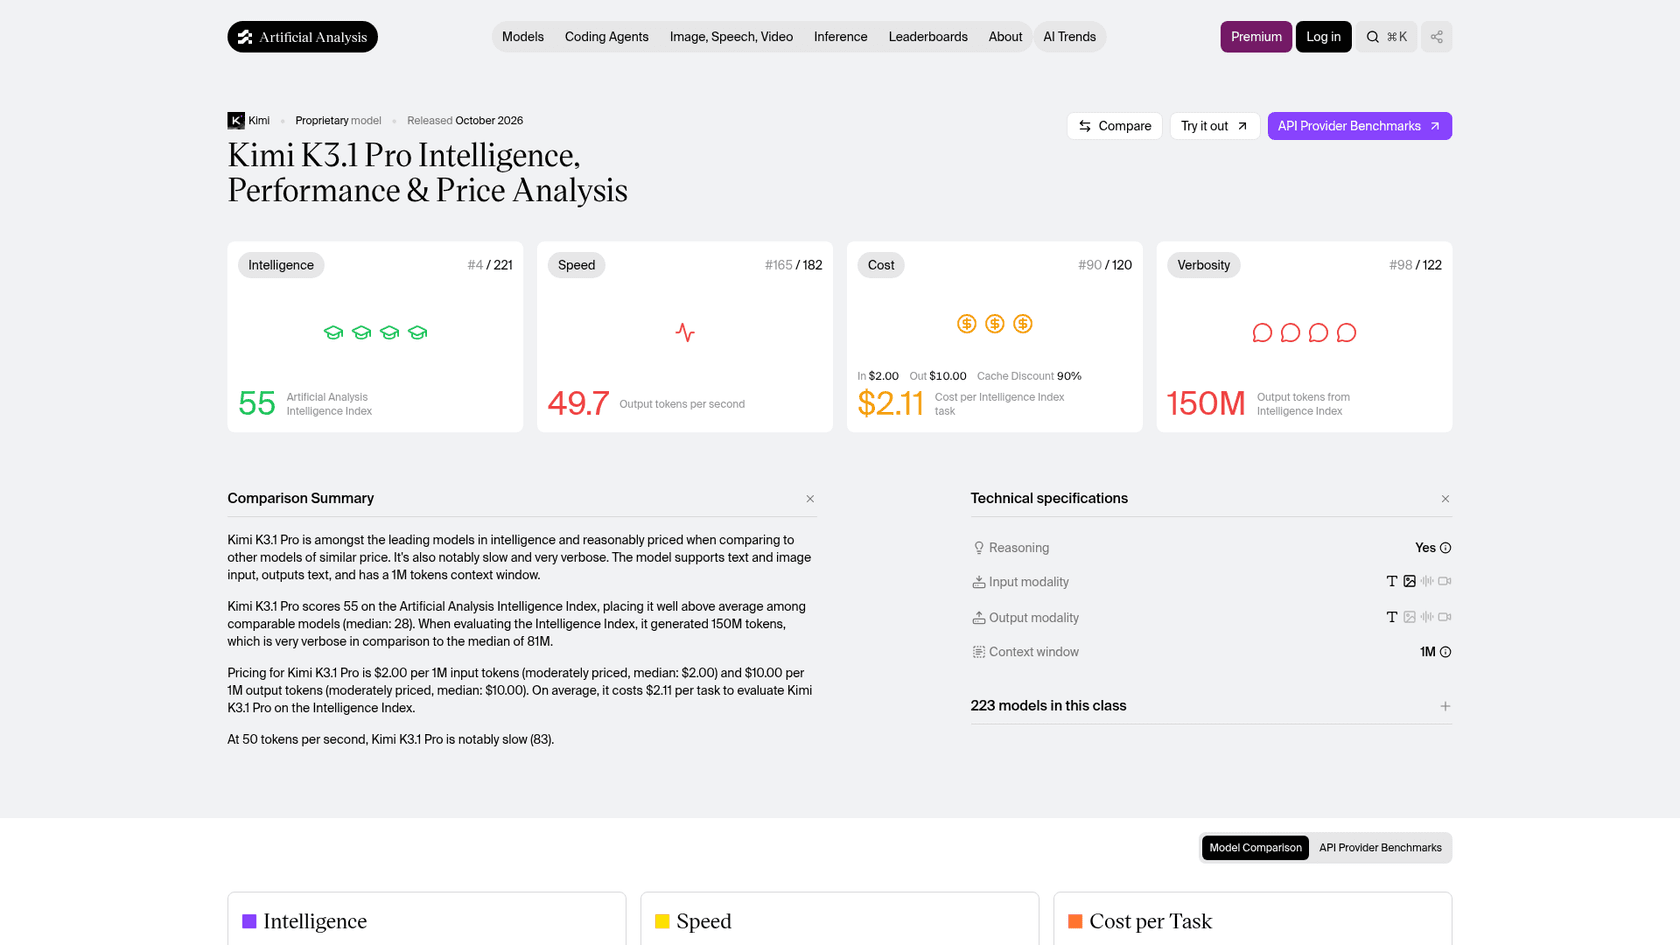
Kimi K3.1 Pro é o modelo de pesos abertos mais forte anunciado até agora, com 55 no Artificial Analysis Intelligence Index, 2.5 pontos atrás do Claude Opus 5.5, a US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída. A Moonshot o lançou em 23 de outubro de 2026 como uma versão do Kimi K3 com pós-treinamento intensivo, e o salto é real: o Terminal-Bench 4.0 passou de 12.6% para 67.2% no Artificial Analysis.
O problema está em tudo o que cerca essas pontuações. Ele roda a cerca de 50 tokens por segundo, perto do fim da sua categoria. Os pesos estão prometidos para "by Nov 4", então hoje ele só está disponível via API. E os primeiros assinantes do Kimi Code relatam esgotar um limite de 5 horas em menos de uma hora. A redução de preço é por token, não por resposta: ele escreve muito, então custa $3,117 executar o índice completo de benchmarks, contra $3,658 para o K3, uma economia de 15%, não de 33%.
Se você está escolhendo um modelo para um agente de suporte com IA, o modelo é a parte menor do trabalho. Passei anos na eesel colocando IA em filas reais de helpdesk, e a parte difícil nunca é o motor. É a conexão com o helpdesk, as regras de transferência e os testes com tickets reais do passado. A SE Ranking usa essa camada em três produtos no Zendesk, com cerca de 4,650 conversas por mês.
O que é o Kimi K3.1 Pro?
O Kimi K3.1 Pro é o novo modelo principal da Moonshot AI, e também é o primeiro lançamento da sua série K3.1. A Moonshot o descreve como "our most capable 3T-class open-weight model to date", com uma janela de contexto de 1 milhão de tokens. Por baixo do capô, é um modelo de mistura de especialistas, com 2.8T parâmetros totais e 104B ativos, segundo a publicação de lançamento no X.
Ele vem em duas versões: Kimi K3.1 Pro é a padrão, e Kimi K3.1 Pro Highspeed é o mesmo modelo, mas servido "2-3× faster" pelo dobro do preço. Ambos ficaram disponíveis no mesmo dia, no kimi.ai, nos aplicativos Kimi, no Kimi Work, no Kimi Code e na API Kimi.
A Moonshot destaca quatro áreas em que houve melhorias: programação, criação 3D, pesquisa financeira e trabalho de agentes de longa duração. Se você acompanhou o lançamento do Kimi K3 em julho, a versão resumida é esta: em tarefas de agentes, o K3.1 Pro é o modelo que o K3 deveria ter sido.
O que mudou em relação ao Kimi K3?
Para deixar claro, o Kimi K3.1 Pro não é um novo modelo-base. A Moonshot o descreve como "a post-trained version of Kimi K3, with substantially larger post-training compute", usando aprendizado por reforço em "hundreds of downstream domains". Portanto, os pesos de 2.8T são os mesmos, o que mudou foi o volume de treinamento para usá-los.
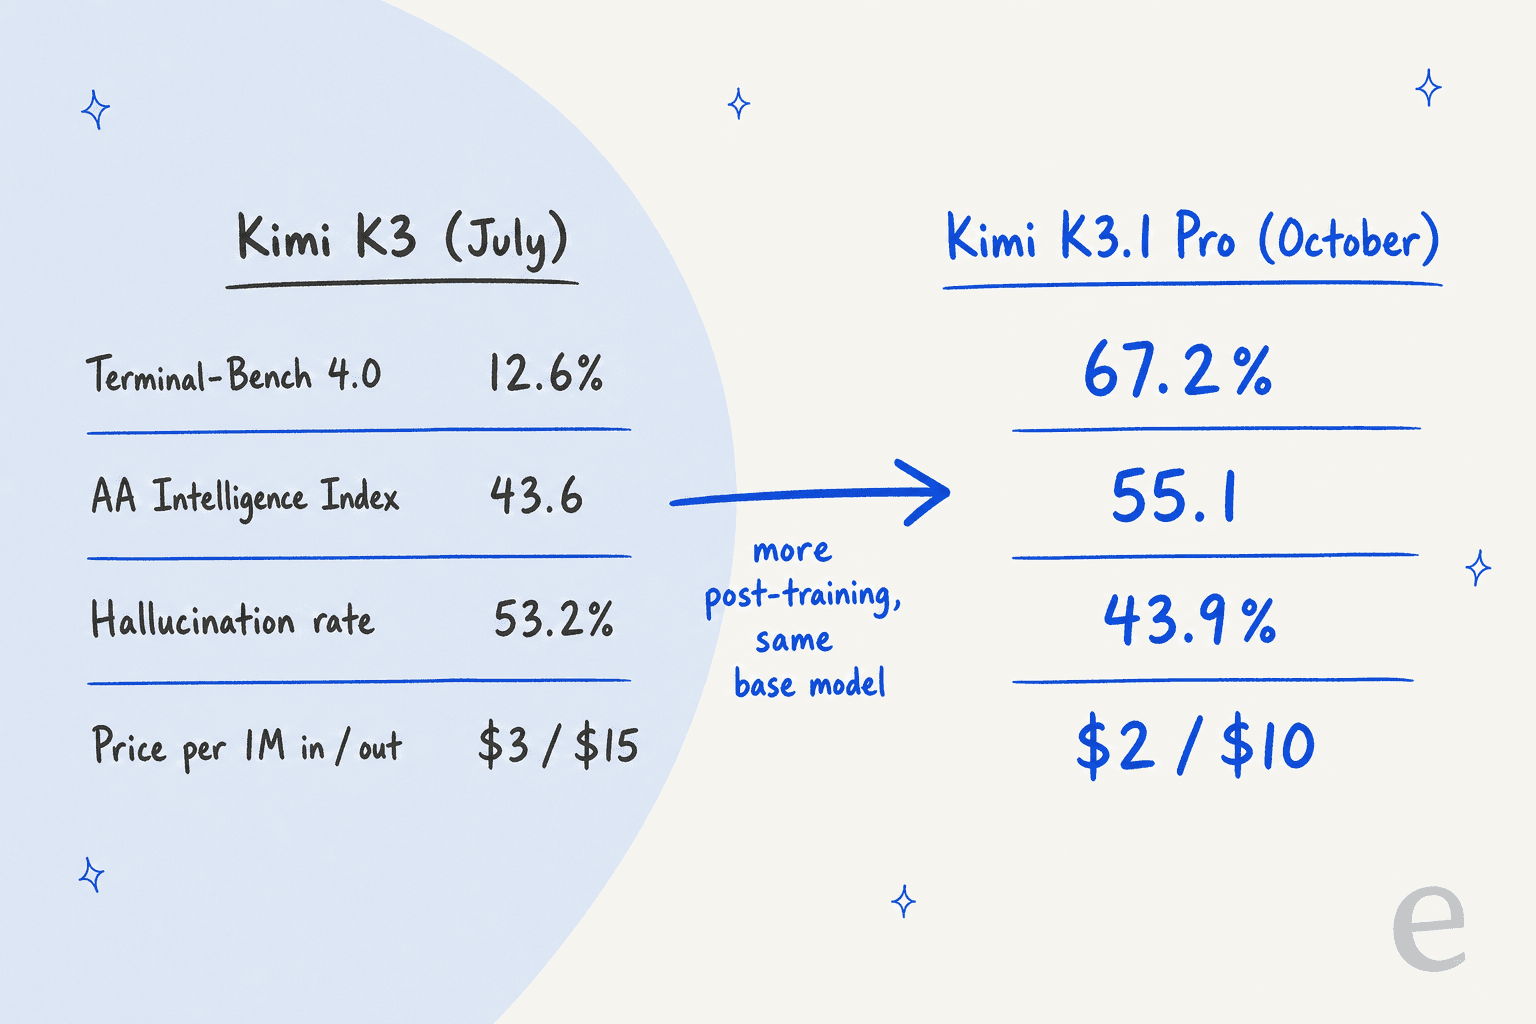
No papel, isso parece incremental, mas os números contam outra história. Na página do K3.1 Pro no Artificial Analysis, medido na mesma versão do índice que o Kimi K3:
| Kimi K3 (Max) | Kimi K3.1 Pro | |
|---|---|---|
| Lançamento | 16 de julho de 2026 | 23 de outubro de 2026 |
| Intelligence Index (v4.3.2) | 43.6 | 55.1 |
| Terminal-Bench 4.0 | 12.6% | 67.2% |
| Taxa de alucinação (AA-Omniscience) | 53.2% | 43.9% |
| GDPval-AA (Elo) | 1,534 | 1,846 |
| Preço da API por 1M (entrada / saída) | $3 / $15 | $2 / $10 |
| Velocidade de saída | 54.5 tokens/s | 49.7 tokens/s |
| Pesos | Abertos | Previstos até 4 de novembro |
O salto de 12,6% para 67,2% no Terminal-Bench é o grande destaque. Esse benchmark verifica se um modelo consegue de fato concluir um trabalho de várias etapas dentro de um terminal, e é isso que os agentes de programação fazem o dia todo. O K3 era um modelo inteligente que tinha dificuldade para colocar isso em prática, enquanto o K3.1 Pro consegue agir.
Há uma armadilha que vale observar se você comparar com artigos mais antigos: o K3 marcou 57 no Artificial Analysis em agosto, mas a escala do índice mudou desde então. Na versão atual, o K3 está em 43.6, então o K3.1 Pro representa um salto de 11.5 pontos, não uma queda de 2 pontos. Fiz a mesma comparação na minha análise do Kimi K3 na época, então considere aqueles números mais antigos como pertencentes a uma escala diferente.
A Moonshot também fez algo um pouco incomum: removeu de propósito dados de treinamento relacionados à área cibernética da versão de pesos abertos. Em seu próprio benchmark interno de exploração de vulnerabilidades, o modelo final marca 81.0, contra 90.5 do mesmo modelo treinado sem esse corte. A regra declarada pela Moonshot é não "release open weights that would extend the absolute frontier of cyber capability."
Como o Kimi K3.1 Pro se sai nos benchmarks?
No gráfico da própria Moonshot com 14 avaliações, o Kimi K3.1 Pro fica em primeiro em 6 e em segundo em 5, competindo com Claude Opus 5.5, GPT-6 Astra, Claude Fable 5.1, DeepSeek V4.1 Flash e GLM-5.3. Todos os modelos foram executados com esforço máximo de raciocínio.
Aqui estão os destaques, retirados diretamente do blog de lançamento da Moonshot:
| Benchmark | Kimi K3.1 Pro | Opus 5.5 | GPT-6 Astra | Fable 5.1 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7 | 66.4 | 58.2 | 57.9 |
| SWE Marathon | 51.7 | 46.3 | 42.5 | 45.6 |
| OfficeQA Pro v2 | 64.4 | 62.2 | 54.4 | 54.5 |
| Humanity's Last Exam (com ferramentas) | 70.0 | 67.7 | 57.2 | 65.6 |
| OSWorld V2.1 | 79.6 | 81.8 | 75.8 | 80.7 |
| GDPval-AA v2.1 (Elo) | 1846 | 1866 | 1573 | 1754 |
| BenchCAD (com ferramentas) | 92.7 | 96.2 | 95.9 | 92.6 |
| Terminal-Bench-Science 0.1 | 38.1 | 63.3 | 68.1 | 40.0 |
Há duas coisas que vale saber antes de sair citando qualquer um desses resultados.
Primeiro, os benchmarks de programação foram executados dentro do ambiente do Claude Code, e não no da própria Moonshot. É uma escolha razoável, já que a maioria dos desenvolvedores usa esse ambiente, mas isso significa que os resultados mostram como o Kimi se sai quando é conduzido como o Claude. Uma publicação de Lisan al Gaib levantou exatamente essa questão no dia do lançamento.
Segundo, os números de terceiros e os do fornecedor não coincidem exatamente. O Artificial Analysis coloca o K3.1 Pro em 67.2% no Terminal-Bench 4.0 e o Opus 5.5 (Max) em 59.6%, uma vitória muito mais ampla do que os 65.7 contra 66.4 da própria Moonshot. Vários outros resultados de destaque (Kimi Code Bench, os testes financeiros, Kimi Hallu Bench) são benchmarks internos da própria Moonshot. O índice independente é o número em que eu me apoiaria: 55.1, quarto entre 215 modelos.
Programação e agentes de longa duração
Para programação, a proposta gira em torno de projetos completos, e não apenas correções. Segundo a Moonshot, o K3.1 Pro consegue criar jogos em Unity, Unreal Engine e Godot, e a demonstração escolhida foi uma execução longa no projeto de código aberto human-atlas: 167 missões e 420 revisões independentes para construir um simulador de caminhada para um modelo corporal com 296 componentes esqueléticos e 402 musculares. No fim, o humano simulado passou de cair em segundos para caminhar por 11.2 segundos.
No SWE Marathon, um benchmark de programação de longa duração, ele marca 51.7, contra 46.3 do Opus 5.5. Se eu tivesse que acompanhar apenas um resultado, seria esse, porque é nas tarefas longas que a diferença de preço em relação ao Claude continua se acumulando.
Modelagem e design 3D
Essa é a parte mais diferenciada do lançamento. O K3.1 Pro escreve scripts para Blender e softwares CAD e os executa diretamente, "without MCP connectors", e a Moonshot criou um recurso para consumidores em torno disso, chamado 3D Make.
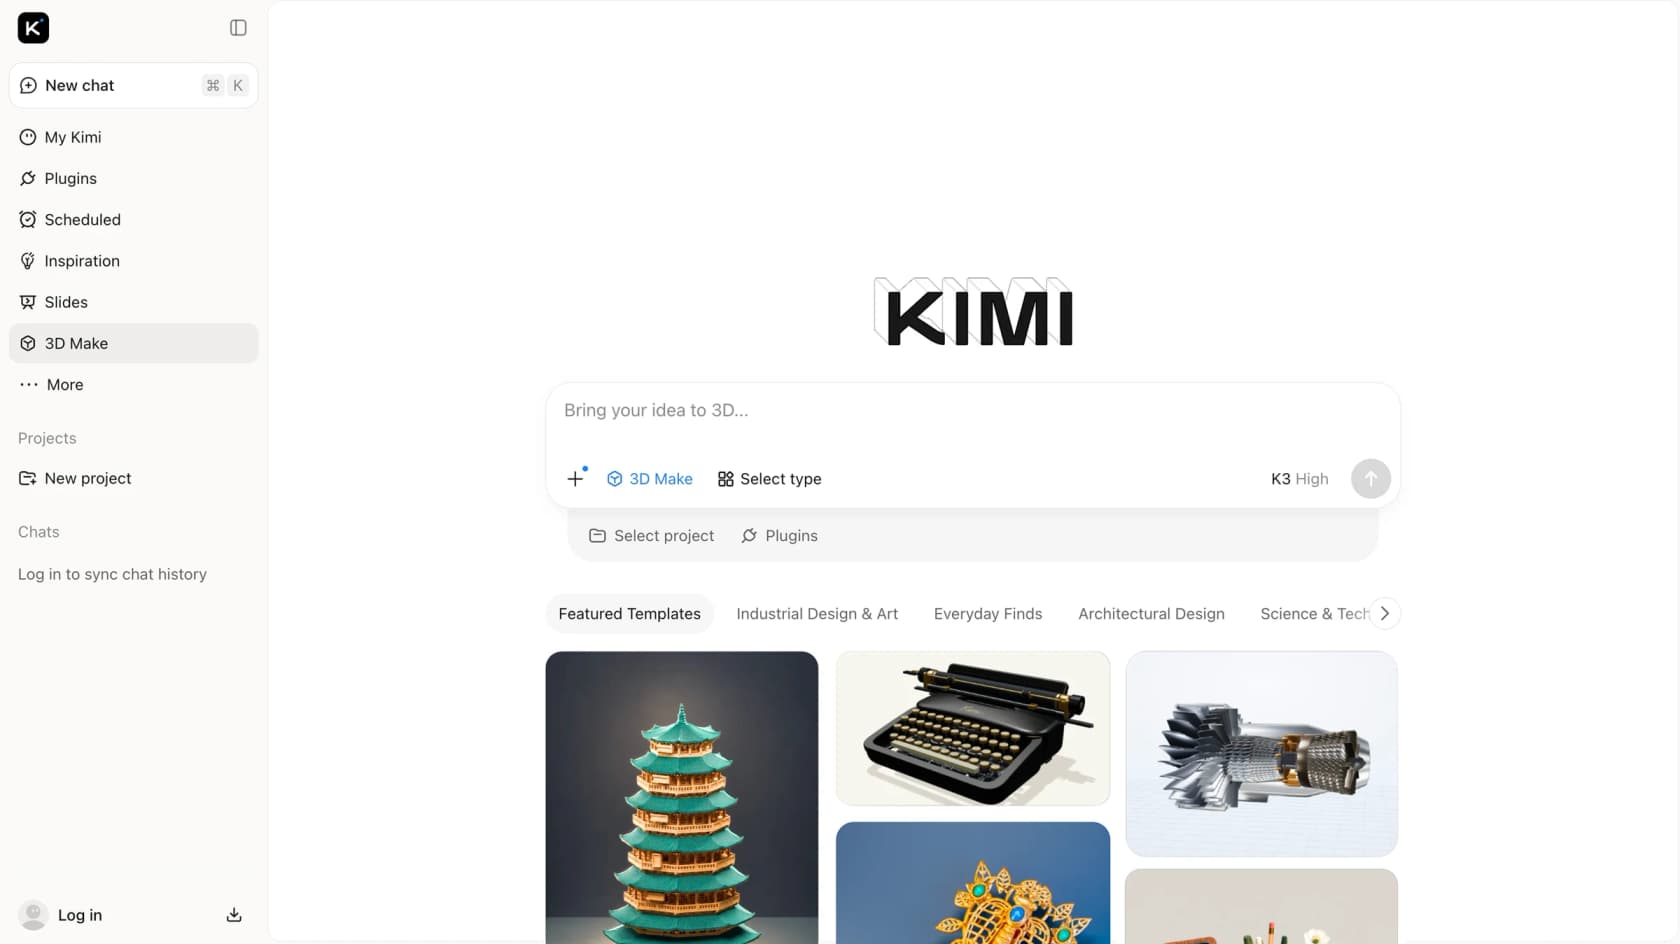
No BenchCAD com ferramentas, ele marca 92.7, atrás do Opus 5.5 (96.2) e do GPT-6 Astra (95.9). Sem ferramentas, fica quase exatamente empatado com o Opus: 72.8 contra 73.0. A Moonshot diz que seu ponto mais forte é o trabalho paramétrico, ou seja, peças mecânicas e modelos arquitetônicos, além de produtos e móveis configuráveis.
Trabalho financeiro e precisão factual
A alegação da Moonshot para finanças é "hallucination down by 65%". Isso corresponde aproximadamente ao seu Kimi Hallu Bench interno, em que a proporção de afirmações falsas em um teste difícil com ferramentas caiu de 23.4% (K3) para 8.3%.
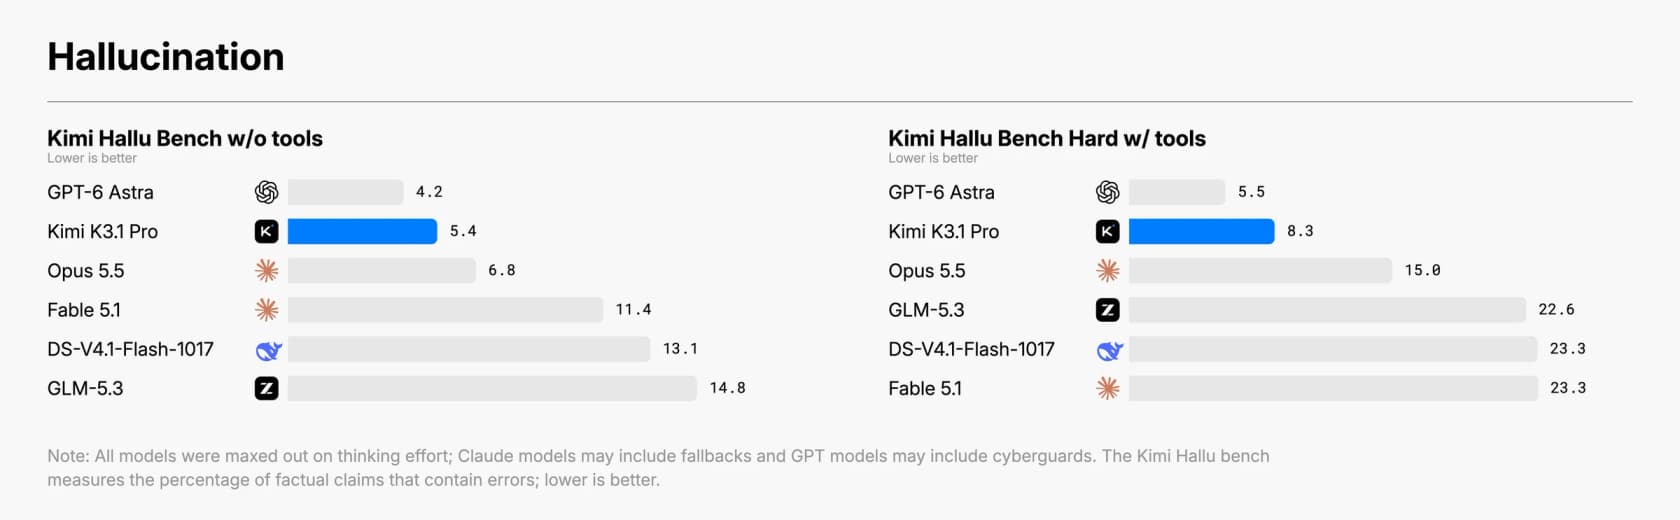
Para dar o devido crédito, a Moonshot também acrescenta que essas taxas "do not represent overall error rates in daily use." No teste independente AA-Omniscience, a taxa de alucinação do K3.1 Pro é de 43.9%. Isso é melhor que o Opus 5.5 Max (58.6%), mas fica bem atrás do Gemini 4 Argon (15.1%). Se um número errado em uma planilha vai custar dinheiro a você, ainda vale conferir o trabalho dele.
Quanto custa o Kimi K3.1 Pro?
O Kimi K3.1 Pro custa US$ 2 por milhão de tokens de entrada, US$ 0,20 por milhão de tokens de entrada em cache e US$ 10 por milhão de tokens de saída na API Kimi, e o Highspeed dobra esses valores. Os preços permanecem fixos em todo o contexto de 1M, com "no tiering by context length", segundo o guia de início rápido do K3.1 Pro.
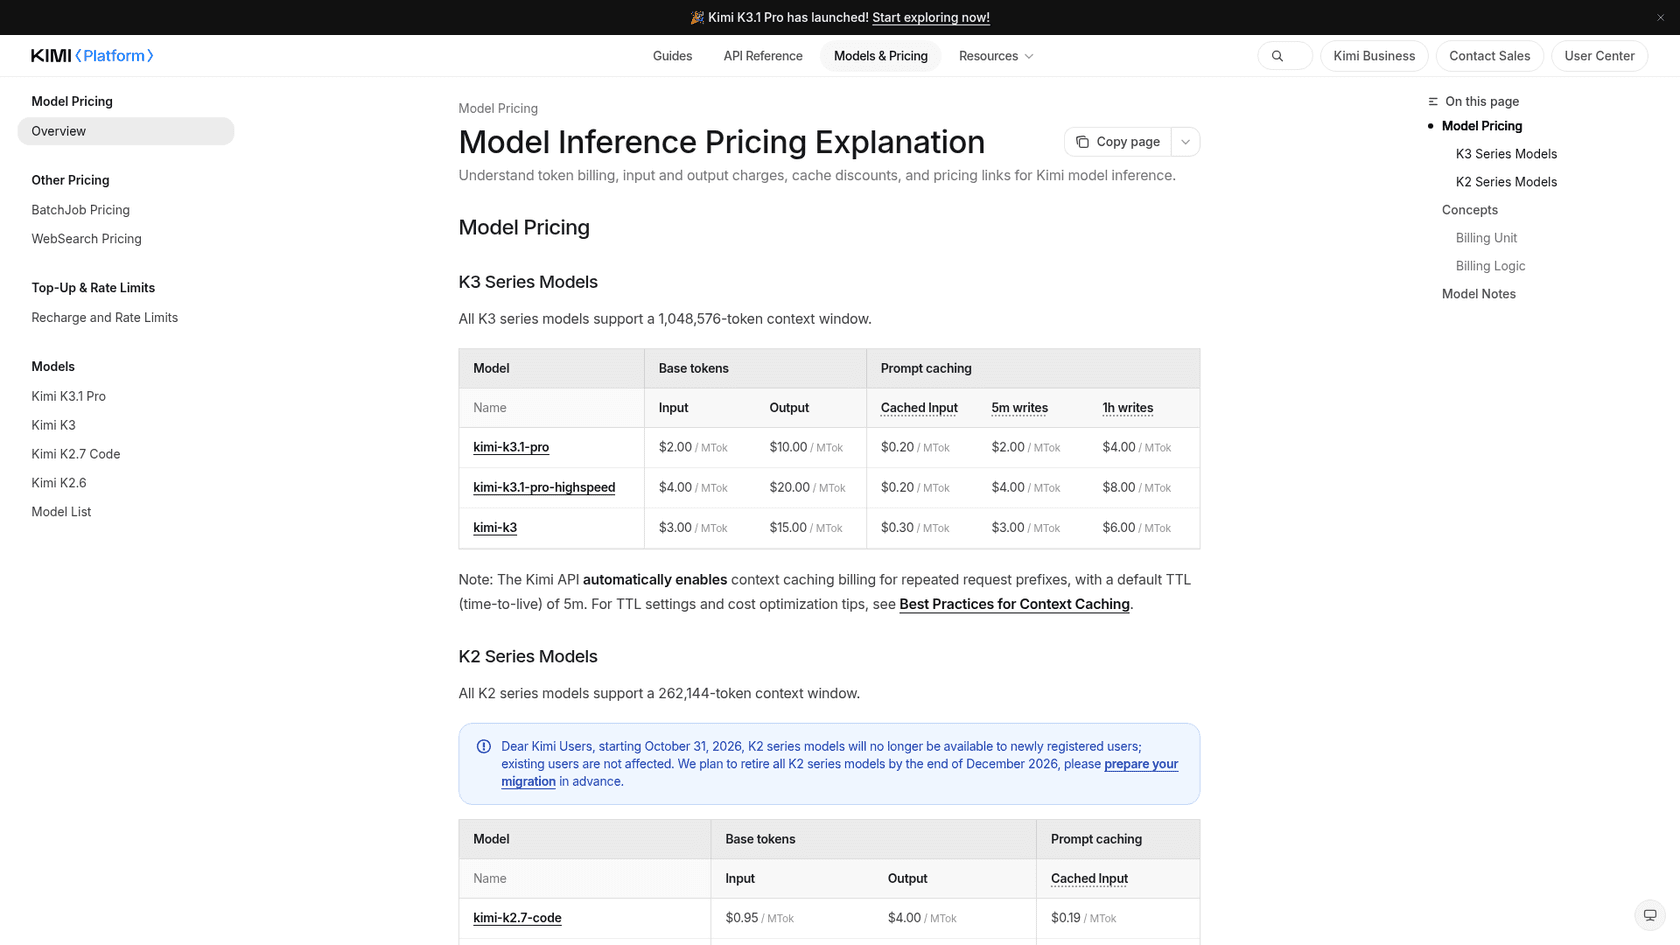
Da página de preços do Kimi, por milhão de tokens:
| ID do modelo | Entrada | Entrada em cache | Saída | Gravação em cache (5 min) | Gravação em cache (1 hora) |
|---|---|---|---|---|---|
kimi-k3.1-pro | $2.00 | $0.20 | $10.00 | $2.00 | $4.00 |
kimi-k3.1-pro-highspeed | $4.00 | $0.20 | $20.00 | $4.00 | $8.00 |
kimi-k3 | $3.00 | $0.30 | $15.00 | $3.00 | $6.00 |
Alguns detalhes de cobrança que mudam o que você realmente paga:
- O cache é automático para prefixos de prompt repetidos, com uma janela padrão de 5 minutos. Os acertos de cache custam 90% menos. Quando seu agente reutiliza um prompt de sistema longo, isso acaba importando mais do que a tarifa anunciada.
- Você precisa de uma recarga de US$ 1 para desbloquear o K3.1 Pro, e é o total das suas recargas que define seu nível de limite de requisições.
- Ainda não há desconto por lote. O preço por lote de 60% só cobre os modelos K2 mais antigos, que deixam de aceitar novos usuários em 31 de outubro de 2026.
- O K3 ainda custa US$ 3 / US$ 15, então não há muito motivo para continuar nele em novos trabalhos.
Nos preços de tabela acompanhados pelo Artificial Analysis, ele custa exatamente o mesmo que os preços do Claude Sonnet 5.5, os preços do Gemini 4 Argon e o GPT-6.1 Sol. É metade dos preços do Claude Opus 5.5, de US$ 4 / US$ 20.
Planos do aplicativo Kimi e do Kimi Code
Se você prefere pagar uma assinatura em vez de pagar por token, o K3.1 Pro está incluído nos planos de assinatura do Kimi. Os preços abaixo são da página do Kimi Code:
| Plano | Mensal | Cobrança anual (por mês) | Acesso ao K3.1 Pro |
|---|---|---|---|
| Plus | $19 | $15 | Padrão |
| Pro | $39 | $31 | Padrão e Highspeed |
| Max | $99 | $79 | Padrão e Highspeed |
| Ultra | $199 | $159 | Padrão e Highspeed |
O Highspeed consome créditos a uma taxa 2x maior. O Kimi renomeou os planos recentemente "with pricing unchanged", e o Kimi Code ainda compartilha uma cota com o restante da assinatura. Com os novos planos, o limite semanal do Kimi Code acabou, mas o limite de janela móvel de 5 horas permaneceu, e esse limite é a reclamação mais forte até agora (mais sobre isso abaixo).
Mais barato por token, nem sempre por tarefa
Aqui está a parte que a maior parte da cobertura do lançamento deixa de lado. Por token, o K3.1 Pro é um terço mais barato que o K3, mas ele pensa muito e escreve muito. O Artificial Analysis o classifica como "very verbose": ele usou cerca de 150M tokens de saída para executar o índice, contra uma mediana de 87M para modelos semelhantes.
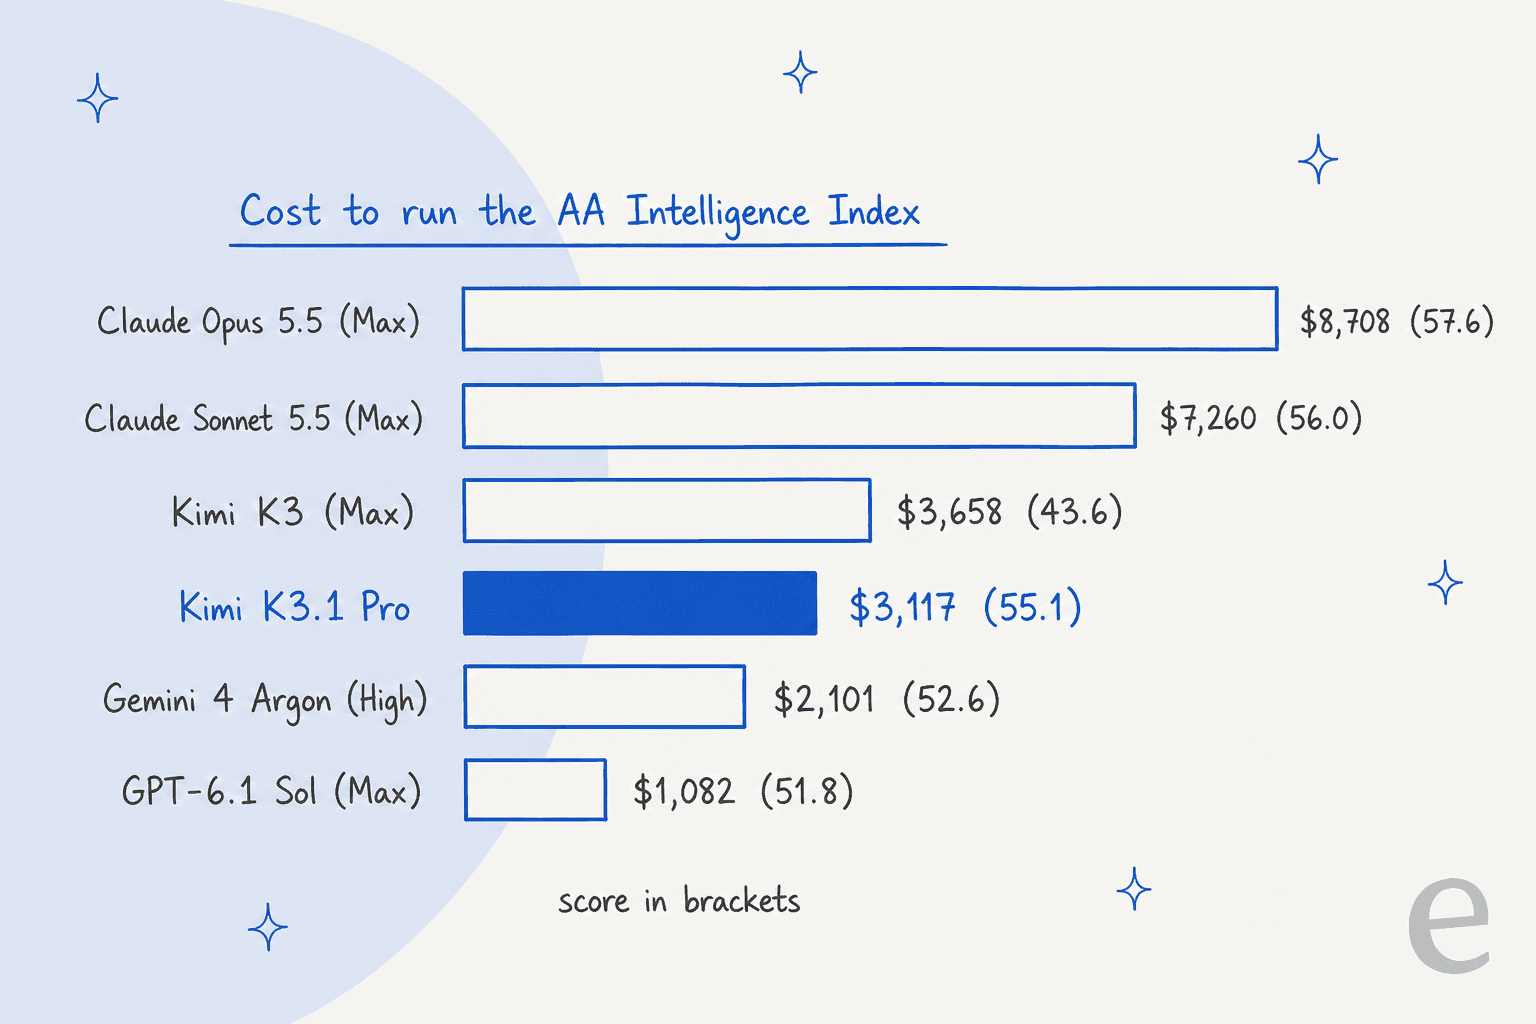
Então, a forma mais honesta de comparar é pelo custo por trabalho:
- Contra o Claude, é um ótimo negócio. Ele fica a 2.5 pontos do Opus 5.5 (Max) por
36%do custo de execução do índice, e custa bem menos da metade do Sonnet 5.5 (Max), que consumiu416Mtokens. - Contra o K3, a economia é menor do que parece.
$3,117contra$3,658é cerca de 15% mais barato, e você recebe um modelo muito melhor por isso. - Contra as opções mais baratas, ele não é a pechincha. O GPT-6.1 Sol (Max) executou o índice por
$1,082e o Gemini 4 Argon (High) por$2,101, com pontuações 3.3 e 2.5 pontos menores.
O gráfico da própria Moonshot faz a comparação com o Claude no Terminal-Bench, em que o K3.1 Pro com esforço máximo fica em torno de US$ 5 por tarefa, contra aproximadamente US$ 14 para o Opus 5.5:
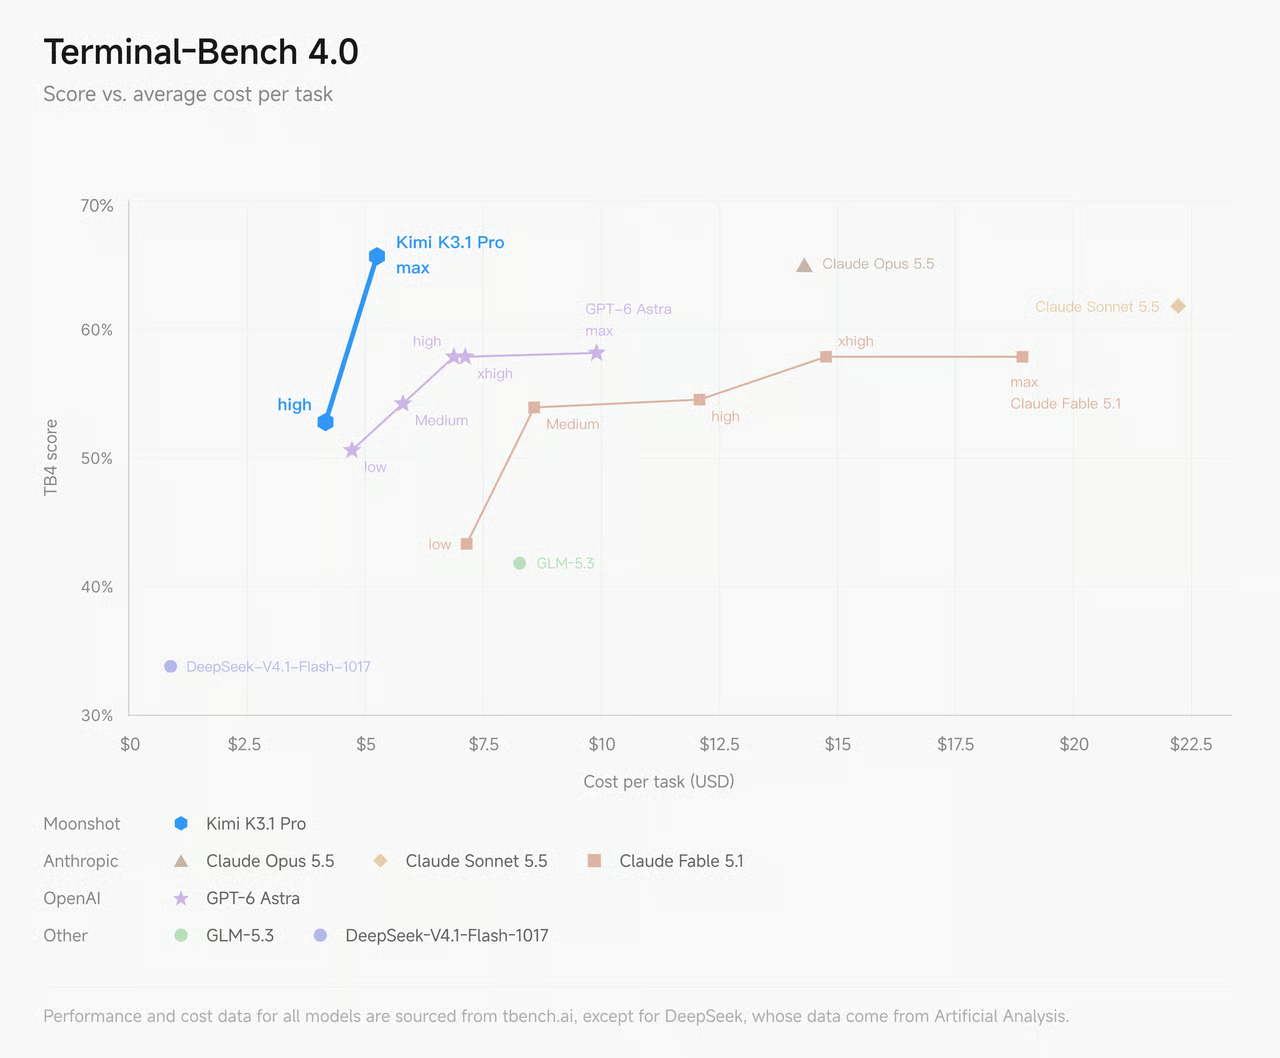
Nathan Lambert, pesquisador da Ai2, apontou a mesma compensação no dia do lançamento:
"K3.1 is also cheaper than K3 per token, but some benchmarks in the blog show it uses meaningfully more tokens per answer, so it may be about the same price."
O Kimi K3.1 Pro é de código aberto?
Ainda não. A Moonshot diz "Full model weights will be released by Nov 4, 2026", e até 27 de outubro ainda não havia nenhum repositório dele no Hugging Face. Por enquanto, o Artificial Analysis o lista como um modelo proprietário, e a API é oferecida por 5 provedores, contra 20 para o K3.
A Moonshot tem um histórico aqui: os pesos do K3 de fato foram disponibilizados no Hugging Face, e o repositório do K3 mostra cerca de 2.78T parâmetros em 8 bits. Você pode esperar algo parecido para o K3.1 Pro, o que significa que executá-lo por conta própria é trabalho para um cluster de servidores, não para um notebook.
"a 3T parameter model is still a bit beyond even many enthusiasts for running locally."

Os termos de licença do K3.1 Pro ainda não foram publicados. A licença do K3 permitia uso comercial com algumas restrições, então leia a nova antes de desenvolver algo com ele. Se você precisa de um modelo aberto que possa implantar hoje, o DeepSeek V4.1 Flash marca 45.1 no mesmo índice por uma fração do custo.
Qual é a velocidade do Kimi K3.1 Pro?
É lento. O Artificial Analysis mede 49.7 tokens de saída por segundo na API Kimi, o que o coloca na posição #165 entre 182 modelos, contra uma mediana de modelos semelhantes em torno de 83. O tempo até o primeiro token é bom, de 2.95 segundos. O que pesa é o tempo que ele continua escrevendo: uma tarefa média do índice levou cerca de 17 minutos.
Na prática, ainda é uma melhoria em relação ao K3, já que o K3.1 Pro desperdiça menos tempo pensando. Um desenvolvedor mediu isso:
"Biggest gripe with K3 was slow responses, partly due to inefficient thinking. So far K3.1 pro is almost twice as fast as k3 on our benchmark."
A resposta da Moonshot para isso é o Highspeed: "2-3× the speed" pelo dobro do preço. O Artificial Analysis ainda não o avaliou, e a reação no dia do lançamento foi morna:
"I'll wait for the openweight... btw double the price for 67 TPS... Hardly 'nitro'."
Minha opinião: para agentes em segundo plano que rodam por uma hora enquanto você faz outra coisa, a velocidade quase não importa, então o modelo padrão é a escolha certa. Para qualquer situação em que uma pessoa fica esperando, como uma janela de chat, pague pelo Highspeed ou escolha um modelo mais rápido.
O que os desenvolvedores estão dizendo sobre o Kimi K3.1 Pro?
A discussão de lançamento no Hacker News recebeu 1,089 pontos e 674 comentários, e a reação ficou bem dividida. Quase todos concordam que ele é um grande avanço em relação ao K3 e também o melhor modelo de pesos abertos anunciado até agora, enquanto a maioria de quem programa diariamente ainda diz que o Claude Opus 5.5 está à frente na prática.
O mais positivo dos testes independentes o comparou em 180 pinturas geradas por código:
"It also does this while thinking less (~6.5k reasoning tokens vs ~8k for K3). Kimi K3.1 is roughly 2/3 the cost of Kimi K3 and ~1/3 the cost of Opus 5.5."
No lado negativo, um avaliador o testou contra 105 bugs inseridos em dois repositórios reais, e ali ele marcou 36, contra 41.7 do Opus 5.5:
"I'm sorry. Considering the cost, I see no reason to use this model."
Os benchmarks de entusiastas ficam em algum ponto intermediário, mais ou menos no nível do Fable 5.1 e do Gemini 4 Argon:
"Ran it on my adversarial programming language (KillSwitch) benchmark[1]. Very significant improvement over K3. On par with Gemini 4 Argon and Fable 5.1. Much slower than both though."
E então vêm os limites de uso, que dominaram a discussão mais do que a qualidade do modelo:
"Bought the $100/month subscription and hit my 5-hour limit with one prompt on default settings (max effort) in their CLI harness. It might be smart but it's unusable compared to other subscriptions right now."
Se você pretende usá-lo por uma assinatura do Kimi Code, reduza o esforço de raciocínio antes de julgar o plano. A API aceita low, high e max, e max é o padrão. Um comentarista que o executou com subagentes mais leves relatou usar apenas 22% de uma cota semanal em uma sessão de 8 horas, então a configuração muda bastante o cenário.
Como acessar o Kimi K3.1 Pro?
Há quatro caminhos no total, e o mais adequado depende do que você está construindo.
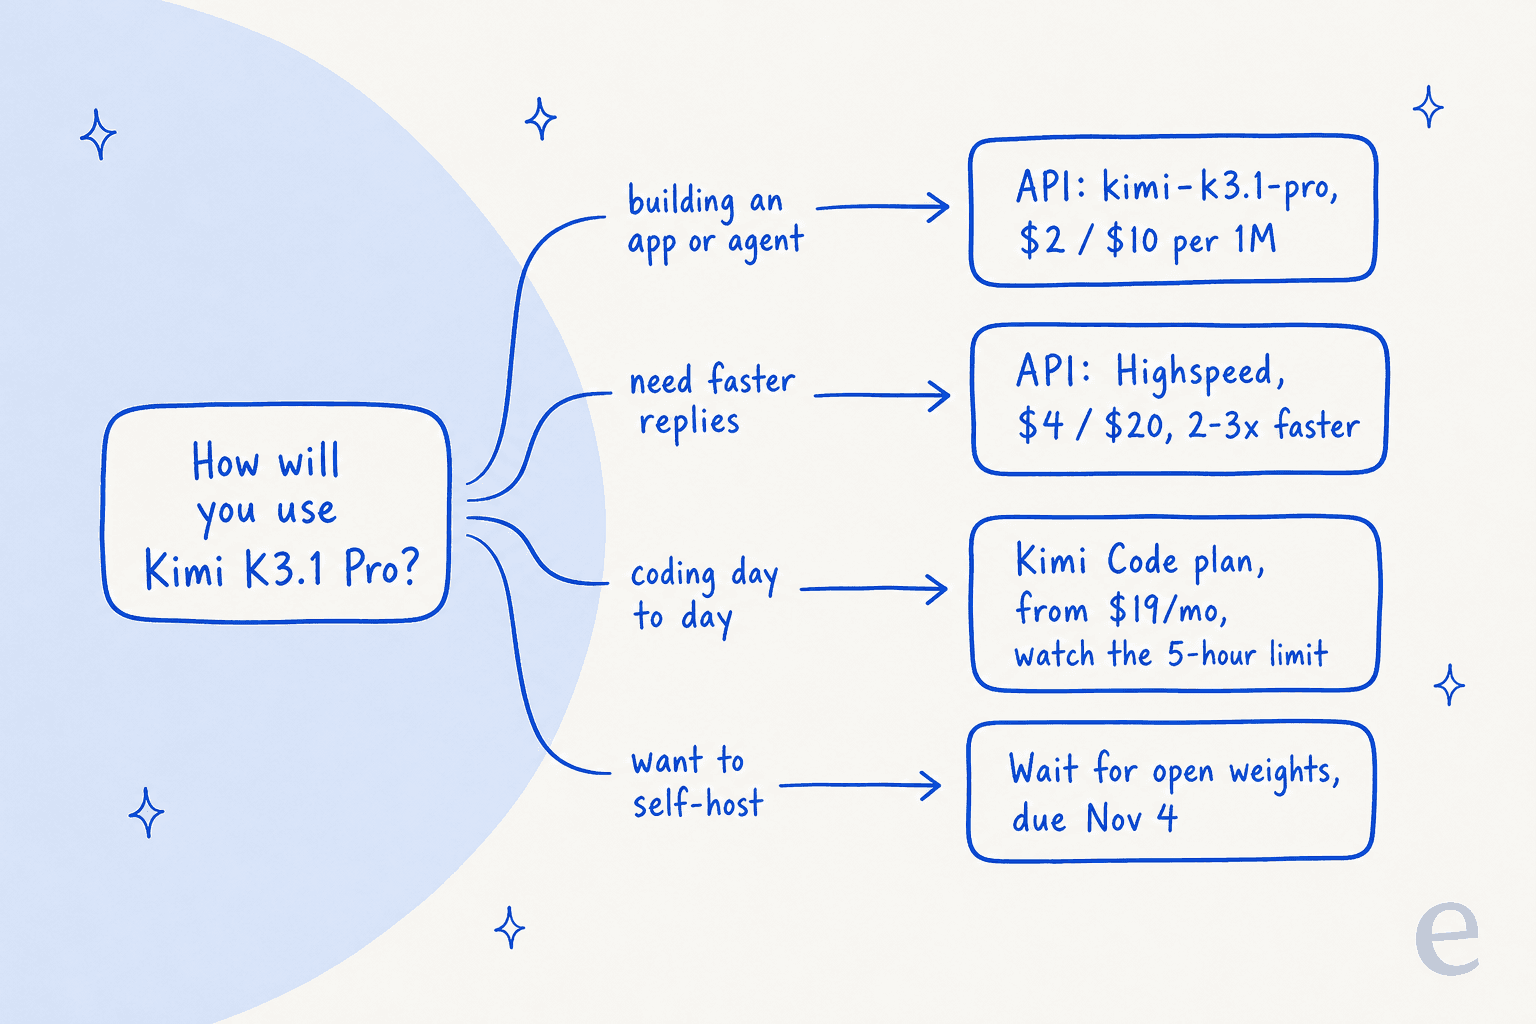
- API Kimi. Use os IDs de modelo
kimi-k3.1-prooukimi-k3.1-pro-highspeedna Kimi API Platform. O raciocínio está sempre ativado,reasoning_effortaceitalow,highoumax, e a saída padrão é de131,072tokens (configurável até o total de 1M). Zero Data Retention está disponível para clientes da API. - OpenRouter. Ele está listado como
moonshotai/kimi-k3.1-pro, com a Moonshot como único provedor por enquanto. É prático se você já faz roteamento entre modelos, e também útil ao compará-lo com um nível de API de IA gratuita. - Kimi Code. Você o seleciona com
/model. Esse é o agente de programação da própria Moonshot, disponível para desktop, CLI e plugins de IDE, e ele concorre diretamente com o Claude Code e com o modelo anterior da Moonshot, o Kimi K2.7 Code. - Aplicativos Kimi e Kimi Work. Esse é o caminho para consumidores, e inclui o 3D Make. O Kimi Work exige a versão de desktop
3.1.0ou posterior. No Kimi Enterprise, o K3.1 Pro vem desativado por padrão, então os administradores precisam ativá-lo.
Quem deve usar o Kimi K3.1 Pro?
Esta é minha conclusão depois de ler a documentação e os benchmarks, além das primeiras centenas de reações de desenvolvedores.
Escolha-o se você executa trabalhos longos de agentes sem supervisão (programação, pesquisa, trabalho financeiro com muitas planilhas) pelos quais pagaria os preços do Claude e pode esperar pelos resultados. A qualidade é próxima à do Opus por aproximadamente um terço do custo de execução, e não há cobrança adicional por prompts longos no contexto de 1M. Ele também é o modelo para ficar de olho se você precisa de um modelo de ponta que possa, no futuro, hospedar por conta própria.
Evite-o se uma pessoa espera por cada resposta, porque a 50 tokens por segundo o chat ao vivo e as trocas rápidas durante a programação parecem lentos. Você também pode evitá-lo se prioriza mais o custo do que a qualidade: GPT-6.1 Sol e Gemini 4 Argon concluem o mesmo trabalho de benchmark por menos. E, se você está comparando com outros modelos abertos, minha comparação Qwen 3.8 Max vs K3 e a lista de alternativas ao Kimi K3 continuam válidas para o cenário mais amplo.
O fator decisivo é se sua carga de trabalho é longa e tolera espera ou curta e interativa, e o K3.1 Pro foi feito para o primeiro tipo.
O que o Kimi K3.1 Pro significa para as equipes de suporte
Muitas pessoas que leem publicações de lançamento como esta têm uma pergunta mais específica em mente: meu agente de suporte deveria usar esse modelo? Acho que essa não é a primeira pergunta certa. Um modelo como o Kimi K3.1 Pro é um motor. Para responder tickets com ele, você ainda precisaria conectá-lo ao seu helpdesk e sincronizar sua central de ajuda e tickets anteriores, depois decidir o que ele pode fazer sozinho e o que transfere para uma pessoa, além de testá-lo antes que os clientes tenham qualquer contato com ele. Já vi bots que soavam confiantes darem respostas erradas em filas reais, e é por isso que a eesel simula cada implantação primeiro com os tickets históricos da própria equipe.
Essa camada é exatamente o que a eesel é. Você contrata um colega de equipe de IA para helpdesk pronto para trabalhar, que entra na sua fila existente no Zendesk, Freshdesk ou Gorgias, aprende com seus documentos e tickets anteriores e depois segue as regras de transferência que você escreve em inglês simples. Se você está comparando a categoria mais ampla, meu guia sobre funcionários de IA explica a diferença entre contratar um colega de equipe e construir um.

A SE Ranking dá uma boa ideia de como isso funciona em produção. Ela opera três produtos (SE Ranking, Planable e SE Visible) com uma única equipe no Zendesk, com um agente eesel por produto. Cada agente pesquisa cerca de 16,800 páginas de conteúdo da central de ajuda e do site antes de responder, responde ao chat ao vivo no idioma do cliente e transfere reembolsos, extensões de teste e dúvidas de nível 2 para uma pessoa, com os dados do cliente anexados. Entre 8 de agosto e 8 de setembro de 2026, ela atendeu cerca de 4,650 conversas. Nada disso depende de qual modelo teve a maior pontuação na semana passada.
Se a abordagem do Kimi focada em agentes chama sua atenção, a eesel CLI a leva para o suporte. Você pode executar o mesmo colega de equipe a partir de um terminal, por exemplo, para verificar seu trabalho recente com eesel activity ou aprovar e negar ações pendentes com eesel approvals, e também pode editar suas regras permanentes com eesel instructions. Os comandos imprimem JSON e os comandos de escrita aceitam --dry-run, o que significa que scripts e agentes de programação como o Claude Code conseguem operá-lo, e há também um servidor MCP. Abordo esse padrão mais amplo no meu guia sobre a CLI de agentes de IA.
Quer o resultado sem ter que ficar escolhendo modelos? Experimente a eesel gratuitamente no seu próprio helpdesk e veja como ela lida com os tickets da semana passada, ou explore os melhores colegas de equipe de IA para comparar as opções primeiro.
Perguntas frequentes
O que é o Kimi K3.1 Pro?
Kimi K3.1 Pro é o principal modelo da Moonshot AI, lançado em 23 de outubro de 2026. Ele usa a mesma base de 2.8T de parâmetros do Kimi K3, com muito mais pós-treinamento, uma janela de contexto de 1M de tokens e uma variante Highspeed mais rápida. Ele marca 55 no Artificial Analysis Intelligence Index, perto do Claude Opus 5.5.
Quanto custa o Kimi K3.1 Pro?
Na API do Kimi, o Kimi K3.1 Pro custa US$ 2 por milhão de tokens de entrada, US$ 0,20 para entrada em cache e US$ 10 por milhão de tokens de saída. A versão Highspeed custa US$ 4 e US$ 20. Isso é um terço mais barato que os preços do Kimi K3 e tem o mesmo preço de tabela do Claude Sonnet 5.5.
O Kimi K3.1 Pro é de código aberto?
Ainda não. A Moonshot diz que os pesos completos do Kimi K3.1 Pro serão lançados até 4 de novembro de 2026 e, até lá, ele só está disponível por API e aplicativo. Com 2.8T de parâmetros, ele vai precisar de um cluster de servidores, não de um notebook. Se você quer um modelo aberto que possa executar hoje, minha seleção de agentes de IA de código aberto apresenta as opções.
O Kimi K3.1 Pro é melhor que o Claude Opus 5.5?
No gráfico da própria Moonshot, o Kimi K3.1 Pro vence em 6 de 14 benchmarks e fica atrás do Opus 5.5 no Terminal-Bench 4.0 por 0.7 pontos. No Artificial Analysis, ele marca 55.1 contra 57.6. A maioria dos avaliadores independentes diz que o Opus ainda está à frente no uso diário, mas o Kimi custa cerca de um terço do valor para rodar. Minha análise do Claude Opus 5.5 aborda o outro lado.
O que é o Kimi K3.1 Pro Highspeed?
Kimi K3.1 Pro Highspeed é o mesmo modelo disponibilizado com velocidade 2 a 3 vezes maior, pelo dobro do preço: US$ 4 para entrada e US$ 20 para saída por milhão de tokens. Nos planos do Kimi para consumidores, ele exige o plano Pro ou superior e consome créditos duas vezes mais rápido. Ele faz mais diferença em chats e ciclos de programação em que a espera atrapalha, como no trabalho com o Claude Code.
Como uso o Kimi K3.1 Pro no Kimi Code?
Kimi K3.1 Pro está disponível no Kimi Code a partir do plano Plus (US$ 19/mês). Execute o Kimi Code e troque de modelo com o comando /model. Fique de olho no limite de uso em uma janela móvel de 5 horas, que os avaliadores atingiram rapidamente com o esforço no máximo. Para mais opções, veja minha lista de assistentes de programação com IA.
Posso usar o Kimi K3.1 Pro para suporte ao cliente?
Pode, mas o Kimi K3.1 Pro é um modelo bruto, então você ainda teria que criar por conta própria a conexão com o helpdesk, a sincronização de conhecimento, as regras de transferência e os testes. Sua velocidade de 50 tokens por segundo também é lenta para chat ao vivo. Um colega de equipe pronto para uso no suporte ao cliente com IA, como o eesel, cuida dessa camada, e meu guia sobre o melhor modelo de IA para tickets de suporte compara os motores.