

Resumo
A alternativa mais próxima do Kimi K3.1 Pro é o Claude Sonnet 5.5: os mesmos US$ 2/US$ 10 por milhão de tokens, cerca de três vezes a velocidade de saída e uma pontuação quase idêntica nos benchmarks. O Gemini 4 Argon também custa US$ 2/US$ 10, mas só até 30 de novembro de 2026, depois o preço dobra.
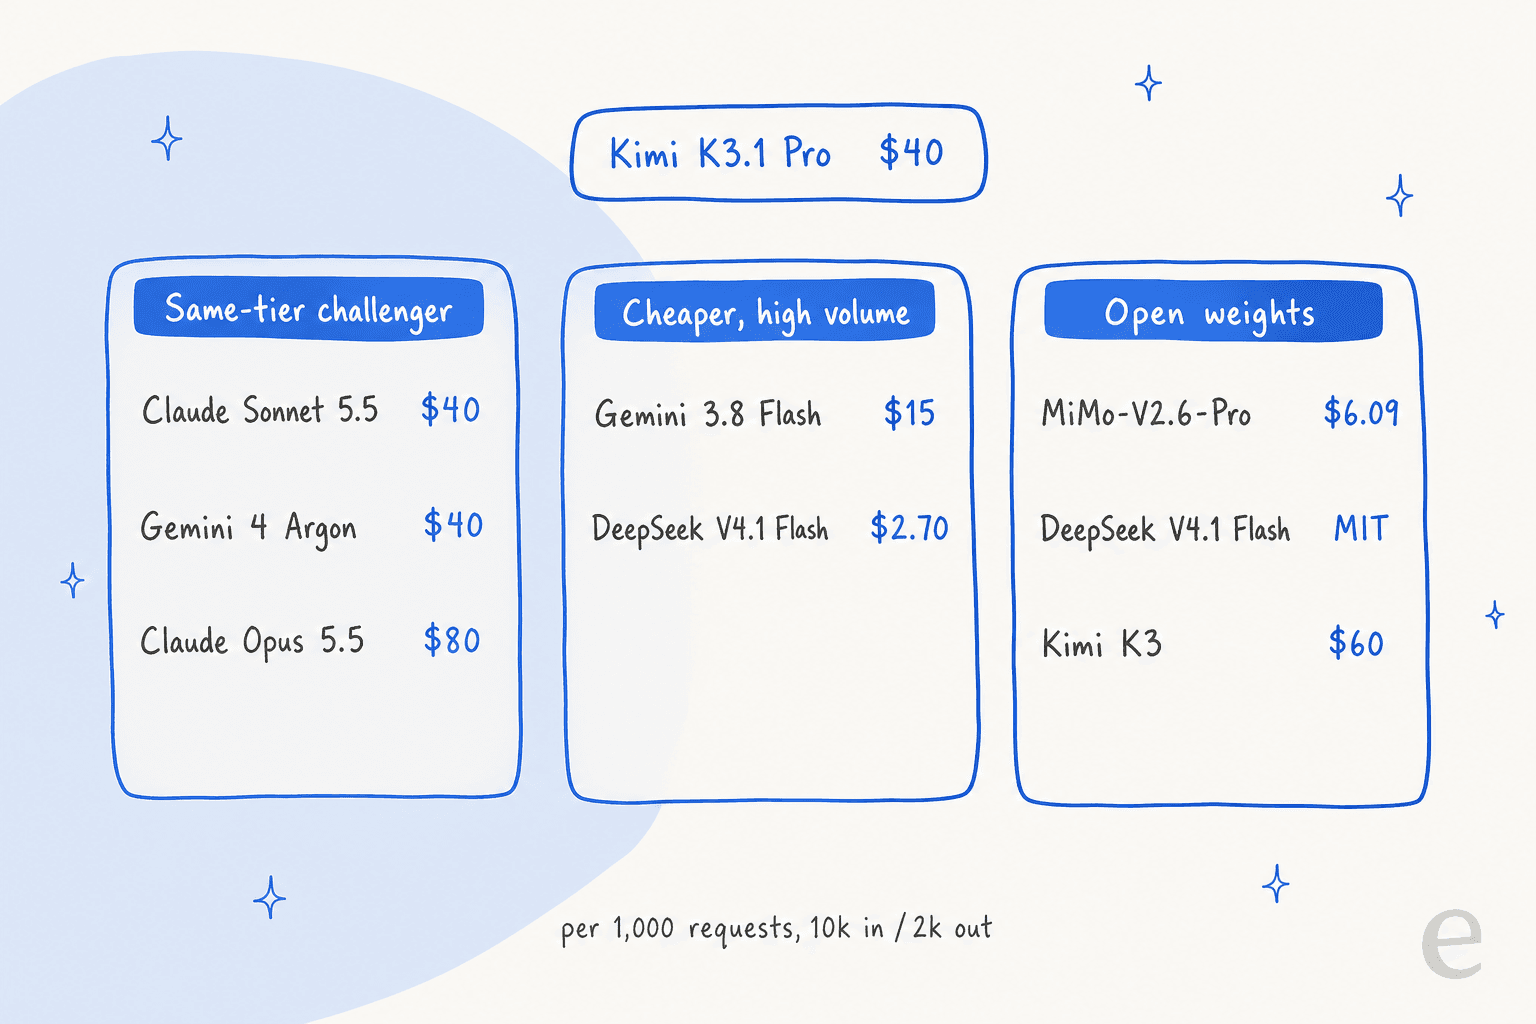
Se o problema é a sua conta, as opções mais baratas são o Gemini 3.8 Flash (cerca de $15 por 1.000 solicitações típicas, contra os $40 do Kimi) e o DeepSeek V4.1 Flash (cerca de $2.70 fora do horário de pico). Para pesos abertos que você pode baixar hoje, tanto o DeepSeek V4.1 Flash quanto o MiMo-V2.6-Pro têm licença MIT.
A surpresa é o Claude Opus 5.5: o dobro do preço de tabela, mas mais barato por tarefa concluída no nível de esforço High (US$ 1,82 contra US$ 2,11 no Artificial Analysis). E, se o modelo vai responder a tickets de suporte, talvez você nem precise escolher um: um colega de equipe de IA para helpdesk como o eesel já usa modelos de ponta e é testado primeiro nos seus tickets anteriores.
Por que olhar além do Kimi K3.1 Pro?
O Kimi K3.1 Pro é um modelo muito bom, e quero dizer isso antes de qualquer coisa. Ele marca 55.1 no Artificial Analysis Intelligence Index, ocupa a posição #4 entre 215, a US$ 2 de entrada e US$ 10 de saída por milhão de tokens na Kimi API. No Terminal-Bench 4.0, registrou a maior pontuação de qualquer modelo naquela página, 67,2%.
Então, por que as pessoas estão buscando alternativas uma semana depois do lançamento? Pelo que li nas discussões sobre o lançamento e nos números, quatro motivos aparecem repetidamente:
- Ele é lento. O Artificial Analysis mediu 49.7 tokens de saída por segundo, contra uma mediana de 83.1 entre os pares, colocando-o na posição #165 entre 182 em velocidade. Um usuário esperando uma resposta no chat sente isso.
- Ele escreve muito. Usou 148M de tokens de saída para executar o índice, contra uma mediana de cerca de 87M entre os pares, então o preço baixo por token acaba voltando para a conta. Seu custo médio por tarefa do índice é de
$2.11, um pouco mais que os$2.00do Kimi K3. - Os pesos ainda não saíram. O guia de início rápido do K3.1 Pro da Moonshot diz que eles serão lançados até 4 de novembro. No dia em que consultei, não havia um repositório do K3.1 Pro no Hugging Face.
- Menos formas de comprá-lo. A Batch API do Kimi não inclui o K3.1 Pro, e os planos para consumidores atingem rapidamente seus limites de 5 horas, como disse um comprador:
"If you are expecting any sort of usable limits on their subscription plan I suggest adjusting your expectations. I subscribed to $99 a month plan and within 47 minutes with one session (not asking for swarms or anything) was limited by 5-hour quota."

Nenhum desses pontos, sozinho, é motivo para descartar o modelo. Mas cada um aponta para uma alternativa diferente, e é por isso que organizei esta lista pelo motivo da sua mudança, não por um ranking único. Minha análise do Kimi K3.1 Pro tem o quadro completo de resultados, caso você ainda esteja decidindo se vale a pena mudar.
Como fiz a comparação?
Eu desenvolvo agentes de IA no eesel, onde a equipe passou anos colocando modelos de ponta em filas reais de suporte. A lição que ficou: o preço por token não diz quase nada sobre a conta. O que importa é o custo por tarefa bem-sucedida, ou seja, o gasto total em um lote de tarefas reais dividido pelas tarefas que deram certo. Um modelo que custa metade do preço de tabela, mas escreve o dobro de tokens ou falha em uma de cada quatro tarefas, não é mais barato.
Por isso, para cada alternativa, analisei três números:
- Preço de tabela, retirado apenas da página de preços ou da documentação do próprio fornecedor.
- Custo por 1.000 solicitações para uma chamada típica de 10.000 tokens de entrada e 2.000 tokens de saída, sem cache. Esse é um piso, porque modelos de raciocínio geralmente escrevem muito mais que 2.000 tokens.
- Custo por tarefa e pontuação no Intelligence Index do Artificial Analysis, que submete todos os modelos às mesmas 10 avaliações. É a aproximação pública mais próxima do custo por tarefa bem-sucedida.
Agrupei as sete opções em três categorias, da mesma forma que a maioria dos compradores pensa: um concorrente do mesmo nível por um preço próximo ao do Kimi, um modelo mais barato para alto volume e pesos abertos que você pode hospedar por conta própria.
Alternativas ao Kimi K3.1 Pro em resumo
Todos os preços abaixo vêm da página do próprio fornecedor. As colunas de benchmark, velocidade e custo por tarefa vêm do Artificial Analysis, no nível de esforço indicado entre parênteses.
| Modelo | Categoria | Entrada / saída por 1M | Entrada em cache por 1M | Contexto | Saída máxima | Por 1.000 solicitações (10k entrada / 2k saída) | AA Intelligence Index | Custo por tarefa no AA | Velocidade de saída (t/s) | Pesos |
|---|---|---|---|---|---|---|---|---|---|---|
| Kimi K3.1 Pro (referência) | n/a | US$ 2 / US$ 10 | US$ 0,20 | 1M | 131K por padrão, até 1M | US$ 40 | 55.1 | US$ 2,11 | 49.7 | Prometidos até 4 de novembro |
| Claude Sonnet 5.5 | Mesmo nível | US$ 2 / US$ 10 | US$ 0,10 | 1M | 128K | US$ 40 | 56.0 (Max), 51.9 (Xhigh) | US$ 5,46 (Max), US$ 2,01 (Xhigh) | 141.3 (Max) | Fechados |
| Gemini 4 Argon | Mesmo nível | US$ 2 / US$ 10 até 30 de novembro, depois US$ 4 / US$ 20 | US$ 0,10, depois US$ 0,20 | 1M | 65K por padrão, até 1M | US$ 40, depois US$ 80 | 52.6 (High) | US$ 1,62 (High) | 79.7 (High) | Fechados |
| Claude Opus 5.5 | Mesmo nível, premium | US$ 4 / US$ 20 | US$ 0,20 | 1M | 128K | US$ 80 | 57.6 (Max), 53.6 (High) | US$ 5,98 (Max), US$ 1,82 (High) | 98.1 (Max) | Fechados |
| Gemini 3.8 Flash | Mais barato | US$ 0,75 / US$ 3,75 até 31 de dezembro, depois US$ 1,50 / US$ 7,50 | US$ 0,075, depois US$ 0,15 | 1M | 65K | US$ 15, depois US$ 30 | 41 (High) | n/a | 133.7 (High) | Fechados |
| DeepSeek V4.1 Flash | Mais barato, aberto | US$ 0,15 / US$ 0,60 fora do pico, US$ 0,30 / US$ 1,20 no pico | US$ 0,003 fora do pico | 1M | 384K | US$ 2,70 fora do pico, US$ 5,40 no pico | 45.1 (Max) | US$ 0,26 (Max) | 169.3 (Max) | MIT |
| MiMo-V2.6-Pro | Pesos abertos | US$ 0,435 / US$ 0,87 | US$ 0,0036 | 1M | Não informado | US$ 6,09 | 46.3 | Cerca de US$ 0,14 | 54.7 | MIT |
| Kimi K3 | Aberto, mesma família | US$ 3 / US$ 15 | US$ 0,30 | 1M | 131K por padrão, até 1M | US$ 60 | 43.6 (Max) | US$ 2,00 (Max) | 54.5 (Max) | Licença Kimi K3 |
Duas coisas chamam a atenção. Primeiro, a coluna de mesmo nível está cheia: três modelos compartilham o preço de US$ 40 por 1.000 solicitações do Kimi, pelo menos por enquanto. Segundo, a coluna de custo por tarefa muda a ordem da lista. Tanto o Opus 5.5 em High quanto o Gemini 4 Argon em High concluem uma tarefa média por menos que o Kimi K3.1 Pro, embora o Opus custe o dobro por token.
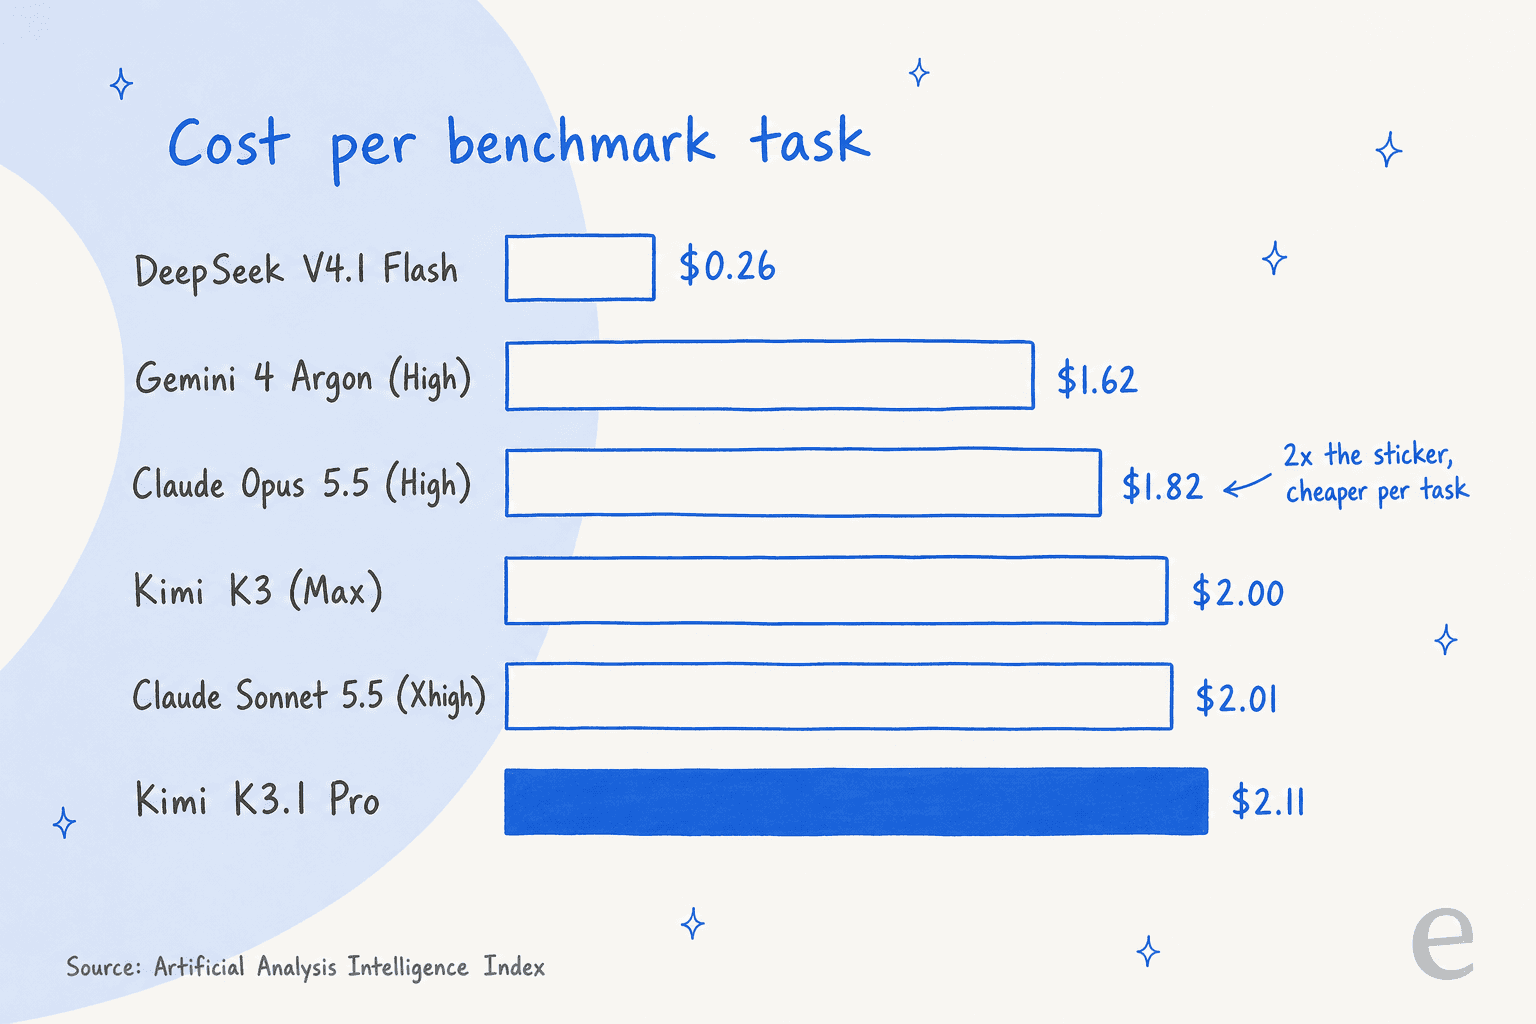
Uma ressalva sobre esse gráfico: o Kimi K3.1 Pro foi executado no esforço máximo padrão, enquanto o Opus e o Argon foram executados em High. Mas esse é justamente o ponto. O esforço é um ajuste que você pode controlar, e a boa resposta mais barata costuma vir de um modelo mais forte em uma configuração mais baixa.
Qual alternativa combina com o seu produto?
Escolha o trabalho que seu produto faz, e o cartão mostra por onde eu começaria o teste comparativo.
Escolha um trabalho para ver qual modelo eu testaria primeiro contra o Kimi K3.1 Pro, com seu custo por 1.000 solicitações de 10k tokens de entrada e 2k de saída.
1. Claude Sonnet 5.5
Ideal para: equipes que querem o preço do Kimi com uma saída mais rápida e estável. Concorrente do mesmo nível.
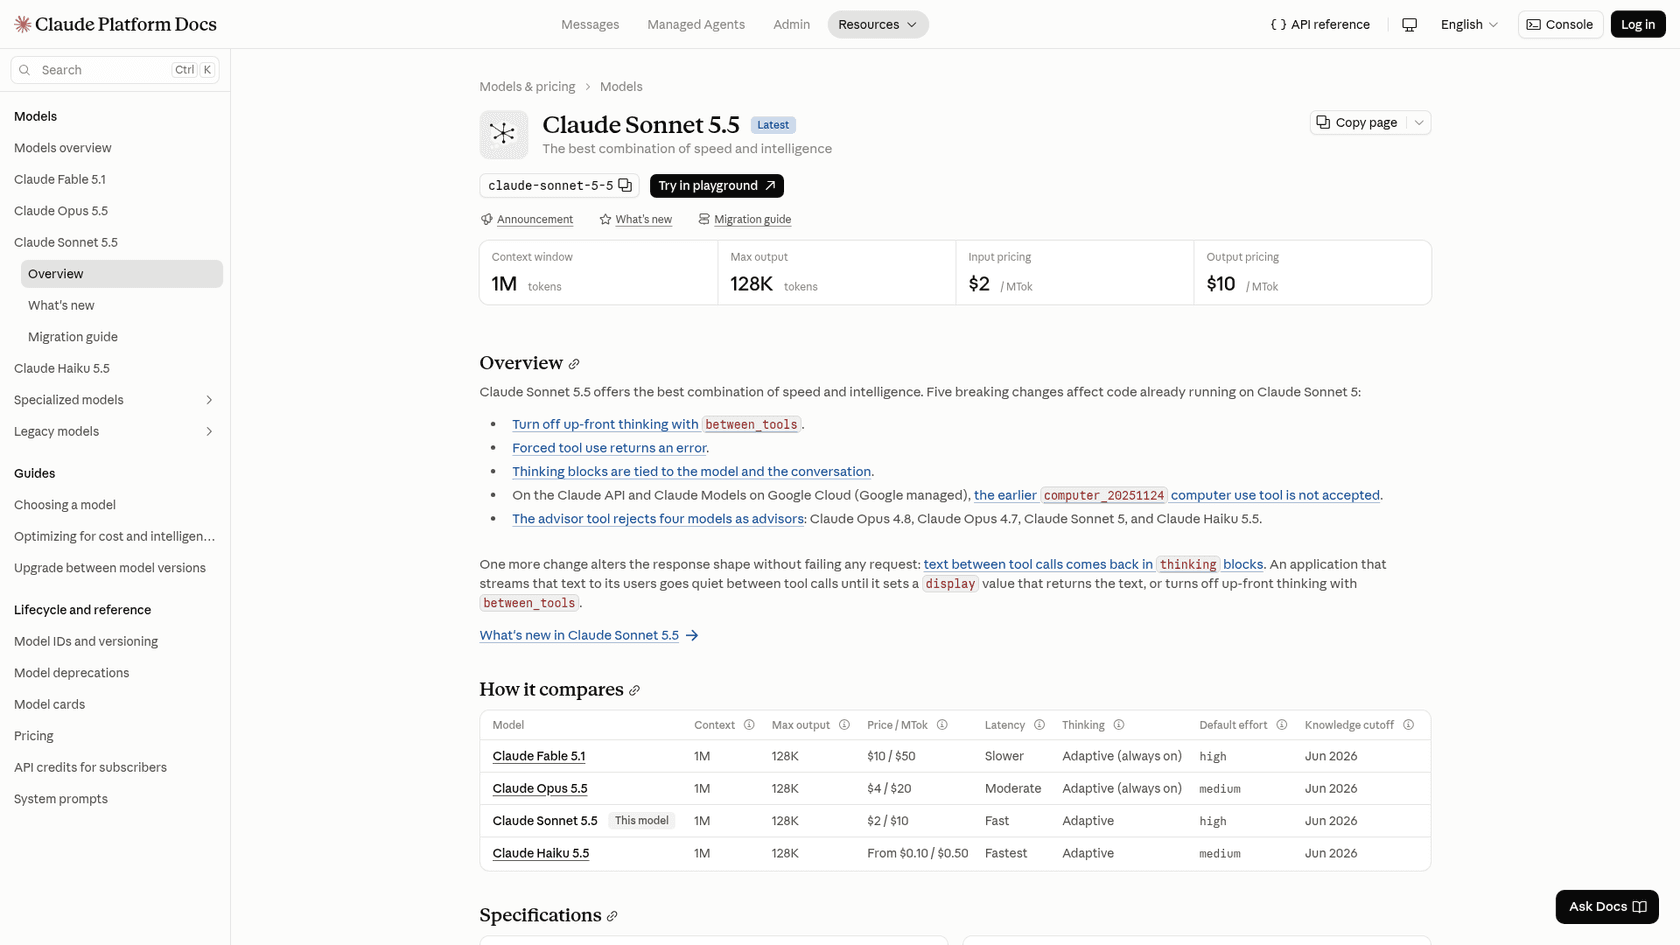
O Claude Sonnet 5.5 é a substituição mais direta desta lista. A Anthropic cobra exatamente o preço de tabela do Kimi K3.1 Pro, US$ 2 de entrada e US$ 10 de saída por milhão de tokens, com uma janela de contexto de 1M e saída máxima de 128K, segundo sua visão geral do modelo.
Por que escolhê-lo em vez do Kimi K3.1 Pro
- Velocidade. O Artificial Analysis mediu 141.3 tokens por segundo com esforço máximo, contra os 49.7 do Kimi.
- Uma pontuação um pouco maior. 56.0 no Intelligence Index em Max, contra 55.1.
- Leituras de cache mais baratas. A página de preços da Anthropic cobra US$ 0,10 por milhão de tokens de entrada em cache no Sonnet 5.5, metade dos US$ 0,20 do Kimi. Em um bot de suporte com um prompt de sistema longo e estável, isso faz diferença.
- Processamento em lote. O Sonnet 5.5 custa US$ 1 / US$ 5 na API de processamento em lote da Anthropic. A API de processamento em lote do Kimi não inclui o K3.1 Pro.
Um participante da discussão sobre o lançamento do K3.1 executou ambos em seu próprio benchmark e encontrou um empate em qualidade:
"Kimi K3.1 Pro ties Sonnet 5.5 at 93, for $0.68 and 11 min vs Sonnet's $1.61 and 14 min."
Onde ele fica aquém
O Sonnet 5.5 escreve muito com esforço máximo. Usou 416M de tokens de saída para executar o índice, então seu custo por tarefa em Max é de $5.46, mais que o dobro do Kimi. Em Xhigh, a pontuação cai para 51.9 e o custo para $2.01. Ele também trouxe cinco mudanças que quebram código existente: forçar o uso de ferramentas retorna um erro, e o raciocínio não pode ser desativado da forma antiga, segundo a página de visão geral. Se seu bot de suporte depende de forçar uma chamada de ferramenta, verifique isso primeiro.
Preços
| Item | Preço por 1M de tokens |
|---|---|
| Entrada | US$ 2 |
| Saída | US$ 10 |
| Leitura de cache | US$ 0,10 |
| Gravação em cache de 5 minutos | US$ 2,50 |
| Gravação em cache de 1 hora | US$ 4 |
| Entrada / saída em lote | US$ 1 / US$ 5 |
O detalhamento completo está no meu guia de preços do Sonnet 5.5.
Minha opinião
Escolha o Sonnet 5.5 se a velocidade do Kimi é o motivo da sua mudança e execute-o abaixo do esforço máximo. Evite-o se sua carga de trabalho envolve execuções longas de agentes com esforço máximo, em que a menor contagem de tokens do Kimi leva vantagem na conta. A análise do Sonnet 5.5 aborda em detalhes as vantagens e desvantagens dos níveis de esforço.
2. Gemini 4 Argon
Ideal para: trabalhos com contexto longo e sensíveis à precisão pelo preço do Kimi, se você mudar antes de dezembro. Concorrente do mesmo nível.
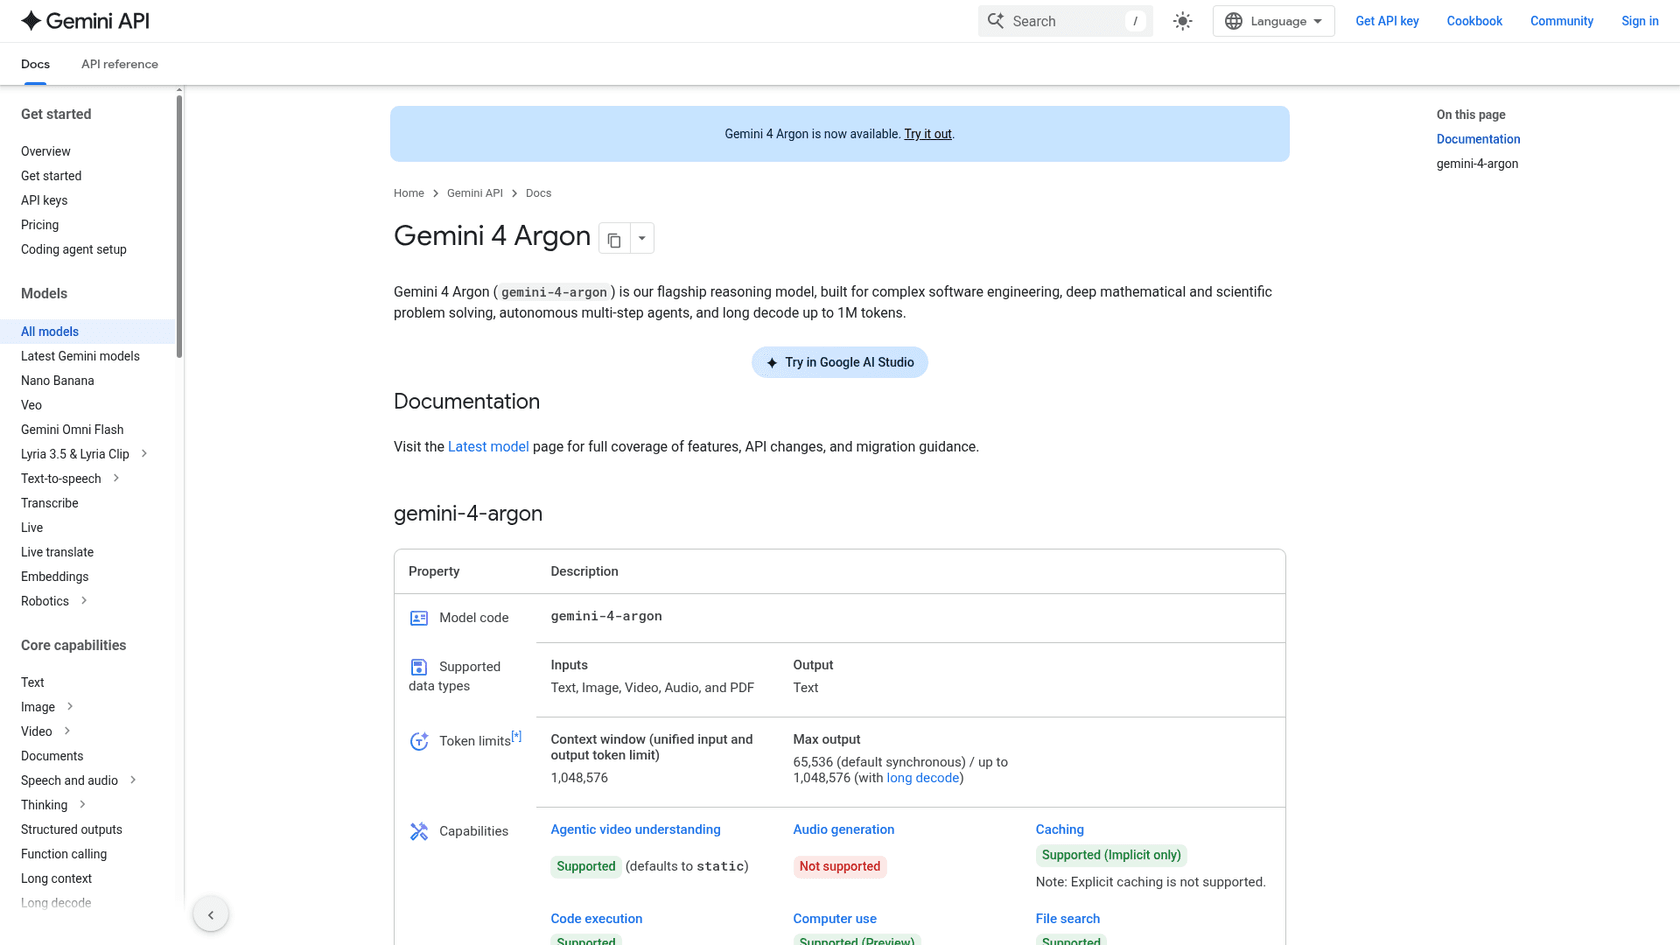
O Gemini 4 Argon é o principal modelo de raciocínio do Google e já está disponível na Gemini API. Nas próximas semanas, ele custa exatamente o mesmo que o Kimi K3.1 Pro, o que faz dele o teste mais fácil de realizar entre modelos do mesmo nível.
Por que escolhê-lo em vez do Kimi K3.1 Pro
- Menos respostas inventadas. O Artificial Analysis aponta uma taxa de alucinação de 15,1%, contra 43,9% do Kimi K3.1 Pro. Para qualquer coisa voltada ao cliente, esse seria o número mais importante para mim.
- Mais barato por tarefa. No nível de esforço High, teve uma média de
$1.62por tarefa do índice, com uma pontuação de 52.6. - Saída longa. Sua página do modelo lista 65.536 tokens de saída por padrão e até 1.048.576 com decodificação longa.
- Seus dados ficam fora do treinamento. A página de preços do Google diz que o uso na modalidade paga não é usado para melhorar seus produtos.
Onde ele fica aquém
O preço é promocional. O Google lista US$ 2 / US$ 10 até 30 de novembro de 2026 e US$ 4 / US$ 20 a partir de 1 de dezembro, o que o coloca no preço de tabela do Opus 5.5. Não há suporte a cache explícito, apenas implícito, e não existe modalidade gratuita. Sua pontuação no índice, 52.6 em High, fica 2.5 pontos abaixo da do Kimi.
Preços
| Item | Até 30 de novembro de 2026 | A partir de 1 de dezembro de 2026 |
|---|---|---|
| Entrada por 1M | US$ 2 | US$ 4 |
| Saída por 1M (incl. raciocínio) | US$ 10 | US$ 20 |
| Entrada em cache por 1M | US$ 0,10 | US$ 0,20 |
| Entrada / saída em lote por 1M | US$ 1 / US$ 5 | US$ 2 / US$ 10 |
| Fundamentação com pesquisa | 5.000 gratuitas por mês, depois US$ 14 por 1.000 | Igual |
Mais detalhes no meu post sobre preços do Gemini 4 Argon.
Minha opinião
Escolha o Argon se respostas erradas são seu maior risco e faça as contas com a tarifa de dezembro para não ter surpresas. Evite-o se você precisa de um preço fixo para o próximo ano. A análise do Gemini 4 Argon traz mais detalhes sobre onde ele lidera e onde fica atrás.
3. Claude Opus 5.5
Ideal para: os trabalhos mais difíceis de programação e de agentes, nos quais uma execução malsucedida custa mais que os tokens. Concorrente premium do mesmo nível.
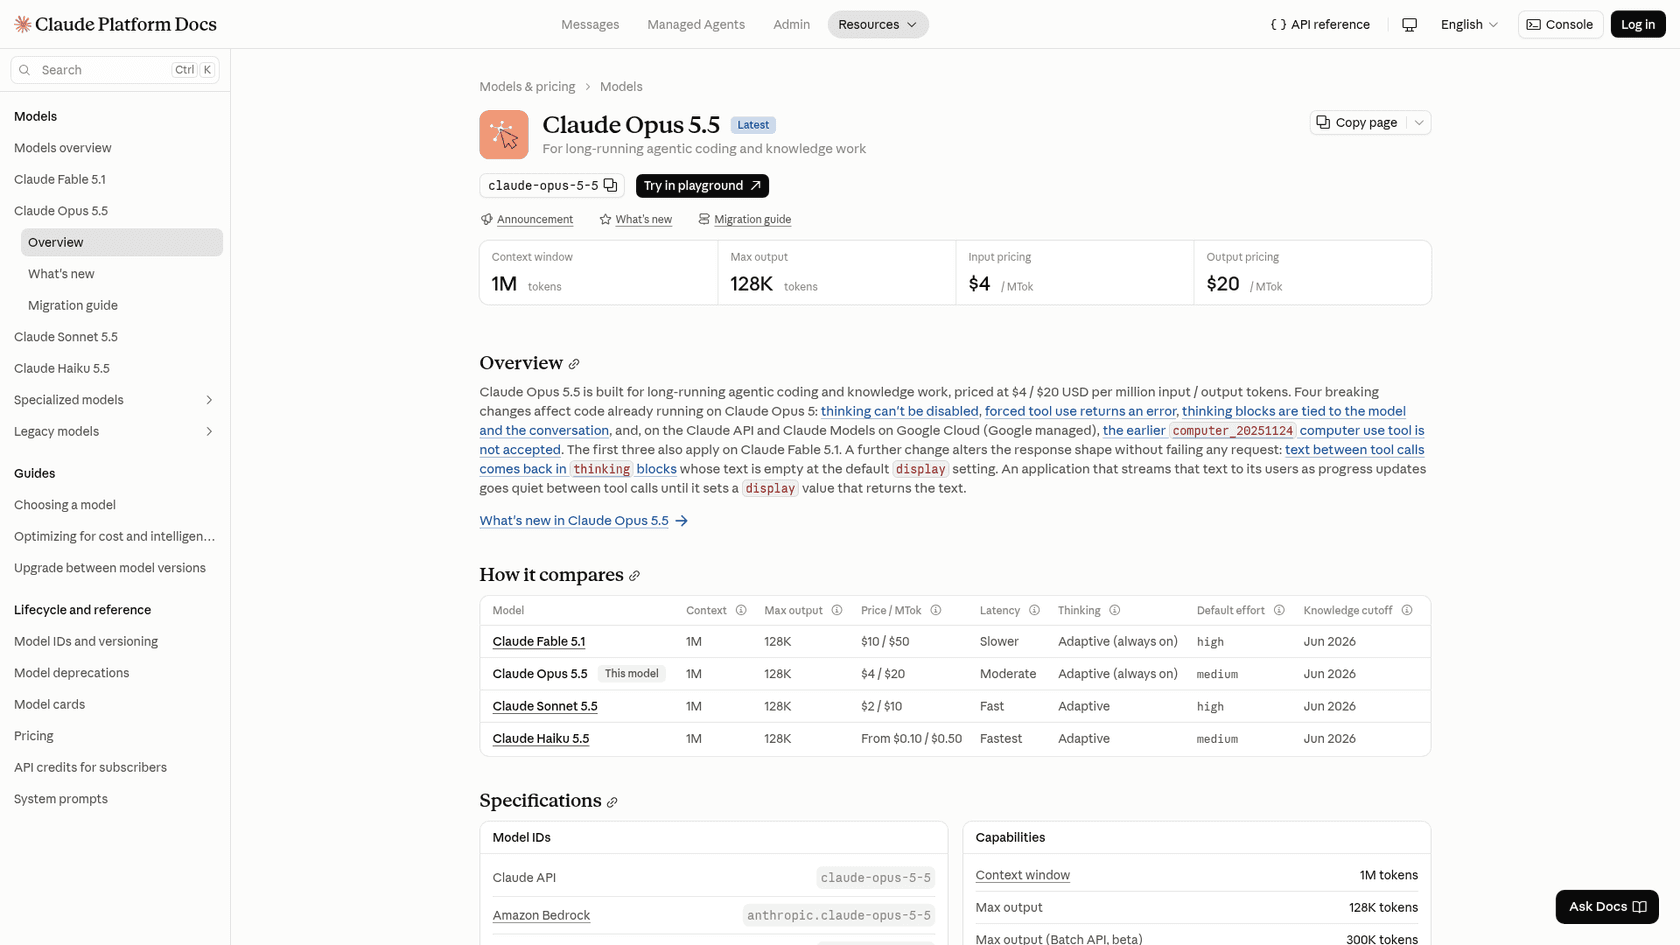
O Claude Opus 5.5 é o modelo com o qual o Kimi K3.1 Pro se compara. A própria visão geral dos modelos da Anthropic agora orienta os desenvolvedores a começar por ele para a maioria das cargas de trabalho, e seu esforço padrão é médio.
Por que escolhê-lo em vez do Kimi K3.1 Pro
- A maior pontuação aqui. 57.6 no Intelligence Index em Max, o topo da comparação do Artificial Analysis.
- Mais barato por tarefa em High. 53.6 por
$1.82por tarefa, menos que os$2.11do Kimi. - Usuários diários ainda o colocam à frente. No X, um avaliador comparou ambos em 180 pinturas feitas com código:
"I feel Opus still nails the subtle details better, like in the tractor example below. But I wonder if it matters when you can run Kimi 3x before it costs the same as one Opus?"
Onde ele fica aquém
Em Max, o Opus é a opção mais cara: $5.98 por tarefa e US$ 8.708 para executar o índice completo, contra os US$ 3.117 do Kimi. Sua taxa de alucinação em Max é de 58,6% no Artificial Analysis, maior que os 43,9% do Kimi. E os próprios números de lançamento do Kimi o colocam a menos de um ponto de distância no Terminal-Bench 4.0 (65,7% contra 66,4%).
Preços
| Item | Preço por 1M de tokens |
|---|---|
| Entrada | US$ 4 |
| Saída | US$ 20 |
| Leitura de cache | US$ 0,20 |
| Gravação em cache de 5 minutos | US$ 5 |
| Gravação em cache de 1 hora | US$ 8 |
| Entrada / saída em lote | US$ 2 / US$ 10 |
| Entrada / saída no modo rápido | US$ 8 / US$ 40 |
Tudo vem da página de preços da Anthropic. O post sobre preços do Opus 5.5 detalha contas reais.
Minha opinião
Escolha o Opus 5.5 em High quando a qualidade por execução é o fator limitante e você pode definir o esforço por conta própria. Evite-o se seu tráfego é simples e de alto volume, pois você estará pagando por raciocínio que não usa. Minha análise do Opus 5.5 passa por cada nível de esforço.
4. Gemini 3.8 Flash
Ideal para: tráfego de API de alto volume em que a resposta não precisa chegar em dois segundos. Categoria mais barata.
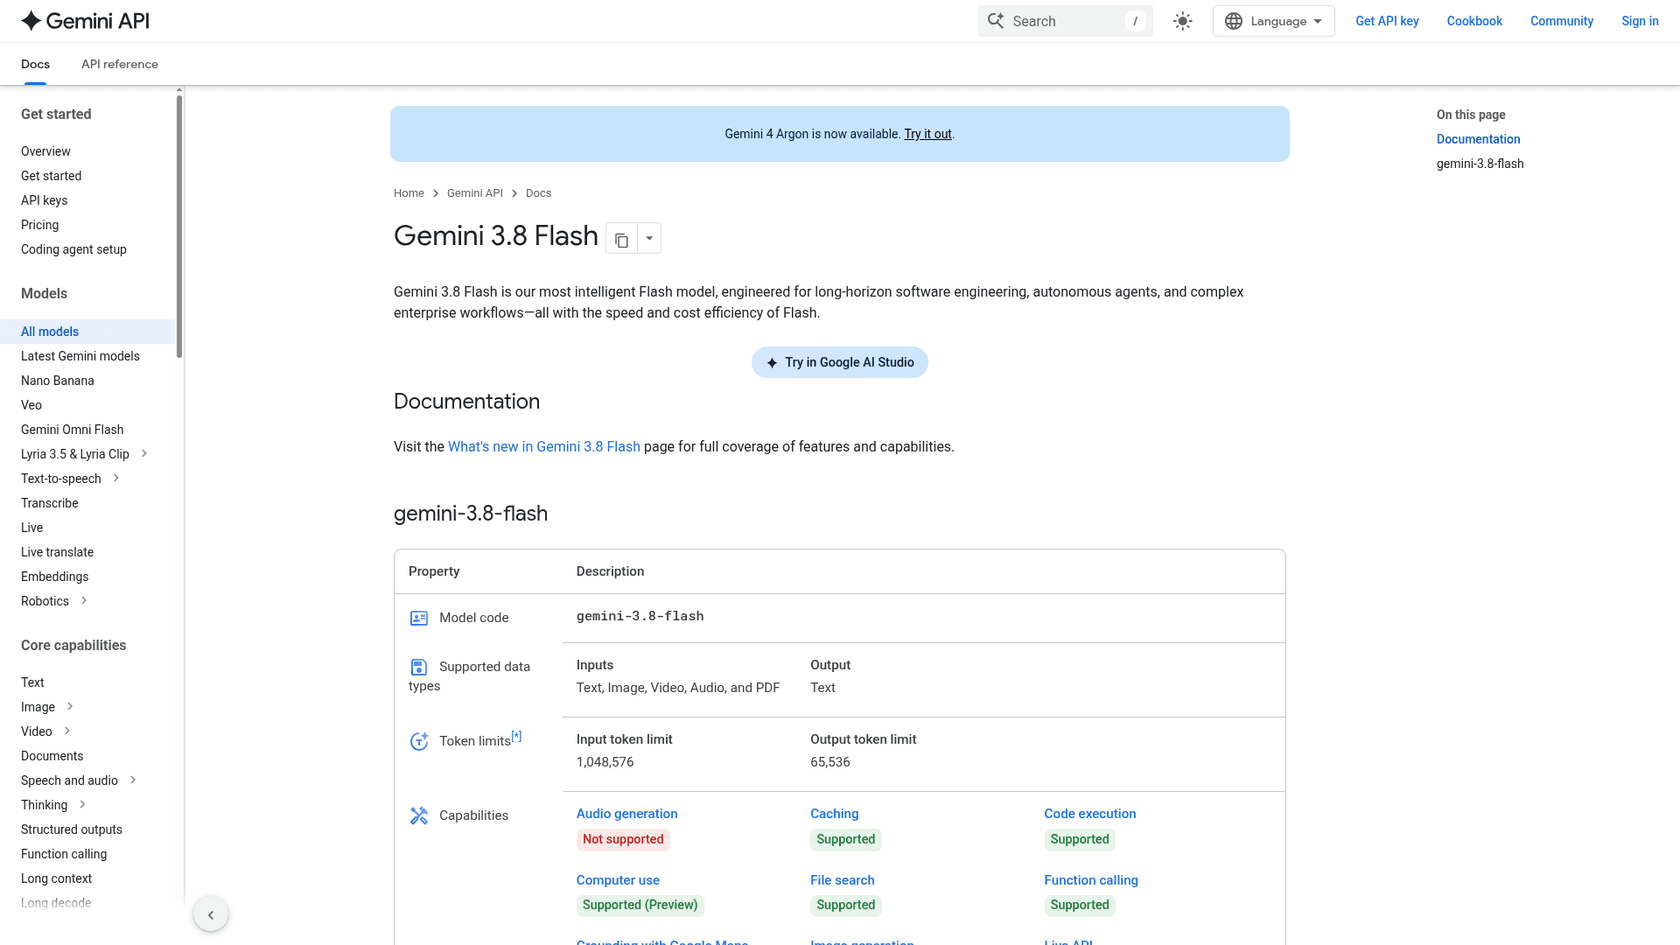
O Gemini 3.8 Flash é o modelo fechado mais barato aqui. Na página de preços da Gemini API, ele custa US$ 0,75 de entrada e US$ 3,75 de saída por milhão de tokens, incluindo tokens de raciocínio, até 31 de dezembro de 2026.
Por que escolhê-lo em vez do Kimi K3.1 Pro
- Cerca de um terço da conta. Aproximadamente
$15por 1.000 solicitações típicas, contra os$40do Kimi. - Saída rápida. 133.7 tokens por segundo no Artificial Analysis.
- Uma modalidade gratuita para testes, e processamento em lote pela metade do preço pago.
- Entradas variadas. Texto, imagem, vídeo, áudio e PDF como entrada, segundo sua página do modelo.
Onde ele fica aquém
Ele fica um nível abaixo em inteligência: 41 no Intelligence Index em High, contra os 55.1 do Kimi. O Artificial Analysis também mediu um tempo até o primeiro token de 28,78 segundos, muito acima da mediana de 3,90 segundos da sua faixa de preço, então um usuário olhando para uma janela de chat vai perceber. E o preço dobra em 1 de janeiro de 2027, para US$ 1,50 / US$ 7,50.
Preços
| Item | Até 31 de dezembro de 2026 | A partir de 1 de janeiro de 2027 |
|---|---|---|
| Entrada por 1M | US$ 0,75 | US$ 1,50 |
| Saída por 1M (incl. raciocínio) | US$ 3,75 | US$ 7,50 |
| Entrada em cache por 1M | US$ 0,075 | US$ 0,15 |
| Entrada / saída em lote por 1M | US$ 0,375 / US$ 1,875 | US$ 0,75 / US$ 3,75 |
| Modalidade gratuita | Sim | Sim |
Meu post sobre preços do Gemini 3.8 Flash traz exemplos com os cálculos.
Minha opinião
Escolha o 3.8 Flash para tarefas em segundo plano: classificação com tags, resumos, agentes que rodam durante a noite. Evite-o para chat ao vivo até medir por conta própria a espera pelo primeiro token. A análise do Gemini 3.8 Flash aborda a questão da latência.
5. DeepSeek V4.1 Flash
Ideal para: a menor conta desta lista, com pesos abertos como alternativa. Categoria mais barata e pesos abertos.
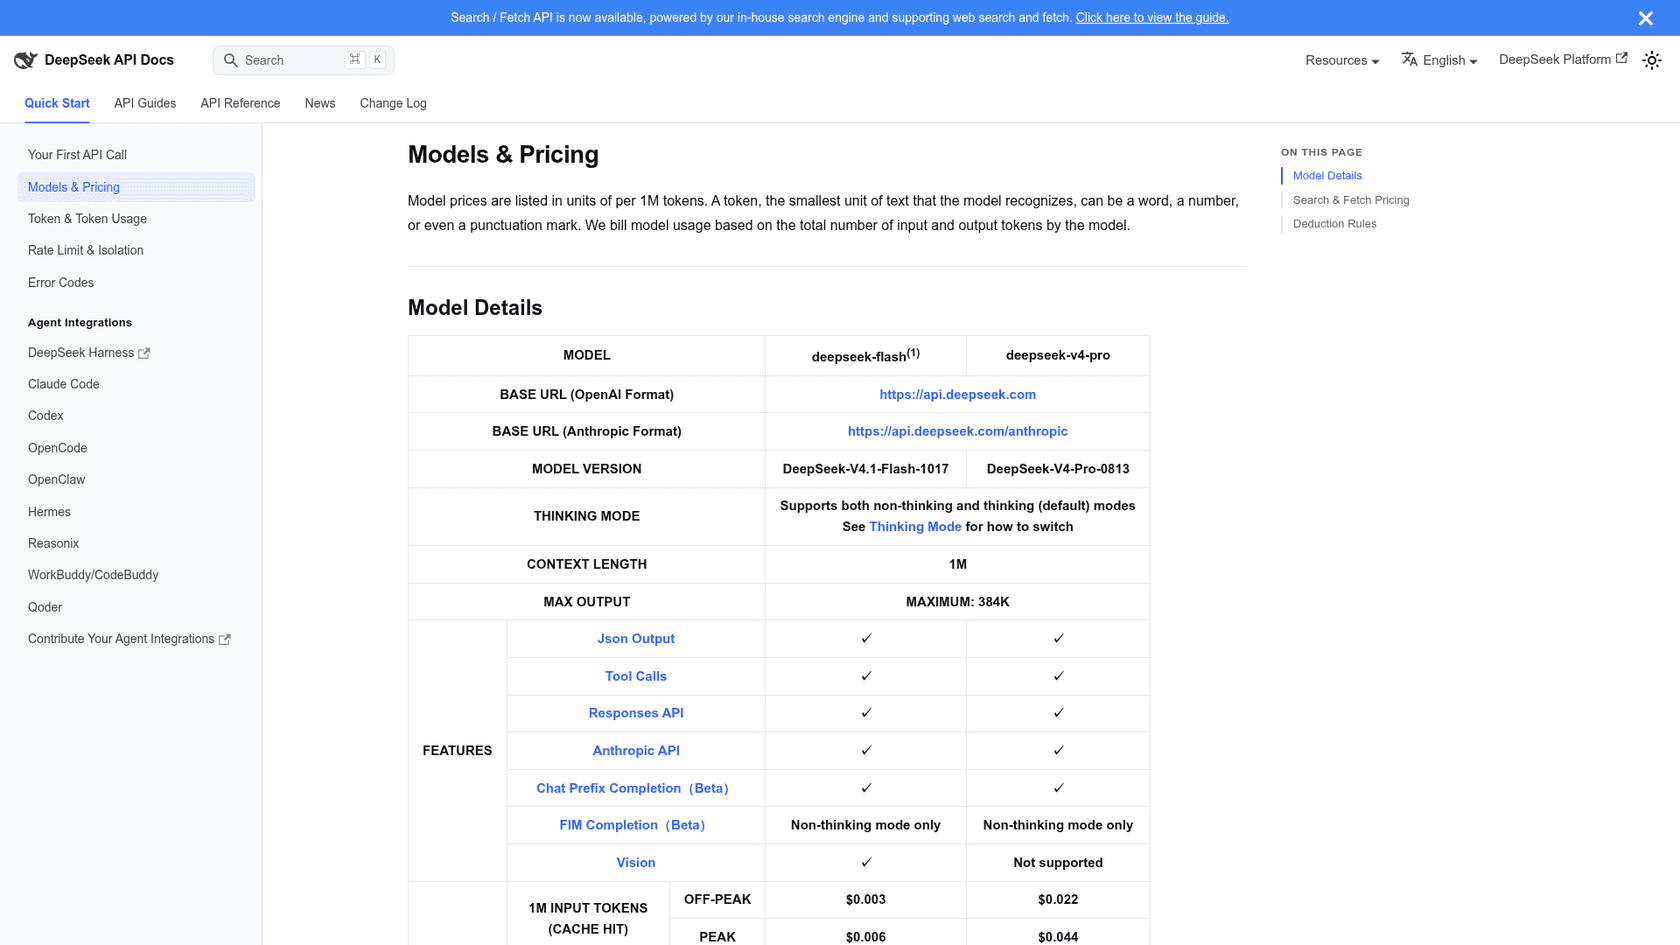
O DeepSeek V4.1 Flash é o piso de preço deste grupo. Na página de Modelos e Preços da DeepSeek, o modelo deepseek-flash (agora na versão 1017) custa US$ 0,15 de entrada e US$ 0,60 de saída por milhão de tokens fora do horário de pico.
Por que escolhê-lo em vez do Kimi K3.1 Pro
- Cerca de 15x mais barato por solicitação. Aproximadamente
$2.70por 1.000 solicitações típicas fora do pico, contra$40. - Cerca de 8x mais barato por tarefa.
$0.26por tarefa do Artificial Analysis, contra$2.11, com uma pontuação de 45.1. - Rápido. 169.3 tokens por segundo, o mais rápido aqui.
- Pesos abertos agora. Com licença MIT no Hugging Face, cerca de 763B de parâmetros.
No benchmark de correção de bugs reais de um avaliador, ele até terminou à frente:
"So I tested Kimi K3.1 Pro on real work. 2 repos. 105 replanted bugs. Find and fix what you can. The results: DeepSeek V4.1 Flash 1017 (max): 42.7 Muse Wonder Full 1.0 (max): 42 Opus 5.5 (max): 41.7 Kimi K3.1 Pro (max): 36 Muse Spark 1.3 (max): 32.2 I'm sorry. Considering the cost, I see no reason to use this model."
Onde ele fica aquém
Sua pontuação no índice fica 10 pontos abaixo da do Kimi, então as tarefas baratas são baratas em parte porque as respostas são mais simples. Os preços dobram nos horários de pico (01:00 a 04:00 e 06:00 a 10:00 UTC nos dias úteis). E, para dados de clientes, os termos da API da DeepSeek não publicam um acordo de processamento de dados nem uma opção de retenção zero, então peça uma análise jurídica antes de enviar tickets de suporte por ela.
Preços
| Item | Fora do pico por 1M | No pico por 1M |
|---|---|---|
| Entrada, acerto de cache | US$ 0,003 | US$ 0,006 |
| Entrada, sem acerto de cache | US$ 0,15 | US$ 0,30 |
| Saída | US$ 0,60 | US$ 1,20 |
| Search ou Fetch API | US$ 0,75 por 1.000 solicitações | Igual |
Mais no meu guia de preços do DeepSeek V4.1 Flash e na análise da atualização 1017.
Minha opinião
Escolha o DeepSeek V4.1 Flash para trabalhos de volume em que um modelo de 45 pontos é suficiente e encaminhe as tarefas difíceis para outro modelo. Evite-o para dados de clientes sujeitos a regulamentação, a menos que você hospede os pesos por conta própria.
6. MiMo-V2.6-Pro
Ideal para: pesos abertos de um segundo fornecedor, com um preço de API muito baixo. Categoria de pesos abertos.
O MiMo-V2.6-Pro é o modelo de um trilhão de parâmetros da Xiaomi, lançado com pesos sob licença MIT em setembro. O post de lançamento da Xiaomi o chama de modelo de código aberto mais poderoso disponível no lançamento, com uma pontuação de 46 no índice do Artificial Analysis.
Por que escolhê-lo em vez do Kimi K3.1 Pro
- Cerca de um sexto do preço por solicitação. US$ 0,435 de entrada e US$ 0,87 de saída por milhão de tokens na tabela de preços internacional da Xiaomi, ou cerca de
$6.09por 1.000 solicitações típicas. - Uma conta minúscula para o índice completo. O Artificial Analysis gastou cerca de
$207para executar todo o seu índice no MiMo-V2.6-Pro, contra$3,117no Kimi K3.1 Pro. - Pesos que você pode baixar hoje, com licença MIT, no Hugging Face.
- Uma API de processamento em lote pela metade do preço, algo que o Kimi não oferece para o K3.1 Pro.
Onde ele fica aquém
Ele marca 46.3, nove pontos abaixo do Kimi. É igualmente lento (54.7 tokens por segundo), com um tempo até o primeiro token de 3,29 segundos. A Xiaomi vende um modo UltraSpeed com saída até 20x mais rápida, mas por 10x o preço (US$ 4,35 / US$ 8,70). E, com cerca de 1.02T de parâmetros, a hospedagem própria ainda exige um cluster com várias GPUs.
Preços
| Item | Tempo real por 1M | Em lote por 1M |
|---|---|---|
| Entrada, acerto de cache | US$ 0,0036 | US$ 0,0018 |
| Entrada, sem acerto de cache | US$ 0,435 | US$ 0,2175 |
| Saída | US$ 0,87 | US$ 0,435 |
| Entrada / saída UltraSpeed | US$ 4,35 / US$ 8,70 | Não oferecido |
Mais no meu detalhamento dos preços do MiMo V2.6.
Minha opinião
Escolha o MiMo-V2.6-Pro se você quer pesos abertos e uma API hospedada barata do mesmo fornecedor, e suas tarefas não precisam de raciocínio no nível do Kimi. Evite-o para qualquer coisa sensível à latência, a menos que você pague pelo UltraSpeed. A análise do MiMo V2.6 traz os benchmarks.
7. Kimi K3
Ideal para: continuar com a Moonshot usando pesos que já são públicos. Pesos abertos, mesma família.
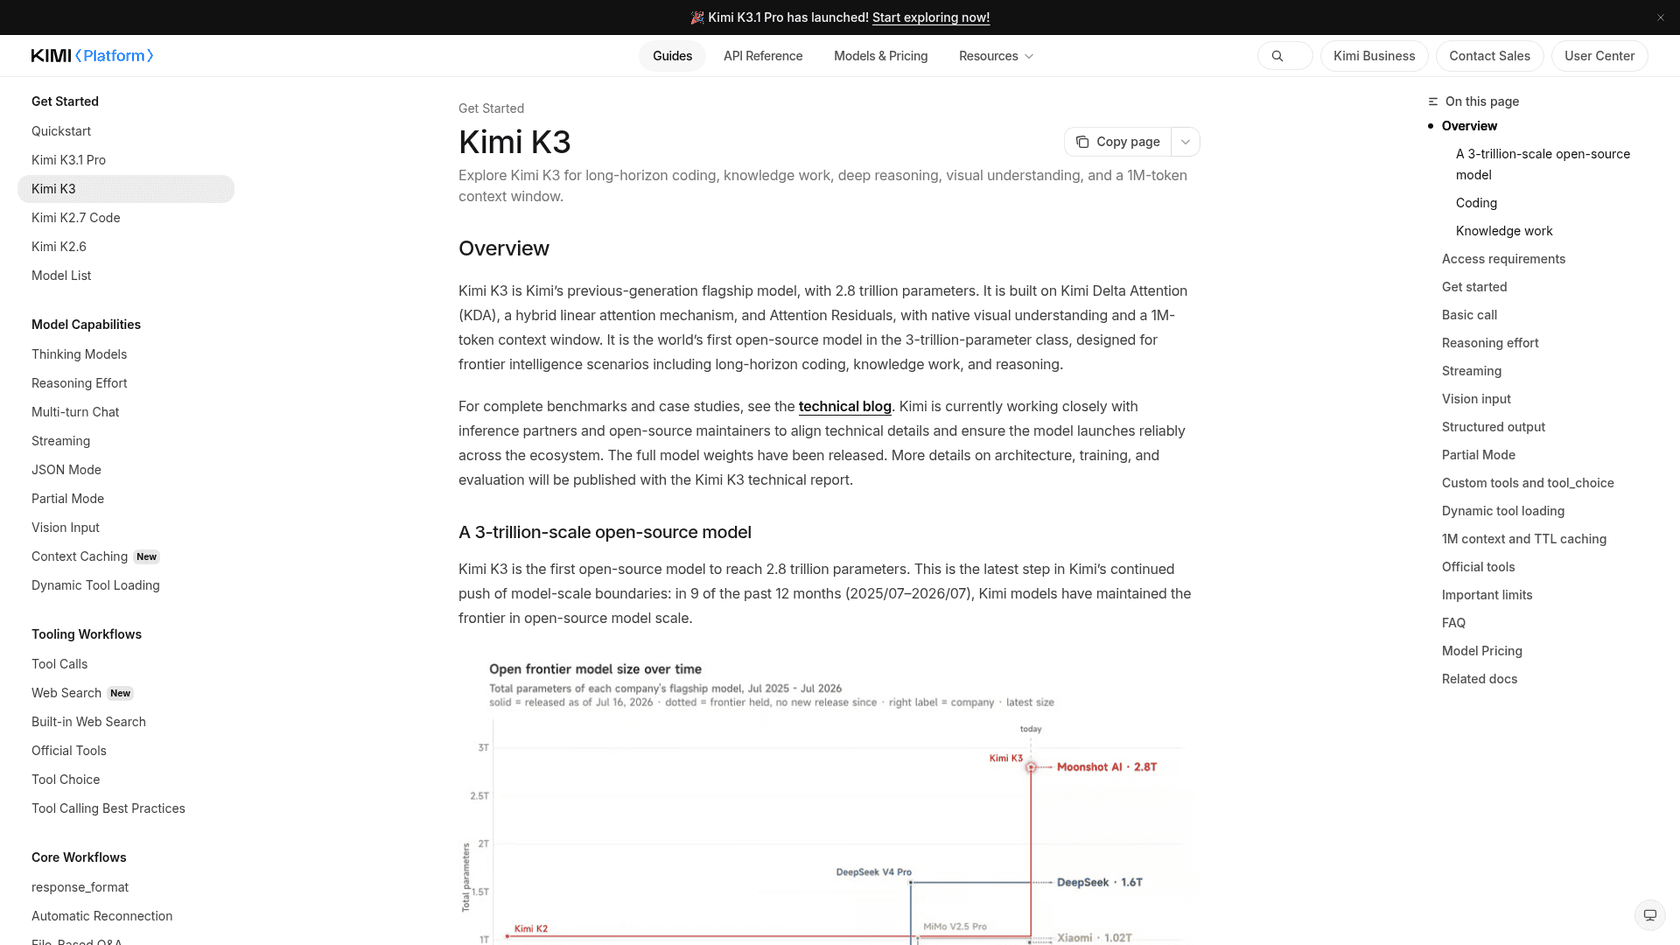
O Kimi K3 é o modelo base do K3.1 Pro. O guia de início rápido da Moonshot agora o chama de "previous-generation flagship", e seus pesos já estão no Hugging Face.
Por que escolhê-lo em vez do Kimi K3.1 Pro
- Pesos hoje, não até 4 de novembro. Cerca de 2.78T de parâmetros no repositório público.
- Mesma API, mesmas ferramentas. Se você desenvolveu usando a Kimi API, trocar o ID do modelo é toda a migração.
- Mesmo custo por tarefa.
$2.00por tarefa do Artificial Analysis, contra$2.11do K3.1 Pro.
Onde ele fica aquém
Sinceramente, não há muito motivo para escolhê-lo para novos trabalhos via API hospedada. Ele custa mais por token (US$ 3 / US$ 15), marca 43.6 contra 55.1 e conseguiu apenas 12,6% no Terminal-Bench 4.0, contra os 67,2% do K3.1 Pro. Sua licença também acrescenta condições para produtos muito grandes e empresas de hospedagem de modelos. Se você só precisa dos pesos do K3.1 Pro, esperar uma ou duas semanas provavelmente é a melhor opção.
Preços
| Item | Preço por 1M de tokens |
|---|---|
| Entrada, sem acerto de cache | US$ 3 |
| Entrada, acerto de cache | US$ 0,30 |
| Saída | US$ 15 |
| Gravação em cache de 5 minutos | US$ 3 |
| Gravação em cache de 1 hora | US$ 6 |
Da página de preços do Kimi. Meu post sobre preços do Kimi K3 traz o histórico.
Minha opinião
Escolha o K3 apenas se você precisa de pesos abertos do Kimi nesta semana. Caso contrário, fique no K3.1 Pro ou escolha uma das seis opções acima. A análise do Kimi K3 e minha comparação DeepSeek vs Kimi K3 abordam isso com mais profundidade.
Quanto custam 1.000 solicitações em cada um?
Aqui está a mesma solicitação típica, 10.000 tokens de entrada e 2.000 de saída sem cache, calculada pelo preço de tabela de cada fornecedor. É o número de onde parte a maioria das estimativas de custo.
| Modelo | Entrada / saída por 1M | Custo por solicitação | Custo por 1.000 solicitações |
|---|---|---|---|
| DeepSeek V4.1 Flash (fora do pico) | US$ 0,15 / US$ 0,60 | US$ 0,0027 | US$ 2,70 |
| DeepSeek V4.1 Flash (no pico) | US$ 0,30 / US$ 1,20 | US$ 0,0054 | US$ 5,40 |
| MiMo-V2.6-Pro | US$ 0,435 / US$ 0,87 | US$ 0,0061 | US$ 6,09 |
| Gemini 3.8 Flash (até 31 de dezembro) | US$ 0,75 / US$ 3,75 | US$ 0,015 | US$ 15 |
| Gemini 3.8 Flash (a partir de 1 de janeiro de 2027) | US$ 1,50 / US$ 7,50 | US$ 0,030 | US$ 30 |
| Kimi K3.1 Pro | US$ 2 / US$ 10 | US$ 0,040 | US$ 40 |
| Claude Sonnet 5.5 | US$ 2 / US$ 10 | US$ 0,040 | US$ 40 |
| Gemini 4 Argon (até 30 de novembro) | US$ 2 / US$ 10 | US$ 0,040 | US$ 40 |
| Kimi K3 | US$ 3 / US$ 15 | US$ 0,060 | US$ 60 |
| Claude Opus 5.5 | US$ 4 / US$ 20 | US$ 0,080 | US$ 80 |
| Gemini 4 Argon (a partir de 1 de dezembro) | US$ 4 / US$ 20 | US$ 0,080 | US$ 80 |
| Kimi K3.1 Pro Highspeed | US$ 4 / US$ 20 | US$ 0,080 | US$ 80 |
Agora o alerta. Modelos de raciocínio raramente param em 2.000 tokens de saída. No índice do Artificial Analysis, o Kimi K3.1 Pro escreveu 55.195 tokens de saída por tarefa, a maior parte deles de raciocínio. É por isso que a coluna de custo por tarefa na tabela de resumo importa mais que esta, e por isso você deve refazer essa conta com seu próprio tráfego antes de mudar.
Eu faria assim: pegue 100 solicitações reais do seu produto, passe-as por dois ou três desses modelos e avalie as respostas. Depois, divida o gasto de cada modelo pelas respostas que você realmente usaria. Esse é seu custo por tarefa bem-sucedida, e é o único número que resolve a escolha. Meu guia de preços do Kimi K3.1 Pro detalha a mesma conta só para o Kimi.
Uma equipe de suporte precisa mesmo escolher um modelo?
Se seu produto é um bot de suporte, toda esta lista está uma camada abaixo do que você precisa. Um modelo é infraestrutura. O que responde aos seus clientes é tudo o que foi construído ao redor dele: quais tickets anteriores ele lê, quais regras segue, quando transfere para uma pessoa e como você o verifica antes de colocá-lo em produção.
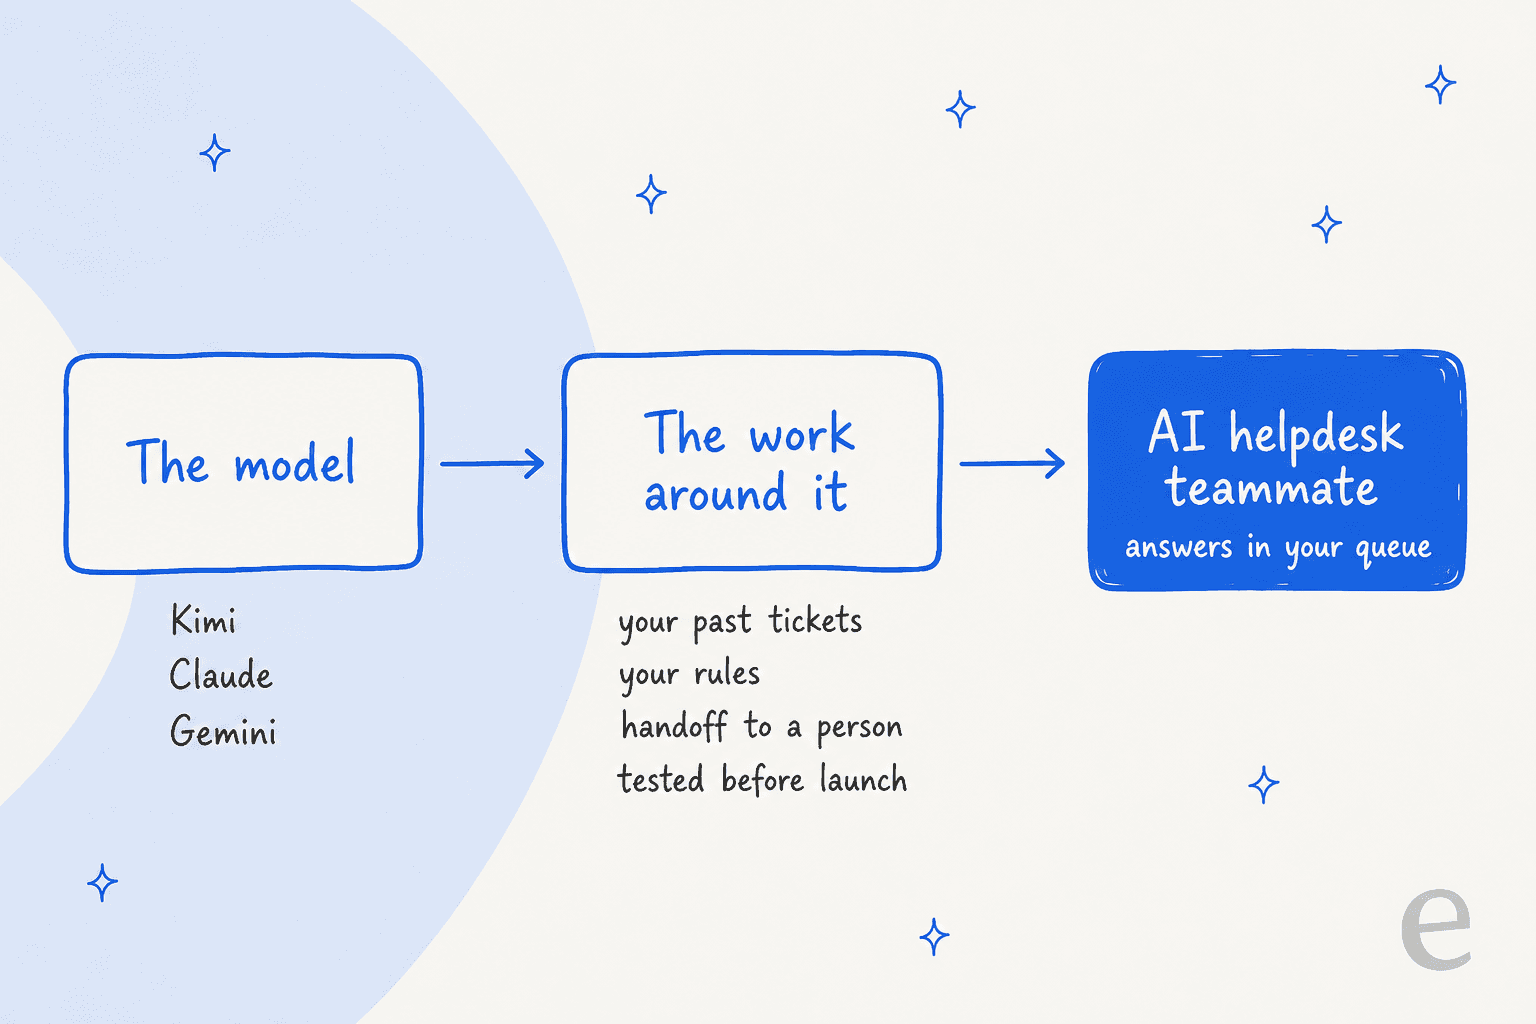
É nessa parte que passo meus dias no eesel. Já vi um modelo confiante dar respostas fluentes e erradas em uma fila real, e é por isso que toda implantação do eesel agora reprocessa primeiro centenas de tickets anteriores e avalia os rascunhos em relação ao que a equipe realmente enviou. A escolha do modelo ainda importa. Só não é a decisão que determina o sucesso ou o fracasso de um bot de suporte.
A Qontro, uma empresa de ERP da Nova Zelândia, é um bom exemplo. Ela conectou o Freshdesk ao eesel em julho de 2026 e carregou cerca de 9.800 tickets anteriores e artigos de ajuda. Entre 8 de agosto e 8 de setembro, o eesel elaborou rascunhos de respostas para cerca de 190 tickets, realizando cerca de 400 buscas na base de conhecimento ao longo do processo. Indisponibilidades, perda de dados e questões de cobrança vão direto para uma pessoa. A equipe compara cada rascunho com o que enviou e usa as diferenças para corrigir a central de ajuda. Ninguém na Qontro precisou fazer um teste comparativo de modelos para chegar lá.
Para desenvolvedores que preferem continuar no terminal, a eesel CLI controla o mesmo colega de equipe. npx @eesel/cli init chat-bubble --site https://your-site.com configura um agente com uma bolha de chat no site que lê suas páginas, e eesel chat permite testá-lo pela linha de comando. Todo comando imprime JSON, então um agente de programação como Claude Code ou Cursor pode executar a configuração para você. Meu post sobre CLIs de agentes de IA explica por que isso importa.
Experimente o eesel na sua fila de suporte
Se você estava considerando o Kimi K3.1 Pro ou um desses modelos para responder a tickets de clientes, experimente primeiro o outro caminho. O eesel é um colega de equipe de IA para helpdesk que se integra ao seu helpdesk atual, aprende com seus tickets anteriores e sua central de ajuda e é testado no seu histórico antes de responder a qualquer pessoa. Ele funciona com Freshdesk, Zendesk e outros, e o plano gratuito inclui 100 créditos, em que um ticket ou chat equivale a um crédito (veja os preços).
Experimente o eesel gratuitamente ou leia como as equipes o usam no suporte a SaaS. Para uma visão mais ampla da categoria, minha seleção dos melhores softwares de helpdesk com IA compara as principais opções.
Perguntas frequentes
Qual é a melhor alternativa ao Kimi K3.1 Pro?
Para a maioria das equipes, é o Claude Sonnet 5.5: os mesmos US$ 2 de entrada e US$ 10 de saída por milhão de tokens, cerca de três vezes a velocidade de saída no Artificial Analysis e uma pontuação no índice ligeiramente maior com esforço máximo. Se o custo por tarefa concluída importa mais do que o preço de tabela, teste o Claude Opus 5.5 com esforço High, que o Artificial Analysis mediu em US$ 1,82 por tarefa, contra US$ 2,11 do Kimi K3.1 Pro. A análise completa do Sonnet 5.5 traz os detalhes.
Existe uma alternativa mais barata ao Kimi K3.1 Pro?
Sim. O DeepSeek V4.1 Flash custa US$ 0,15 de entrada e US$ 0,60 de saída por milhão de tokens fora do horário de pico, o que equivale a cerca de US$ 2,70 por 1.000 solicitações de 10.000 tokens de entrada e 2.000 de saída, contra US$ 40 do Kimi K3.1 Pro. O Gemini 3.8 Flash custa cerca de US$ 15 pelas mesmas 1.000 solicitações até 31 de dezembro de 2026. Veja o guia de preços do DeepSeek V4.1 Flash e o detalhamento dos preços do Kimi K3.1 Pro.
Quais são as alternativas de pesos abertos ao Kimi K3.1 Pro?
O DeepSeek V4.1 Flash e o MiMo-V2.6-Pro disponibilizam pesos com licença MIT no Hugging Face, e o Kimi K3, mais antigo, tem pesos abertos sob sua própria licença. A Moonshot diz que os pesos do Kimi K3.1 Pro serão lançados até 4 de novembro de 2026, mas eles não estavam no Hugging Face quando conferi. Minha visão geral do MiMo V2.6 aborda a opção da Xiaomi.
O Claude Sonnet 5.5 é melhor que o Kimi K3.1 Pro?
Com esforço máximo, o Sonnet 5.5 marca 56,0 no Artificial Analysis Intelligence Index, contra 55,1 do Kimi K3.1 Pro, pelo mesmo preço de tabela, e gera cerca de 141 tokens por segundo, contra 50. O Kimi é mais barato por tarefa concluída com esforço máximo (US$ 2,11 contra US$ 5,46), porque o Sonnet escreve mais tokens. Meus posts com a análise do Kimi K3.1 Pro e os preços do Sonnet 5.5 aprofundam o assunto.
Como comparar as alternativas ao Kimi K3.1 Pro pelo custo?
Compare o custo por tarefa concluída com sucesso, não o preço por token. Pegue o gasto total em um lote de teste com suas próprias tarefas e divida pelo número de tarefas que cada modelo concluiu corretamente. Um modelo com preço de tabela menor ainda pode sair perdendo se escrever mais tokens ou falhar com mais frequência, por isso listo o custo por tarefa do Artificial Analysis ao lado dos preços por token. O guia de custo do atendimento ao cliente com IA mostra a mesma ideia para o suporte.
Qual alternativa ao Kimi K3.1 Pro é melhor para suporte ao cliente?
Para um bot de suporte, a velocidade e as respostas erradas importam mais do que as pontuações máximas em benchmarks. O Gemini 4 Argon teve a menor taxa de alucinação deste grupo no Artificial Analysis (15,1%), e o Claude Sonnet 5.5 é rápido. Se você não quer nem precisar criar o bot, um agente de IA para helpdesk como o eesel já usa modelos de ponta e aprende com seus tickets anteriores.
Devo esperar pelos pesos abertos do Kimi K3.1 Pro?
Só se você pretende hospedá-lo por conta própria. O modelo tem 2,8 trilhões de parâmetros no total, então executá-lo por conta própria exige um grande cluster de GPUs. Se você o acessa por uma API, os pesos mudam pouco para você; o preço da versão hospedada já é de US$ 2 de entrada e US$ 10 de saída por milhão de tokens. A visão geral do Kimi K3.1 Pro acompanha o lançamento.