

Resumo
O Kimi K3.1 Pro custa US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída na API da Kimi, com entrada em cache a US$ 0,20. A versão Highspeed custa exatamente o dobro, US$ 4 / US$ 20. Se você prefere pagar um valor fixo, ele está incluído nos planos da Kimi de $19 por mês (Plus) a $199 (Ultra), com Highspeed a partir do plano Pro de $39.
O preço de tabela diz que ele é um terço mais barato que o Kimi K3. A conta diz outra coisa: o K3.1 Pro pensa e escreve muito, então uma tarefa média de agente custa $2.11, contra $2.00 no K3, segundo a Artificial Analysis. Você paga praticamente o mesmo por um modelo muito melhor, não menos pelo mesmo modelo. Comparado ao Claude, a economia é real, com menos da metade do custo por tarefa do Sonnet 5.5 ou do Opus 5.5 no esforço máximo.
Duas pegadinhas determinam a maior parte das contas: os tokens de saída e de raciocínio representam a maior parte do custo, e os planos de assinatura têm um limite em janela móvel de 5 horas que os primeiros compradores atingiram em menos de uma hora. Se o que você realmente quer é uma IA respondendo a tickets de suporte, passei anos na eesel operando IA em filas reais de helpdesk, e a conta de tokens é a parte pequena. A SE Ranking lida com cerca de 4,650 conversas por mês em três produtos no Zendesk sem nunca escolher um modelo.
Quanto custa o Kimi K3.1 Pro na API?
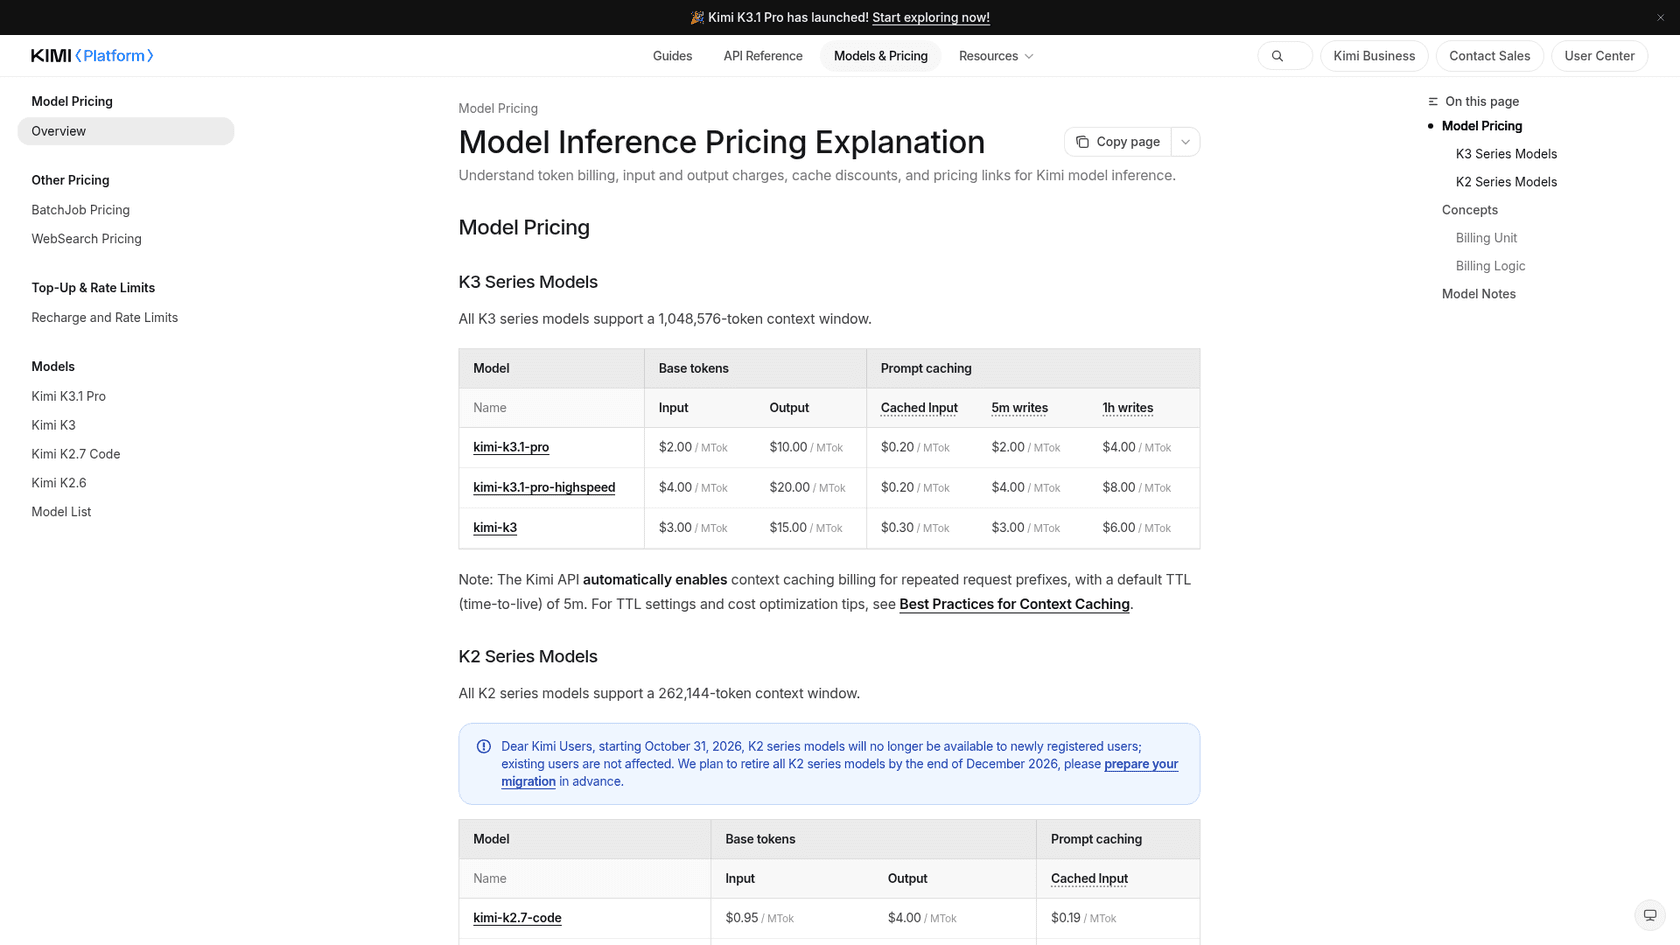
O Kimi K3.1 Pro custa US$ 2,00 de entrada, US$ 0,20 de entrada em cache e US$ 10,00 de saída por milhão de tokens na página de preços da API da Kimi. A Moonshot o lançou em 23 de outubro de 2026 sem nenhuma tarifa promocional, o que indica que esse deve ser o preço padrão, não um desconto de lançamento.
Aqui está a tabela completa de tarifas da série K3, por milhão de tokens:
| ID do modelo | Entrada (sem acerto de cache) | Entrada em cache (acerto de cache) | Saída | Gravação em cache, 5 min | Gravação em cache, 1 hora |
|---|---|---|---|---|---|
kimi-k3.1-pro | $2.00 | $0.20 | $10.00 | $2.00 | $4.00 |
kimi-k3.1-pro-highspeed | $4.00 | $0.20 | $20.00 | $4.00 | $8.00 |
kimi-k3 | $3.00 | $0.30 | $15.00 | $3.00 | $6.00 |
Alguns pontos dessa tabela merecem uma pausa:
- Sem sobretaxa por contexto longo. Os dois modelos K3.1 Pro aceitam um contexto de
1,048,576tokens, e o guia de início rápido do K3.1 Pro diz que ele "uses flat pay-as-you-go pricing", sem faixas por tamanho de contexto. Isso importa muito se você fornece bases de código inteiras a ele. - O preço por acerto de cache não dobra no Highspeed. Todo o resto dobra, mas a entrada em cache continua em
$0.20, então, se suas requisições reutilizam um prompt longo, o Highspeed acaba custando menos de 2x na prática. - O K3 continua à venda pelo preço antigo. O
kimi-k3permanece em US$ 3 / US$ 15, e a documentação agora o chama de "previous-generation flagship". Não consigo pensar em um projeto novo em que faça sentido continuar no K3, a menos que você precise dos pesos abertos dele hoje.
O que conta como token faturável?
Cada token de entrada e cada token de saída, incluindo o raciocínio. O K3.1 Pro é um modelo de raciocínio com o modo de pensamento sempre ativo, e reasoning_effort tem max como padrão, segundo o guia de chave de API da Moonshot. Esses tokens de pensamento são cobrados pela tarifa de saída de $10, mesmo que você nunca os veja na resposta.
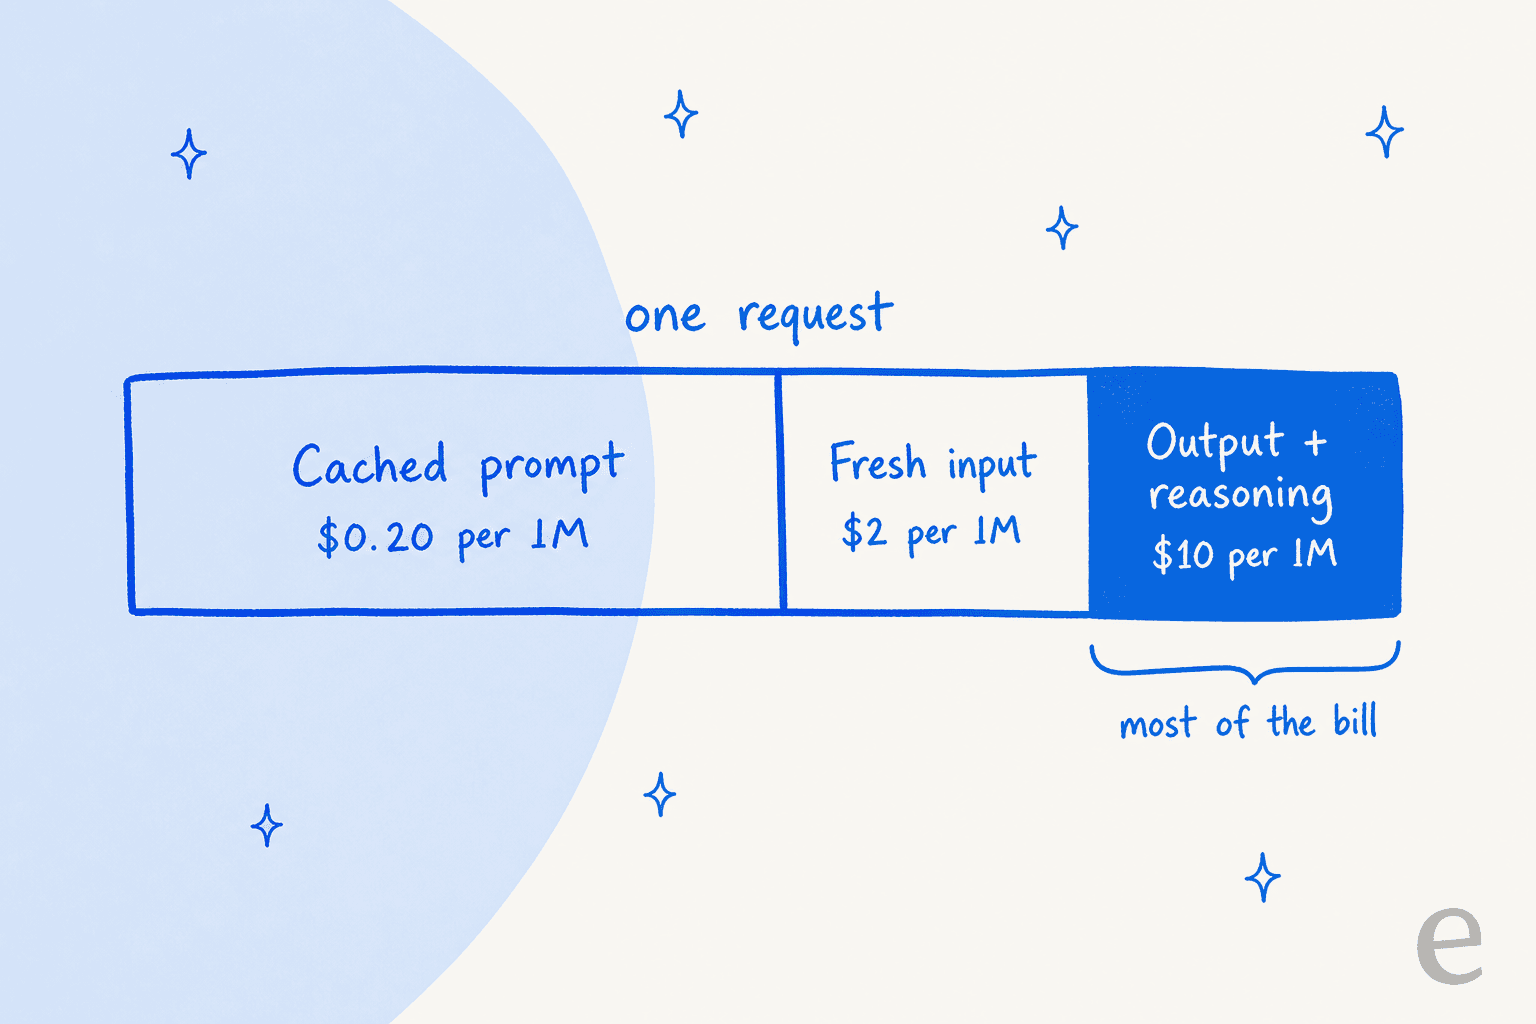
Esse é, de longe, o maior fator de influência na sua conta. Nas execuções de benchmark da Artificial Analysis, uma tarefa média produziu 55,195 tokens de saída, dos quais 34,883 eram de raciocínio (página do modelo na AA). A US$ 10 por milhão, isso dá cerca de 55 centavos de saída por tarefa, antes de contar um único token de entrada.
Como funciona o cache de prompts da Kimi?
O cache acontece automaticamente para prefixos de prompt repetidos, com um tempo de vida padrão de 5 minutos. Um acerto de cache custa $0.20, 90% menos que uma entrada nova. A gravação no cache é cobrada separadamente, dependendo de quanto tempo você o mantém: $2.00 por milhão na faixa de 5 minutos e $4.00 na de 1 hora, que você escolhe com prompt_cache_options.ttl (guia de início rápido).
Há dois detalhes que confundem as pessoas. Blocos parciais de cache são cobrados como entradas sem acerto de cache, então um prompt que muda perto do início perde a maior parte do desconto. A faixa de 1 hora também só compensa quando o tráfego é esparso demais para manter um cache de 5 minutos ativo, o que, para um agente com bastante atividade, significa que o padrão costuma ser a opção mais barata.
Os limites de uso dependem da sua recarga
O K3.1 Pro é liberado após uma recarga bem-sucedida de pelo menos $1, e o total das suas recargas define sua faixa de limites de uso (Recarga e limites de uso):
| Faixa | Total de recargas | Simultaneidade | Requisições/min | Tokens/min | Tokens/dia |
|---|---|---|---|---|---|
| Tier0 | $1 | 1 | 3 | 500,000 | 1,500,000 |
| Tier1 | $10 | 15 | 100 | 2,000,000 | Ilimitado |
| Tier2 | $20 | 40 | 100 | 3,000,000 | Ilimitado |
| Tier3 | $100 | 50 | 200 | 3,000,000 | Ilimitado |
| Tier4 | $1,000 | 60 | 200 | 4,000,000 | Ilimitado |
| Tier5 | $3,000 | 100 | 300 | 5,000,000 | Ilimitado |
A faixa de $1 serve mais para um test-drive do que para uma configuração de produção. Com 1,500,000 tokens por dia, menos de 30 tarefas médias de agente consumiriam tudo, mas, assim que você coloca $10, o teto diário desaparece. Se você já teve dificuldades com os limites de uso da OpenAI, essa progressão vai parecer familiar, só que os patamares são muito mais baixos.
Ainda sem desconto para processamento em lote
A Batch API da Kimi cobra 60% do preço padrão, mas só oferece suporte a kimi-k2.7-code e kimi-k2.6. O K3.1 Pro não está nessa lista. Esses modelos K2 deixam de aceitar novos usuários em 31 de outubro de 2026 e serão descontinuados até o fim de dezembro, o que significa que as tarefas noturnas que dependiam dos preços do Kimi K2.7 Code logo passarão a pagar as tarifas integrais do K3.1.
Quanto custa o Kimi K3.1 Pro por tarefa?
Na Artificial Analysis, uma tarefa média do Intelligence Index custa $2.11 com o K3.1 Pro, e executar o índice inteiro custou $3,117 (página do modelo na AA). Esse é o número que eu usaria como referência, porque já inclui o raciocínio longo que o preço por token esconde.
A AA classifica o K3.1 Pro como "very verbose". Ele usou cerca de 150M tokens de saída para executar o índice, contra uma mediana de 87M entre os modelos da sua faixa de preço. Então o desconto de um terço anunciado encolhe bem rápido quando o modelo começa a pensar.
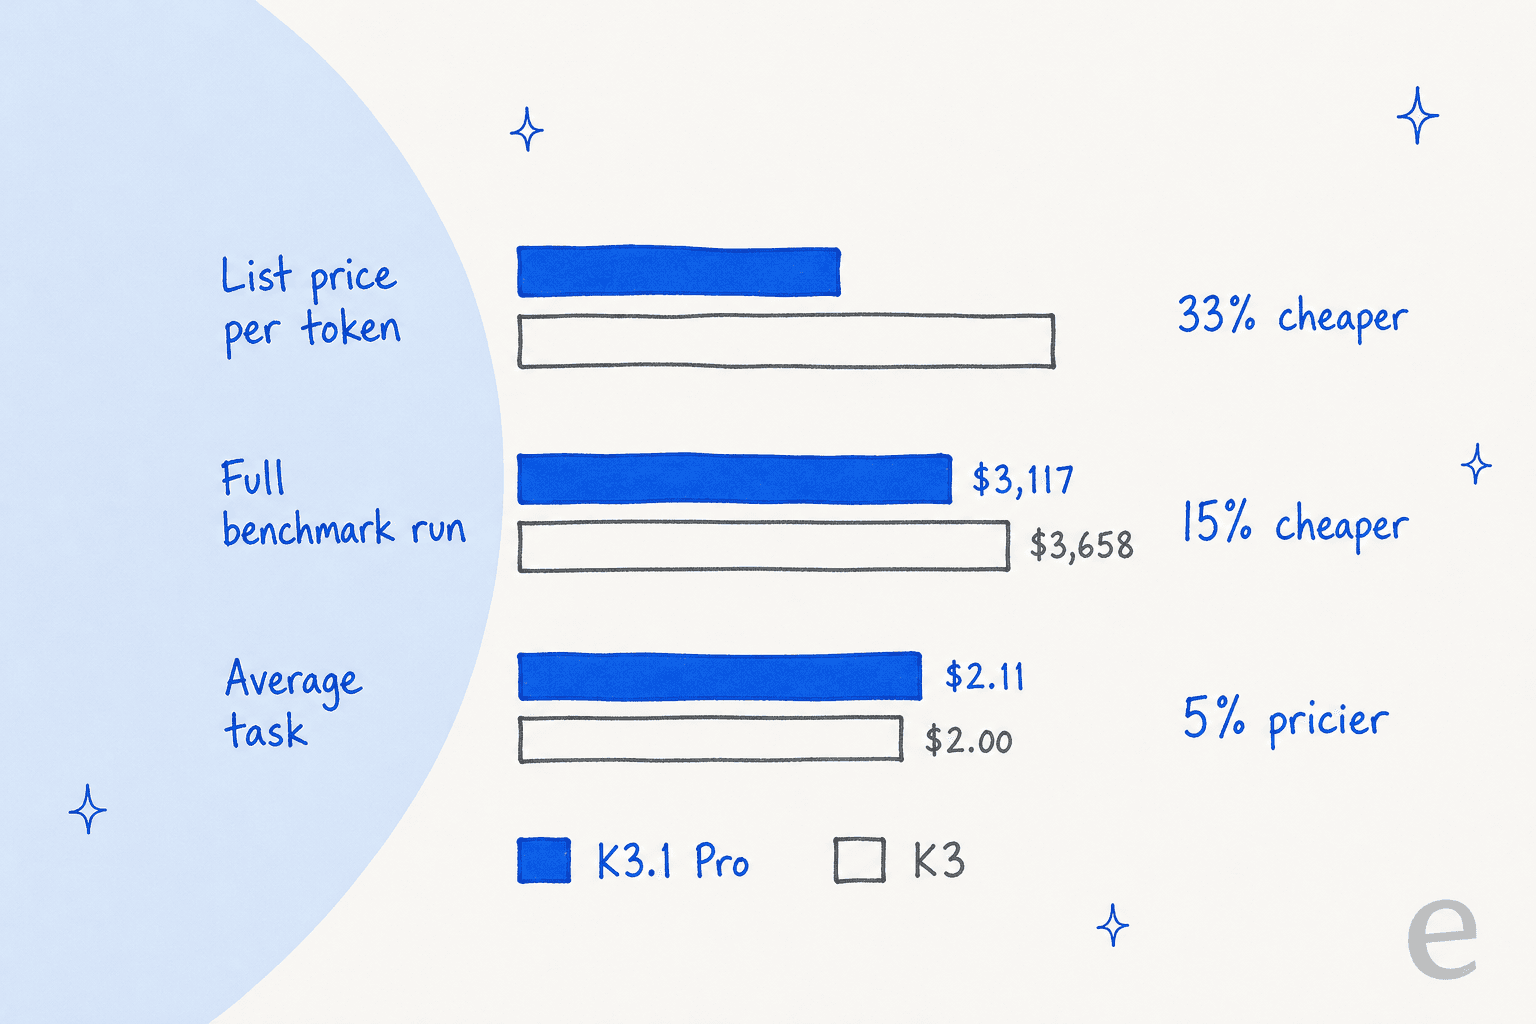
Os três números não se contradizem, apenas medem coisas diferentes. A execução completa dá mais peso às tarefas grandes, que é onde os ganhos de eficiência do K3.1 Pro aparecem. O valor por tarefa média é uma média simples, em que a escrita extra nas tarefas pequenas o coloca ligeiramente acima do K3. De qualquer forma, o resumo honesto é que você recebe um modelo 11.5 pontos mais inteligente por praticamente o mesmo dinheiro, não o mesmo modelo por um terço a menos.
Nathan Lambert, pesquisador da Ai2, já tinha apontado isso no dia do lançamento:
"K3.1 is also cheaper than K3 per token, but some benchmarks in the blog show it uses meaningfully more tokens per answer, so it may be about the same price."
Como ele se compara a outros modelos de ponta
Veja como ele fica diante dos modelos que as pessoas estão considerando como alternativas, todos da mesma página da Artificial Analysis:
| Modelo | Preço de tabela (entrada / saída) | Intelligence Index | Custo por tarefa | Custo para executar o índice | Velocidade de saída |
|---|---|---|---|---|---|
| Claude Opus 5.5 (Max) | $4 / $20 | 57.6 | $5.98 | $8,708 | 98.1 t/s |
| Claude Sonnet 5.5 (Max) | $2 / $10 | 56.0 | $5.46 | $7,260 | 141.3 t/s |
| Kimi K3.1 Pro | $2 / $10 | 55.1 | $2.11 | $3,117 | 49.7 t/s |
| Claude Fable 5.1 (Max) | $10 / $50 | 53.4 | $7.63 | $13,129 | 69.8 t/s |
| GPT-6 Astra (Max) | $10 / $50 | 52.7 | $3.26 | $5,324 | 66.7 t/s |
| Gemini 4 Argon (High) | $2 / $10 | 52.6 | $1.62 | $2,101 | 79.7 t/s |
| GPT-6.1 Sol (Max) | $2 / $10 | 51.8 | $0.72 | $1,082 | 65.9 t/s |
| DeepSeek V4.1 Flash 1017 (Max) | $0.30 / $1.20 | 45.1 | $0.26 | $445 | 169.3 t/s |
| Kimi K3 (Max) | $3 / $15 | 43.6 | $2.00 | $3,658 | 54.5 t/s |
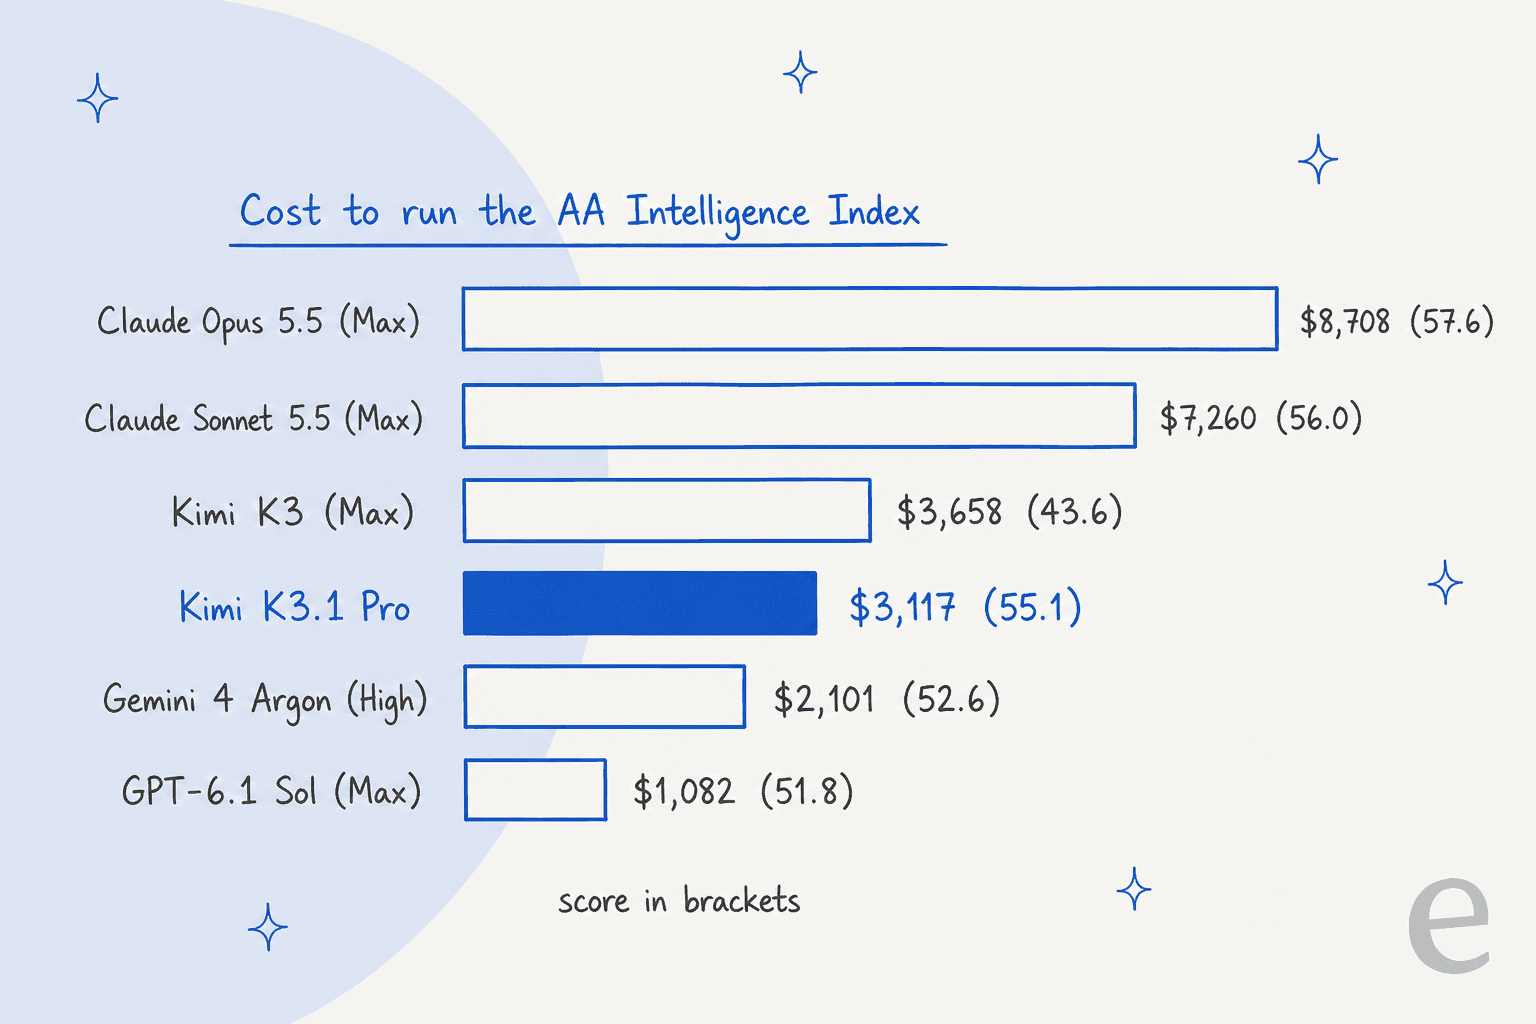
Minha leitura dessa tabela:
- Comparado ao Claude, ele é claramente a escolha com melhor custo-benefício. Tem o mesmo preço de tabela do Sonnet 5.5, mas o Sonnet no esforço máximo consumiu
416Mtokens de saída no índice, enquanto o K3.1 Pro fica a menos de um ponto dele por bem menos da metade do custo por tarefa. - Comparado aos modelos mais baratos de US$ 2 / US$ 10, ele não é a pechincha. O GPT-6.1 Sol e o Gemini 4 Argon concluem uma tarefa média por
$0.72e$1.62, ficando cerca de 3 e 2.5 pontos abaixo no índice. Se o custo por tarefa importa mais para você do que os últimos pontos, eles saem na frente. - A velocidade é o preço oculto. Com
49.7tokens por segundo, ele ocupa a posição#165entre 182 modelos. Uma tarefa média do índice levou cerca de 17 minutos, o que não aparece na fatura, mas é bem perceptível para quem está esperando.
O próprio gráfico da Moonshot apresenta o argumento contra o Claude no Terminal-Bench, onde coloca o K3.1 Pro em aproximadamente US$ 5 por tarefa, contra cerca de US$ 14 do Opus 5.5:
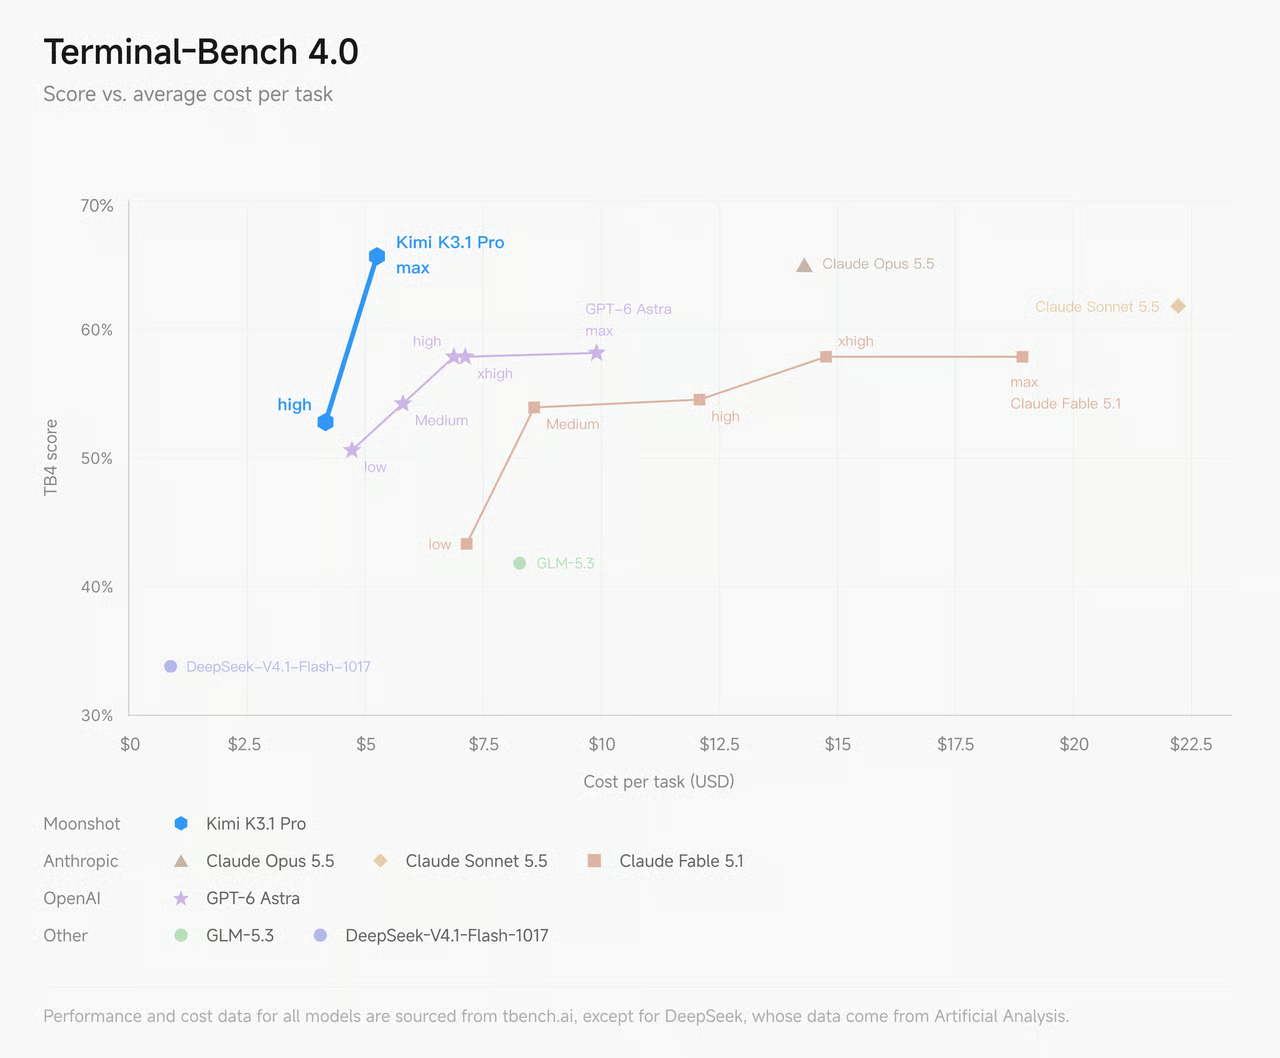
Uma pessoa que fez um teste independente viu o mesmo tipo de diferença em uma tarefa menor:
"Kimi K3.1 Pro ties Sonnet 5.5 at 93, for $0.68 and 11 min vs Sonnet's $1.61 and 14 min."

Vale a pena pagar o dobro pelo Kimi K3.1 Pro Highspeed?
Só quando há uma pessoa esperando pela resposta. O Highspeed é o mesmo modelo servido a "about 2-3× the speed" por exatamente o dobro do preço de entrada e saída (guia de chave de API). A qualidade é idêntica, então o que você está comprando é tempo, não inteligência.
Para tarefas noturnas e agentes em segundo plano, ou qualquer coisa em que ninguém esteja olhando para o cursor, o K3.1 Pro padrão é a escolha óbvia. Para chat ao vivo ou ciclos curtos de programação, os 49.7 tokens por segundo do modelo base realmente parecem lentos, e o Highspeed resolve isso. Mas nem todo mundo ficou impressionado com a atualização:
"I'll wait for the openweight... btw double the price for 67 TPS... Hardly 'nitro'."
Ainda não há uma medição independente de velocidade do Highspeed, a Artificial Analysis não o lista, então eu trataria os 2-3x da Moonshot como uma alegação até alguém fazer um benchmark.
Quanto custam os planos da Kimi que incluem o K3.1 Pro?
Os planos de assinatura da Kimi vão de $19 a $199 por mês e incluem o K3.1 Pro no aplicativo da Kimi e no Kimi Work, além do Kimi Code, o agente de programação da Moonshot. Os preços abaixo vêm da página do Kimi Code:
| Plano | Mensal | Cobrança anual (por mês) | Cobrança anual (total) | Acesso ao K3.1 Pro |
|---|---|---|---|---|
| Plus | $19 | $15 | $180 | Padrão |
| Pro | $39 | $31 | $372 | Padrão e Highspeed |
| Max | $99 | $79 | $948 | Padrão e Highspeed |
| Ultra | $199 | $159 | $1,908 | Padrão e Highspeed |
O Highspeed em um plano usa "2× credit usage". A Kimi também renomeou seus planos recentemente, "with pricing unchanged", segundo a página de benefícios do Kimi Code, e os assinantes atuais podem manter os nomes antigos (Moderato, Allegretto e assim por diante). Os novos planos eliminaram o limite semanal do Kimi Code, mas mantiveram a janela móvel de 5 horas, além de um saldo mensal de créditos compartilhado entre Kimi e Kimi Code.
Na China, a mesma progressão tem preços em yuans, de um plano Go de ¥49 (sem Kimi Code) até ¥1.399 por mês no Ultra, segundo a página de ajuda sobre preços de assinatura da Kimi.
O que acontece quando você atinge o limite?
Você pode comprar Extra Usage, uma recarga com pagamento conforme o uso compartilhada entre Kimi e Kimi Code, com um mínimo de ¥25 por recarga. A Kimi diz que o preço é "close to the official API pricing", então, na prática, é a API com uma forma de pagamento diferente.
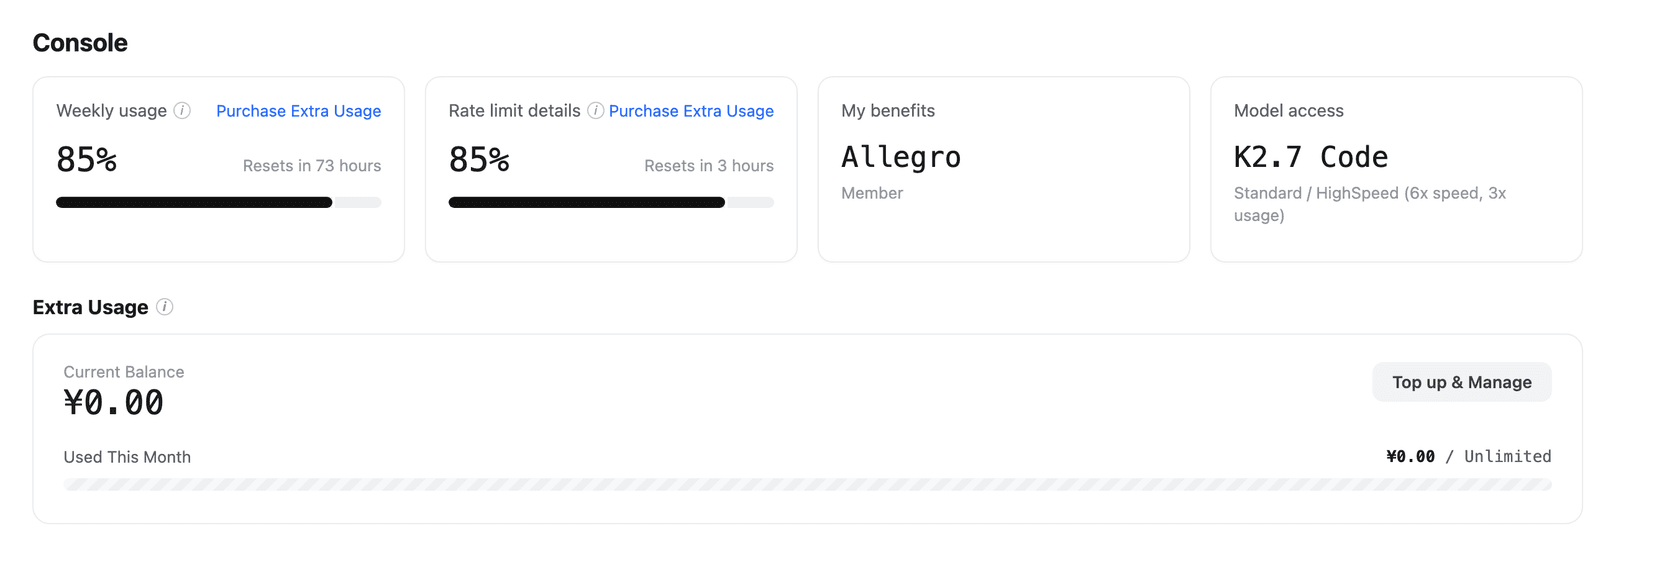
Isso importa porque o limite de 5 horas é, até agora, a reclamação mais forte sobre o K3.1 Pro. Na discussão de lançamento com 674 comentários no Hacker News, a cota apareceu mais vezes do que a qualidade do modelo:
"If you are expecting any sort of usable limits on their subscription plan I suggest adjusting your expectations. I subscribed to $99 a month plan and within 47 minutes with one session (not asking for swarms or anything) was limited by 5-hour quota."
Para ser justo com a Moonshot, o esforço padrão max explica boa parte disso, e outro usuário na mesma discussão relatou trabalhar por 8 horas usando 22% da sua cota semanal ao combinar o K3.1 Pro com um modelo mais leve para subagentes. Os planos funcionam, só não rendem tanto quanto alguns planos concorrentes de programação desde o primeiro dia.
Você deve usar a API ou um plano da Kimi?
Escolha com base em quem está chamando o modelo. Se é seu aplicativo ou agente, use a API: você paga por token e, depois de uma recarga de $10, não há teto diário. Se é você quem faz as chamadas, pelo Kimi Code ou pelo aplicativo da Kimi, um plano quase sempre sai mais barato, desde que você consiga conviver com a janela de 5 horas.
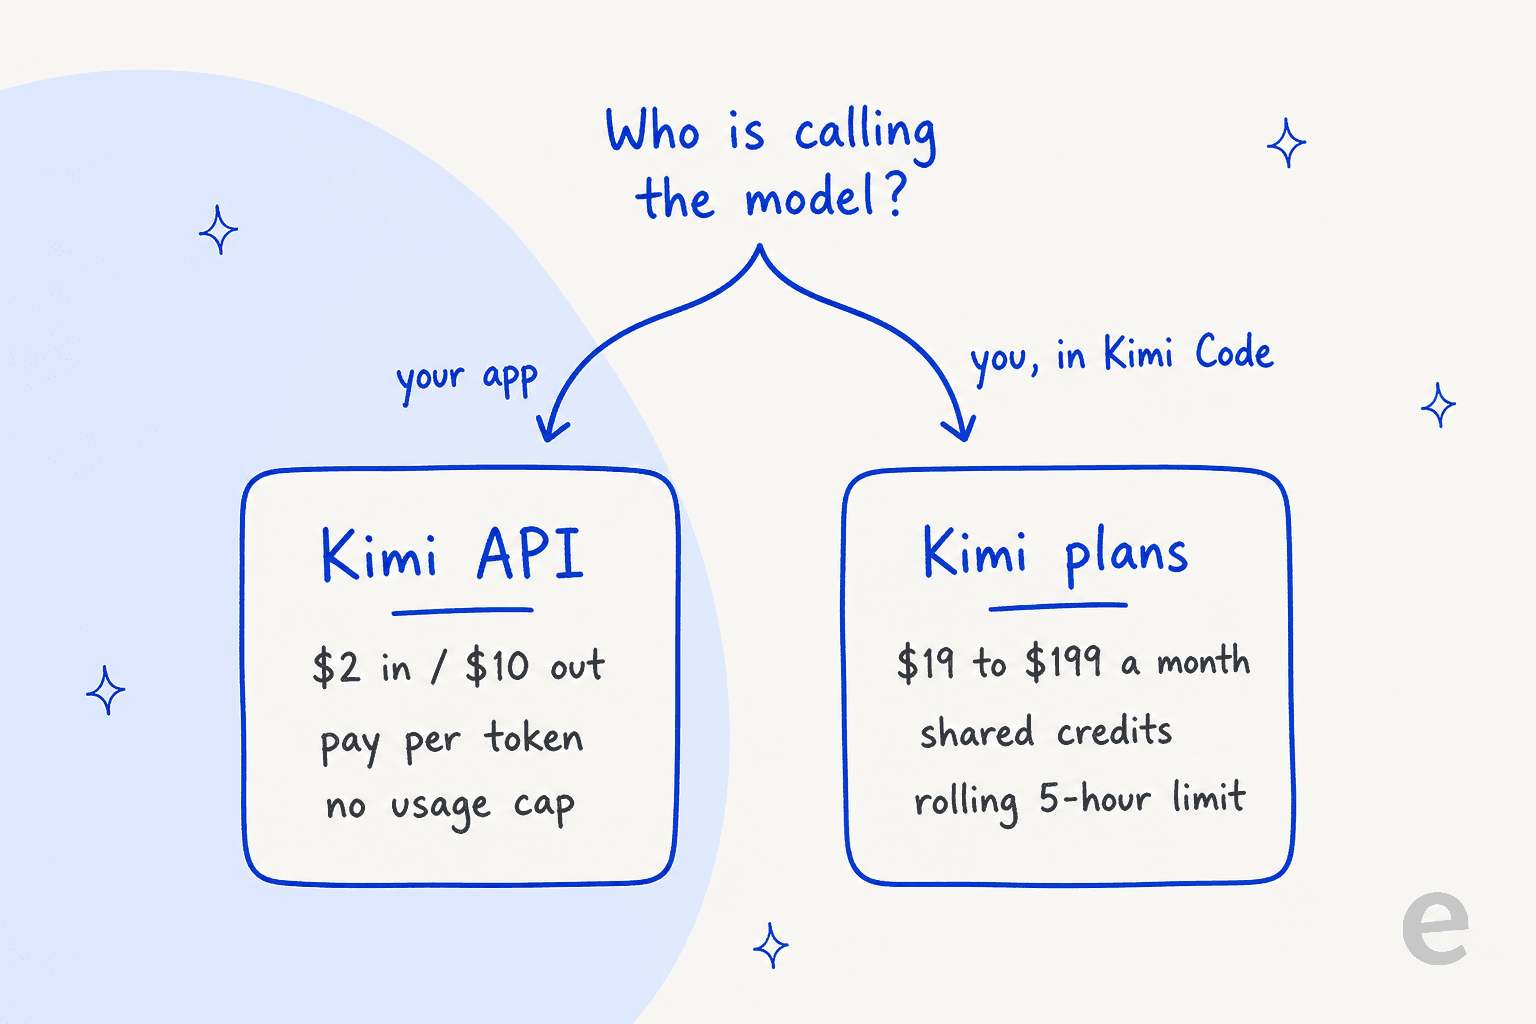
A conta mostra o motivo. Uma pessoa desenvolvedora executando 20 tarefas de agente por dia útil, na média da Artificial Analysis de $2.11 por tarefa, gastaria cerca de $928 por mês na API (20 × 22 × $2.11). O plano Max de $99 é uma pechincha em comparação, e é exatamente por isso que a Moonshot raciona seu uso com o limite em janela móvel. Se você está comparando planos de programação, minha análise dos preços do Claude Code e a lista de assistentes de programação com IA cobrem o outro lado.
Quanto o Kimi K3.1 Pro custaria para minha carga de trabalho?
Insira seus próprios números. A calculadora abaixo usa as tarifas oficiais da API da Kimi e pressupõe que sua parcela em cache permaneça ativa (sem cobranças de gravação em cache), então é melhor tratar o resultado como um piso.
Para dar uma ideia de cenários reais, veja quanto custam três cargas de trabalho comuns no K3.1 Pro padrão, usando as tarifas oficiais:
| Carga de trabalho | Por requisição | Volume mensal | K3.1 Pro | Highspeed | Kimi K3 |
|---|---|---|---|---|---|
| Respostas de suporte | 6.000 em cache + 2.000 de entrada nova, 1.500 de saída | 10,000 | $202 | $392 | $303 |
| Perguntas e respostas sobre documentos longos | 200.000 de entrada nova, 3.000 de saída | 500 | $215 | $430 | $323 |
| Programação com agentes | Tarefa média da AA ($2.11) | 440 | ~$928 | n/d | ~$880 |
O padrão se mantém nos três casos: o cache de entrada se resolve sozinho em prompts repetidos, e a saída é onde você deve procurar economia. Reduzir reasoning_effort do padrão max para high ou low seria o primeiro ajuste que eu faria. No K3, a AA mediu a configuração de baixo esforço em $1.15 por tarefa, contra $2.00 no máximo, com uma grande perda de pontuação, então teste nas suas próprias tarefas antes de adotá-la. Se você acompanha gastos em vários modelos, uma ferramenta de monitoramento de LLMs ajuda a detectar um agente fora de controle antes que a fatura faça isso.
O Kimi K3.1 Pro vale o preço?
Para programação com agentes e trabalhos longos com várias etapas, sim. É um dos modelos com maior pontuação que você pode comprar e custa bem menos da metade do Claude por tarefa no esforço máximo. Os pesos também estão prometidos "by Nov 4", o que deve trazer mais provedores de hospedagem. Só para dar uma noção de escala, o Kimi K3 é servido por 20 provedores na Artificial Analysis, contra 5 do K3.1 Pro hoje.
Ele é um negócio menos vantajoso em três casos:
- Você quer o trabalho concluído pelo menor preço. O GPT-6.1 Sol e o Gemini 4 Argon fazem a tarefa média por menos. Em custo puro, o DeepSeek V4.1 Flash está em outro patamar, a
$0.26por tarefa. - Uma pessoa espera por cada resposta. A 50 tokens por segundo, você vai acabar no Highspeed, e aí a vantagem de preço em relação ao Sonnet 5.5 diminui.
- Você pretende depender de um plano da Kimi no dia a dia. A janela de 5 horas é apertada no esforço máximo. Reserve um orçamento para Extra Usage ou espere algumas semanas para ver se a Moonshot flexibiliza o limite.
Se você está comparando com o mercado mais amplo, minha lista de alternativas ao Kimi K3 e a análise dos preços do Qwen 3.8 Max continuam válidas.
Pelo lado dos modelos abertos, comparei Qwen 3.8 Max e K3 diretamente, e a análise completa do modelo está no meu post sobre o Kimi K3.1 Pro.
O que o preço de um modelo não diz a uma equipe de suporte
Muitas das pessoas pesquisando preços de modelos como este estão, na verdade, perguntando se vale a pena construir um agente de suporte sobre ele. Como alguém que trabalha nas integrações da eesel, eu diria que o valor por token é a parte fácil. Usando o exemplo de suporte acima, $202 por mês compram tokens, não um agente. Você ainda teria que conectar seu helpdesk, sincronizar sua central de ajuda e os tickets anteriores, escrever as regras de transferência e testar tudo antes que um cliente veja uma resposta. Essa construção é onde vai a maior parte do tempo e do risco, e é por isso que toda implantação da eesel é simulada primeiro com os tickets históricos da própria equipe.
A eesel elimina toda essa construção. Você contrata um colega de equipe de IA para helpdesk pronto para trabalhar, que entra na sua fila existente no Zendesk, Freshdesk ou Gorgias e aprende com sua documentação e seus tickets anteriores, depois segue regras de transferência que você escreve em inglês simples. Os preços são baseados em planos fixos de créditos, em vez de cobrança por token, então a conta não oscila quando um modelo decide pensar mais. Se você quer ver como os custos se comparam no geral, meu guia de custo por resolução faz as contas, e o post sobre o melhor modelo de IA para suporte compara os modelos por trás deles.

A SE Ranking é um bom retrato de como isso funciona em produção. Ela opera três produtos (SE Ranking, Planable e SE Visible) com uma única equipe no Zendesk, com um agente eesel por produto. Cada agente pesquisa cerca de 16,800 páginas de conteúdo da central de ajuda e do site, responde ao chat ao vivo no idioma do cliente e encaminha reembolsos, extensões de período de teste e dúvidas de nível 2 para uma pessoa, com os detalhes anexados. Entre 8 de agosto e 8 de setembro de 2026, ela lidou com cerca de 4,650 conversas, e nada disso dependeu de qual modelo liderava um ranking naquela semana.
Se você gosta do estilo da Kimi que prioriza o terminal, a eesel CLI leva a mesma proposta para o suporte. Você pode revisar o trabalho recente do colega de equipe com eesel activity e aprovar ou negar ações pendentes com eesel approvals, além de editar suas regras permanentes com eesel instructions. A saída é em JSON e os comandos de escrita oferecem suporte a --dry-run, então scripts e agentes de programação como o Claude Code podem operá-la com segurança.
Também há um servidor MCP, e eu abordo o padrão mais amplo no meu guia sobre a CLI para agentes de IA.
Experimente a eesel
Se você está pesquisando o preço do Kimi K3.1 Pro para operar seu suporte, experimente a versão em que outra pessoa já fez a construção. A eesel coloca um colega de equipe de IA pronto para trabalhar no seu helpdesk em minutos e o treina com seus tickets anteriores, além de permitir que você teste com a fila da semana passada antes que ele responda a alguém. Experimente a eesel grátis ou compare as opções primeiro na minha lista dos melhores colegas de equipe de IA.
Perguntas frequentes
Quanto custa o Kimi K3.1 Pro?
Na API da Kimi, o Kimi K3.1 Pro custa US$ 2 por milhão de tokens de entrada, US$ 0,20 por milhão de tokens de entrada em cache e US$ 10 por milhão de tokens de saída. Não há cobrança adicional por contexto longo em toda a janela de 1M de tokens. Minha visão geral do Kimi K3.1 Pro aborda o modelo em si.
Quanto custa o Kimi K3.1 Pro Highspeed?
O Kimi K3.1 Pro Highspeed custa US$ 4 de entrada e US$ 20 de saída por milhão de tokens, exatamente o dobro do modelo padrão, para cerca de 2 a 3 vezes a velocidade. A entrada em cache continua em US$ 0,20. Nos planos da Kimi para consumidores, o Highspeed exige o plano Pro ou superior e consome créditos duas vezes mais rápido.
O Kimi K3.1 Pro é mais barato que o Kimi K3?
Por token, sim: o K3.1 Pro custa US$ 2/US$ 10, contra US$ 3/US$ 15 nos preços do Kimi K3, um terço a menos. Por tarefa, o custo é quase igual, porque o K3.1 Pro escreve mais. A Artificial Analysis calcula US$ 2,11 por tarefa média, contra US$ 2,00 para o K3, com uma pontuação 11.5 pontos maior.
De qual plano Kimi preciso para usar o Kimi K3.1 Pro?
O modelo padrão Kimi K3.1 Pro está disponível no plano Plus (US$ 19/mês) e superiores, e o Highspeed exige o Pro (US$ 39/mês) ou superior. O Kimi Code compartilha a mesma cota com o restante da assinatura. Compare com os preços do Claude Code se você estiver escolhendo um plano para programação.
O Kimi K3.1 Pro tem uma modalidade gratuita ou desconto para processamento em lote?
Não. A API é liberada após uma recarga mínima de US$ 1, e o desconto de 60% da Batch API só se aplica aos modelos K2 mais antigos por enquanto. Se você precisa de uma forma de experimentar sem custo, minha seleção de APIs de IA gratuitas lista as opções atuais.
O Kimi K3.1 Pro é mais barato que o Claude?
No preço de tabela, ele se iguala aos preços do Claude Sonnet 5.5, de US$ 2/US$ 10, e custa metade dos preços do Claude Opus 5.5. Por tarefa, ele é muito mais barato que ambos com esforço máximo: US$ 2,11 contra US$ 5,46 para o Sonnet 5.5 e US$ 5,98 para o Opus 5.5 na Artificial Analysis.
Quanto custa o Kimi K3.1 Pro para um bot de atendimento ao cliente?
Para 10.000 respostas por mês, cada uma com um prompt de 6.000 tokens em cache, 2.000 novos tokens de entrada e 1.500 tokens de saída, os preços do Kimi K3.1 Pro resultam em cerca de US$ 202 por mês em tokens. A conexão com o helpdesk, os testes e as regras de transferência são custos adicionais. Um colega de equipe de atendimento ao cliente com IA pronto para usar, como o eesel, inclui essa camada.