Resumo
O Claude Sonnet 5.5 custa US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, o mesmo que o Sonnet 5 e exatamente metade do Claude Opus 5.5 em entrada, saída, gravações de cache e Batch. Não há sobretaxa de contexto longo em toda a janela de 1M, e ele está incluído no plano gratuito do Claude.
O porém é a única linha que não custa metade. As leituras de cache custam US$ 0,20 por milhão tanto no Sonnet 5.5 quanto no Opus 5.5. Nos testes da Artificial Analysis, as leituras de cache foram 40% da fatura do Sonnet 5.5 em esforço máximo, e nessa configuração ele custou US$ 7,60 por tarefa contra US$ 5,98 do Opus 5.5. Em esforço Low e Medium, o Sonnet 5.5 é a opção barata e rápida que promete ser. Acima de High, o Opus 5.5 em Medium normalmente entrega a mesma pontuação por menos dinheiro.
Na eesel, eu escrevo o código de integração que envia essas chamadas de API, então leio tabelas de preço pela linha que acaba na fatura. Se você está calculando o custo do Sonnet 5.5 para uma fila de suporte, a eesel roda modelos como ele dentro de um colega de helpdesk com IA que cobra por ticket atendido, então o controle de esforço nunca aparece na sua fatura.
Preços do Claude Sonnet 5.5 em resumo
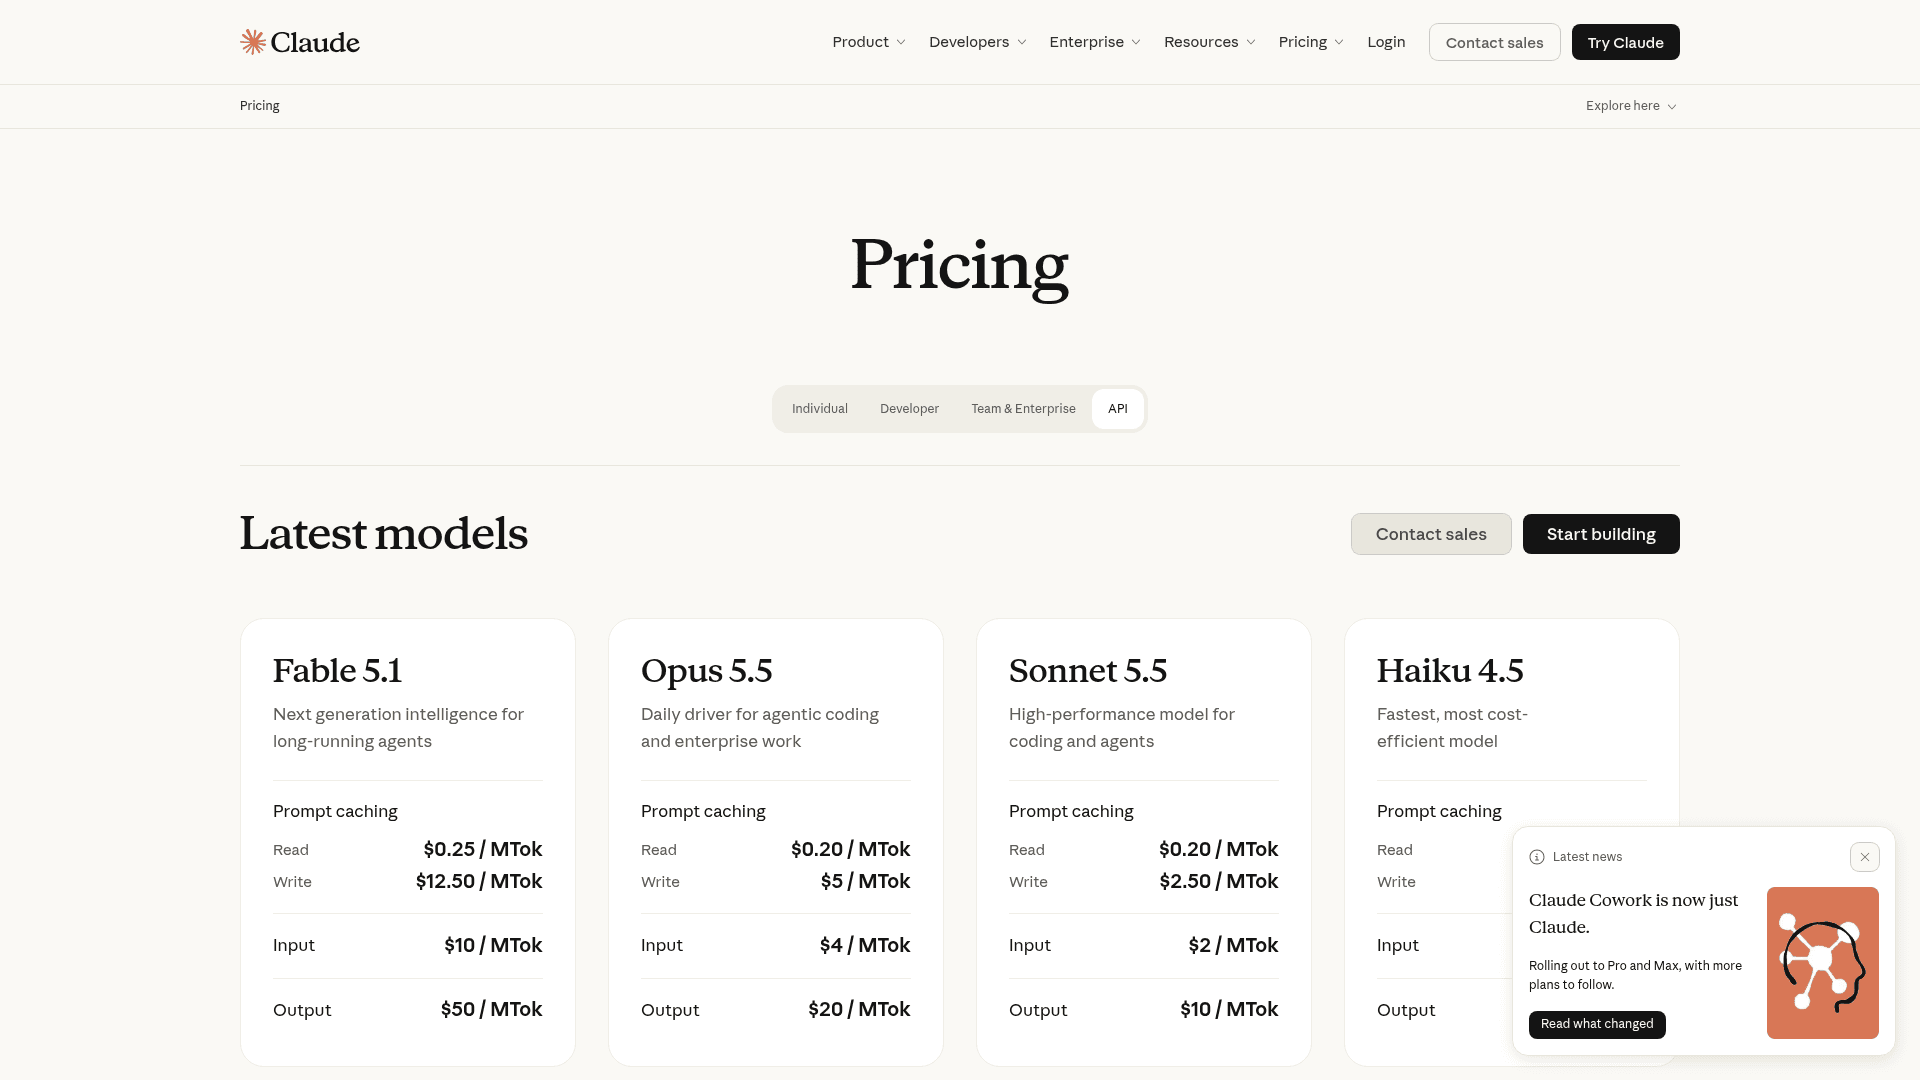
O Claude Sonnet 5.5 foi lançado em 28 de setembro de 2026, e a Anthropic manteve o preço. Esta é a tabela completa da API da documentação de preços do Claude, por milhão de tokens, ao lado dos dois irmãos mais próximos:
| Preço por 1M de tokens | Claude Sonnet 5.5 | Claude Opus 5.5 | Claude Haiku 4.5 |
|---|---|---|---|
| Entrada | $2 | $4 | $1 |
| Saída (raciocínio incluído) | $10 | $20 | $5 |
| Gravação de cache de 5 minutos | $2.50 | $5 | $1.25 |
| Gravação de cache de 1 hora | $4 | $8 | $2 |
| Leitura de cache | $0.20 | $0.20 | $0.10 |
| Batch entrada / saída | $1 / $5 | $2 / $10 | $0.50 / $2.50 |
| Fast mode | Não oferecido | $8 / $40 | Não oferecido |
| Janela de contexto | 1M | 1M | 200K |
| Saída máxima | 128K (300K na beta do Batch) | 128K (300K no Batch) | 64K |
| Sobretaxa de contexto longo | Nenhuma | Nenhuma | n/d |
Alguns detalhes dessa tabela importam mais do que parecem à primeira vista:
- O raciocínio é cobrado como saída. O Sonnet 5.5 usa raciocínio adaptativo, então cada token de raciocínio custa US$ 10 por milhão, igual à resposta.
- O esforço padrão da API é
high, segundo a visão geral do modelo. Os apps do Claude e o Claude Code usam Medium por padrão. Essa única configuração muda sua fatura mais do que qualquer outra coisa nesta página. - O prompt mínimo que pode ir para o cache tem 512 tokens, então até um prompt de sistema curto de suporte pode ser cacheado.
- O tokenizador é o mesmo do Sonnet 5, então o mesmo texto gera a mesma contagem de tokens. Qualquer economia vem de o modelo escrever menos, não de uma contagem mais amigável.
Se você vem da geração anterior, nada no preço de tabela mudou em relação aos preços do Sonnet 5, e ele continua abaixo dos US$ 3 e US$ 15 do Claude Sonnet 4.6. O que a Anthropic defende é que a fatura ainda cai, porque o modelo termina o mesmo trabalho com menos tokens.
Metade do preço do Opus em todas as linhas menos uma
Esta é a parte que a maioria dos resumos de preços pula. O Sonnet 5.5 custa exatamente metade do Claude Opus 5.5 em entrada, saída, gravações de cache e Batch. Em leituras de cache, não é mais barato de jeito nenhum.
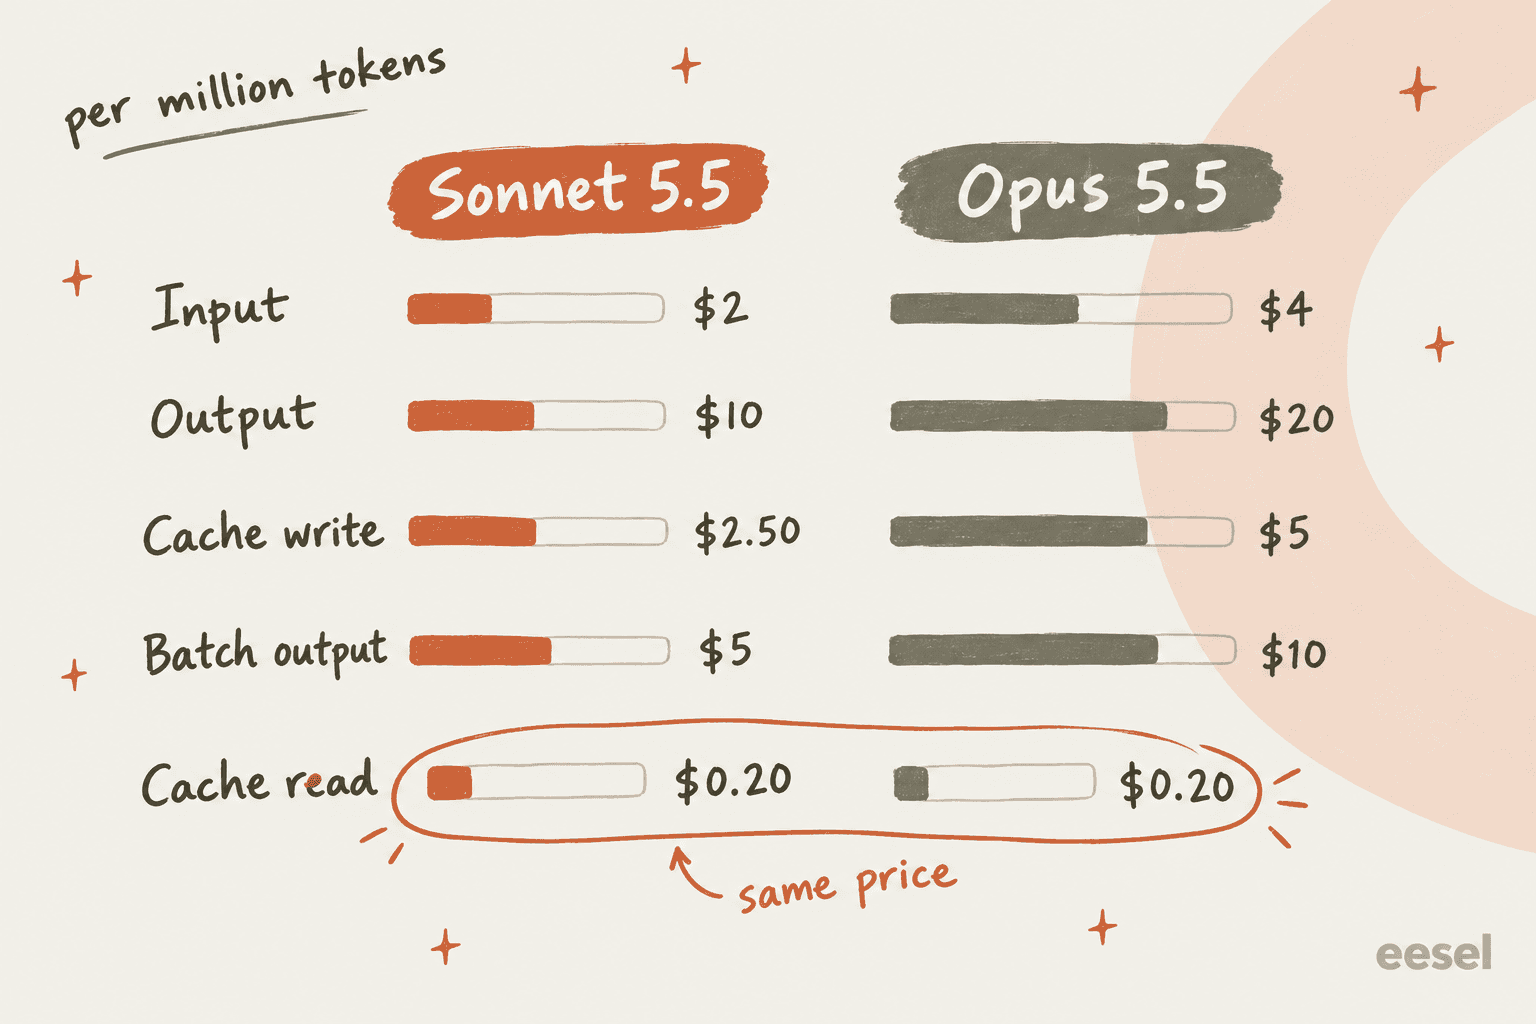
Isso aconteceu porque o Opus 5.5 ganhou um cache excepcionalmente barato. O multiplicador de leitura de cache dele é 0,05x da entrada, enquanto o Sonnet usa o padrão de 0,1x, segundo a tabela de prompt caching. A entrada do Opus custa US$ 4, então 0,05x dá US$ 0,20. A entrada do Sonnet custa US$ 2, então 0,1x também dá US$ 0,20. O mesmo número por dois caminhos.
Para um chatbot que envia um prompt e recebe uma resposta, isso quase não importa, mas para um agente importa bastante. Cada volta de um loop de agente reenvia a conversa inteira até ali, e com o cache ligado, a maior parte desse reenvio é cobrada como leitura de cache. Quanto mais longa a sessão, maior fica essa linha, e ela é a única linha em que escolher o modelo menor não economiza nada.
A comunidade percebeu no dia do lançamento:
"Cache read is the same as Opus as well where most agentic workflow cost comes from. Not quite sure where this fits well."

Quanto custa de verdade uma execução real
Uma tabela de preços diz o preço de um token. Ela não diz quantos tokens um modelo gasta para terminar um trabalho, e é aí que o Sonnet 5.5 fica interessante. A Artificial Analysis rodou seu Intelligence Index em todos os níveis de esforço e publicou o custo medido por tarefa.
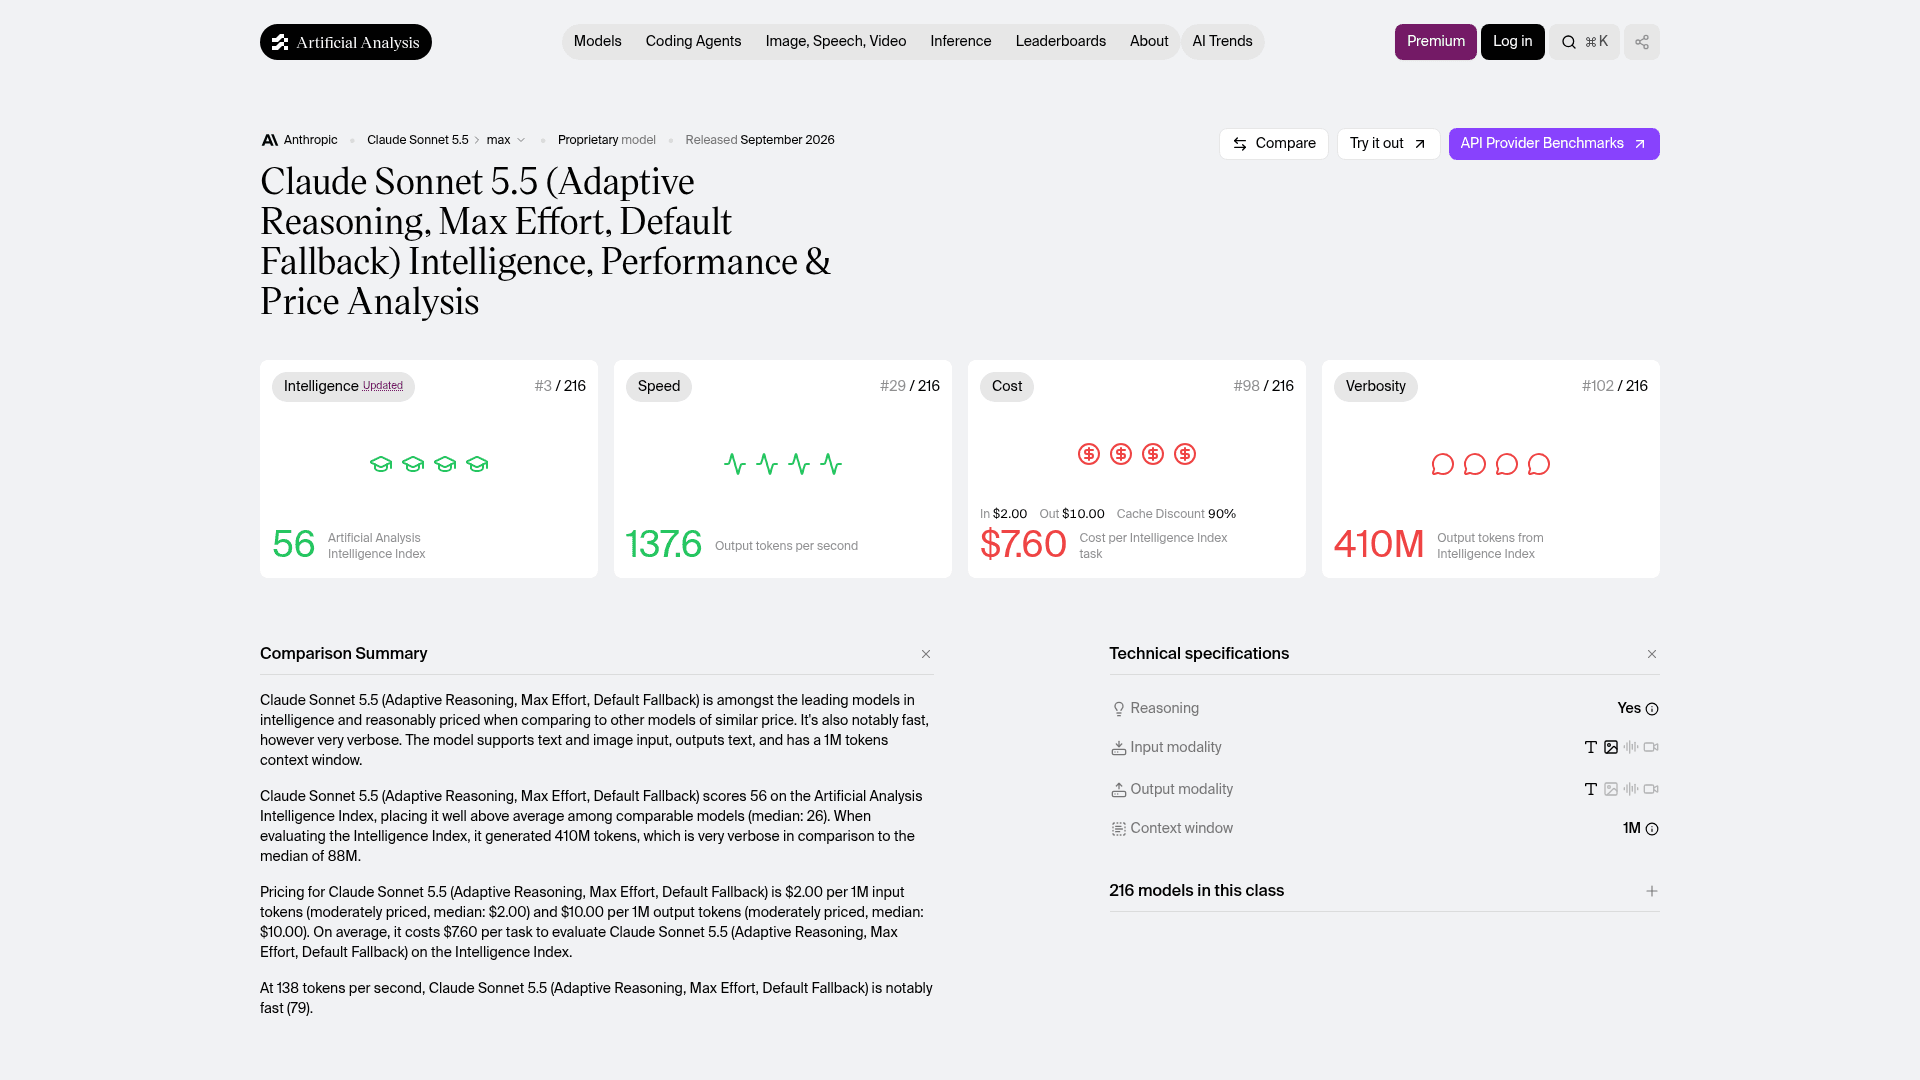
A página é direta sobre o custo. Em esforço máximo, o Sonnet 5.5 gerou 410M de tokens de saída ao longo do índice contra uma mediana da classe de 88M, e o próprio resumo da AA o chama de "very verbose". Aqui está a escada completa da página do Sonnet 5.5 da AA, ao lado das linhas correspondentes da página do Opus 5.5:
| Esforço | Pontuação Sonnet 5.5 | Custo por tarefa Sonnet 5.5 | Tokens de saída por tarefa | Pontuação Opus 5.5 | Custo por tarefa Opus 5.5 |
|---|---|---|---|---|---|
| Low | 36 | $0.41 | 13.9k | 42 | $0.55 |
| Medium | 41 | $0.59 | 19.5k | 51 | $1.34 |
| High | 47 | $1.08 | 34.5k | 54 | $1.82 |
| Xhigh | 52 | $2.74 | 73.7k | 56 | $3.46 |
| Max | 56 | $7.60 | 192.8k | 58 | $5.98 |
Lendo a coluna do Sonnet de cima para baixo, o custo mais ou menos dobra a cada passo acima de Medium e quase triplica de Xhigh para Max. Lendo na horizontal, o padrão se inverte por volta de High. O Sonnet 5.5 em esforço máximo custa 27% mais por tarefa que o Opus 5.5 no máximo, com dois pontos a menos de pontuação. Ele usou 193k tokens de saída por tarefa ali, contra 119k do Opus.
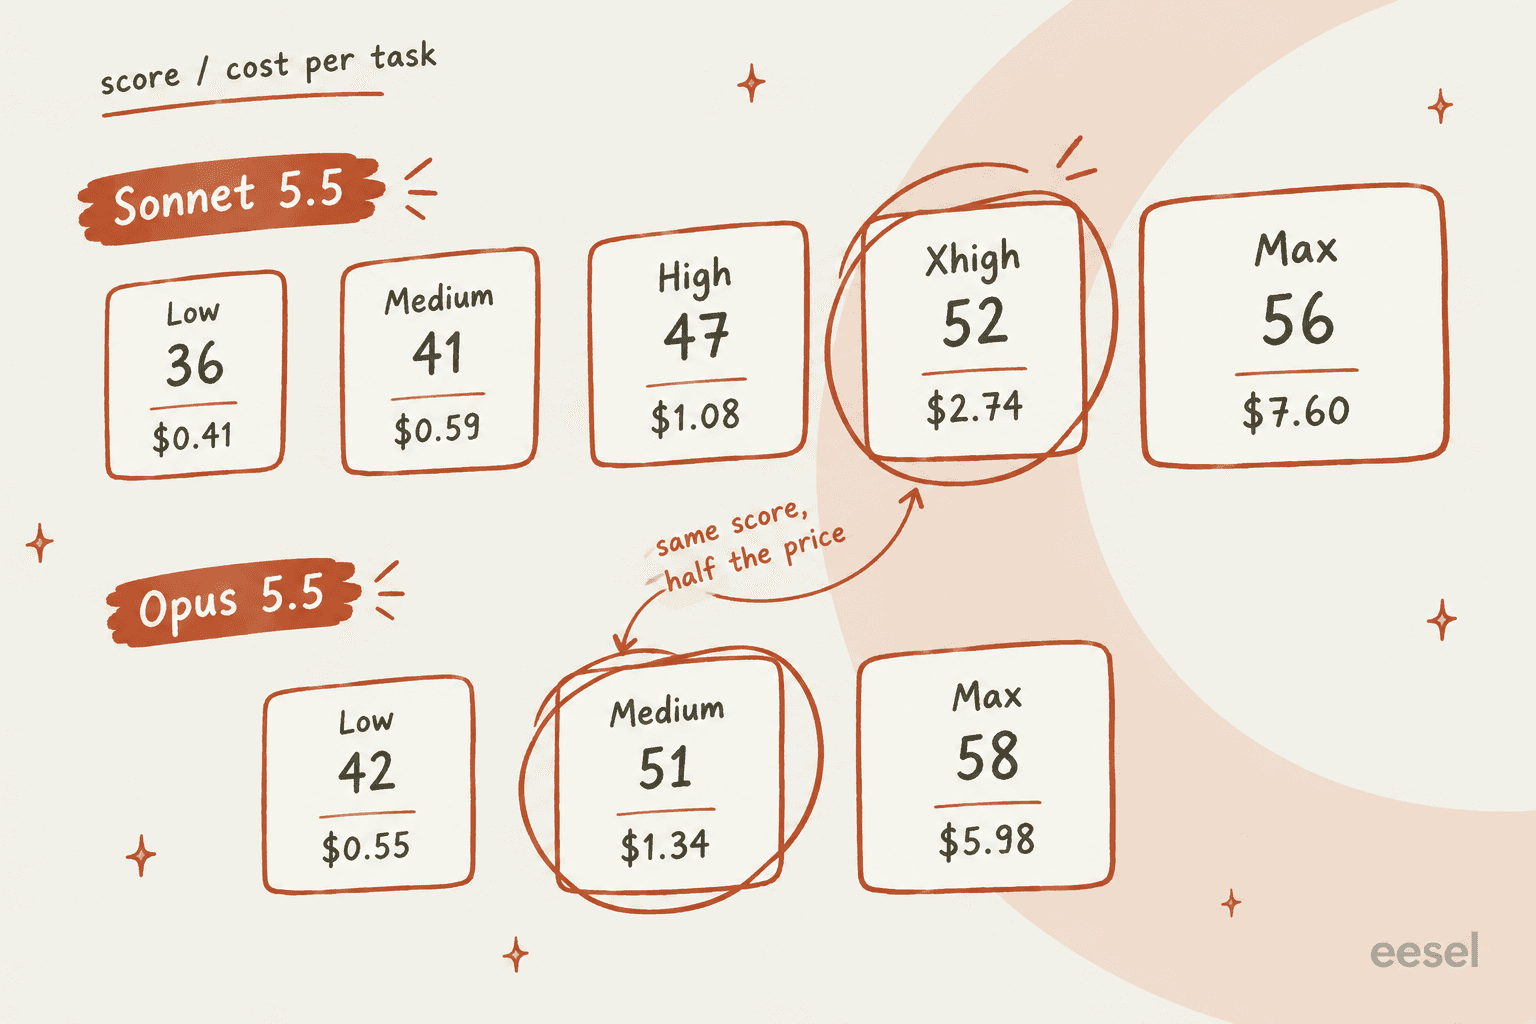
O par que eu ficaria olhando é Sonnet Xhigh contra Opus Medium. Eles pontuam 52 e 51, e o Opus custa US$ 1,34 contra US$ 2,74 do Sonnet. Se você se pegar aumentando o Sonnet 5.5 acima de High para conseguir a qualidade de que precisa, acaba pagando mais do que pagaria pelo modelo maior na configuração padrão.
Essa também é a leitura honesta da afirmação da própria Anthropic de "até 30% menos por tarefa". O post de lançamento diz que o Sonnet 5.5 "complements Opus 5.5 best when running at lower effort settings, where it costs less per task. At higher settings, it can perform comparably at a similar cost." Os números da AA confirmam isso exatamente.
Para onde vai o dinheiro na fatura de um agente
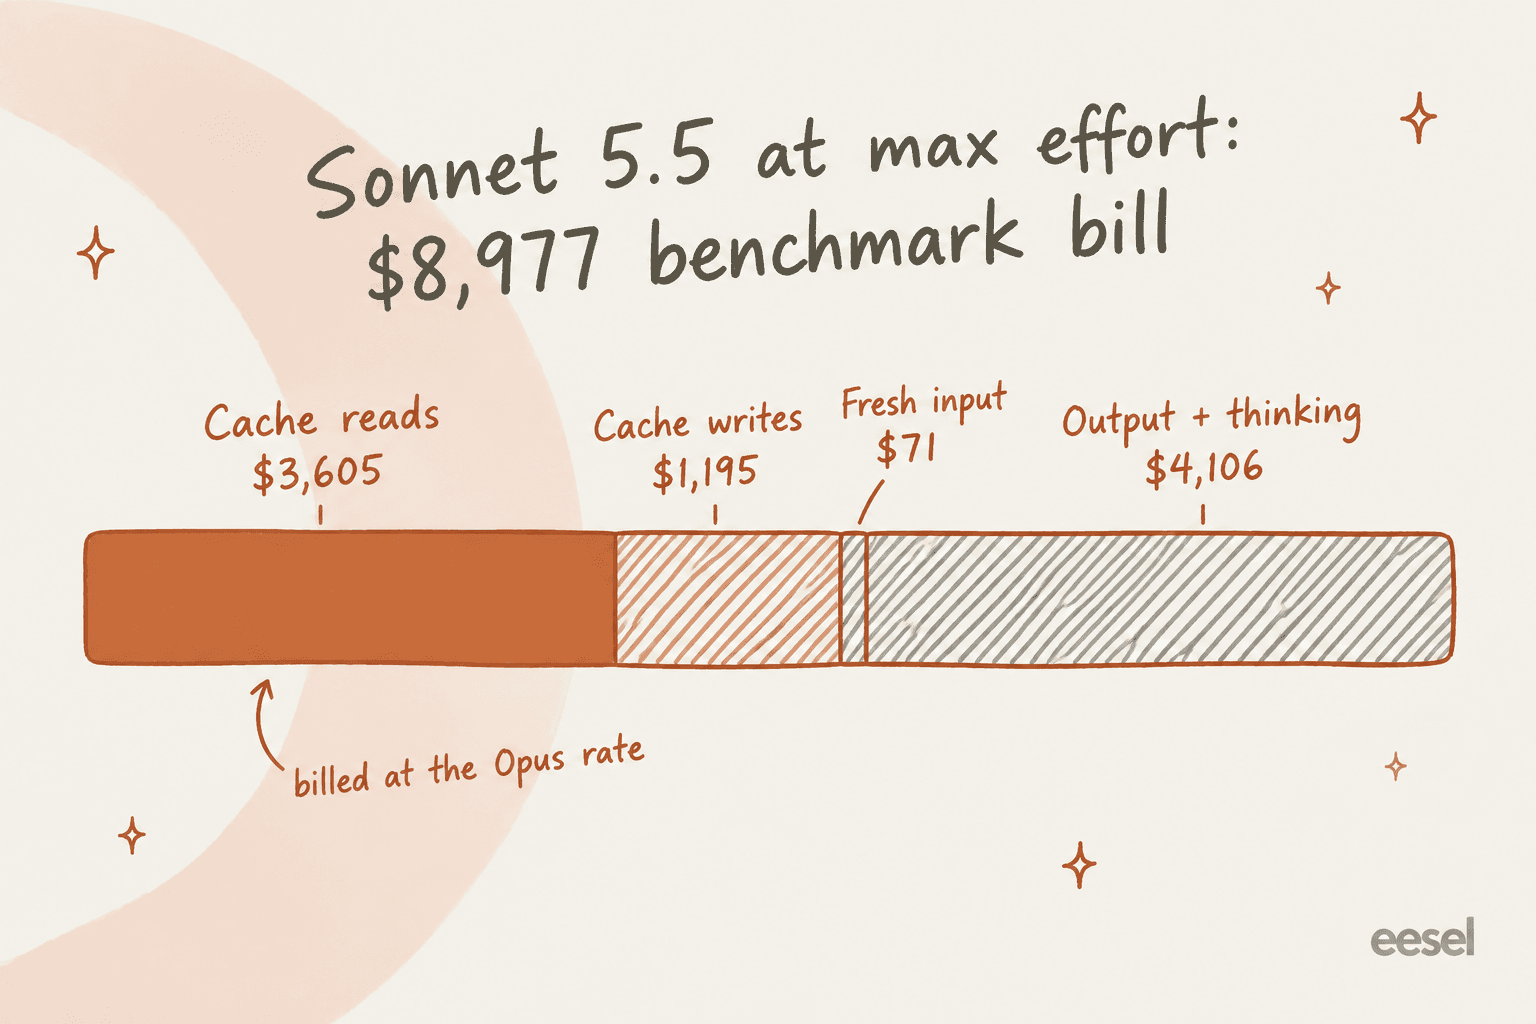
A AA também divide o custo de cada execução por tipo de token, e é aqui que a linha de leitura de cache de antes deixa de ser teórica. Na execução completa do Intelligence Index em esforço máximo, a fatura do Sonnet 5.5 chegou a US$ 8.977:
| Item | Sonnet 5.5 em Max | Parcela | Sonnet 5.5 em Medium | Parcela |
|---|---|---|---|---|
| Leituras de cache | $3,605 | 40% | $180 | 26% |
| Gravações de cache | $1,195 | 13% | $155 | 22% |
| Entrada nova | $71 | 1% | $70 | 10% |
| Saída e raciocínio | $4,106 | 46% | $295 | 42% |
| Total | $8,977 | $701 |
Duas coisas saltam aos olhos. A entrada nova, a linha em que a maioria pensa ao ouvir "tokens de entrada", é quase nada, porque quase todo token de entrada em uma execução de agente é uma leitura ou uma gravação de cache. E as leituras de cache, a linha sem desconto no Sonnet, crescem de um quarto da fatura em Medium para 40% em Max, porque raciocinar por mais tempo significa mais voltas e mais releituras.
Colocando os dois modelos lado a lado na mesma execução, a diferença diminui, que é a mesma história que a comparação mais antiga de Opus 5 vs Sonnet 5 contava. Em Medium, a execução do índice com Sonnet 5.5 custou US$ 701 contra US$ 1.627 do Opus 5.5, então o Sonnet foi 43% da fatura do Opus. No Max, o Sonnet custou US$ 8.977 contra US$ 8.708 do Opus. Metade do preço de tabela, 3% a mais na fatura.
Exemplos práticos em três perfis de carga
Benchmarks são a carga de trabalho de outra pessoa, então aqui vai a conta pela tabela de preços para três perfis comuns, usando apenas os preços publicados. Trate as contagens de tokens como ilustrativas e coloque as suas na calculadora abaixo.
1. Um bot de respostas de suporte. Cada resposta envia 8.000 tokens de entrada, 6.000 deles um prompt de sistema e artigos de ajuda em cache, e recebe 1.500 tokens de volta, incluindo raciocínio.
- Sonnet 5.5: US$ 0,004 de entrada nova + US$ 0,0012 de leituras de cache + US$ 0,015 de saída = cerca de 2 centavos por resposta, ou US$ 202 por 10.000 tickets
- Opus 5.5: US$ 0,008 + US$ 0,0012 + US$ 0,03 = cerca de 3,9 centavos, ou US$ 392 por 10.000
- Haiku 4.5: US$ 0,002 + US$ 0,0006 + US$ 0,0075 = cerca de 1 centavo, ou US$ 101 por 10.000
A saída domina aqui, então o preço pela metade do Sonnet na saída se reflete quase por inteiro. Este é o perfil em que o Sonnet 5.5 é claramente a melhor compra em relação ao Opus. Para um panorama maior do que o suporte com IA custa além do modelo, veja o guia de custo do atendimento ao cliente com IA.
2. Uma sessão longa de agente. Imagine um agente de programação ou operações que roda 30 voltas, relê um contexto de 60.000 tokens do cache em cada volta, adiciona 3.000 tokens novos e escreve 2.000 por volta.
- Sonnet 5.5: US$ 0,36 de leituras de cache + US$ 0,18 de entrada nova + US$ 0,60 de saída = US$ 1,14
- Opus 5.5: US$ 0,36 + US$ 0,36 + US$ 1,20 = US$ 1,92
Agora suponha que o Sonnet precise de 40 voltas onde o Opus precisa de 25, que é a direção para a qual as contagens de tokens da AA apontam em esforço maior. O Sonnet passa a US$ 0,48 + US$ 0,24 + US$ 0,80 = US$ 1,52, e o Opus passa a US$ 0,30 + US$ 0,30 + US$ 1,00 = US$ 1,60. O modelo de "metade do preço" fica a 8 centavos do caro.
3. Um job Batch noturno. Você extrai campos de 10.000 documentos com 20.000 tokens de entrada e 1.000 de saída cada, e nada precisa de resposta em tempo real.
- Sonnet 5.5 no Batch: US$ 200 de entrada + US$ 50 de saída = US$ 250
- Opus 5.5 no Batch: US$ 400 + US$ 100 = US$ 500
- Haiku 4.5 no Batch: US$ 100 + US$ 25 = US$ 125
Não há releituras de cache nem loop de agente, então a proporção de 2x se mantém bem limpa. O Batch também se combina com o prompt caching, segundo a documentação de preços.
Estime a sua própria fatura mensal
Defina a contagem de tokens por tarefa da sua carga de trabalho e veja quanto cada modelo custa por mês. As gravações de cache ficam de fora por simplicidade, já que com o cache aquecido elas são uma parcela pequena de uma carga estável.
Se o preset de agente te surpreender, é a linha de leitura de cache trabalhando. Com 1,8M de tokens em cache por sessão, Sonnet e Opus pagam os mesmos US$ 0,36 pelas releituras, e só a linha de saída mantém os dois separados.
Esforço é o controle de preço, e o padrão da API é high
A Anthropic deixa você definir o esforço por requisição, e ele é a maior alavanca sobre uma fatura do Sonnet 5.5. Simon Willison rodou o mesmo prompt de SVG em todos os níveis e postou os custos na thread do lançamento:
| Esforço | Custo de um prompt | Tempo |
|---|---|---|
| Low | 1,6 centavo | 10s |
| Medium | 1,8 centavo | 11s |
| High | 2,3 centavos | 17s |
| Xhigh | 5,7 centavos | 41s |
| Max | $1.28 | 15m 40s, e falhou |
No Max, o modelo, nas palavras dele, "burned through 128,000 thinking tokens (taking 15 minutes to do that) and ran out before it had produced the final SVG". Isso é um salto de custo de 80 vezes de Low para Max por um resultado pior.
Meu conselho prático, como alguém que coloca essas chamadas em código de produção:
- Defina o esforço explicitamente em toda requisição. O padrão da API é
high, não o Medium que você vê nos apps, então uma integração ingênua começa um degrau acima da zona barata. - Comece em Low para trabalho de rotina como classificação, etiquetagem e respostas curtas, e só suba onde suas avaliações mostrarem uma diferença real.
- Trate Xhigh e Max como um sinal para trocar de modelo. Depois de High, o Opus 5.5 em Medium tende a superar o Sonnet em pontuação e preço.
- Refaça seus testes de esforço se estiver migrando do Sonnet 5. A Anthropic recalibrou os níveis na página de novidades, então as configurações antigas não se aplicam.
A vantagem é grande na parte de baixo do controle. A AA mediu o Sonnet 5.5 em Medium com pontuação 41 por US$ 0,59 por tarefa, contra o Claude Sonnet 5 no Max com pontuação 38 por US$ 5,09. É um resultado melhor por cerca de um nono do custo, que é a história de upgrade que a Anthropic vende, e ela se sustenta.
Descontos, adicionais e os itens menores
Além do esforço, quatro modificadores mudam o preço por token, todos da documentação de preços do Claude:
| Modificador | Efeito no Sonnet 5.5 | Observações |
|---|---|---|
| Prompt caching | Leituras a $0.20 (0,1x), gravações a $2.50 (5 min) ou $4 (1 hora) | Compensa após uma leitura no cache de 5 minutos |
| API Batch | 50% de desconto: $1 de entrada, $5 de saída | Combina com caching; 300K de saída com header beta |
| Inferência apenas nos EUA | 1,1x em toda categoria de token | Definida com inference_geo: "us" |
| Fast mode | Não disponível | Apenas Opus 5.5, a $8 / $40 |
As tarifas de ferramentas se somam aos tokens. A busca na web custa US$ 10 por 1.000 buscas, o web fetch não tem custo extra, e a execução de código é gratuita quando usada junto com busca ou fetch na web; do contrário, há 1.550 horas de contêiner gratuitas por mês e depois US$ 0,05 por hora. O Sonnet 5.5 adiciona 286 tokens de prompt de sistema sempre que há ferramentas. As sessões do Claude Managed Agents acrescentam US$ 0,08 por hora de sessão em execução além das tarifas padrão de tokens.
Um custo fácil de deixar passar: o uso forçado de ferramentas (tool_choice definido como any ou uma ferramenta específica) agora retorna 400 no Sonnet 5.5, segundo as notas de migração. Não é um preço, mas se o seu bot de suporte dependia disso, o retrabalho é um custo real da troca. O post principal percorre as cinco mudanças incompatíveis.
Claude Free, Pro, Max, Team e Enterprise
Se você usa o Sonnet 5.5 nos apps do Claude em vez da API, paga por assento, não por token. Da página de preços do Claude:
| Plano | Preço | Acesso ao Sonnet 5.5 | Observações |
|---|---|---|---|
| Free | $0 | Sim | A Anthropic diz "anyone can chat with Claude using Sonnet 5.5" |
| Pro | $17/mês com cobrança anual, $20 mensal | Sim | Adiciona Opus e créditos de uso |
| Max 5x / 20x | A partir de $100/mês | Sim | 5x ou 20x o uso do Pro, acesso prioritário |
| Team padrão | $20/assento/mês anual, $25 mensal | Sim | Para 2 a 150 pessoas |
| Team premium | $100/assento/mês anual, $125 mensal | Sim | 5x o uso do assento padrão |
| Enterprise | $20/assento/mês mais uso às tarifas da API | Sim | O uso é cobrado pelas tarifas de token acima |
Duas coisas mudam a conta aqui. No Free e no Pro, o Sonnet é o modelo que a maioria das pessoas realmente vai usar, e os usuários gratuitos agora têm o Sonnet 5.5. No Enterprise, a taxa por assento é só o começo, porque o uso é cobrado pelas mesmas tarifas de API deste post inteiro. O guia de preços do Claude e o detalhamento do Claude Pro cobrem os limites de uso, e o guia de preços do Claude Code cobre o lado do desenvolvedor, onde o esforço Medium é o padrão.
Um desenvolvedor no dia do lançamento resumiu bem a divisão entre assinatura e API:
"Sonnet 5.5 might not be useful or necessary in a Claude Code session but it could be good value in the API when you pay per token."
Bedrock, Google Cloud e Foundry
O Sonnet 5.5 chegou a todas as grandes nuvens no primeiro dia, como anthropic.claude-sonnet-5-5 no Amazon Bedrock e claude-sonnet-5-5 no Google Cloud e no Microsoft Foundry, segundo a visão geral do modelo. Como você é cobrado depende da porta que usar:
- Amazon Bedrock e Google Cloud são operados por parceiros. Eles cobram diretamente pelas próprias tarifas publicadas, então confira os preços do Bedrock antes de assumir paridade. O Google também publica suas próprias tarifas do Vertex AI.
- Claude Platform on AWS e Claude in Microsoft Foundry são operados pela Anthropic. Eles valorizam seu uso pelos preços padrão da Anthropic, aplicam qualquer desconto negociado e convertem em Claude Consumption Units a US$ 0,01 cada, cobradas por hora, em atraso, pelo marketplace.
- A inferência apenas nos EUA tem o mesmo multiplicador de 1,1x na API própria, no Claude Platform on AWS e nas implantações US Data Zone do Foundry.
Se você já roda o Claude por uma nuvem, o guia do Bedrock e o guia do Vertex AI cobrem a configuração.
Como o Sonnet 5.5 se compara ao GPT-6 Sol e ao Gemini 3.8 Flash
A comparação mais marcante não está dentro da linha da Anthropic. O GPT-6 Sol tem uma tabela principal idêntica: US$ 2 de entrada, US$ 10 de saída, US$ 0,20 de entrada em cache, US$ 2,50 de gravação de cache, segundo o detalhamento dos preços do GPT-6 Sol.
| Por 1M de tokens | Claude Sonnet 5.5 | GPT-6 Sol | Gemini 3.8 Flash |
|---|---|---|---|
| Entrada | $2 | $2 | $0.75 (sobe para $1.50 em 1 jan. 2027) |
| Saída | $10 | $10 | $3.75 (sobe para $7.50) |
| Leitura de cache | $0.20 | $0.20 | $0.075 |
| Prêmio de contexto longo | Nenhum até 1M | Tarifa maior acima de 272K de entrada | Nenhum |
| Custo por tarefa na AA (configuração) | $1.08 (high) | $1.05 (max) | Não comparável |
| AA Intelligence Index | 47 (high) | 48 (max) | Não comparável |
As linhas da AA entregam o jogo. O Sonnet 5.5 em High e o GPT-6 Sol no max chegam a quase a mesma pontuação por quase o mesmo custo por tarefa. A diferença está mais nas pontas: o Sonnet não tem sobretaxa de contexto longo, então um agente de suporte que carrega uma base de conhecimento grande no contexto não cruza um precipício de preço, e o Sol cruza acima de 272K. Os números da AA para o Gemini vieram de uma versão anterior do índice, então deixei-os fora do comparativo direto, e os preços do Gemini 3.8 Flash dobram em janeiro. A comparação de três APIs vai mais fundo se você está escolhendo um provedor em vez de um modelo.
Para tickets de suporte especificamente, o ranking tem menos a ver com preço do que com confiabilidade nos seus próprios dados, e é por isso que o ranking de modelos para tickets de suporte coloca a precisão em primeiro lugar.
O que os desenvolvedores estão dizendo sobre o preço
A reação no dia do lançamento no Hacker News foi principalmente sobre onde ele fica em relação ao Opus. A visão cética:
"I feel like sonnet is priced too close to opus right now. If Sonnet 5.5 were half its current price it would make sense to use."
A visão ponderada, que combina com a escada da AA acima:
"Per the charts, there is largely no point to using Sonnet 5.5 at high+ as opus low generally will give similar performance at similar or lower cost."
E a entusiasmada, de um usuário comparando-o ao modelo principal da OpenAI em uma configuração mais baixa:
"Sonnet 5.5 medium scores better than gpt 5.6 Sol high and is less than 1/5 the cost Absolutely bonkers"

O padrão a que as pessoas chegavam sempre era uma configuração dividida: o Sonnet 5.5 em Low ou Medium fazendo o trabalho de alto volume como subagente, com o Opus 5.5 orquestrando ou finalizando as partes difíceis. Se nenhum dos dois serve, o levantamento de alternativas ao Claude cobre outros caminhos. Isso combina com a precificação, já que o desconto do Sonnet é real em chamadas com muita saída e contexto curto, e some em loops longos e carregados de cache.
O Claude Sonnet 5.5 vale US$ 2 e US$ 10?
Sim, em esforço Low e Medium, e eu não hesitaria ali. Ele supera a melhor pontuação do Sonnet 5 por uma fração do custo, custa metade do Opus na linha de saída que domina cargas do tipo chat, e não tem sobretaxa de contexto longo. Para um bot de respostas de suporte, um classificador, uma etapa de redação ou um job Batch noturno, é o que eu escolheria como padrão.
É uma compra mais fraca em dois casos. Se a sua carga é um loop longo de agente, as leituras de cache comem o desconto porque custam o mesmo nos dois modelos. E se você precisa de Xhigh ou Max para chegar à qualidade que quer, o Opus 5.5 em Medium costuma ser mais barato pela mesma pontuação. Teste o Sonnet em Low primeiro, meça, e depois decida se a diferença vale US$ 1,34 por tarefa.
Se o trabalho é uma fila de suporte, mais um custo entra na conta: planejar um gasto que se move com o esforço e o volume. Um comprador nas ligações de vendas da eesel chegou a 200 interações em um único dia de teste e imediatamente se preocupou com o custo por interação em escala. Faturas por token tornam essa preocupação mais difícil de responder, porque o mesmo ticket pode custar 1,6 centavo ou US$ 1,28 dependendo de uma configuração.
Experimente a eesel para uma fatura fixa por ticket
O Sonnet 5.5 é o motor. Se o que você quer são tickets respondidos, a eesel é a funcionária: um colega de helpdesk com IA que se conecta ao Zendesk, Freshdesk, Gorgias e às suas outras ferramentas, aprende com seus tickets anteriores e sua central de ajuda, e permite simulá-lo com tickets históricos antes de ele responder a um cliente real. Você nunca escolhe um nível de esforço nem acompanha leituras de cache. Os preços da eesel são um plano mensal fixo de créditos em que um ticket ou chat atendido é um crédito, a partir de US$ 299 por 500 créditos, com um nível gratuito de 100 créditos para testar.
Se você trabalha em um terminal, a CLI da eesel controla o mesmo colega. Você pode conectar integrações e editar suas instruções permanentes, além de aprovar ou negar ações e ler seu registro de atividade em JSON. Agentes de programação como o Claude Code também podem executá-la, pelo servidor MCP do workspace.

Experimente a eesel e veja quanto sua fila custa por ticket em vez de por token.
Perguntas frequentes
Quanto custa o Claude Sonnet 5.5 por milhão de tokens?
O Claude Sonnet 5.5 é mais caro que o Claude Sonnet 5?
O Claude Sonnet 5.5 custa metade do Claude Opus 5.5?
Qual é a forma mais barata de rodar o Claude Sonnet 5.5?
Posso usar o Claude Sonnet 5.5 de graça?
O Claude Sonnet 5.5 cobra a mais por contexto longo?
Quanto custa o Claude Sonnet 5.5 no Amazon Bedrock ou no Google Cloud?
Quanto o Claude Sonnet 5.5 custaria para um bot de atendimento ao cliente?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.