

Resumo
O preço do Claude Haiku 5.5 é de US$ 0,10 por milhão de tokens de entrada e US$ 0,50 por milhão de tokens de saída, igual ao GPT-6 Luna e 90% abaixo do Haiku 4.5. Esse preço só vale enquanto o prompt de uma requisição ficar em até 100.000 tokens. Acima desse limite, cada linha da fatura custa 5x mais (US$ 0,50 de entrada, US$ 2,50 de saída), tokens em cache contam para o limite e o Haiku 5.5 é o único modelo Claude atual precificado assim.
Outras duas coisas mexem no custo real por tarefa. O novo tokenizador transforma o mesmo texto em cerca de 30% mais tokens do que o Haiku 4.5, e o esforço (effort) define quanto raciocínio você paga: rodar o mesmo conjunto de benchmarks custou US$ 34 em Low e US$ 330 em Max. O Batch corta tudo pela metade, e as leituras de cache custam um décimo da entrada.
Para uma equipe de suporte, o Haiku 5.5 é um motor de triagem muito barato se você mantiver os prompts curtos. Etiquetar 20.000 tickets por mês custa cerca de US$ 12, enquanto um bot de respostas que carrega 120k tokens de contexto por ticket custa cerca de US$ 1.300. Se você prefere não montar tudo em torno do limite, o colega de IA para helpdesk da eesel faz a triagem e as respostas dentro do seu helpdesk por US$ 299 fixos por mês para 500 tickets.
Preços do Claude Haiku 5.5 num relance
Isto é o que notei ao ver o que as pessoas pesquisam depois do lançamento de um modelo. A busca é "preços do Claude Haiku 5.5", mas o trecho que o Google mostra já responde US$ 0,10 e US$ 0,50, então o que a pessoa quer saber de verdade é quanto um mês disso vai custar, e no Haiku 5.5 isso depende de um número mais do que de qualquer outro: o tamanho dos seus prompts.
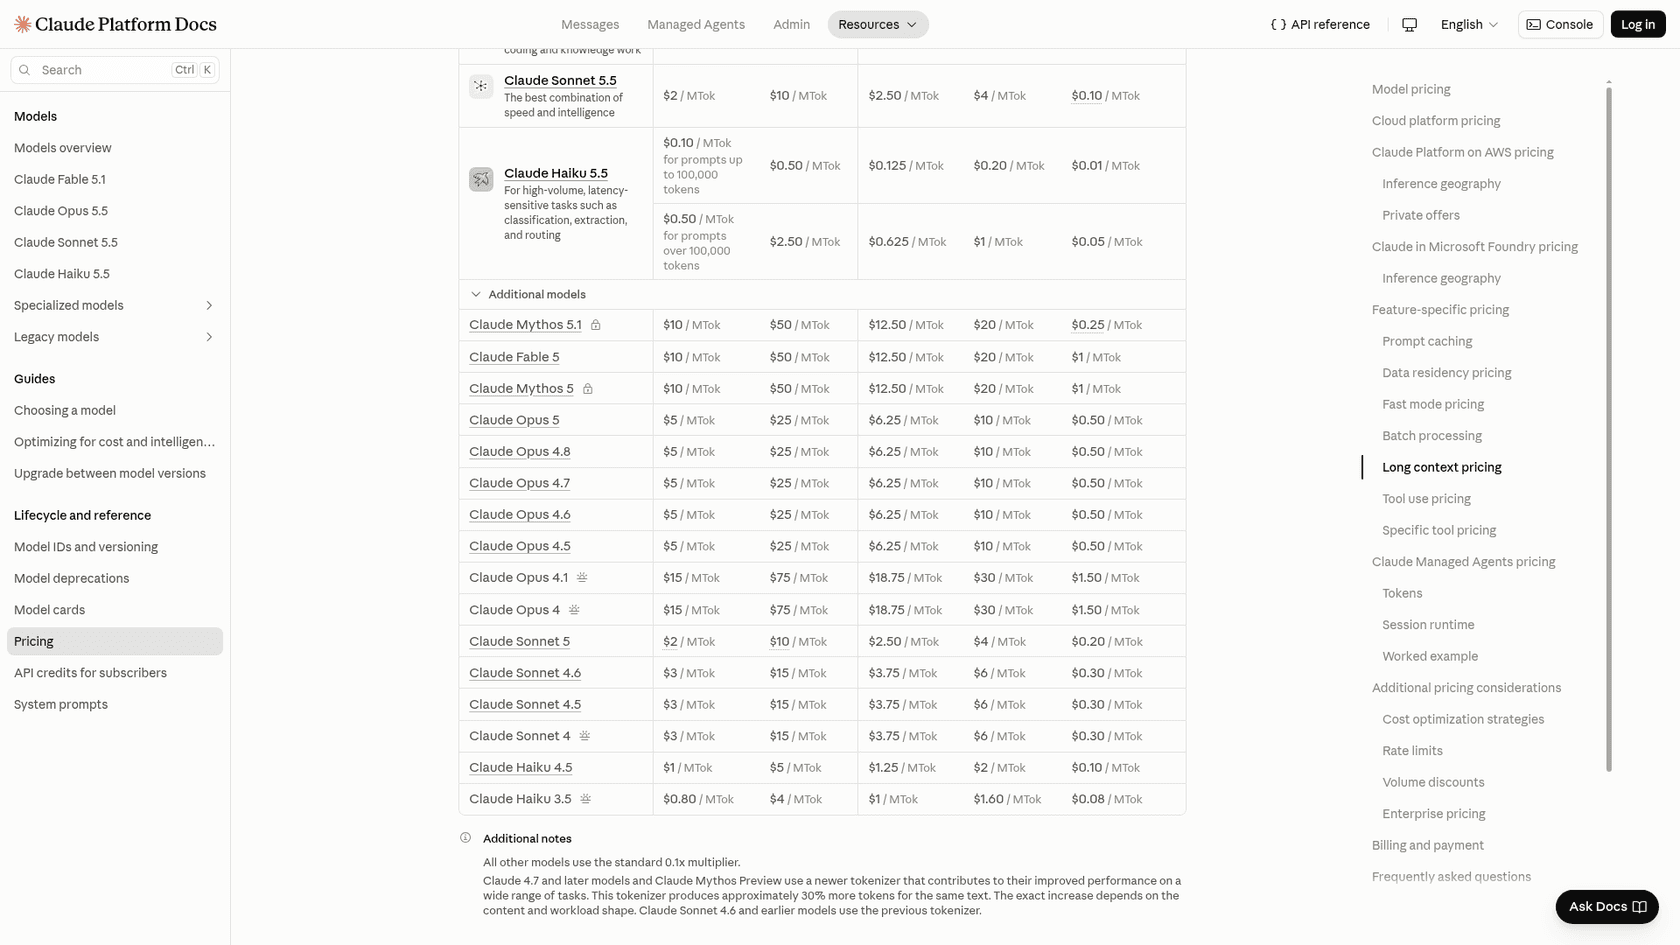
O Claude Haiku 5.5 foi lançado em 7 de outubro de 2026, com o ID de modelo claude-haiku-5-5. Abaixo está a tabela completa de preços da API, da documentação de preços da Anthropic, por milhão de tokens:
| Item | Prompt de até 100.000 tokens | Prompt acima de 100.000 tokens |
|---|---|---|
| Entrada | US$ 0,10 | US$ 0,50 |
| Saída (incluindo raciocínio) | US$ 0,50 | US$ 2,50 |
| Leitura de cache (acerto ou renovação) | US$ 0,01 | US$ 0,05 |
| Escrita de cache de 5 minutos | US$ 0,125 | US$ 0,625 |
| Escrita de cache de 1 hora | US$ 0,20 | US$ 1,00 |
| Entrada no Batch | US$ 0,05 | US$ 0,25 |
| Saída no Batch | US$ 0,25 | US$ 1,25 |
E aqui está onde ele fica ao lado dos modelos com os quais você de fato o compararia:
| Modelo | Entrada | Saída | Leitura de cache | Prompts longos |
|---|---|---|---|---|
| Claude Haiku 5.5 | US$ 0,10 | US$ 0,50 | US$ 0,01 | 5x em cada linha acima de 100k |
| Claude Haiku 4.5 | US$ 1,00 | US$ 5,00 | US$ 0,10 | Fixo, limite de contexto de 200k |
| Claude Sonnet 5.5 | US$ 2,00 | US$ 10,00 | US$ 0,10 | Fixo até 1M |
| Claude Opus 5.5 | US$ 4,00 | US$ 20,00 | US$ 0,20 | Fixo até 1M |
| Claude Fable 5.1 | US$ 10,00 | US$ 50,00 | US$ 0,25 | Fixo até 1M |
Algumas coisas não aparecem na tabela, e vale destacar. Não existe Fast mode para o Haiku 5.5 (ele cobre só os modelos Opus), e o guia de migração diz que o Priority Tier também não é suportado. A inferência apenas nos EUA acrescenta 1,1x em toda categoria de token, igual aos outros modelos Claude 4.6 e posteriores. Para o panorama de todos os modelos da Anthropic, meu guia de Anthropic API pricing traz tudo.
O limite de 100k é por requisição, e o cache não te deixa abaixo dele
Todos os outros modelos Claude atuais já incluem a janela de contexto inteira de 1M por um único preço. A página de preços diz isso de forma bem direta: os modelos Claude 4.6 e posteriores "(except Claude Haiku 5.5)" cobram uma requisição de 900k tokens pela mesma tarifa por token de uma de 9k. O Haiku 5.5 é a exceção aqui, e a documentação detalha três regras que decidem a sua fatura.
- O tamanho do prompt conta todo token de entrada. Isso inclui leituras de cache e também escritas de cache, não só o texto novo.
- Cada requisição é precificada separadamente. Uma requisição longa não empurra as outras para uma faixa mais alta, e as anteriores mantêm o preço pelo qual foram cobradas.
- Uma requisição acima do limite paga as tarifas mais altas por tudo. Entrada e saída vão para a tarifa de 5x, e o cache também, mesmo quando a maior parte do prompt é acerto de cache.
A terceira regra é a que as pessoas costumam deixar passar. O cache não esconde tokens do medidor. Se o seu agente arrasta 120.000 tokens de histórico para uma requisição, ele paga US$ 0,05 por milhão pela parte em cache em vez de US$ 0,01, e depois US$ 2,50 por milhão pela saída em vez de US$ 0,50.
Veja o que isso faz com uma única requisição. Um prompt de 90k tokens com 1.000 tokens de saída custa US$ 0,0095. Some mais 20.000 tokens de prompt e a mesma requisição passa a custar US$ 0,0575.
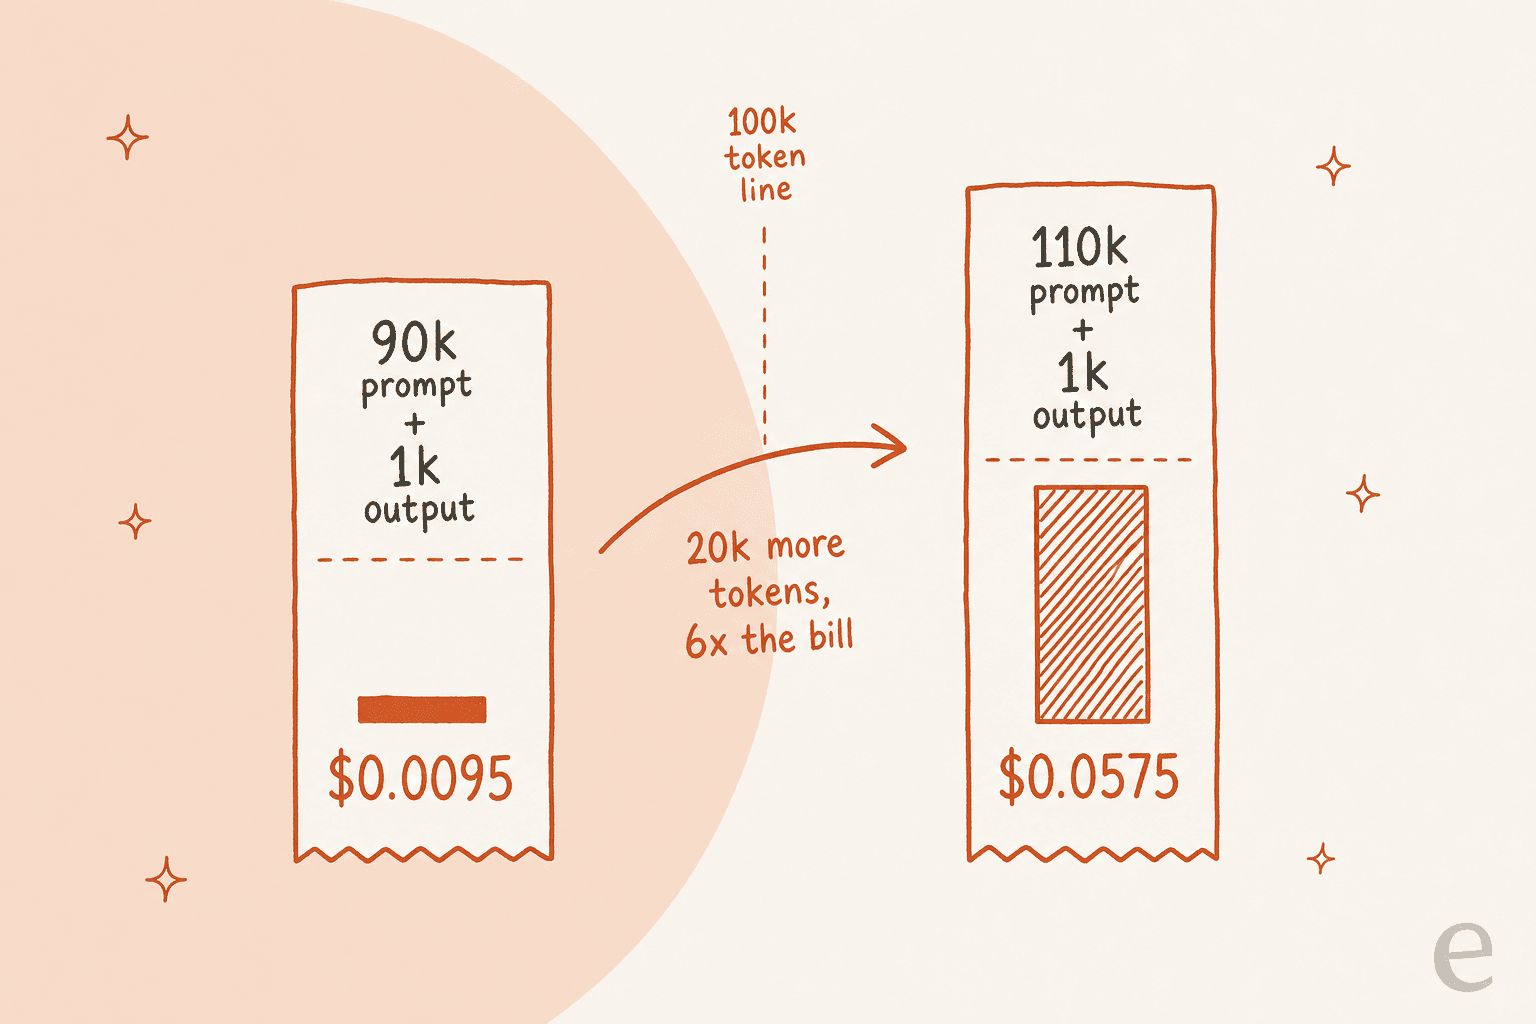
Ou seja, 20k tokens extras deixam uma requisição cerca de 6x mais cara. Não 22% mais cara, que é o que só a contagem de tokens faria você esperar. O tópico de lançamento no Hacker News percebeu isso em poucos minutos:
"100k tokens is an absurdly low cutoff and it is only applicable to Haiku and not Sonnet or Opus. It's a low enough cutoff that it will be quickly exceeded if you are doing anything with Agents; for typical generation or Jev-like classifiers, it's a good value and as noted in this article, that is apparently the vast majority of Haiku use."

A parte da "grande maioria" vem da própria Anthropic. O post de lançamento diz que prompts de até 100.000 tokens eram cerca de 90% das requisições ao Haiku 4.5. Se o seu tráfego é assim, o limite raramente pega, mas se você roda agentes, é a primeira coisa a medir.
Seus tokens ficaram cerca de 30% maiores
O segundo custo escondido está no tokenizador. A página what's new da Anthropic diz que o mesmo texto de entrada produz aproximadamente 30% mais tokens no Haiku 5.5 do que no Haiku 4.5. Simon Willison mediu um prompt longo no seu contador de tokens do Claude e chegou a cerca de 1,25x, o que ele chamou de "a hidden price increase".
Isso muda bastante o desconto de capa. Medindo por palavra de texto, não por token:
| Comparação com o Haiku 4.5 | Corte no preço de tabela | Corte por palavra, a 1,3x tokens |
|---|---|---|
| Prompts de até 100k tokens | 90% | cerca de 87% |
| Prompts acima de 100k tokens | 50% | cerca de 35% |
Isso também move o próprio limite. Pela minha conta, 100.000 tokens do Haiku 5.5 comportam mais ou menos o texto que no Haiku 4.5 eram 77.000 tokens. Qualquer prompt do Haiku 4.5 acima de uns 77k tokens hoje vai cair acima do limite depois da migração, e o guia de migração manda recontar os prompts com model em claude-haiku-5-5 exatamente por isso.
A diferença para a OpenAI é ainda maior. Um comentarista estimou que 100K tokens do Claude equivalem a uns "~60-65K modern GPT tokens", então o mesmo documento chega ao limite do Haiku bem antes de chegar ao limite de 272k do GPT-6 Luna. O número líquido da própria Anthropic, que já considera o tokenizador, é que o Haiku 5.5 custa "around 75% less to run" que o Haiku 4.5 em média. Esse é o número honesto para planejar, não os 90%. O Haiku 4.5 ainda consta como ativo na página de descontinuações, com desativação não antes de 15 de outubro de 2026, então há tempo para medir antes de migrar. Se você o usa dentro do Claude Code, meu guia de Claude Code Haiku cobre a troca.
O esforço é o outro botão de preço
O Haiku 5.5 é o primeiro Haiku com um ajuste de esforço, e o padrão da API é medium. Tokens de raciocínio são cobrados como saída, e não dá para desligar totalmente o raciocínio acima de high, então o esforço decide quantos desses tokens de saída de US$ 0,50 você compra por resposta.
A Artificial Analysis rodou o Intelligence Index em todos os níveis. O custo da execução inteira é a forma mais clara de ver a diferença:
| Esforço | Intelligence Index | Custo para rodar o índice | Tokens de saída usados |
|---|---|---|---|
| Low | 29,4 | US$ 34,31 | 32M |
| Medium (padrão da API) | 34,5 | US$ 56,36 | 54M |
| High | 37,8 | US$ 94,07 | 97M |
| Xhigh | 41,2 | US$ 157,58 | 180M |
| Max | 43,4 | US$ 330,25 | 440M |
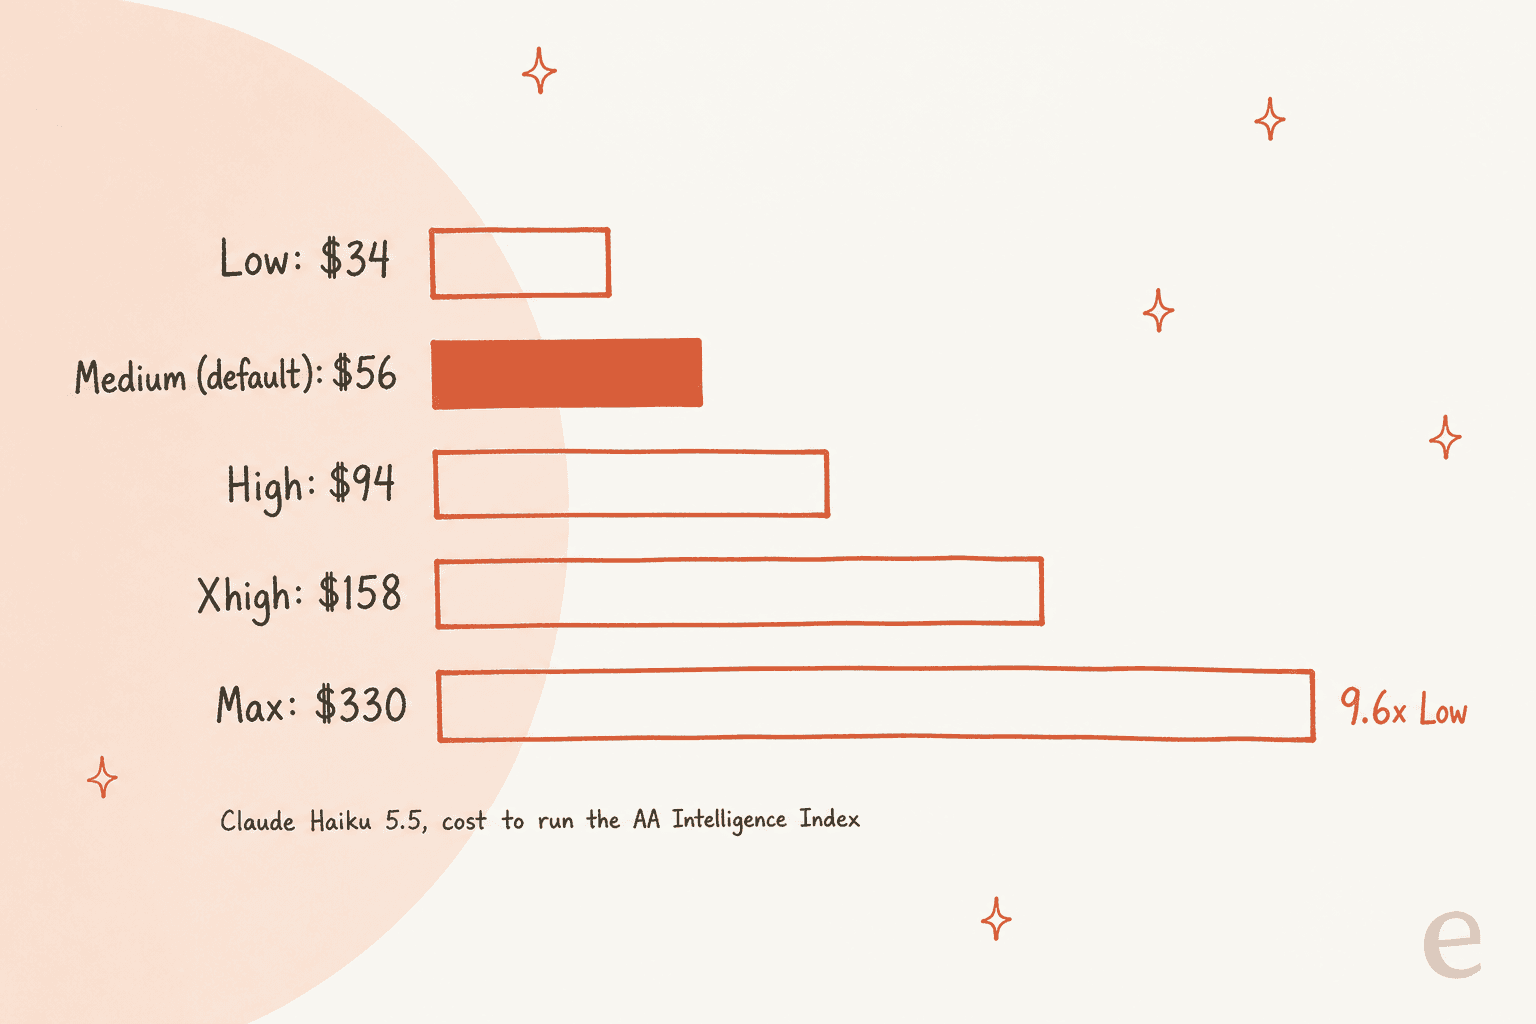
O Max custa 9,6x o que o Low custa para o mesmo conjunto de tarefas, por um ganho de 14 pontos no índice. A AA mediu cerca de 162k tokens de saída por tarefa no Max e chamou o modelo de "very verbose". No preço de tabela, isso dá US$ 0,21 por tarefa no Max, e esses números usam a tarifa abaixo de 100k, já que a AA observa que ainda não reflete a precificação escalonada.
Um teste menor mostra o mesmo formato. Simon Willison desenhou seu pelicano de sempre em cada nível: o Low custou 0,0936 centavos e levou 7 segundos, enquanto o Max levou 5 minutos e 9 segundos e custou 3,3826 centavos. Do Medium para cima, o quadro da bicicleta saiu certo.
Minha opinião é simples. Para etiquetar e direcionar tickets ou fazer resumos curtos, comece no Low e só suba quando um conjunto de testes mostrar perda de precisão. Para uma resposta que precisa raciocinar sobre uma política, o Medium é o padrão por um motivo. Raramente pagaria pelo Max no Haiku.
Um comentarista do HN leu os números da AA como colocando o Haiku no nível Max em custo por tarefa equivalente ao GPT-6.1 Sol em medium, um modelo muito mais forte. Nesse ponto, é melhor subir para o Sonnet 5.5 com esforço menor. Meu guia de seleção de modelo explica quando subir.
O que uma equipe de suporte paga de fato
A triagem de suporte é a carga de trabalho que o post de lançamento da Anthropic cita diretamente, com classificação e roteamento além de "live customer support". É também onde já vi o modelo mais barato fazer o trabalho mais útil. Em um teste da eesel com tráfego real do Zendesk de uma caixa de e-commerce de cerca de 1.000 tickets por mês, 22% dos tickets recebidos eram spam, e a triagem atingiu 93% de precisão com 100% de detecção de spam e zero falsos positivos. É um trabalho que um modelo pequeno deve assumir, e não precisa de prompts longos. Meu guia das melhores IAs para triagem de tickets cobre as ferramentas feitas para isso, e o guia do custo da IA no atendimento ao cliente coloca a conta do modelo ao lado do resto do orçamento.
Aqui estão duas cargas de trabalho com 20.000 tickets por mês, cada uma precificada pela tabela de preços. As contagens de tokens são suposições, então coloque as suas na calculadora abaixo. As escritas de cache ficam de fora, já que um cache aquecido gasta pouco com elas.
Etiquetagem e roteamento de tickets (abaixo do limite)
Cada requisição leva um prompt de sistema de 2.500 tokens com a sua lista de etiquetas mais um ticket de 1.500 tokens, e devolve cerca de 400 tokens com a etiqueta e um motivo curto.
| Configuração | Por ticket | Por mês (20.000 tickets) |
|---|---|---|
| Haiku 5.5, sem cache | US$ 0,0006 | US$ 12,00 |
| Haiku 5.5, prompt de sistema em cache | US$ 0,000375 | US$ 7,50 |
| Haiku 5.5, cache mais Batch | cerca de US$ 0,00019 | cerca de US$ 3,75 |
| Haiku 4.5, mesmo texto (menos tokens) | US$ 0,0046 | US$ 92 |
| Sonnet 5.5, sem cache | US$ 0,012 | US$ 240 |
Nesse tamanho, a conta do modelo é basicamente um erro de arredondamento. O que custa dinheiro é tudo em volta, como integrar ao helpdesk, escrever as regras de etiquetas e conferir as etiquetas que ele erra. Os guias sobre classificação de tickets com IA, roteamento de tickets e conectar o Claude ao seu helpdesk cobrem esse lado.
Redigir respostas com contexto da base de conhecimento (acima do limite)
Agora um bot de respostas. Cada requisição carrega 80.000 tokens de artigos da central de ajuda e macros que ficam iguais entre tickets, mais 40.000 tokens de histórico do ticket e dados do pedido, e escreve uma resposta de 2.000 tokens com o raciocínio. São 120k tokens de prompt, ou seja, acima do limite.
| Configuração | Por ticket | Por mês (20.000 tickets) |
|---|---|---|
| Haiku 5.5, prompt de 120k, sem cache | US$ 0,065 | US$ 1.300 |
| Haiku 5.5, prompt de 120k, 80k em cache | US$ 0,029 | US$ 580 |
| Haiku 5.5, enxugado para 95k, sem cache | US$ 0,0105 | US$ 210 |
| Haiku 5.5, enxugado para 95k, 80k em cache | US$ 0,0033 | US$ 66 |
| Sonnet 5.5, prompt de 120k, 80k em cache | US$ 0,108 | US$ 2.160 |
| GPT-6 Luna, prompt de 120k, 80k em cache | US$ 0,0058 | US$ 116 |
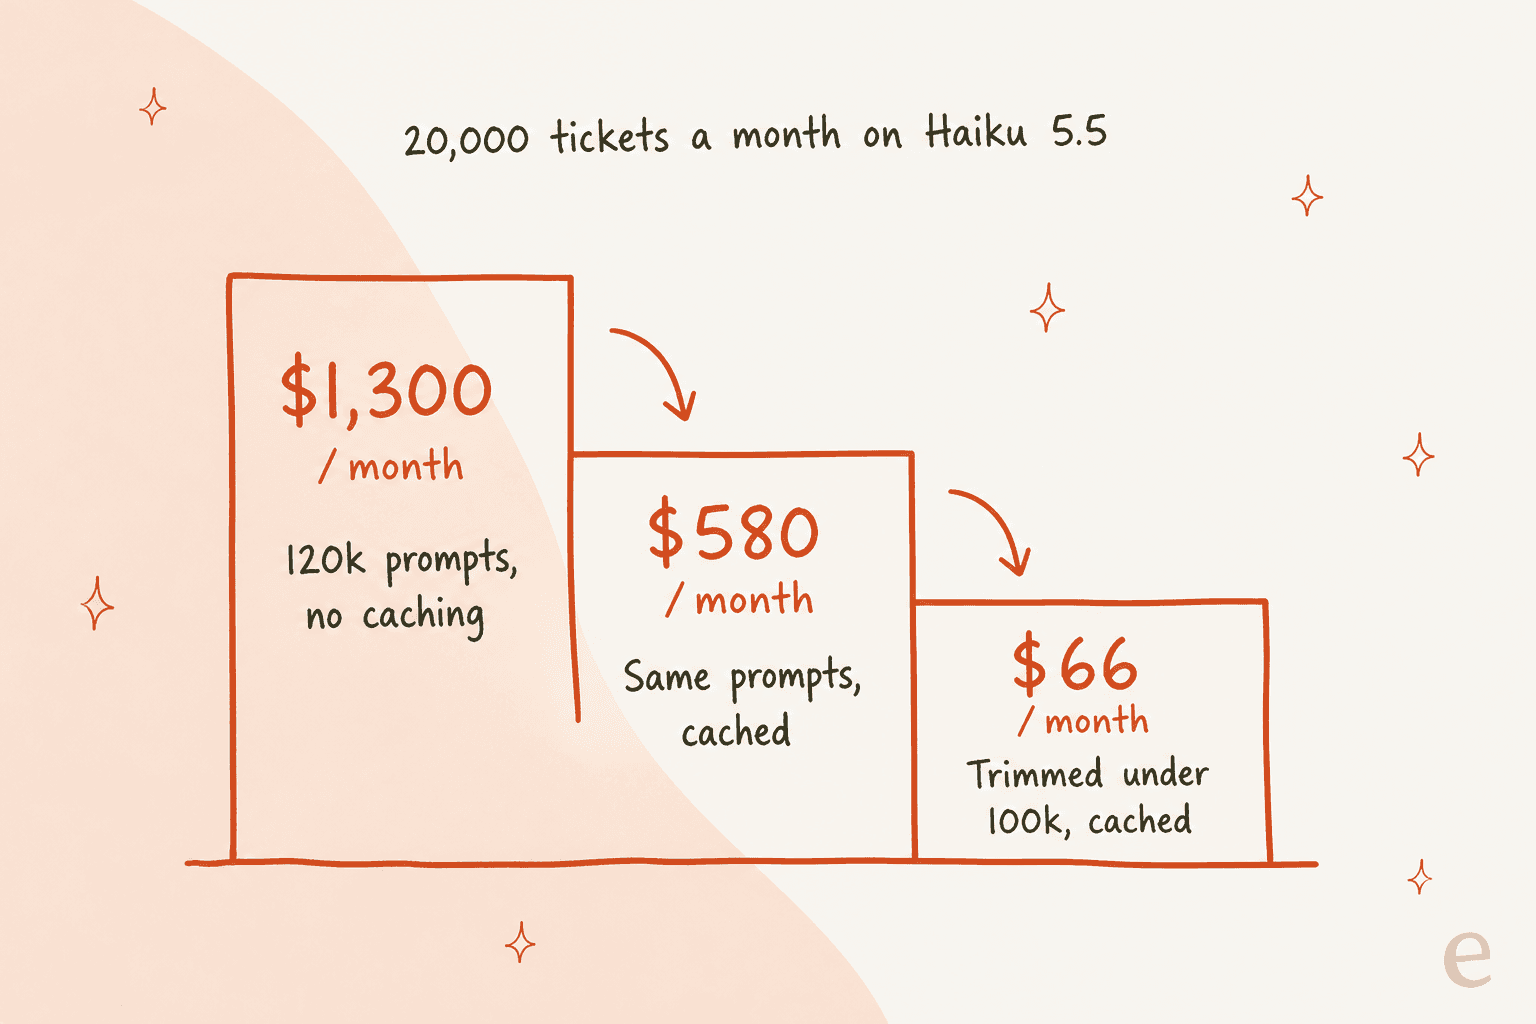
Só o cache já corta a fatura em mais da metade. Enxugar 25k tokens de prompt corta de novo 9x, de US$ 580 para US$ 66. O enxugamento costuma ser só a recuperação de informação fazendo seu trabalho: puxar os cinco artigos de ajuda mais relevantes em vez de uma categoria inteira, e resumir o histórico antigo do ticket em vez de colá-lo. O próprio Haiku é bom nesse passo de resumo, na tarifa barata.
A linha do Luna usa as mesmas contagens de tokens, o que favorece o Claude, já que a OpenAI conta menos tokens para o mesmo texto. O preço do Luna só sobe a partir de 272k tokens, então nesse formato ele fica bem abaixo do Haiku. Mais sobre isso na comparação abaixo e no meu detalhamento de GPT-6 Luna pricing.
Estime a sua própria fatura do Haiku 5.5
Escolha um preset ou coloque seus números. A barra mostra onde o seu prompt fica em relação ao limite de 100k, e as linhas comparam a mesma carga no Haiku 4.5 e no Sonnet 5.5, com o GPT-6 Luna também incluído.
Duas coisas que valem a pena testar. Coloque o prompt do preset Reply em 99.000 e depois em 101.000, e veja o valor mensal pular. Depois ative o Batch, que corta cada linha pela metade mas só serve para trabalho que pode esperar até 24 horas, como etiquetar um acúmulo durante a noite ou resumos semanais de tickets.
Batch, cache e os itens menores
Estas são as alavancas que se somam ao preço base, segundo a documentação de preços:
| Alavanca | O que faz no Haiku 5.5 | Atenção a |
|---|---|---|
| Batch API | 50% de desconto em entrada e saída, nas duas faixas | Assíncrono, então não serve para chat ao vivo |
| Escrita de cache de 5 minutos | 1,25x a entrada, se paga após uma leitura de cache | O cache expira se o tráfego for esparso |
| Escrita de cache de 1 hora | 2x a entrada, se paga após duas leituras de cache | Vale a pena com tráfego diurno constante |
| Leitura de cache | 0,1x a entrada (US$ 0,01 ou US$ 0,05) | Ainda conta para o limite de 100k |
| Inferência apenas nos EUA | 1,1x em toda categoria de token | O roteamento global é o padrão |
| Prompt de sistema de uso de ferramentas | 286 tokens de entrada extras (auto, none) | Abaixo dos 496 do Haiku 4.5 |
| Busca na web | US$ 10 por 1.000 buscas, mais tokens | Os resultados somam tokens de entrada |
| Conjunto de ferramentas de uso do navegador | Cerca de 6.600 tokens de entrada por requisição | Capturas de tela são cobradas como entrada de imagem |
Os modificadores se multiplicam, então uma leitura de cache em um job Batch custa metade do preço do cache. Num modelo tão barato, a sobrecarga das ferramentas importa mais do que parece. Um agente de uso do navegador começa cada requisição uns 6.600 tokens mais perto do limite antes mesmo de ler uma página.
Haiku 5.5 vs Haiku 4.5, Sonnet 5.5 e os rivais da faixa barata
O preço por token é só metade da comparação. Os tokenizadores são diferentes, e também quanto cada modelo escreve por tarefa. Esta tabela coloca os preços de tabela ao lado do custo por tarefa do Intelligence Index da AA, que incorpora a verbosidade:
| Modelo | Entrada / saída por 1M | Ponto de mudança de preço | Custo por tarefa na AA |
|---|---|---|---|
| Claude Haiku 5.5 | US$ 0,10 / US$ 0,50 | 5x acima de 100k de prompt | US$ 0,21 (Max) |
| GPT-6 Luna | US$ 0,10 / US$ 0,50 | 2x entrada, 1,5x saída acima de 272k | US$ 0,07 (Max) |
| Gemini 3.5 Flash-Lite | US$ 0,30 / US$ 2,50 | Nenhum informado | US$ 0,19 |
| GLM-5.3 Flash | US$ 0,15 / US$ 0,50 | Nenhum informado | US$ 0,25 |
| DeepSeek V4.1 Flash | US$ 0,15 a US$ 0,30 / US$ 0,60 a US$ 1,20 | Horário de pico custa 2x | Não medido |
| Claude Haiku 4.5 | US$ 1 / US$ 5 | Limite de contexto de 200k | Não medido |
| Claude Sonnet 5.5 | US$ 2 / US$ 10 | Fixo até 1M | Não medido |
Os preços vêm da página de preços de cada fornecedor, e a tabela completa da OpenAI está no meu guia de OpenAI API pricing.
Se o Gemini 3.8 Flash te tenta, lembre que a página de preços do Google dobra o preço dele em 1º de janeiro de 2027.
A comparação real mais limpa que encontrei foi de um desenvolvedor que rodou o mesmo trabalho de classificação nos dois:
"I compared the costs between luna and haiku for some classification work. Luna comes out a fair amount cheaper due to more efficient tokenization and less outputs."
Os números dele: o Haiku 5.5 usou 11.893.643 tokens de entrada e custou US$ 0,42 de forma síncrona, enquanto o GPT-6 Luna usou 7.903.468 tokens de entrada para o mesmo trabalho e custou US$ 0,31. Mesmo preço de tabela, mas a fatura do Haiku saiu 35% maior. O benchmark de análise de dados da Plotly contou algo parecido, com o Luna indo "a bit better" por cerca de 30% do custo do Haiku.
Então por que pagar mais pelo Haiku? Velocidade, e em alguns testes também qualidade. A AA mediu de 137 a 243 tokens de saída por segundo conforme o nível de esforço, e um comentarista relatou que a OpenRouter entregava cerca do dobro da vazão do Luna. A Anthropic o chama de seu modelo mais rápido em velocidade padrão, e por isso cita o atendimento ao cliente ao vivo como um bom uso. Um bot lento te custa mais em tempo de agente humano do que qualquer linha de token. Meu post sobre alternativas ao Haiku 5.5 aprofunda quando trocar, e a comparação de três APIs mostra como escolher um provedor.
Contra os próprios modelos da Anthropic, o degrau acima pesa mais. O Sonnet 5.5 custa 20x o preço de entrada do Haiku com prompts curtos, mas só 4x o do Haiku acima do limite, e não tem limite nenhum. Se a maior parte das suas requisições fica entre 100k e 400k tokens, passe os dois pela calculadora acima antes de presumir que o Haiku ganha. O detalhamento de Sonnet 5.5 pricing (e o mais antigo Sonnet 5 pricing) também cobre o corte do mesmo dia na leitura de cache, de US$ 0,20 para US$ 0,10, que a Anthropic diz deixar o Sonnet 5.5 cerca de 20% mais barato na maior parte do trabalho com agentes.
Usando o Haiku 5.5 num plano do Claude ou com créditos de API
Se você só quer conversar com o Haiku, não paga por token de jeito nenhum, e meu guia de preços do Claude compara os planos por completo. A página de planos do Claude lista o Haiku em Free, Pro, Max e Team. O Pro custa US$ 17 por mês com cobrança anual (US$ 20 mensal), o Max começa em US$ 100, e os assentos do Team custam US$ 20 Standard ou US$ 100 Premium por assento com cobrança anual.
A novidade são os créditos de API. Junto com o Haiku 5.5, a Anthropic começou a dar aos assinantes do Max e do Team um crédito mensal para a Claude Platform:
| Plano | Crédito mensal de API |
|---|---|
| Max 5x | US$ 100 |
| Max 20x | US$ 200 |
| Team, assento Standard | US$ 20 por assento |
| Team, assento Premium | US$ 100 por assento |
| Teto do pool do Team | US$ 500 por mês |
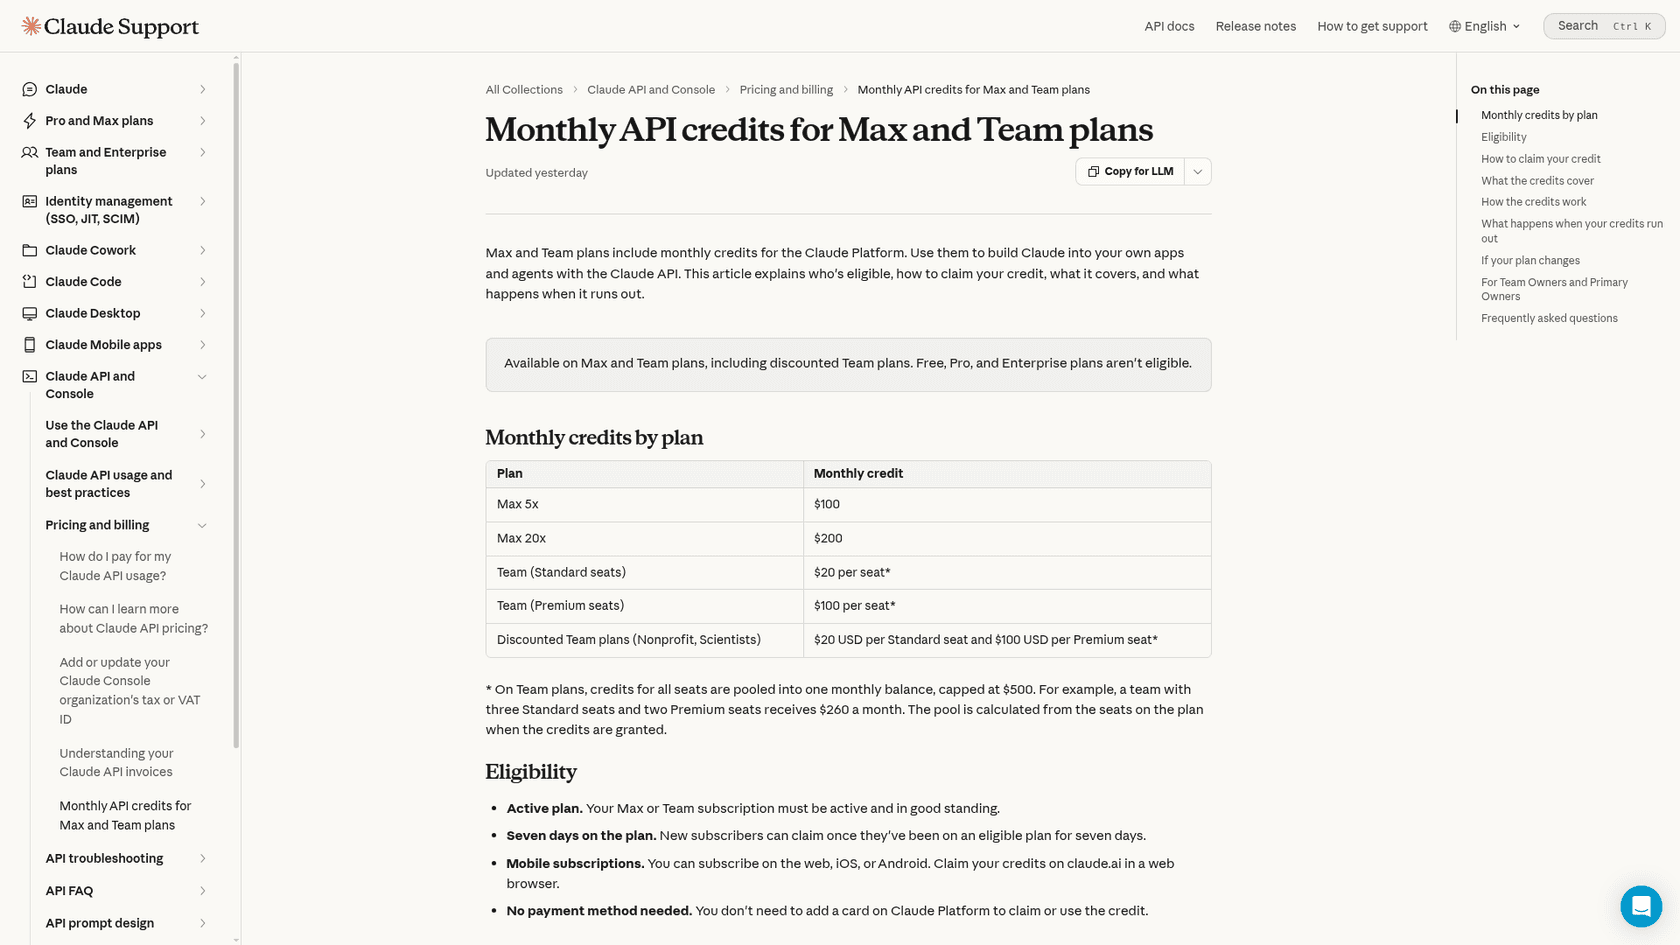
O artigo de ajuda traz as regras. Free, Pro e Enterprise não são elegíveis, e você precisa estar no plano há sete dias. Os créditos não acumulam, algo para lembrar, e cobrem a API mais Batches, Managed Agents e o Agent SDK, além do claude -p com uma chave de API. Não cobrem o Claude Code interativo nem o uso no Bedrock, Vertex AI ou Foundry.
No Haiku 5.5, esse crédito rende muito. Pela minha conta, US$ 100 compram cerca de 1 bilhão de tokens de entrada com prompts curtos ou 200 milhões de tokens de saída por mês. A carga de etiquetagem em cache acima rodaria cerca de um ano com um mês de crédito do Max 5x. Um projeto paralelo ou uma ferramenta interna pode viver inteiramente dentro do crédito, desde que fique abaixo do limite.
O que os desenvolvedores dizem sobre o preço
O tópico de lançamento se dividiu em torno de uma pergunta: o seu trabalho cabe em 100k tokens?
"noticeably smarter remains to be seen in practice. For now, Haiku is a bit more expensive than Luna on < 100k token, but I just don't have any agentic work below 100k, so this is going to be 5x more expensive than shown on these charts."
O outro lado vê o limite como uma troca justa para trabalho de subagentes:
"I would mostly use Haiku in task or explorer subagents. I'm not saying I stay under that on every task, but I do have quite a few sessions that cap out well below that, so that price difference would be very meaningful."
E um comentarista leu toda a estrutura mais como uma jogada de preços do que como um limite técnico:
"I'd consider the 100k a "promotional price" to match Luna's token pricing while delivering noticeably more intelligence."
Essa última é especulação, e a Anthropic não disse que vai mudar. Ainda assim, é um bom motivo para não montar um modelo de custos que só funciona se o Haiku ficar em US$ 0,10 para prompts de qualquer tamanho.
O Claude Haiku 5.5 vale a pena a esse preço?
Para trabalhos curtos e de alto volume, sim, claramente. Classificação e etiquetagem, roteamento, extração, resumos curtos: tudo isso cabe abaixo de 100k tokens, custa centavos a cada mil chamadas e ainda roda rápido. Vindo do Haiku 4.5, é o corte de custo mais fácil da linha Claude, cerca de 87% por palavra de texto. Se você usa o Claude para Zendesk ou um script de triagem caseiro, esse é o modelo para migrar primeiro. O guia de Claude para atendimento ao cliente traz a configuração.
Para agentes de contexto longo, é mais apertado. Acima do limite, o Haiku custa um quarto do Sonnet 5.5 por token, sem teto para quantas vezes você o cruza, e o GPT-6 Luna continua mais barato até 272k. Meça o tamanho dos seus prompts antes de migrar e depois desenhe a recuperação de informação para ficar abaixo do limite, se puder.
O panorama completo de qualidade está na minha análise do Haiku 5.5, onde o tópico do HN também tem desenvolvedores relatando regressões em relação ao Haiku 4.5 nas próprias avaliações. Um modelo mais barato que exige refazer os prompts não é mais barato até o retrabalho estar feito.
Entregue a fila de triagem para a eesel
Se o motivo de você estar avaliando o preço do Haiku 5.5 é a sua fila de suporte, a conta de tokens é a menor parte do trabalho, ponto que meu detalhamento de economia de custos no suporte com IA mostra com números reais. Você ainda precisa da integração com o helpdesk e das regras de etiquetas, depois de uma forma de testar com tickets passados, e também de alguém que acompanhe o que ele erra. É esse trabalho que a eesel tira das suas costas.
O colega de IA para helpdesk da eesel entra no helpdesk que você já tem, como Zendesk, Freshdesk ou Gorgias, aprende com seus tickets passados e então etiqueta e direciona tickets, redige respostas ou as responde.
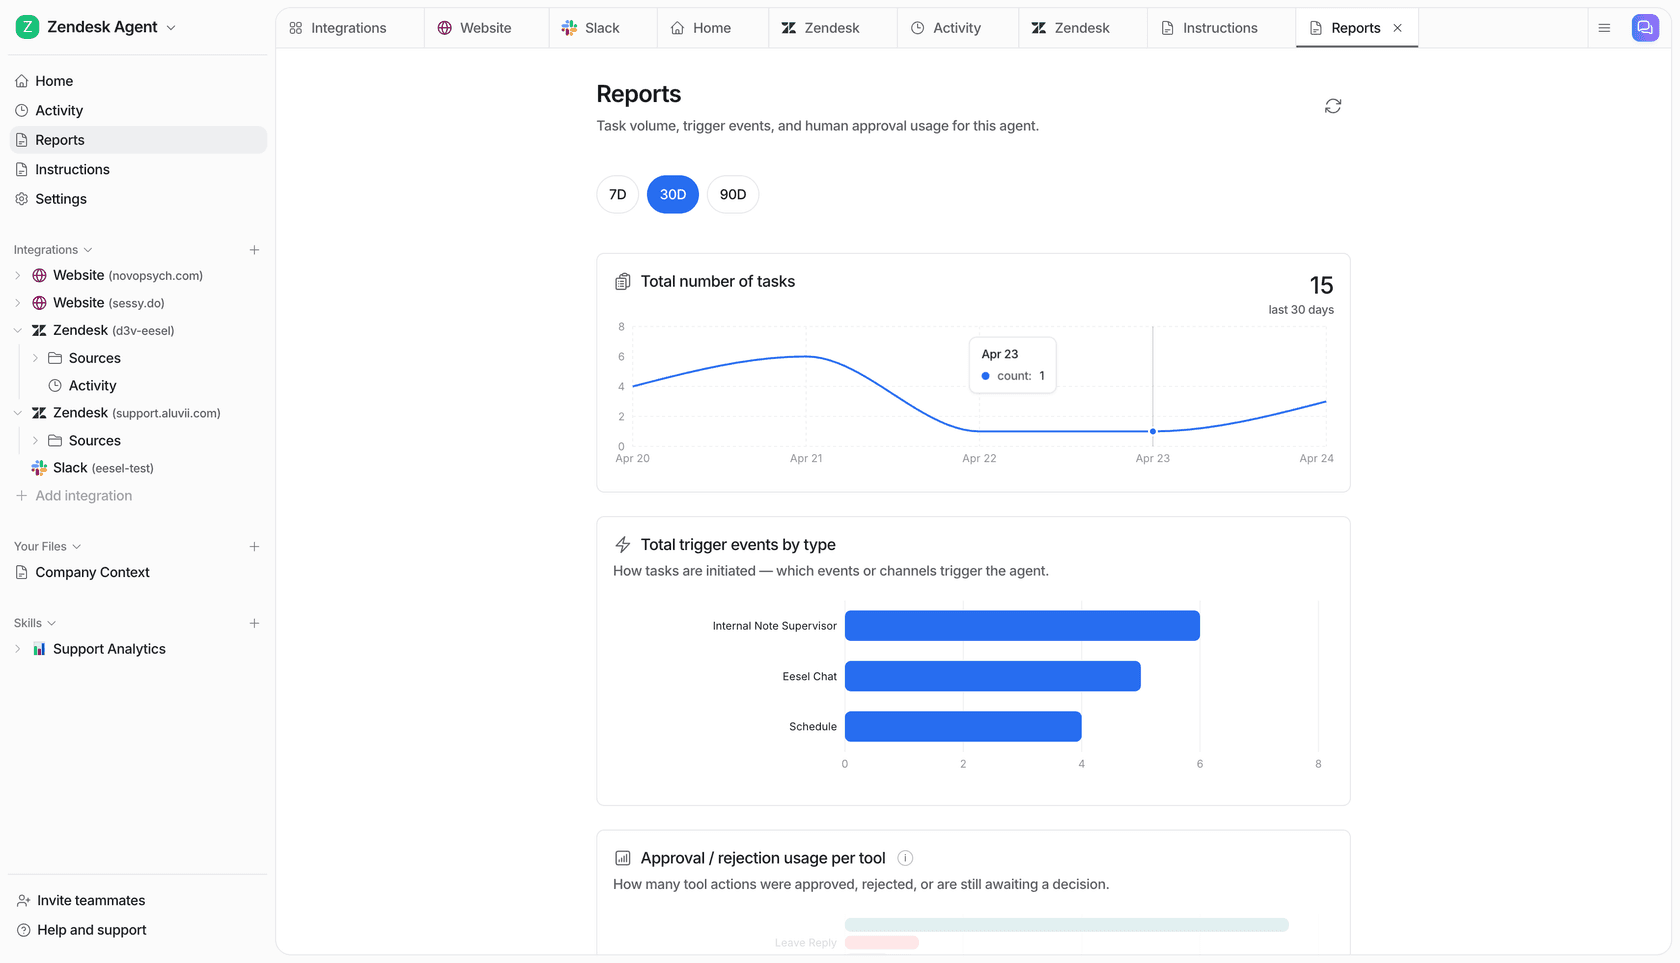
Antes de ele tocar num cliente real, eu o rodaria contra os seus tickets históricos, e essa simulação já vem embutida. Você acompanha o que ele faz na visão de relatórios:
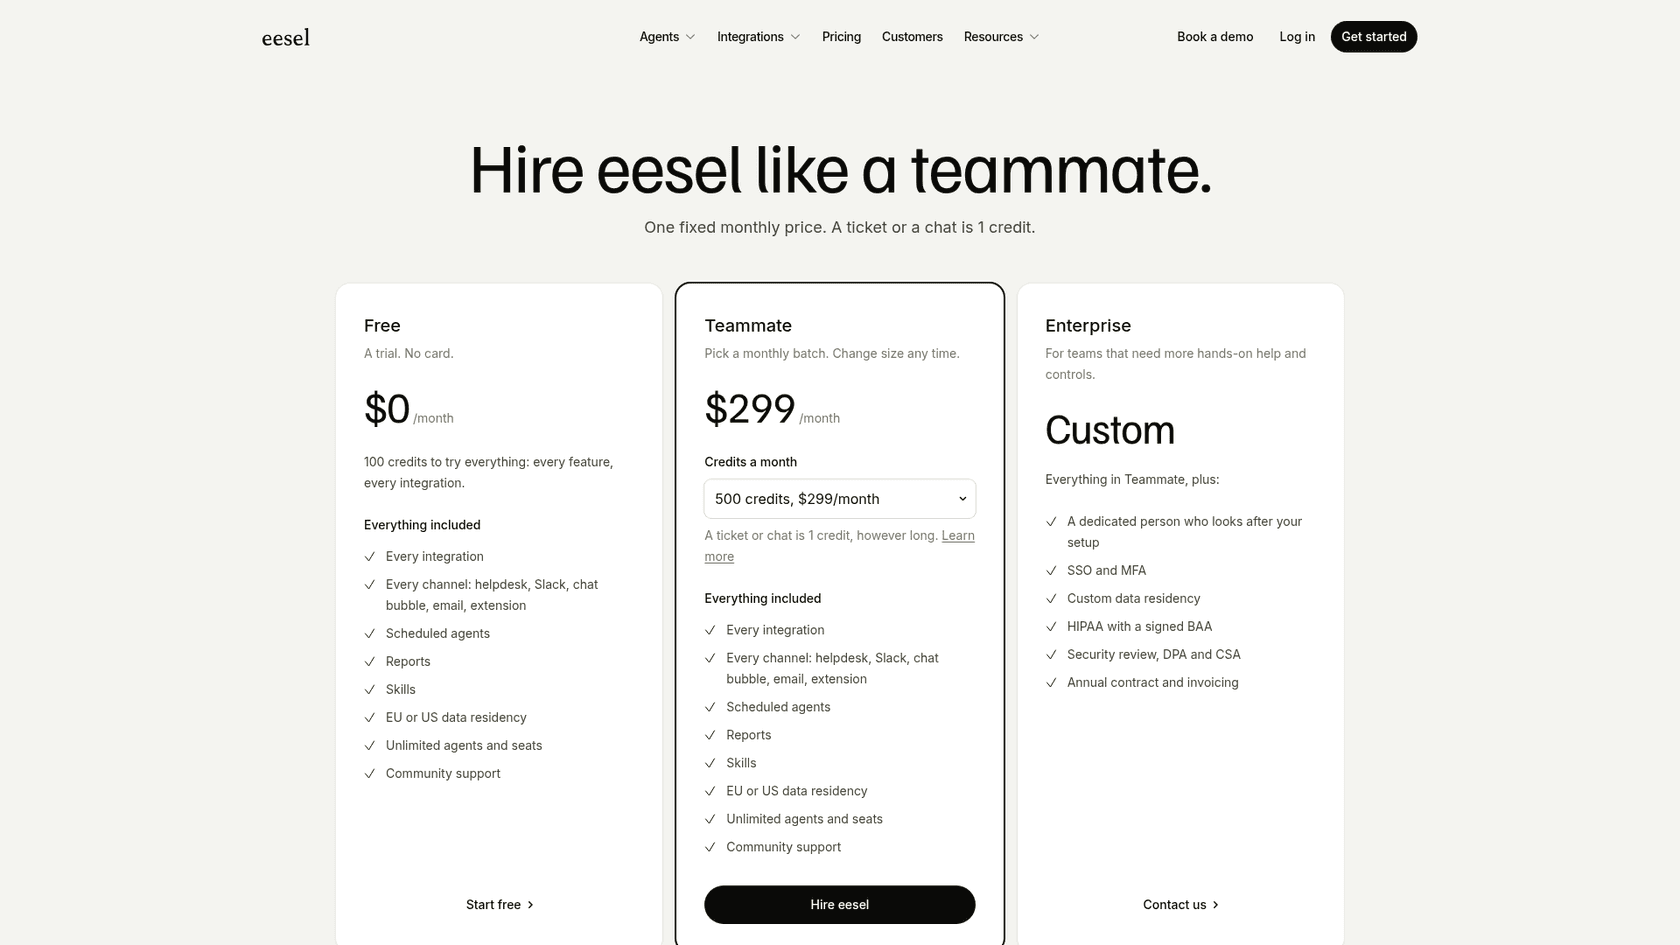
O preço é o oposto de um medidor de tokens. Um ticket ou chat é um crédito, não importa quanto dure, então uma conversa de 120k tokens custa o mesmo que uma pergunta de duas linhas. Os planos começam em US$ 299 por mês para 500 créditos e vão até US$ 1.749 para 5.000, com um teste gratuito de 100 créditos e sem cartão. A previsibilidade importa mais do que parece. Um usuário de teste da eesel, no Gorgias, viu o agente dele lidar bem com 12 chats de teste e pediu para cancelar assim que chegou à página de cobrança. Compare com ferramentas medidas como o Zendesk AI pricing, em que a fatura se move a cada resolução.
Para ser franco sobre o encaixe: se você só precisa de um script de etiquetagem e tem engenheiros, a API pura do Haiku 5.5 a US$ 12 por mês é mais barata, e você deve usá-la. A eesel faz sentido quando você quer o colega completo, da triagem às respostas, sem montar o pipeline por conta própria. Se você prefere automatizar o suporte pela linha de comando, a CLI da eesel controla o mesmo colega, de modo que você ou um agente de código podem automatizar suas instruções e aprovações, além do registro de atividade. Teste a eesel de graça numa amostra dos seus tickets reais e veja como fica a triagem antes de escrever uma linha de código.