

Meu veredito num relance
Eu trabalho na fila de suporte da eesel todo dia, então quando um modelo é lançado eu o leio com uma pergunta em mente: o cliente espera menos ou recebe uma resposta melhor? O Haiku 5.5 é o primeiro Claude pequeno em que a resposta é um sim claro para uma boa fatia dos tickets, e o placar completo está abaixo.
| O que verifiquei | Veredito | O número por trás |
|---|---|---|
| Preço abaixo de 100k tokens | Excelente | $0.10 entrada / $0.50 saída, 90% abaixo do Haiku 4.5 |
| Preço acima de 100k tokens | Medíocre | $0.50 / $2.50, o Luna continua mais barato aqui |
| Inteligência | Melhor da categoria | 43 na AA, contra 38 do GPT-6 Luna |
| Velocidade | Excelente | 137-243 tokens/s na AA, conforme o nível de esforço |
| Programação agêntica | Fraco | 39,2% no Terminal-Bench 4.0 contra 70,6% do Sonnet 5.5 |
| Eficiência de tokens | Ruim com esforço alto | ~162k tokens de saída por tarefa da AA no Max, ~3x o Luna |
| Alucinação | Melhor que os rivais, ainda real | 40% no AA-Omniscience contra 77% do Luna |
| Esforço de migração | Médio | 6 mudanças incompatíveis, incluindo temperature e prefill |
O que é o Claude Haiku 5.5
O Claude Haiku 5.5 é o modelo pequeno e rápido da Anthropic, lançado em 7 de outubro de 2026, com o ID de modelo claude-haiku-5-5. A Anthropic o indica para "high-volume, cost-sensitive tasks" como resumos, compactação, classificação e consultas a bancos de dados, e como subagente do Opus 5.5 e do Sonnet 5.5 em trabalho de programação.
A ficha técnica é um grande salto em relação ao Haiku 4.5. A janela de contexto cresce de 200k para 1M de tokens, a saída máxima vai de 64k para 128k e o corte de conhecimento avança para junho de 2026. Ele também é o primeiro Haiku com esforço ajustável e thinking adaptativo, e esse thinking vem ligado por padrão em Medium.
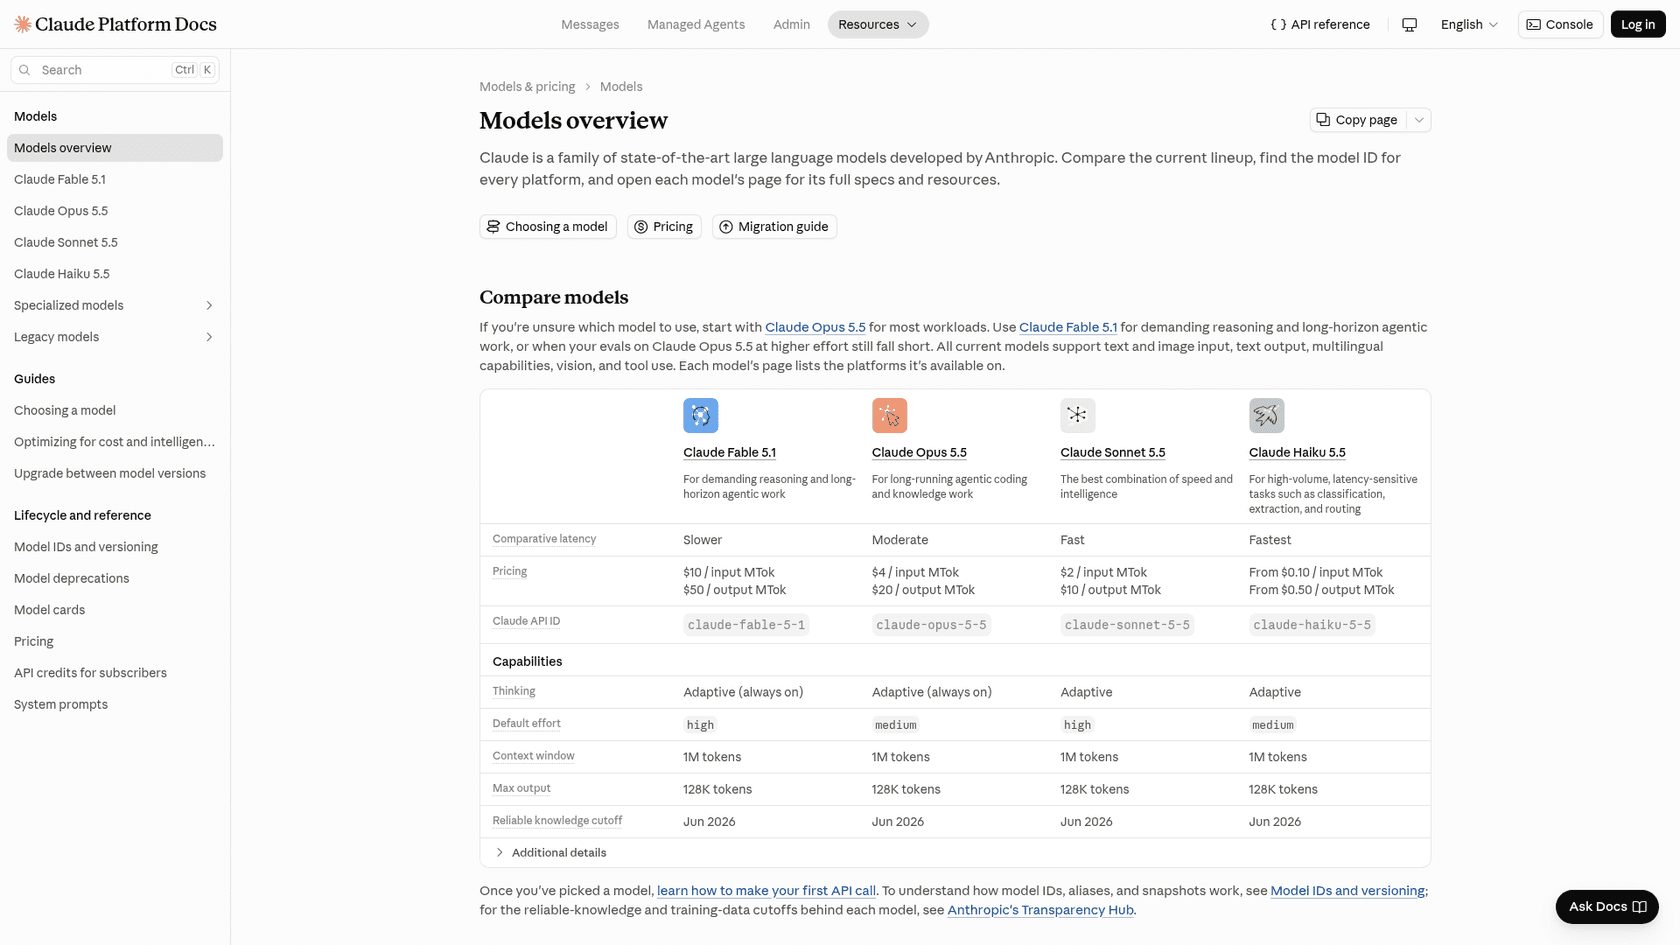
A visão geral de modelos o descreve como o modelo "for high-volume, latency-sensitive tasks such as classification, extraction, and routing." Essa única frase é, acho, um bom resumo de onde ele brilha e onde não.
Onde o Claude Haiku 5.5 é forte
Há muito o que gostar aqui, e os ganhos sobre o Haiku 4.5 não são pequenos, então veja onde ele merece seu lugar.
Fica perto do Sonnet 5.5 na maior parte do trabalho
Nos benchmarks de lançamento da própria Anthropic, o Haiku 5.5 chega a 1620 no GDPval-AA contra 1840 do Sonnet 5.5, e a 72,4% no OSWorld 2.1 contra 83,9%. Para um modelo que custa um vigésimo do preço de entrada do Sonnet, é um resultado impressionante.
| Benchmark | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 (trabalho de conhecimento) | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1 (uso de computador) | 72,4% | 15,7% | 48,9% | 83,9% |
| Humanity's Last Exam, sem ferramentas | 45,9% | 10,2% | n/a | 56,9% |
| Terminal-Bench 4.0 | 39,2% | 0,0% | 16,4% | 70,6% |
| FrontierCode 1.1 | 46,4% | n/a | 42,4% | 52,1% (Xhigh) |
| Chartography, sem ferramentas | 46,4% | 6,4% | 29,1% | 61,6% |
O padrão fica mais claro quando você divide cada pontuação do Haiku pela do Sonnet, que é o que o gráfico abaixo faz.
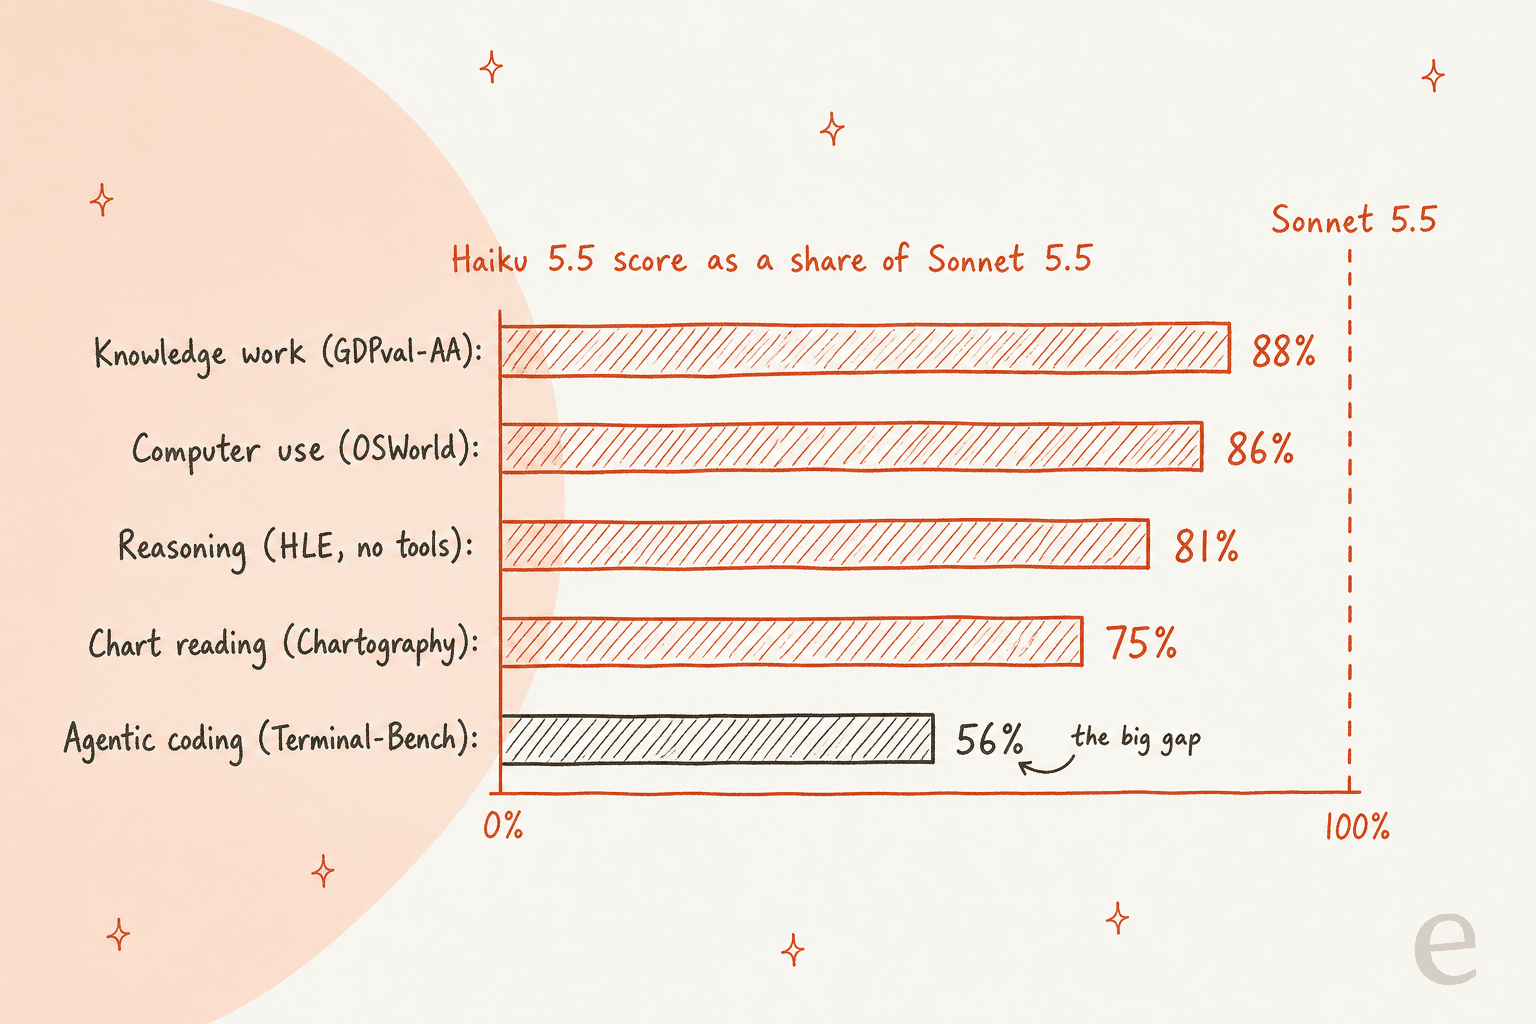
Em trabalho de conhecimento e uso de computador, o Haiku 5.5 entrega 86-88% do Sonnet 5.5. Em programação agêntica, entrega 56%. Essa diferença mostra exatamente quais trabalhos entregar a ele.
Vence o GPT-6 Luna em inteligência e alucinação
A Artificial Analysis coloca o Haiku 5.5 em 43 no Intelligence Index com esforço Max, à frente do GLM-5.3 Flash (42), do Gemini 3.8 Flash (41) e do GPT-6 Luna (38). Ela também viu o Haiku mais disposto a dizer que não sabe, com taxa de alucinação de 40% no AA-Omniscience contra 77% do Luna.
"Haiku 5.5 is noticeably smarter than GPT-6 Luna, so I can see their pricing strategy here. For a while Anthropic has lacked a cost effective "cheap" LLM for summarisation, compacting, RAG helpers, etc."

É rápido
A Anthropic o chama de "our fastest model to date" em velocidade padrão. A Artificial Analysis mediu de 137 a 243 tokens de saída por segundo conforme o esforço, contra 128 do Luna no Max e 90 do Haiku 4.5. Relatos de clientes batem: a Asana viu "over a 30% reduction in latency for task completions" nas avaliações do AI Teammates, e a Box mediu 11 pontos a mais que o Haiku 4.5 "at about half the latency."
Velocidade não é métrica de vaidade em suporte. Um comprador com quem conversei fez uma avaliação metódica de 67 testes de uma solução de chat com IA, achou as respostas sólidas e mesmo assim desistiu porque o widget de chat era, nas palavras dele, "slow and often gets stuck." Uma ótima resposta que chega tarde só parece um produto quebrado.
É forte em trabalho curto e fundamentado
As melhores citações de clientes do lançamento são todas sobre tarefas estreitas e repetidas. A HubSpot relatou 92,8% na sua suíte de avaliação de CRM, "the best score we've seen on this suite yet", com a menor taxa de falsos positivos numa auditoria de registros desatualizados. A AlphaSense viu um salto estatisticamente significativo no seu Q&A de documentos de 8M de chamadas por semana, de 0,76 para 0,84.
A comunidade viu o mesmo em trabalho pesado em recuperação.
"Tested on my RAG system containing all of cloudflare docs (more than 3000 A4 sized highly technical documents): best
quality*speed/priceratio of any other model. And I have tested more than a 100 different models."
Esse é o formato da maioria dos tickets de suporte: você lê alguns artigos de ajuda e o ticket e então responde à pergunta. É também por isso que acho que o Haiku 5.5 importa mais para a classificação de tickets com IA e o resumo de tickets do que para programação.
Funciona como modelo auxiliar
O discurso da própria Anthropic é o Haiku como subagente de um modelo maior, e os primeiros relatos confirmam. A Rogo usa um subagente Haiku 5.5 para extrair uma linha de receita de um 10-K enquanto um modelo maior monta a apresentação. A Cognition diz que seu setup Devin Fusion, com Opus 5.5 como líder e Haiku 5.5 como auxiliar, "holds a top-tier FrontierCode score of 66.2 while cutting cost and latency."
Um testador do Hacker News até viu o modelo delegar sozinho uma construção complexa de UI ao Opus, notando que ele "at least knows what it isn't good at." Se você já usa subagentes do Claude Code, o setup de Haiku no Claude Code é o lugar óbvio para testar primeiro.
Onde o Claude Haiku 5.5 fica a desejar
Nenhum desses pontos é impeditivo sozinho, mas juntos eles decidem se o Haiku 5.5 economiza dinheiro ou custa em silêncio mais do que você planejou.
O penhasco de preço de 100k tokens
Este é o grande. O Haiku 5.5 é o único modelo Claude atual sem preço fixo ao longo da janela de contexto. Segundo a documentação de preços, um prompt acima de 100.000 tokens paga a tarifa mais alta em todas as linhas: entrada, saída e cache.
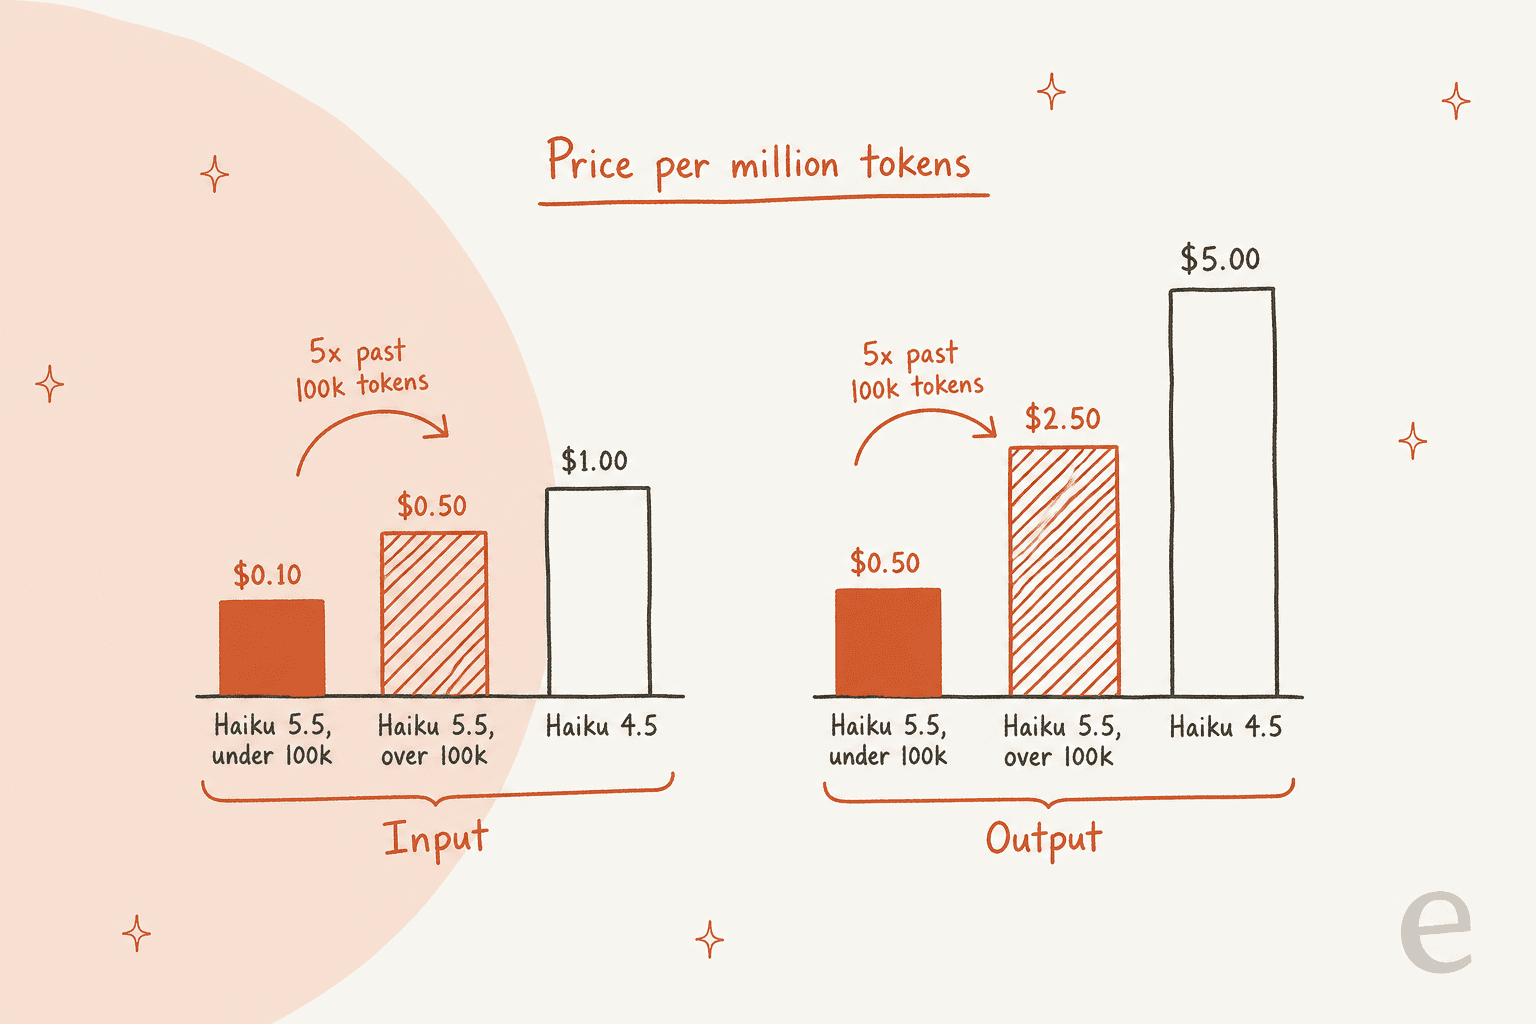
A Anthropic diz que prompts abaixo de 100k são cerca de 90% das requisições ao Haiku anterior, então a maioria dos trabalhos clássicos de Haiku cai na faixa barata. Loops de agentes são outra história, já que o histórico da conversa se acumula rápido.
"100k tokens is an absurdly low cutoff and it is only applicable to Haiku and not Sonnet or Opus. It's a low enough cutoff that it will be quickly exceeded if you are doing anything with Agents; for typical generation or Jev-like classifiers, it's a good value"
O texto de lançamento de Simon Willison enquadra bem o dilema: abaixo de 100k, o Haiku iguala o preço do Luna com pontuações maiores, mas "Above 100,000 tokens, Luna looks like a much better deal." O degrau de preço do próprio Luna vem aos 272k tokens e só sobe para $0.20/$0.75.
Um novo tokenizador adiciona tokens em silêncio
O guia de migração diz que o mesmo texto produz "approximately 30% more tokens than on Haiku 4.5." Simon Willison mediu cerca de 1,25x em um prompt longo e chamou isso de "a hidden price increase." Isso também significa que você chega à linha de 100k antes do que a contagem bruta de caracteres sugere.
Um testador colocou números reais nisso com um trabalho de classificação.
| Modelo | Tokens de entrada | Tokens de saída | Custo em batch | Custo síncrono |
|---|---|---|---|---|
| Haiku 5.5 | 11,893,643 | 240,451 | $0.21 | $0.42 |
| GPT-6 Luna | 7,903,468 | 177,602 | $0.16 | $0.31 |
Esses números vêm de Farmadupe no Hacker News. Mesmo preço por token, mas o Luna saiu cerca de 26% mais barato no mesmo trabalho porque precisou de menos tokens para ler e escrever a mesma coisa.
O esforço Max é uma fornalha de tokens
As configurações de esforço são novidade no Haiku, e o topo é caro. A Artificial Analysis viu o Haiku 5.5 no Max usar cerca de 162k tokens de saída por tarefa do Intelligence Index, cerca de 3x o Luna no Max. O tempo até o primeiro token no Max foi de 415 segundos.
| Esforço | AA Intelligence Index | Custo para rodar o índice | Tokens de saída | Tempo até o primeiro token |
|---|---|---|---|---|
| Low | 29.4 | $34.31 | 32M | 13.6s |
| Medium (padrão) | 34.5 | $56.36 | 54M | 14.2s |
| High | 37.8 | $94.07 | 97M | 26.2s |
| Xhigh | 41.2 | $157.58 | 180M | 86.8s |
| Max | 43.4 | $330.25 | 440M | 415.3s |
Ir do Medium ao Max soma 9 pontos por quase 6x o custo. A Artificial Analysis também observa que esses custos ainda não incluem o degrau de preço de 100k, então tarefas longas ficarão mais caras do que a tabela diz. O teste do pelicano de Simon Willison mostra o mesmo em miniatura: o Low levou 7 segundos e custou 0,0936 centavo, e o Max levou 5 minutos e 9 segundos.
Para chat ao vivo, vale testar nos seus próprios tickets o tempo até o primeiro token do Medium nesse benchmark (cerca de 14 segundos), já que o thinking adaptativo roda antes de a resposta começar. A documentação diz que esforço menor deixa o modelo pular o thinking em pedidos simples, e o thinking ainda pode ser desligado em High ou abaixo.
Ainda erra fatos quando não tem nada para ler
A system card da Anthropic é franca nisso. No teste sem consulta AA-Omniscience, o Haiku 5.5 acertou 44%, errou 32% e se absteve em 24%. É melhor que o Haiku 4.5 no saldo, mas uma taxa de erro de mais ou menos um em cada três em perguntas que ele não pode consultar é justamente o motivo pelo qual um modelo de suporte precisa da sua base de conhecimento à frente.
A system card também aponta que ele recusou pedidos em excesso mais do que qualquer outro modelo na auditoria automatizada de comportamento, e a Artificial Analysis diz que sua pontuação de 35% no AutomationBench é "likely understated" por causa de um problema de recusa excessiva pré-lançamento que a Anthropic está corrigindo.
Suas próprias avaliações podem discordar
Nem todos tiveram bons testes no primeiro dia, e acho que vale ouvir isso antes de virar uma chave em produção.
"At work we use haiku 4.5 for a handful of latency sensitive tasks that are fairly simple. It performs well. Just started testing 5.5 as I've been anticipating a nice improvement since it was teased. Results so far are trash. Prompt leakage even. And it's slower."
Um segundo comentarista respondeu que as avaliações e os testes humanos pareados dele também colocaram o Haiku 4.5 em primeiro, e que ele estava retrabalhando os prompts por isso. O Haiku 4.5 continua listado como ativo, com aposentadoria não antes de 15 de outubro de 2026, então há uma janela para rodar os dois lado a lado.
O que quebra na migração
A página de novidades lista várias mudanças incompatíveis. Para bots de suporte e classificadores, estas são as que mordem.
| Mudança | O que acontece agora | A correção |
|---|---|---|
| Orçamentos manuais de thinking | budget_tokens retorna 400 | Use thinking adaptativo mais effort |
| Parâmetros de amostragem | Qualquer top_k, ou temperature diferente de 1, retorna 400 | Remova; conduza pelo prompt |
| Prefill do assistente | Retorna 400, mesmo com thinking desligado | Termine messages com um turno de usuário |
| Histórico somente de acréscimo | Editar system, ferramentas ou turnos anteriores e depois reenviar o thinking retorna 400 | Mantenha o histórico somente de acréscimo |
| Ferramenta de uso de computador | computer_20250124 é rejeitada na API e no Google Cloud | Migre para computer_toolset_20260801 |
| Tokenizador | ~30% mais tokens para o mesmo texto | Recalcule max_tokens e orçamentos |
A mudança de temperature é a traiçoeira para suporte. Muitos pipelines de triagem de tickets rodam com temperature 0 para rótulos consistentes, e essa requisição agora falha de vez. O prefill é o outro truque comum (muitas vezes usado para forçar uma chave de abertura JSON), e isso também acabou.
O tool_choice forçado continua funcionando, o que é uma boa notícia depois que o Sonnet 5.5 o removeu. A pegadinha é que uma chamada de ferramenta forçada volta sem bloco de thinking, segundo o guia de migração. Se você quer que o modelo raciocine antes de chamar sua ferramenta de reembolso ou de roteamento, use auto e diga isso no prompt.
Preços do Claude Haiku 5.5 em uma tabela
Aqui está a tabela completa de tarifas da documentação de preços do Claude, com o Haiku 4.5 e o Sonnet 5.5 como referência. Todos os preços são por milhão de tokens.
| Tarifa | Haiku 5.5, até 100k | Haiku 5.5, acima de 100k | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|---|
| Entrada | $0.10 | $0.50 | $1.00 | $2.00 |
| Saída | $0.50 | $2.50 | $5.00 | $10.00 |
| Escrita em cache de 5 minutos | $0.125 | $0.625 | $1.25 | $2.50 |
| Escrita em cache de 1 hora | $0.20 | $1.00 | $2.00 | $4.00 |
| Leitura de cache | $0.01 | $0.05 | $0.10 | $0.10 |
| Batch entrada / saída | $0.05 / $0.25 | $0.25 / $1.25 | $0.50 / $2.50 | $1.00 / $5.00 |
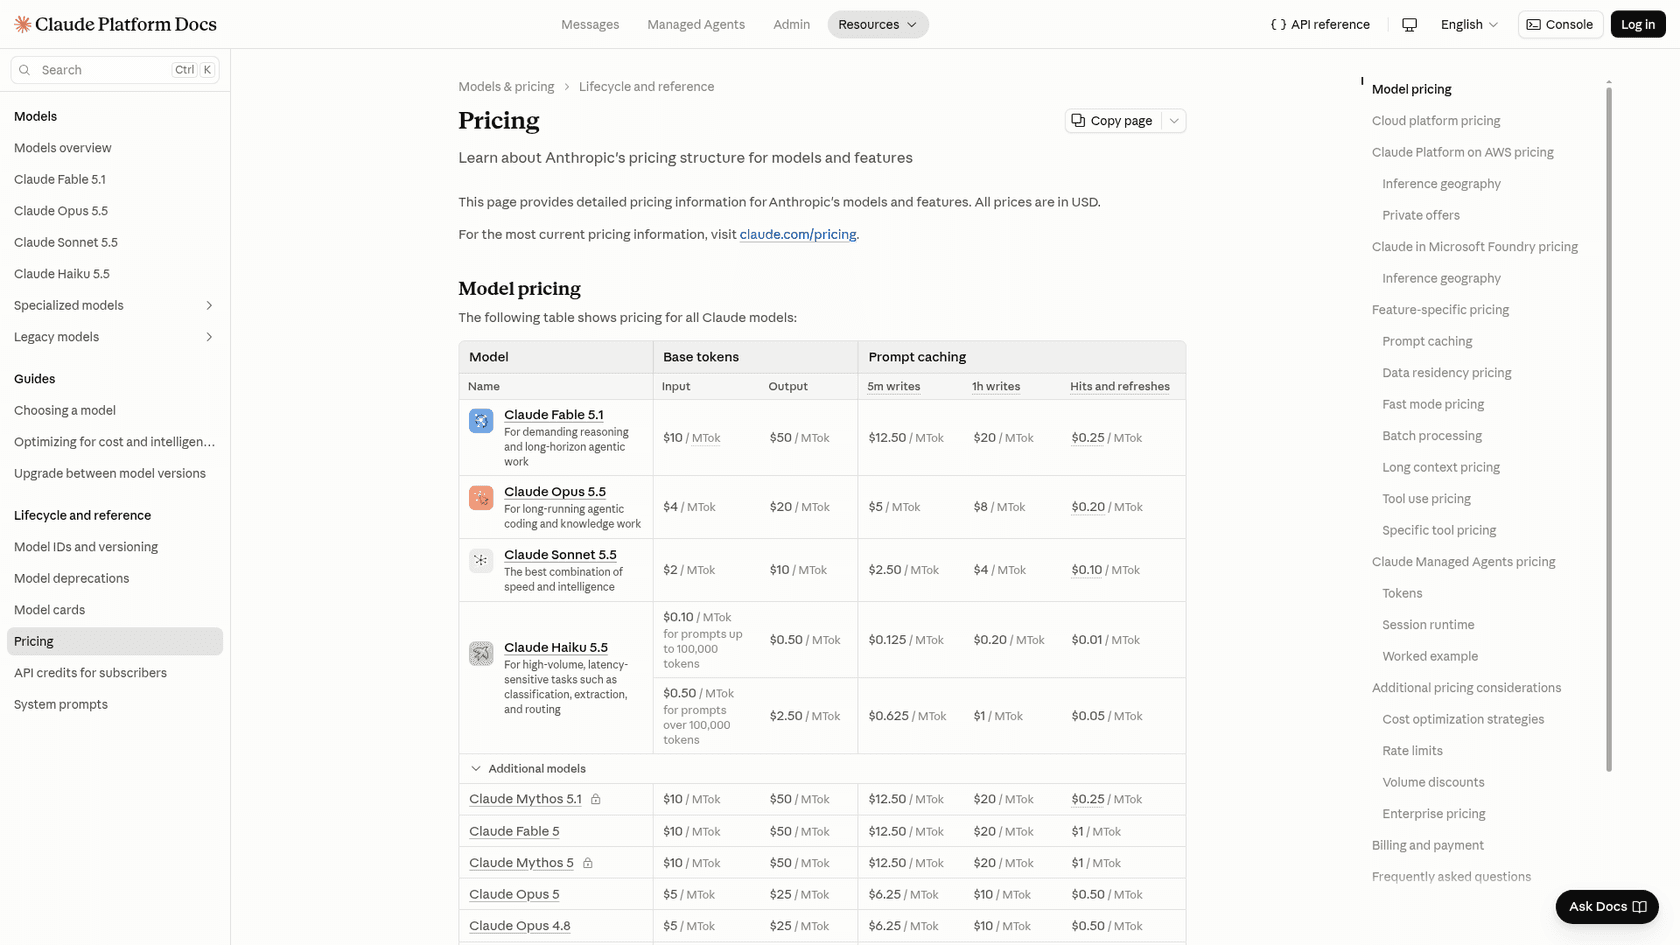
Para deixar concreto, pegue uma resposta de suporte com prompt de 8.000 tokens (instruções, alguns artigos de ajuda e o ticket) e 600 tokens de saída, thinking incluído. No Haiku 5.5, são cerca de $0.0011 por ticket, ou aproximadamente $11 por 10.000 tickets. Se a mesma conversa crescer para um prompt de 150.000 tokens, só a entrada custa $0.075, cinco vezes o que custaria abaixo da linha. Não há modo Fast para o Haiku 5.5, e a Anthropic também cortou pela metade as leituras de cache do Sonnet 5.5 para $0.10 no mesmo dia, o que reduz a diferença para agentes que dependem muito de cache. Meu guia de preços do Sonnet 5.5 cobre esse lado.
Como eu usaria numa fila de suporte
O jeito como eu rodaria o Haiku 5.5 em suporte decorre bem diretamente dos pontos fortes e dos penhascos acima. Deixe que ele faça o trabalho rápido, curto e de alto volume em todo ticket e passe os difíceis para cima.
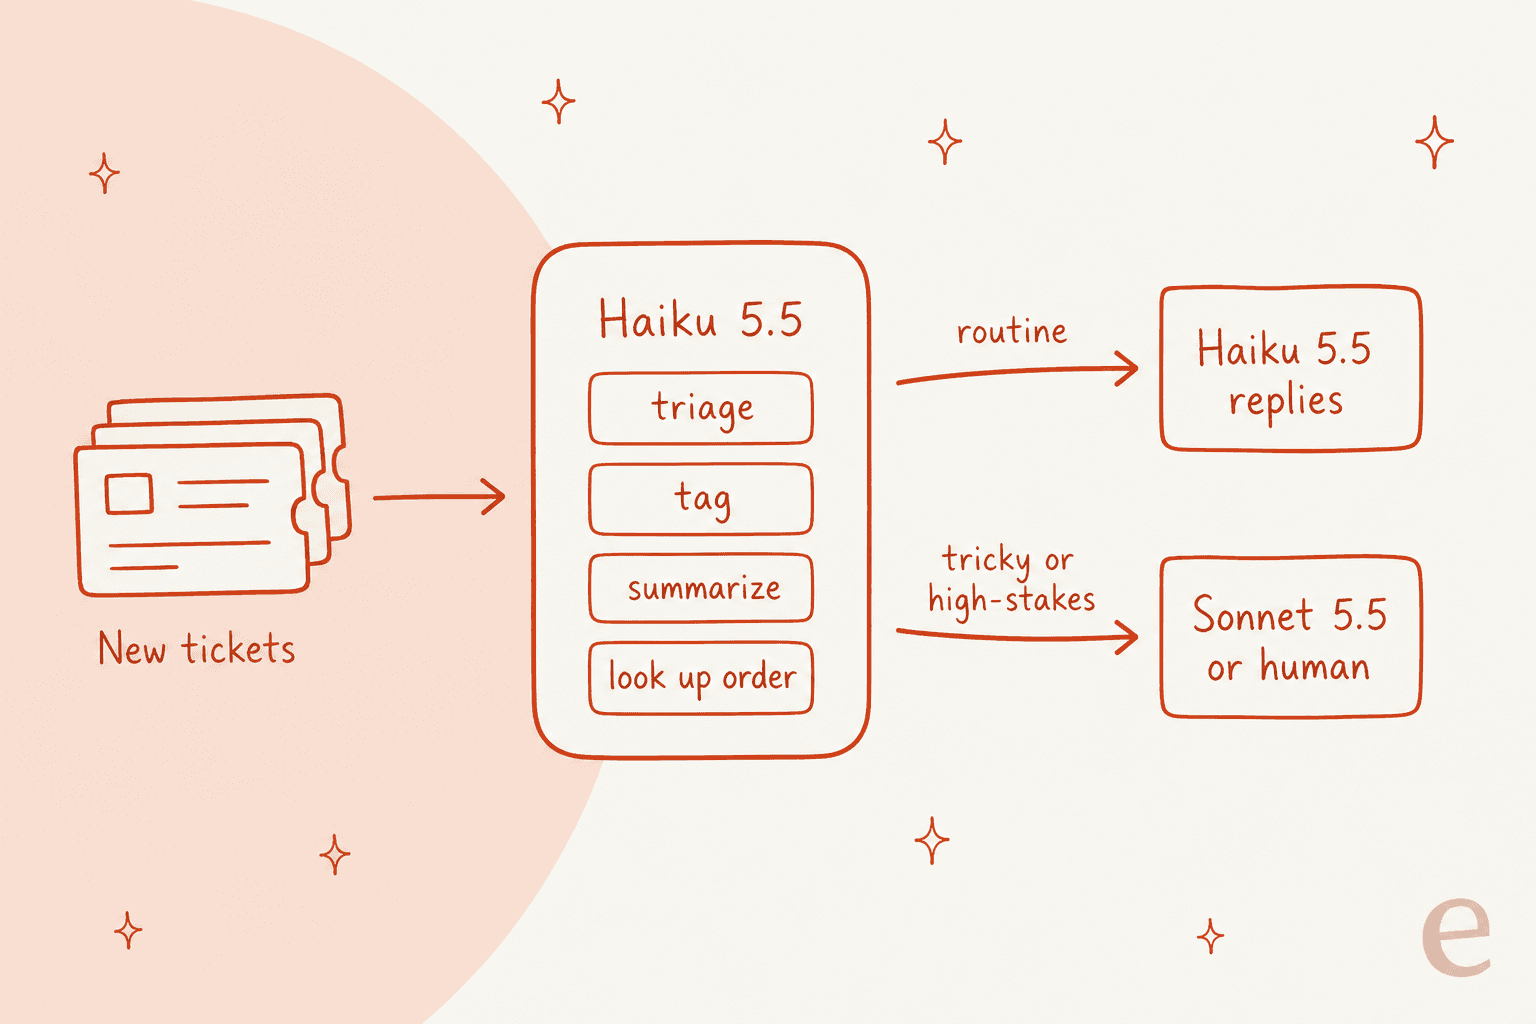
Na prática, isso significa:
- Triagem e etiquetagem com esforço Low. Prompts curtos, uma lista fixa de rótulos, sem histórico longo. É o trabalho para o qual a faixa de 100k foi feita, e serve também para a priorização de tickets.
- Resumos e notas de repasse com Medium. Rápido o bastante para rodar em todo ticket sem ninguém notar o custo.
- Respostas de rotina, baseadas na sua central de ajuda. Status de pedido, redefinição de senha, prazos de devolução. Mantenha o contexto recuperado enxuto para o prompt ficar abaixo de 100k.
- Escale o resto. Disputas de reembolso, solução de problemas em várias etapas e qualquer coisa com thread longa vão para o Sonnet 5.5 ou para uma pessoa.
É mais ou menos assim também que um teste real parece quando dá certo. Num teste de e-commerce com tráfego real do Zendesk, a triagem foi o trabalho mais forte da IA, com 93% de precisão e 100% de detecção de spam, enquanto rascunhos completos precisaram de mais ajuda das respostas anteriores da própria equipe. Um modelo pequeno e rápido combina bem com esse primeiro trabalho, acho.
O que os desenvolvedores estão dizendo
O thread de lançamento no Hacker News passou de 770 pontos e 380 comentários, e a reação se dividiu por uma linha: quem tinha trabalhos curtos e bem delimitados adorou, e quem rodava sessões longas de agentes fez a conta do penhasco de 100k.
"Ran our DataAnalyticsBench benchmark on it: 9x cheaper than Haiku 4.5 and 2 letter grades better. It's also now the fastest model (using the default speeds, not trying any of the other models "Fast" mode) to complete the exam."
O mesmo testador acrescentou que ele deu conta de toda pergunta direta de analytics, mas ficou aquém nas que exigiam escavação estatística mais profunda, e que o GPT-6 Luna foi um pouco melhor, a cerca de 30% do custo.
"With that said, the real reason to use Haiku is that it's faster than all of these models. OpenRouter is showing an average so far of 93 tokens/sec, and AA got at least 137 in each of their benchmarks. So it might be valuable for speed at lower thinking levels."
"noticeably smarter remains to be seen in practice. For now, Haiku is a bit more expensive than Luna on < 100k token, but I just don't have any agentic work below 100k, so this is going to be 5x more expensive than shown on these charts."
A equipe da Artificial Analysis resumiu como "notably fast, however very verbose", o que combina com tudo acima.
Quem deve trocar e quem deve esperar
Eis como eu decidiria, pelo trabalho e não pelo gráfico de benchmarks.
| Você está rodando | Minha decisão | Por quê |
|---|---|---|
| Classificação, etiquetagem, roteamento | Troque, depois de uma avaliação curta | Faixa mais barata, modelo mais rápido, prompts pequenos |
| Respostas RAG sobre uma central de ajuda | Troque, mantenha prompts abaixo de 100k | Bons resultados fundamentados, janela de 1M se precisar |
| Subagentes sob um líder Sonnet ou Opus | Troque | O caso de uso que a Anthropic e os primeiros clientes apontam |
| Loops longos de agentes além de 100k tokens | Espere ou escolha o Luna | Degrau de preço de 5x mais o tokenizador mais pesado |
| Programação agêntica complexa | Fique no Sonnet 5.5 | 39,2% contra 70,6% no Terminal-Bench 4.0 |
| Pipelines que dependem de temperature 0 ou prefill | Reserve tempo de migração | Ambos retornam erro 400 agora |
Se você está comparando com opções de fora, meus textos sobre alternativas ao GPT-6 Luna, Gemini 3.8 Flash e Kimi K3 cobrem o resto do campo de modelos pequenos e médios.
Para suporte especificamente, o guia sobre qual LLM serve para suporte vai mais longe.
Um modelo mais rápido não corrige uma resposta errada
Uma coisa que uma análise de modelo não consegue mostrar é que a maioria das falhas de bots de suporte que eu vejo não tem nada a ver com o modelo. Uma equipe B2B de telemática veicular descobriu que o bot dizia aos clientes que suportava marcas de carro que não estavam no banco de dados. O modelo não estava inventando nada, para ser justo. A base de conhecimento deles dizia que suportavam "all models", e o bot acreditou. O Haiku 5.5 teria dado a mesma resposta errada, só que mais rápido e mais barato.
É por isso que todo rollout da eesel é simulado com tickets históricos antes de o colega falar com um cliente. Essa etapa é onde você pega as lacunas de conhecimento que nenhuma troca de modelo resolve, e com um modelo que erra 32% dos fatos sem consulta isso importa ainda mais.
Experimente a eesel com modelos Claude rápidos na sua fila
Se o que você quer do Haiku 5.5 é a velocidade nos seus tickets, a eesel é o atalho. O colega de helpdesk com IA entra no seu helpdesk atual, como Zendesk, Freshdesk ou Gorgias, aprende com seus tickets anteriores e sua central de ajuda, e faz triagem, etiqueta e responde com um modelo de fronteira por baixo. O penhasco de 100k, o ajuste de esforço, as mudanças incompatíveis acima, tudo isso vira problema da eesel e não seu.

Se você vive num terminal, a CLI da eesel opera o mesmo colega e o mesmo workspace do painel. Você pode automatizá-la com scripts ou deixar um agente de programação como o Claude Code controlá-la, que é o mesmo padrão de líder e auxiliar desta análise aplicado ao seu setup de suporte.
Meus textos sobre a CLI de agentes de IA e os servidores MCP aprofundam mais.
Os planos pagos começam em $299 por 500 créditos, e você pode testar de graça antes com uma parte dos seus tickets reais. Experimente a eesel e veja se um modelo mais rápido realmente aparece como respostas mais rápidas para seus clientes.
O Claude Haiku 5.5 vale a pena?
Sim, se o seu trabalho é curto e repetitivo. Abaixo de 100k tokens de prompt e com esforço Low ou Medium, o Claude Haiku 5.5 é o melhor modelo pequeno que já vi da Anthropic: mais inteligente que o GPT-6 Luna pelo mesmo preço de tabela e mais rápido que qualquer outro que a Anthropic vende, e fica perto o bastante do Sonnet 5.5 em trabalho de conhecimento para assumir uma grande fatia de uma fila de suporte.
Passando de qualquer uma das duas linhas, a conta se inverte: sessões longas de agentes pagam 5x, o esforço Max queima tokens e o novo tokenizador faz as duas coisas chegarem mais cedo. Rode sua própria avaliação contra o Haiku 4.5 enquanto ele ainda está disponível, mantenha os prompts enxutos e deixe os modelos maiores cuidarem do que o Haiku 5.5 repassar.