

Por que as pessoas procuram alternativas ao Claude Haiku 5.5
Começo pela boa notícia, porque o Haiku 5.5 a merece. O Claude Haiku 5.5 foi lançado em 7 de outubro de 2026, pontua 43 no Intelligence Index da Artificial Analysis, à frente de todos os outros modelos pequenos deste post, gera 243 tokens por segundo e, abaixo de 100.000 tokens de prompt, custa $0.10 de entrada e $0.50 de saída por milhão. Cobri tudo isso na minha análise do Haiku 5.5.
Eu escrevo a infraestrutura de API na eesel, então leio lançamentos como esse pelo lado da integração. As perguntas que faço são o que quebra, quanto custa com uma carga real e o que preciso reescrever. Com base nessas checagens, vejo quatro motivos pelos quais uma equipe pode decidir que o Haiku 5.5 não é o seu modelo.
- O precipício dos 100k. Segundo a documentação de preços do Claude, um prompt acima de 100.000 tokens paga $0.50 de entrada e $2.50 de saída, mais 5x em leituras e escritas de cache. O Haiku 5.5 é o único modelo Claude atual sem preço fixo em toda a sua janela de 1M.
- O tokenizador. A página de novidades diz que o mesmo texto produz "approximately 30% more tokens" que no Haiku 4.5. Você paga por mais tokens e chega à linha dos 100k mais cedo.
- Mudanças de API que quebram. Qualquer
temperature,top_poutop_kfora do padrão agora retorna erro, assim como o prefill do assistente. Muitos classificadores foram construídos exatamente sobre esses dois truques, por isso esta dói. - Verbosidade. A Artificial Analysis contou 440M de tokens gerados em seu índice para o Haiku 5.5 contra 140M do GPT-6 Luna. Mesmo preço de tabela e, depois, uma conta cerca de 3x maior pelo mesmo trabalho.
Para ser justo, o Hacker News fez a conta dos prompts longos uma hora depois do lançamento.
"noticeably smarter remains to be seen in practice. For now, Haiku is a bit more expensive than Luna on < 100k token, but I just don't have any agentic work below 100k, so this is going to be 5x more expensive than shown on these charts."

Então a alternativa certa depende de qual desses quatro atingiu você, e este é o mapa que eu uso.
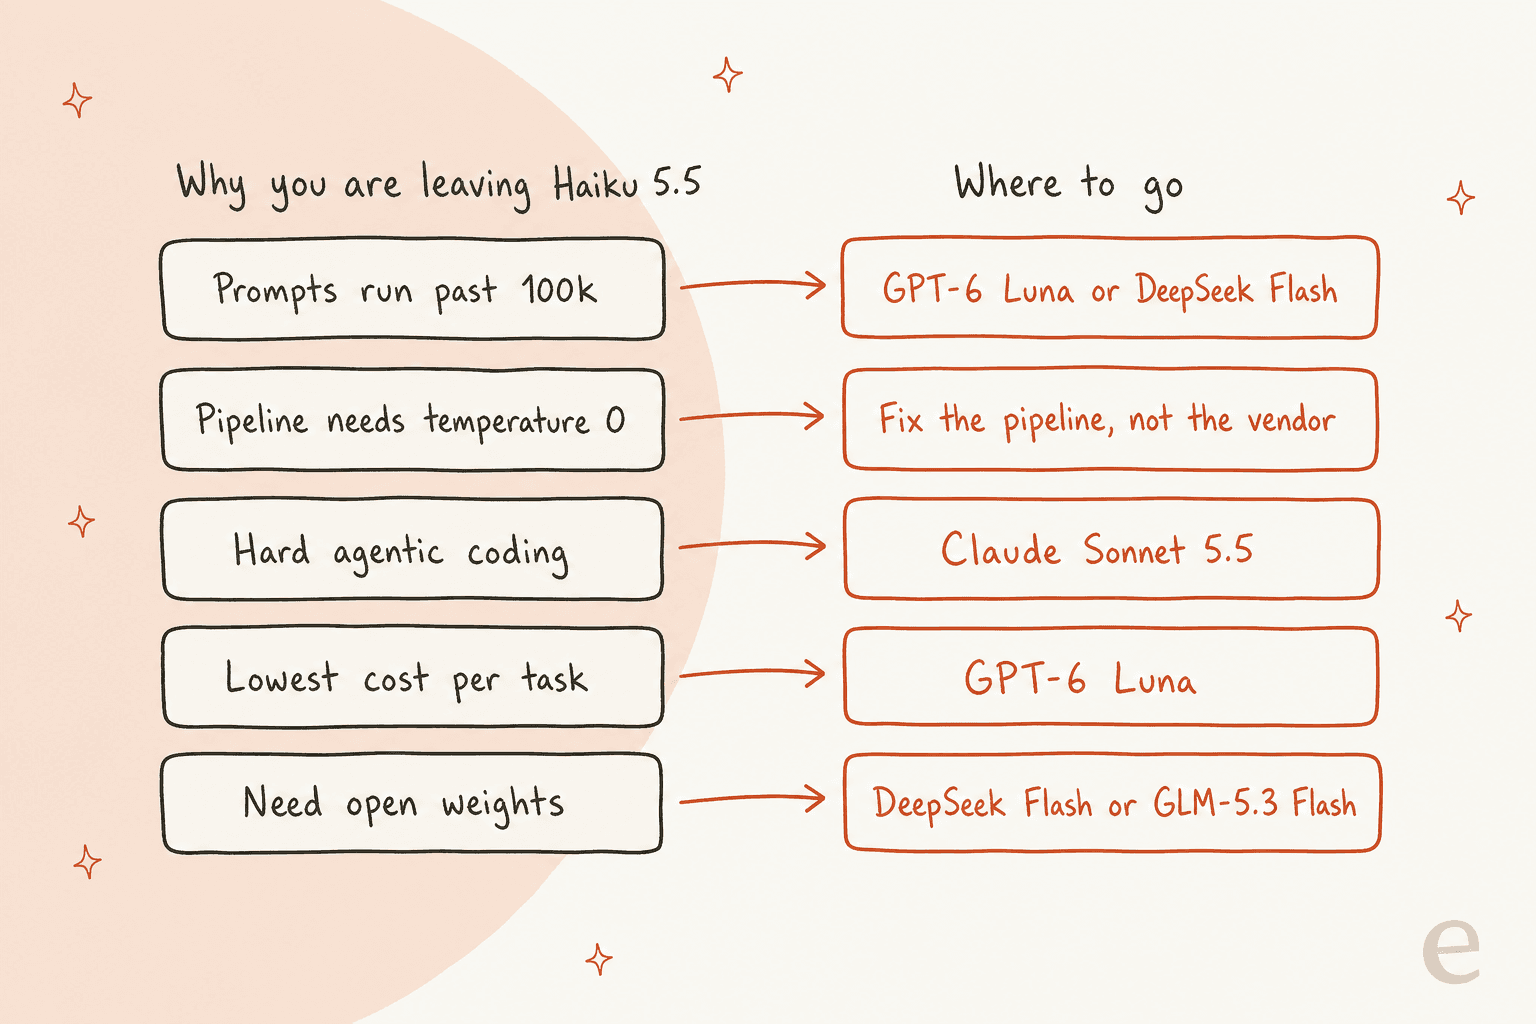
Alternativas ao Claude Haiku 5.5 num relance
Todos os preços abaixo são por milhão de tokens em tarifas padrão, conferidos na página de preços de cada fornecedor em 8 de outubro de 2026. As colunas da Artificial Analysis (AA) usam o Intelligence Index v4.3.2 no nível de esforço que a AA informa.
| Modelo | Entrada / saída | Regra de prompt longo | Contexto | Índice AA | Custo AA por tarefa | Velocidade de saída | Temperature 0 | Pesos abertos | Melhor para |
|---|---|---|---|---|---|---|---|---|---|
| Claude Haiku 5.5 (referência) | $0.10 / $0.50 | 5x em cada linha acima de 100k | 1M | 43 | $0.21 | 243 tok/s | Erro | Não | Trabalhos curtos, inteligentes e rápidos |
| GPT-6 Luna | $0.10 / $0.50 | 2x entrada, 1.5x saída acima de 272k | 1.05M | 38 | $0.07 | 128 tok/s | Só com esforço none | Não | Menor custo por tarefa |
| Claude Haiku 4.5 | $1 / $5 | Fixo | 200k | n/d | n/d | n/d | Funciona | Não | Ganhar tempo com prompts antigos |
| Claude Sonnet 5.5 | $2 / $10 | Fixo | 1M | 56 (max) | $7.60 (max) | n/d | Erro | Não | Raciocínio e programação difíceis |
| DeepSeek V4.1 Flash | $0.30 / $1.20 no pico, metade fora do pico | Fixo | 1M | 39 | $0.27 (pico) | n/d | Ignorado no modo thinking | Sim, MIT | Prompts longos com orçamento enxuto |
| GLM-5.3 Flash | $0.15 / $0.50 | Fixo | 1M | 42 | $0.25 | 51 tok/s | Thinking sempre ligado | Sim | Pesos abertos perto da pontuação do Haiku |
| Gemini 3.5 Flash-Lite | $0.30 / $2.50 | Fixo | 1M | 22 | $0.19 | 346 tok/s | O Google aconselha 1.0 | Não | Vazão bruta |
| Gemini 3.8 Flash | $0.75 / $3.75 (dobra em 1º jan. 2027) | Fixo | 1M | 41 (high) | $1.24 | n/d | O Google aconselha 1.0 | Não | Tarefas longas de agentes no stack do Google |
Uma observação sobre a coluna de velocidade: "n/d" significa que eu não tinha uma leitura da AA do mesmo dia em que confiasse, não que o modelo seja lento.
Como escolhi estes
Limitei a lista a modelos para os quais um usuário do Haiku 5.5 poderia realmente migrar esta semana: de disponibilidade geral, com preço público e na mesma faixa de pequeno e rápido, mais um degrau acima (Sonnet 5.5) e um para trás (Haiku 4.5). Conferi cada preço na página do próprio fornecedor, cada comportamento de API na documentação do fornecedor e cada benchmark na Artificial Analysis, em vez de gráficos de lançamento.
A métrica em que mais me apoio é o custo por tarefa concluída, não o preço por token. Haiku 5.5 e Luna têm preços por token idênticos, mas contas muito diferentes, e essa é a história toda desta faixa.
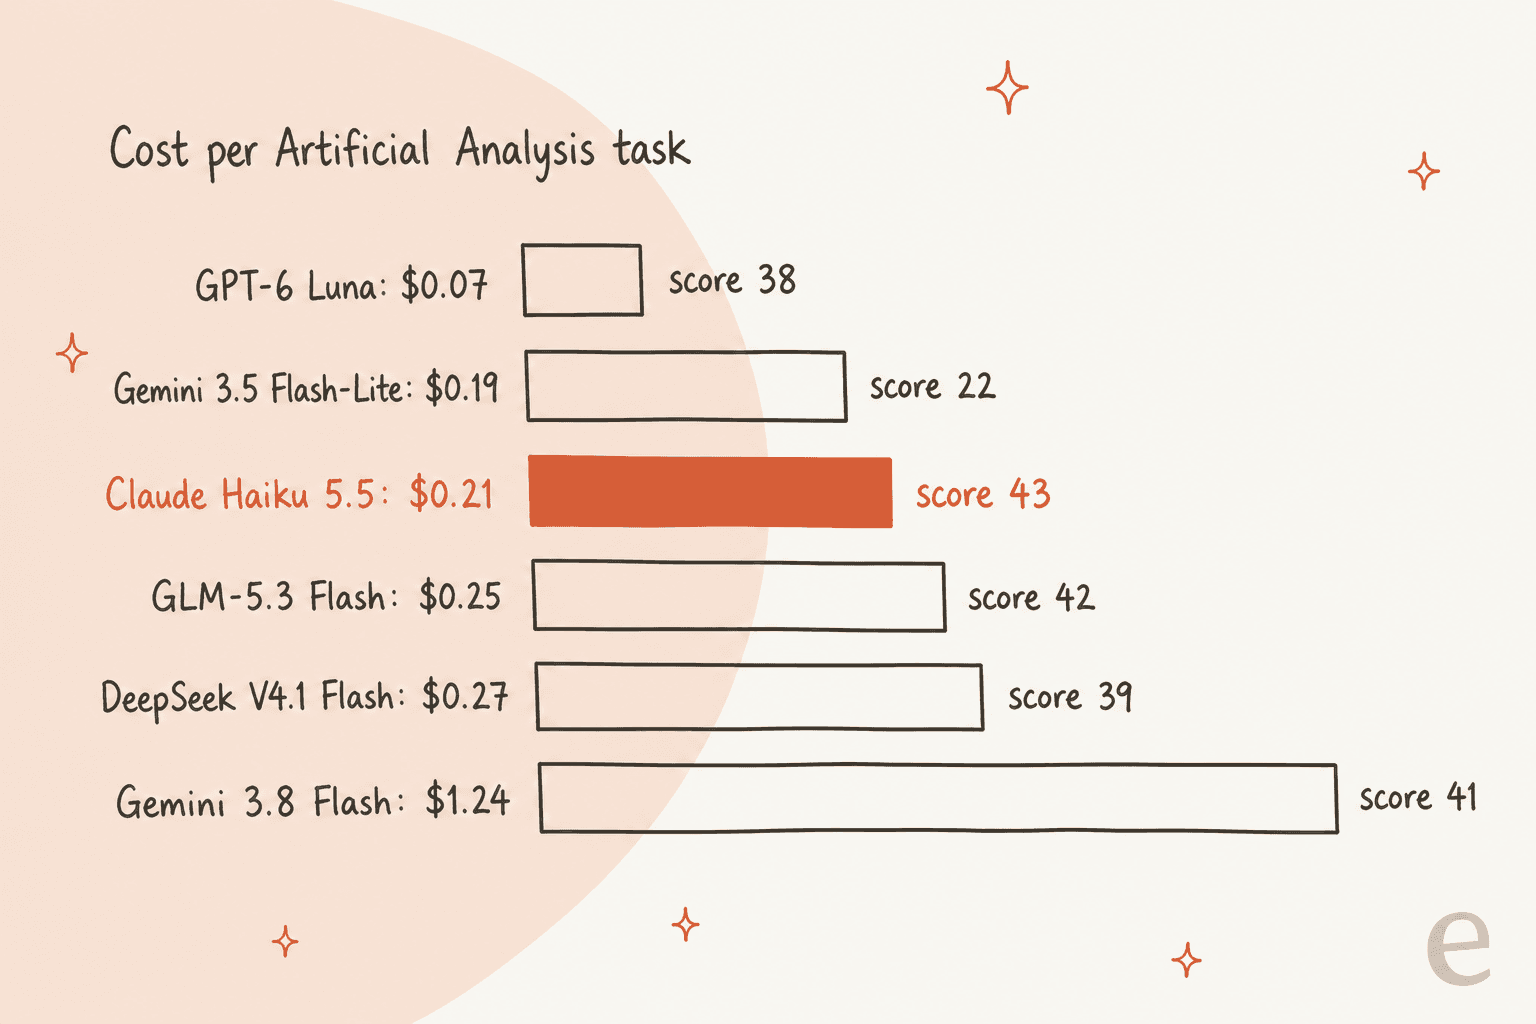
Leia esse gráfico como uma troca, não como um ranking. O Haiku 5.5 dá 5 pontos de índice a mais que o Luna por 3x o custo por tarefa. Se isso vale a pena depende de sua tarefa ser do tipo em que esses 5 pontos aparecem.
1. GPT-6 Luna
Melhor para: equipes que querem preços de Haiku sem o precipício dos 100k, e a menor conta por trabalho concluído.
O que ele faz melhor que o Haiku 5.5
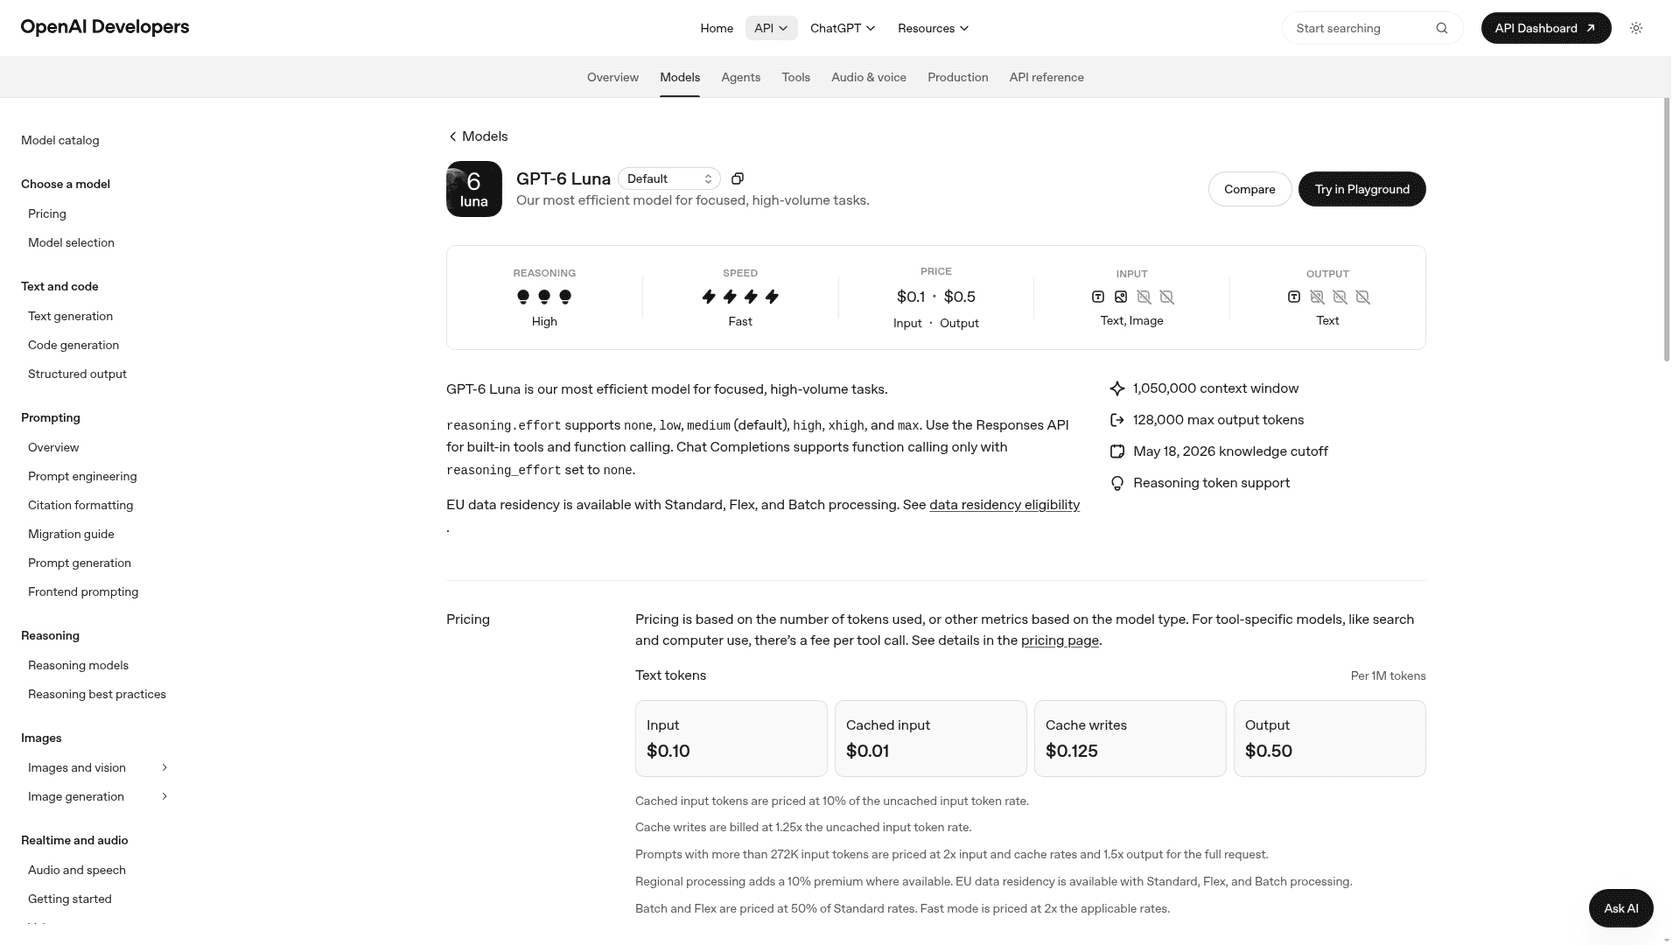
O Luna é o modelo com cujo preço o Haiku 5.5 foi alinhado, e ele ganha em duas coisas que importam nas contas reais. A primeira é que sua regra de contexto longo é bem mais branda. A página do modelo diz que prompts acima de 272K tokens de entrada pagam 2x na entrada e no cache e 1.5x na saída, o que dá $0.20 de entrada e $0.75 de saída. O Haiku 5.5 sobe aos 100k, e por 5x.
A segunda é que ele escreve menos, o que aparece rápido na conta. A AA colocou o Luna em 140M de tokens em seu índice contra os 440M do Haiku, e em $0.07 por tarefa contra $0.21. Um testador do Hacker News rodou o mesmo trabalho de classificação nos dois e achou o Luna cerca de 26% mais barato com preço por token idêntico. Os tokenizadores também importam:
"There's also a tokenizer efficiency difference: modern Claude's 100K tokens are about ~60-65K modern GPT tokens, so in reality the Luna cutoff is much further away than the Haiku one."
Onde ele deixa a desejar
O Luna pontua 38 na AA contra 43 do Haiku, e o teste de alucinação da AA mostra a lacuna maior: 77% para o Luna contra 40% para o Haiku 5.5, segundo minha análise do Haiku. Ele também é mais lento, com 128 tokens de saída por segundo, e isso importa no uso ao vivo. E a API tem seu próprio senão. O guia do modelo mais recente da OpenAI diz que, quando o esforço de raciocínio não é none, você deve remover temperature e top_p, e o Chat Completions só aceita function calling com esforço none. Para ferramentas com raciocínio, usa-se a Responses API.
Preços
| Tarifa | Até 272K de entrada | Acima de 272K de entrada |
|---|---|---|
| Entrada | $0.10 | $0.20 |
| Entrada em cache | $0.01 | $0.02 |
| Saída | $0.50 | $0.75 |
| Batch / Flex entrada / saída | $0.05 / $0.25 | $0.10 / $0.375 |
Fonte: preços da API da OpenAI. O guia de preços do Luna explica o modo Fast e as tarifas regionais.
Minha opinião
Sinceramente, esta é a troca padrão. Se seu uso do Haiku 5.5 cruza 100k tokens com regularidade, ou se você se importa mais com o custo por tarefa do que com os últimos pontos de qualidade, mude para cá. Fique no Haiku se suas avaliações mostram esses 5 pontos extras (ou a menor taxa de alucinação) aparecendo na sua tarefa real. Meu post sobre as alternativas ao GPT-6 Luna faz a comparação pelo outro lado.
2. Claude Haiku 4.5
Melhor para: pipelines que dependem de temperature: 0, prefill ou orçamentos de thinking manuais, enquanto você os reescreve.
O que ele faz melhor que o Haiku 5.5
Nada em benchmarks, mas o que ele faz melhor é não quebrar seu código. O Haiku 4.5 ainda aceita os parâmetros de amostragem, o prefill e o budget_tokens que o Haiku 5.5 rejeita, seu preço é fixo em toda a janela de 200k e seu tokenizador mais antigo conta menos tokens para o mesmo texto. Algumas equipes também simplesmente gostam da saída dele no trabalho específico delas.
"Not really. We use Haiku 4.5 to turn users' natural language queries and requests into fairly complex structured specs for interior design and construction. It has near perfect accuracy."
Onde ele deixa a desejar
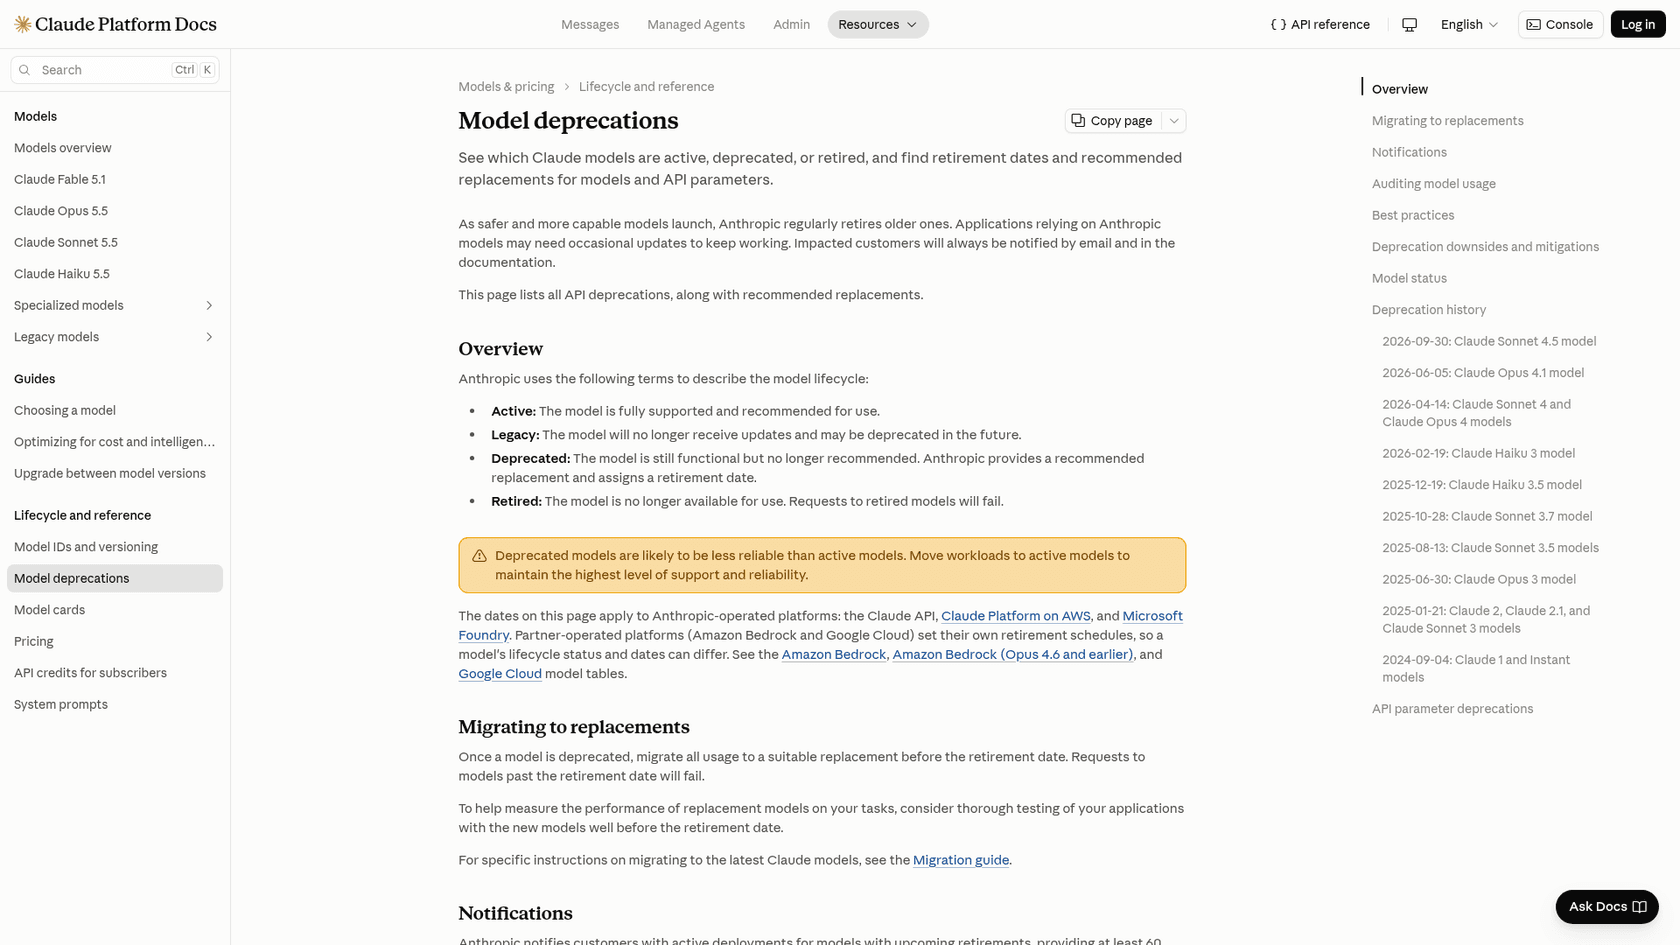
Ele custa 10x o preço por token do Haiku 5.5 abaixo de 100k ($1 / $5 contra $0.10 / $0.50), e a lacuna de capacidade é enorme: o OSWorld 2.1 foi de 15.7% para 72.4% entre os dois. O problema maior é o tempo. A página de desativações lista claude-haiku-4-5-20251001 como Active, com desativação "Not sooner than October 15, 2026". Isso é um piso, não uma data marcada, e a Anthropic diz que avisa os clientes antes de uma desativação. Então construir qualquer coisa nova nele é uma aposta contra o calendário.
Preços
| Tarifa | Claude Haiku 4.5 |
|---|---|
| Entrada / saída | $1 / $5 |
| Escrita de cache 5 minutos / 1 hora | $1.25 / $2 |
| Leitura de cache | $0.10 |
| Batch entrada / saída | $0.50 / $2.50 |
Fonte: documentação de preços do Claude. O guia de preços da API da Anthropic cobre toda a linha.
Minha opinião
Use como ponte: mantenha o pipeline antigo rodando no 4.5 enquanto migra os rótulos para saídas estruturadas e depois rode os dois modelos lado a lado nos mesmos tickets. Não comece nada novo aqui.
3. Claude Sonnet 5.5
Melhor para: as tarefas que o Haiku 5.5 passa para cima, especialmente programação agêntica e trabalho longo de várias etapas.
O que ele faz melhor que o Haiku 5.5
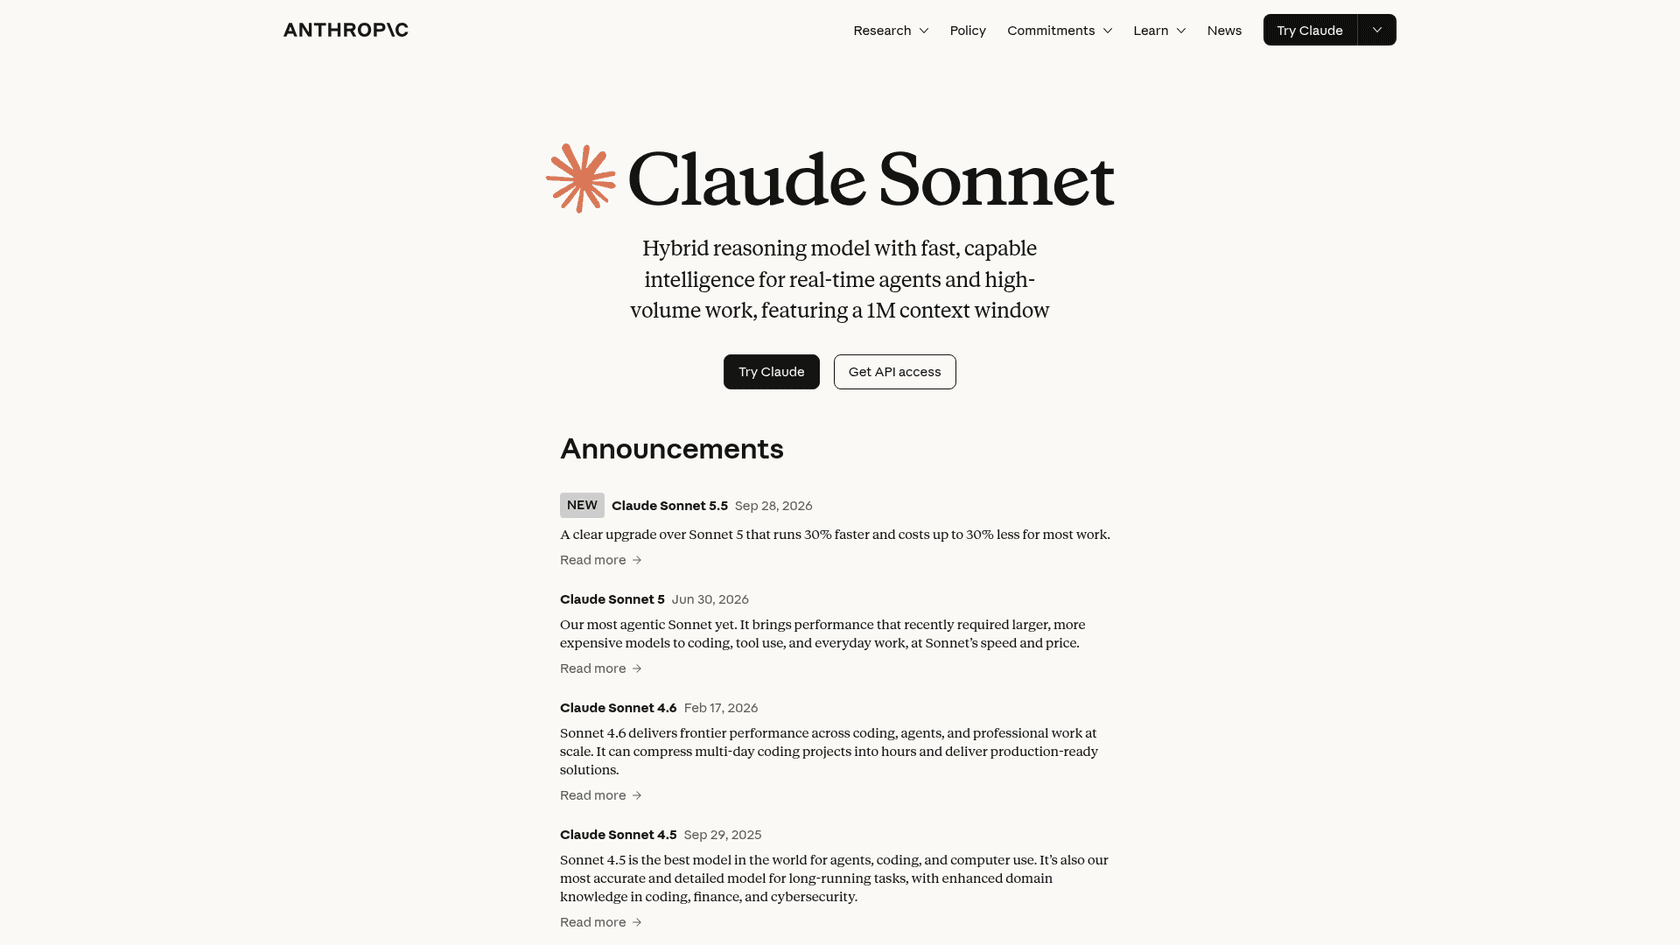
A lacuna é maior exatamente onde o Haiku é mais fraco, que é a programação. Nos benchmarks de lançamento da Anthropic, o Sonnet 5.5 pontua 70.6% no Terminal-Bench 4.0 contra 39.2% do Haiku 5.5. Em trabalho de conhecimento a lacuna é pequena (1840 contra 1620 no GDPval-AA), o que mostra onde vale pagar pelo Sonnet. O Claude Sonnet 5.5 também tem preço fixo em toda a janela de 1M, e a Anthropic reduziu pela metade suas leituras de cache para $0.10 no dia de lançamento do Haiku.
Onde ele deixa a desejar
Ele custa 20x o Haiku 5.5 por token abaixo de 100k ($2 / $10), e tem as mesmas restrições de amostragem e prefill mais algumas próprias, como rejeitar tool_choice forçado. Em termos de custo, o nível de esforço também pesa muito: a AA mediu $7.60 por tarefa em esforço máximo, e por isso minha análise do Sonnet 5.5 recomenda Medium para a maior parte do trabalho.
Preços
| Tarifa | Claude Sonnet 5.5 |
|---|---|
| Entrada / saída | $2 / $10 |
| Escrita de cache 5 minutos / 1 hora | $2.50 / $4 |
| Leitura de cache | $0.10 |
| Batch entrada / saída | $1 / $5 |
Fonte: documentação de preços do Claude. O post sobre os preços do Sonnet 5.5 calcula contas reais por nível de esforço.
Minha opinião
Não substitua o Haiku pelo Sonnet, encaminhe para ele. Mantenha o trabalho curto e de alto volume em um modelo pequeno e mande programação e investigação longa de problemas um nível acima, e também tudo que for de alto risco. Se as manias do próprio Sonnet 5.5 forem o impedimento, meu post sobre as alternativas ao Sonnet 5.5 cobre essa faixa.
4. DeepSeek V4.1 Flash
Melhor para: prompts longos e trabalhos em lote com orçamento apertado, com pesos abertos como reserva.
O que ele faz melhor que o Haiku 5.5
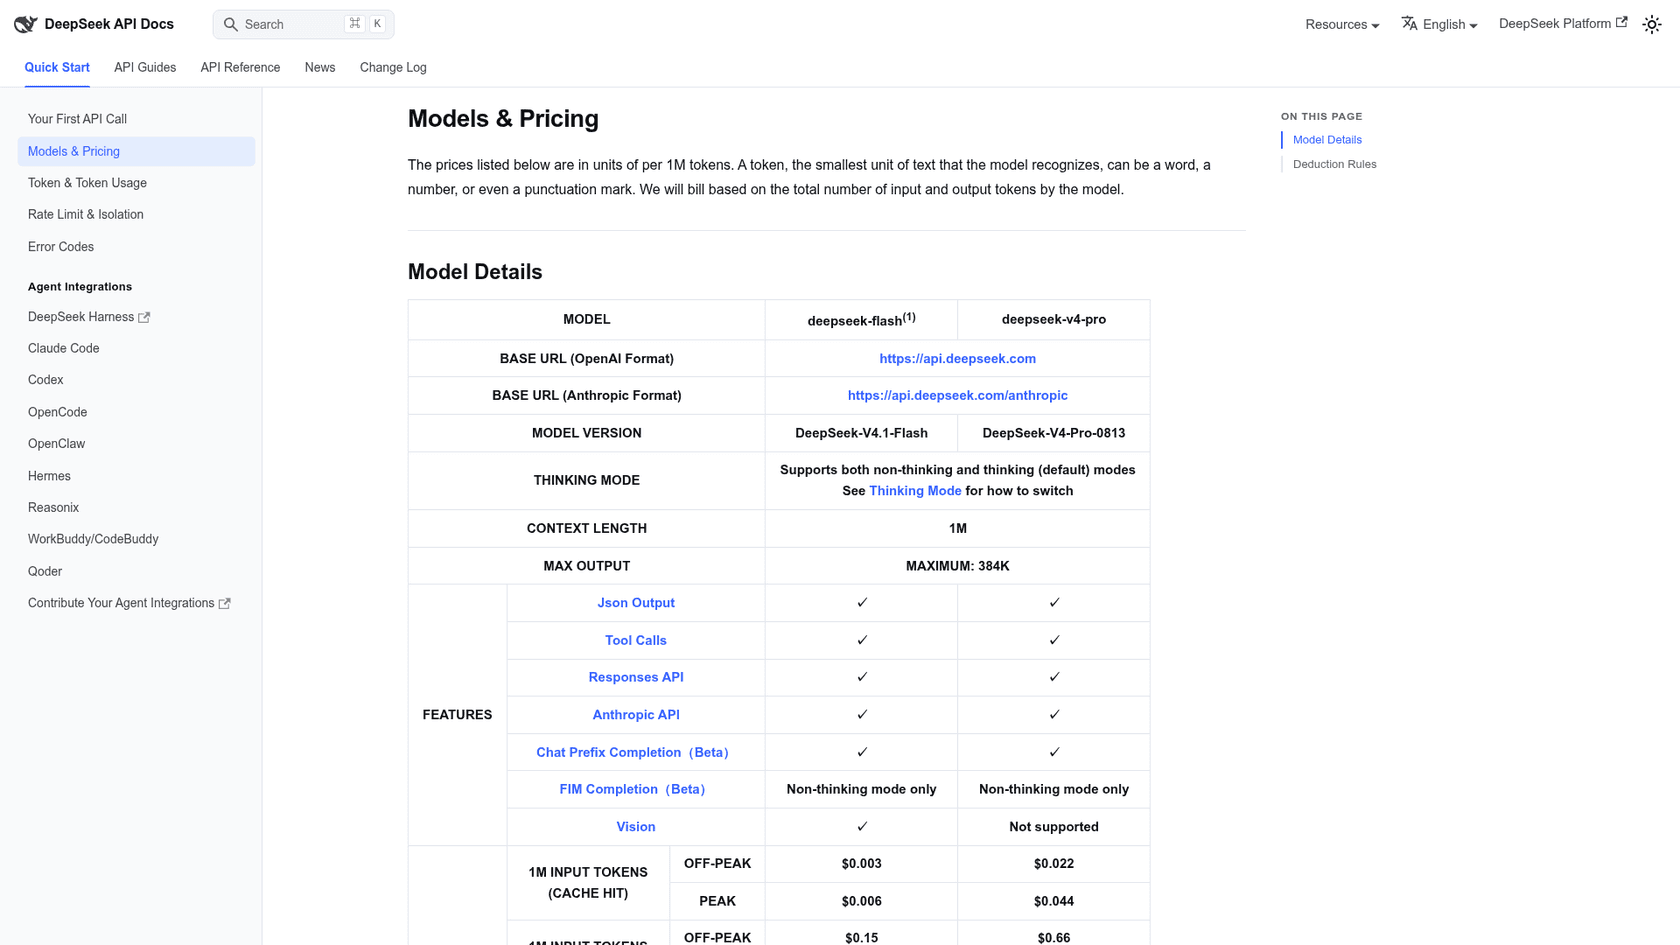
Sem precipício de preço. O DeepSeek V4.1 Flash cobra a mesma tarifa do primeiro ao milionésimo token, e fora do pico são $0.15 de entrada e $0.60 de saída. Acertos de cache custam $0.003 fora do pico, um terço dos $0.01 do Haiku. Então, com um prompt de 150.000 tokens, a entrada do DeepSeek fora do pico custa $0.0225 enquanto o Haiku 5.5 custa $0.075.
Ele também fala o formato de API da Anthropic, o que significa que apontar uma integração Claude existente para ele é basicamente trocar a URL base, e suporta chat prefix completion (prefill, nos termos da Anthropic) em beta. Os pesos estão no Hugging Face sob licença MIT.
Onde ele deixa a desejar
Dois senões. O preço no pico é o dobro, e o horário de pico é de 01:00 a 04:00 e de 06:00 a 10:00 UTC em dias úteis, que é a manhã de trabalho europeia. E no modo thinking, o guia do modo thinking do DeepSeek diz que temperature "will not trigger an error but will also have no effect", então o mesmo problema de rótulos determinísticos segue você aqui, só que em silêncio. A AA o pontua com 39, quatro pontos abaixo do Haiku.
Preços
| Tarifa | Fora do pico | Pico |
|---|---|---|
| Entrada, cache miss | $0.15 | $0.30 |
| Entrada, cache hit | $0.003 | $0.006 |
| Saída | $0.60 | $1.20 |
Fonte: preços do DeepSeek. Meu post sobre os preços do V4.1 Flash cobre a conta do horário de pico.
Minha opinião
A escolha para trabalho em lote de contexto longo onde o precipício dos 100k mais dói, como resumir históricos longos de tickets durante a noite. Verifique antes a residência de dados e as regras de fornecedores da sua empresa, pois algumas equipes não podem enviar dados de clientes a uma API sediada na China, e hospedar os pesos abertos por conta própria é a saída.
5. GLM-5.3 Flash
Melhor para: equipes que querem um modelo de pesos abertos pontuando a um ponto do Haiku 5.5.
O que ele faz melhor que o Haiku 5.5
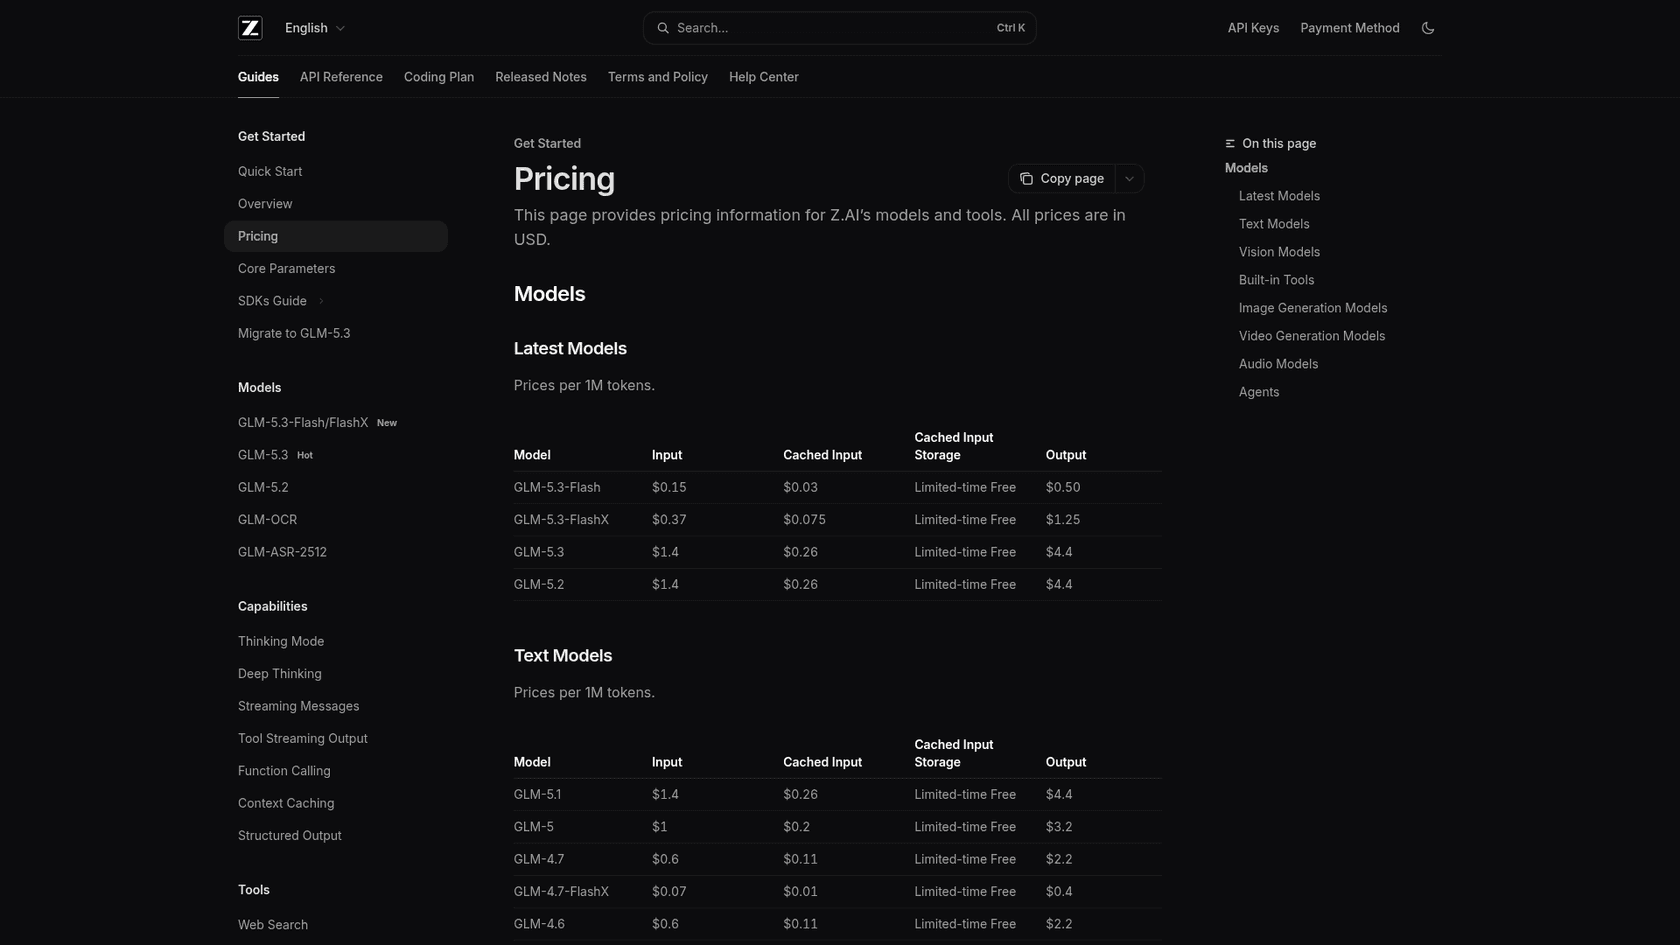
Pontuação por dólar sem precipício. O GLM-5.3 Flash pontua 42 na Artificial Analysis, um ponto abaixo do Haiku 5.5, a $0.15 de entrada e $0.50 de saída fixos numa janela de 1M. O preço de saída iguala a faixa barata do Haiku, e você nunca paga o degrau de 5x. Os pesos são públicos no Hugging Face, então dá para rodá-lo no seu próprio hardware ou por um host de terceiros.
Alguns desenvolvedores já o usam como seu modelo barato do dia a dia:
"Not me, I use GLM-5.3-Flash for almost everything (the subscription-subsidized pricing on a legacy Z.ai plan makes it the best value model by a wide margin), along with some MiMo and DeepSeek."
Onde ele deixa a desejar
A velocidade é o problema. A AA mede 51 tokens de saída por segundo na API própria, contra 243 do Haiku 5.5, então ele serve mal para qualquer coisa que uma pessoa espera. O thinking também não pode ser desligado: a página do modelo diz "thinking.type only supports enabled", e a Z.ai recomenda temperature: 1. A entrada também é $0.15 contra $0.10 do Haiku, então prompts muito curtos e pesados em entrada custam um pouco mais.
Preços
| Tarifa | GLM-5.3 Flash | GLM-5.3 FlashX |
|---|---|---|
| Entrada | $0.15 | $0.37 |
| Entrada em cache | $0.03 | $0.075 |
| Saída | $0.50 | $1.25 |
Fonte: preços da Z.AI. Minha análise do GLM-5.3 Flash e o post de preços aprofundam.
Minha opinião
A melhor resposta de pesos abertos ao Haiku 5.5 em qualidade e uma escolha forte para trabalhos em segundo plano, embora eu o evitasse em chat ao vivo, onde a velocidade aparece. O post sobre as alternativas ao GLM-5.3 Flash cobre seus vizinhos.
6. Gemini 3.5 Flash-Lite
Melhor para: trabalhos simples de volume muito alto onde a vazão vale mais que a inteligência.
O que ele faz melhor que o Haiku 5.5
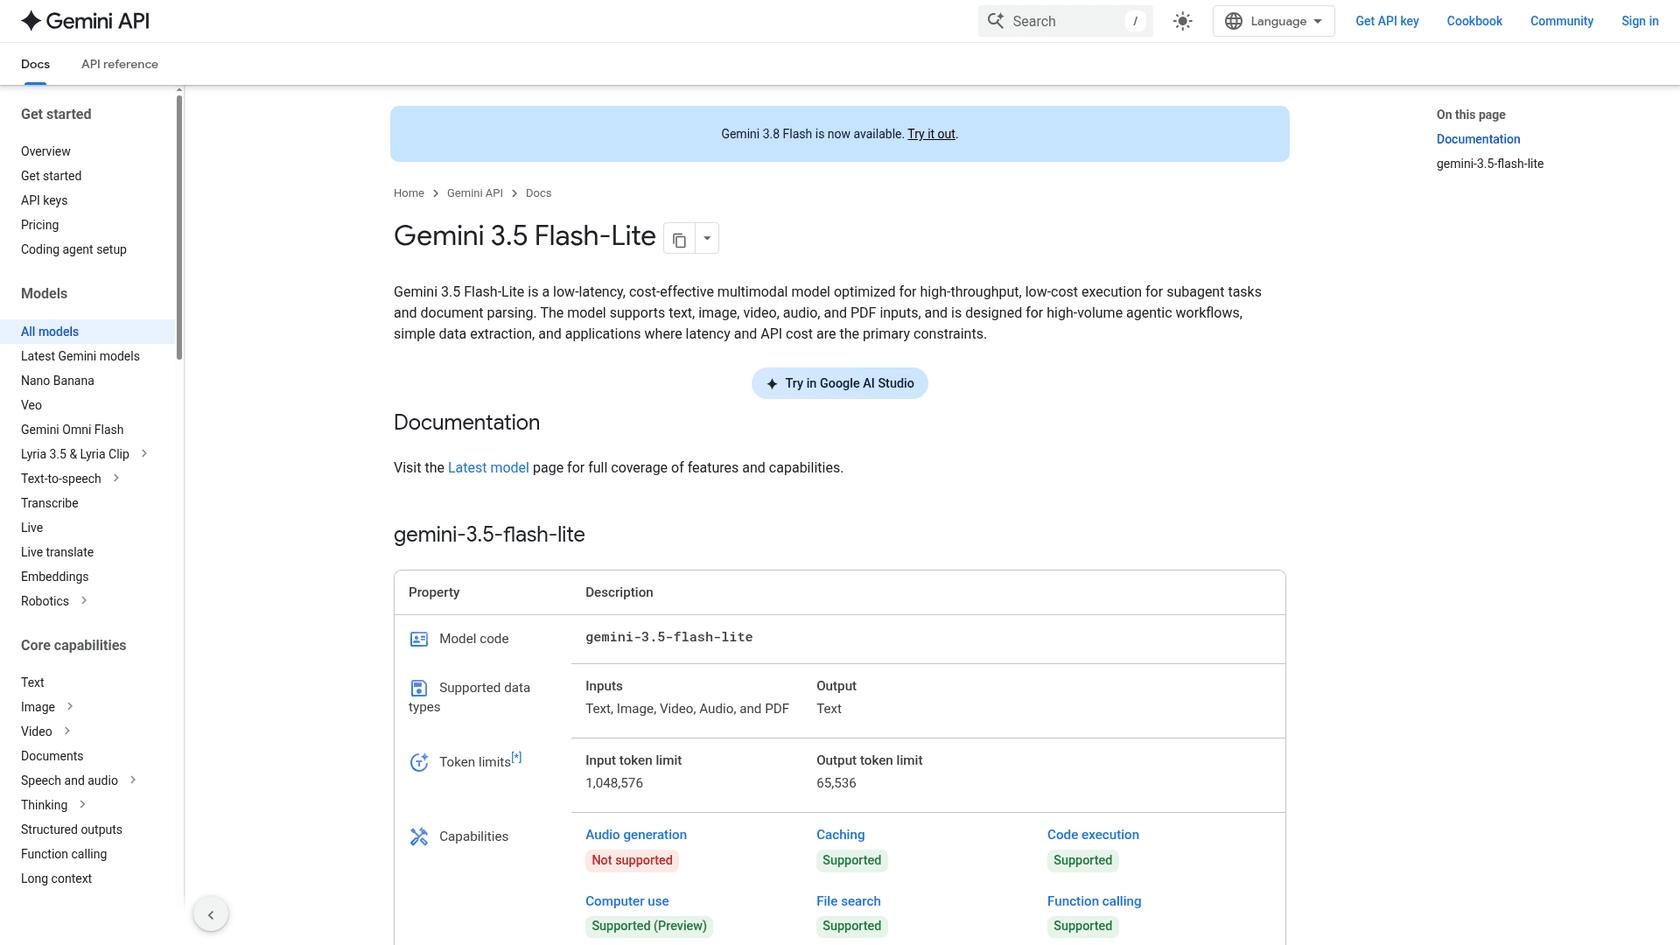
É o modelo mais rápido daqui, com 346 tokens de saída por segundo na Artificial Analysis, e o menos prolixo: 59M de tokens no índice da AA contra os 440M do Haiku. O preço é fixo em sua janela de 1M, aceita texto, imagem, vídeo, áudio e PDF como entrada, e o Google também oferece um nível gratuito para testes. O Gemini 3.5 Flash-Lite foi feito para análise, marcação e roteamento em escala.
Onde ele deixa a desejar
A inteligência é a lacuna. Ele pontua 22 na AA, cerca de metade dos 43 do Haiku 5.5, e seu custo por tarefa ($0.19) acaba perto do do Haiku de qualquer forma porque seu preço de saída é $2.50, cinco vezes a faixa barata do Haiku. A saída máxima é de 65.536 tokens. E o guia do Gemini 3 do Google recomenda fortemente manter a temperature em 1.0 para todos os modelos Gemini 3, alertando que valores mais baixos podem causar "looping or degraded performance".
Preços
| Tarifa | Gemini 3.5 Flash-Lite |
|---|---|
| Entrada / saída | $0.30 / $2.50 |
| Cache de contexto | $0.03, mais armazenamento |
| Nível gratuito | Sim |
Fonte: preços da API do Gemini. O post sobre os preços do Flash-Lite cobre os níveis batch e prioritário.
Minha opinião
Use-o para a etapa mais boba e de maior volume de um pipeline, como detecção de idioma ou filtro de spam, e mantenha-o longe de qualquer coisa que exija julgamento. Sinceramente, para a maioria dos usuários do Haiku 5.5 é um passo atrás, não para o lado.
7. Gemini 3.8 Flash
Melhor para: tarefas longas de agentes para equipes que já estão no Google Cloud, onde o raciocínio extra do modelo compensa.
O que ele faz melhor que o Haiku 5.5
Preço fixo em uma janela de 1M e um bom desempenho em trabalho agêntico longo, além de toda a caixa de ferramentas do Google (grounding com busca, um nível gratuito, Vertex AI). O Gemini 3.8 Flash pontua 41 na AA com esforço alto, perto do Haiku 5.5, e é a escolha natural se seus dados e contratos já vivem no Google Cloud.
Onde ele deixa a desejar
Principalmente custo e tempo de espera. A AA o coloca em $1.24 por tarefa, cerca de 6x o Haiku 5.5, e o preço na página de preços do Google dobra em 1º de janeiro de 2027, de $0.75/$3.75 para $1.50/$7.50. A AA também mediu 13.3 segundos até o primeiro token no lançamento, o que minha análise do Gemini 3.8 Flash aponta como problema para qualquer coisa que um cliente esteja vendo. O conselho sobre temperature é o mesmo do Flash-Lite: deixe em 1.0.
Preços
| Tarifa | Até 31 dez. 2026 | A partir de 1º jan. 2027 |
|---|---|---|
| Entrada | $0.75 | $1.50 |
| Saída, thinking incluso | $3.75 | $7.50 |
| Leitura de cache | $0.075 | $0.15 |
| Batch entrada / saída | $0.375 / $1.875 | $0.75 / $3.75 |
Fonte: preços da API do Gemini. O post sobre os preços do Gemini 3.8 Flash traz o nível prioritário.
Minha opinião
Não é um substituto equivalente do Haiku. É um modelo mais caro para trabalho de agente mais pesado, o que significa que a mudança de preço de janeiro o torna pior custo-benefício no ano que vem. Se você quer a opção do Google, orce já pela tarifa de 2027. O post sobre as alternativas ao Gemini 3.8 Flash cobre essa faixa.
O problema do temperature 0 segue você
Este é o motivo que mais vejo quando as equipes explicam por que estão trocando, e por isso ganha sua própria seção. O Haiku 5.5 retorna erro para qualquer temperature fora do padrão, e muitos pipelines de triagem de tickets foram construídos com temperature 0 para rótulos consistentes, mais prefill para forçar uma chave de abertura JSON.
Então o incômodo é que o resto da faixa barata se moveu na mesma direção.
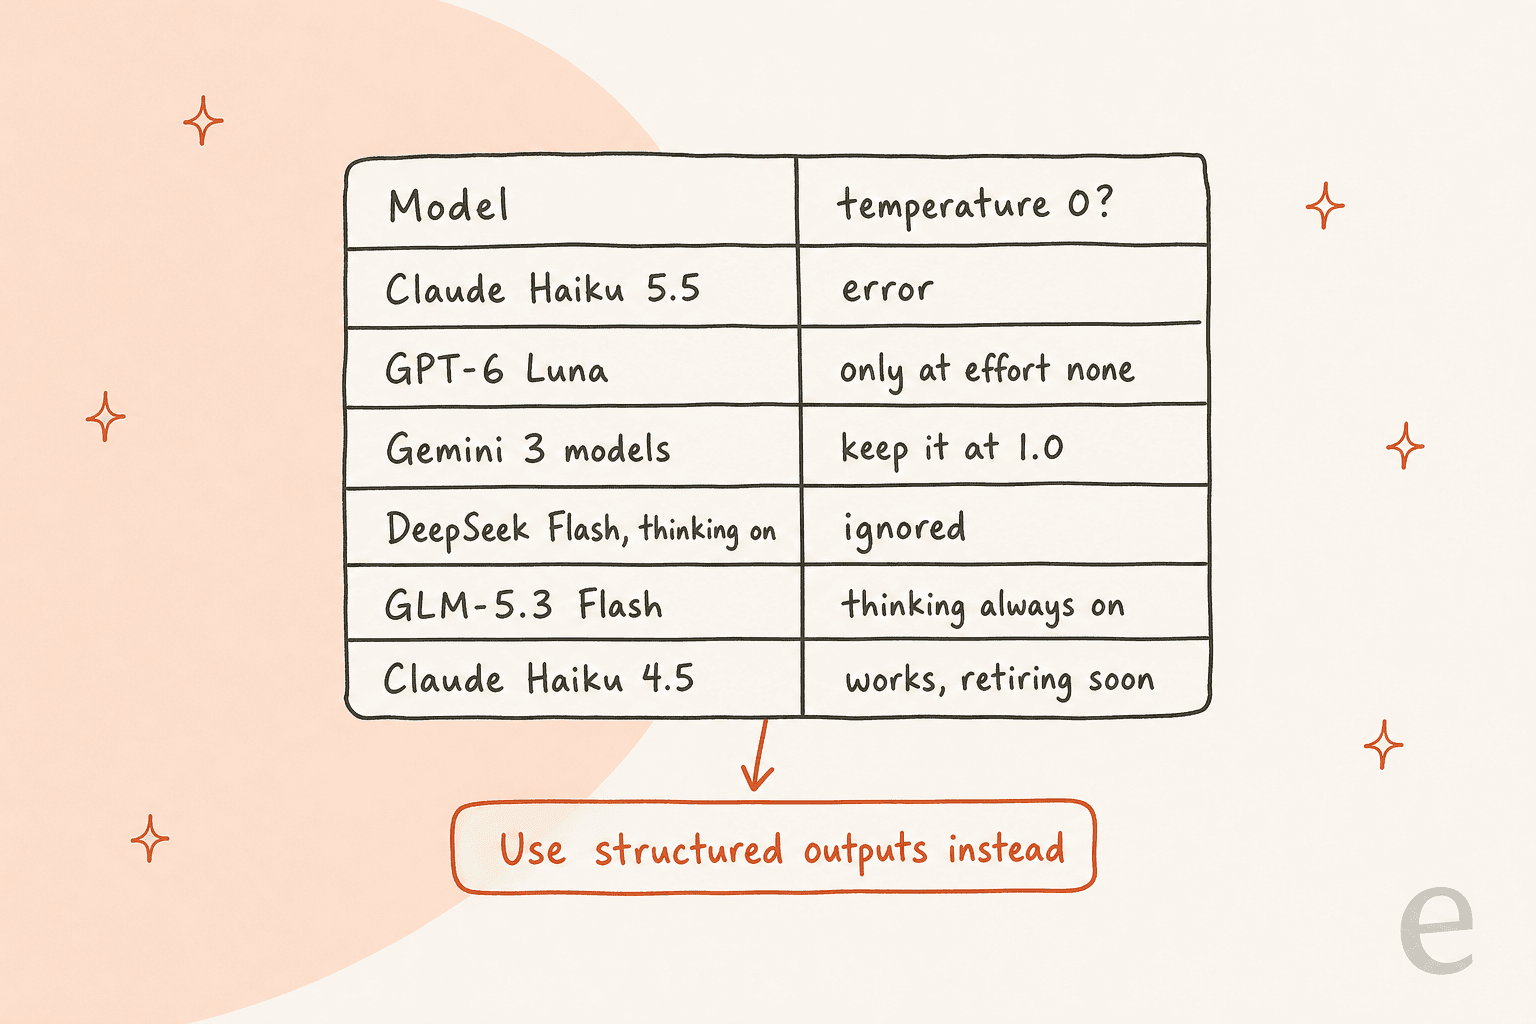
Modelos de raciocínio amostram seu pensamento, e os fornecedores decidiram que temperaturas baixas prejudicam mais do que ajudam. Então trocar de fornecedor para manter temperature 0 compra, no máximo, alguns meses. A correção duradoura, portanto, é parar de depender da amostragem para consistência.
- Use saídas estruturadas ou esquemas de ferramentas estritos para forçar um conjunto fixo de rótulos. O modelo só pode responder com uma das suas categorias, qualquer que seja a temperature.
- Elimine o prefill. Termine suas mensagens com um turno do usuário e coloque a regra de formato no prompt ou no esquema.
- Rode esforço baixo na classificação. Menos thinking significa menos chances de se perder e também uma conta menor.
- Meça a consistência, não presuma. Rode os mesmos 200 tickets duas vezes e conte as trocas de rótulo. Esse número diz mais que qualquer ajuste de temperature.
Há uma lição relacionada vinda das chamadas de vendas da eesel. Um líder de CX de uma marca DTC de suplementos que atende cerca de 7.000 tickets por mês disse à equipe o que realmente queria:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Esse é o objetivo real por trás da maioria das configurações com temperature 0. Não redação idêntica, mas saber quando o modelo tem certeza. O roteamento baseado em confiança, em que a IA responde o que tem certeza e deixa o resto para uma pessoa, leva você até lá com mais confiabilidade que qualquer ajuste de amostragem, e funciona igual em todos os modelos desta lista.
Qual alternativa ao Claude Haiku 5.5 serve para qual trabalho
É assim que eu decidiria, por trabalho e não por benchmark.
| Você está rodando | Minha escolha | Por quê |
|---|---|---|
| Classificação curta, marcação, roteamento | Ficar no Haiku 5.5, ou Luna se o custo por tarefa vencer | Ambos $0.10/$0.50 abaixo de 100k; o Luna escreve menos tokens |
| Loops de agentes que passam de 100k tokens | GPT-6 Luna | O degrau vem em 272k e só de 2x / 1.5x |
| Resumos em lote de contexto longo | DeepSeek V4.1 Flash, fora do pico | $0.15 / $0.60 fixos até 1M tokens |
| Pipelines com temperature 0 ou prefill | Haiku 4.5 no curto prazo, saídas estruturadas no longo | Todo modelo de raciocínio restringe a amostragem |
| Programação agêntica | Claude Sonnet 5.5 | 70.6% contra 39.2% no Terminal-Bench 4.0 |
| Pesos abertos ou auto-hospedagem | GLM-5.3 Flash ou DeepSeek V4.1 Flash | AA 42 e 39, ambos no Hugging Face |
| Filtragem simples em volume enorme | Gemini 3.5 Flash-Lite | 346 tok/s, o menos prolixo |
Mais um ponto prático antes de migrar. A maioria das equipes acaba com dois modelos, não um: um barato para o grosso e um mais inteligente para as escalações. Esse padrão funciona com qualquer par daqui, então você não fica preso a um fornecedor. Para suporte, meu guia sobre qual LLM serve para suporte e a lista dos melhores modelos de IA para tickets vão mais longe.
Experimente a eesel em vez de reconstruir seu pipeline de tickets
Se você está procurando uma alternativa ao Haiku 5.5 para tocar uma fila de suporte, o modelo é, sinceramente, a metade menor do problema. A eesel é uma colega de helpdesk com IA que entra no helpdesk que você já usa, como Zendesk, Freshdesk ou Gorgias, aprende com seus tickets passados e sua central de ajuda, e cuida da classificação de tickets, dos resumos e das respostas. Quando um fornecedor cria um precipício de preço ou passa a rejeitar um parâmetro, essa migração é da eesel, não sua.

Antes de responder a um único cliente, todo rollout é simulado contra seus tickets históricos, para que você veja quais tickets ela resolveria e quais passaria para sua equipe. Isso dá o roteamento baseado em confiança que o líder de CX dos 7.000 tickets pediu, sem um ajuste de temperature à vista.
Se você trabalha pelo terminal, a CLI da eesel opera a mesma colega e o mesmo workspace do painel. Você pode automatizá-la com scripts ou ligá-la ao CI, e também deixar um agente de programação como o Claude Code executá-la. Meu post sobre a CLI de agentes de IA cobre essa configuração.
Os planos pagos começam em $299 por 500 créditos, e você pode testar de graça antes em uma fatia dos seus tickets reais. Experimente a eesel.