

O que é o Claude Haiku 5.5?
O Claude Haiku 5.5 é o modelo pequeno da linha atual da Anthropic. Você recorre a ele quando uma tarefa roda milhares de vezes por dia e cada execução é curta. O post de lançamento da Anthropic o chama de "the cheapest, fastest, and most capable small model we've ever released" e cita as tarefas para as quais foi feito: resumos, compactações, consultas a bancos de dados, classificação, atendimento ao cliente ao vivo e uso de navegador.
Eu construo agentes de IA na eesel e, sinceramente, a maior parte do que esses agentes fazem o dia todo não é raciocínio difícil. Eles leem um ticket e decidem para onde vai, tiram um número de pedido de uma mensagem, às vezes escrevem um resumo de três linhas para a próxima pessoa não precisar rolar a tela. Por anos esse trabalho ficou num ponto desconfortável: um bom modelo custava caro demais para isso, e um modelo barato errava o tempo todo. O Haiku 5.5 mira exatamente nesse ponto.
Também havia um buraco na linha da Anthropic, e isto o preenche. Antes deste lançamento, o Claude atual mais barato era o Sonnet 5.5 a $2/$10, e o Haiku 4.5 a $1/$5 tinha ficado bem atrás de rivais mais baratos como o GPT-6 Luna. Como um desenvolvedor disse no X uma semana antes do lançamento, o espaço de modelos pequenos e baratos era "mostly chinese labs", com o Luna como a única exceção.
Especificações do Claude Haiku 5.5 num relance
Esta é a ficha técnica como está agora, retirada da página de visão geral do Haiku 5.5 na documentação da Anthropic.
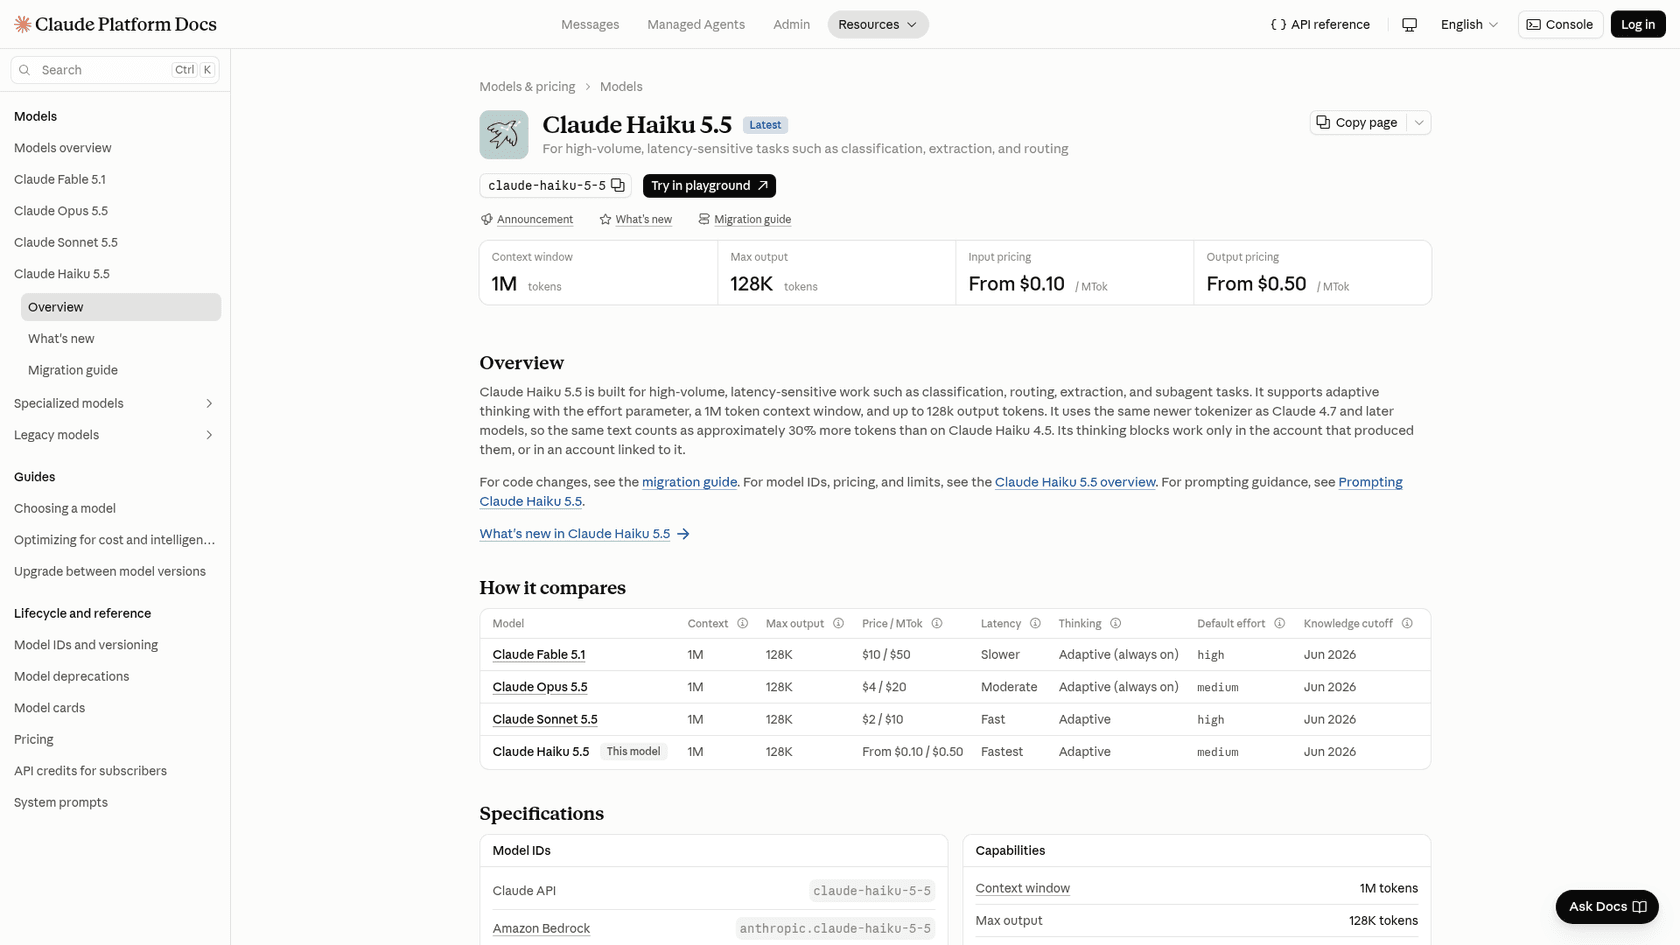
| Especificação | Claude Haiku 5.5 |
|---|---|
| ID do modelo na API | claude-haiku-5-5 (sem sufixo de data, sem alias separado) |
| ID no Amazon Bedrock | anthropic.claude-haiku-5-5 |
| Lançamento | 7 de outubro de 2026 |
| Janela de contexto | 1M de tokens |
| Saída máxima | 128K tokens (300K na Batch API, em beta) |
| Raciocínio | Adaptativo, ativado por padrão |
| Esforço padrão | medium |
| Entrada / saída | Texto e imagens na entrada, texto na saída |
| Data de corte do conhecimento | Junho de 2026 |
| Plataformas | Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry, Claude Platform on AWS |
| Descontinuação | Não antes de 7 de outubro de 2027 |
Alguns detalhes dessa tabela passam despercebidos. Primeiro, o ID do modelo não tem um snapshot datado, então claude-haiku-5-5 é o nome fixo e não um alias que se move depois. Segundo, com um cabeçalho beta a Batch API pode devolver até 300K tokens de saída, útil se você usa o Haiku para escrever arquivos estruturados longos durante a noite.
Onde o Haiku 5.5 se encaixa na linha Claude
A Anthropic agora mantém quatro modelos atuais. O Haiku 5.5 fica na base da escada, que aqui é a ponta rápida e barata.
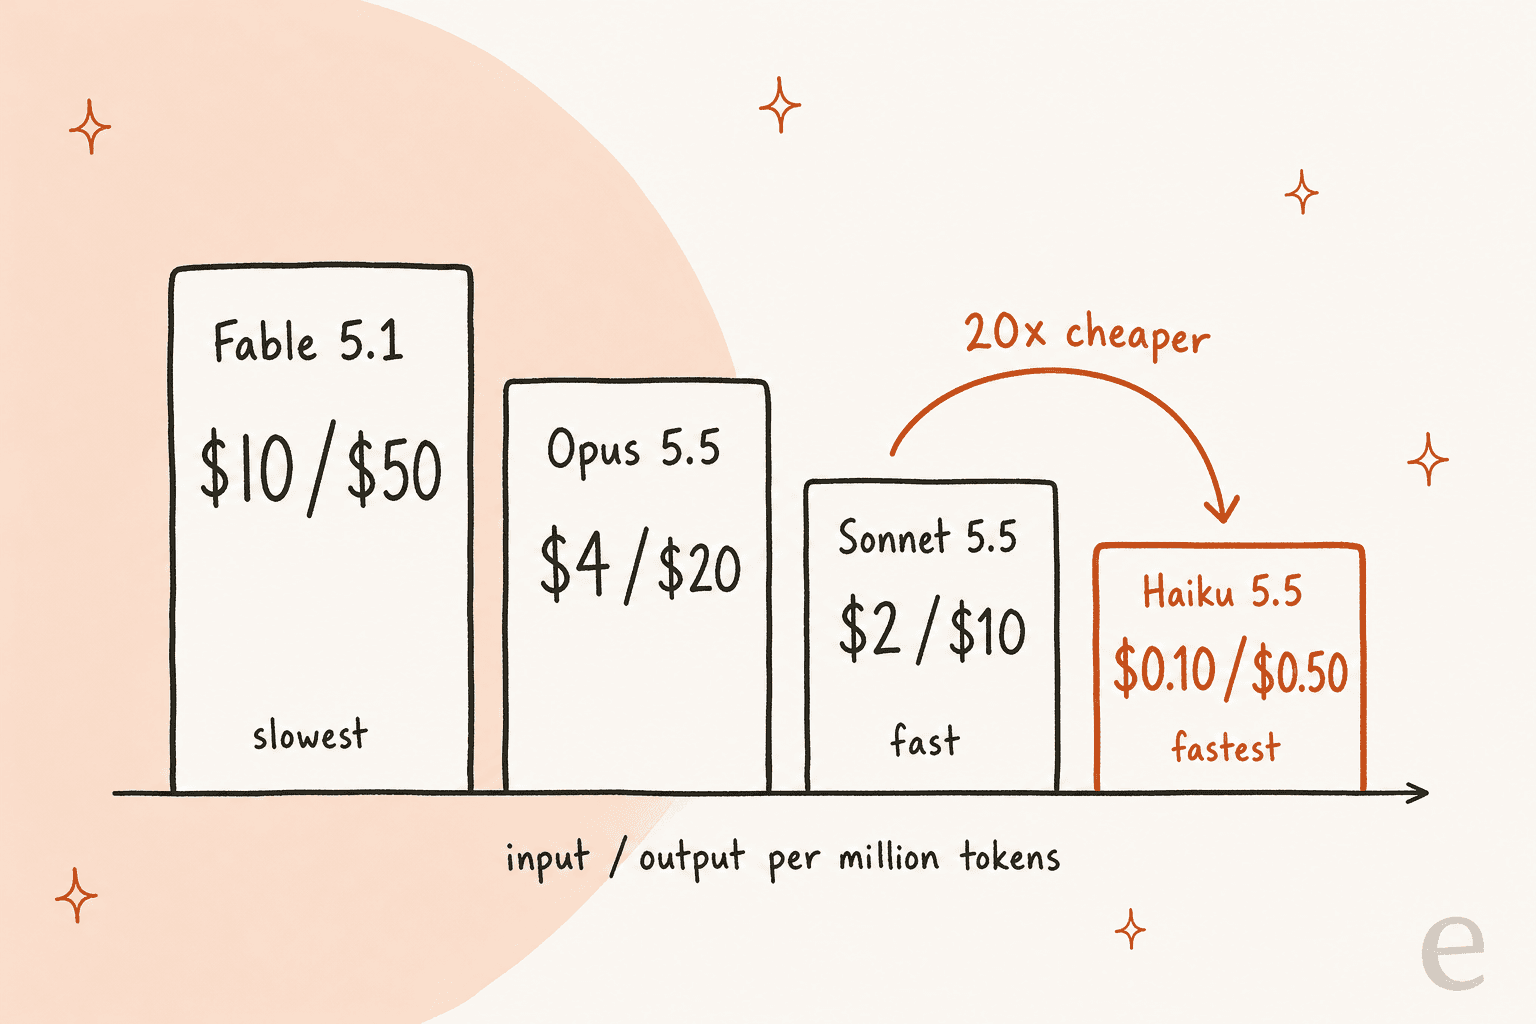
| Modelo | Melhor para | Latência | Preço entrada / saída por 1M | Esforço padrão |
|---|---|---|---|---|
| Claude Fable 5.1 | Raciocínio exigente, agentes de longo horizonte | Mais lento | $10 / $50 | high |
| Claude Opus 5.5 | Programação agêntica de longa duração e trabalho de conhecimento | Moderada | $4 / $20 | medium |
| Claude Sonnet 5.5 | Melhor mistura de velocidade e inteligência | Rápida | $2 / $10 | high |
| Claude Haiku 5.5 | Classificação, extração, roteamento, subagentes | A mais rápida | A partir de $0.10 / a partir de $0.50 | medium |
Os quatro compartilham a mesma janela de contexto de 1M, o mesmo limite de saída de 128K e a mesma data de corte de junho de 2026, segundo a visão geral dos modelos. A janela deixou de ser motivo para escolher um modelo em vez de outro. O que sobra para decidir é preço e velocidade, além de quão difícil a tarefa realmente é.
A Anthropic também não finge que o Haiku é um Sonnet barato. Seu post de lançamento diz que Sonnet 5.5 e Opus 5.5 "remain better choices for complex agentic coding tasks", e que o Haiku 5.5 serve para trabalho bem delimitado como compactação, resumo e tarefas de subagentes. Para mim essa frase vale mais do que qualquer outra coisa no anúncio, e eu a mantenho em mente em cada decisão abaixo.
O que há de novo em comparação com o Haiku 4.5
O Haiku 4.5 saiu um ano antes deste. Pelo número da versão você esperaria um passo pequeno, mas o salto é bem maior.
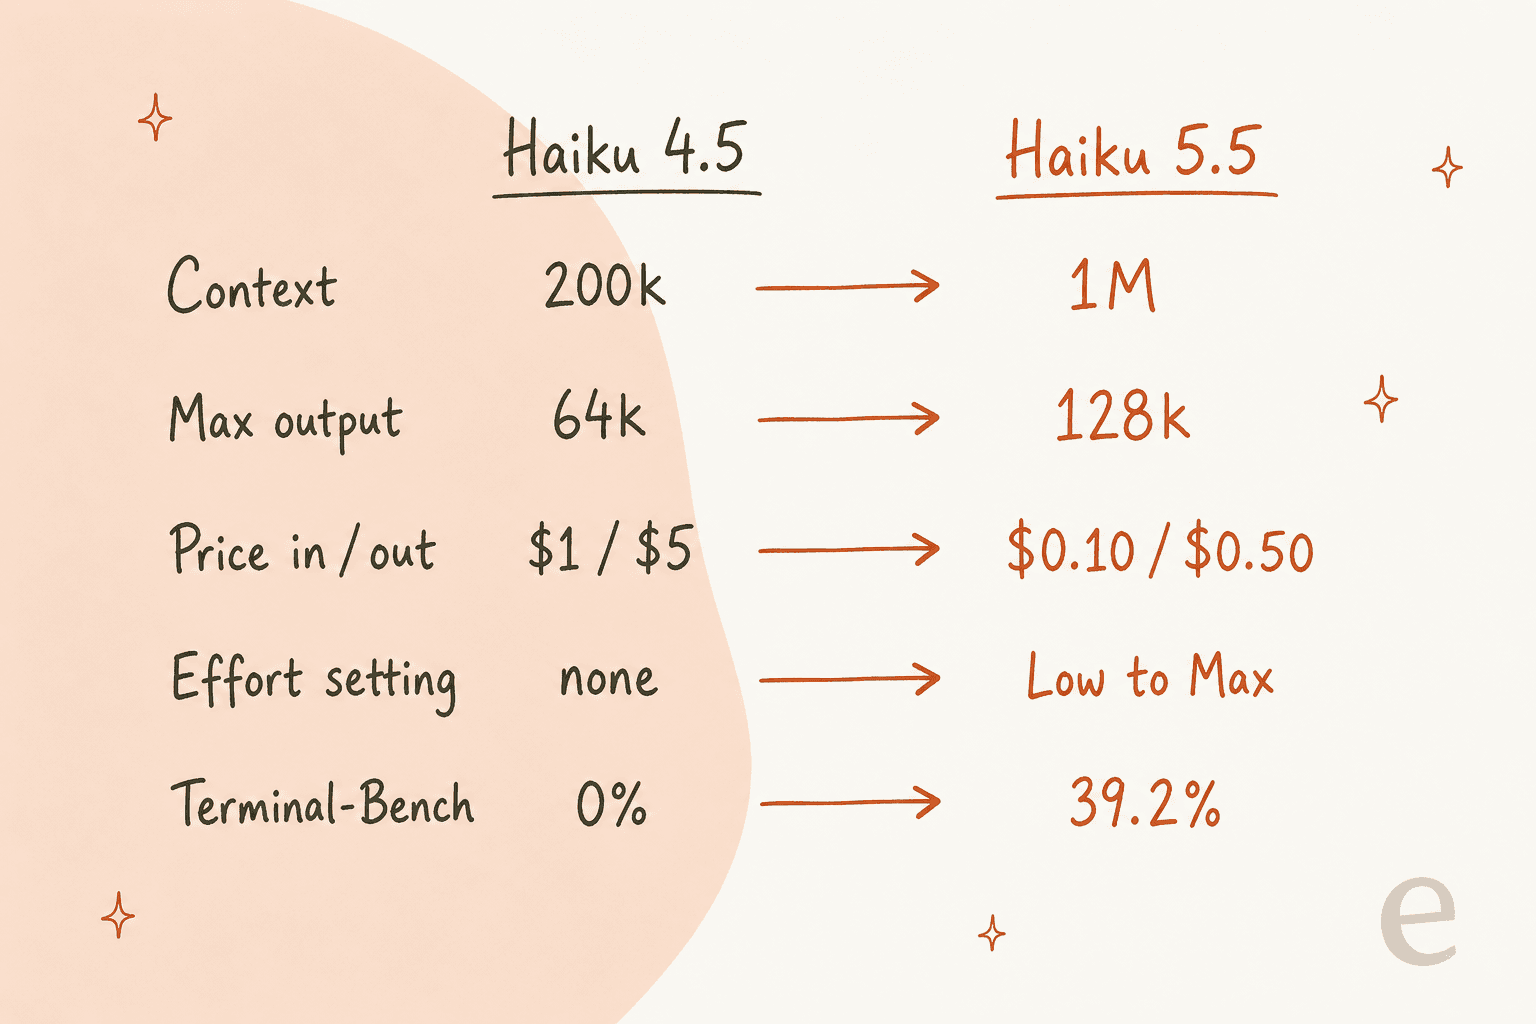
A página de novidades da Anthropic lista 13 mudanças: 4 novas capacidades, 5 mudanças incompatíveis e 4 mudanças de comportamento. Abaixo passo só pelas que mudam como você de fato usa o modelo.
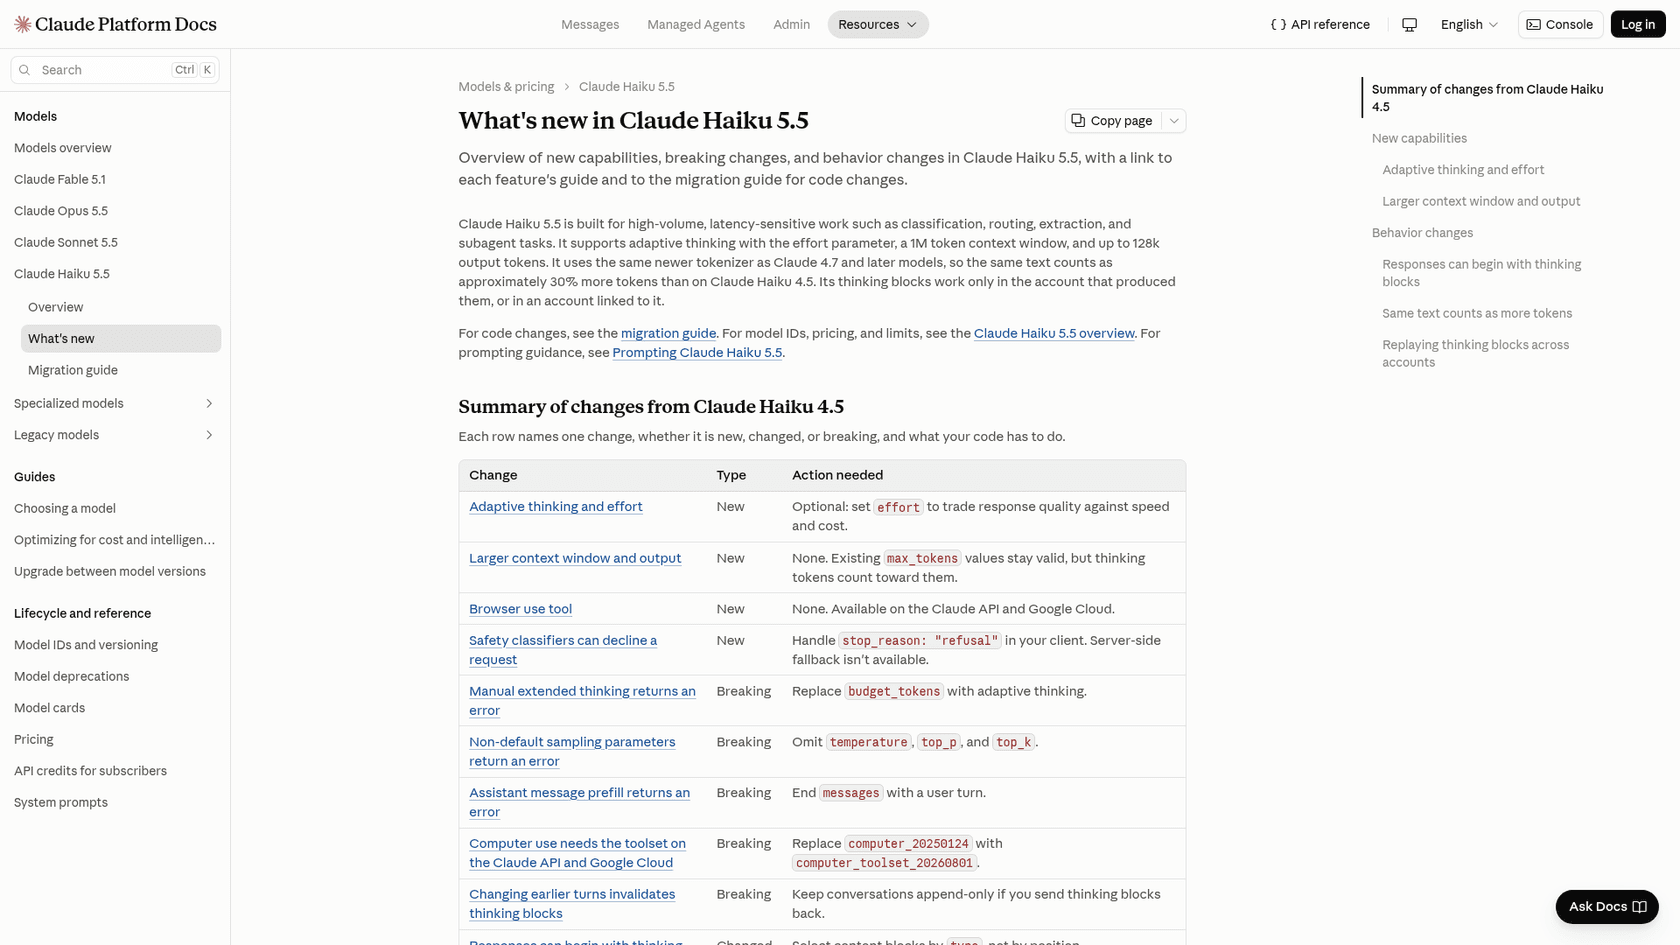
Raciocínio adaptativo e um ajuste de esforço
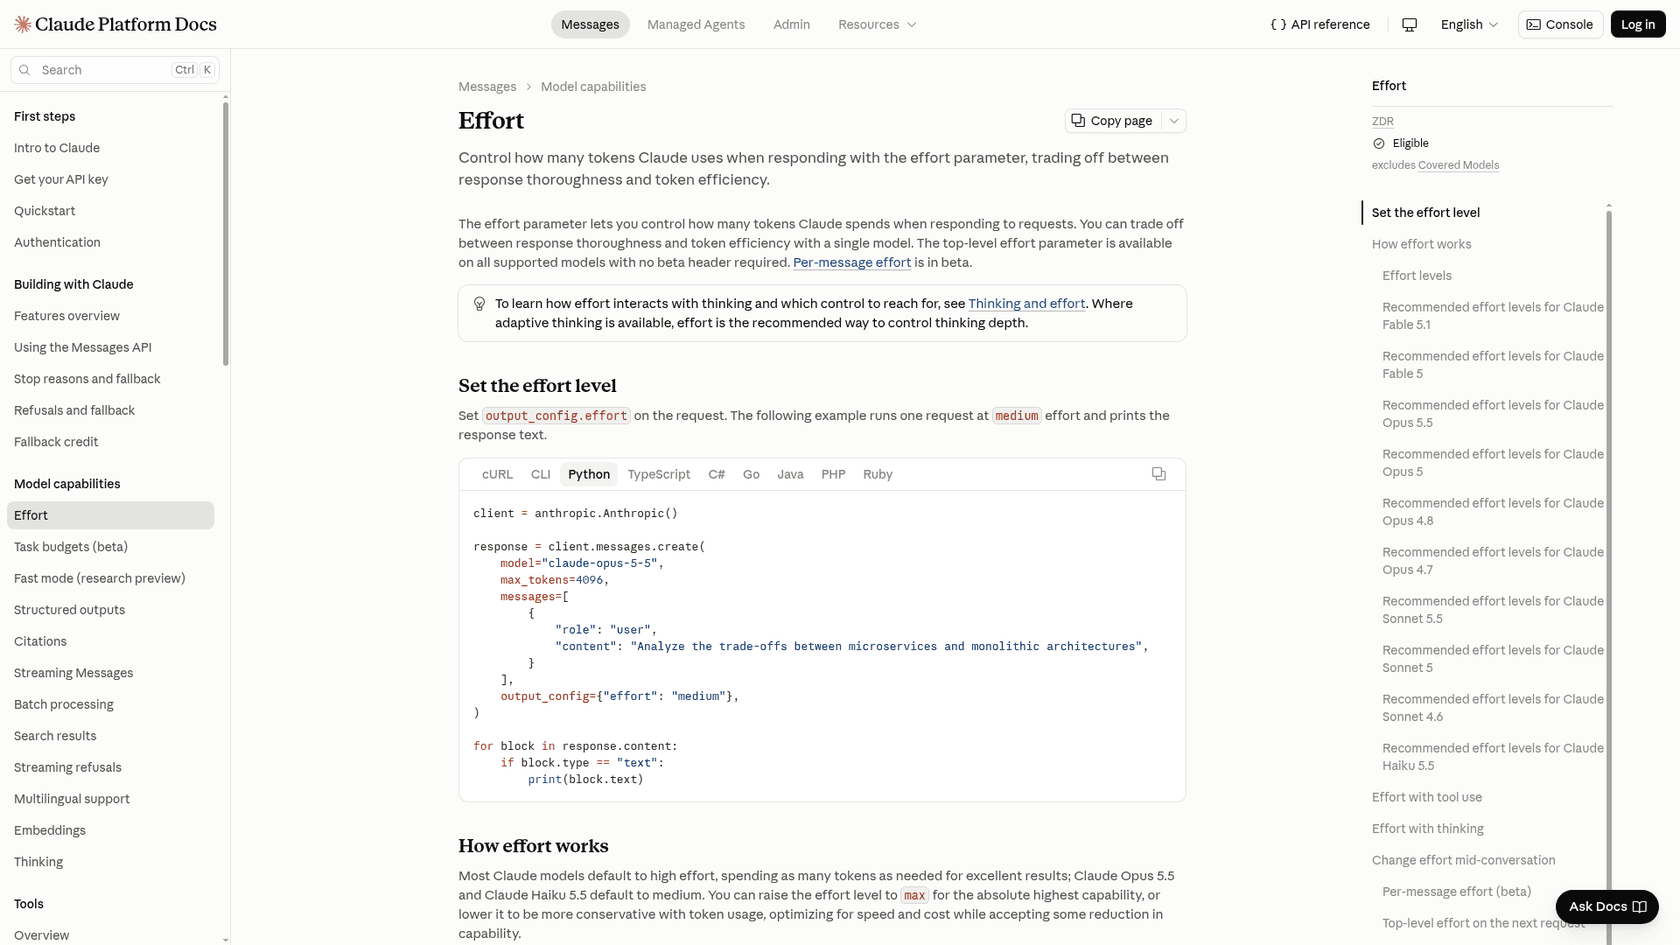
O Haiku 5.5 é o primeiro modelo da classe Haiku com ajuste de esforço configurável. O raciocínio é adaptativo e vem ativado por padrão. Na prática, o próprio modelo decide quando pensar e por quanto tempo, e sua alavanca é effort em vez de um orçamento fixo de raciocínio. Com esforço menor, um pedido simples pode não receber raciocínio algum. O que cada nível faz eu explico mais adiante.
Uma janela de 1M e saídas de 128K
O contexto cresceu de 200k para 1M de tokens e a saída máxima de 64k para 128K. Atenção aqui: tokens de raciocínio contam para max_tokens. Se você ajustou esse limite no talo para o Haiku 4.5, a resposta agora pode terminar logo após o bloco de raciocínio, antes de sair qualquer texto.
Uso de navegador e de computador
O Haiku 5.5 suporta a ferramenta de uso de navegador na Claude API e no Google Cloud, e a Anthropic lançou no mesmo dia um SDK de uso de navegador e computador para Python e TypeScript. Segundo a Anthropic, o Haiku 5.5 é "especially well-suited" para essas tarefas por causa de velocidade e preço. A pontuação de 72,4% no OSWorld 2.1 (contra 15,7% do Haiku 4.5) sustenta essa afirmação.
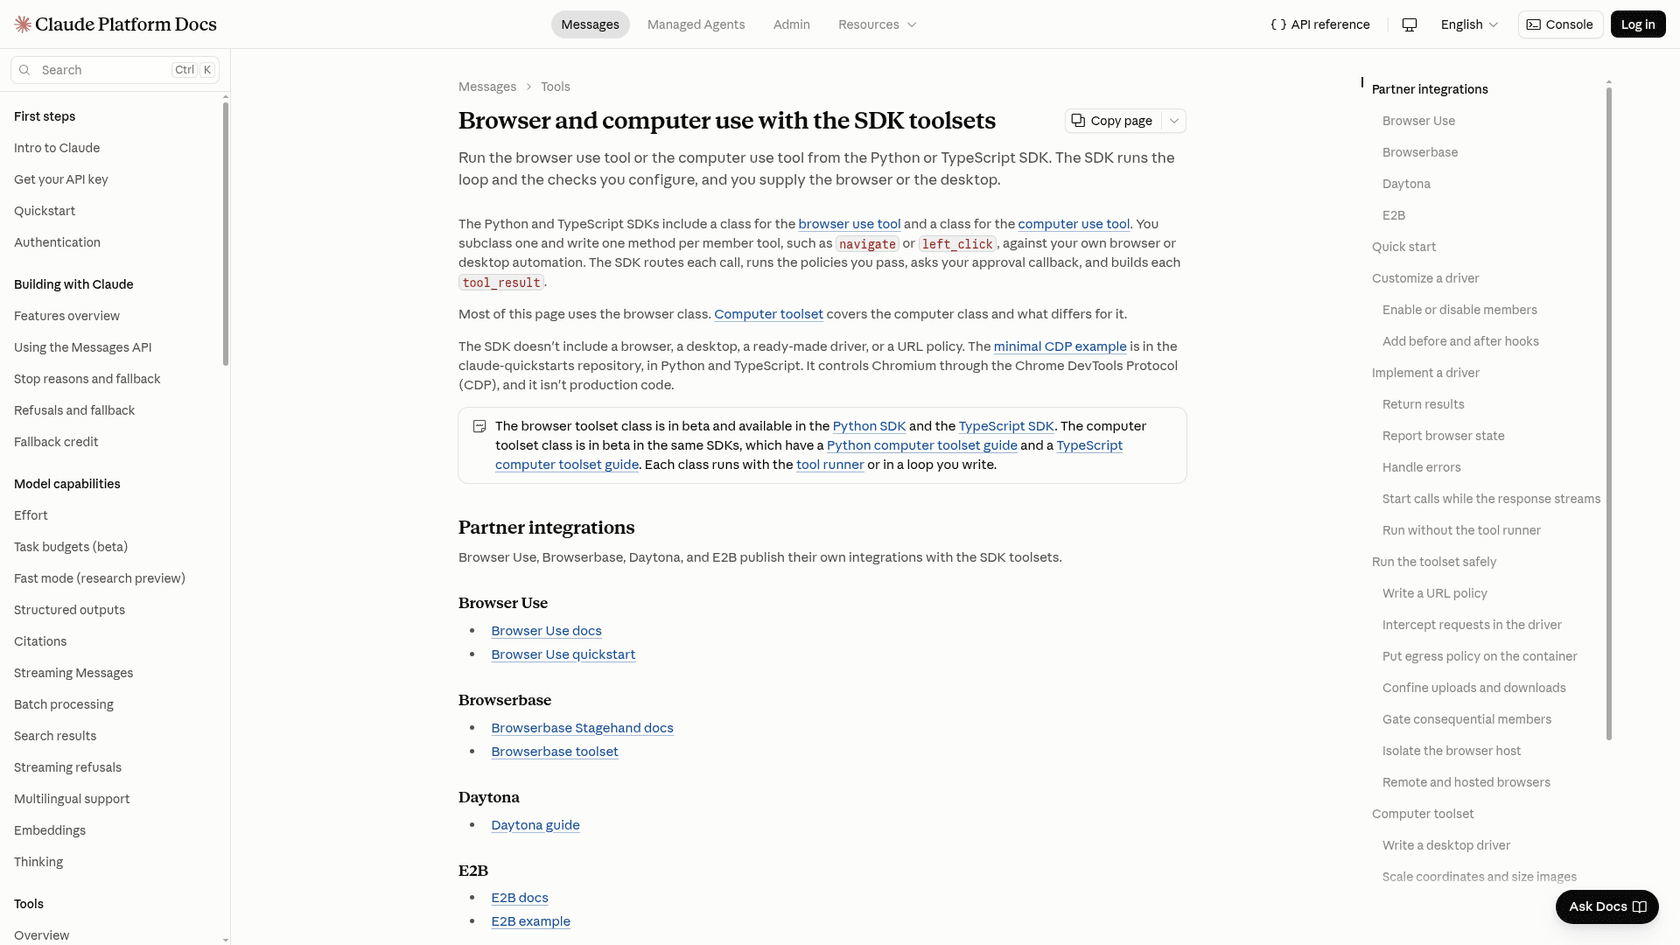
Vale saber antes de se empolgar: o SDK vem sem navegador, sem desktop e sem qualquer política de URL. O driver é por sua conta, e os exemplos iniciais na documentação trazem o rótulo "not production code". Se escrever um não te atrai, Browser Use, Browserbase, Daytona e E2B já publicam integrações prontas.
Um novo tokenizador
O Haiku 5.5 usa o mesmo tokenizador mais recente do Sonnet 5.5 e do Opus 5.5, e o guia de migração diz que o mesmo texto produz cerca de 30% mais tokens do que no Haiku 4.5. Isso explica por que o número de destaque da própria Anthropic diz "around 75% less to run" e não 90%. Por token o preço caiu 90%, só que cada tarefa agora consome mais tokens.
Como o ajuste de esforço muda o Haiku 5.5
Se eu só pudesse dedicar meu tempo a uma parte do Haiku 5.5, seria esta, pois nada mais altera tanto o comportamento do modelo. A documentação de esforço descreve cinco níveis, e o Haiku usa medium por padrão onde a maioria dos modelos Claude usa high.
A Artificial Analysis rodou o Haiku 5.5 em todos os níveis, e a troca que ela encontrou não é sutil. A pontuação do Intelligence Index sobe de 29,4 em Low para 43,4 em Max, mas o tempo até o primeiro pedaço de saída, que inclui o raciocínio, vai de cerca de 14 segundos para 415 segundos.
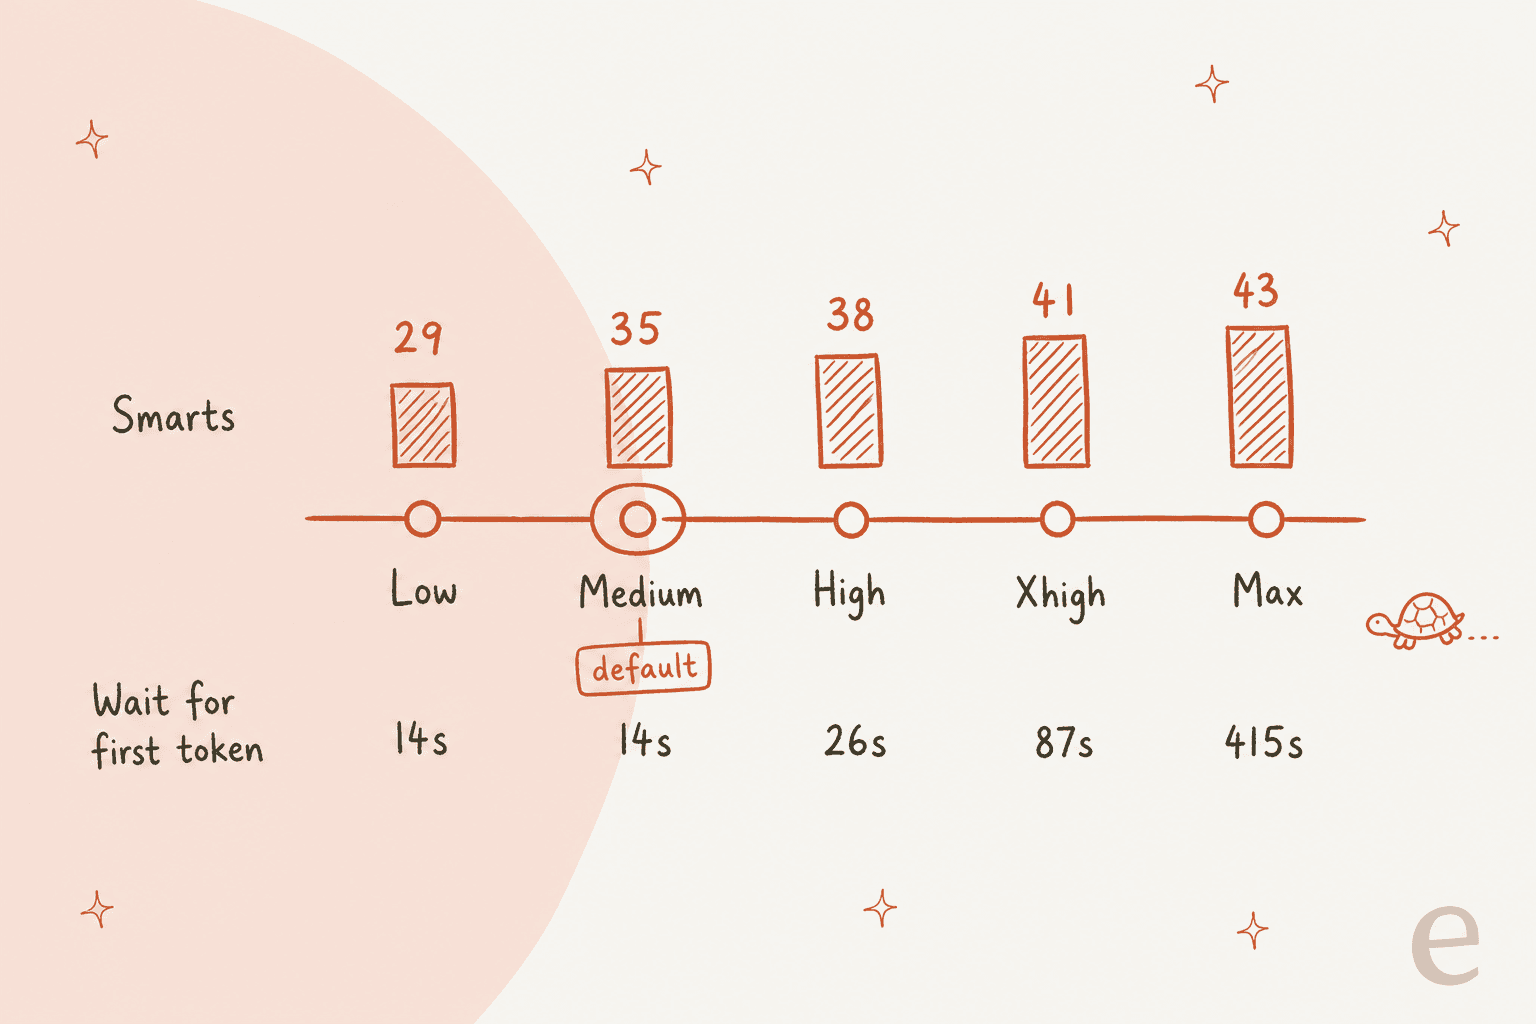
| Esforço | AA Intelligence Index | Tokens de saída para rodar o índice | Velocidade de saída | Tempo até o primeiro pedaço |
|---|---|---|---|---|
| Low | 29.4 | 32M | 181 tokens/s | 13.6 s |
| Medium (padrão) | 34.5 | 54M | 137 tokens/s | 14.2 s |
| High | 37.8 | 97M | 173 tokens/s | 26.2 s |
| Xhigh | 41.2 | 180M | 188 tokens/s | 86.8 s |
| Max | 43.4 | 440M | 243 tokens/s | 415.3 s |
Eu leio essa tabela mais como uma lista de preços disfarçada. Ir de Medium para Max compra 9 pontos, e você paga por eles com cerca de 8x mais tokens de saída. A Artificial Analysis também observou em seu post de lançamento no X que ir de Xhigh para Max "adds 2 points for ~1.8x the tokens".
Numa tarefa minúscula, o teste do pelicano de Simon Willison traça a mesma curva:
"Low messes up the bicycle frame, but medium/high/xhigh/max all get the bicycle frame right. The max one took 5 minutes 9 seconds and cost 3.3826 cents. The cheapest one (low) cost 0.0936 cents and took 7 seconds."

A regra prática a que cheguei construindo agentes é esta. Qualquer coisa com um conjunto fixo de respostas, como tags ou roteamento, começa em Low. Qualquer coisa que escreva prosa que um cliente vai ler começa em Medium. E quando uma tarefa só sai certa em High ou acima, isso costuma indicar que era uma tarefa de Sonnet desde o início.
Quão bom é o Claude Haiku 5.5?
Para o seu tamanho ele é muito bom, embora ainda dê para perceber que é um modelo pequeno. Abaixo estão os benchmarks publicados pela Anthropic em suas configurações de destaque.
| Benchmark | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 (trabalho de conhecimento, Elo) | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 (trabalho de conhecimento, Elo) | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1 (uso de computador) | 72.4% | 15.7% | 48.9% | 83.9% |
| Humanity's Last Exam (sem ferramentas) | 45.9% | 10.2% | n/a | 56.9% |
| Terminal-Bench 4.0 (programação agêntica) | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1 (programação agêntica) | 46.4% | n/a | 42.4% | 52.1% |
| Chartography (raciocínio visual, sem ferramentas) | 46.4% | 6.4% | 29.1% | 61.6% |
O padrão se mantém em toda a tabela. Em tudo que foi testado, o Haiku 5.5 supera o GPT-6 Luna, e chega perto do Sonnet 5.5 em trabalho de conhecimento e uso de computador. Programação agêntica longa é onde ele fica bem atrás do Sonnet.
Na página de lançamento, os primeiros relatos de clientes contam mais ou menos a mesma história, só que em palavras mais simples. A HubSpot disse ter obtido "the best score we've seen on this suite yet, at 92.8%" em suas tarefas de CRM. A AlphaSense mediu 0,84 contra 0,76 do Haiku 4.5 numa carga de perguntas e respostas sobre documentos de cerca de 8M de chamadas por semana. A Box relatou 11 pontos acima do Haiku 4.5 com cerca de metade da latência.
Há um alerta da Artificial Analysis que eu manteria em mente. O Haiku 5.5 sabe menos fatos que os modelos maiores, com 36% de precisão em seu teste AA-Omniscience, mas diz "I don't know" com mais facilidade, então sua taxa de alucinação é de 40%, contra 77% do GPT-6 Luna. Quando um cliente vai ler a saída, esse número me importa mais que a pontuação do índice. A lição prática: dê ao Haiku a sua central de ajuda e não confie no que ele lembra.
Preços do Claude Haiku 5.5
Dos modelos atuais do Claude, só o Haiku 5.5 tem duas faixas de preço. Qual você paga depende do tamanho do prompt, e a página de preços lista cada linha.
| Preço por 1M de tokens | Prompts de até 100.000 tokens | Prompts acima de 100.000 tokens | Haiku 4.5 (fixo) | Sonnet 5.5 |
|---|---|---|---|---|
| Entrada | $0.10 | $0.50 | $1.00 | $2.00 |
| Saída | $0.50 | $2.50 | $5.00 | $10.00 |
| Leitura de cache | $0.01 | $0.05 | $0.10 | $0.10 |
| Escrita de cache de 5 minutos | $0.125 | $0.625 | $1.25 | $2.50 |
| Escrita de cache de 1 hora | $0.20 | $1.00 | $2.00 | $4.00 |
| Batch API | 50% de desconto em entrada e saída | 50% de desconto | 50% de desconto | 50% de desconto |
A Anthropic colocou a linha em 100.000 tokens porque, segundo seu post de lançamento, cerca de 90% das requisições ao Haiku 4.5 ficavam abaixo dela. Com uma carga nesse formato, o Haiku 5.5 iguala o preço de tabela de $0.10/$0.50 do GPT-6 Luna. Com outro formato, bem, o thread do HN fez a conta rápido:
"100k tokens is an absurdly low cutoff and it is only applicable to Haiku and not Sonnet or Opus. It's a low enough cutoff that it will be quickly exceeded if you are doing anything with Agents; for typical generation or Jev-like classifiers, it's a good value and as noted in this article, that is apparently the vast majority of Haiku use."
Há também uma diferença mais discreta entre tokens do Claude e tokens da OpenAI. Outro comentarista apontou que "modern Claude's 100K tokens are about ~60-65K modern GPT tokens", então o mesmo documento chega mais cedo à linha do Haiku do que à do Luna. Aprofundo o lado dos custos na minha análise do Claude Haiku 5.5 e nos preços do GPT-6 Luna.
Coloque seus próprios números abaixo para ver quanto custa um mês de chamadas e onde a linha de 100k começa a pesar. Use contagens de tokens como o Haiku 5.5 as conta.
Como exemplo, tente 50.000 requisições com 6.000 tokens de prompt e 800 de saída. No Haiku 5.5 isso dá $50 por mês, enquanto o Sonnet 5.5 dá $1.000. Depois suba o prompt para 120.000 tokens e você verá o Haiku saltar 5x.
Como acessar e usar o Claude Haiku 5.5
O Haiku 5.5 está no ar em todas as plataformas pelas quais a Anthropic vende: a Claude API, o Amazon Bedrock, o Google Cloud, o Microsoft Foundry e o Claude Platform on AWS. Você também pode usá-lo nos apps do claude.ai, onde a Anthropic publica seu prompt de sistema.
Aqui vai uma chamada mínima à API. O esforço é definido explicitamente e não há parâmetros de amostragem:
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=4096,
    output_config={"effort": "low"},
    messages=[
        {"role": "user", "content": "Tag this ticket as billing, shipping, bug or other: ..."}
    ],
)

for block in response.content:
    if block.type == "text":
        print(block.text)
Alguns hábitos que me pouparam tempo de depuração depois:
- Selecione blocos de conteúdo por
type. Uma resposta pode começar com um bloco de raciocínio mesmo que você nunca tenha pedido raciocínio, então não presuma que o primeiro bloco é a resposta. - Deixe de fora
temperature,top_petop_k. No Haiku 5.5, qualquer valor fora do padrão gera um erro 400. - Trate
stop_reason: "refusal". O Haiku 5.5 roda classificadores de segurança que às vezes recusam um pedido, e segundo o guia de migração nenhum modelo de fallback no servidor o recolhe.
Quem tem um plano Claude agora tem um jeito de testá-lo quase de graça. A partir da semana de lançamento, a Anthropic dá créditos mensais de API a assinantes Max e Team: $100 por mês no Max 5x, $200 no Max 20x e até $500 compartilhados no Team. Você pode gastar os créditos em qualquer modelo. O que eles não cobrem são sessões interativas do Claude Code.
Dentro do próprio Claude Code, o Haiku é uma escolha comum para subagentes, e meu guia de seleção de modelo no Claude Code explica quando trocar.
O que quebra ao migrar do Haiku 4.5
Chamar o Haiku 5.5 de substituto direto só é verdade se seu código já estava escrito para os modelos Claude mais novos. O guia de migração tem uma lista de 10 passos, e estes cinco retornam erros:
| O que seu código faz hoje | O que acontece no Haiku 5.5 | A correção |
|---|---|---|
Envia thinking com budget_tokens | Erro 400 | Use {"type": "adaptive"} e defina effort |
Define temperature, top_p ou top_k | Erro 400 | Remova-os |
Termina messages com um turno do assistente (prefill) | Erro 400 | Termine com um turno do usuário, use saídas estruturadas |
Usa computer_20250124 na Claude API ou no Google Cloud | Rejeitado | Migre para computer_toolset_20260801 |
| Edita turnos anteriores e reenvia blocos de raciocínio | Blocos de raciocínio invalidados | Mantenha a conversa apenas com acréscimos |
Dessas, a mudança de temperatura é a que eu planejaria. Muitos pipelines de classificação fixam a temperatura em 0 para obter saída repetível, e no Haiku 5.5 essa requisição simplesmente falha. Se você quer consistência agora, saídas estruturadas com um esquema fixo são o melhor caminho. Mais uma coisa: o Priority Tier não é oferecido no Haiku 5.5, então uma equipe com compromisso de Priority no 4.5 precisa planejar a capacidade de outra forma.
Para que o Claude Haiku 5.5 serve?
Quando avalio um modelo pequeno, primeiro pergunto pela tarefa. O prompt é curto, existe uma resposta certa clara e, além disso, roda em alto volume? O Haiku 5.5 foi feito para tarefas em que a resposta a tudo isso é sim.
| Tarefa | Adequação | Por quê |
|---|---|---|
| Classificação de tickets e etiquetagem | Forte | Prompts curtos, rótulos fixos, esforço Low funciona |
| Resumos de tickets e notas de passagem | Forte | Rápido em Medium, barato o bastante para rodar em todo ticket |
| Roteamento e priorização | Forte | Velocidade importa mais que profundidade |
| Respostas da central de ajuda (RAG) | Forte, se os prompts ficarem abaixo de 100k | Taxa de alucinação menor que a do Luna, janela de 1M se precisar |
| Subagentes sob um líder Sonnet ou Opus | Forte | Anthropic e Cognition apontam esse uso |
| Uso de navegador e de computador | Bom | 72,4% no OSWorld 2.1, o Claude mais rápido |
| Loops longos de agentes e programação difícil | Fraco | 39,2% contra 70,6% do Sonnet 5.5 no Terminal-Bench 4.0 |
As pessoas subestimam a velocidade. Numa avaliação da eesel, um comprador submeteu o bot de suporte da eesel a uma revisão cuidadosa de 67 testes e achou as respostas de conhecimento sólidas. Mesmo assim foi embora, porque o widget de chat parecia lento e travava. Boas respostas não conseguiram salvar uma experiência lenta. O Haiku 5.5 é o modelo mais rápido da Anthropic em velocidade padrão, e uma medição do OpenRouter compartilhada no HN o coloca em cerca de o dobro da vazão do Luna, então ele fala diretamente a esse tipo de negócio perdido.
No Hacker News, os desenvolvedores que mais gostaram foram os que faziam justamente esse tipo de trabalho curto e fundamentado:
"Tested on my RAG system containing all of cloudflare docs (more than 3000 A4 sized highly technical documents): best
quality*speed/priceratio of any other model. And I have tested more than a 100 different models."
Outro testador deu a ele uma tarefa grande demais, e ele pareceu conhecer os próprios limites:
"One interesting thing is it took a look at the job at hand, and immediately delegated it to Opus 5.5. It at least knows what it isn't good at. Very fast though, and likely best used for small subagent tasks / tightly scoped work."
O que os desenvolvedores estão dizendo
O thread de lançamento no Hacker News foi em grande parte positivo sobre preço e velocidade. As reclamações reais se resumiram a duas: a linha de 100k e equipes cujas próprias avaliações não batiam com os gráficos da Anthropic.
"It's absolutely better than Luna. It feels closer to a "sonnet 5.2" if that makes sense. Of course it's not as big, and hence falls-off quicker."
"At work we use haiku 4.5 for a handful of latency sensitive tasks that are fairly simple. It performs well. Just started testing 5.5 as I've been anticipating a nice improvement since it was teased. Results so far are trash. Prompt leakage even. And it's slower."
Eu levaria esse segundo comentário a sério. O Haiku 4.5 rodava sem raciocínio por padrão, então um prompt ajustado para ele pode se comportar de outro jeito num modelo que pensa em esforço Medium logo de fábrica. A Anthropic publicou um guia de prompts para o Haiku 5.5 justamente para isso. Se um prompt migrado ficar mais lento, meu primeiro passo seria baixar o esforço para Low.
O cenário mais amplo de modelos pequenos é coberto nos meus posts sobre alternativas ao Claude Haiku 5.5, Gemini 3.8 Flash e GLM-5.3 Flash.
Respostas rápidas como as do Haiku na sua fila de suporte com a eesel
Se você está lendo sobre o Haiku 5.5 por causa de uma fila de suporte, então o modelo é a parte fácil. A parte difícil é tudo em volta: quais tickets recebem o modelo rápido, como manter os prompts abaixo da linha de 100k, em que nível de esforço cada tarefa roda e como respostas erradas são pegas antes que um cliente veja uma.
Esse trabalho é o que o colega de IA para helpdesk da eesel tira das suas costas. Ele entra no helpdesk que você já usa, como Zendesk, Freshdesk ou Gorgias, aprende com seus tickets passados e sua central de ajuda, e faz triagem, etiquetagem, resumos e respostas. Cada implantação é simulada com seus tickets históricos antes de falar com um único cliente, então primeiro você vê como ele teria tratado a fila do mês passado.

Se preferir conduzi-lo por um terminal, a CLI da eesel executa o mesmo colega e o mesmo workspace do painel, de modo que um script ou um agente de programação como o Claude Code pode configurá-lo e conferir seu trabalho. É basicamente o padrão de líder e ajudante que a Anthropic recomenda para o Haiku, apontado para a sua configuração de suporte. Meus posts sobre a CLI de agentes de IA e os servidores MCP vão mais fundo.
Os planos começam em $299 por 500 créditos, mas você pode rodá-lo de graça numa fatia de tickets reais antes de pagar qualquer coisa. Experimente a eesel e veja se respostas mais rápidas realmente chegam aos seus clientes.
Perguntas frequentes
O que é o Claude Haiku 5.5?
claude-haiku-5-5. Ele tem janela de contexto de 1M de tokens, até 128K tokens de saída, raciocínio adaptativo com um ajuste de esforço, e foi feito para trabalho de alto volume como classificação, roteamento, extração, resumos e tarefas de subagentes.Quanto custa o Claude Haiku 5.5?
O Claude Haiku 5.5 é melhor que o Haiku 4.5?
Qual a diferença entre o Claude Haiku 5.5 e o Sonnet 5.5?
Como uso o Claude Haiku 5.5?
model: "claude-haiku-5-5", ou use anthropic.claude-haiku-5-5 no Amazon Bedrock. Deixe de fora temperature, top_p e top_k, e defina output_config.effort como low, medium, high, xhigh ou max. Ele também está no Google Cloud, no Microsoft Foundry e no Claude Platform on AWS. Para equipes de suporte, o colega de IA para helpdesk da eesel executa modelos rápidos dentro do seu helpdesk sem nenhum código.O Claude Haiku 5.5 é bom para atendimento ao cliente?
O que quebra quando troco para o Claude Haiku 5.5?
budget_tokens, temperature, top_p ou top_k diferentes do padrão, prefill de mensagem do assistente, a antiga ferramenta computer_20250124 na Claude API e no Google Cloud, e edições em turnos anteriores quando você reenvia blocos de raciocínio. O novo tokenizador também conta cerca de 30% mais tokens para o mesmo texto. O post sobre alternativas ao Claude Haiku 5.5 mostra para onde ir se essas mudanças não servirem para você.