Meu veredito em resumo
No dia seguinte ao lançamento, passei o tempo lendo o anúncio da Anthropic e a documentação do modelo, depois o guia de migração, e também o thread de lançamento no Hacker News, com cerca de 550 comentários. Meu trabalho é construir agentes de IA para o colega de helpdesk da eesel, então li tudo com uma pergunta em mente: eu colocaria este modelo em uma fila de suporte real amanhã?
Aqui vai a versão curta, avaliada pelo que importa quando você realmente coloca em produção:
| O que verifiquei | Nota | Por quê |
|---|---|---|
| Qualidade de código | 9/10 | 70,6% no Terminal-Bench 4.0, acima do Opus 5.5 |
| Trabalho de conhecimento | 8/10 | GDPval-AA 1844, dois pontos atrás dos 1846 do Opus 5.5 |
| Eficiência de tokens | 9/10 em Low/Medium, 4/10 no Max | ~121k contra 497k tokens por resposta na Balyasny, mas 193k por tarefa no Max |
| Velocidade | 8/10 | Saída 30%+ mais rápida que o Sonnet 5 |
| Dor de migração | 5/10 | Cinco mudanças incompatíveis, uma delas ruim para bots de suporte |
| Adequação ao suporte | 8/10 | A Zendesk viu tickets processados 20% mais rápido |
| Geral | 8/10 | Melhor custo-benefício da linha, com uma configuração cara a evitar |
Uma nota rápida sobre o método, para deixar claro em que essas notas se apoiam. Eu não fiz um teste de meses em produção, já que o modelo tem apenas um dia. As notas são construídas com os números publicados pela Anthropic e os resultados de clientes nomeados no post de lançamento, mais execuções independentes de benchmarks que as pessoas postaram publicamente, e depois minha própria leitura da documentação da API frente ao modo como a eesel conecta modelos em fluxos de tickets. Quando um número vem da Anthropic, eu digo.
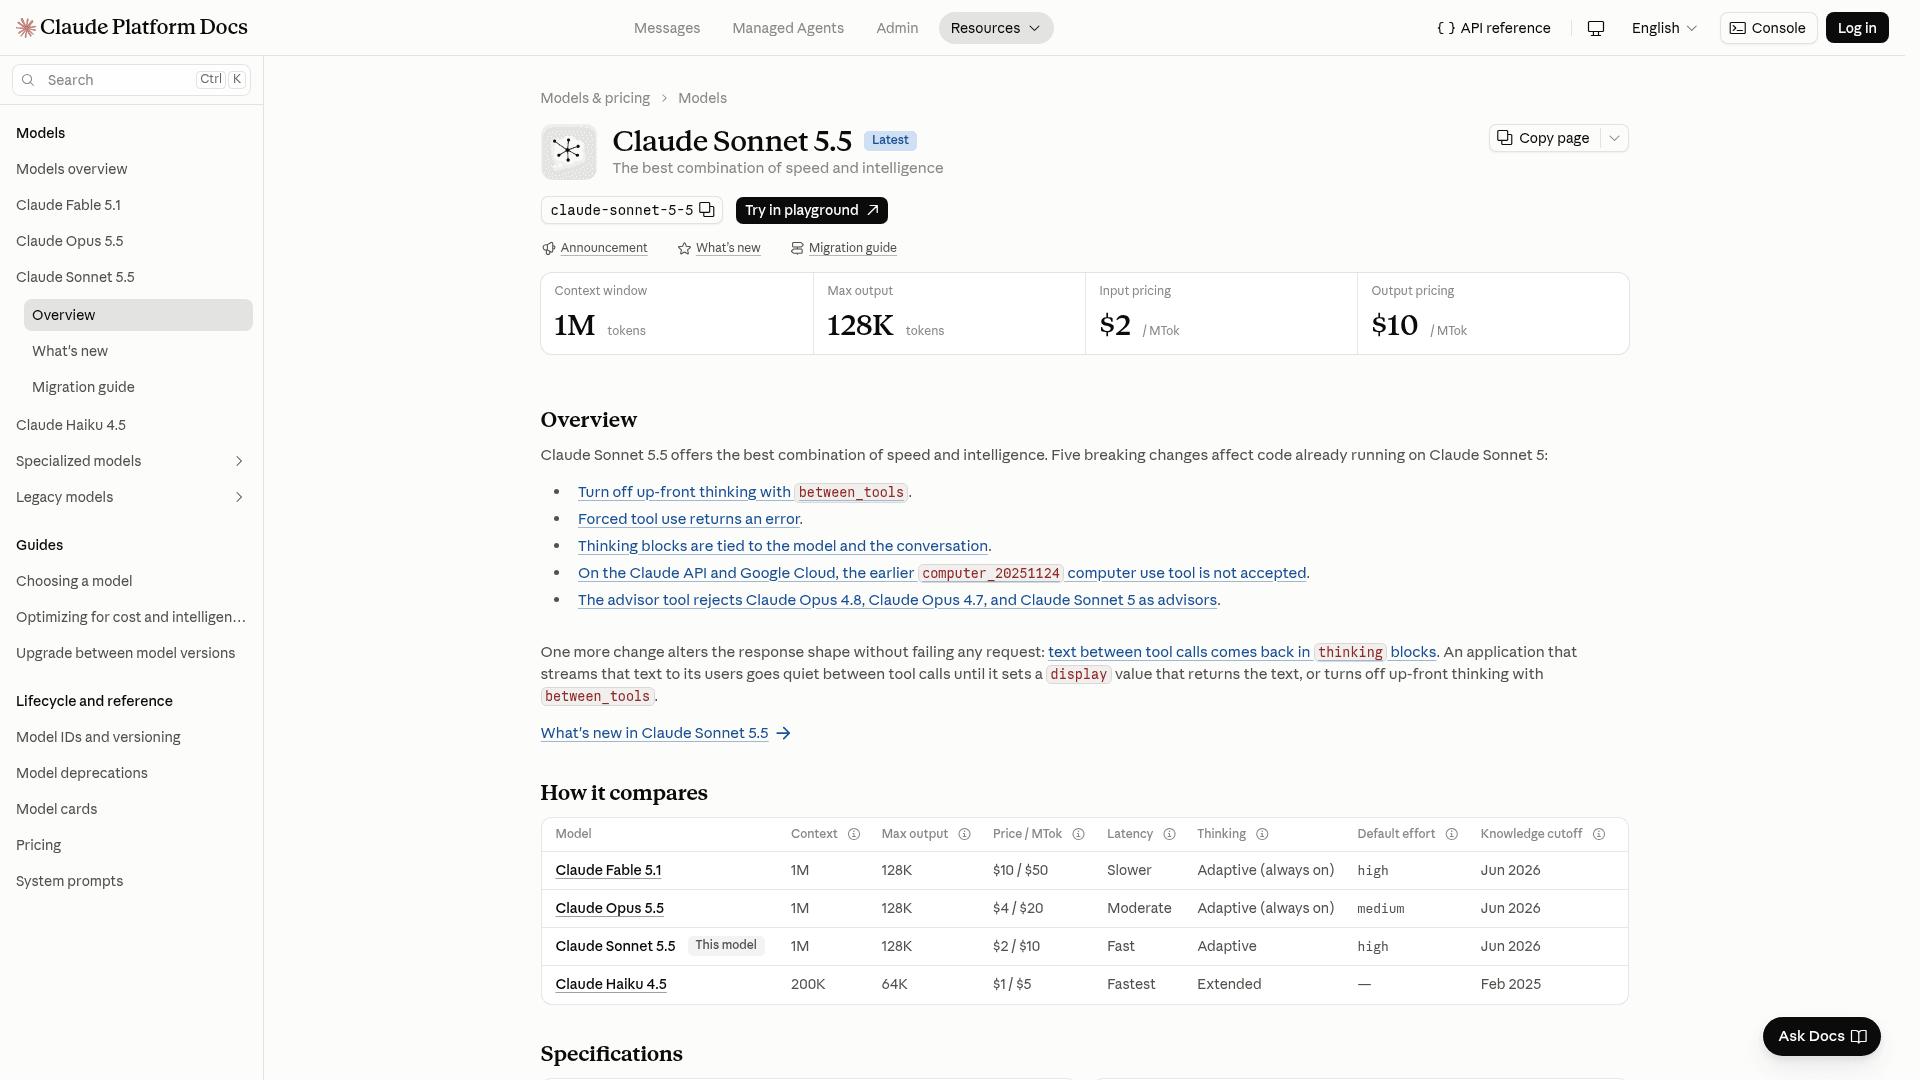
O que é o Claude Sonnet 5.5
O Claude Sonnet 5.5 é o modelo de nível intermediário da família Claude 5.5 da Anthropic, lançado em 28 de setembro de 2026. Ele fica abaixo do Claude Opus 5.5 e acima do Haiku 4.5, enquanto o Claude Fable 5.1 ocupa o topo da linha. A Anthropic o apresenta como "a faster, lower-cost complement" ao Opus, mais forte em "well-scoped everyday tasks, fixing bugs, and creating polished documents, slides, and spreadsheets."
Quanto às especificações, a visão geral do modelo lista janela de contexto de 1M de tokens e 128K de saída máxima (300K no Batch), com corte de conhecimento em junho de 2026 e o mesmo tokenizador do Claude Sonnet 5. Para o passo a passo completo do lançamento, a visão geral do Sonnet 5.5 do meu colega cobre bem. Este post é mais o veredito.
Onde o Claude Sonnet 5.5 é forte
Três coisas se destacaram nos dados de lançamento, e as três aparecem em resultados de clientes nomeados, não apenas nos gráficos da própria Anthropic.
Ele programa como um modelo Opus
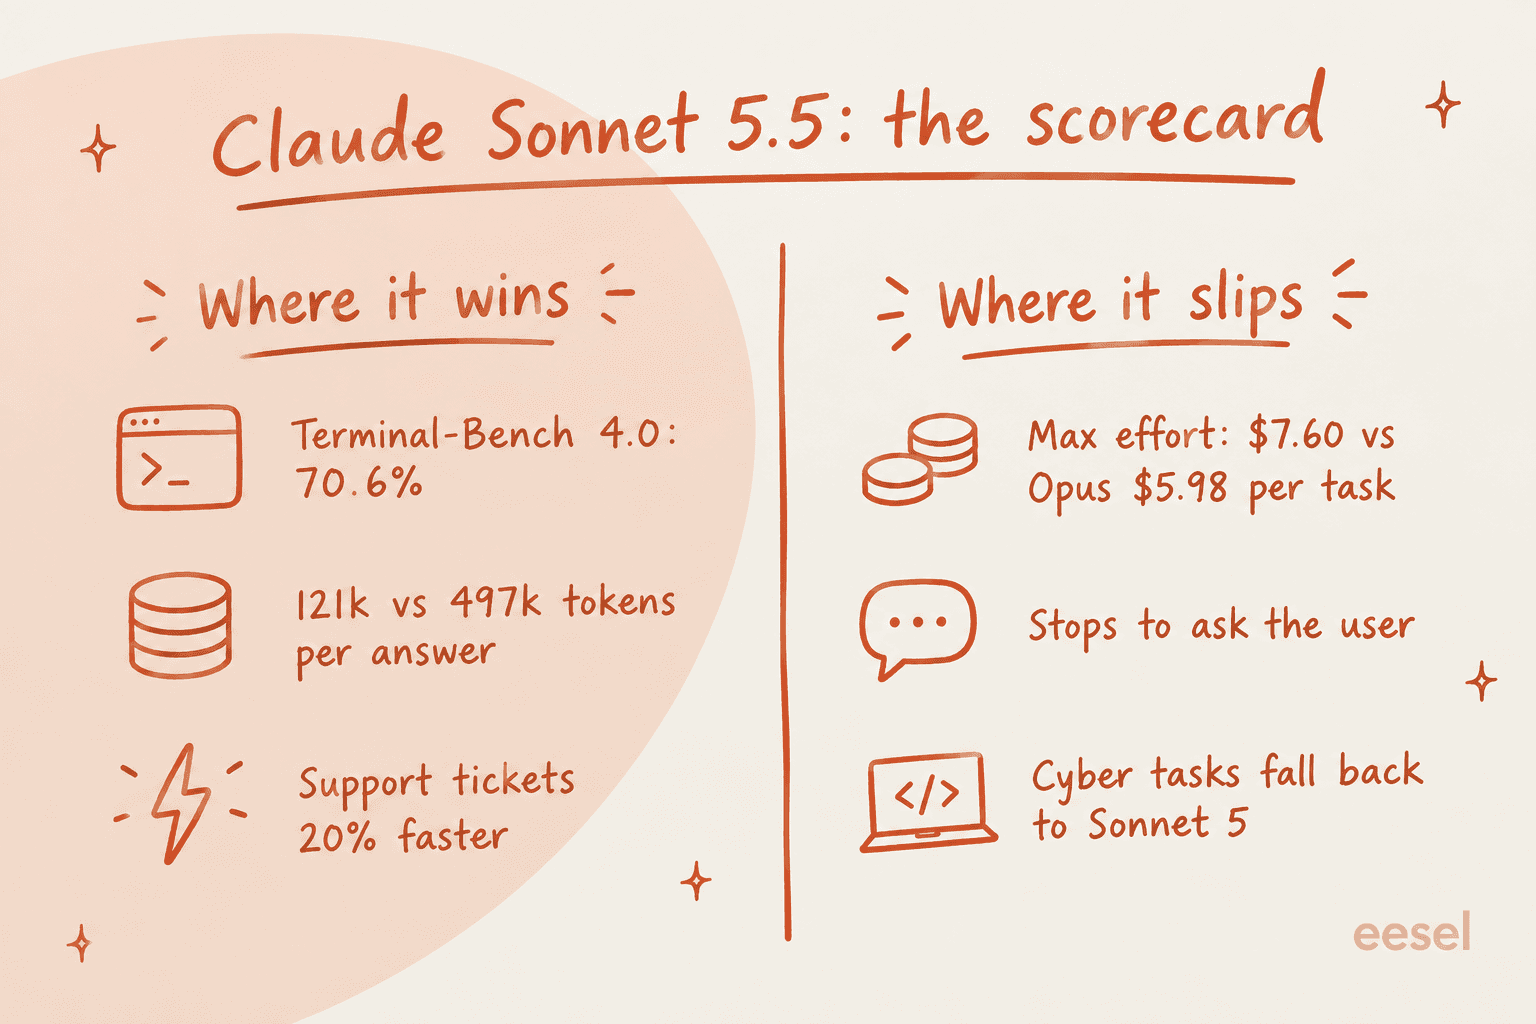
O número principal é o Terminal-Bench 4.0, um teste de programação agêntica executado na linha de comando. O Sonnet 5 marcou 10,3% ali, e o Sonnet 5.5 marca 70,6%, acima dos 66,4% do Opus 5.5. Não é erro de digitação. É o maior salto de uma geração para outra que já vi em qualquer modelo Sonnet.
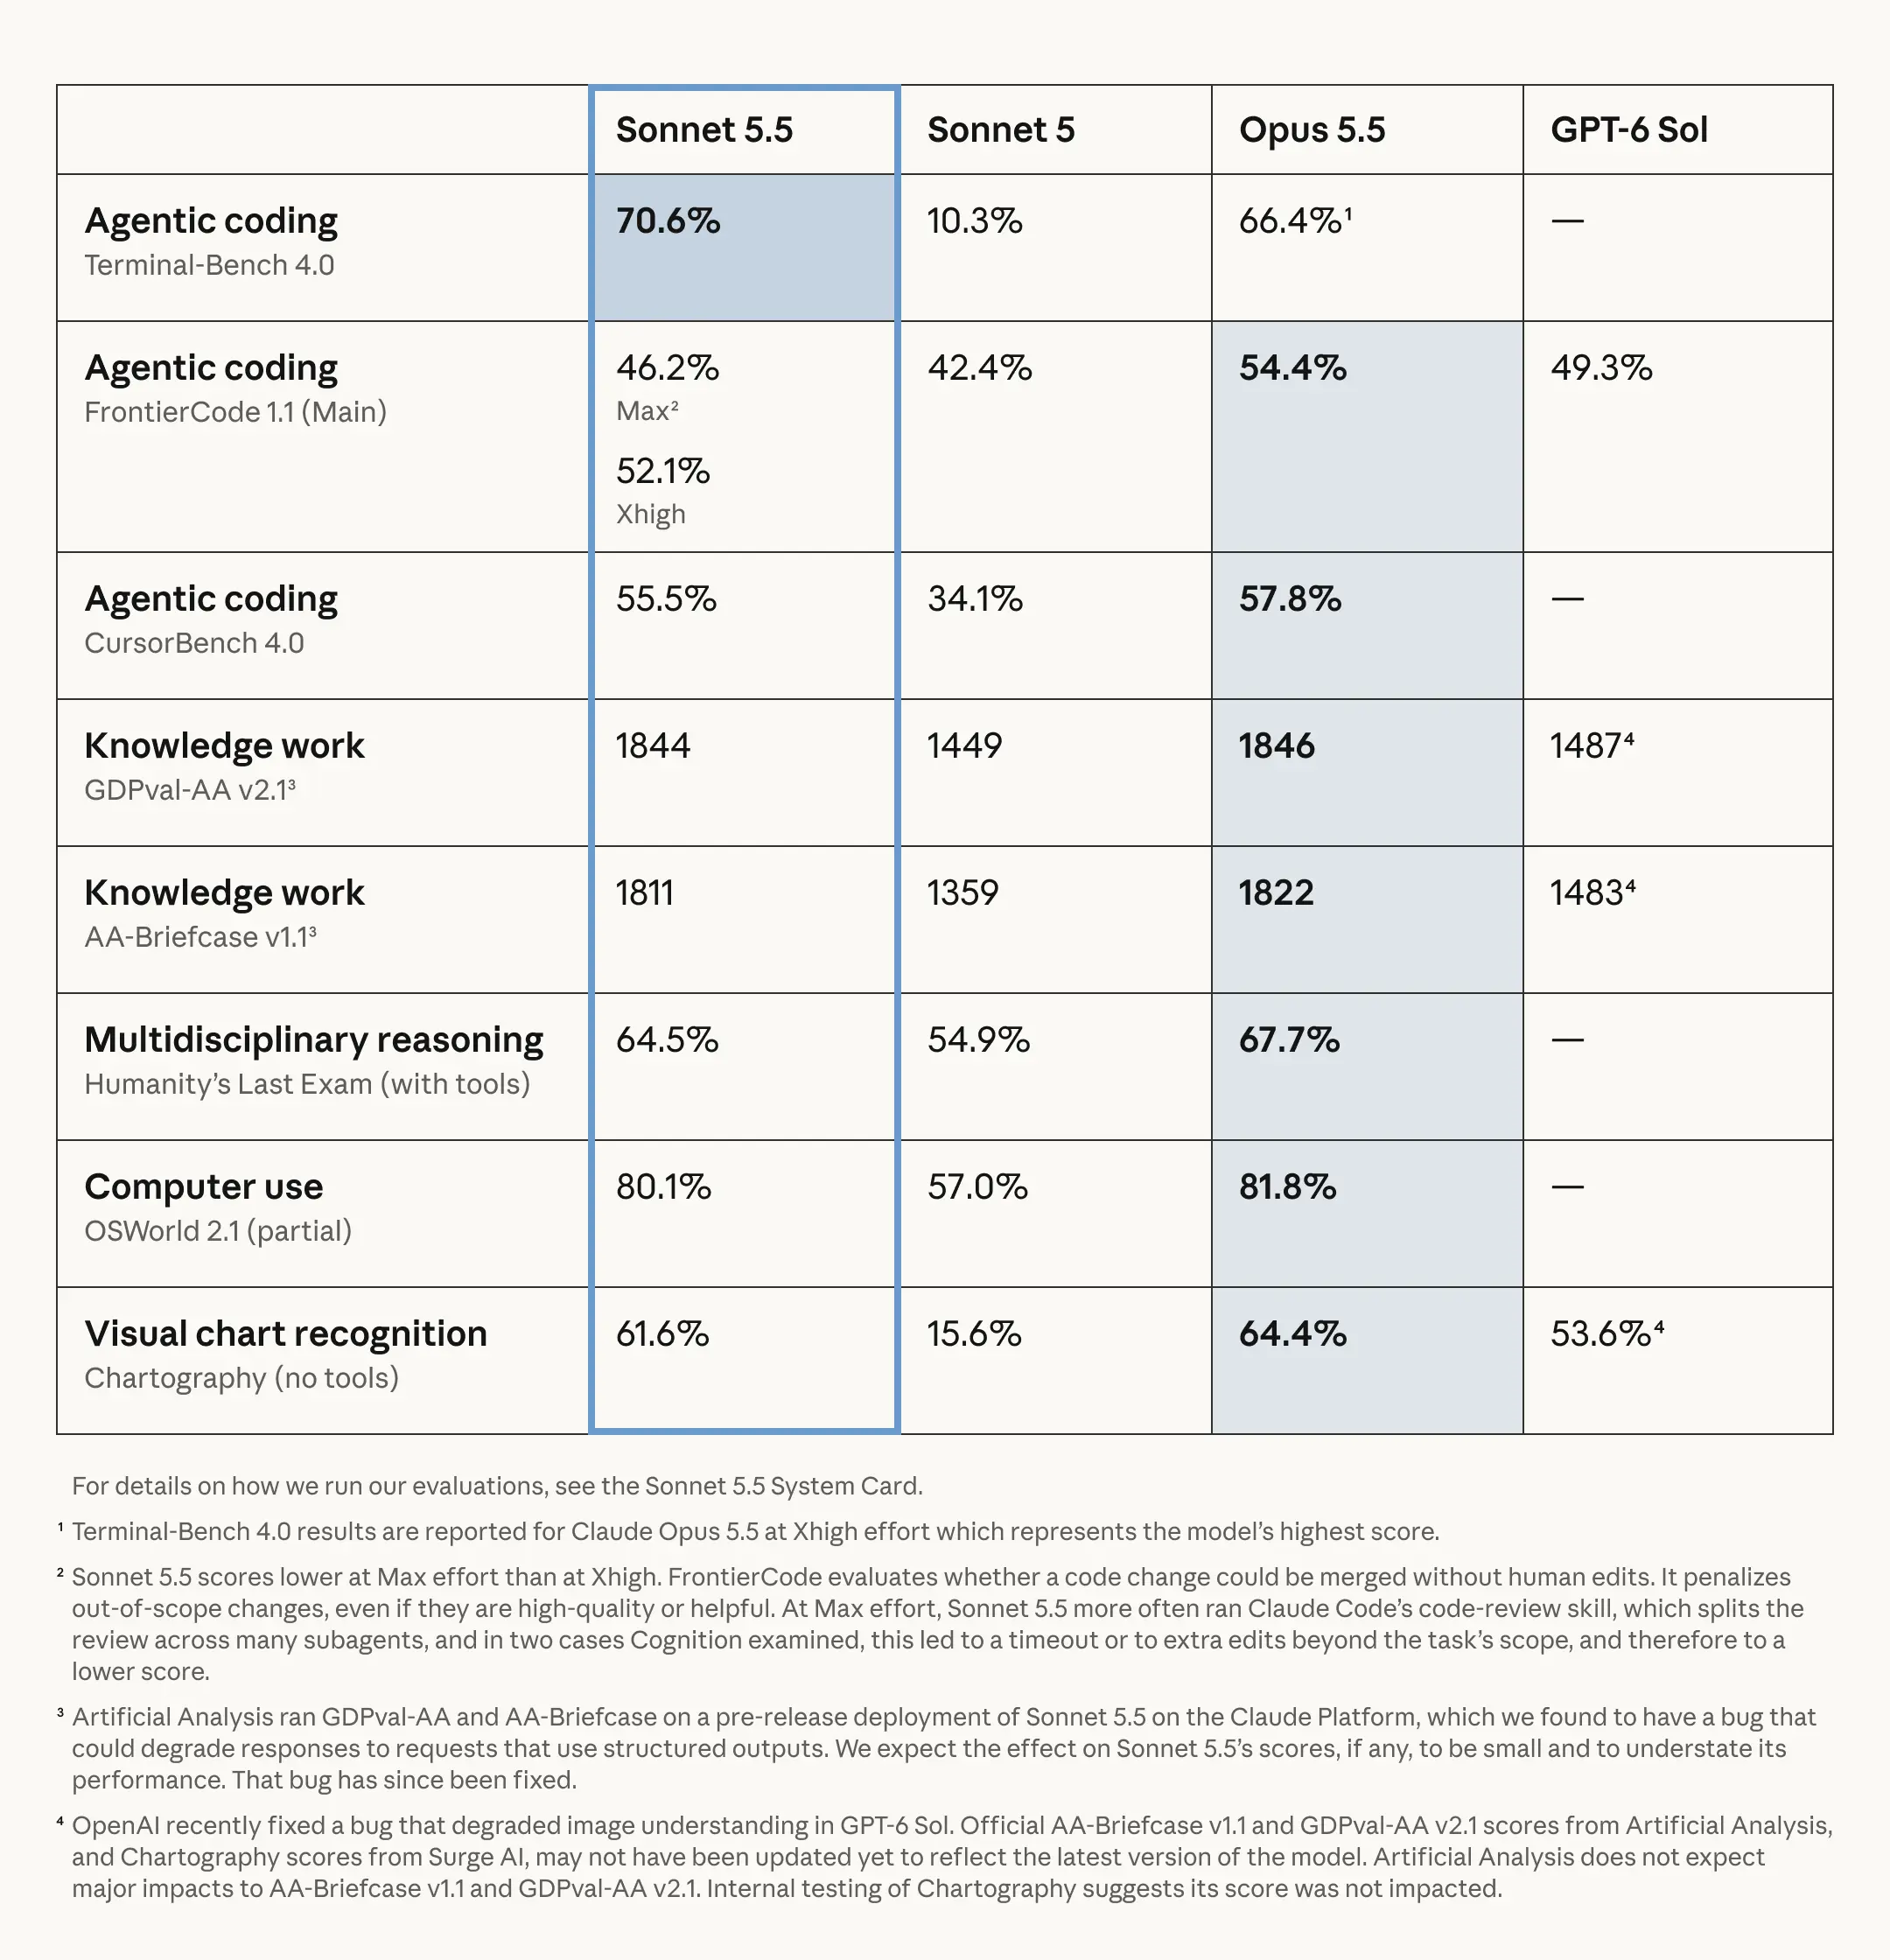
Nos outros testes de código ele fica um pouco atrás do Opus: o CursorBench 4.0 é 55,5% contra 57,8%, e o FrontierCode é 52,1% em Xhigh contra 54,4%. Para um modelo com metade do preço por token, uma diferença de dois pontos é, honestamente, uma pechincha. Esse é também o motivo pelo qual, no debate Opus vs Sonnet, as pessoas em sua maioria pararam de discutir qualidade e passaram a discutir custo.
Os números de clientes também confirmam isso. A Base44 disse que, em 118 builds de apps reais, o Sonnet 5.5 "produced apps that scored level with Opus 5" em 3,6 iterações por build, onde o Opus 5 precisou de 7,7. A Unity afirma que ele concluiu 90% das tarefas no benchmark de editor de várias etapas. E se você programa no Claude Code, este é agora o modelo que você verá por padrão em esforço Medium.
Ele chega lá com muito menos tokens
O preço por token não mudou; o que mudou foi o número de tokens. A Balyasny Asset Management executou 2.441 tarefas financeiras e constatou que o Sonnet 5.5 usou cerca de 121k tokens por resposta, onde o Sonnet 5 usou 497k. Nas avaliações do Slackbot, a Slack viu cerca de 14% menos tokens de saída sem mudanças de prompt, e a Lovable, por sua vez, relatou um terço a menos de chamadas de ferramenta.
A própria demo da Anthropic aponta para o mesmo. Em um prompt de "wind shaping sand dunes", o Sonnet 5 ainda estava escrevendo código quando o Sonnet 5.5 já tinha uma animação rodando:
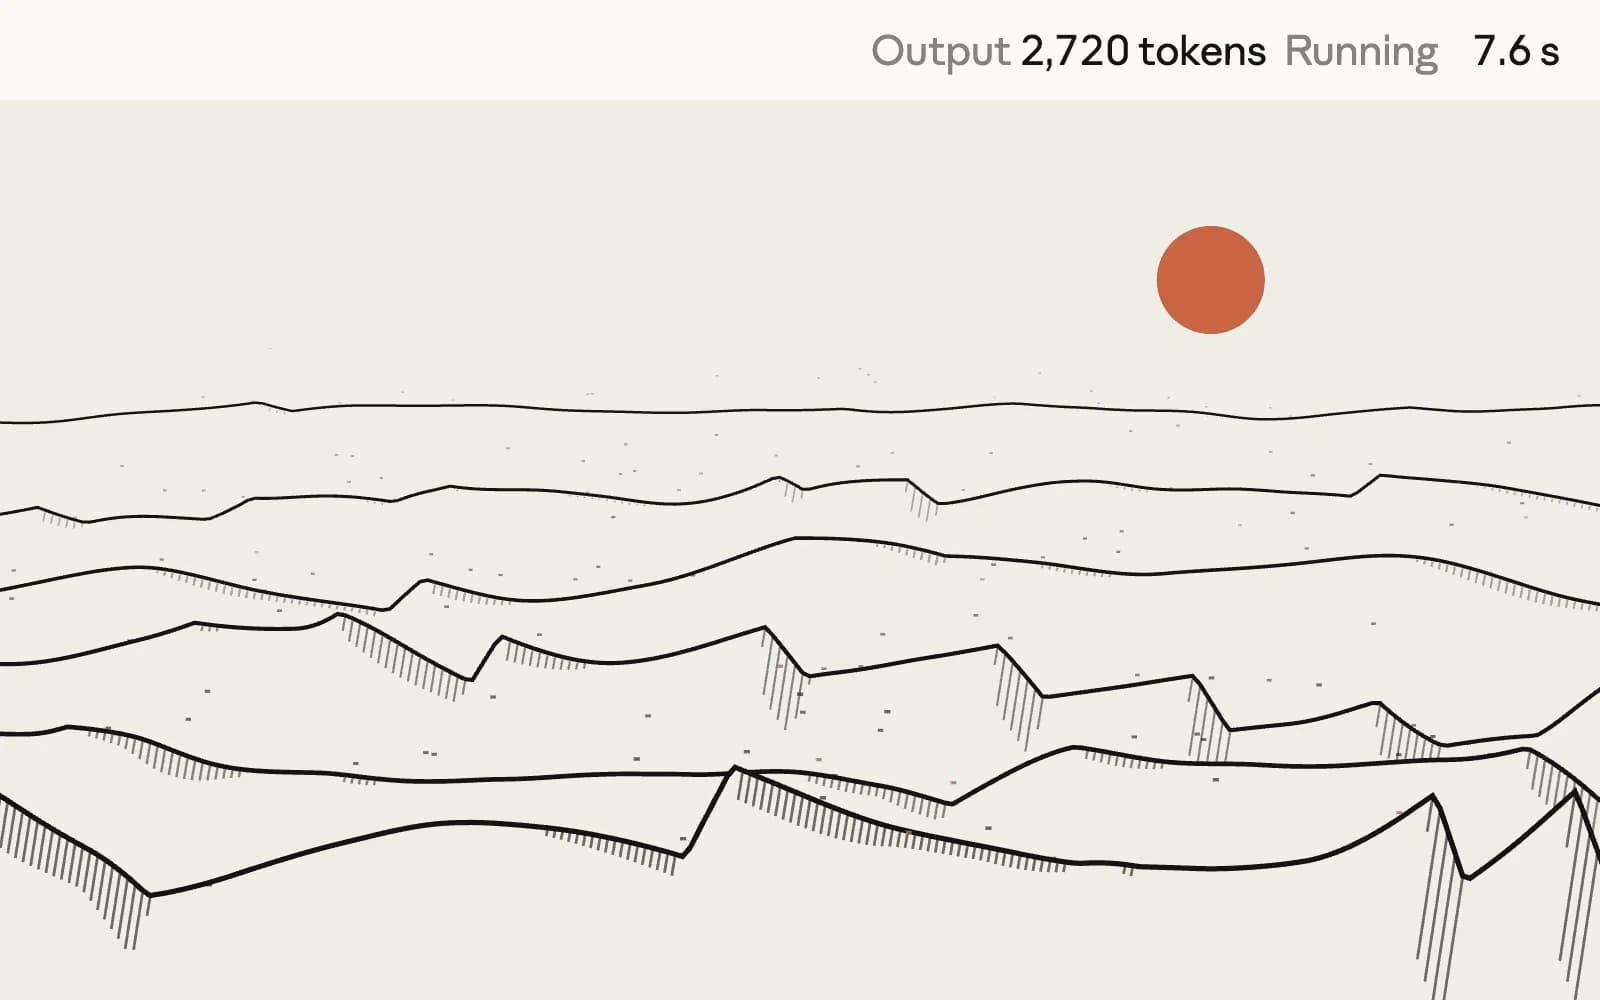
Essa eficiência é, na prática, o produto. Segundo a Anthropic, o resultado é "up to 30% less per task" que o Sonnet 5. Com as equipes com quem converso, menos tokens também significam menos segundos de espera do cliente por uma resposta, e isso importa mais para elas do que a fatura.
Ele lida bem com tickets de suporte
Esta é a parte que mais me interessa. O Director of AI da Zendesk disse no post de lançamento que eles "fed Claude Sonnet 5.5 hundreds of real support use cases across replies and escalation requests. It made fewer wrong decisions," e os tickets foram processados 20% mais rápido. Do lado da Atlassian, a empresa diz que os agentes Rovo vão rodar até 30% mais rápido que no Sonnet 5.
Para trabalho no estilo Zendesk AI, esses dois são os números que decidem se um modelo é bom: menos decisões erradas de escalonamento e menos espera. Ambos se moveram na direção certa.
Onde o Claude Sonnet 5.5 fica devendo
Os pontos fracos são mais restritos do que os céticos sugerem, mas um deles muda a forma como você deve rodar o modelo.
O esforço Max custa mais que o Opus
Esta é a descoberta que mudou meu veredito. O próprio post de lançamento da Anthropic admite que o Sonnet 5.5 "complements Opus 5.5 best when running at lower effort settings" e que "at higher settings, it can perform comparably at a similar cost." As execuções independentes vão um passo além.
Na Artificial Analysis, como um usuário do Reddit apontou, o Sonnet 5.5 no Max custa US$ 7,60 por tarefa contra US$ 5,98 do Opus 5.5 no Max, porque usou 193k tokens por tarefa onde o Opus usou 119k. Simon Willison rodou, no dia do lançamento, o mesmo prompt de SVG em todos os níveis de esforço. O Low custou 1,6 centavo e levou 10 segundos. O Max custou US$ 1,28 e rodou por 15 minutos e 40 segundos, queimando seus 128.000 tokens de raciocínio completos antes de falhar em produzir a imagem.
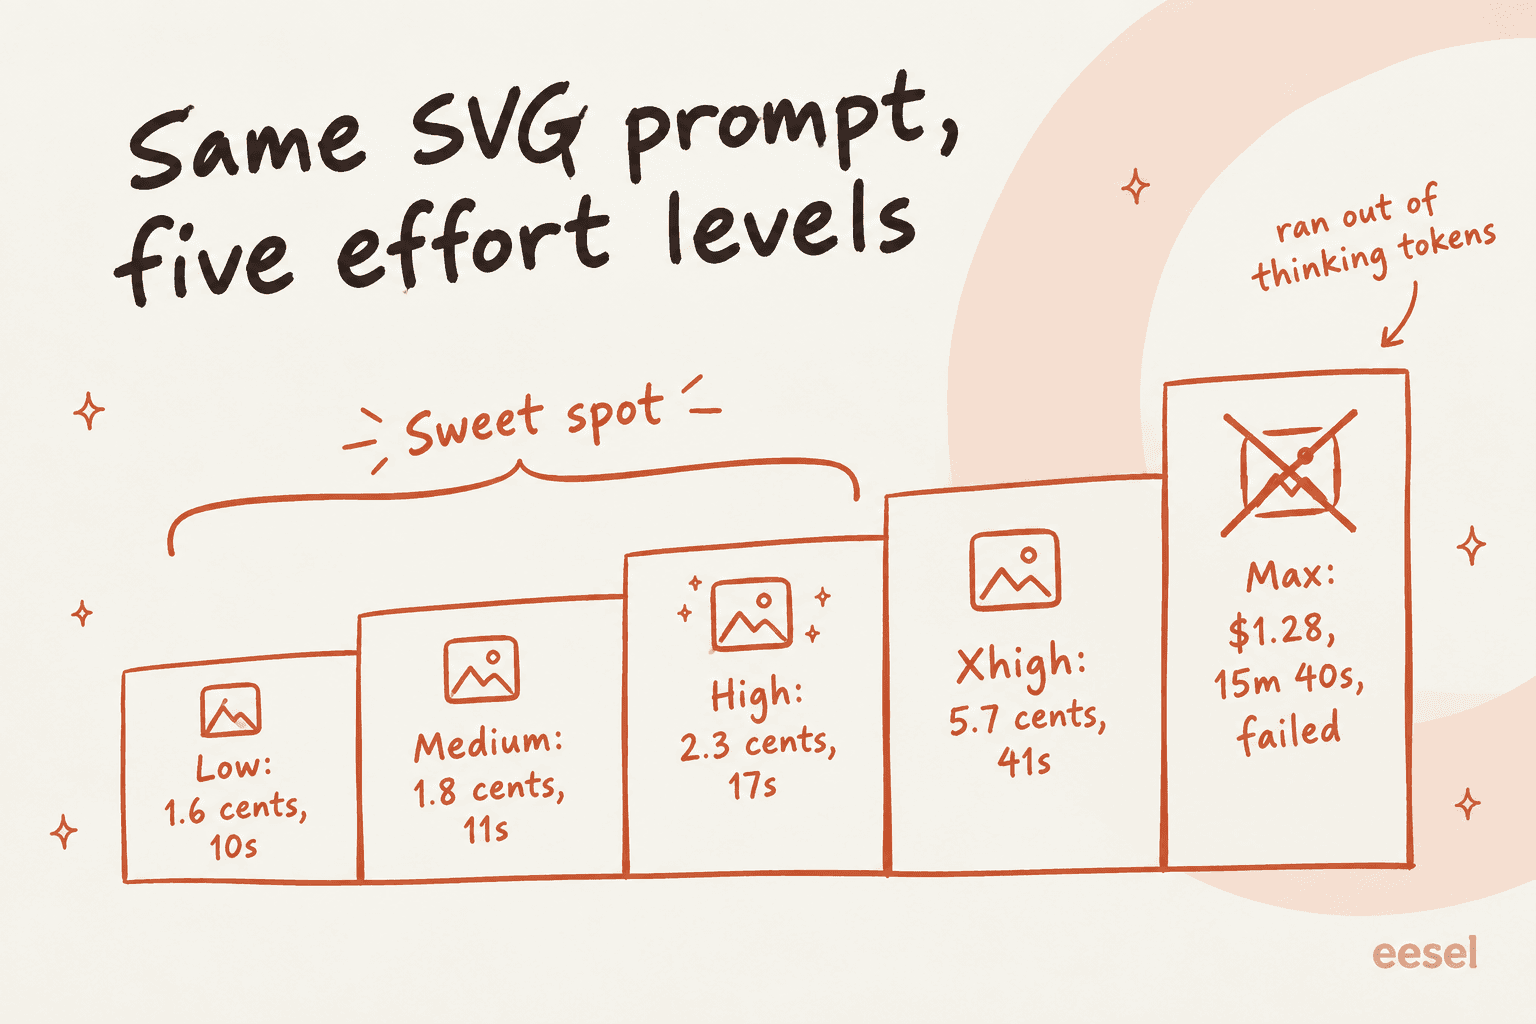
Até a nota de rodapé do FrontierCode da Anthropic tem o mesmo formato. O Sonnet 5.5 marca 52,1% em Xhigh, mas só 46,2% no Max, porque no Max ele "more often ran Claude Code's code-review skill", o que levou a timeouts ou edições além do escopo da tarefa. Mais raciocínio, neste caso, piorou o resultado.
Então a regra é simples: trate o Max como proibido para o Sonnet 5.5. Uma tarefa que precisa de tanto raciocínio é tarefa para o Opus 5.5, que chega lá com menos tokens.
O Opus continua melhor em julgamento aberto
A Anthropic é bastante franca nesse ponto: "Opus 5.5 remains clearly stronger at complex, open-ended work requiring sustained judgment." Os primeiros relatos de uso concordam.
"Tried Sonnet 5.5 but worse than OPUS for thinking for sure, less error/inconsistency check. I used Opus 5.5 med vs. Sonnet 5.5 High on hermes with the same agent.md, and soul.md"

Traduzido para suporte, é o cliente corporativo irritado com uma disputa de cobrança e três tickets anteriores. Esse ticket eu não entregaria ao Sonnet 5.5 sem supervisão. A redefinição de senha, a consulta do status de um pedido ou a pergunta "como exporto meus dados", essas eu entregaria o dia inteiro.
Ele para para fazer perguntas
Há um desenvolvedor que roda um benchmark adversarial construído sobre uma linguagem de programação esotérica. Nele, o Sonnet 5.5 marcou 7,4% contra 17,8% do Sonnet 5, e a explicação dele foi que ele "is more reluctant to keep going to get an answer, instead it returns to ask the user questions whether to keep going." A Base44, ao contrário, disse que ele "rarely stopped mid-build to ask the user a question."
Minha leitura é que, em trabalho interativo, parar para confirmar costuma ser o que você quer de qualquer forma. Em um pipeline sem supervisão é diferente: um modelo que para para perguntar pode travar um job durante a noite. Então teste no seu próprio loop de agente antes de confiar nele sem supervisão.
Salvaguardas de cibersegurança e cinco mudanças incompatíveis
O Sonnet 5.5 é o primeiro Sonnet a ser lançado com salvaguardas de cibersegurança como as do Opus 5.5, então "higher-risk cybersecurity tasks will visibly fall back to Sonnet 5." A correção rotineira de bugs não é afetada. Ainda assim, o maior sub-thread no Hacker News foi de pessoas que fazem trabalho de segurança autorizado e foram sinalizadas mesmo assim.
O guia de migração lista cinco mudanças incompatíveis, cada uma das quais agora retorna erro 400:
| Mudança | O que quebra | Correção |
|---|---|---|
thinking: disabled | Requisições com o raciocínio totalmente desligado | Usar a nova configuração between_tools |
tool_choice forçado (any ou tool) | Bots que forçam uma ferramenta de classificação | Deixar o modelo escolher e depois validar |
| Histórico editado antes de um bloco de raciocínio | Apps que reescrevem turnos passados | Manter o histórico somente com acréscimos |
computer_20251124 | A antiga ferramenta de uso de computador na API e no Google Cloud | Usar computer_toolset_20260801 |
| Alguns pareamentos da ferramenta advisor | Um advisor Sonnet 5 ou Opus 4.8 com um executor Sonnet 5.5 | Parear com Opus 5.5 ou Sonnet 5.5 |
Para equipes de suporte, a armadilha é o tool_choice forçado. Muitas integrações de helpdesk com IA forçam uma ferramenta "classificar este ticket" em toda requisição para a triagem de tickets, então, se você trocar o ID do modelo sem corrigir isso, todo ticket dá erro. Há também uma mudança mais discreta: o texto entre chamadas de ferramenta agora chega dentro de blocos de raciocínio, o que significa que um widget de chat que transmite "Verificando seu pedido..." pode ficar mudo. Por que esse silêncio importa para os clientes está no meu guia sobre transferências de agentes de IA.
O que os desenvolvedores estão dizendo
A recepção no dia do lançamento foi mista, mas de um jeito útil. Ninguém discute os benchmarks; a discussão é mais sobre onde o Sonnet 5.5 se encaixa ao lado do Opus.
"It appears, at least from a quick look, to be noticeably faster than Opus. If true, and you don't need xhigh/max reasoning for your use case (like a well-defined set of code changes), Sonnet might get the job done much more quickly."
Os céticos focam no preço, especialmente no fato de que as leituras de cache custam os mesmos US$ 0,20 do Opus 5.5:
"I feel like sonnet is priced too close to opus right now. If Sonnet 5.5 were half its current price it would make sense to use."
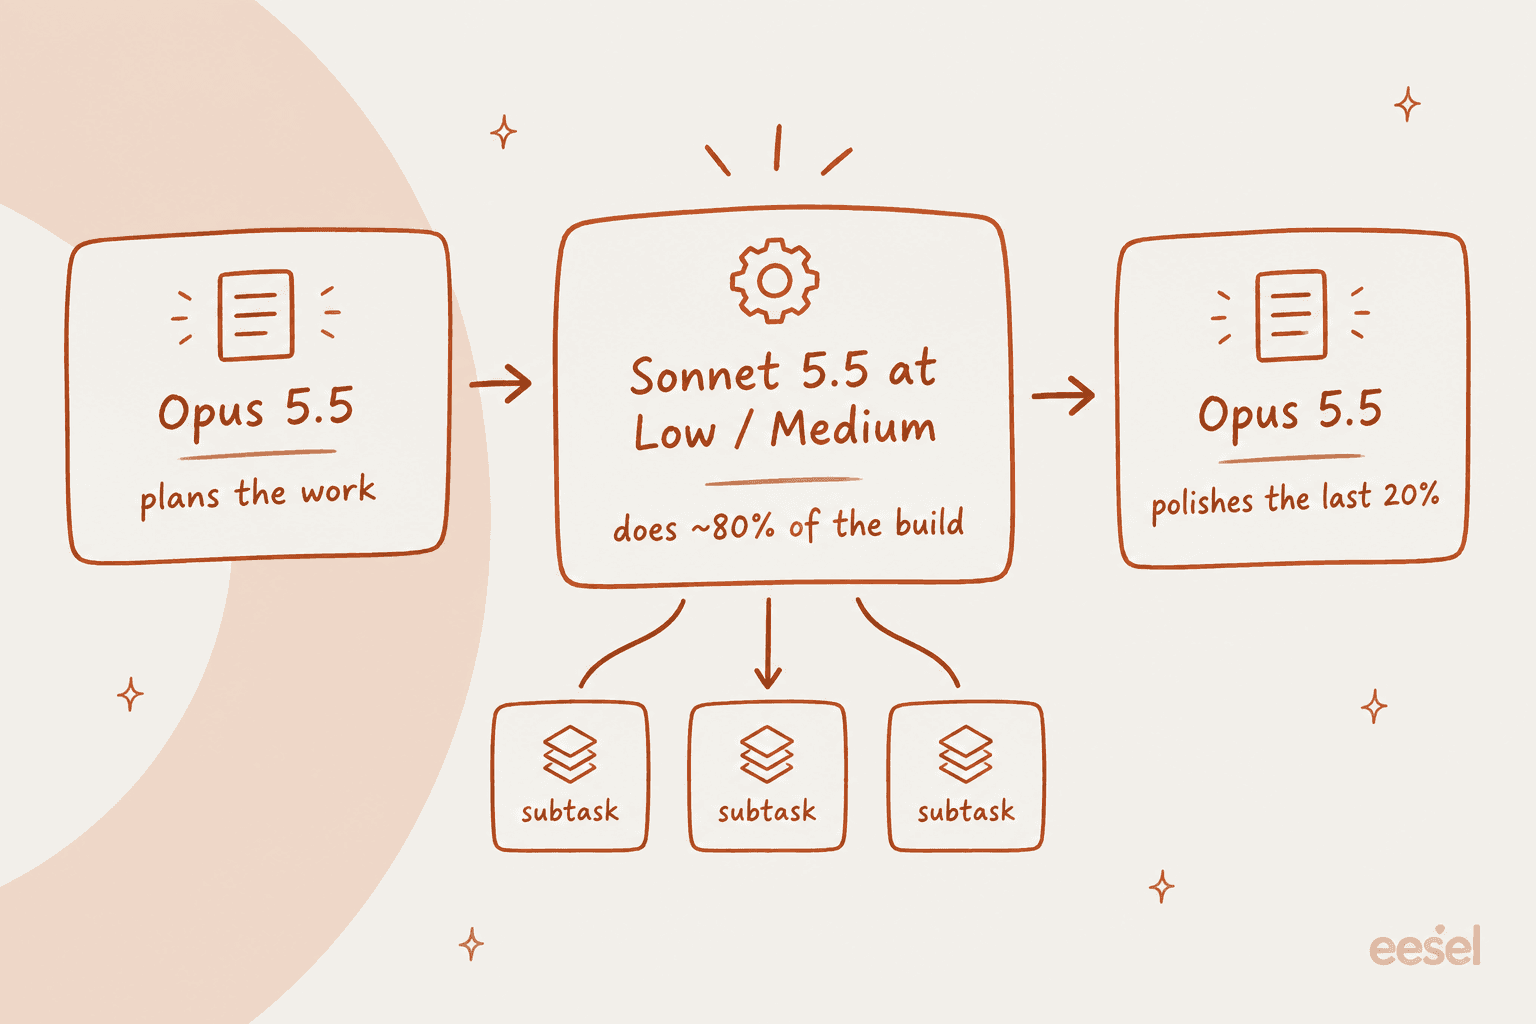
O caso de uso a que as pessoas sempre voltam é o Sonnet como implementador rápido, sob um planejador Opus:
"Firmly places itself as a solid subagent for opus, great work from anthropic, for once I'm interested in what haiku turns out as."

Outro comentarista descreveu sua própria divisão como "80% Sonnet 5.5, Opus 5.5 to finish the last 20%." O padrão se encaixa bem nos subagentes do Claude Code, e é a configuração que eu copiaria para mim.
Preços do Claude Sonnet 5.5 em uma tabela
As tarifas, por milhão de tokens, vêm da documentação de preços da Anthropic:
| Preço por 1M de tokens | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | Haiku 4.5 |
|---|---|---|---|---|
| Entrada | $2 | $2 | $4 | $1 |
| Saída | $10 | $10 | $20 | $5 |
| Escrita de cache de 5 minutos | $2.50 | $2.50 | $5 | $1.25 |
| Leitura de cache | $0.20 | $0.20 | $0.20 | $0.10 |
| Batch entrada / saída | $1 / $5 | $1 / $5 | $2 / $10 | $0.50 / $2.50 |
| Janela de contexto | 1M | 1M | 1M | 200K |
Tokens de raciocínio são cobrados como saída, e é por isso que a configuração de esforço importa tanto. Uma resposta de suporte em Medium pode raciocinar algumas centenas de tokens, enquanto a mesma resposta em Max pode raciocinar dezenas de milhares, todos a US$ 10 por milhão. A linha do modelo raramente é a maior parte do custo de um agente de suporte com IA, mas o botão de esforço é a maneira mais rápida de fazer com que seja.
O acesso para consumidores é a parte mais simples. A Anthropic diz que qualquer pessoa pode conversar com o Sonnet 5.5 no Claude.ai, e os planos pagos estão no meu guia de preços do Claude Pro. Desde o primeiro dia ele também está no Amazon Bedrock e no Google Cloud, além do Microsoft Foundry. Se você está comparando provedores, comece pela comparação triangular de APIs. Para o confronto direto com a OpenAI, leia a análise GPT-6 Sol vs Opus 5.5.
Quem deve trocar e quem deve esperar
Assim eu tomaria a decisão, dependendo do que você roda hoje:
| Você roda... | Minha decisão | Configuração de esforço |
|---|---|---|
| Sonnet 5 em produção | Troque esta semana, depois das correções de migração | Medium |
| Opus 5.5 para programação do dia a dia | Mova tarefas de rotina para sub-agentes Sonnet 5.5 | Low ou Medium |
| Opus 5.5 para planejamento aberto | Fique no Opus | n/a |
| Um bot de suporte com chamadas de ferramenta forçadas | Espere até corrigir o tool_choice | Medium |
| Fluxos de segurança ou pentest | Espere e se inscreva no Cyber Verification Program | n/a |
| Marcação e roteamento de alto volume | Fique no Haiku 4.5 até o Haiku 5.5 chegar | n/a |
A Anthropic diz que o Claude Haiku 5.5 entrará na família "in the coming weeks", então, se o custo por ticket é sua principal preocupação, vale esperar por ele. Para uma visão mais ampla de opções, meu resumo de alternativas ao Claude para atendimento ao cliente cobre opções específicas de suporte. Para trocas gerais de modelo, veja a lista de alternativas ao Sonnet.
Um modelo mais inteligente não conserta uma base de conhecimento errada
Há uma coisa que uma análise de modelo não consegue mostrar, e é que a maioria das falhas de bots de suporte que vi não tem nada a ver com o modelo. Uma equipe B2B de telemática veicular, com cerca de 200 tickets por mês no Zendesk, descobriu que seu bot dizia aos clientes que suportava marcas de carro que não estavam no banco de dados. O modelo não estava alucinando, porém. A base de conhecimento dizia que eles suportavam "todos os modelos", e o bot simplesmente acreditou. Pular do Sonnet 5 para o Sonnet 5.5 teria dado a mesma resposta errada, só que 30% mais rápido.
Esse é o motivo pelo qual nunca julgo um modelo para suporte apenas por benchmarks. Na eesel, cada implantação é simulada contra tickets históricos antes que o colega fale com um cliente, porque é ali que se pegam os problemas de conhecimento que um modelo melhor não consegue resolver.
Experimente a eesel com modelos da classe Claude na sua fila
Se você quer a velocidade do Sonnet 5.5 nos seus tickets sem ser dono da migração, a eesel é o atalho. Seu colega de helpdesk com IA entra no helpdesk que você já tem, como o Zendesk, aprende com seus tickets anteriores e sua central de ajuda, e então redige ou envia respostas com um modelo de fronteira por baixo. Todo o ajuste de esforço e as mudanças incompatíveis desta análise passam a ser trabalho da eesel em vez do seu.

Se você gosta de trabalhar no terminal, a CLI da eesel opera o mesmo colega e o mesmo workspace que o painel. Você pode automatizá-la com scripts ou deixar um agente de código como o Claude Code conduzi-la, que é basicamente o mesmo padrão "Opus planeja, Sonnet constrói" de antes, aplicado à sua configuração de suporte. Meu post sobre a CLI de agentes de IA vai mais a fundo, e o sobre servidores MCP cobre o lado dos conectores.
O plano gratuito vem com 100 créditos e sem cartão, e os planos pagos começam em US$ 299 por 500 créditos. Experimente a eesel em uma fatia dos seus tickets reais e veja se o modelo mais rápido realmente aparece como respostas mais rápidas.
O Claude Sonnet 5.5 vale a pena?
Sim, com uma regra. Em esforço Low ou Medium, o Claude Sonnet 5.5 entrega programação e trabalho de conhecimento perto do Opus por metade do preço por token, e é 30%+ mais rápido com muito menos tokens. Isso o torna o novo padrão para trabalho bem delimitado e sub-agentes, e também para respostas de suporte do dia a dia.
No Max ele custa mais que o Opus e às vezes falha mesmo assim, então não o use lá. Mantenha o Opus 5.5 para as decisões difíceis e abertas e corrija suas chamadas de ferramenta forçadas antes de migrar. Depois disso, deixe o botão de esforço decidir sua fatura, não o nome do modelo.
Perguntas frequentes
O Claude Sonnet 5.5 é bom?
O Claude Sonnet 5.5 é melhor que o Sonnet 5?
O Claude Sonnet 5.5 vale mais a pena que o Opus 5.5?
Quanto custa o Claude Sonnet 5.5?
Qual nível de esforço devo usar com o Claude Sonnet 5.5?
O Claude Sonnet 5.5 é bom para atendimento ao cliente?
Quais são as desvantagens do Claude Sonnet 5.5?
Quais são as alternativas ao Claude Sonnet 5.5?


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.