

Resumo rápido
Dou ao Kimi K3.1 Pro 3,5 de 5: ele raciocina quase tão bem quanto o Claude Opus 5.5, com 55.1 no Artificial Analysis Intelligence Index (#4 de 215), a US$ 2 por entrada e US$ 10 por saída por milhão de tokens. Para trabalhos longos de agentes que você pode deixar rodando sem supervisão, ele oferece o melhor custo-benefício entre os modelos próximos do topo do ranking neste momento.
Ele perde pontos pela forma como funciona, não por sua inteligência. É lento, com cerca de 50 tokens por segundo, escreve respostas longas que corroem a vantagem do preço baixo, os pesos abertos foram prometidos para "by Nov 4", mas ainda não saíram, e assinantes do Kimi Code relatam esgotar um limite de 5 horas em menos de uma hora. Contrate pela API para tarefas que podem esperar; evite para qualquer coisa em que uma pessoa fique esperando.
Se você chegou aqui escolhendo um modelo para um agente de suporte, o modelo é a parte menor da decisão. Eu desenvolvo as integrações e APIs da eesel e, em anos usando IA em filas reais de helpdesk, o que determina a qualidade é a configuração ao redor do modelo. A SamCart usa a eesel nos tickets do Freshdesk e no chat do site, respondendo com base em 280 artigos da central de ajuda, sem nunca se preocupar com qual modelo liderou um ranking naquela semana.
O que é o Kimi K3.1 Pro?
O Kimi K3.1 Pro é o modelo principal da Moonshot AI, lançado em 23 de outubro de 2026. A Moonshot o chama de "a post-trained version of Kimi K3, with substantially larger post-training compute" em seu post de lançamento, então é a mesma base de 2.8T parâmetros do Kimi K3 (104B ativos, mistura de especialistas), com muito mais treinamento adicional e uma janela de contexto de 1M tokens.
Ele está disponível no app Kimi, no Kimi Work, no Kimi Code e na Kimi API, e agora é o modelo padrão na caixa de chat do kimi.com. Se você quer um panorama completo do lançamento (benchmarks, comparação com o K3, formas de acesso), minha visão geral do Kimi K3.1 Pro cobre tudo isso. Este post é o veredito, no mesmo formato da minha avaliação anterior do Kimi K3.
Como testei e avaliei o Kimi K3.1 Pro?
Li o post de lançamento da Moonshot, o guia de início rápido da API e a página de preços, depois analisei os resultados independentes da Artificial Analysis e a primeira leva de testes práticos, incluindo a discussão no Hacker News com 674 comentários. O modelo tem quatro dias de vida, então não vou fingir que o uso em produção há meses. O que posso fazer é avaliá-lo pelos fatores que determinam se vale a pena desenvolver algo com ele.
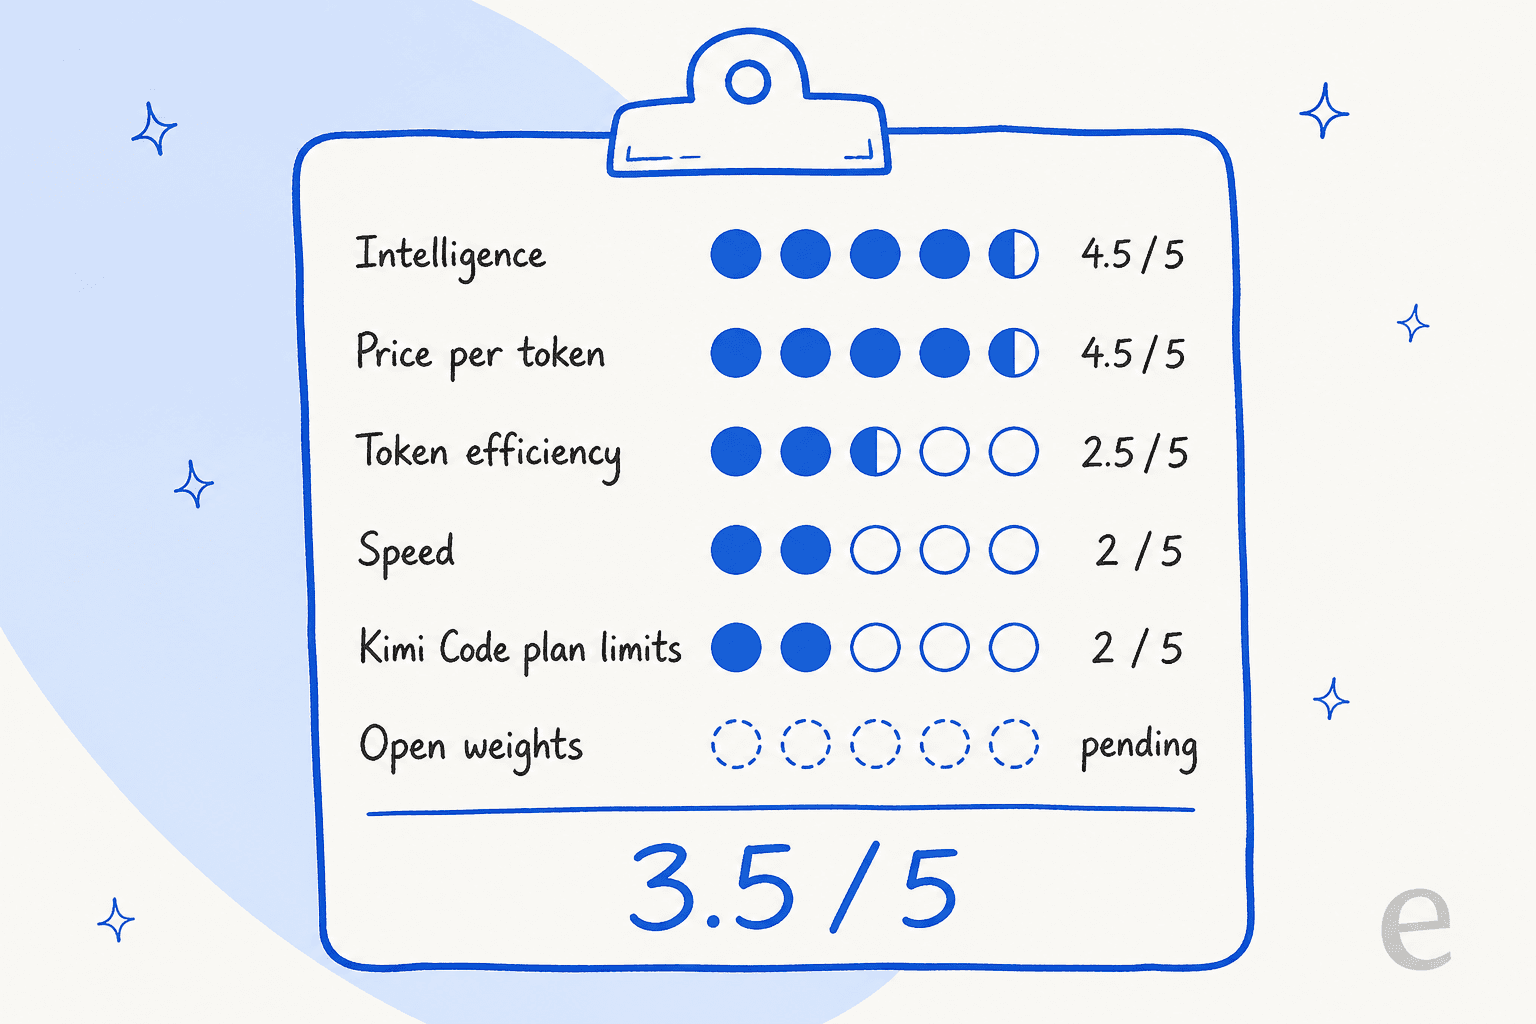
| Categoria | Nota | Motivo |
|---|---|---|
| Inteligência | 4,5/5 | 55.1 no índice da AA, 2.5 pontos atrás do Opus 5.5 (Max) |
| Preço por token | 4,5/5 | US$ 2 / US$ 10, um terço mais barato que o K3, sem sobretaxa por contexto longo |
| Eficiência de tokens | 2,5/5 | 150M tokens de saída para executar o índice da AA contra uma mediana de 87M entre os pares |
| Velocidade | 2/5 | 49.7 tokens por segundo, posição 165 de 182 |
| Limites dos planos do Kimi Code | 2/5 | Vários assinantes relatam atingir o limite de 5 horas em menos de uma hora |
| Pesos abertos | Pendente | Prometidos até 4 de novembro, não publicados em 27 de outubro |
| Geral | 3,5/5 | Motor potente, mas com arestas na forma como você consegue usá-lo |
Quais são os pontos fortes do Kimi K3.1 Pro?
Resumindo: nenhum laboratório de fora dos EUA chegou tão perto do topo do ranking, a um preço intermediário. Veja onde isso aparece.
Raciocínio próximo dos modelos de ponta por US$ 2 e US$ 10
Na Artificial Analysis, o K3.1 Pro marca 55.1, contra 57.6 do Claude Opus 5.5 (Max) e 56.0 do Claude Sonnet 5.5 (Max). Ele fica acima do GPT-6 Astra (Max), com 52.7, e do Gemini 4 Argon (High), com 52.6. Na mesma versão do índice, o Kimi K3 marca 43.6, então este lançamento representa um salto de mais de 11 pontos a partir do mesmo modelo-base.
O preço é o que torna isso interessante. O K3.1 Pro tem preço de tabela de US$ 2 por entrada, US$ 0,20 por entrada em cache e US$ 10 por saída por milhão de tokens na Kimi API, o que é um terço a menos que os preços do Kimi K3 e o mesmo preço de tabela do Sonnet 5.5. Ele executou o índice completo da Artificial Analysis por $3,117, contra $8,708 do Opus 5.5 (Max).
Tarefas longas de agentes e trabalho de escritório
É aqui que o treinamento adicional aparece. A Artificial Analysis mediu 67.2% no Terminal-Bench 4.0, a maior pontuação entre todos os modelos apresentados em sua página do K3.1 Pro, contra 12.6% do K3. Nos testes da própria Moonshot, ele lidera no SWE Marathon (51.7 contra 46.3 do Opus 5.5) e no OfficeQA Pro v2 (64.4 contra 62.2), um benchmark de finanças e documentos de escritório.
Ele também inventa menos coisas que o K3. No Hallu Bench interno da Moonshot, a taxa de alucinação por afirmação em perguntas difíceis com ferramentas caiu de 23.4% para 8.3%. Esse é um teste da própria Moonshot, então dou pouco peso a ele, mas o número independente aponta na mesma direção: a taxa de alucinação da AA é de 43.9% para o K3.1 Pro, contra 53.2% do K3 e 58.6% do Opus 5.5 (Max).
Os primeiros relatos de uso prático confirmam isso. Um desenvolvedor migrou diretamente do K3:
"Using it now via API (3.1 Pro on Open Router) in a HITL setup (Cline in VSCode). Off-hand it's quite good. I've been using K3 for the past few months almost exclusively for coding work and have been stunned by how good it is. Excited to see how far 3.1 Pro can be pushed."

Uma janela de contexto de 1M com preço fixo
O guia de início rápido diz que o K3.1 Pro tem preços fixos por uso, sem faixas por tamanho de contexto, então um prompt de 900.000 tokens custa o mesmo por token que um curto. A entrada em cache é cobrada a US$ 0,20 por milhão, um desconto de 90%, com cache padrão de 5 minutos e uma opção de 1 hora. Para agentes que releem uma base de código grande ou um contrato longo a cada interação, isso resulta em uma economia real.
Onde o Kimi K3.1 Pro deixa a desejar?
Tudo que custou pontos a ele está ao redor do modelo, não dentro dele. Estes são os cinco problemas que influenciariam minha decisão de desenvolver algo com ele hoje.
Ele é lento
A Artificial Analysis mediu 49.7 tokens de saída por segundo na própria API da Moonshot, posição 165 de 182, e o chamou de "notably slow". A tarefa média em seu índice de benchmarks levou 1,011 segundos, cerca de 17 minutos. A solução da Moonshot é o Kimi K3.1 Pro Highspeed, que, segundo ela, roda a "2-3× the speed" por exatamente o dobro do preço (US$ 4 / US$ 20).
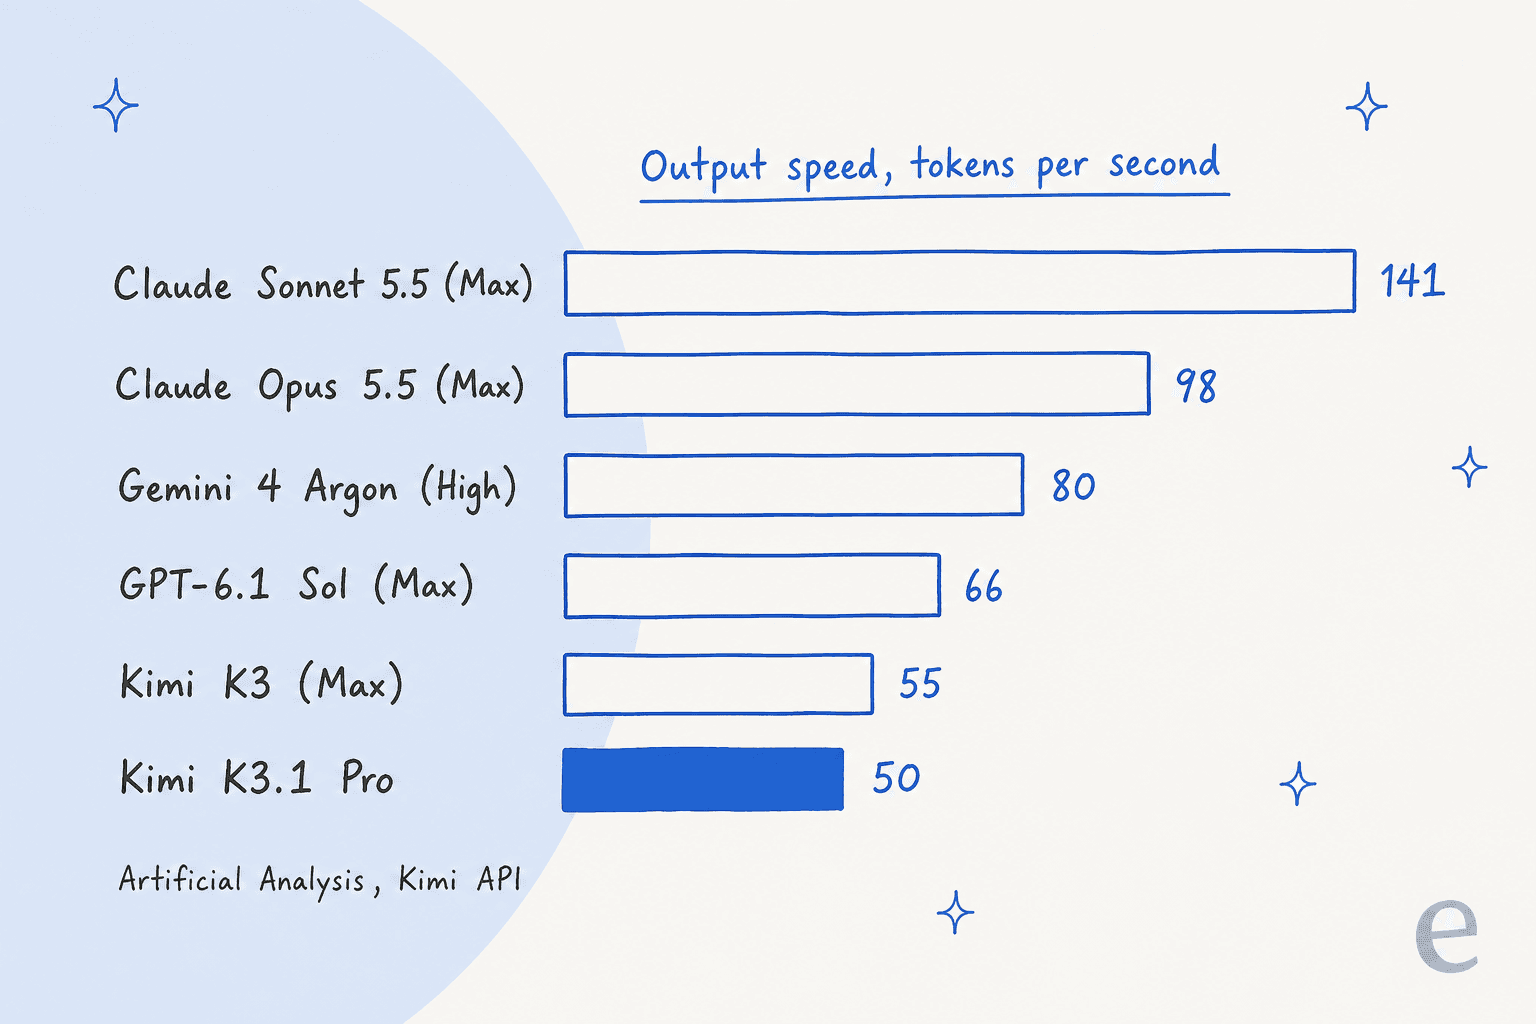
O Sonnet 5.5 custa o mesmo por token e transmite a saída quase três vezes mais rápido. Para uma tarefa em lote rodando durante a noite, 50 tokens por segundo não fazem diferença. Para uma janela de chat com uma pessoa olhando para ela, fazem.
Ele escreve muito
O K3.1 Pro usou 150M tokens de saída para executar o índice da Artificial Analysis, contra uma mediana de 87M entre os pares. A maior parte disso é raciocínio: 34,883 tokens de raciocínio por tarefa, em média. Então o desconto por token não se reflete integralmente na conta. Por tarefa, a média foi de $2.11, contra $2.00 do K3, embora o preço de tabela do K3 seja US$ 3 / US$ 15. Detalho essa conta no post sobre os preços do Kimi K3.1 Pro.
"So their base price is 1/5th of Opus 5.5 per token, but if you want "highspeed" it's 2x that and then I guess it generates 2x the number of tokens as well? That might suggest that Opus is competitively priced after all."
O ajuste que você tem à disposição é reasoning_effort. A API aceita low, high e max, e a página de chave de API lista max como padrão. Todos os números de benchmarks acima foram obtidos no nível máximo, então reduzir o esforço significa trocar pontuação por menos tokens.
Os limites do Kimi Code se esgotam rápido
A reclamação mais forte na discussão de lançamento não é sobre qualidade, é sobre cota. A página do Kimi Code lista o Plus a US$ 19, o Pro a US$ 39, o Max a US$ 99 e o Ultra a US$ 199 por mês, e o Highspeed exige Pro ou superior e usa o dobro de créditos. Os novos planos mantêm uma janela móvel de 5 horas mais um saldo mensal de créditos compartilhado com o app Kimi.
"If you are expecting any sort of usable limits on their subscription plan I suggest adjusting your expectations. I subscribed to $99 a month plan and within 47 minutes with one session (not asking for swarms or anything) was limited by 5-hour quota."
Nem todo mundo esbarrou no limite, e o esforço máximo por padrão é parte da explicação, já que consome tokens mais rápido. Ainda assim, se você vem do Claude Code e espera a mesma folga de uso por dólar, teste por uma semana no plano mensal antes de pagar por um ano.
Os pesos ainda não saíram
A Moonshot chama o K3.1 Pro de seu "most capable 3T-class open-weight model", e tanto o blog quanto o guia de início rápido dizem que os pesos completos serão lançados até 4 de novembro. Em 27 de outubro, a API de modelos do Hugging Face não retornou nenhum repositório K3.1 na conta da Moonshot, e a Artificial Analysis lista a licença como proprietária por enquanto.
Isso importa por dois motivos. Você ainda não pode hospedá-lo por conta própria nem fazer ajuste fino, e só a Moonshot o disponibiliza: a listagem no OpenRouter mostra dois endpoints, ambos da própria Moonshot. A Artificial Analysis contabiliza 5 provedores de API para o K3.1 Pro, contra 20 para o K3. Mesmo quando os pesos chegarem, um modelo de 2.8T parâmetros precisa de um cluster de servidores, não de uma estação de trabalho.
Alguns benchmarks de destaque são internos
Várias das afirmações mais fortes da Moonshot vêm de testes internos: Kimi Code Bench, Hallu Bench, os benchmarks de finanças e a avaliação de cibersegurança. Seus benchmarks de programação foram executados no ambiente de testes do Claude Code, o que uma conta com muitos seguidores no X questionou no dia do lançamento. Os números independentes da Artificial Analysis continuam fortes, então não acho que os benchmarks sejam vazios. Eu só confiaria primeiro nos independentes.
Como o Kimi K3.1 Pro se compara ao Claude, GPT e Gemini?
Todos os números abaixo vêm da página do K3.1 Pro na Artificial Analysis, medidos na API de cada fabricante, então a comparação usa a mesma base.
| Modelo | Índice da AA | Preço de entrada / saída (por 1M) | Velocidade (tokens/s) | Custo por tarefa | Custo para executar o índice | Terminal-Bench 4.0 |
|---|---|---|---|---|---|---|
| Claude Opus 5.5 (Max) | 57.6 | US$ 4 / US$ 20 | 98.1 | $5.98 | $8,708 | 59.6% |
| Claude Sonnet 5.5 (Max) | 56.0 | US$ 2 / US$ 10 | 141.3 | $5.46 | $7,260 | 63.6% |
| Kimi K3.1 Pro | 55.1 | US$ 2 / US$ 10 | 49.7 | $2.11 | $3,117 | 67.2% |
| Claude Fable 5.1 (Max) | 53.4 | US$ 10 / US$ 50 | 69.8 | $7.63 | $13,129 | 52.0% |
| GPT-6 Astra (Max) | 52.7 | US$ 10 / US$ 50 | 66.7 | $3.26 | $5,324 | 59.1% |
| Gemini 4 Argon (High) | 52.6 | US$ 2 / US$ 10 | 79.7 | $1.62 | $2,101 | 57.1% |
| GPT-6.1 Sol (Max) | 51.8 | US$ 2 / US$ 10 | 65.9 | $0.72 | $1,082 | 56.1% |
| DeepSeek V4.1 Flash 1017 (Max) | 45.1 | US$ 0,30 / US$ 1,20 | 169.3 | $0.26 | $445 | 33.8% |
| Kimi K3 (Max) | 43.6 | US$ 3 / US$ 15 | 54.5 | $2.00 | $3,658 | 12.6% |
Duas coisas chamam a atenção. Primeiro, entre os modelos com pontuação de 55 ou mais, o K3.1 Pro é de longe o mais barato de executar. Segundo, ele não é o modelo inteligente mais barato no geral: o GPT-6.1 Sol e o Gemini 4 Argon ficam a três ou quatro pontos de distância por uma fração do custo por tarefa. O ponto ideal do K3.1 Pro é "quase no nível do Claude, por um terço da conta do Claude", não "o mais barato que funciona".
Na experiência de uso, a maioria de quem fez testes práticos concorda que o Opus ainda tem uma vantagem que os benchmarks não capturam:
"I feel Opus still nails the subtle details better, like in the tractor example below. But I wonder if it matters when you can run Kimi 3x before it costs the same as one Opus?"
"TLDR: Kimi is a good model, especially for visual work, but I still find Opus 5.5 more useful for general-purpose tasks and white-collar work."
Se você está comparando especificamente com outros modelos abertos, minhas comparações de Qwen 3.8 Max vs K3 e DeepSeek V4 Flash vs K3 ainda descrevem o cenário mais amplo, e a lista de alternativas ao Kimi K3 é uma boa seleção inicial.
Como é desenvolver com a API do Kimi K3.1 Pro?
Do lado da integração, que é a parte com que trabalho todos os dias, é uma API simples, com algumas pegadinhas. Os IDs dos modelos são kimi-k3.1-pro e kimi-k3.1-pro-highspeed, e a documentação cobre streaming, entrada de imagens, chamadas de ferramentas, saída estruturada e um recurso chamado "Dynamic tool loading".
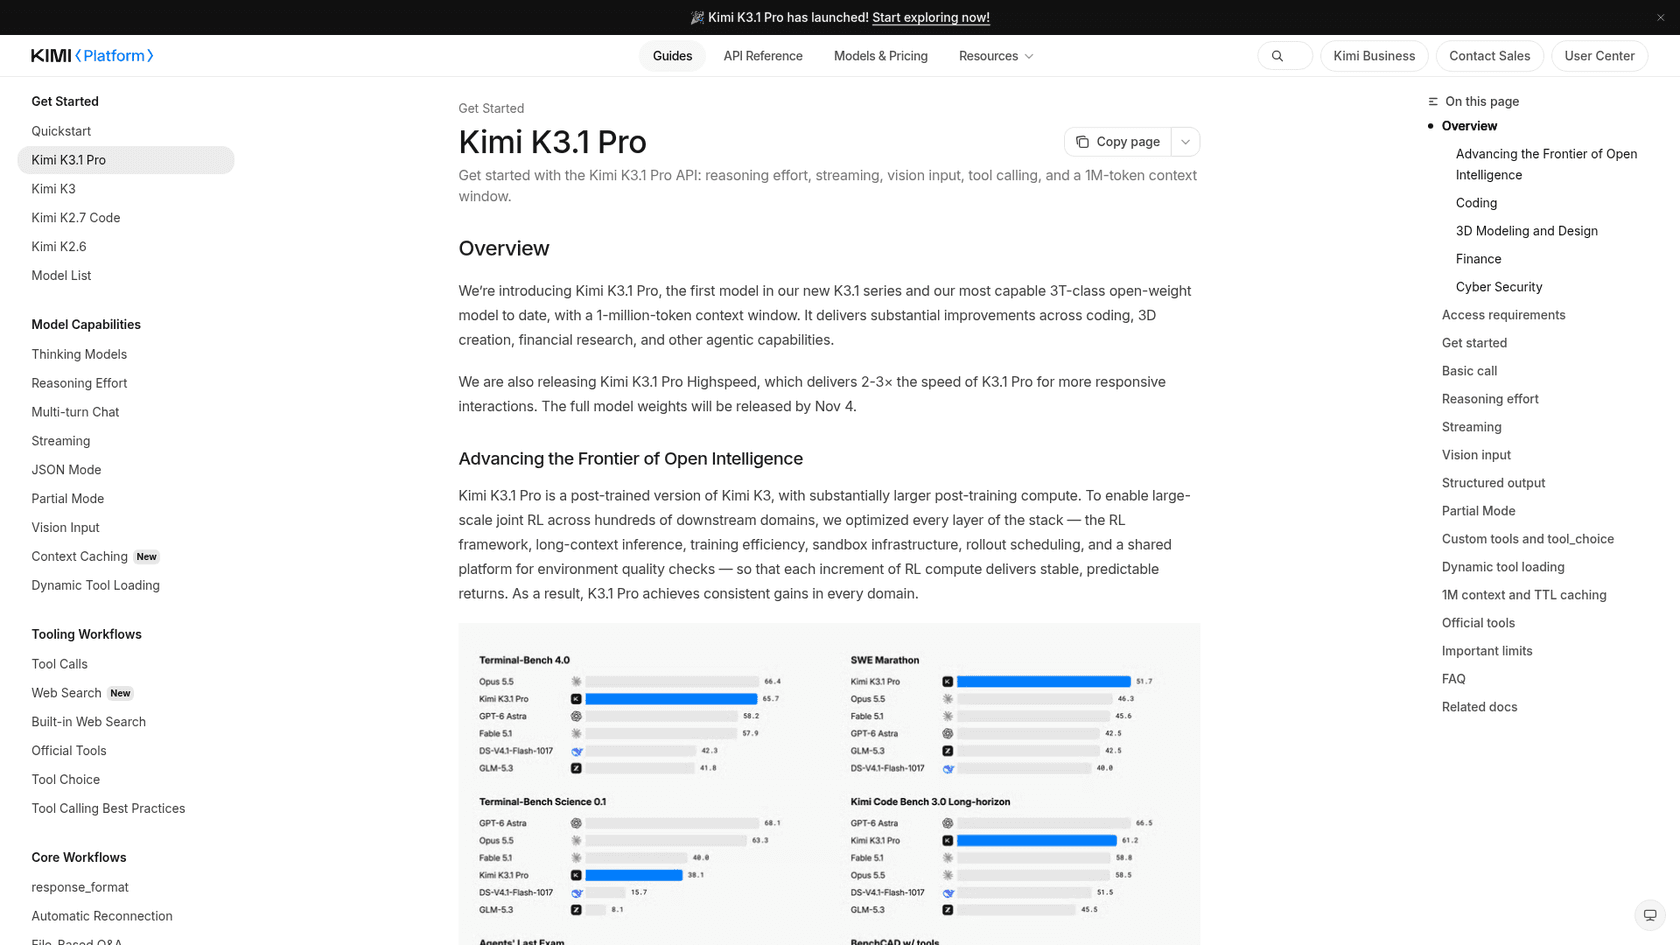
O que eu gostaria de saber antes de escrever uma linha de código:
- O acesso é liberado após uma recarga de US$ 1, e seu limite de requisições depende do total que você já recarregou. Na faixa de US$ 1, você recebe
3requisições por minuto; precisa de$10acumulados para chegar a100RPM, segundo a página de limites de requisições. - Não há desconto por lote para o K3.1 Pro. A API de processamento em lote do Kimi custa 60% do preço padrão, mas só abrange modelos da série K2.
- O raciocínio fica sempre ativado, e
max_completion_tokenstem como padrão131,072. Reserve orçamento para respostas longas. - Zero Data Retention está disponível para clientes da API, segundo o post de lançamento.
- Os modelos K2 estão sendo descontinuados. Novos usuários perdem acesso ao K2 a partir de 31 de outubro de 2026, e está previsto que todos os modelos K2 sejam desligados até o fim de dezembro, então, se você usa o Kimi K2.7 Code, terá que migrar de qualquer forma.
Se você quer principalmente um modelo capaz para criar protótipos gastando pouco, vale conferir minha seleção de APIs de IA gratuitas antes de fazer uma recarga em qualquer lugar.
Quem deve usar o Kimi K3.1 Pro?
Escolha se você executa tarefas longas e sem supervisão em que a qualidade importa e ninguém está esperando: execuções de programação com agentes, relatórios de pesquisa, trabalho financeiro com muitas planilhas, processamento de documentos em contextos enormes. Você chega perto da qualidade do Opus por cerca de um terço do custo de execução, sem sobretaxa por contexto longo.
Evite se uma pessoa espera por cada resposta. A 50 tokens por segundo, o chat ao vivo e as interações rápidas de programação parecem lentos, e o Highspeed dobra o preço para resolver isso. Evite também se o custo é sua prioridade: o GPT-6.1 Sol e o Gemini 4 Argon concluem as mesmas tarefas de benchmark por menos. E, se você precisa de pesos que possa executar por conta própria hoje, continue no K3 até que 4 de novembro comprove que a Moonshot cumpre sua promessa.
O fator decisivo é a paciência. O K3.1 Pro foi feito para trabalhos que você inicia e deixa rodando.
Uma equipe de suporte deve usar o Kimi K3.1 Pro para executar seu agente de IA?
Essa pergunta surge toda vez que um novo modelo lidera um ranking, e acho que é a pergunta errada para começar. O Kimi K3.1 Pro é infraestrutura. Para responder a um único ticket com ele, você ainda precisaria conectá-lo ao seu helpdesk, sincronizar sua central de ajuda e tickets anteriores, decidir o que ele faz sozinho e o que encaminha a uma pessoa, e testá-lo antes que um cliente veja uma resposta. A eesel é o funcionário que atua sobre modelos como esse.
O problema de velocidade também afeta o suporte mais do que a maioria dos usos. Um cliente em uma janela de chat não vai esperar enquanto um modelo escreve 35.000 tokens de raciocínio. Para suporte, um modelo rápido com boa recuperação de informações geralmente supera um mais inteligente e mais lento.
E as respostas erradas no suporte, na maioria das vezes, não vêm do modelo. Um exemplo das próprias chamadas de vendas da eesel: uma equipe de suporte de telemática veicular que usa Zendesk viu seu bot dizer aos clientes "yes, we support your car model" para marcas que não atendia, porque sua base de conhecimento dizia "we support all models". Nenhum salto no ranking resolve isso. O que resolve é impedir alucinações na camada de conhecimento e simular o agente em tickets reais anteriores antes do lançamento, por isso a eesel testa cada implantação primeiro com os tickets históricos da equipe.
Essa é a camada da qual o colega de equipe de IA para helpdesk da eesel cuida. A SamCart mostra como isso funciona na prática. Ela usa a eesel nos tickets do Freshdesk e no chat do site, com um agente separado para cada canal, ambos respondendo com base nos mesmos 280 artigos de sua central de ajuda. No Freshdesk, o agente envia a primeira resposta apenas enquanto nenhuma pessoa estiver atribuída ao ticket, deixa de atuar assim que um colega de equipe assume o ticket e marca o ticket para transferência quando um vendedor pede para falar com uma pessoa. O espaço de trabalho agora executa 4 agentes, incluindo um para um segundo produto que a SamCart lançou em 2026.
Se o que atrai você é o estilo centrado em agentes e no terminal de ferramentas como o Kimi Code, a eesel CLI leva isso ao suporte. Você executa o mesmo colega de equipe a partir de um terminal: eesel activity para revisar o que ele fez, eesel approvals para aprovar ou negar ações pendentes, eesel instructions para editar suas regras permanentes. Os comandos imprimem JSON e os comandos de escrita aceitam --dry-run, então scripts e agentes de programação podem controlá-lo com segurança, e também há um servidor MCP. Aprofundo o assunto no meu guia sobre a CLI de agente de IA.
Experimente a eesel
Se você está procurando um modelo porque quer uma IA respondendo no seu helpdesk, pule uma etapa. O colega de equipe de IA para helpdesk da eesel se conecta ao Freshdesk, Zendesk ou Gorgias, aprende com sua central de ajuda e tickets anteriores, e mostra como teria respondido aos tickets do mês passado antes de mexer em um ticket real.
Experimente a eesel grátis na sua própria fila, ou primeiro compare com os outros melhores colegas de equipe de IA. Se você ainda está decidindo entre contratar uma IA ou desenvolver uma, meu guia sobre funcionário de IA explica a diferença.
Perguntas frequentes
O Kimi K3.1 Pro é bom?
Sim, para o trabalho certo. Na minha análise do Kimi K3.1 Pro, dou nota 3,5 de 5: ele marca 55.1 no Artificial Analysis Intelligence Index, perto do Claude Opus 5.5, por US$ 2/US$ 10 por milhão de tokens. Perde pontos pela geração lenta, pelas respostas longas e pelos limites dos planos no Kimi Code. A visão geral do Kimi K3.1 Pro cobre o lançamento por completo.
O Kimi K3.1 Pro é melhor que o Claude Opus 5.5?
No geral, não. O Opus 5.5 (Max) marca 57.6 no Artificial Analysis contra 55.1, e roda a aproximadamente o dobro da velocidade. O Kimi K3.1 Pro ganha no custo: executou o índice completo de benchmarks por US$ 3.117 contra US$ 8.708 do Opus 5.5 (Max). Minha análise do Claude Opus 5.5 traz o outro lado dessa comparação.
Quanto custa o Kimi K3.1 Pro?
Na API do Kimi, custa US$ 2 por milhão de tokens de entrada, US$ 0,20 para entrada em cache e US$ 10 por milhão de tokens de saída. A versão Highspeed custa US$ 4 e US$ 20. Os planos do aplicativo Kimi vão de US$ 19 a US$ 199 por mês. O detalhamento completo está no meu guia de preços do Kimi K3.1 Pro.
Por que o Kimi K3.1 Pro é tão lento?
O Artificial Analysis mediu 49.7 tokens de saída por segundo na API do Kimi, posição 165 de 182, e ele também escreve um raciocínio longo antes de responder. Uma tarefa média do benchmark levou cerca de 17 minutos. O Kimi K3.1 Pro Highspeed é 2-3x mais rápido pelo dobro do preço. Se a velocidade for o mais importante, o Claude Sonnet 5.5 roda a 141 tokens por segundo pelo mesmo preço de tabela.
O Kimi K3.1 Pro é de código aberto?
Ainda não. A Moonshot diz que os pesos completos serão lançados até 4 de novembro de 2026, mas em 27 de outubro não havia repositório no Hugging Face nem licença. O Kimi K3 é o modelo aberto que você pode baixar hoje, e minha lista de agentes de IA de código aberto cobre outras opções.
O Kimi K3.1 Pro vale a pena para programar?
Para trabalhos longos de programação sem supervisão, sim: ele marcou 67,2% no Terminal-Bench 4.0 no Artificial Analysis e 51.7 no SWE Marathon nos testes da Moonshot. Para programação em par em tempo real, a geração lenta atrapalha, e usuários do Kimi Code relatam atingir rapidamente o limite de 5 horas. Compare com o Claude Code antes de assinar.
Posso usar o Kimi K3.1 Pro em um agente de IA para atendimento ao cliente?
Pode, mas o modelo é a parte pequena do trabalho. Você ainda precisa de uma conexão com o helpdesk, regras de transferência e testes com tickets anteriores, e, a 50 tokens por segundo, as respostas no chat ao vivo pareceriam lentas. Um agente de IA para helpdesk pronto, como o eesel, cuida dessa camada para você, e é assim que a SamCart dá as primeiras respostas no Freshdesk.