

Alternativas ao Microsoft-Decision-1 num relance
| Modelo | Fornecedor | Entrada por 1M de tokens | Saída | Contexto por chamada | Imagens | Como rodar | Pesos e licença | Decision Index v0.3.1 (Full) | Notas de dados e conformidade | Cota gratuita |
|---|---|---|---|---|---|---|---|---|---|---|
| Microsoft-Decision-1 (referência) | Microsoft | $0.042 | Grátis | 32,768 | Não | Azure Foundry, OpenRouter | Fechado | Não listado | SLA do Azure; regiões não publicadas | Azure geral $200, 30 dias |
| Jev 1.13 | TypeSafe | $0.042 | Grátis | 64k por requisição, 32k de estado + a maior pergunta | Não | TypeSafe API, Cloudflare Workers AI | Fechado | 60.11 (referência, empatado em 2º) | Zero retenção de dados na listagem da Cloudflare | Nenhuma documentada |
| OpenAI Decisions API | OpenAI | $0.10 | Grátis | 1,050,000 (2x o preço de entrada acima de 272K) | Sim | OpenAI API, beta público | Fechado | Não listado | ZDR e HIPAA para clientes elegíveis, residência de dados nos EUA e na UE | Nenhuma |
| Clef-flash | Cloudflare | $0.038 | Grátis | 24,576 | Sim | Workers AI ou auto-hospedado | Aberto, Apache 2.0 | 47.61 (#33) | Termos de conta da Cloudflare | 10,000 neurons do Workers AI por dia |
| Clef | Cloudflare | $0.24 | Grátis | 65,536 | Sim | Workers AI ou auto-hospedado | Aberto, Apache 2.0 | 53.08 (#19) | Termos de conta da Cloudflare | 10,000 neurons do Workers AI por dia |
| Perplexity Decider v1.1 | Perplexity | O custo da sua GPU | n/d | 8,192 por decisão | Sim | Auto-hospedado, cerca de 49 GiB de pesos | Apache 2.0, download autenticado | 62.75 (#1) | Fica na sua infraestrutura | Download gratuito |
| Rune 26B-A4B v3 | Surogate (Invergent) | O custo da sua GPU | n/d | 262k | Sim | Auto-hospedado com o motor surogate | Apache 2.0, formulário de contato | 57.43 (#10) | Fica na sua infraestrutura | Download gratuito |
| Strands Decider 2B | AWS Strands Labs | O custo da sua GPU | n/d | Testado com 4,096 | Opcional, sem treino | Auto-hospedado, cabe numa 3090 | Apache 2.0 | 21.75 (#84) | Fica na sua infraestrutura | Download gratuito |
| eesel (não é um modelo) | eesel | $299 por mês por 500 tickets ou chats | n/d | Ticket inteiro e histórico | Sim | Conecta ao seu helpdesk | Produto hospedado | n/d | HIPAA no Enterprise | 100 créditos grátis |
Preços e contexto vêm da documentação de cada fornecedor, conferidos em 11 de outubro de 2026. As pontuações do Decision Index vêm do painel Jev Decision Index, versão 0.3.1, atualizado em 10 de outubro.
Por que olhar além do Microsoft-Decision-1?
Escrevi o que o modelo faz na minha visão geral do Microsoft-Decision-1 e quanto custa no detalhamento de preços. É um lançamento forte. A tabela da própria Microsoft dá 83.5% de precisão média em 36 benchmarks, com mediana de 85 ms no Foundry. Mas algumas lacunas aparecem o tempo todo:
- Sem pesos abertos. É um Qwen3.5-9B pós-treinado, mas a página do Hugging Face que a Microsoft usaria retorna 404. Você aluga ou não usa. Se você gostava da família Qwen para auto-hospedagem, este é fechado.
- Só texto, 32K de contexto. Capturas de tela, formulários escaneados e threads muito longas precisam de outro modelo.
- Papelada do Azure rala. Está em GA no catálogo, mas ainda não tem linha na página de preços do Foundry do Azure, nem regiões, cotas ou tarifa de lote publicadas. Equipes que compram via modelos do Azure costumam querer isso antes de se comprometer.
- Ainda sem nota independente. Não está no Jev Decision Index, então todos os números de precisão até agora são da própria Microsoft.
Esse último ponto motivou a maior parte da reação no dia do lançamento. A resposta mais votada sob o post de lançamento de Satya Nadella foi direta:
"How is Jev not ranked? That's literally the #1 model people are going to compare this to."
A Microsoft depois atualizou o post para incluir o Jev na tabela de precisão e calibração. Ainda assim, a questão por trás é a certa. Modelos de decisão já são um campo concorrido, e o modelo de decisão que você escolher deve depender de onde ele roda e do que ele lê, não dos gráficos do dia do lançamento.
Como escolhi essas alternativas
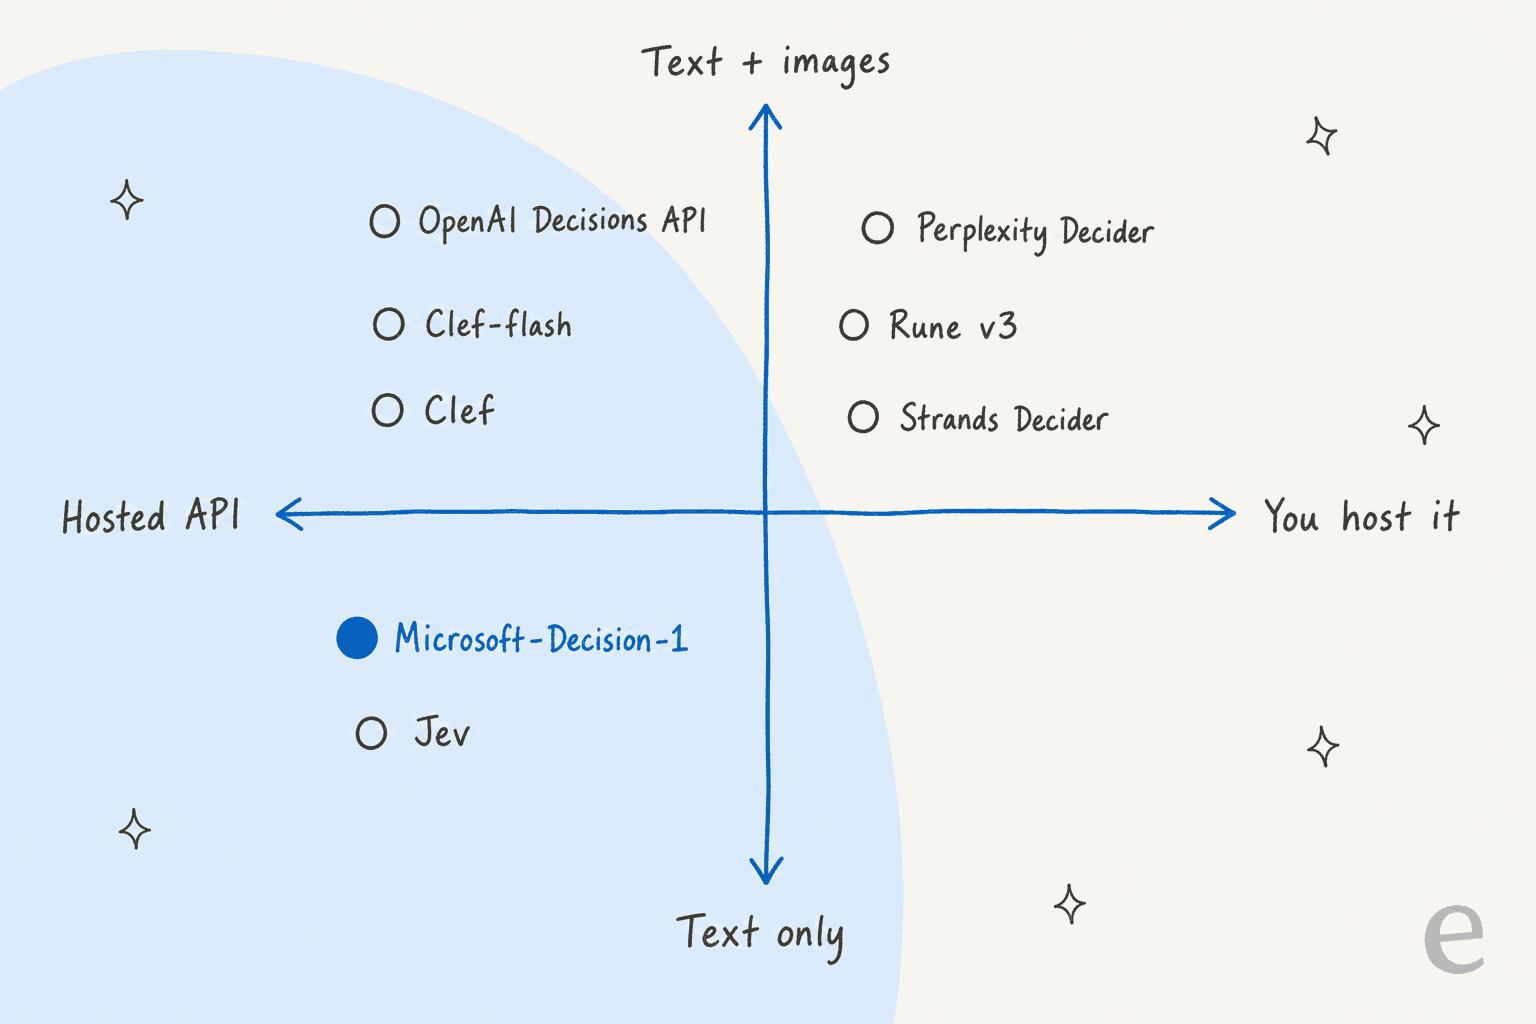
Venho do lado da busca. Meu trabalho na eesel é principalmente descobrir o que os compradores realmente perguntam quando digitam uma consulta, e "Microsoft-Decision-1 alternatives" dois dias após o lançamento se divide com clareza em preço, hospedagem e tipo de entrada. Então fiquei com modelos que fazem o mesmo trabalho: você envia um estado mais opções de resposta fixas e recebe probabilidades calibradas de volta numa única passada.
Cada modelo abaixo aparece na própria tabela comparativa da Microsoft ou pontua no Decision Index, ou ambos. Deixei de fora modelos de chat gerais com modo JSON, já que function calling num modelo grande tem uma curva de custo totalmente diferente. Cada entrada usa os mesmos cinco títulos para você comparar de relance.
Quanto texto cada um consegue ler por chamada?
O contexto é a especificação que pesa primeiro no trabalho de suporte. Um único ticket com histórico de pedidos, um trecho de política e três respostas de ida e volta pode passar de 10,000 tokens.
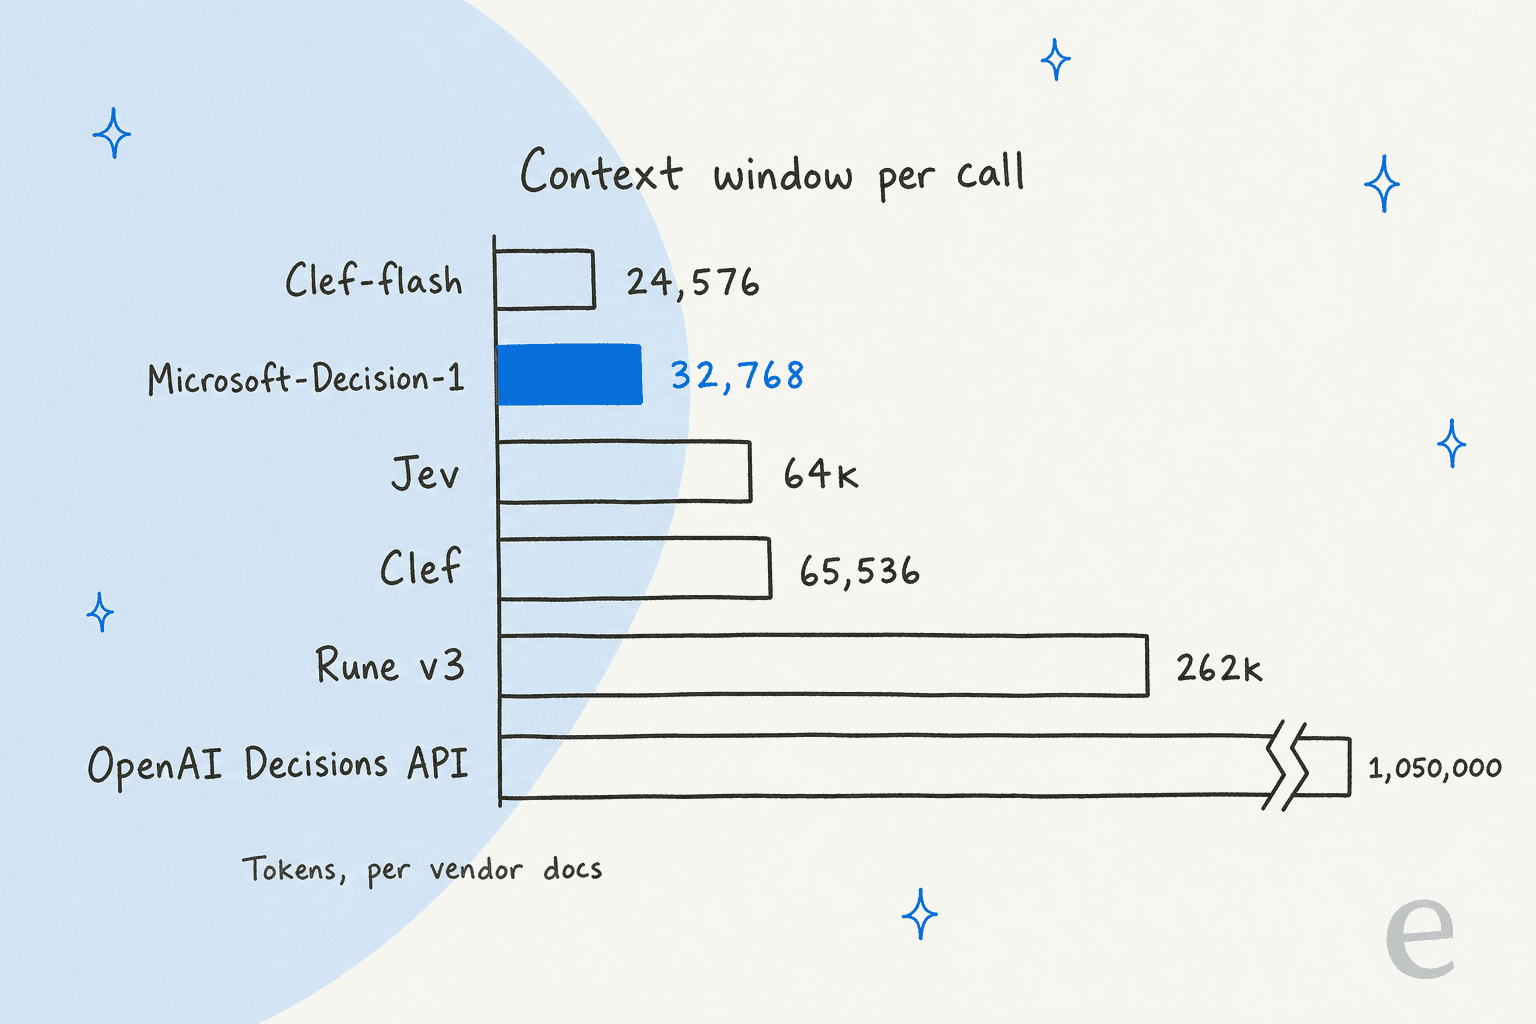
O Perplexity Decider está fora desse gráfico de propósito. Seu cartão diz que o texto e todas as imagens de uma decisão precisam caber em 8,192 tokens, e entradas maiores são rejeitadas em vez de truncadas. Maior nota, menor janela.
1. Jev 1.13 (TypeSafe)
O que é
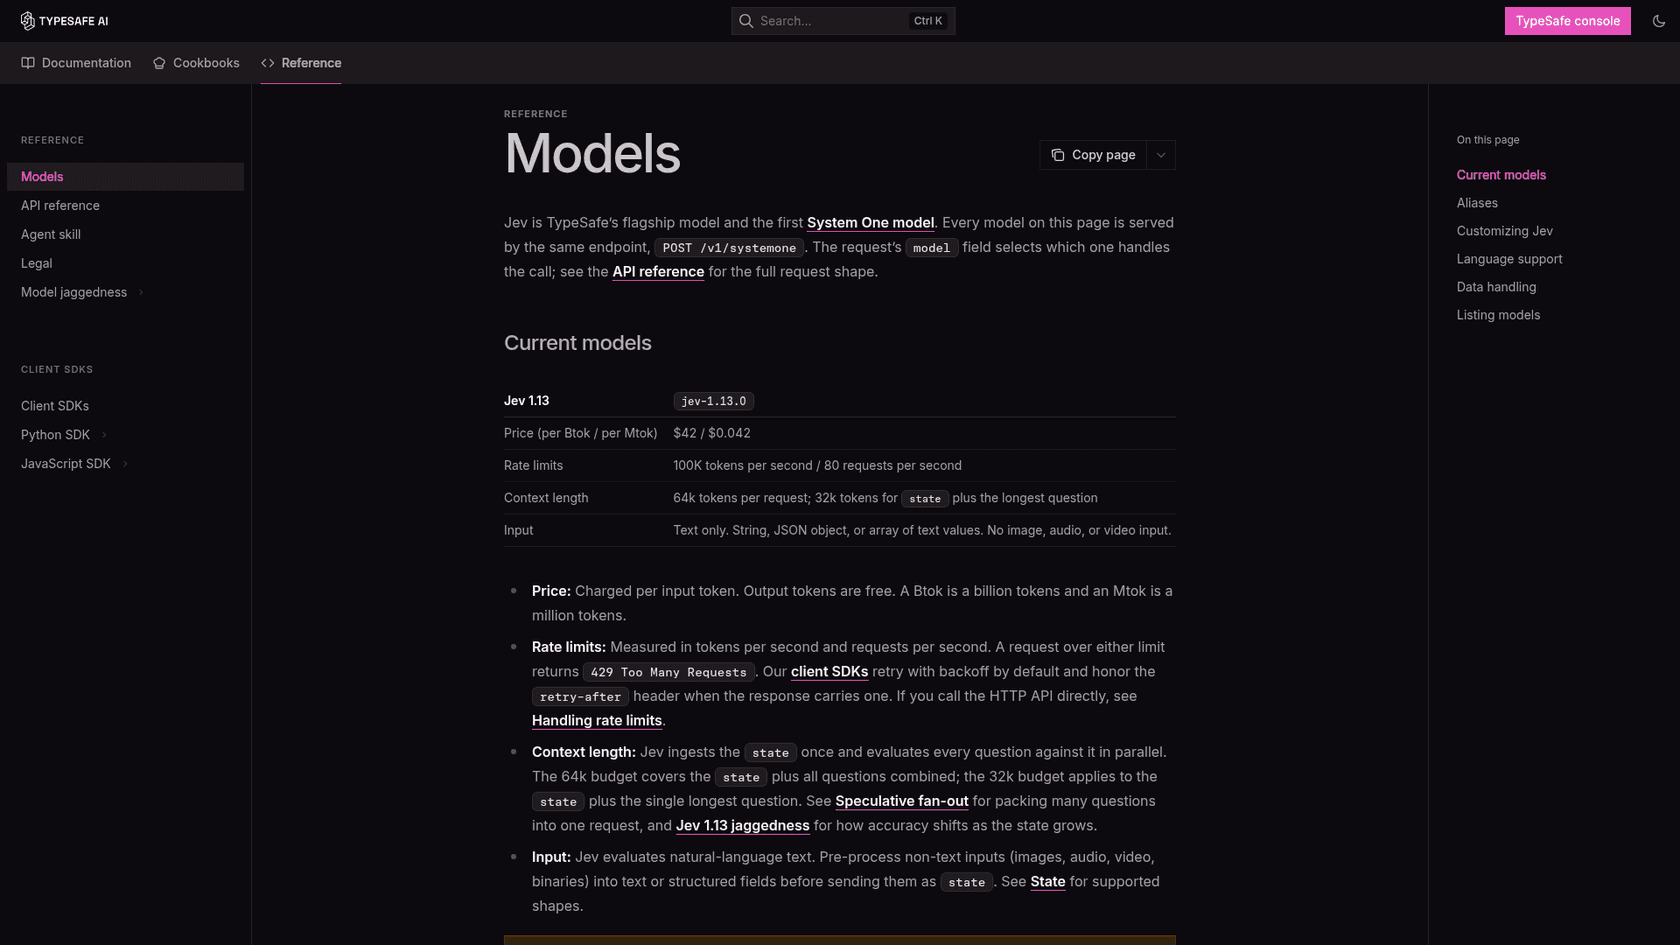
O Jev é o modelo que deu início à categoria. A TypeSafe o serve por um único endpoint, POST /v1/systemone, e ele pontua cada pergunta que você envia, em paralelo, contra um estado compartilhado. Cobri em profundidade na minha visão geral do Jev.
Onde supera o Microsoft-Decision-1
- Requisições maiores. O Jev aceita 64k tokens por requisição, com 32k para o estado mais a maior pergunta individual, segundo a página de modelos da TypeSafe. A Microsoft limita em 32,768.
- Melhor calibração. Mesmo na tabela da própria Microsoft, o Jev marca 93.7 em calibração contra 92.2 da Microsoft.
- Mais lugares para comprar. Além da API da TypeSafe, o Jev está no Cloudflare Workers AI pelo mesmo preço, com entrada em cache gratuita e zero retenção de dados.
Onde fica a desejar
- Só texto, como a Microsoft. As imagens precisam virar texto antes.
- A TypeSafe avisa que "Rate limits are adjusting dynamically" e podem mudar sem aviso. O limite de hoje é de 100K tokens e 80 requisições por segundo.
- A tabela da Microsoft o coloca um pouco atrás em precisão, 82.3% a 83.5%.
Um testador do Hacker News rodou os dois na própria suíte no dia seguinte ao lançamento:
"In my minimal suite it was cheaper (by 0.72x) but higher latency (283ms vs 369ms p50) than Jev. Results were very comparable across all scenarios I measure, first of these that I have tested that actually justifies its existence as a commercial release."

Mesmo preço de tabela, contas diferentes: os tokenizadores contam de forma diferente, então teste com seus próprios tickets.
Preços
$0.042 por milhão de tokens de entrada, saída gratuita, sem faixa gratuita documentada. Meu post sobre os preços do Jev calcula o custo por decisão, e o Jev Ultrafast cobre a faixa de velocidade.
Ideal para
Equipes que querem uma alternativa ao Microsoft-Decision-1 com o mesmo preço e o mesmo formato de API, entradas maiores e sem dependência do Azure.
2. OpenAI Decisions API (gpt-6-luna)
O que é
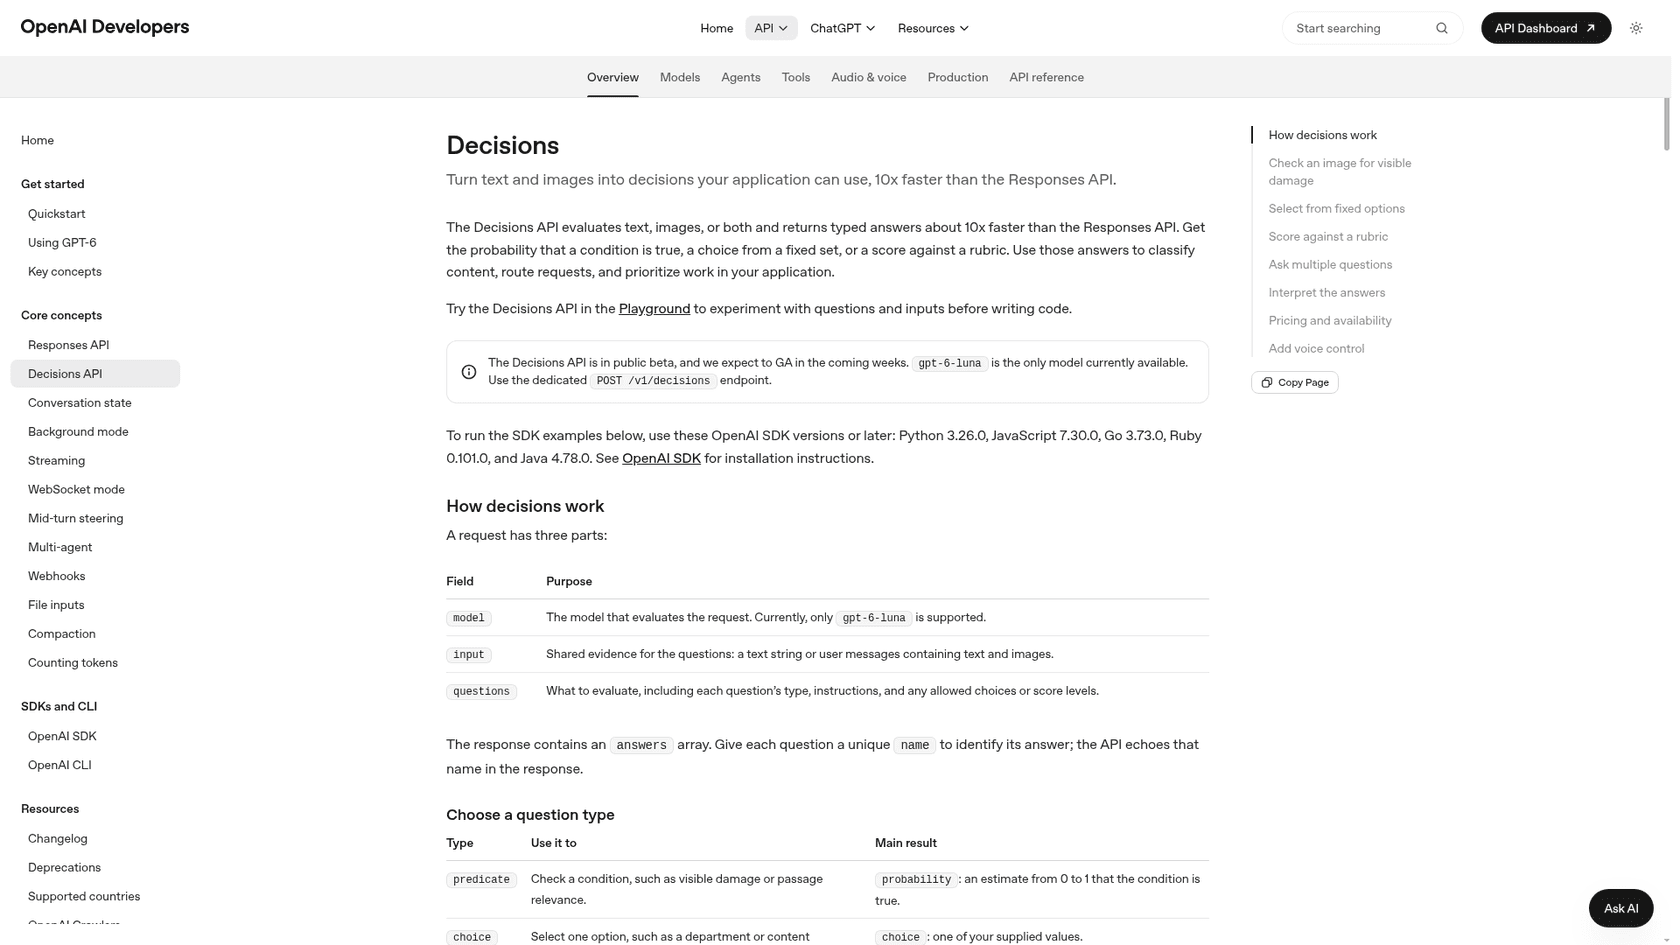
A versão da OpenAI para a mesma ideia, lançada em beta público em 6 de outubro. Você chama POST /v1/decisions com gpt-6-luna, uma entrada de texto e imagens e uma lista de perguntas do tipo predicate, choice ou score. Meu guia da Decisions API tem o passo a passo.
Onde supera o Microsoft-Decision-1
- Imagens. Lê texto e imagens numa só chamada. As imagens precisam ser data URLs base64 em linha.
- Contexto enorme. Herda a janela de 1,050,000 tokens do GPT-6 Luna, então um histórico inteiro de ticket cabe.
- Opções de conformidade. O guia da OpenAI lista Zero Data Retention e HIPAA para clientes elegíveis, além de residência de dados nos EUA e na UE.
Onde fica a desejar
- Custa cerca de 2,4x mais por token que a Microsoft.
- Ainda em beta. A OpenAI diz esperar a GA "in the coming weeks".
- Prompts acima de 272K tokens são cobrados a 2x a entrada, e há acréscimos por processamento regional.
- A OpenAI não publica latência em milissegundos, apenas "about 10x faster than the Responses API". A tabela da Microsoft mediu 300 ms de mediana e 79.4% de precisão.
Preços
$0.10 por milhão de tokens de entrada, sem cobrança de saída, leitura de cache ou escrita de cache. Essa tarifa está no guia de Decisions, ainda não na página principal de preços da API da OpenAI. Mais no meu post sobre os preços do Luna.
Ideal para
Equipes que já usam a OpenAI e precisam pontuar capturas de tela ou threads longas, ou que precisam da papelada HIPAA em dia.
3. Cloudflare Clef-flash
O que é
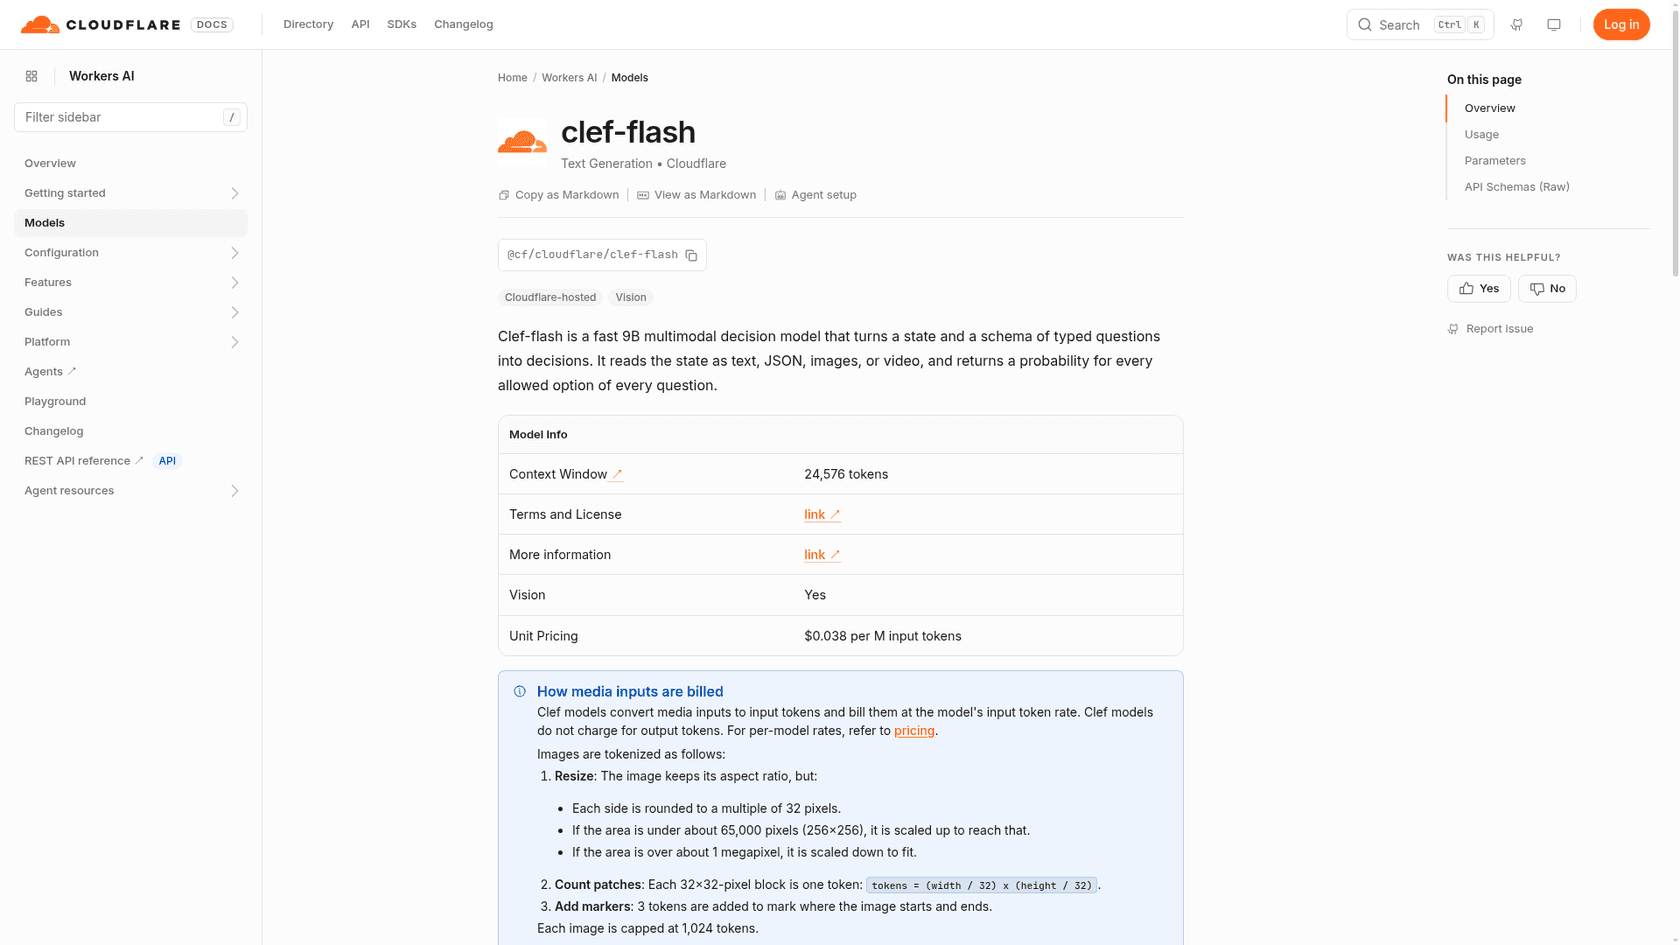
O pequeno modelo de decisão da Cloudflare, um 9B construído sobre a mesma base Qwen3.5-9B que o da Microsoft. Roda no Workers AI como @cf/cloudflare/clef-flash, e os pesos estão no Hugging Face sob Apache 2.0. Minha visão geral do Clef cobre os dois tamanhos do Clef.
Onde supera o Microsoft-Decision-1
- A tarifa hospedada mais barata. $0.038 por milhão de tokens de entrada, contra $0.09 uma semana atrás.
- Imagens. A página da Cloudflare lista suporte a visão, com imagens cobradas como tokens de entrada.
- Cota diária gratuita. O Workers AI dá 10,000 neurons por dia nos planos Free e Paid. Pela minha conta, são cerca de 2.9M de tokens de entrada do Clef-flash por dia.
- Pesos abertos, então você pode levá-lo para dentro de casa depois.
Onde fica a desejar
- A janela de contexto encolheu para 24,576 tokens com o corte de preço, menor que a da Microsoft.
- Fica em 33º no Decision Index (47.61), bem abaixo do Clef e do Jev.
- Não está na tabela comparativa da Microsoft, então não há benchmark em comum entre os dois.
Preços
$0.038 por milhão de tokens de entrada e nenhuma cobrança de saída. Passados os neurons gratuitos, o Workers AI cobra $0.011 por 1,000 neurons.
Ideal para
Classificação de texto ou imagem em alto volume, onde o custo por chamada pesa mais e as entradas são curtas.
4. Cloudflare Clef
O que é
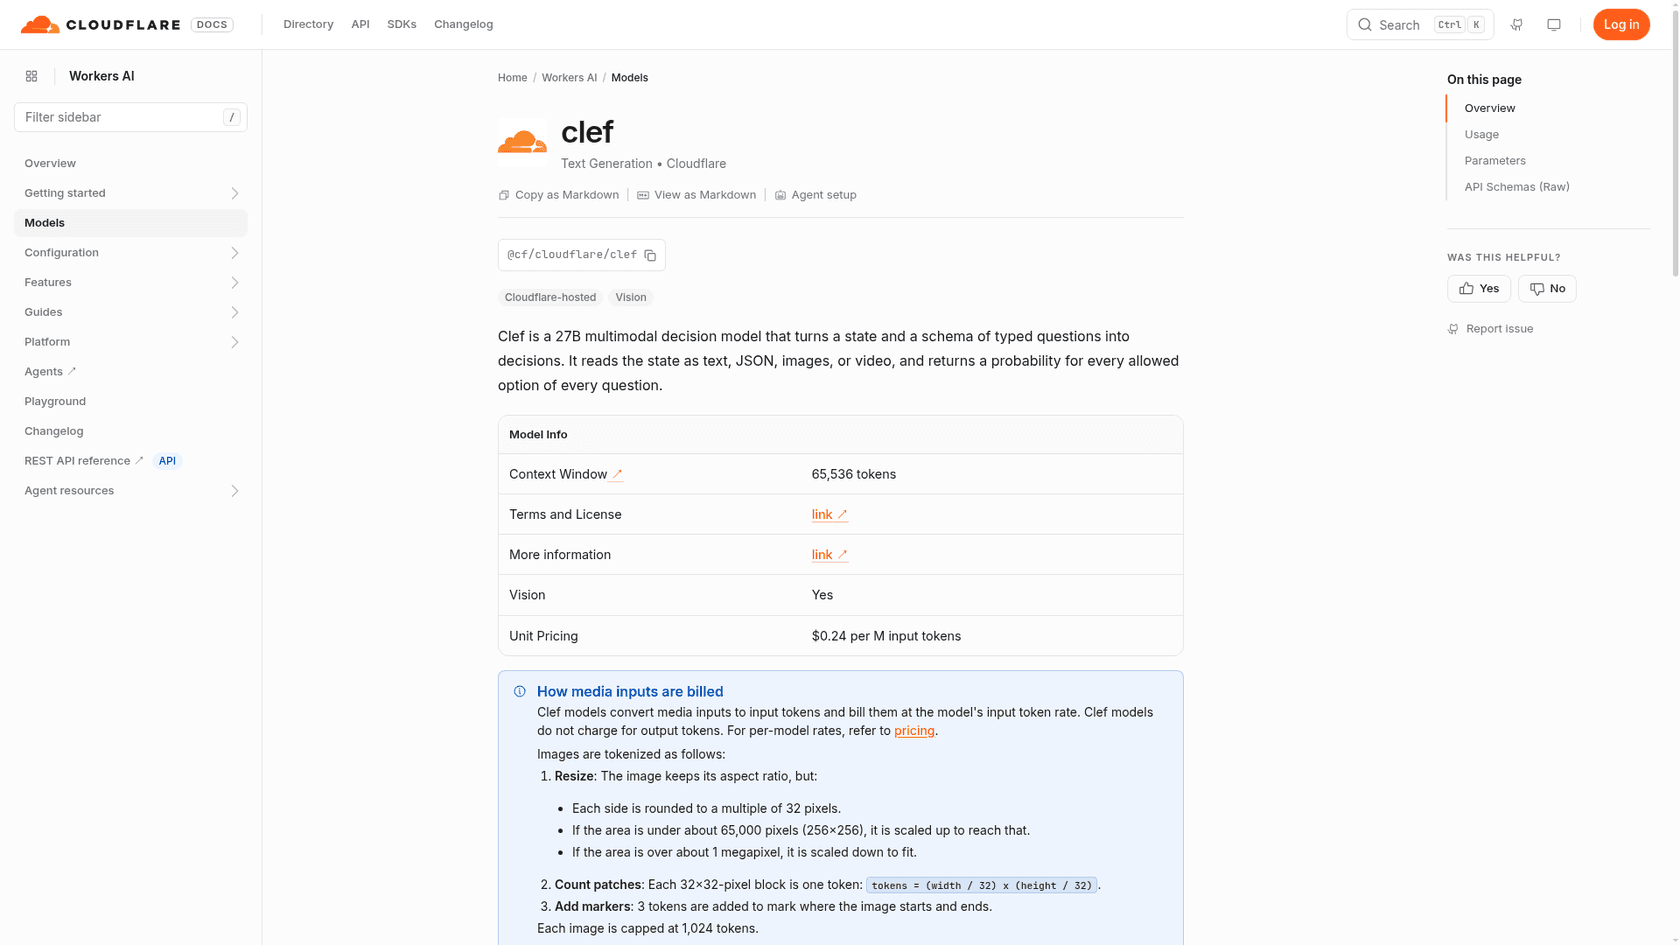
O Clef maior: um modelo de decisão multimodal de 27B pós-treinado a partir do Qwen3.8-27B, hospedado no Workers AI e publicado sob Apache 2.0.
Onde supera o Microsoft-Decision-1
- O dobro de contexto. 65,536 tokens.
- Imagens e vídeo no estado, segundo o cartão do modelo da Cloudflare.
- Uma nota independente. Está no Decision Index com 53.08 Full, e sua nota só em benchmarks públicos, 61.71, é o maior número público entre as opções hospedadas aqui.
Onde fica a desejar
- A $0.24 por milhão de tokens de entrada, custa quase 6x a tarifa da Microsoft.
- A nota no teste privado o derruba para 19º, então o número público o favorece.
- A mediana autodeclarada da Cloudflare foi de 209 ms, mais lenta que os 85 ms alegados pela Microsoft.
Preços
$0.24 por milhão de tokens de entrada, sem cobrança de saída e os mesmos 10,000 neurons gratuitos por dia (cerca de 458K tokens de entrada do Clef). Meu post sobre os preços do Clef traz a conta.
Ideal para
Equipes na Cloudflare que precisam de entradas multimodais mais longas e pagarão mais por chamada por isso.
5. Perplexity Decider v1.1 (27B)
O que é
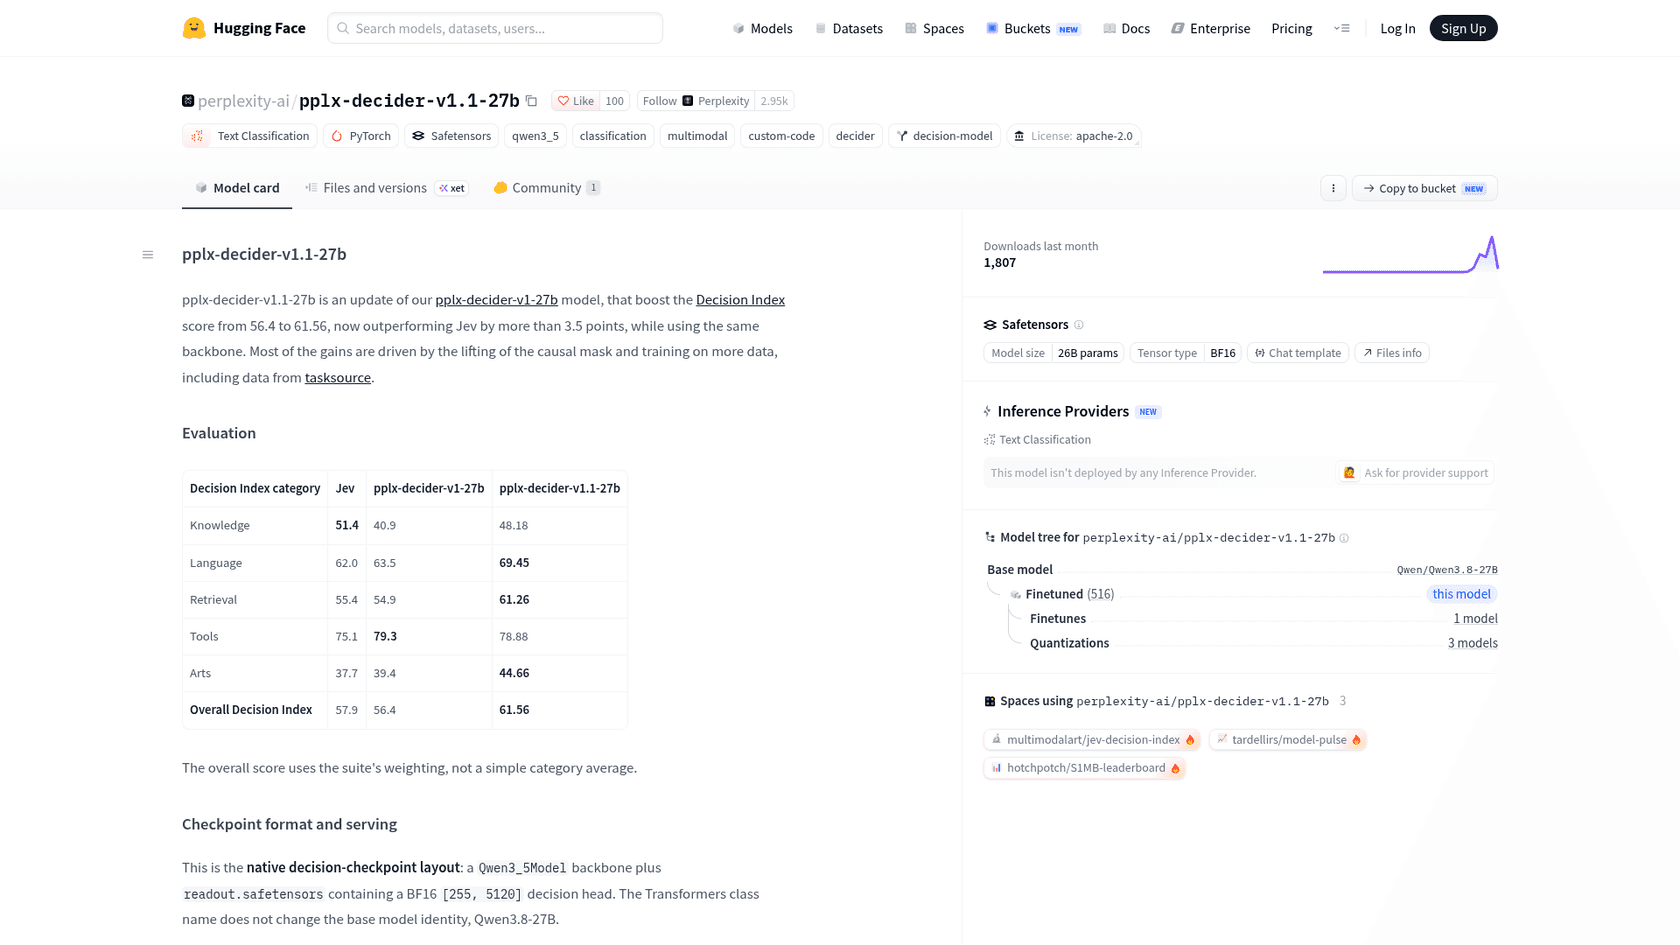
O modelo de decisão aberto da Perplexity, um ajuste fino completo do Qwen3.8-27B com uma cabeça de decisão separada. A Perplexity diz que a v1.1 ganhou a maior parte da melhora com "the lifting of the causal mask" e mais dados de treino. Você baixa do Hugging Face e roda com o código incluído.
Onde supera o Microsoft-Decision-1
- Melhor nota independente. Fica em primeiro no Decision Index v0.3.1 com 62.75, à frente dos 60.11 do Jev.
- Os pesos são seus. Apache 2.0, nada sai dos seus servidores.
- Imagens, passadas como caminhos de arquivo, imagens PIL ou URLs base64.
Onde fica a desejar
- Limite rígido de 8,192 tokens por decisão, texto e imagens somados.
- Você precisa de uma GPU CUDA com espaço para cerca de 49 GiB de pesos mais memória de trabalho, e de uma conta autenticada do Hugging Face para baixar.
- Sem API hospedada: o cartão diz que nenhum provedor de inferência o serve.
- A inferência causal padrão não reproduz a configuração avaliada, então você precisa usar o código da Perplexity ou uma exportação cuidadosa.
Preços
Download gratuito. Seu custo é tempo de GPU. Sobre custo, um comentarista do Hacker News resumiu bem:
"Open weight model pricing isn't really up to the company that built them (unless they are also serving them, in which case their API price may differ). It's really up to the serving cost and/or pricing of whoever is actually serving the model."
Ideal para
Equipes de ML com GPU sobrando que querem o modelo aberto mais preciso e mantêm as entradas curtas.
6. Surogate Rune 26B-A4B v3
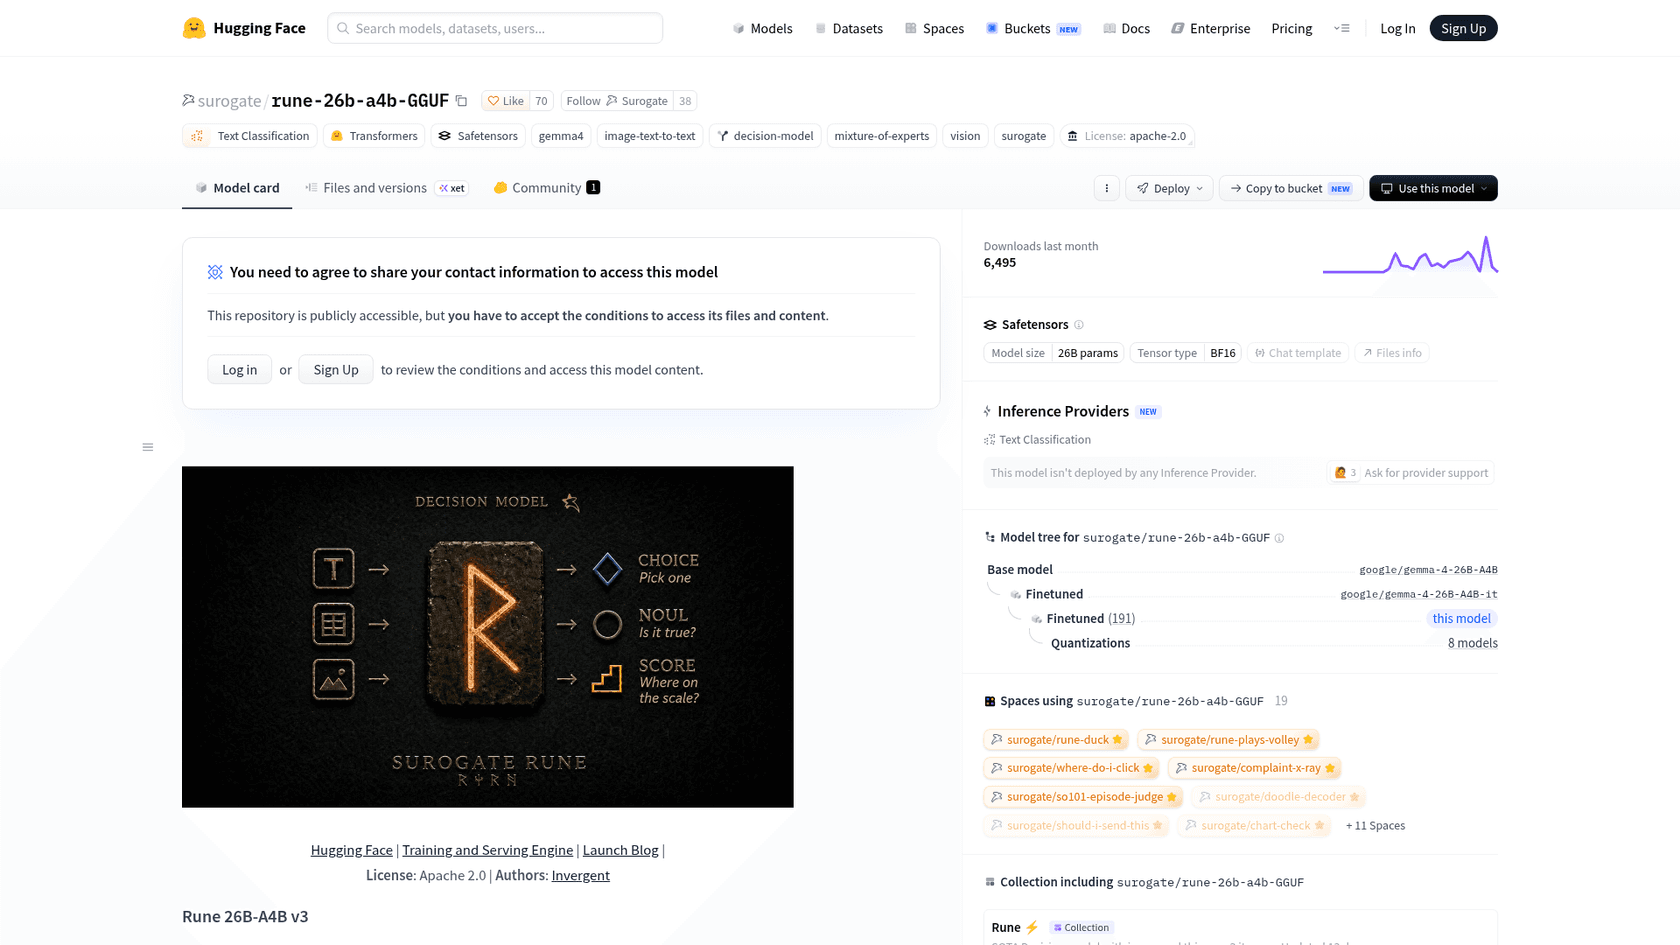
O que é
O modelo de decisão aberto da Invergent, um ajuste fino completo do Gemma 4 26B-A4B (8 de 128 especialistas ativos por token). Responde perguntas choice, noul e score e é servido mais rápido pelo motor de código aberto surogate.
Onde supera o Microsoft-Decision-1
- Entradas longas. O cartão afirma um contexto de 262k, oito vezes o da Microsoft.
- Imagens, com a torre de visão mantida. O próprio teste de imagens da Invergent marcou 83.4% com 1,120 tokens de imagem.
- Raciocínio opcional. Com
"thinking": true, as perguntas de que não tem certeza são raciocinadas antes de responder. A Invergent estima que isso eleva seu índice em cerca de 1.8 ponto, a cerca de 5 segundos por pergunta com raciocínio. - Na tabela da própria Microsoft marcou 79.7%, perto do Luna da OpenAI.
Onde fica a desejar
- Os downloads ficam atrás de um formulário de informações de contato.
- Suas probabilidades padrão saem superconfiantes. O cartão recomenda ler as respostas na temperatura 2 para corrigir a calibração.
- A Invergent mediu mediana de 388 ms por requisição numa RTX PRO 6000, mais lenta que o alegado pela Microsoft.
- 10º no Decision Index (57.43), atrás de Perplexity e Jev.
Preços
Download gratuito sob Apache 2.0. Você paga pelo hardware.
Ideal para
Quem auto-hospeda e precisa de entradas longas ou pesadas em imagens e sabe ajustar o serving por conta própria.
7. Strands Decider (AWS Strands Labs)
O que é
Um pequeno modelo de decisão aberto do Strands Labs da AWS, feito para etapas de agentes como seleção de ferramentas, guardrails e roteamento. O modelo de referência é um 2B em Qwen3.5, e quatro tamanhos do Gemma 4 vieram em 10 e 11 de outubro. Cobri o lançamento no meu post sobre o Strands Decider.
Onde supera o Microsoft-Decision-1
- Roda em hardware modesto. O 2B atingiu mediana de 115 ms numa única RTX 3090 no teste da própria Strands.
- Gratuito e aberto, Apache 2.0, e se encaixa no harness do Strands mais amplo para agentes.
- Entrada de imagem opcional com
--vision, embora a Strands observe que nada foi treinado com imagens.
Onde fica a desejar
- A precisão é bem menor. A tabela da Microsoft mostra 54.8% em apenas 23 de 36 benchmarks, e o Decision Index o coloca em 84º (21.75).
- Foi testado com janelas de 3,072 e 4,096 tokens.
- Não há API hospedada em lugar nenhum, Bedrock incluso.
Preços
Gratuito. Sua própria GPU ou CPU.
Ideal para
Guardrails locais e baratos para agentes e escolha de ferramentas, onde velocidade em hardware pequeno vale mais que a precisão máxima.
8. eesel (se você quer a decisão e o trabalho)

O que é
Não é um modelo. As sete opções acima são infraestrutura. A eesel é a funcionária: uma colega de helpdesk com IA que entra na sua fila do Zendesk, Freshdesk ou Gorgias, toma a decisão de roteamento e depois escreve a resposta ou executa a ação. Ela aprende com seus tickets anteriores e sua central de ajuda.
Onde supera o Microsoft-Decision-1
- Nenhum pipeline para construir. Sem limiares, webhooks ou código de cola com a API do helpdesk.
- Age sobre a resposta. Tags, prioridade, escalonamento e a própria resposta.
- Ações arriscadas podem esperar aprovação, para que uma pessoa dê o aval antes de qualquer coisa irreversível.
Onde fica a desejar
- Bem mais cara por ticket do que uma única chamada de modelo, porque inclui o trabalho.
- Vive no seu helpdesk. Se você precisa de decisões dentro do caminho de código do seu próprio app, use um modelo.
Preços
Os planos da eesel começam em $299 por mês por 500 créditos, em que um ticket ou um chat equivale a um crédito, não importa quanto dure. 5,000 créditos custam $1,749 por mês. Há um início gratuito com 100 créditos e sem cartão.
Ideal para
Equipes de suporte cujo objetivo real é ter tickets classificados e respondidos, não um modelo para integrar.
Qual alternativa ao Microsoft-Decision-1 você deve escolher?
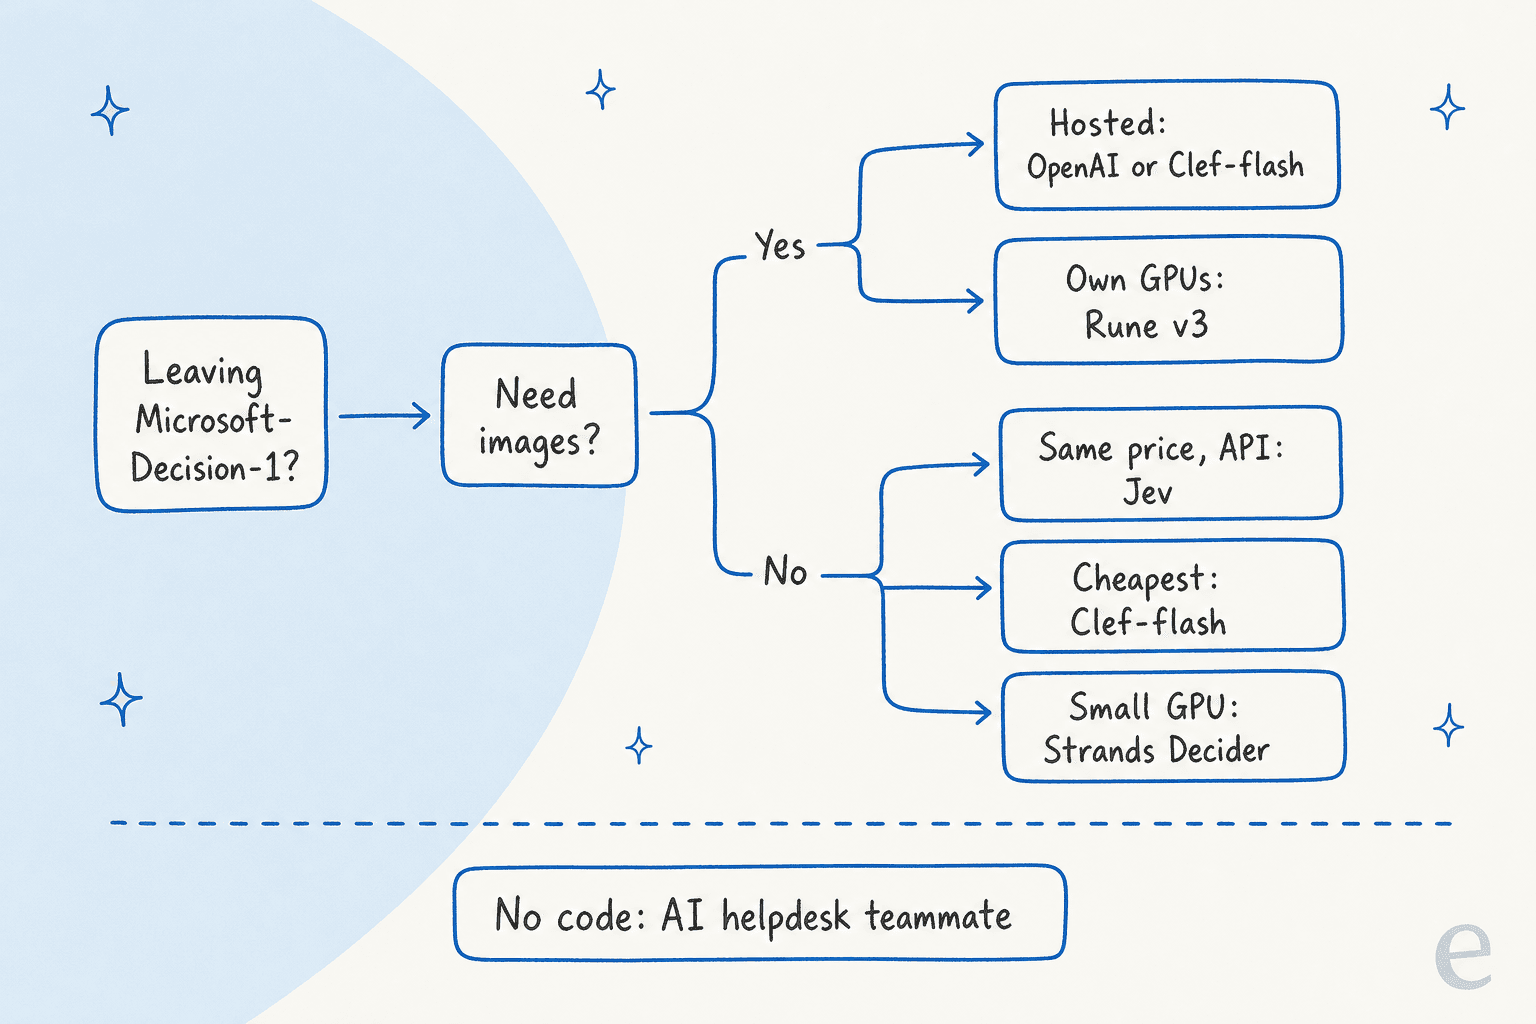
Minha versão curta:
- Mesmo trabalho, sem Azure: Jev pelo mesmo preço. Compare os dois primeiro com seus próprios dados.
- A menor conta: Clef-flash, se suas entradas cabem em 24,576 tokens.
- Imagens ou threads muito longas: a Decisions API da OpenAI hospedada, Rune v3 auto-hospedado.
- Melhor precisão aberta: Perplexity Decider v1.1, se 8,192 tokens bastam.
- Pequeno e local: Strands Decider para guardrails de agentes.
Para equipes de suporte, o caso de uso é quase sempre classificação de tickets e roteamento. É aí que a pontuação de probabilidade se paga: você só automatiza aquilo de que o modelo tem certeza. Em filas reais, a parte difícil vem depois. Num exemplo dos nossos próprios dados, a IA de uma empresa de infraestrutura Web3 comparou uma proposta de vendas fria, vinda de uma lista de contatos, com tickets antigos do Zendesk, a classificou como spam e redigiu uma recusa educada como nota interna em vez de tentar respondê-la. Um modelo de decisão lhe dá o rótulo "spam". Alguém ainda precisa ler o histórico e escrever a nota.
Fique de olho também nos falsos positivos na marcação. Uma taxa de erro de 1% é barata por chamada e cara quando manda um reembolso para vendas. Meu panorama da melhor IA para triagem compara ferramentas que resolvem isso de fábrica.
Pule o modelo, fique com a decisão
Se você está comparando alternativas ao Microsoft-Decision-1 porque quer tickets roteados, marcados e priorizados, talvez nem precise de um modelo. A eesel funciona como um novo contratado para o seu helpdesk: conecta-se ao Zendesk ou ao Freshdesk em minutos, lê seus tickets anteriores, toma as mesmas decisões de triagem que um modelo de decisão tomaria e depois responde ao cliente. Você pode simulá-la com tickets históricos antes que ela toque num ticket ao vivo.
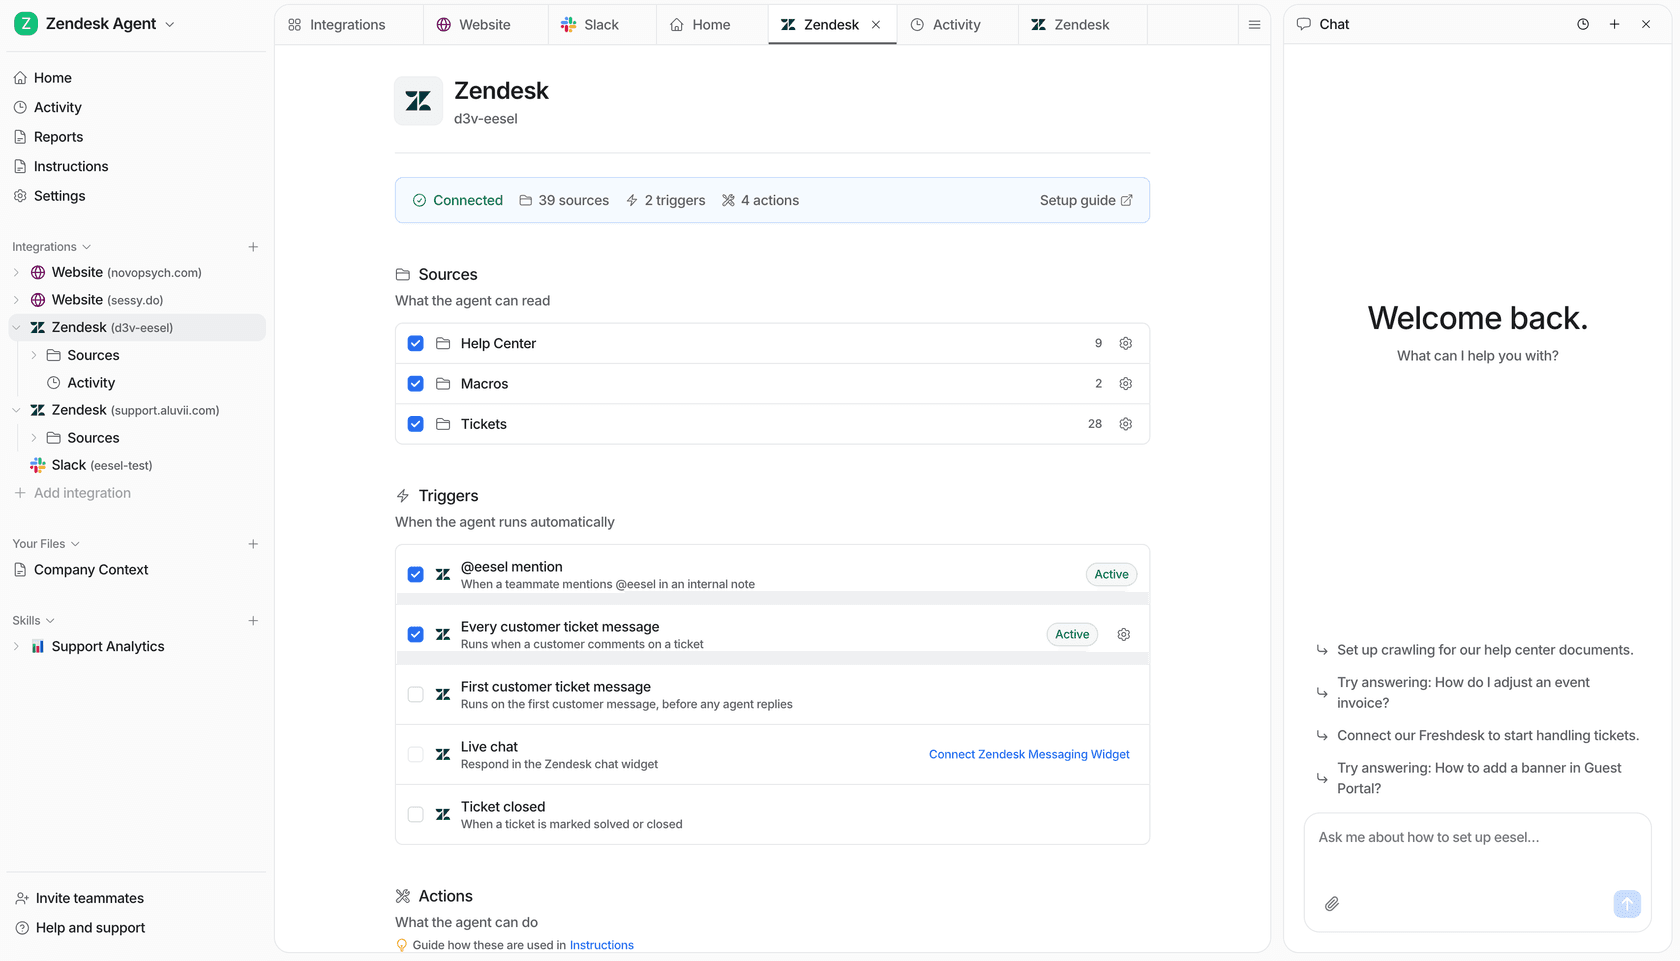
Se preferir conduzir por código, a CLI da eesel roda a mesma colega que o painel. Cada comando imprime JSON, então você, um script ou um agente de código como Claude Code, Codex ou Cursor pode configurá-la. eesel integrations conecta seu helpdesk, eesel automations enable <platform> <key> --instructions "..." escreve uma regra de triagem em palavras simples, e eesel approvals lista as ações retidas para aprovar ou negar. Mais sobre por que isso importa no meu texto sobre a CLI de agentes.
Experimente a eesel grátis com 100 créditos e aponte-a para uma semana dos seus tickets. Se ela os rotear tão bem quanto o seu pipeline de decisão faria, você economizou a construção.
Perguntas frequentes
Quais são as melhores alternativas ao Microsoft-Decision-1?
A troca mais próxima é o Jev da TypeSafe, que custa o mesmo, $0.042 por milhão de tokens de entrada. A Decisions API da OpenAI adiciona imagens e uma janela de contexto enorme, o Clef-flash da Cloudflare é a opção hospedada mais barata a $0.038, e Perplexity Decider, Rune v3 e Strands Decider são alternativas de pesos abertos ao Microsoft-Decision-1 que você mesmo executa.
Existe uma alternativa mais barata ao Microsoft-Decision-1?
Sim. O Clef-flash da Cloudflare custa $0.038 por milhão de tokens de entrada contra os $0.042 da Microsoft, com saída gratuita em ambos. Os modelos de pesos abertos não custam nada para baixar, mas você paga pela GPU. Meu detalhamento dos preços do Clef cobre a cota diária gratuita no Workers AI.
O Jev é melhor que o Microsoft-Decision-1?
Na tabela de 36 benchmarks da própria Microsoft, o Microsoft-Decision-1 marcou 83.5% de precisão média contra 82.3% do Jev, enquanto o Jev teve nota maior em calibração (93.7 vs 92.2). Os preços são idênticos. O Jev lê 64k tokens por requisição contra os 32,768 da Microsoft. Minha análise do Jev traz mais sobre como ele se comporta na prática.
Existe uma alternativa de código aberto ao Microsoft-Decision-1?
A Microsoft não liberou os pesos, então você não pode hospedá-lo por conta própria. Perplexity Decider v1.1, Surogate Rune 26B-A4B v3, os modelos Clef da Cloudflare e o Strands Decider da AWS são todos lançados sob Apache 2.0. O Perplexity Decider v1.1 lidera atualmente o Decision Index da comunidade.
Qual alternativa ao Microsoft-Decision-1 suporta imagens?
A Decisions API da OpenAI, Cloudflare Clef e Clef-flash, Perplexity Decider e Rune v3 aceitam imagens. Microsoft-Decision-1 e Jev aceitam só texto. Se aparecem capturas de tela no seu fluxo de triagem de tickets, só isso já reduz a lista.
Como o Microsoft-Decision-1 se compara à Decisions API da OpenAI?
A OpenAI cobra $0.10 por milhão de tokens de entrada no gpt-6-luna, cerca de 2,4x a tarifa da Microsoft, também com saída gratuita. Em troca você recebe imagens, uma janela de 1,050,000 tokens e opções de ZDR e HIPAA para clientes elegíveis. A API ainda está em beta público. Veja meu post sobre os preços da Decisions API.
Preciso de um modelo de decisão para rotear tickets de suporte?
Só se você estiver construindo o roteamento dentro do seu próprio produto ou pipeline. Se o objetivo é ter tickets classificados e respondidos dentro do seu helpdesk, um agente de helpdesk com IA faz a decisão e o trabalho sem código. Meu guia sobre como automatizar a triagem de tickets percorre os dois caminhos.