

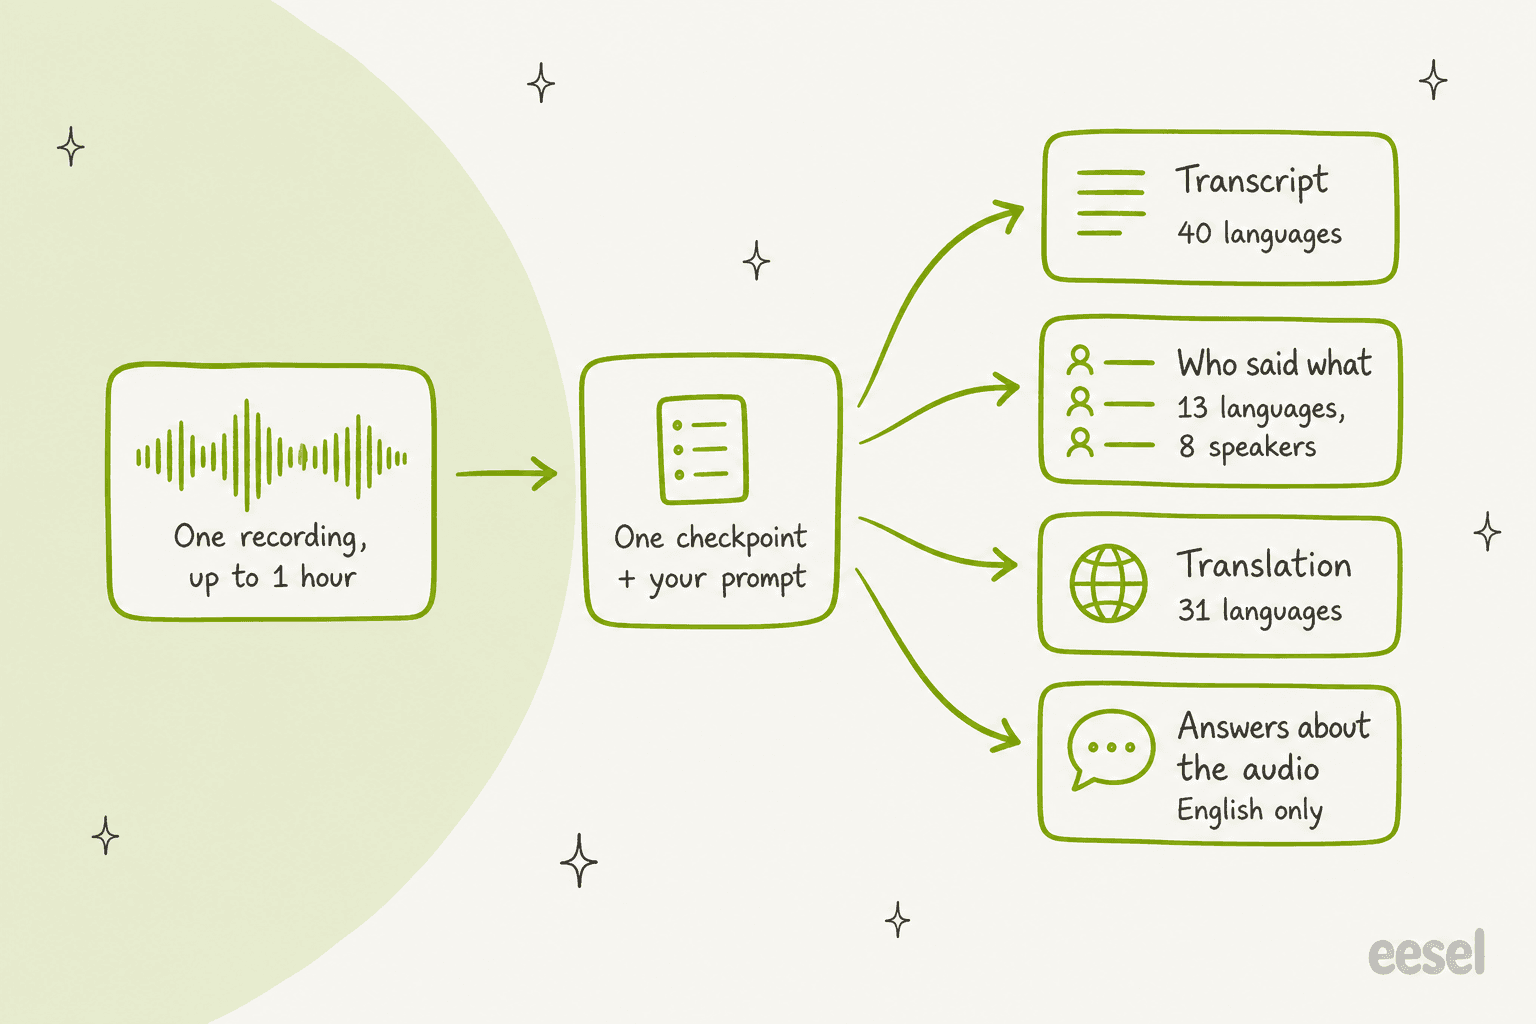
O Nemotron 3.5 Transcribe é o modelo de voz gratuito e de pesos abertos da NVIDIA, lançado em 28 de outubro de 2026, e um único checkpoint faz quatro trabalhos: transcrições em 40 idiomas, rótulos de "quem disse o quê" para até oito falantes, tradução em 31 idiomas e respostas sobre o áudio. Você diz qual trabalho quer com um prompt simples em linguagem normal.
É preciso para um modelo aberto: 2,81% de taxa de erro de palavras no Artificial Analysis, segundo entre os modelos abertos, e primeiro no leaderboard aberto em inglês do Hugging Face com 5,33%. O problema é tamanho e momento. Hoje exige uma GPU de data center de 80 GB e só funciona com gravações, não com ligações ao vivo. Se você não quer o hardware, a DeepInfra o hospeda por US$ 0,002 o minuto, cerca de metade do que a maioria das APIs de transcrição cobra.
Para uma equipe de suporte, a transcrição é o primeiro passo, não o último. Trabalho na eesel, e o colega de IA para o helpdesk que ajudo a construir é o que pega o ticket em que uma ligação ou mensagem de voz se transforma e responde no idioma do cliente, como faz para a Koffer.ch em alemão, francês, inglês e italiano.
O que é o Nemotron 3.5 Transcribe?
O Nemotron 3.5 Transcribe é um modelo de voz de pesos abertos da NVIDIA. Ele pega um arquivo gravado e o transforma em texto, e depois em qualquer tipo de texto que você pedir. A NVIDIA o chama de modelo de linguagem aumentado por voz: um codificador de áudio alimenta um modelo de linguagem, então você controla a saída com instruções em vez de configurações (model card).
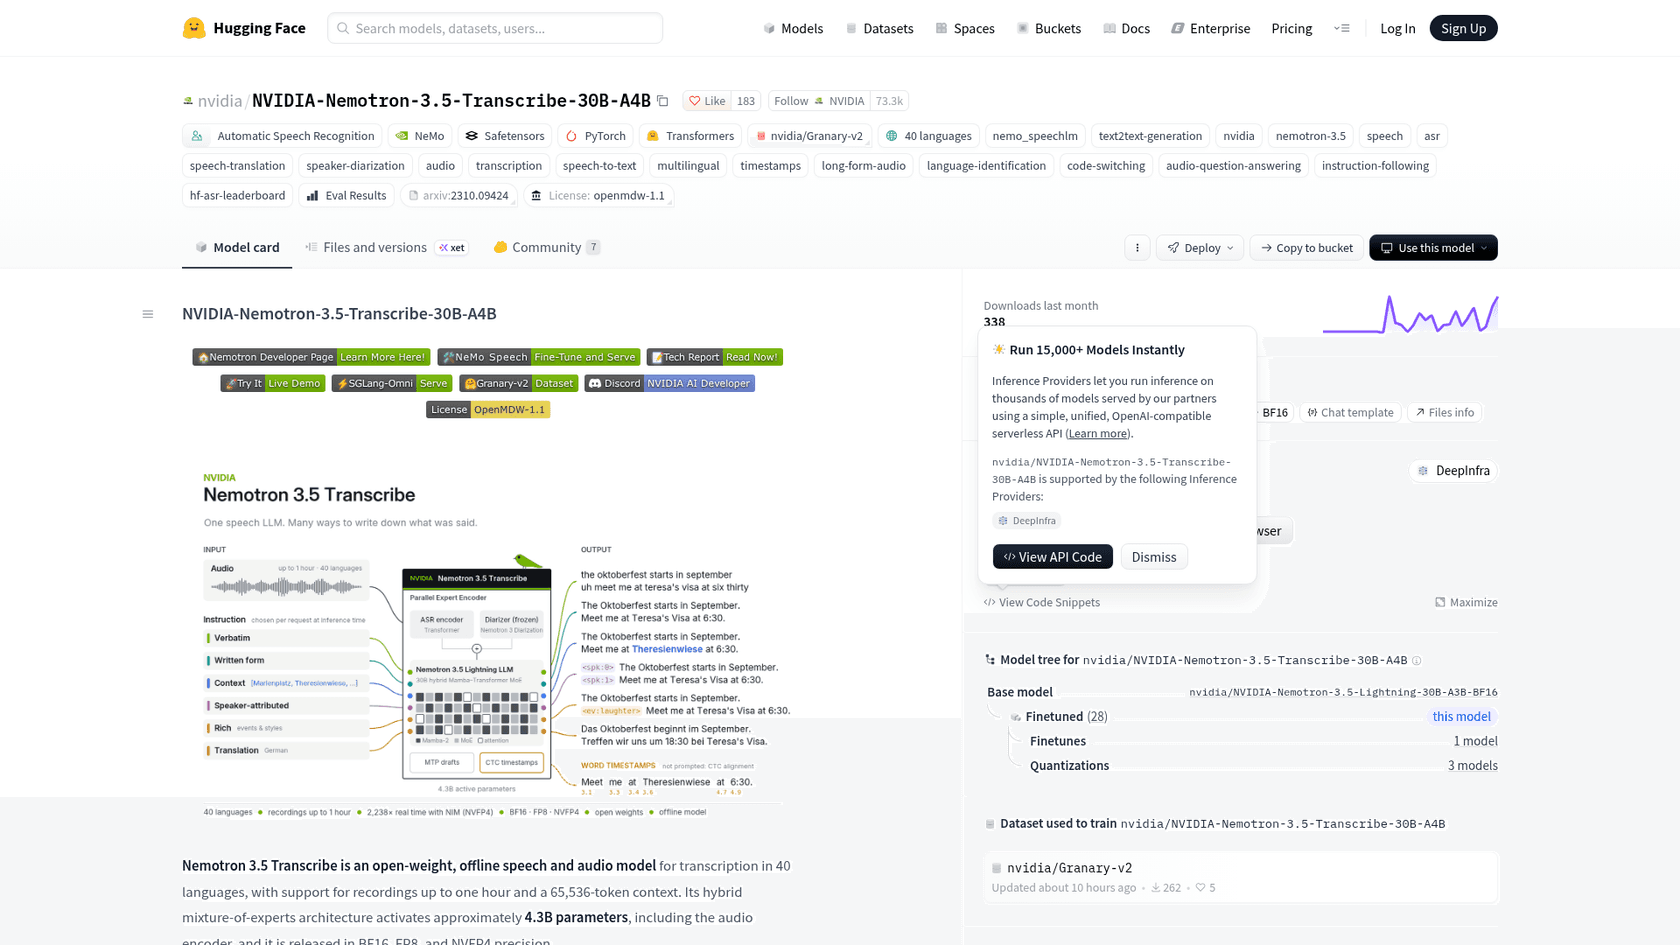
Os números principais, todos do blog de lançamento da NVIDIA e do model card:
| Especificação | Nemotron 3.5 Transcribe |
|---|---|
| Lançamento | 28 de outubro de 2026 |
| Tamanho | Mistura de especialistas da classe 30B, cerca de 4B ativos por token (o card conta 34B no total, 4,3B ativos, com o codificador de áudio) |
| Transcrição | 40 idiomas |
| Tradução | 31 idiomas, de ou para o inglês |
| Rótulos de falante | 13 idiomas, até 8 falantes |
| Gravação mais longa | 1 hora (contexto de 65.536 tokens) |
| Streaming ao vivo | Não, apenas áudio gravado |
| Licença | OpenMDW-1.1, uso comercial permitido |
| Precisões | BF16 agora; FP8 e NVFP4 listados como futuros |
O "cerca de 4B ativos" é, na verdade, a razão de um modelo desse tamanho ser utilizável. É uma mistura de especialistas híbrida Mamba-Transformer, construída sobre o modelo de linguagem Nemotron 3.5 Lightning da NVIDIA, então apenas uma pequena fatia dos pesos trabalha em cada token. É o mesmo truque do resto da família, como o Nemotron 3.5 Super VL.
Há uma armadilha de nome que vale apontar. "Nemotron 3.5 ASR" é outro modelo de streaming, minúsculo, então quando você vir um preço ou uma velocidade online, confira de qual dos dois se trata.
O que você pode pedir que ele faça?
Você pode pedir uma transcrição literal, uma limpa, uma com rótulos de falante, uma tradução ou uma resposta, tudo a partir do mesmo arquivo. O que muda entre elas é apenas uma linha de prompt. Os próprios exemplos da NVIDIA são tão simples quanto "Transcribe this recording and label each speaker" ou "What decisions were made in this meeting?" (blog de lançamento).
Os prompts que mais importam no trabalho real, segundo o model card:
- Literal ou limpo. Manter cada "hã" e repetição, ou removê-los e deixar o resto inalterado.
- Termos de contexto. Liste antes nomes de produtos, pessoas ou jargões. No teste contextual de teleconferências de resultados da NVIDIA, a recuperação de palavras-chave foi de 58,16% para 96,05% quando os termos foram fornecidos.
- Falantes e marcas de tempo. Peça tags de falante e tempos de palavra em uma única passada, em vez de rodar depois uma ferramenta de diarização separada.
- Valores exatos. Uma predefinição mantém e-mails, URLs, caminhos de arquivo e números de pedido escritos do jeito que foram ditos, justamente o que uma transcrição de suporte não pode errar.
- Marcação de dados pessoais. O modelo foi treinado para marcar ou ocultar dados pessoais, útil se você oculta dados em transcrições de suporte antes que alguém as leia.
O card até cita "support recordings" como adequadas ao prompt de termos de contexto e lista o atendimento ao cliente como área de aplicação. Ou seja, os call centers estão bem claramente na mira da NVIDIA com este modelo.
Qual a qualidade real dele?
Nos testes públicos, é o melhor ou o segundo melhor modelo de voz aberto, e fica um passo atrás dos melhores fechados. A seguir, o que os números dizem e também onde eles discordam entre si.
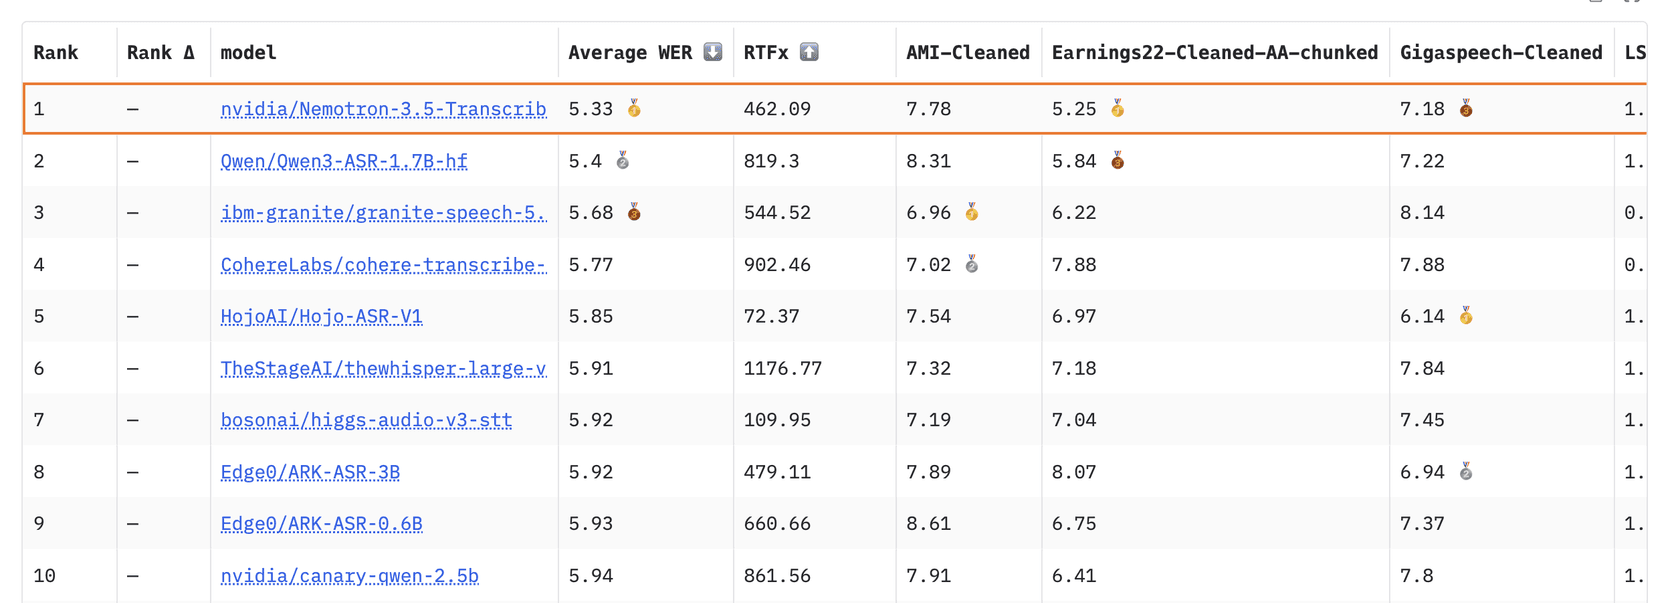
Leaderboard Open ASR do Hugging Face (inglês). Primeiro entre os modelos de pesos abertos com 5,33% de taxa média de erro de palavras, logo à frente do Qwen3-ASR-1.7B com 5,4% (leaderboard). A taxa de erro de palavras é a parcela de palavras que um modelo erra, então quanto menor, melhor.
Artificial Analysis. 2,81% no índice de erro, segundo entre os modelos abertos, por um fio atrás do Voxtral Small com 2,77%, que usa cerca de seis vezes mais parâmetros ativos (Artificial Analysis). O próprio blog da NVIDIA chama isso de empate no primeiro lugar. Os modelos fechados ainda lideram no geral: o MAI-Transcribe-2 está em 2,04% e o Gemini 3.5 Transcribe em 2,60%. No conjunto para agentes de voz, o AgentTalk, ele marca 1,78%, perto do topo de toda a tabela.
Eu colocaria dois asteriscos nesse número, porém. O endpoint público da DeepInfra mede 3,4% no mesmo índice, então os 2,81% vieram de uma configuração que a maioria ainda não consegue alcançar. E em teleconferências de resultados ele marca 5,69%, atrás do ElevenLabs Scribe v2 com 3,95%.
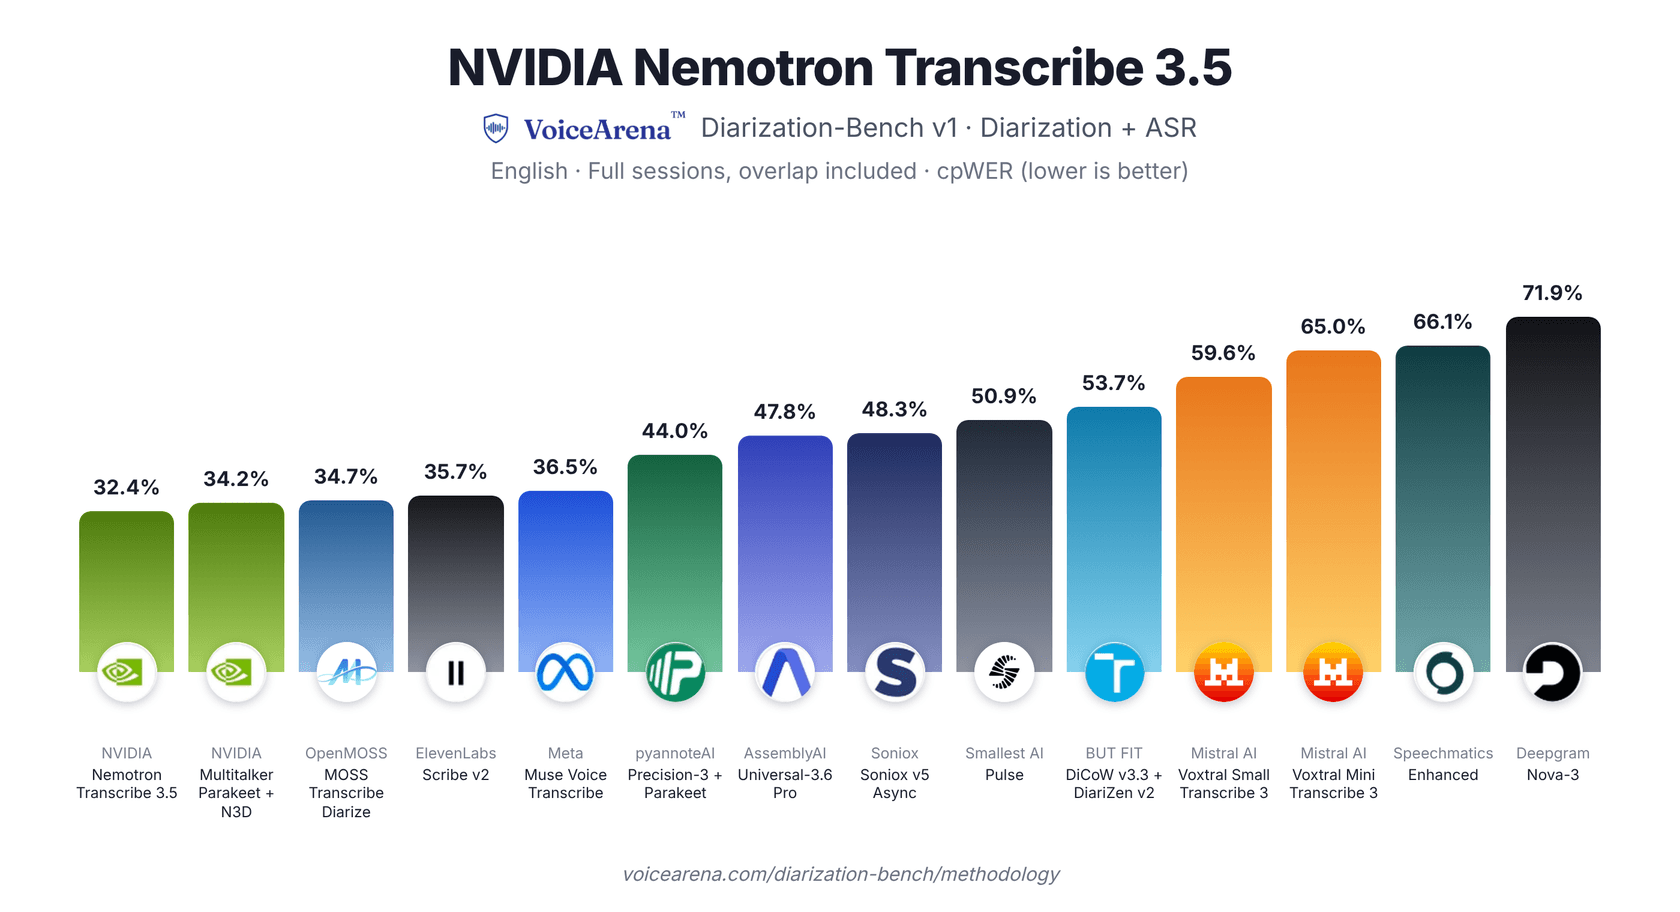
Quem disse o quê. É onde ele é mais forte. No benchmark de diarização da VoiceArena, com sessões completas em inglês e fala sobreposta, ficou em primeiro entre 14 sistemas com 32,4% de erro após o pareamento dos falantes, e omitiu muito menos palavras que os demais: 8,32% contra uma mediana de cerca de 31% (blog de lançamento).
Os idiomas não são iguais. A NVIDIA classifica 13 idiomas como "leading", incluindo inglês, espanhol, alemão, francês, hindi e coreano, e outros 15 como prontos para produção. Alguns ficam muito atrás: o erro no FLEURS é de 26,93% para o grego e 20,97% para o hebraico, e o norueguês, com 63,76%, não tem suporte de transcrição algum (model card). Então, se seus clientes ligam em norueguês, este modelo ainda não é para você.
O que as pessoas dizem após o primeiro dia?
A reação inicial é empolgada com a lista de recursos, mas mista quando as pessoas realmente testam. O tópico no r/LocalLLaMA passou de 193 votos em um dia, e o comentário mais votado deu o tom:
"Holy! This might be the holy grail of OS ASR models I have been looking for - something to dethrone venerable Qwen ASR."

O único teste real até agora, no Hacker News, veio de alguém que rodou uma quantização comunitária de 4 bits em áudio japonês, e que avisou que talvez não fosse a precisão total:
"testing it against parakeet right now for ASR, it's slower, heavier, and has a higher error rate. but i'm doing a pass with the embedded translation to see if that's any good, it might be worth it."

O retorno seguinte sobre a tradução não foi mais gentil ("disappointing model"), então trate as vitórias em benchmarks como números da NVIDIA até que cheguem testes independentes com pesos de precisão total. A outra coisa que aparece o tempo todo é o tamanho. Como disse um comentarista do Reddit, "30b for ASR is such a luxury", já que o Parakeet de 0,6B da própria NVIDIA roda em quase tudo (Reddit).
O caso de uso de que as pessoas mais pareceram gostar é um que equipes de suporte e operações conhecem bem: reuniões e ligações bagunçadas em que todos falam por cima uns dos outros.
"finally a model that can follow a standup where everyone unmutes at once"
Como executar o Nemotron 3.5 Transcribe?
Há três formas de entrar agora. Você pode testar uma demo gratuita ou chamar uma API hospedada e, se tiver o hardware, executá-lo na sua própria GPU.
- Testar a demo. O Hugging Face Space da NVIDIA aceita um upload e um prompt. É uma boa forma de checar o seu próprio áudio antes de se comprometer com qualquer coisa.
- Chamar uma API hospedada. A DeepInfra o lista a US$ 0,002 por minuto com zero retenção de dados. Baseten e Simplismart também o hospedam, mas vendem tempo de GPU ou orçamentos sob medida em vez de um preço por minuto.
- Hospedar você mesmo. O model card traz uma receita de vLLM 0.32.0 em uma H100 de 80 GB, além de opções com Transformers e SGLang-Omni. O servidor vLLM fala o formato de chat da OpenAI, então o código escrito para a API de áudio da OpenAI é portado com pequenas mudanças.
O card também tem algumas armadilhas fáceis de perder:
- A versão rápida ainda não é aberta. A manchete da NVIDIA de 100 horas de áudio em menos de três minutos usa os pesos NVFP4 não lançados e o servidor otimizado próprio. A configuração aberta do vLLM é "expected to be roughly two times slower".
- O SGLang-Omni só transcreve. Esse caminho dispensa marcas de tempo, rótulos de falante e tradução, que são metade da razão de escolher este modelo.
- GPUs menores esperam. O suporte à RTX 5090 é só NVFP4 e o da L40S só FP8, e nenhum dos repositórios era público em 29 de outubro.
- Pode entrar em loop. A NVIDIA fornece uma regex de limpeza para o raro caso em que a saída não para, e alerta sobre fala alucinada. Confira por amostragem nomes e trocas de falante.
Se executar modelos abertos no seu próprio hardware é novidade para você, o guia do Hugging Face cobre o básico do hub pelo qual a NVIDIA distribui.
Quanto custa?
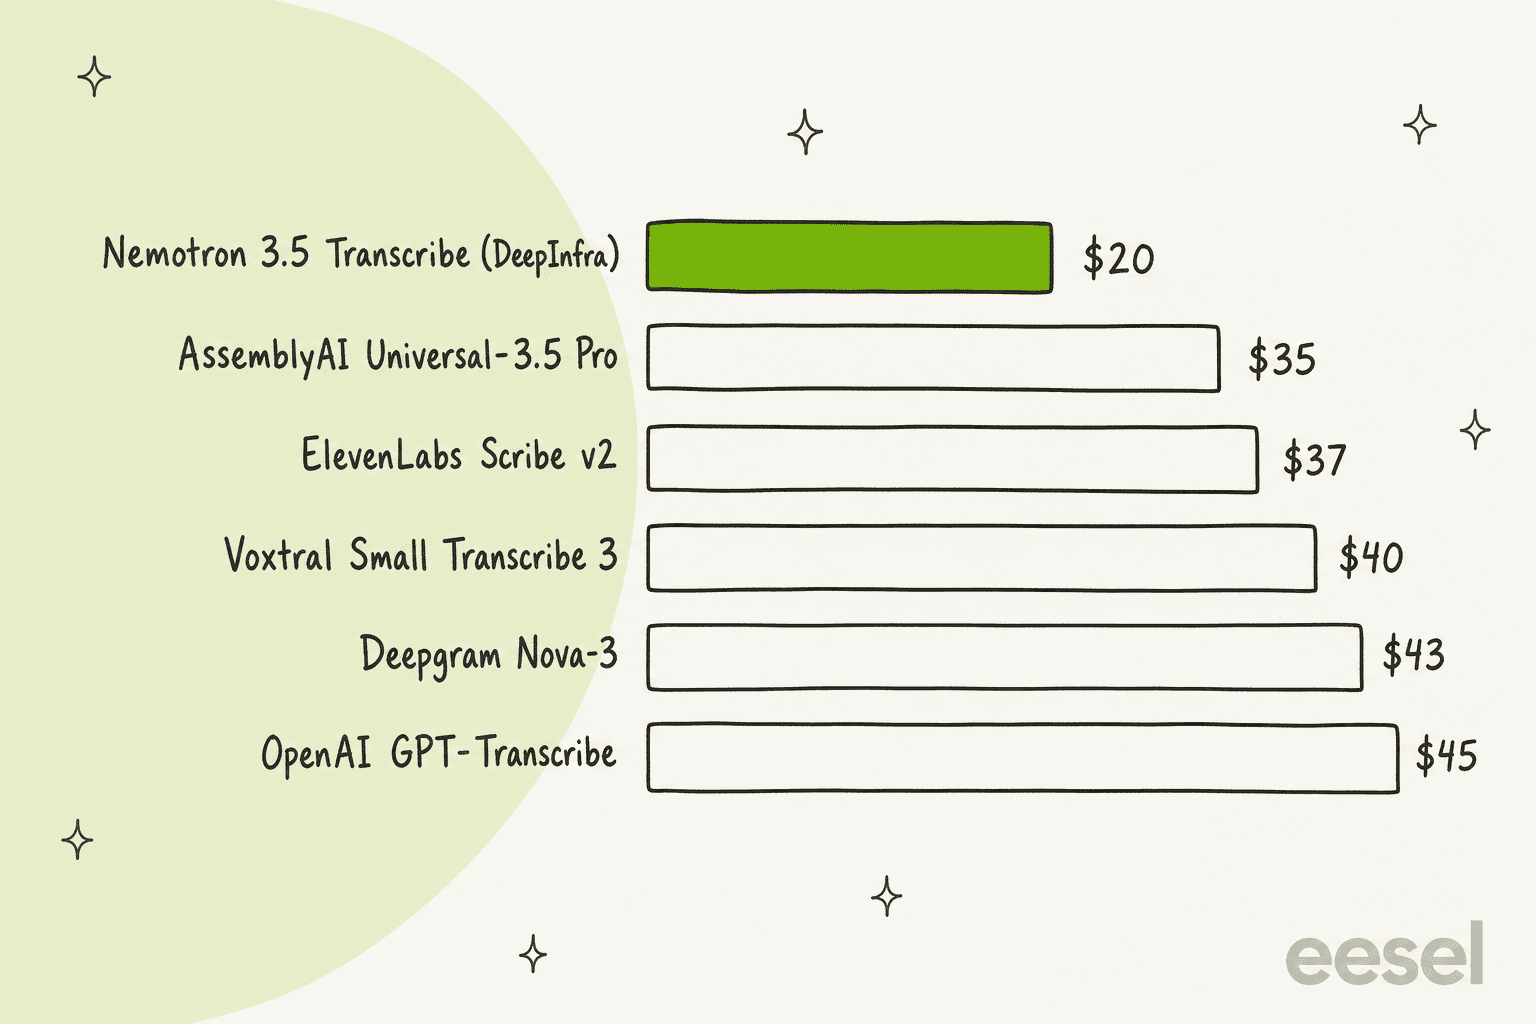
Os pesos não custam nada, então o preço real é o que você paga pela GPU ou pela API. Nas tarifas hospedadas, saiu como a opção precisa mais barata que encontrei. Aqui estão 10.000 minutos de ligações gravadas por mês, cerca de 167 horas, precificados pela página de cada fornecedor:
| Modelo | Preço em lote | 10.000 minutos | Fonte |
|---|---|---|---|
| Nemotron 3.5 Transcribe (DeepInfra) | US$ 0,002/min | US$ 20 | DeepInfra |
| AssemblyAI Universal-3.5 Pro | US$ 0,21/h | US$ 35 | AssemblyAI |
| ElevenLabs Scribe v2 | US$ 0,22/h | cerca de US$ 37 | ElevenLabs |
| Mistral Voxtral Small Transcribe 3 | US$ 0,004/min | US$ 40 | Mistral |
| Deepgram Nova-3, pré-gravado | US$ 0,0043/min | US$ 43 | Deepgram |
| OpenAI GPT-Transcribe | US$ 0,0045/min | US$ 45 | OpenAI |
| Gemini 3.5 Transcribe | cerca de US$ 0,005/min | cerca de US$ 50 |
A diferença aumenta quando se compara igual com igual em recursos. O Nemotron inclui prompting, termos de contexto e rótulos de falante na chamada básica. Na AssemblyAI, acrescentar prompting (US$ 0,05/h) e diarização (US$ 0,02/h) ao Universal-3.5 Pro leva a US$ 0,28 a hora, mais que o dobro dos US$ 0,12 do Nemotron. Para um olhar mais profundo sobre os rivais, veja as análises do Gemini 3.5 Transcribe e do Voxtral 3.
Hospedar você mesmo só sai mais barato por hora de áudio se a GPU ficar ocupada. A Baseten aluga uma H100 por US$ 0,10833 o minuto (Baseten), cerca de US$ 6,50 a hora. A NVIDIA mede de 260 a 410 vezes o tempo real nessa placa para inglês em lote, então uma hora de GPU cobre de 260 a 410 horas de áudio. Pelas minhas contas, são cerca de 2 a 3 centavos por hora de áudio, contra 12 centavos na DeepInfra, mas só quando você alimenta um lote constante. Uma equipe com 167 horas por mês pagaria por uma GPU quase sempre ociosa, então a API vence até o volume ficar sério.
Onde se encaixa para uma equipe de suporte?
Encaixa em qualquer lugar onde você já tem gravações e quer texto que possa pesquisar, pontuar ou acionar. Conversas ao vivo são onde ele não se encaixa.
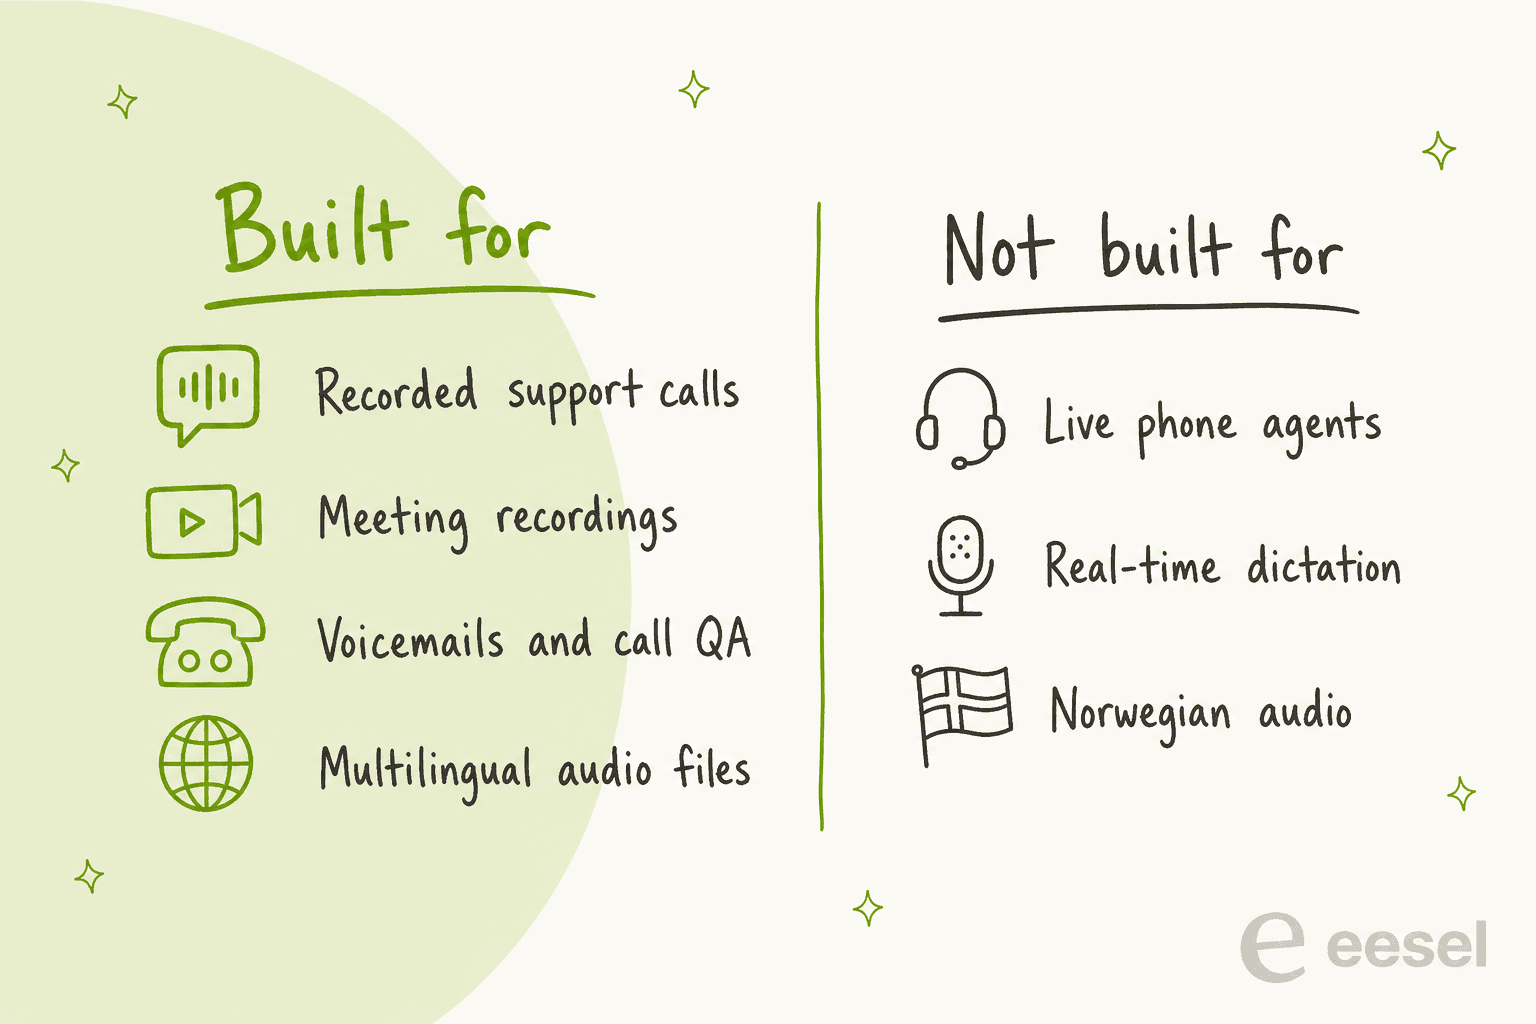
- Controle de qualidade de chamadas. Transcrições com rótulos de falante facilitam pontuar como os agentes conduzem as ligações, a parte chata do controle de qualidade em call centers. Combine com o QA de suporte com IA para avaliar o texto.
- Mensagens de voz e retornos. Transcreva e deixe o ticket carregar o texto, para que quem o pegar não precise ouvir primeiro.
- Resumos e sentimento. A transcrição alimenta o resumo de tickets e a análise de sentimento, do mesmo jeito que as transcrições de chat.
- Filas multilíngues. Um modelo cobrindo 40 idiomas vence costurar uma ferramenta diferente por mercado, que é metade da batalha no suporte ao cliente multilíngue.
O que ele não faz é falar com quem liga. Para isso você precisa de um modelo de streaming dentro de um agente de voz com IA, ou de uma das ferramentas da minha lista dos melhores agentes de voz com IA. Ele também não decide o que responder. Uma transcrição perfeita de um pedido de reembolso ainda precisa de alguém, ou algo, que conheça a sua política de reembolso.
Essa segunda parte é onde passo a maior parte dos meus dias. Nos anos em que a eesel roda IA em filas de suporte reais, o difícil nunca foi transformar palavras em texto. Foi responder corretamente a partir das políticas da própria empresa e saber quando passar para uma pessoa, e é por isso que toda implantação é testada nos tickets antigos de uma equipe antes de responder a alguém.
Por que o Nemotron 3.5 Transcribe importa
Importa porque torna opcional "mandar o áudio para a nuvem de outra pessoa". Até agora, os modelos de voz precisos com rótulos de falante e tradução embutidos eram APIs fechadas, e os abertos eram modelos pequenos de função única que você tinha de encadear. O Nemotron 3.5 Transcribe põe tudo em um único checkpoint aberto que você pode executar no seu próprio data center, com uma licença comercial e os dados de treinamento Granary v2 da NVIDIA (463.062 horas em 48 idiomas) publicados junto.
A outra mudança é que adaptá-lo agora é barato. O estudo de caso médico da NVIDIA o ajustou com fala clínica de sotaque indiano e reduziu os erros de 30,8% de fábrica para 11,8%, em cerca de 14 horas de GPU em uma única GB300 (estudo de caso).
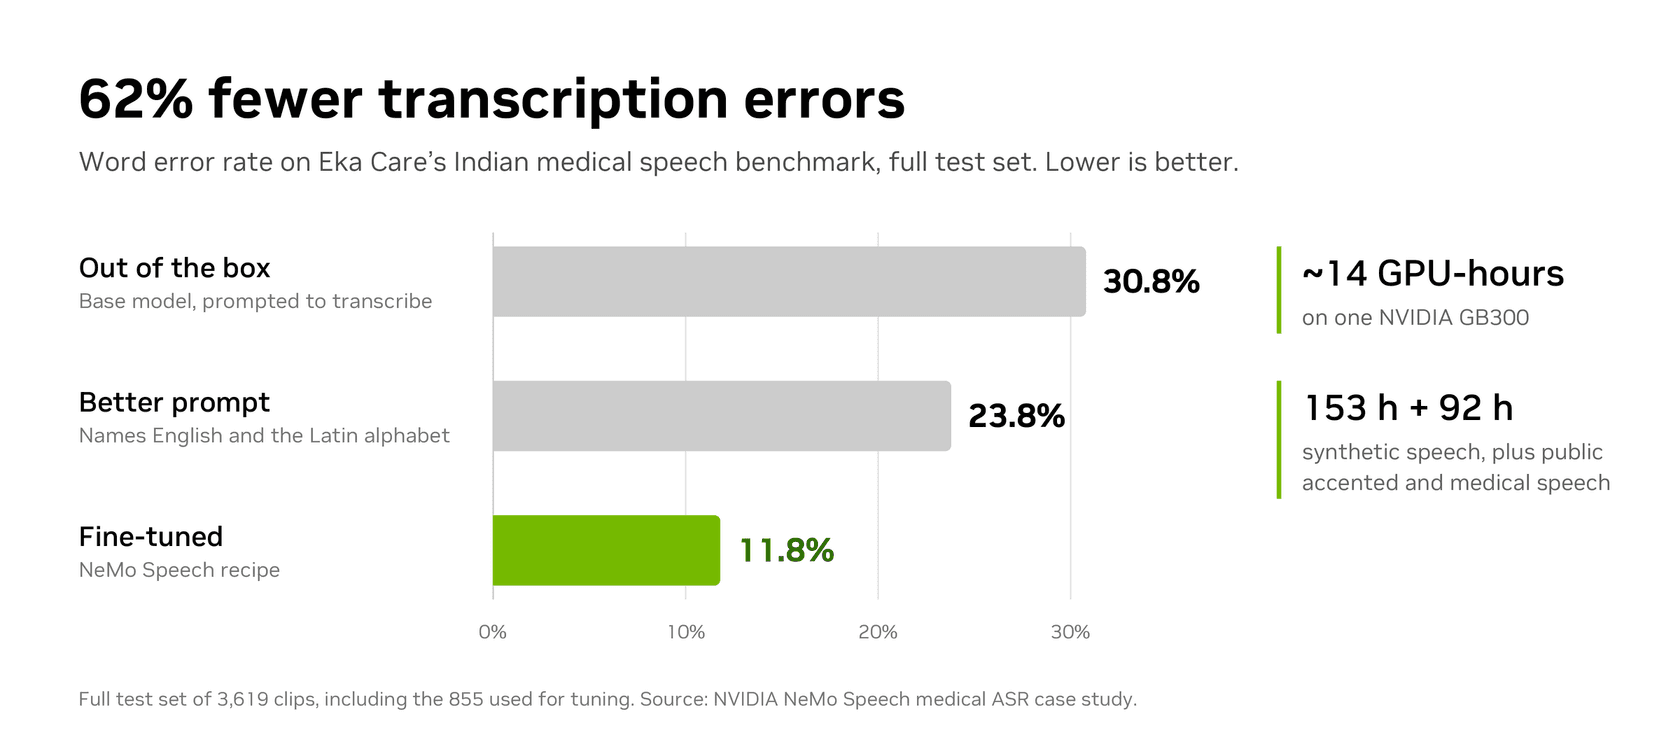
A barra do meio é a que merece atenção. Só um prompt melhor levou de 30,8% a 23,8% antes de qualquer treinamento. Minha opinião: teste o prompt antes de testar o ajuste fino. Dizer ao modelo o idioma e o alfabeto, além dos nomes dos seus produtos, não custa nada e, para a maioria das equipes de suporte, é boa parte do ganho.
Se você o está comparando com outros modelos abertos para uma stack maior, a plataforma aberta de segurança de agentes da NVIDIA e minha lista de agentes de IA de código aberto cobrem as peças ao redor.
Experimente a eesel
O Nemotron 3.5 Transcribe é infraestrutura: ouvidos excelentes, sem descrição de cargo. Ele transforma uma ligação em texto. O que acontece depois, ler o ticket, conferir o pedido, responder no idioma do cliente, escalar o cliente irritado, é um trabalho, e é isso que o colega de IA para o helpdesk da eesel faz. Ele se integra ao Zendesk, ao Freshdesk ou ao Gorgias, aprende com seus tickets antigos e sua central de ajuda, e você pode testá-lo em centenas desses tickets antes que ele responda a qualquer pessoa.

O idioma é onde isso mais compensa. Na smava, ele atendeu 27.000 tickets do Zendesk em um mês, marcando o idioma e a categoria de cada um e redigindo respostas em alemão. Na Koffer.ch, ele redige respostas no Freshdesk em qualquer um dos quatro idiomas em que o cliente escreveu, com a ortografia suíça no alemão.
Se você gosta de operar modelos pelo terminal, a CLI da eesel opera o mesmo colega: ler e editar suas instruções, aprovar ações que aguardam uma pessoa e conferir o log de atividade de cada execução, com saída JSON e simulações nas gravações. Um agente de código como o Claude Code pode gerenciar seu colega de suporte ao lado do seu pipeline de transcrição. Experimente a eesel grátis, ou agende uma demo para vê-lo nos seus próprios tickets.