

O Voxtral 3 é o pacote de voz com melhor custo-benefício que você pode comprar hoje de um laboratório europeu, e eu daria 3,5 de 5: excelente para transcrição em lote, promissor mas ainda cedo como agente telefônico. O Voxtral Small Transcribe 3 empata com o Microsoft AI Transcribe 2 em uma taxa de erro de palavras de 4,0% no teste de 45 idiomas da Mistral e custa $0.004 o minuto. A voz custa $13 por 1 M de caracteres, e a API de agentes de voz completa custa $0.04 o minuto.
Três coisas o seguram. Todos os modelos estão em prévia pública, os pesos são fechados desta vez (o Voxtral 1 e o 2 eram abertos) e chamadas telefônicas por SIP são apenas para empresas no lançamento. O gráfico da própria Mistral também mostra o Gemini 3.5 Realtime à frente na transcrição ao vivo em todas as configurações de latência.
Se você cuida de suporte, a camada de voz é a metade fácil. Na eesel respondemos 27,000 tickets do Zendesk por mês em alemão para a smava, e o que faz isso funcionar é treinar com tickets anteriores, não um microfone melhor. Um modelo de voz dá ouvidos e voz ao seu agente; ele ainda precisa conhecer o seu negócio.
O que é o Voxtral 3?
O Voxtral 3 é a família de voz da Mistral, lançada em 20 de outubro de 2026. Ele reúne três coisas que antes eram compradas separadamente: modelos de fala para texto, um modelo de texto para fala e um SDK de agentes de voz que os encadeia com um modelo de chat no meio.
Eu construo integrações e APIs para viver, então leio este lançamento como leria a documentação de qualquer fornecedor: o que cada ID de modelo realmente faz, quanto custa por unidade e o que quebra quando eu o conecto. Esta é a linha de produtos:
| Modelo | Função | Preço | Observações |
|---|---|---|---|
| Voxtral Small Transcribe 3 | Transcrição em lote, carro-chefe | $0.004/min | 50 idiomas, diarização, também faz tradução e perguntas sobre a fala |
| Voxtral Mini Transcribe 3 | Transcrição em lote, econômico | $0.0035/min | 4B parâmetros, pequeno o bastante para hardware limitado |
| Voxtral Mini Transcribe Realtime 3 | Transcrição ao vivo | $0.008/min | Controle de latência de 80 ms a 2.400 ms, detecção de fim de turno |
| Voxtral TTS 3 | Texto para fala | $13/1M chars | 35+ idiomas, 50+ dialetos, clonagem de voz |
| API de agentes de voz (Mistral Small 4) | Fluxo completo da chamada | $0.04/min | Fala de entrada, raciocínio, fala de saída |
| API de agentes de voz (modelo maior) | Fluxo completo da chamada | $0.08/min | O mesmo, com um modelo de raciocínio maior |
Os preços vêm da publicação de lançamento e da página de documentação de cada modelo, como a ficha do Voxtral Small Transcribe 3. Cada uma dessas páginas rotula o modelo como Public Preview, o que importa mais do que parece se você planeja um lançamento em produção neste trimestre.
Quão precisa é a transcrição do Voxtral 3?
Muito, para áudio gravado. Esta é a parte do lançamento em que eu mais confiaria, porque os números se sustentam mesmo quando você lê os gráficos da Mistral com mais cuidado do que o texto da Mistral.
No benchmark FLEURS em 45 idiomas, o Voxtral Small Transcribe 3 marca 4.0% de taxa de erro de palavras quando detecta o idioma sozinho. Veja como os sete modelos do gráfico da Mistral se alinham:
| Modelo | Taxa de erro, idioma informado | Taxa de erro, idioma detectado |
|---|---|---|
| Voxtral Small Transcribe 3 | 4.1% | 4.0% |
| Microsoft AI Transcribe 2 | 4.1% | 4.0% |
| Voxtral Mini Transcribe 3 | 4.6% | 4.5% |
| Gemini 3.5 Transcribe | 6.1% | 4.5% |
| Scribe v2 | 4.9% | 4.9% |
| GPT Transcribe | 6.3% | 5.6% |
| Whisper large-v3 | 16.0% | 14.9% |
Repare que a linha de cima é um empate. O texto do lançamento diz que o Small "supera o Whisper, o Scribe v2 e o Gemini 3.5 Transcribe", o que é verdade, e deixa de fora o Microsoft AI Transcribe 2, que o iguala até a casa decimal. No gráfico da própria Mistral do índice de erro de palavras da Artificial Analysis, o Voxtral Small Transcribe 3 aparece em terceiro, atrás do Fun-Realtime-ASR-preview e do Microsoft AI Transcribe 2. É um ótimo resultado. Só não é a vitória limpa que a manchete sugere.
O modelo Mini é o vencedor discreto aqui. Com 4.5%, ele iguala o Gemini 3.5 Transcribe em áudio com idioma detectado, e a ficha do modelo Mini diz que ele é pequeno o bastante para implantações com recursos limitados. Se você transcreve chamadas gravadas para garantia de qualidade, o Mini a $0.0035 o minuto é por onde eu começaria.
Quem disse o quê: diarização
A diarização (rotular qual falante disse cada linha) é onde o Voxtral lidera seu gráfico. No benchmark combinado de diarização da Mistral, que mistura gravações de reuniões e chamadas telefônicas, as taxas de erro são:
- Voxtral Small Transcribe 3:
18.4% - Voxtral Mini Transcribe 3:
18.6% - Pyannote Orchestrator:
19.0% - Microsoft AI Transcribe 2:
20.3% - Scribe v2:
23.0% - Voxtral Mini Transcribe 2:
30.9% - Gemini 3.5 Transcribe:
38.4%
Esse salto de 30.9% no antigo Mini para 18.6% no novo é a maior melhoria individual do lançamento. Para equipes de suporte, a diarização é o que transforma a gravação de uma chamada em uma transcrição utilizável: você precisa saber quais linhas eram do cliente e quais eram do agente antes de avaliar a chamada ou extrair a reclamação. Também importa se você pretende ocultar dados pessoais das transcrições, já que as regras de ocultação costumam diferir por falante.
Nomes de produtos e jargão: viés de contexto
O viés de contexto permite entregar ao modelo uma lista de termos (nomes de produtos, SKUs, pessoas) para que ele os escreva corretamente. No teste de frases-chave Earnings-22, o Voxtral Small atinge 94.6% de recall com contexto e 81.4% sem. O Scribe v2 marca 94.3% com contexto e 84.0% sem.
Então, com uma lista de termos, os dois ficam empatados, e sem ela o Scribe v2 na verdade lembra mais frases-chave. A leitura prática: se você usa o Voxtral, sempre envie uma lista de termos. O guia de migração acrescenta que as entradas agora podem ser frases de várias palavras, mas elas dividem a janela de contexto com o áudio, então uma lista longa pode disparar um erro 400.
O Voxtral 3 é bom para chamadas ao vivo?
Bom, não o melhor. É aqui que meu veredicto se suaviza, e é o gráfico da própria Mistral que o suaviza.
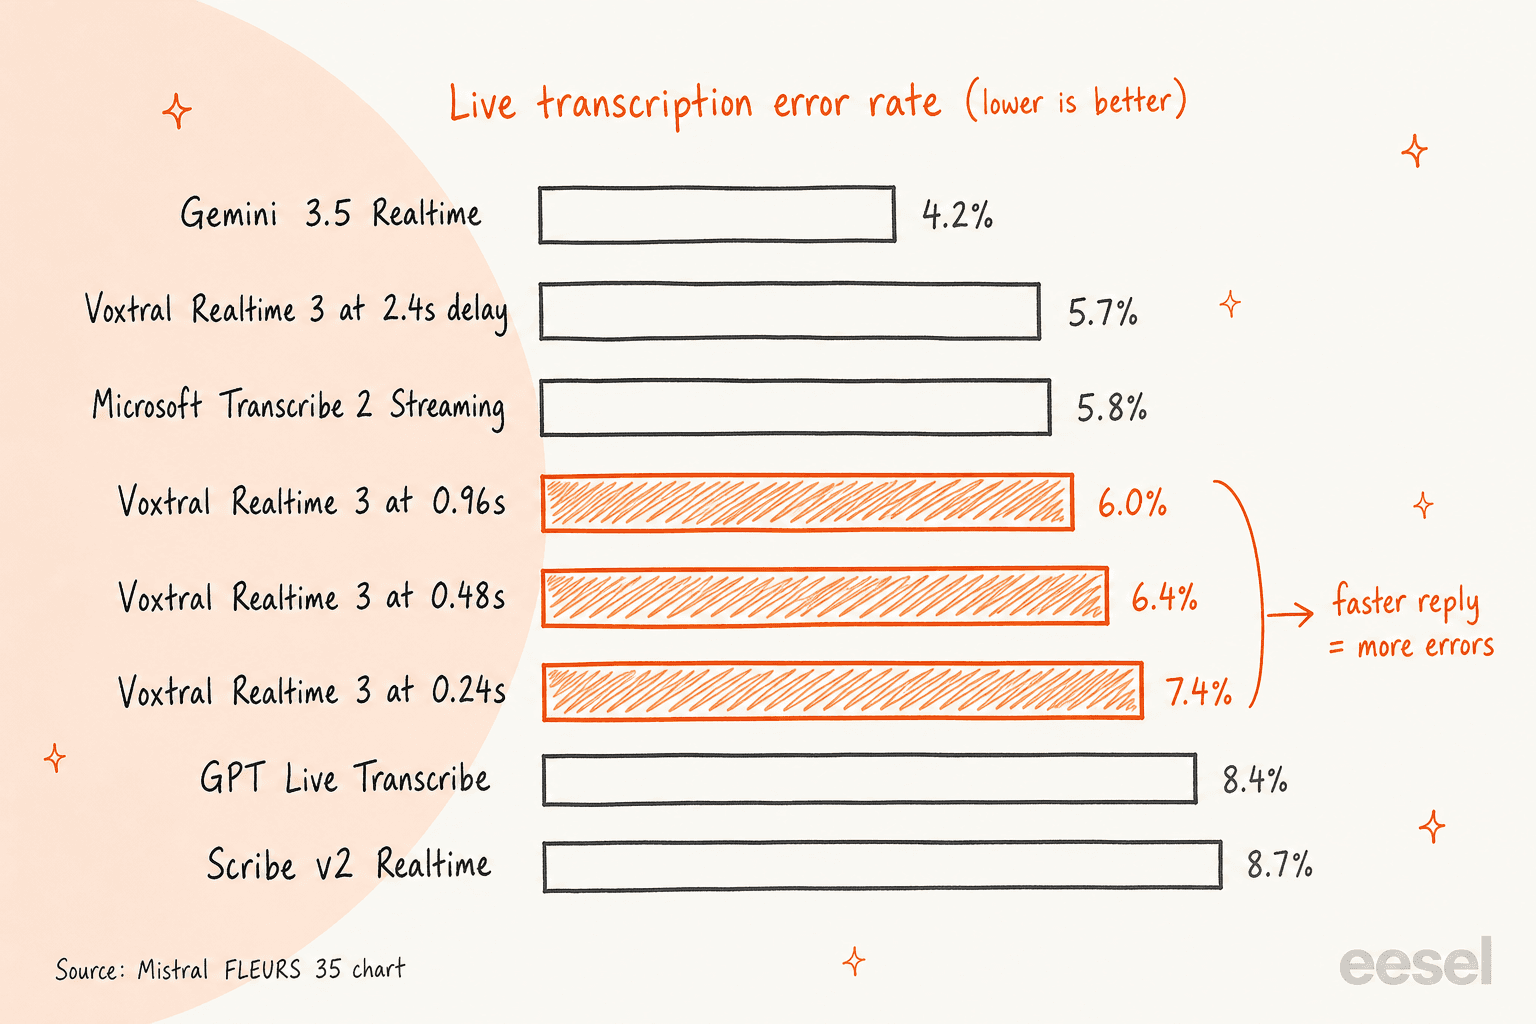
O Voxtral Mini Transcribe Realtime 3 tem um controle de latência: você escolhe quanto ele espera antes de fixar as palavras, de 80 ms a 2.400 ms. Esperar mais significa mais contexto e menos erros. No teste em tempo real de 35 idiomas da Mistral:
| Configuração | Taxa de erro |
|---|---|
| Gemini 3.5 Realtime Transcribe | 4.2% |
| Voxtral Realtime 3 a 2.400 ms | 5.7% |
| Microsoft AI Transcribe 2 Streaming | 5.8% |
| Voxtral Realtime 3 a 960 ms | 6.0% |
| Voxtral Realtime 3 a 480 ms | 6.4% |
| Voxtral Realtime 3 a 240 ms | 7.4% |
| GPT Live Transcribe | 8.4% |
| Scribe v2 Realtime | 8.7% |
Duas coisas se destacam. Primeiro, o Gemini 3.5 Realtime supera todas as configurações do Voxtral no gráfico da própria Mistral. Segundo, a configuração que você realmente usaria para um agente telefônico ágil (cerca de 240 a 480 ms) é onde o Voxtral abre mão de mais precisão. Ainda assim ele supera o GPT Live Transcribe e o Scribe v2 Realtime em todas as configurações, então é uma escolha sólida. Só não a mais precisa.
Uma coisa pequena que eu verificaria antes de construir sobre ele: as páginas da Mistral não concordam sobre quantos idiomas o modelo em tempo real cobre. A publicação de lançamento diz mais de 35, o cartão de preços diz 40+, e o gráfico testa 35. Teste os seus idiomas exatos em vez de confiar no número maior.
A boa notícia é a detecção de fim de turno. O modelo em tempo real prevê quando quem ligou terminou de falar usando tanto o som quanto o significado do que foi dito, o que impede um agente de voz de falar por cima de alguém que fez uma pausa no meio da frase. Quem já aguentou um bot que entra enquanto você dita o número do cartão sabe por que isso importa.
Quão natural soa a voz do Voxtral 3?
Natural o bastante, e muito barata pelo que entrega. O Voxtral TTS 3 é a peça que mais melhorou na sensação, embora não em um único número de manchete.
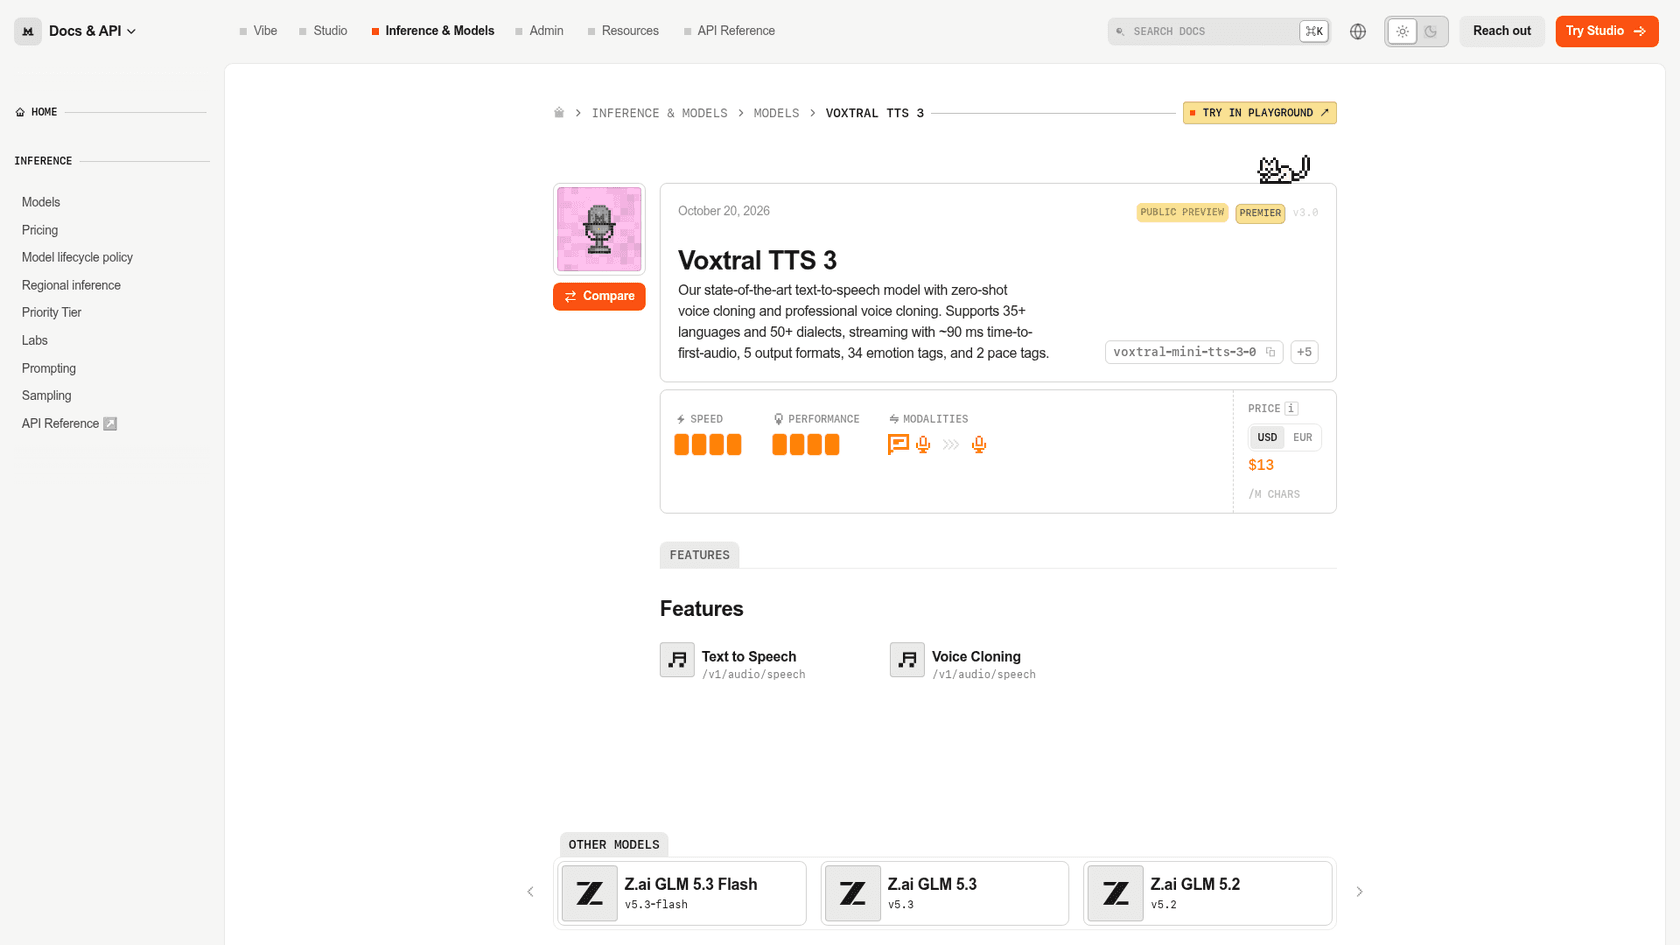
A folha de especificações da ficha do modelo:
- 35+ idiomas e 50+ dialetos, com vozes predefinidas em 18 idiomas
- Cerca de
90 msaté o primeiro áudio em streaming - 34 tags de emoção e 2 de ritmo que você pode inserir no texto, como
[emotion=...] - Clonagem de voz zero-shot, mais uma opção "Pro Voice" treinada com cerca de 30 minutos de áudio
- 5 formatos de saída
Vale ouvir os exemplos da página de lançamento, porque eles miram exatamente onde as vozes de suporte falham. Em um, o Voxtral 1 lê um horário de voo como "21,000pm on 10 over 10". O Voxtral 3 lê como "21pm on October 10th". Outro lê um endereço de e-mail para quem ligou sem tropeços. São esses os momentos em que uma voz barata te deixa mal numa linha de suporte.
No preço, a Mistral afirma que US$ 13 por 1 M de caracteres custam menos para operar que o OpenAI TTS-1, o Deepgram, o ElevenLabs Flash e o Gemini Flash, e seus gráficos de qualidade por dólar (baseados no Voice Code Bench da BeSimple AI, que testa números e nomes incomuns em roteiros de suporte) colocam o Voxtral TTS na ponta barata do mercado. São gráficos feitos pelo fornecedor com um modelo Gemini como juiz, então trate-os como uma lista de candidatos, não um veredicto. Se for comparar a sério, coloque-o ao lado do ElevenLabs, do Cartesia Sonic 3 e do Gemini 3.8 Flash TTS com seus próprios roteiros, ou veja a lista de alternativas ao ElevenLabs.
Uma observação do guia de migração: as instruções de estilo, o controle de texto livre de "diga isso com carinho", estão marcadas como indisponíveis no lançamento. Hoje você tem tags de emoção e de ritmo.
Como funciona o SDK de agentes de voz do Voxtral 3?
O SDK é a parte mais interessante do lançamento para quem constrói um agente de voz para suporte ao cliente, e a mais restrita.
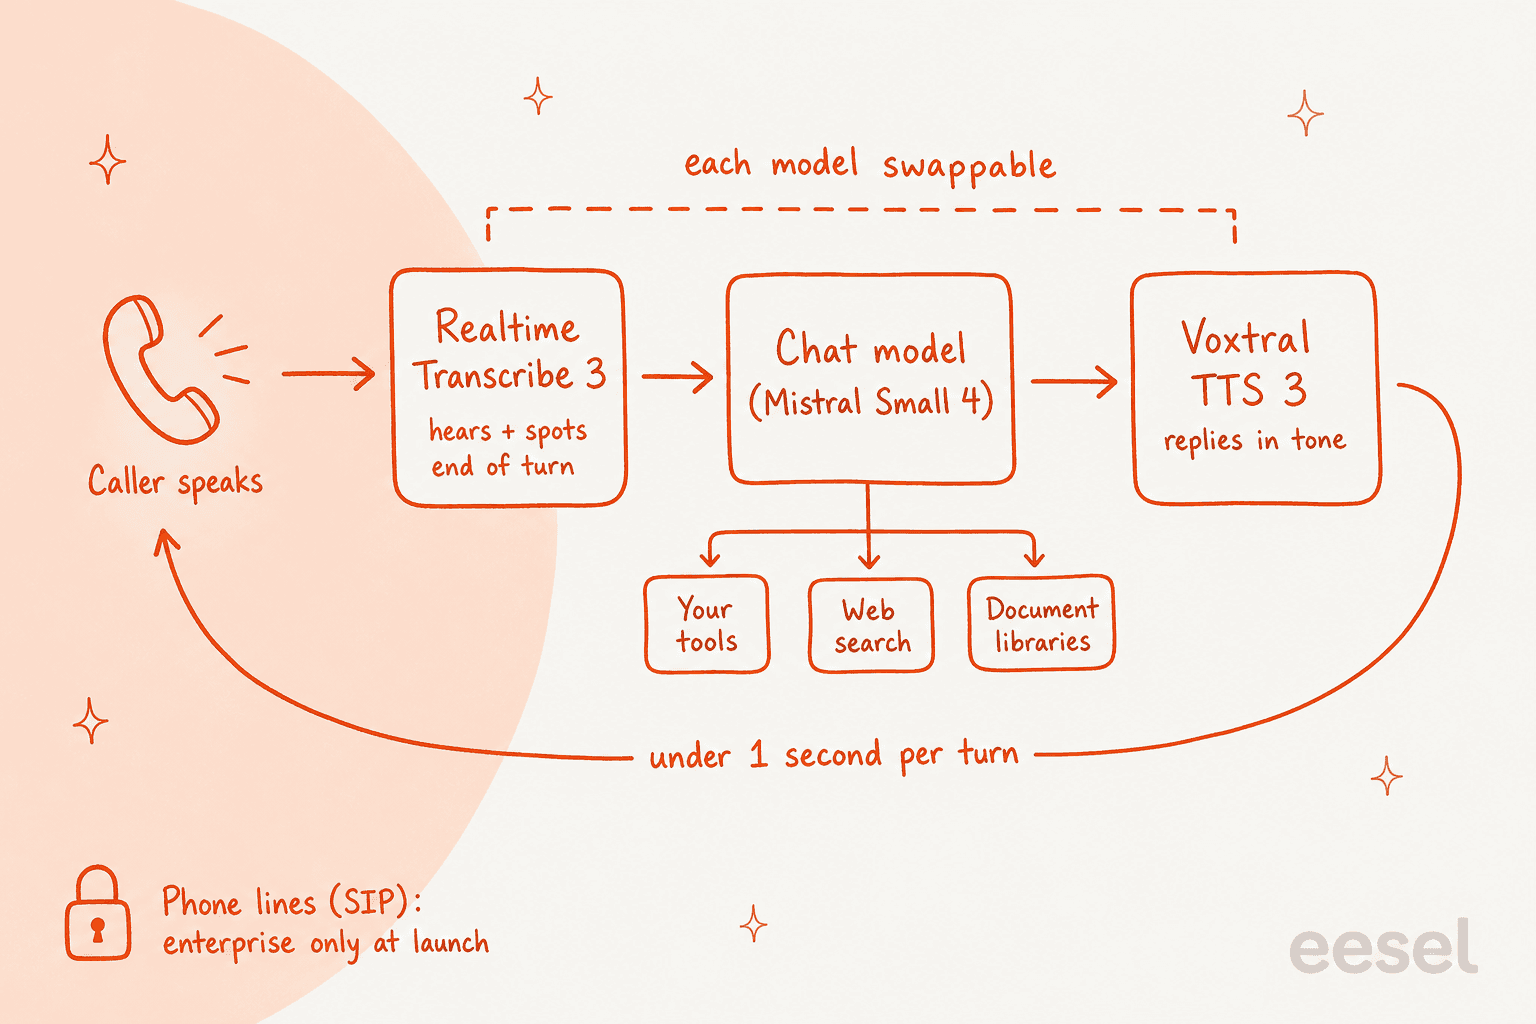
Segundo a documentação de agentes de voz, cada turno de uma conversa passa por três etapas: o modelo em tempo real transcreve e detecta o fim do turno, um modelo de chat como o Mistral Small 4 escreve a resposta e chama ferramentas, e o Voxtral TTS a fala. A Mistral diz que as etapas fluem uma dentro da outra, então cada turno termina em menos de um segundo, e quem ligou pode interromper.
O que eu gosto como desenvolvedor:
- Cada etapa é um modelo separado. Você pode trocar o modelo de raciocínio por um maior, ou mudar a voz ou o idioma, sem reescrever o agente.
- Os agentes têm versões. Você salva a configuração de um agente, cada mudança cria uma nova versão, e você pode fixar a produção em uma versão conhecida enquanto testa a próxima. É o design certo para qualquer coisa que converse com clientes.
- Webhooks disparam quando uma chamada começa, termina ou falha, para que você guarde cada transcrição no seu próprio sistema de registro.
- Ele é construído sobre o LiveKit para o transporte de áudio, com bindings em Python e TypeScript, mas você não precisa conhecer o LiveKit para usá-lo.
O que me dá pausa:
- As linhas telefônicas são só para empresas no lançamento. A documentação diz que a telefonia por SIP está "disponível para clientes corporativos no lançamento, por meio da sua equipe de conta". A voz em navegador e apps (via WebRTC) está aberta a todos. Para uma equipe de suporte cujos clientes ligam para um número de telefone, essa é a linha decisiva.
- Ferramentas do lado do cliente falham em chamadas telefônicas. A documentação deixa claro que, numa linha telefônica, nenhum código seu roda na chamada, então tudo de que um agente telefônico precisa (consultar um pedido, verificar uma fatura) tem de ser uma ferramenta do lado do servidor.
- As ferramentas são busca na web, bibliotecas de documentos, conectores de workspace e suas próprias funções. Não há noção embutida do seu helpdesk nem dos seus tickets anteriores. Nas nossas chamadas de vendas na eesel, a capacidade mais pedida é treinar com tickets anteriores, porque é lá que vivem as respostas reais de uma empresa. Com o Voxtral, isso é trabalho de integração que você mesmo faria.
Há também a questão de segurança levantada por um comentarista do Hacker News no tópico do lançamento, que chegou a 770 pontos e 202 comentários. Um agente de voz ligado a sistemas internos é um alvo de injeção de prompt que qualquer pessoa com um telefone alcança:
"I see companies hooking this up direct to the company intranet, and then users calling up and saying "Can you check this website for me?""

Isso não é tanto uma falha do Voxtral quanto a descrição do cargo de qualquer agente de voz que chama ferramentas. Mas é um bom motivo para manter agentes telefônicos em ferramentas estreitas, do lado do servidor, com limites claros sobre o que podem alterar. Se você está definindo o que um agente de IA para call center deve e não deve poder fazer, comece por aí.
Quanto custa o Voxtral 3 na prática?
Os preços por minuto são minúsculos até você somar o raciocínio. Veja quanto custam 10.000 chamadas de cinco minutos (50.000 minutos) aos preços de tabela da Mistral:
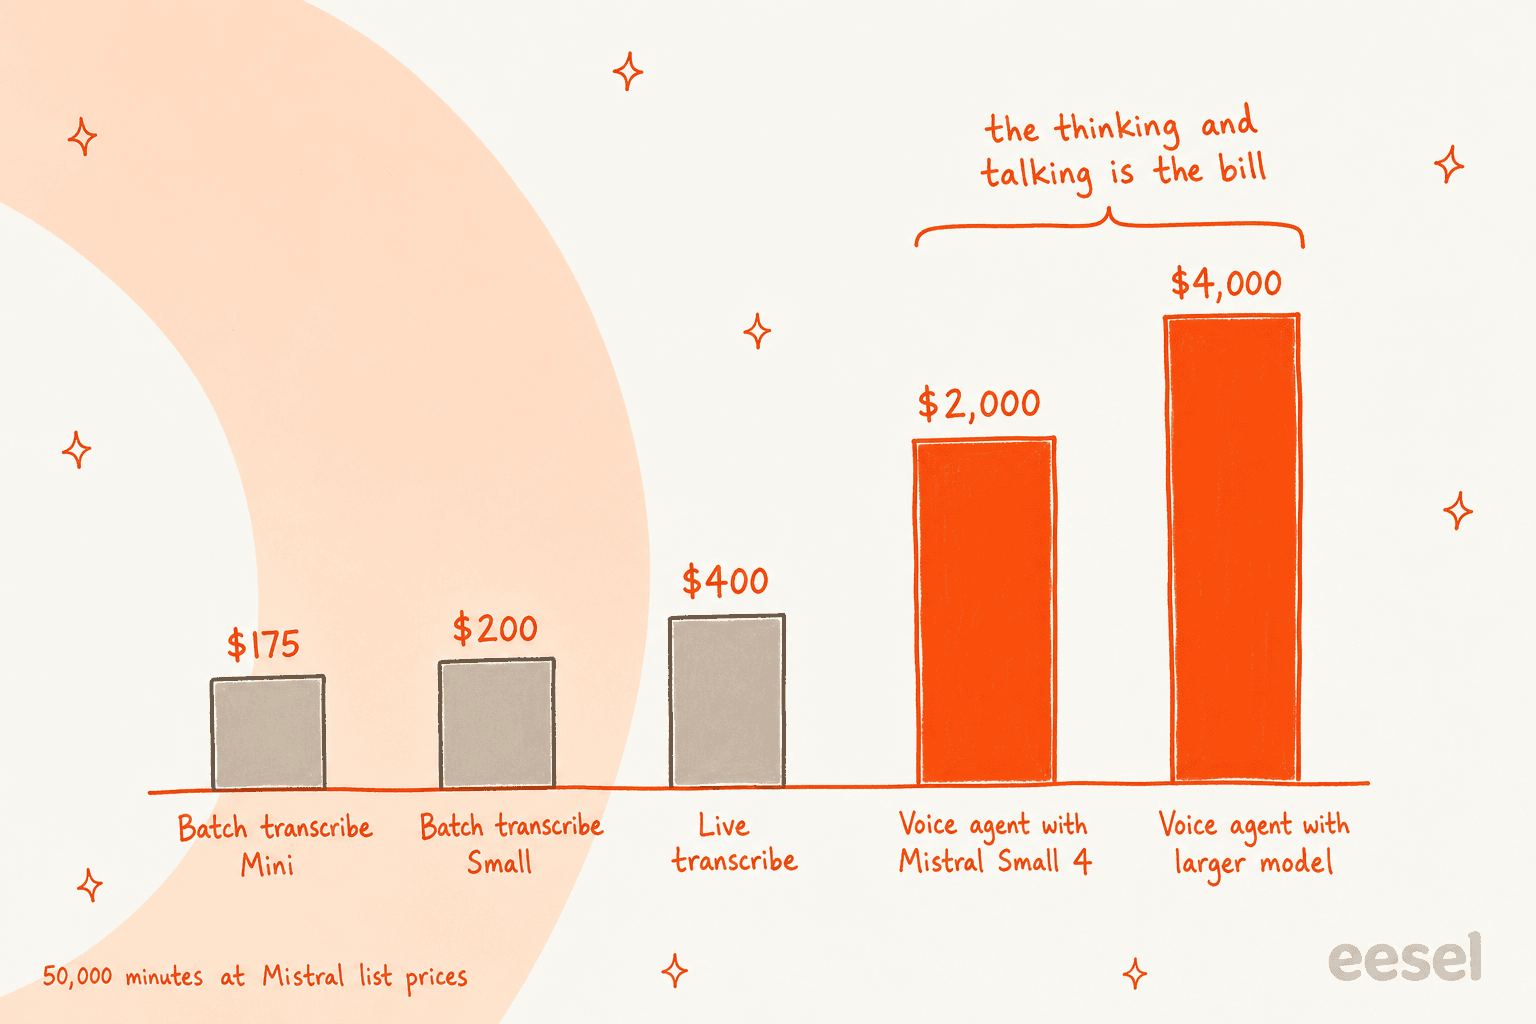
| O que você executa | Tarifa | 50.000 minutos |
|---|---|---|
| Transcrição em lote, Mini | $0.0035/min | $175 |
| Transcrição em lote, Small | $0.004/min | $200 |
| Transcrição ao vivo | $0.008/min | $400 |
| API de agentes de voz com Mistral Small 4 | $0.04/min | $2,000 |
| API de agentes de voz com um modelo maior | $0.08/min | $4,000 |
O padrão é a parte útil. Transcrever toda chamada que você já atende para o controle de qualidade custa algumas centenas de dólares por mês. Ter um agente de IA realmente atendendo essas chamadas custa de 10 a 20 vezes mais, porque o raciocínio e a fala são a conta. Uma única chamada de suporte de cinco minutos pela API de agentes sai por $0.20 com o Mistral Small 4. Esse é o número a colocar no seu modelo de ROI do call center, não os $0.004.
A tarifa de agente de $0.04 também é competitiva à primeira vista. Para contexto, minha análise do Grok Voice em agosto cobriu um concorrente com preço de $0.08 o minuto. Confira as tarifas mais recentes na página de cada fornecedor antes de se comprometer, já que os preços de voz mudaram rápido este ano. O detalhamento completo dos preços da Mistral AI cobre os modelos de chat por trás do agente.
Por que os pesos do Voxtral 3 são fechados?
Esta é a mudança que provocou a reação mais forte, e é justa. Os primeiros modelos Voxtral (Mini 3B e Small 24B, julho de 2025) e o modelo Voxtral Mini 4B Realtime de janeiro de 2026 foram todos lançados com pesos abertos no Hugging Face. Só esse modelo em tempo real mostra mais de 2 milhões de downloads. O Voxtral 3 não tem pesos públicos.
O lançamento diz que o Voxtral 3 está disponível "para autoimplantação na sua própria infraestrutura", o que confundiu os leitores até um comentarista esclarecer:
"You have to call sales to get access for on-prem deployment and the models. If it were open weights, it would be on Huggingface and they would have put a link in the post"
O comentário principal do tópico resumiu a decepção com clareza:
"Closed model unfortunately, continues the theme of TTS / STT being really not great for local deployments."
Para ser justo com a Mistral, ela não parou totalmente com os lançamentos abertos, como mostra a sequência de novos modelos. Comentaristas apontaram o Timestral na semana anterior e os pesos prometidos do Mistral Large 4. E um profissional apresentou o argumento comercial: bons modelos de fala com diarização são mais escassos que bons modelos de texto, e os compradores pagam um valor extra por eles. Para uma equipe de suporte corporativa, pesos fechados mais implantação local por contrato é um caminho de compra normal. Para um hobbista montando um assistente doméstico, é um beco sem saída.
O que quebra se você está no Voxtral 2?
Se você já chama o Voxtral 2, leia o guia de migração antes de trocar os IDs de modelo. Ele é bem escrito e honesto sobre o que quebra.
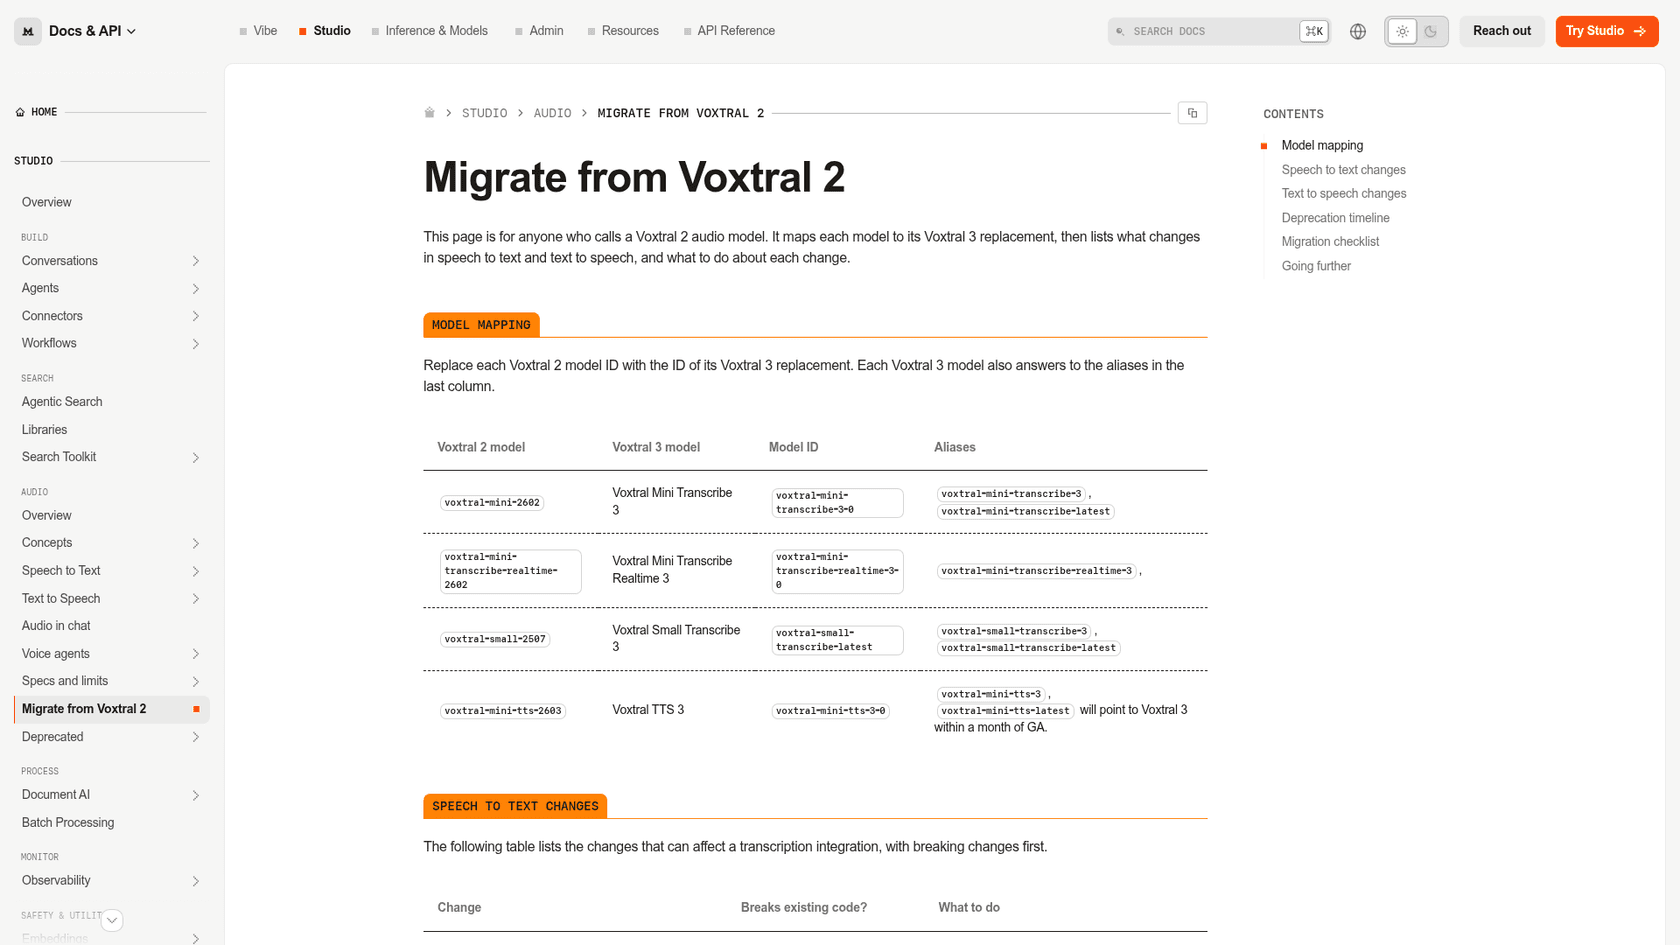
As mudanças incompatíveis, na ordem em que eu as verificaria:
- Os carimbos de tempo por palavra acabaram.
timestamp_granularitiessó aceitasegment; pedirwordretorna um erro400. Se você destaca palavras enquanto o áudio toca, esta dói. - As sessões em tempo real travam suas configurações quando o primeiro trecho de áudio chega. Um
session.updateposterior retorna um erro, então envie todas as configurações logo de início. - Os segmentos com diarização agora podem se sobrepor quando duas pessoas falam ao mesmo tempo. Se a sua exibição assume que isso nunca acontece, ela precisará de um ajuste.
O lado do TTS é mais brando: as vozes predefinidas antigas como gb_jane_sad continuam funcionando, e a clonagem com ref_audio também. O alias voxtral-mini-tts-latest passará para o Voxtral 3 até um mês após a disponibilidade geral, então fixe IDs de modelo explícitos se não quiser surpresas.
Quem deve usar o Voxtral 3?
Onde eu chego, por tipo de comprador:
| Se você é... | Veredicto |
|---|---|
| Transcreve chamadas gravadas para QA ou análises | Sim. Precisão quase no topo, a melhor diarização do seu gráfico e $0.0035 a $0.004 o minuto. |
| Uma equipe da UE que precisa processar áudio na Europa | Sim. API hospedada na UE e implantação local por contrato. Combine com uma leitura das regras do AI Act da UE para suporte. |
| Constrói um assistente de voz para navegador ou dentro de um app | Provavelmente. O SDK é bem projetado e o preço do agente é baixo, mas é uma prévia. |
| Quer colocar uma IA na sua linha telefônica de suporte este mês | Ainda não, a menos que seja cliente corporativo. O SIP é restrito para suporte telefônico com IA, e a integração com o helpdesk fica por sua conta. |
| Quer pesos para rodar localmente | Não. Veja as alternativas à Mistral ou os modelos Voxtral abertos mais antigos. |
No geral, eu daria ao Voxtral 3 3,5 de 5. Os modelos de transcrição são um 4,5, a voz um 4, e o SDK de agentes um promissor 3 seguro pelo status de prévia e pela restrição telefônica. Se a Mistral abrir o SIP para todos e os modelos saírem da prévia a esses preços, essa nota sobe.
Se você está comparando com o mercado mais amplo, meu resumo da melhor IA para suporte por voz e a lista de empresas de voz com IA cobrem as outras opções. E se você ainda está decidindo se vale a pena automatizar o suporte por telefone, a automação de call center é o lugar para começar.
Onde a eesel se encaixa ao lado do Voxtral 3
O Voxtral 3 é infraestrutura: ouvidos muito bons e uma voz barata e expressiva. A eesel é o funcionário. Nosso colega de helpdesk com IA entra no helpdesk que você já usa (Zendesk, Freshdesk, Gorgias e outros), aprende com seus tickets anteriores, sua central de ajuda e suas macros, e é testado com o seu histórico real de tickets antes de responder a um único cliente.
Essa é a metade do suporte que o Voxtral deixa para você. A smava, um comparador alemão de empréstimos, faz a eesel cuidar de 27,000 tickets do Zendesk por mês em alemão, categorizando 14,600 deles e redigindo 15,300 respostas a partir de 820 macros e artigos da central de ajuda. A Koffer.ch, uma loja suíça de malas, usa para redigir respostas no Freshdesk em alemão, francês, inglês ou italiano, conforme o idioma em que o cliente escreveu, com ortografia suíça. Isso é suporte multilíngue sem etapa de tradução. Nenhuma das duas precisou de um modelo de voz para chegar lá, e ambas precisariam exatamente desse conhecimento de tickets se um dia colocassem um agente ao telefone.
Se a sua fila hoje é de e-mail e chat, é ali que eu automatizaria primeiro. Experimente a eesel com seus próprios tickets anteriores, de graça, e veja o que ela teria respondido.