

O Voxtral 3 é toda a pilha de voz da Mistral num único lançamento: três modelos que transformam fala em texto, um que transforma texto em fala e um SDK de agentes de voz que os liga a um modelo de chat para que uma IA possa manter uma conversa por telefone ou navegador. Foi lançado em 20 de outubro de 2026, e todos os modelos continuam em pré-visualização pública.
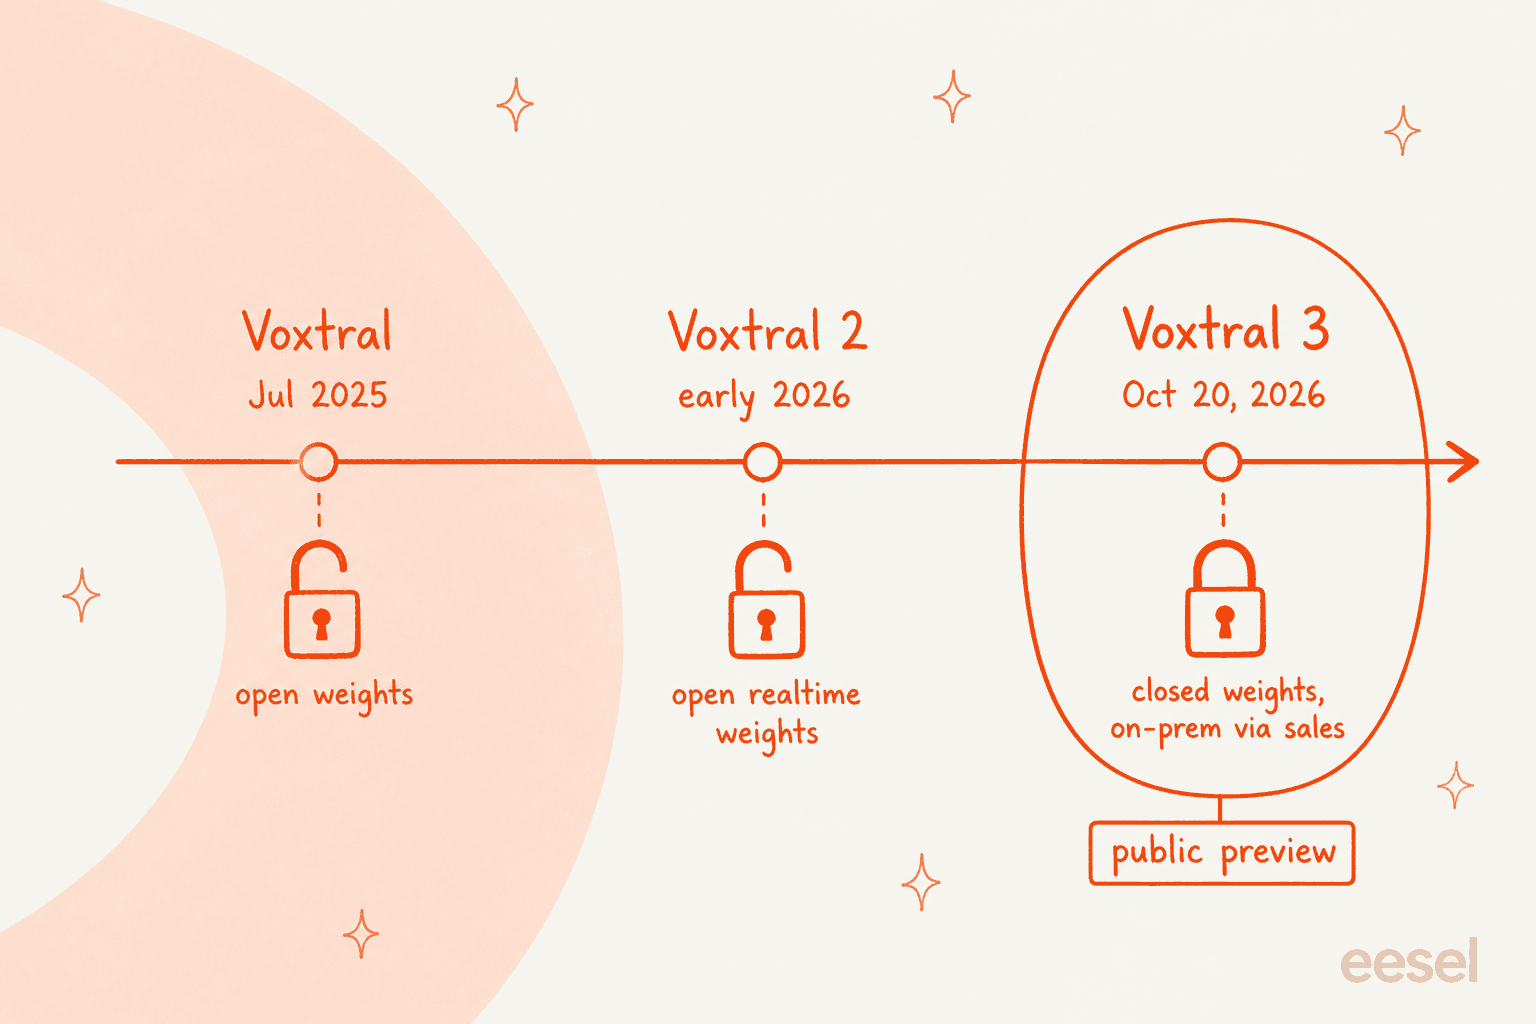
Os preços são baixos. A transcrição custa de US$ 0,0035 a US$ 0,008 por minuto, a voz custa US$ 13 por 1M de caracteres e todo o fluxo do agente custa US$ 0,04 por minuto com o Mistral Small 4 a raciocinar. Dois senões: desta vez os pesos são fechados, e as linhas telefónicas por SIP são só para enterprise no lançamento.
Para equipas de suporte, a conclusão é que o Voxtral resolve ouvir e falar, não saber. Na eesel construo os agentes de IA que respondem a tickets reais, e o trabalho que os torna úteis é aprender as respostas anteriores de uma empresa, como os 27.000 tickets do Zendesk em alemão por mês que tratamos para a smava. O Voxtral dá a um agente ouvidos e voz. As respostas ainda têm de vir de algum lado.
O que é o Voxtral 3?
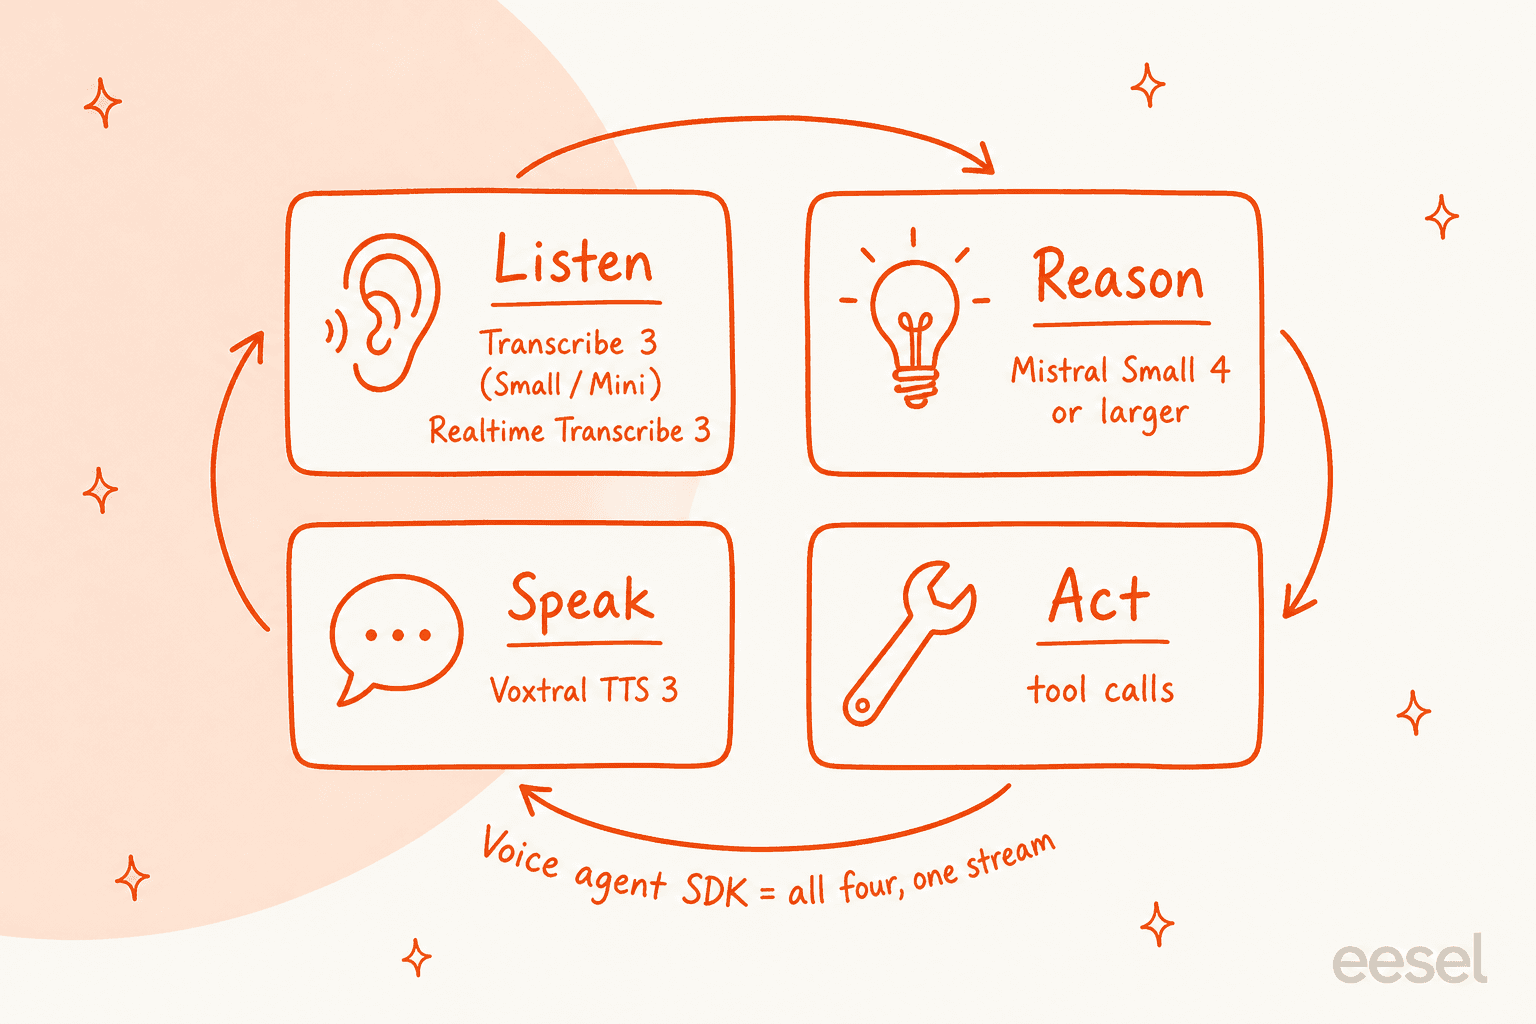
O Voxtral 3 é uma família de modelos de voz da Mistral AI, o laboratório sediado em Paris por trás dos modelos de chat Mistral e Magistral. O argumento da Mistral é que um agente de voz que funciona tem de fazer quatro trabalhos ao mesmo tempo: ouvir com precisão, raciocinar sobre o que quem liga quer dizer, falar com naturalidade e agir noutros sistemas. O Voxtral 3 é o primeiro lançamento do Voxtral que traz uma peça para cada um.
Trabalho em como os agentes da eesel realmente funcionam por baixo, por isso o que acho mais interessante neste lançamento não é nenhum benchmark isolado. É que a Mistral dividiu o trabalho em modelos separados que se podem trocar, em vez de um modelo que faz tudo. Essa escolha explica a maior parte do que é bom e do que é incómodo no Voxtral 3.
Que modelos há no Voxtral 3?
Há quatro modelos e um produto de API. Aqui está a linha com os IDs de modelo que realmente chamaria, retirados do guia de migração e dos preços de lançamento:
| Modelo | ID do modelo | O que faz | Preço |
|---|---|---|---|
| Voxtral Small Transcribe 3 | voxtral-small-transcribe-3-0 | Transcrição em lote de topo, diarização, tradução, perguntas e respostas sobre fala | $0.004/min |
| Voxtral Mini Transcribe 3 | voxtral-mini-transcribe-3-0 | Modelo de transcrição em lote menor, de 4B | $0.0035/min |
| Voxtral Mini Transcribe Realtime 3 | voxtral-mini-transcribe-realtime-3-0 | Transcrição ao vivo com deteção de fim de turno | $0.008/min |
| Voxtral Mini TTS 3 | voxtral-mini-tts-3-0 | Texto para fala, mais de 35 idiomas, clonagem de voz | $13/1M chars |
| API de agente de voz | n/a | Transcrição em tempo real + modelo de chat + TTS num só fluxo | $0.04/min (Mistral Small 4), $0.08/min (modelo maior) |
Cada modelo tem também aliases curtos, como voxtral-mini-transcribe-latest. Um ponto a vigiar: a Mistral diz que o alias voxtral-mini-tts-latest só passará para o Voxtral 3 no prazo de um mês após a disponibilidade geral. Se quer comportamento previsível, fixe o ID completo do modelo.
Tudo está disponível através da API da Mistral em endpoints europeus, dos EUA e globais, e pode experimentar transcrição, fala e agentes de voz no playground do Studio antes de escrever código.
Os modelos de transcrição
O Voxtral Small Transcribe 3 é o que vale a pena conhecer. A Mistral chama-lhe o seu modelo de topo de transcrição e diarização (diarização significa etiquetar quem disse cada linha). Lida com 50 idiomas, incluindo os 24 idiomas oficiais da UE (útil para suporte multilíngue), e a sua ficha de modelo diz que também traduz, resume e faz chamadas de funções a partir de áudio. A janela de contexto é de 32k tokens.
No teste FLEURS de 45 idiomas da Mistral, o Small tem uma taxa de erro de palavras de 4,0% quando deteta o idioma sozinho, empatado com o Microsoft AI Transcribe 2 e muito à frente do Whisper large-v3, com 14,9%. O modelo Mini tem 4,5% por um pouco menos de dinheiro. Detalho todos os gráficos, incluindo onde o Voxtral não está em primeiro, na minha análise do Voxtral 3.
Ambos os modelos em lote suportam context biasing: envia uma lista de termos (nomes de produtos, pessoas, SKUs) e o modelo escreve-os corretamente sem qualquer ajuste fino. No teste de frases-chave da Mistral, essa lista eleva o recall do Small de 81,4% para 94,6%, por isso trate-a como padrão, não como extra.
O modelo em tempo real é o que um agente ao vivo usa. Você escolhe quanto tempo espera antes de confirmar palavras, e esperas mais longas significam menos erros. Também prevê quando quem fala terminou, usando tanto o som como o significado das palavras, o que impede um bot de voz de cortar alguém a meio da frase. Isso importa para o suporte telefónico com IA, em que quem liga faz pausas para ler números de encomenda.
O modelo de voz
O Voxtral Mini TTS 3 transforma texto em fala em mais de 35 idiomas e mais de 50 dialetos, com vozes predefinidas em 18 idiomas. A ficha do modelo indica cerca de 90 ms até ao primeiro áudio em streaming, 34 etiquetas de emoção e 2 de ritmo que se escrevem inline, e clonagem de voz a partir de um clipe curto. Para vozes de marca, a "Pro Voice" cria uma cópia mais fiel a partir de cerca de 30 minutos de áudio.
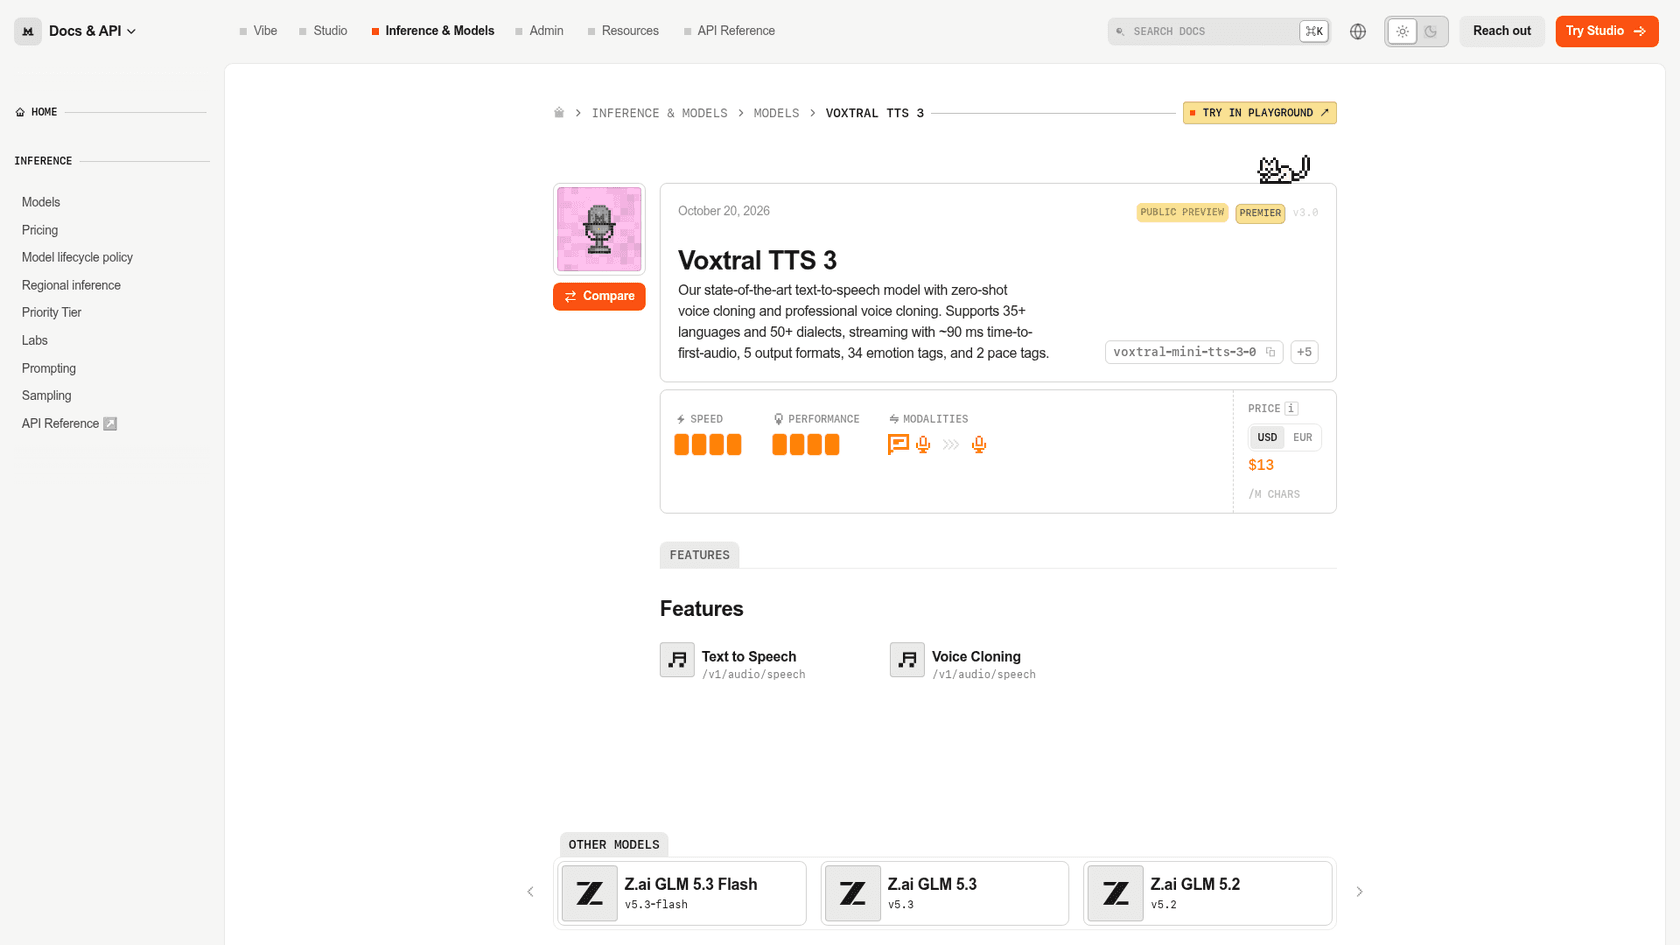
As amostras de som da página de lançamento visam exatamente o que faz tropeçar as vozes de suporte: ler um endereço de e-mail, uma hora de voo, um preço em libras. A Mistral também afirma que US$ 13 por 1M de caracteres fica abaixo do ElevenLabs Flash, do OpenAI TTS-1, da Deepgram e do Gemini Flash. Ainda assim, nem toda a gente gosta do novo som:
"The examples they give of how they "improved" the voices aren't great. Version 1 sounded like actual people, while this version sounds like generic AI slop voice."

É um único ouvinte, e o gosto por vozes é pessoal. Ainda assim, é uma boa razão para gerar amostras com os seus próprios guiões antes de escolher uma voz.
Como funciona o agente de voz do Voxtral 3?
O agente de voz executa um ciclo de três etapas em cada turno da conversa. Segundo a documentação de agentes de voz, o modelo em tempo real transcreve quem liga e deteta quando parou, um modelo de chat como o Mistral Small 4 decide o que dizer e chama as ferramentas, e o Voxtral TTS diz a resposta. As etapas alimentam-se umas às outras em streaming em vez de esperar, por isso a Mistral diz que cada turno termina em menos de um segundo, e o agente para de falar quando quem liga o interrompe.
Durante uma chamada, o agente pode usar chamadas de funções, pesquisa na web, bibliotecas de documentos e as suas próprias funções, por exemplo para verificar quem liga ou marcar uma consulta. Funciona em navegadores e apps por WebRTC, e em linhas telefónicas por SIP. O SDK assenta no LiveKit para o transporte de áudio.
Um comentador do Hacker News disse com precisão porque é esta a parte interessante do lançamento:
"I think the special sauce of this isn't the STT/TSS (although it does appear to be quite good) - it's the integration of a real-time reasoning model to actually do something with the raw text of the conversation, and whatever they're doing to hide tool call latency if the model needs to search for something."
Concordo, e é também onde o trabalho recai sobre si. As ferramentas são genéricas: não há noção embutida do seu helpdesk, do seu sistema de encomendas ou dos seus tickets anteriores. Nas nossas chamadas de vendas na eesel, o pedido mais frequente de longe é um agente que aprenda com tickets anteriores, porque é aí que estão as respostas reais de uma empresa. Com o Voxtral, ligar isso é trabalho de integração que fica consigo. Se está a definir a que deve poder aceder um agente de IA para call center, decida isso antes de ligar as ferramentas.
Dois limites do lançamento importam mais para o suporte. As chamadas telefónicas por SIP são só para enterprise no lançamento, organizadas pela equipa de contas da Mistral, enquanto a voz na web e em apps está aberta a todos. E as ferramentas que correm no navegador do utilizador não funcionam em chamadas telefónicas, por isso tudo o que um agente telefónico precisa tem de correr no seu servidor.
O que há de novo em relação ao Voxtral 2?
A versão curta: mais idiomas, diarização muito melhor, uma nova camada de agentes e pesos fechados.
O que melhorou:
- Diarização. A taxa de erro do modelo Mini no benchmark de diarização da Mistral desceu de
30,9%no Voxtral Mini Transcribe 2 para18,6%no Mini Transcribe 3. Em gravações de chamadas, saber que linhas eram do cliente é metade do valor. - Idiomas. A transcrição em lote cobre agora 50 idiomas, com a adição de idiomas asiáticos e indianos de poucos recursos.
- Context biasing. Os termos podem agora ser frases de várias palavras, e uma frase de contexto livre funciona offline.
- Funcionalidades em tempo real. Diarização, referências de falante e deteção de turnos funcionam agora em sessões em tempo real.
- Controlo de voz. A emoção passa de vozes predefinidas separadas (como
gb_jane_sad) para etiquetas inline[emotion=...], e as vozes clonadas podem ser guardadas uma vez e reutilizadas por ID.
O que quebra, segundo o guia de migração:
- Os carimbos de tempo por palavra desapareceram. Pedir a granularidade
worddevolve um erro400, por isso mude para carimbos de tempo por segmento. - As sessões em tempo real bloqueiam as suas definições no primeiro bloco de áudio, por isso envie todas as definições logo no início.
- Os segmentos diarizados podem sobrepor-se quando duas pessoas falam ao mesmo tempo.
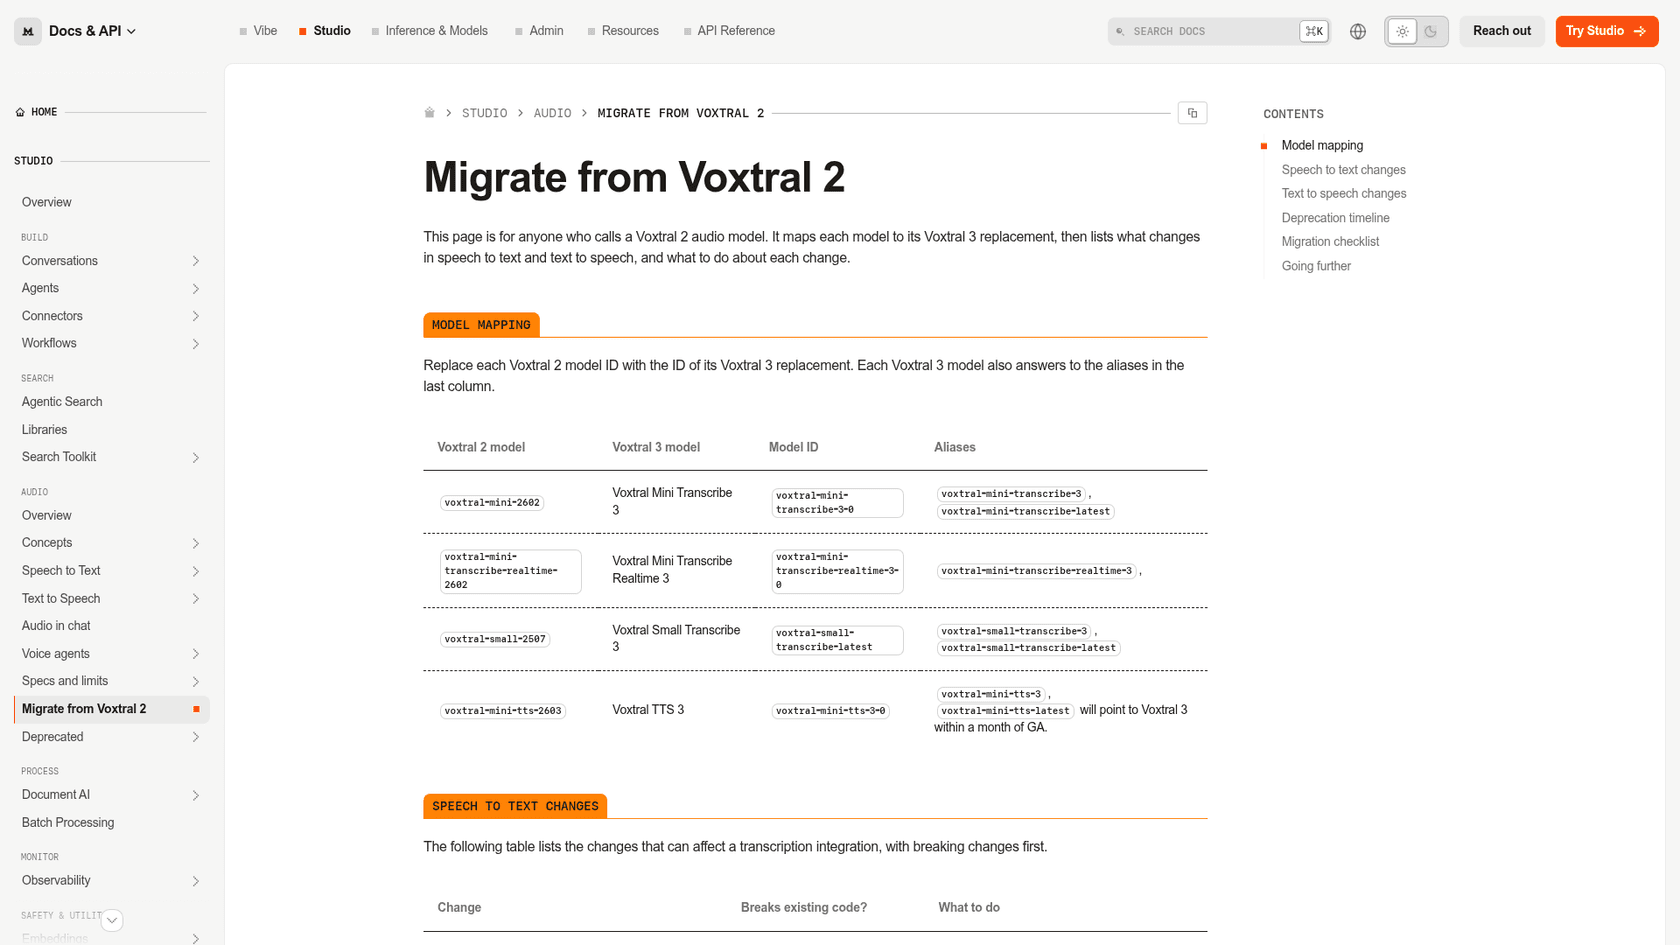
Uma funcionalidade está listada mas não foi lançada: as instruções de estilo, o controlo de texto livre do tipo "diz isto com calor", aparecem riscadas na documentação como indisponíveis no lançamento.
Porque importam os pesos fechados
Os primeiros modelos Voxtral de julho de 2025 e o modelo Voxtral Mini 4B Realtime tinham pesos abertos no Hugging Face. O Voxtral 3 não. O lançamento menciona "implantação própria", mas isso significa um contrato: as configurações on-prem e de nuvem privada passam pela equipa de vendas da Mistral.
"You have to call sales to get access for on-prem deployment and the models. If it were open weights, it would be on Huggingface and they would have put a link in the post"
Para um entusiasta que corre voz num laptop, é uma perda real. Para uma equipa de suporte enterprise, uma API alojada na UE mais on-prem por contrato é uma compra normal e, provavelmente, o caminho mais seguro para o áudio de chamadas ao abrigo da Lei de IA da UE. A Mistral continua a lançar modelos abertos noutros campos, como mostram os planos do Mistral Large 4.
Quanto custa o Voxtral 3?
O Voxtral 3 é cobrado por minuto de áudio na transcrição e no agente, e por caractere na voz. Estes são os preços de tabela de lançamento da Mistral:
| Carga de trabalho | Tarifa | 1.000 chamadas de cinco minutos |
|---|---|---|
| Transcrever gravações com o Mini | $0.0035/min | $17.50 |
| Transcrever gravações com o Small | $0.004/min | $20 |
| Transcrição ao vivo | $0.008/min | $40 |
| Agente de voz com o Mistral Small 4 | $0.04/min | $200 |
| Agente de voz com um modelo maior | $0.08/min | $400 |
O padrão é a parte útil. Transcrever todas as chamadas que já atende para garantia de qualidade custa uns trocados. Ter uma IA a atender as chamadas custa 10 a 20 vezes mais, porque o raciocínio e a fala são onde está a conta. Uma chamada de cinco minutos pela API de agente fica em US$ 0,20. É esse o valor a pôr nas suas contas de ROI do call center.
Para um detalhe de custos mais profundo dos modelos de chat por trás do agente, veja os preços da Mistral AI. Para contexto sobre pilhas de voz rivais, compare GPT Realtime e Grok Voice Think Fast 2 nas páginas dos próprios fornecedores, já que os preços de voz mudaram depressa este ano.
Que modelo do Voxtral 3 deve usar?
Escolha pela tarefa, não pelo maior modelo. Eis como eu os associaria:
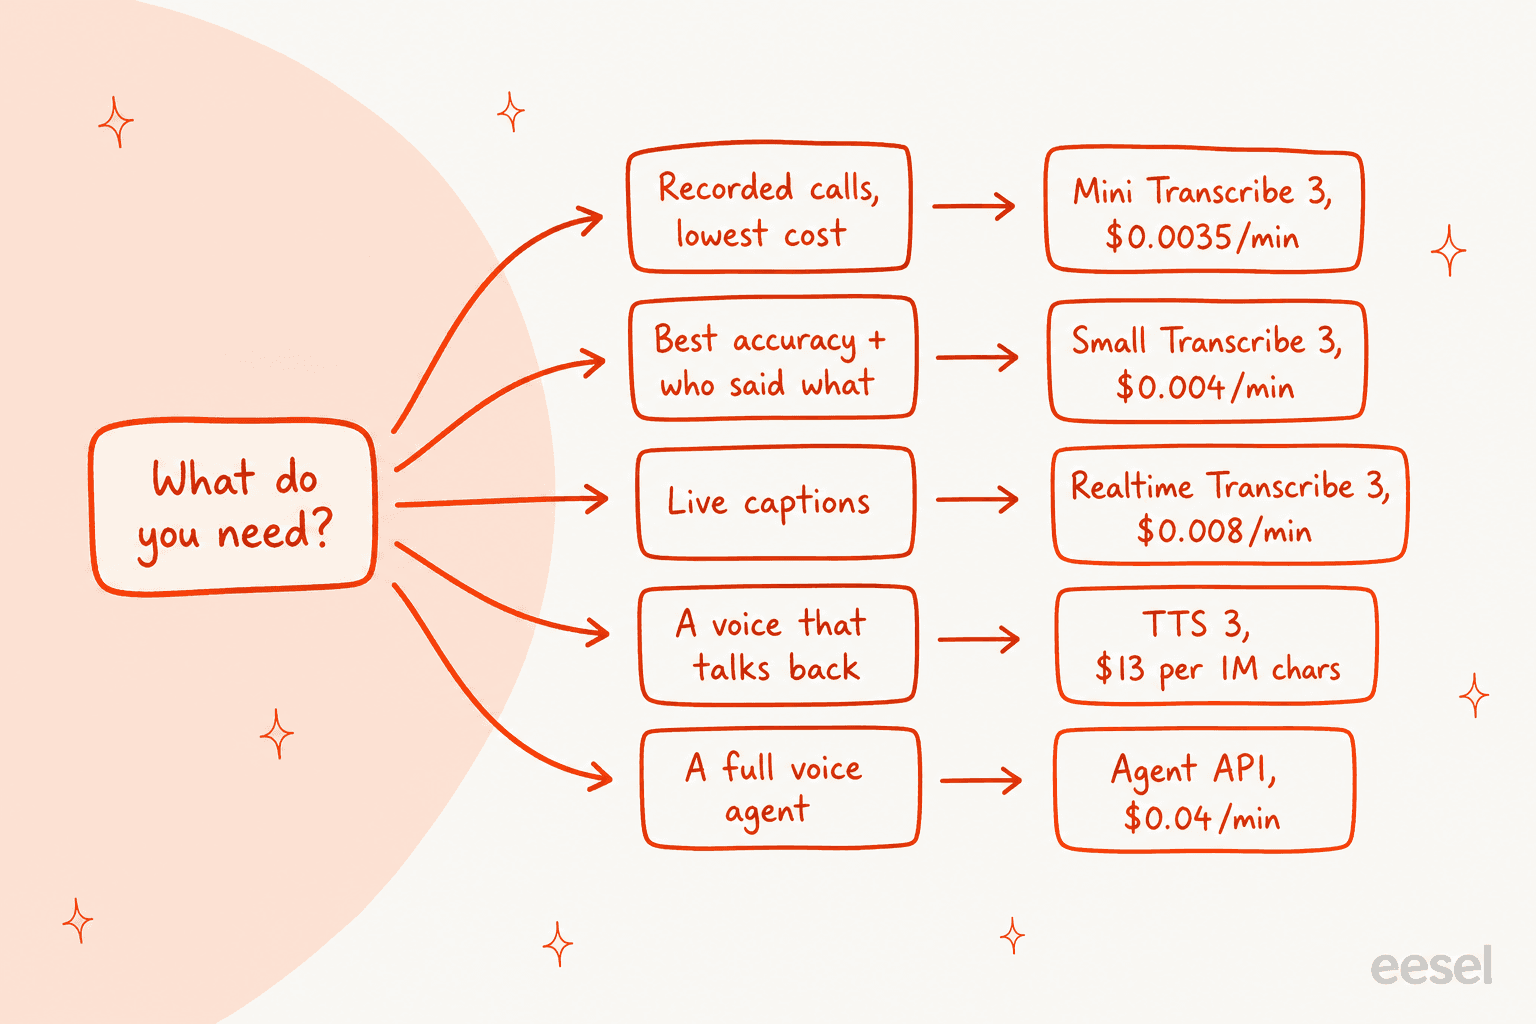
- Análise de chamadas e QA: Mini Transcribe 3. Fica a meio ponto do Small no teste da Mistral e é a linha mais barata da lista. Combine-o com redação de PII antes de as transcrições irem para algum lugar partilhado.
- Reuniões e gravações com vários falantes: Small Transcribe 3, pela melhor diarização do gráfico da Mistral.
- Um assistente de voz no navegador ou numa app: a API de agente de voz. Está bem desenhada, mas planeie em torno do estado de pré-visualização.
- Uma IA no seu número de telefone de suporte: espere, a menos que seja um cliente enterprise que consiga acesso a SIP, e reserve orçamento para a integração com o helpdesk.
- Fala local, offline: não o Voxtral 3. Veja as alternativas à Mistral ou os pesos abertos antigos do Voxtral.
Se está a comparar o Voxtral com outros modelos de voz, Gemini 3.5 Transcribe, MAI-Transcribe 2 e Cartesia Sonic 3 são os mais próximos.
Para produtos completos em vez de modelos, os meus resumos de empresas de voz com IA e da melhor IA para suporte por voz cobrem o setor.
O que o Voxtral 3 significa para equipas de suporte
O Voxtral 3 torna a parte de voz de um agente de suporte barata e boa. Não faz o agente conhecer o seu negócio. É nessa lacuna que a maioria dos projetos de voz encalha: o bot ouve perfeitamente quem liga e depois dá uma resposta confiante e errada sobre a política de reembolso.
Na eesel passámos anos a pôr agentes de IA em filas de suporte reais, e a lição repete-se em cada implantação. A precisão vem do que o agente aprende (tickets anteriores, artigos da central de ajuda, macros) e de testá-lo com conversas reais antes de falar com um cliente. É por isso que cada implantação da eesel é primeiro simulada com tickets históricos. Um microfone melhor não muda essa ordem de trabalho.
Por isso, se está a planear automação de call center, eu sequenciaria assim: automatize primeiro os canais escritos com um agente de IA para atendimento ao cliente, onde as respostas são construídas e testadas, e depois dê a esse mesmo conhecimento uma voz. O Voxtral 3 é um candidato forte para a camada de voz quando o SIP abrir.
Experimente a eesel para ter as respostas por trás da voz
O Voxtral é infraestrutura; a eesel é o funcionário. O nosso colega de IA para helpdesk junta-se ao helpdesk que já usa, como o Zendesk ou o Freshdesk, aprende com os seus tickets anteriores e responde no idioma em que o cliente escreveu.
Essa parte multilíngue é o que a lista de idiomas do Voxtral não consegue fazer sozinha. A Koffer.ch, uma loja suíça de malas, faz a eesel redigir respostas do Freshdesk em alemão, francês, inglês ou italiano, conforme o cliente, com ortografia suíça. A smava usa-a em 27.000 tickets do Zendesk em alemão por mês.
Se o seu suporte funciona hoje por e-mail e chat, comece por aí. Experimente a eesel grátis com os seus próprios tickets anteriores e veja o que teria respondido.