

Resumo
O Mistral Large 4 é o maior salto individual que já vi da Mistral: 38,4 no Artificial Analysis Intelligence Index, contra 9,3 do Large 3. Ele também é rápido, barato por token durante a promoção de preview pela metade do preço, e o único modelo de classe fronteira que conheço cujo fabricante promete hospedagem europeia e pesos abertos no mesmo mês.
Mas os números independentes o colocam no meio da tabela, não na frente. Ele fica atrás do Kimi K3 e do Qwen 3.8 Max, pontua quase o mesmo que modelos que custam um quarto por tarefa, e alucinou em 41,9 % das perguntas que errou no teste de conhecimento da Artificial Analysis. Os gráficos de lançamento da Mistral destacam testes de segurança cibernética e jurídicos, e essas vitórias parecem reais, mas restritas.
Meu veredito: escolha se você precisa de um provedor da UE ou de trabalho de segurança sem recusas. Pule se você só quer a melhor resposta por dólar. E se você pensa em colocá-lo diante de clientes, a escolha do modelo importa menos que as proteções ao redor, que é o trabalho que o colega de helpdesk com IA da eesel já faz no Zendesk, Freshdesk e Gorgias.
O que é o Mistral Large 4?
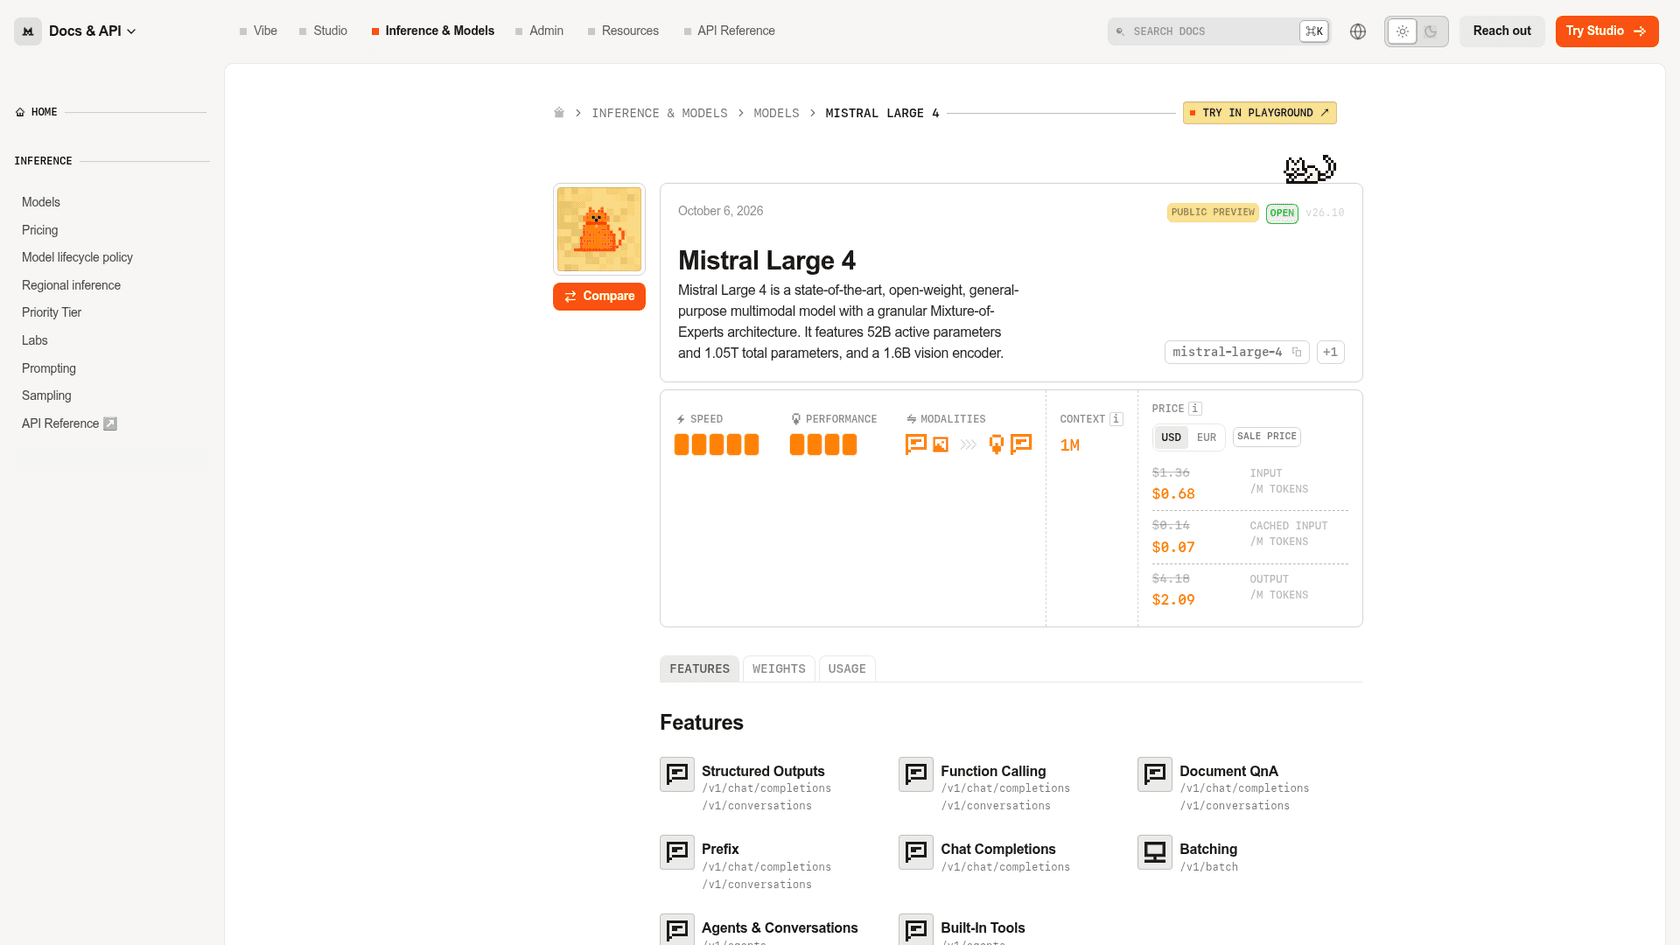
O Mistral Large 4 é o novo carro-chefe da Mistral, lançado em 6 de outubro de 2026 como preview pública e apelidado de "Le Chonk". Segundo seu model card, é um LLM de mistura de especialistas com 1,05 trilhão de parâmetros no total, 52 bilhões ativos por token, um codificador de visão de 1,6 bilhão e uma janela de contexto de 1 milhão de tokens. É um modelo híbrido: você pode pedir que ele raciocine primeiro com o ajuste reasoning_effort, ou que responda direto.
Uma observação rápida sobre meu ponto de partida. Eu escrevo e cuido do SEO do blog da eesel, e quem busca "análise do Mistral Large 4" raramente tem curiosidade sobre contagem de parâmetros. A dúvida é mais estreita: é bom o bastante para trocar, e para quê? É essa a pergunta que esta análise responde. Para a ficha técnica completa, veja minha visão geral do Mistral Large 4, e para todas as faixas de preço, meu detalhamento dos preços do Mistral Large 4.
Eu mesmo não rodei o modelo, então minhas opiniões se apoiam em quem rodou: os testes independentes da Artificial Analysis, a documentação da própria Mistral e os relatos práticos no Hacker News, Reddit e X nos primeiros três dias.
Análise do Mistral Large 4 num relance
Aqui está a versão curta, antes do detalhe.
| O que verifiquei | Resultado | Fonte |
|---|---|---|
| Inteligência geral | 38,4 no AA Intelligence Index (mediana da sua faixa de preço: 26) | Artificial Analysis |
| Salto sobre o Large 3 | 9,3 para 38,4, cerca de 4,1x | AA: Large 3 |
| Posição entre rivais próximos | Atrás do Kimi K3 (43,6) e do Qwen 3.8 Max (45,4) | AA |
| Preço (promoção de preview) | US$ 0,68 entrada / US$ 2,09 saída por 1 M de tokens | Preços da Mistral |
| Custo por tarefa da AA | US$ 1,13 na tabela, cerca de US$ 0,57 na promoção | Artificial Analysis |
| Taxa de alucinação | 41,9 % no AA-Omniscience | Artificial Analysis |
| Velocidade de saída | 116,1 tokens/s; ~18,7 s até o primeiro token da resposta | Artificial Analysis |
| Verbosidade | 200 M de tokens para rodar o índice vs 81 M de mediana | Artificial Analysis |
| Pesos abertos | Prometidos para o fim de outubro de 2026, ainda não lançados | Mistral |
| Melhor em | Tarefas de segurança cibernética sem recusas, agentes jurídicos, ancoragem visual | Gráficos de lançamento da Mistral |
O que a Mistral realmente corrigiu?
A manchete honesta é que a Mistral voltou à corrida. Em dezembro passado, o Mistral Large 3 marcou 9,3 no mesmo índice, longe da fronteira. O Large 4 marca 38,4. É a diferença entre um modelo para resumos baratos e um em que você poderia rodar um agente de IA.
A equipe da Plotly o passou pelo benchmark de análise de dados no dia do lançamento e viu o mesmo salto por outro ângulo:
"É 10x mais barato que o Mistral Medium 3.5 de abril e vai de 58 % para 74 % de acertos. Definitivamente uma mudança de geração."

O porém é de onde veio esse salto. O Large 4 é um modelo de raciocínio e o Large 3 não era, então boa parte do ganho foi comprada com tokens de raciocínio.
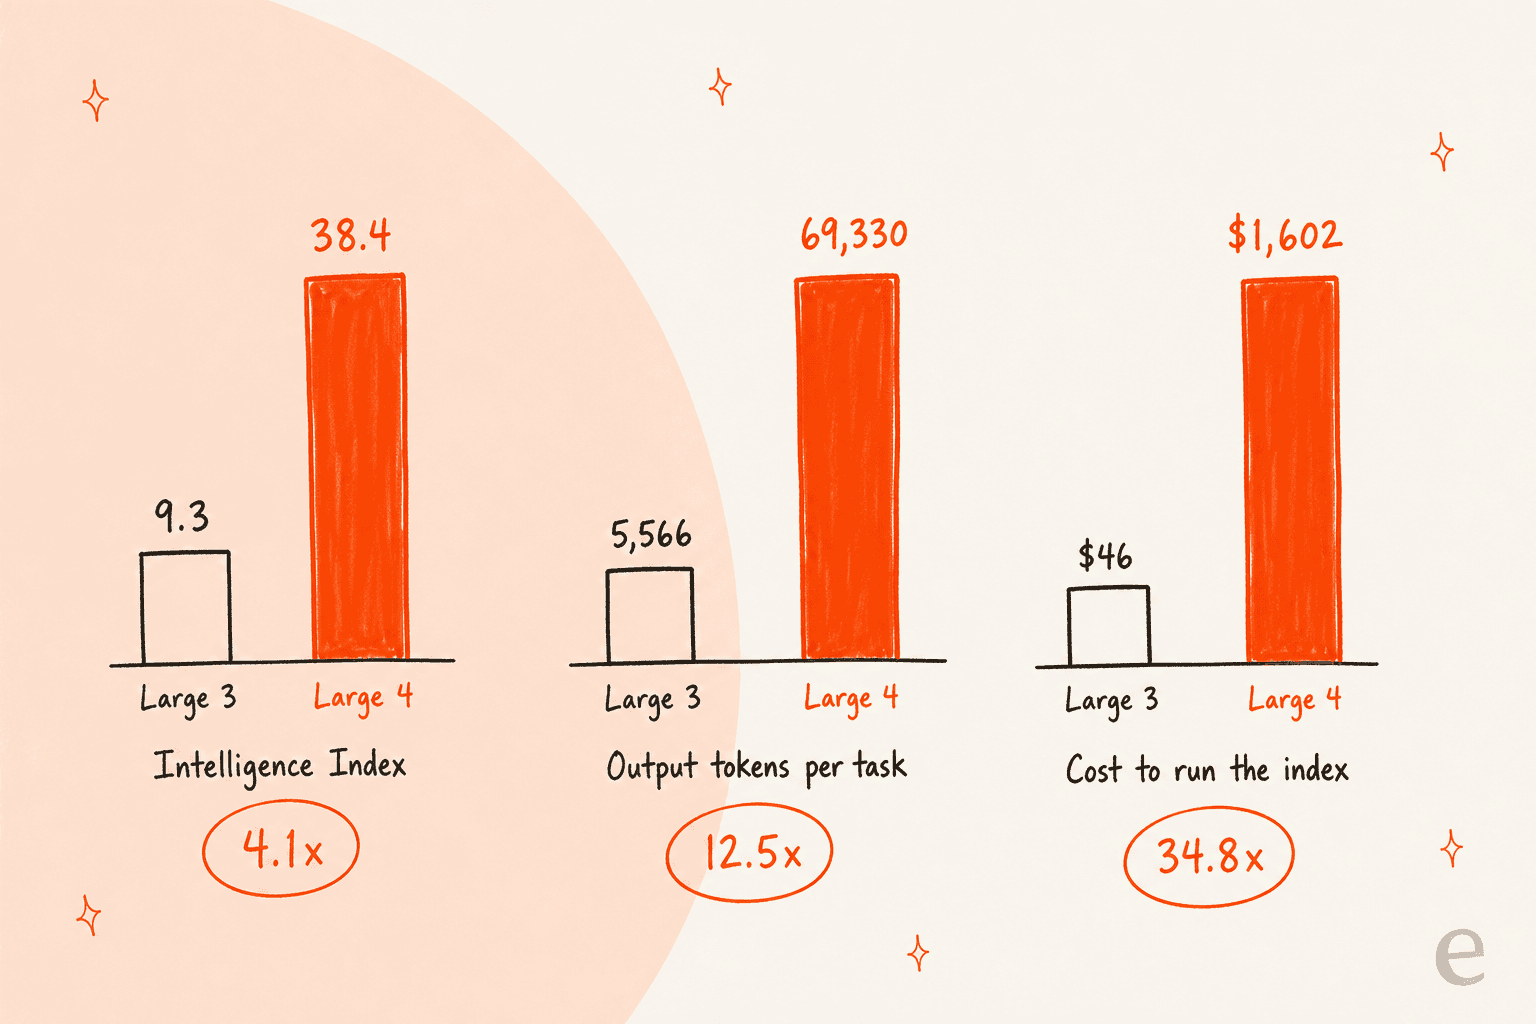
A nota subiu cerca de 4,1x. Os tokens que ele escreve por tarefa subiram 12,5x, e o custo de rodar o índice completo a preço de tabela subiu 34,8x, de US$ 46 para US$ 1.602, segundo a Artificial Analysis. Isso não é crítica ao modelo; todo laboratório pagou o mesmo pedágio pelo raciocínio. Mas significa que o preço por token é um mau guia do que o Large 4 vai custar a você. A Artificial Analysis o chama de "muito verboso": 200 M de tokens para concluir o índice contra uma mediana de 81 M.
Como o Mistral Large 4 se compara em benchmarks independentes
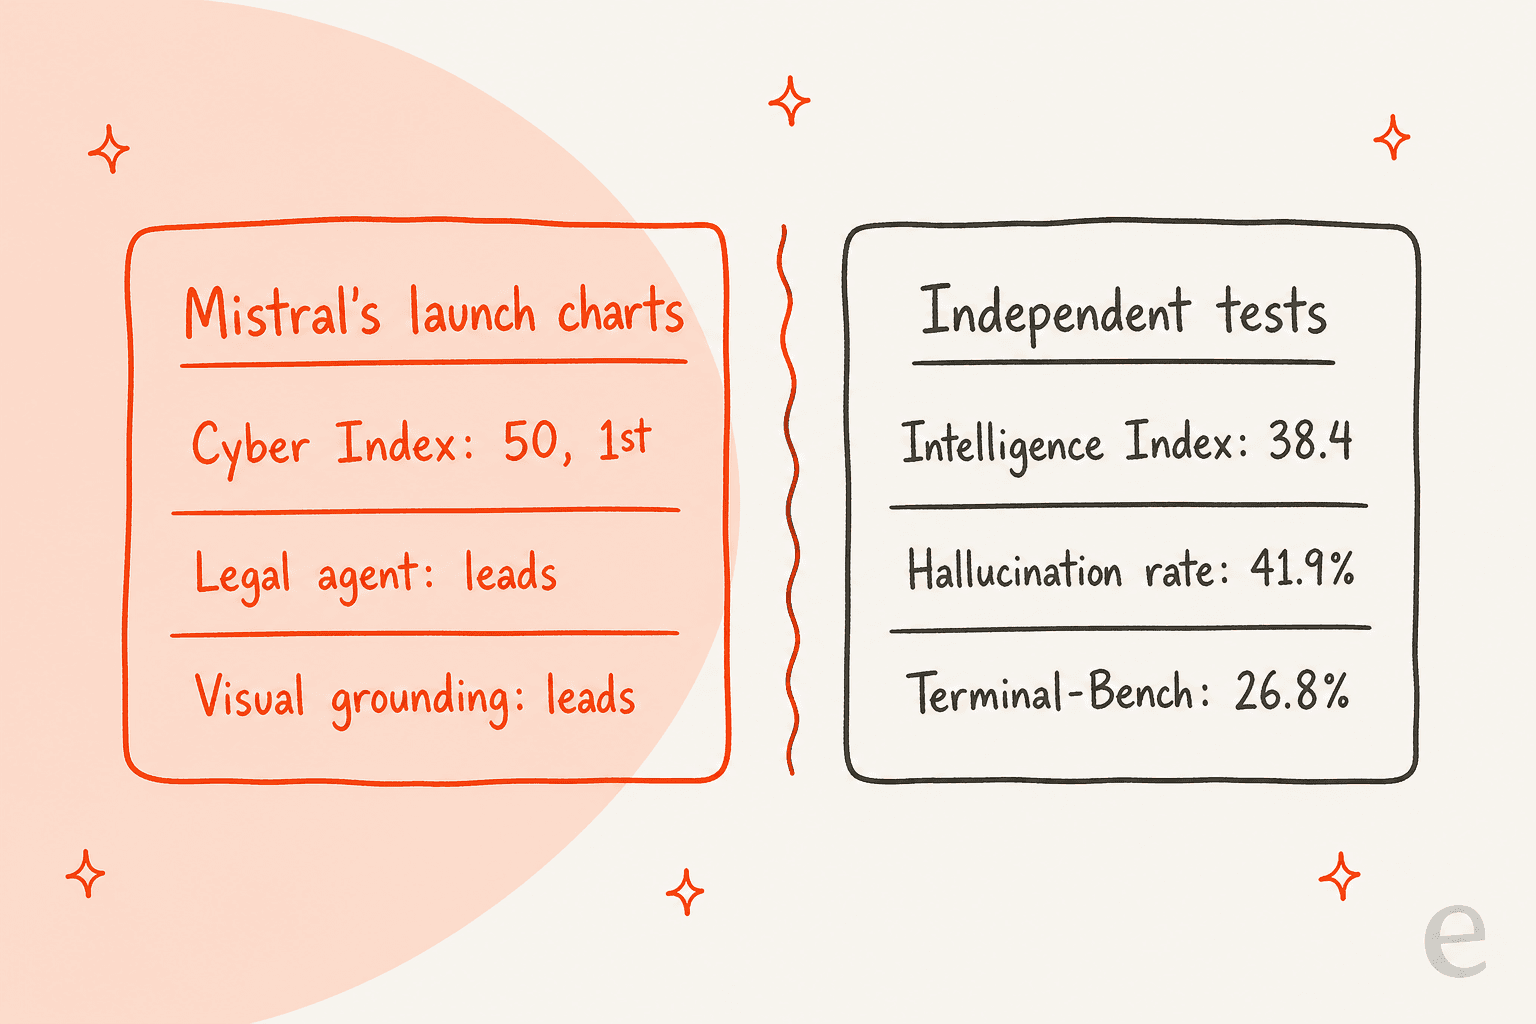
Aqui a análise fica menos lisonjeira. O post de lançamento da Mistral está cheio de gráficos, e a maioria mostra o Large 4 vencendo. O quadro independente é mais misto.
No índice v4.3.2 da Artificial Analysis, que combina 10 avaliações, veja onde o Large 4 fica entre os modelos com que é comparado:
| Modelo | Índice AA | Preço entrada / saída por 1 M (tabela) | Custo por tarefa da AA | Velocidade de saída |
|---|---|---|---|---|
| Claude Sonnet 5.5 (Xhigh) | 51,9 | US$ 2 / US$ 10 | US$ 2,01 | 100,7 t/s |
| Qwen 3.8 Max | 45,4 | US$ 2 / US$ 6 | US$ 5,41 | 37,6 t/s |
| Kimi K3 | 43,6 | US$ 3 / US$ 15 | US$ 2,00 | 41,7 t/s |
| Gemini 3.8 Flash | 40,9 | US$ 0,75 / US$ 3,75 | US$ 1,24 | 125,2 t/s |
| DeepSeek V4.1 Flash | 39,5 | US$ 0,30 / US$ 1,20 | US$ 0,27 | 216,1 t/s |
| Mistral Large 4 Preview | 38,4 | US$ 1,36 / US$ 4,18 | US$ 1,13 | 116,1 t/s |
| GPT-5.6 Luna | 37,3 | US$ 0,20 / US$ 1,20 | US$ 0,18 | 117,0 t/s |
Todos os números vêm das páginas de modelos da Artificial Analysis, consultadas em 8 de outubro de 2026. O custo por tarefa do Large 4 cai aproximadamente pela metade ao preço promocional atual.
Duas coisas chamam a atenção. Primeiro, o Large 4 é mais barato por tarefa que todos os modelos acima dele e transmite mais rápido que o Kimi K3 e o Qwen 3.8 Max. Segundo, DeepSeek V4.1 Flash e GPT-5.6 Luna ficam a cerca de um ponto e custam uma fração por tarefa, mesmo depois da promoção de 50 % da Mistral. Se o seu trabalho é "respostas razoáveis, muitas", esses dois são a concorrência mais dura.
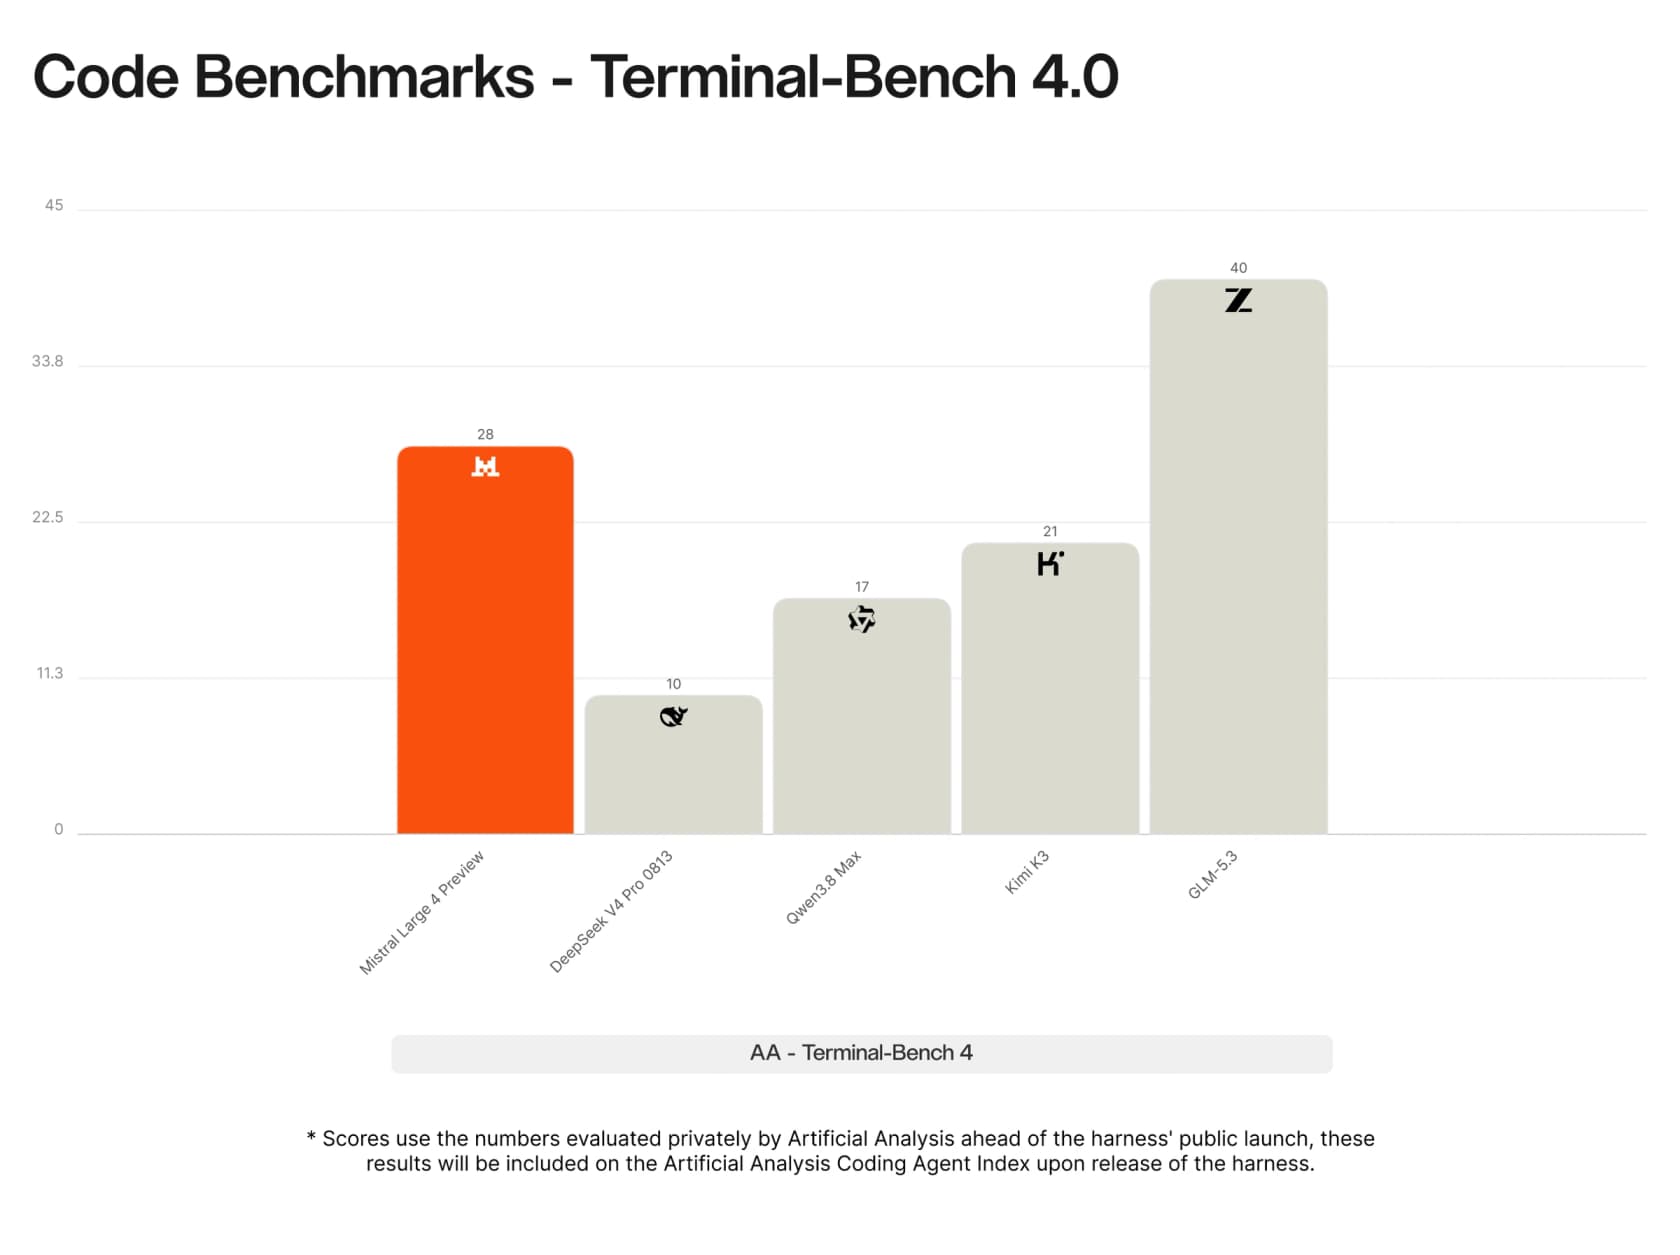
O gráfico do Terminal-Bench 4.0 da própria Mistral é um bom exemplo de como o enquadramento importa. Ele mostra o Large 4 em 28, à frente do Qwen 3.8 Max e do Kimi K3, mas bem atrás do GLM-5.3, com 40.
Alguns leitores do Hacker News foram mais diretos sobre a escolha dos gráficos. Um comentarista conferiu um gráfico multimodal com os números públicos da Artificial Analysis e encontrou uma diferença:
"Não conheço esse benchmark, mas a lista GDP.pdf da AA tem o Sol 5.6 Max em 27, até sem raciocínio supera os 12,8. É estranhíssimo escolher a dedo o Sol 5.6 e ainda mentir sobre a nota publicada do benchmark de terceiros."
Eu não chegaria a dizer "mentir". Versões e configurações de benchmark diferem, e os gráficos da Mistral podem usar outra execução. Mas é um bom motivo para ler os gráficos de fornecedores como o melhor cenário e tratar a página da Artificial Analysis como linha de base.
Onde o Mistral Large 4 é realmente forte
Estar no meio da tabela no geral não significa estar no meio em tudo. Três áreas resistem ao escrutínio.
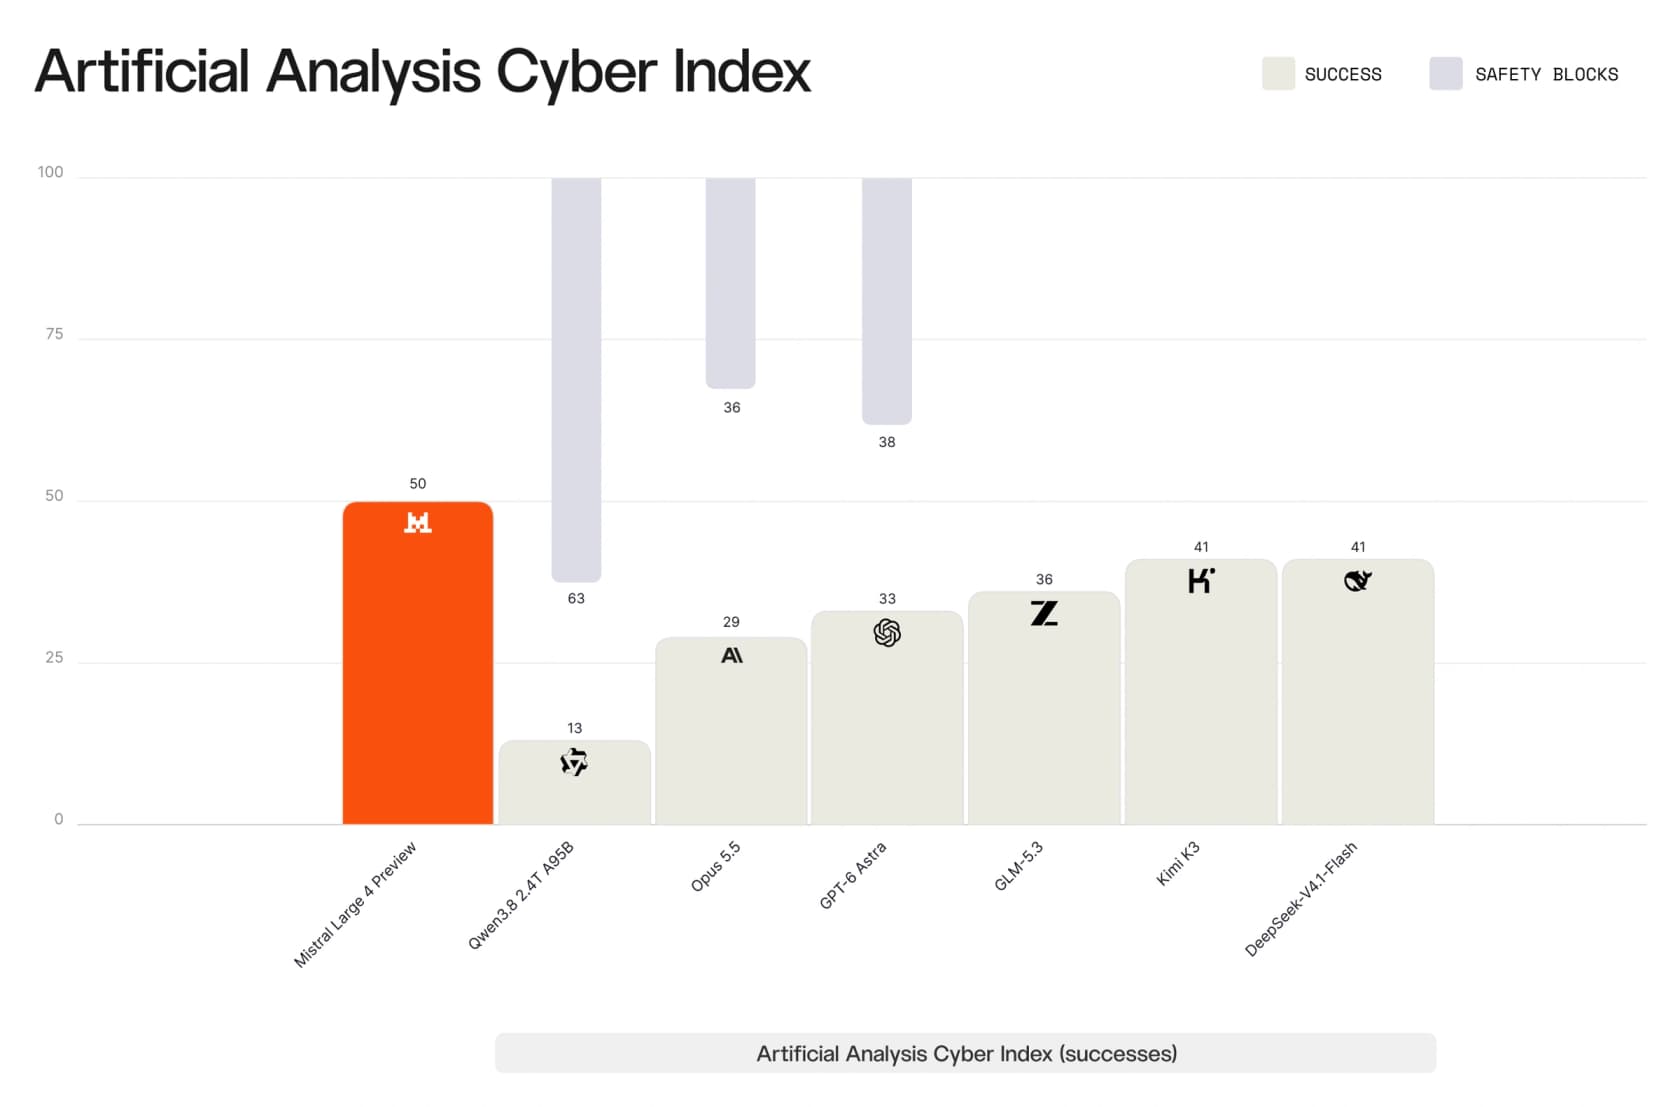
Trabalho de segurança sem recusas. No Cyber Index da Artificial Analysis, como exibido pela Mistral, o Large 4 marca 50, à frente do Kimi K3 e do DeepSeek V4.1 Flash com 41. A parte mais interessante do gráfico são as barras cinzas: outros modelos de fronteira tiveram grande parte das tentativas barradas por bloqueios de segurança.
O cofundador da Mistral Guillaume Lample defendeu exatamente esse ângulo no dia do lançamento, dizendo que modelos abertos "não se recusam a ajudar". Se você lidera um time de segurança e seu modelo atual vive recusando examinar código de exploit no seu próprio stack, é um motivo real para testar o Large 4.
Trabalho jurídico e com documentos. O gráfico da Mistral da Vals.ai mostra o Large 4 liderando o benchmark de agente jurídico da Harvey, e a Artificial Analysis dá a ele 81,3 % no AA-LCR, seu teste de raciocínio de contexto longo. Contratos longos combinam bem com uma janela de 1 M de tokens.
Velocidade depois que começa a falar. Com 116,1 tokens por segundo na API da Mistral, ele transmite bem mais rápido que o Kimi K3 e o Qwen 3.8 Max. Um dos primeiros testadores no Hacker News gostou dele como uso diário por esse motivo:
"É muito rápido via OpenRouter (bem melhor que o Kimi K3) no webui. Muito verboso e parece começar a esquecer instruções depois de um tempo, mas me deu bastante informação boa durante meia hora de conversa sobre C e programação embarcada."
Repare no meio dessa citação. "Começa a esquecer instruções" importa muito mais em produção do que numa janela de chat.
Onde o Mistral Large 4 fica a desejar
Os pontos fracos são igualmente específicos.
Recordação factual e alucinação. Este é o número que eu marcaria em vermelho se estivesse avaliando para qualquer uso voltado ao cliente. No AA-Omniscience, que faz perguntas de conhecimento e premia o modelo por dizer "não sei" em vez de chutar, o Large 4 acertou 25,8 % e teve uma taxa de alucinação de 41,9 %, para uma nota geral de -5,3, segundo a Artificial Analysis. Um testador do Hacker News viu o mesmo em um jogo de adivinhação:
"O Mistral Large 4 não é muito bom. Às vezes resolve um jogo com ~40 palpites, enquanto os melhores modelos como Gemini 3.8 Flash ou Grok 4.7 resolvem a maioria dos enigmas de primeira. Meu benchmark está alinhado com o AA Omniscience."
Tempo até a primeira resposta. É um modelo de raciocínio, então pensa antes de falar. A Artificial Analysis mediu cerca de 18,7 segundos até o primeiro token da resposta em um prompt longo e 28,4 segundos com 100 mil tokens. Serve para um agente de back-office e é doloroso para um widget de chat ao vivo.
Programação agêntica. Ele fica atrás do GLM-5.3 no Terminal-Bench e marcou 26,8 % na execução própria da Artificial Analysis. Alguns relatos práticos foram ainda mais duros:
"Brinquei um pouco com ele, para análise de código, classificação de imagens e capacidade em xadrez. Parece bem datado e muito atrás do que costumo usar."

Para ser justo com a Mistral, isto é uma preview. Lample disse no X que a rodada de aprendizado por reforço "ainda está em andamento", e uma versão final está prevista junto com os pesos. As notas podem mudar antes do fim de outubro.
"Pesos abertos" é um motivo para escolhê-lo hoje?
Ainda não. O model card traz um selo "Open", mas o campo de licença está vazio e, em 9 de outubro, a página da Mistral no Hugging Face não tem repositório do Large 4. A Artificial Analysis o lista como proprietário até os pesos chegarem.
Mesmo quando saírem, um modelo de 1,05 trilhão de parâmetros não é algo que a maioria das equipes rode numa GPU sobrando. A resposta mais curtida ao tuíte de lançamento da Mistral disse isso melhor:
"eu com 12 GB de VRAM lendo 'pesos abertos, 1,05T de parâmetros'"
O valor prático dos pesos abertos aqui é para grandes empresas e governos que queiram hospedar um modelo capaz em hardware próprio na Europa. Para todos os outros, é a API, e a API é uma preview com aviso de descontinuação de um mês, não os seis meses que um modelo em disponibilidade geral recebe. Construir um fluxo de produção sobre uma preview é aceitar que ele pode mudar com quatro semanas de aviso.
Quem deve usar o Mistral Large 4?
Depois de tudo isso, minha resposta se resume a duas perguntas: seus dados precisam ficar na Europa (ou nos seus próprios servidores), e a precisão bruta é o que mais importa no seu caso de uso?
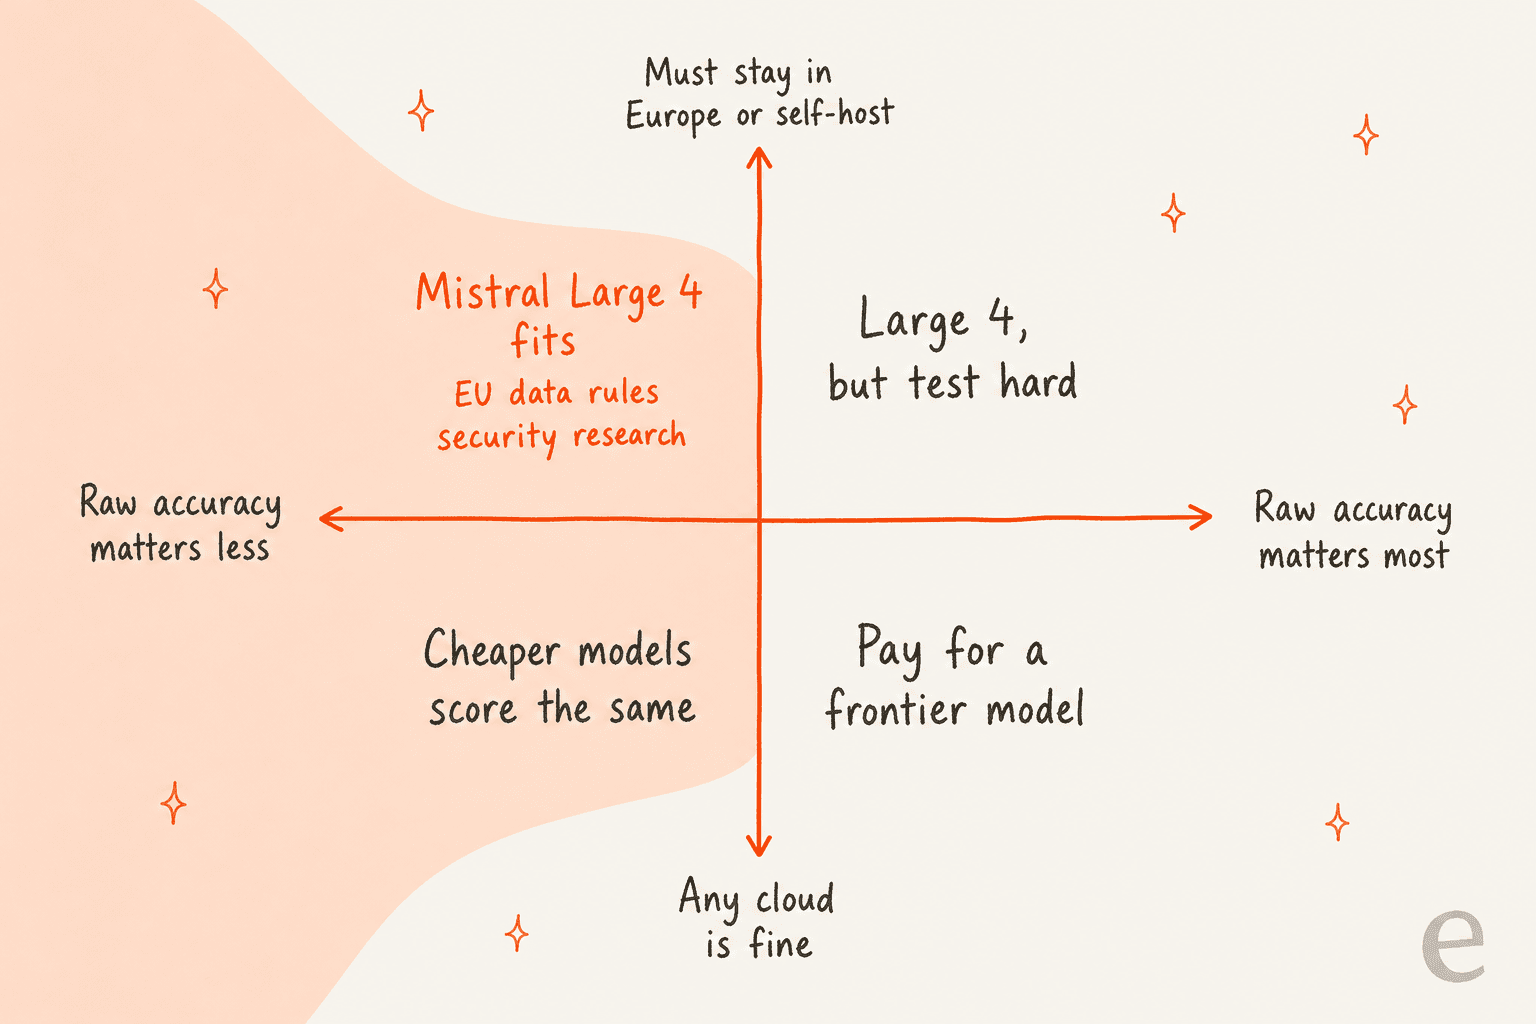
O ponto da soberania é real, e muitos comentaristas disseram isso com clareza:
"Na maioria dos fluxos corporativos provavelmente é bom o bastante. E você não precisa vender a alma para o Xi ou para o Trump. Como europeu, eu temia coisa muito pior."
Experimente o teste de adequação abaixo para ver onde seu caso de uso se encaixa.
O que mais importa para a sua carga de trabalho?
Escolha uma opção para ver minha avaliação.
O que isso significa se você lidera uma equipe de suporte
Muita gente que lê análises de modelos agora está se perguntando se um modelo europeu mais barato poderia alimentar seu bot. Eu entendo. Mas o número de alucinação é aquele sobre o qual eu pensaria com calma.
Já vi o que acontece quando um bot de suporte responde pela memória do modelo em vez dos seus documentos. No começo deste ano, alguns clientes pagantes da eesel tinham um bot que, quando a busca na base de conhecimento voltava vazia, preenchia a lacuna com seus dados de treinamento em vez de encaminhar. Um enviou detalhes de assinatura inventados a clientes reais. Outro respondeu uma pergunta de suporte com "Oxigênio", o elemento da tabela periódica. Foi um problema de plano alternativo, não de modelo, e um modelo maior não teria resolvido. É por isso que toda implantação da eesel agora é simulada com tickets passados antes de tocar em um cliente.
Uma líder de CX de uma marca de suplementos, que lida com cerca de 7.000 tickets, descreveu o requisito real melhor que qualquer benchmark:
"Preciso de uma IA que só trate os tickets que tem confiança de tratar e deixe todos os outros em paz."
Isso é primeiro um problema de roteamento e de pontuação de confiança e só depois um problema de modelo. Um modelo com 41,9 % de alucinação torna essa camada mais importante, não menos. Se você construir o seu em cima do Large 4, meus guias sobre RAG para suporte, como impedir alucinações e o melhor LLM para suporte são um bom ponto de partida. E se o seu motivo para a Mistral são as regras de dados da UE, verifique primeiro o que SOC 2 e GDPR realmente exigem do fornecedor; o país de origem do modelo é apenas uma parte.
Alternativas ao Mistral Large 4 que vale testar
Se a análise o deixou hesitante, é aqui que eu olharia, conforme o que você precisa:
| Você quer | Veja | Por quê |
|---|---|---|
| Mais precisão, ainda acessível | Sonnet 5.5 ou Kimi K3 | 51,9 e 43,6 no índice AA |
| Mesma nota, custo menor | Família DeepSeek V4 Flash, GPT-5.6 Luna | 39,5 e 37,3 a US$ 0,18 a US$ 0,27 por tarefa |
| Pesos abertos que você pode rodar hoje | DeepSeek V4.1 Flash, GLM-5.3 | Ambos listados como open-weight ao lado do Large 4 nesta comparação da AA |
| Uma Mistral mais barata | Large 3 ou Small 4 (veja preços da Mistral AI) | US$ 0,50/US$ 1,50 e US$ 0,15/US$ 0,60 por 1 M |
Para uma lista maior, meu levantamento de alternativas à Mistral e os comparativos Claude vs Mistral e ChatGPT vs Mistral vão mais a fundo.
O veredito
O Mistral Large 4 é um retorno real de um laboratório que parecia ter estagnado. O salto de nota é real, o preço é justo enquanto a promoção durar, e a velocidade é boa. Se você precisa de um provedor europeu ou de um modelo que de fato ajude em trabalho de segurança, é o que eu testaria primeiro.
Para todos os outros, os números ainda não justificam a troca. Ele fica quase no mesmo nível de modelos que custam um quarto por tarefa, alucina mais do que eu aceitaria para trabalho voltado ao cliente, e a versão que você testa hoje é uma preview que pode mudar com um mês de aviso. Eu voltaria a olhar depois da versão final e dos pesos no fim de outubro, e então decidiria.
Experimente a eesel
Se você chegou aqui porque está escolhendo um modelo para um bot de suporte, eis o atalho: o modelo é infraestrutura, e a eesel é o funcionário. O colega de helpdesk com IA da eesel se conecta ao Zendesk, Freshdesk ou Gorgias, aprende com seus tickets passados e sua central de ajuda, e roda uma simulação sobre centenas dos seus tickets reais para você ver as respostas antes de um cliente. Escolha do modelo, ancoragem e o plano alternativo "não sei, vou passar para uma pessoa" são resolvidos para você, e você paga por ticket tratado, então um modelo verboso nunca aparece na sua fatura. Os planos começam grátis na página de preços.

Experimente a eesel e reproduza seu último mês de tickets antes de decidir qualquer coisa.