

A melhor alternativa ao Voxtral 3 depende de qual parte você está substituindo. Para um agente telefônico em um número real hoje, o GPT-Live-1 da OpenAI a $0.05 o minuto ou o ElevenAgents a $0.08 mais o LLM, porque o Voxtral 3 mantém as chamadas SIP só para enterprise no lançamento. Para transcrição barata de ligações gravadas, o Speechmatics lista $0.12 a hora. Para a voz, Cartesia Sonic.
O que me surpreendeu depois de precificar as sete: o Voxtral 3 continua sendo o agente telefônico agrupado mais barato daqui, a $0.04 o minuto com o Mistral Small 4. As pessoas saem dele por acesso, pesos abertos ou precisão ao vivo, não por preço. Sua transcrição ao vivo está, na verdade, no meio da tabela em custo, a $0.48 a hora.
Trabalho na fila de suporte da eesel todo dia, e a camada de fala nunca é o que decide se quem liga recebe a resposta certa. A operadora de balsas Norden-Frisia planeja 10,000 interações por mês na alta temporada, respondidas a partir de 346 itens de conhecimento. Seja qual for o modelo que ouve quem liga, algo ainda precisa saber sobre o que a pessoa está perguntando.
Por que as pessoas procuram uma alternativa ao Voxtral 3?
Principalmente pelo que o Voxtral 3 ainda não deixa você fazer, não porque seja ruim. Dei a ele 3.5 de 5 na minha análise do Voxtral 3, e os motivos pelos quais perdeu pontos são os mesmos pelos quais as pessoas saem em busca de outras opções.
Primeiro, o mérito. Nos gráficos de lançamento da Mistral, o Voxtral Small Transcribe 3 empata com o Microsoft AI Transcribe 2 em uma taxa de erro de palavras de 4.0% em 45 idiomas, e custa $0.004 o minuto. A voz custa $13 por 1M de caracteres. A API de agentes de voz custa $0.04 o minuto com o Mistral Small 4. É um lançamento forte.
Mesmo assim, quatro coisas fazem as pessoas procurar:
- As linhas telefônicas são restritas. A telefonia SIP é só para enterprise no lançamento. Se você quer um bot no seu número de suporte este mês, precisa da camada telefônica de outra empresa.
- Os pesos são fechados. O Voxtral 1 e o modelo em tempo real do Voxtral 2 foram lançados no Hugging Face. O Voxtral 3 é só por API, com implantação on-premises combinada com vendas.
- A precisão ao vivo fica atrás do Gemini. No gráfico em tempo real de 35 idiomas da própria Mistral, o Gemini 3.5 Realtime marca
4.2%e supera todas as configurações de latência do Voxtral. Na configuração de 240 ms que um agente telefônico ágil usaria, o Voxtral fica em7.4%. - Tudo é prévia pública, e a atualização do Voxtral 2 removeu os carimbos de tempo por palavra. Equipes com um fluxo funcionando têm motivo para olhar ao redor antes de migrar.
Os pesos fechados receberam a maior parte das críticas no tópico de lançamento do Hacker News:
"You have to call sales to get access for on-prem deployment and the models If it were open weights, it would be on Huggingface and they would have put a link in the post"

Como escolhi estas sete
Fiz ao ChatGPT a pergunta que uma líder de suporte faria («estamos testando o Voxtral 3 para transcrição, voz e um agente telefônico, com o que devemos compará-lo?») e ele pré-selecionou estas sete. Bateu com o que eu teria escolhido, então fui à página de preços e à documentação de cada fornecedor em 28 de outubro de 2026 e precifiquei todas do mesmo jeito.
Cada uma é avaliada em quatro pontos que importam para uma linha de suporte:
- Ela atende um número de telefone hoje, de forma nativa ou por meio de um parceiro nomeado?
- Quanto custa um minuto, com a unidade de cobrança explicada?
- O que o fornecedor afirma sobre latência e precisão, com os números dele?
- Onde o Voxtral 3 ainda é a melhor escolha?
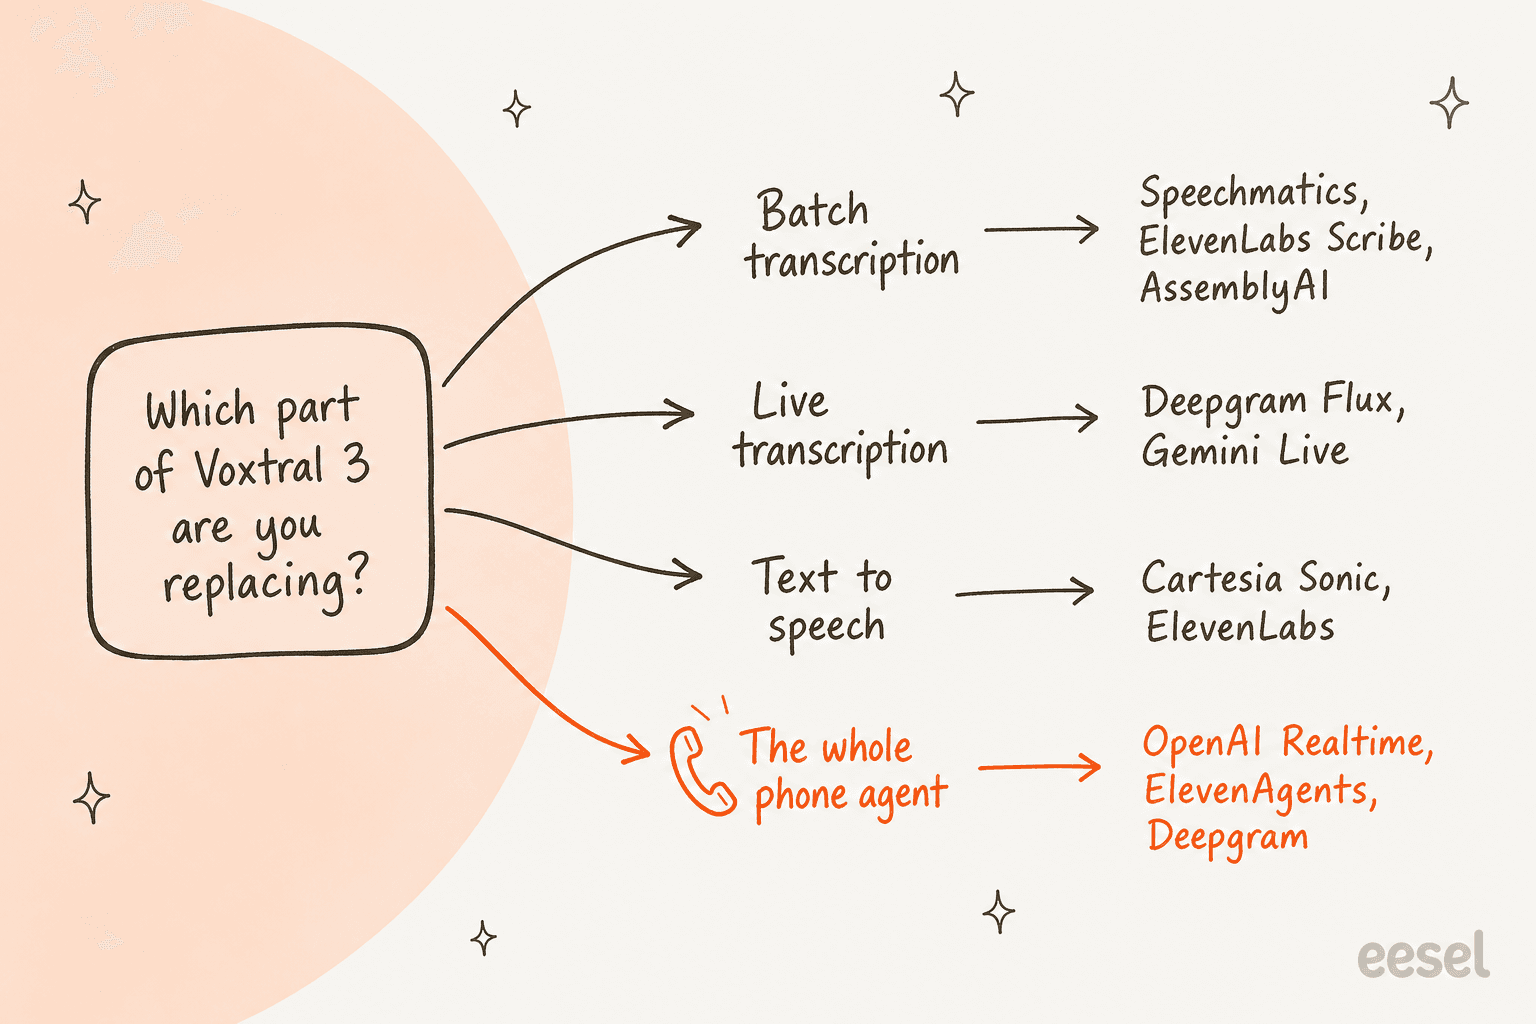
O mapa de decisão é a conclusão de verdade. O Voxtral 3 são quatro produtos em um só lançamento, e ninguém o supera nos quatro. Descubra qual peça está falhando com você e substitua só essa.
Alternativas ao Voxtral 3 comparadas
Os preços são preços de tabela da página de cada fornecedor, convertidos para a mesma unidade quando o fornecedor deu um valor por minuto. «Not published» significa que o fornecedor não lista um preço, não que seja grátis.
| Ferramenta | Transcrição em lote | Transcrição ao vivo | Voz (por 1M de caracteres) | Agente telefônico (por minuto) | Linha telefônica | Auto-hospedagem | Conformidade listada |
|---|---|---|---|---|---|---|---|
| Voxtral 3 | $0.21-$0.24/hr | $0.48/hr | $13 | $0.04 (Small 4) ou $0.08 | SIP só enterprise no lançamento | On-prem via vendas | Não consta nas páginas de lançamento |
| OpenAI | $0.27/hr (GPT-Transcribe) | $1.02/hr (GPT-Live-Transcribe) | Sem preço atual, modelos TTS são aposentados em jan. 2027 | $0.05 + modelo de backend (GPT-Live-1) | SIP nativo | Não | HIPAA BAA, residência na UE +10% |
~$0.30/hr (Gemini 3.5 Transcribe) | ~$0.54/hr (Transcribe Live) | $30 (Chirp 3: HD) | ~$0.023 áudio entrada + saída (Gemini 3.8 Live) | Parceiros (Voximplant, LiveKit) | Não | Chirp 3 em regiões dos EUA e da UE | |
| Deepgram | $0.26/hr (Nova-3) | $0.39/hr (Flux English) | $30 (Aura-2) | $0.075 (Standard) | Montagem de referência com Twilio | Enterprise, GPUs NVIDIA | SOC 2 Type 2, HIPAA BAA, endpoint UE do GDPR |
| ElevenLabs | $0.22/hr (Scribe v2) | $0.39/hr (Scribe v2 Realtime) | $40 (v4 Turbo) | $0.08 + LLM | Tronco SIP nativo, Twilio | Não | SOC 2, HIPAA BAA, residência na UE no Enterprise |
| Cartesia | Só streaming | $0.39/hr (Ink-2, plano Scale) | $38-$65 de excedente | $0.06 + $0.014 o número | Números próprios, SIP no enterprise | Enterprise, on-prem ou VPC | SOC 2 Type II, apto a HIPAA, GDPR |
| AssemblyAI | $0.21/hr (Universal-3.5 Pro) | $0.45/hr (Universal-3.6 Pro Realtime) | $15 | Not published | Tronco SIP da Twilio | Opção auto-hospedada | SOC 2 Type 2, BAA |
| Speechmatics | $0.12/hr (Melia 1) | $0.30/hr (Linden 1, agentes) | $11 (inglês, prévia) | Not published | Parceiros (Vapi, LiveKit, Pipecat) | Contêineres enterprise | SOC 2 Type II, ISO 27001, GDPR, HIPAA |
Duas coisas saltam aos olhos na tabela. O preço em lote do Voxtral 3 é bom, mas não o mais baixo, e sua transcrição ao vivo fica no meio da tabela. A voz e o agente agrupado são onde é difícil superá-lo.
Quanto custa uma linha telefônica de suporte em cada uma?
Para comparar preços por minuto, por token e por caractere, precifiquei um comprador: 10,000 ligações de cinco minutos por mês, ou seja, 50,000 minutos. As tarifas de operadora telefônica ficam de fora, a menos que o fornecedor venda o próprio número.
| Opção | A conta | Custo mensal | O que não está incluído |
|---|---|---|---|
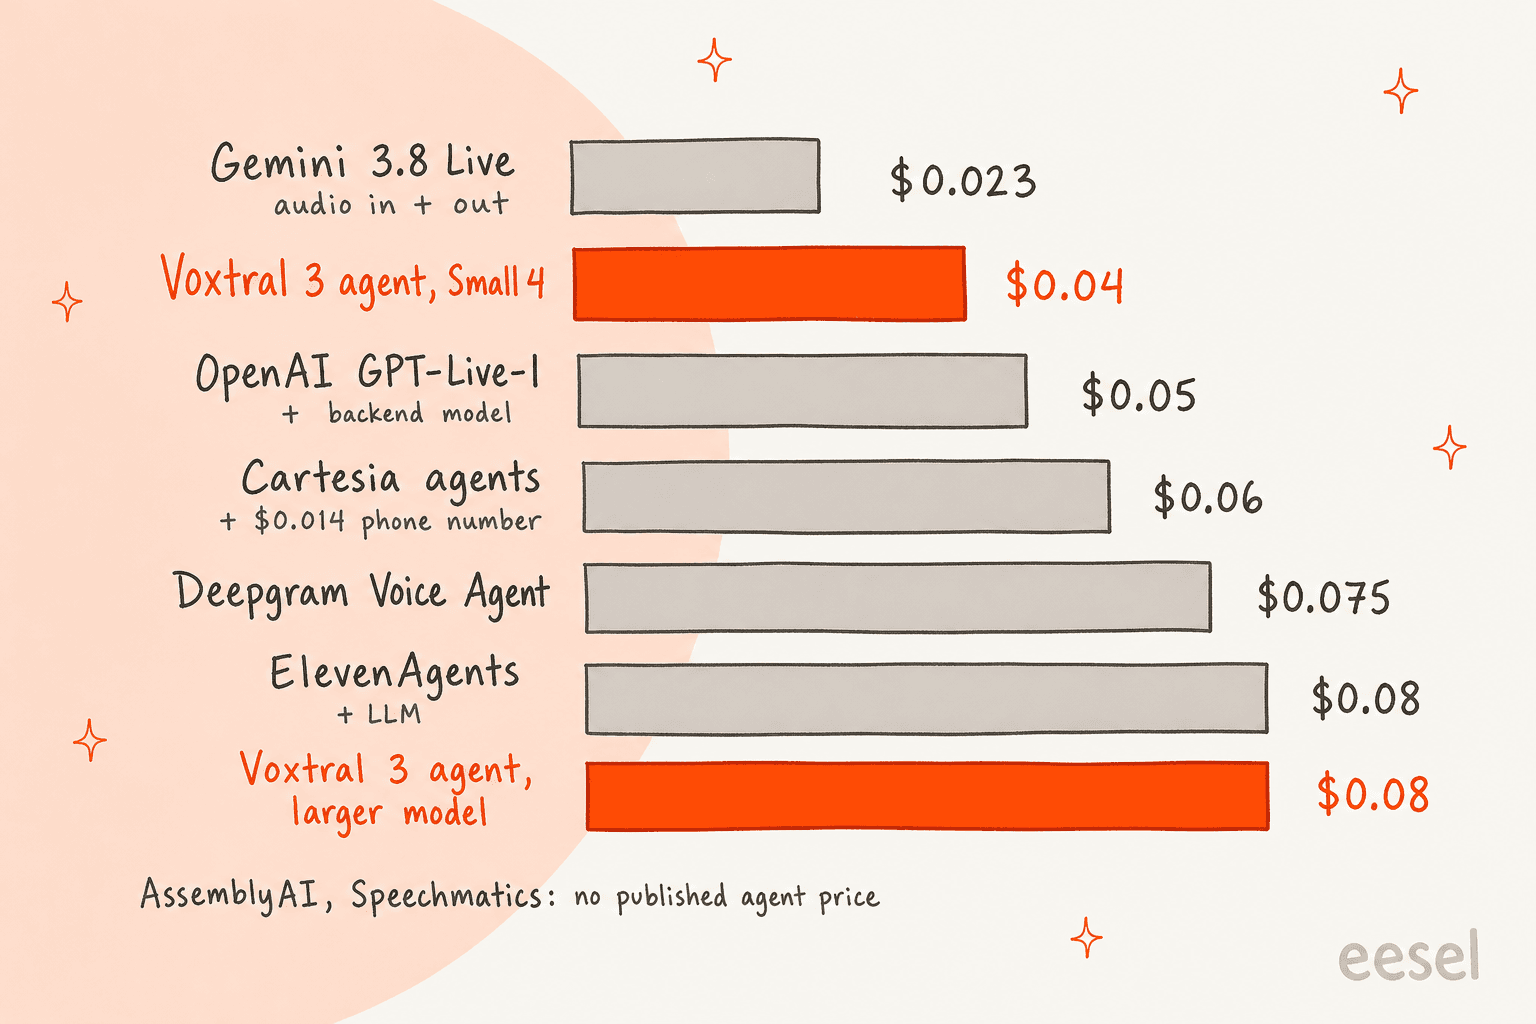
| Agente Voxtral 3, Mistral Small 4 | 50,000 × $0.04 | $2,000 | Acesso SIP (enterprise) |
| Agente Voxtral 3, modelo maior | 50,000 × $0.08 | $4,000 | Acesso SIP (enterprise) |
| Gemini 3.8 Live | 50,000 × ($0.005 entrada + $0.018 saída) | $1,150 no máximo só de áudio | Tokens de texto e de raciocínio, parceiro de telefonia |
| OpenAI GPT-Live-1 | 50,000 × $0.05 | $2,500 | Modelo de backend, ferramentas, tronco SIP |
| Agentes da Cartesia | 50,000 × ($0.06 + $0.014) | $3,700 | LLM, quando acabar o período gratuito |
| Deepgram Voice Agent, Standard | 50,000 × $0.075 | $3,750 ($3,400 no Growth) | Operadora |
| ElevenAgents | 50,000 × $0.08 + LLM a $0.0029 | cerca de $4,145 | Operadora |
| AssemblyAI | 833 horas × $0.45 para escutar | $375 + voz + LLM | Sem preço de agente agrupado |
| Speechmatics | 833 horas × $0.30 para escutar | $250 + voz + LLM + plataforma | Sem preço de agente agrupado |
O número do Gemini é um teto só de áudio: assume que os dois lados falam o minuto inteiro, o que nunca acontece, e deixa de fora os tokens de texto e de raciocínio que fazem o raciocínio de fato. Leia como «provavelmente a mais barata», não como uma cotação.
Os $2,000 do Voxtral são a linha a bater, e só o Gemini faz isso com clareza. O problema é que você ainda não consegue apontar um número de telefone para o Voxtral sem um contrato enterprise, por isso eu leria esta tabela como «o que você paga pelo acesso», não «o que você paga pela fala». Se preferir não cuidar de nada disso, meu panorama da melhor IA para suporte telefônico cobre as plataformas gerenciadas, e ferramentas de atendimento ao cliente por voz cobre as nativas de helpdesk.
1. OpenAI Realtime API
Ideal para: equipes que querem um agente de fala para fala em um número de telefone esta semana.
O que é. A pilha de voz da OpenAI tem agora dois modelos de agente. O GPT-Realtime-2.1 faz fala, raciocínio e chamadas de ferramentas em uma única sessão. O GPT-Live-1 é full duplex, ou seja, escuta enquanto fala, e entrega o raciocínio a um modelo de backend separado que você escolhe. A transcrição é o GPT-Transcribe para gravações e o GPT-Live-Transcribe para áudio ao vivo. Cobri a geração anterior no meu post sobre GPT Realtime.
Preços. O GPT-Live-1 custa $0.05 o minuto, cobrado por segundo, com o modelo de backend e as ferramentas cobrados à parte. O GPT-Realtime-2.1 é cobrado por tokens: $32 por 1M de tokens de entrada de áudio e $64 por 1M de saída de áudio. A versão mini custa $10 e $20. O GPT-Transcribe custa $0.0045 o minuto, o GPT-Live-Transcribe $0.017. A residência de dados na UE acrescenta 10%. O detalhamento completo dos preços da API da OpenAI cobre os modelos de texto que você combinaria com ele.
Onde supera o Voxtral 3. No telefone. Você aponta um tronco SIP para sip.api.openai.com, a OpenAI envia um webhook ao seu backend, e você aceita, transfere ou desliga a chamada, conforme o guia de SIP. Também há um endpoint na UE. A detecção de turnos vem em dois sabores: baseada em silêncio, ou semantic_vad, em que o modelo avalia se quem liga terminou o raciocínio.
Onde o Voxtral 3 ainda ganha. Precisão de transcrição e preço da voz. No gráfico da Mistral, o GPT Transcribe marca 5.6% contra 4.0% do Voxtral Small, e o GPT Live Transcribe 8.4% contra 7.4% do Voxtral Realtime na configuração mais rápida. Os modelos de voz independentes da OpenAI (tts-1, tts-1-hd, gpt-4o-mini-tts) são desligados em 6 de janeiro de 2027, segundo o guia de TTS, então não há preço atual por caractere para comparar.
Veredito: escolha a OpenAI se chegar rápido a uma linha telefônica importa mais do que economizar um centavo por minuto. Descarte se você precisa principalmente de transcrição em lote, onde ela é mais cara e menos precisa no teste da Mistral.
2. Google Gemini Live e Cloud Speech
Ideal para: linhas de suporte multilíngues em que a precisão da transcrição ao vivo é o fator decisivo.
O que é. O Google vende as peças separadamente. O Gemini 3.8 Live é o modelo de agente de áudio para áudio. O Gemini 3.5 Transcribe e o Transcribe Live cuidam da fala para texto pela Gemini API, com o Cloud Speech-to-Text (Chirp 3) como produto de nuvem mais antigo. As vozes vêm do Cloud Text-to-Speech, incluindo Chirp 3: HD e os modelos Gemini TTS que cobri em Gemini 3.8 Flash TTS.
Preços. O Gemini 3.8 Live custa $0.005 o minuto de áudio de entrada e $0.018 o minuto de áudio de saída, mais tokens de texto e de raciocínio a $0.75 e $4.50 por 1M. O Gemini 3.5 Transcribe sai a cerca de $0.005 o minuto combinado, o Transcribe Live a cerca de $0.009. As vozes Chirp 3: HD custam $30 por 1M de caracteres depois do primeiro 1M grátis a cada mês, segundo a página de preços de TTS. O Gemini 3.8 Flash TTS é mais barato no áudio de saída, mas dobra de preço em 1º de janeiro de 2027.
Onde supera o Voxtral 3. Precisão ao vivo, segundo o gráfico da própria Mistral. O Gemini 3.5 Transcribe na forma em tempo real marca uma taxa de erro de 4.2%, que supera o Voxtral Realtime 3 em todas as configurações de latência, inclusive a mais lenta e cuidadosa (5.7%). Provavelmente também é o agente ao vivo mais barato daqui. O Gemini 3.8 Live aceita chamadas de função assíncronas, então o agente pode continuar falando enquanto uma consulta de reembolso roda.
Onde o Voxtral 3 ainda ganha. O telefone e a duração da sessão. O Google não documenta nenhum endpoint SIP para a Live API; você passa por parceiros como Voximplant, LiveKit ou Pipecat. As sessões só de áudio são limitadas a 15 minutos por padrão, a menos que você adicione gerenciamento de sessão. As duas páginas da Live API do Google também discordam sobre o número de idiomas (70 contra 99), então teste os seus.
Veredito: escolha o Gemini se seus clientes trocam de idioma e você tem engenheiros para montar a telefonia. Combina bem com o resto de uma configuração de suporte multilíngue. Descarte se quer um único fornecedor atendendo o telefone.
3. Deepgram
Ideal para: equipes voltadas ao telefone que querem turnos de baixa latência e limites de concorrência publicados.
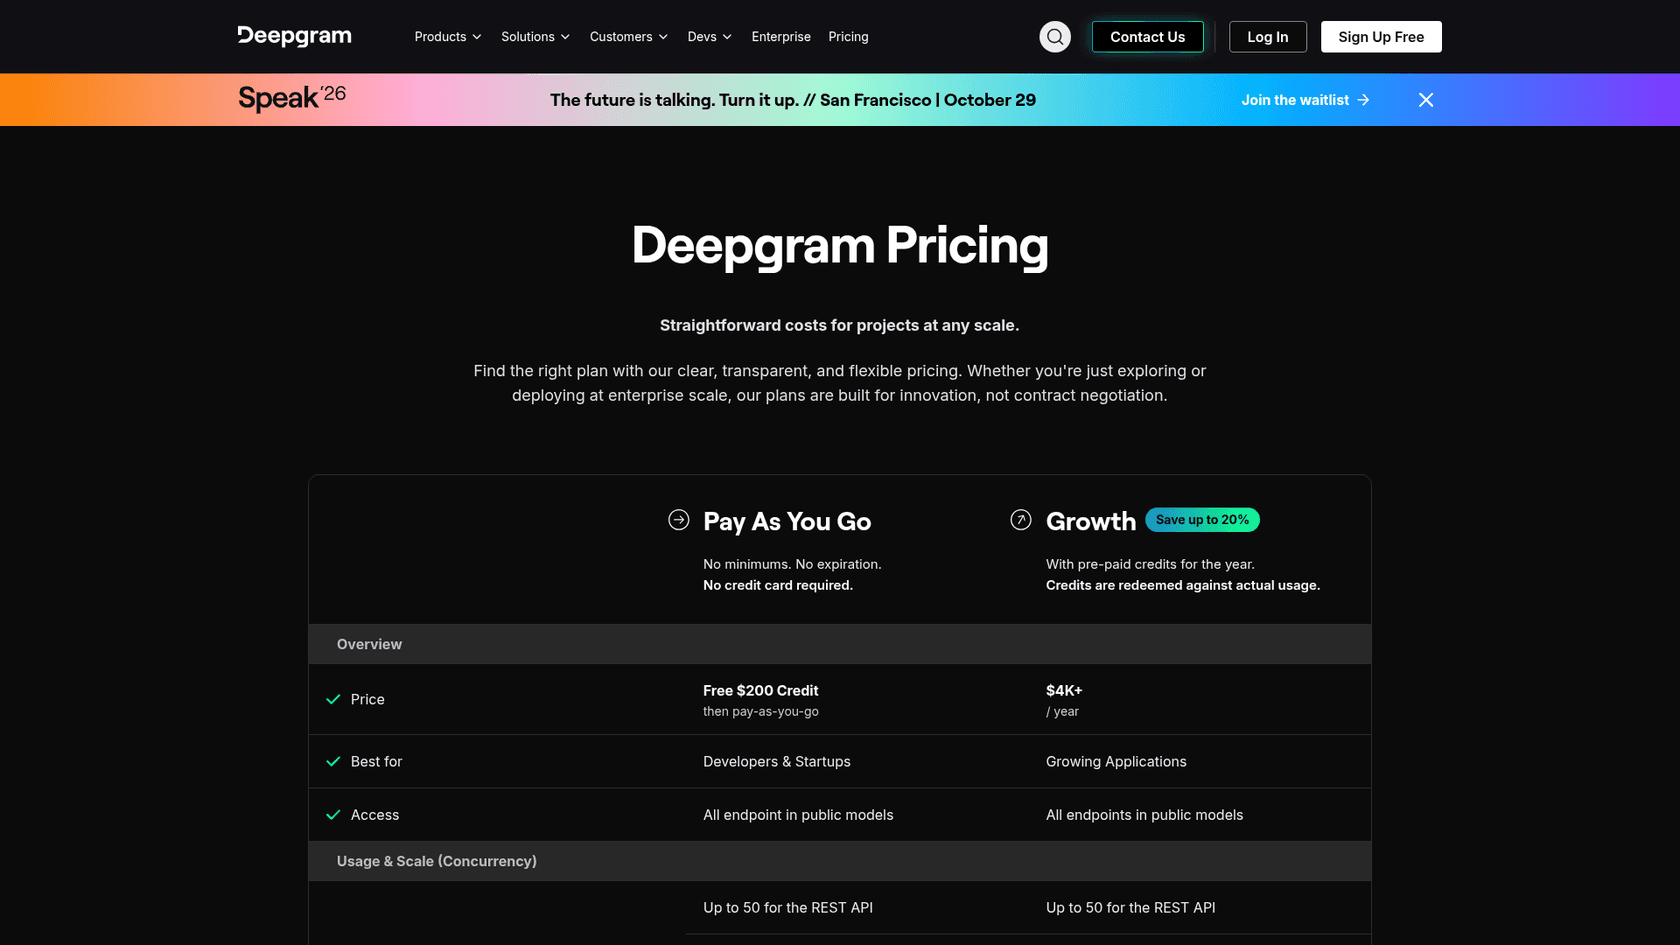
O que é. A Deepgram é primeiro uma empresa de fala. O Flux é seu modelo de fala para texto em streaming feito para agentes de voz, com detecção de fim de turno dentro do modelo. O Nova-3 cuida da transcrição geral, o Aura-2 é a voz, e a Voice Agent API agrupa escuta, um LLM e fala em um único WebSocket.
Preços. O nível Standard da Voice Agent API custa $0.075 o minuto no Pay As You Go, ou $0.068 no Growth (a partir de $4,000 por ano pré-pagos), cobrado pelo tempo de conexão WebSocket. Trazendo seu próprio LLM e voz, cai para $0.050. O Flux English custa $0.0065 o minuto, o Nova-3 para áudio gravado $0.0043 e o Aura-2 $0.030 por 1,000 caracteres. Contas novas ganham $200 de crédito sem cartão.
Onde supera o Voxtral 3. A parte hidráulica do telefone e os controles. A Deepgram afirma cerca de 260ms de detecção de fim de turno, mais um sinal «eager» que deixa seu LLM começar a redigir uma resposta antes de quem liga terminar de vez. A concorrência é publicada: 45 sessões de agente no Pay As You Go, 60 no Growth. O Flux aceita diretamente áudio telefônico mulaw de 8 kHz, e o guia de telefonia de entrada percorre uma montagem com Twilio. A conformidade é detalhada: SOC 2 Type 2, HIPAA com BAA no Enterprise e um endpoint dedicado na UE.
Onde o Voxtral 3 ainda ganha. Idiomas e preço. O Flux Multilingual cobre 10 idiomas, contra mais de 35 do Voxtral Realtime. As vozes Aura cobrem 7. E o agente do Voxtral custa mais ou menos metade por minuto.
Veredito: escolha a Deepgram se está construindo um agente telefônico em inglês ou em um grande idioma europeu e quer concorrência e conformidade por escrito. Descarte se precisa de uma mistura ampla de idiomas.
4. ElevenLabs
Ideal para: linhas de suporte em que a própria voz faz parte da marca, e equipes que querem um construtor de agentes sem código.
O que é. O ElevenAgents (antes Conversational AI) reúne um modelo de fala para texto, o LLM que você escolher, uma voz e um modelo de turnos de fala em uma plataforma de agentes, com base de conhecimento, construtor de fluxos e avaliações. O Scribe v2 é o modelo de transcrição, e as vozes vão do Flash v2.5 ao novo Eleven v4. Meu post sobre os preços da ElevenLabs traz todos os planos.
Preços. Os minutos de agente custam $0.08 cada além do seu plano, mais o uso do LLM (a calculadora mostrava o Gemini 2.5 Flash a $0.0029 o minuto). O plano Business custa $990 por mês por 12,375 minutos e 40 chamadas simultâneas. A ElevenLabs não cobra taxa de telefonia; sua operadora cobra você. O Scribe v2 custa $0.22 a hora, o Scribe v2 Realtime $0.39. As vozes custam de $0.04 a $0.08 por 1,000 caracteres, ou seja, de $40 a $80 por 1M, segundo a página de preços da API.
Onde supera o Voxtral 3. O telefone e o produto ao redor. Troncos SIP nativos com chamadas de entrada e saída, uma integração com a Twilio, chamadas de saída em lote e ajustes de quão rápido o agente assume o turno. O SDK de agentes do Voxtral é code-first sobre o LiveKit; o ElevenAgents é algo que uma líder de suporte consegue configurar.
Onde o Voxtral 3 ainda ganha. Precisão e preço. O gráfico da Mistral coloca o Scribe v2 em 4.9% contra 4.0% do Voxtral Small, e o Scribe v2 Realtime em 8.7%, o último dos modelos em tempo real nesse gráfico. A voz do Voxtral custa um terço do v4 Turbo. Residência de dados fora dos EUA é um recurso Enterprise na ElevenLabs.
A latência é a reclamação que mais vejo entre quem constrói, e geralmente vem do LLM, não da voz:
"The agents are taking 4000ms to answer anything. This is without RAG which shouldn't take anywhere near that long."

Esse tópico é de uma geração de modelos mais antiga, então trate como um teste a fazer, não como um veredito. O panorama de análises da ElevenLabs traz o quadro mais amplo.
Veredito: escolha a ElevenLabs se a voz é o que seus clientes vão julgar, ou se ninguém na equipe quer escrever código de orquestração. Descarte se o custo por minuto é o fator decisivo.
5. Cartesia
Ideal para: equipes cujo agente soa bem, mas começa a falar tarde demais.
O que é. A Cartesia fez nome com o Sonic, um modelo de voz rápido agora na versão 3.6, e acrescentou o Ink-2 para transcrição em streaming e os Managed Agents, que combinam os dois com um LLM à sua escolha. Testei uma versão anterior na minha análise do Cartesia Sonic 3.
Preços. Os planos são Free, Pro $5, Startup $49 e Scale $299 por mês, vendidos como créditos em que um caractere de fala é um crédito. O excedente custa de $38 a $65 por 1M de créditos conforme o plano. Os agentes custam $0.06 o minuto em todo plano de autoatendimento, mais $0.014 o minuto por um número de telefone da Cartesia. O uso do LLM para agentes criados na interface é grátis «for a limited time», segundo a página de preços. O Ink-2 sai a $0.39 a hora no Scale.
Onde supera o Voxtral 3. Promessas de velocidade e números de telefone que você pode comprar hoje. O Sonic afirma o primeiro áudio em cerca de 90ms, o mesmo valor que a Mistral dá para a voz do Voxtral, e o Ink afirma 88ms até uma transcrição final. O Ink-2 marca os turnos pelo sentido, não pelo silêncio, e a Cartesia vende o próprio número de telefone. O Sonic cobre 44 idiomas.
Onde o Voxtral 3 ainda ganha. Amplitude de transcrição e preço da voz. O Ink-2 cobre cinco idiomas (inglês, espanhol, francês, híndi e japonês). O excedente do Sonic, de $38 ou mais por 1M de caracteres, é cerca de três vezes os $13 do Voxtral. O período gratuito do LLM vai acabar, e o preço do agente vai subir quando isso acontecer.
Veredito: escolha a Cartesia pela voz em um agente telefônico em inglês ou espanhol onde cada milissegundo de silêncio dói. Descarte se precisa de transcrição em mais de cinco idiomas.
6. AssemblyAI
Ideal para: equipes focadas em transcrição que se importam em acertar números de pedido, e-mails e nomes.
O que é. A AssemblyAI é mais conhecida por transcrição e agora vende uma Voice Agent API que agrupa seus modelos de fala com um LLM e uma voz própria. Você pode trazer o Claude pelo gateway dela ou qualquer modelo compatível com a OpenAI.
Preços. O Universal-3.6 Pro Realtime custa $0.45 a hora em 32 idiomas, e o mais barato Universal-Streaming $0.15. O áudio gravado custa $0.21 a hora no Universal-3.5 Pro. A voz, AssemblyAI-TTS-1, custa $15 por 1M de caracteres, o mesmo preço nos EUA ou na UE. A Voice Agent API em si não tem preço por minuto publicado, então o custo de uma chamada completa depende do que você combina com ela.
Onde supera o Voxtral 3. Nos detalhes que arruínam ligações de suporte. A detecção de turnos espera de propósito enquanto quem liga lê um número de telefone, e-mail ou data, e a interrupção ignora «uh-huh», mas para com «wait, stop». Um agente inicial dtmf recebe números de cartão pelo teclado, fora da transcrição, dos logs e do modelo. Nos benchmarks da própria AssemblyAI, ela fica em primeiro entre 22 sistemas em erros de entidades de agentes de voz (14.41%), um teste que inclui o Voxtral Mini. O SIP funciona por um tronco da Twilio, e existe uma opção auto-hospedada.
Onde o Voxtral 3 ainda ganha. Cobertura de idiomas e um preço conhecido. A mesma página de benchmarks coloca a AssemblyAI em quinto no FLEURS multilíngue (8.44% em 18 idiomas). O fornecedor também observa que sua limpeza de dígitos falados é «best-effort, not guaranteed», então teste números de conta longos.
Veredito: escolha a AssemblyAI se seus clientes passam metade da ligação soletrando coisas. Descarte se precisa de um preço que caiba no orçamento antes de construir.
7. Speechmatics
Ideal para: transcrição barata e precisa de ligações gravadas, com sotaques e troca de idioma no meio da frase.
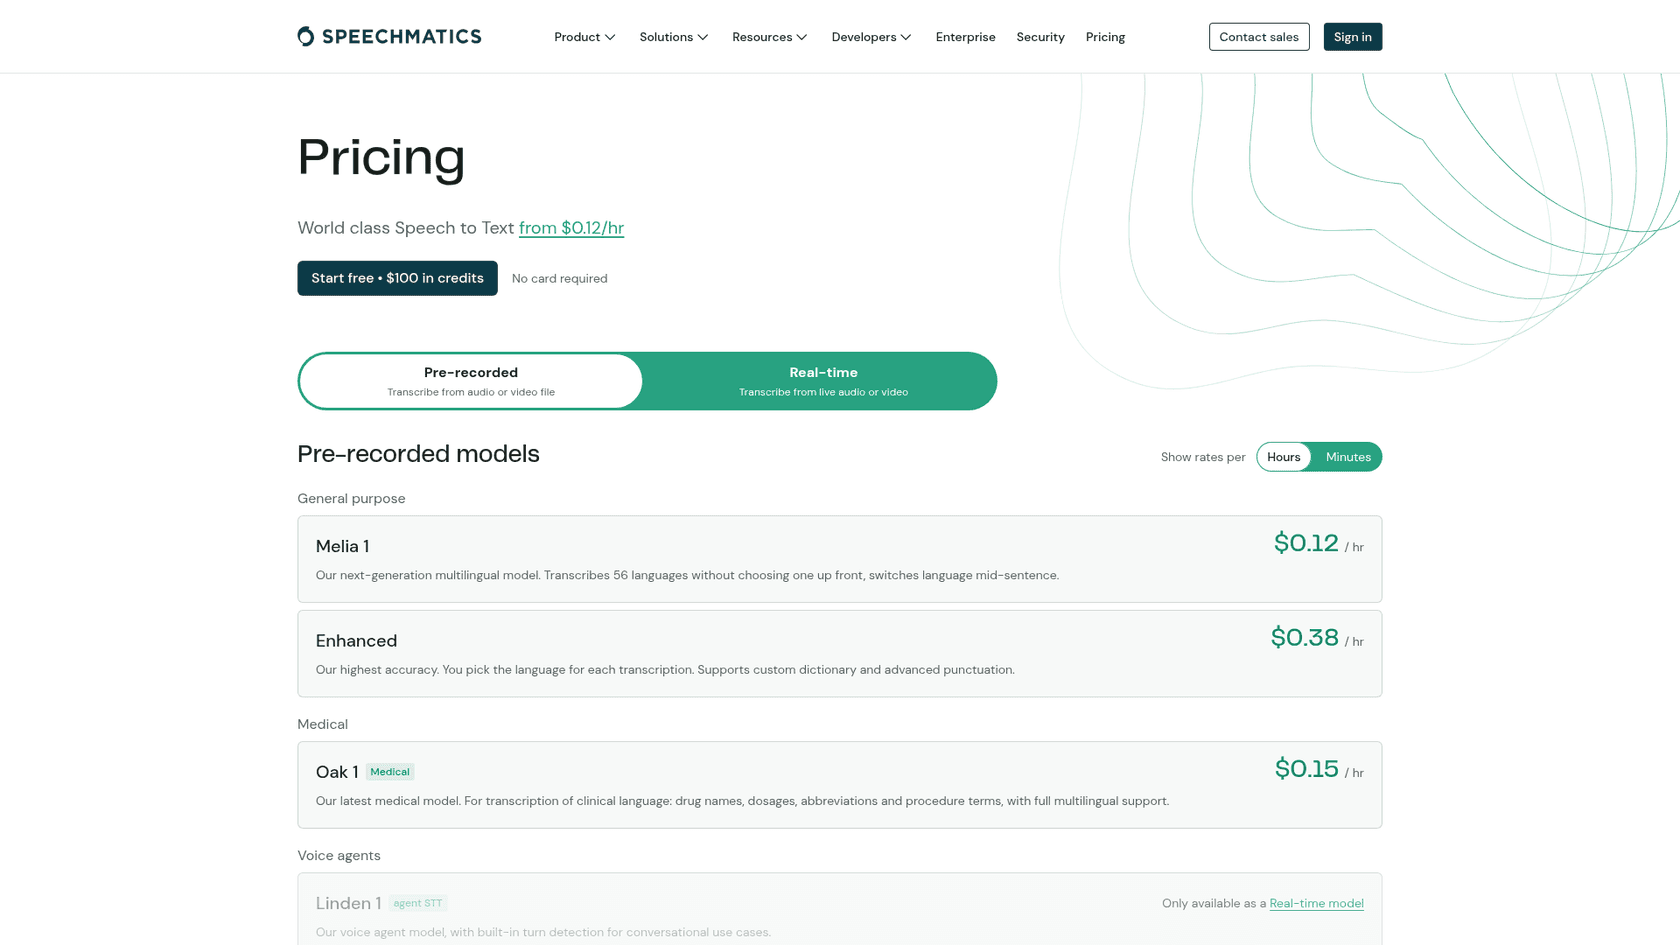
O que é. A Speechmatics vende a camada de fala, não o agente. O Melia 1 é seu modelo multilíngue (56 idiomas, com troca no meio da frase), o Linden 1 é o modelo de fala para texto para agentes de voz, e um produto de texto para fala está em prévia. Você traz o LLM e a orquestração, por Vapi, LiveKit ou Pipecat.
Preços. O Melia 1 custa $0.12 a hora na página de preços, embora a calculadora do site mostre $0.24, então confirme antes de orçar. O Linden 1 para agentes custa $0.30 a hora a preço de tabela, até $0.15 com volume. A voz custa $0.011 por 1,000 caracteres ($11 por 1M), com o primeiro 1M grátis. Contas novas ganham $100 de crédito.
Onde supera o Voxtral 3. Preço em áudio gravado e a papelada de conformidade. $0.12 a hora é o menor preço em lote desta lista, contra $0.21 do Voxtral Mini. A Speechmatics lista SOC 2 Type II, ISO 27001, GDPR e HIPAA, com processamento na UE, nos EUA ou na Austrália. O Linden afirma transcrições finais em 350ms, com rótulos de falante incluídos.
Onde o Voxtral 3 ainda ganha. Tudo além da transcrição. A voz é só em inglês, com quatro vozes em prévia, a Voice Agent API é uma prévia de acesso antecipado que «should not be used for live production traffic», e a detecção de turnos é por enquanto guiada por silêncio, com detecção semântica «coming soon», segundo a página de agentes de voz.
Veredito: escolha a Speechmatics para transcrever ligações gravadas para garantia de qualidade em escala. Descarte para qualquer coisa que precise responder falando.
E se você queria o Voxtral pelos pesos abertos?
Então nenhuma dessas sete o substitui, e prefiro dizer isso com clareza. Toda opção aqui é uma API hospedada. Deepgram, Cartesia, AssemblyAI e Speechmatics oferecem auto-hospedagem, mas em contratos enterprise, que é o mesmo acordo que a Mistral agora oferece para o Voxtral 3.
O tópico do Hacker News tinha muitos desenvolvedores que rodam fala no próprio hardware, e a escolha deles foi o Parakeet da NVIDIA, não outra API hospedada:
"I do think Parakeet is pretty amazing, though, so some of these product announcements have limited interest to me, especially since it's cloud and costs per hour, even if it's a low cost."
Se você já usa o modelo aberto em tempo real do Voxtral 2, o movimento prático é ficar nele até a Mistral dizer mais sobre os pesos do Voxtral 3, e enquanto isso testar o Parakeet com seu próprio áudio. O post de análises da Mistral AI acompanha como a empresa tem lidado com lançamentos abertos.
O que nenhuma dessas sete resolve em uma linha de suporte
Todas as ferramentas acima resolvem a mesma metade do problema: ouvir quem liga e responder falando. Nenhuma conhece sua política de reembolso, o que um status de pedido significa na sua loja ou quais perguntas sua equipe sempre passa para uma pessoa.
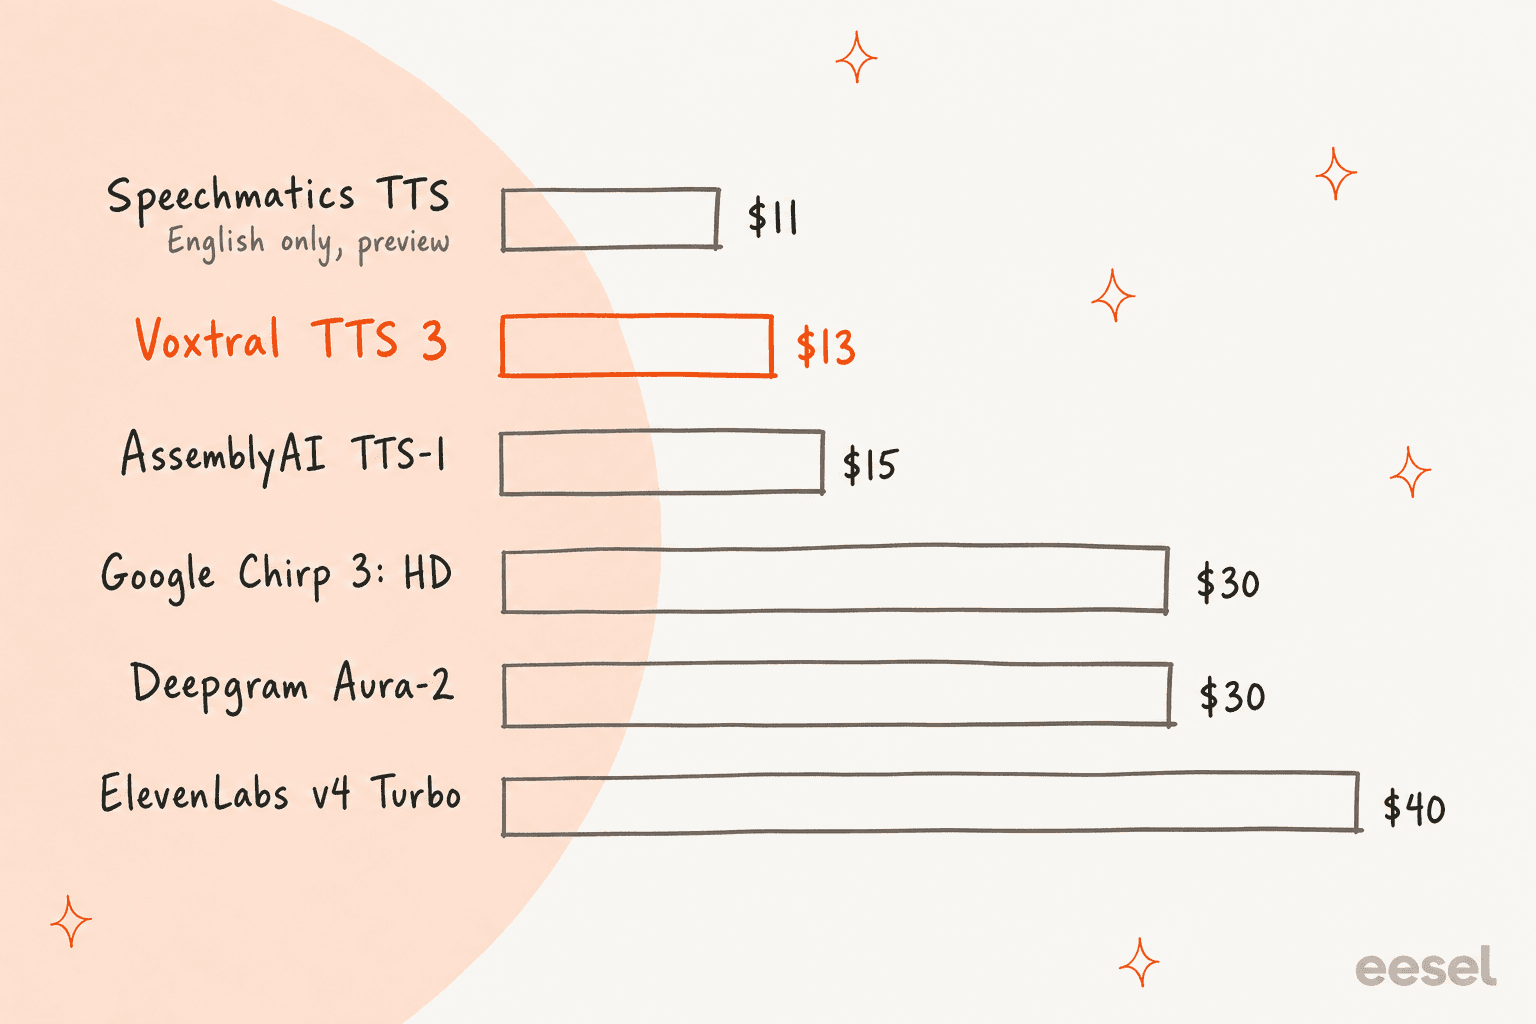
Esse gráfico é o tipo de comparação em que os lançamentos de fala competem, e a diferença é real: de $11 a $40 por 1M de caracteres. Numa linha de suporte, é também o menor número da conta. A 750 a 800 caracteres por minuto falado (a regra prática da própria Cartesia), até a voz mais cara daqui custa cerca de 3 centavos por minuto. Uma resposta errada custa uma ligação repetida e um ticket.
Pela fila, as ligações que dão errado raramente têm a ver com uma palavra mal entendida. Têm a ver com um agente, humano ou de IA, que não tem a resposta. Por isso eu escolheria a camada de fala por último e organizaria o conhecimento primeiro, do mesmo jeito que você configuraria a transferência do agente de IA para uma pessoa antes de entrar no ar. A comparação de Grok Voice que escrevi bateu na mesma parede: no meu post sobre alternativas ao Grok Voice, o melhor modelo resolveu 56.5% das ligações simuladas.
Para a maioria das equipes, a ordem que funciona é automatizar primeiro os canais de texto, onde o mesmo conhecimento é testado em milhares de tickets, e depois levar ao telefone. Meu guia sobre como automatizar o suporte telefônico percorre essa sequência, e agente de IA para call center cobre o que muda quando você chega à voz.
Se seu helpdesk já tem um produto de voz, comece pelos agentes de voz com IA do Zendesk ou pelos agentes de voz do Freshcaller.
Teste a eesel para as perguntas por trás das ligações
Essas sete ferramentas são infraestrutura, e a eesel é o funcionário. O colega de helpdesk com IA da eesel entra no Zendesk ou no Freshdesk, aprende com seus tickets anteriores, macros e central de ajuda, e responde às perguntas que os clientes repetem nos canais em que já escrevem.
A Norden-Frisia, uma empresa alemã de balsas, roda seu bot CaptAIn no Zendesk, no chat do site e em um link de chat público, respondendo perguntas sobre horários, carros e bicicletas a partir de 346 itens de conhecimento, com um plano de 10,000 interações por mês na alta temporada. A Innr, uma marca holandesa de iluminação inteligente, recebe respostas do Freshdesk redigidas no idioma em que o cliente escreveu, a partir de 1,500 artigos de ajuda e tickets anteriores. Esse é o conhecimento de que um agente do Voxtral, do Gemini ou da ElevenLabs precisaria no primeiro dia. Teste a eesel primeiro no seu helpdesk, e seu agente telefônico terá algo que valha a pena dizer.