

O que é o Eleven v4?
O Eleven v4 é a quarta geração do modelo de voz da ElevenLabs, uma das empresas de voz com IA mais conhecidas, e a empresa o chama de "the first in a new generation of models" na sua página de documentação do Eleven v4.
O post de lançamento diz que ele roda numa arquitetura totalmente nova, que lê um roteiro como um dublador leria, prestando atenção em quem está falando e no que acabou de acontecer antes de decidir como uma fala deve soar.
Eu construo agentes de IA na eesel (a plataforma de colegas de IA), e a equipe passou anos colocando IA em filas de suporte reais, então, quando um lançamento assim chega, só quero saber uma coisa: o que muda para quem precisa colocá-lo em produção? Resposta curta: o v4 é um avanço real, mas também é uma migração, não uma troca direta.
Segundo a referência de modelos, há duas variantes:
- Eleven v4 (
eleven_v4): o modelo de qualidade. Limite de 10.000 caracteres (cerca de 10 minutos de áudio), diálogo com vários falantes, servido pela API de Text to Dialogue. - Eleven v4 Turbo (
eleven_v4_turbo): o modelo de tempo real, com latência de inferência mediana de ~100 ms, servido pelo WebSocket de Text to Dialogue e dentro do ElevenAgents.
Segundo o changelog de 28 de setembro, você pode usar ambos hoje no ElevenCreative (o app web), no ElevenAgents e na API. A ElevenLabs também publicou um breve tutorial para desenvolvedores, se você preferir vídeo.
O que realmente mudou em relação ao v3?
Expressividade e precisão de clonagem ficam com as manchetes. Mas os detalhes com que você realmente planeja estão na documentação, então montei esta comparação lado a lado a partir da página de modelos e da página de preços da API.
| Eleven v3 | Eleven v4 | Eleven v4 Turbo | |
|---|---|---|---|
| Ideal para | Interpretações dramáticas | Audiolivros, locuções, dublagem | Agentes de voz, apps interativos |
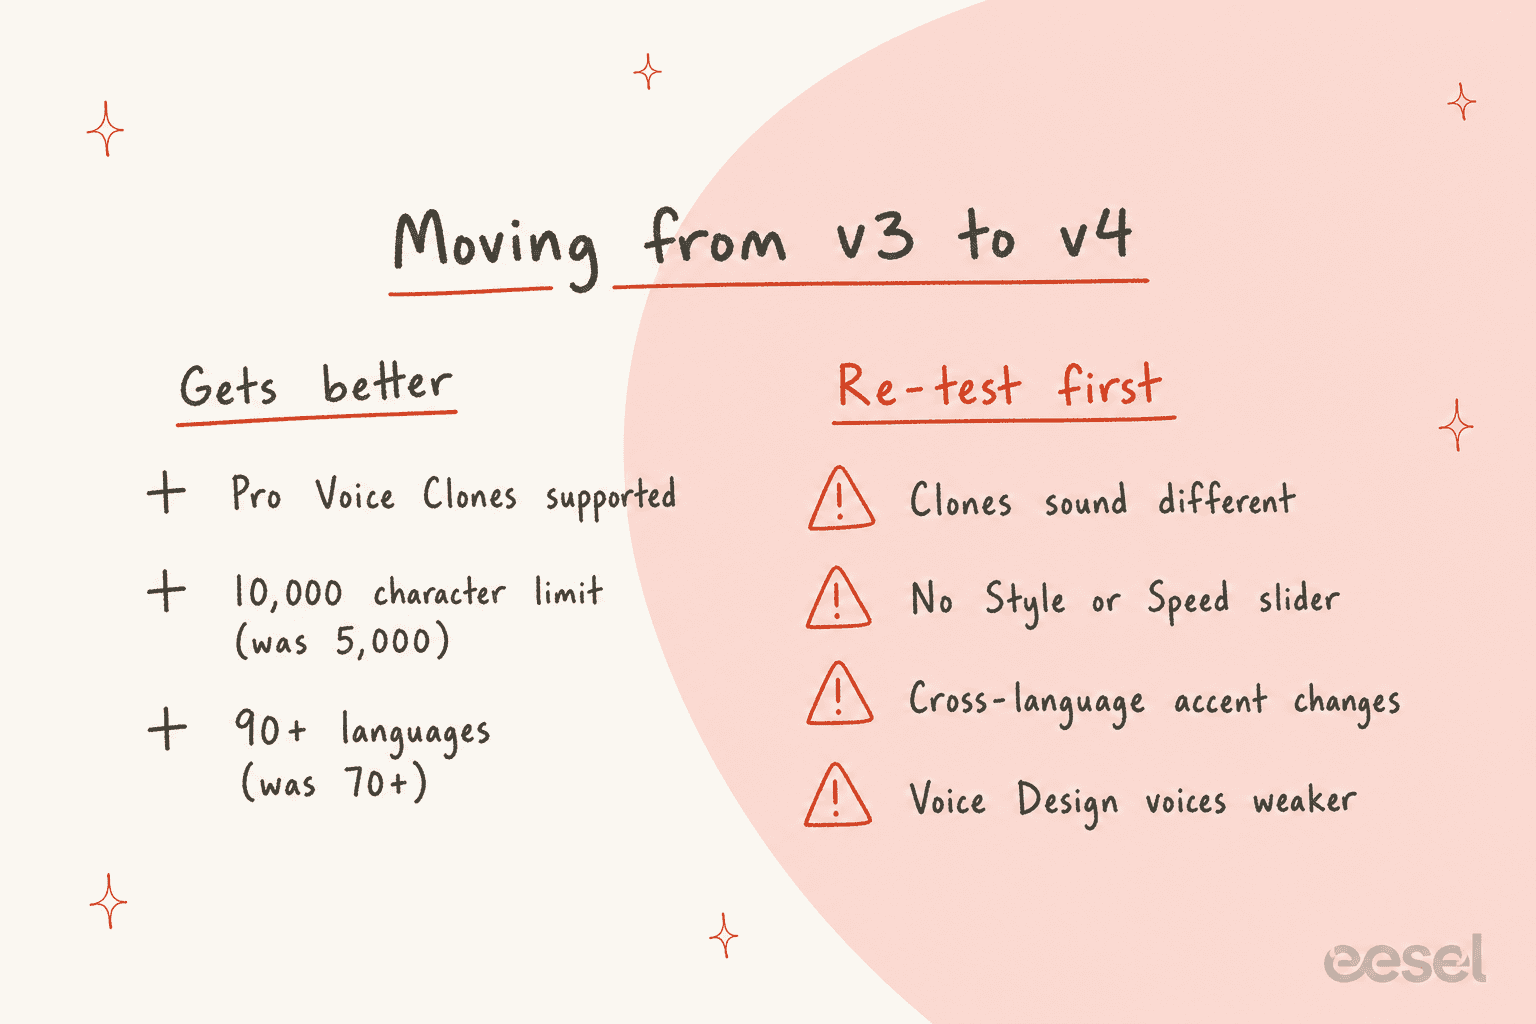
| Idiomas | 70+ | 90+ | 90+ |
| Limite de caracteres por requisição | 5.000 | 10.000 | Streaming |
| Latência | Não é tempo real | Não é tempo real | ~100 ms de inferência mediana |
| Preço de tabela da API por 1.000 caracteres | US$ 0,08 | US$ 0,08 | US$ 0,04 |
| Professional Voice Clones | Não totalmente otimizados | Suportado | Suportado |
| Controles de Style e Speed | Sim | Não | Não |
| SSML | Não | Não | Não |
| Elo na arena (Artificial Analysis) | 1174 | 1321 | 1334 |
Alguns desses pontos precisam de mais espaço do que uma célula de tabela oferece.
Os Professional Voice Clones voltaram. Segundo a página de boas práticas do v3, os PVCs não estavam totalmente otimizados para o v3, e por isso equipes com um clone profissional caro costumavam ficar em modelos mais antigos. O guia de boas práticas agora aponta essas vozes direto para o v4. Há uma ressalva, porém. A documentação diz que o suporte a PVC "is currently rolling out to everyone", então algumas contas ainda podem estar esperando.
Clones instantâneos precisam de menos áudio. O post de lançamento diz que os Instant Voice Clones capturam uma voz com "just 10 seconds of audio", embora a documentação ainda recomende de um a dois minutos para um resultado sólido.
O formato longo está mais estável. A ElevenLabs diz que o request stitching (encadear gerações numa peça mais longa) é "significantly more reliable", e quem mais vai notar são os produtores de audiolivros que trabalham no Studio.
Só restam dois controles. Stability e Similarity continuam no v4. Style e Speed não, então a direção agora fica no próprio roteiro, como audio tags do tipo [whispers] ou [sighs].
Por que o Turbo é a escolha da maioria
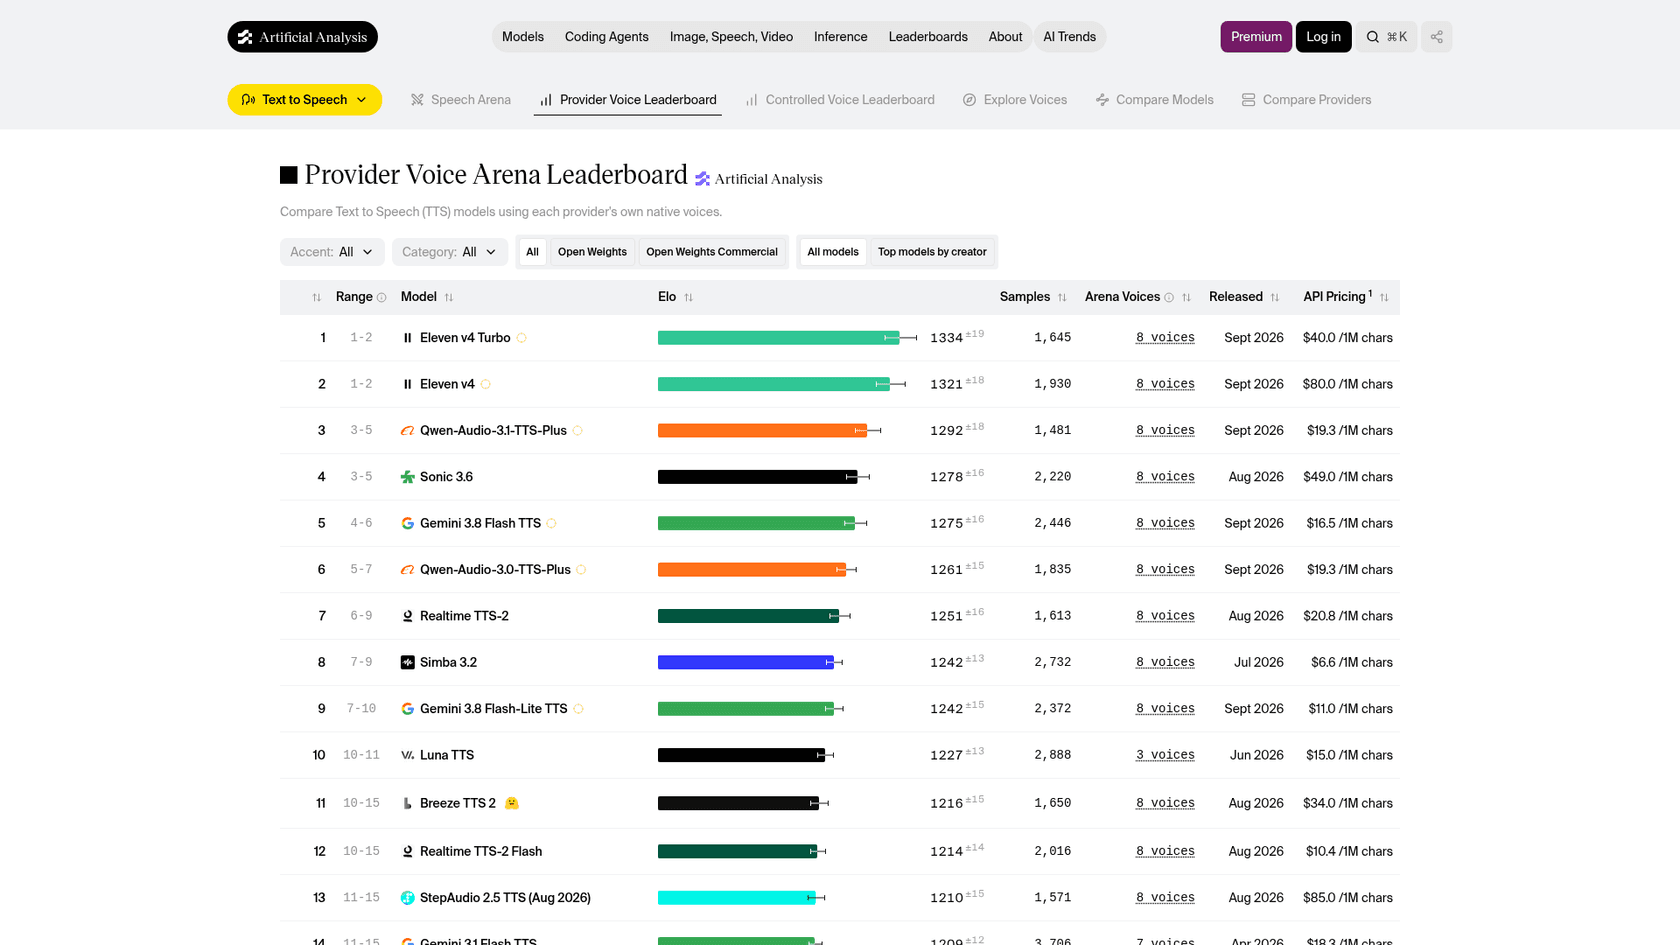
Esta foi a parte que me surpreendeu. Você imaginaria que o modelo de "qualidade" vence o "rápido" em qualidade. Na Provider Voice Arena da Artificial Analysis, onde os ouvintes escolhem o mais natural de dois clipes sem saber qual modelo os gerou, é o contrário:
- Eleven v4 Turbo: 1334 Elo em 1.645 votos, US$ 40 por 1 M de caracteres.
- Eleven v4: 1321 Elo em 1.930 votos, US$ 80 por 1 M de caracteres.
- Qwen-Audio-3.1-TTS-Plus: 1292 Elo, US$ 19,30 por 1 M de caracteres.
- Cartesia Sonic 3.6: 1278 Elo, US$ 49 por 1 M de caracteres.
- Gemini 3.8 Flash TTS: 1275 Elo, US$ 16,50 por 1 M de caracteres.
Os dois modelos v4 se sobrepõem dentro das suas faixas de confiança (ambos estão na faixa de ranking "1-2"), então a leitura justa é que o Turbo iguala o modelo completo em naturalidade de clipes curtos pela metade do preço. O modelo completo justifica o preço em coisas que a arena não testa, como o limite de 10.000 caracteres e a manutenção do contexto da cena ao longo de um roteiro longo. Costurar um capítulo inteiro sem deriva é outra.
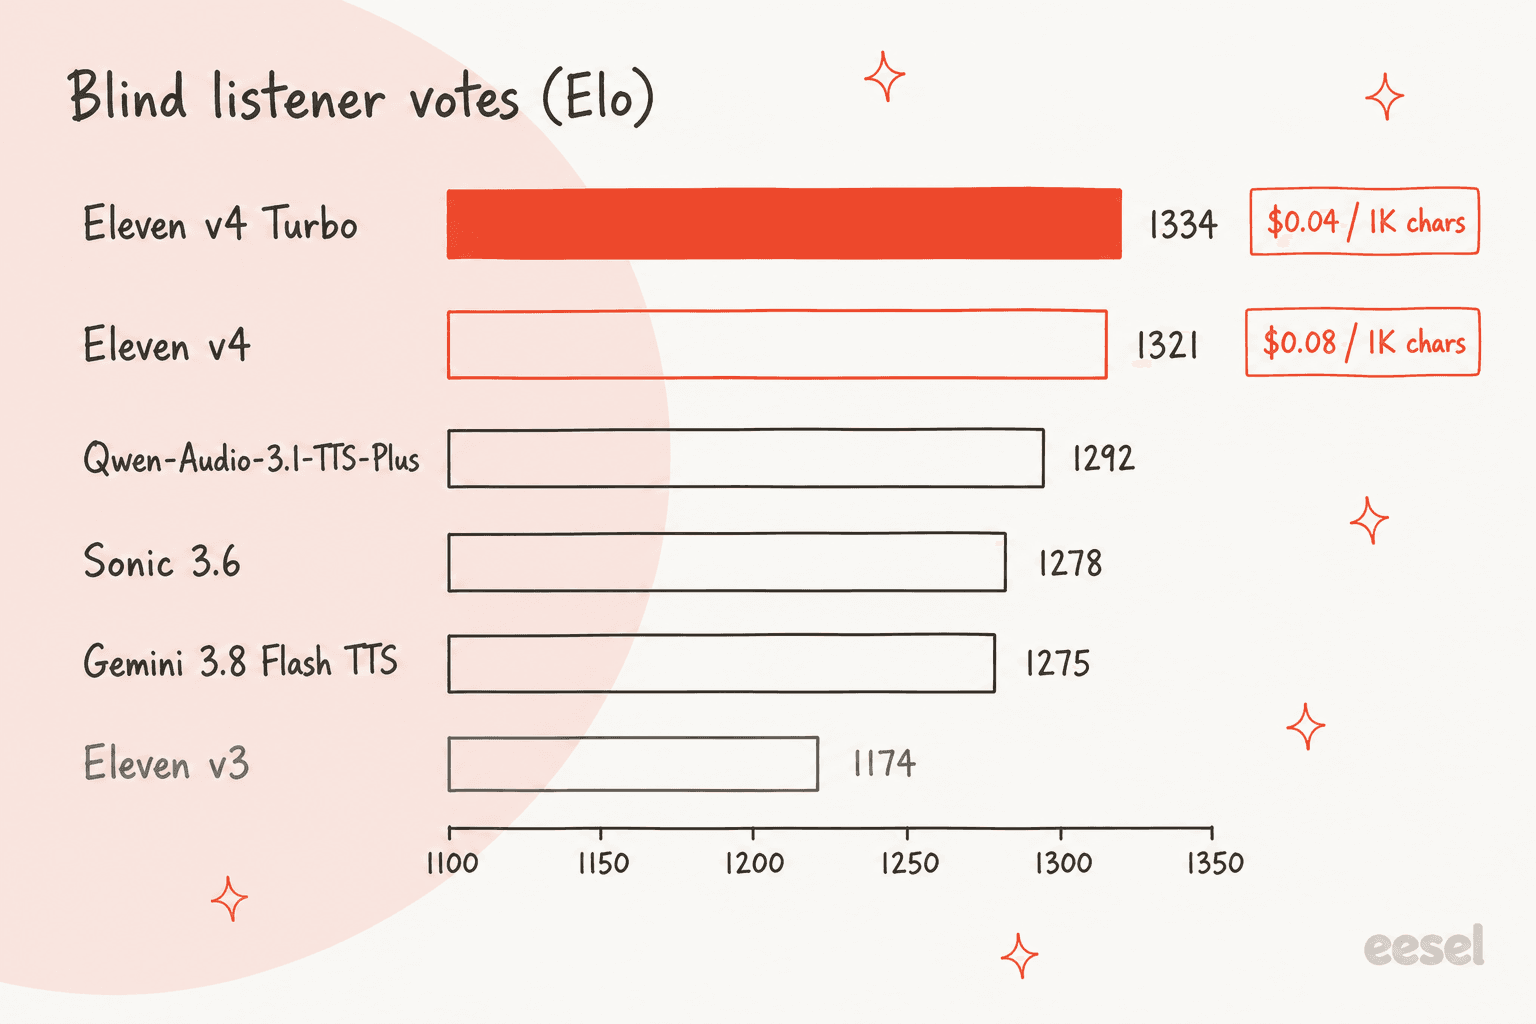
A diferença para o v3 também se sustenta e não é arredondamento de marketing. O v3 está em 1174 no mesmo placar, 147 pontos atrás do v4, e numa escala Elo isso significa que os ouvintes preferem o v4 na maior parte das vezes. Os testes da própria ElevenLabs afirmam que o v4 foi preferido por ~75% dos ouvintes frente ao Cartesia Sonic 3.6, ao Inworld TTS-2 e a dois modelos TTS do Gemini 3.8, segundo as notas de rodapé do post de lançamento. Eu trataria isso como uma alegação do fornecedor e usaria os números da arena como verificação independente.
Minha regra prática é Turbo por padrão, e o modelo completo só quando uma única requisição precisa sustentar minutos de narração contínua.
Comparando fornecedores? Meus artigos Cartesia Sonic 3 vs ElevenLabs e a análise do Gemini 3.8 Flash TTS cobrem os dois nomes seguintes desse placar.
O post sobre os preços do Gemini 3.8 Flash TTS explica por que o Google cobra menos que todo mundo. Há uma lista mais ampla em alternativas à ElevenLabs.
Qual modelo Eleven combina com o seu projeto?
Escolha o que você está construindo. Os preços são tarifas de tabela da API por 1.000 caracteres.
Como o sotaque nativo muda as vozes multilíngues
A documentação destaca isso como uma das maiores mudanças do v4. É também a que mais provavelmente pegará um cliente existente de surpresa.
Uma voz clonada no v3 levava seu sotaque consigo para outros idiomas. O v4 divide isso em dois casos. Se o idioma de saída corresponde ao idioma da própria voz, o sotaque é preservado; se não, o v4 produz fala fluente com sotaque nativo do idioma de destino. A documentação dá este exemplo: clone um falante coreano, gere em inglês e você obtém inglês natural, não inglês com sotaque coreano.
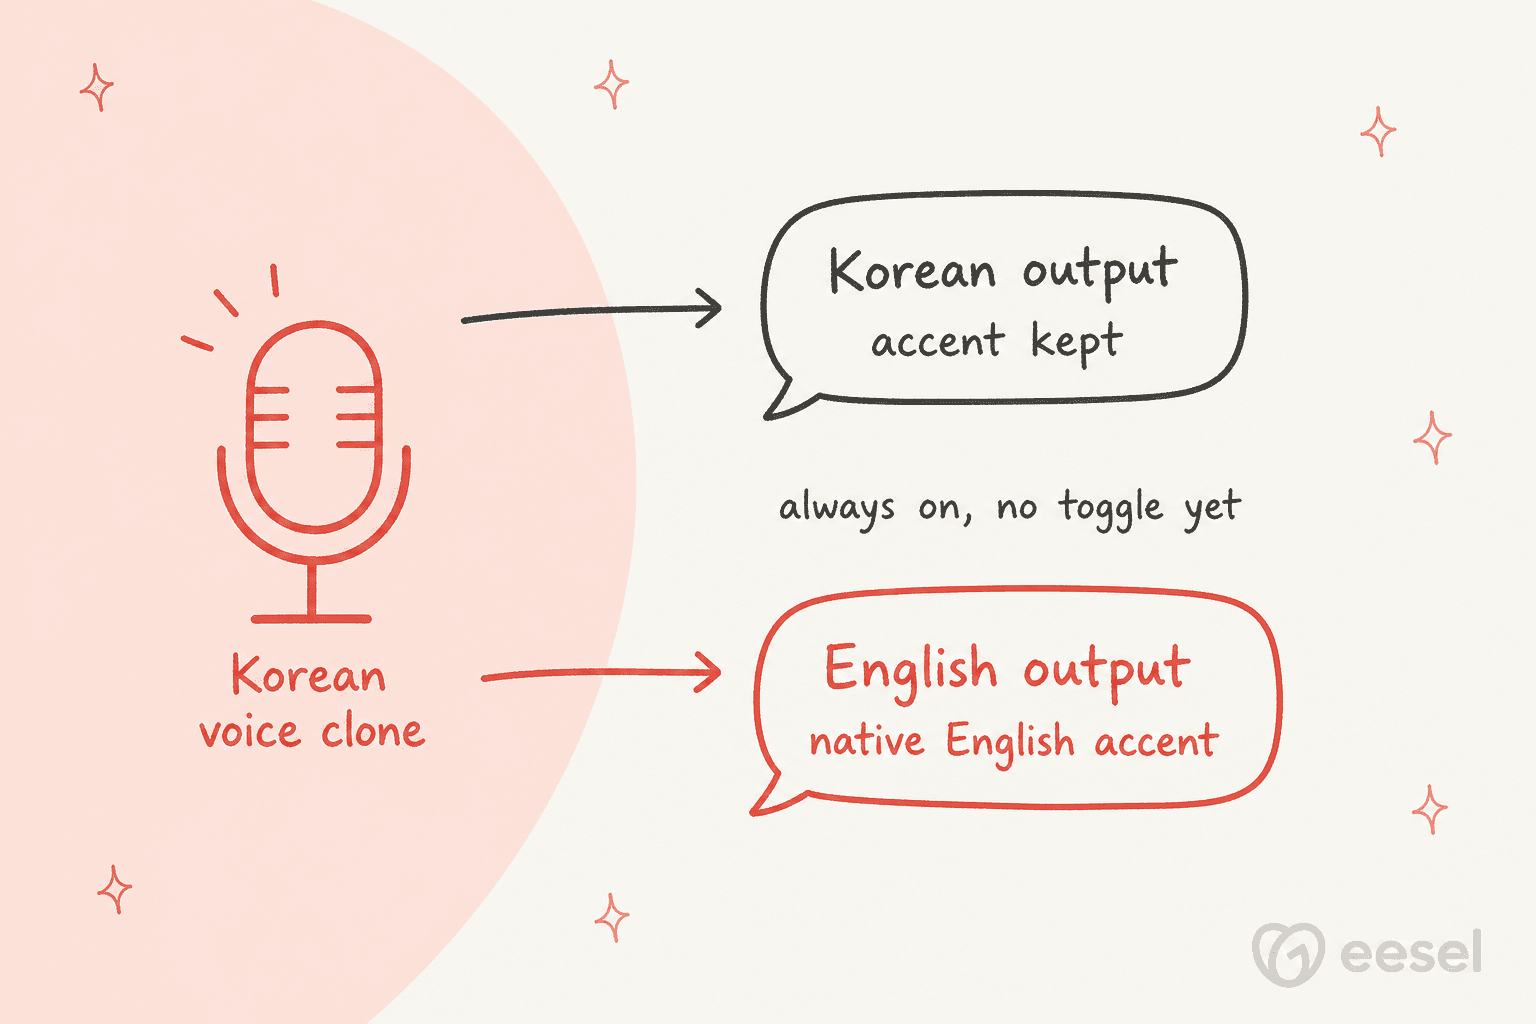
É um grande avanço para dublagem e para agentes que atendem chamadas em vários idiomas, já que uma única voz de marca agora pode soar local em qualquer lugar. Mas, se a sua voz é o sotaque, é um retrocesso. A ElevenLabs admite abertamente que uma opção para isso ainda é um "still a research project", sem prazo.
Nem todos os primeiros usuários concordam que funcione como descrito. No tópico do subreddit oficial, um comentarista teve o problema oposto:
"In English it's good but the American accent bleeds terribly into other languages."

Outra pessoa queria o controle de sotaque definido no nível da voz, e não por linha. Para quem produz uma série longa, é um pedido justo:
"I want accent/dialects to be encoded at the voice level, not have to prompt for it in every single line. It is really impossible to keep a stable idiolect that way and generic [Scottish] or whatever can still come out a million ways."
Na prática: se você opera suporte ao cliente multilíngue com um agente de voz, gere um roteiro de teste em cada um dos seus principais idiomas antes de trocar. Segundo o post do Turbo nos agentes, os maiores ganhos vieram em japonês, português do Brasil, mandarim e cantonês, que são bons para testar primeiro.
As minhas vozes clonadas vão soar iguais?
Provavelmente não, e a ElevenLabs admite isso. O v4 reproduz a voz de origem com mais precisão (timbre, cadência, volume, até defeitos de gravação), então um clone no v4 "may sound quite different from its Eleven v3 version", segundo as perguntas frequentes do v4. Há também uma frase na documentação que eu gostaria que todo responsável por áudio lesse duas vezes: precisão e preferência pessoal nem sempre são a mesma coisa.
Isso tem dois efeitos em cadeia:
- Seu áudio de treino importa mais. O v4 copia fielmente plosivas, sibilância áspera e também saltos de volume. Os clipes de demonstração na página da documentação são deixados sem tratamento de propósito para mostrar isso. Se o seu clone veio de uma gravação ruidosa, regrave antes de culpar o modelo.
- Vozes da biblioteca podem mudar sem aviso. Usuários do ElevenReader (o app de escuta) notaram vozes mudando no meio de um livro. Alguns adoraram e outros não.
"In ElevenReader it genuinely blew me away. I didn't even know the update was coming, but suddenly my narrator sounded like an actual real human was reading my book to me."
Criadores que haviam ajustado uma voz para uma entrega específica e contida viram o contrário:
"I'm actually having big issues with v4 its super expressive but for my niche its too damn theatrical and you cannot make certain voices be straight/monotone while speaking..."
Há um asterisco mais discreto para vozes do Voice Design (as geradas a partir de uma descrição em texto). A documentação diz que elas funcionam no v4, mas "may not be as performative or sound as good as with earlier models".
Como funcionam as audio tags e o prompting no v4?
Como os controles de Style e Speed sumiram, a direção precisa vir do roteiro. Você escreve tags no meio do texto, como [whispers], [sighs], [laughs harder], ou indicações sonoras como [door slams] e [light rain], e o v4 as segue "more reliably than v3", segundo a página do v4. A ElevenLabs também tem uma lista de audio tags com mais de 50 exemplos.
Algumas notas do guia de prompting que podem poupar uma ou duas regerações:
- Sem SSML. Nem o v4 nem o v3 suportam as tags de pausa do SSML, o que é uma mudança se você vem de uma API de fala mais antiga. Use reticências e quebras de linha, ou tags como
[short pause]ou[long pause]. - Tags podem ser lidas como efeitos sonoros. O v4 gera efeitos sonoros além de vozes, então uma tag vaga pode sair como um ruído. A documentação sugere algo mais descritivo, como
[low, gravelly voice]. - Tags funcionam melhor dentro do alcance da voz. Uma voz que nunca sussurrou nos dados de treino ainda pode seguir
[whispering], mas "the result may not be optimal". - A pronúncia em IPA agora é nativa. Você coloca símbolos IPA entre barras direto no texto, sem tags XML de fonemas. Isso é útil para nomes de remédios, de produtos ou de lugares que um agente de voz de suporte precisa acertar.
De todas as reclamações que vi, a do controle Speed ausente foi a mais comum. Um criador escreveu que o v4 "does seem to be speaking much faster (there isn't a slider in the voice settings to control that)" no mesmo tópico do Reddit, e o moderador do subreddit repassou como feedback. Até isso mudar, o ritmo é algo que você resolve na escrita, com frases mais curtas e tags de pausa explícitas.
Quanto custa o Eleven v4?
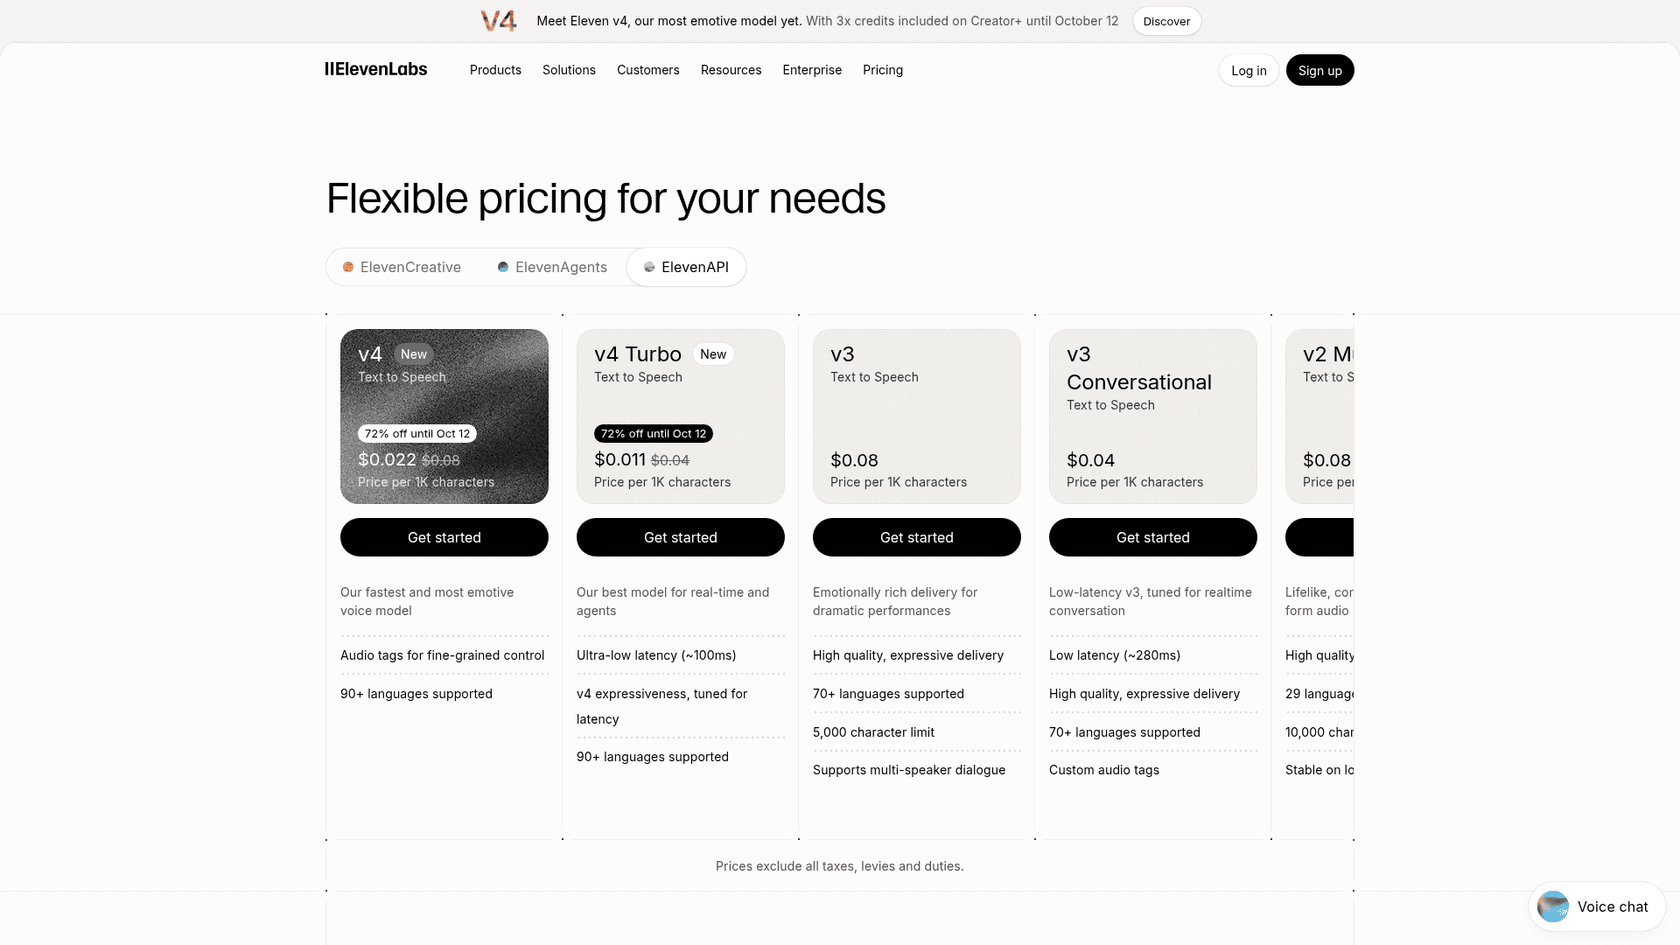
No preço de tabela da API, o Eleven v4 custa o mesmo que o v3, e o Turbo equivale ao v3 Conversational. Por ora também há um desconto de lançamento de 72% até 12 de outubro de 2026, segundo a página de preços da API.
| Modelo | Preço de tabela por 1.000 caracteres | Preço de lançamento (até 12 out.) | Latência | Limite de caracteres |
|---|---|---|---|---|
| Eleven v4 | US$ 0,08 | US$ 0,022 | Não é tempo real | 10.000 |
| Eleven v4 Turbo | US$ 0,04 | US$ 0,011 | ~100 ms | Streaming |
| Eleven v3 | US$ 0,08 | n/a | Não é tempo real | 5.000 |
| Eleven v3 Conversational | US$ 0,04 | n/a | ~280 ms | Streaming |
| Flash v2.5 | US$ 0,04 | n/a | ~75 ms | 40.000 |
No app web, o v4 consome do mesmo pool mensal de créditos que todo o resto. Os planos atuais na página de preços do ElevenCreative são Free (US$ 0, 10.000 créditos), Starter (US$ 6, 30.000), Creator (US$ 22, 121.000), Pro (US$ 99, 600.000), Scale (US$ 299, 1,8 M) e Business (US$ 990, 6 M). As perguntas frequentes de preços colocam o Text to Speech em cerca de 1 crédito por caractere. Há também uma promoção de lançamento para planos Creator e superiores em que o uso do v4 até 2x os seus créditos mensais de TTS não conta contra o seu saldo nos apps web e mobile. Curiosamente, o banner e a seção da promoção nessa página discordam se é 2x ou 3x, então eu conferiria o seu próprio saldo antes de planejar com base nisso. Meu guia de preços da ElevenLabs percorre cada nível, e o post de avaliações da ElevenLabs mostra o que os usuários pagantes dizem sobre o sistema de créditos.
Um exemplo prático. Um usuário do Reddit perguntou quanto custaria um audiolivro de 8 horas, então aqui está a conta. A documentação estima 10.000 caracteres em cerca de 10 minutos de áudio, o que dá 8 horas em aproximadamente 480.000 caracteres:
- Eleven v4 na API no preço de tabela: 480 × US$ 0,08 = US$ 38,40
- Eleven v4 no preço de lançamento: 480 × US$ 0,022 = US$ 10,56
- Eleven v4 Turbo no preço de tabela: 480 × US$ 0,04 = US$ 19,20
- No app: cerca de 480.000 créditos, que cabem nos 600.000 do plano Pro por US$ 99/mês.
Agentes de voz não são cobrados por caractere. Os preços do ElevenAgents funcionam por minuto de chamada, com planos do Free (15 minutos) ao Business (US$ 990 por 12.375 minutos), minutos extras a US$ 0,08 cada e o LLM cobrado à parte. Detalhei a mesma conta no resumo dos melhores agentes de voz com IA.
Você deveria colocar o Eleven v4 Turbo na sua linha de suporte?

A ElevenLabs claramente mira o Turbo no atendimento ao cliente. O post de lançamento do ElevenAgents fala de agentes que soam "apologetic about a missed delivery, brisk when someone just wants a confirmation", e a equipe do Agentforce Voice da Salesforce é citada na página do v4 elogiando as "faster, more natural responses" do Turbo.
Ele chega também num mês movimentado: o GPT-Live-1 da OpenAI, o Grok Voice Think Fast 2 da xAI e o Decagon Voice 3 miram nas mesmas chamadas de suporte.
A Salesforce também tem sua própria história com o agente de voz com IA. Para quem liga, é uma melhoria real, já que um bot monótono lendo uma política de reembolso é parte do motivo de as pessoas apertarem o zero para falar com um humano. O que um lançamento de TTS não resolve é a resposta em si. A voz lê o que o agente produziu, e uma voz lindamente compreensiva confirmando o prazo de reembolso errado continua errada, só que agora soa mais convincente.
Anos observando IA em filas de suporte reais apontam a mesma lição. A precisão vem do que o agente sabe (sua central de ajuda, macros e tickets anteriores) e de testá-lo antes que os clientes o façam, e por isso toda implantação da eesel é simulada primeiro com tickets históricos. Se você está avaliando plataformas de voz, meus guias de agentes de IA para call center, Retell AI e Vapi comparam como cada uma lida com conhecimento e transferência, além das integrações com helpdesk.
Meu resumo de suporte por voz coloca todas lado a lado.
A voz também é uma fatia menor do suporte do que parece. A maioria das equipes ainda recebe a maior parte do volume por tickets e chat, então é ali que os problemas de qualidade da resposta aparecem primeiro. Se você já usa o Zendesk, os agentes de IA de voz dele e uma camada de atendimento ao cliente com IA para a fila de tickets podem compartilhar o mesmo conhecimento.
Experimente a eesel para as respostas por trás da voz
A eesel é uma plataforma de colegas de IA, e o colega de IA para helpdesk é o criado exatamente para esse problema. Ele entra na sua fila existente do Zendesk, Freshdesk ou Gorgias, aprende com seus tickets anteriores e com a central de ajuda, e redige ou envia respostas no tom da sua equipe. Antes de tocar num cliente real, você pode rodá-lo em simulação sobre os seus tickets históricos para ver o que ele teria dito.
Para ser honesto sobre o escopo: hoje a eesel é voltada a texto, trabalha com tickets e chat, não com áudio de telefone. Uma equipe de suporte que usa a eesel me disse que o suporte a gravação de voz "would significantly increase our usage", e por isso está no radar. Se você combinar uma plataforma de voz com o Eleven v4 Turbo, a eesel cobre o lado dos tickets do mesmo conhecimento, e a CLI da eesel (mais neste guia de CLI para agentes de IA) permite que um script ou um agente de programação como o Claude Code atualize esse conhecimento e teste respostas pelo terminal, mantendo os dois canais sincronizados. Os planos começam grátis com 100 créditos na página de preços, e cada ticket ou chat atendido consome um crédito.
Experimente a eesel e veja como ela lida com os tickets do mês passado antes de decidir qualquer coisa.
Perguntas frequentes
O que é o Eleven v4?
eleven_v4 para conteúdo e eleven_v4_turbo para uso em tempo real, cobre mais de 90 idiomas e traz de volta o suporte a Professional Voice Clone que o v3 não tinha.