

O Qwen 4 Max vale alguns dias de uso prático na sua ferramenta de código, e nada mais por enquanto. A preview (qwen4-max-preview) tem 1M de tokens de contexto e 393.216 de saída máxima, mas a Alibaba não publicou benchmarks nem preço por token. Ele só roda na assinatura Token Plan, que proíbe backends de app, e é retirado em 25 de novembro de 2026. Teste enquanto os créditos custam 20% da taxa padrão. Construa sobre o Qwen 3.8 Max em vez disso. Para trabalho de suporte, um agente de helpdesk como a eesel roda em modelos estáveis, e com o CLI da eesel um agente de código pode carregar seus artigos de ajuda e testar respostas antes de qualquer coisa ir ao ar.
O que é o Qwen 4 Max?
O Qwen 4 Max é o primeiro modelo da geração Qwen 4 da Alibaba, e por agora existe só como preview. A documentação do modelo da Alibaba chama o qwen4-max-preview de "o modelo multimodal principal de próxima geração da família Qwen", feito para código, trabalho de escritório, design de frontend e tarefas de agentes.
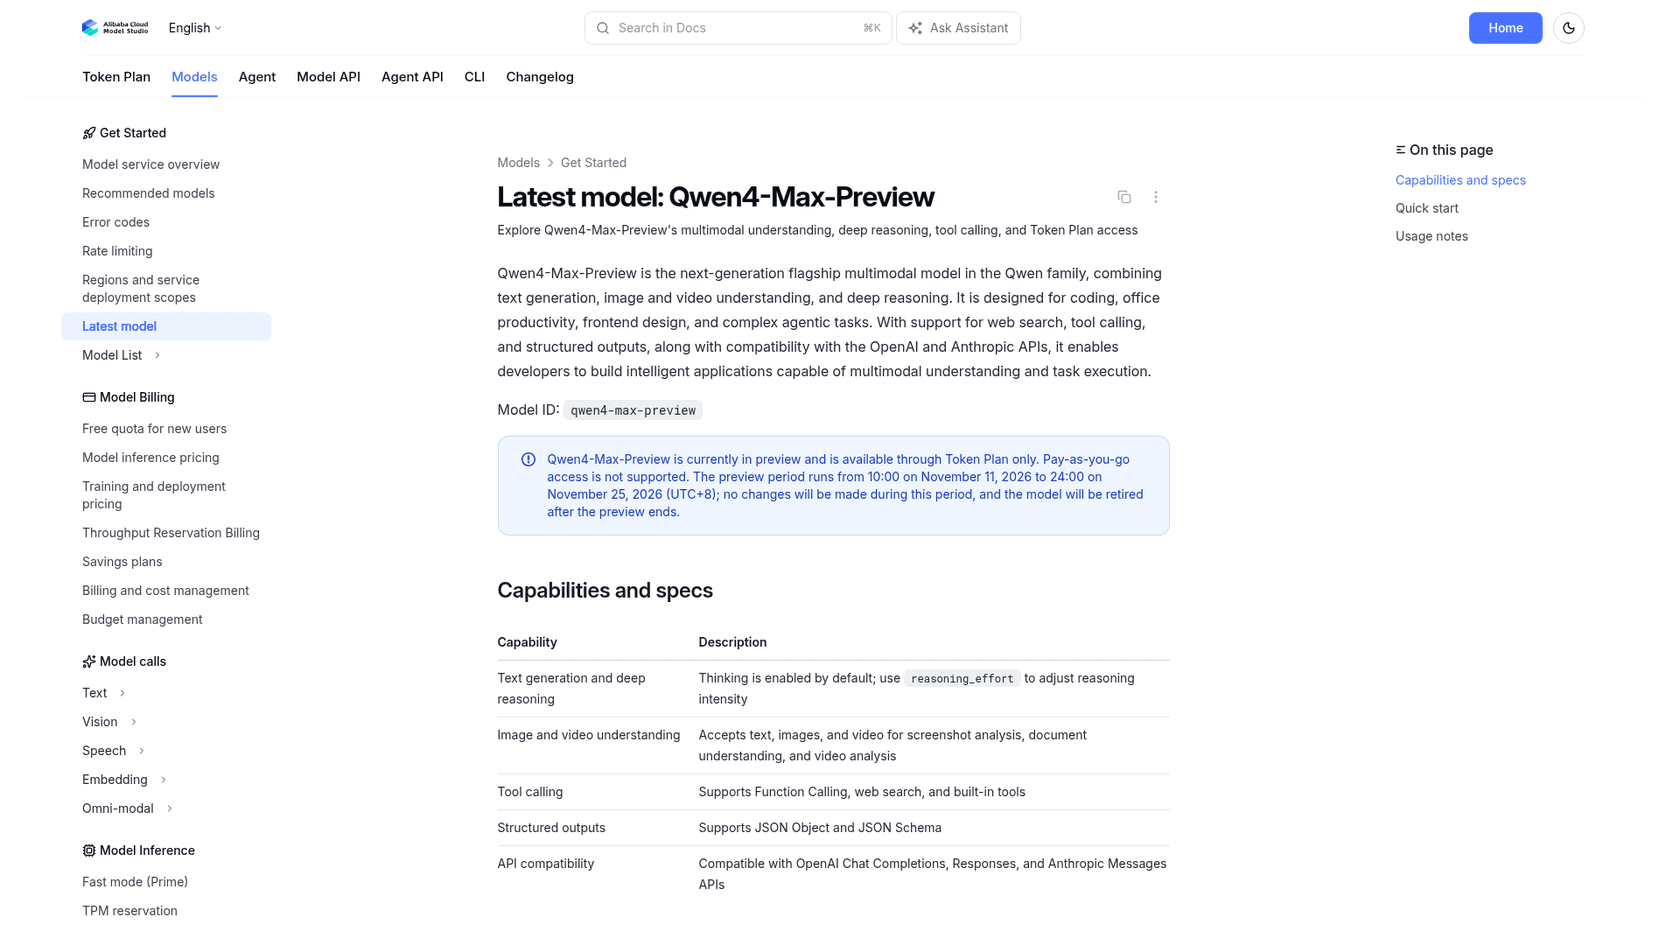
Foi ao ar em 11 de novembro de 2026 às 10h00 horário de Pequim. Veja o que a documentação confirma:
| Especificação | Qwen4-Max-Preview |
|---|---|
| ID do modelo | qwen4-max-preview (alias qwen4.0-max-preview) |
| Entrada | Texto, imagens e vídeo |
| Tamanho do contexto | 1M de tokens |
| Saída máxima | 393.216 tokens, compartilhados entre pensamento e resposta |
| Pensamento | Ativado por padrão, low, medium ou xhigh (padrão) |
| Ferramentas | Chamada de funções, busca na web, ferramentas integradas |
| Saída estruturada | JSON Object e JSON Schema |
| Formatos de API | OpenAI Chat Completions, Responses, Anthropic Messages |
| Acesso | Só Token Plan, sem pagamento por uso |
| Janela de preview | De 11 a 25 de nov. de 2026 (UTC+8), depois retirado |
Parte do meu trabalho é verificar o que um lançamento realmente promete antes de alguém construir sobre ele. Então, antes de falar de como o modelo parece na prática, aqui está o que falta. Ao lado do lançamento do Qwen 3.8 Max, este é bem mais magro.
O que a Alibaba deixou de fora?
A Alibaba publicou capacidades e limites, mas não os números que normalmente se usam para julgar um modelo. A página de documentação não tem tabela de benchmarks. Não há contagem de parâmetros, não há model card, não há pesos abertos e não há preço por token. Quando verifiquei em 12 de novembro, o Qwen 4 Max também não tinha página na Artificial Analysis, enquanto o Qwen 3.8 Max está nesse ranking.
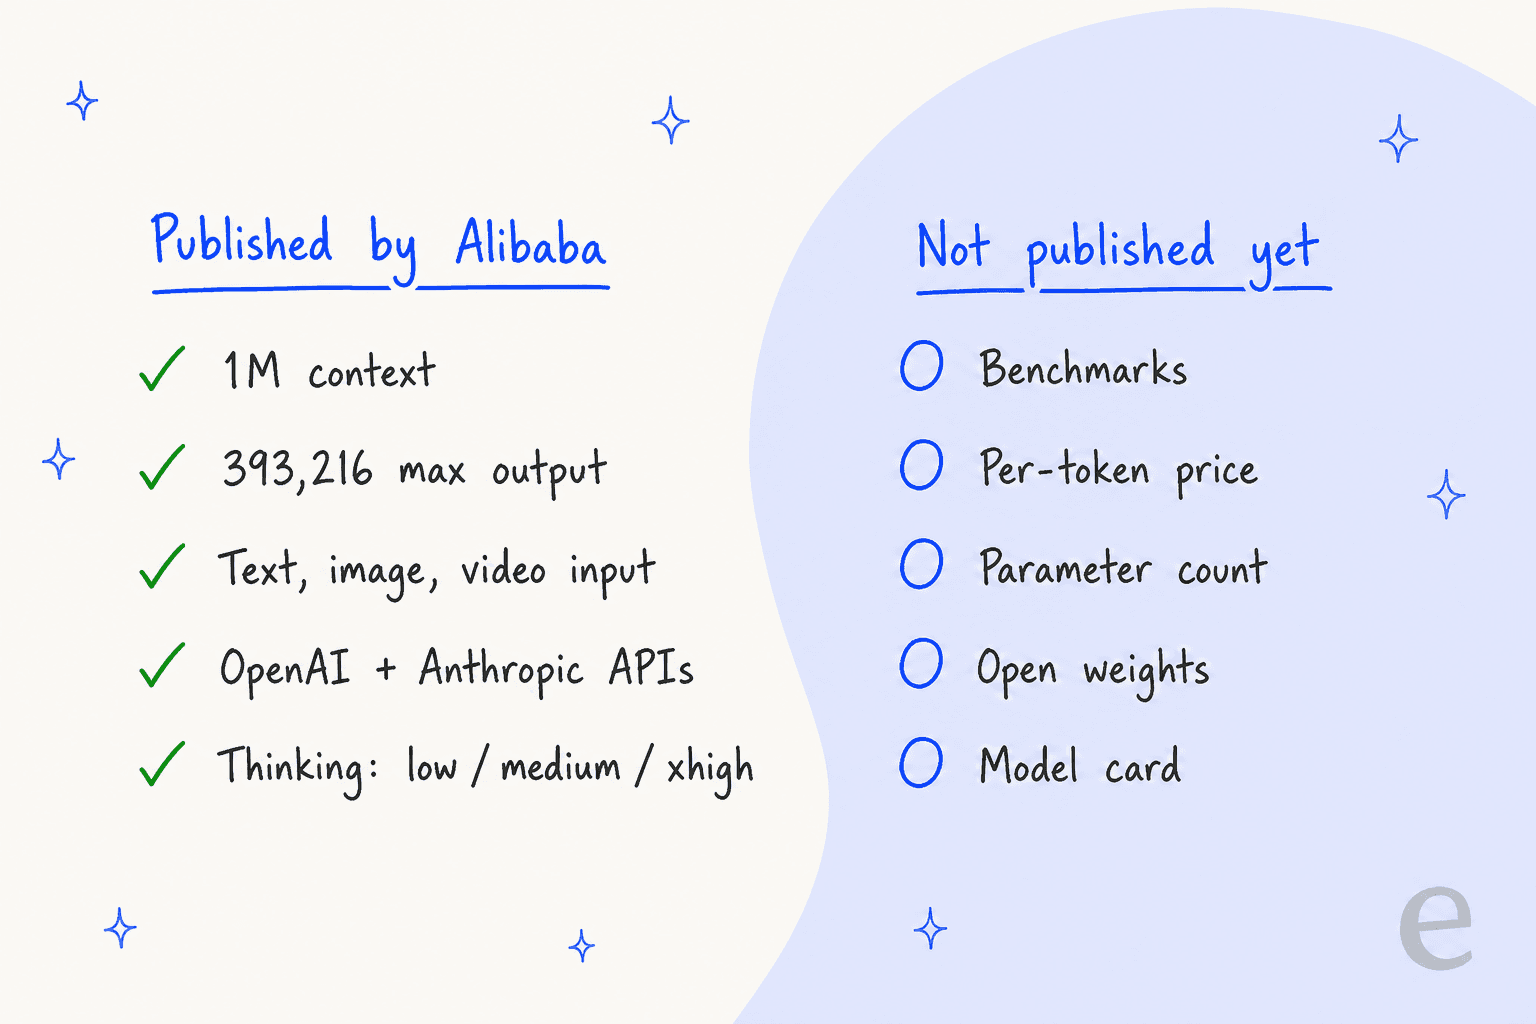
Então qualquer gráfico "Qwen 4 Max tira X" que você veja essa semana vem de um terceiro testando a preview, não da Alibaba. Isso não é condenável, previews costumam sair assim. Mas significa que uma análise hoje é uma análise dos termos de acesso, não da inteligência. A thread de lançamento no Hacker News disse exatamente isso:
"No benchmarks yet. The smaller Qwen models are extremely popular for people running things locally, yet I don't know absolutely anyone running Qwen Max."

Essa segunda frase também importa. Os modelos Qwen que as pessoas amam são os pequenos e abertos, como o Qwen 3.8 Flash Next e o de 27B. O nível Max é só hospedado, e essa preview não muda isso.
Como conseguir acesso, e quanto custa?
Você consegue o Qwen 4 Max pelo Token Plan da Alibaba, uma assinatura mensal paga em créditos. Não há opção de pagamento por uso para a preview. Os preços da Personal Edition vêm da documentação do Token Plan da Alibaba:
| Plano | Preço de tabela | Preço para novo usuário | Créditos mensais | Agentes simultâneos |
|---|---|---|---|---|
| Lite | 6 $/mês | 3 $/mês | 20.000 | 1-2 |
| Essential | 10 $/mês | 5 $/mês | 45.000 | 2-3 |
| Standard | 18 $/mês | - | 80.000 | 3-4 |
| Pro | 43 $/mês | - | 200.000 | 6-8 |
O preço para novo usuário vale até 30 de novembro de 2026 para contas que nunca compraram uma assinatura Personal. Pacotes extras custam 15 $ por 20.000 créditos, e você pode guardar até cinco. A Personal Edition é só para a região de Singapura, e a inferência roda no deployment Global da Alibaba, então seus prompts cruzam fronteiras.
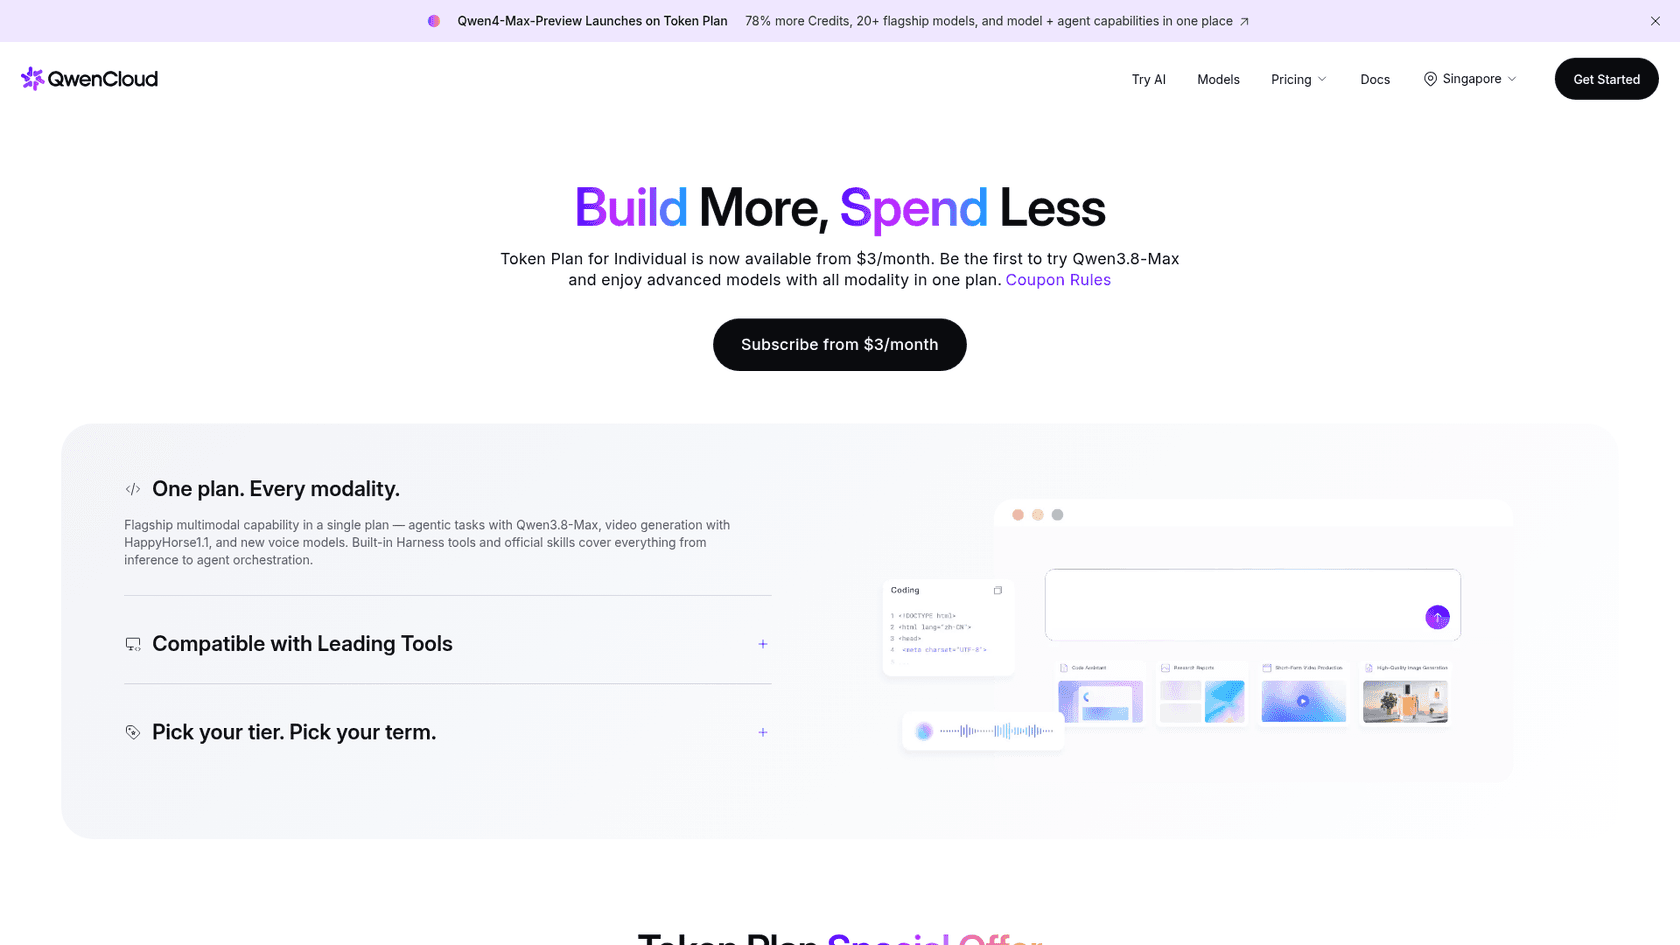
Aqui está a armadilha para quem tenta comparar custos. A Alibaba diz que os créditos por requisição são "determinados dinamicamente pelo tipo de modelo, uso de tokens, modo de pensamento e chamadas de ferramentas", e não publica uma taxa de créditos por token para o Qwen 4 Max. Você descobre quanto custa uma chamada na página de uso do console, depois de fazê-la. Então não dá para calcular o preço de um trabalho com antecedência como dá com o Qwen 3.8 Max, que lista 2 $ de entrada e 6 $ de saída por 1M de tokens na sua página de modelo da QwenCloud.
O desconto da preview, e por que "a noite" é o seu dia de trabalho
Durante a preview, o Qwen 4 Max consome créditos a 20% da taxa padrão. Entre 22h00 e 08h00 horário de Pequim, você ganha outros 60% de desconto, ou seja, 8% da taxa padrão.
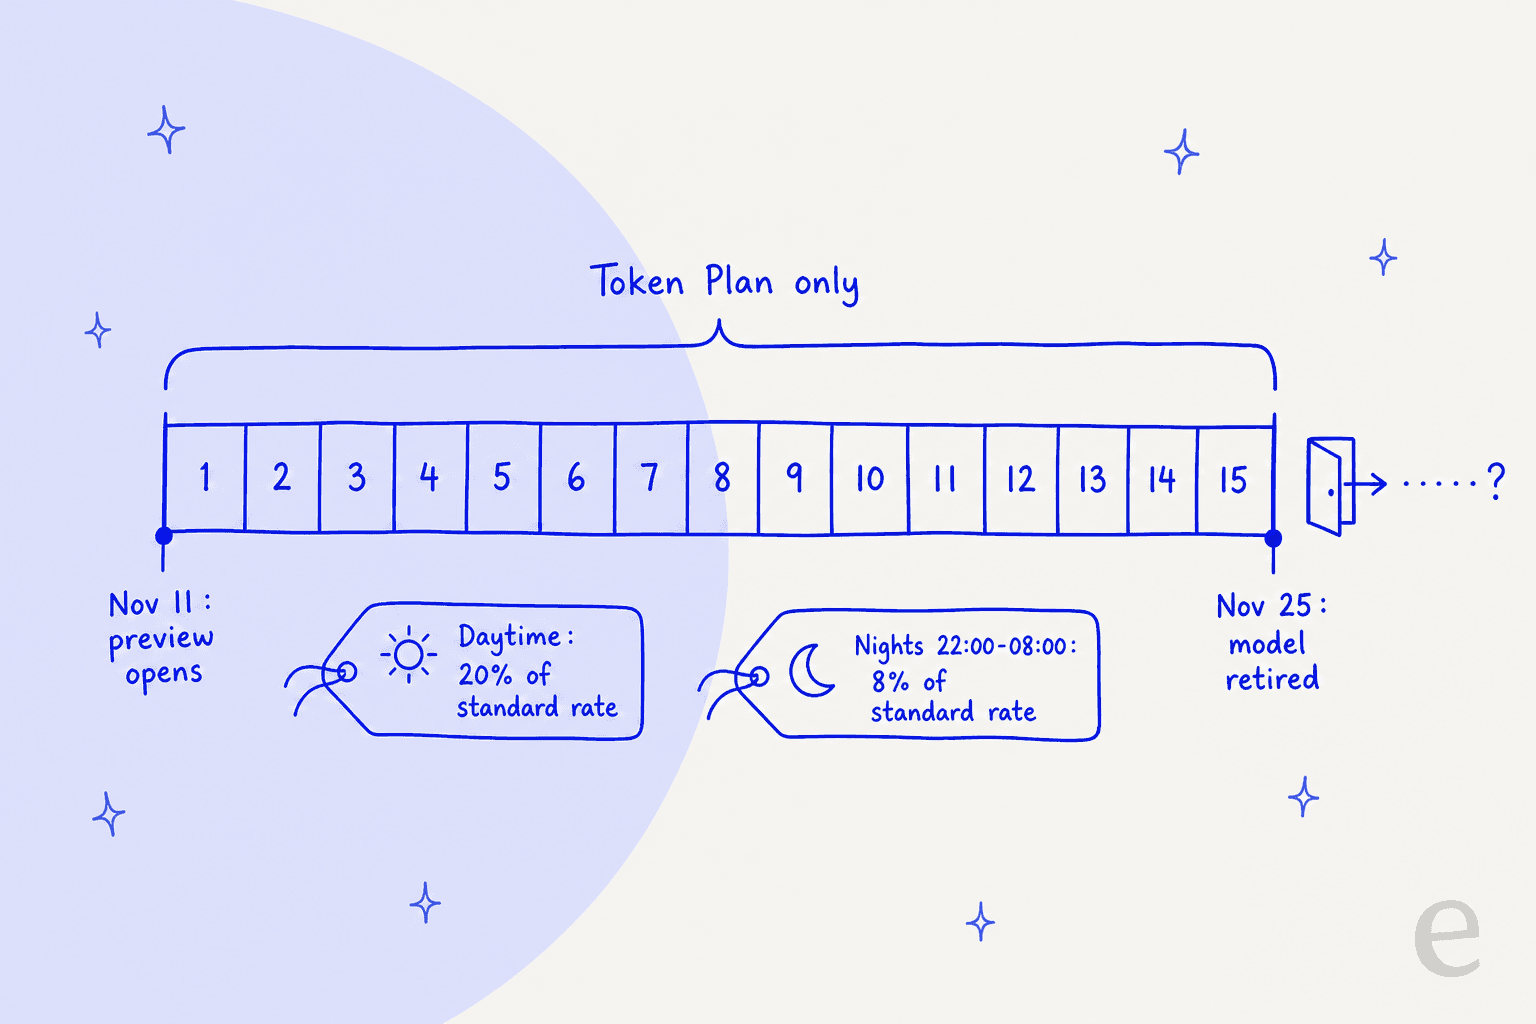
O detalhe que quase todo mundo perde: das 22h00 às 08h00 em Pequim é das 14h00 às 00h00 UTC. Isso é das 9h às 19h na costa leste dos EUA. Se você está nas Américas, a taxa mais barata cobre todo o seu dia de trabalho. Um testador inicial no Hacker News fez o mesmo comentário:
"By November 25th, Beijing time daytime (8am-22pm) -80%, and at night (Western daytime) even -92%!"
É possível construir sobre o Qwen 4 Max?
Não, e esta é a parte da análise que mais importa se você toca um produto ou uma equipe de suporte. Dois pontos descartam isso.
Primeiro, o modelo é temporário. A documentação da Alibaba diz que "nenhuma mudança será feita durante esse período, e o modelo será retirado após o fim da preview". Tudo o que você construir sobre o qwen4-max-preview para de funcionar depois de 25 de novembro.
Segundo, o Token Plan proíbe justamente o uso que você precisaria. Os termos da assinatura dizem que o plano é "destinado apenas a uso interativo dentro de ferramentas de código e de agentes", e que "não deve ser usado para scripts de automação, backends de aplicações próprias, ou qualquer cenário de chamadas em lote não interativas". Chamadas fora desse escopo podem suspender a assinatura ou banir a chave de API.
Então um chatbot de suporte, um classificador de tickets ou qualquer API de atendimento ao cliente com IA ligada a essa chave quebraria as regras no primeiro dia. O que o plano permite é usar o modelo dentro do Claude Code, Cursor, Qwen Code, OpenAI Codex, Cline, OpenCode ou OpenClaw, todos listados como ferramentas suportadas.
Vale tocar no Qwen 4 Max esta semana?
Abra a opção que mais se parece com você.
Eu codo no Claude Code, Cursor ou Qwen Code todos os dias
Sim. Um plano Lite de 3 a 6 $ te dá duas semanas com 1M de contexto a 20% da taxa padrão de créditos. Teste em uma tarefa real cuja resposta você já conhece, e compare com o seu modelo de costume.
Quero colocar atrás do meu app ou de um bot de suporte
Não. O Token Plan proíbe backends de app, e o modelo é retirado em 25 de novembro. Use agora um modelo de pagamento por uso como o Qwen 3.8 Max, e olhe o Qwen 4 Max de novo quando sair uma versão completa com preço.
Estou escolhendo um modelo para o roadmap da minha empresa
Espere. Sem benchmarks ou uma tabela de tarifas não há nada para colocar em um modelo de custo. Anote o limite de saída de 393.216 tokens e o novo comportamento de max_tokens, e volte quando a Alibaba publicar números.
Eu rodo modelos Qwen auto-hospedados
Pule esta. Não há pesos abertos para a preview. O que vale observar são os modelos Qwen 4 menores, porque são esses que costumam chegar ao Hugging Face.
O que mudou para os desenvolvedores?
Há duas mudanças técnicas que vale a pena conhecer antes de apontar uma ferramenta para ele.
A maior é como o max_tokens funciona. A partir do qwen4-max-preview, o aviso de compatibilidade da Alibaba diz que max_tokens agora equivale a max_completion_tokens, limitando o pensamento e a resposta final juntos. O pensamento vem ativado por padrão em xhigh. Se a sua configuração dimensionou max_tokens só para a resposta, um raciocínio longo pode consumir o orçamento e cortar sua resposta. Modelos Qwen mais antigos mantêm o comportamento antigo, então isso pega ao trocar.
A segunda é o pensamento em múltiplos turnos. O Chat Completions ativa preserve_thinking por padrão, e a documentação pede para enviar o pensamento anterior de volta no campo reasoning_content, não colado dentro de content. Ferramentas construídas para os formatos da Anthropic ou da OpenAI podem não fazer isso automaticamente, o que vale a pena checar se sessões longas de agentes derem problema.
O próprio teto de saída é um salto real: 393.216 tokens, três vezes os 131.072 do Qwen 3.8 Max. Para geração de código longa ou grandes refatorações em uma única passada, essa é a especificação que eu testaria primeiro.
Como é usar na prática?
Os primeiros relatos são mistos e principalmente sobre velocidade, o que combina com um modelo cujo pensamento vem em xhigh por padrão. O testador do Hacker News citado acima disse que "com xhigh thinking a velocidade está ok, parece um pouco mais lento que o Terra", referindo-se ao GPT-6.1 Terra da OpenAI. No X, o lançamento tomou um rumo mais cético em poucas horas:
"Qwen-4-max is live it seems. From what I've heard so far (rumors), Qwen 4 is disappointing."
Note a palavra "rumors" (rumores). Uma resposta sob esse post rebateu com uso real:
"It's preview; Qwen4-max-preview. It's not disappointing at all, at least so far in my one-shots, but more testing is going on and i'll have a clear answer."
Os dois são precoces, e nenhum é um benchmark. Minha leitura honesta: fora da Alibaba, ninguém ainda sabe o quão bom é o Qwen 4 Max, e a janela de 14 dias mais o "sem mudanças durante a preview" significa que o modelo que você testa está congelado. Se for testar, teste no seu próprio trabalho, com uma tarefa que você já resolveu com o Claude Fable 5.2 ou o GPT-6.1 Sol, para ter algo real com que comparar.
Como ele se compara com outros modelos?
Veja como a preview se posiciona ao lado dos modelos com os quais as pessoas realmente vão compará-la. Os preços são da página de cada fornecedor, e marquei o que não está publicado.
| Modelo | Status | Preço | Saída máxima | Notas independentes |
|---|---|---|---|---|
| Qwen 4 Max preview | Preview, retirado em 25 de nov. | Só créditos do Token Plan | 393.216 | Nenhuma ainda |
| Qwen 3.8 Max | Lançado | 2 $ / 6 $ por 1M | 131.072 | Sim |
| Kimi K3 | Lançado | Preços do Kimi K3 | Ver fornecedor | Sim |
| DeepSeek V4.1 Flash | Lançado, também no Token Plan | Preços do DeepSeek V4.1 Flash | Ver fornecedor | Sim |
| GLM 5.3 Flash | Lançado | Preços do GLM 5.3 Flash | Ver fornecedor | Sim |
A tabela diz o que o resto desta análise diz. Cada outra linha é algo que você pode calcular e verificar. O Qwen 4 Max é o único que você só pode testar.
O que isso significa para uma equipe de suporte?
Para uma equipe de suporte, o Qwen 4 Max é um modelo para observar, não um para conectar no seu helpdesk. A pergunta que surge em toda semana de lançamento é se vale trocar o bot de suporte pelo modelo novo. Com este, a resposta é fácil, porque as regras e a data de retirada decidem por você.
Mas o ponto maior vale para todo lançamento. Um modelo bruto, não importa quão forte seja, não é um agente de suporte. O agente é tudo o que está em volta dele: sua central de ajuda, tickets passados, macros, as regras de quando transferir para uma pessoa, e testes antes de qualquer coisa chegar a um cliente. Essa é a camada que o colega de equipe de IA da eesel para o helpdesk é feito para ser. Ele entra na sua fila existente no Zendesk ou no Freshdesk, aprende com seus tickets passados, e é simulado contra conversas históricas antes de responder a alguém.
Dois dos nossos clientes mostram como isso é na prática:
- A smava, um site alemão de comparação de empréstimos, roda a eesel no Zendesk em duas marcas. Em um mês, ela tratou 27.000 tickets, categorizou 14.600 e preparou 15.300 rascunhos de resposta em alemão, a partir de 820 macros e artigos de central de ajuda sincronizados.
- A SamCart roda um agente nos tickets do Freshdesk e outro no chat do site, respondendo a partir de 280 artigos da central de ajuda.
Nenhuma dessas configurações depende de o modelo da semana ganhar um ranking. Se você quer ver o que um modelo consegue fazer com o seu próprio conteúdo de suporte, meus guias sobre conectar o Claude ao seu helpdesk e parar alucinações de IA no suporte são um uso melhor da tarde do que uma preview que é retirada em duas semanas.
Meu veredito sobre o Qwen 4 Max
A preview do Qwen 4 Max é um teste, não um produto. As especificações confirmadas são fortes, especialmente o teto de saída de 393.216 tokens, e o desconto da preview torna um teste de duas semanas barato. Mas sem benchmarks, sem preço por token, com uma proibição de uso em backend e um corte duro em 25 de novembro, ainda não há nada aqui para construir.
Teste se você vive em um agente de código e quer testar um Qwen de contexto longo a 20% (ou 8%) da taxa de créditos. Pule se você precisa de um modelo para um app, um bot de suporte ou um modelo de custo. Use agora o Qwen 3.8 Max, e volte quando a Alibaba lançar a versão completa.
Teste a eesel para um suporte que não espera lançamentos de modelo
Se o seu objetivo real é responder clientes mais rápido, a eesel é um colega de equipe de IA para o helpdesk que se conecta ao helpdesk que você já usa, aprende com seus tickets passados e sua central de ajuda, e é testada em conversas históricas antes de tocar em uma real. A smava a usa para redigir respostas em alemão em 27.000 tickets do Zendesk por mês. Você pode ver os preços ou testar a eesel de graça.
Perguntas frequentes
O Qwen 4 Max já está disponível?
qwen4-max-preview (alias qwen4.0-max-preview), aberto em 11 de novembro de 2026 às 10h00 horário de Pequim. A Alibaba diz que a preview roda até 25 de novembro de 2026, depois o modelo é retirado. Um lançamento completo do Qwen 4 Max ainda não foi anunciado. Para o modelo em que ele se baseia, veja minha análise do Qwen 3.8 Max.Quanto custa o Qwen 4 Max?
Existem benchmarks do Qwen 4 Max?
Posso usar a API do Qwen 4 Max no meu app?
Qual é a diferença entre o Qwen 4 Max e o Qwen 3.8 Max?
max_tokens agora limita o pensamento e a resposta juntos. Veja meu detalhamento de preços do Qwen 3.8 Max.O Qwen 4 Max funciona com o Claude Code?
qwen4-max-preview. Meu guia de seleção de modelo no Claude Code explica como funciona a troca de modelo.