

O Qwen 4 Max é o próximo modelo carro-chefe da Alibaba, e hoje você só consegue acessá-lo como qwen4-max-preview na assinatura Token Plan, a partir de $3 por mês para novos usuários, até 25 de novembro de 2026. É um modelo de raciocínio multimodal com contexto de 1M e saída máxima de 393.216 tokens. A configuração é onde a maioria tropeça: a própria config do Claude Code da Alibaba coloca o Qwen 4 Max no slot do Opus e o roteador auto no slot principal, então talvez você não esteja chamando o Qwen 4 Max a menos que escolha o Opus. Para IA nos tickets de suporte, a eesel roda em modelos estáveis, e o CLI da eesel deixa um agente de código carregar artigos de ajuda e testar respostas antes de qualquer coisa.
O que é o Qwen 4 Max?
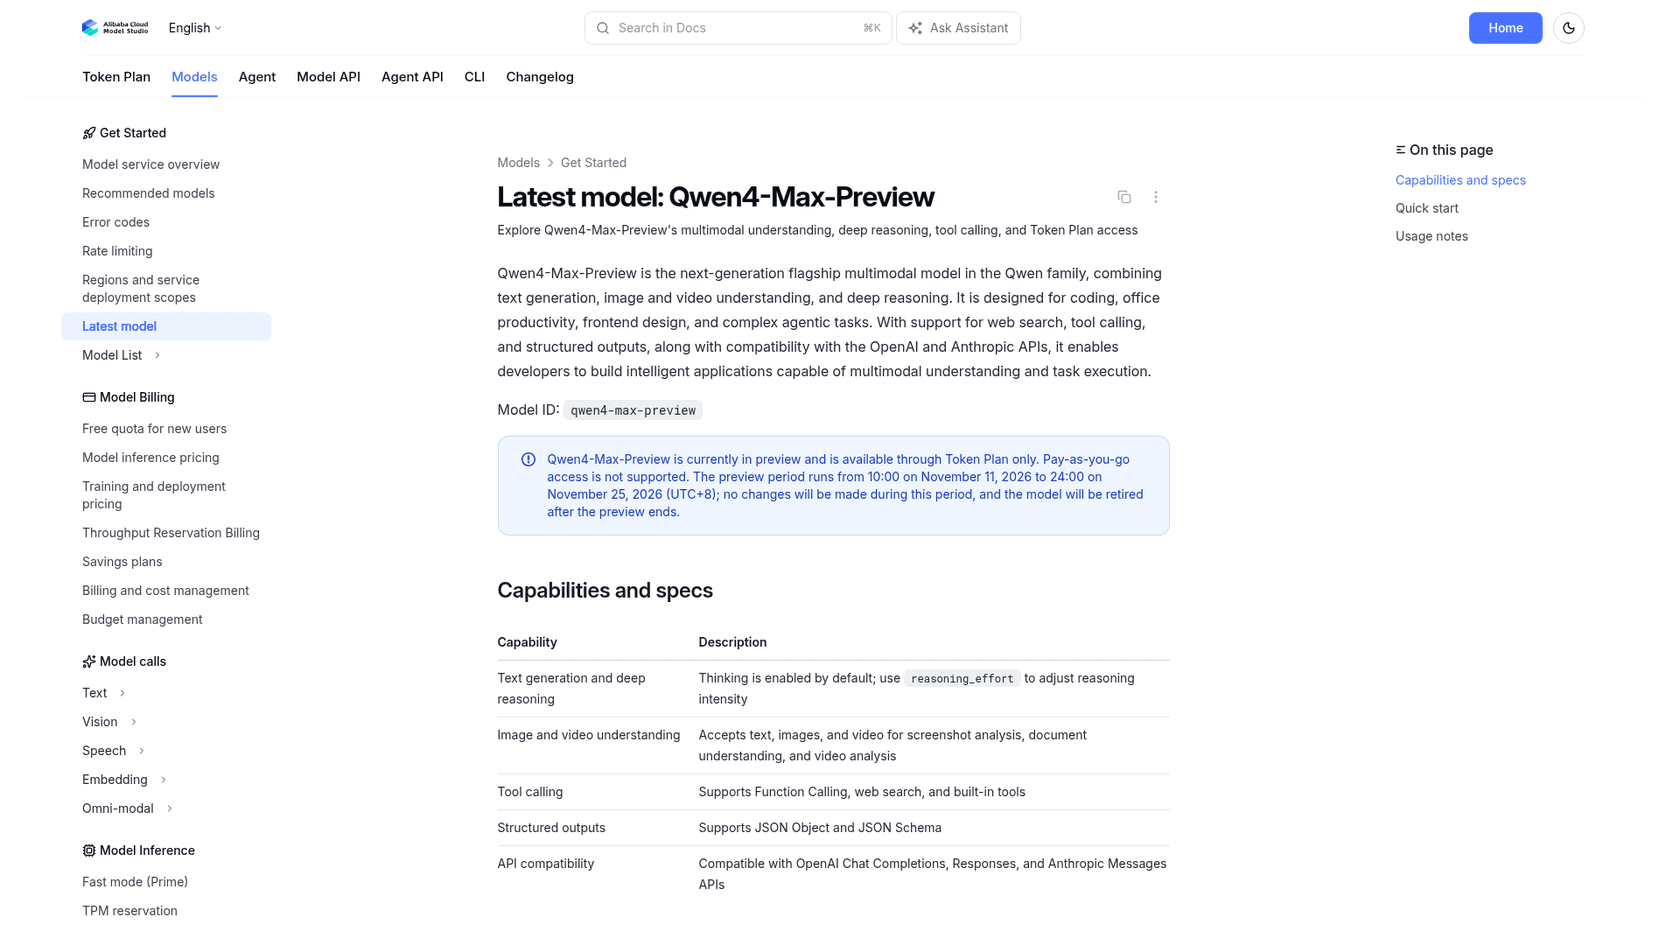
O Qwen 4 Max é o primeiro modelo da geração Qwen 4 da Alibaba, lançado em 11 de novembro de 2026 como uma prévia chamada qwen4-max-preview. A documentação do modelo da Alibaba o descreve como o modelo multimodal carro-chefe de nova geração da família Qwen, voltado para código, trabalho de escritório, design de frontend e tarefas de agentes.
Eu construo integrações como trabalho na eesel, então quando um modelo novo sai, minha primeira pergunta é chata: o que eu coloco na configuração, e o que quebra quando eu faço isso? Este post responde isso. Se você quer minha opinião sobre se o modelo é bom, ela está na análise do Qwen 4 Max do meu colega.
Aqui está tudo o que a Alibaba confirmou até agora:
| Especificação | Qwen 4 Max preview |
|---|---|
| ID do modelo | qwen4-max-preview (alias qwen4.0-max-preview, as faturas mostram o alias) |
| Entrada | Texto, imagens e vídeo |
| Tamanho de contexto | 1M de tokens |
| Saída máxima | 393.216 tokens, compartilhados entre o raciocínio e a resposta |
| Raciocínio | Ativado por padrão; low, medium ou xhigh (padrão) |
| Ferramentas | Function calling, busca na web, ferramentas integradas |
| Saída estruturada | JSON Object e JSON Schema |
| Formatos de API | OpenAI Chat Completions, Responses, Anthropic Messages |
| Acesso | só Token Plan, sem pagamento por uso |
| Disponibilidade | 11 de nov., 10h às 24h de 25 de nov., 2026 (UTC+8), depois desativado |
Não tem contagem de parâmetros, nem pesos abertos, nem ficha de modelo, nem tabela de benchmarks. Isso é normal para uma prévia de duas semanas, mas significa que é um modelo para testar, não um modelo para planejar em torno dele.
Onde o Qwen 4 Max fica na linha Qwen?
O Qwen 4 Max fica no topo da linha hospedada da Alibaba, um nível acima do Qwen 3.8 Max. A lista de modelos do Token Plan os coloca lado a lado, o que dá o retrato mais claro do que você realmente pode chamar hoje:
| ID do modelo no Token Plan | Para que a Alibaba o lista | Status |
|---|---|---|
qwen4-max-preview | Raciocínio, compreensão visual, texto | Prévia, desativado em 25 de nov. |
qwen3.8-max | Raciocínio, compreensão visual, texto | Lançado |
qwen3.8-flash | Raciocínio, compreensão visual, texto | Lançado |
qwen3.7-max | Raciocínio, texto | Lançado |
qwen3.7-plus | Raciocínio, compreensão visual, texto | Lançado |
qwen3.6-flash | Raciocínio, compreensão visual, texto | Lançado |
auto | Escolhe um modelo por requisição | Roteador da plataforma |
O mesmo plano também traz o DeepSeek V4.1 Flash, DeepSeek V4 Pro, GLM 5.3 e GLM 5.2, além de modelos de imagem, vídeo e voz. Então uma única assinatura te dá o Qwen 4 Max ao lado de um punhado de modelos para comparar na mesma tarefa, o que é o melhor uso da prévia.
O que falta é a parte que muita gente mais gosta no Qwen: os modelos menores que rodam localmente. O nível Max é só hospedado, e a prévia sai sem pesos abertos. Se você roda o Qwen no seu próprio hardware, os modelos Qwen 4 menores são os que vale observar, e o Qwen 3.8 Flash Next é a escolha atual enquanto isso.
Quanto custa o Qwen 4 Max?
Não existe preço por token para o Qwen 4 Max. Você paga uma assinatura Token Plan em créditos, e a Alibaba não publica a taxa de crédito padrão para uma chamada do Qwen 4 Max, só o desconto de prévia sobre ela. Os níveis da Personal Edition vêm da documentação do Token Plan:
| Plano | Preço de tabela | Preço para novo usuário | Créditos mensais | Agentes simultâneos |
|---|---|---|---|---|
| Lite | $6/mês | $3/mês | 20.000 | 1-2 |
| Essential | $10/mês | $5/mês | 45.000 | 2-3 |
| Standard | $18/mês | - | 80.000 | 3-4 |
| Pro | $43/mês | - | 200.000 | 6-8 |
O preço para novo usuário dura até 23h59 de 30 de novembro de 2026 (UTC+8), para contas que nunca compraram uma assinatura Personal. Pacotes extras custam $15 por 20.000 créditos, até cinco por vez. Durante a prévia, o Qwen 4 Max consome créditos a 20% da taxa padrão, e a 8% entre 22h e 8h horário de Pequim, o que corresponde ao horário de trabalho dos EUA.
Duas coisas nos termos valem a leitura antes de pagar. A Personal Edition não pode ser cancelada, então escolha o período mais curto. E créditos não usados não passam para o mês seguinte. Para um teste de duas semanas, o plano Lite de $3 é tudo que a maioria precisa. Se você quer um modelo com uma tabela de preços para planejar um orçamento, os preços do Qwen 3.8 Max são $2 de entrada e $6 de saída por 1M de tokens.
Como você consegue acesso ao Qwen 4 Max?
Você consegue acesso em três passos, segundo o guia de início rápido do Token Plan da Alibaba: assinar, gerar uma chave e apontar sua ferramenta para o endpoint certo.
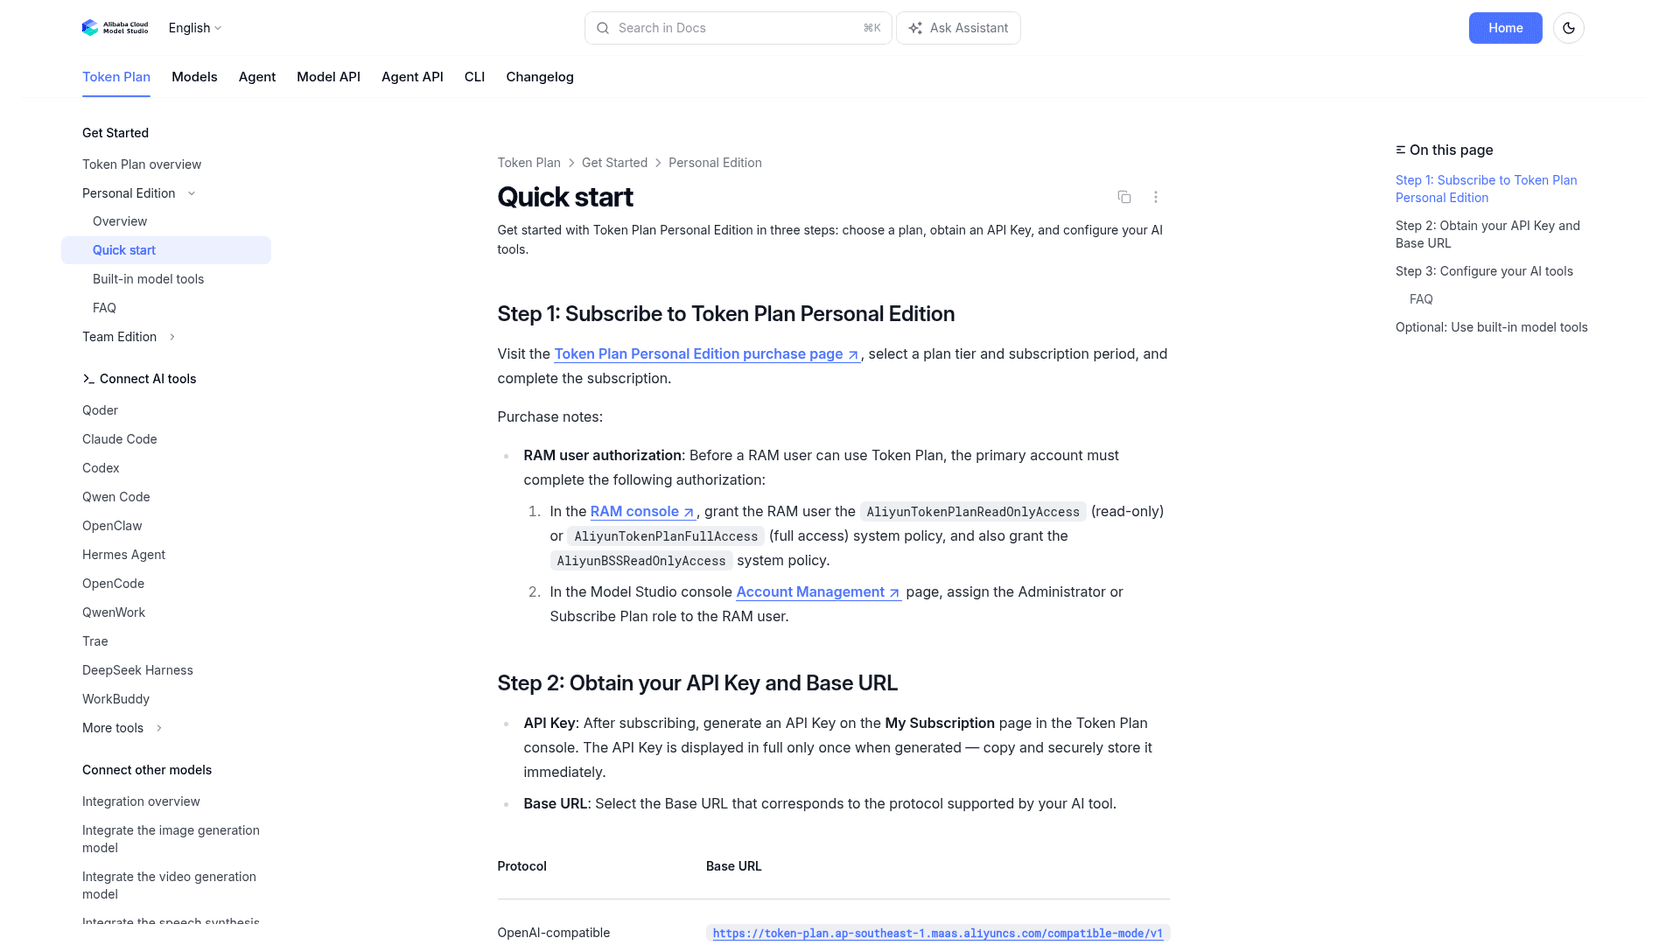
- Assine o Token Plan Personal (só região de Singapura) e escolha um nível.
- Gere uma chave de API na página My Subscription. Ela é mostrada por completo só uma vez, então copie na hora. As chaves do Token Plan começam com
sk-sp-. - Use a URL base do Token Plan para o protocolo da sua ferramenta:
| Protocolo | URL base |
|---|---|
| Compatível com OpenAI | https://token-plan.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1 |
| Compatível com Anthropic | https://token-plan.ap-southeast-1.maas.aliyuncs.com/apps/anthropic |
Depois defina o ID do modelo como qwen4-max-preview.
A chave e o endpoint precisam combinar
Esse é o erro que custa dinheiro de verdade. A Alibaba roda três canais de cobrança separados, Token Plan, Coding Plan e pagamento por uso, cada um com suas próprias chaves e URLs base. O FAQ do Token Plan diz que usar o endpoint geral dashscope-intl.aliyuncs.com ou uma chave do Coding Plan roteia as chamadas pelo pagamento por uso em vez disso, e essas cobranças não podem ser compensadas com créditos nem reembolsadas.
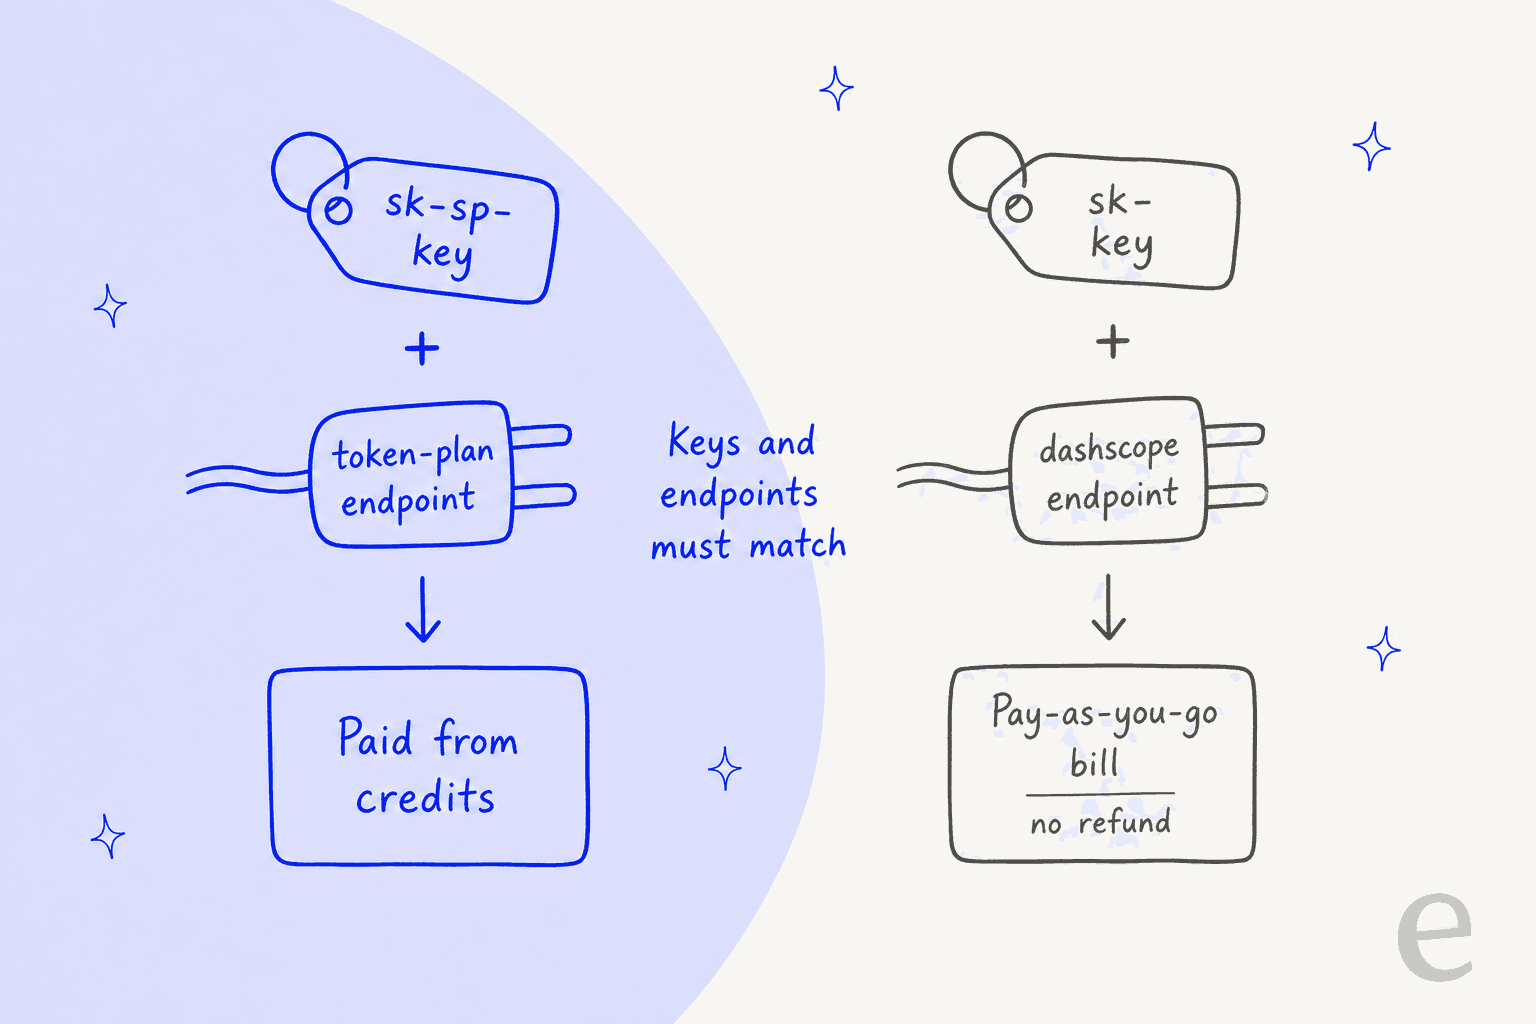
Se você já usou o Qwen pela Alibaba antes, a configuração da sua ferramenta provavelmente ainda tem uma chave sk- antiga e a URL do DashScope. Troque a chave, a URL e o nome do modelo.
Como você roda o Qwen 4 Max no Claude Code?
Você roda apontando o Claude Code para o endpoint Anthropic do Token Plan e associando um slot de modelo a qwen4-max-preview. O guia de Claude Code da Alibaba dá esta configuração para a CLI:
export ANTHROPIC_AUTH_TOKEN="YOUR_API_KEY"
export ANTHROPIC_BASE_URL="https://token-plan.ap-southeast-1.maas.aliyuncs.com/apps/anthropic"
export ANTHROPIC_MODEL="auto"
export ANTHROPIC_DEFAULT_HAIKU_MODEL="qwen3.6-flash"
export ANTHROPIC_DEFAULT_SONNET_MODEL="qwen3.8-flash"
export ANTHROPIC_DEFAULT_OPUS_MODEL="qwen4-max-preview"
export CLAUDE_CODE_SUBAGENT_MODEL="auto"
export CLAUDE_CODE_MAX_CONTEXT_TOKENS="983616"
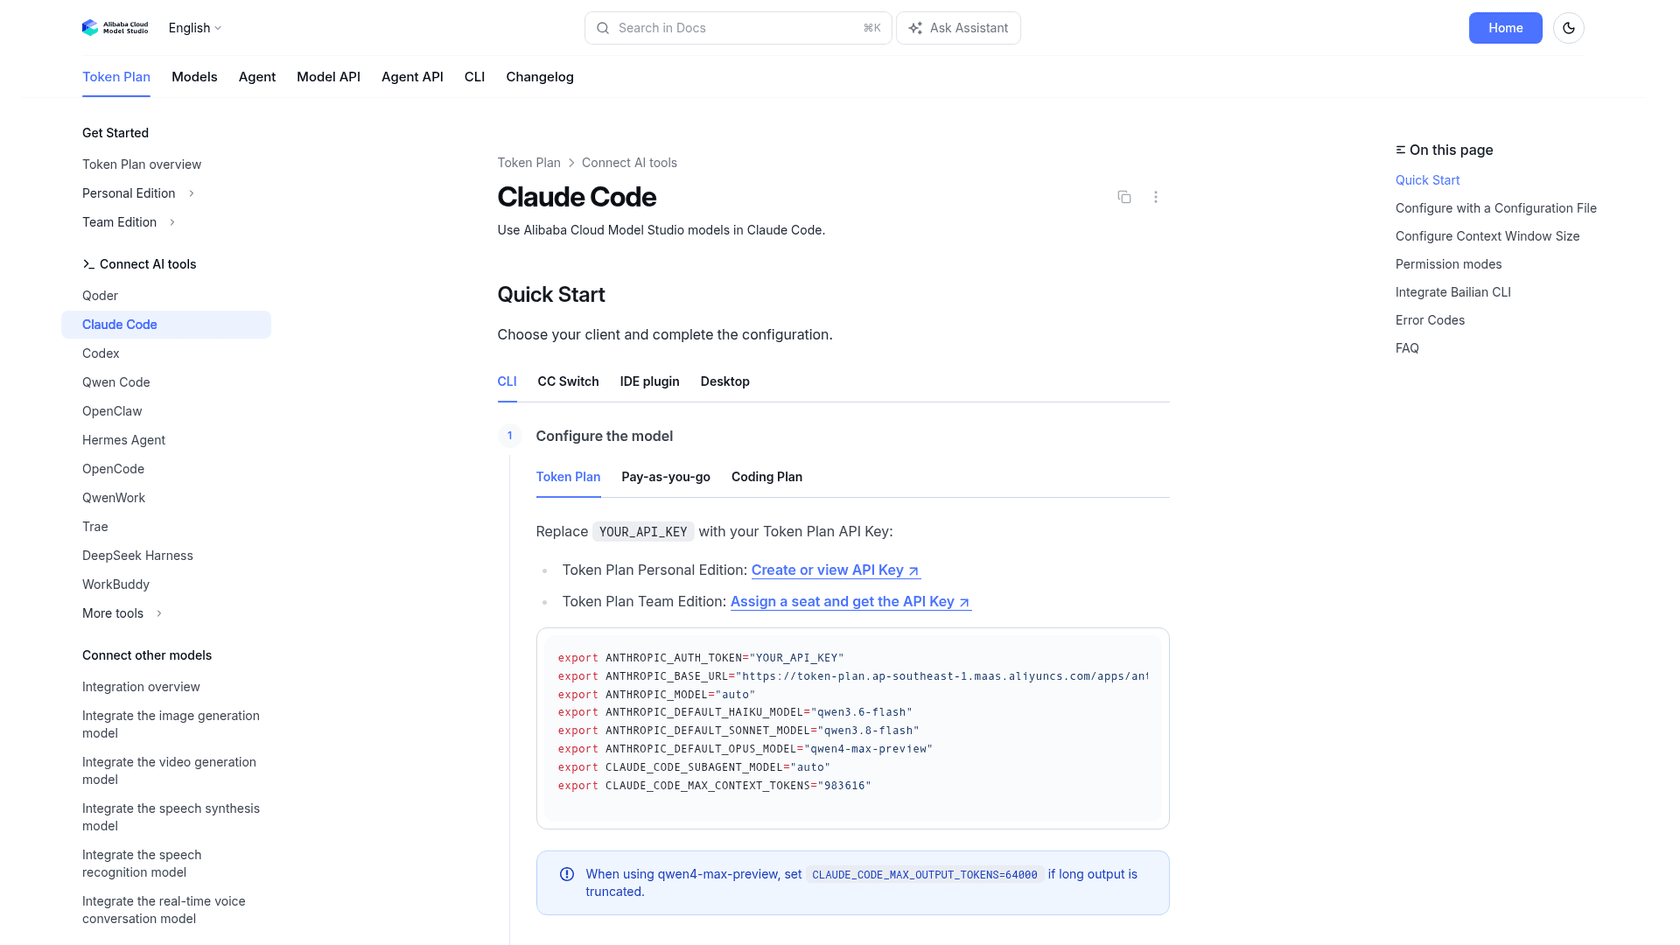
Leia esse bloco com atenção, porque ele não faz o que a maioria espera. O modelo principal é auto, o roteador da Alibaba, e os subagentes também. O Qwen 4 Max só fica no slot do Opus.
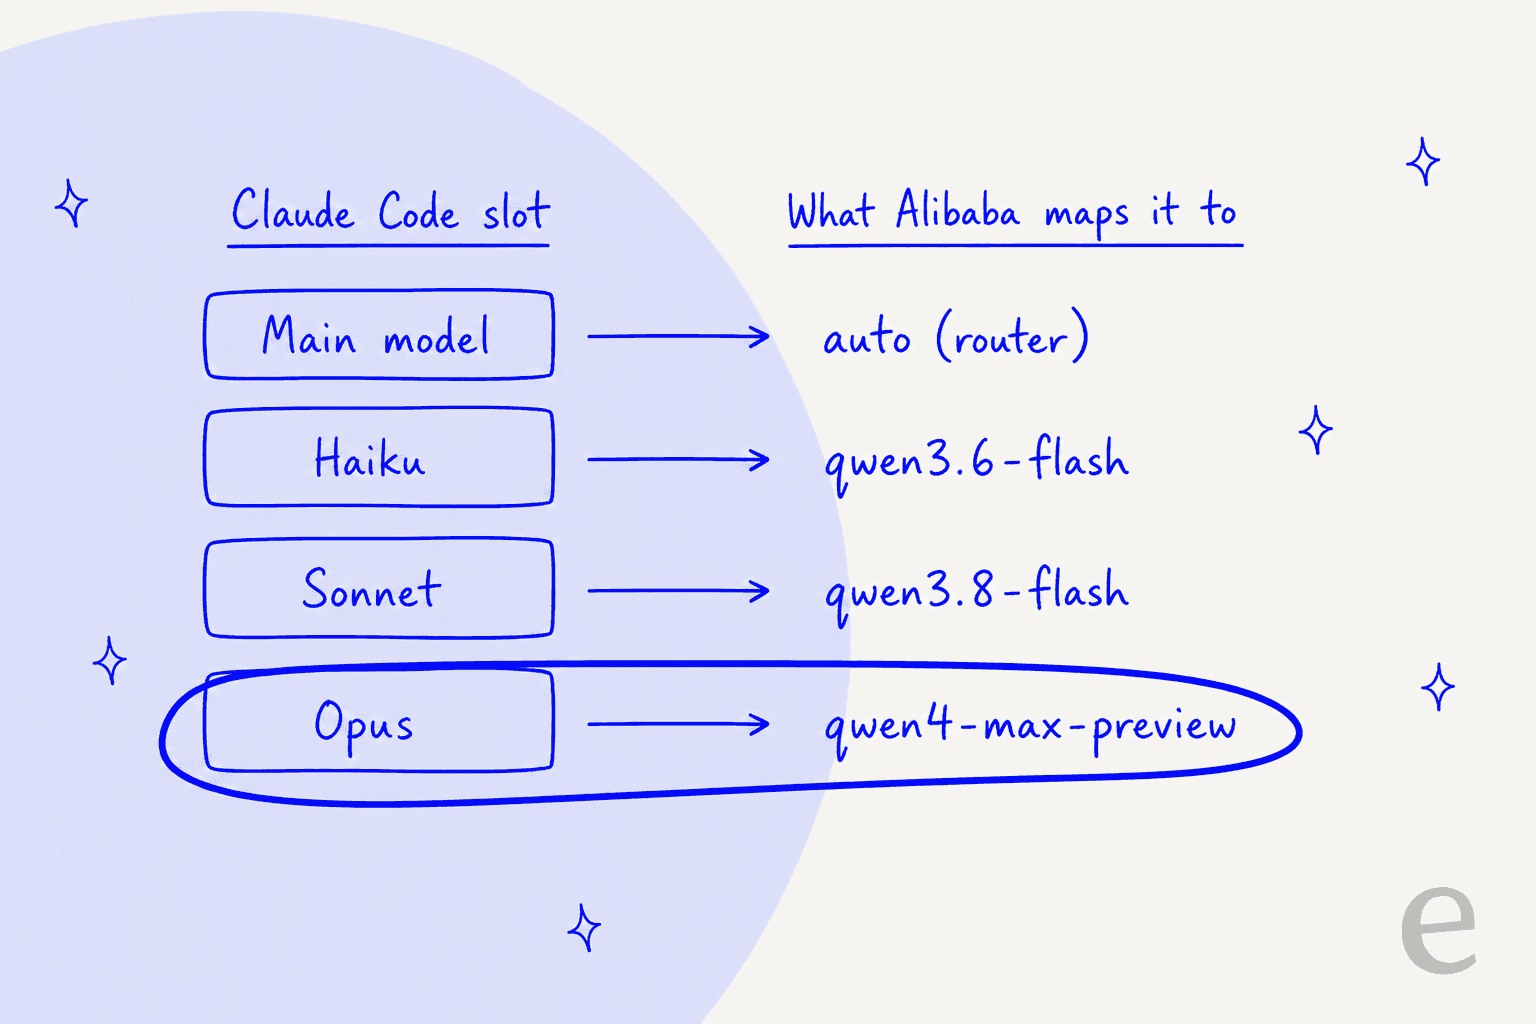
Então se você colar isso e iniciar uma sessão, seus prompts vão para o que o auto escolher, não para o Qwen 4 Max. Para realmente testar o modelo novo, troque com /model opus na sessão, ou defina ANTHROPIC_MODEL="qwen4-max-preview" você mesmo. Se você está comparando modelos, faça a segunda opção, para que cada turno do seu teste rode no mesmo modelo. Meu guia de seleção de modelo no Claude Code explica como os slots funcionam.
Três outras configurações importam:
- Tamanho de saída. A documentação observa que, se a saída longa for cortada com
qwen4-max-preview, definaCLAUDE_CODE_MAX_OUTPUT_TOKENS=64000. - Contexto.
CLAUDE_CODE_MAX_CONTEXT_TOKENS="983616"deixa o Claude Code usar a maior parte da janela de 1M. Veja meu guia da janela de contexto do Claude Code para o que isso muda. - Persistência. Esses exports só duram no terminal atual. Para uma configuração duradoura, as mesmas chaves vão em
envno~/.claude/settings.json, como explicado no meu guia de configuração do Claude Code.
Execute claude -p "Hello" para verificar a conexão. Para o Claude Code Desktop, o guia da Alibaba faz isso passar por um gateway local chamado CC Switch em vez de variáveis de ambiente.
Qwen Code, Cursor e outras ferramentas
Qwen Code usa o endpoint compatível com OpenAI. O ~/.qwen/settings.json de exemplo da Alibaba lista qwen4-max-preview como sua própria entrada de provedor chamada "Qwen4.0 Max Preview", então você escolhe pelo nome em vez de por uma associação de slot. Cursor, OpenAI Codex, OpenCode, OpenClaw, Cline, Qoder e Hermes Agent também têm guias do Token Plan. Em cada um, verifique duas coisas: a URL base é uma URL token-plan, e o ID do modelo é exatamente qwen4-max-preview.
O que muda para quem chama direto?
Dois comportamentos são novos nesse modelo, e os dois podem quebrar uma configuração que funcionava com modelos Qwen mais antigos.
max_tokens agora cobre o raciocínio também. O aviso de compatibilidade da Alibaba diz que, a partir do qwen4-max-preview, max_tokens equivale a max_completion_tokens no Chat Completions, então ele limita o raciocínio e a resposta final juntos. O raciocínio vem ativado em xhigh por padrão. Se você dimensionou max_tokens só para a resposta, o raciocínio consome o orçamento e a resposta volta cortada. Modelos Qwen mais antigos mantêm o comportamento antigo, por isso isso pega as pessoas quando elas trocam o ID do modelo.
O raciocínio precisa ser enviado de volta. O Chat Completions ativa preserve_thinking por padrão. A documentação do modelo pede para enviar de volta o raciocínio anterior no campo reasoning_content de cada mensagem do assistente, não dentro de content. Além disso, não defina reasoning_effort e thinking_budget ao mesmo tempo.
Mais uma coisa: as ferramentas integradas (busca na web, busca de imagens, scraping da web, interpretador de código) só funcionam pela Responses API, não pelo Chat Completions, segundo o guia de início rápido. Se sua ferramenta só fala Chat Completions, você não vai tê-las.
Checagem de configuração do Qwen 4 Max
Marque o que é verdade para a sua configuração. O que ficar sem marcar é provavelmente o motivo de não estar funcionando.
O que você não pode fazer com o Qwen 4 Max?
Você não pode construir um produto sobre ele, por dois motivos que não têm nada a ver com o quão inteligente ele é.
Primeiro, é temporário. A documentação diz que nenhuma mudança é feita durante a prévia e que o modelo é desativado quando ela termina. Qualquer coisa que chame qwen4-max-preview para de funcionar depois de 25 de novembro.
Segundo, o Token Plan proíbe isso. Os termos da assinatura dizem que o plano é só para uso interativo dentro de ferramentas de código e agentes, e não deve ser usado para "scripts de automação, backends de aplicativos personalizados, ou qualquer cenário de chamada em lote não interativo." O FAQ acrescenta que tarefas agendadas em segundo plano também contam, e que compartilhar uma chave pode fazer com que ela seja suspensa. Então um chatbot de suporte, um classificador de tickets ou uma API de atendimento ao cliente com IA conectada a essa chave quebra as regras desde a primeira chamada.
Os primeiros usuários já estão lendo isso como um test drive. Um comentarista do Hacker News resumiu o acordo em uma linha:
"By November 25th, Beijing time daytime (8am-22pm) -80%, and at night (Western daytime) even -92%!"

E sobre qualidade, ainda não há consenso. Um post do X amplamente compartilhado chamou o modelo de "decepcionante" com base no que o próprio autor admitiu serem rumores, e uma resposta de alguém que está realmente testando discordou:
"It's preview; Qwen4-max-preview. It's not disappointing at all, at least so far in my one-shots, but more testing is going on and i'll have a clear answer."
Meu conselho: teste em uma tarefa que você já resolveu com seu modelo habitual, como o Claude Fable 5.2 ou o GPT-6.1 Terra, e julgue por isso. Um modelo congelado por duas semanas é algo justo para testar e ruim para construir sobre.
O que o Qwen 4 Max significa para equipes de suporte?
Para uma equipe de suporte, o Qwen 4 Max é um modelo para testar na sua mesa, não um para colocar na sua fila. Os termos e a data de desativação resolvem isso.
A lição maior se repete em toda semana de lançamento. Um modelo é o motor, não o agente. O que torna a IA útil nos tickets é a camada em torno dele: sua central de ajuda, seus tickets anteriores, as regras de quando transferir para uma pessoa, e testes contra conversas reais antes que qualquer coisa chegue a um cliente. É para isso que o colega de equipe de IA da eesel para o helpdesk é feito. Ele entra na fila que você já roda no Zendesk ou Freshdesk, aprende com seu histórico, e é simulado primeiro contra tickets anteriores.
OroSoft é um bom exemplo da parte de grounding. A empresa faz software para o comércio de metais preciosos e atende clientes pelo Freshdesk. Quando um agente menciona a eesel em um ticket, ela redige uma resposta a partir de 6.100 tickets anteriores e 20 arquivos de central de ajuda e referência, diz qual ticket ou artigo usou, e deixa uma nota pedindo uma pessoa quando não encontra apoio para uma resposta. A smava, um comparador de empréstimos alemão, roda a eesel em duas marcas Zendesk e processou 27.000 tickets em um mês.
Nenhuma das duas configurações muda quando um modelo novo é lançado, e esse é o ponto. Se você tem curiosidade de ver como um modelo lida com seu próprio conteúdo de suporte, meus guias sobre conectar o Claude ao helpdesk, transferências de agente de IA e evitar alucinações são um ponto de partida melhor do que uma chave de prévia.
Vale configurar o Qwen 4 Max essa semana?
Sim, se você vive em um agente de código e quer duas semanas baratas com um Qwen de contexto de 1M. O plano Lite de $3, a taxa de crédito de 20% e a taxa noturna de 8% tornam o teste quase gratuito, desde que você configure o slot do modelo corretamente e faça sua chave combinar com o endpoint do Token Plan.
Não, se você precisa de um modelo para um aplicativo, um bot ou um orçamento. Use o Qwen 3.8 Max no pagamento por uso para isso, e volte a olhar quando a Alibaba lançar o Qwen 4 Max completo com preço e pontuações. Para um olhar mais amplo sobre a família, meu panorama do Qwen e alternativas ao Qwen cobrem o resto.
Teste a eesel para IA na sua fila de suporte
Se o que você realmente quer é IA que responde aos clientes, a eesel é um colega de equipe de IA para o helpdesk que se conecta ao helpdesk que você já usa, aprende com seus tickets anteriores e sua central de ajuda, e é testada em conversas históricas antes de tocar em uma conversa ao vivo. A OroSoft a usa para redigir respostas do Freshdesk fundamentadas que citam o ticket de onde vieram. Você pode ver os preços ou testar a eesel de graça.
Perguntas frequentes
O que é o Qwen 4 Max?
qwen4-max-preview, um modelo de raciocínio multimodal com contexto de 1M de tokens e saída máxima de 393.216 tokens. Foi lançado em 11 de novembro de 2026 e é desativado depois de 25 de novembro. A análise do Qwen 4 Max cobre o que a prévia consegue e não consegue te dizer.Como eu uso o Qwen 4 Max?
sk-sp-, aponte sua ferramenta para a URL base do Token Plan e defina o ID do modelo como qwen4-max-preview. As ferramentas compatíveis incluem Claude Code, Cursor, Qwen Code e OpenClaw.O Qwen 4 Max é gratuito?
A API do Qwen 4 Max está disponível?
Por quanto tempo o Qwen 4 Max fica disponível?
qwen4-max-preview para de funcionar nesse momento. Meu resumo de ferramentas de acompanhamento de LLMs ajuda você a ficar de olho no lançamento completo.Como eu configuro o Qwen 4 Max no Claude Code?
ANTHROPIC_BASE_URL como o endpoint Anthropic do Token Plan, coloque sua chave sk-sp- em ANTHROPIC_AUTH_TOKEN, e associe ANTHROPIC_DEFAULT_OPUS_MODEL a qwen4-max-preview. A própria configuração da Alibaba deixa o modelo principal como auto, então escolha Opus com /model para garantir que está usando o Qwen 4 Max. Meu guia de variáveis de ambiente do Claude Code explica cada variável.Qual é a diferença entre o Qwen 4 Max e o Qwen 3.8 Max?
max_tokens agora cobre o raciocínio e a resposta juntos. O Qwen 3.8 Max já foi lançado, tem pontuações independentes e custa $2 de entrada e $6 de saída por 1M de tokens no pagamento por uso. Veja o detalhamento de preços do Qwen 3.8 Max.