

O Qwen-UI-Agent é o melhor agente que opera celulares já publicado, e você não pode usá-lo. A equipe Tongyi MAI da Alibaba lançou um artigo, um vídeo de demonstração e um benchmark em 30 de julho de 2026. O repositório no GitHub tem 2.2k estrelas e zero releases. Não há pesos no Hugging Face, nem API, nem tabela de preços.
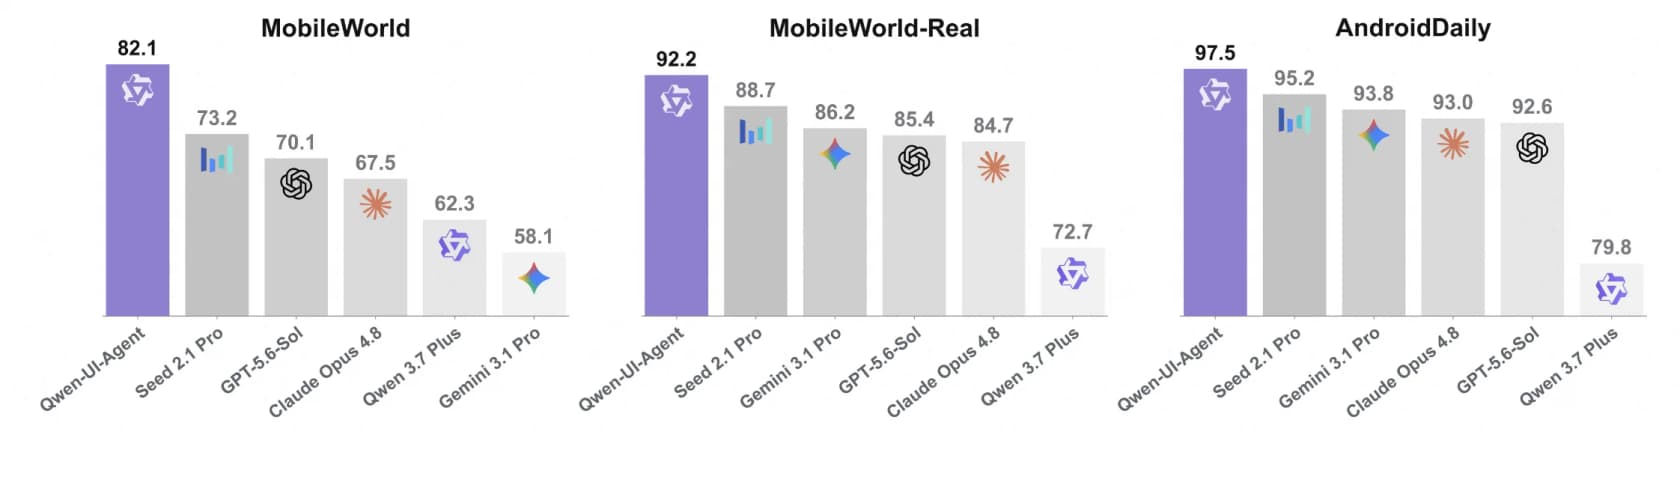
Os números móveis são reais e grandes. 82.1% no MobileWorld, ou seja, 14.6 pontos acima do Claude Opus 4.8 e 38.2 pontos acima do melhor modelo GUI especializado anterior. Os números de desktop são onde a cobertura em inglês errou. No OSWorld-Verified, o gráfico da própria Alibaba coloca o Opus 4.8 em 83.4 e o Qwen-UI-Agent em 79.5. Em trabalho de desktop de longo prazo ele conclui 13.9% das tarefas. Em pesquisa web difícil em inglês ele marca 64.1 contra 90.1 do GPT-5.5.
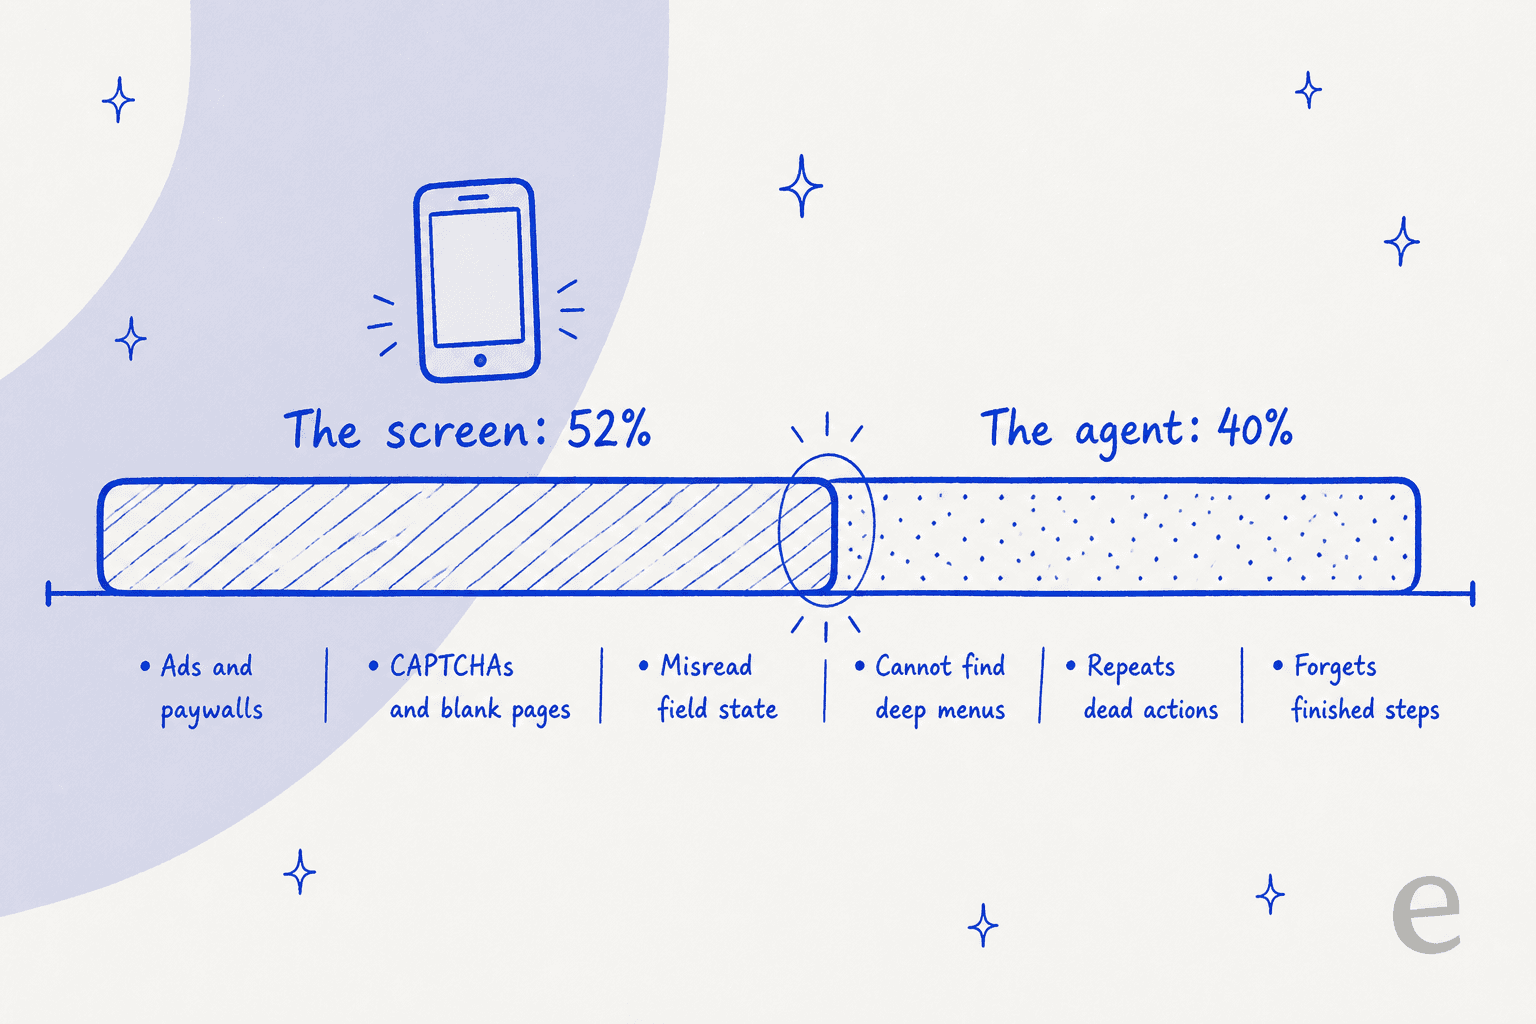
Eu construo o lado de agentes da eesel, então a parte deste artigo que continuo relendo não é o ranking. É a Tabela 10, em que a equipe classificou cada falha em dispositivos reais. 52% delas foram culpa da tela, não do modelo: anúncios, paywalls, CAPTCHAs, páginas em branco, um texto-guia cinza confundido com texto digitado. Esse é o número que diz onde o controle de tela se encaixa e onde não.
O que o Qwen-UI-Agent realmente é
A maioria dos modelos sobre os quais você lê responde a perguntas. Este opera dispositivos. Você dá uma tarefa em linguagem normal, ele olha para uma captura de tela e emite um toque, um deslize, uma tecla ou um comando bash. Depois olha de novo.
O artigo avalia três tamanhos: um modelo de 27B, uma variante esparsa de 35B-A3B e um de 4B. Todo número de destaque pertence ao de 27B. A base quase certamente é o Qwen3.5-27B, porque as tabelas de capacidade geral do artigo colocam os dois lado a lado e as pontuações são quase idênticas: 72.4 contra 73.5 no MMMU-Pro, 83.1 contra 83.1 no RealWorldQA. Seja o que for que o treinamento GUI tenha feito, não consumiu o raciocínio geral do modelo, o que é mais do que se pode dizer da maioria dos ajustes finos especializados.
É uma continuação do MAI-UI 1.0, trabalho anterior da mesma equipe, e herda o hábito de nomear as coisas pelo que elas medem. Se você é novo na família, nossa visão geral do Qwen cobre os modelos principais, e a análise do Qwen traz a leitura de negócios. O carro-chefe atual da Alibaba, o Qwen3.8-Max, é um bicho totalmente diferente: maior, mais falante e não feito para apertar botões.
O que faz dele um agente GUI base e não um bot móvel é a abrangência. Um modelo, quatro ambientes: celulares Android, Linux de desktop, navegadores web e um modo de busca profunda baseado em API. Produtos nomeados que fazem uma dessas coisas existem. Fazer as quatro em um único checkpoint é a alegação.
A tabela de benchmarks e a parte que foi superinterpretada
Aqui está cada número de destaque publicado em um só lugar, com quem realmente ocupa o primeiro lugar.
| Eixo | Benchmark | Qwen-UI-Agent | Melhor publicado | Veredicto |
|---|---|---|---|---|
| GUI móvel | MobileWorld (50 passos) | 82.1% | Qwen-UI-Agent | Lidera por 8.9 sobre o Seed 2.1 Pro |
| Móvel, dispositivos reais | MobileWorld-Real | 92.2% | Qwen-UI-Agent | Lidera por 3.5 sobre o Seed 2.1 Pro |
| Móvel, tarefas diárias | AndroidDaily | 97.5% | Qwen-UI-Agent | Lidera por 2.3 |
| Desktop | OSWorld-Verified | 79.5% | Claude Opus 4.8, 83.4% | Segundo |
| Desktop, longo prazo | OSWorld-v2 partial | 40.0% | Claude Opus 4.8, 54.8% | Terceiro, atrás do GPT-5.5 |
| Desktop, tarefas concluídas | OSWorld-v2 binary | 13.9% | Claude Opus 4.8, 20.6% | Segundo |
| Navegador | WebArena | 73.6% | Qwen-UI-Agent | Lidera por 1.7. O humano é 78.2% |
| Grounding | ScreenSpot-Pro (zoom) | 81.5% | Qwen-UI-Agent | Lidera por 0.8 |
| Busca profunda, EN | BrowseComp | 64.1% | GPT-5.5, 90.1% | 26 pontos atrás |
| Busca profunda, ZH | BrowseComp-ZH | 75.0% | Apodex-1.0-mini, 80.6% | Segundo |
O lado móvel dessa tabela não é parelho. Veja.
Agora olhe o mesmo conjunto de gráficos para desktop e web. Os painéis do meio e da direita são vitórias. O da esquerda não é, e a barra que o supera está identificada.
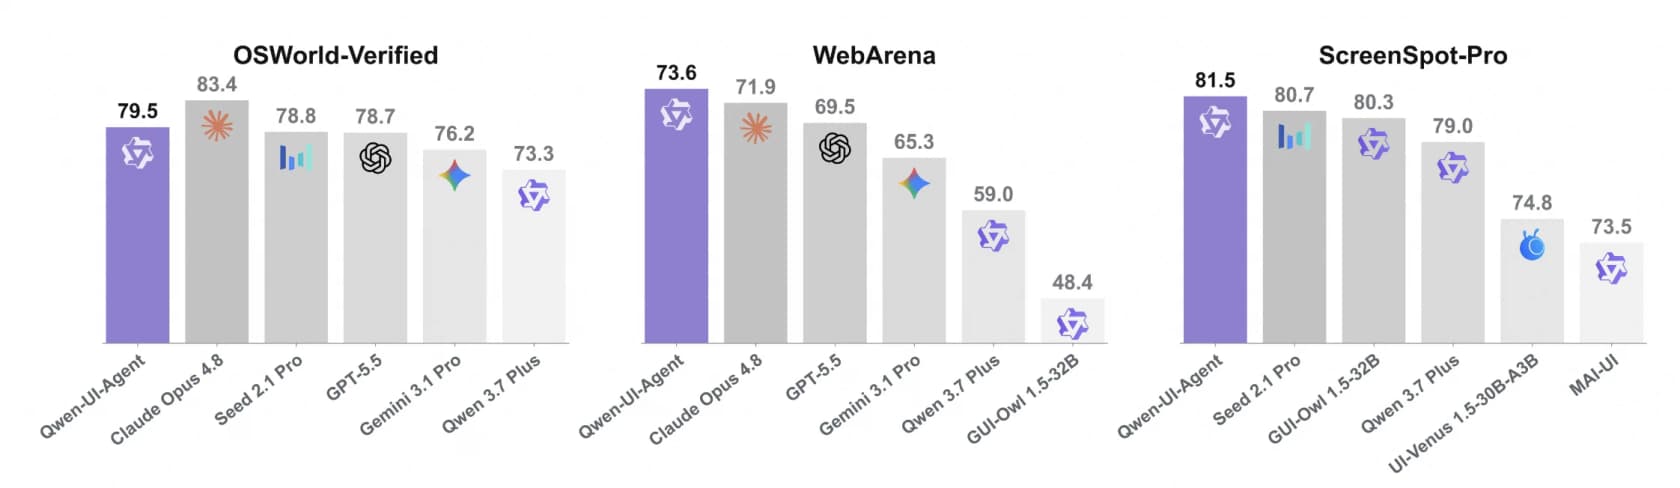
A Alibaba foi franca sobre isso. O artigo diz que o modelo fica "second among all compared models and trailing only Claude Opus 4.8" no OSWorld-Verified, e o resumo divide a alegação com cuidado: estado da arte em celular, competitivo em computador e navegador. O arredondamento aconteceu depois. Um resumo semanal de IA da China muito compartilhado informou as melhores pontuações nos três, MobileWorld, OSWorld-Verified e WebArena, "beating GPT-5.6 Sol, Claude Opus 4.8, and Gemini 3.1 Pro." Dois desses três são verdadeiros. O de desktop não é, segundo o próprio gráfico de barras da Alibaba.
Isso importa porque os dois eixos descrevem trabalhos diferentes. Reservar uma passagem de trem em um app é uma tarefa móvel. Conciliar uma planilha em quatro janelas é uma tarefa de desktop. Um modelo pode dominar uma e perder a outra, e este faz exatamente isso.
Escolha o trabalho e depois leia o número
Um espaço de ações para toques e comandos de terminal
A decisão de projeto que acho mais interessante não tem nada a ver com visão. É a lista de ações.
Ao lado dos verbos GUI esperados, click, long_press, type, drag, system_button, wait, o modelo tem cli_command para executar bash, api_call para chamadas estruturadas de serviço e ask_user para parar e perguntar a um humano. Tudo em um espaço plano, escolhido turno a turno. Assim o agente nunca é forçado a expressar "renomear quarenta arquivos" como quarenta cliques. Ele pode simplesmente escrever o comando.
E faz isso o tempo todo. No OSWorld-v2, 55.1% das ações do agente são comandos digitados, e não ações de tela. No OSWorld-Verified são 40.7%, aparecendo em 92.0% das tarefas.
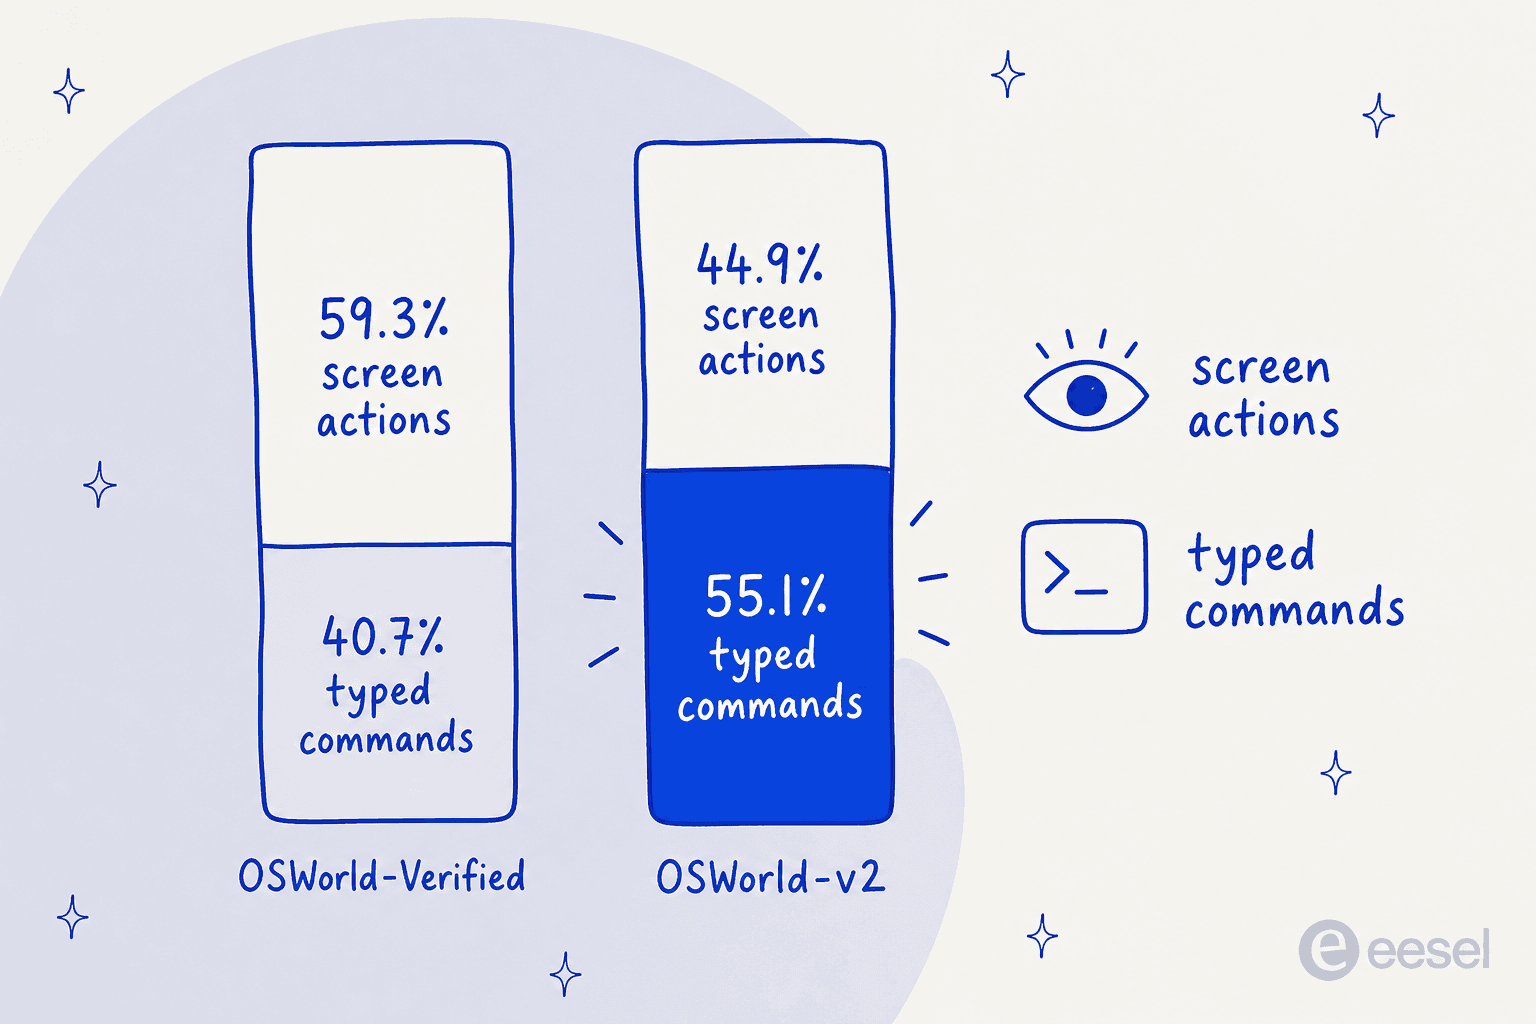
Pense nisso por um segundo. O produto principal é um agente de tela. Dê a ele um teclado e um shell, e no benchmark de desktop mais difícil ele gasta a maior parte das ações sem tocar na tela. A frase do próprio artigo para o padrão é bash como mãos, GUI como olhos, e a trajetória que melhor mostra isso é a da tarefa de marcar 100 pontos no jogo do dinossauro do navegador sem abrir as ferramentas de desenvolvedor. Ao longo de 80 passos o agente observa o canvas por capturas de tela e depois escreve e reescreve Python para cronometrar os pulos.
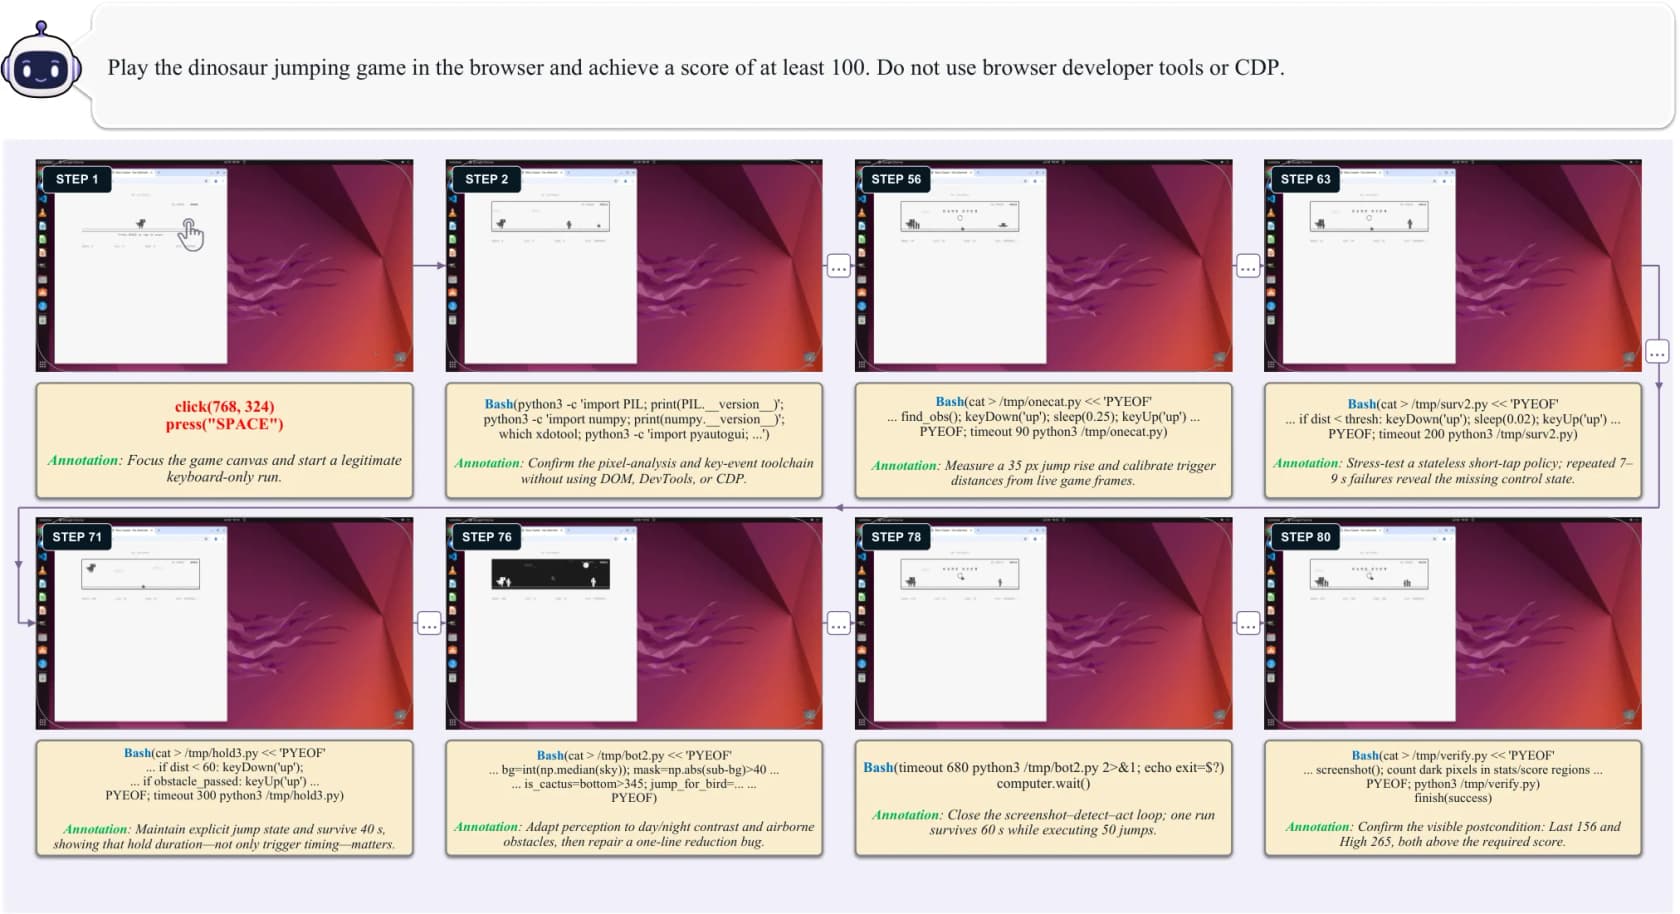
O segundo truque de eficiência é o agrupamento. Em vez de uma ação por turno do modelo, ele emite várias: 39.6% das ações no OSWorld-Verified e 41.6% no OSWorld-v2 chegam em lote, com média de 3.1 primitivas cada. Um exemplo do artigo é uma sequência de 21 ações que preenche um e-mail e vai até o seletor de anexos, e então para, porque a próxima decisão precisa de uma captura de tela nova. Cada turno evitado é uma captura, uma passada de inferência e uma viagem de ida e volta a menos, exatamente o custo que o artigo aponta, na própria seção de trabalhos futuros, como o principal obstáculo ao uso prático.
Se você já viu um agente de navegador se arrastar por um formulário campo a campo, esta é a solução. O Chrome auto-browse tem o mesmo tipo de problema, e é por isso que a latência por passo, e não a precisão, costuma ser o que derruba uma demo.
O número em dispositivos reais é o interessante
A maioria dos agentes GUI é treinada e pontuada em simuladores, porque um simulador pode ser reiniciado e verificado. A Alibaba construiu o oposto: um ambiente de execução com mais de 100 smartphones físicos cobrindo mais de 150 apps, além de um benchmark para acompanhar.
O MobileWorld-Real tem 409 tarefas escritas por humanos em 104 apps Android ativos, mantidas fora do treinamento. Contas reais, conteúdo que muda, permissões reais, rede real. A lista de tarefas parece o sábado de uma pessoa: encontrar o post de receita mais salvo, comprar os ingredientes sem os temperos para entrega às 18:45, comparar o tempo de caminhada de três hotéis até uma ponte, descobrir quando o trem chega e marcar uma reunião para a próxima hora cheia depois disso.
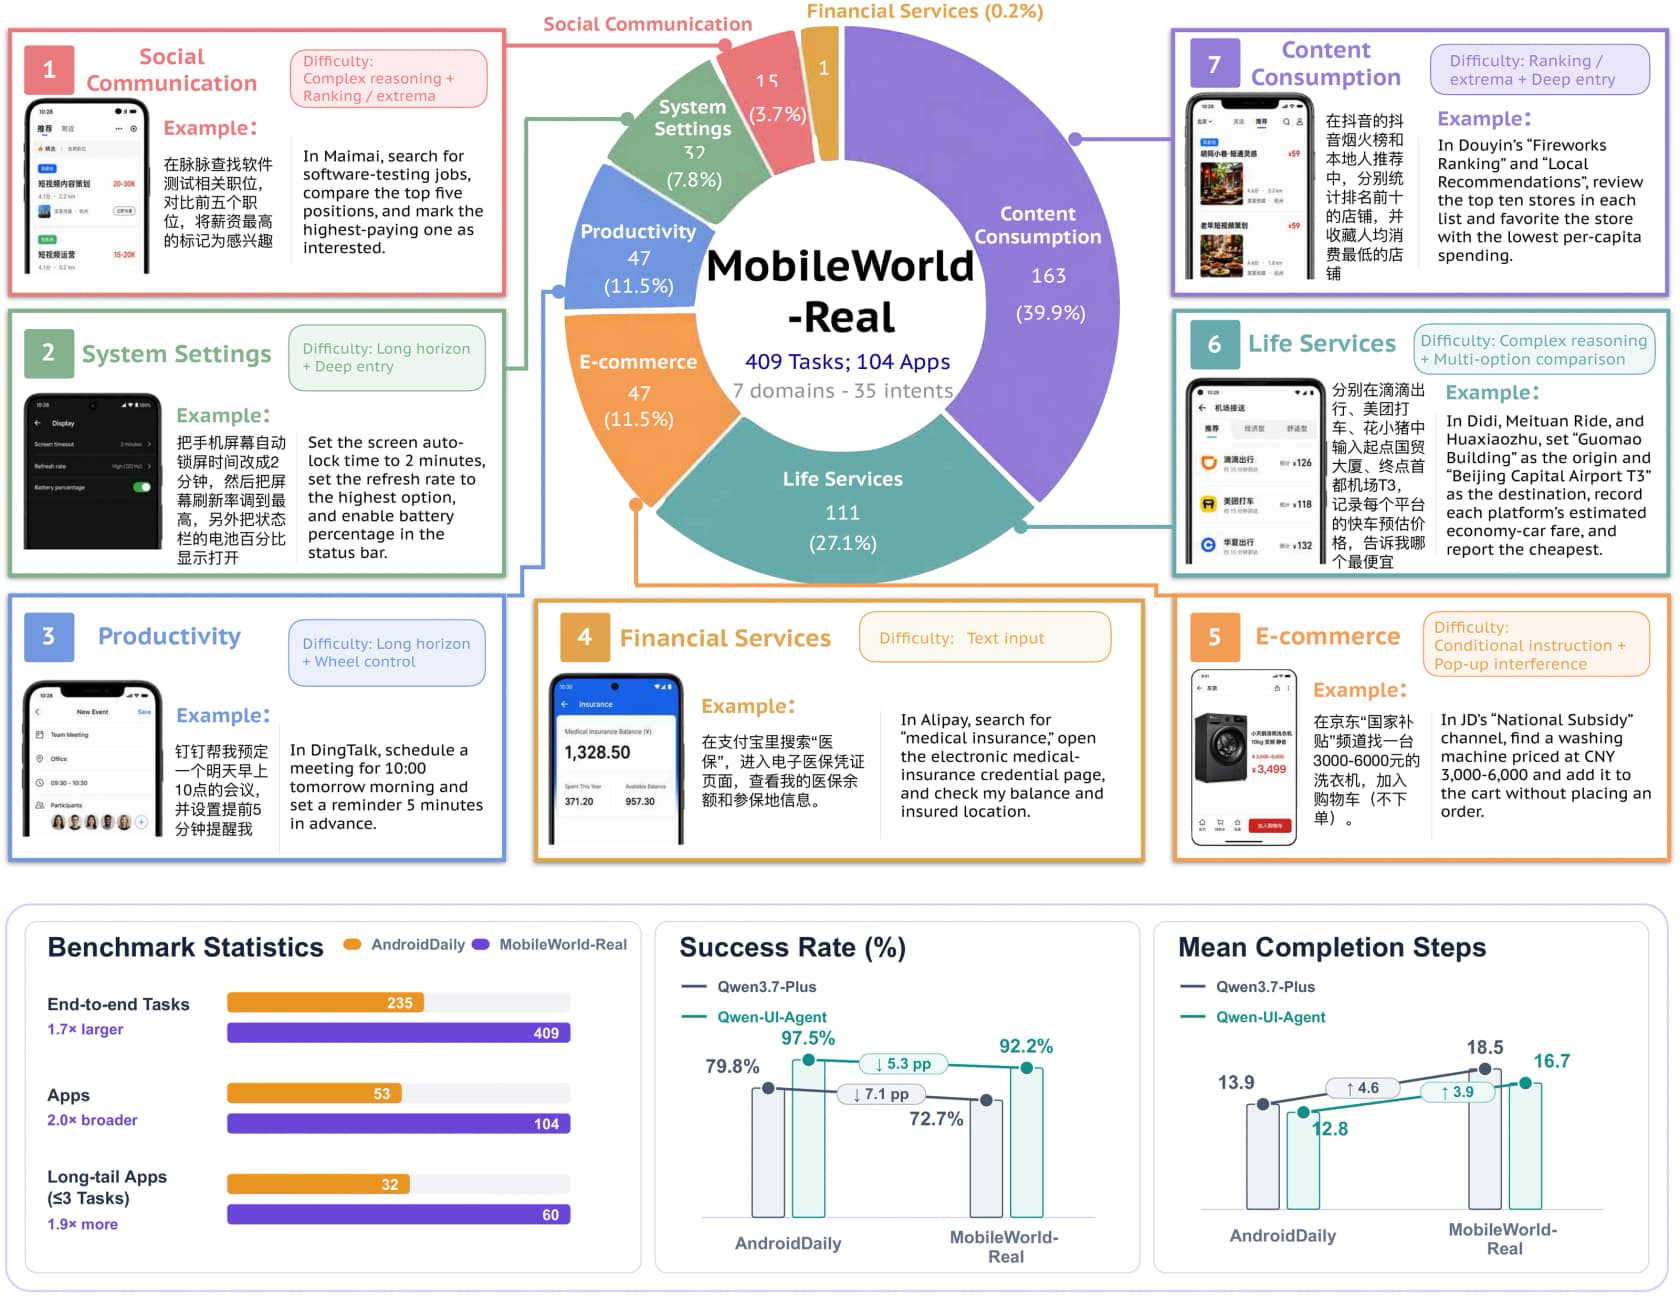
Duas ressalvas honestas cabem nos 92.2%. Primeiro, é o benchmark da própria Alibaba, o que é normal e aceitável, mas não é um placar independente. Segundo, celulares físicos não expõem os internos dos apps, então não há verificador determinístico. A pontuação é feita por um agente chamado AutoJudge, que lê a instrução mais o rastro completo de ações e capturas e devolve aprovado, reprovado ou erro de ambiente. A equipe estimou a precisão dele em 92.8% de correspondência exata com 666 exemplos revisados por especialistas, e listou o erro do juiz como a primeira limitação do artigo. Respeito que tenham começado por isso. Também significa que o topo desse ranking tem uma faixa de tolerância ao redor.
O retorno de todo esse hardware aparece na análise de falhas, a seção que eu leria primeiro se tivesse só cinco minutos. A equipe pegou cada trajetória fracassada do Qwen 3.7 Plus em dispositivos reais e a classificou.
| Padrão de falha | Participação | Como se manifesta |
|---|---|---|
| Leitura errada da interface | 24.7% | Texto-guia cinza lido como texto digitado, então ele continua limpando um campo vazio |
| Interferência de pop-ups | 18.2% | Anúncios, paywalls, CAPTCHAs, páginas em branco |
| Falha de exploração | 19.5% | Não encontra uma função escondida atrás de vários menus |
| Loops de ações erradas | 14.3% | Repete doze vezes uma ação que não fez nada |
| Controle de widgets físicos | 9.1% | Passa do ponto em um seletor de horário nas duas direções e nunca acerta |
| Perda do estado de execução | 6.5% | Esquece quais subtarefas já concluiu e recomeça |
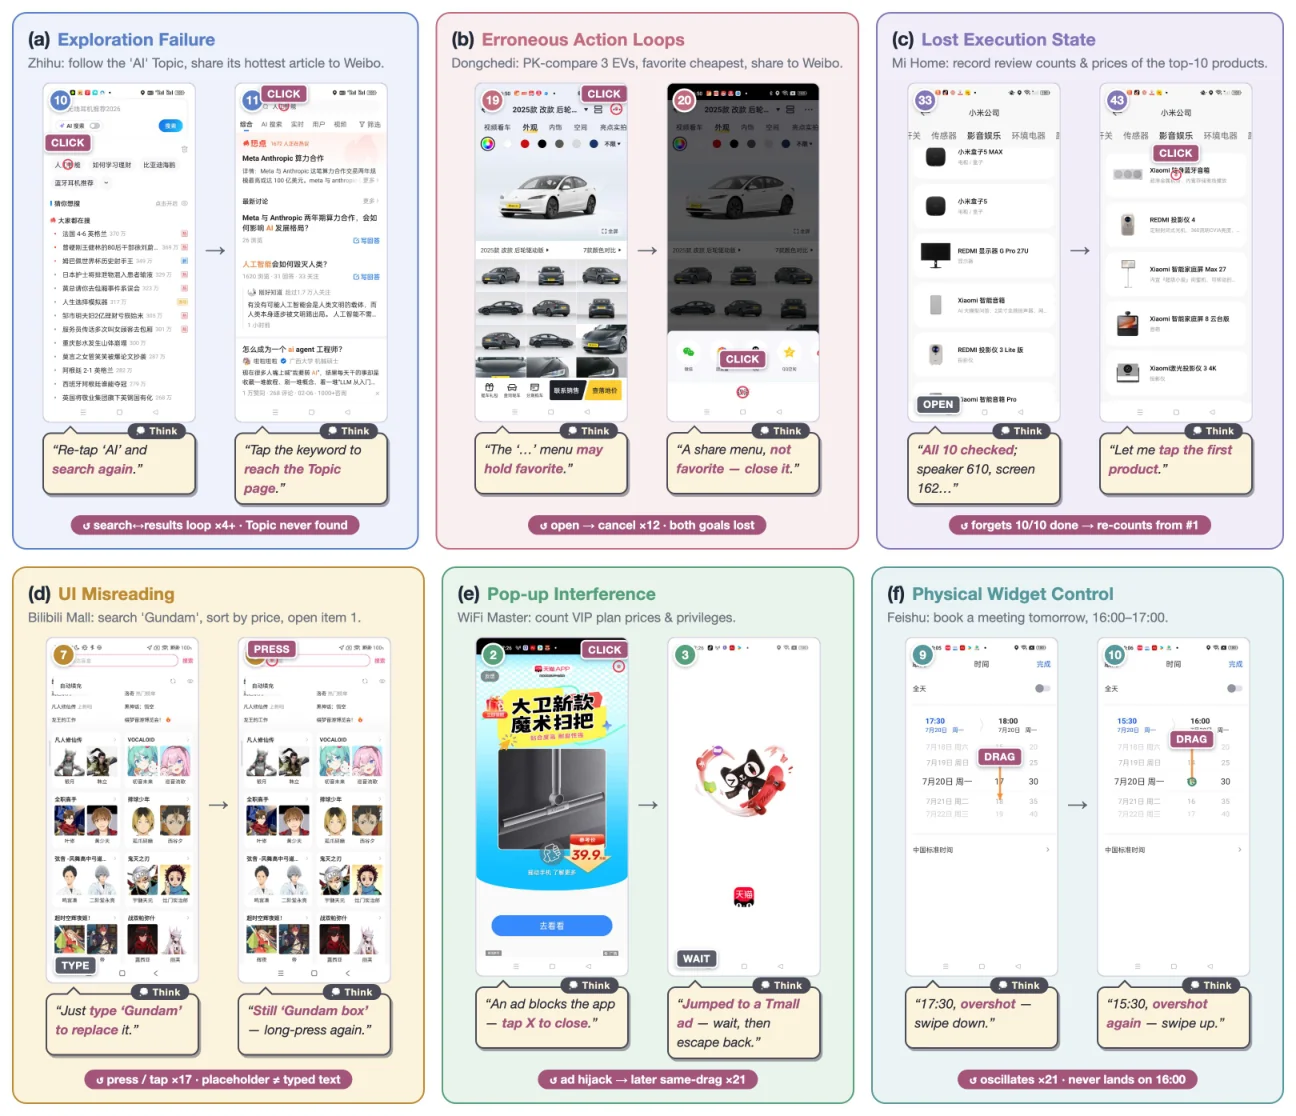
Some as linhas de cima e 52.0% das falhas são do ambiente e não do raciocínio: um anúncio apareceu, uma página ficou em branco, um texto-guia parecia texto. Só 40.3% são o agente falhando nos próprios termos. O verdadeiro adversário de um agente GUI é a interface, e interfaces mudam sem avisar ninguém.
Dá para usar de verdade? Não, ainda não
Esta é a parte que todo thread de anúncio pulou, então vou ser claro sobre o que existe.
| O que você pode querer | O que existe hoje |
|---|---|
| Pesos do modelo | Nenhum. O Tongyi-MAI no Hugging Face tem MAI-UI-2B e MAI-UI-8B de dezembro de 2025 e janeiro de 2026, nada mais novo |
| Código de inferência | Nenhum. O repositório tem 2.2k estrelas, 199 forks, zero releases, zero pacotes |
| Uma API hospedada | Nenhuma publicada |
| Preços | Nenhum, porque não há nada para cobrar |
| Um app para consumidores | Não anunciado |
| O que você pode ler | O relatório técnico, o site do projeto, vídeos de demonstração e o benchmark MobileWorld-Real |
A licença Apache 2.0 do README cobre o conteúdo do repositório, não um checkpoint, o que vale saber antes que alguém diga que este é aberto. A Alibaba tem histórico de lançar pesos eventualmente, então a leitura sensata é "ainda não" e não "nunca". Mas agora o Qwen-UI-Agent é um resultado de pesquisa, não algo que você possa colocar em um fluxo de trabalho. O guia de preços do Qwen cobre os modelos que você realmente pode chamar, e o Qwen 3.7 Flash é o barato que as pessoas estão rodando em produção.
Se você está comprando em vez de lendo, o conjunto de comparação honesto são os modelos que já respondem às suas chamadas de API hoje. Em controle de desktop isso significa primeiro o Claude Opus 5, e nossa análise do Opus 5 detalha por quê.
Abaixo dele, o Gemini 3.5 Pro é a opção crível mais barata com visão, e o GPT-5.6 é aquela para a qual a maioria das equipes já tem uma chave.
Se pesos abertos são um requisito e não uma preferência, os dois que valem ser comparados lado a lado são o Kimi K3 e a faixa barata da DeepSeek. Nosso texto sobre o DeepSeek V4 Flash explica por que a faixa barata é a que as pessoas realmente implantam.
O que isso significa se você cuida de uma fila de suporte
Aqui preciso declarar um interesse, porque este é o meu trabalho do dia a dia. Construo recursos de agentes na eesel, e a fantasia que um agente GUI vende a um líder de suporte é específica e sedutora: uma IA que entra no helpdesk e trabalha os tickets como um novo contratado, sem projeto de integração.
Duas coisas neste artigo argumentam contra recorrer a isso primeiro.
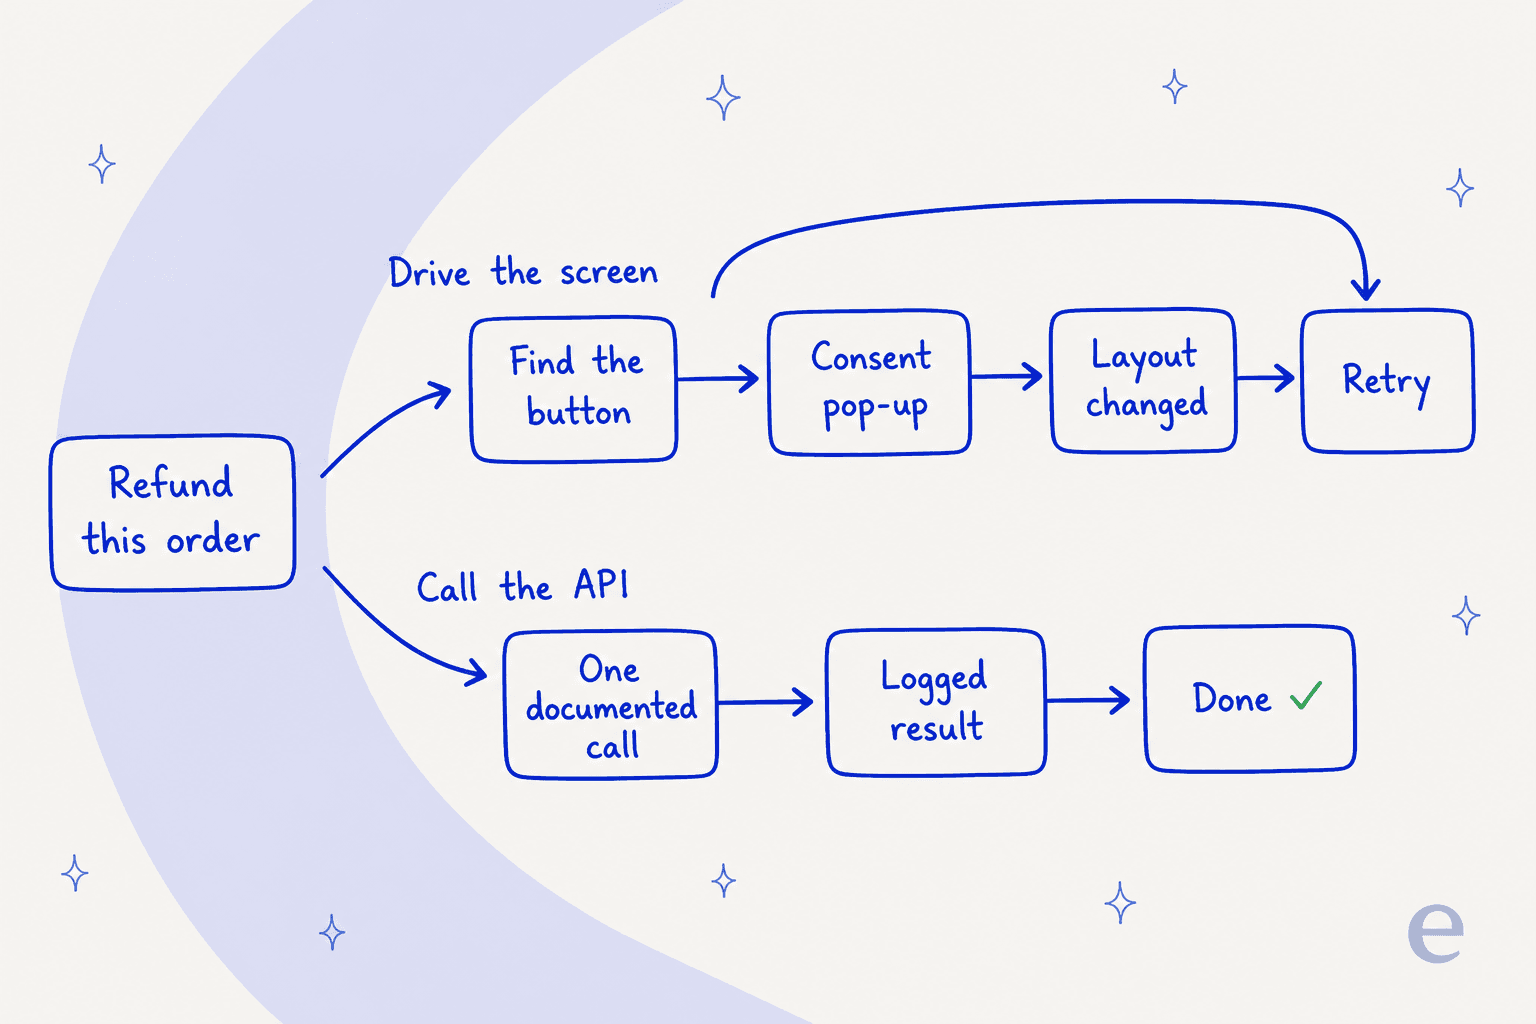
A primeira é aquela tabela de falhas. Anúncios, paywalls, páginas em branco e estados de campo mal lidos são a maioria das falhas em dispositivos reais, e a interface de um helpdesk tem os mesmos perigos em versão mais branda: um banner de consentimento, um tooltip de tour de recursos, um modal que só aparece para administradores, uma tabela que se reorganiza com outro zoom. Seu fluxo de reembolso não deveria estar a um release de CSS de quebrar. Todo helpdesk que vale a pena tem uma API por um motivo. A API do Zendesk faz em uma chamada documentada o que um agente de pixels precisa conquistar com seis cliques e um pouco de sorte. O mesmo vale para a Freshdesk API v2, com limites de taxa publicados nos quais você pode se basear. Controlar a tela é a ferramenta certa para a longa cauda de sistemas internos que nunca lançaram uma API, não para os que lançaram.
A segunda é o ask_user, e digo isso como elogio. A Alibaba colocou "pare e confirme com o humano" no espaço de ações em vez de acrescentá-lo depois, então o agente preenche o valor e a nota do Alipay e para na etapa de pagamento. Essa é exatamente a forma da objeção que mais ouço no suporte. Um líder de CX que atende cerca de 7.000 tickets por mês nos disse isto, e ficou comigo desde então:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Isso não é um pedido de recurso sobre telas. É um pedido de um limite de confiança, que é a mesma ideia de projeto que a Alibaba entregou como uma ação. Se você está caminhando nessa direção, as regras de transferência são o ponto de partida prático. A mecânica do gatilho em si está nas regras de escalonamento. O que decide primeiro em qual caixa uma conversa cai costuma ser a classificação de tickets.
A terceira coisa é aquela que a Alibaba gastou 100 celulares para provar, e ela se generaliza além do celular. Um número de simulador não prevê o comportamento no ambiente real. Esse é todo o argumento a favor do ambiente de dispositivos reais, e é o mesmo argumento para rodar um agente de IA sobre os seus próprios tickets históricos antes que ele responda um ao vivo. Aprendemos isso do jeito difícil anos atrás, vendo um bot de tom confiante dar respostas erradas com total compostura, e é por isso que nada na eesel entra no ar sem uma rodada de simulação antes. Se quiser a versão mais ampla desse argumento, o controle de qualidade do suporte mostra como as equipes realmente medem isso. O equivalente do lado humano está no coaching de agentes.
Nada disso é uma crítica ao Qwen-UI-Agent. Ele é um operador de dispositivos, e muito bom em celulares. Não tem modelo de tickets, base de conhecimento, fila nem conceito de cliente, então fica uma camada abaixo das ferramentas do nosso guia dos melhores agentes de IA e da lista mais restrita do melhor agente de IA para suporte. Trabalho completamente diferente.
Se quiser o mapa de categorias, os exemplos de agentes de IA mostram onde cada tipo se justifica. Agentes de IA vs. chatbots traça a linha que a maioria dos compradores realmente procura, e os chatbots baseados em regras cobrem a geração anterior a esta.
Experimente a eesel
Se o que você quer é uma IA que trabalhe a sua fila em vez de ficar clicando nela, é isso que construímos. A eesel se conecta pela API do helpdesk que você já usa, aprende com seus tickets passados e sua central de ajuda em vez de adivinhar, e roda uma simulação sobre o seu histórico real de tickets antes que um único cliente veja uma resposta. Você recebe de antemão a taxa de acerto, as lacunas e a redação a corrigir. A cobrança é por ticket atendido, não por assento, então um mês tranquilo custa menos que um movimentado.

Esse painel de aprovação é a ideia do ask_user em produção: cada ação de ferramenta que o agente quis executar, e se um humano a aprovou, rejeitou ou ainda não decidiu.
Comece pela IA para helpdesk se quiser a visão geral, pela deflexão de tickets se estiver atrás de um número específico, ou pelas ferramentas de automação de suporte se ainda estiver comparando.
Caso contrário, experimente a eesel grátis. Sem precisar de ligação.
Então onde isso deixa o modelo
O Qwen-UI-Agent é a mais forte evidência publicada até agora de que um modelo de porte médio com arquitetura aberta consegue operar um celular melhor que um generalista de fronteira. 82.1% no MobileWorld contra 67.5% do Opus 4.8 não é erro de arredondamento, e 38.2 pontos sobre o melhor especialista anterior é um salto. O espaço de ações híbrido é a ideia certa e o agrupamento é a otimização certa. A Alibaba também reportou as partes que não a favorecem, o que é mais raro do que deveria.
Ele também está indisponível, não foi comprovado em stacks de apps ocidentais, é segundo no desktop e está 26 pontos atrás em pesquisa em inglês. Se você ler uma só coisa além do ranking, que seja a Tabela 10. A tela é o adversário, não o modelo, e isso vale tanto se a interface for o Douyin quanto se for o seu helpdesk. Onde existe API, use a API. Onde não existe, é essa linha de trabalho que acabará preenchendo a lacuna, e vale acompanhá-la justamente por isso.
Enquanto isso, as perguntas que decidem o seu trimestre são as chatas. Se a sua base de conhecimento com IA é boa o bastante para responder a partir dela. Se o roteamento de tickets está enviando as coisas ao lugar certo antes que qualquer IA as toque.
Depois a pergunta do dinheiro, que é o custo de agente de IA vs. humano no seu volume real, não no de um fornecedor. E a pergunta do enquadramento, porque a proposta dos colegas de equipe de IA e a do funcionário de IA divergem mais do que o marketing sugere.
Por fim, a que todo mundo adia: se um sistema de tickets com IA compensa a migração do que você tem hoje. Para o resto da linha da Alibaba, as alternativas ao Qwen são o guia e a análise do Qwen3.8-Max é o parente mais próximo deste artigo.
Perguntas frequentes
O que é o Qwen-UI-Agent?
O Qwen-UI-Agent é de código aberto ou pode ser baixado?
Quão bom é o agente de UI do Qwen em comparação com Claude e GPT?
Quanto custa o Qwen-UI-Agent?
Um agente GUI pode operar meu helpdesk por mim?
O que acontece se o agente errar em um ticket real?
ask_user para poder parar antes de um pagamento ou de uma exclusão, que é a mesma ideia de um limite de confiança no suporte: responder automaticamente o que o agente tem certeza e passar o restante para uma pessoa. Nossos guias sobre regras de transferência e regras de escalonamento mostram como configurar isso.