

Em celulares, nada publicado o supera. 92,2% no MobileWorld-Real, um benchmark de 400 tarefas executado em dispositivos Android físicos, à frente de Seed 2.1 Pro, Gemini 3.1 Pro, GPT-5.6 Sol e Claude Opus 4.8. Esse é o Qwen-UI-Agent, o novo agente GUI de base da Alibaba. A engenharia por baixo é, porém, o que mais me chamou a atenção. Um espaço de ações que mistura cliques na tela com comandos Bash. Ações em lote, de modo que várias coisas acontecem por turno do modelo. E aprendizado por reforço online sobre trajetórias com mais de 100 passos.
Depois há o número de desktop, que ninguém cita. No OSWorld-v2, o conjunto de uso de computador de longo prazo, o Qwen-UI-Agent marca 40,0% de progresso parcial contra 54,8% do Claude Opus 4.8. Ou seja: um agente de celular, competitivo no desktop. Não um controlador de tela geral que por acaso é bom em celulares. Vale saber isso antes de ler "estado da arte" e assumir que significa em todo lugar.
O que decide se tudo isso importa para você: você não pode executá-lo. Sem pesos no Hugging Face. Sem endpoint hospedado, e também sem preço. Eu construo agentes de IA que atuam em filas de suporte reais na eesel e, depois de mais de três anos colocando agentes em tickets ao vivo, a lição que fica é que uma pontuação diz um teto e nada sobre um piso. O que realmente faz um agente passar por um líder de suporte é prová-lo no próprio histórico dele antes de tocar em um cliente, e é por isso que toda implantação da eesel começa como uma simulação sobre tickets passados em vez de um lançamento.
O que o Qwen-UI-Agent realmente é
O Qwen-UI-Agent é um único modelo que opera software como uma pessoa faria, olhando para a tela e clicando nela. Saiu da equipe MAI-UI dentro do laboratório Tongyi da Alibaba e é o sucessor direto do MAI-UI 1.0, que lançou checkpoints de 8B e 2B em dezembro de 2025. Se você quer primeiro o panorama mais amplo da Alibaba, nossa visão geral do Qwen e nossa análise do Qwen cobrem a família de modelos.
O artigo chegou ao arXiv em 30 de julho de 2026 e quase imediatamente virou o artigo número um do dia no Hugging Face, onde agora tem 308 votos positivos. O site do projeto o apresenta como um agente que "pensa, pesquisa e age em celular, desktop e web".
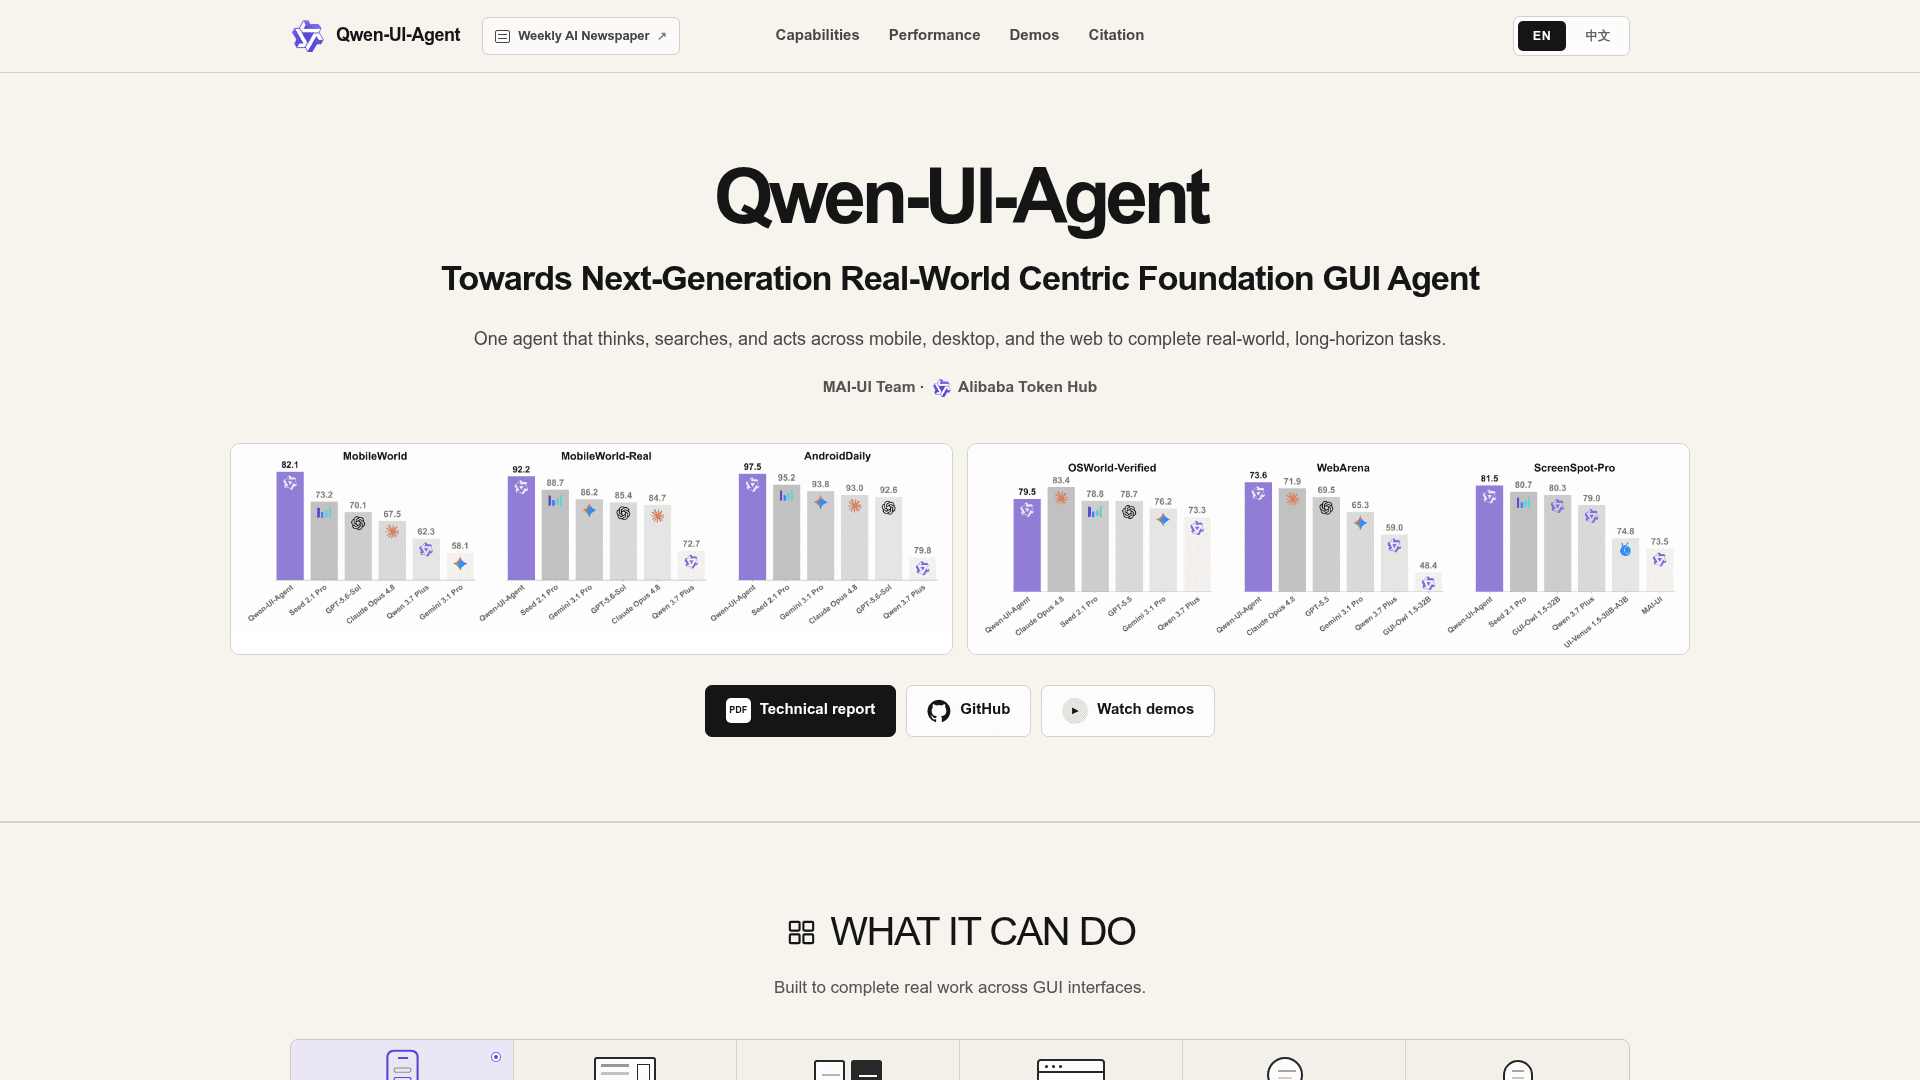
Olhe os três botões sob os gráficos. Relatório técnico, GitHub, ver demos. Essa é toda a superfície de distribuição agora, e vou voltar a isso.
Quatro cenários vivem dentro do único modelo. Uso de GUI móvel e uso de computador, mais uso de navegador e depois o que a Alibaba chama de DeepSearch. Este último é o comportamento de pesquisa profunda e não foi acoplado depois. O agente pode sair de um app, ir verificar algo na web aberta e voltar ao app para agir com base no que encontrou. Uma das demos publicadas o mostra extraindo afirmações de um vídeo social, conferindo-as em artigos de pesquisa e depois voltando para escrever um comentário que nomeia o problema específico.
Se a categoria em si é nova para você, nossos textos sobre agentes de IA e sobre agentes versus chatbots cobrem o terreno mais rápido que o artigo. Para o lado de licenças permissivas do campo, também temos nosso apanhado de agentes de IA de código aberto.
Como funciona por baixo do capô
Esta é a parte que acho mais interessante como alguém que constrói agentes para viver, porque três das escolhas de design não são óbvias, e as três miram o mesmo modo de falha.
GUI e CLI em um único espaço de ações
A maioria dos agentes de tela só consegue clicar. O Qwen-UI-Agent pode clicar ou executar um comando Bash, e escolhe entre os dois dentro de um único espaço de ações unificado. O próprio relatório da Alibaba sobre tarefas de uso de computador diz que comandos CLI e cliques GUI emergem como os dois tipos de ação dominantes, que é um jeito educado de dizer que o modelo descobriu que alguns trabalhos saem muito mais baratos com um comando de shell do que com trinta cliques.
Quem já viu um agente de navegador tentando renomear quarenta arquivos arrastando-os entende de imediato por que isso importa.
Ações em lote
Em vez de emitir uma ação, esperar uma captura de tela e pensar de novo, o modelo emite várias ações dentro de uma única decisão. A Alibaba reporta que cerca de 40% das saídas de ação são em lote nas tarefas de uso de computador.
A implicação de custo é real. Cada turno em um agente de tela significa uma nova captura entrando no contexto, e capturas são tokens caros. Reduzir à metade a contagem de turnos em uma tarefa longa é a diferença entre um fluxo viável e um que come o orçamento em silêncio, que é a mesma aritmética por trás do custo de agentes de IA em escala.
Treinado em celulares reais, não só em simuladores
Esta é a afirmação principal, e também a que eu mais gostaria de verificar se pudesse. A Alibaba diz que construiu um ambiente móvel ao vivo com mais de 100 celulares físicos cobrindo mais de 150 apps, e o usou para construção de tarefas, coleta de trajetórias, treinamento e avaliação. Também construiu seu próprio benchmark sobre essa frota, o MobileWorld-Real, com mais de 400 tarefas em mais de 100 apps.
O propósito declarado é fechar a lacuna entre simulação e realidade, e o design de fato ataca o que torna enganosas as pontuações de simulador. Apps reais têm indicadores de carregamento, layouts com testes A/B, sessões expiradas e instabilidade de rede que uma sandbox nunca reproduz.
O treinamento então executa aprendizado por reforço online sobre trajetórias com mais de 100 passos, com cerca de 10.000 ambientes rodando simultaneamente. Alimentando tudo isso há um ciclo de dados no estilo AutoResearch, em que agentes constroem as tarefas, os ambientes e os verificadores, diagnosticam suas próprias falhas e depois planejam a próxima iteração.
Um harness para trabalho proativo
A última peça é uma camada leve de harness que permite ao agente iniciar o trabalho a partir de um sinal do mundo real em vez de um prompt. A demo da Alibaba é uma notificação de voo cancelado. O agente a percebe, abre apps de viagem ao vivo, compara voos e trens com a reunião das 14h do usuário e volta com opções ordenadas. Ele não reserva, o que vale destacar. Apresenta uma decisão e para.
Essa contenção é o instinto correto, e é o mesmo por trás das boas práticas de transferência de agentes de IA em suporte. O Google tomou o caminho oposto com o Chrome auto-browse, que age dentro do navegador em vez de perguntar antes.
Os resultados dos benchmarks, lidos com honestidade
Aqui a história se divide em duas.
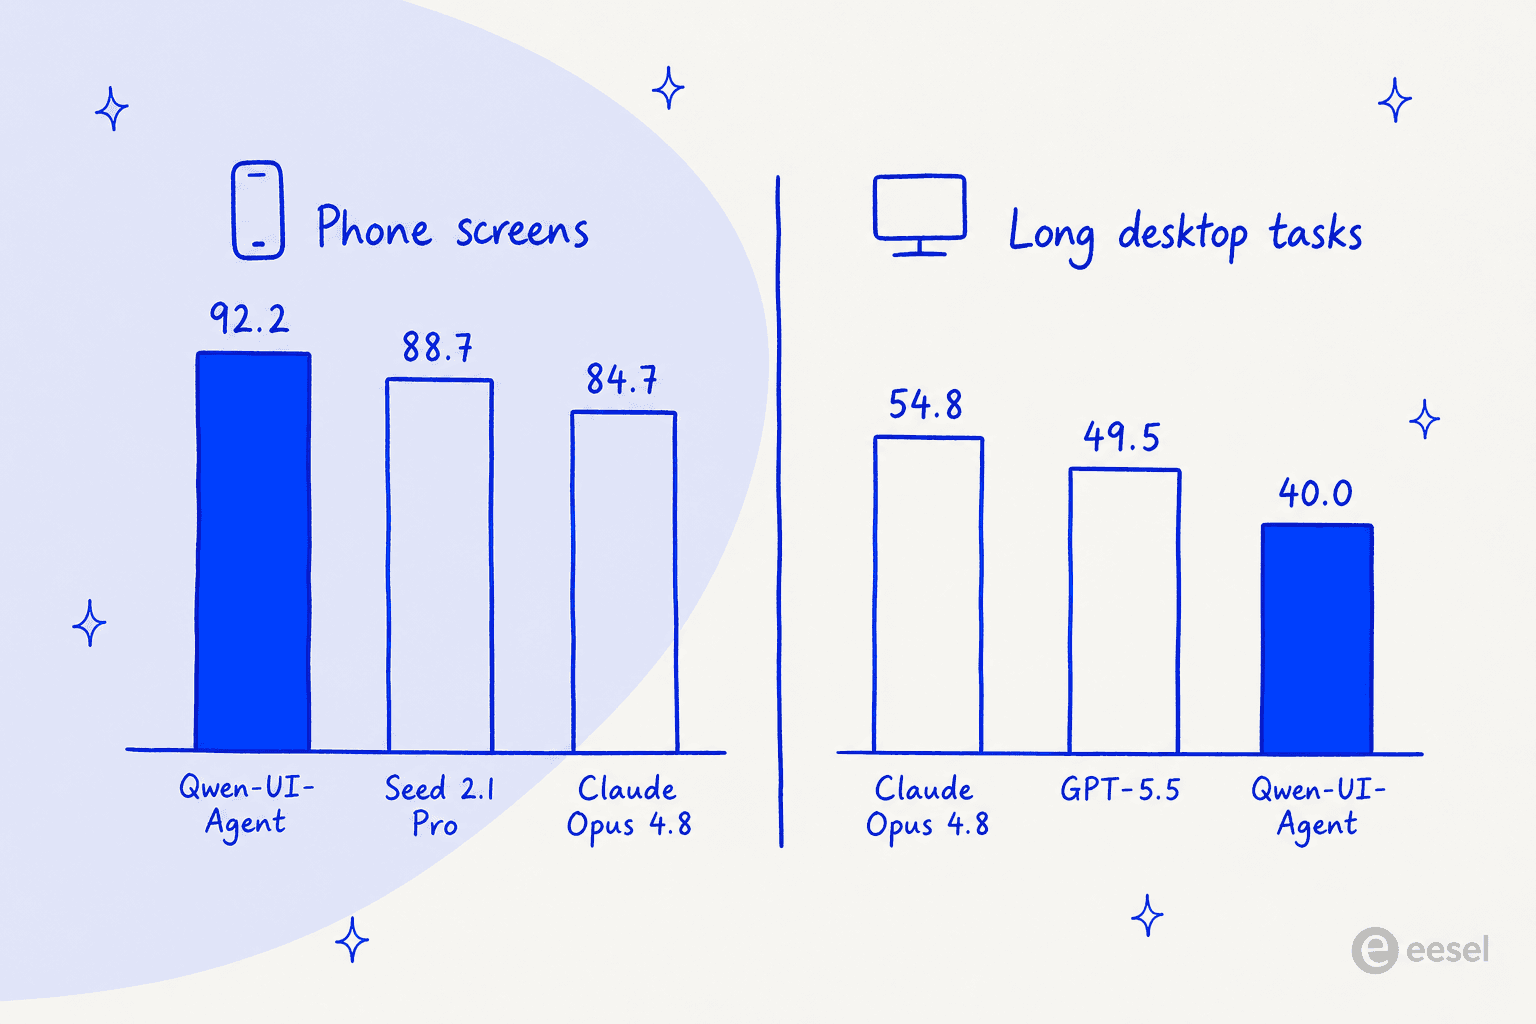
Em celulares, ele vence com clareza
| Benchmark móvel | Qwen-UI-Agent | Seed 2.1 Pro | Gemini 3.1 Pro | GPT-5.6 Sol | Claude Opus 4.8 |
|---|---|---|---|---|---|
| MobileWorld | 82.1 | 73.2 | 58.1 | 70.1 | 67.5 |
| MobileWorld-Real | 92.2 | 88.7 | 86.2 | 85.4 | 84.7 |
| AndroidDaily | 97.5 | 95.2 | 93.8 | 92.6 | 93.0 |
A margem no MobileWorld é a que mais se destaca para mim. Quase nove pontos à frente do modelo seguinte, e mais de 14 pontos à frente do GPT-5.6 Sol, em um benchmark em que as tarefas envolvem trocas interativas entre agente e usuário em vez de execução às cegas. Não são diferenças de arredondamento.
No desktop ele é competitivo, e depois não é
| Benchmark de computador e navegador | Qwen-UI-Agent | Claude Opus 4.8 | GPT-5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|
| OSWorld-Verified | 79.5 | 83.4 | 78.7 | 76.2 |
| OSWorld-v2 (progresso parcial) | 40.0 | 54.8 | 49.5 | não reportado |
| WebArena | 73.6 | 71.9 | 69.5 | 65.3 |
O OSWorld-Verified é um quase. Quatro pontos atrás do Claude Opus 4.8, mas ainda à frente do GPT-5.5 e do Gemini 3.1 Pro. O WebArena ele leva por inteiro. Depois o OSWorld-v2, o conjunto de longo prazo, abre uma lacuna de 14,8 pontos em relação ao Opus 4.8.
O padrão combina com o que o treinamento móvel indica. Tarefas de celular são curtas, delimitadas e muito praticadas dentro daquela frota de dispositivos reais. Fluxos longos de desktop são onde os modelos desviam, e o desvio é a coisa mais difícil de eliminar com treinamento. O próprio resumo da Alibaba usa a palavra "competitivo" para uso de computador e "estado da arte" só para móvel. É uma descrição justa, que a maior parte da cobertura então achata em uma única afirmação.
No grounding, ele varre
Grounding é a habilidade chata que decide se qualquer coisa acima realmente funciona. O modelo consegue colocar o cursor no pixel certo? O Qwen-UI-Agent lidera todos os benchmarks de grounding do relatório: 81,5% no ScreenSpot-Pro com zoom, 76,6% sem zoom, 97,5% no SS-V2, 70,0% no UI-Vision.
O número sem zoom é o honesto aqui. O zoom é um truque de harness que recorta e reexamina a tela, então um modelo que só vence com ele está se apoiando em andaime. Vencer sem ele significa que a percepção em si é real.
E o modelo geral por baixo?
A Alibaba também reporta que o treinamento GUI não lobotomizou o modelo base, e publica uma comparação com o Qwen3.5-27B para provar.
| Benchmark geral | Qwen-UI-Agent | Qwen3.5-27B |
|---|---|---|
| MMLU-Pro | 86.5 | 86.0 |
| MMMU-Pro | 72.4 | 73.5 |
| MathVision | 82.8 | 82.0 |
| IFEval (strict) | 90.2 | 90.4 |
| Tau2-Bench | 89.9 | 89.2 |
| Terminal-Bench 2.0 | 50.1 | 41.1 |
| BrowseComp-ZH | 75.0 | 62.1 |
O Terminal-Bench subir nove pontos e o BrowseComp-ZH treze é o que se esperaria de um modelo ensinado a usar um shell e a pesquisar. A pequena queda no MMMU-Pro e no IFEval é o imposto por isso, e é um imposto pequeno. Uma linha vai na outra direção: o QwenClawBench cai de 48,5 para 44,2, o que o relatório publica em vez de esconder.
O que os números não dizem
Três ressalvas. Para crédito da Alibaba, duas delas vêm da própria Alibaba.
Toda pontuação foi reproduzida no ambiente dos próprios autores. A nota de avaliação no site do projeto diz isso diretamente e acrescenta que algumas configurações de harness, juiz, simulador, runtime ou subconjunto de tarefas diferem das avaliações oficiais. Várias das linhas de concorrentes trazem uma adaga que as marca como reproduzidas pelos autores em vez de copiadas do relatório do próprio fornecedor. Isso é mais transparência do que a maioria dos lançamentos de modelos se dá ao trabalho de oferecer, e também significa que não são as mesmas condições sob as quais os fornecedores publicaram.
As demos são construídas sobre o ecossistema de apps chinês. Douyin, Hema, Trip.com, Amap, Dianping, Xiaohongshu, 12306, DingTalk, Beike. A engenharia generaliza. Os 92,2% específicos não se transferem automaticamente para uma frota de celulares rodando Slack, Shopify e Gmail. Se os seus fluxos são de SaaS ocidental, trate esse número móvel como um sinal forte sobre o método, e não como uma promessa sobre os seus próprios apps.
O repositório do site entrega o estado do lançamento. O repositório do próprio site do projeto ainda traz uma instrução de edição para substituir os cartões de recursos "em breve" pelas URLs finais do relatório, do código e dos checkpoints no momento do lançamento, e uma nota de que os números de resultado que entram em conflito no rascunho são deliberadamente omitidos até que os valores sejam congelados. É um projeto ainda em andamento, não um produto lançado.
Dá para executá-lo hoje?
Não. E esta é a seção que eu leria primeiro se fosse você.
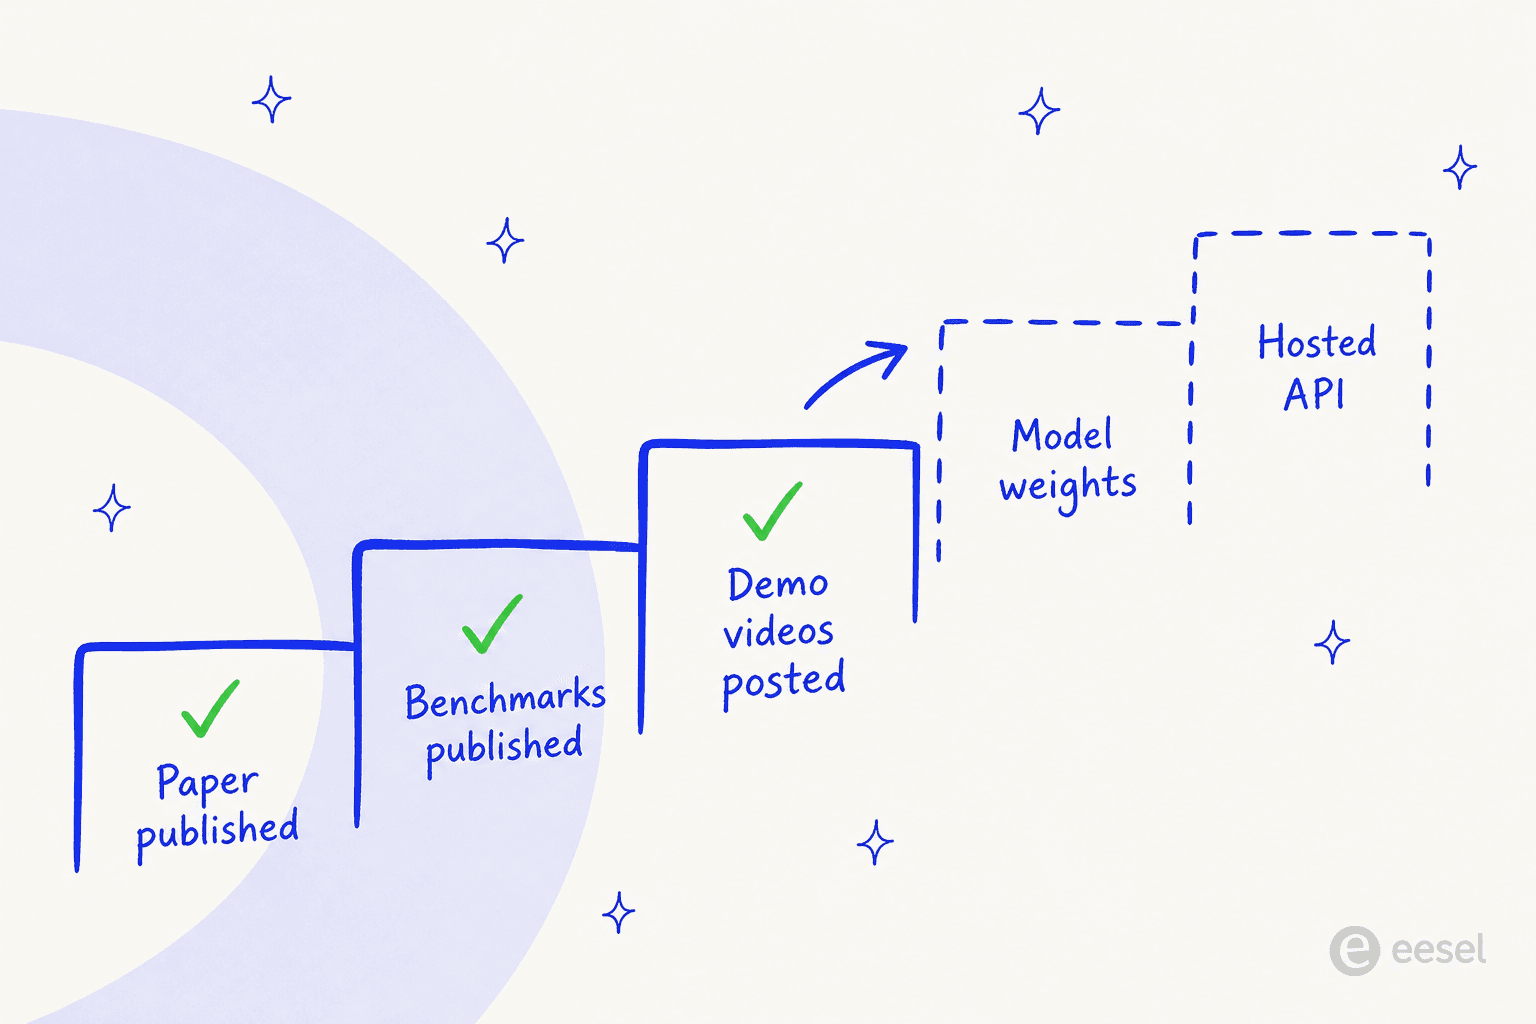
Isto é o que conferi, em 24 de agosto de 2026:
- A organização Tongyi-MAI no Hugging Face lista quatro modelos: Z-Image, Z-Image-Turbo, MAI-UI-8B e MAI-UI-2B. Nenhum Qwen-UI-Agent.
- A página do artigo reporta zero modelos, zero datasets e zero Spaces vinculados.
- O repositório do GitHub chamado Qwen-UI-Agent é apenas o código-fonte do site, e diz isso em negrito no topo do readme.
- O repositório de implementação, Tongyi-MAI/MAI-UI, tem 2,2k estrelas e nenhum release, nenhuma tag e nenhum link de checkpoint para este modelo.
- Não há entrada do Qwen-UI-Agent no catálogo de modelos da Alibaba, então não há endpoint nem tabela de preços.
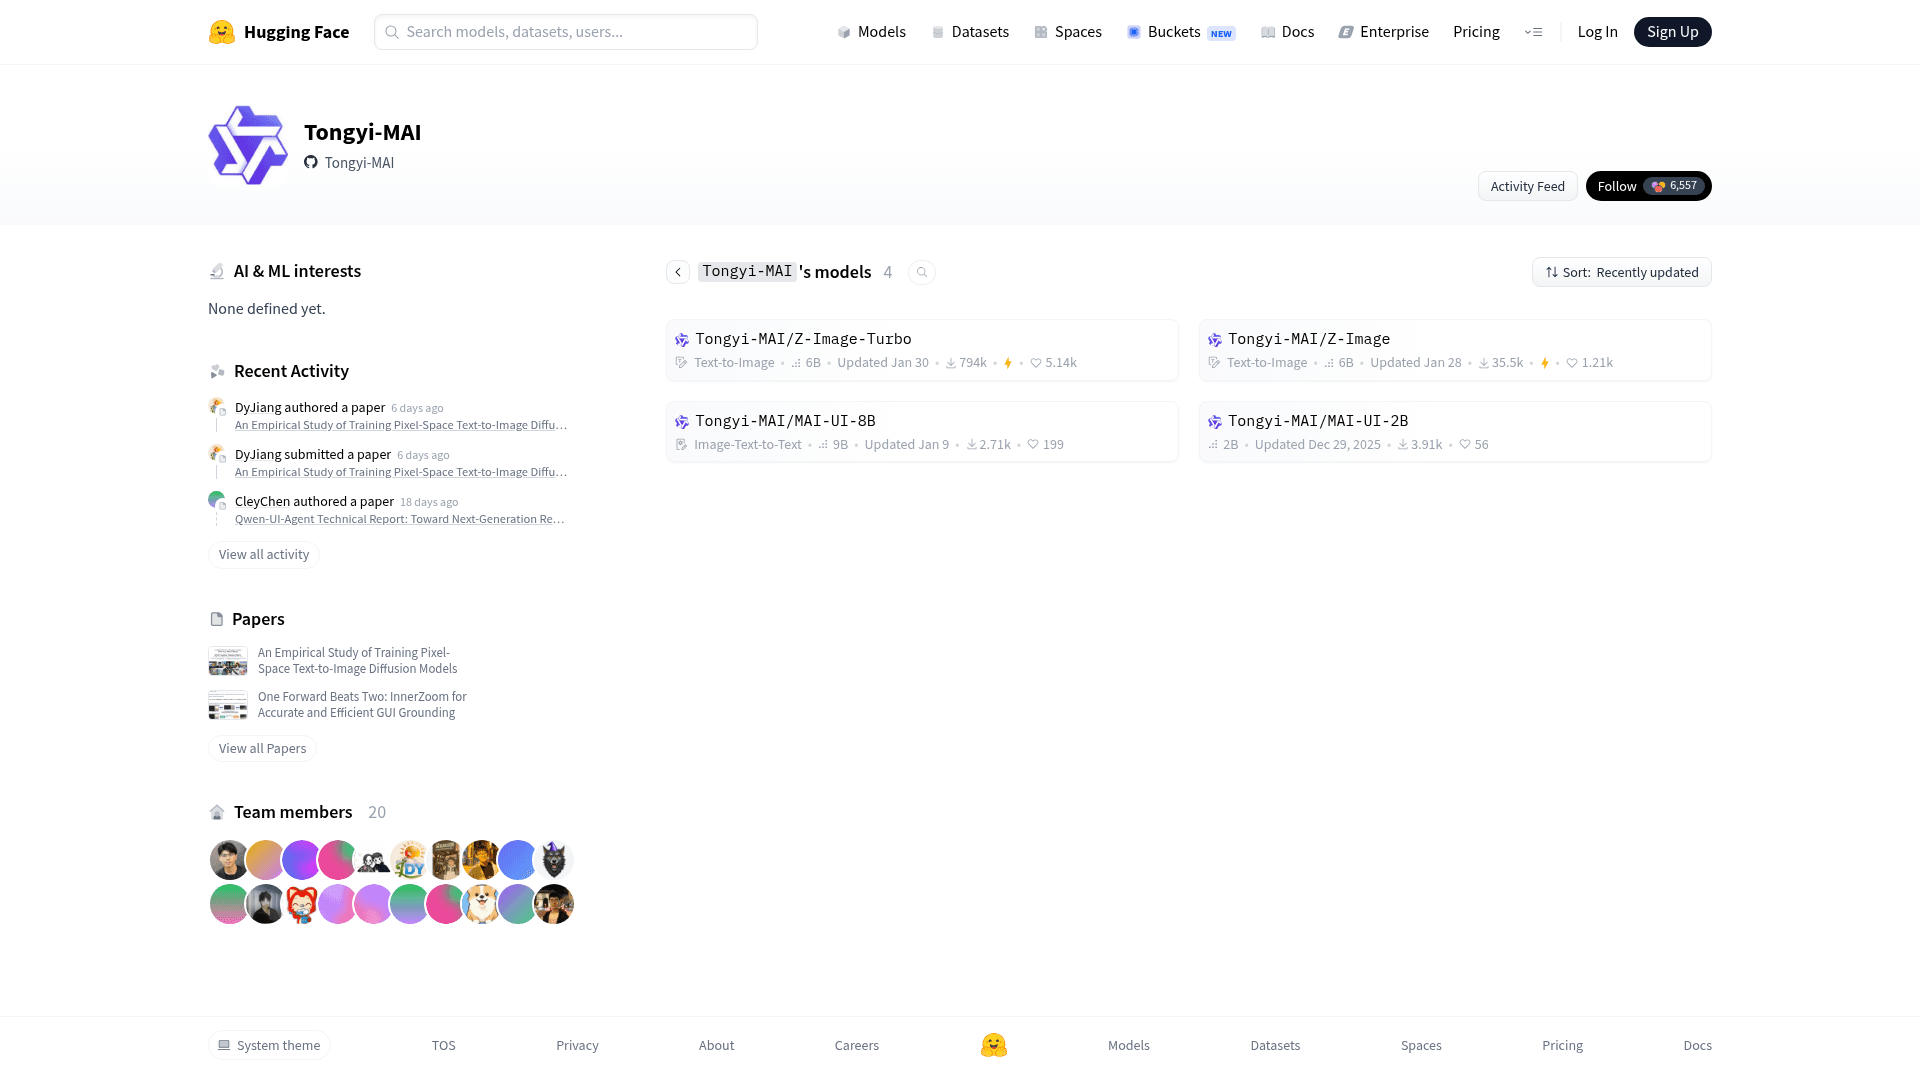
O único sinal animador é o precedente. A mesma equipe lançou o MAI-UI 8B e 2B em dezembro de 2025, e o readme afirma que o projeto tem licença Apache 2.0. A Alibaba também liberou pesos para sua linha principal, como nossa análise do Qwen 3.8 Max cobre. Então um lançamento aberto é plausível o bastante. Só não é algo em que se possa planejar um trimestre.
Se você precisa de algo que possa chamar neste mês, a lista curta prática passa pelas alternativas ao Qwen e pelo Kimi K3. Para uma opção aberta mais barata, há o DeepSeek V4 Flash.
O que isso significa se você gerencia uma fila de suporte
Quero ser cuidadoso nesta seção, porque "agente GUI marca 89,9 em um benchmark de suporte" é exatamente o tipo de manchete que acaba dentro de uma apresentação para a diretoria.
O Tau2-Bench é um benchmark real, e 89,9 é uma boa pontuação nele. Mas olhe o que ele mede em comparação com o que um líder de suporte realmente precisa. Nas chamadas ouço os mesmos requisitos voltando várias vezes. Treine com os nossos próprios tickets passados. Coloque uma citação em cada resposta. E nos deixe ver o que ele teria feito, antes de fazer. Um agente que controla a tela estruturalmente não consegue dar a segunda nem a terceira. Ele clica. Não há um objeto de resposta no qual anexar uma fonte, e também não existe modo de simulação para um mouse, razão pela qual a prevenção de alucinações em suporte começa pelo escopo e não pela escolha do modelo.
Uma equipe de suporte de hardware com quem conversei, tratando cerca de 250 tickets por mês no Zendesk em vários idiomas, transformou as citações em requisito obrigatório antes de qualquer coisa ir ao ar. Outra, uma empresa de serviços de TI do setor público que está perdendo dois agentes seniores neste ano, queria a IA treinada nos próprios tickets resolvidos, justamente para que o conhecimento de quem sai não fosse embora junto. Nenhum dos dois é um problema de tela. Ambos são problemas de recuperação e governança, mais próximos das questões de qual LLM serve para suporte do que de qualquer coisa neste artigo, e por isso o melhor modelo de IA para tickets de suporte raramente é o maior.
O padrão que realmente funciona é um padrão tedioso, e vale para quase todas as implantações que vi. Começar em modo rascunho, em que a IA escreve e um humano envia. Depois evoluir para a automação total quando os números tiverem merecido. Esse é o formato do trabalho de assistência de agentes de IA, e é por isso que contenção e qualidade de escalonamento são melhores preditores de uma implantação bem-sucedida do que qualquer benchmark desta página. O controle de qualidade de suporte é a outra metade desse ciclo.
Onde um agente GUI realmente conquista seu lugar é na longa cauda de operações internas para as quais ninguém nunca construiu uma API. Um painel de administração legado. Um portal de fornecedores ou alguma ferramenta interna de 2014. Isso é valor real, e também é subestimado. É apenas um trabalho diferente de resolver tickets de clientes, do mesmo modo que a automação de fluxos de trabalho é um trabalho diferente da deflexão de tickets.
Onde a eesel se encaixa
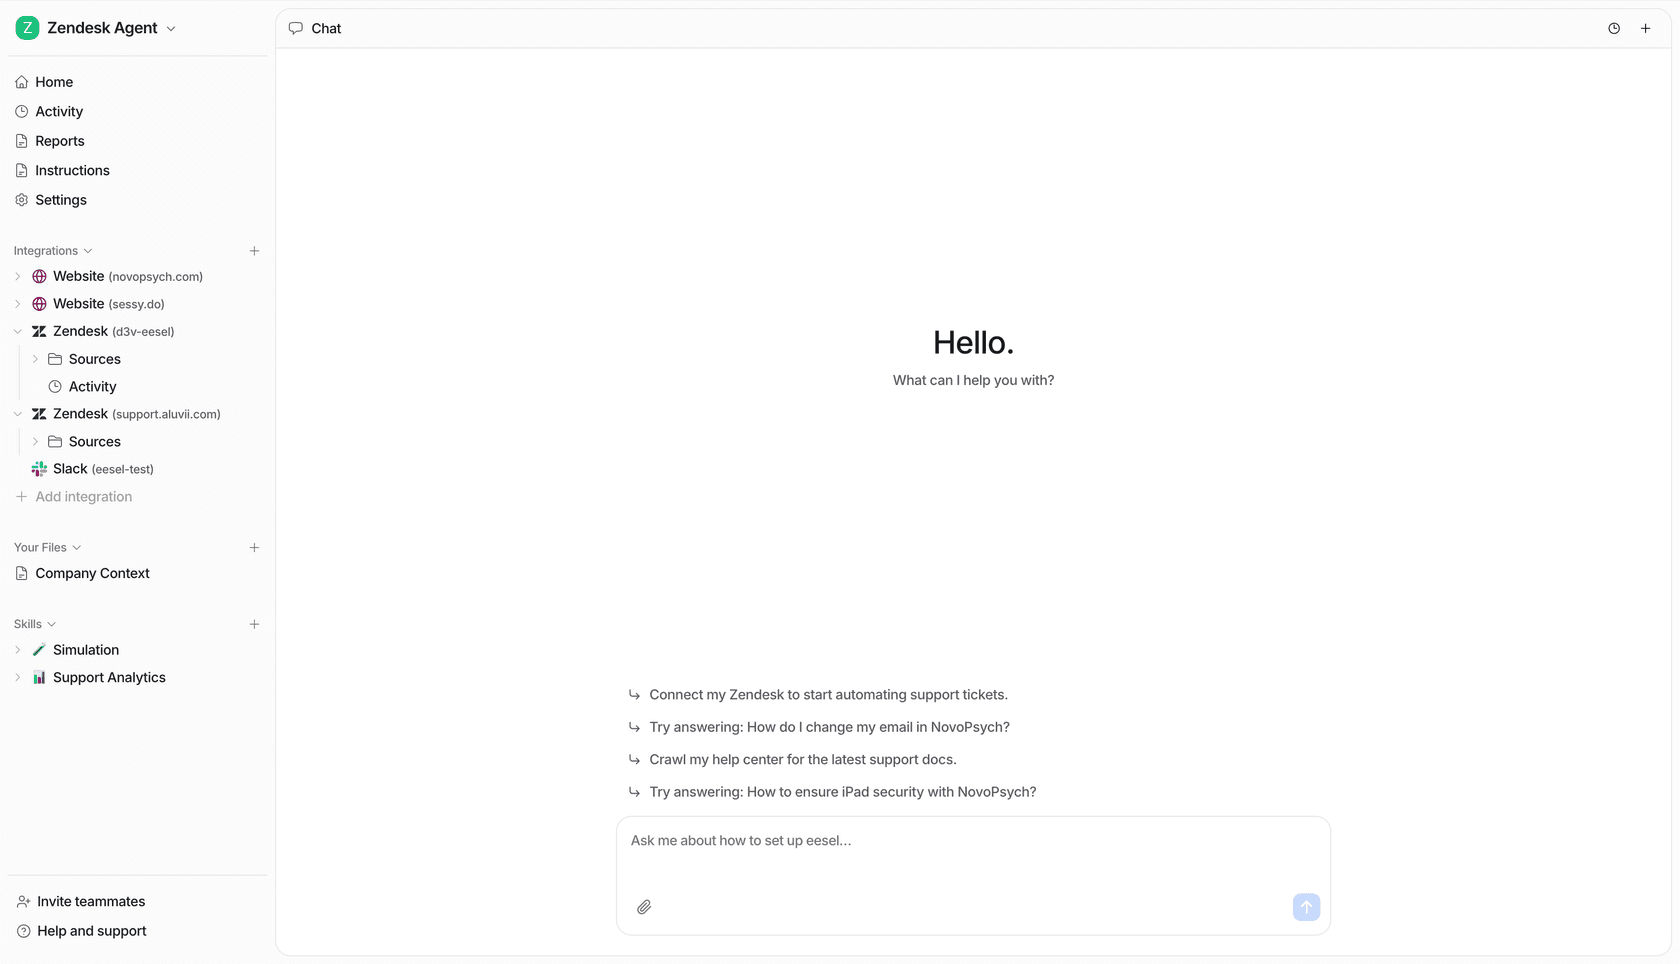
Se você está lendo um artigo sobre agentes GUI porque o que realmente quer é uma fila de helpdesk menor, o atalho é pular totalmente a camada de tela. A eesel se conecta direto ao Zendesk, Freshdesk, Gorgias e o resto, aprende com os seus próprios tickets passados e central de ajuda em vez de um rastreamento público, e cita a fonte em cada resposta que dá. Ela se comporta menos como um controlador de tela e mais como a abordagem de colegas de equipe de IA e funcionário de IA que usamos para este trabalho.
A parte que mais importa para esta comparação: você pode executá-la em simulação sobre milhares dos seus tickets históricos e ler exatamente o que ela teria respondido, antes que um único cliente a veja. Esse é o passo de "prove primeiro" que uma pontuação de benchmark nunca pode substituir, e leva minutos em vez de um ciclo de compras. Teste grátis.
Para quem é o Qwen-UI-Agent
Vale acompanhar de perto se você está construindo automação móvel, faz QA em dispositivos Android reais ou pesquisa agentes GUI e quer o método mais bem documentado atualmente. O ciclo de treinamento em dispositivos reais e o espaço de ações GUI mais CLI são as duas ideias com maior chance de aparecer no próximo lançamento de todo mundo.
Vale ignorar por enquanto se você precisa de algo em produção neste trimestre. Não há nada para implantar. Leia o artigo, anote a técnica e volte quando um checkpoint aparecer. Enquanto isso, o Qwen 3.7 Flash é o modelo da Alibaba que você realmente pode chamar.
Vale ser cético se suas cargas de trabalho são fluxos longos de desktop. Os 40,0% no OSWorld-v2 são o número que deveria guiar essa decisão, e não os 92,2% em celulares. Para esse tipo de trabalho, o Claude Opus 5 e seus antecessores continuam sendo a aposta mais segura, e nosso texto de alternativas ao Opus 5 cobre o resto do campo.
Não é a ferramenta certa de jeito nenhum se você está tentando automatizar o suporte ao cliente. Não porque seja fraco. Ele mira uma superfície diferente, só isso. O que as equipes de suporte precisam é de algo que se conecte ao helpdesk e aprenda com a sua base de conhecimento e com os tickets resolvidos.
A partir daí o trabalho é roteamento, classificação de tickets e escalonamentos de suporte limpos quando um humano é necessário. Controlar a tela não é o gargalo ali, e tratá-lo como tal é como as equipes acabam com uma demo impressionante e uma fila inalterada.
O veredito
O Qwen-UI-Agent é o artigo sobre agentes GUI mais interessante do ano e o produto menos utilizável desta comparação. As duas coisas são verdade ao mesmo tempo.
O resultado móvel é a manchete real e merece ser: 92,2% em mais de 400 tarefas em uma frota de celulares físicos, superando quatro modelos de fronteira, não é um artefato de benchmark. O método por trás, em particular a mistura de comandos de shell no fluxo de cliques e o agrupamento de ações por turno, é o tipo de ideia que é copiada.
O resultado de desktop é a ressalva real: 40,0% em uso de computador de longo prazo contra 54,8% do Claude Opus 4.8 é uma lacuna ampla, e o trabalho de desktop de longo prazo é de qualquer forma a maior parte do que as pessoas querem dizer com "uso de computador" em um contexto empresarial.
E a disponibilidade é o bloqueio real. Apache 2.0 em um readme é uma intenção. Até que um checkpoint realmente apareça, isto é pesquisa para aprender, não software para comprar. Se a fila à sua frente é uma fila de suporte e não uma tela, o melhor agente de IA não será o que clica mais rápido. Será o que você pôde testar nos seus próprios tickets antes de confiar nele.