Alternativas ao Qwen-UI-Agent: 8 agentes de GUI que você pode usar de verdade em 2026

Rama Adi

Katelin Teen
Última edição August 24, 2026
Você não consegue trocar o Qwen-UI-Agent por outro, porque ainda não há nada de que trocar. A equipe Tongyi MAI da Alibaba publicou um relatório técnico em 30 de julho de 2026 com números móveis excelentes e depois não lançou nenhum checkpoint, nenhuma API e nenhum preço. A organização no Hugging Face lista quatro modelos e nenhum é este. Então procurar alternativas é, na verdade, procurar um agente de GUI que exista.
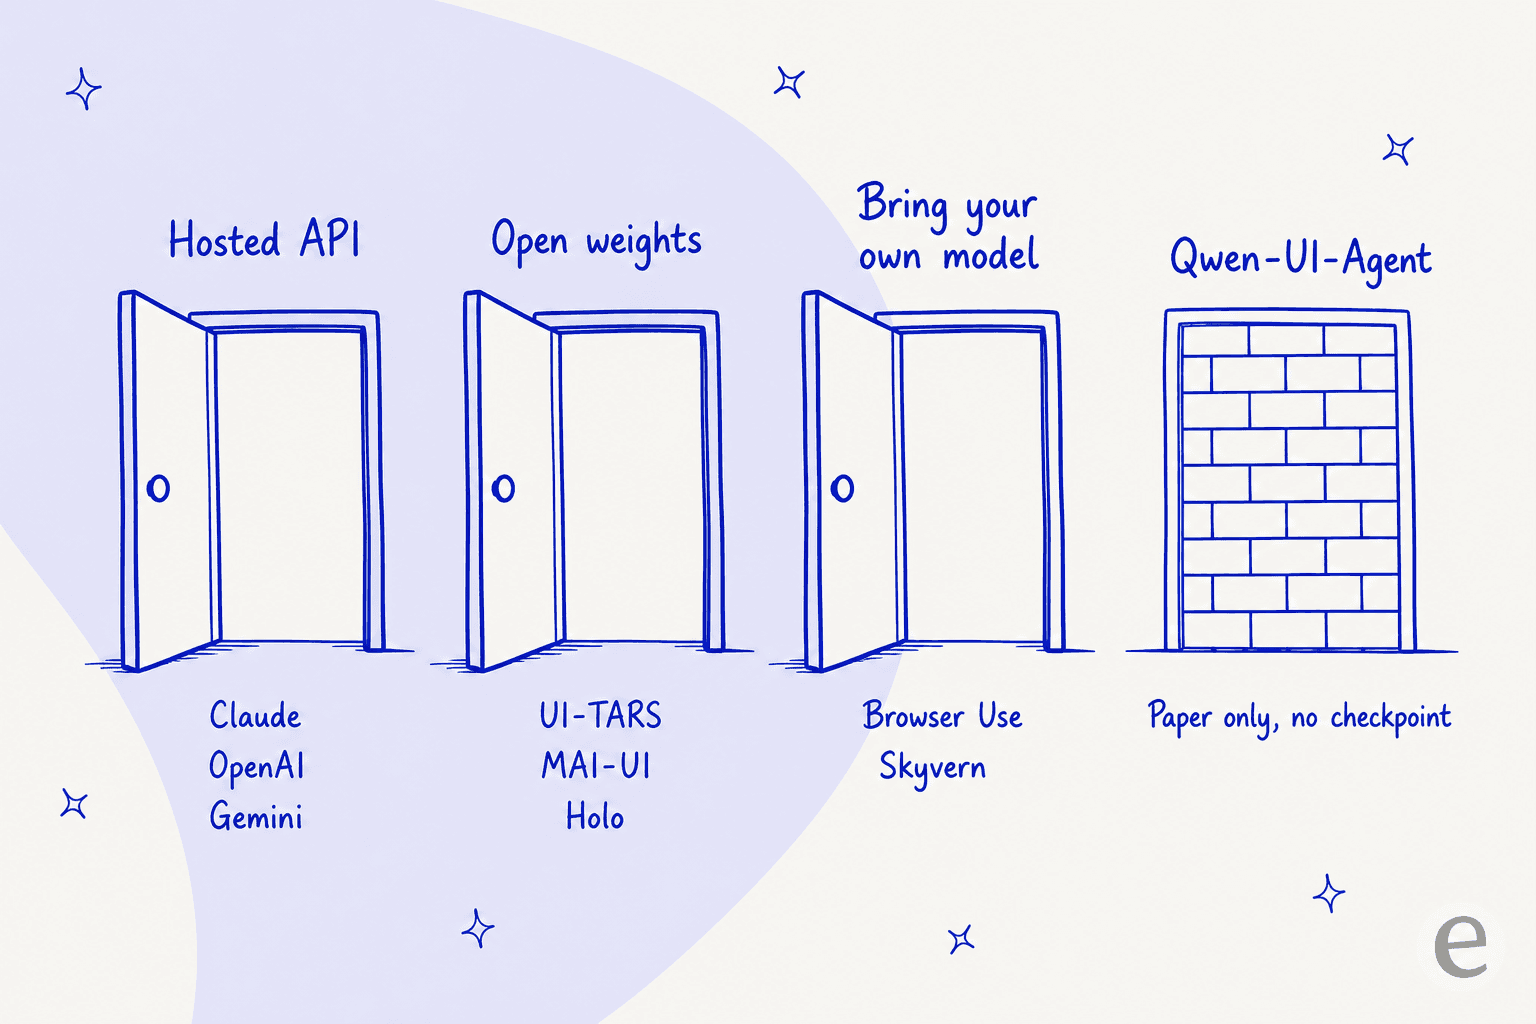
Existem oito, e eles se dividem em três caminhos em vez de um ranking. As APIs hospedadas de Anthropic, OpenAI e Google dão os modelos mais fortes e a melhor infraestrutura de segurança, com o Google sendo o único que também controla o Android. Os pesos abertos de UI-TARS, MAI-UI e Holo 3.1 dão Apache 2.0 e um laptop sob seu controle, com um custo real em precisão. Browser Use e Skyvern não dão nem um modelo nem um mistério: controlam o Chromium com o LLM que você apontar para eles, e são o jeito mais barato de concluir uma tarefa na web.
Duas coisas me surpreenderam. Todo agente de GUI de pesos abertos que você pode baixar é um ajuste fino do Qwen, então deixar a Alibaba é uma decisão de licença e não de arquitetura. E nos próprios traços do Qwen-UI-Agent, 55,1% das ações no benchmark de desktop mais difícil foram comandos digitados, não cliques. O melhor agente de controle de tela do mundo evita a tela quando pode. Se o trabalho que você tinha em mente são tickets de suporte, aceite a dica: a eesel conversa com Zendesk e Gorgias por meio das APIs e deixa você fazer um teste a seco com os tickets do mês passado, algo que nenhum mouse consegue.
O que as pessoas realmente procuram quando pesquisam isso
Eu construo integrações para viver, então meu primeiro instinto com qualquer novo modelo de agente é procurar o endpoint. Com o Qwen-UI-Agent não existe nenhum.
O que é uma pena, porque a Alibaba normalmente entrega. Se você chegou aqui pela nossa lista de alternativas ao Qwen ou pela análise do Qwen, sabe que os modelos de texto têm tabelas de preços públicas e endpoints reais. Este não tem.
Vale ser preciso, porque a cobertura não foi. O site do projeto tem exatamente três botões: relatório técnico, GitHub e um vídeo de demonstração. O repositório no GitHub tem 2,2k estrelas e zero versões, zero tags e zero pacotes. A organização Tongyi-MAI no Hugging Face publica Z-Image, Z-Image-Turbo, MAI-UI-8B e MAI-UI-2B, e essa é a lista inteira. Apache 2.0 aparece no README, mas uma licença em um repositório de figuras não é um modelo que você possa executar.
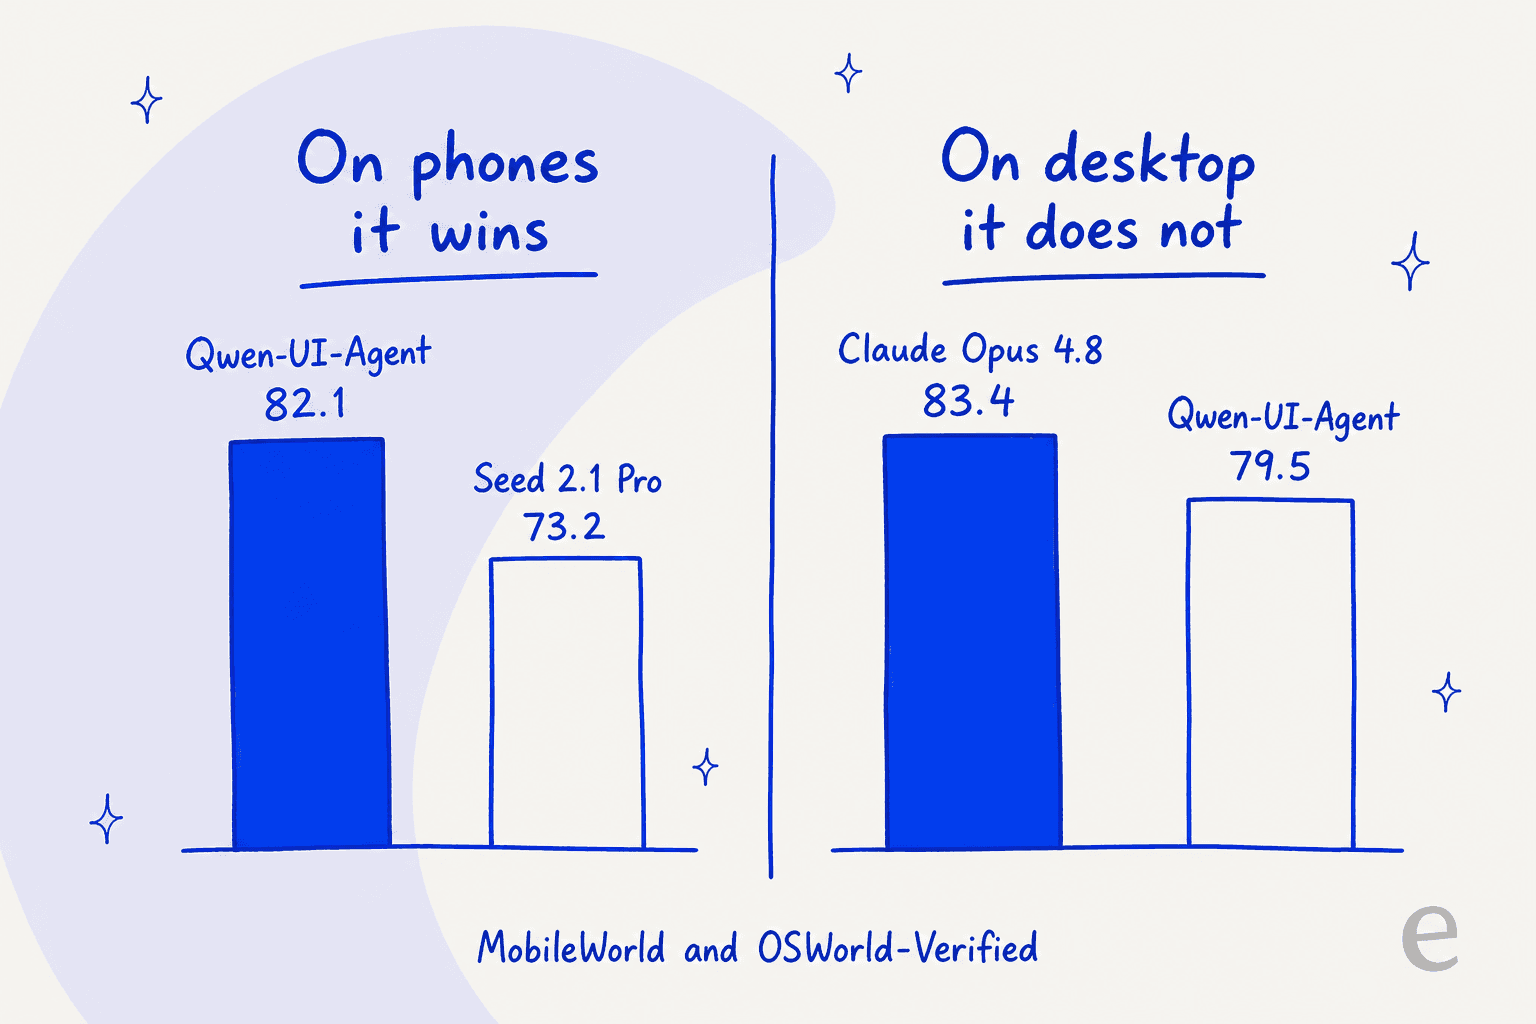
Nada disso torna o trabalho pior. A manchete do artigo é uma variante de 27B que os autores chamam de modelo principal para a avaliação de ponta a ponta, segundo o relatório técnico, e em celulares é com folga o melhor que alguém já publicou: 82,1% no MobileWorld contra 73,2 do Seed 2.1 Pro, e 92,2% em um benchmark reservado de 409 tarefas em 104 apps Android reais, executado em uma frota de mais de 100 aparelhos físicos. Esse último número é o interessante, porque foi medido em dispositivos reais e não em emuladores.
No desktop é onde a história se achata no recontar. Um resumo semanal muito compartilhado colocou assim:
"Alibaba also released Qwen-UI-Agent, a 27B GUI agent model that claims top scores on MobileWorld (82.1%), OSWorld-Verified (79.5%), and WebArena (73.6%), beating GPT-5.6 Sol, Claude Opus 4.8, and Gemini 3.1 Pro."
O próprio gráfico da Alibaba diz outra coisa sobre o número do meio. No OSWorld-Verified, o Claude Opus 4.8 marca 83,4 e o Qwen-UI-Agent marca 79,5, e o artigo afirma claramente que fica em segundo, atrás apenas do Opus 4.8. No conjunto mais difícil de longo prazo, o OSWorld-v2, a diferença aumenta para 40,0 contra 54,8 do Opus 4.8 em progresso parcial. A afirmação de "superar" vale para celular e para o WebArena. Não vale para o benchmark de desktop que a maioria dos compradores cita.
Vale lembrar também que essa categoria tem histórico de prometer demais. A Adept AI lançou o ACT-1, o primeiro agente sério que clicava em telas, e depois mudou de rumo; a Rabbit AI vendeu um grande modelo de ações dentro de um aparelho de consumo. Demonstrações de agentes operando software já correram à frente da realidade antes, um bom motivo para ler cada gráfico deste artigo duas vezes.
Então o enquadramento honesto deste artigo todo: você não está substituindo um produto, está escolhendo o seu primeiro. E a escolha depende menos da pontuação do que de por qual das três portas você entra.
O que diz o ranking neutro
Quase todo número da seção anterior é informado pelo próprio fornecedor, inclusive o da Alibaba. Então, antes da lista, aqui está o mesmo benchmark executado por alguém sem nada a vender.
O OSWorld-Verified tem um quadro mantido pelos mantenedores, em que a equipe do OSWorld avalia as submissões por conta própria, com configurações unificadas, nas mesmas 361 tarefas. Ele não aparece como tabela na página, é carregado no cliente a partir de uma planilha, então aqui estão os oito melhores resultados desse arquivo.
| Posição | Agente ou modelo | Instituição | Tipo | Taxa de sucesso |
|---|---|---|---|---|
| 1 | Intelligence-Indeed Agent | Intelligence Indeed | Framework de agentes | 90.19 |
| 2 | claude-fable-5[1m] | Anthropic | Modelo geral | 85.96 |
| 3 | Pointer Agent w/ Opus 4.7 | Pointer | Framework de agentes | 83.64 |
| 4 | claude-opus-5[1m] | Anthropic | Modelo geral | 83.39 |
| 5 | Coasty CUA v1 | Coasty Team | Modelo geral | 82.81 |
| 6 | Holo3-35B-A3B | H Company | Modelo especializado | 82.56 |
| 7 | Pointer Agent w/ Sonnet 4.6 | Pointer | Framework de agentes | 81.45 |
| 8 | Muse Spark 1.1 | Meta Superintelligence Labs | Modelo geral | 80.67 |
Disso saem três coisas, e todas moldaram este artigo.
O Qwen-UI-Agent não está nele e não pode estar. A regra de submissão do quadro é que você marca uma reunião e os mantenedores executam o código do seu agente do lado deles. Sem checkpoint e sem API, não há nada para eles executarem. As únicas entradas da Alibaba em toda a planilha de 66 entradas são o Qwen 3.7 Plus com 73,3 e o GUI-Owl-1.5 32B com 55,44. Se você tomar os 79,5 autodeclarados da Alibaba ao pé da letra e colocá-los nesta tabela, ficam em 9º de 66, fora dos oito primeiros.
O líder é um arnês, não um modelo. Cinco dos doze primeiros são frameworks de agentes que envolvem o modelo de outra pessoa, e a entrada número um é um deles, com 90,19. Se você esperava comprar um modelo e pronto, o quadro diz que o andaime vale mais pontos que os pesos.
Um modelo de pesos abertos está de fato na disputa. O Holo3-35B-A3B está em 6º com 82,56, que é mais que a afirmação publicada pela própria H Company de 78,85 e foi verificado por alguém que não é a H. É o número mais crível para qualquer agente de GUI baixável, e subiu o Holo na minha lista.
Vale notar para quem for citar esses números: o desempenho humano no OSWorld é de 72,36%, e tudo nesses doze primeiros agora está acima disso. Também um detalhe de nomenclatura para tomar cuidado: a Anthropic autodeclara 83,4 para o Opus 4.8, enquanto a linha com 83,39 nesta planilha se chama claude-opus-5[1m] e não existe nenhuma linha de Opus 4.8 ali. O número bate, o rótulo não.
Como escolhi e o que medi
Passei esta semana nas documentações, fichas de modelo, arquivos de licença e tabelas de preços de cada candidato, e descartei tudo que não consegui verificar nas páginas do próprio fornecedor. Seis coisas decidiram a lista.
Se você consegue obter hoje. Um artigo não é uma alternativa. Ou os pesos são baixáveis, ou há um endpoint com preço, ou está fora.
Quem fornece a tela. Todos esses precisam de algo para controlar: uma VM, um Chromium sem interface, um dispositivo Android. Quase nenhum fornece. Esse é o item de custo que todos esquecem.
Quais telas ele controla. Navegador, desktop e celular são três produtos diferentes com o mesmo nome, e os fornecedores não são igualmente honestos sobre quais fazem.
De quem é o arnês que produziu a pontuação. Todo número deste artigo é informado pelo fornecedor, a menos que eu diga o contrário, e vários foram medidos em benchmarks modificados. Eu aviso toda vez. O tamanho dessa diferença também não é hipotético. Em um tópico do Launch HN, um fundador foi questionado sobre uma alegação de SOTA e respondeu com as duas cifras em uma só frase:
"We've hit 82.8% on OSWorld Verfied(on the official page) and with our latest internal testing we're hitting 85.6% which we've posted"

Isso é um prêmio autodeclarado de 2,8 pontos, dito com honestidade, por um fornecedor cujo número no quadro neutro posso ir conferir. Presuma que algo parecido esteja por trás de cada gráfico dessa categoria, inclusive o da Alibaba.
Quanto custa uma execução. Não o preço por milhão, mas o custo por execução, que é dominado pelo número de passos porque cada passo reenvia toda a trajetória mais uma captura de tela nova. Se quiser a mesma aritmética aplicada a equipe, nossa comparação de custo de agentes faz isso. Os profissionais acompanham isso obsessivamente, e os números deles não são gentis:
"Numbers I was seeing: - 20 to 50 LLM calls per task - $0.50 to $3.00 per task at Claude Sonnet 4.6 prices - Half the runs drifted off-task halfway through"

Se você consegue testar antes da produção. É o que mais importa na prática e o que ninguém resolve. É um problema mais ou menos resolvido para agentes de texto, como mostra nosso guia do OpenAI Evals, e um problema sem solução assim que a saída é um movimento de mouse.
Sobre o custo, aqui está a aritmética que mudou como penso os orçamentos de agentes de GUI. Arraste o número de passos e veja a curva se dobrar.
As oito alternativas num relance
| Ferramenta | Melhor para | Como obter | Telas que controla | Licença ou preço | Melhor pontuação publicada e de quem é o arnês | Quem fornece a tela | Teste a seco antes da produção | Defesa contra injeção | Plano gratuito |
|---|---|---|---|---|---|---|---|---|---|
| Claude computer use | Trabalho de desktop que precisa estar certo | API hospedada, GA | Desktop, navegador | Opus 5 $5 / $25 por MTok | 83.4% OSWorld-Verified (Opus 4.8, Anthropic) | Você | Não | Classificadores ativados por padrão | Não |
| Gemini computer use | Uma API para celular e desktop | API hospedada, flag de prévia | Navegador, celular, desktop | 3.7 Flash $0.75 / $3.75 por MTok | 83.0% OSWorld-Verified (3.6 Flash, Google) | Você | Não | Opcional, desativada por padrão | Não |
| OpenAI computer use | Equipes que já usam a Responses API | API hospedada, GA | Desktop, navegador | Sol $4 / $20, Luna $0.20 / $1.20 | 92.8% Online-Mind2Web (OpenAI) | Você | Não | Política publicada, você aplica | Não |
| ByteDance UI-TARS | Uma licença permissiva que você pode distribuir | Pesos no Hugging Face | Desktop, navegador, Android via modelo | Apache 2.0 | 27.5% OSWorld para o 8B aberto (ByteDance) | Você | Não | Nenhuma | Pesos são gratuitos |
| MAI-UI 8B e 2B | O primo baixável mais próximo | Pesos no Hugging Face | Celular, desktop | Apache 2.0 | 65.7% ScreenSpot-Pro para o 8B (Alibaba) | Você | Não | Nenhuma | Pesos são gratuitos |
| Holo 3.1 | Pesos abertos com alternativa hospedada | Pesos mais API hospedada | Web, desktop, celular | Apache 2.0, API $0.25 / $1.80 | 82.56% OSWorld-Verified, 6º (quadro dos mantenedores) | Você, ou os agentes gerenciados da H | Não | Não documentada | 10 RPM, sem cartão |
| Browser Use | Tarefas de navegador em grande volume | Biblioteca Python mais nuvem | Somente navegador | Biblioteca MIT, nuvem a partir de $29/mês | 87.4% no Odysseys (hospedado por terceiros) | A nuvem fornece o Chromium | Não | Não documentada | 10 tarefas/mês |
| Skyvern | Fluxos com login e 2FA no caminho | Autohospedado ou nuvem | Somente navegador | AGPL-3.0, nuvem a partir de $29/mês | 85.85% WebVoyager, jan. 2025 (Skyvern) | A nuvem fornece o Chromium | Não | Não documentada | 5.000 créditos |
Duas colunas merecem atenção. Ninguém oferece um teste a seco, a maior lacuna operacional de toda a categoria. E quem fornece a tela divide a lista com clareza: os três laboratórios de ponta dão um modelo e desejam boa sorte com a VM, enquanto Browser Use e Skyvern dão um navegador em execução e deixam você escolher o modelo.
1. Claude computer use
Melhor para automação de desktop em que um clique errado sai caro.
Como funciona. Você declara uma única entrada de ferramenta e o modelo da Anthropic devolve ações para o seu código executar. A versão atual é um conjunto de ferramentas do cliente, computer_toolset_20260801, que reúne 17 ferramentas-membro atrás de uma declaração e não precisa de cabeçalho beta. Funciona em Fable 5, Mythos 5, Opus 5, Opus 4.8 e Sonnet 5, e notavelmente não no Haiku 4.5. O legal para quem constrói um pipeline de verdade é que você pode dar ao mesmo modelo uma ferramenta bash e um editor de arquivos no mesmo array tools, para que ele saia da GUI e vá para um terminal no meio da tarefa.
Duas superfícies vizinhas valem conhecer se você for por aqui: o Claude Managed Agents para hospedar e supervisionar o ciclo, e a plataforma desktop do Claude se você preferir limitar um agente a um app em vez de um sistema operacional inteiro.
O que eu gosto. As pontuações são as melhores publicadas em desktop: 83,4% no OSWorld-Verified para o Opus 4.8, e 70,57% no mais novo e mais difícil OSWorld 2.0 para o Opus 5 contra 62,6 do GPT-5.6 Sol. Mas o que realmente valorizo é a camada de segurança. Você declara a ferramenta oficial e a Anthropic executa automaticamente classificadores de injeção de prompt em cada captura de tela, e quando um dispara, o modelo é conduzido a pedir sua confirmação antes de agir de novo. A Anthropic diz que isso roda em paralelo à inferência com latência adicional praticamente zero e sem custo extra. Ninguém mais nesta lista entrega isso ativado por padrão.
Onde fica devendo. Não há história móvel nenhuma. O ambiente de referência é X11 em Linux dentro de um contêiner, o vocabulário é inteiramente de mouse e teclado, e não há toque, deslize ou pinça em nenhum dos 17 membros. Então, justamente no eixo em que o Qwen-UI-Agent é mais forte, isto não é um substituto. A Anthropic também lista a latência como sua primeira limitação, nas próprias palavras possivelmente lento demais em comparação com um humano fazendo os mesmos cliques. E o custo extra de tokens é real: a definição do conjunto de ferramentas custa cerca de 4.520 tokens de entrada em cada requisição antes de você ter enviado um pixel, e cada captura de tela acrescenta de 1.000 a 1.800. Mais uma armadilha para quem implementa: a API não reduz imagens grandes demais para você, ela as rejeita.
Preços.
| Modelo | Entrada / MTok | Saída / MTok | Leitura de cache | Observações |
|---|---|---|---|---|
| Opus 5 | $5.00 | $25.00 | $0.50 | O modo rápido é exatamente 2x |
| Opus 4.8 | $5.00 | $25.00 | $0.50 | Detém a pontuação de 83,4% |
| Sonnet 5 | $2.00 | $10.00 | $0.20 | Conjunto de ferramentas compatível |
| Fable 5 | $10.00 | $50.00 | $1.00 | Conjunto de ferramentas compatível |
| Haiku 4.5 | $1.00 | $5.00 | $0.10 | Conjunto de ferramentas não compatível |
O modo em lote reduz pela metade os dois lados, o contexto completo de 1M roda a tarifas padrão sem degrau, e o uso do computador é elegível para retenção zero de dados porque o ciclo roda do seu lado.
Veredito: se o trabalho acontece em um desktop e o estrago de um erro é mais que um incômodo, é com este que eu começaria, e os classificadores de injeção integrados são o motivo. Pule se o trabalho acontece em um celular, porque ele simplesmente não consegue. Se a preocupação é dependência de fornecedor e não capacidade, nossa lista de alternativas ao Claude cobre o resto do campo. Quem compara os dois grandes fornecedores de API frente a frente aproveita mais nosso guia de APIs da OpenAI vs Anthropic do que um gráfico de benchmark.
2. Gemini computer use
Melhor para cobrir celulares e desktops a partir de um único endpoint hospedado.
Como funciona. Não existe mais um modelo dedicado de uso do computador. O Google incorporou a capacidade em uma ferramenta computer_use embutida que se acopla a modelos Flash gerais, e o antigo gemini-2.5-computer-use-preview-10-2025 agora é rotulado como prévia legada. A ferramenta em si não custa nada extra, cobrada como tokens normais na tarifa do modelo. As coordenadas voltam normalizadas em uma grade de 0 a 999, e o Google é explícito de que é uma ferramenta do lado do cliente, então o ciclo é seu para rodar.
O que eu gosto. É a única API hospedada da lista com um ambiente móvel documentado, e isso é um diferencial real e não uma frase de marketing. Há três tabelas de ações separadas: ENVIRONMENT_BROWSER com 21 ações, ENVIRONMENT_MOBILE com 10 que o Google descreve como otimizadas para Android e que acrescenta open_app, list_apps e long_press enquanto remove scroll e hotkey, e ENVIRONMENT_DESKTOP com 17 para controle do cursor no nível do sistema operacional. A trajetória no desktop também é íngreme: o OSWorld-Verified foi de 65,1 no 3 Flash para 78,4 no 3.5 Flash e 83,0 no 3.6 Flash, o que coloca o Google a meio ponto do melhor da Anthropic. E é de longe a rota hospedada mais barata.
Onde fica devendo. A divulgação é bagunçada de um jeito que vai custar uma tarde. A página de índice de modelos ainda lista só o modelo 2.5 legado entre os modelos de ferramentas e agentes, a maior pontuação de OSWorld que o Google publica pertence a um modelo que a página de uso do computador não lista, e o uso do computador ainda aparece como "Supported (Preview)" mesmo no gemini-3.7-flash já disponível para todos. O Google também não republicou Online-Mind2Web, WebVoyager ou AndroidWorld para nenhum modelo 3.x, então a capacidade móvel tem um espaço de ações documentado e nenhum benchmark atual por trás. A detecção de injeção de prompt existe mas vem desativada por padrão, o oposto da postura da Anthropic. Não há plano gratuito para isso. E o preço do modelo recomendado dobra em 1º de janeiro de 2027.
Preços.
| Modelo | Entrada / MTok | Saída / MTok | Observação |
|---|---|---|---|
gemini-3.7-flash | $0.75 | $3.75 | Recomendado. Sobe para $1.50 / $7.50 em 1 jan. 2027 |
gemini-3.5-flash | $1.50 | $9.00 | |
gemini-3.5-flash-lite | $0.30 | $2.50 | Rota mais barata deste artigo inteiro |
gemini-2.5-computer-use-preview | $1.25 | $10.00 | Prévia legada |
Veredito: a escolha se você precisa de um único fornecedor para navegador, desktop e Android, e a escolha se o custo por execução é a restrição principal. Ative a detecção de injeção antes de fazer qualquer outra coisa e orce 2027 pelo preço pós-aumento. Nosso detalhamento dos preços do Gemini 3 tem a tabela mais ampla se você estiver modelando a sério, e o Gemini Agentic Vision cobre como a captura de tela vira um alvo de clique. Pesar o Google contra o resto do campo é trabalho do nosso artigo de alternativas ao Gemini.
3. OpenAI computer use
Melhor para equipes cuja pilha já termina na Responses API.
Como funciona. O computer-use-preview está obsoleto e fora da tabela de preços. O uso do computador agora é tools: [{ type: "computer" }] nos três níveis do GPT-5.6, sem cobrança por chamada pela ferramenta em si. O guia documenta três formas de arnês em vez de uma, o que apreciei: o ciclo embutido que devolve ações de interface estruturadas, uma ferramenta personalizada sobre um arnês Playwright ou Selenium que você já tenha, e um arnês de execução de código em que o modelo alterna entre clicar e escrever pequenos scripts. O vocabulário de ações tem nove tipos, e eles são agrupados em um array actions[] em vez de irem um a um.
O que eu gosto. Os números de navegador são os mais fortes aqui por larga margem: 92,8% no Online-Mind2Web, 67,3% no WebArena-Verified, 90,4% no BrowseComp. A OpenAI também publica um resultado de cliente e não só um benchmark, relatando 95% de sucesso na primeira tentativa em cerca de 30.000 portais de IPTU, subindo para 100% em até três tentativas. E o nível Luna torna a experimentação barata, com $0,20 de entrada e $1,20 de saída.
Onde fica devendo. Nada de celular, confirmado de cinco formas: os dois ambientes documentados são desktops, as resoluções recomendadas se chamam desktop, não há toque, deslize ou voltar no vocabulário, e todo benchmark publicado é de desktop ou navegador. O modelo de segurança também foi na direção errada. A ferramenta disponível para todos descartou o handshake pending_safety_checks da era da prévia, então o que você recebe agora é uma política de confirmação de três níveis publicada, um trecho de prompt contra injeção pronto para colar e a instrução de manter uma lista de domínios permitidos, tudo o que você mesmo implementa. Vale saber antes de planejar em torno do lado do consumidor: o ChatGPT agent foi aposentado, e seu substituto, o navegador em nuvem do ChatGPT Work, não aceita credenciais, não usa preenchimento automático nem gerenciador de senhas, não faz login em sites e não conclui pagamentos. A própria API da OpenAI supera o próprio agente de consumo em 21,9 pontos no Online-Mind2Web.
Preços.
| Modelo | Entrada / MTok | Em cache | Saída / MTok | Contexto longo ent. / saída |
|---|---|---|---|---|
gpt-5.6-sol | $4.00 | $0.40 | $20.00 | $8.00 / $30.00 |
gpt-5.6-terra | $2.00 | $0.20 | $12.00 | $4.00 / $18.00 |
gpt-5.6-luna | $0.20 | $0.02 | $1.20 | $0.40 / $1.80 |
Batch e Flex custam metade, o modo rápido o dobro, e são tarifas promocionais até 21 de novembro de 2026. A publicação de lançamento listava o Sol a $5 / $30 e o Luna a $1 / $6, então o Luna está rodando hoje a um quinto do próprio preço de tabela. Há também um limite de nível de contexto longo em 270K tokens que um ciclo de capturas de tela alcança mais rápido do que você imagina, e o plano gratuito não é compatível. Do lado do consumidor, os números estão no nosso guia dos preços do Atlas, um produto diferente a um preço diferente.
Veredito: a escolha com foco em navegador, e a que eu faria se o sistema ao redor já fala function calling e você prefere adicionar uma ferramenta a adotar um fornecedor. Reserve tempo de engenharia para a camada de segurança, porque esse trabalho agora é seu. Veja modelos da OpenAI para saber como os três níveis se diferenciam em outros contextos.
4. ByteDance UI-TARS
Melhor para uma licença permissiva que você de fato possa distribuir em um produto comercial.
Como funciona. Seis checkpoints estão na organização ByteDance-Seed sob Apache 2.0, sem bloqueio e sem aceite por clique: um 2B, duas variantes de 7B, duas variantes de 72B e o 1.5-7B que todo mundo realmente usa. Os nomes dos repositórios subestimam os tamanhos, já que o "7B" tem na verdade 8,3B parâmetros e o "72B" tem 73,4B. Três modelos de prompt acompanham, COMPUTER_USE, MOBILE_USE e GROUNDING, então o celular é uma capacidade documentada do modelo com as ações long_press, open_app, press_home e press_back.
O que eu gosto. Apache 2.0 sem cláusula não comercial, confirmado no arquivo LICENSE, nas seis fichas de modelo e no repositório do app desktop. O ecossistema em torno do 8B é o mais profundo de qualquer agente de GUI aberto: 11 ajustes finos, 13 quantizações e builds GGUF prontos para llama.cpp, LM Studio, Jan e Ollama. É por isso que ele tem cerca de 808.000 downloads por mês enquanto o 72B tem 446. Você pode ter um agente de GUI rodando em um laptop hoje à noite, comercialmente, de graça.
Onde fica devendo. Os benchmarks de manchete pertencem a um modelo que você não pode ter. A tabela de escala da própria ByteDance coloca o 1.5-7B baixável em 27,5% no OSWorld e 49,6% no ScreenSpot-Pro, contra 42,5% e 61,6% do 1.5 interno que a imprensa cobriu. Isso é uma diferença de 15 e de 12 pontos, e curiosamente o 72B pontua pior que o 7B nos dois. O painel de avaliação da comunidade do Hugging Face complica mais ao atribuir ao 7B 61,6% no ScreenSpot-Pro, contradizendo os 49,6% da própria ByteDance, então trate essa coluna como indefinida. O UI-TARS-2 foi anunciado em setembro de 2025 e nunca teve pesos, o que o próprio relatório da Alibaba confirma de forma independente ao listá-lo como código fechado. A ByteDance não publicou nenhum número de OSWorld-Verified apesar de ser creditada como contribuidora da correção que o produziu.
O quadro de ritmo é o que eu mais pesaria. O repositório do modelo tem 11.374 estrelas, zero tags, zero versões e último commit em 5 de setembro de 2025. O monorepo do desktop tem 38.697 estrelas e último commit de julho de 2026. As ferramentas estão vivas e a linha de modelos está congelada. O app instalável é só para macOS e Windows, sem build para Linux, e a última versão com instaladores é a v0.2.4 de agosto de 2025, enquanto /releases/latest resolve para uma versão de CLI sem arquivos anexados, exatamente o link que o início rápido manda você clicar.
Se você está dimensionando um modelo pequeno para o seu próprio hardware em vez de perseguir um ranking, nosso texto sobre modelos de linguagem pequenos é um enquadramento melhor para essa decisão do que qualquer tabela de benchmark.
Preços. Os pesos são gratuitos. A rota hospedada é o doubao-1-5-ui-tars-250428 na Volcengine a ¥1,75 por milhão de entrada e ¥3,50 por milhão de saída listados, embora essa página renderize os preços no cliente, então eu reconferiria antes de orçar, e a Volcengine é uma nuvem da região da China. O sucessor Doubao-Seed-2.1-Pro está listado a ¥6 e ¥30, um produto diferente a um preço diferente. Para uma implantação ocidental, autohospedar ou usar um provedor de inferência de terceiros é o caminho prático.
Veredito: escolha pela licença e pelo ecossistema, não pela pontuação, e calibre em 27,5% em vez de 42,5%. Vale dizer um risco em voz alta: a própria seção de limitações da ByteDance aponta que o modelo lida com CAPTCHAs, descreve isso como uma preocupação de acesso não autorizado, e não há nenhuma salvaguarda técnica em um checkpoint Apache 2.0. Se você está avaliando pesos abertos em geral, nosso texto de alternativas ao Kimi K2.5 cobre como o resto desse campo é precificado.
5. MAI-UI 8B e 2B
Melhor para o que mais se parece com o Qwen-UI-Agent e que você realmente pode baixar, do mesmo laboratório.
Como funciona. Estes são os dois checkpoints que a equipe MAI da Alibaba de fato lançou, enviados em 25 de dezembro de 2025 e anunciados quatro dias depois, ambos Apache 2.0, ambos na arquitetura qwen3_vl. O MAI-UI-8B tem 8,77B parâmetros em quatro fragmentos com 16,33 GiB, e o MAI-UI-2B tem 2,13B em um único arquivo de 3,96 GiB. São os antecessores diretos do Qwen-UI-Agent, o que os torna o substituto mais honesto do que o pós-treinamento daquela equipe realmente entrega.
O que eu gosto. Mesmo laboratório, mesma linhagem, Apache 2.0 e pequenos o bastante para serem práticos. O 2B em particular cabe com folga em uma placa de 8 GB pela aritmética dos pesos. Existem quantizações da comunidade para ambos, sete para o 8B e cinco para o 2B. E o próprio benchmark MobileWorld é baixável abertamente embora o modelo que o lidera não seja, então você pelo menos pode avaliar com honestidade.
Onde ficam devendo. Leia as fichas de modelo com cuidado, porque elas imprimem números dos carros-chefe da família em vez dos dos próprios checkpoints. Os 76,7% no AndroidWorld na ficha do 2B pertencem a um modelo de 235B que nunca foi lançado. Os únicos números resolvidos por tamanho que a equipe já publicou são do ScreenSpot-Pro sem zoom, do registro de novidades do repositório: 67,9% para um 32B que também nunca saiu, 65,7% para o 8B e 57,4% para o 2B. Contra os 76,6% do Qwen-UI-Agent no mesmo cenário, são 10,9 e 19,2 pontos atrás em grounding. No trabalho de ponta a ponta a diferença é bem mais feia: o melhor resultado do MAI-UI no MobileWorld foi 41,7% contra 82,1%, uma diferença de 40,4 pontos. Grounding é quase um problema resolvido em pesos abertos. Concluir um fluxo de vários passos não é.
Duas notas práticas. Nenhum valor de VRAM é publicado em lugar algum, nem em nenhuma das fichas nem no repositório, então os números acima são minha aritmética a partir do tamanho dos pesos e não uma afirmação do fornecedor. E nenhum provedor de inferência do Hugging Face serve nenhum dos dois modelos, então local é a única rota.
Preços. Gratuitos, Apache 2.0, e o custo inteiro é o seu tempo de GPU.
Para contexto de como o resto do mundo de pesos abertos define expectativas, a Mistral AI publica mais detalhes por checkpoint do que qualquer uma dessas fichas. O DeepSeek V3.2 também.
Veredito: o modelo mais interessante aqui para entender o que o Qwen-UI-Agent será, e um dos mais fracos para realmente trabalhar. Eu executaria o 8B para aprender o espaço de ações e calibrar expectativas, depois usaria uma API hospedada para qualquer coisa que um cliente veja. Também diz algo que a coleção MAI-UI ainda mostre dois itens, atualizada pela última vez em 6 de janeiro de 2026, seis meses antes de o Qwen-UI-Agent ser anunciado.
6. Holo 3.1
Melhor para pesos abertos quando você também quer um endpoint hospedado como reserva.
Como funciona. A H Company, sediada em Paris, lançou cinco gerações em doze meses, e o Holo 3.1 chegou em 1º de junho de 2026. O que o torna incomum é que o mesmo checkpoint é vendido de duas formas. A API da H documenta um modo de ciclo de agente, em que o Holo é o cérebro de um agente de navegador ou desktop, e um modo de localização de elementos, em que você passa uma imagem mais uma descrição do alvo e recebe {x, y} em uma grade de 0 a 1000. Esse segundo modo o torna um componente de grounding pronto para uso dentro do agente de outra pessoa, algo que nenhuma das APIs de ponta oferece.
O que eu gosto. É a única entrada de todo o artigo cujo número de manchete eu não precisei aceitar na confiança. O Holo3-35B-A3B está em 6º no quadro OSWorld-Verified dos mantenedores com 82,56%, à frente do Muse Spark 1.1 da Meta e a menos de um ponto da linha Opus da Anthropic, e é o único modelo especializado de pesos abertos entre os seis primeiros. A afirmação publicada pela própria H para o Holo3 era 78,85%, então, pela primeira vez, o fornecedor se subestimou.
Além disso, o Holo 3.1 é o lançamento mais permissivo que a H já fez: sete checkpoints todos Apache 2.0, abrangendo 0,8B, 4B, 9B e um 35B-A3B de mistura de especialistas, além de builds FP8, NVFP4 e Q4 GGUF do carro-chefe. A H informa que os builds quantizados ficam a cerca de dois pontos do checkpoint BF16 no OSWorld. O celular é o grande ganho desta geração, com o AndroidWorld indo de 67% para 79,3% no 35B-A3B. E o preço hospedado é o mais baixo de qualquer modelo deste artigo, a $0,25 de entrada e $1,80 de saída, com um plano gratuito de 10 requisições por minuto e sem cartão.
Onde fica devendo. A generosidade de licenciamento tem um porém. Nas gerações anteriores o padrão era modelos pequenos Apache 2.0 e grandes só para pesquisa: o Holo2-30B-A3B e o Holo2-235B-A22B são ambos CC BY-NC 4.0, assim como o Holo1.5-72B, então nenhum deles é utilizável em um produto sem chamar a H. E o carro-chefe atual foi além de só pesquisa. O holo3-122b-a10b não tem pesos nenhum, só API, e a própria lista de modelos da H diz isso. Duas páginas da própria H divergem em um ponto sobre o número do AndroidWorld da variante pequena, 71% contra 72%. A grade por benchmark do Holo 3.1 é publicada apenas dentro de uma imagem na ficha do modelo, não como texto. Seu composto de manchete inclui o H Corporate Benchmarks, 486 tarefas construídas com a própria fábrica de ambientes sintéticos da H, então qualquer afirmação de Pareto desse gráfico é em parte avaliada em lição de casa não publicada. E o produto gerenciado Computer-use Agents de julho de 2026 não publica tabela de preços nenhuma.
Preços.
| Rota | Tarifa | Contexto | Observações |
|---|---|---|---|
| Pesos, família Holo 3.1 | Grátis, Apache 2.0 | n/d | 0.8B a 35B-A3B, mais FP8, NVFP4, GGUF |
API holo3-1-35b-a3b | $0.25 ent. / $1.80 saída por MTok | 65.536 | Function calling, plano gratuito 10 RPM |
API holo3-122b-a10b | $0.40 ent. / $3.00 saída por MTok | 65.536 | Sem pesos, sem function calling |
| Computer-use Agents | Não publicado | n/d | Navegador e desktop no ar, celular não listado |
Veredito: minha escolha entre as opções de pesos abertos, e a única que eu colocaria à frente de uma API hospedada por mérito, porque os 82,56% estão no quadro de outra pessoa e não no da H. É também a opção mais bem desenhada para uma equipe que quer começar hospedada e migrar para autohospedada sem trocar de família de modelos, e a única em que os mesmos pesos podem servir como sub-rotina de grounding dentro de outro agente. Leia a licença da geração que escolher em vez de presumir, porque ela muda entre tamanhos e o carro-chefe atual não tem pesos.
7. Browser Use
Melhor para tarefas de navegador que você precisa rodar mil vezes sem vigiar.
Como funciona. É a opção que a maioria das pessoas descreve errado, então vale ser exato. O Browser Use começou como um arnês e não como um modelo: uma classe Agent que roda o ciclo observar, decidir, agir contra o Chromium, com o LLM como argumento trocável do construtor. Agora também traz modelos, endpoints hospedados bu-* com bu-2-0 como padrão mais um bu-30b-a3b-preview de pesos abertos. Mas o arnês é anterior ao modelo e não o exige, e a lista de provedores é incomumente longa: Google, OpenAI, Anthropic, Azure, Bedrock, Groq, Cerebras, DeepSeek, Mistral, OpenRouter, LiteLLM, Ollama local e qualquer coisa compatível com OpenAI por uma URL base personalizada. Você traz sua própria chave o tempo todo.
O que eu gosto. 110,3k estrelas, 12,1k forks, MIT na biblioteca e um ritmo de lançamentos que não desacelerou. É também a única entrada em que a nuvem fornece o navegador, o que remove o maior custo escondido de toda a categoria. E os preços são incomumente legíveis: as assinaturas compram um fundo de créditos dólar por dólar que dois medidores consomem, então dá para prever de verdade.
Onde fica devendo. Somente navegador, e eles são diretos quanto a isso. Cada sessão é um Chromium remoto acessado por CDP, a superfície da API é /runs e /browsers, e eles se posicionam contra os agentes de uso do computador em vez de como um deles. Cuidado com uma armadilha sutil na documentação: macOS, Windows e Linux aparecem como impressões digitais imitadas pelo modo furtivo, não como plataformas controladas. As mais de 1.000 integrações são APIs que o agente chama, não aplicações que ele opera.
A história de benchmarks deles também exige leitura cuidadosa. Os 89,1% no WebVoyager que costumam ser citados vieram de uma execução com gpt-4o, com código e prompts modificados, 55 tarefas removidas e avaliações falhas ou desconhecidas corrigidas manualmente, e o próprio Browser Use diz nessa publicação que o benchmark não está de fato testando as coisas certas. A manchete atual é 82% de precisão estrita em um conjunto interno de tarefas não públicas. A afirmação mais forte é a hospedada por terceiros: primeiro lugar no Odysseys com 87,4% em 200 tarefas web de longo prazo. Note também que a MIT cobre só a biblioteca, a nuvem roda sob termos separados e a documentação encaminha você à nuvem para CAPTCHAs, gerenciamento de memória e execução paralela.
Preços.
| Plano | Mensal | Créditos | Sessões simultâneas |
|---|---|---|---|
| Free | $0 | Só recargas, 10 tarefas/mês | 3, ou 10 após uma recarga |
| Dev | $29 | $29 | 25 |
| Business | $299 | $299 | 200 |
| Scaleup | $999 | $999 | 500 |
Os dois medidores por baixo importam mais que o plano. A infraestrutura de navegador é cobrada a $0,02 por hora de navegador, que é nada, enquanto o proxy gerenciado é cobrado a $5 por GB, caindo para $4 no Scaleup, e o tráfego de saída sem proxy a $0,20 por GB. Um gigabyte de tráfego de proxy custa o mesmo que 250 horas de navegador, então o proxy é o verdadeiro centro de custo. Agentes hospedados rodam a 1,2x as tarifas do provedor subjacente, e trazer sua própria chave acrescenta uma taxa de orquestração de 0,2x, então BYOK compra controle e não economia. Rodar o BU 2.0 na sua própria biblioteca é o caminho mais barato, a $0,60 de entrada e $3,50 de saída sem cobrança por hora de navegador. Nenhum plano enterprise é publicado, então SLAs e termos de retenção passam pelo comercial.
Veredito: se o alvo é um site, comece por aqui em vez de uma API de uso do computador de ponta. Você recebe um navegador em execução, um modelo trocável e uma fatura previsível, e o resultado de terceiros no Odysseys é o número mais crível deste artigo. Quem compara isso com um simples scraper deveria ler antes nosso texto de alternativas de web scraping, porque muitos trabalhos que parecem de agente não são.
8. Skyvern
Melhor para fluxos web com login em que o 2FA é o verdadeiro obstáculo.
Como funciona. O Skyvern não é só visão, e essa é a decisão de design que o define. Uma captura de tela e uma árvore DOM simplificada vão juntas ao modelo, e o enquadramento deles é que a imagem fornece o layout e o contexto visual enquanto o DOM fornece os identificadores de elemento que o Playwright consegue alvejar. Depois o Playwright executa. As credenciais são injetadas no navegador e não no prompt, então o modelo nunca as vê. A ablação deles é publicada de forma refrescante: um único ator pontua cerca de 45% no WebVoyager, adicionar um planejador leva a 68,7%, e adicionar um validador leva a 85,85%.
O que eu gosto. É a única entrada aqui construída em torno da realidade chata do trabalho web com login, e essa realidade é exatamente onde a abordagem de pura visão desaba. Um profissional que rodou quatro agentes lado a lado descreveu o limiar assim:
"the pattern that actually mattered wasn't which agent, it was that any task with login + 3 or more steps breaks on every screenshot-driven approach. … once you drop the browser sandbox and drive the OS accessibility tree directly, you get real element handles instead of pixel guesses and the failure rate falls roughly 4x on long tasks."
O design de DOM mais captura de tela do Skyvern é a mesma percepção aplicada uma camada acima. Além disso: segundos fatores TOTP, por e-mail e SMS são tratados, há um cofre de credenciais com suporte a Bitwarden, 1Password e Azure Key Vault, e um botão "Take Control" que devolve uma sessão ao vivo a um humano no meio da execução. O Route Memorization é a parte esperta do roadmap, compilando uma execução bem-sucedida do agente em um script Playwright barato que se autocorrige quando quebra, o que já é entregue como cache de código. Essa é a resposta certa ao custo por passo.
Onde fica devendo. A licença tem uma exceção que você precisa ler. O README diz que a lógica central é AGPL-3.0 com exceção das medidas anti-bot disponíveis na nuvem gerenciada, então a camada anti-bot deliberadamente não está no repositório. Autohospedar não tem custo de software mas tem dois precipícios: a resolução automática de CAPTCHA não existe lá, e o agente em vez disso pausa 30 segundos para intervenção manual. As afirmações sobre CAPTCHA também se estreitam conforme você vai fundo, da resolução nativa sem serviços de terceiros na página inicial até documentos que nomeiam tipos específicos e depois dizem que a resolução não é garantida. Somente navegador, nas palavras deles, se acontece em um navegador que o Skyvern consegue rodar. O número de 85,85% no WebVoyager é de janeiro de 2025 com GPT-4o e 8 tarefas removidas, e o Skyvern diz nessa mesma página que o ranking avançou desde então. O número mais recente deles é 64,4% no próprio WebBench. Algumas páginas deles também se contradizem, sobre a contagem de ações do plano gratuito e a cobertura de países do proxy.
Preços.
| Free | Hobby | Pro | Enterprise | |
|---|---|---|---|---|
| Preço | $0 | $29/mês | $149/mês | Sob medida |
| Créditos | 5.000 únicos | 30.000/mês | 150.000/mês | Sob medida |
| Ações estimadas | ~170 | ~1.200 | ~6.200 | Sob medida |
| Execuções simultâneas | 1 | 10 | 25 | 100 |
| 2FA e TOTP | Não | Não | Sim | Sim |
| Proxy | Datacenter | Datacenter | Residencial | Residencial |
O custo em créditos por passo nunca é publicado, então eu o derivei: cerca de 25 créditos por ação dá aproximadamente $0,024 por passo nos dois níveis pagos, idêntico em cada um, o que significa que a mudança de plano compra volume, concorrência e 2FA e não uma tarifa unitária melhor. Uma tarefa típica leva de 2 a 10 passos, então cerca de $0,05 a $0,24. Nenhuma tarifa de excedente é publicada em lugar algum, e execuções falhas ainda consomem crédito.
Veredito: a escolha do especialista, e especialistas são subestimados. Se o trabalho é entrar em um portal que não é seu e preencher um formulário atrás de um segundo fator, isto é mais bem desenhado do que qualquer API geral de uso do computador. Tenha o 2FA em mente ao comparar os planos, porque ele começa em $149 e não em $29. Se você está pesando um agente que aprende contra seletores codificados à mão, nosso texto de agente de IA vs chatbot enquadra bem esse dilema.
O número que ninguém cita do artigo do Qwen-UI-Agent
Aqui está a descoberta que reenquadrou a categoria para mim, e ela vem dos próprios traços do titular, não de um concorrente.
O espaço de ações do Qwen-UI-Agent não é puramente gráfico. Ao lado de click, type, drag e long_press, ele expõe cli_command para bash, api_call, ask_user e terminate. Então, quando o modelo roda uma tarefa de desktop, ele pode escolher entre clicar em um botão e digitar um comando. E escolhe muito o comando. No OSWorld-Verified, as ações de CLI são 40,7% de todas as ações e aparecem em 92,0% das tarefas. No mais difícil OSWorld-v2, isso sobe para 55,1% das ações em 98,2% das tarefas.
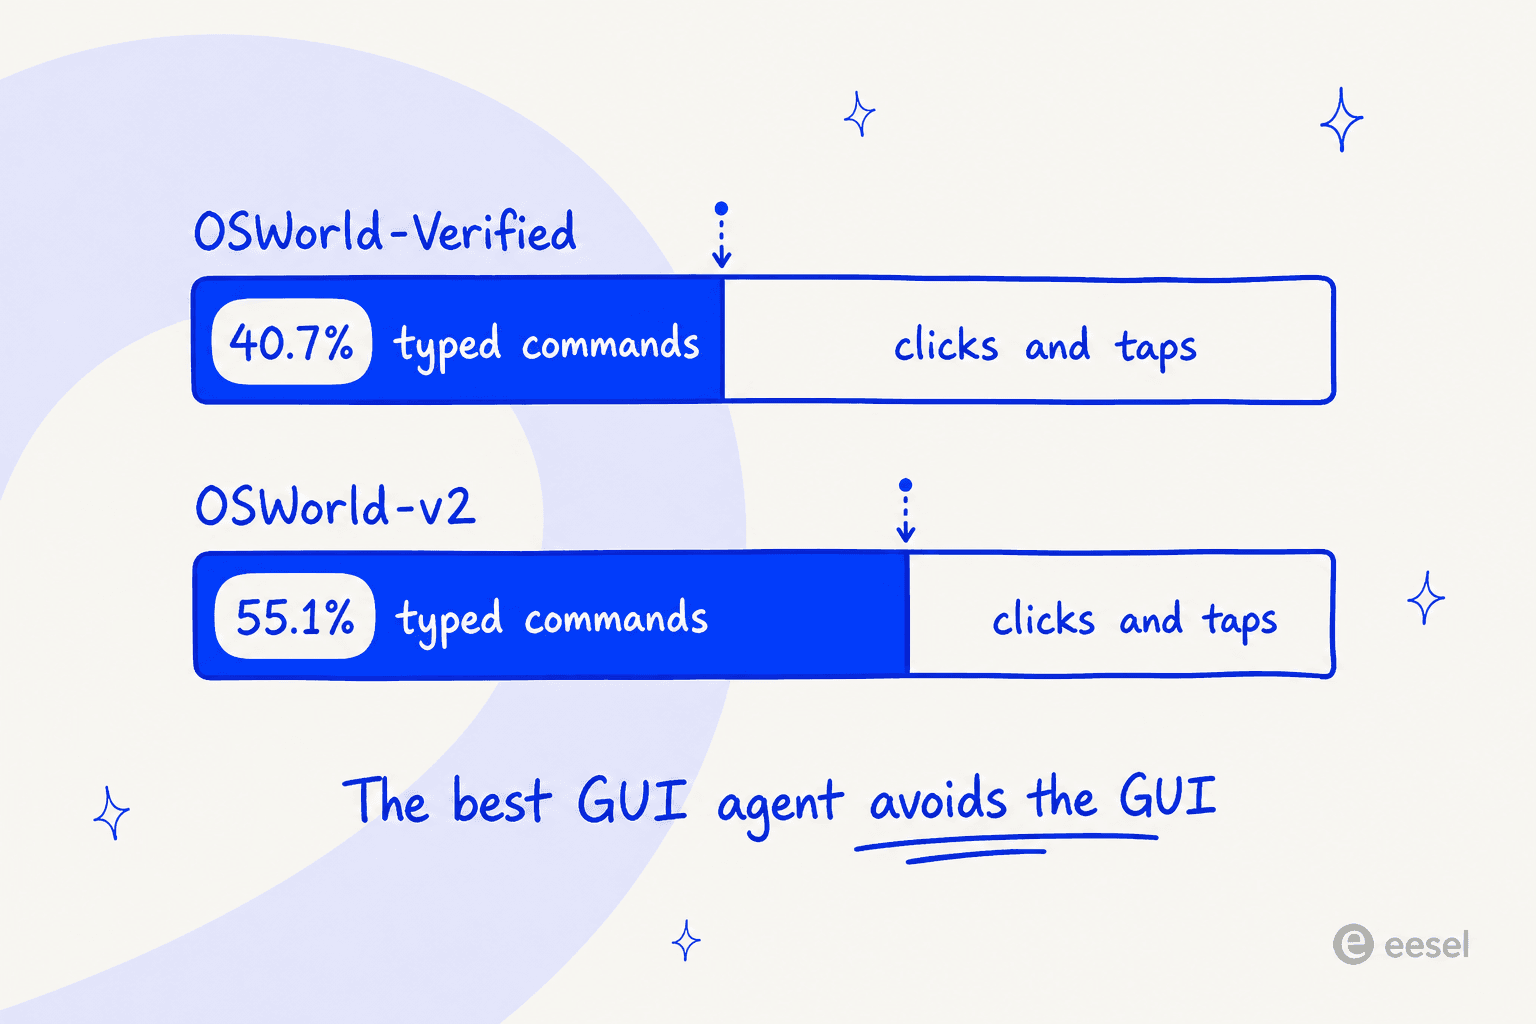
Leia de novo. O melhor agente de controle de tela publicado em 2026, com liberdade de escolha, gasta mais da metade de suas ações no benchmark de desktop mais difícil sem controlar a tela.
Os números da ByteDance dizem a mesma coisa pelo outro lado. O UI-TARS-2 pontua 29,6% no BrowseComp com seu conjunto completo de ferramentas, e 7,0% quando restrito a operação somente por GUI sem SDK. Essa é a ablação deles, e significa que aproximadamente três quartos dessa pontuação vieram do acesso a terminal e ferramentas, não de pixels.
É também por isso que as ferramentas de CLI agênticas silenciosamente superam os agentes de tela em tudo que um terminal alcança, e por que uma automação API-first como o Zapier AI vence uma que clica em pixels sempre que o endpoint existe.
A conclusão prática é uma pergunta a fazer antes de escolher qualquer coisa da tabela acima: esse trabalho tem uma API? Se tem, um agente de controle de tela é o jeito caro, frágil e não auditável de fazer algo que você poderia fazer com uma chamada autenticada. Agentes de GUI ganham seu lugar nas superfícies que não têm API, que é uma categoria real e grande: ferramentas internas legadas, portais governamentais, software de desktop de 2009, painéis de fornecedores sem história de integração. Só é muito menor do que as demonstrações sugerem.
Metade das falhas nunca foi culpa do modelo
A outra coisa útil no relatório do Qwen-UI-Agent é a Tabela 10, em que os autores pegaram um modelo de base, o Qwen 3.7 Plus, e classificaram cada uma de suas trajetórias falhas em dispositivos reais em vez de só relatar uma taxa de sucesso. Não vi nenhum outro laboratório publicar isso, e deveria mudar como você orça.
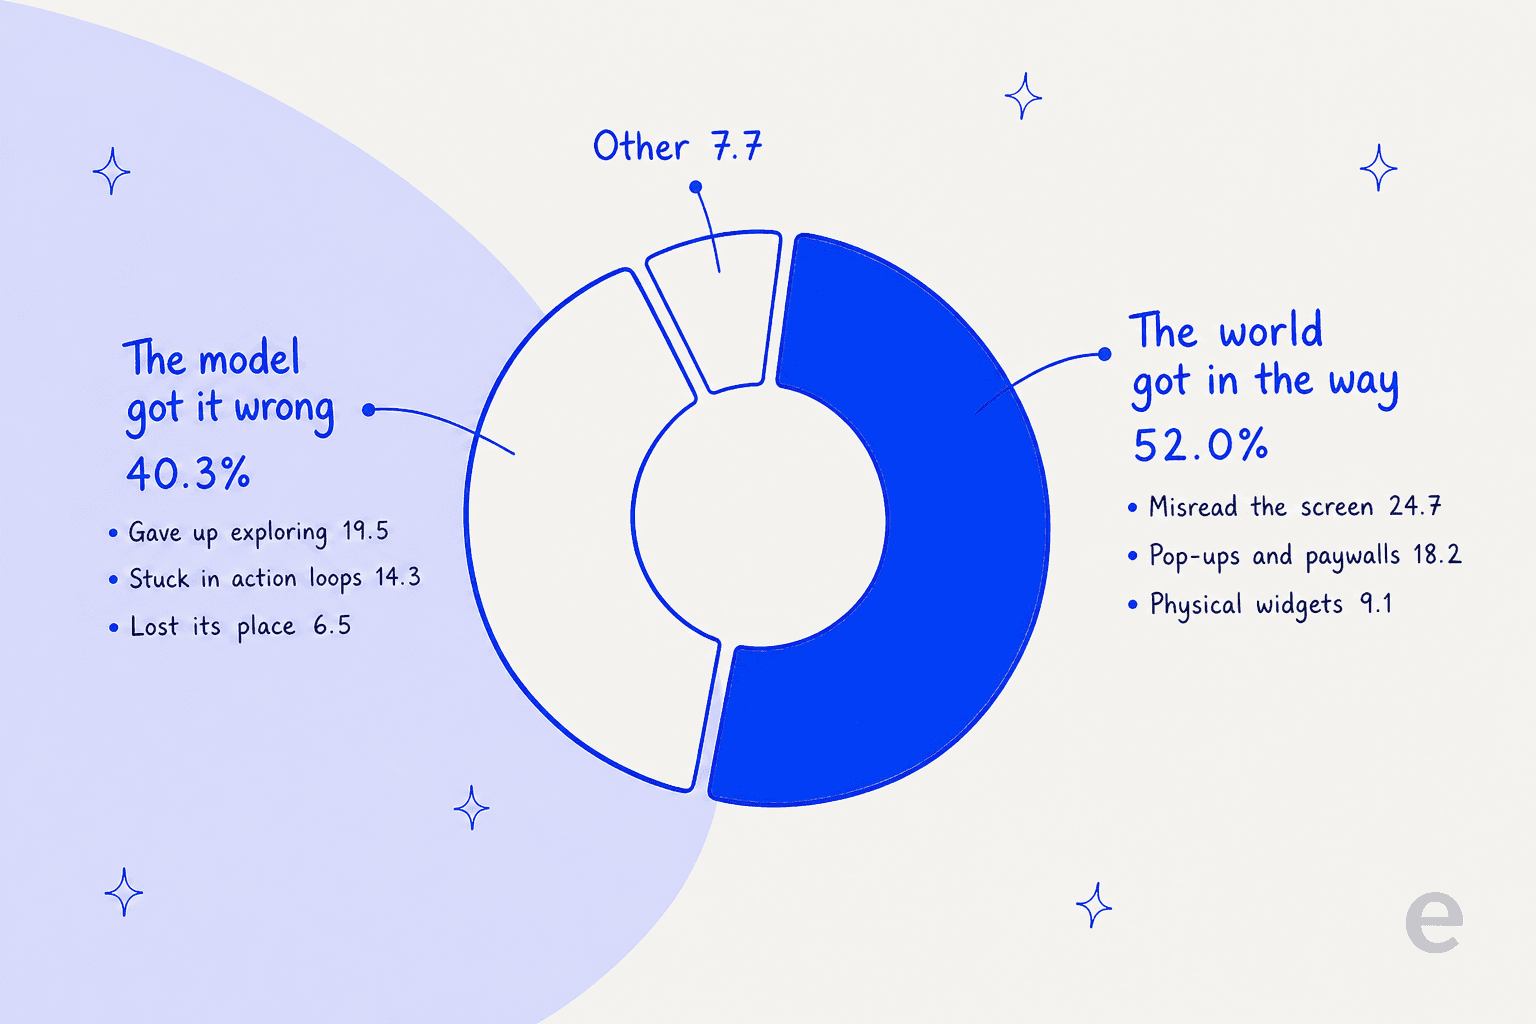
Nas execuções falhas do Qwen 3.7 Plus, os desafios do cenário do mundo real respondem por 52,0%: ler errado a interface com 24,7%, interferência de pop-ups, anúncios, paywalls e CAPTCHAs com 18,2%, e problemas com widgets físicos com 9,1%. As limitações de capacidade de execução respondem por 40,3%: falhar em explorar com 19,5%, ficar preso em ciclos de ações com 14,3% e perder o estado de execução com 6,5%. O Qwen-UI-Agent é o modelo mais forte, então a mistura dele será diferente, mas o formato da distribuição é a descoberta.
A razão pela qual essa divisão importa é que comprar um modelo melhor só resolve a metade menor. Um diálogo modal, um banner de cookies, um paywall e um CAPTCHA não são problemas de modelo, e são a maior parte do que dá errado. É também por isso que a linha de proxy do Browser Use e o tratamento de CAPTCHA do Skyvern não são recursos incidentais. Eles atacam a distribuição real de falhas, enquanto uma API de ponta ataca os 40%.
Uma ressalva que devo fazer, já que me apoiei nos números da Alibaba o tempo todo. O MobileWorld-Real é o benchmark próprio da Alibaba, e é pontuado pelo AutoJudge, o juiz agente da própria Alibaba, que o artigo reporta com 92,8% de precisão de correspondência exata em 666 exemplos examinados por especialistas. Os autores listam o erro do juiz como a primeira limitação declarada, o que é o instinto certo. Os apps de demonstração também são do ecossistema de consumo chinês, então 92,2% em dispositivos reais é um sinal sobre o método e não uma promessa sobre SaaS ocidental.
Toda alternativa aberta é um ajuste fino do Qwen
Isso me pegou de surpresa. Fui procurar uma saída arquitetural da Alibaba e ela não existe.
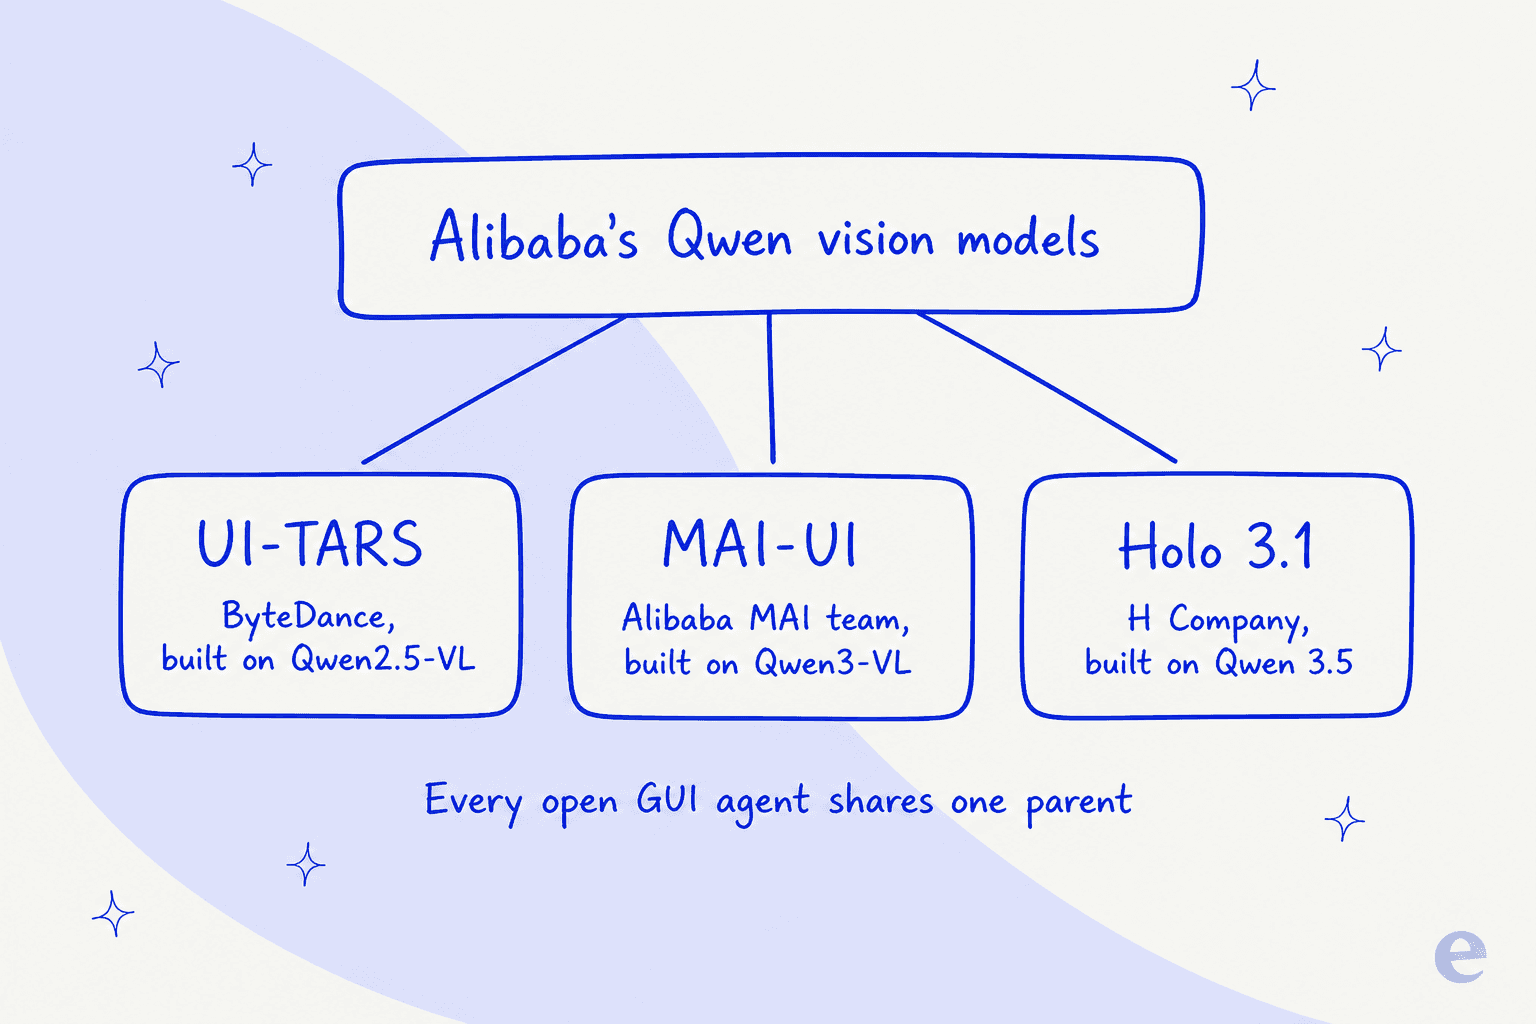
O UI-TARS-1.5-7B é treinado a partir do Qwen2.5-VL-7B, dito explicitamente na própria página Seed da ByteDance, e sua tag de arquitetura no Hugging Face é qwen2_5_vl. O MAI-UI é qwen3_vl. Toda geração do Holo é um derivado do Qwen, do Qwen2.5-VL ao Qwen3-VL e à família Qwen 3.5, e o arquivo de licença do Holo1 diz que o produto foi construído com Qwen e que a Qwen Research License prevalece em caso de conflito. Todo gráfico de benchmark do lançamento do Holo 3.1 compara o Holo com a família Qwen 3.5 em vez de com a linha de agentes de GUI da Alibaba.
Então "sair da Alibaba" em agentes de GUI de pesos abertos significa trocar licença, jurisdição e equipe de pós-treinamento, não a arquitetura base. É algo que se pode querer de verdade, especialmente se a licença é o que está bloqueando você, e a contribuição da H Company é própria: o pós-treinamento específico para GUI, a fábrica de ambientes sintéticos, o arnês. Mas ninguém deveria escolher um desses três acreditando ter escapado do Qwen. A leitura honesta é que os modelos de visão da Alibaba são o substrato de toda essa categoria aberta, o que também explica por que um agente de GUI da Alibaba a lidera.
Quem deixei de fora e por quê
Manus. Tentei avaliar e não consegui fazer login. O site deles mostra atualmente um aviso de que o acesso retoma às 8h do dia 25 de agosto de 2026, explicando que estão processando uma exclusão programada de dados para cumprir exigências regulatórias em jurisdições específicas enquanto a Manus se prepara para retomar as operações como empresa independente. Não posso recomendar um produto que não consegui abrir hoje. Vale revisitar, e nossa visão geral do Manus AI e o detalhamento dos preços do Manus AI cobrem o assunto enquanto isso.
Seed 2.1 Pro. O modelo de uso do computador de ponta atual da ByteDance é real e competitivo, com 78,8% no OSWorld-Verified na comparação da Alibaba. Mas é só API em uma nuvem da região da China a ¥6 e ¥30 por milhão de tokens, e o próprio anúncio do Seed 2.1 da ByteDance nunca menciona o UI-TARS, então a linhagem que a maior parte da cobertura presume é uma inferência e não uma declaração.
GUI-Owl-1.5-32B-Instruct. Aparece em todas as tabelas da Alibaba como o mais forte especialista aberto anterior, e com 43,9% no MobileWorld contra 82,1% a distância geracional é larga demais para recomendá-lo como opção atual.
Assistentes que leem a tela e nunca agem. Ferramentas no molde do Cluely observam sua tela e aconselham, e copilotos de navegador como o Edge Copilot resumem a página em que você está. Úteis, e não é o mesmo trabalho que concluir uma tarefa, então fora do escopo aqui.
Tudo que não tem preço. O produto gerenciado Computer-use Agents da H Company e toda plataforma de agentes de "fale conosco" que examinei. Se um fornecedor não publica uma tarifa para um produto medido, um comprador não consegue comparar, e não vou fingir o contrário.
Se o trabalho são tickets de suporte, a tela é a porta errada
Uma boa parte das pessoas que pesquisam isso não está tentando automatizar um app de desktop legado. Elas querem uma IA que trabalhe em um helpdesk, e um agente de controle de tela parece o caminho de propósito geral para chegar lá.
Eu discordaria, e não só porque trabalho na alternativa. Seu helpdesk já tem uma API. Zendesk, Freshdesk, Gorgias, Front e Jira Service Management expõem o ticket como um objeto que você pode ler e escrever, o que significa que um agente de controle de tela está escolhendo localizar esse ticket procurando por ele e clicando nele. É por isso que ferramentas dedicadas de triagem de tickets e um agente de IA para helpdesk superam a automação de tela na mesma fila. Toda mudança de layout, modal e teste A/B vira um novo modo de falha, e segundo a Tabela 10 acima, essa classe de problema é a maior parte do que quebra.
Há também um problema mais sutil que uma equipe rodando isso em produção descobriu na marra, e é a coisa mais aguda que li a semana toda:
"we run screen-driven agents against web forms in production and the failure mode that took us longest to find wasn't navigation, it was commits that don't commit. a react controlled select can render the right value after a click while the framework's internal state never updated, so every pixel says done and the submitted payload says null. vision-only verification passes because the screen genuinely looks correct."
Todo pixel diz concluído e a carga enviada diz null. Esse é todo o risco de um agente guiado por pixels em uma fila de tickets em uma linha, e o fornecedor questionado naquele tópico concordou: o agente dele é guiado por tela, então eles não afirmam que pixels possam provar toda transição de estado oculta. Uma chamada de API ou retornou 200 ou não retornou.
O problema maior é o teste. Todo fornecedor deste artigo recomenda uma VM isolada, uma lista de domínios permitidos e um humano no circuito, e nenhum oferece um teste a seco com o seu próprio trabalho passado. Essa lacuna não é acadêmica. É a primeira pergunta que um líder de suporte faz, quase com estas palavras:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Esse é um líder de CX de uma marca de suplementos direto ao consumidor que atende cerca de 7.000 tickets por mês no Gorgias e no Shopify. Um agente de GUI não tem resposta para isso, porque um clique não carrega pontuação de confiança, e não tem nada parecido com uma escalação por IA. A escolha do modelo importa muito menos aqui do que a recuperação de informação, assunto do nosso texto sobre o melhor LLM para suporte.
Aprendi essa parte na marra e não na teoria. No começo, três contas pagas da eesel tinham bots que inventavam respostas quando a recuperação voltava vazia, porque faltava o fallback rígido. Um inventou afirmações de assinatura sobre células solares e as enviou a clientes reais. Outro, diante de uma pergunta de produto, respondeu "Oxygen" direto da tabela periódica. Nada no produto estava mentindo para mim, apenas narrava um sucesso que não tinha alcançado, a mesma classe de afirmação de um agente de GUI que informa ter clicado no botão. A diferença é que uma chamada de API deixa um registro que você pode conferir e uma coordenada não. Esse incidente é o motivo de cada implantação agora ser simulada contra tickets históricos antes de chegar perto de um cliente, e é o argumento mais forte que conheço para evitar alucinações por design e não por prompt.
Experimente a eesel no seu helpdesk
Se o que você realmente precisa é de um colega de IA na sua fila de tickets e não de um mouse robô, é isso que a eesel é. Ela se conecta a Zendesk, Freshdesk, Gorgias, Front, Help Scout, HubSpot, Salesforce Service Cloud e Jira Service Management por meio das APIs deles e chama ferramentas nomeadas, então uma ação é uma chamada de API registrada e não uma coordenada que alguém espera que tenha caído no pixel certo.
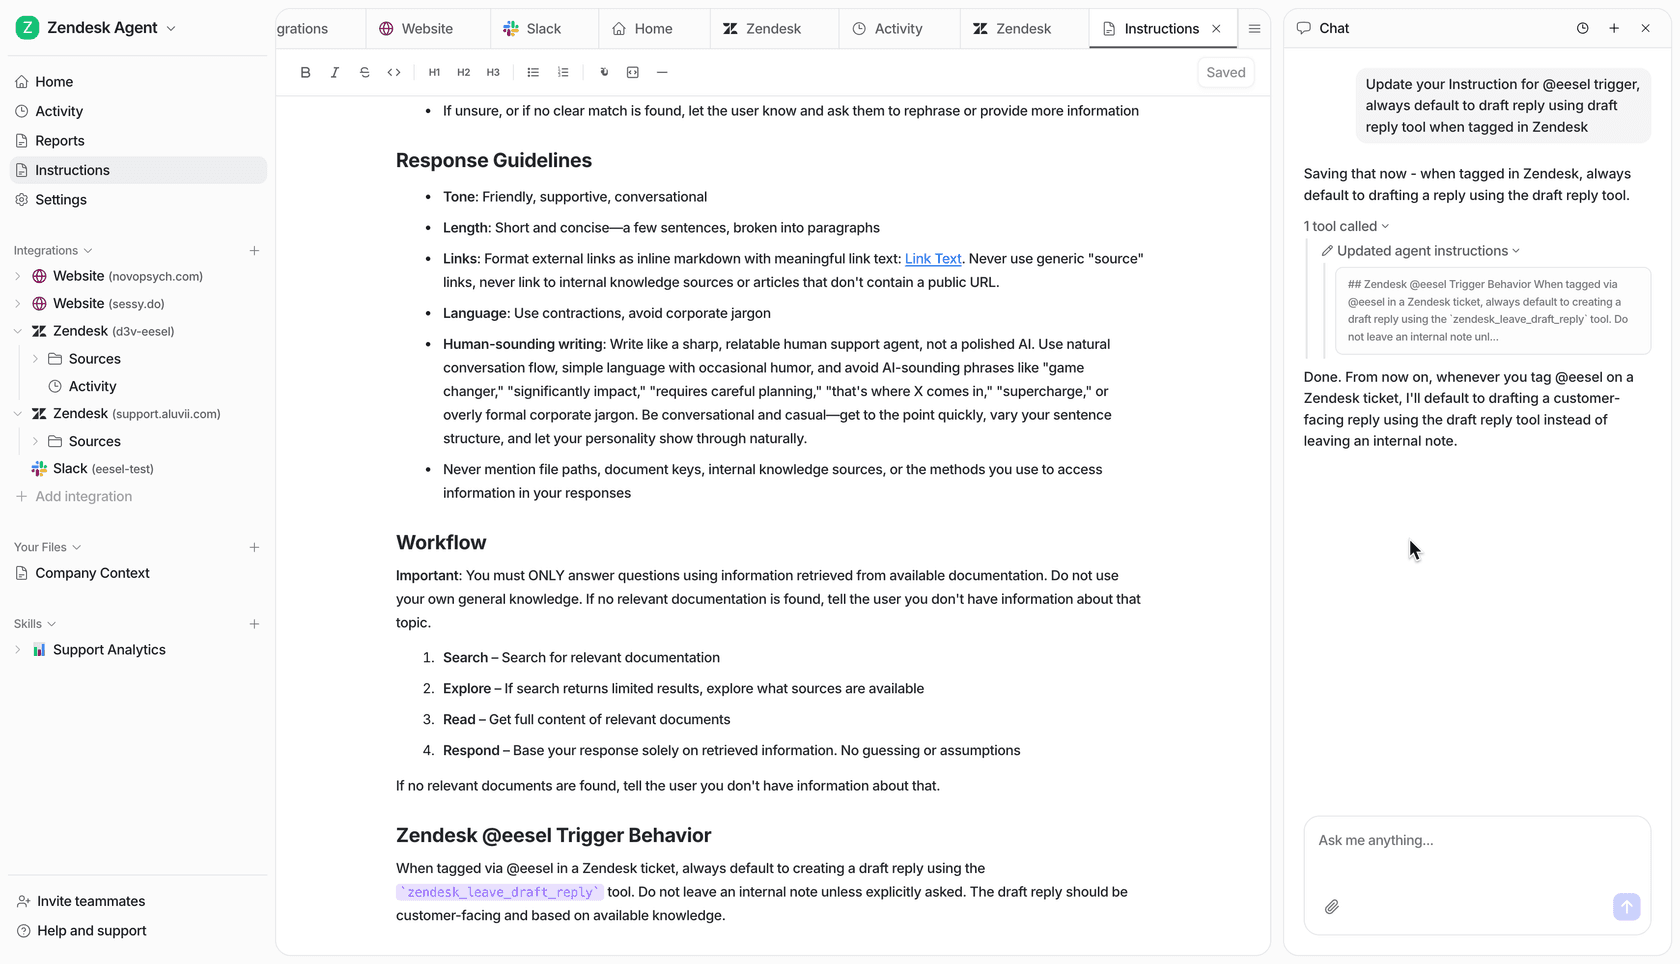
A parte que mais importa para quem acabou de ler oito seções sobre agentes não testáveis é a Simulação. Aponte-a para seus próprios tickets passados e ela executa o pipeline completo do agente em um ambiente isolado sem enviar nenhuma resposta real, faz um juiz pontuar cada resposta, mostra uma comparação lado a lado com o que sua equipe de fato enviou, marca cada uma como Perfeita, Aceitável ou Falha e devolve lacunas de cobertura por tema com correções de instruções sugeridas. Depois você roda de novo. Esse é o teste a seco que nada neste artigo oferece.
O preço funciona como o widget acima sugere que deveria: um preço mensal fixo, a partir de US$ 299/mês por 500 créditos, em que 1 crédito é um ticket ou chat, não importa quantas mensagens vão e voltam, sem taxa de plataforma e sem taxa por usuário. Se você encaminhar 200 dos seus 1.000 tickets, só esses 200 usam créditos; 1.000 créditos por mês custam US$ 499. Compare com um medidor por passo em que o mesmo ticket custa o que a interface decidir cobrar naquele dia. Uma ressalva honesta: um crédito é usado quer o resultado seja perfeito ou não, então isso é por ticket atendido e não por ticket resolvido.
O grounding é a outra metade. A eesel lê sua central de ajuda, documentação e tickets passados existentes em vez de olhar para uma tela, e nossos guias sobre como treinar com uma base de conhecimento e como conectar bases de conhecimento cobrem como isso funciona na prática.
Para ver como isso é em produção, a Gridwise relatou ter resolvido 73% das solicitações de nível 1 no primeiro mês após um teste de sete dias, e a Smava roda mais de 100.000 tickets por mês totalmente automatizados em alemão no Zendesk. Se preferir ver primeiro o campo mais amplo, nosso panorama de IA para atendimento ao cliente é a comparação honesta.
Comece com 100 créditos grátis, sem cartão e com todos os recursos liberados. Experimente a eesel, ou aponte-a primeiro para os tickets do mês passado e veja a pontuação antes de decidir.