As 9 melhores alternativas ao Grok Voice 3 em 2026

Rama Adi

Katelin Teen
Última edição October 15, 2026
Por que olhar além do Grok Voice 3?
Começo pela parte honesta: o Grok Voice 3.0 é muito bom. Na minha análise do Grok Voice 3 chamei-o de minha escolha padrão para um agente telefônico que precisa executar ações, e nada do último dia mudou isso. A Artificial Analysis o colocou em 1º lugar no seu índice speech-to-speech, em 1º em sucesso de tarefas em ligações ao vivo (94,8%) e em 2º no τ-Voice, o benchmark que simula ligações de suporte reais com ferramentas e um documento de políticas.
"SpaceXAI's Grok Voice 3.0 is the new leading Speech to Speech model, debuting at #1 on the Artificial Analysis Speech to Speech Index at 86.9, while also being competitive on latency"
Então por que as pessoas já procuram alternativas ao Grok Voice 3 apenas um dia após o lançamento? Lendo a documentação e as tabelas de benchmark, há cinco motivos reais:
- Concorrência em uma conta nova. A concorrência do speech-to-speech agora sobe com o gasto acumulado: 10 sessões com US$ 0, 20 com US$ 50, 50 com US$ 250, 100 com US$ 1.000 e 200 com US$ 5.000. Em produção isso é tranquilo, mas uma equipe que quer testar 50 ligações simultâneas no primeiro dia precisa pagar adiantado para liberar o nível.
- Idiomas. A documentação de speech-to-speech da xAI lista 20+ idiomas. O Gemini Live lista 70, a ElevenLabs 90+.
- É uma API, não uma central de atendimento. Você traz a linha telefônica, o fluxo da ligação, a análise e o caminho de escalonamento. A xAI vende um Voice Agent Builder sem código, mas muitas equipes querem uma plataforma completa.
- A latência foi na direção errada. O tempo até o primeiro áudio é de 0,81 segundo, acima dos 0,70 segundo do Grok Voice 2.0. Ainda é mais rápido do que todos os modelos próximos no índice, mas não é o Grok mais rápido.
- Preço. US$ 0,08 por minuto (US$ 4,80 por hora) fica no meio da tabela. O Gemini 3.8 Live é medido em US$ 0,84 por hora.
Se nenhum desses cinco incomoda, você pode parar aqui e fixar o grok-voice-3.0. Se algum incomoda, a alternativa certa depende de qual seja, e esclarecer isso é o que o resto deste texto faz. Para um panorama maior além desse fornecedor, meu artigo sobre alternativas à xAI cobre também os modelos de texto.
Três tipos de alternativa
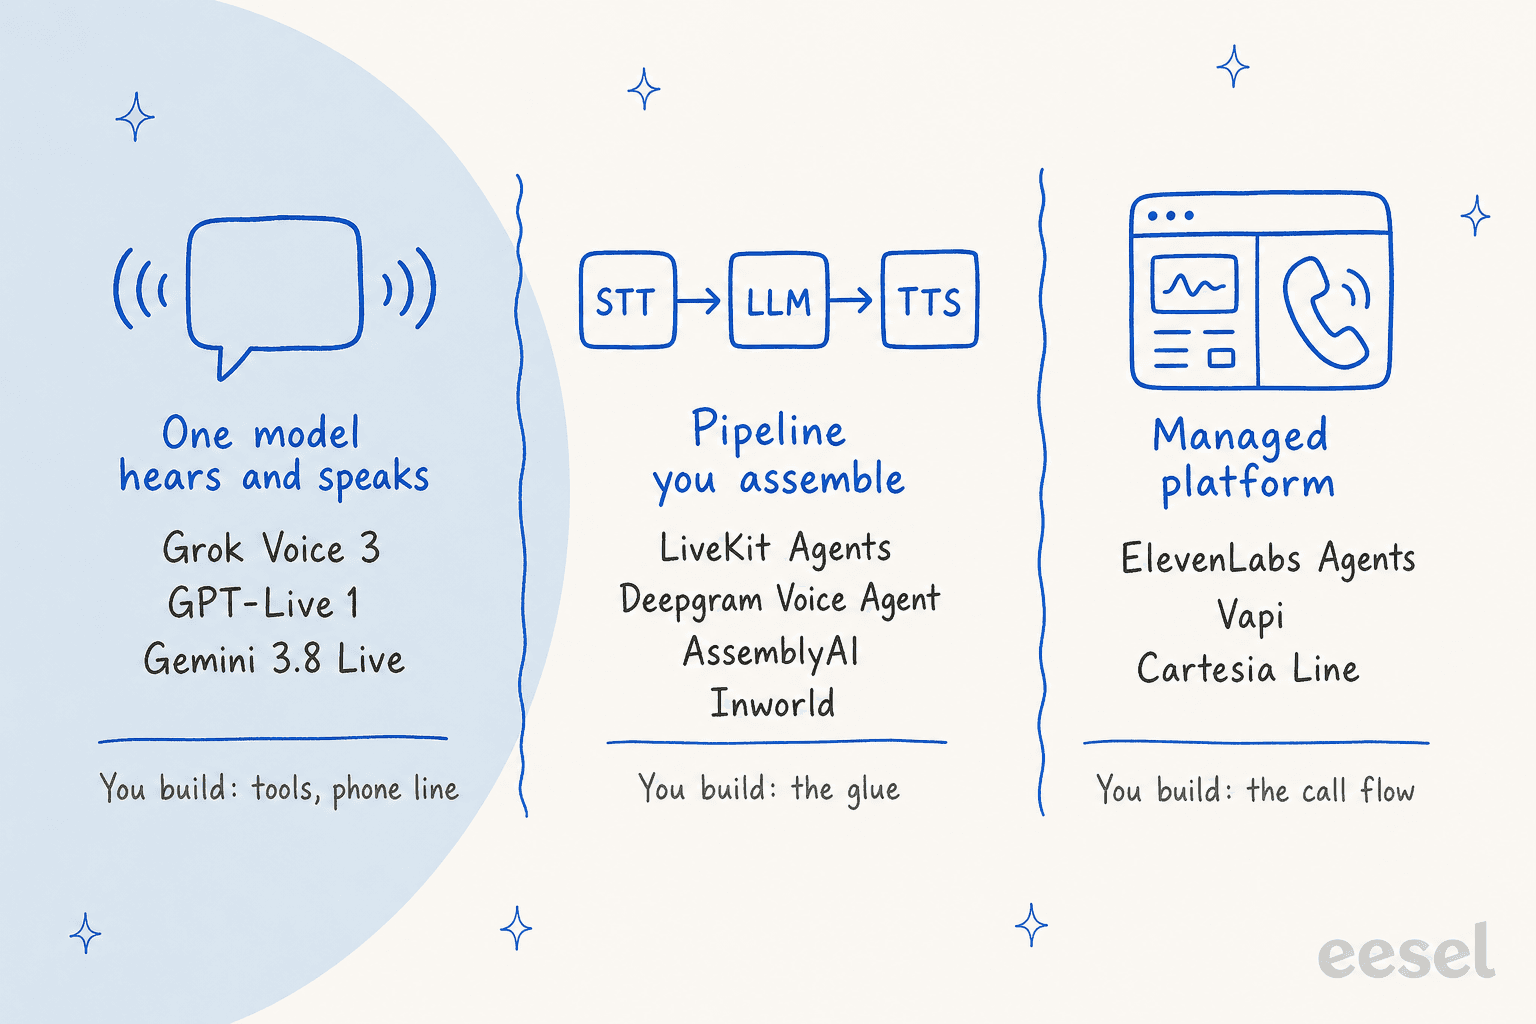
Quando pedi ao ChatGPT alternativas ao Grok Voice 3, ele organizou a resposta em três grupos, e acho que esse enquadramento é a coisa mais útil que um comprador pode levar desta página. As ferramentas abaixo não são intercambiáveis: trocar de um grupo para outro muda quem controla a alternância de turnos e a telefonia, e também as chamadas de ferramentas.
- Modelos speech-to-speech ouvem áudio e respondem em áudio dentro de um único modelo. Menos peças móveis, interrupção natural e as melhores pontuações de benchmark. Você ainda constrói as ferramentas e a conexão telefônica.
- Pipelines encadeiam speech-to-text, um LLM de texto e text-to-speech. Mais etapas, mas você pode trocar qualquer peça, usar qualquer LLM e ler uma transcrição limpa em cada passo.
- Plataformas gerenciadas envolvem um pipeline com números de telefone, construtor, testes e análises. Você constrói o fluxo da ligação; elas cuidam da infraestrutura.
Um desenvolvedor no Hacker News contestou o primeiro grupo, e vale ter isso em mente:
"Yeah, sadly "audio to audio" seems to mean "we transcript it automatically for you internally which gets passed to the model", otherwise we'd be seeing models that are able to hear nuance in the input voice and pronunciation, which AFAIK, no model does yet."

Para uma linha de suporte, isso é menos problema do que o som. Quem liga quer ter o pedido encontrado, não precisa que o sotaque seja apreciado.
Como escolhi estas nove
Construo a camada de integração na eesel, ou seja, o código que conecta um agente de IA a um helpdesk ao vivo, então leio estas ferramentas como construtor. Para cada uma, li a documentação e a página de preços do fornecedor em 15 de outubro de 2026, capturei as páginas de produto eu mesmo e tirei cada número de benchmark do ranking speech-to-speech da Artificial Analysis. Os preços vêm apenas das páginas dos fornecedores.
O que não fiz foi passar mil ligações de produção por cada uma, porque o Grok Voice 3.0 tem só um dia. Quando cito uma latência, é o tempo até o primeiro áudio medido pela Artificial Analysis ou o número publicado pelo próprio fornecedor, e digo qual dos dois.
A lista curta começou com as seis ferramentas que o ChatGPT citou (OpenAI, Google, ElevenLabs, Deepgram, LiveKit, Vapi), e depois adicionei três que apareceram nos próprios testes de sistemas em cascata do benchmark ou que têm uma API real de agentes de voz: Cartesia, AssemblyAI e Inworld. Deixei a Retell AI de fora porque seu nicho se sobrepõe ao da Vapi; minha análise da Retell AI cobre o assunto se você estiver comparando as duas.
Alternativas ao Grok Voice 3 comparadas
Aqui está o campo inteiro em uma tabela. "Preço de destaque" é o número da página de preços do fornecedor, com o que ele deixa de fora na coluna seguinte.
| Ferramenta | Tipo | Preço de destaque | Não incluído | Início grátis | Concorrência (de entrada ao máximo publicado) | Tempo até o primeiro áudio | Idiomas | Telefone | Conformidade (declarada pelo fornecedor) |
|---|---|---|---|---|---|---|---|---|---|
| Grok Voice 3.0 (referência) | Speech-to-speech | $0.08/min | Sua operadora | Nenhum plano gratuito listado | 10 a 200 conforme o gasto acumulado | 0.81s (AA) | 20+ | SIP nativo, Twilio, LiveKit | SOC 2 Type II, compatível com HIPAA com BAA, DPA do GDPR |
| GPT-Live 1 | Speech-to-speech | $0.05/min | Modelo de backend e uso de ferramentas | Não | Não consta na página de preços | 1.24s a 1.34s (AA) | Não consta na página do modelo | SIP direto, Twilio, Telnyx, Bandwidth | SOC 2 Type 2, BAA disponível |
| Gemini 3.8 Live | Speech-to-speech | $0.005/min entrada, $0.018/min saída | Search grounding acima de 5,000/mês | Sim, plano gratuito | Não consta na página de preços | 1.18s (AA) | 70 | Apenas WebSocket | Dados do plano pago não são usados para treinamento |
| LiveKit Agents | Pipeline (código aberto) | $0.01/min de sessão de agente | STT, LLM, TTS, telefonia | 1,000 min de agente/mês | 5 a 600 | Depende dos modelos | Depende dos modelos | Números dos EUA, SIP, Twilio, WhatsApp | SOC 2 Type II, BAA no Scale |
| Deepgram Voice Agent | Pipeline (gerenciado) | $0.075/min | Nada no Standard | $200 de crédito | Até 45 no pay-as-you-go | Não medido | 45+ (Nova) | Documentação de telefonia | SOC 2 Type 2, HIPAA BAA, endpoint na UE |
| AssemblyAI Voice Agent | Pipeline (gerenciado) | $0.075/min | Nada listado | Cadastro gratuito | Não consta na página de preços | Não medido | 32 | Guia de número de telefone | SOC 2 Type 2, BAA |
| Inworld Realtime | Pipeline (API estilo S2S) | Por peça: STT $0.15/hr, TTS a partir de $15/1M de caracteres | Tokens do LLM | Início gratuito sob demanda | Não publicada | 204ms melhor, 462ms mediana (fornecedor) | ~500 (TTS) | G.711 da Twilio | SOC 2 Type II, GDPR, HIPAA como complemento |
| ElevenLabs Agents | Plataforma gerenciada | $0.08/min | LLM, sua operadora | 15 min/mês | 4 a 40, rajada até 3x | Não medido | 90+ | Twilio, tronco SIP | BAAs no Enterprise |
| Vapi | Plataforma gerenciada | $0.05/min de hospedagem | STT, LLM, TTS a preço de custo | $5 de crédito | 4 a 30, +$10 por linha | Não medido | Depende dos modelos | SIP da Vapi grátis, Twilio repassado | Complemento HIPAA $2,000/mês |
| Cartesia Line | Plataforma gerenciada | $0.06/min | $0.014/min do número Cartesia | $1 de crédito de agente (~17 min) | 8 a 60 | Não medido | Depende da voz | Números da Cartesia | SOC 2 Type II, HIPAA, GDPR |
A coluna de latência AA só está preenchida para os modelos speech-to-speech, já que a Artificial Analysis mede o tempo até o primeiro áudio nesses. Em pipelines e plataformas, a latência depende dos modelos que você conecta, que é a variável que você controla.
Quanto os minutos realmente custam
Os preços de destaque não se alinham, porque cada fornecedor deixa de fora uma peça diferente. A calculadora abaixo coloca todas as ferramentas em pé de igualdade: um minuto de uma ligação de suporte em que o agente fala cerca de metade do tempo. Digite seus minutos de ligação por mês e as barras se refazem sozinhas.
Digite seus minutos de ligação por mês para ver a conta de cada ferramenta a preço de tabela. Preços da página de preços de cada fornecedor em 15 de outubro de 2026; GPT-Live 1, Inworld e ElevenLabs excluem parte do custo do LLM, então trate-os como pisos.
Duas coisas chamam a atenção. Primeiro, a maior parte do campo se agrupa entre US$ 0,075 e US$ 0,083 por minuto, o que significa que o Grok Voice 3.0 não é caro pelo que entrega. Segundo, os dois extremos de custo (Gemini 3.8 Live e Inworld) são também os dois em que você troca algo real: precisão em tarefas de suporte no caso do Gemini, e uma escolha de LLM feita à mão no caso da Inworld. Para ter o contexto de quanto vale um minuto de voz de IA frente a um humano, meu detalhamento de agente de IA vs custo humano faz a conta.
Trocas speech-to-speech
Estes dois são as substituições diretas, mesma arquitetura do Grok, com um modelo que escuta e também fala. Se o seu código já fala o formato de eventos do OpenAI Realtime (a API da Grok foi feita para ser compatível com ele), a mudança é principalmente um endpoint e uma chave.
O benchmark que mais importa para uma linha de suporte é o τ-Voice, que pontua se o problema de um cliente simulado foi de fato resolvido. É aqui que três famílias speech-to-speech se separam:
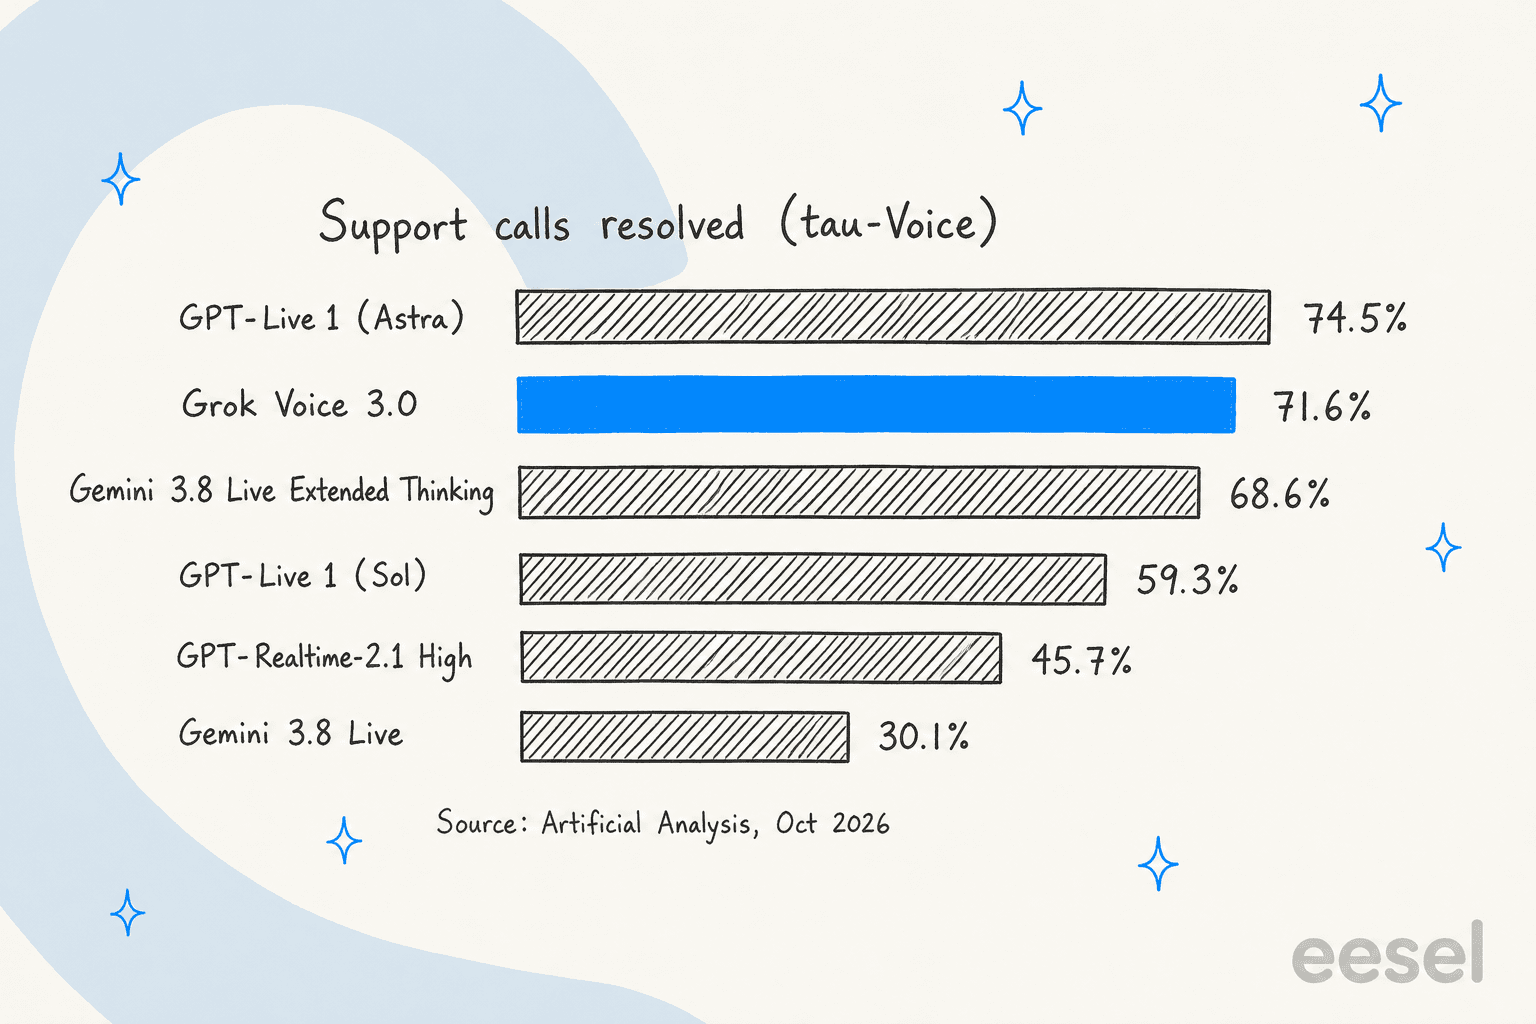
Vale notar a barra de baixo. O Gemini 3.8 Live é a segunda voz mais apreciada em testes de audição às cegas e o modelo mais barato aqui, e mesmo assim resolve 30,1% das ligações. Agradável e correto são pontuações diferentes.
1. OpenAI GPT-Live 1 e a Realtime API
Ideal para: linhas de suporte em que concluir a tarefa importa mais do que qualquer outra coisa, e equipes que já usam a OpenAI.
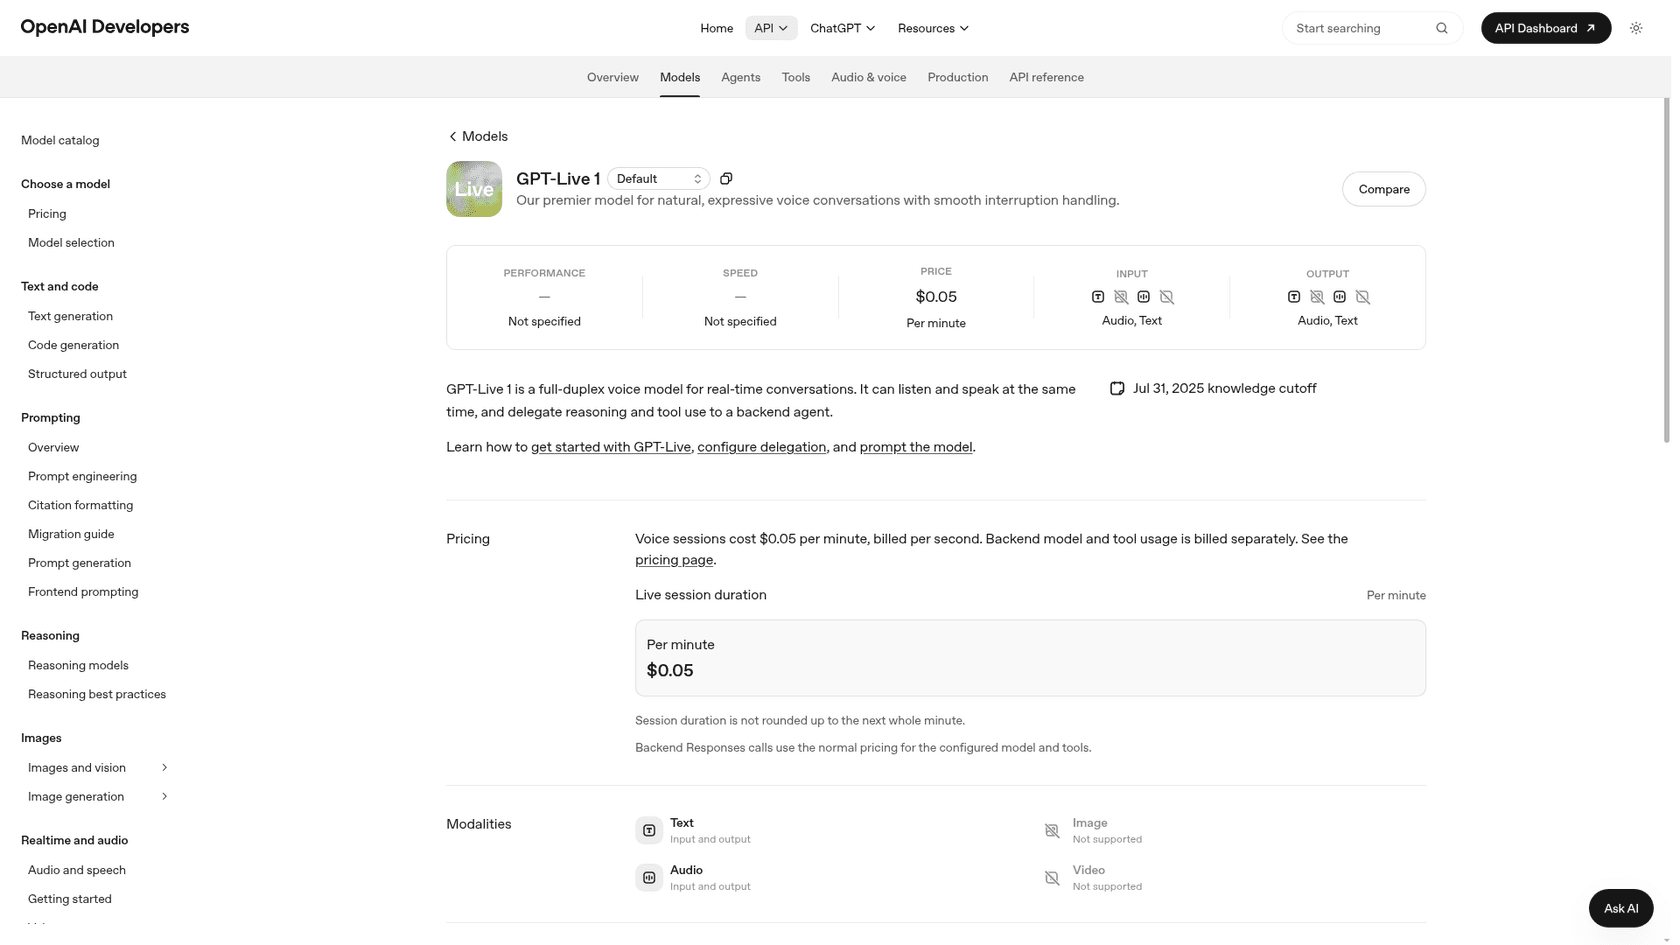
A OpenAI tem agora dois caminhos de voz. O GPT-Live 1 é um modelo full-duplex que, segundo sua página do modelo, "can listen and speak at the same time, and delegate reasoning and tool use to a backend agent". A Realtime API mais antiga, com o gpt-realtime-2.1, é um único modelo speech-to-speech que lida com turnos de áudio, ferramentas e interrupções em uma só sessão. A divisão importa para o suporte: o GPT-Live passa o raciocínio pesado a um modelo de texto separado (Astra ou Sol no benchmark), e essa configuração é a que lidera o τ-Voice.
As ligações telefônicas chegam a ele por um tronco SIP direto, e a OpenAI publica guias de parceiros para Twilio, Telnyx, Bandwidth, LiveKit e Daily/Pipecat em sua documentação de telefonia. Desenvolvedores no Hacker News ficaram entusiasmados no lançamento:
"I was excitedly awaiting this hitting the API, because ofc there wasn't a super high fidelity option for drop-in voice interface in front of a given harness. This is blowing me away so far!"
O que faz melhor que o Grok:
- O único modelo que supera o Grok no τ-Voice: 74,5% para o GPT-Live 1 (Astra, medium) contra 71,6%.
- O agente de backend é qualquer modelo que você configurar, então seu agente de texto atual e suas ferramentas podem ficar atrás da voz.
- Cobrança por segundo a US$ 0,05 por minuto, sem arredondar para um minuto inteiro.
Onde fica devendo:
- Demora mais para começar a falar: 1,34 s até o primeiro áudio com o Astra e 1,24 s com o Sol, contra 0,81 s do Grok.
- Os US$ 0,05 de destaque excluem o modelo de backend. A Artificial Analysis mediu a configuração com Astra em US$ 5,83 por hora, mais que os US$ 4,80 do Grok.
- A Artificial Analysis observa que as pontuações τ-Voice do GPT-Live vêm de uma única tentativa, contra três para a maioria dos modelos.
- A página do modelo não lista os idiomas suportados, uma lacuna que um usuário do HN também apontou.
Preços:
| Modelo | Preço | Observações |
|---|---|---|
| GPT-Live 1 | $0.05/min, cobrado por segundo | Chamadas Responses do backend cobradas às tarifas desse modelo |
| gpt-realtime-2.1 | $32 / $64 por 1M de tokens de áudio entrada / saída | Texto $4 / $24 por 1M |
| gpt-realtime-2.1-mini | $10 / $20 por 1M de tokens de áudio entrada / saída | Texto $0.60 / $2.40 por 1M |
Tudo da página de preços da OpenAI. A conta completa está no meu artigo sobre os preços do GPT-Live 1, e há uma lista separada de alternativas ao GPT-Live 1 se você estiver chegando pelo outro lado.
Minha opinião: a troca mais forte se suas ligações são pesadas em tarefas (reembolsos, reservas, mudanças de conta) e você aguenta meio segundo extra antes de o agente falar. Descarte se precisar de uma lista de idiomas publicada ou de um orçamento fixo por minuto. Se você for ligar ferramentas, leia antes sobre as chamadas de ferramentas no Realtime, porque o silêncio enquanto uma função roda é onde os clientes desligam.
2. Google Gemini 3.8 Live
Ideal para: ligações de alto volume e baixo risco (linhas de informação, lembretes de reserva, portas de entrada multilíngues) em que custo e cobertura de idiomas pesam mais que precisão em tarefas.
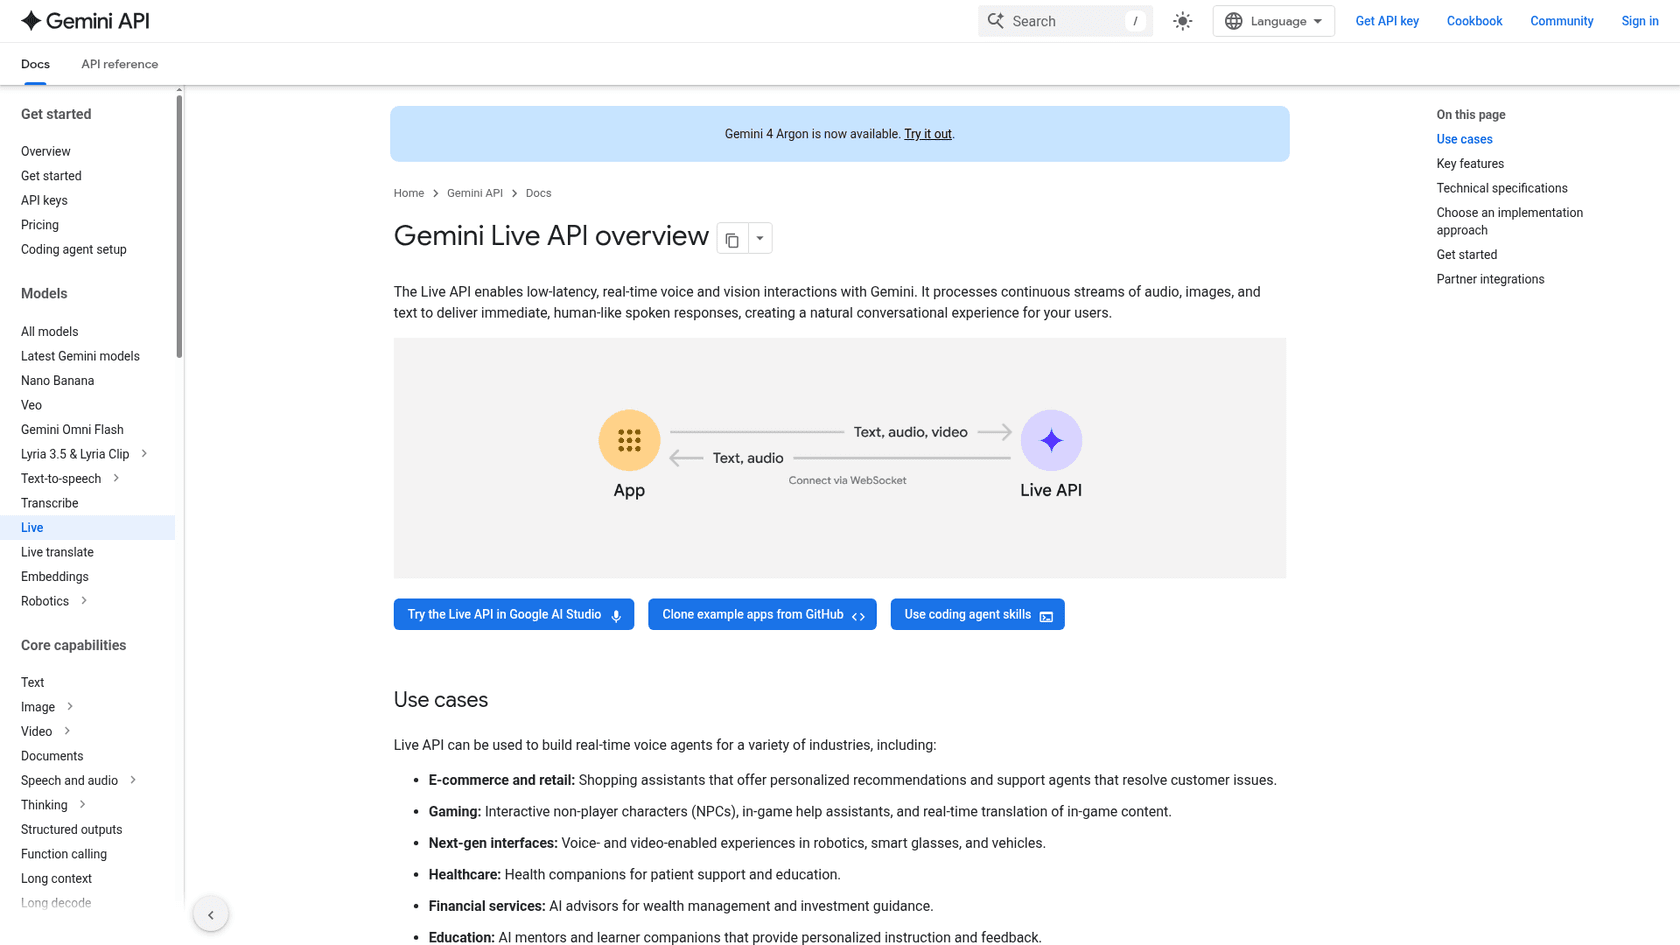
O Google chama o Gemini 3.8 Live de "the default option for most low-latency voice agent experiences", e é um modelo estável, não uma prévia. A Live API é um WebSocket com estado que recebe áudio, imagens e texto e responde em áudio, em 70 idiomas. As chamadas de função agora rodam de forma assíncrona por padrão, então o modelo pode continuar falando enquanto uma consulta roda.
Há também uma variante Extended Thinking, que raciocina em segundo plano. Ela marca 68,6% no τ-Voice, perto do Grok, mas seu tempo até o primeiro áudio é de 1,35 s e a Artificial Analysis a mediu em US$ 3,50 por hora. A família Live do Google também inclui o Live Translate para tradução speech-to-speech, um modelo à parte.
O que faz melhor que o Grok:
- Preço: US$ 0,005 por minuto de áudio de entrada e US$ 0,018 de saída. A Artificial Analysis mediu US$ 0,84 por hora contra os US$ 4,80 do Grok.
- 70 idiomas suportados contra 20+.
- Um plano gratuito na página de preços, e no plano pago seus dados não são usados para melhorar os produtos do Google.
- A segunda maior pontuação de preferência humana do ranking (Elo 1088).
Onde fica devendo:
- τ-Voice de 30,1% para o modelo padrão. Soa bem e muitas vezes não conclui o trabalho.
- Sessões sem compressão de contexto são limitadas a 15 minutos de áudio, e uma conexão dura cerca de 10 minutos antes de você precisar de retomada de sessão.
- Apenas WebSocket. Não há SIP nativo, então uma linha telefônica passa por um parceiro como o LiveKit.
- O modelo tem um limite de 131.072 tokens de entrada.
Preços:
| Item | Plano gratuito | Plano pago |
|---|---|---|
| Entrada de áudio | Grátis | $3.00 por 1M de tokens ou $0.005/min |
| Saída de áudio | Grátis | $12.00 por 1M de tokens ou $0.018/min |
| Entrada / saída de texto | Grátis | $0.75 / $4.50 por 1M de tokens |
| Google Search grounding | Suportado | 5,000 grátis/mês, depois $14 por 1,000 |
Minha opinião: a escolha certa quando o custo por minuto decide tudo e o agente mais informa do que age. Para uma linha que precisa alterar pedidos ou emitir créditos, eu testaria o Extended Thinking lado a lado com o Grok antes de confiar no modelo padrão. Se você já usa o Gemini 3.8 Flash para texto, a conta de faturamento compartilhada é um pequeno bônus.
Pipelines que você monta
Estes quatro encadeiam speech-to-text, um LLM de texto e text-to-speech. As etapas extras custam latência, e um desenvolvedor do Reddit resumiu bem o dilema:
"The core problem I found with the Retell/Vapi approach was the latency that chaining 3 services sequentially together added. STT provider → LLM → TTS provider. Each hop adds latency and you're managing 3 WebSocket connections plus your own VAD and turn-taking logic."

O outro lado é o controle. Com um pipeline, o LLM é qualquer modelo que você quiser, inclusive o que seu agente de texto já usa, e você ganha uma transcrição limpa em cada etapa para controle de qualidade e resumos de ligações. Deepgram, AssemblyAI e Inworld rodam o pipeline para você como uma única API, enquanto o LiveKit dá o framework para você rodá-lo por conta própria.
3. LiveKit Agents
Ideal para: equipes de engenharia que querem ser donas da stack, trocar de modelo livremente e operar seus próprios números de telefone.
O LiveKit Agents é um framework de código aberto (Apache 2.0) para adicionar um programa em Python ou Node.js a uma ligação como participante completo. Ele cuida das partes difíceis da voz: transmitir áudio pelo pipeline, detecção de turnos, interrupções e orquestração do LLM. Também suporta modelos em tempo real, incluindo GPT-Live e Gemini Live, e a documentação da xAI lista o LiveKit como uma forma suportada de conectar o Grok. Então o LiveKit é menos um substituto do Grok e mais uma camada que permite substituir o Grok depois sem reescrever.
O LiveKit Cloud adiciona hospedagem e números de telefone, simulações e observabilidade, além de um catálogo de inferência hospedado para chamar modelos sem chaves de API separadas.
O que faz melhor que o Grok:
- Liberdade de modelos: a página de preços lista dezenas de LLMs e modelos de STT e TTS com tarifas por minuto, do GPT-5 nano a US$ 0,0002/min ao Deepgram Flux a US$ 0,0065/min.
- Telefonia embutida: um número gratuito dos EUA, troncos SIP e conectores de Twilio e WhatsApp.
- Até 600 sessões simultâneas no plano Scale, publicadas na página.
- Simulações de texto e áudio para testar o agente antes de clientes reais chegarem, grátis até 31 de outubro.
Onde fica devendo:
- Você é o integrador. Escolher e ajustar três modelos dá trabalho de verdade.
- A latência depende das suas escolhas, e não existe um número independente de tempo até o primeiro áudio para o "LiveKit" como um todo.
- HIPAA com BAA assinado começa no plano Scale, a partir de US$ 500 por mês.
Preços:
| Plano | Preço | Minutos de agente incluídos | Sessões simultâneas | Destaque |
|---|---|---|---|---|
| Build | $0 | 1,000 | 5 | 1 número gratuito dos EUA, 50 minutos de entrada |
| Ship | A partir de $50/mês | 5,000, depois $0.01/min | 20 | Colaboração em equipe, rollback instantâneo |
| Scale | A partir de $500/mês | 50,000, depois $0.01/min | Até 600 | HIPAA BAA, fixação de região |
| Enterprise | Personalizado | Personalizado | Personalizado | Preço de inferência por volume, SSO |
A própria calculadora do LiveKit precifica um agente telefônico de exemplo (Gemma 4 31B, STT da AssemblyAI, TTS da Fish Audio, um número dos EUA e observabilidade) em US$ 0,0479 por minuto, cerca de 40% abaixo do Grok.
Minha opinião: minha escolha para uma equipe com engenheiros que espera trocar de modelo mais de uma vez. É a única opção aqui em que passar do Grok para o Gemini ou o GPT-Live é uma mudança de configuração. Descarte se ninguém na equipe quiser ser dono de um pipeline de voz.
4. Deepgram Voice Agent API
Ideal para: equipes que querem uma API de pipeline gerenciada a preço fixo, com a opção de trazer o próprio LLM.
A Voice Agent API da Deepgram "handles the full speech pipeline (listening, thinking, and speaking)" por um único WebSocket. Você configura o modelo de fala e o provedor de LLM, a voz e o endpointing, e depois adiciona chamadas de função e transferências entre vários agentes. Seu modelo de fala Flux foi feito para agentes de voz, com detecção de turnos e tratamento de interrupções embutidos. Quando a Artificial Analysis testou a stack padrão da Deepgram, era Nova-3 para ouvir, GPT-4o Mini para pensar e Aura-2 para falar.
O que faz melhor que o Grok:
- Um crédito grátis de US$ 200 sem cartão, que a Deepgram diz cobrir cerca de 43.000 minutos de transcrição Nova.
- Opções de trazer o seu cortam o preço: US$ 0,050 por minuto se você fornecer o LLM e a voz.
- Até 45 conexões de agente simultâneas no pay-as-you-go simples, sem escada de gastos.
- SOC 2 Type 2, HIPAA com BAA para Enterprise e um endpoint dedicado na UE.
Onde fica devendo:
- O LLM padrão no teste da Artificial Analysis foi o GPT-4o Mini, um modelo pequeno para ligações de suporte complexas. Planeje trazer o seu para qualquer coisa pesada em políticas.
- Sem pontuação τ-Voice ou de latência da Artificial Analysis para o agente completo.
- Cobrado pelo tempo de conexão WebSocket, então um socket aberto e ocioso ainda custa dinheiro.
Preços:
| Nível | Pay-as-you-go | Growth |
|---|---|---|
| Standard | $0.075/min | $0.068/min |
| Standard, TTS próprio | $0.065/min | $0.051/min |
| Custom, LLM próprio | $0.059/min | Não listado |
| Custom, LLM + TTS próprios | $0.050/min | $0.041/min |
| Advanced | $0.163/min | $0.146/min |
O Growth exige um compromisso a partir de US$ 4.000 por ano, segundo a página de preços da Deepgram.
Minha opinião: o pipeline mais limpo de "uma API, um preço" aqui. Bom encaixe para uma equipe que já tem um agente LLM e quer envolvê-lo com os ouvidos e a voz da Deepgram a US$ 0,050 por minuto. Menos atraente se você quiser que o LLM padrão faça o raciocínio.
5. AssemblyAI Voice Agent API
Ideal para: equipes que querem o preço único mais simples e reconhecimento de fala forte, e que aceitam o LLM próprio da AssemblyAI.
A AssemblyAI é mais conhecida por speech-to-text, e sua Voice Agent API empilha três peças próprias: o modelo de fala Universal-3.6 Pro Realtime, um LLM proprietário "tuned for spoken conversation rather than text chat" e sua própria voz de baixa latência. O guia de início rápido põe um agente de navegador para falar em quatro comandos e depois o coloca em um número de telefone.
O que faz melhor que o Grok:
- Um preço único de US$ 4,50 por hora (US$ 0,075 por minuto), com reconhecimento de fala, LLM e voz incluídos.
- O modelo de fala suporta 32 idiomas com prompting de termos-chave, útil para nomes de produtos e SKUs.
- Contas pagas podem optar por não participar do treinamento, e um BAA assinado faz isso automaticamente, segundo a página de segurança da AssemblyAI.
Onde fica devendo:
- O LLM incluído é o da própria AssemblyAI. Não há benchmark publicado de como ele lida com uma política de suporte e ferramentas.
- Sem pontuação da Artificial Analysis para o agente completo.
- Os limites de concorrência não estão na página de preços; condições por volume passam pelas vendas.
Preços:
| Componente | Preço |
|---|---|
| Voice Agent API (orquestração e hospedagem) | $4.50/hr ($0.075/min) |
| Modelo de fala Universal-3.6 Pro Realtime | Incluído |
| LLM do Voice Agent | Incluído |
| TTS do Voice Agent | Incluído |
| Descontos por volume, engenheiro de implantação | Fale com vendas |
Minha opinião: um padrão sensato para uma equipe que se importa mais em ouvir bem os clientes (sotaques, linhas ruidosas, nomes de produtos) e quer uma única linha na fatura. Eu testaria o LLM deles em 30 das minhas ligações mais difíceis antes de me comprometer, já que é a parte sem pontuação pública.
6. Inworld Realtime API
Ideal para: equipes que querem uma API estilo speech-to-speech com LLM à escolha e o menor custo de voz por minuto.
A Realtime API da Inworld parece um modelo speech-to-speech por fora: uma única conexão WebSocket ou WebRTC que "listens, reasons and talks back". Por baixo, é um pipeline com o speech-to-text próprio da Inworld, sua escolha entre 8 LLMs hospedados e as vozes TTS-2 no final. O atrativo para quem usa Grok é que seus eventos e a configuração de sessão coincidem com a OpenAI Realtime API, então um cliente migra com um novo endpoint e uma nova chave.
O que faz melhor que o Grok:
- Sem taxa de speech-to-speech por cima. Cada peça é cobrada à sua própria tarifa: speech-to-text a US$ 0,15 por hora, TTS-2 Flash a partir de US$ 15 por milhão de caracteres sob demanda.
- Você escolhe o LLM, então o raciocínio pode ser tão forte (ou tão barato) quanto quiser.
- Primeiro áudio medido pelo fornecedor de até 204 ms, com mediana de 462 ms em 17 turnos medidos.
- GDPR e SOC 2 Type II em todos os planos.
Onde fica devendo:
- Os números de latência são medições da própria Inworld, não independentes.
- O preço é uma soma de partes, então prever uma fatura dá mais trabalho do que com uma tarifa fixa por minuto.
- HIPAA e BAA são complementos no plano mais alto publicado.
- O áudio telefônico chega como G.711 da Twilio, então você traz o número de telefone.
Preços:
| Plano | Mensal | TTS-2 Flash por 1M de caracteres | STT 1 por hora |
|---|---|---|---|
| On-Demand | $0 | $15 | $0.15 |
| Creator | $25 | $10 | $0.10 |
| Builder | $100 | $9 | $0.10 |
| Developer | $300 | $8 | $0.10 |
| Growth | $1,500 | $7 | $0.10 |
A Inworld estima cerca de 1.000 caracteres de fala por minuto, então a saída de voz fica em torno de US$ 0,01 a US$ 0,015 por minuto em que o agente fala, mais os tokens do LLM. Mais no meu detalhamento dos preços da Inworld AI e na lista de alternativas à Inworld.
Minha opinião: a jogada de custo mais interessante para equipes que já estão satisfeitas com um LLM de texto. Ela dá a experiência de desenvolvimento estilo Grok com a flexibilidade de um pipeline. Espere se precisar de números de latência independentes ou de uma linha telefônica pronta para uso.
Plataformas gerenciadas de agentes de voz
Estas três envolvem um pipeline com o que um líder de suporte precisa para realmente operar um agente telefônico: números e um construtor, testes e análises, além de concorrência que você pode comprar. Você troca um pouco de controle e uma taxa de plataforma por não construir nada disso sozinho. Se sua equipe está avaliando uma plataforma, meu panorama da melhor IA para suporte por voz cobre mais delas, assim como a lista de alternativas ao Voiceflow.
7. ElevenLabs Agents
Ideal para: equipes que querem um agente gerenciado com a maior cobertura de idiomas e as vozes mais naturais.
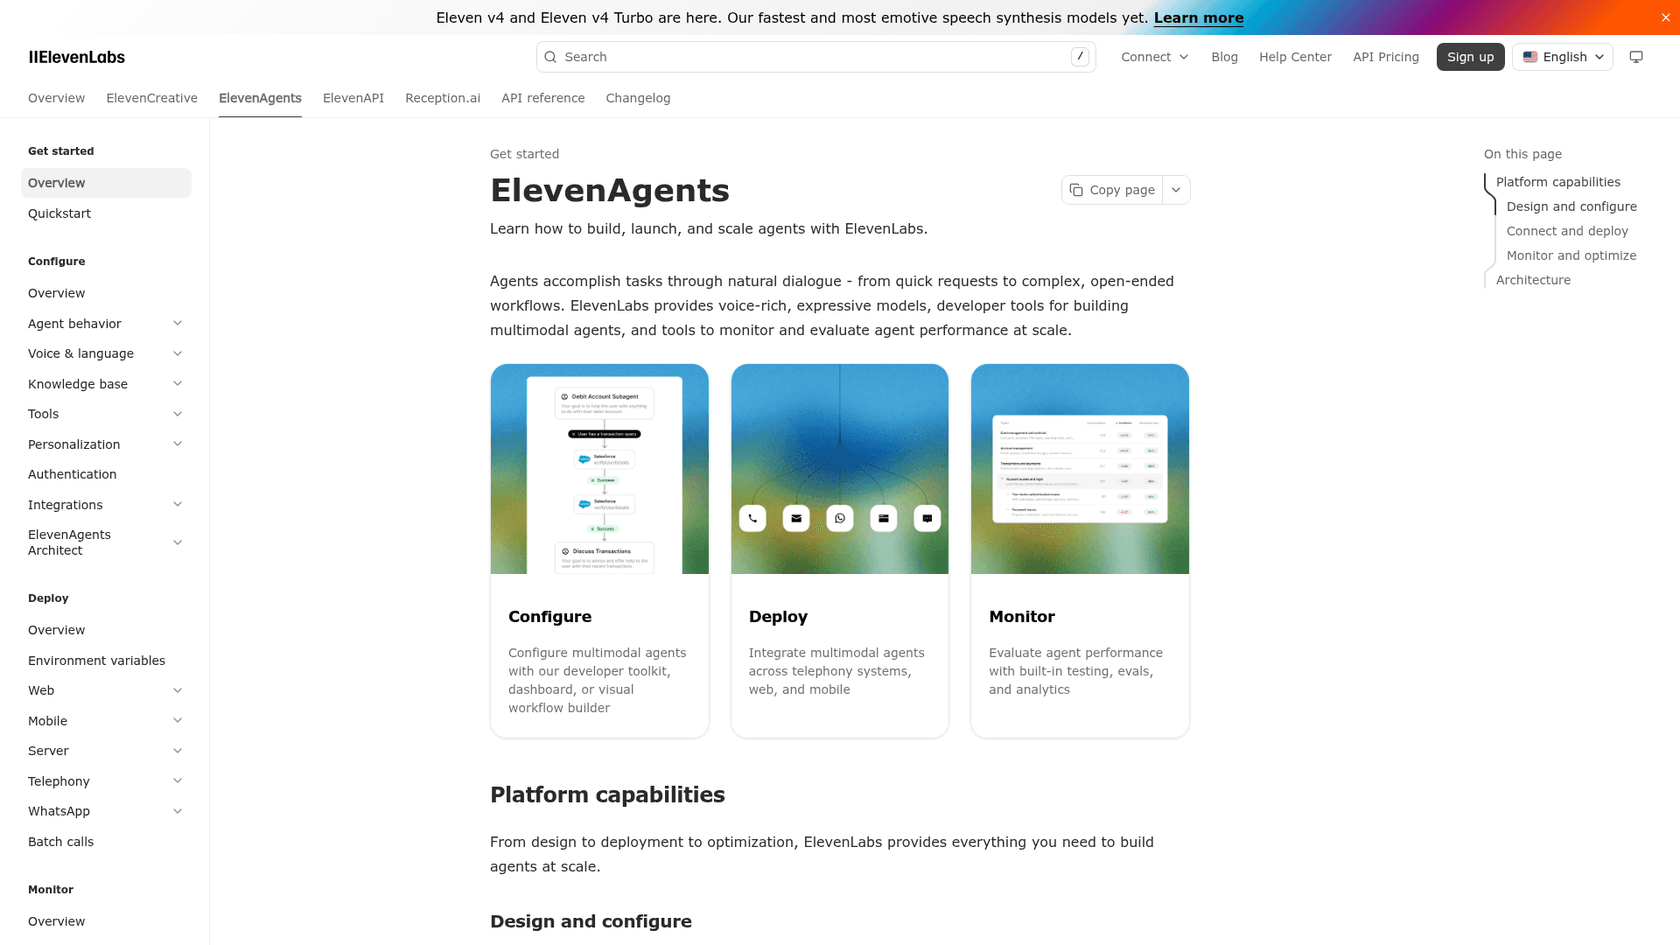
A ElevenLabs fez seu nome com vozes, e o ElevenAgents é sua plataforma para "natural, human-sounding agents in 90+ languages" em voz, chat e e-mail. Você configura um agente com um construtor de fluxos, anexa uma base de conhecimento e ferramentas, implanta em uma linha telefônica, na web ou no celular e monitora com testes e análises embutidos. A stack padrão que a Artificial Analysis testou foi Scribe v2 Realtime, Gemini 2.5 Flash e Eleven Flash v2, e você pode escolher de uma longa lista de LLMs ou trazer o seu.
O que faz melhor que o Grok:
- 90+ idiomas, a maior cobertura desta lista.
- Concorrência publicada em todos os planos, de 4 ligações no Free a 40 no Business, e preço de rajada que permite aos agentes atender até 3x esse limite pelo dobro da tarifa.
- Sem taxa de telefonia: traga Twilio ou um tronco SIP e pague sua operadora diretamente.
- Um construtor de agentes completo, para que um líder de suporte altere o fluxo sem fazer deploy.
Onde fica devendo:
- Os US$ 0,08 por minuto são antes do LLM. A calculadora de preços mostra o Gemini 2.5 Flash a US$ 0,0029 por minuto; modelos mais fortes custam mais.
- BAAs para HIPAA só no Enterprise.
- Sem pontuação τ-Voice independente para o agente completo.
Preços:
| Plano | Mensal | Minutos de ligação incluídos | Ligações simultâneas |
|---|---|---|---|
| Free | $0 | 15 | 4 |
| Starter | $6 (primeiro mês $1) | 75 | 6 |
| Creator | $22 (primeiro mês $11) | 275 | 10 |
| Pro | $99 | 1,238 | 20 |
| Scale | $299 | 3,738 | 30 |
| Business | $990 | 12,375 | 40 |
| Enterprise | Personalizado | Personalizado | Elevadas |
Minutos extras custam US$ 0,08 em todos os planos, e minutos de rajada US$ 0,16, segundo a página de preços do ElevenAgents. Há mais detalhes no meu artigo sobre os preços da ElevenLabs e na lista de alternativas à ElevenLabs.
Minha opinião: a troca gerenciada mais fácil para uma equipe de suporte, especialmente uma multilíngue. No Business, 12.375 minutos incluídos por US$ 990 dão os mesmos US$ 0,08 do Grok, com construtor, telefonia e análises de bônus. Descarte se precisar de HIPAA sem contrato Enterprise.
8. Vapi
Ideal para: desenvolvedores que querem uma plataforma gerenciada mas ainda querem escolher cada modelo e pagar os provedores a preço de custo.
A Vapi fica entre o LiveKit e a ElevenLabs. Ela roda a infraestrutura (hospedagem e telefonia, monitoramento, além de testes com simulação), e você escolhe o transcritor, o LLM e a voz do catálogo, cobrados "with no markup". Sua página inicial cita a equipe de suporte da Ring indo de zero à produção em duas semanas. Um desenvolvedor do Reddit que opera sistemas de produção nela contestou a ideia de que serve só para protótipos:
"Vapi is good at PoC stage and it is good at production usage, it is not a fair criticism at all - I have many production AI voice systems running on Vapi right now with no issues."
O que faz melhor que o Grok:
- Qualquer combinação de modelos, incluindo speech-to-speech, com os provedores repassados a preço de custo.
- Telefonia e SIP da Vapi são grátis, e a concorrência extra custa uma tarifa fixa de US$ 10 por linha por mês.
- Ligações de teste simuladas antes de clientes reais ouvirem o agente.
Onde fica devendo:
- A taxa de hospedagem de US$ 0,05 é somada a cada modelo. A própria estimativa da Vapi para 1.000 minutos fica entre US$ 82 e US$ 129, ou seja, US$ 0,082 a US$ 0,129 por minuto.
- HIPAA é um complemento de US$ 2.000 por mês.
- SLAs de disponibilidade começam no pacote Pro de US$ 999 por mês.
Preços:
| Pacote | Mensal | Ligações simultâneas | Destaque |
|---|---|---|---|
| Sem pacote | $0, $5 de crédito grátis | 4 | $0.05/min de hospedagem, 14 dias de retenção de dados |
| Core | $29 | 10 | Retenção zero de dados, SLA de suporte de 2 dias úteis |
| Pro | $999 mínimo (10% da taxa de hospedagem) | 30 | RBAC, suporte por Slack, SLA de disponibilidade de 99% |
| Premier | Personalizado | Elevadas | SLA de disponibilidade de 99,9%, SIP dedicado |
Tudo da página de preços da Vapi.
Minha opinião: o meio-termo certo quando você quer recursos de plataforma mas se recusa a ficar preso aos modelos de um único fornecedor. Orce a taxa de hospedagem mais três provedores, e o total costuma ficar nos US$ 0,08 do Grok ou acima.
9. Cartesia Line
Ideal para: equipes que querem um agente gerenciado com controle no nível do código e a menor taxa fixa de plataforma.
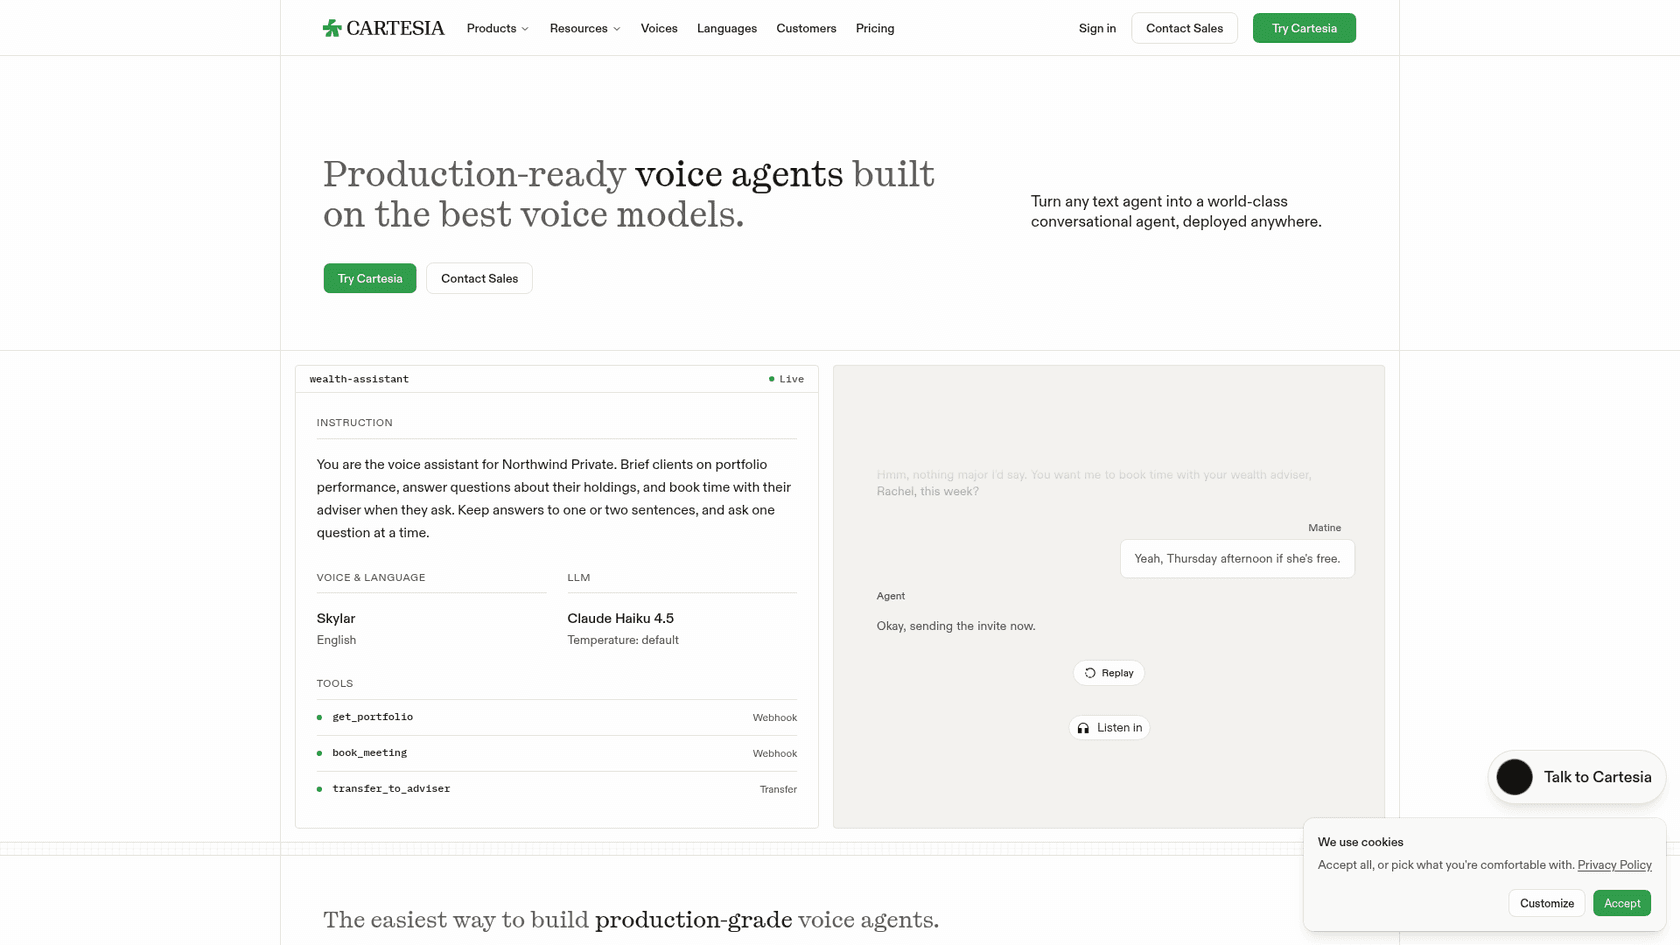
O Line "brings voice to your text agents" usando o speech-to-text Ink e as vozes Sonic da Cartesia, que cobri na minha análise do Cartesia Sonic 3. Você escreve a lógica de raciocínio em código com o SDK (qualquer LLM, qualquer API) ou prototipa no construtor sem código, e depois implanta no runtime gerenciado da Cartesia com registros de ligações, avaliações e implantações versionadas que você pode reverter. Há uma CLI para implantar e testar pelo terminal.
O que faz melhor que o Grok:
- US$ 0,06 por minuto pelo agente gerenciado, a menor taxa fixa de plataforma desta lista.
- O uso de LLM é grátis para agentes criados na interface, por tempo limitado.
- SOC 2 Type II, HIPAA e GDPR listados no site.
- As mensalidades do plano voltam como crédito de agente: o plano Scale de US$ 299 inclui US$ 299 para gastar em agentes.
Onde fica devendo:
- A promoção do LLM tem prazo, então planeje seu orçamento como se fosse pagar pelos tokens.
- A concorrência chega ao teto de 60 ligações no plano Scale antes do Enterprise.
- Sem pontuação τ-Voice independente para o agente completo.
Preços:
| Plano | Mensal | Crédito de agente incluído | Ligações simultâneas |
|---|---|---|---|
| Free | $0 | $1 (~17 min) | 8 |
| Pro | $5 | $5 | 12 |
| Startup | $49 | $49 | 20 |
| Scale | $299 | $299 | 60 |
| Enterprise | Personalizado | Personalizado | Personalizado |
As ligações custam US$ 0,06 por minuto, mais US$ 0,014 por minuto em um número de telefone da Cartesia, segundo a página de preços da Cartesia. Se a qualidade da voz for o fator decisivo, minha comparação Cartesia vs ElevenLabs aprofunda mais.
Minha opinião: uma escolha forte para uma equipe de desenvolvimento que gosta da abordagem gerenciada da ElevenLabs mas quer escrever o agente em código. Fique de olho na linha do LLM na sua fatura quando a promoção acabar.
Como escolher o vencedor em uma semana
Os benchmarks reduzem a lista, e depois suas próprias ligações decidem. O conselho do ChatGPT foi passar as mesmas 20 a 50 conversas de teste pelos seus dois ou três melhores candidatos, e concordo, com uma mudança: use ligações reais, não inventadas.
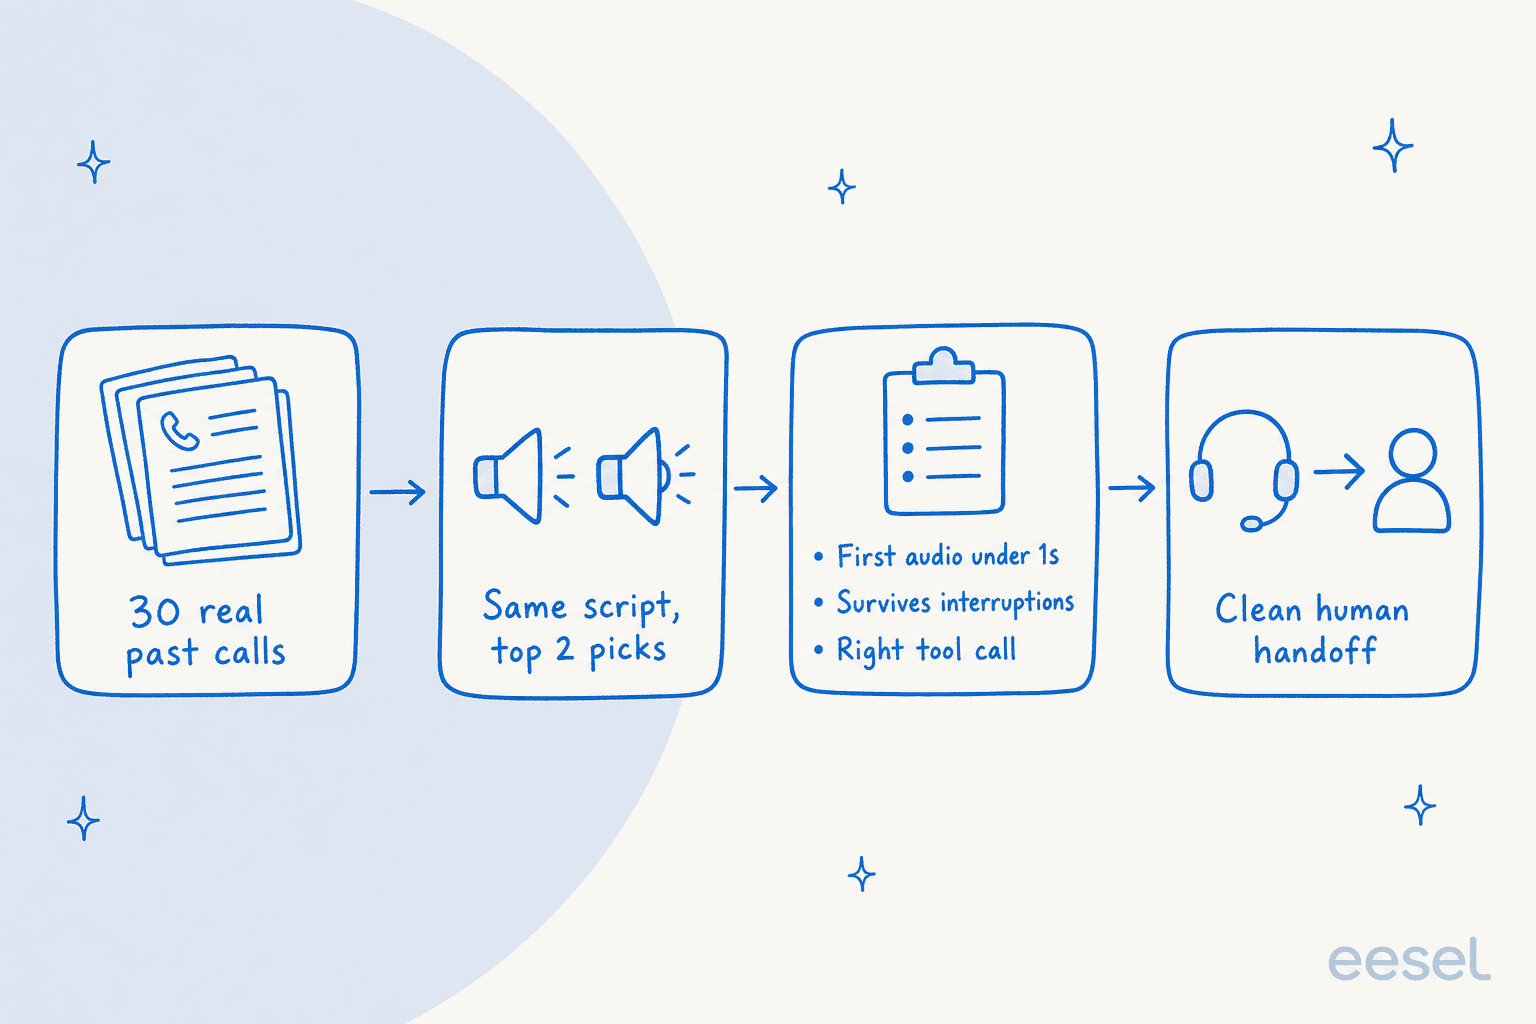
- Puxe 30 ligações reais passadas. Transcrições do seu sistema telefônico, com peso para as ligações que sua equipe considera mais difíceis: reembolsos, clientes irritados, mudanças de conta.
- Rode o mesmo roteiro pelas suas duas primeiras. O Grok Voice 3.0 deve ser geralmente uma delas, já que é a barra a superar.
- Pontue três coisas. Tempo até o primeiro áudio (o cliente ouve uma resposta em menos de um segundo?), interrupções (ele para e escuta quando o cliente o corta?) e chamadas de ferramentas (chamou a função certa com o número de pedido certo?).
- Verifique a transferência. Todo agente de voz falha em algumas ligações. O que importa é se ele passa o cliente a uma pessoa com o contexto. Meu artigo sobre boas práticas de transferência cobre o que esse contexto deve incluir.
Se você já usa agentes de voz de IA do Zendesk ou os agentes de voz do Freshcaller, inclua também a opção nativa do seu helpdesk no teste. Às vezes a resposta chata é a que vence.
O que nenhuma dessas nove resolve
Todo modelo e plataforma acima é, no que faz, um motor de conversa. O benchmark τ-Voice dá a cada um um documento de políticas e um conjunto de ferramentas escritos para o teste. Na sua linha telefônica, o agente sabe exatamente o que você conecta a ele e nada mais.
É aí que a maioria dos lançamentos reais de suporte por voz gasta seu tempo: decidir o que o agente pode dizer, manter as respostas atualizadas e conectá-lo aos dados de pedidos e contas. Nas nossas ligações de vendas, o pedido mais consistente entre os compradores é o mesmo: treinar a IA nos tickets anteriores da equipe. Uma marca de suplementos direto ao consumidor dessas ligações passa cerca de 7.000 tickets por mês por Gorgias e Shopify, com um sistema telefônico separado ao lado. Seu agente telefônico e sua fila de tickets precisam das mesmas respostas.
As equipes que acertam isso tratam o agente telefônico como um chatbot de base de conhecimento com voz: uma fonte mantida de respostas, da qual todos os canais leem. Se você ainda está decidindo se a IA pode atender ligações de suporte na sua equipe, ou se vale automatizar o suporte por telefone, comece pelos canais de texto. Eles são mais baratos por interação, mais fáceis de medir e constroem o conhecimento de que o agente de voz vai precisar.
Meu guia para automatizar o atendimento ao cliente mostra a ordem em que eu faria.
Combine qualquer uma delas com a eesel
A API de voz é a infraestrutura, e a eesel é o funcionário. O colega de IA para o helpdesk da eesel entra no seu Zendesk, Freshdesk ou Gorgias, aprende com seus tickets anteriores e sua central de ajuda e trabalha a fila de e-mail e chat que fica atrás de toda linha telefônica. Antes de entrar no ar, você pode rodá-lo contra seus próprios tickets anteriores e comparar as respostas dele com o que sua equipe realmente enviou.

Para desenvolvedores, o ponto de conexão é o MCP. Todo workspace da eesel é um servidor MCP: npx @eesel/cli mcp token da CLI da eesel imprime a URL e um token de 30 dias, para que um agente de voz no Grok, GPT-Live ou LiveKit consulte as mesmas respostas que seu agente de tickets usa. A mesma CLI permite automatizar o agente pelo terminal ou entregá-lo a um agente de código como o Claude Code. Ainda não rodei essa combinação em uma linha telefônica ao vivo, então trate-a como uma construção promissora e fique de olho na latência de uma chamada de ferramenta no meio da frase.
O preço é um plano fixo mensal de créditos: US$ 299 por mês por 500 créditos, em que um ticket ou chat é um crédito, com 100 créditos grátis e sem cartão para começar. Experimente a eesel em uma fatia da sua fila antes de escolher uma voz, para que a vencedora tenha algo que valha a pena dizer.