Alternativas ao Grok Bot em 2026: 8 agentes que você realmente consegue auditar

Riellvriany Indriawan

Katelin Teen
Última edição October 14, 2026
Eu trabalho na fila de suporte da eesel, então quando o Grok Bot foi lançado, meu primeiro pensamento não foi "quão inteligente ele é". Foi mais: essa coisa manda algo errado numa terça, como eu vou sequer descobrir até quinta? A própria documentação da xAI é honesta sobre isso, e a resposta honesta é ainda não: "Spend and usage are on the dashboard today. An audit view of Bot actions is coming."
Então este comparativo não classifica agentes por esperteza. Três coisas são verificadas, as que um comprador consegue conferir antes de assinar qualquer coisa. Dá para testar no mês passado antes que ele toque neste mês? Dá para provar depois o que ele fez? Dá para mantê-lo longe do que ele nunca deve tocar? A resposta do Grok Bot aqui é não, ainda não, em parte, o que é uma lacuna real por US$ 200/mês, e é a mesma lacuna que a maioria das oito opções abaixo consegue fechar.
Versão curta: se o trabalho é a sua fila de suporte, a eesel AI é a que reproduz o seu próprio histórico de tickets e dá um número de precisão antes que qualquer cliente veja algo, a partir de US$ 299/mês por 500 créditos em vez de uma licença por usuário. Para trabalho geral de conhecimento, há o Claude in Chrome, que mantém tudo dentro do seu próprio navegador com um plano que você aprova primeiro. E se o que você mais quer são comprovantes, n8n e Manus são os dois que mantêm um registro de execução de verdade.
Por que as pessoas já estão procurando uma alternativa ao Grok Bot
Sejamos justos primeiro com o Grok Bot: o que ele faz bem, faz melhor que quase todo mundo. A aposta de design dele, operar uma interface do jeito que uma pessoa faria, é o que permite chegar a ferramentas sem uma API limpa. É uma capacidade real, e vale dizer isso com clareza. Todo o resto desta lista precisa de uma API ou de um conector antes de poder ajudar, e muitas ferramentas internas nunca ganharam um. O Grok Bot simplesmente passa direto por esse problema. Um descendente honesto do RPA de call center, só que com um cérebro muito melhor por baixo.
As dores que mandam as pessoas procurar outra coisa, porém, não são sobre o cérebro.
A porta custa US$ 200. O Cursor Ultra custa US$ 200/mês e o Cursor Premium Teams US$ 120 por usuário, sem plano gratuito e sem duração de teste publicada. Curiosamente, o plano de equipe sai mais barato por usuário que o individual. Passei pelas quatro camadas dessa conta no detalhamento dos preços do Grok Bot; resumindo, o preço de tabela é a taxa de entrada, não o custo real.
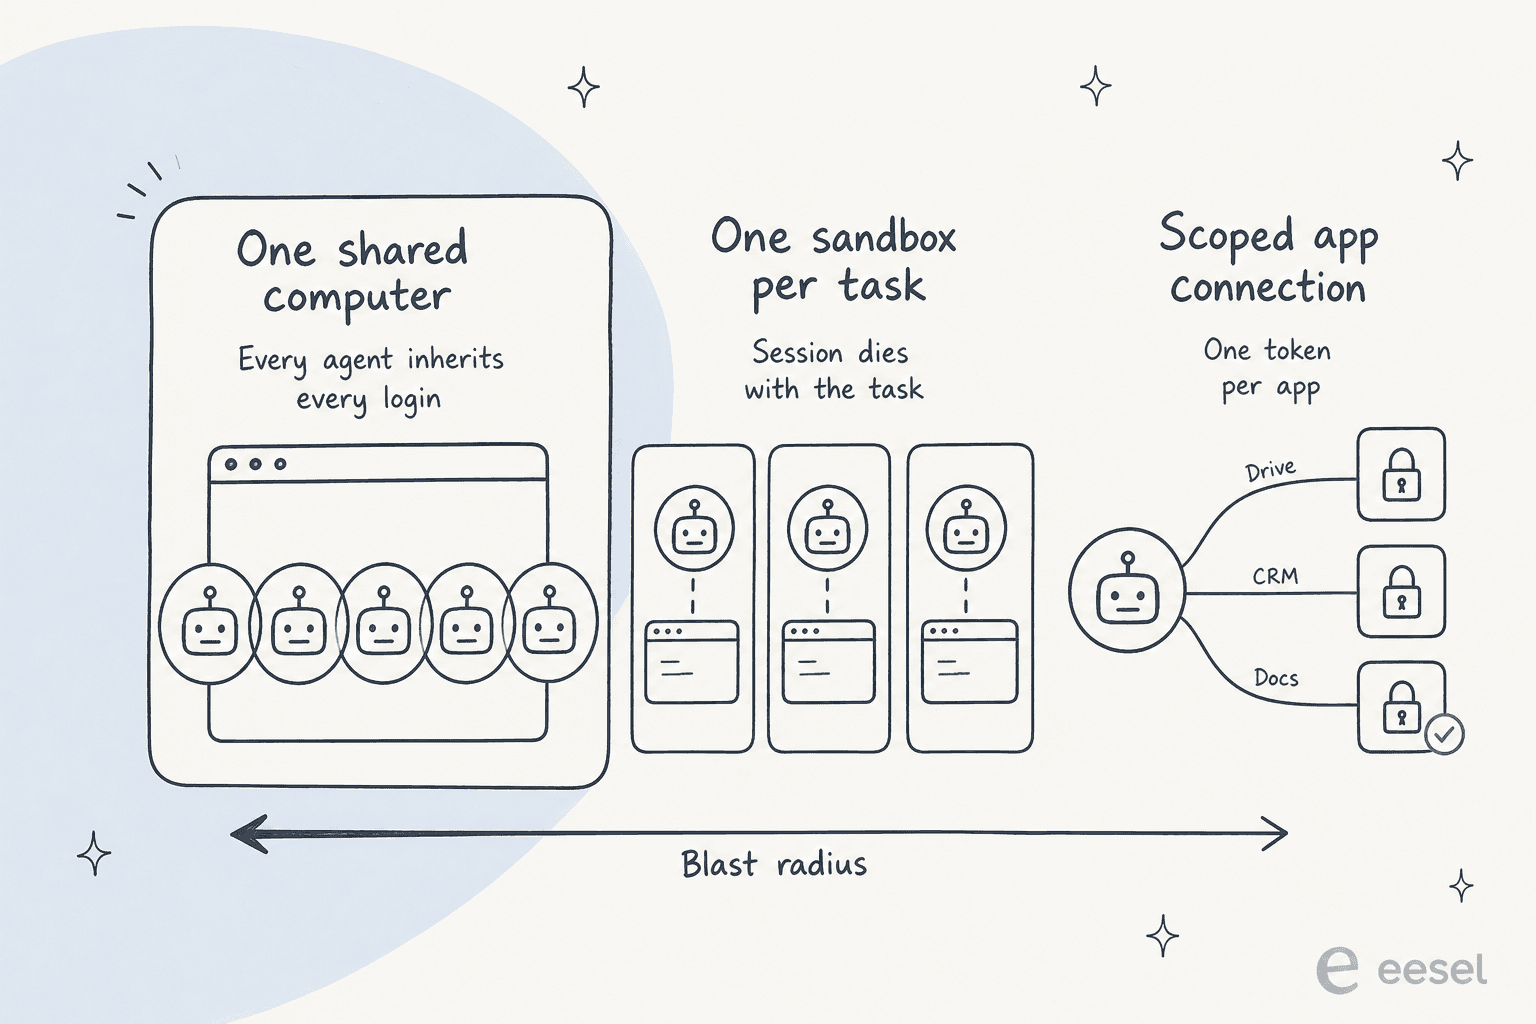
Todos os seus Bots dividem um computador. Isso é o que mais surpreende, e vem da própria xAI, não de críticos. A documentação diz com clareza: "All of your Bots share one cloud computer assigned to your user account. Files, browser sessions, and command line credentials on that computer are available across your Bot roster." Depois, dito duas vezes na mesma página: "Do not use separate Bots as a security boundary." Você loga um Bot no seu helpdesk e de repente todos os outros Bots herdam essa sessão também. Apaga um Bot, e os logins continuam lá.
A explicação mais afiada de por que isso importa veio do Hacker News no dia do lançamento:
"By hijacking a real person's credentials, that person becomes the accountability sink. Very neat. Very deliberate."

Não há teste a seco. Também da documentação, literal de novo: "A test run performs real work. It can navigate websites, change files, and call connected tools." Ou seja, a única forma de descobrir se o Bot entende o seu processo é soltá-lo para fazer o seu processo de verdade.
Nada é certificado. Sem SOC 2, sem ISO 27001, sem GDPR, sem HIPAA, sem janela de retenção, sem residência de dados, sem subprocessadores nomeados. A segurança é adiada por inteiro para os termos do Cursor, e o Grok Bot "requires data storage and does not support Legacy Privacy Mode", o que significa que não há opção de retenção zero para recorrer quando você precisar.
E o único trabalho que ele anuncia, ele não entregou de fato. O prompt de exemplo em x.ai/bot é "Sign in to Zendesk so I can work the support queue." Nenhum dos oito papéis lançados, Sales Outbound, Talent Scout, Paid Media, Expense Manager, Product Performance, Bug Reproduction, Account Health, Chief of Staff, é um papel de suporte. Reparei porque por acaso é o meu trabalho, e é estranho abrir a página do produto com isso.
As três perguntas que eu faria antes de dar um login a qualquer agente
Passei os últimos anos vendo agentes de IA trabalharem filas de suporte ao vivo, e a falha que ficou comigo não é um bot que quebrou. É um bot que soava totalmente bem enquanto errava. O agente de um cliente da eesel, com uma base de conhecimento sem nada relevante sobre a pergunta, preencheu a lacuna com seus próprios dados de treinamento e mandou afirmações inventadas e confiantes para pessoas reais. Outro disse aos clientes "sim, damos suporte ao modelo do seu carro" para marcas que nem estavam no banco de dados, só porque a central de ajuda dizia que a empresa dá suporte a todos os modelos. Nenhum dos dois parece um erro num log, parecem boas respostas.
É por isso que as três perguntas abaixo são sobre evidência, não sobre capacidade. Uma resposta fluente e errada continua invisível a menos que algo a force a aparecer.
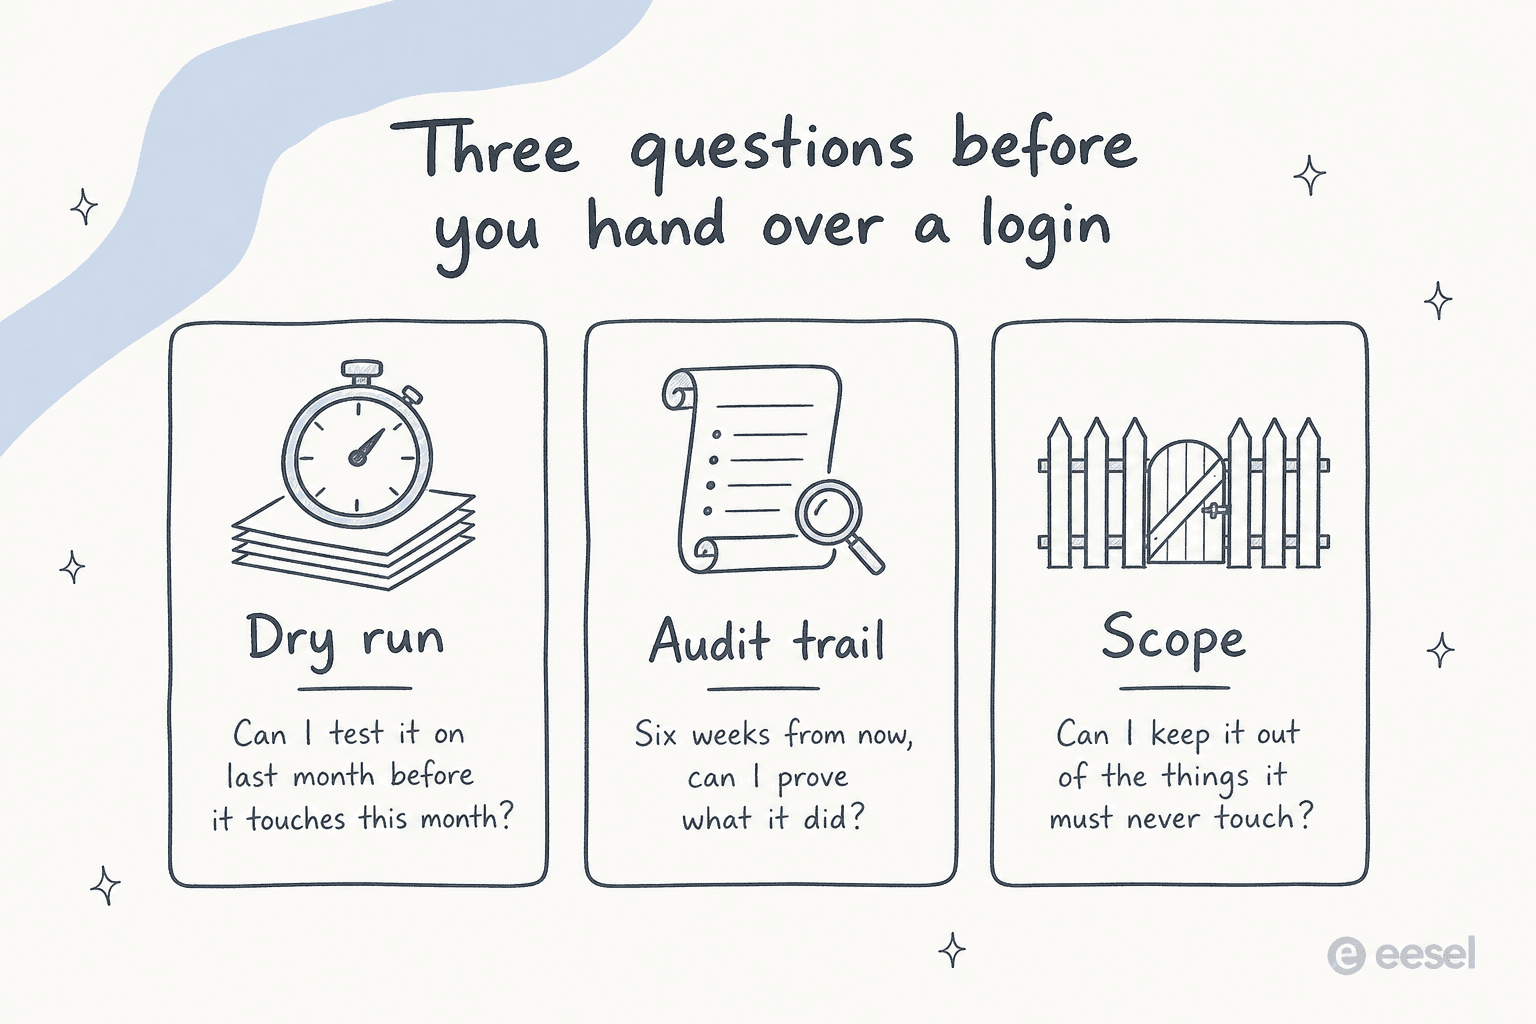
1. Dá para testar no mês passado antes que ele toque neste mês?
Não "tem uma sandbox?", nem "consigo vê-lo trabalhar?". Dá para apontá-lo para dados que já aconteceram e tirar um número de verdade? Esse número é basicamente o argumento inteiro. Numa caixa de entrada de e-commerce rodei essa reprodução e ela voltou com 93% de precisão na triagem, 100% na detecção de spam e uma taxa de erro factual de 7% nos rascunhos. Eu sabia cada um desses números antes de um único cliente ver qualquer coisa, e esses 7% são exatamente o motivo de o lançamento ter começado em modo rascunho em vez de ir ao vivo direto.
Só três das oito ferramentas abaixo conseguem reproduzir algo que já aconteceu. A maioria oferece em vez disso um aviso de confirmação ao vivo, que é outro produto: ele pega a ação que você está olhando, não o padrão que você ainda não percebeu.
2. Daqui a seis semanas, dá para provar o que ele fez?
Avisos de aprovação parecem a resposta aqui, e não são, por causa de uma linha enterrada na própria documentação da xAI, que acho ser a frase mais importante da página inteira: "An approval controls the proposed action. It does not reverse work already completed."
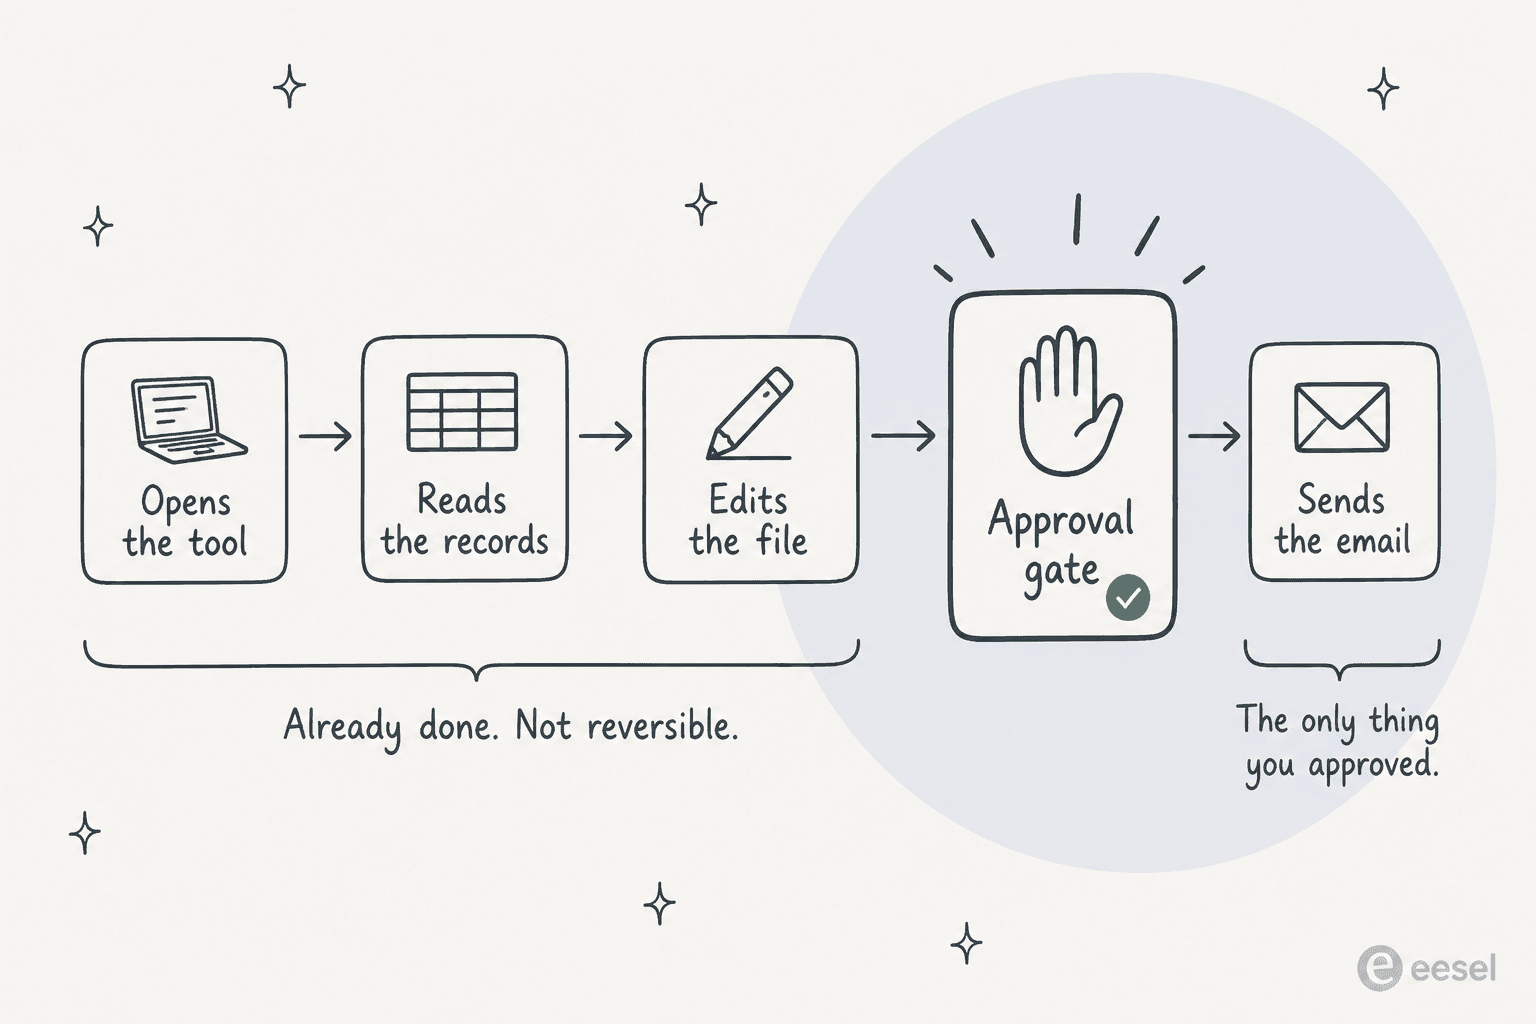
Quando um cartão de aprovação sequer aparece, o agente já abriu coisas, leu coisas, mudou coisas. Você está aprovando o último passo de uma cadeia, não a cadeia. A única coisa capaz de recuperar essa cadeia depois é um log, e "em breve" não é um log, ainda não. Essa é também mais ou menos a diferença entre um copiloto de IA e um agente autônomo: o registro do copiloto é o humano que de fato apertou enviar.
Vale sinalizar: as aprovações do Grok Bot também são texto livre escrito pelo usuário, não uma lista de ações perigosas imposta pelo produto. A documentação manda você escrever o limite em prosa, e as sete categorias sugeridas ("Prefer explicit boundaries for:") são só conselho. Há também um motor de regras opcional chamado Auto Review, e o aviso da própria xAI sobre ele é refrescantemente direto: ele "is model-based and should complement, not replace, least privilege and explicit approval boundaries." Um LLM julgando outro LLM, em outras palavras.
3. Dá para mantê-lo fora do que ele nunca deve tocar?
Isso decide se uma equipe de suporte consegue colocar um agente no ar, e é o motivo de eu voltar sempre ao escopo em vez da esperteza. Um líder de CX de uma marca de suplementos, com cerca de 7.000 tickets por mês no Gorgias, disse isso melhor do que eu conseguiria:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
O requisito inteiro, basicamente, era que a IA não tocasse na maior parte da fila. Outro administrador pediu algo ainda mais estreito: responder só quando for mencionada explicitamente com @, nunca a cada mensagem de cliente. Uma sessão de navegador persistente logada como humano não tem onde colocar nenhuma das duas restrições. A exclusão por tipo de ticket e um limite de confiança são propriedades de uma integração, não de um login.
Alguém no Hacker News fez esse mesmo ponto, só que de forma mais estrutural:
"AI Session Hijacking is such a dead end and I think this will be the thing that kills it. Just register these things in the IDP and let them sign into their own accounts."
Compare qualquer opção com o Grok Bot
Antes de chegar às análises individuais, aqui está a mesma comparação reunida num só lugar. Escolha a ferramenta que você está avaliando e as respostas dela aparecem ao lado das do Grok Bot, nos quatro pontos que vale conferir.
As 8 melhores alternativas ao Grok Bot em 2026
Cada item abaixo segue a mesma forma: para quem é, o que realmente é, como responde às três perguntas, quanto custa, prós, contras e depois o meu veredito. Primeiro a tabela, para quem lê na diagonal.
| Ferramenta | Melhor para | Onde o trabalho roda | Teste a seco | Log de execução | SOC 2 | ISO 27001 | HIPAA | Plano gratuito | Preço de entrada | Unidade de cobrança |
|---|---|---|---|---|---|---|---|---|---|---|
| Grok Bot | Ferramentas só com interface e sem API | Computador compartilhado na nuvem | Não | Em breve | Não | Não | Não | Não | US$ 200/mês | Usuário + tokens semanais |
| eesel AI | Filas de suporte | Integração com o helpdesk | Simulação em tickets antigos | Activity + Reports | Em andamento | Não | Fale conosco | 100 créditos grátis | US$ 299/mês (500 créditos) | Crédito (1 por ticket ou chat) |
| Claude | Trabalho no seu próprio navegador | Seu perfil do Chrome | Não, aprovação do plano | Histórico de permissões | Sim | Sim | Não no Chrome | Não (Chrome é pago) | US$ 17/mês | Por usuário |
| ChatGPT Work | Entregáveis + conectores | Nuvem da OpenAI, local no desktop | Não, confirmação de ação | Só no nível da tarefa | Sim | Enterprise | Não publicado | Limitado no desktop | US$ 20/mês | Por usuário, créditos |
| Manus | Pesquisa e artefatos | VM isolada por tarefa | Não, confirmação de custo | Histórico de tarefas + Replay | Sim | Sim | Não | Não | US$ 20/mês | Créditos |
| Lindy | Agentes de negócio sem código | Integrações OAuth hospedadas | Test Mode | Task History | Sim | Não | Sim, BAA no Enterprise | Teste de 7 dias | US$ 29,99/usuário | Créditos, em pool |
| Zapier Agents | Maior cobertura de apps, mais de 9.000 | Infraestrutura da Zapier | Preview + Test Zap | Página Activity, execuções apagáveis | Sim, mais SOC 3 | Não | Não | Sim, 400 atividades | Grátis, depois US$ 33,33/mês | Atividade |
| n8n | Equipes que querem comprovantes | Seu servidor ou nuvem na UE | Test workflow | Aba Executions | Alinhada, SOC 3 público | Não | Não | Sim, hospedagem própria | US$ 20/mês | Execução de workflow |
| Tasklet AI | Automações baratas sempre ativas | Sandbox por thread | Não | Transcrição do thread | Sim | Não | Não | Sim | US$ 25/mês | Créditos |
1. eesel AI
Melhor para: uma equipe de suporte ou operações que quer um agente trabalhando dentro do helpdesk que já tem, testado no seu próprio histórico de tickets antes de responder a um cliente real.
Eu trabalho aqui, então leve o entusiasmo em conta, e confira os links por conta própria também. O que posso dizer é por que a forma aqui é diferente. A eesel AI não ganha um desktop e nunca faz login em nada como uma pessoa faria. Ela entra no seu helpdesk como integração pela API, com uma lista nomeada do que pode fazer: deixar uma resposta pública, deixar uma nota interna, etiquetar o ticket, atribuir a um grupo, atualizar campos. Como são ações discretas e restritas, e não cliques numa tela, elas aparecem como eventos visíveis no histórico do próprio ticket e respeitam quaisquer triggers, automações, políticas de SLA e horários comerciais já configurados no Zendesk.

As três perguntas. Teste a seco: sim, e é o recurso com que eu abriria. A simulação reproduz o agente sobre seus tickets antigos e informa a cobertura por tópico, então você vê "política de reembolso, 28%", corrige a lacuna e a vê subir para 91% antes do lançamento. Trilha de auditoria: a visão Activity filtra por aprovadas, rejeitadas e pendentes, cada linha ligada ao ticket que tocou, e o Reports detalha o uso de aprovações e rejeições por ferramenta. Escopo: o roteamento por confiança manda respostas de baixa confiança para um rascunho para um humano em vez de enviá-las, e você pode manter tipos inteiros de ticket longe da IA.
Preço. Um preço mensal fixo sem taxa por usuário. 100 créditos grátis para começar, sem cartão, depois planos a partir de US$ 299/mês por 500 créditos, em que 1 crédito é um ticket ou chat, não importa quantas mensagens haja dentro. Posts de blog custam US$ 4,00 cada. Pagar um ano adiantado dá dois meses grátis. SSO e MFA são complementos a partir de US$ 199/mês, HIPAA é fale conosco, e se os créditos acabarem você pode ativar excedente com um teto que você define.
Prós
- A simulação em tickets históricos reais é o único teste a seco desta lista que produz um número de precisão em vez de um visto verde.
- Precificada numa unidade em que líderes de suporte já pensam: 1 crédito por ticket. Acompanhamentos e passos internos dentro de um ticket não usam créditos extras.
- As ações herdam as regras já existentes do helpdesk, então nada contorna seus caminhos de escalonamento.
Contras
- O SOC 2 Type II é certificado, e um comprador que precisar do relatório pode solicitá-lo.
- HIPAA é fale conosco em vez de autoatendimento, e os planos pagos começam em US$ 299/mês.
- Não é um agente de trabalho de uso geral e não finge ser. Ele não vai fazer login numa ferramenta SaaS qualquer sem API e ficar clicando por você, que é exatamente para o que o Grok Bot serve.
Minha opinião: se o trabalho é ticket, esta é a escolha, e o que decide é a reprodução, não o preço. Se o trabalho é qualquer outra coisa que não ticket, pule para o próximo item, já que a estreiteza é todo o design aqui.
2. Claude (Anthropic)
Melhor para: trabalho de conhecimento que deve acontecer dentro das suas próprias contas, com um plano que você aprova antes de qualquer coisa se mexer.
O Claude não é de fato um único produto de agente, e isso confunde esta comparação até ser separado. O Claude in Chrome é uma extensão de navegador que lê, clica e navega em páginas em que você já está logado. Os conectores MCP deixam o Claude chamar ferramentas externas por uma API. As Agent Skills empacotam os procedimentos que ele segue. A própria frase da Anthropic na página do Chrome expressa o design com mais clareza: ele "reads the page you're signed in to, then clicks, types, and fills forms while you decide what happens next."
Essa é, basicamente, a forma oposta de raio de impacto de uma máquina compartilhada na nuvem. Uma instalação, o navegador de uma pessoa, os cookies dessa própria pessoa. E os conectores "inherit each person's permissions from the connected service", o que significa que o Claude não consegue ver nada que a conta subjacente já não pudesse ver. Escrevi sobre os dois caminhos para um helpdesk em conectar o Claude ao seu helpdesk.
As três perguntas. Teste a seco: sem simulação, mas o modelo de aprovação mais forte daqui. Três modos de permissão nomeados (Manually approve, Automatically approve, Skip all approvals) mudam por conversa, e no modo Manually approve o Claude declara um plano nomeando os sites que vai tocar e "will not deviate from the stated plan without requesting your permission first." Ações protegidas sempre exigem aprovação, e uma lista fixa é recusada de vez: compras, criação de contas, manuseio de cartões e documentos, exclusões permanentes. Trilha de auditoria: este é o ponto fraco. O registro publicado é um "histórico de permissões" por usuário dos sites que você concedeu, não um registro do que o Claude clicou. Logs de auditoria para toda a organização existem, no Enterprise. Escopo: administradores podem impor uma lista de sites permitidos, e o conselho da própria Anthropic é começar restritivo.
Preço. O Free não inclui Chrome e limita conectores personalizados a um. O Pro custa US$ 17/mês com cobrança anual ou US$ 20 mensal. O Max custa US$ 100 ou US$ 200/mês para 5x e 20x de uso. O Team custa US$ 20 por usuário ao ano com Chrome ativado por padrão; o Enterprise custa US$ 20 por usuário mais uso a preço de API, com Chrome desativado por padrão até um administrador ativar. Meu post sobre os preços do Claude Cowork cobre o pacote de agente mais amplo.
Prós
- O modelo de permissões publicado mais claro desta lista, com padrão documentado por superfície e um plano que você vê antes de o trabalho começar.
- SOC 2 Type 2 e ISO 27001 ambos publicados, mais do que a maioria dos produtos de agente consegue mostrar.
- O ponto de entrada sério mais barato, a US$ 17/mês, e o modelo por baixo é o Claude Opus 5.
Contras
- Sem log por ação voltado a administradores para o Chrome, então reconstruir uma sessão depois significa ler a conversa.
- Tudo o que está visível na página entra na conversa, e a Anthropic diz com clareza que "Claude can't filter sensitive content out of what it sees." Numa fila cheia de números de cartão, isso importa.
- Não disponível para organizações sujeitas à HIPAA, com recomendação explícita contra usá-lo em páginas reguladas.
Minha opinião: a melhor escolha de uso geral se você quer o agente vivendo no seu próprio navegador e não no data center de outra pessoa, e a que eu entregaria a um colega não técnico sem preocupação. Descarte-a, porém, se um log de auditoria importa mais do que aprovações, ou se você é regulado. Para a versão específica de suporte desse mesmo equilíbrio, veja as alternativas ao Claude para atendimento ao cliente.
3. ChatGPT Work (OpenAI)
Melhor para: equipes que já estão dentro do ChatGPT e querem tarefas longas de vários passos e documentos prontos do outro lado.
Primeiro, uma correção que vale saber antes de continuar a pesquisar: o "ChatGPT agent" não existe mais. A central de ajuda da OpenAI diz agora "ChatGPT agent is no longer available. Use ChatGPT Work for longer, multi-step tasks and finished deliverables. For supported browser workflows, see Using cloud browser in ChatGPT." Então o que você realmente compara hoje com o Grok Bot é o ChatGPT Work mais um navegador na nuvem separado, não aquele antigo modo agente de antes.
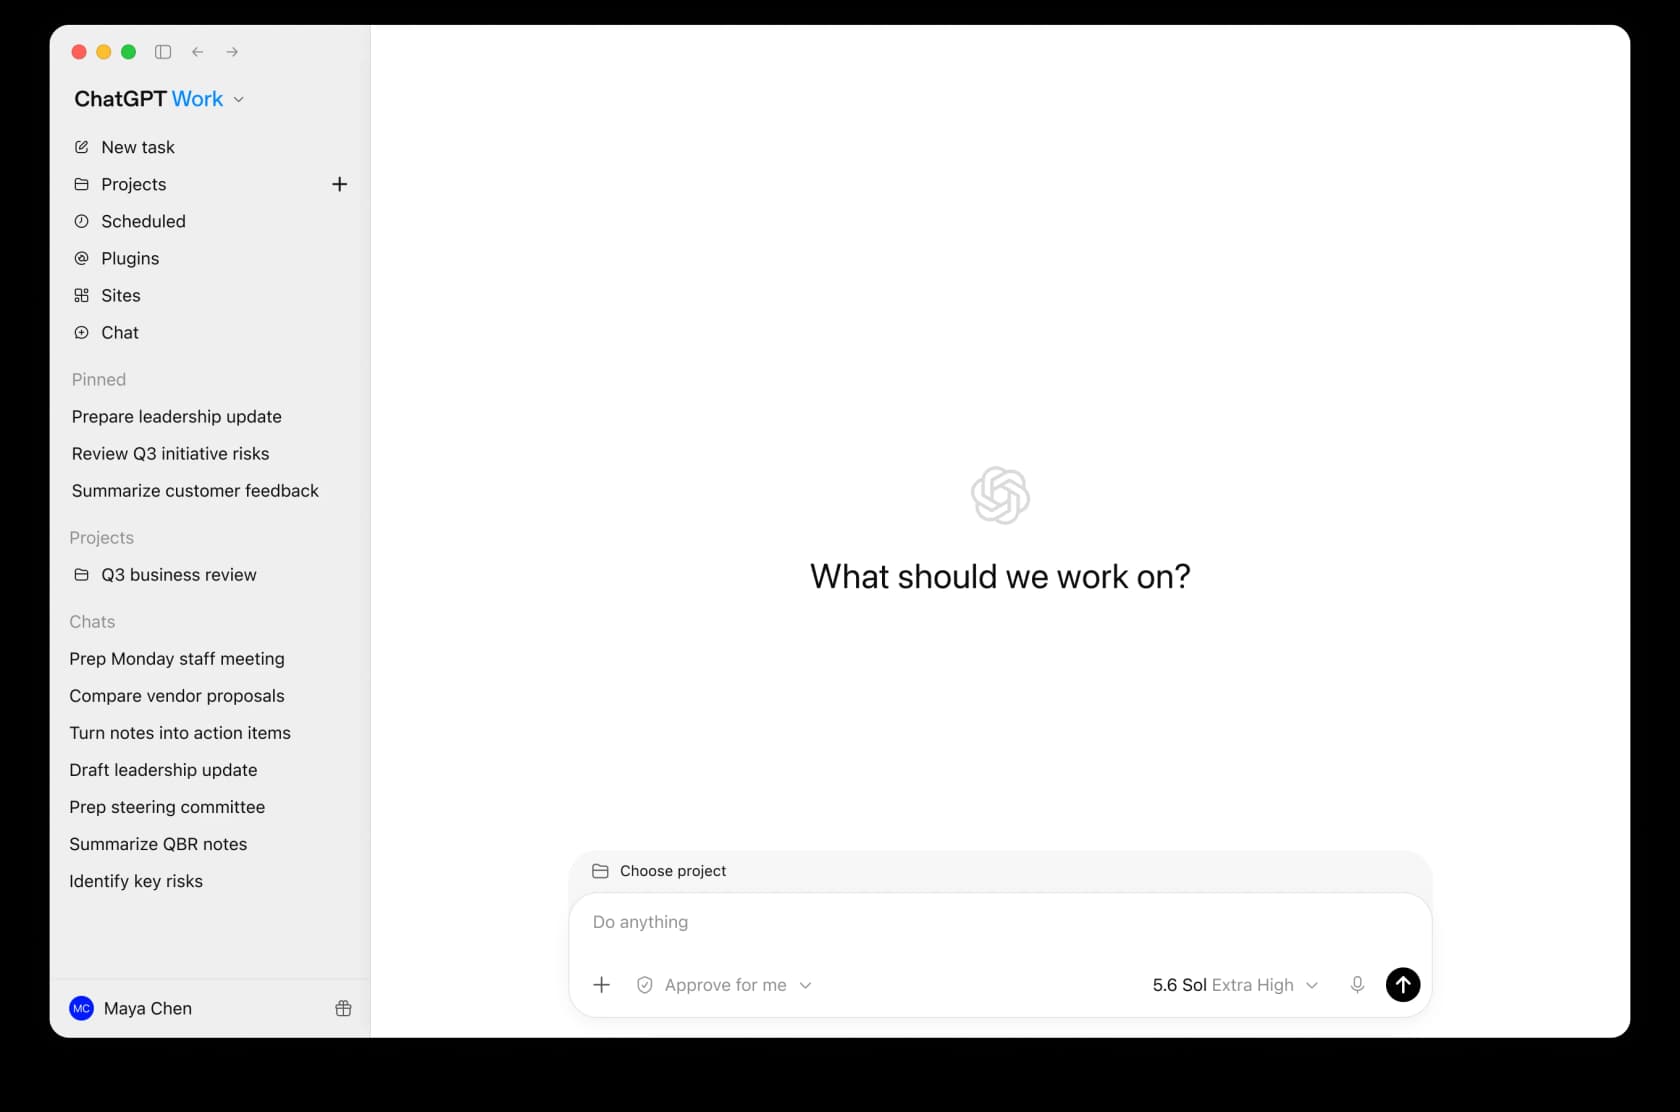
A divisão importa muito para o raio de impacto. O Work roda na nuvem na web e no celular, e no app desktop pode tocar arquivos locais e apps do desktop, com permissão. O navegador na nuvem é uma sessão remota separada, e no lançamento "does not accept credentials, use autofill or password managers, sign in to websites, or complete payments. If a site requires one of those steps, the task stops." Isso é exatamente o inverso de todo o design do Grok Bot, e dependendo do trabalho, ou é a coisa mais segura desta lista ou um impedimento total.
As três perguntas. Teste a seco: nenhum publicado. O portão é uma confirmação ao vivo em qualquer coisa que a OpenAI classifique como "important action", definida como uma que "could have a meaningful effect outside ChatGPT, expose sensitive information, or be difficult to undo", e o nível de permissão padrão é Important actions. Trilha de auditoria: fraca de um jeito específico que vale citar, porque tem a mesma forma da lacuna do Grok Bot. Para o Enterprise, "conversations involving agent tasks will appear in Compliance API logs, but individual agent actions (such as virtual computer usage, app requests, chain of thought) will not." Chamadas de conector são registradas; passos do navegador não. Escopo: contenção real no nível do workspace, com acesso de agente desligado por padrão, RBAC por papel e listas de domínios bloqueados.
Mais uma coisa sobre isolamento: os cookies "persist across sessions for convenience, just like a regular browser", então o navegador remoto não é limpo por tarefa por padrão.
Preço. O Free tem Work limitado só no desktop. O Go, a US$ 8/mês, exclui o navegador na nuvem. O Plus custa US$ 20/mês, o Pro a partir de US$ 100/mês, o Business US$ 25 por usuário mensal ou US$ 20 anual, o Enterprise sob consulta. O Work agora segue a estrutura de créditos do Codex em vez de um limite fixo de mensagens, então a OpenAI não publica mais um limite fixo de tarefas. Workspaces Enterprise precisam ter o Enterprise Key Management ligado antes de o Work rodar.
Prós
- A lista de confirmações é específica e nomeada em vez de vaga, e dispara por padrão.
- Contenção real para administradores: desligado por padrão, com RBAC e listas de domínios bloqueados.
- Sem treinamento com dados da empresa por padrão em Business, Enterprise e Edu, incluindo dados tocados durante sessões de agente.
Contras
- A Compliance API diz que uma tarefa rodou, não o que ela fez dentro do computador virtual.
- Os cookies persistem entre execuções, então uma sessão não fica restrita a uma tarefa a menos que você a limpe.
- Sem teste a seco nem reprodução histórica publicados, só um aviso em tempo real sobre a própria ação.
Minha opinião: a escolha certa se a sua empresa já padronizou no ChatGPT e o entregável é um documento. O navegador na nuvem recusar logins de cara é a decisão de design mais interessante de toda esta lista, e se você estava considerando o Grok Bot justamente porque ele faz login em algum lugar, este não é o seu substituto. Leituras relacionadas: ChatGPT com Zendesk e minha análise do ChatGPT Work.
4. Manus
Melhor para: trabalho aberto que você de outro modo entregaria a um freelancer, em que você se importa com o artefato e quer poder reproduzir como ele foi feito.
O Manus recebe uma meta em linguagem corrente, executa sozinho toda a tarefa de vários passos e depois devolve algo pronto: um relatório, um site, uma apresentação, uma extração de dados em lote. Algo que vale sinalizar e que a cobertura mais antiga erra: o Manus foi afiliado à Meta durante parte de 2026, mas, segundo o próprio aviso de 11 de agosto de 2026, "soon return to operating as an independent company." Meu post sobre o Manus AI tem mais contexto.
As três perguntas. Onde ele roda é a manchete: o Manus Sandbox é "a fully isolated cloud virtual machine that Manus allocates for each task. Each Sandbox runs in its own environment, does not affect other tasks, and can execute in parallel." Essa é a resposta arquitetural direta ao único computador compartilhado do Grok Bot. Teste a seco: sem simulação. O Wide Research mostra uma estimativa de uso e "requires confirmation before executing", o que controla custo e escopo, não correção. Trilha de auditoria: a melhor desta lista, e o recurso que eu roubaria. O histórico de tarefas registra cada ação, e um link de Replay compartilhável reproduz uma execução passo a passo. Um avaliador no LinkedIn disse bem: "one thing that I love about Manus is it's got a replay function so you can see what it did decision making wise and action wise behind the scenes."
Preço. Standard US$ 20/mês por 4.000 créditos mais 300 por dia. Customizable US$ 40/mês por 8.000. Extended US$ 200/mês por 40.000 e um Cloud Computer grátis. Team e Enterprise são via vendas. A unidade de cobrança é o crédito, e o Manus não publica uma taxa fixa do que um compra, que é a reclamação recorrente:
"Manus AI agent is super expensive. I feel like the pricing model needs some adjustment because it's really costly. They give you only 1,000 credits at a time, which is not enough, especially for heavy tasks."

Prós
- Uma VM isolada por tarefa, então uma tarefa fora de controle não consegue alcançar outra.
- Links de Replay são um artefato de auditoria real que você pode enviar a outra pessoa.
- Três certificações independentes num trust center público: SOC 2 Type II, ISO 27001:2022, ISO 27701:2019.
Contras
- Sem teste a seco com seus próprios dados, só uma confirmação de custo antes do modo em lote.
- Sem taxa publicada por crédito, então o custo real de um trabalho recorrente só se conhece depois que ele roda.
- Sem declaração de HIPAA, e transferências internacionais se apoiam em cláusulas contratuais padrão em vez de uma certificação formal de GDPR.
Minha opinião: a US$ 20/mês contra os US$ 200 do Grok Bot, com isolamento por tarefa e um replay de verdade para se apoiar, o Manus acaba sendo a troca mais parecida para um usuário individual com trabalho geral. Veja as alternativas ao Manus AI se o modelo de créditos for o seu problema.
5. Lindy
Melhor para: uma equipe pequena que quer um agente sem código ligado ao Gmail, Slack e Calendar, com aprovações ativadas por padrão.
O Lindy é basicamente um construtor: escolha um gatilho, descreva o trabalho em linguagem corrente, e o agente lê o contexto nos apps que você conectou e age com base nele. A maior parte roda por integrações OAuth hospedadas com mais de 1.000 apps, segundo ele afirma, então o raio de impacto aqui é o que foi concedido de permissões. Quando simplesmente não existe API, uma habilidade separada, o Computer Use, do Pro em diante, opera um navegador num computador hospedado pelo Lindy, com uma opção Incognito Computer que não persiste nada e um botão Take Control no meio da execução para quando as coisas dão errado.
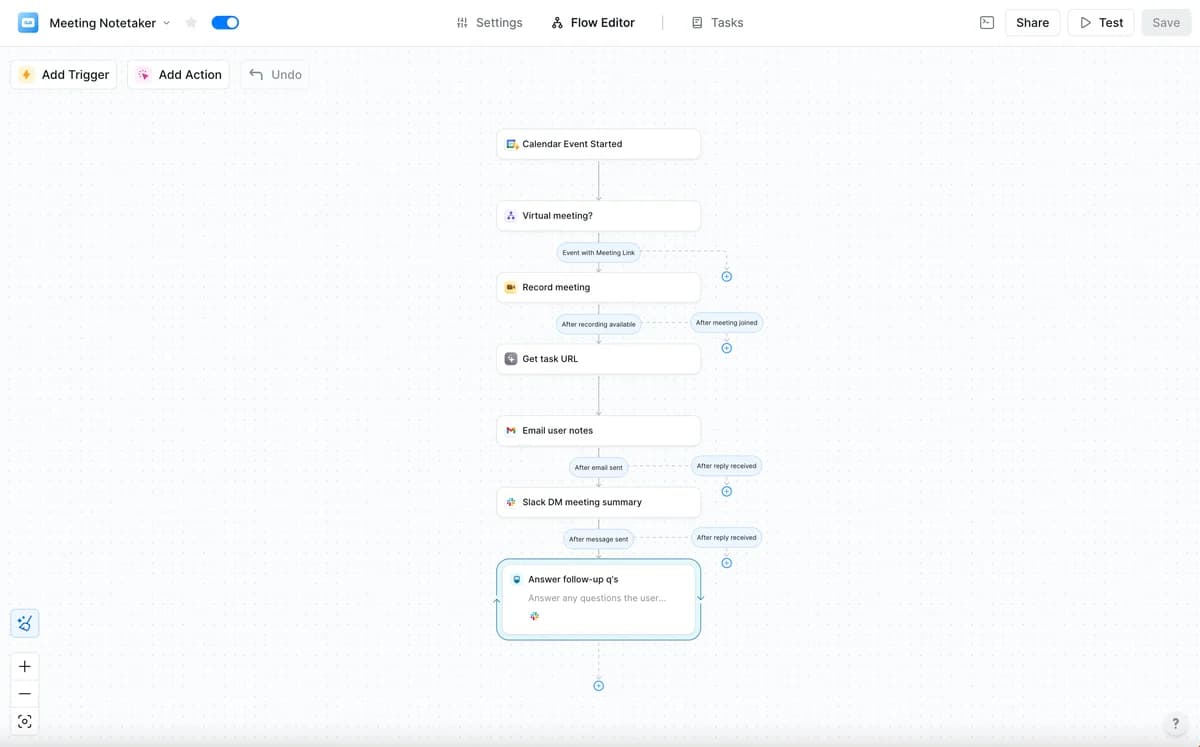
As três perguntas. Teste a seco: sim, um Test Mode nomeado. Você clica em Test no editor de fluxos, roda o workflow, e o Lindy mostra onde e por que ele travou, com um atalho para o passo que falhou. Trilha de auditoria: Task History por agente, que abre bloco a bloco, mais uma ação Get Task Details que devolve entradas, saídas, carimbos de data e hora e status de cada bloco. A documentação lista "generate detailed audit logs" como caso de uso, que é o enquadramento honesto: você tem as peças, o recurso de log de auditoria de nível de conformidade é do Enterprise. Escopo: qualquer ação com impacto externo (enviar um e-mail, atualizar um ticket, postar num canal, publicar um documento) espera aprovação humana por padrão; consultas só de leitura, não.
Preço. Reprecificado desde a última vez que olhei, e agora por usuário. Plus US$ 29,99 por usuário por 3.000 créditos, Pro US$ 99,99 por 15.000, Max US$ 199,99 por 35.000, Enterprise sob consulta. Os créditos ficam num pool no workspace, reiniciam todo mês e não acumulam; quando o pool esvazia o Lindy pausa em vez de cobrar excedente. Teste de 7 dias. Note que operar o navegador exige o nível de US$ 99,99.
Prós
- Portões de aprovação já vêm ativados por padrão, em vez de algo que você precisa lembrar de configurar.
- A observabilidade no nível de bloco é boa o bastante para construir por cima a sua própria pontuação de qualidade.
- Sinal forte de facilidade de uso: 4,9/5 em 171 avaliações no G2, com facilidade de uso como o pró mais marcado, em 125 menções.
Contras
- O preço por créditos é a principal reclamação no G2, marcado como Expensive 42 vezes, e os avaliadores descrevem não saber quanto uma tarefa vai custar antes de rodá-la.
- O Computer Use é restrito ao nível de US$ 99,99, então tarefas sem API precisam do segundo plano acima.
- Logs de auditoria formais e SSO são só do Enterprise.
Vale registrar uma pequena alfinetada de um avaliador exatamente na superfície de que este post trata:
"'Testing' side tab reloads on changes, back log available but non-intuitively under 'tasks' at top"

Minha opinião: a melhor resposta aqui se você quer a sensação de "time de colegas" do Grok Bot, mas com aprovações e um log de execução já no lugar, e pagar por usuário não incomoda. Veja o Lindy AI para um olhar mais longo, ou construtor de agentes sem código se for a categoria que você está comparando.
6. Zapier Agents
Melhor para: a maior cobertura de apps desta lista, e a forma mais segura de começar porque a automação continua sendo um fluxo que você consegue ler.
Os Zapier Agents são descritos em linguagem natural, conectam-se aos seus dados ao vivo e agem num horário, sob demanda ou a partir de um gatilho, o que for mais adequado. Eles usam exatamente as mesmas conexões OAuth que seus Zaps já usam, então a Zapier guarda a credencial uma vez por app e o agente chama os gatilhos e ações já existentes daquele app em vez de clicar numa interface. O grafo de conectores é o verdadeiro argumento de venda aqui: mais de 9.000 apps.
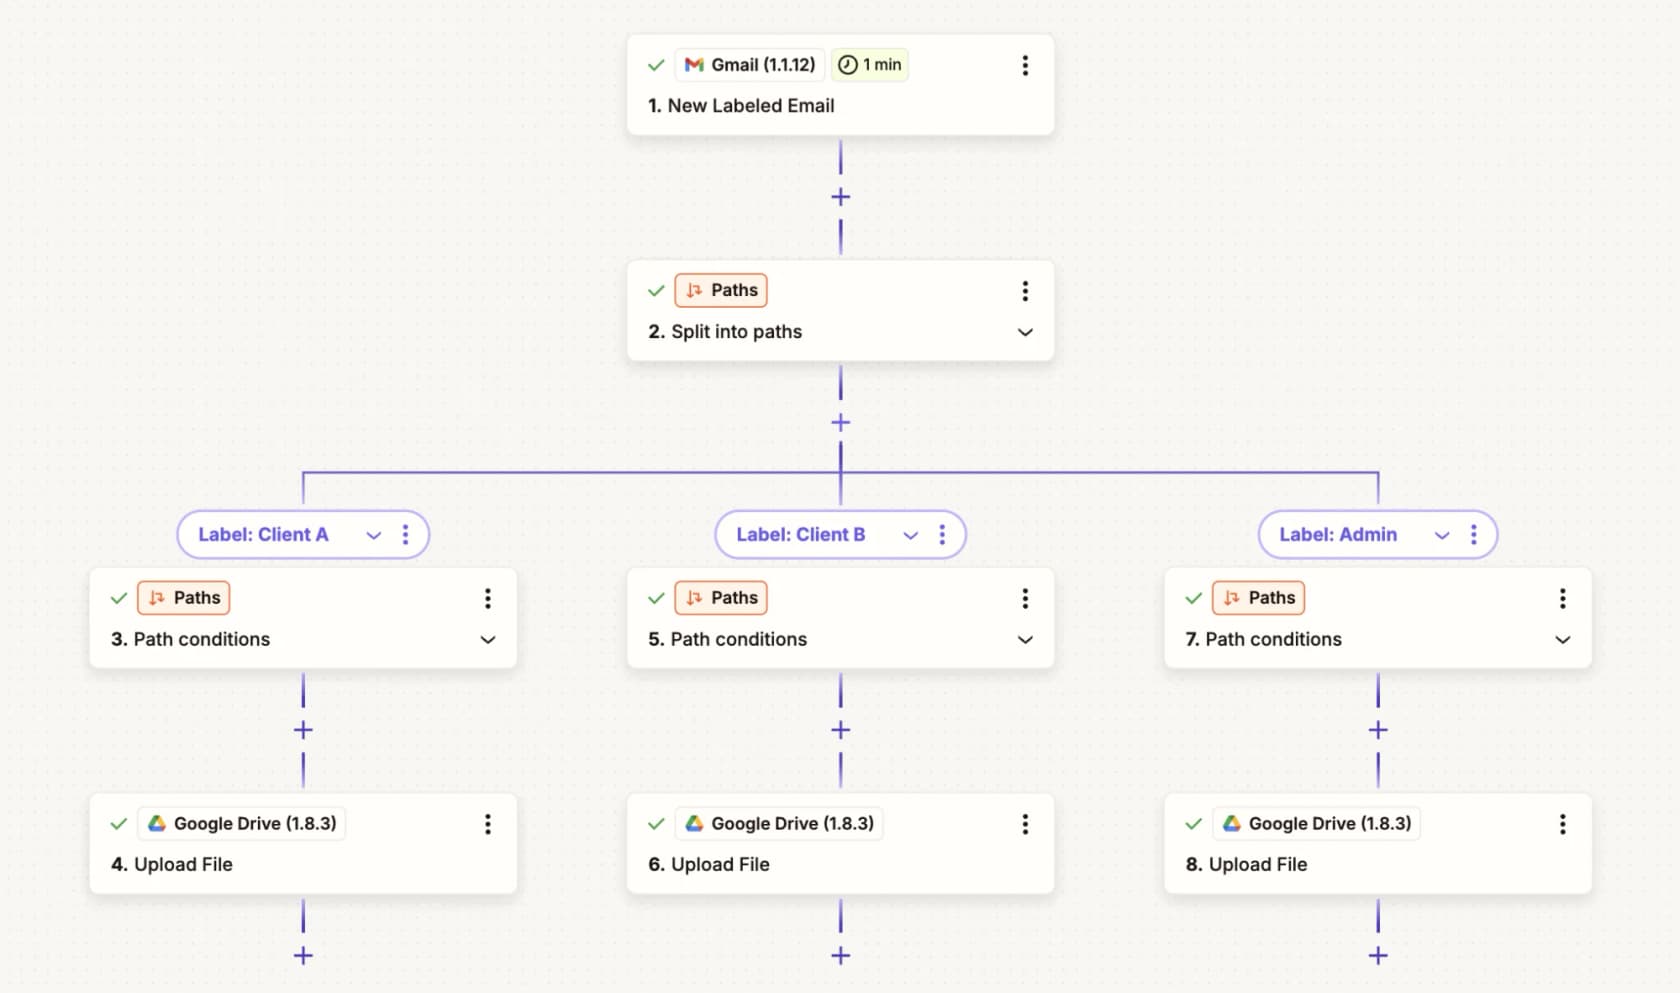
Compre de olhos abertos numa coisa, porém: o produto Agents independente está sendo incorporado ao "AI by Zapier", um passo dentro do editor de Zaps normal, e contas de teste Enterprise tiveram de migrar até 15 de agosto de 2026 ou passar para uma conta gratuita de Agents. Então as superfícies abaixo estão se movendo debaixo de você.
As três perguntas. Teste a seco: sim, e ele sobrevive à migração. No construtor antigo, "until you publish, your agent only runs during testing." No fluxo novo são dois passos: Preview para rodar só o passo de IA com dados de exemplo e ver quais ferramentas ele chamaria, depois Test Zap para o workflow inteiro. A ressalva é da própria Zapier: "Full-Zap tests currently consume tasks the same way production runs do. Zapier is working on a fix for this." Trilha de auditoria: o produto independente tem uma página Activity com status da execução, apps usados e carimbos de data e hora. Não é à prova de adulteração, porque qualquer usuário com acesso pode apagar uma execução específica e apagar um agente apaga o histórico dele. Após a migração cada execução vai para o histórico normal de Zaps, onde você pode "review which tools were called, what data was passed, which model tier was used, and how many tasks it consumed", uma melhoria real. Escopo: o que foi concedido à conexão OAuth, mais um controle de apps restritos no Enterprise.
Preço. Foi aqui que a versão anterior das minhas próprias notas estava errada, então vale dizer com cuidado. O Agents cobra num medidor de atividade separado, não no pool compartilhado de tarefas do Zap. Uma atividade são "actions your agent takes in behaviors or in chat, browsing the web, or looking up information from attached knowledge." O Agents Free custa US$ 0 para sempre com 400 atividades por mês. O Agents Pro custa US$ 33,33/mês com cobrança anual (US$ 400 adiantados) por 1.500. O Enterprise é sob consulta e acrescenta compartilhamento em toda a organização e logs de auditoria Enterprise. Quando um agente vira um passo do AI by Zapier, passa a ser cobrado por tarefa como todo o resto.
Prós
- Mais de 9.000 apps, mais alcance que qualquer outra coisa aqui sem um navegador.
- As ações rodam por conexões OAuth gerenciadas na infraestrutura da Zapier, em vez de uma frágil camada de interface.
- Um passo de teste real antes de publicar, tanto no construtor antigo quanto no novo, então nada vai direto para produção.
Contras
- O log de atividade pode ser apagado por execução e some com o agente, então é um registro de depuração, não de auditoria.
- O produto está em meio a uma descontinuação rumo ao AI by Zapier, o que significa reaprender a superfície em um ou dois lançamentos.
- Execuções de teste no fluxo novo consomem cota real de tarefas, então testar não é grátis nem livre de efeitos colaterais.
O enquadramento beta mais o preço anual irritou pelo menos um comprador:
"Zapier agents dont seem ready for prime time... They label Agents as a beta feature, so I don't expect it to be perfect, but they still charged me $400 for it."
Minha opinião: um primeiro passo sensato se você já tem Zaps rodando, porque um agente que na verdade é um workflow é um que você pode ler, comparar e desligar quando quiser. Eu esperaria a migração para o AI by Zapier assentar antes de construir algo crítico em cima, e não contaria aquela página Activity como trilha de auditoria enquanto qualquer colega puder apagar uma execução à vontade. Vale ler junto com AgentKit vs Zapier se a camada de cola for o que você está avaliando.
7. n8n
Melhor para: uma equipe técnica que quer ser dona da infraestrutura e ver exatamente o que cada chamada de ferramenta fez, aceitando que você constrói o ambiente de testes por conta própria.
O n8n é uma plataforma de workflows de código disponível (source-available), tela visual, e você pode colocar JavaScript ou Python de verdade direto nela. Seu nó AI Agent é basicamente um Tools Agent no estilo LangChain que você mesmo liga: modelo de chat, ferramentas, memória, um armazenamento vetorial se quiser. É mais trabalho que um agente pronto, claro, mas esse é justamente o ponto.
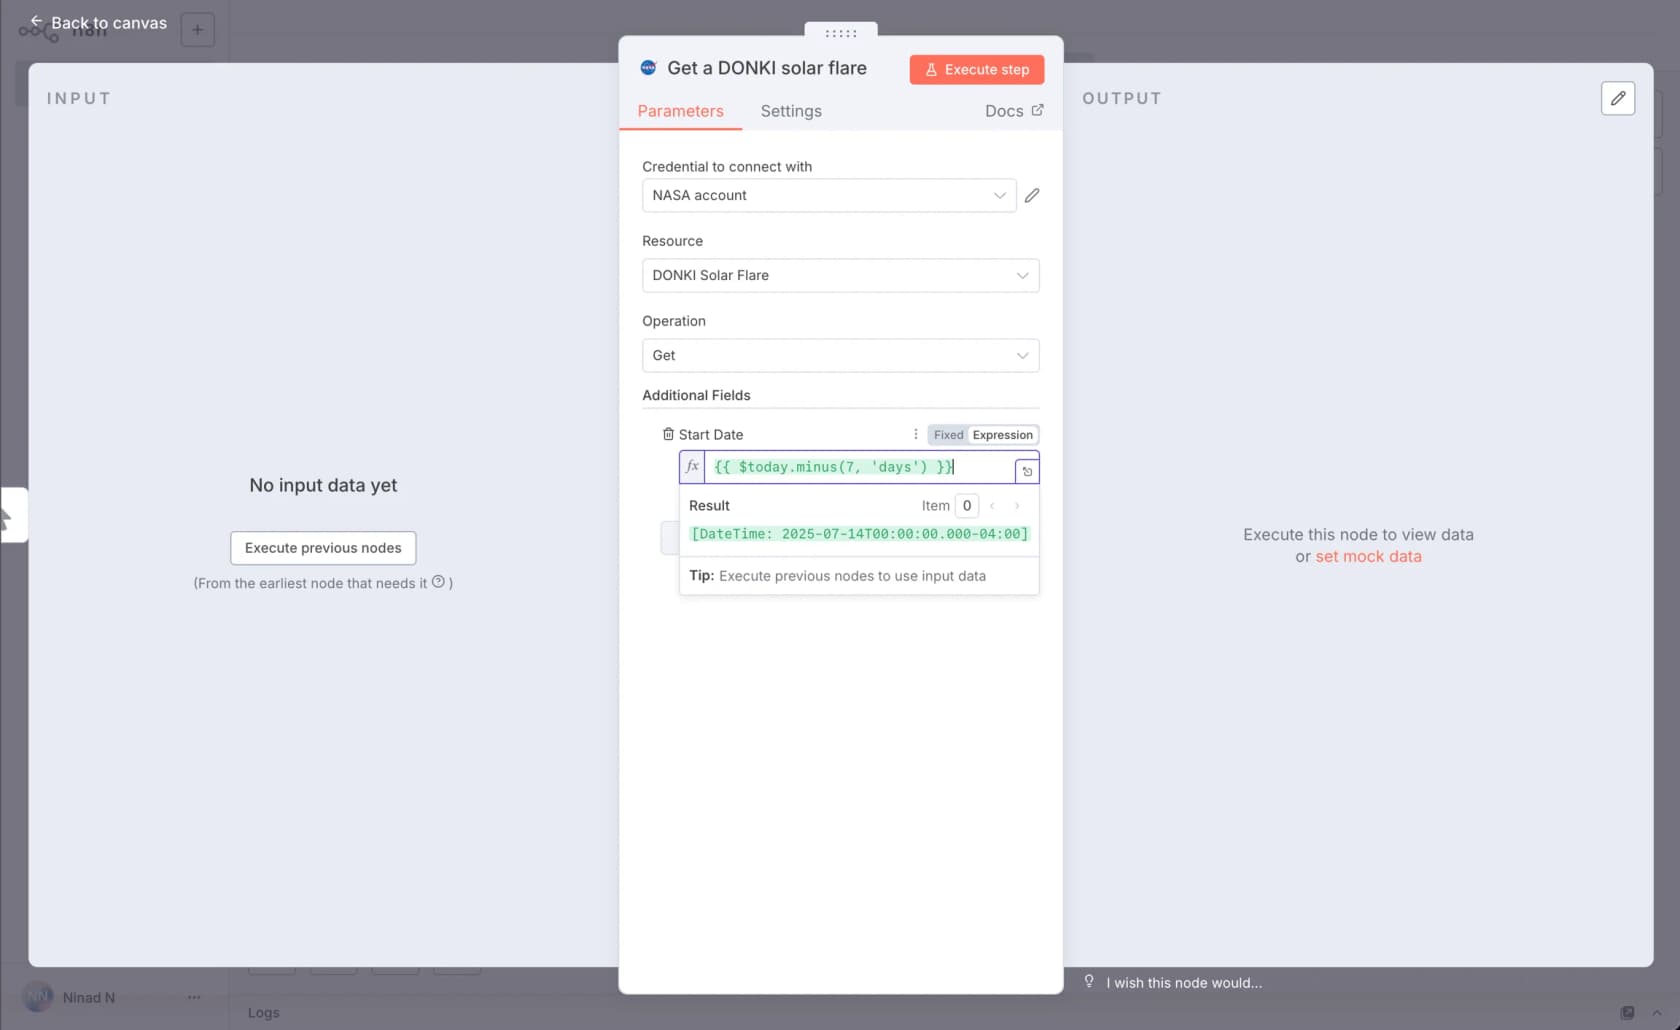
As três perguntas. Onde ele roda é você quem decide: hospedar por conta própria via Docker ou npm sob a Sustainable Use License, que é fair-code e não código aberto pela OSI, ou usar o n8n Cloud no Azure, na UE. Teste a seco: Test workflow na tela e Execute step num nó, e execuções manuais não contam na sua cota. Seja realista, porém: uma execução manual ainda chama APIs reais com credenciais reais, a menos que você simule os dados por nó, então é uma execução de verdade e não uma sandbox. Trilha de auditoria: os melhores comprovantes daqui. Cada execução é uma execution na aba Executions, com status, tempos e a entrada e saída exatas de cada nó. Retenção: 7 dias no Starter, 30 no Pro, ilimitada no Enterprise, e o Enterprise acrescenta streaming de logs para um SIEM.
Preço. O Community Edition é gratuito para sempre se hospedado por conta própria. Starter US$ 20/mês por 2.500 execuções, Pro US$ 50/mês por 10.000, Business US$ 800/mês por 40.000, Enterprise sob consulta, tudo cobrado anualmente. A unidade é dita com clareza: "An execution is a single run of your entire workflow. It doesn't matter how many steps are in the workflow or how much data it processes, it's still a single execution." Usuários são ilimitados em todos os planos.
Prós
- Entrada e saída por nó em cada execução, que é a diferença entre "o agente fez algo" e um rastro depurável.
- Hospedagem própria completa, então dados sensíveis nunca saem da sua infraestrutura. Um avaliador do G2 reconheceu exatamente isso: "allowed our team to automate sensitive customer data workflows without sending that data to a third-party cloud."
- A cobrança por execução significa que um workflow de IA de 200 passos custa o mesmo que um de dois passos.
Contras
- Workflows e credenciais do Community Edition têm um único dono, então uma equipe não ganha visibilidade compartilhada sem pagar.
- Sem reprodução histórica para agentes de IA. Testar um significa montar você mesmo um conjunto de dados de avaliação numa tabela de dados ou no Google Sheets.
- A cobrança por execução pesa em padrões de chat e de polling, em que cada interação é uma execução própria:
"Zapier → Make → n8n is the classic pilgrimage. If something keeps breaking, it's usually just one trigger that isn't set the way you think. Check the execution logs- 99% of the time the answer is hiding there."
Minha opinião: se o seu motivo para deixar o Grok Bot é não conseguir provar o que ele fez, o n8n é a resposta, e o preço dessa resposta é tempo de engenharia, simples assim. Existe um caminho real pela integração do Zendesk com o n8n se o plano é ligar uma fila por conta própria, e AgentKit vs n8n cobre também a comparação da camada de cola.
8. Tasklet AI
Melhor para: automações baratas sempre ativas em ferramentas comuns, quando preço e amplitude importam mais que burocracia.
O Tasklet, criado pelos cofundadores do Firebase, transforma uma frase em linguagem corrente numa automação recorrente em vez de apenas uma resposta pontual. Cada agente ganha sua própria sandbox isolada no Google Cloud e dispara por horário, evento de app ou webhook, então continua rodando muito depois de você fechar o notebook. O alcance vem de duas formas: chamadas diretas de API e MCP contra mais de 3.000 integrações, segundo ele afirma, mais um navegador Computer use em sandbox que clica por interfaces web enquanto mantém um perfil de login por thread.
As três perguntas. Teste a seco: nada estruturado. Testar significa perguntar no thread ou abrir o painel de detalhes da automação pelo ícone de raio. Trilha de auditoria: também sem log nomeado; a transcrição do thread é o registro, e a página de confiança descreve controles de acesso internos do Tasklet, não um log de ações voltado ao cliente. Escopo: o detalhe mais bacana aqui é que o compartilhamento separa o acesso das credenciais, então um colega pode usar uma conexão compartilhada de Stripe ou de CRM sem nunca ver a chave.
Preço. O Free é de verdade: sem cartão, 300 créditos bônus por dia, agentes e integrações ilimitados, com limite de 10 execuções por automação. Starter US$ 25/mês por 10.000 créditos, Pro US$ 100/mês por 40.000, Custom a partir de US$ 250/mês por 100.000 e um controle deslizante até 4.000.000. Não há taxa publicada por crédito nem política de excedente declarada.
Prós
- Um plano gratuito de verdade sem cartão, algo que nada mais na metade de cima desta lista oferece.
- Alcance muito amplo: mais de 3.000 integrações embutidas mais qualquer API HTTP ou servidor MCP, inclusive internos privados.
- Conexões compartilhadas deixam colegas usarem um login sem ver a credencial.
Contras
- Sem taxa em dólar por crédito ou por tarefa e sem política de excedente, então o custo real de uma automação recorrente é impossível de saber até ela rodar.
- Sem teste a seco estruturado nem log de execução nomeado, a mesma lacuna que torna o Grok Bot difícil de colocar no ar.
- SOC 2 é a única certificação atestada. GDPR consta como em andamento, e não há ISO 27001, HIPAA ou opção de residência.
Pelo menos um operador identificado está satisfeito:
"If AI agents have seemed theoretical or inaccessible to you, you should definitely try Tasklet. I've been using Tasklet for a few weeks now and it has already been transformative to my day-to-day life. [...] I now have 20+ agents running. [...] I've wanted this for years. [...] Incredible product."

Minha opinião: a forma mais barata de descobrir se um agente sempre ativo ajuda, e eu testaria uma ideia nele com gosto. Eu não o colocaria, porém, em nada voltado ao cliente até a parte de auditoria alcançar o número de integrações.
O que eu realmente escolheria
Se uma frase basta: escolha pelo controle de que você não consegue abrir mão, não por qual agente faz a melhor demo.
- O trabalho é a sua fila de suporte. eesel AI, porque é a única que reproduz os seus próprios tickets e dá um número primeiro. Um plano a partir de US$ 299/mês supera US$ 200 por usuário assim que você tem alguns usuários, e a comparação de custo de IA versus humano é a outra metade dessa conta.
- Você precisa dos comprovantes acima de tudo. n8n se você tem engenheiros, Manus se não. Executions com dados por nó, ou um link de Replay que você possa enviar a alguém.
- Você quer trabalho geral nas suas próprias contas. Claude in Chrome, a US$ 17/mês, com um plano que você aprova antes de ele se mexer.
- Você padronizou no ChatGPT. ChatGPT Work, e saiba que o navegador na nuvem dele não faz login em nada.
- Você quer colegas com aprovações já ligadas. Lindy, se o preço por usuário funciona para você.
- Você já roda Zaps. Zapier Agents, porque um agente que na verdade é um workflow legível é um que você pode desligar. Espere antes a migração para o AI by Zapier assentar.
- Você está testando se isso ajuda. O plano gratuito do Tasklet, ou n8n hospedado por conta própria.
- A ferramenta que você precisa automatizar não tem API e nunca terá. Então o Grok Bot continua sendo a resposta, e o conselho honesto é dar a ele contas próprias em vez das suas, manter a execução no computador local como nunca permitida e tratar o computador compartilhado como uma única fronteira de segurança em vez de várias. É também o que a documentação manda você fazer.
O que eu não faria é comprar qualquer uma destas só porque parece o futuro. A diferença entre um agente de IA e um chatbot não é inteligência, é quem carrega a culpa quando algo dá errado. Escolha a que deixa você responder a essa pergunta em voz alta, sem hesitar.
Experimente a eesel na sua fila de suporte
Se você chegou aqui porque o prompt de exemplo do Grok Bot falava em atender uma fila do Zendesk, e o que você queria de fato era a versão que um líder de suporte consegue assinar sem pestanejar, essa é a eesel AI. Ela entra no Zendesk, no Freshdesk, no Gorgias ou no Front pela integração, não por um login de navegador, aprende com seus tickets antigos e sua central de ajuda, e depois responde só os tickets de que está realmente confiante.
A parte que eu testaria primeiro é a reprodução, sinceramente. Aponte para o mês passado, veja a cobertura por tópico, feche as lacunas que aparecerem e lance quando o número for um que você defenderia numa reunião sem suar. Cada ação tomada depois aparece em Activity como aprovada, rejeitada ou pendente, com o uso de aprovações detalhado por ferramenta, de modo que "o que a IA fez na terça" tem de fato uma resposta esperando por você.

Ela começa com 100 créditos grátis e sem cartão, então rodar a simulação não custa nada. Experimente a eesel.