As 8 melhores alternativas ao MAI-Transcribe-2 em 2026

Kira

Katelin Teen
Última edição September 8, 2026
O MAI-Transcribe-2 é o novo modelo de fala para texto da Microsoft AI, e é excelente: uma taxa média de erro por palavra de 5,2 % em 60 idiomas e um preço de lançamento de 0,10 $ por hora. Se encaixa na sua stack, é uma das opções mais fortes que existem. Mas esse preço é uma promoção, é uma pré-visualização apenas em lotes, sem SLA, e vive dentro do Azure, por isso muitas equipas vão querer outra escolha.
Aqui estão as oito melhores alternativas e a razão numa linha para escolher cada uma:
- Google Gemini 3.5 Transcribe - a precisão mais próxima, e a escolha óbvia se já está no Google.
- ElevenLabs Scribe v2 - o melhor para media e dobragem, com identificação de 32 falantes e etiquetagem de eventos de áudio.
- Deepgram - a escolha para agentes de voz em tempo real e streaming telefónico.
- AssemblyAI - transcrição mais uma camada integrada de resumos, sentimento e ocultação de dados sensíveis.
- OpenAI GPT-Transcribe - o mais fácil de acoplar a um pipeline OpenAI existente.
- Speechmatics - a maior cobertura de idiomas e implementação local verdadeira.
- Amazon Transcribe - a escolha por defeito se os seus dados já estão na AWS.
- OpenAI Whisper - o modelo gratuito e de código aberto que hospeda por conta própria.
Uma coisa que vale a pena dizer logo, porque construo agentes de IA na eesel e isso molda a forma como leio toda esta categoria: uma transcrição precisa não é aquilo que alguém realmente queria. É a matéria-prima. Qualquer que seja o modelo escolhido, alguém ainda tem de ler o texto, encontrar a resposta e resolver o ticket, e isso é um trabalho diferente da transcrição.
Por que olhar além do MAI-Transcribe-2
Sejamos primeiro justos com o incumbente, porque ele merece. O MAI-Transcribe-2 está no topo da comparação de precisão FLEURS da Microsoft, transcreve uma hora de áudio em cerca de dez segundos e, a 0,10 $ por hora, fica abaixo de todos. Quando li os primeiros comentários de programadores, as reações eram daquelas que não se conseguem fingir. Um programador independente submeteu-lhe um clipe difícil do mundo real:
"Experimentei passar uma homilia em eslovaco com muito eco... Saiu-se muito melhor do que a ElevenLabs, a 45 % do preço."
Áudio ruidoso, com eco e que não está em inglês é exatamente o que derruba os modelos mais fracos, por isso é um sinal real. Então, porquê olhar para outro lado? Por três razões concretas, nenhuma delas uma crítica ao modelo em si.
Primeiro, o preço é um alvo móvel. Esses 0,10 $ são uma promoção de lançamento que decorre "até ao fim do ano", e a Microsoft não disse o que acontece depois. Como referência, o anterior MAI-Transcribe-1.5 continua listado a 0,36 $ por hora, por isso uma tarifa padrão da v2 nessa faixa não surpreenderia ninguém. Um comentador do Hacker News fez exatamente a pergunta que a Microsoft deixou em aberto:
"dá para usar isto em streaming ou só em lotes? dizem o preço depois de acabar o desconto de lançamento (até ao fim do ano)?"

Segundo, é uma pré-visualização pública lançada sem SLA, que a Microsoft assinala como não destinada a produção, e a API principal só funciona em lotes, com um limite de ficheiro de 300 MB. O áudio ao vivo exige uma configuração separada do Voice Live. Terceiro, é um modelo do Azure, por isso acede-se através do Azure Speech, de um playground para programadores ou de routers de terceiros, não de uma aplicação autónoma. Se está a construir noutro lado, essa gravidade do ecossistema é um custo real.
Nada disto faz do MAI-Transcribe-2 uma má escolha. Significa apenas que "o mais barato e preciso hoje" não é o mesmo que "o ideal para o seu projeto", e é nessa lacuna que vivem estas alternativas.
Como as comparei
Passei muito tempo dentro destas APIs, a ler a documentação, as páginas de preços e as listas de parâmetros, por isso escolhi as dimensões que realmente mudam a sua arquitetura, não os pontos de marketing. Cinco coisas importam:
- Precisão, medida como taxa de erro por palavra (WER, a percentagem de palavras que o modelo erra). Quanto menor, melhor.
- Preço por hora de áudio, normalizado para comparar em pé de igualdade.
- Lotes vs. tempo real, porque um modelo apenas em lotes não pode alimentar um agente telefónico ao vivo, por mais preciso que seja.
- Identificação de falantes e carimbos de tempo, as etiquetas de falante e a marcação palavra a palavra que transformam uma parede de texto em algo utilizável.
- Implementação, ou seja, se pode executá-lo no seu próprio hardware ou tem de enviar o áudio para a cloud do fornecedor.
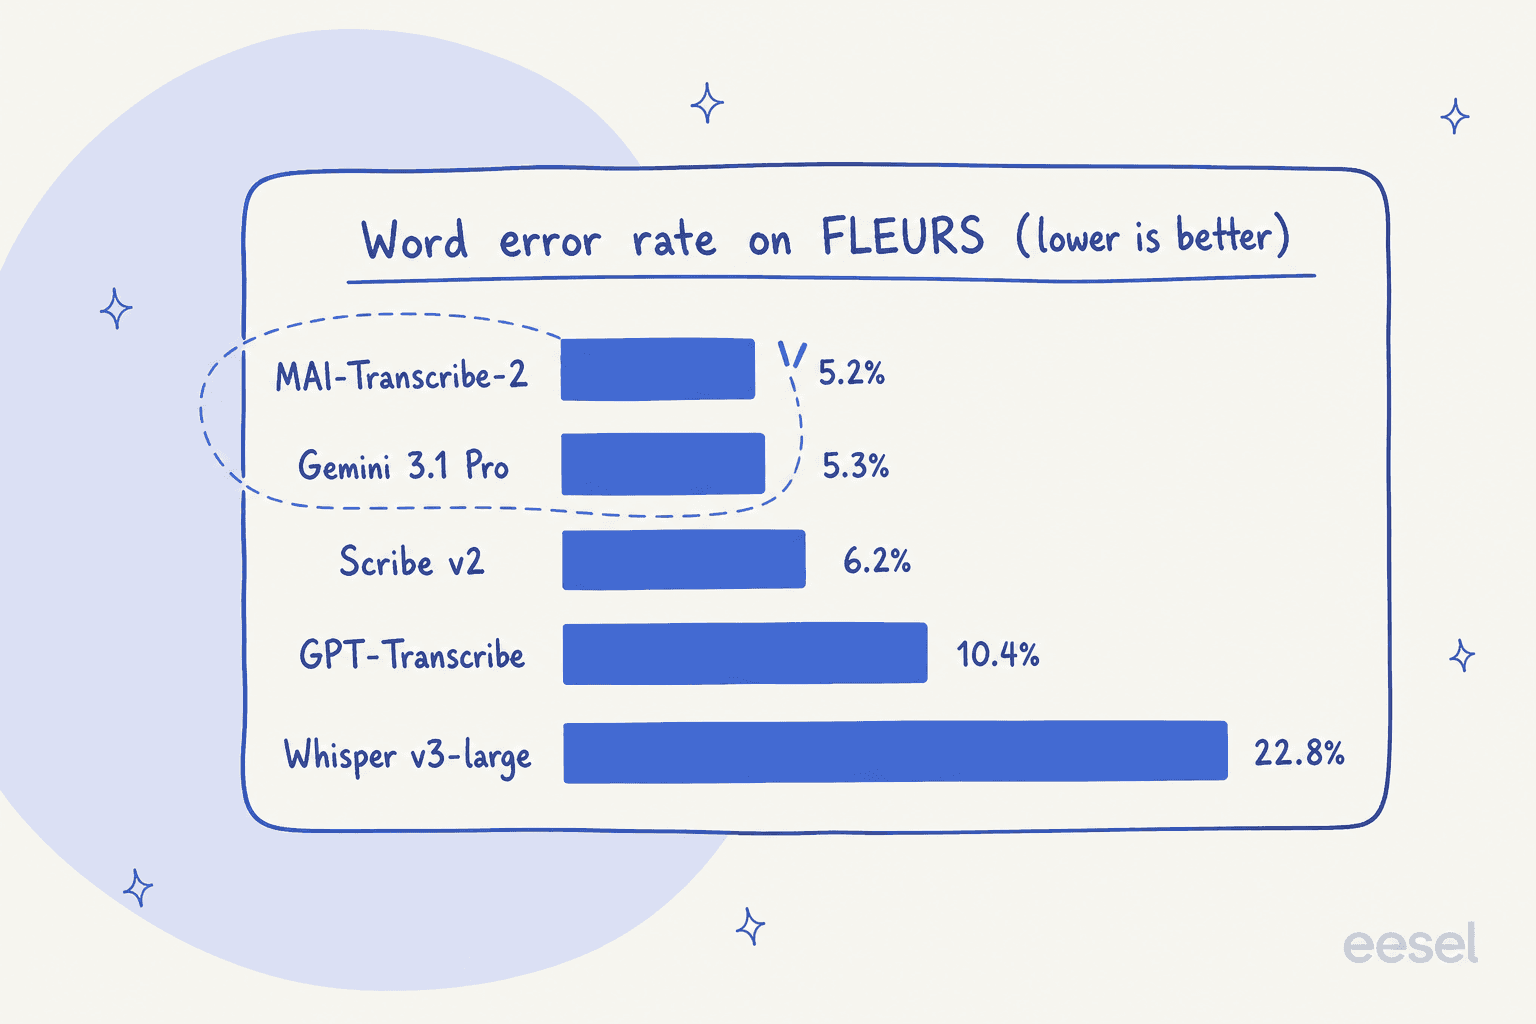
Em precisão pura, é aqui que o campo fica na comparação FLEURS da própria Microsoft. Vale a pena interiorizar uma coisa deste gráfico: o topo é um quase empate, e a verdadeira diferença está entre os líderes e o Whisper aberto, mais antigo.
As melhores alternativas ao MAI-Transcribe-2 num relance
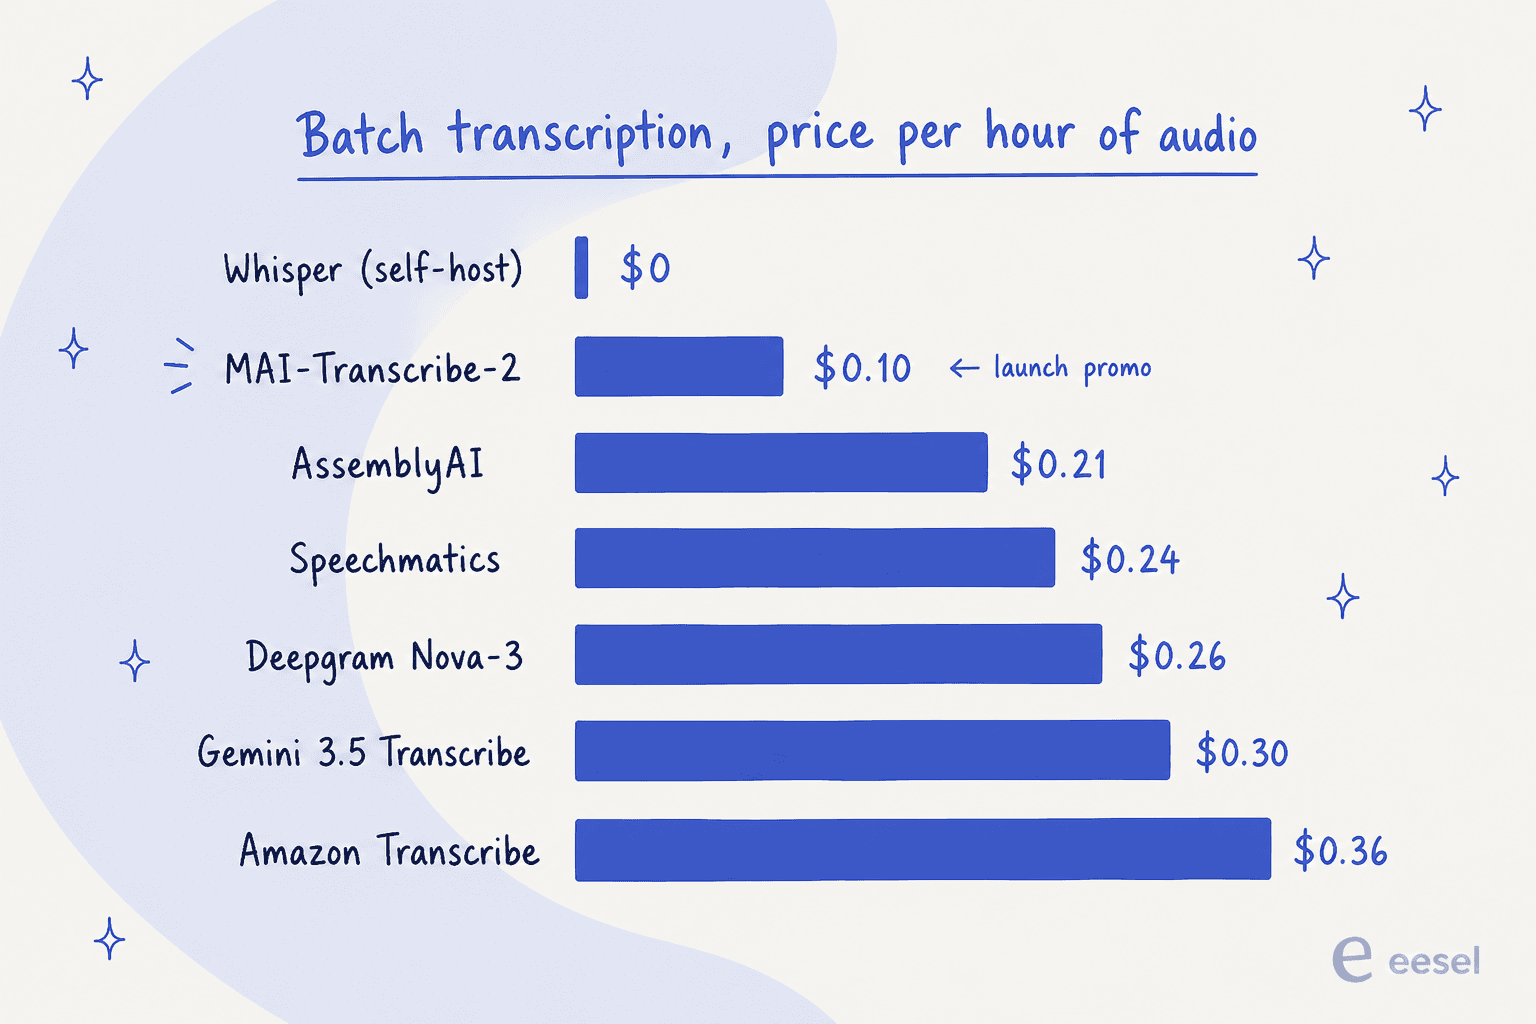
Antes das análises detalhadas, aqui está todo o campo numa tabela. Os preços são por hora de áudio para transcrição padrão em lotes, convertidos a partir da tarifa por minuto ou por token publicada por cada fornecedor.
| Modelo | Melhor para | Preço em lotes/h | Streaming em tempo real | Idiomas | Identificação de falantes | Auto-hospedagem | Plano gratuito |
|---|---|---|---|---|---|---|---|
| MAI-Transcribe-2 | Lotes multilingues mais baratos | 0,10 $ (promo) | Só via Voice Live | 60+ | Sim | Não | Não |
| Gemini 3.5 Transcribe | Precisão mais próxima | ~0,30 $ | Sim (modelo live) | 85+ | Até 8 | Não | Sim |
| ElevenLabs Scribe v2 | Media e dobragem | 0,22 $ | Sim (realtime) | 90+ | Até 32 | Não | 10.000 créditos/mês |
| Deepgram | Agentes de voz em tempo real | 0,26 $ | Sim (ponto forte) | 40+ | Sim | Sim (Enterprise) | 200 $ de crédito |
| AssemblyAI | Inteligência de áudio | 0,21 $ | Sim | 99+ | Sim | Não | 185 h |
| OpenAI GPT-Transcribe | Pipelines nativos OpenAI | 0,27 $ | Saída em streaming | 99+ | Modelo separado | Não | Não |
| Speechmatics | Amplitude de idiomas, local | 0,24 $ | Sim (<1 s) | 55+ | Sim | Sim (Enterprise) | 100 $ de crédito |
| Amazon Transcribe | Equipas já na AWS | 0,36 $ | Sim | 100+ | Sim | Não | 60 min/mês (12 meses) |
| Whisper (código aberto) | Custo de API zero | 0 $ (auto-hospedado) | Não (lotes) | 99+ | Complemento | Sim | Gratuito |
Os preços pagos em lotes concentram-se muito mais do que a maioria das pessoas espera. Quando a promoção do MAI-Transcribe-2 terminar, todo o campo fica a poucos cêntimos de distância.
1. Google Gemini 3.5 Transcribe
Melhor para: equipas que querem a precisão mais próxima do MAI-Transcribe-2 e já constroem sobre o Google.
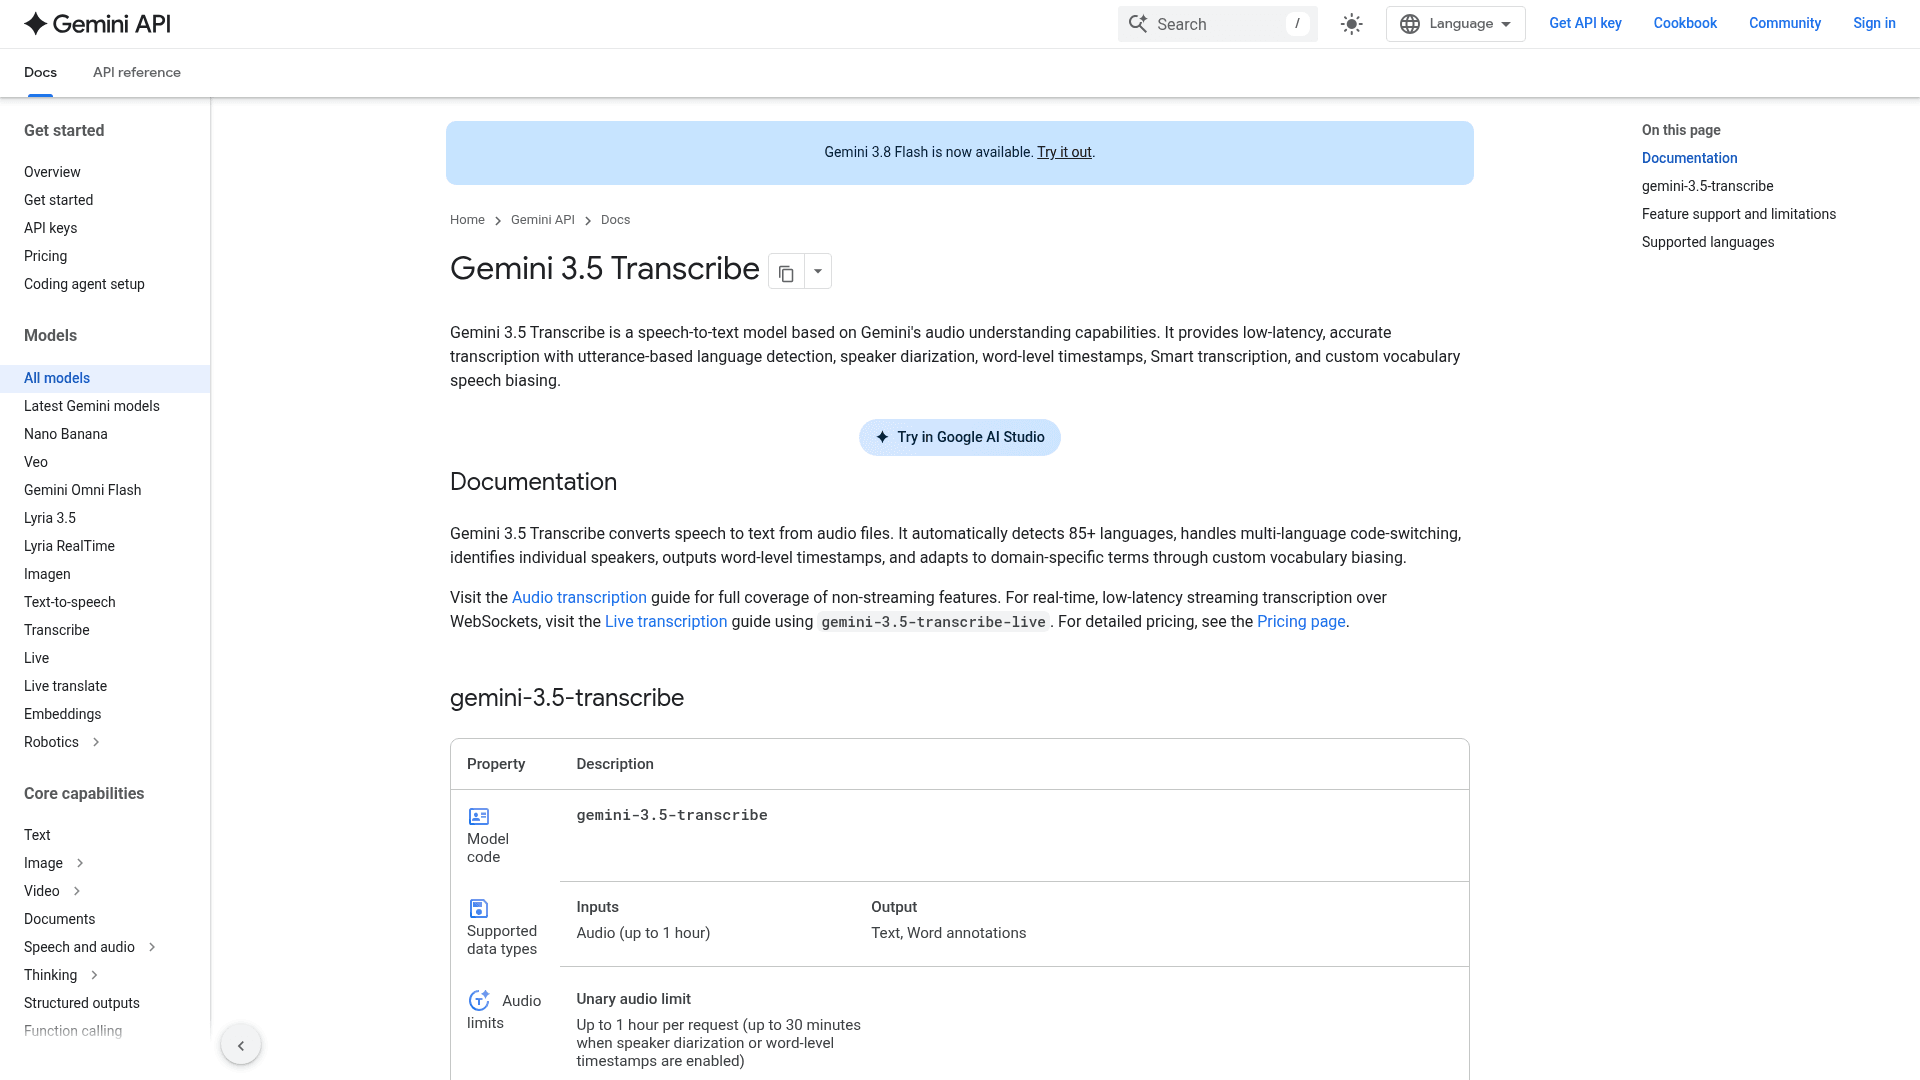
A Google é a alternativa que iguala o MAI-Transcribe-2 frente a frente. Na própria tabela FLEURS da Microsoft, o Gemini 3.1 Pro regista 5,3 %, uma décima atrás, e a Google também disponibiliza um modelo de fala para texto dedicado, gemini-3.5-transcribe, mais uma variante de streaming gemini-3.5-transcribe-live. Essa divisão importa: o modelo de ficheiros processa áudio até uma hora por pedido (30 minutos se ativar a identificação de falantes ou os carimbos de tempo por palavra), enquanto o modelo live faz streaming de baixa latência por WebSockets.
Obtém um conjunto completo de funcionalidades: mais de 85 idiomas com mudança de idioma a meio da frase, identificação de até oito falantes, carimbos de tempo por palavra e enviesamento de vocabulário personalizado até 1.000 termos. Parece mais uma stack completa de compreensão de áudio do que um simples endpoint de transcrição.
Quanto ao preço, o modelo dedicado é cobrado por tokens: a entrada de áudio custa 2,00 $ por milhão de tokens e a saída de texto 12,00 $ por milhão, o que dá uma tarifa combinada de cerca de 0,005 $ por minuto, ou cerca de 0,30 $ por hora. Há um plano gratuito para testar, uma boa rampa de entrada.
A nossa opinião: se a precisão é o seu único fator decisivo e não está preso ao Azure, esta é a escolha. É o único modelo que se equipara ao MAI-Transcribe-2 no benchmark, e ter uma variante de streaming própria fecha a grande lacuna que o MAI deixa em aberto. O senão é que a Google não publicou um WER próprio de destaque, por isso confia na comparação da Microsoft para os números exatos.
2. ElevenLabs Scribe v2
Melhor para: equipas de media, podcasts e dobragem que precisam de etiquetas de falante detalhadas e etiquetagem de eventos de áudio.
A ElevenLabs fez nome na geração de voz, e o Scribe é o seu lado de fala para texto. O modelo de topo atual é o scribe_v2, com uma variante scribe_v2_realtime que ronda os 150 ms de latência. Na comparação FLEURS da Microsoft fica nos 6,2 %, um passo atrás dos líderes mas em boa companhia, e a própria ElevenLabs afirma mais de 98 % de precisão de transcrição com detalhes de WER por idioma.
Onde o Scribe se destaca é na riqueza da saída. Cobre mais de 90 idiomas, identifica até 32 falantes (o máximo desta lista), etiqueta eventos de áudio dinâmicos como risos e música, e reconhece 65 tipos de entidades. Para quem corta legendas ou transcreve gravações com vários falantes, esse detalhe é todo o objetivo.
O preço é faturado por hora: o Scribe v2 custa 0,22 $ por hora em lotes e 0,39 $ em tempo real, com complementos como deteção de entidades (+0,070 $/h) e prompting de termos-chave (+0,050 $/h). O plano gratuito dá 10.000 créditos por mês, embora sem licença comercial. Um programador resumiu o apelo prático no Hacker News:
"O modelo Scribe da ElevenLabs também é particularmente bom em precisão, e uso-o para transcrições de alta qualidade ou carrego ficheiros manualmente para a API deles para obter identificação de falantes e carimbos de tempo."
A nossa opinião: o Scribe v2 é o modelo a bater para trabalho de media, onde a identificação de 32 falantes e a etiquetagem de áudio justificam o custo. Fica um pouco atrás em WER bruto e é mais caro do que as opções mais baratas, mas para equipas de conteúdo a qualidade da saída compensa. Para transcrição simples de chamadas de suporte, modelos mais baratos fazem o mesmo trabalho base.
3. Deepgram
Melhor para: agentes de voz em tempo real, sistemas telefónicos e qualquer produto que faça streaming de áudio ao vivo.
O Deepgram é o favorito dos programadores para transcrição em tempo real, e a resposta mais clara àquilo que o MAI-Transcribe-2 não faz bem de origem: streaming ao vivo. Aparece na maioria das compilações de empresas de voz com IA por boas razões. O seu modelo de topo Nova-3 lida tanto com lotes como com streaming, e um modelo mais recente chamado Flux foi concebido de propósito para agentes de voz, com deteção de turnos incorporada. Se está a ligar voz a uma árvore telefónica ou a um agente ao vivo, é aqui que os programadores começam.
Os preços são agressivos e invulgarmente transparentes. O Nova-3 custa 0,0043 $ por minuto para áudio pré-gravado (cerca de 0,26 $ por hora) e 0,0048 $ por minuto para streaming, faturado ao segundo sem arredondamento. Recebe 200 $ de crédito gratuito, cerca de 750 horas, para testar. Cobre mais de 40 idiomas, faz identificação de falantes e carimbos de tempo por palavra, e suporta prompting de termos-chave para o seu jargão.
A outra coisa a assinalar é a implementação. O Deepgram oferece contentores auto-hospedados no plano Enterprise, com SOC 2, HIPAA, RGPD e residência de dados na UE, para que equipas reguladas mantenham o áudio na sua própria infraestrutura. É um diferenciador genuíno face às APIs apenas na cloud desta lista.
A nossa opinião: para tudo o que é tempo real, o Deepgram é a minha recomendação por defeito face ao MAI-Transcribe-2. Menos idiomas do que o Gemini ou o Whisper, mas a latência de streaming, a faturação ao segundo e a opção de auto-hospedagem fazem dele a escolha prática para produtos de voz ao vivo. Se todo o seu áudio são ficheiros gravados, os líderes de precisão podem superá-lo.
4. AssemblyAI
Melhor para: equipas que querem transcrição mais resumos, sentimento e ocultação de dados numa só chamada de API.
A proposta da AssemblyAI é que a transcrição é apenas o primeiro passo. O seu modelo de topo Universal-3.5 Pro faz o fala para texto, e depois há toda uma camada de Audio Intelligence por cima: resumo, análise de sentimento, deteção de tópicos, deteção de entidades, ocultação de PII e uma LLM Gateway para executar prompts de modelos de linguagem sobre o áudio. Se de outro modo juntaria três serviços, a AssemblyAI faz isso num só.
O preço é por hora e está entre os mais baixos aqui. O Universal-3.5 Pro custa 0,21 $ por hora em modo assíncrono e 0,45 $ em tempo real, enquanto o anterior Universal-2 desce para 0,15 $ por hora. As funcionalidades de inteligência são cobradas à parte, por hora, por isso só paga pelo que ativar. O plano gratuito é generoso: 185 horas de áudio pré-gravado e 333 de streaming, sem cartão.
Uma nota honesta: a AssemblyAI promove uma "precisão líder do setor em áudio do mundo real", mas não imprime um único número FLEURS nas páginas principais, por isso não aparece na comparação da Microsoft. Escolhe-a pela camada de inteligência e pelo preço, não por um WER de destaque que possa verificar.
A nossa opinião: se o seu produto precisa da análise, não apenas da transcrição, como resumos de chamadas ou pontuação de sentimento, a AssemblyAI poupa-lhe acoplar um segundo fornecedor. Só para transcrição bruta é competitiva, mas não claramente melhor do que os líderes de precisão. O enorme plano gratuito torna fácil experimentar.
5. OpenAI GPT-Transcribe
Melhor para: equipas que já executam um pipeline OpenAI e querem a transcrição no mesmo SDK.
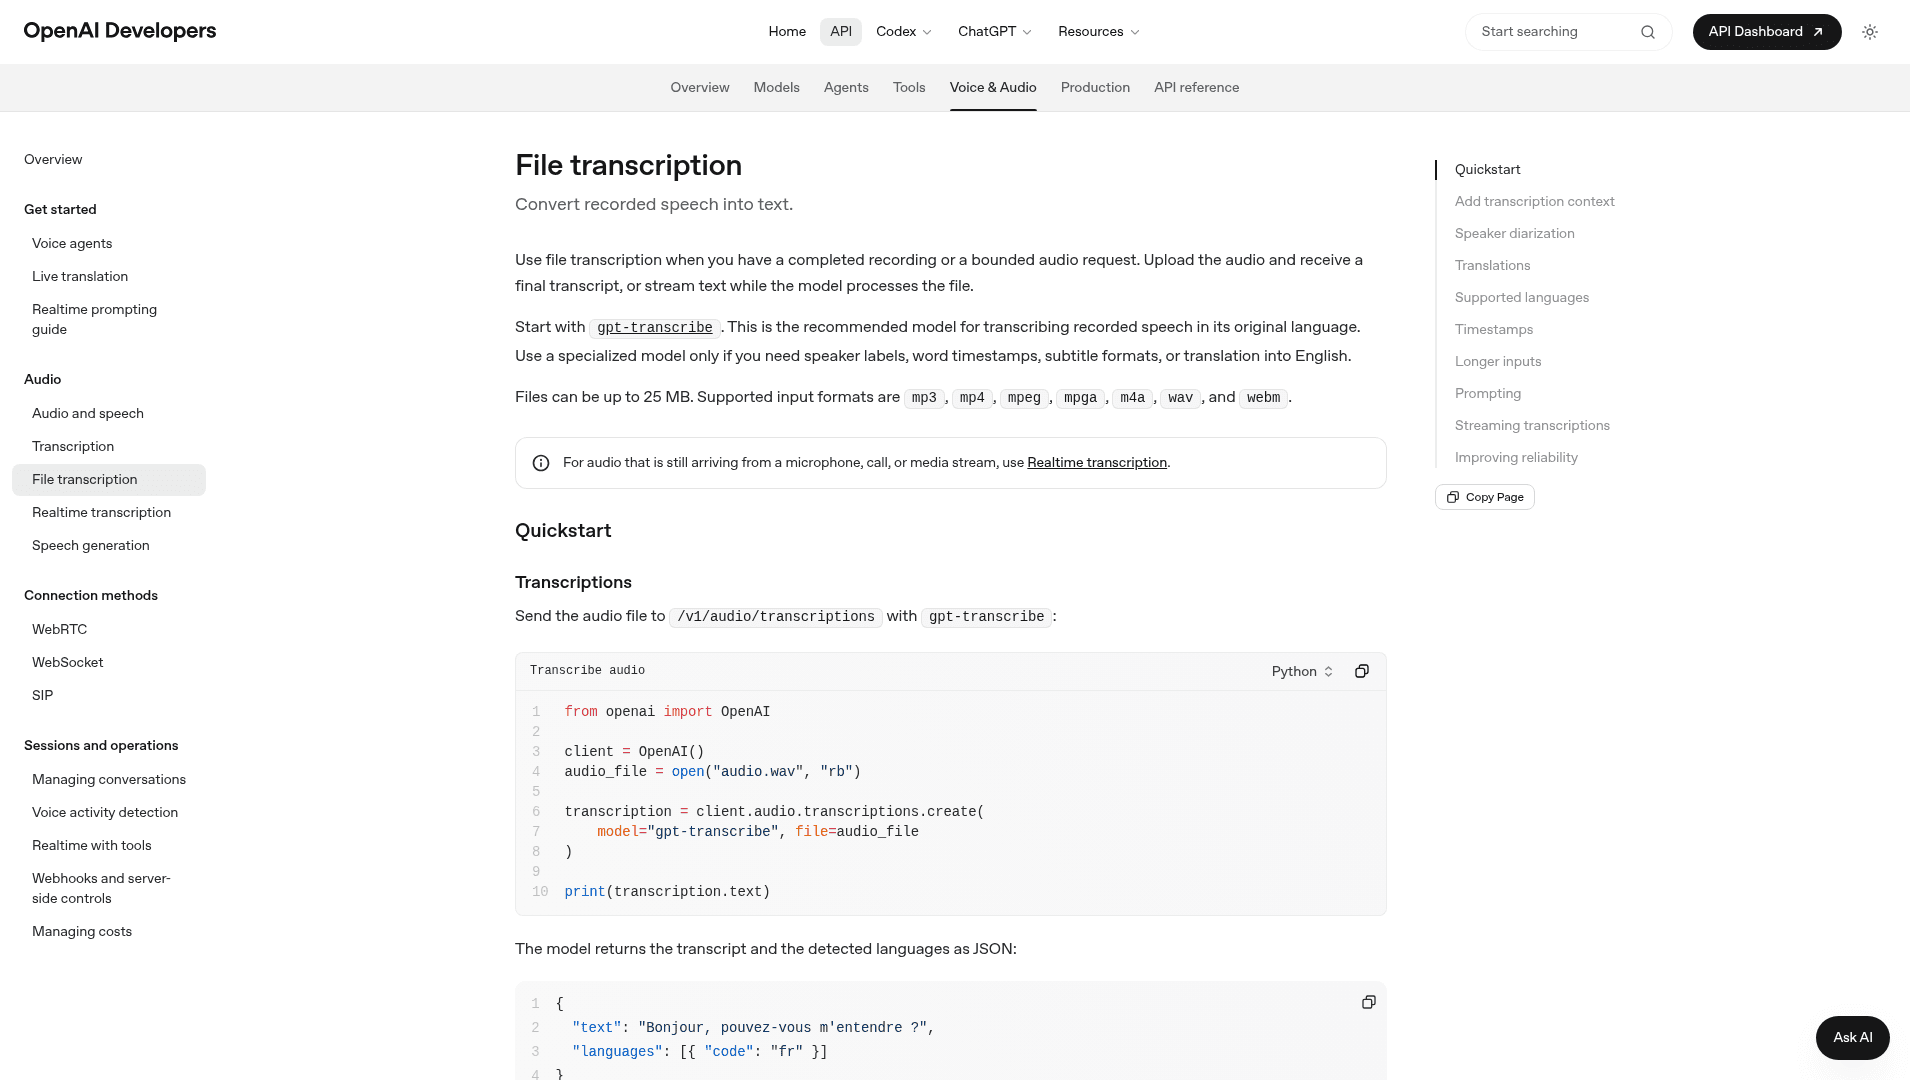
A OpenAI renovou discretamente a sua oferta de transcrição. O gpt-transcribe é agora a opção padrão recomendada, com o gpt-4o-transcribe, o gpt-4o-mini-transcribe e o antigo whisper-1 ainda disponíveis. Na tabela FLEURS da Microsoft, o GPT-Transcribe fica nos 10,4 %, bem atrás dos líderes, embora as avaliações do mundo real sejam mais calorosas do que esse número sugere:
"O Utter usa o GPT-4o Transcribe por defeito para transcrição na cloud e, na minha experiência, é o melhor da sua classe. A diferença é mais óbvia em nomes, terminologia de nicho e vocabulário técnico."
O preço é por minuto de áudio: o gpt-transcribe custa 0,0045 $ por minuto (cerca de 0,27 $ por hora), o gpt-4o-transcribe 0,006 $ e o gpt-4o-mini-transcribe uns baratos 0,003 $. Os ficheiros estão limitados a 25 MB, e cerca de 99 idiomas são suportados com deteção automática.
A armadilha a prever: os modelos simples não etiquetam falantes. A identificação de falantes vive num modelo separado, o gpt-4o-transcribe-diarize, e os carimbos de tempo por palavra só vêm através do antigo whisper-1. Por isso a arrumada história da "uma só API" tem alguns asteriscos consoante os metadados de que precisa.
A nossa opinião: a razão para escolher o GPT-Transcribe é a integração, não a precisão. Se já chama a OpenAI, acrescentar transcrição é uma alteração de uma linha e a qualidade prática em nomes e jargão é bem vista. Se a precisão em muitos idiomas é a prioridade, o benchmark diz para olhar primeiro para o Gemini ou o MAI.
6. Speechmatics
Melhor para: a maior cobertura de idiomas e sotaques, e equipas que precisam de implementação local.
A Speechmatics é a especialista empresarial, construída em torno de uma precisão independente do sotaque e de uma filosofia de idiomas "global-first". Cobre mais de 55 idiomas e dialetos de transcrição, mais 69 pares de tradução, e o seu modelo multilingue Melia lida com a mudança de idioma a meio da conversa, uma vantagem real para áudio em vários idiomas.
O preço é por hora e baseado em créditos, com escalões claros. O processamento em lotes vai de 0,129 $ por hora no modelo Melia até 0,40 $ no modelo Enhanced, com o escalão Standard a 0,24 $; o tempo real custa de 0,24 $ a 0,43 $. Há 100 $ de crédito gratuito e um desconto automático de 20 % acima de 500 horas por mês. Tem 4,7 em 5 no G2 com 70 avaliações.
O destaque é a implementação. A Speechmatics oferece auto-hospedagem verdadeira: Private Cloud, Container, Virtual Appliance e até opções On-Device, todas de nível Enterprise, com SOC 2 Type II, ISO 27001, RGPD e HIPAA. Segundo relatos, o Adobe Premiere e a Stenograph executam-no no dispositivo. Se o seu áudio legalmente não pode sair das suas instalações, este é um dos poucos modelos aqui que o permite.
A nossa opinião: a Speechmatics é a resposta quando a conformidade e a amplitude de idiomas pesam mais do que um preço mínimo. Não é a mais barata nem a campeã do FLEURS, mas a proposta local e a precisão independente do sotaque fazem dela a escolha segura para empresas reguladas e multilingues. Equipas pequenas à procura da fatura mais baixa olharão para outro lado.
7. Amazon Transcribe
Melhor para: equipas cujos dados e infraestrutura já vivem na AWS.
O Amazon Transcribe é a opção da cloud estabelecida, e toda a sua proposta de valor é ser nativo da AWS. Os trabalhos em lotes leem e escrevem no S3, encaixa nos pipelines de eventos do Lambda e alimenta o Bedrock e o Amazon Connect Contact Lens para resumos generativos. Se já é uma casa AWS, não há novo fornecedor, nem faturação separada, nem nova revisão de segurança.
O preço é por segundo, escalonado para baixar com o volume. O lote padrão custa 0,006 $ por minuto (cerca de 0,36 $ por hora) e o streaming 0,01 $ por minuto, com identificação de falantes, vocabulário personalizado e identificação de idioma incluídos. O plano gratuito é de 60 minutos por mês nos primeiros 12 meses. Há também um escalão Transcribe Medical compatível com HIPAA, a cerca de 0,075 $ por minuto, que identifica automaticamente informação de saúde protegida.
Cobre mais de 100 idiomas e faz o habitual: identificação de falantes, vocabulário personalizado, ocultação de PII e informações do Call Analytics. O que não publica é um número de precisão de destaque, por isso está ausente da comparação da Microsoft, e a sua precisão no mundo real tem uma reputação mista face aos fornecedores mais recentes centrados no modelo.
A nossa opinião: o argumento a favor do Amazon Transcribe é operacional, não de precisão. Dentro da AWS é o caminho de menor resistência, e a faturação e o IAM unificados valem dinheiro a sério. Fora da AWS, há poucas razões para o escolher em vez dos modelos especializados, mais afiados e baratos, e paga um prémio à tarifa padrão.
8. OpenAI Whisper (código aberto)
Melhor para: equipas com as suas próprias GPUs que querem custo zero por hora e controlo total.
O Whisper é o modelo que tornou a transcrição de código aberto mainstream, e continua a ser o ponto de referência para auto-hospedagem. Tem licença MIT tanto no código como nos pesos, vem em seis tamanhos, do tiny (39 M de parâmetros) ao large-v3 (1550 M), mais uma versão turbo de 809 M, e instala-se com um único pip install. Não há fatura de API de todo, paga apenas o processamento, cerca de 10 GB de VRAM para executar o large-v3.
A troca honesta é a precisão e o esforço. Na comparação FLEURS da Microsoft, o whisper-large-v3 fica nos 22,8 %, muito atrás dos modelos modernos, o que ilustra da melhor forma a rapidez com que este campo avançou. Também não tem identificação de falantes integrada (acrescenta-se o pyannote ou o WhisperX) nem streaming nativo. Mas para muitas cargas de trabalho a qualidade é mais do que suficiente, como disse um utilizador que o hospeda por conta própria:
"Tenho executado o whisper large-v3 num M2 Max através de um endpoint auto-hospedado e, sinceramente, a precisão é boa o bastante para eu ter deixado de me preocupar com modelos de limpeza. O maior incómodo para mim foi a latência em segmentos mais longos."
Se quer o Whisper sem gerir servidores, a OpenAI também disponibiliza o whisper-1 como API a 0,006 $ por minuto.
A nossa opinião: o Whisper é a escolha quando o controlo dos dados e o custo marginal zero pesam mais do que a precisão de topo. Em grande escala, a auto-hospedagem pode ficar abaixo de qualquer API paga aqui. Basta orçamentar o tempo de GPU, o complemento de identificação de falantes e a diferença de precisão face a um modelo de 2026 como o MAI-Transcribe-2 ou o Gemini.
Qual deve realmente escolher?
A resposta honesta é que a transcrição se tornou uma camada de commodity, por isso a escolha depende da tarefa, não de um único "melhor" modelo, tal como escolher software de helpdesk com IA depende da adequação mais do que de um ranking. Aqui está o atalho que eu usaria.
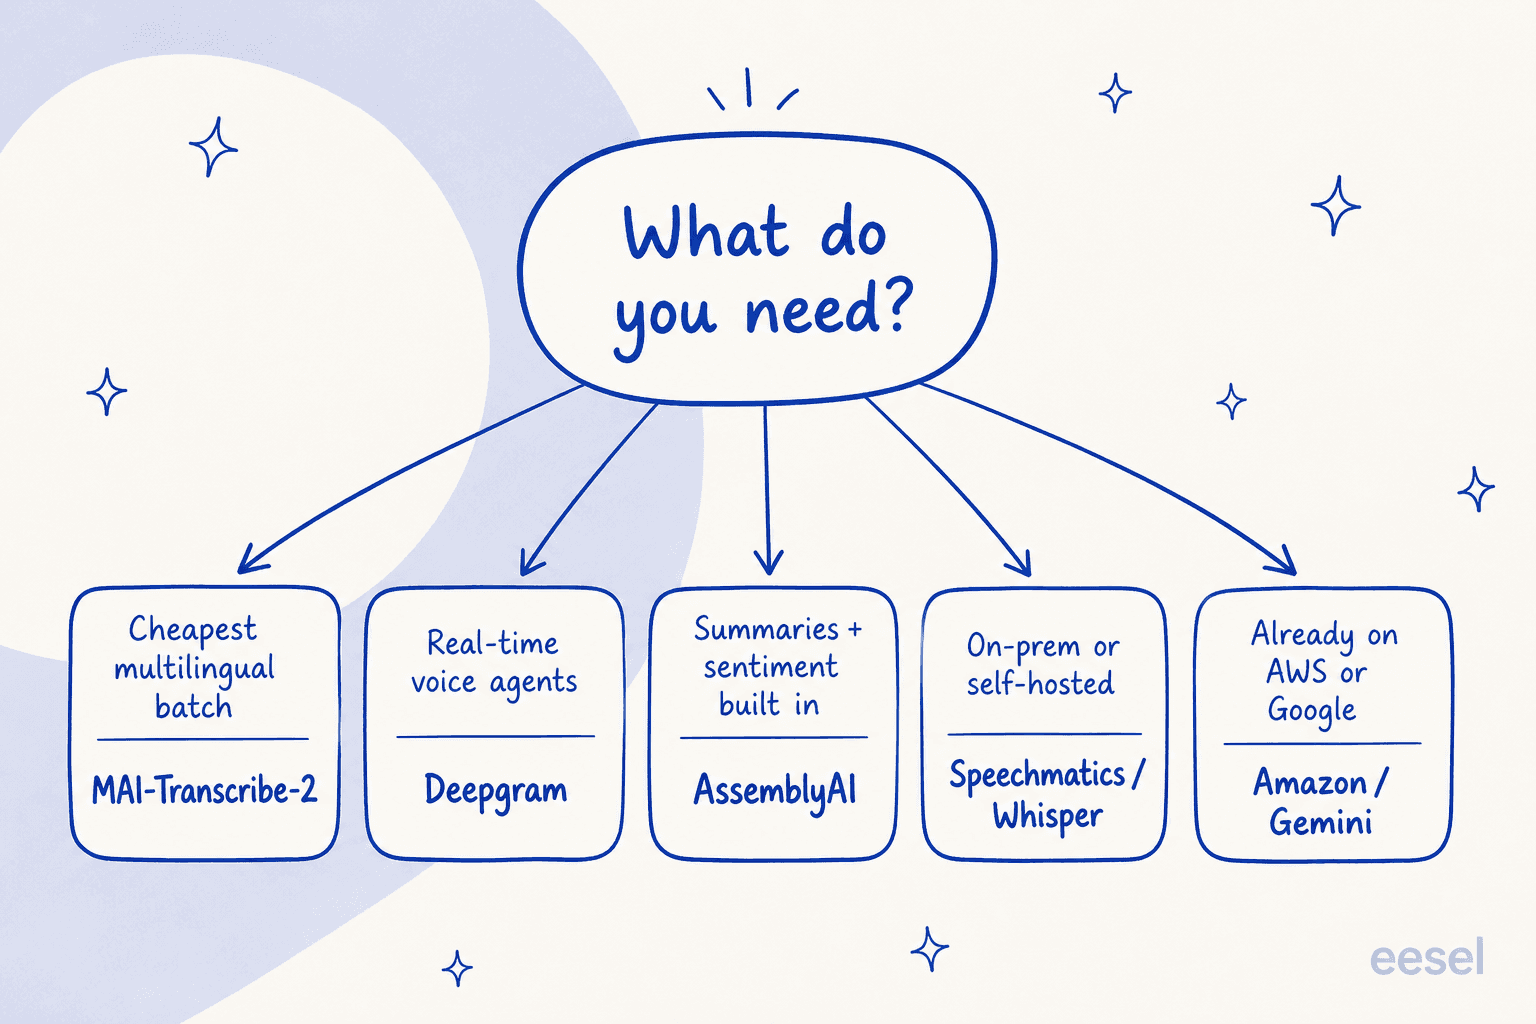
Se procura a fatura mais baixa para lotes multilingues, ganham o MAI-Transcribe-2 ou o Deepgram. Se constrói agentes de voz ao vivo, Deepgram ou Speechmatics. Se precisa de resumos e sentimento prontos a usar, AssemblyAI. Se está limitado por conformidade ou regras de implementação local, Speechmatics ou Whisper. Se já vive numa cloud, use o Amazon Transcribe ou o Gemini e poupe o trabalho de integração.
O que o ranking não mostra
Este é o reenquadramento a que voltei vezes sem conta ao pesquisar, e é o que realmente importa se trabalha em suporte. A transcrição costumava ser a parte difícil e cara. Já não é. O MAI-Transcribe-2 e todos os modelos desta lista transformaram-na numa commodity rápida, barata e quase resolvida. É ótimo, mas significa que o valor se deslocou.
Uma transcrição precisa de uma chamada de suporte não é o que alguém queria. O texto ainda tem de ser lido, a resposta ainda tem de ser encontrada nos seus documentos e tickets anteriores, e a resposta ainda tem de ser escrita e o ticket resolvido. O modelo dá-lhe os ouvidos. Não lhe dá o colega de equipa.
Vejo isto acontecer na eesel há anos. Já executámos IA em filas de suporte ao vivo com milhares de tickets reais, e a lição que ficou é que a precisão da transcrição nunca foi o gargalo; foi a resolução. É também por isso que simulamos cada implementação com os tickets passados reais de uma equipa antes de responder a um único cliente, para que veja como teria tratado a sua fila em vez de confiar num benchmark. Um modelo com ar confiante que dá respostas erradas é pior do que nenhum modelo, e esse risco está na camada de resolução, não na de transcrição.
Experimente a eesel para transformar transcrições em resoluções
Cada modelo desta lista é infraestrutura. A eesel é o funcionário que trabalha por cima. Construímos colegas de equipa de IA que contrata para uma tarefa específica, e o colega de equipa de IA para helpdesk é o que retoma exatamente onde um modelo de transcrição pára: lê o texto, tira a resposta da sua central de ajuda e de tickets anteriores, e redige ou envia a resposta diretamente no Zendesk, no Freshdesk ou no Slack. Combine um modelo como o MAI-Transcribe-2 com a eesel e um ticket de voz transcrito passa a ser um ticket resolvido, não apenas um parágrafo arrumado.
E como todos estes são modelos orientados primeiro para API, os programadores que os escolhem tendem a querer o mesmo controlo sobre a sua automatização de suporte. A eesel tem uma CLI pública exatamente para isso: controla o mesmo colega de equipa e o mesmo espaço de trabalho a partir de um terminal, para que uma pessoa a possa executar à mão, um script a possa automatizar e agentes de código como o Claude Code ou o Cursor a possam operar sem interface, sem precisar de painel. Liga a transcrição ao início do pipeline e a eesel à extremidade que resolve. É gratuita para experimentar, liga-se ao seu helpdesk em poucos minutos e simula com os seus tickets passados reais antes de responder a um único cliente.