As 9 melhores alternativas ao Meta Muse Wonder em 2026, por tarefa e preço

Kira

Katelin Teen
Última edição October 14, 2026
Por que olhar além do Muse Wonder
Começo pelo que a Meta acertou, porque é bastante coisa. O Muse Wonder é a primeira família de modelos de fronteira da Meta Superintelligence Labs, lançada em 12 de outubro, e a variante maior, Wonder Full, ficou em segundo lugar no índice da Artificial Analysis no dia do lançamento. O modelo da API tem janela de contexto de 1.048.576 tokens, aceita texto, imagem, vídeo, áudio e PDF, e vem com uma tabela de preços clara: sem acréscimo para contexto longo e 3.000 requisições por minuto desde o primeiro dia. A análise do Muse Wonder do meu colega cobre tudo isso em detalhes.
Os motivos para olhar outras opções são específicos, e os três podem ser conferidos:
- O modelo que você pode comprar não é o modelo do gráfico. A própria tabela de benchmarks da Meta mostra o Wonder Full vencendo 6 de 14 linhas. O Wonder comum, o único na API, vence 1 (MemoryBench).
- Custa preço de fronteira. A Meta costumava cobrar menos que todo mundo. A
$4/$20, o Wonder agora iguala o Opus 5.5 até o centavo e custa o dobro do GPT-6.1 Sol. - É uma prévia. A documentação de modelos o marca como preview, o relatório de segurança estará "disponível em breve", e um testador inicial apontou problemas de confiabilidade da API.
"It's ok, intelligent, almost SOTA, but way too expensive [0], and some issues with API failing sometimes at the moment."

Eu construo funcionalidades e agentes de IA na eesel, e o modelo por baixo é a parte da stack da eesel que mais espero que mude. Não é palpite. Em uma ligação de vendas, uma equipe de suporte de hardware B2B com cerca de 250 tickets por mês disse à equipe de vendas da eesel que precisava substituir sua ferramenta de suporte com IA. O motivo não tinha nada a ver com preço: o fornecedor havia mudado seu modelo de negócio, e a equipe foi forçada a migrar. Um modelo em preview é exatamente onde esse tipo de mudança acontece sem muito aviso, então eu trataria o Wonder como uma opção para testar, não como uma plataforma para amarrar de vez.
Mesmo preço, pontuação diferente
Este é o gráfico que vale guardar deste artigo. No preço de saída por milhão de tokens, o Muse Wonder fica no mesmo nível do Opus 5.5. No índice da Artificial Analysis, como mostrado no próprio gráfico de lançamento da Meta, fica seis pontos abaixo.
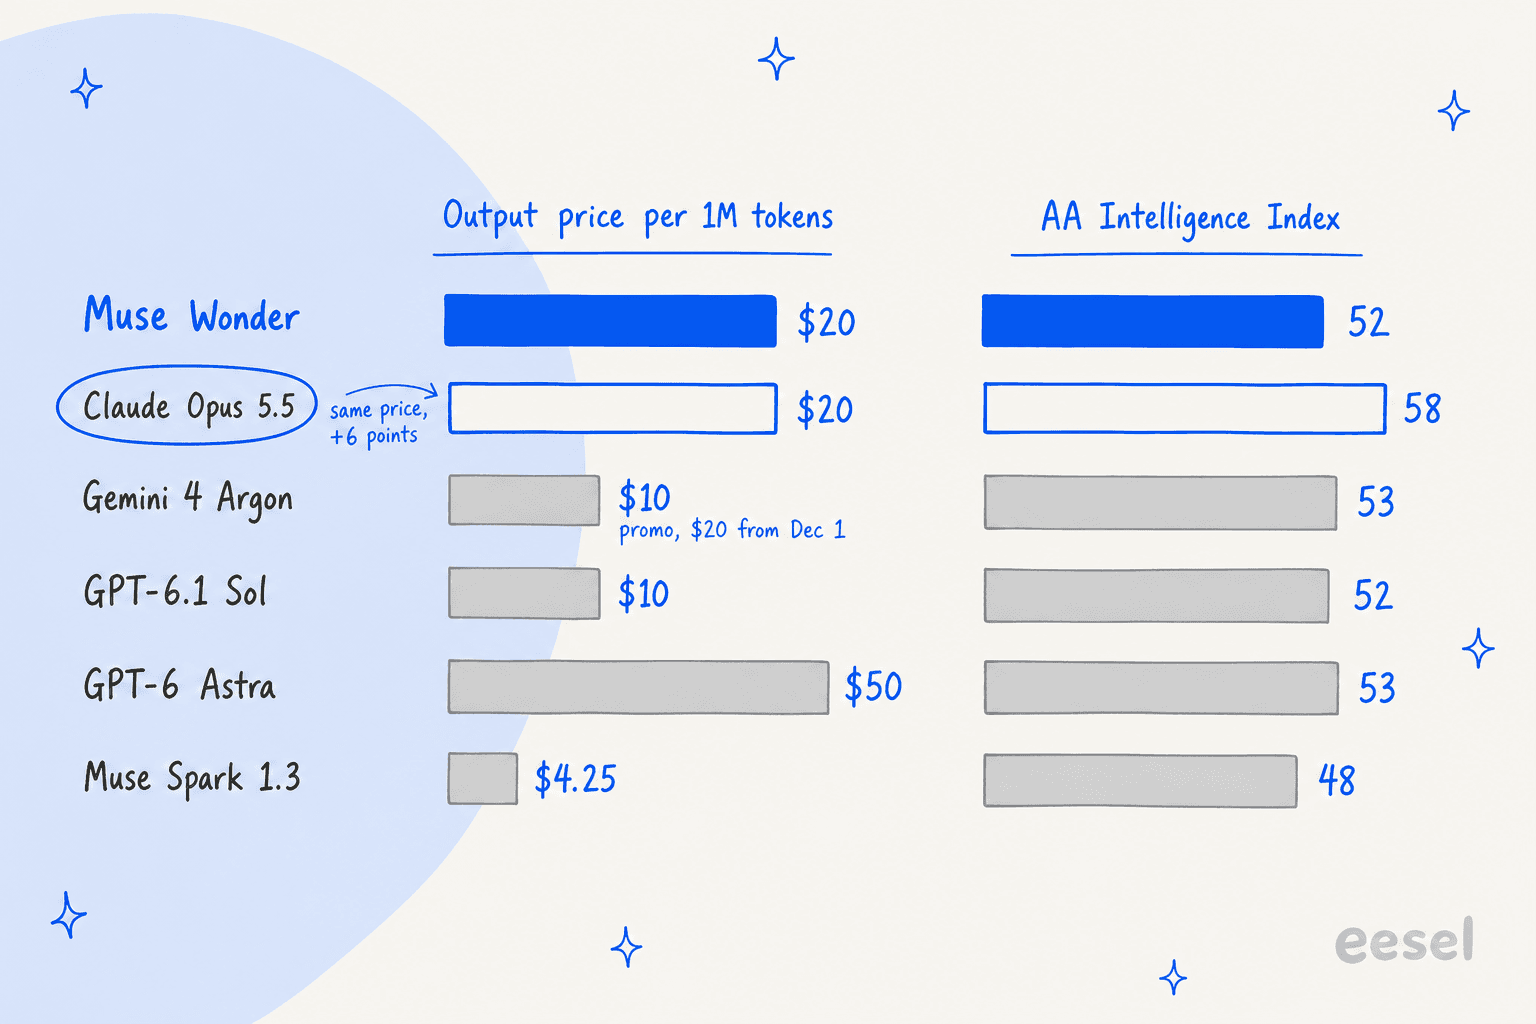
Lendo as linhas, três coisas se destacam. O Opus 5.5 é a mesma conta por 6 pontos a mais. O GPT-6.1 Sol é a mesma pontuação pela metade do preço de saída. E o GPT-6 Astra cobra 2,5 vezes o preço do Wonder por um ponto extra. Benchmarks não são tudo (o resultado do Wonder no MemoryBench é real, e a Meta o criou para execuções longas de agentes), mas com preços idênticos, o ônus da prova fica com o modelo de menor pontuação.
Um comentarista do HN resumiu a comparação com o Sol sem rodeios:
"sol 6.1 is 50% cheaper than this. sol pricing$2.00 output $10.00 dont know why the f people downvote for saying sol pricing."
As alternativas ao Muse Wonder num relance
Os preços são tarifas padrão de API por milhão de tokens, tiradas da página de preços de cada fornecedor, conferidas em 14 de outubro de 2026. As pontuações do índice vêm do gráfico de lançamento da Meta (12 de outubro) quando o modelo aparece nele, e das páginas de modelos da Artificial Analysis nos demais casos.
| Modelo | Melhor para | Entrada / cache / saída por 1M | AA Intelligence Index | Contexto / saída máx. | Pesos abertos | Treina com seus dados por padrão | Plano gratuito | Onde obter |
|---|---|---|---|---|---|---|---|---|
| Muse Wonder (referência) | Execuções longas de agentes, memória | $4 / $0.20 / $20 | 52 | 1M / não publicado | Não | Não (API) | Não | Meta Model API, OpenRouter, Muse Code |
| Claude Opus 5.5 | Mesma conta, pontuação maior | $4 / $0.20 / $20 | 58 | 1M / 128K | Não | Não | Não | Claude API, Bedrock, Vertex, Foundry |
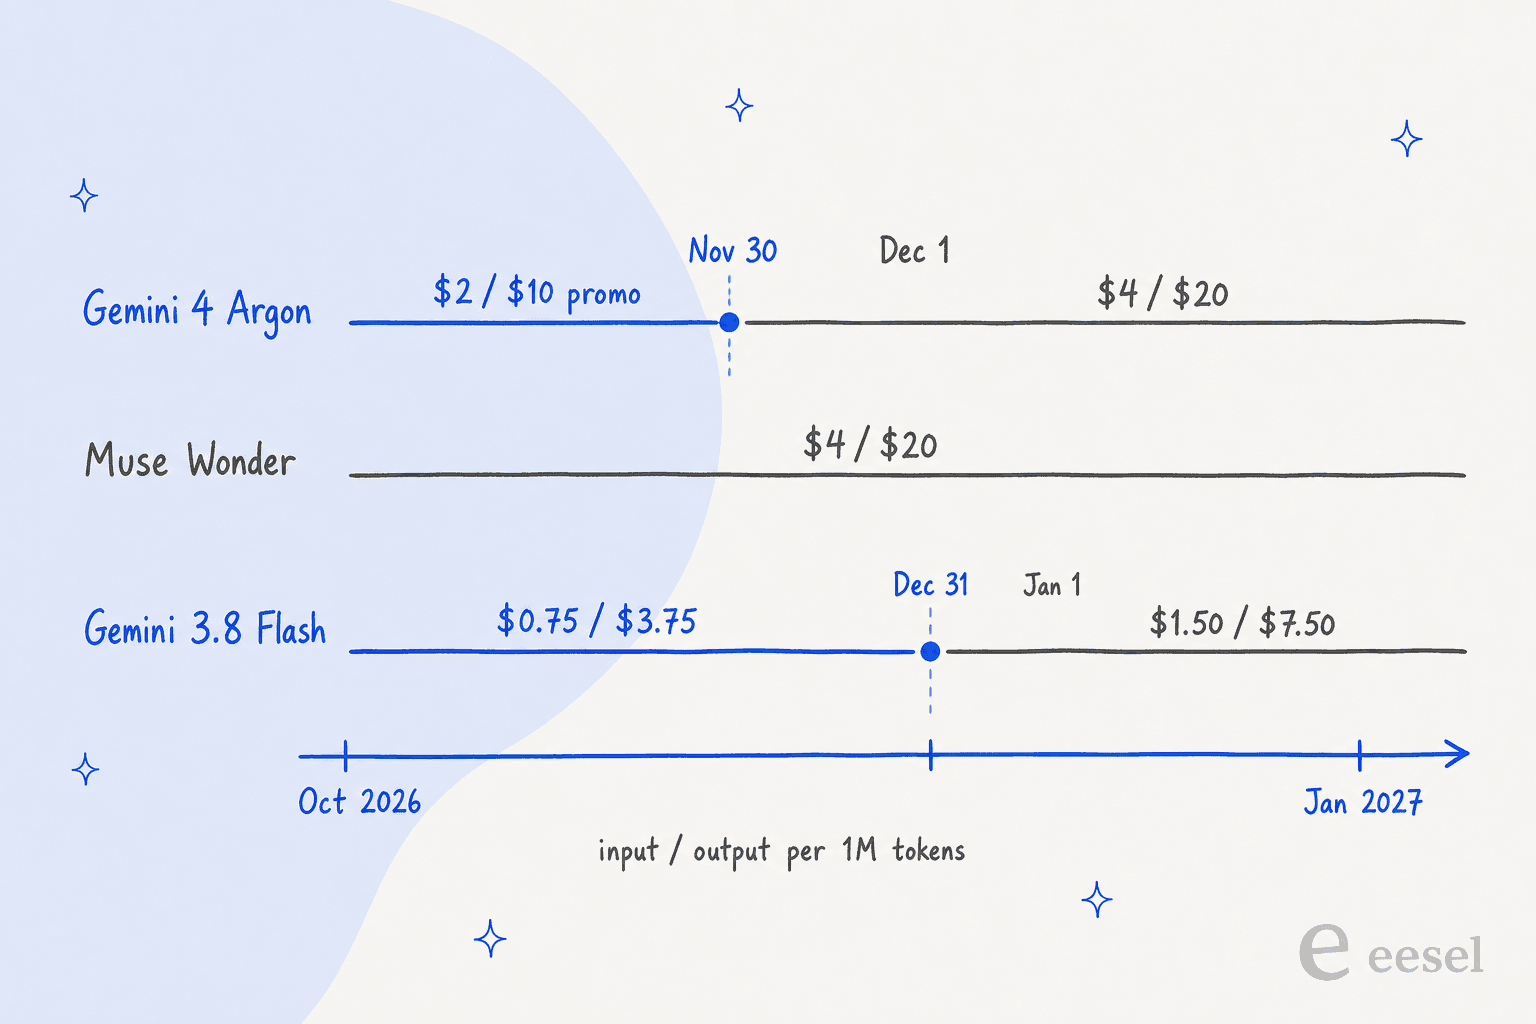
| Gemini 4 Argon | Documentos longos, mais barato até dez. | $2 / $0.10 / $10, depois $4 / $0.20 / $20 | 53 | 1M unificado / até 1M | Não | Não (pago) | Não | Gemini API, AI Studio |
| Muse Wonder Full | O melhor da Meta, programação no Muse Code | $50 ou $200 por mês | 56 | 1M / não publicado | Não | Sim (modo Contributor) | Não | Somente Muse Code Power ou Max |
| GPT-6.1 Sol | Pontuação do Wonder pela metade do preço | $2 / $0.10 / $10 | 52 | 1.05M / 128K | Não | Não | Não | OpenAI API, ChatGPT Work, Codex |
| GPT-6 Astra | Nível máximo da OpenAI, Ultrafast | $10 / $1 / $50 | 53 | 1.05M / 128K | Não | Não | Não | OpenAI API, planos pagos do ChatGPT |
| Claude Sonnet 5.5 | Programação pela metade do preço do Opus | $2 / $0.10 / $10 | 56 (max), 47 (high) | 1M / 128K | Não | Não | Não | Claude API, nuvens |
| Muse Spark 1.3 | Alto volume, continuar com a Meta | $1.25 / $0.15 / $4.25 | 48 | 1M / não publicado | Não (prometido) | Somente na variante contributor | Não | Meta Model API, Muse Code |
| Gemini 3.8 Flash | Trabalho em lote barato, plano gratuito | $0.75 / $0.075 / $3.75 | 41 (high) | 1M / 64K | Não | Somente no plano gratuito | Sim | Gemini API, AI Studio |
| DeepSeek V4.1 Flash | Pesos abertos, menor conta | $0.15 / $0.003 / $0.60 fora do pico | 39.5 (max) | 1M / 384K | Sim, MIT | Os termos não dizem | Não | DeepSeek API, auto-hospedagem |
Não sabe qual linha é a sua? Escolha o motivo mais próximo de por que você estava olhando para o Wonder.
Para que você queria o Muse Wonder?
Escolha o motivo mais próximo do seu.
Como escolhi estas alternativas
Parti da lista curta que um assistente de IA dá a um comprador que pergunta com o que comparar o Wonder, e depois conferi cada nome em fontes primárias. Essa lista se apoiava no GPT-6 Astra, no Claude Opus 5.5, no Gemini 4 Argon, no Wonder Full e em um Gemini Flash barato. Dois deles precisavam de correção. O Gemini 4 Argon tinha acabado de sair, e o Flash que ele sugeriu, o Gemini 3.5 Flash, está descontinuado com as requisições agora redirecionadas para o 3.6 Flash, então usei o atual 3.8 Flash.
Depois acrescentei os modelos que um comprador do Wonder realmente pesa por preço: GPT-6.1 Sol e Claude Sonnet 5.5 a $2/$10, o próprio Muse Spark 1.3 da Meta e uma opção de pesos abertos. Cada preço abaixo vem da página de preços do fornecedor em 14 de outubro. Cada benchmark é do fornecedor ou da Artificial Analysis, e eu digo qual.
O que não fiz foi passar nove modelos pelo meu próprio ambiente de testes para este artigo. O Wonder tem três dias, e uma comparação justa precisa das suas tarefas, não das minhas. Por isso a última seção traz o teste de cinco tarefas que eu executaria, e cada item abaixo diz qual dessas tarefas ele deveria vencer.
1. Claude Opus 5.5: a mesma conta por uma pontuação maior
Melhor para: equipes que queriam um modelo de fronteira a $4/$20 e querem o que pontua mais nesse preço.
O Claude Opus 5.5 é a troca mais direta desta lista porque nada no seu orçamento muda. A documentação de preços da Anthropic lista $4 de entrada, $20 de saída e $0.20 por acerto de cache, os mesmos três números do Wonder. A diferença é a pontuação: 58 no índice da Artificial Analysis contra 52 do Wonder, e o primeiro lugar nesse índice no lançamento do Wonder.
A própria tabela da Meta defende o Opus. O Opus 5.5 vence 6 das 14 linhas, incluindo uso de computador (OSWorld 81.8 contra 72.6 do Wonder), programação em terminal (59.6 contra 52.0) e programação do zero. Esta última é a maior diferença de toda a tabela: ProgramBench 70.5 para o Opus 5.5, 50.0 para o Wonder comum. Onde o Wonder se sustenta é em memória e programação de longo prazo: ele supera o Opus 5.5 no DeepSWE (78.8 contra 74.2) e no SWE-Marathon (53.1 contra 46.3).
Os extras práticos também contam. O Opus 5.5 roda na Claude API e também no Bedrock, Vertex e Foundry, o Batch reduz o preço pela metade para $2/$10, e o esforço padrão da Anthropic agora é médio, que pontua 51 por $1.34 por tarefa na Artificial Analysis. A análise do Opus 5.5 aprofunda os níveis de esforço.
Prós: preço idêntico ao do Wonder; 6 pontos acima no índice; lidera a tabela da Meta em uso de computador, terminal e programação do zero; disponível em três grandes nuvens.
Contras: forçar tool_choice (any ou uma ferramenta nomeada) retorna erro, o que importa se seu agente depende disso; o esforço máximo custa cerca de $5.98 por tarefa na Artificial Analysis; sem pesos abertos.
Preços: $4 de entrada, $0.20 por acerto de cache, $20 de saída por 1M de tokens; escrita de cache de 5 minutos $5, de 1 hora $8; Batch $2/$10; modo Fast $8/$40. Tabela completa em preços do Opus 5.5.
Minha opinião: se você ia colocar o Wonder em produção a $4/$20, coloque primeiro o Opus 5.5 e faça o Wonder vencê-lo nas suas próprias tarefas. Pelo mesmo preço, o modelo de maior pontuação fica com o padrão.
2. Gemini 4 Argon: metade do preço do Wonder até dezembro
Melhor para: documentos longos, execuções longas de agentes e equipes que querem a menor taxa de respostas inventadas do grupo de fronteira.
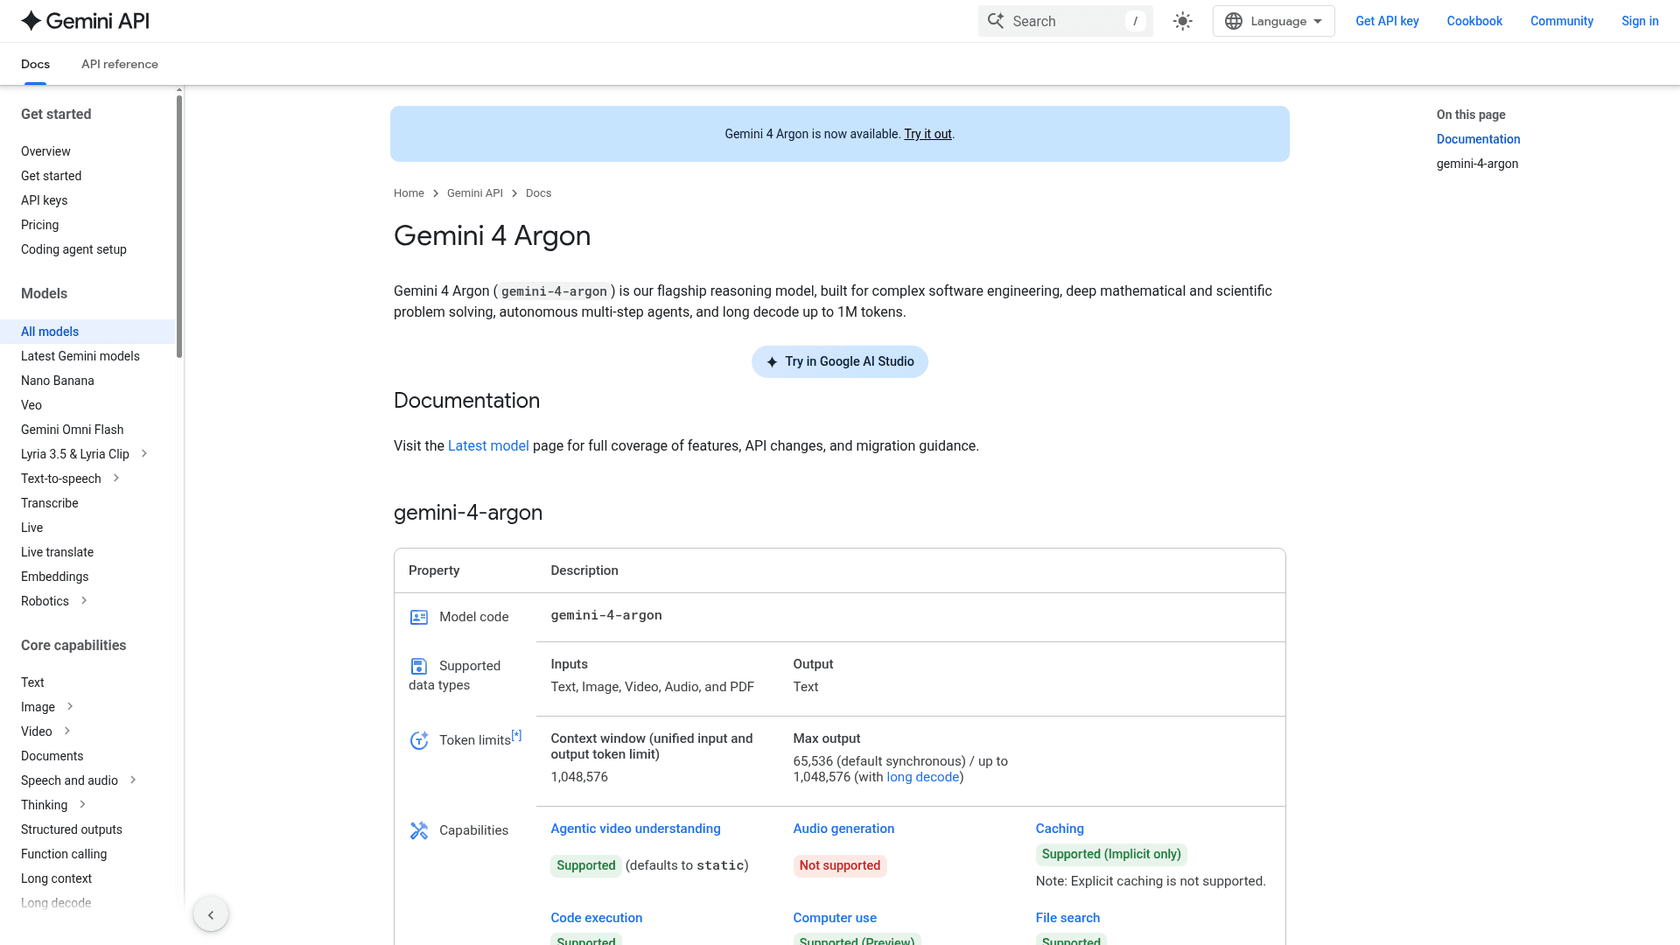
No dia do lançamento do Wonder, um comentarista do HN elogiou o Wonder por estar "available unlike Gemini 4 Argon". Durou um dia. O changelog do Google mostra que o gemini-4-argon ficou geralmente disponível na API do Gemini em 13 de outubro, e agora também está no AI Studio. A análise do Gemini 4 Argon foi escrita quando ele ainda era só por convite; os fatos abaixo vêm da documentação ao vivo do Google.
O preço é a parte interessante. A página de preços do Google lista $2 de entrada, $0.10 em cache e $10 de saída até 30 de novembro, depois $4, $0.20 e $20 a partir de 1º de dezembro, que é exatamente a tabela do Muse Wonder. Então, por cerca de sete semanas você tem um modelo que pontua 53 no índice (um ponto acima do Wonder) pela metade do preço, e depois o tem pelo mesmo preço.
O que o Argon faz melhor é trabalho longo. A página do modelo lista uma janela unificada de 1.048.576 tokens, 65.536 tokens de saída por padrão e até 1.048.576 com decodificação longa, além de uso de computador em preview, execução de código, busca de arquivos e ancoragem em busca. Na Artificial Analysis, sua taxa de alucinação é de 15%, a mais baixa de qualquer modelo de fronteira que já conferi. A tabela de benchmarks do próprio Google o mostra liderando em tarefas de finanças, jurídico e fluxos de negócio, embora sejam execuções do Google, não as versões da AA na tabela da Meta.
Prós: metade do preço do Wonder até 30 de novembro; um ponto acima no índice; menor taxa de alucinação do grupo de fronteira; decodificação longa até 1M de tokens de saída; Batch e Flex pela metade do preço.
Contras: a promoção termina em 1º de dezembro; não há suporte a cache de contexto explícito (só implícito); sem plano gratuito; escreve bastante, cerca de $1.99 por tarefa na Artificial Analysis com o preço promocional.
Preços: $2 / $0.10 / $10 até 30 de novembro, depois $4 / $0.20 / $20; Batch e Flex $1 / $5 (depois $2 / $10); Priority $3.60 / $18. Veja preços do Gemini 4 Argon.
Minha opinião: se documentos longos e precisão são o motivo de você querer o Wonder, teste o Argon agora, enquanto está barato. Só reserve orçamento para o preço de 1º de dezembro, porque depois é uma disputa direta de $4/$20 com o Wonder e o Opus 5.5.
3. Muse Wonder Full: o upgrade dentro da família
Melhor para: desenvolvedores individuais e equipes pequenas em projetos longos de programação, redação jurídica ou pesquisa financeira dentro do agente de programação da Meta.
Se você gostou do Wonder por causa do gráfico de lançamento da Meta, o Wonder Full é o modelo que o mereceu. Pontua 56 no índice, atrás apenas do Opus 5.5 no lançamento, e vence 6 das 14 linhas da Meta: o composto interno, jurídico (13.1 contra 4.2 do Opus 5.5), finanças, fluxos de negócio, DeepSWE e SWE-Marathon (57.5 contra 46.3). Nenhum outro modelo deste artigo lidera em tantas tarefas longas e pesadas em documentos.
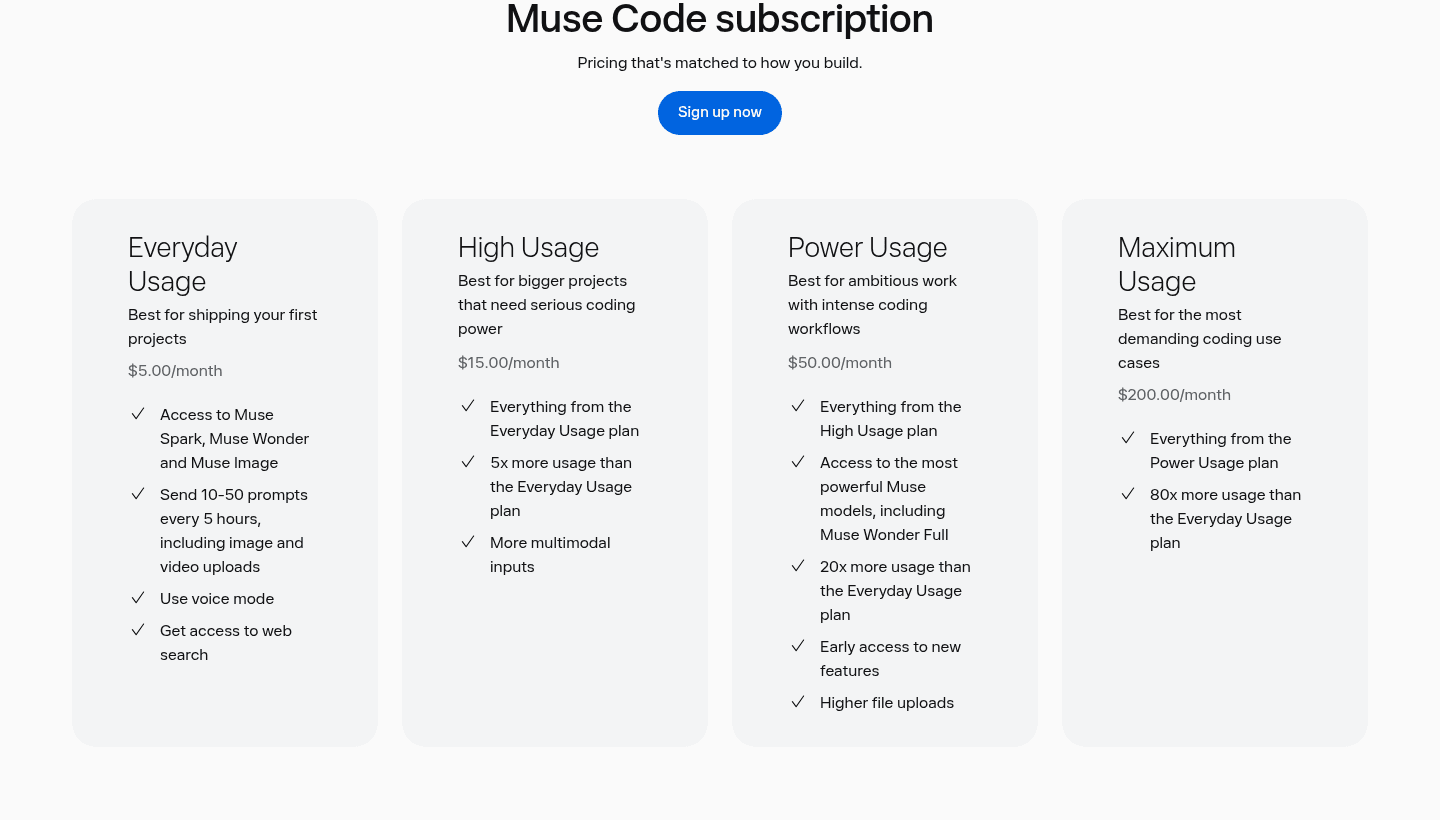
O problema é o acesso. O Full só está no plano Power Usage do Muse Code a $50 por mês e no Maximum Usage a $200. Não tem preço por token, e a documentação de modelos da Meta diz que definir o esforço como max no Wonder comum não o seleciona. Uma chave de assinatura também só funciona dentro da CLI do Muse Code, então você não pode colocar o tráfego do seu produto nela.
"Super interesting that they're not even making Wonder Full available outside of their own coding harness, and thus not providing an API price to use in comparisons."
Mais duas coisas antes de pagar. A documentação de assinaturas diz que os planos vêm por padrão no modo Contributor, que permite à Meta treinar com seus prompts, código e arquivos até você desativá-lo. E os planos são para maiores de 18, sem reembolso e com disponibilidade que varia por região; um comentarista relatou que a assinatura é somente para a América do Norte por enquanto.
Prós: o modelo mais forte da Meta; lidera em jurídico, finanças, fluxos de trabalho e programação muito longa; preço mensal fixo em vez de cobrança por token.
Contras: somente por assinatura, somente dentro do Muse Code; modo Contributor ativado por padrão; limitado por região; não pode ser usado para alimentar um app.
Preços: Power Usage $50/mês (20x o uso do Everyday) ou Maximum Usage $200/mês (80x). Os planos mais baratos Everyday ($5) e High ($15) incluem apenas o Wonder comum. Mais em preços do Muse Code.
Minha opinião: se você queria o Wonder para sua própria programação, pule a API e pague $50 pelo Full, com o modo Contributor desativado desde o primeiro dia. Se queria o Wonder dentro de um produto, o Full não é opção, então olhe os itens 1 e 2. O artigo de alternativas ao Muse Code cobre os outros agentes de programação com o mesmo orçamento.
4. GPT-6.1 Sol: a pontuação do Wonder pela metade do preço
Melhor para: apps em produção em que o nível de qualidade do Wonder basta e a conta importa.
O GPT-6.1 Sol pontua 52 no próprio gráfico de lançamento da Meta, igual ao Wonder. A página de preços da OpenAI o lista a $2 de entrada, $0.10 em cache e $10 de saída, exatamente metade do Wonder em cada linha. Para uma equipe de produto, é a troca mais limpa desta lista: mesmo nível de benchmark, metade da conta.
Também é eficiente por tarefa. A Artificial Analysis mediu o 6.1 Sol com esforço máximo em cerca de $0.72 por tarefa, e o esforço xhigh supera o max no seu índice de agentes de programação. Tem janela de contexto de 1.050.000 tokens, 128.000 tokens de saída máximos e residência de dados nos EUA e na UE. A afirmação da própria OpenAI no DevDay foi que ele iguala o GPT-6 Astra no DeepSWE por cerca de um quinto do custo.
Onde difere do Wonder é na forma da API. O 6.1 Sol não tem esforço none nem minimal, e o Chat Completions funciona somente sem chamadas de ferramentas, então agentes devem usar a Responses API. Prompts acima de 272K tokens de entrada são cobrados a uma taxa maior.
Prós: mesma pontuação de índice do Wonder pela metade do preço; barato por tarefa; bons resultados em agentes de programação; residência de dados na UE.
Contras: sem esforço none; chamadas de ferramentas exigem a Responses API; prompts longos acima de 272K custam mais; sem pesos abertos.
Preços: $2 / $0.10 / $10 por 1M de tokens, escrita de cache $2.50; acima de 272K de entrada $4 / $0.20 / $15; Batch e Flex $1 / $5. Detalhamento em preços do GPT-6.1 Sol.
Minha opinião: se você ia usar o Wonder como um cavalo de batalha sólido e não como vitrine, é este. Passe suas tarefas pelos dois, e a menos que o Wonder vença com clareza, a metade do preço vence.
5. GPT-6 Astra: o nível máximo da OpenAI, a 2,5 vezes o preço do Wonder
Melhor para: equipes que já usam a OpenAI e precisam do modelo de topo ou do nível de velocidade Ultrafast.
O GPT-6 Astra foi o primeiro nome da lista curta do assistente de IA, e é um modelo forte: janela de 1.050.000 tokens, shell hospedado, apply-patch, uso de computador e MCP integrados, e a maior pontuação na linha GDP.pdf de trabalho profissional da Meta (34.2). Também é o primeiro modelo que a OpenAI classificou como "Critical" em cibersegurança, com o uso cibernético avançado restrito.
Mas os números não o favorecem como substituto do Wonder. Ele pontua 53 no gráfico da Meta, um ponto acima do Wonder, custando $10 de entrada e $50 de saída por milhão de tokens, 2,5 vezes o preço do Wonder. O Wonder Full o supera em 11 das 14 linhas da tabela da Meta. Na Artificial Analysis, o Astra com esforço máximo custa cerca de $3.26 por tarefa.
A única coisa que só o Astra tem hoje é o Ultrafast. A página de preços da OpenAI lista tarifas Ultrafast somente para o Astra, a $60 de entrada e $300 de saída por milhão de tokens. Se seu produto precisa desse nível de velocidade neste mês, é a única opção da família GPT-6.
Prós: o modelo mais forte da OpenAI; ferramentas de agente integradas; maior pontuação em GDP.pdf na tabela da Meta; a única opção Ultrafast.
Contras: 2,5 vezes o preço do Wonder por mais um ponto de índice; prompts longos acima de 272K são cobrados a $20 / $75; o Wonder Full o supera na maioria das linhas da Meta.
Preços: $10 / $1 / $50 por 1M de tokens; Batch e Flex $5 / $25; Fast $20 / $100; Ultrafast $60 / $300. Veja preços do GPT-6 Astra.
Minha opinião: eu não sairia do Wonder para o Astra só por qualidade. Escolha-o se estiver padronizando na OpenAI e precisar de Ultrafast, ou se seus próprios testes o mostrarem vencendo em documentos profissionais.
6. Claude Sonnet 5.5: metade do Opus, perto em programação
Melhor para: agentes de programação e apps com muitas ferramentas que querem qualidade Anthropic pela metade do preço do Opus.
O Claude Sonnet 5.5 custa $2 de entrada e $10 de saída, metade do Wonder, e a documentação de preços da Anthropic agora lista seu acerto de cache a $0.10, metade dos $0.20 do Wonder. Pontua 56 na Artificial Analysis com esforço máximo, acima do Wonder comum. Nos números de lançamento da Anthropic, ele até supera o Opus 5.5 no Terminal-Bench 4.0 (70.6 contra 66.4).
A ressalva é o esforço. Esse 56 vem com esforço máximo, onde a Artificial Analysis mediu cerca de $7.60 por tarefa, mais que o Opus 5.5. Com esforço alto pontua 47 por $1.08, e a própria Anthropic diz que a economia aparece com esforço baixo e médio. Minha análise do Sonnet 5.5 o achou ótimo no médio e uma armadilha no max.
Ele também chegou com mudanças incompatíveis: forçar tool_choice retorna erro, thinking: disabled retorna erro, e os blocos de raciocínio são vinculados ao modelo, então o histórico da conversa precisa ser somente de acréscimo.
Prós: metade do preço por token do Wonder, com acerto de cache mais barato; boa programação em terminal; mesma janela de 1M e 128K de saída do Opus.
Contras: o esforço máximo custa mais por tarefa que o Opus 5.5; mudanças incompatíveis na API desde o Sonnet 5; sem uso forçado de ferramentas.
Preços: $2 / $0.10 / $10 por 1M de tokens; escrita de cache de 5 minutos $2.50, de 1 hora $4; Batch $1 / $5. Detalhamento em preços do Sonnet 5.5.
Minha opinião: um bom substituto do Wonder para agentes de programação se você o mantiver em esforço baixo ou médio. Se se pegar subindo para max, troque para o Opus 5.5.
7. Muse Spark 1.3: a resposta da própria Meta para volume
Melhor para: trabalho de alto volume e sensível à latência, para equipes que querem continuar na API da Meta.
Esta é a alternativa que a própria Meta recomenda. Sua documentação de modelos apresenta o Wonder para tarefas longas e complexas e direciona trabalho de alto volume, sensível à latência ou ao custo para o Muse Spark. O Muse Spark 1.3 custa $1.25 de entrada, $0.15 em cache e $4.25 de saída por milhão de tokens, menos de um quarto do preço de saída do Wonder, e pontua 48 no gráfico da Meta.
Usuários frequentes o avaliam bem pelo preço:
"I've been a regular user of muse spark 1.3 ... and I can tell you one thing for sure that this model, muse-spark-1.3 in xhigh mode, is between sol-6-medium and high."
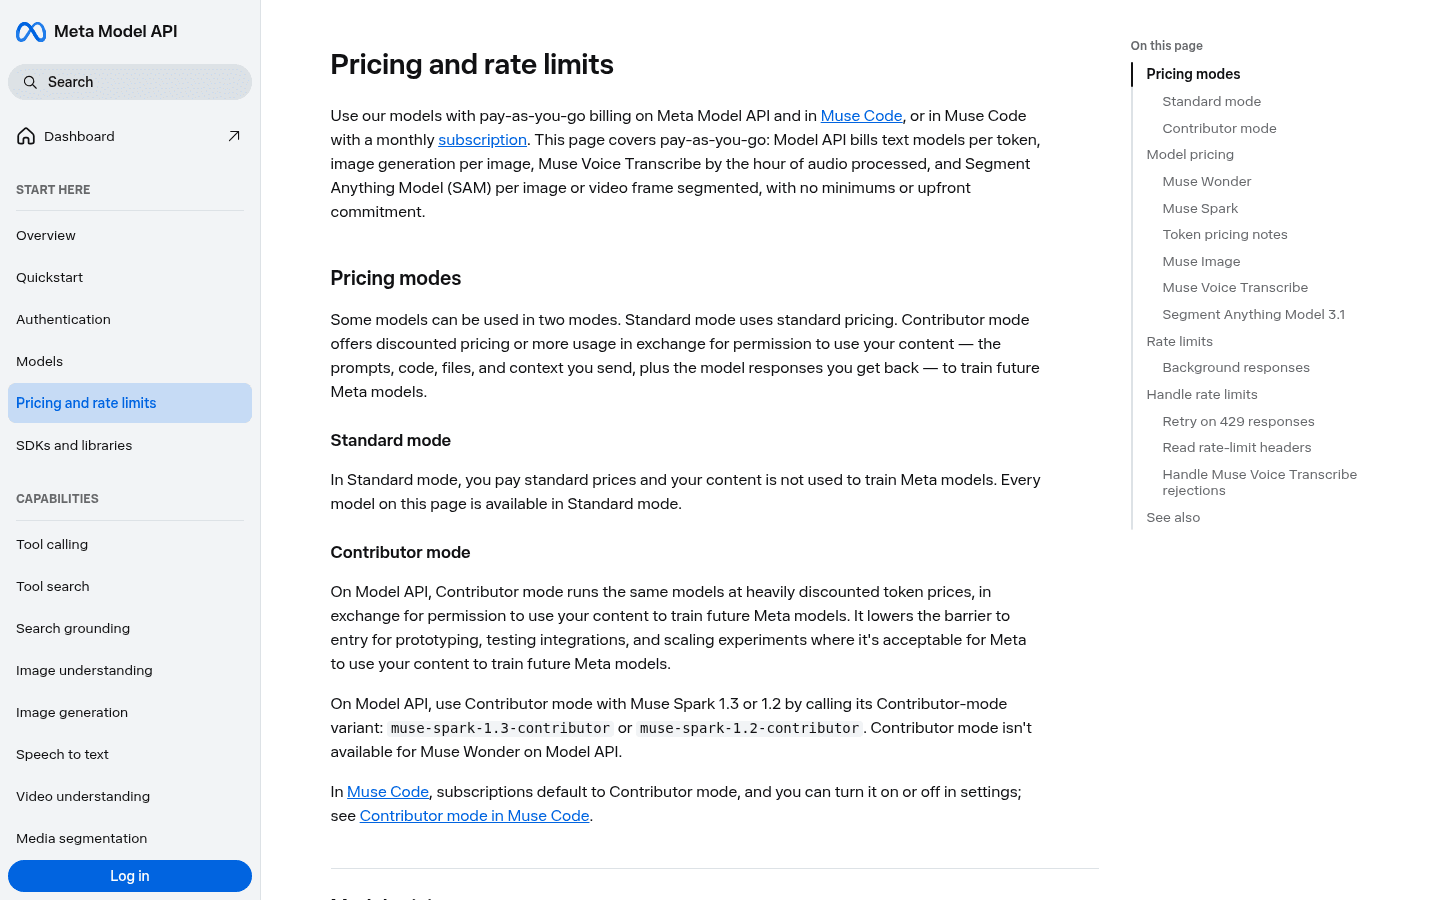
O Spark também tem algo que o Wonder não tem: uma variante Contributor na API. A página de preços da Meta explica que o muse-spark-1.3-contributor roda a preços bastante reduzidos (cerca de $0.10/$0.20) em troca de deixar a Meta treinar com seu conteúdo. O modo Contributor não está disponível para o Wonder na API. É uma boa troca para protótipos e uma ruim para dados de clientes. Mais uma coisa: o Spark 1.3 é verboso, usando cerca de 120 milhões de tokens de saída para concluir o índice da Artificial Analysis contra uma mediana de 72 milhões.
Prós: menos de um quarto do preço de saída do Wonder; mesma API, mesmo fornecedor, fácil de rotear entre os dois; desconto Contributor opcional para trabalho não sensível.
Contras: 4 pontos abaixo do Wonder no índice; verboso, o que consome a economia; os pesos abertos que a Meta prometeu para o Spark não saíram.
Preços: Standard $1.25 / $0.15 / $4.25 por 1M de tokens; variante Contributor cerca de $0.10 / $0.20 com treinamento nos seus dados. Veja preços do Muse Spark 1.3.
Minha opinião: a configuração inteligente na Meta é rotear, não escolher: Spark para a maior parte das requisições, Wonder para as longas e difíceis. Se a maior parte do seu tráfego é simples, só isso já reduz bastante a conta.
8. Gemini 3.8 Flash: a opção barata com plano gratuito
Melhor para: trabalhos em lote, protótipos e pipelines focados em custo em que ninguém espera pelo primeiro token.
Este é o espaço de "velocidade e custo" que o assistente de IA preencheu com o Gemini 3.5 Flash, que o Google desde então descontinuou. O modelo atual, o Gemini 3.8 Flash, custa $0.75 de entrada e $3.75 de saída por milhão de tokens, cerca de um quinto do preço do Wonder, e é o único modelo desta lista com plano gratuito. O Google também descontinuou o 3.7 Flash em 8 de outubro e redireciona suas requisições para o 3.8.
Pontua 41 na Artificial Analysis com esforço alto, bem abaixo do Wonder, por cerca de $1.24 por tarefa. Duas ressalvas. Primeiro, o preço dobra para $1.50/$7.50 em 1º de janeiro de 2027. Segundo, a Artificial Analysis mediu 13,30 segundos até o primeiro token, então é uma escolha ruim para qualquer coisa que uma pessoa espere, como um widget de chat.
Sobre o plano gratuito, a página de preços do Google diz que seu conteúdo é usado para melhorar seus produtos; no plano pago, não.
Prós: cerca de um quinto do preço do Wonder; plano gratuito para testes; Batch e Flex pela metade do preço; janela de 1M.
Contras: muito abaixo do Wonder no índice; primeiro token lento; o preço dobra em 1º de janeiro; o plano gratuito treina com seus dados.
Preços: $0.75 / $0.075 / $3.75 por 1M de tokens até 31 de dezembro, depois $1.50 / $0.15 / $7.50; Batch e Flex com 50% de desconto. Veja preços do Gemini 3.8 Flash.
Minha opinião: bom para o trabalho em lote noturno pelo qual você pagaria demais no Wonder. Não substitui as tarefas difíceis do Wonder, nem serve para nada ao vivo.
9. DeepSeek V4.1 Flash: pesos abertos e a menor conta
Melhor para: equipes que precisam de pesos abertos ou do menor custo possível por token.
O Muse Wonder não tem pesos abertos, e a Meta ainda não publicou os pesos que prometeu para o Muse Spark. Se você precisa de um modelo que possa rodar por conta própria, o DeepSeek V4.1 Flash é a opção mais forte aqui: pesos com licença MIT no Hugging Face, janela de contexto de 1M e até 384K tokens de saída.
A API hospedada é muito barata. A página de preços da DeepSeek lista o deepseek-flash a $0.15 de entrada e $0.60 de saída por milhão de tokens fora do pico, e $0.30/$1.20 no horário de pico (manhãs de dias úteis em UTC). Isso é cerca de 3% do preço de saída do Wonder fora do pico. A Artificial Analysis o pontua em 39.5 com esforço máximo por cerca de $0.27 por tarefa.
As desvantagens são reais. Sua taxa de alucinação na Artificial Analysis é de 96%, a maior que já vi em um modelo atual, então exige ancoragem rigorosa em fontes. A API hospedada processa dados na China, e os termos pagos não dizem se seus dados são usados para treinamento. Auto-hospedar resolve a questão dos dados, mas exige hardware sério para um modelo de 552B de parâmetros.
Prós: pesos abertos sob MIT; o menor preço desta lista; bons resultados no uso de ferramentas para o custo; 384K de saída máxima.
Contras: 12,5 pontos abaixo do Wonder no índice; taxa de alucinação muito alta; preocupações com dados na API hospedada; pesado para auto-hospedar.
Preços: fora do pico $0.003 por acerto de cache, $0.15 de entrada, $0.60 de saída por 1M de tokens; no pico, o dobro. Veja preços do DeepSeek V4.1 Flash. O Kimi K3 é a outra opção de pesos abertos, a $3/$15.
Minha opinião: escolha-o por pesos abertos ou para processar em massa texto não sensível. Mantenha-o longe de qualquer coisa em que uma resposta errada dita com confiança seja cara.
Como testar sua lista curta: as mesmas cinco tarefas para cada finalista
Esta é a parte que as tabelas de benchmarks não podem fazer por você. Escolha dois ou três finalistas acima e execute as mesmas cinco tarefas em cada um, além do próprio Wonder. Registre três números por execução: aprovado ou reprovado, custo e segundos.
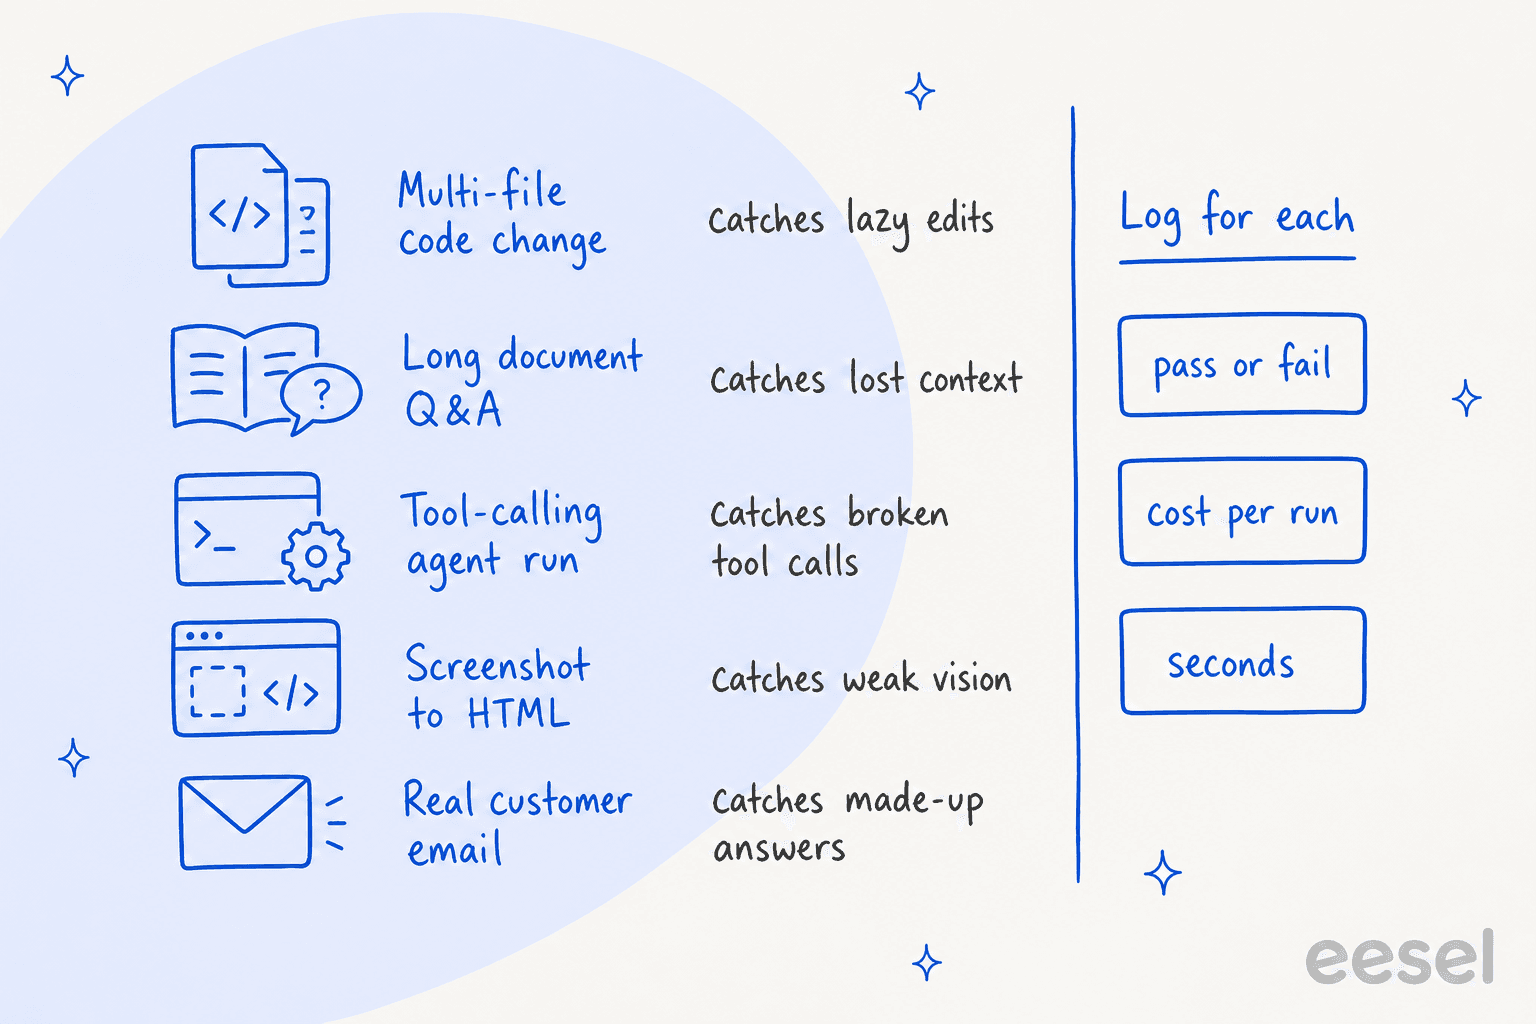
Cada tarefa está ali para pegar uma falha específica. E cada finalista tem uma tarefa que deveria vencer, se seus benchmarks forem honestos:
| Finalista | O que eu testaria primeiro | Pergunta principal |
|---|---|---|
| Claude Opus 5.5 | Captura de tela para HTML, alteração de código em vários arquivos | O Wonder vence em alguma coisa pelo mesmo preço? |
| Gemini 4 Argon | Perguntas sobre documento longo | Continua preciso com 500K tokens, e o preço de dezembro ainda fará sentido? |
| Muse Wonder Full | Alteração de código em vários arquivos no Muse Code | Vale $50 por mês a mais que o Wonder comum? |
| GPT-6.1 Sol | Execução de agente com chamadas de ferramentas | Metade do preço basta em qualidade para produção? |
| Muse Spark 1.3 ou Gemini 3.8 Flash | Os 80% mais fáceis do seu tráfego real | O modelo barato consegue assumir a maioria das requisições? |
A tarefa de captura de tela para HTML está ali por um motivo. Um desenvolvedor a executou no dia do lançamento e achou o Wonder comum muito mais fraco que o Opus 5.5, mais perto do Sonnet ou do Haiku. É o tipo de diferença que um teste de uma hora encontra e uma tabela de benchmarks esconde.
Mantenha o teste pequeno o bastante para repeti-lo. Preços e versões de modelos mudam a cada poucas semanas (o do Argon em 1º de dezembro, o do Flash em 1º de janeiro), e a maneira mais barata de continuar no modelo certo é reexecutar as mesmas cinco tarefas sempre que algo for lançado.
O que trocar de modelo significa para uma equipe de suporte
Se você é desenvolvedor, o teste acima é seu próximo passo. Se você é líder de suporte e chegou aqui pela cobertura do lançamento do Wonder, a resposta honesta é diferente: o modelo é a menor parte de um agente de suporte com IA.
Qualquer que seja o modelo escolhido, alguém ainda precisa conectá-lo ao seu helpdesk, manter suas respostas dentro do seu conhecimento aprovado, decidir quando ele passa para uma pessoa e provar que ele acerta antes de um cliente vê-lo. Esses são os trabalhos em que passo a maior parte do meu tempo, e nenhum deles muda quando o modelo muda. As notas sobre Muse para atendimento ao cliente e Muse para Zendesk mostram quanta cola é necessária com um modelo bruto.
É também por isso que os números de alucinação do DeepSeek e do Gemini Flash acima importam mais para suporte do que para código. Uma linha de código errada reprova um teste. Uma política de reembolso errada chega a um cliente. Se você vai construir por conta própria de qualquer forma, o guia do melhor modelo para tickets de suporte compara modelos especificamente para esse trabalho, e a explicação de agentes de IA vs chatbots cobre o que a camada de agente acrescenta.
Experimente a eesel
O Muse Wonder e todos os modelos desta lista são infraestrutura; a eesel é o funcionário. A eesel é uma plataforma de colegas de equipe de IA onde você contrata colegas prontos para trabalhar em tarefas específicas, e hoje são dois papéis: um colega de IA para helpdesk e um redator de blog com IA. Cada um roda em modelos de fronteira, então você aproveita as melhorias de modelo sem refazer uma disputa de modelos todo mês.
O colega de helpdesk se conecta ao Zendesk, Freshdesk ou Gorgias, aprende com seus tickets passados e sua central de ajuda e responde somente com o que você aprovou. Antes de responder a qualquer pessoa, você pode executá-lo contra seus tickets históricos e ver o que ele teria dito. Os planos têm taxa mensal fixa em que um ticket equivale a um crédito, a partir de $299 por mês por 500 créditos, com 100 créditos grátis para começar, segundo a página de preços da eesel.

Como você provavelmente é desenvolvedor se leu até aqui, vale conhecer a CLI da eesel. É um pacote npm (@eesel/cli) que controla o mesmo colega e o mesmo workspace do painel, a partir do seu terminal, de um script ou de um agente de programação como o Claude Code. eesel activity lista o que o colega fez e deixa você ler qualquer execução em detalhe, eesel approvals list mostra ações aguardando uma pessoa, e --dry-run imprime a chamada exata que uma alteração faria sem enviá-la. Todo comando imprime JSON, e seu workspace também funciona como servidor MCP, então um agente pode gerenciá-lo do mesmo jeito que você. O guia para gerenciar agentes pelo terminal mostra o passo a passo.
Se o Wonder chamou sua atenção porque você quer IA trabalhando sua fila de suporte, pule a busca por modelos e experimente a eesel com seus próprios tickets.