As 8 melhores alternativas ao Meta Muse Spark Open em 2026, comparadas por licença, preço e hardware

Rama Adi

Katelin Teen
Última edição October 18, 2026
Resumo
A melhor alternativa ao Muse Spark Open para a maioria das equipes é o GLM 5.3: ele marca 45 na tabela comparativa da própria Meta contra 39 do Muse Spark Open, por 15 centavos de dólar a mais por milhão de tokens. A licença pede um aviso de copyright e mais nada, a menos que você tenha uma empresa de hospedagem de modelos com mais de US$ 10 bilhões em receita.
Se o motivo da sua busca é custo, o DeepSeek V4.1 Flash tem licença MIT e é cerca de 7x mais barato na saída (US$ 0,60 vs US$ 4,25 por milhão de tokens, fora do pico). Se o motivo é hardware, o gpt-oss-120b roda em uma única GPU de 80GB. Se você precisa das melhores pontuações em código e visão, o Kimi K3 lidera, a US$ 15 por milhão de tokens de saída.
Fique com o Muse Spark Open se precisar da melhor pontuação em uso de ferramentas (89,2 no MCP-Atlas) e da resistência a jailbreak mais forte da categoria. E se o modelo é para uma fila de suporte, o modelo é a decisão menor: o colega de equipe de IA para helpdesk do eesel já cuida de fundamentação, testes com seus tickets anteriores e transferências para humanos, algo que nenhum modelo de pesos abertos traz de fábrica.
Por que as pessoas olham além do Muse Spark Open
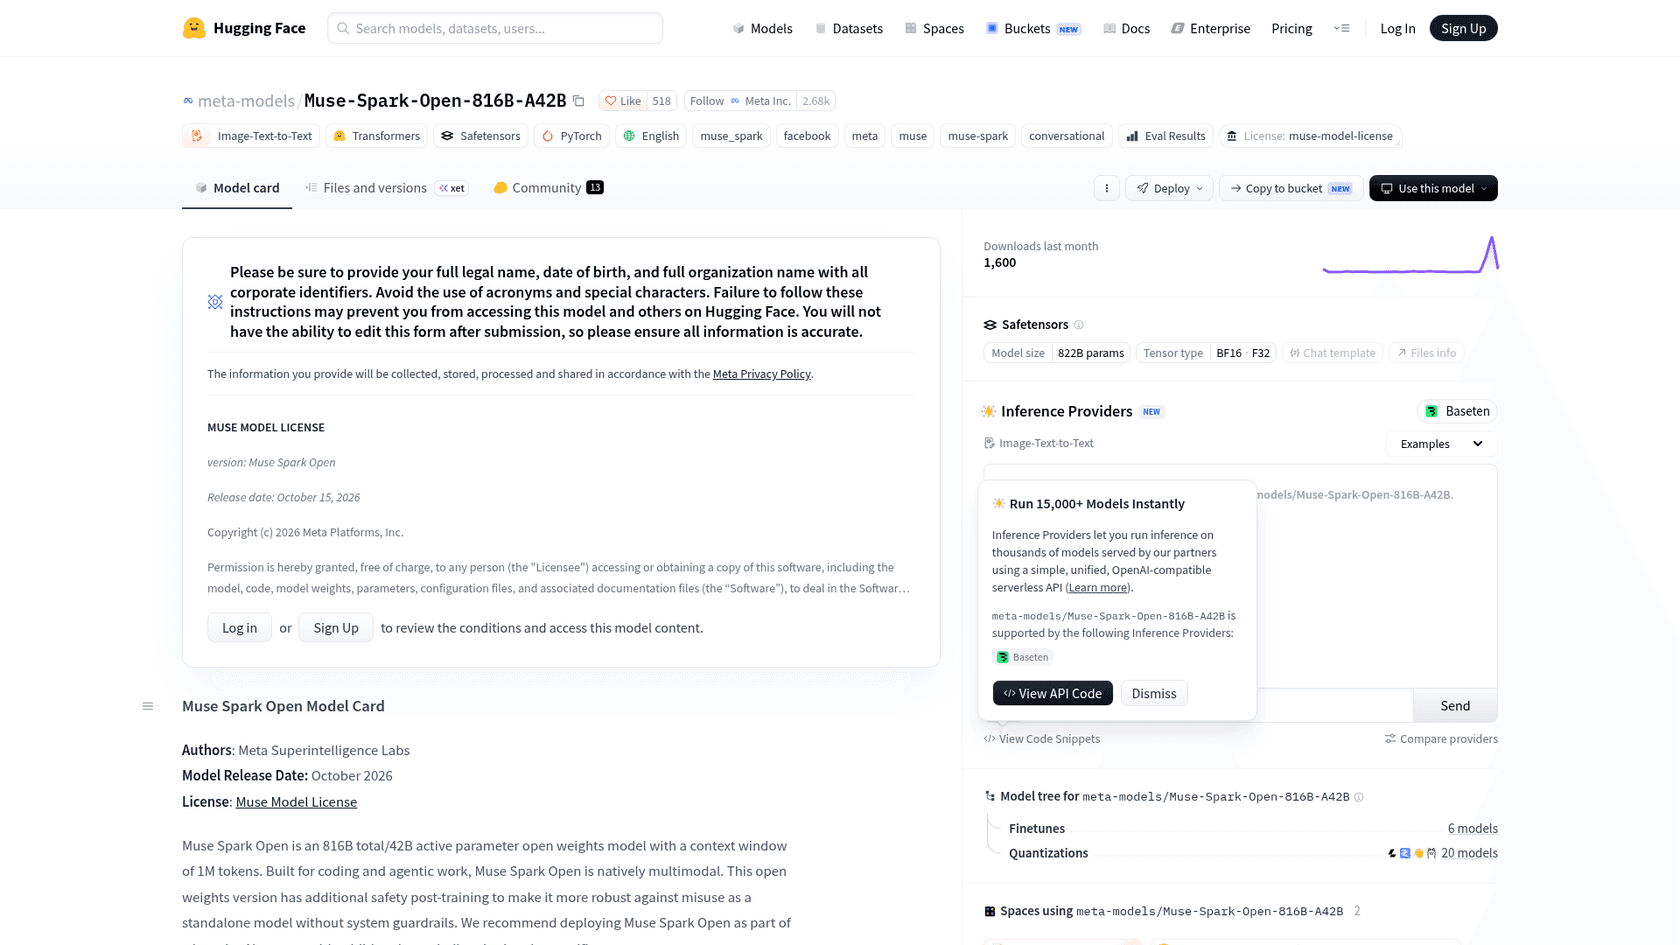
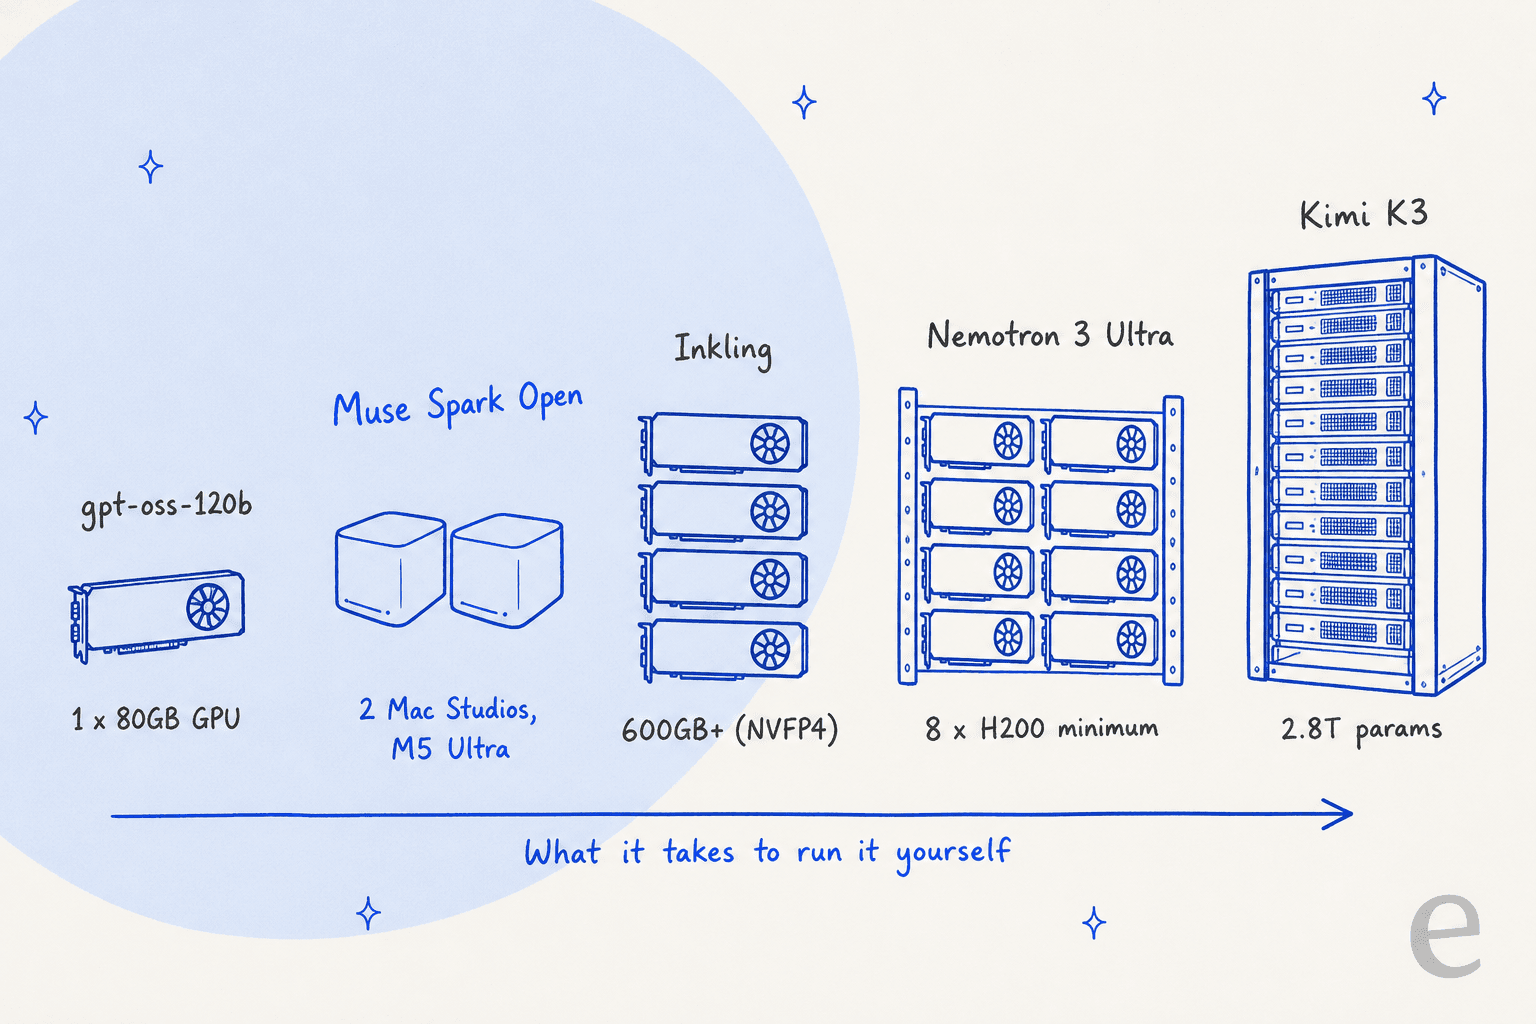
A Meta lançou o Muse Spark Open em 15 de outubro de 2026, e é um modelo sério. É uma mistura de especialistas de 816B de parâmetros com 42B ativos por token, janela de contexto de 1M de tokens e entrada nativa de texto, imagem, áudio e vídeo, segundo o blog de pesquisa da Meta. Também é o primeiro modelo da categoria que roda em cima de uma mesa: dois Mac Studios M5 Ultra, usando o MLX da Apple a 24,99 tokens por segundo.
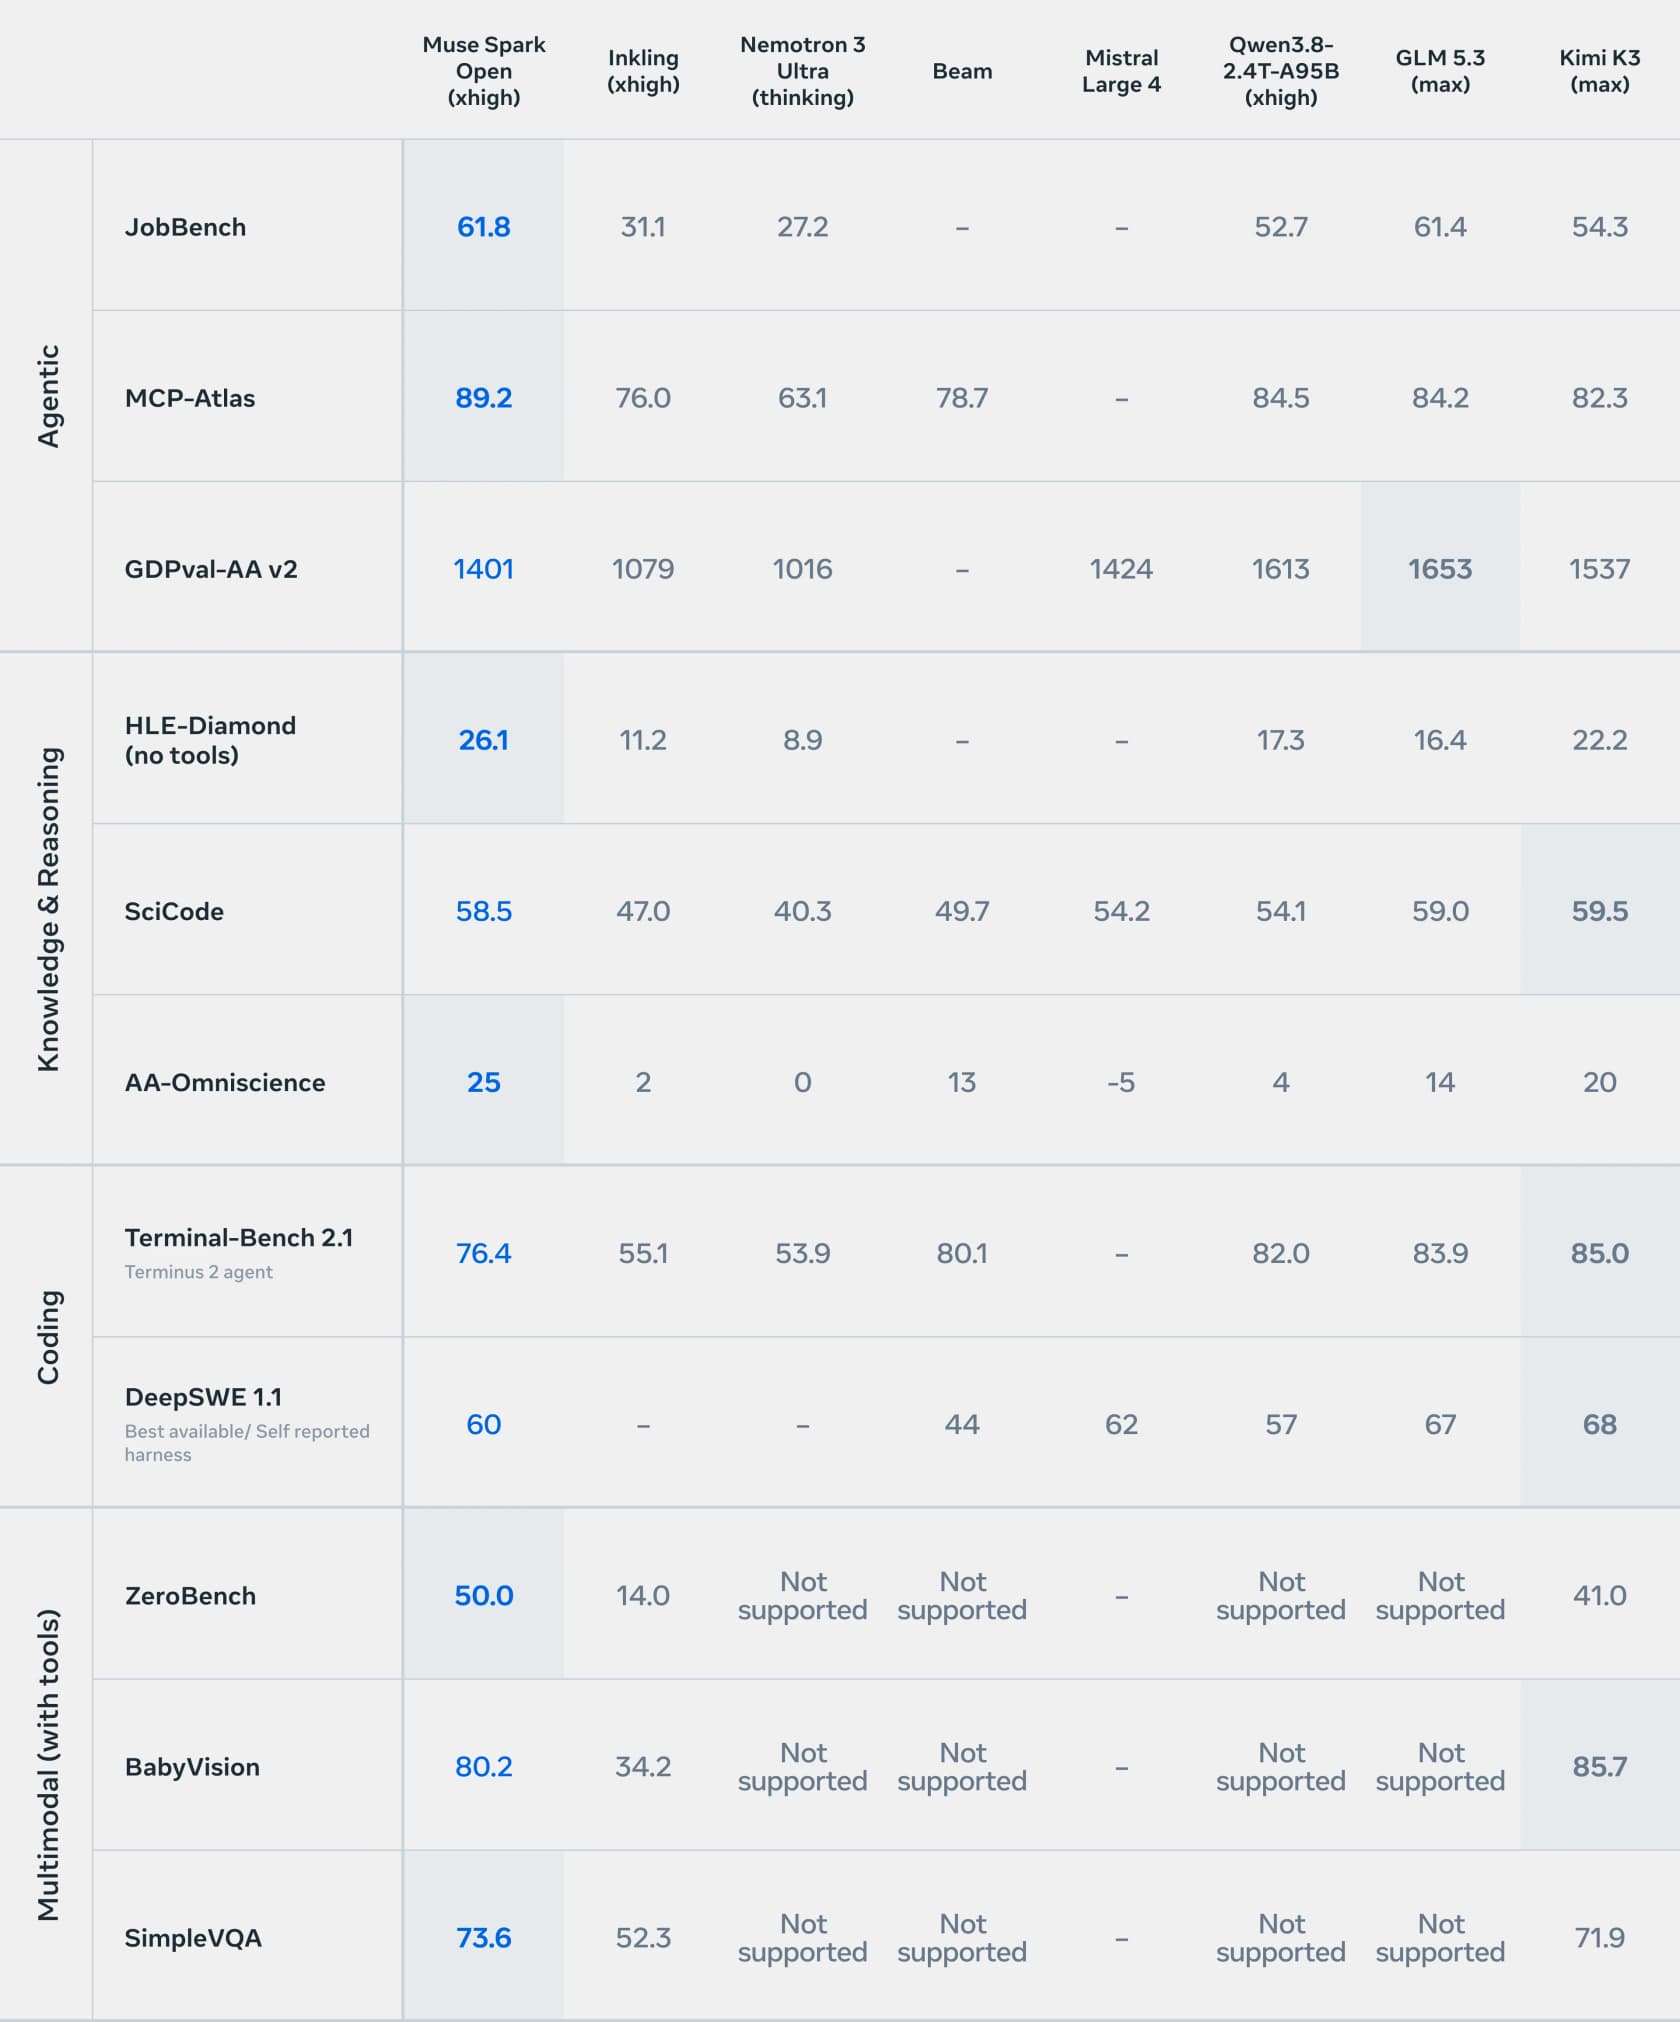
Eu construo integrações e APIs no eesel, então a primeira coisa que faço com qualquer modelo novo é ler a licença e a tabela de preços antes do gráfico de benchmarks. O Muse Spark Open tem pontos fortes reais aí. Ele lidera seus pares no model card da Meta em MCP-Atlas (89,2), JobBench (61,8) e HLE-Diamond (26,1), e marca 0,5 no StrongREJECT, enquanto todos os outros modelos da tabela ficam entre 62,9 e 86,4. Para um agente que chama ferramentas o dia todo e precisa recusar pedidos ruins, essa é uma vantagem significativa.
Mas quatro coisas aparecem sempre que as pessoas decidem olhar para outro lado:
- A pontuação. A tabela da própria Meta coloca o Muse Spark Open em 39 no Artificial Analysis Intelligence Index, atrás do GLM 5.3 (45), do Kimi K3 (44) e do Qwen3.8 (40). Ele também fica para trás em código: 60 no DeepSWE contra 68 do Kimi K3.
- A licença. A Muse Model License exige que você "prominently display 'Built with Muse Spark Open'" em todo produto que o utilize, em qualquer tamanho. Empresas de hospedagem de modelos acima de US$ 20 milhões em receita também precisam de um acordo separado com a Meta.
- O preço. Todos os provedores no OpenRouter cobram US$ 1,25 de entrada e US$ 4,25 de saída por milhão de tokens, a mesma tabela do Muse Spark 1.3 fechado. Pesos abertos costumam derrubar os preços hospedados. Aqui, não derrubaram.
- Recusas em excesso. No FORTRESS, a pontuação de recusa excessiva do Muse Spark Open é 17,4, contra 2,7 do Kimi K3 e 3,2 do GLM 5.3. O treinamento de segurança que o torna difícil de sofrer jailbreak também o faz dizer não a mais pedidos inofensivos.
O tópico de lançamento no Hacker News chegou aos mesmos dois pontos:
"The model license requires large inference providers to contact Meta separately to obtain a license to serve the model. I know we've seen this before with other large models, but it's still a bit irritating. The usual effect of separate licensing is decreased price competition from public providers (like we saw with Kimi K3)."

"Well, this is much better than nothing -- we should be grateful that whatever the market conditions and corporate incentives, a major lab is releasing a capable open-weight model. But still very far behind DeepSeek and GLM. Even on consumer hardware, Qwen 3.8 27B is going to compare favorably to this."
Como escolhi essas alternativas
Antes de escrever isto, perguntei ao ChatGPT com o que um desenvolvedor deveria comparar o Muse Spark Open e registrei as buscas que ele fez. Ele foi direto para "best open-weight language models 2026 Qwen DeepSeek Kimi GLM" e voltou com seis nomes: GLM 5.3, Kimi K3, Qwen3.8, DeepSeek V4, Mistral Large 4 e gpt-oss-120b. Mantive os seis e acrescentei os outros dois modelos abertos da tabela comparativa da própria Meta, o Nemotron 3 Ultra e o Inkling.
Toda alternativa aqui precisava cumprir três regras:
- Os pesos estão disponíveis para download hoje, ou o fornecedor tem uma promessa pública com data (só o Mistral Large 4 cai nessa categoria, e eu aviso).
- Os preços vêm da página do próprio fornecedor, ou da página de preços de um provedor nomeado quando o laboratório não vende o modelo diretamente.
- As pontuações vêm de um único lugar sempre que possível. Uso a tabela comparativa da Meta, porque ela passou todos os modelos pelo mesmo ambiente de testes, e aviso quando um número vem de outra fonte.
Comparei cada uma com as mesmas quatro perguntas: em que ela vence o Muse Spark Open, onde fica devendo, quanto custa e o que a licença exige de você.
Alternativas ao Muse Spark Open em resumo
| Modelo | Desenvolvedora | Parâmetros totais / ativos | Contexto | Tipos de entrada | Licença | Condições | Pontuação na tabela da Meta | Preço hospedado, entrada / saída por 1M | Mínimo para self-host | Raciocínio pode ser desligado |
|---|---|---|---|---|---|---|---|---|---|---|
| Muse Spark Open (referência) | Meta | 816B / 42B | 1M | Texto, imagem, áudio, vídeo | Muse Model License | Selo "Built with" em todo produto; acordo para hospedagem de modelos acima de US$ 20M de receita | 39 | US$ 1,25 / US$ 4,25 | 2 Mac Studios (M5 Ultra) | Não |
| GLM 5.3 | Z.ai | 744B / 40B | 1M | Somente texto | GLM-5.3 License (estilo MIT) | Revisão de segurança só para hospedagem de modelos acima de US$ 10B de receita | 45 | US$ 1,40 / US$ 4,40 | Não informado | Não |
| Kimi K3 | Moonshot AI | 2,8T / 104B | 1M | Texto, imagem, vídeo | Kimi K3 License (estilo MIT) | Exibir "Kimi K3" acima de 100M de usuários ou US$ 20M/mês; acordo para hospedagem de modelos acima de US$ 20M | 44 | US$ 3,00 / US$ 15,00 | Não informado (2,8T de parâmetros) | Não |
| Qwen3.8 2.4T | Alibaba | 2,4T / 95B | 262K nativo, até 1M | Somente texto (base aberta) | Qwen3.8 License | Exibir o nome acima de 100M de usuários ou US$ 20M/mês; licença para hospedagem de modelos acima de US$ 50M | 40 | US$ 2,00 / US$ 6,00 (Qwen3.8 Max) | Não informado | Não (base aberta) |
| DeepSeek V4.1 Flash | DeepSeek | 552B (8B / 16B ativos) | 1M | Texto, imagem | MIT | Manter o aviso de copyright | Fora da tabela | US$ 0,15 / US$ 0,60 fora do pico | Não informado | Sim |
| gpt-oss-120b | OpenAI | 117B / 5,1B | 128K | Somente texto | Apache 2.0 | Avisos na redistribuição | Fora da tabela | US$ 0,15 / US$ 0,60 (Together) | 1 GPU de 80GB | Não (low / medium / high) |
| Mistral Large 4 | Mistral AI | 1,05T / 52B | 1M | Texto, imagem | Ainda não divulgada | Pesos previstos para o fim de outubro | 38 | US$ 0,68 / US$ 2,09 (promoção) | Não informado | Modelo híbrido |
| Nemotron 3 Ultra | NVIDIA | 550B / 55B | Até 1M (262K na configuração) | Somente texto | OpenMDW-1.1 | Avisos na redistribuição | 23 | US$ 0,50 / US$ 2,20 (DeepInfra) | 8 x H200 | Sim |
| Inkling | Thinking Machines Lab | 975B / 41B | 1M | Texto, imagem, áudio | Apache 2.0 + política de uso | Política de uso (aviso de IA) | 26 | US$ 1,00 / US$ 4,05 | 600GB+ (NVFP4) | Controle de esforço |
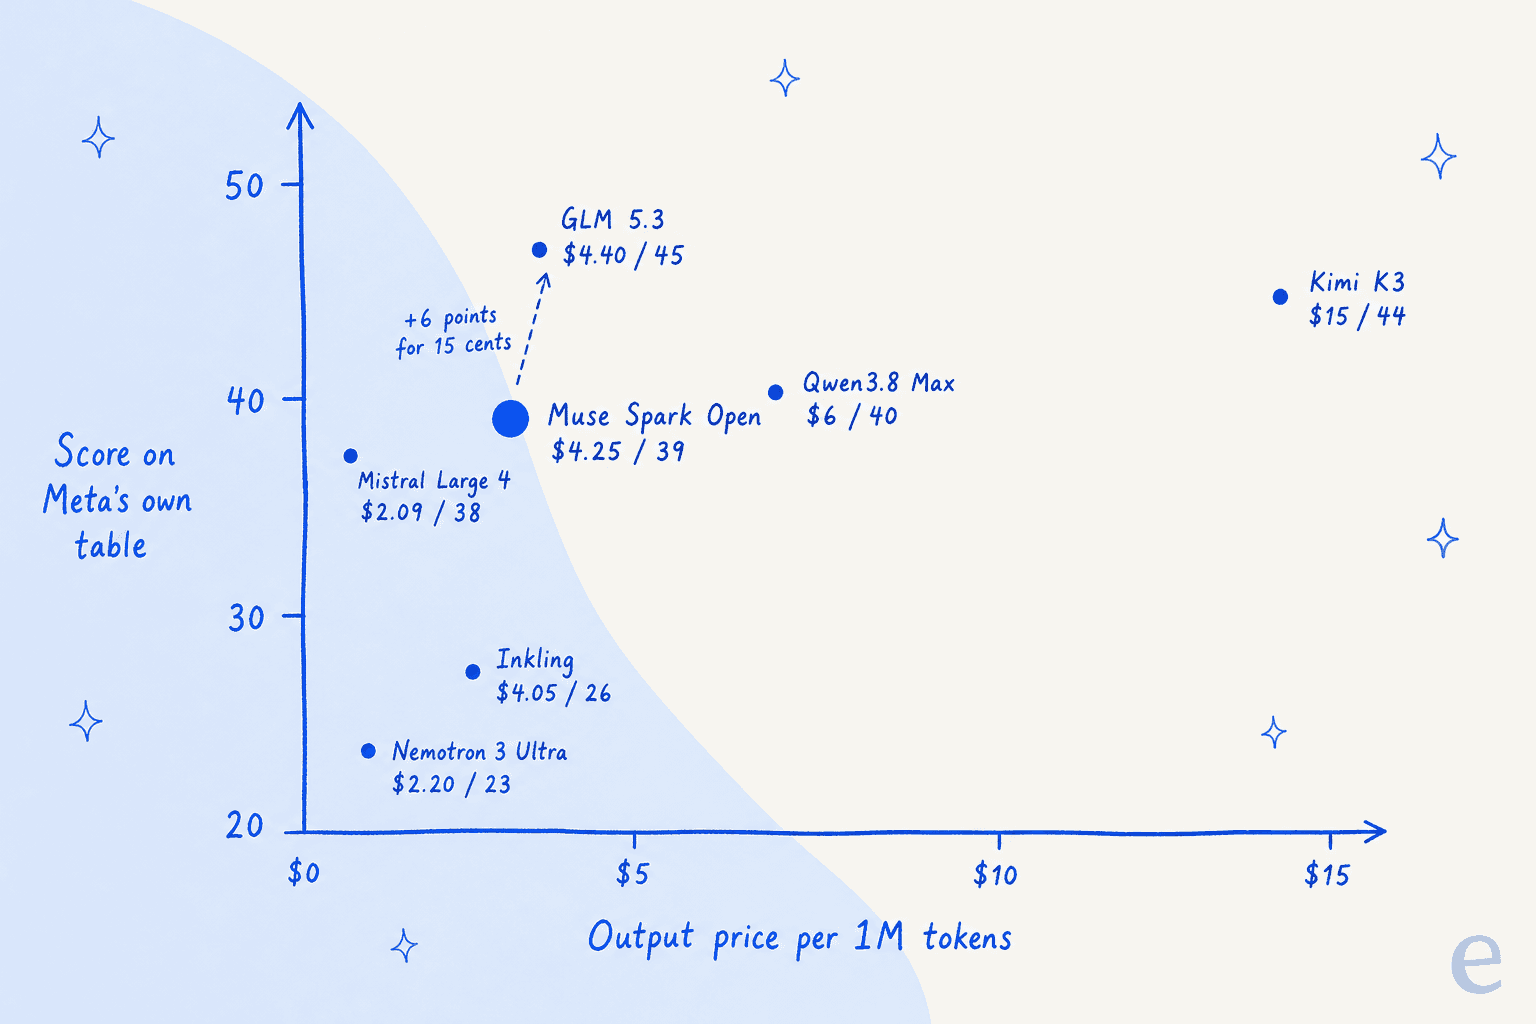
O gráfico é o argumento inteiro em uma imagem. O Muse Spark Open está no meio do pelotão em preço e pontuação. O GLM 5.3 está quase exatamente acima dele. O Kimi K3 compra alguns pontos com uma conta muito maior, e o Mistral Large 4 é mais barato por quase a mesma pontuação, mas por enquanto só em uma API de prévia.
Qual alternativa combina com o seu motivo para sair?
A maioria das pessoas não está deixando o Muse Spark Open por "um modelo melhor" em geral. Está saindo por um motivo específico. Escolha o seu e a indicação correspondente aparece abaixo.
Escolha o motivo que está afastando você do Muse Spark Open para ver a alternativa que eu testaria primeiro. Todos os números vêm das páginas dos fornecedores e da tabela da Meta citadas abaixo.
1. GLM 5.3
Melhor para: equipes que querem uma evolução direta do Muse Spark Open pelo quase mesmo preço, com uma licença mais leve.
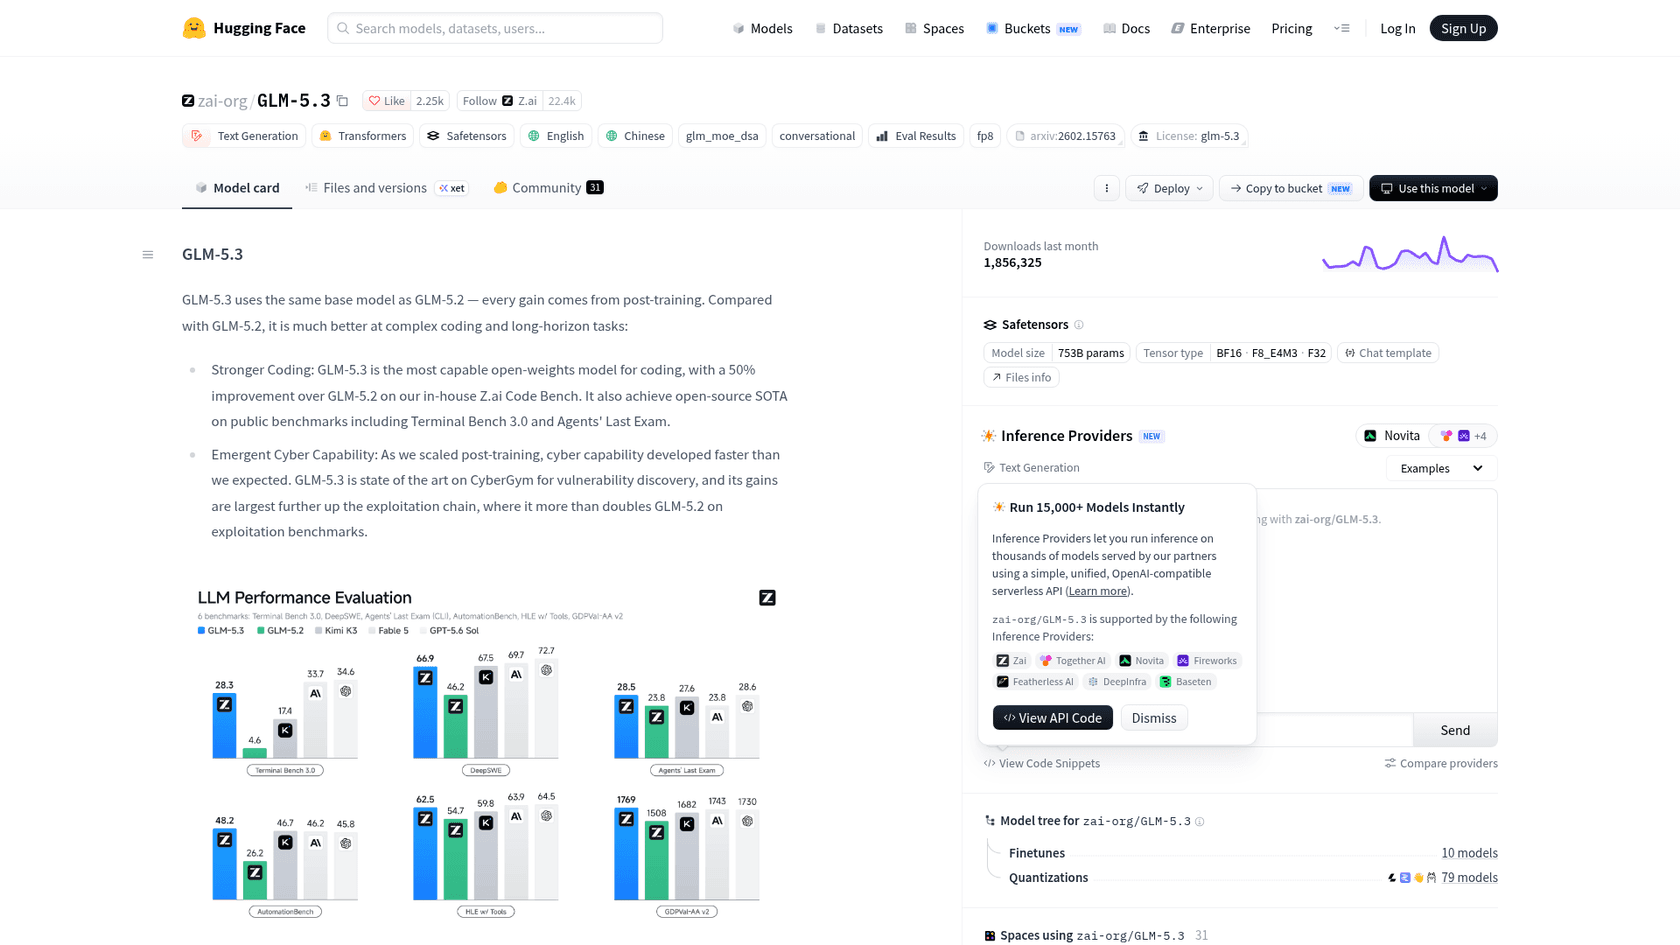
O GLM 5.3 é o modelo principal da Z.ai, lançado em 14 de agosto de 2026. É uma mistura de especialistas de 744B de parâmetros com 40B ativos, segundo a tabela de download do GLM-5 da Z.ai, com contexto de 1M de tokens e até 128K de tokens de saída. É o mesmo modelo base do GLM-5.2, e o model card diz que "every gain comes from post-training." Não confunda com o menor GLM 5.3 Flash, que tem outra base, de 320B.
Em que ele vence o Muse Spark Open. Na própria tabela da Meta, o GLM 5.3 tem a maior pontuação no Intelligence Index entre os modelos abertos (45 vs 39), a melhor pontuação no GDPVal-AA v2 (1653 vs 1401) e lidera no HLE com ferramentas (62,5 vs 61,0), no DeepSWE (67 vs 60) e no Terminal-Bench 2.1 (83,9 vs 76,4). Ele também recusa muito menos pedidos inofensivos (recusa excessiva no FORTRESS 3,2 vs 17,4).
Onde fica devendo. É somente texto, então não há entrada de imagem, áudio ou vídeo. O raciocínio não pode ser desligado; a documentação da Z.ai diz "disabling reasoning is no longer supported," e os níveis de esforço são low, high e max. Perde para o Muse Spark Open no MCP-Atlas (84,2 vs 89,2) e sofre jailbreak com muito mais facilidade (StrongREJECT 62,9 vs 0,5).
"Feels dumber than GLM 5.3 (only open model I use extensively). But is really fast (fireworks.ai)."
Preço e licença. A página de preços da Z.ai lista o GLM 5.3 a US$ 1,40 por milhão de tokens de entrada, US$ 0,26 em cache e US$ 4,40 de saída, sem mudança desde o lançamento. São 15 centavos de dólar a mais que o Muse Spark Open tanto na entrada quanto na saída. A GLM-5.3 License é estilo MIT com uma condição: uma empresa de hospedagem de modelos cuja receita do grupo ultrapasse US$ 10 bilhões deve passar pela revisão de segurança da Z.ai. Produtos que embutem o modelo em um recurso ficam fora dessa definição, e não há regra de exibição.
| Plano | Entrada por 1M | Entrada em cache por 1M | Saída por 1M |
|---|---|---|---|
| GLM 5.3 | US$ 1,40 | US$ 0,26 | US$ 4,40 |
| GLM 5.3 FlashX | US$ 0,37 | US$ 0,075 | US$ 1,25 |
| GLM 5.3 Flash | US$ 0,15 | US$ 0,03 | US$ 0,50 |
Veredito: Esta é a alternativa que eu testaria primeiro. Se você não precisa de entrada multimodal, o GLM 5.3 dá uma pontuação maior, menos recusas e uma licença mais folgada por 15 centavos de dólar a mais por milhão de tokens. Descarte-o apenas se imagens, áudio ou precisão na chamada de ferramentas forem o núcleo da sua carga de trabalho.
2. Kimi K3
Melhor para: agentes de código e trabalho multimodal em que a qualidade importa mais que a conta de tokens.
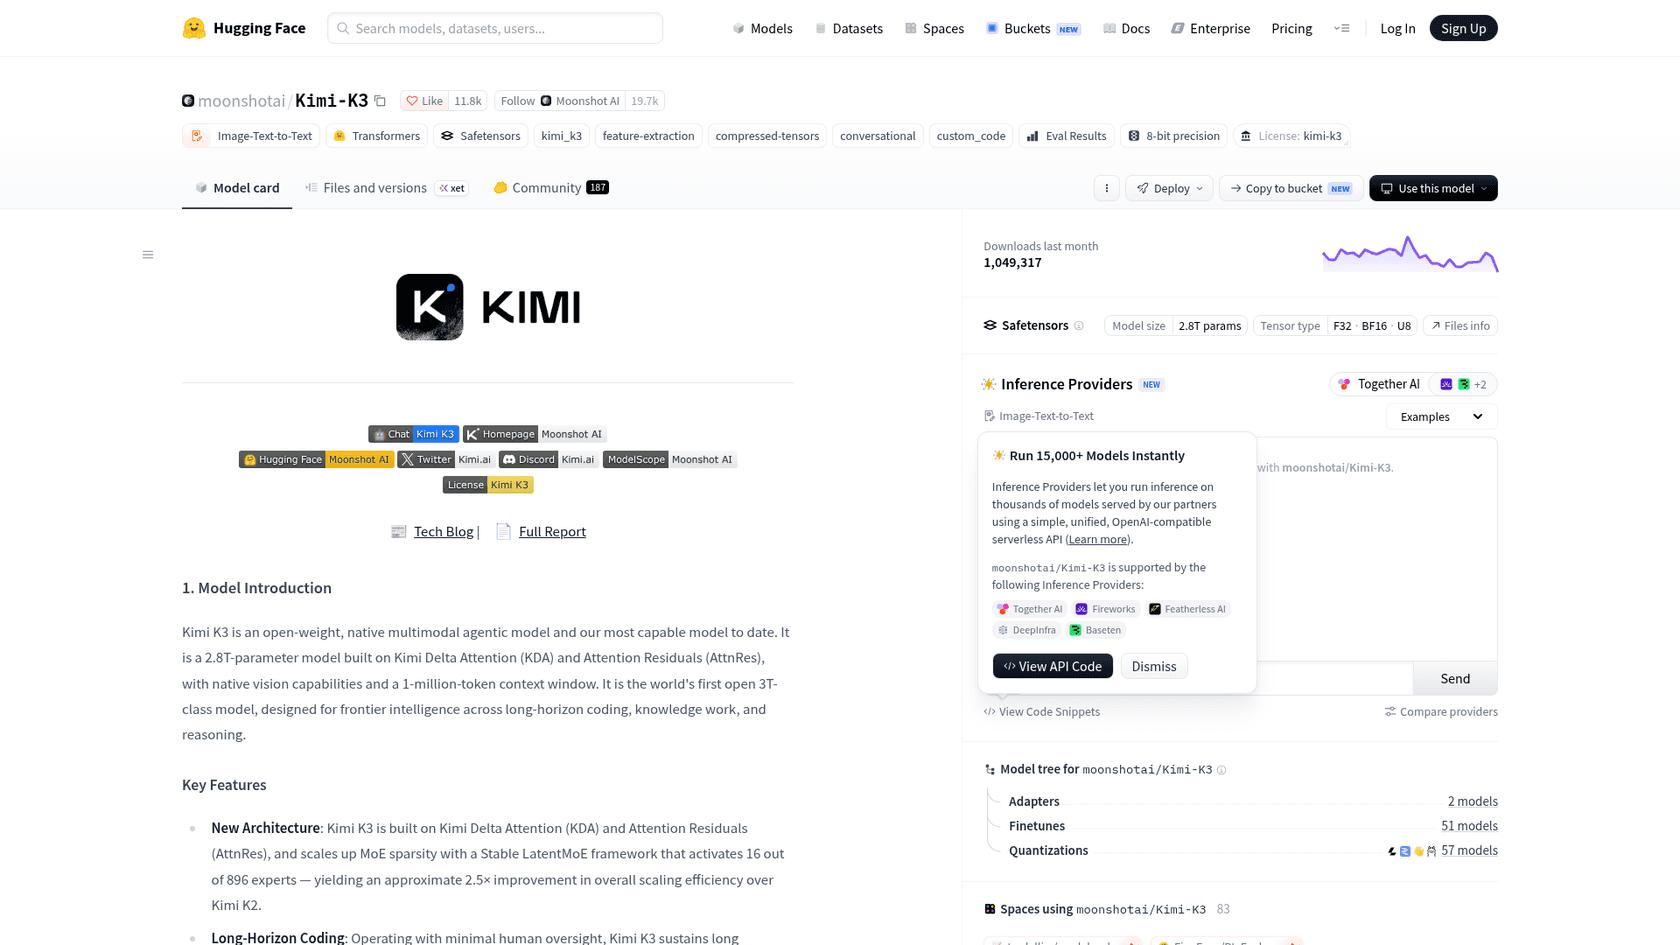
O Kimi K3 é o modelo principal da Moonshot AI, lançado em julho de 2026 com pesos no Hugging Face. É o maior modelo aqui: 2,8T de parâmetros totais, 104B ativos, 896 especialistas com 16 escolhidos por token. Ele lê texto, imagens e vídeo de forma nativa e mantém 1M de tokens de contexto, com saída configurável de até 1.048.576 tokens segundo o quickstart do K3.
Em que ele vence o Muse Spark Open. O Kimi K3 é o líder em código na tabela da Meta: DeepSWE 68 vs 60, SWE-Atlas-QnA 66 vs 58, Terminal-Bench 2.1 85,0 vs 76,4. Também vence no OSWorld Verified (84,8 vs 80,4), no Toolathlon (76,5 vs 72,8) e no benchmark de vídeo VideoMMEv2 (65,4 vs 61,5). Tem a menor pontuação de recusa excessiva do conjunto, 2,7.
Onde fica devendo. O Muse Spark Open o supera no MCP-Atlas (89,2 vs 82,3), no JobBench (61,8 vs 54,3) e em segurança. O card da Meta relata que o Kimi K3 recusou apenas 75,5% dos jailbreaks no benchmark interno de ciber da Meta, contra 99,2% do Muse Spark Open. O raciocínio não pode ser desligado, e a API não aceita URLs públicas de imagem, apenas base64 ou IDs de arquivos enviados.
Preço e licença. A página de preços da Moonshot lista US$ 3,00 por milhão de tokens de entrada, US$ 0,30 em cache e US$ 15,00 de saída, valor fixo em todo o contexto de 1M. Um detalhe novo: as gravações em cache agora são cobradas à parte, a US$ 3,00 por milhão para um cache de 5 minutos e US$ 6,00 para um cache de 1 hora. A Kimi K3 License é parecida com a do Muse Spark Open no lado da hospedagem (um acordo separado para empresas de hospedagem de modelos acima de US$ 20 milhões por ano), mas sua regra de exibição só vale acima de 100 milhões de usuários mensais ou US$ 20 milhões de receita mensal.
"I believe it's because they are below $20 Million revenue limit (which Kimi K3's license has) So we won't see any price decrease unless Kimi changes the license of K3"
Veredito: O Kimi K3 é a escolha quando as pontuações em código decidem o projeto. Ele custa 3,5x o preço de saída do Muse Spark Open, então eu só recorreria a ele para os trabalhos que realmente precisam, e mandaria todo o resto para algo mais barato. Meu detalhamento de preços do Kimi K3 tem as contas de custo.
3. Qwen3.8
Melhor para: equipes que querem uma única família de modelos que escale de um Mac até um modelo principal hospedado.
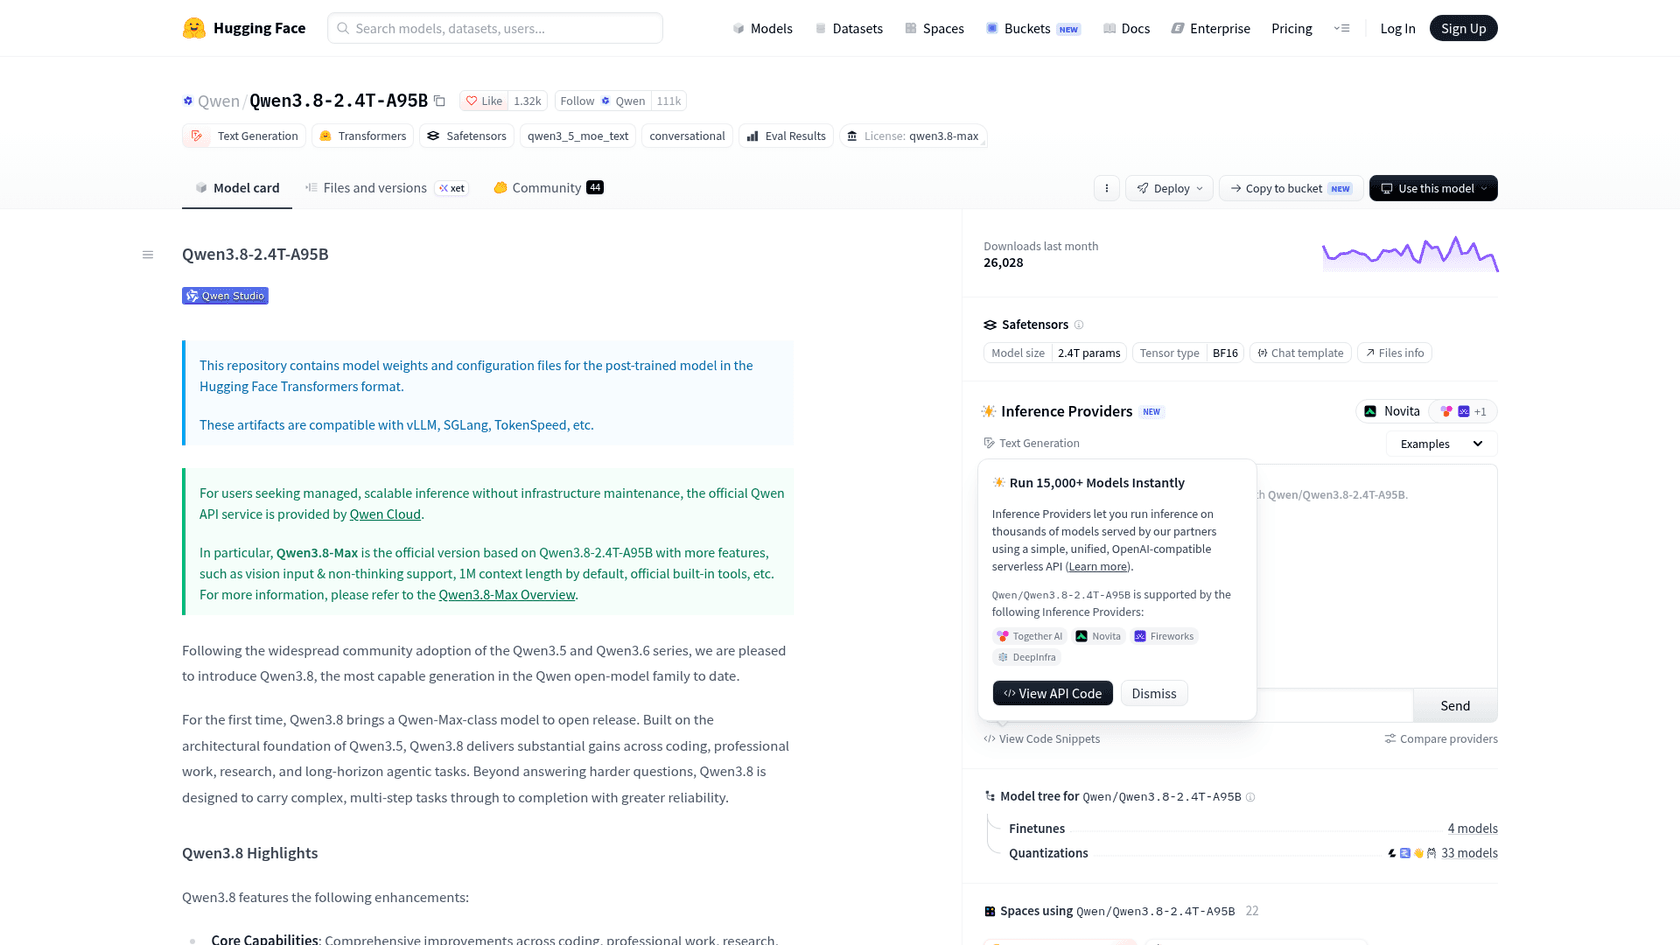
O Qwen3.8 são, na verdade, dois lançamentos abertos. O grande, Qwen3.8-2.4T-A95B, é uma mistura de especialistas de 2,4T de parâmetros com 95B ativos. Seu contexto é de 262.144 tokens nativos, extensível a cerca de 1M. O pequeno, Qwen3.8-27B, é um modelo denso de 27B que lê imagens e vídeo e permite desligar o raciocínio a cada requisição. O Qwen3.8 Max hospedado é construído sobre a base grande, com visão, modo sem raciocínio e ferramentas integradas adicionados.
Em que ele vence o Muse Spark Open. Na tabela da Meta, a base aberta de 2,4T marca 40 no Intelligence Index (um ponto à frente), empata com o Kimi K3 na melhor pontuação de GPQA Diamond (93,5 vs 89,0) e vence o Muse Spark Open no Terminal-Bench 2.1 (82,0 vs 76,4), no SWE-Atlas-QnA (62 vs 58) e no GDPVal-AA v2 (1613 vs 1401). O de 27B é a verdadeira surpresa: os benchmarks do MLX da Apple mostram que ele cabe em um Mac Studio usando até 68GB de memória com contexto de 65.536 tokens.
Onde fica devendo. A base aberta de 2,4T é mais limitada do que as pessoas esperam. O model card diz que ela "is a text-only model that requires thinking mode for all interactions," então os recursos de visão e de modo sem raciocínio pertencem apenas ao Max hospedado. Fica atrás do Muse Spark Open no MCP-Atlas (84,5 vs 89,2), no JobBench (52,7 vs 61,8) e no HLE-Diamond (17,3 vs 26,1).
"From running small models like Qwen3.8-27B to large models like Qwen3.8-2.4T. I can tell you that small models will never be enough or match up. Everyone will want the smartest model, not just a good enough model."
Preço e licença. A Alibaba não vende a base aberta diretamente. O caminho hospedado é o Qwen3.8 Max no QwenCloud, a US$ 2 de entrada e US$ 6 de saída por milhão de tokens, com acertos de cache implícito a US$ 0,25. O de 27B agora tem sua própria página hospedada, a US$ 0,50 de entrada e US$ 3 de saída. A base de 2,4T sai sob a Qwen3.8 License, com regra de exibição acima de 100 milhões de usuários mensais ou US$ 20 milhões de receita mensal, e uma licença separada para empresas de hospedagem de modelos ou de assistentes de trabalho com IA acima de US$ 50 milhões. O de 27B é Apache 2.0 simples.
| Modelo | Entrada por 1M | Entrada em cache por 1M | Saída por 1M | Licença |
|---|---|---|---|---|
| Qwen3.8 Max (hospedado) | US$ 2,00 | US$ 0,25 (implícito) | US$ 6,00 | Somente hospedado |
| Qwen3.8-27B (hospedado) | US$ 0,50 | US$ 0,10 (implícito) | US$ 3,00 | Apache 2.0 |
| Qwen3.8-2.4T-A95B | Self-host ou terceiros | n/a | n/a | Qwen3.8 License |
Veredito: O Qwen3.8 é a escolha da família. Use o de 27B onde você usaria um modelo Muse pequeno em um notebook ou em um Mac, e o Max hospedado quando precisar do grande. Se quiser o de 2,4T pelos pesos abertos, lembre que ele é somente texto. Para comparações diretas, veja Qwen3.8 Max vs Kimi K3.
4. DeepSeek V4.1 Flash
Melhor para: cargas de trabalho de alto volume em que o custo por token decide tudo.
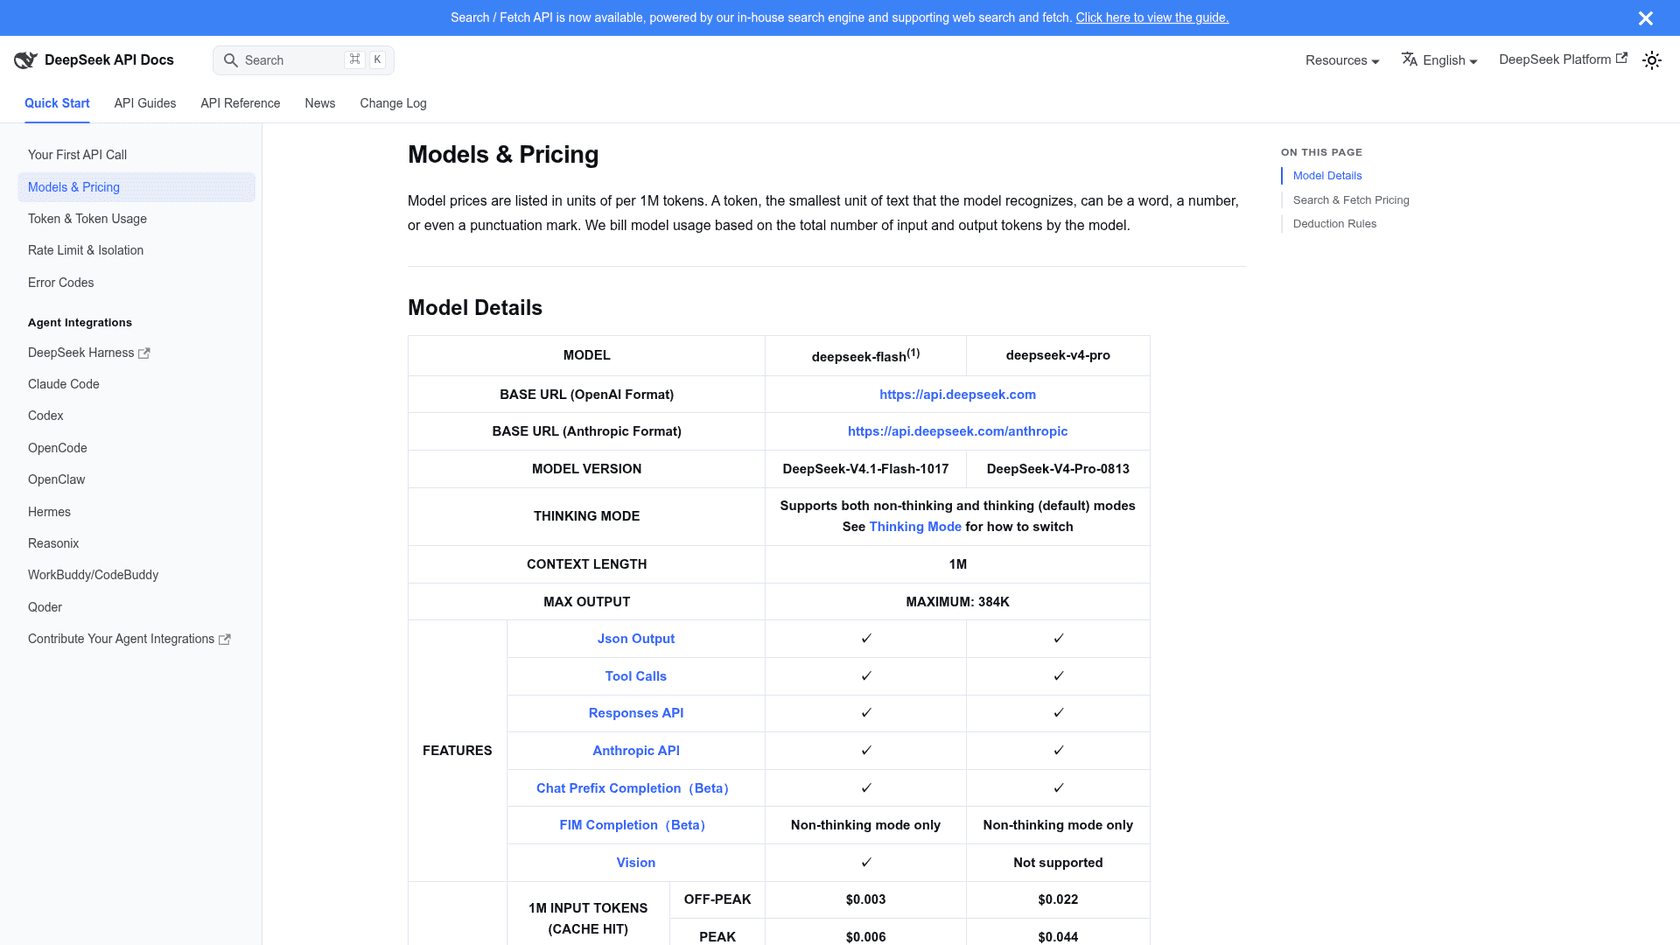
O DeepSeek V4.1 Flash foi lançado em 10 de setembro de 2026 e recebeu uma atualização em 17 de outubro: o DeepSeek-V4.1-Flash-1017, que o DeepSeek descreve como tendo "stronger benchmark performance, faster task completion, and shorter outputs than the previous version." É uma mistura de especialistas de 552B de parâmetros com uma divisão incomum: 8B de parâmetros ativos para ler a entrada e 16B para escrever a saída, segundo as notas de lançamento. Tem contexto de 1M, até 384K tokens de saída e entrada de visão.
Em que ele vence o Muse Spark Open. Preço, de longe. E no card do próprio DeepSeek para a versão 1017, o DeepSWE v1.1 sobe para 77,0, o que superaria todos os modelos da tabela da Meta, embora seja um número do fornecedor, de outro ambiente de testes. O DeepSeek não está na comparação da Meta. Um comentarista no tópico de lançamento do Muse Spark Open apontou que o Artificial Analysis colocava o V4.1 Flash anterior na mesma pontuação do Muse Spark Open:
"Crucially, it's about the same as DeepSeek v4.1 Flash, and about 10x more expensive to run...
No thanks..."
Onde fica devendo. Os tokens de raciocínio são cobrados como saída, e o raciocínio vem ligado por padrão, então uma tarifa barata ainda pode virar uma conta grande em respostas longas. Os termos da API paga não dizem se o DeepSeek treina com as suas entradas, e não há opção publicada de retenção zero, o que importa se você planeja enviar dados de clientes à API do próprio DeepSeek. Hospedar você mesmo os pesos MIT, ou usar um provedor terceiro, evita essa dúvida.
Preço e licença. A página de preços do DeepSeek tem duas tarifas. O horário de pico é 01:00-04:00 e 06:00-10:00 UTC em dias úteis; todo o resto é fora do pico, com metade do preço.
| Tarifa | Entrada com cache hit por 1M | Entrada com cache miss por 1M | Saída por 1M |
|---|---|---|---|
| Fora do pico | US$ 0,003 | US$ 0,15 | US$ 0,60 |
| Pico | US$ 0,006 | US$ 0,30 | US$ 1,20 |
Os pesos são MIT: mantenha o aviso de copyright, e pronto. Sem limites de receita, sem regra de exibição.
"I've been using DS v4.1 Flash daily for nearly a month now on Agent Swarm experiments. I've tested it against GLM-5.3-flash and Opus 5.5. DS 4.1 comes out tops for me. Opus 5.5 is still the smartest, but DS 4.1's speed and price more than make up for the "intelligence" gap."
Veredito: Se você ia chamar o Muse Spark Open milhões de vezes por dia, rode primeiro o mesmo conjunto de testes no DeepSeek V4.1 Flash. A US$ 0,60 por milhão de tokens de saída fora do pico, ele é cerca de 7x mais barato sob a licença mais permissiva desta lista. Veja os preços do DeepSeek V4.1 Flash para as contas do horário de pico.
5. gpt-oss-120b
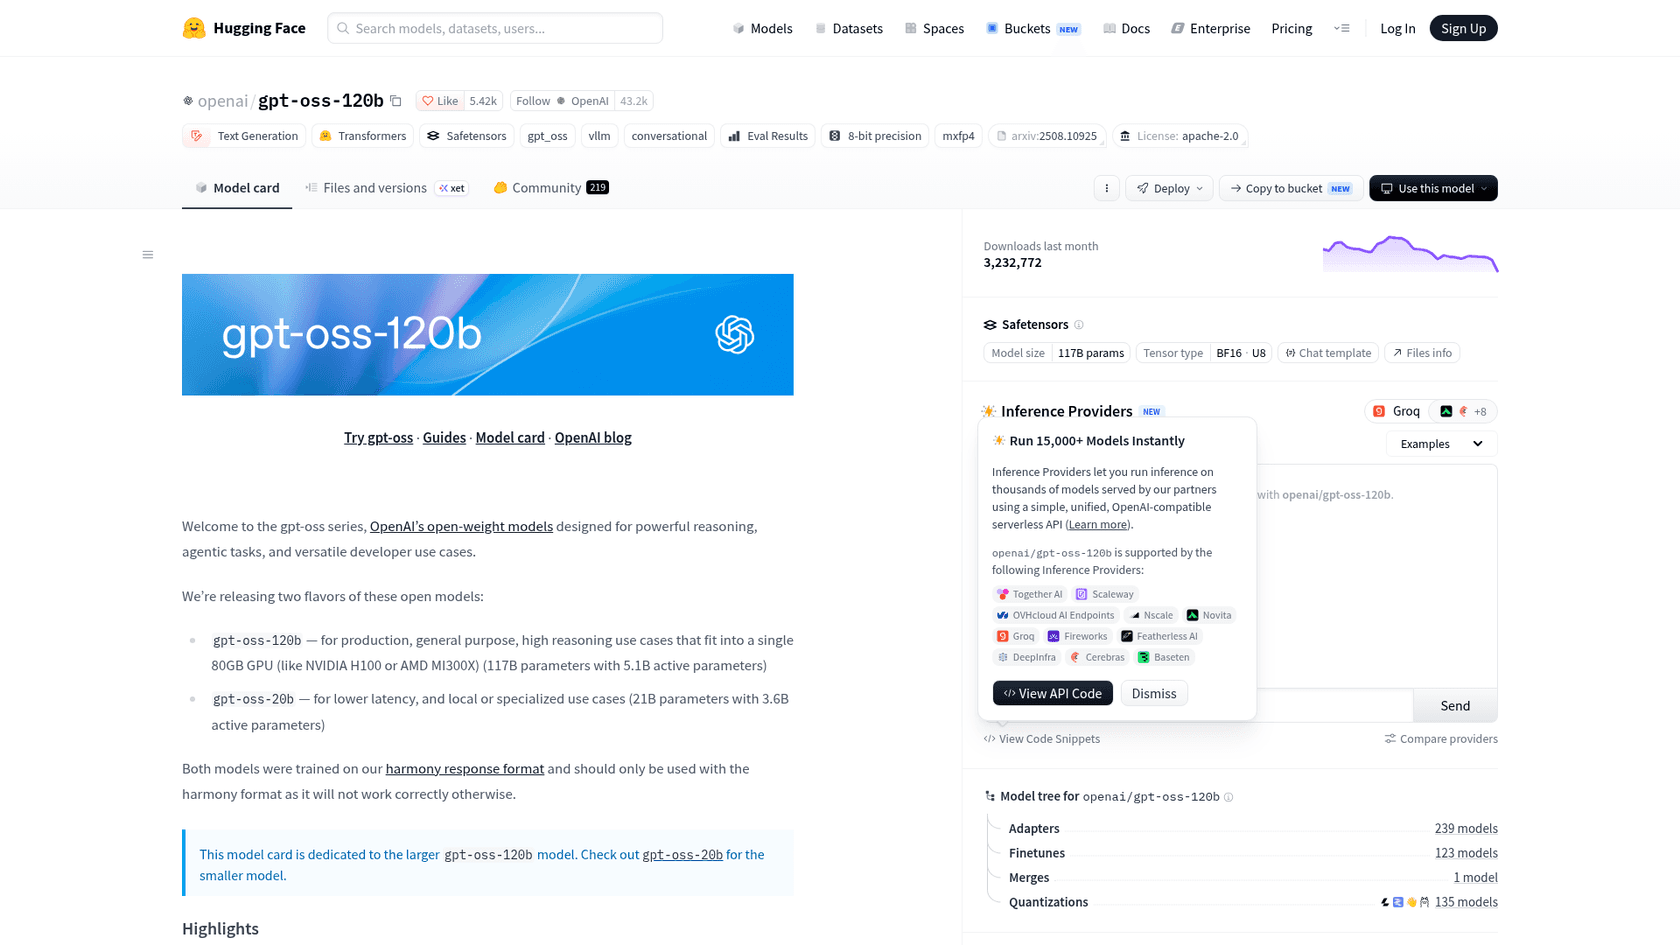
Melhor para: equipes que precisam fazer self-host em uma única GPU e qualquer pessoa que queira uma referência barata para testar modelos maiores.
O gpt-oss-120b é o modelo de pesos abertos da OpenAI de agosto de 2025. Tem 117B de parâmetros totais com apenas 5,1B ativos por token, quantizado para rodar "on a single 80GB GPU (like NVIDIA H100 or AMD MI300X)," segundo o model card. É somente texto, com contexto de 128K e três níveis de raciocínio (low, medium, high) definidos no prompt de sistema.
Em que ele vence o Muse Spark Open. Hardware e custo. O Muse Spark Open exige dois Mac Studios com até 512GB de memória cada, segundo a Apple; o gpt-oss-120b exige uma placa. Isso o torna a única alternativa aqui que uma equipe pequena pode realisticamente rodar no próprio servidor ou em uma conta de nuvem privada.
Onde fica devendo. Tem 14 meses, e a OpenAI não lançou um gpt-oss mais novo desde então; os lançamentos posteriores são classificadores de segurança. Não está na tabela comparativa da Meta, e o contexto de 128K é um oitavo do do Muse Spark Open. Também só funciona direito com o formato de resposta harmony da OpenAI; o card diz que ele "will not work correctly otherwise."
"The finding that flips the usual story is the sparse-MoE reversal: on gpt-oss-120b the A100 comes in cheaper per output token than the H100, because the workload is latency-tolerant and the MXFP4 experts fit in 80GB."
Preço e licença. A OpenAI não o vende, então os preços hospedados vêm de provedores. A página de preços da Together AI lista US$ 0,15 de entrada e US$ 0,60 de saída por milhão de tokens, o mesmo que a tarifa fora do pico do DeepSeek. A licença é Apache 2.0, e a política de uso é uma linha sobre cumprir a lei.
Veredito: O gpt-oss-120b não vai igualar o Muse Spark Open em tarefas difíceis de agente, e eu não fingiria o contrário. Mas é o modelo de controle certo: rode sua avaliação nele primeiro e você saberá quanto do tamanho extra do Muse Spark Open você realmente usa. Provedores como Together AI e Groq servem o modelo.
6. Mistral Large 4
Melhor para: equipes europeias que querem um modelo treinado e hospedado na UE e podem esperar algumas semanas pelos pesos.
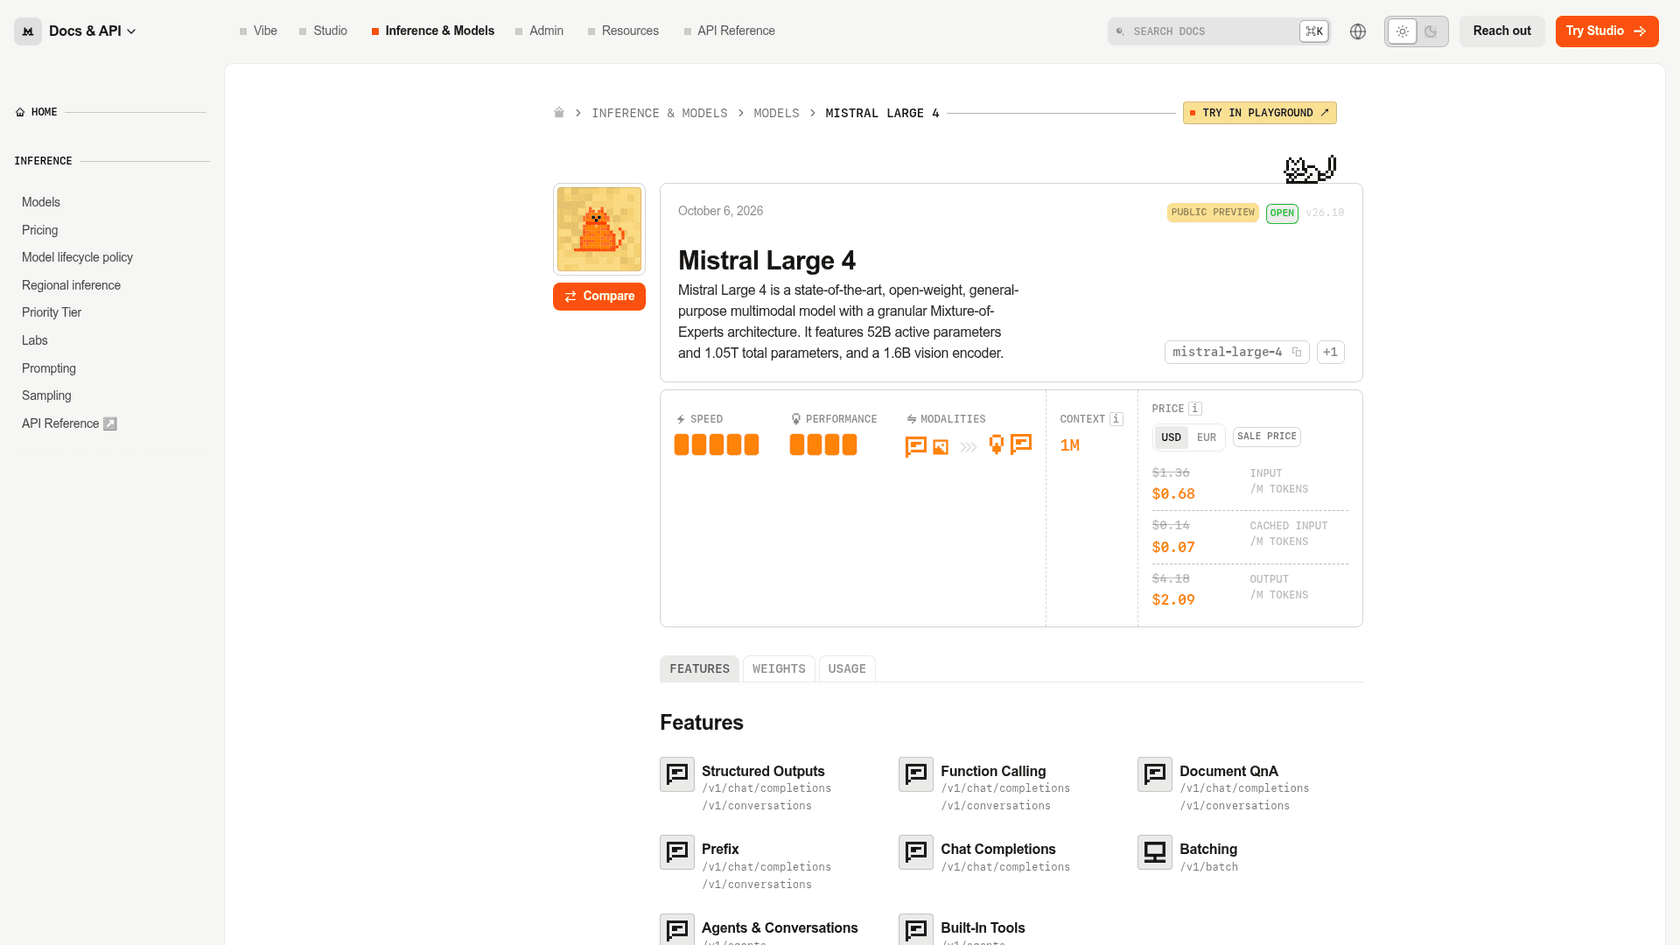
O Mistral Large 4 entrou em prévia pública em 6 de outubro de 2026. O model card lista 1,05T de parâmetros totais, 52B ativos e um codificador de visão de 1,6B, com contexto de 1M. A Mistral o treinou em 3.800 GPUs NVIDIA Grace Blackwell em seus próprios datacenters europeus, segundo o post de lançamento.
Em que ele vence o Muse Spark Open. Preço e o ângulo europeu. Ele marca 38 na tabela da Meta, um ponto atrás do Muse Spark Open, pela metade do preço de saída durante a promoção. Também o supera por pouco no DeepSWE (62 vs 60), no SWE-Atlas-QnA (59 vs 58) e no GDPVal-AA v2 (1424 vs 1401).
Onde fica devendo. Em 18 de outubro, os pesos não saíram. Não há repositório do Mistral Large 4 no Hugging Face, e o post de lançamento ainda diz "we will release the weights by the end of the month." Nenhuma licença foi anunciada, então eu não presumiria Apache 2.0. Sua pontuação no AA-Omniscience na tabela da Meta é -5, a única negativa do conjunto, contra 25 do Muse Spark Open.
"I created a brand new programming language to test LLM models on. It looks like Mistral Large 4 fares about as well as Kimi K3 and Claude Sonnet 5.5. Though it is much slower than Sonnet 5.5 and more expensive than both of those."
Preço e licença. A página de preços da Mistral mostra uma promoção de 50% sem data de término: US$ 0,68 de entrada, US$ 0,07 em cache e US$ 2,09 de saída por milhão de tokens, contra um preço de tabela de US$ 1,36, US$ 0,14 e US$ 4,18. A licença não foi anunciada.
Veredito: Uma escolha razoável se treinamento e hospedagem na UE forem requisito, e o preço promocional supera o do Muse Spark Open hoje. Mas ainda não é uma alternativa de pesos abertos. Volte depois de 31 de outubro antes de montar um plano de self-hosting em torno dele. Meu post sobre preços do Mistral Large 4 acompanha a promoção.
7. Nemotron 3 Ultra
Melhor para: equipes que precisam dos dados de treinamento e da receita, não só dos pesos, sob uma licença americana permissiva.
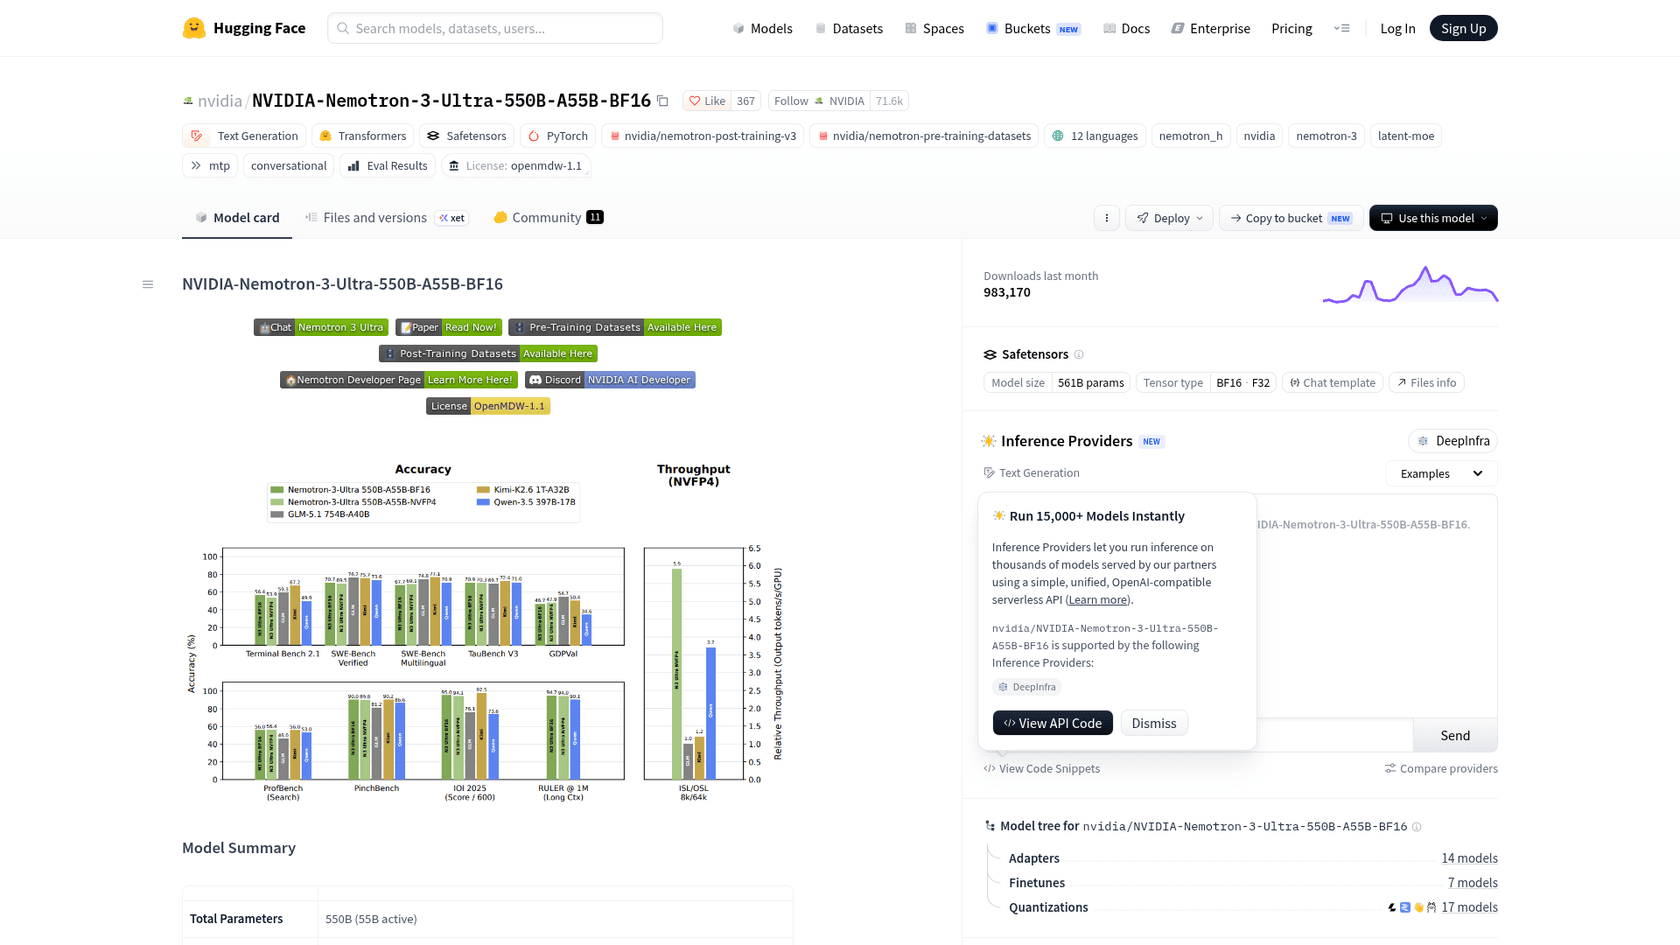
O Nemotron 3 Ultra é o maior modelo aberto da NVIDIA, lançado em 4 de junho de 2026. Tem 550B no total com 55B ativos, um híbrido de camadas Mamba-2, atenção e mistura de especialistas. É somente texto, e o raciocínio liga ou desliga no template de chat.
Em que ele vence o Muse Spark Open. Abertura. A NVIDIA publica os conjuntos de dados de pré-treinamento e pós-treinamento, os ambientes de RL e um relatório técnico. Se você precisa explicar a um auditor o que entrou em um modelo, este é o único da lista em que isso é possível. A licença também é mais leve.
Onde fica devendo. Capacidade. Marca 23 na tabela da Meta, a menor daqui, e fica atrás do Muse Spark Open em todo benchmark em que ambos aparecem, incluindo MCP-Atlas (63,1 vs 89,2) e Terminal-Bench 2.1 (53,9 vs 76,4). O card diz "up to 1M tokens," mas a configuração distribuída está em 262.144. O hardware mínimo é 8x H200 ou 16x H100.
"Each of the Nemotron 3 models were briefly competitive when they launched, but never exceptional, and less competitive with each scale up. The fact that it took so long for Nemotron 3 Ultra to launch really hampered its competitiveness. The Nemotron 3 series is extremely open about training recipes and training data, far more open than most open weight models, and that is valuable."
Preço e licença. A página build da NVIDIA oferece um endpoint de teste sem preço por token. A DeepInfra lista US$ 0,50 de entrada, US$ 0,10 em cache e US$ 2,20 de saída por milhão de tokens. A licença é a OpenMDW-1.1: mantenha a licença e os avisos ao redistribuir, e ela "does not impose any restrictions or obligations" sobre as saídas.
Veredito: Escolha o Nemotron 3 Ultra por transparência, não por um modelo mais inteligente. Se sua equipe jurídica ou de pesquisa precisa saber os dados de treinamento, é a escolha clara. Se você só precisa das melhores respostas, não é.
8. Inkling
Melhor para: produtos de áudio mais texto que querem um modelo Apache 2.0 de um laboratório dos EUA.
O Inkling é o primeiro modelo da Thinking Machines Lab, lançado em 15 de julho de 2026. É uma mistura de especialistas de 975B de parâmetros com 41B ativos, contexto de 1M segundo o model card, e entrada de texto, imagens e áudio de 16kHz. Um Inkling Small menor (276B, 12B ativos) veio em 30 de julho.
Em que ele vence o Muse Spark Open. Clareza de licença: os pesos são Apache 2.0, sem selo no produto e sem cláusula de receita. A Thinking Machines também mantém o Tinker, uma plataforma hospedada de fine-tuning, então ajustá-lo com seus próprios dados é um caminho com suporte, não um projeto de fim de semana.
Onde fica devendo. Marca 26 na tabela da Meta, e o Muse Spark Open o supera em todo benchmark em comum, muitas vezes por larga margem (JobBench 61,8 vs 31,1, MCP-Atlas 89,2 vs 76,0). E, embora os pesos sejam Apache 2.0, o card do Hugging Face linka uma política de uso aceitável separada que diz obrigar quem baixa o modelo. Ela exige avisar os usuários de que estão falando com uma IA quando isso for relevante, o que a maioria das equipes de suporte já faz.
"Very nice, multi modal, largest open weight model that supports audio. Would be interesting to see how good the audio capability is."
Preço e licença. O preço caiu. A inferência serverless em beta da Thinking Machines agora lista o Inkling a US$ 1,00 de entrada, US$ 0,17 em cache e US$ 4,05 de saída por milhão de tokens, em 14 de outubro, com a observação de que "not yet recommended for intensive production use." A Together AI cobra o mesmo. O Inkling Small custa US$ 0,30 de entrada e US$ 1,20 de saída.
Veredito: O Inkling é a escolha se você precisa de entrada de áudio sob Apache 2.0. O Muse Spark Open também aceita áudio e pontua muito mais, então o fator decisivo é se o selo "Built with Muse Spark Open" funciona para o seu produto. Para um olhar mais de perto, veja minha análise do Inkling.
As letras miúdas das licenças, lado a lado
A maioria dos comparativos para nos benchmarks. Em pesos abertos, a licença decide se você pode lançar o produto, então aqui está cada obrigação em uma só visão.
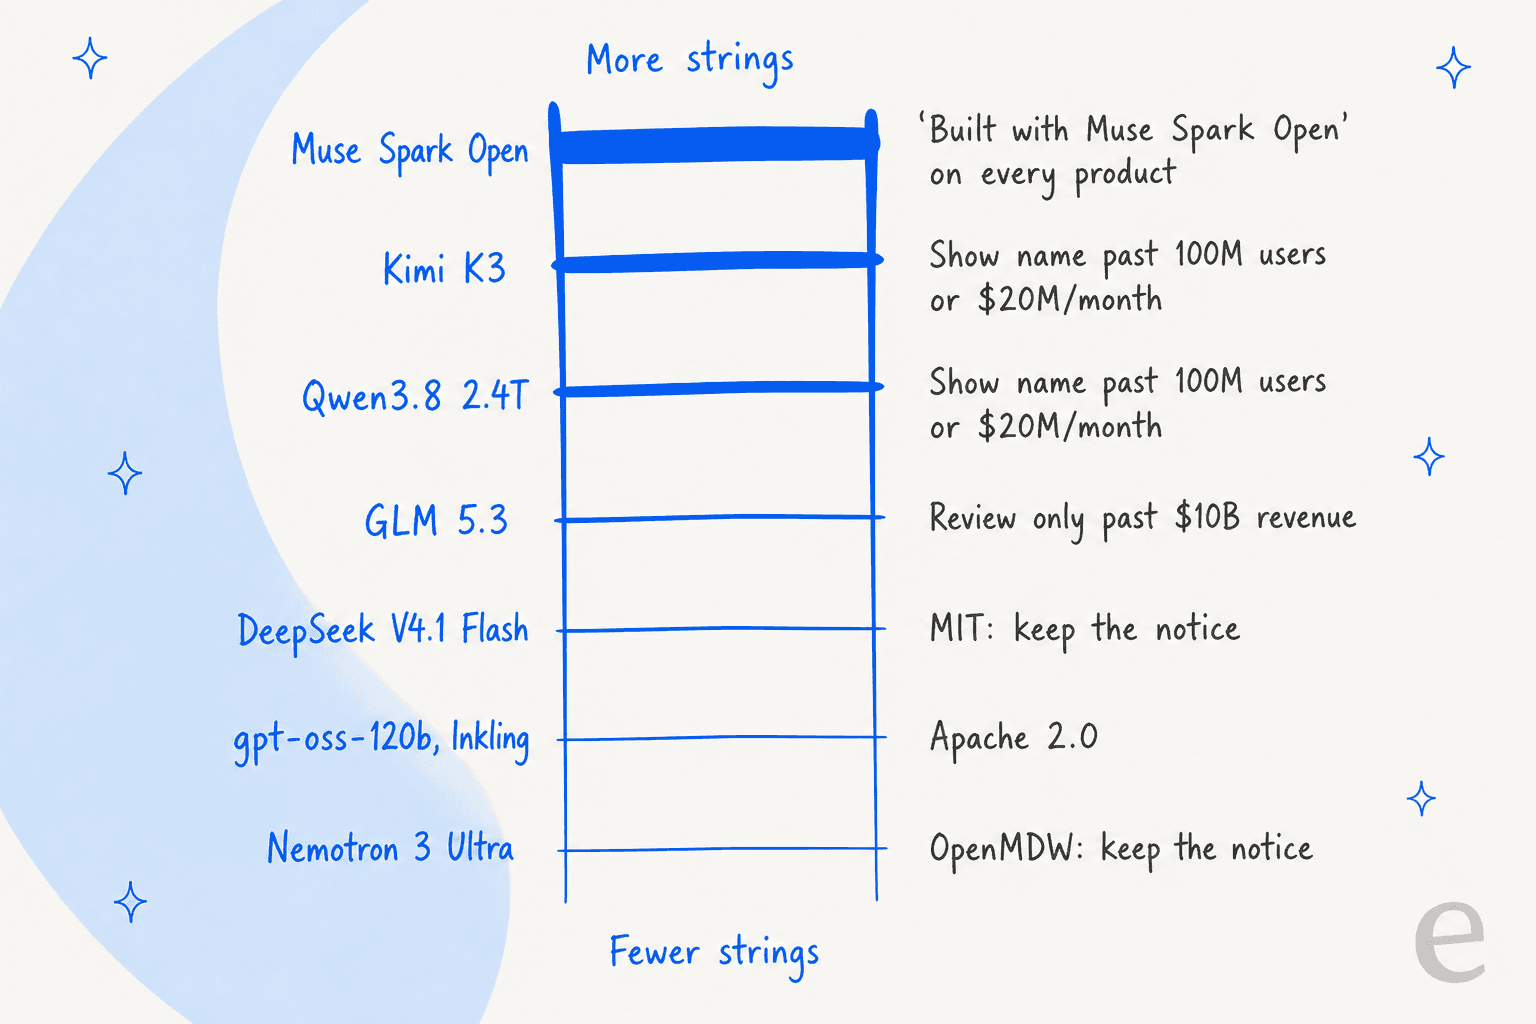
A surpresa para mim foi como a regra de exibição da Meta é incomum. O Kimi K3 e o Qwen3.8 também pedem que você mostre o nome do modelo, mas só depois de passar de 100 milhões de usuários mensais ou US$ 20 milhões de receita mensal. O Muse Spark Open é o único modelo aqui que pede um selo em todo produto, desde o primeiro dia. Sua cláusula de hospedagem é parecida com a do Kimi K3 (US$ 20 milhões por ano), enquanto o GLM 5.3 coloca o limite em US$ 10 bilhões e só pede uma revisão de segurança.
Nada disso é um impeditivo para um produto típico. Uma linha "Built with Muse Spark Open" na sua documentação ou no menu de configurações satisfaz a cláusula da Meta. Mas se você faz white-label para clientes ou revende inferência, leia a cláusula com seu advogado antes de escolher.
Como escolher entre elas
Depois de passar pelas oito, esta é a ordem em que eu testaria, para a maioria das equipes:
- Comece pelo GLM 5.3 como substituto direto. Mesma faixa de preço, pontuação maior, licença mais leve.
- Adicione o DeepSeek V4.1 Flash como teste de custo. Se passar na sua avaliação, você acabou de cortar sua conta em cerca de 7x.
- Adicione o gpt-oss-120b como piso. Se ele também passar, você provavelmente não precisa de um modelo de 700B+ para aquele trabalho.
- Traga o Kimi K3 só para as tarefas de código ou visão em que os outros falham.
- Mantenha o Muse Spark Open para agentes com muito uso de ferramentas, em que sua liderança no MCP-Atlas e a resistência a jailbreak importam, especialmente em qualquer coisa voltada ao cliente que precise recusar com clareza.
O passo que a maioria das equipes pula é a própria avaliação. Benchmarks são médias; sua carga de trabalho não é. Passe 100 das suas tarefas reais por cada candidato em um provedor como Fireworks AI ou Baseten antes de se comprometer, e pontue todos da mesma forma.
Se o modelo é para atendimento ao cliente, o modelo é a decisão menor
Muita gente avaliando pesos abertos em 2026 está fazendo isso para um bot de suporte. Eu diria a mesma coisa a todos: o modelo é infraestrutura. O funcionário é tudo o que se constrói por cima dele.
O eesel passou anos rodando IA em filas de suporte reais, e a falha que mais doeu não teve nada a ver com a escolha do modelo. Alguns clientes pagantes tinham um bot que, quando não encontrava nada relevante na base de conhecimento, preenchia a lacuna com os dados gerais de treinamento do modelo e enviava respostas confiantes e erradas a clientes reais. Trocar por um modelo de pontuação maior não resolve isso. Um fallback rígido, fundamentação nas suas próprias fontes e testes com tickets reais antes do lançamento resolvem. Por isso todo rollout do eesel agora é simulado com tickets históricos antes de responder a qualquer pessoa.
Então, se você está escolhendo entre o GLM 5.3 e o Muse Spark Open para um helpdesk, há um caminho mais curto. O colega de equipe de IA para helpdesk do eesel se conecta ao Zendesk, Freshdesk ou Gorgias, aprende com seus tickets anteriores e sua central de ajuda e mostra como teria respondido aos tickets do mês passado antes de entrar no ar. Um limite honesto: o eesel roda em modelos de fronteira hospedados da OpenAI, Anthropic e Google (listados na página de segurança), não nesses pesos abertos, então, se fazer self-host do modelo for um requisito rígido, o eesel não é a opção.
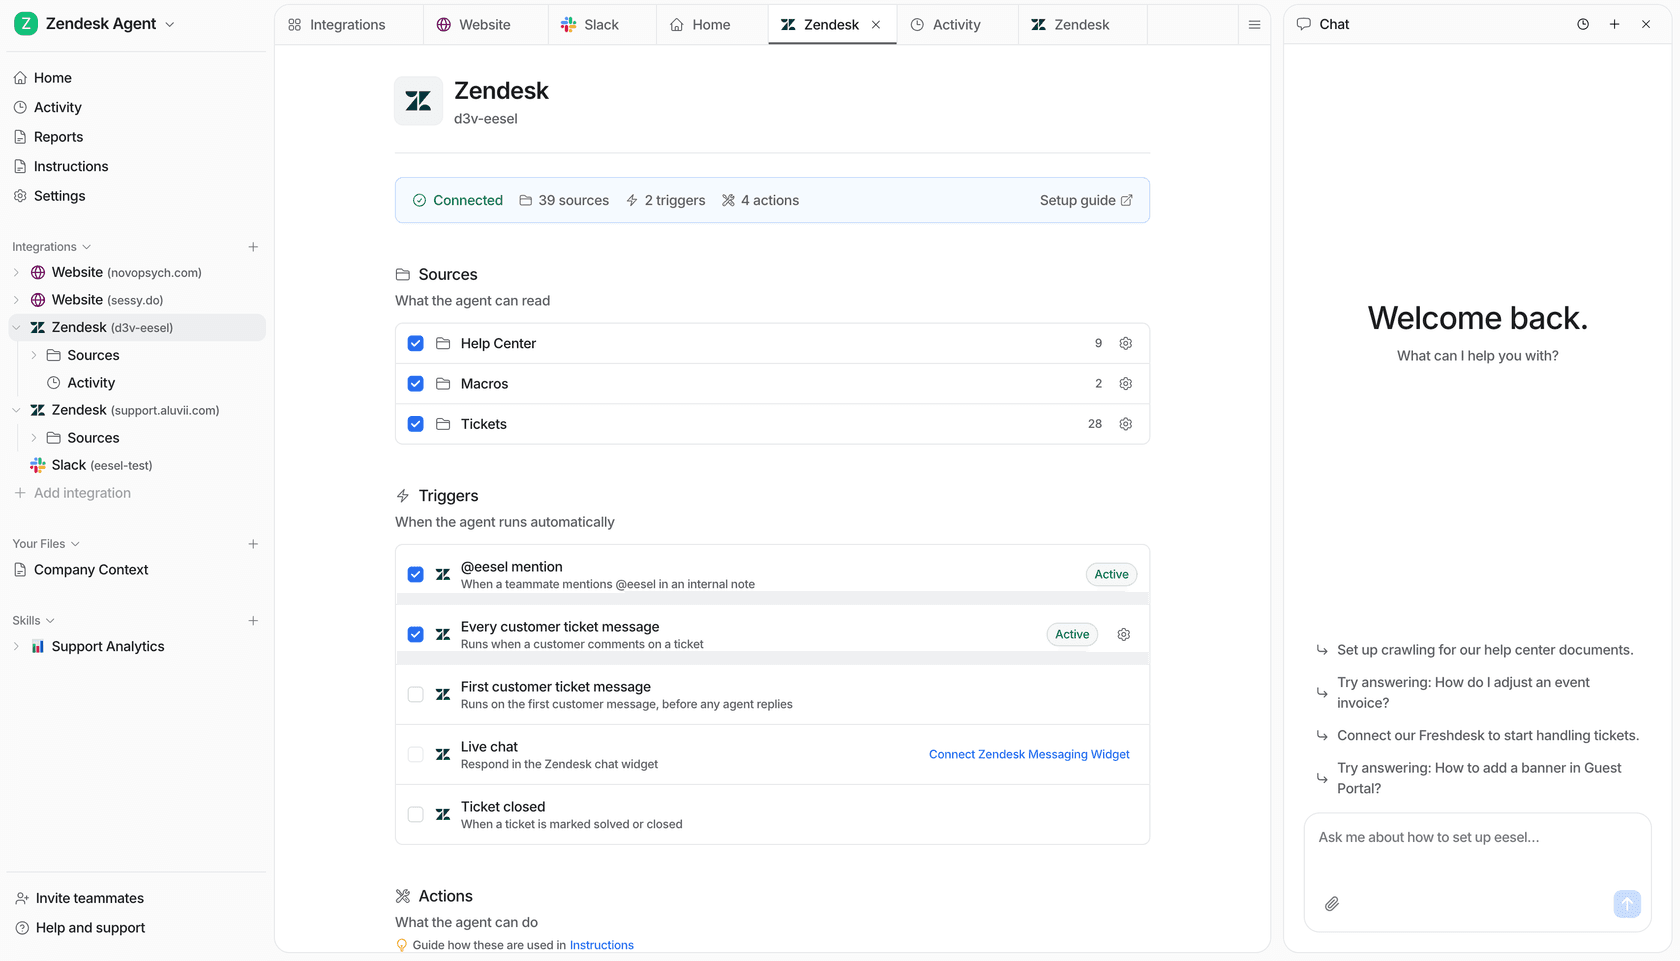
Se você é o tipo de equipe que compara licenças de modelos, provavelmente vai querer controlá-lo por código também. A CLI do eesel (@eesel/cli no npm) roda o mesmo colega de equipe e o mesmo workspace a partir de um terminal: conecte um helpdesk com eesel integrations connect, leia e edite suas instruções permanentes com eesel instructions, aprove ou negue ações pendentes com eesel approvals e revise o que ele fez com eesel activity. Todo comando imprime JSON, os comandos de escrita aceitam --dry-run e tokens headless funcionam em CI, então um script ou um agente de código como o Claude Code pode operá-lo tão facilmente quanto você. Todo workspace também é um servidor MCP, assunto que trato em MCP para atendimento ao cliente.
E se o seu projeto de pesos abertos é sobre conteúdo, e não sobre tickets, o outro colega de equipe do eesel é um redator de blog com IA que pesquisa, escreve e ilustra posts como este.
Experimente o eesel
O Muse Spark Open, o GLM 5.3 e os demais são motores. Se o que você realmente precisa é de uma IA que responda aos seus clientes, o eesel é um colega de equipe de suporte que já conhece sua central de ajuda e seus tickets anteriores, entra no seu helpdesk atual em minutos e se prova nos tickets do mês passado antes de tocar em um ao vivo. Experimente o eesel grátis, ou veja como as equipes o comparam no meu panorama dos melhores agentes de IA para atendimento ao cliente.