9 melhores alternativas ao llama.cpp em 2026, por hardware e carga

Rama Adi

Katelin Teen
Última edição 14 de novembro de 2026
As melhores alternativas ao llama.cpp são vLLM ou SGLang para muitos usuários em um servidor GPU, MLX-LM em um Mac com Apple Silicon, e ExLlamaV3 para encaixar o máximo de modelo em uma única placa NVIDIA. Ollama, LM Studio, Jan e LocalAI são mais amigáveis, mas ainda rodam o llama.cpp por baixo, então eles mudam o app, não o motor. Com o llama.cpp na v1.0.0, uma única pessoa em uma única máquina costuma estar melhor ficando onde está. Se o objetivo é IA em tickets de suporte, o eesel faz isso com modelos hospedados, e sua CLI deixa um agente de código enviar artigos de ajuda e testar respostas antes.
Por que as pessoas procuram alternativas ao llama.cpp?
Na maior parte, porque superaram o trabalho para o qual o llama.cpp foi criado, não porque ele ficou pior. O llama.cpp é o motor em C/C++ que tornou normal rodar modelos em hardware comum, e ainda é o mais amplo: o README do projeto lista backends para CUDA, Metal, HIP, Vulkan, SYCL, CPU pura e mais de uma dúzia de outros, com quantização GGUF de 1,5 bit a 8 bits e offload de CPU mais GPU para modelos maiores que sua VRAM. Ele está em 135.056 estrelas no GitHub sob licença MIT, e em 13 de novembro de 2026 lançou a v1.0.0, seu primeiro release semver, com caches KV FP8, um cache em memória do host para modelos mixture-of-experts e uma web UI redesenhada.
Eu trabalho nas integrações e APIs do eesel, então a maior parte do meu tempo com motores locais vai para as partes chatas: a API que eles expõem, como se comportam com várias solicitações ao mesmo tempo, e o que quebra quando você troca o modelo. Isso molda esta lista. Li a documentação, as notas de versão e os repositórios de cada projeto, e reuni relatos da comunidade no Hacker News, mas não testei os nove em uma única máquina, então trate qualquer afirmação de velocidade abaixo como deles, não minha.
Os motivos que as pessoas dão para trocar se agrupam em quatro:
- Muitos usuários ao mesmo tempo. O llama.cpp é ótimo para uma pessoa e bom para poucas. Uma equipe que bate no mesmo servidor é onde os motores com batching saem na frente.
- Velocidade no Mac. No Apple Silicon, o próprio framework MLX da Apple costuma ser o caminho mais rápido.
- Velocidade máxima em uma GPU específica. Motores com kernels escritos para o hardware de um fabricante podem superar um motor portável nesse hardware.
- Um app em vez de uma compilação. Nem todo mundo quer compilar com CMake e passar flags.
Os três primeiros são mudanças reais de motor. O quarto, geralmente não é, e essa é a parte que a maioria dos posts comparativos ignora.
"While I think that llama.cpp is an outstanding project - a one-stop-shop to get almost any model to run on almost any hardware, you get a lot more speed from specialised inference engines with kernels made for your hardware."

O Ollama é realmente uma alternativa ao llama.cpp?
Não no nível do motor. Ollama, LM Studio, Jan e LocalAI todos rodam o llama.cpp por baixo para modelos GGUF, e vários deles adicionam MLX em Macs. Eles mudam como você instala, baixa e gerencia modelos. Não mudam como os tokens são gerados.
A prova está nas próprias páginas deles. As notas de versão v0.40.16 do Ollama listam "Updated llama.cpp". A página inicial do LM Studio diz que ele roda "with MLX and llama.cpp under the hood." A documentação da API do Jan descreve "local models powered by llama.cpp or MLX." O LocalAI lista o llama.cpp como um dos mais de 80 backends, ao lado do vLLM e do MLX. E a equipe do llama.cpp agora tem seu próprio app de desktop Llama, um download de 1 MB para Mac e Windows.
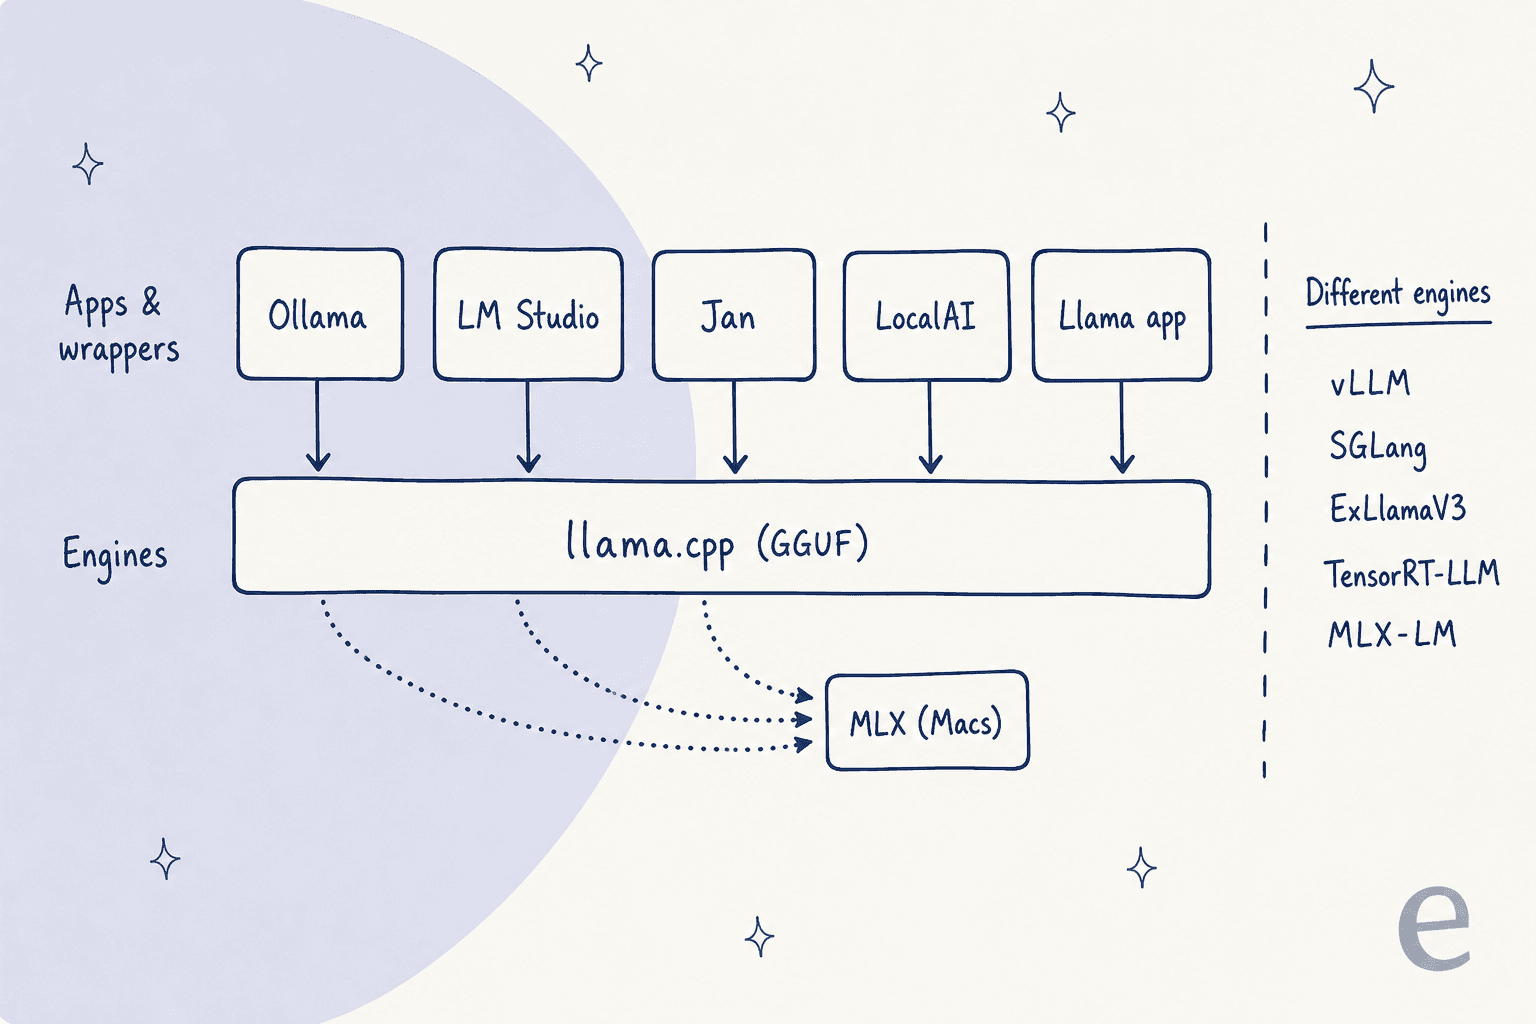
Essa divisão decide onde você deve olhar. Se você está deixando o llama.cpp porque compilações e flags cansam você, um app em cima dele é a solução certa, e você mantém tudo que já funciona. Se está saindo porque é lento demais para a sua carga de trabalho, um app sobre o mesmo motor não vai ajudar, e você quer um dos cinco da coluna da direita.
"There's also been some controversy over not giving proper credit to llama.cpp which ollama is/was a wrapper around."
Como escolhi essas alternativas
Comecei pelo que os compradores realmente perguntam. Quando dei "What are the best llama.cpp alternatives?" para o ChatGPT em um chat novo, ele citou nove projetos e os dividiu entre motores de inferência e plataformas de LLM locais, então os nove estão aqui. Depois verifiquei cada um em cinco pontos:
- Motor ou wrapper. Ele substitui a inferência do llama.cpp, ou apenas a envolve?
- Hardware e SO. NVIDIA, AMD, Apple Silicon, CPU; Linux, Windows, macOS.
- Formato de modelo. GGUF, pesos MLX, EXL3 ou safetensors do Hugging Face.
- Serviço. Uma API compatível com OpenAI, e se ele agrupa bem muitas solicitações.
- Manutenção. Data do último release, licença e estrelas do repositório do GitHub de cada projeto em 15 de novembro de 2026.
Veja como eles se comparam:
| Ferramenta | Tipo | Roda llama.cpp por baixo? | Hardware | SO | Formato de modelo principal | API compatível com OpenAI | Muitos usuários ao mesmo tempo | Licença | Estrelas no GitHub | Último release | Nível pago |
|---|---|---|---|---|---|---|---|---|---|---|---|
| vLLM | Motor | Não | NVIDIA, AMD, Intel, CPU, TPU via plugin | Linux (WSL no Windows) | Safetensors; GGUF experimental | Sim, mais API da Anthropic | Forte | Apache-2.0 | 96.936 | v0.33.0 | Nenhum |
| SGLang | Motor | Não | NVIDIA, AMD, TPU, Intel, Ascend, Mac via MLX | Principalmente Linux | Safetensors; GGUF na NVIDIA | Sim | Forte | Apache-2.0 | 38.874 | v0.5.23 | Nenhum |
| MLX-LM | Motor | Não | Somente Apple Silicon | macOS | Pesos MLX | Parecido com OpenAI, básico | Leve | MIT | 7.656 | v0.32.2 | Nenhum |
| ExLlamaV3 | Motor | Não | NVIDIA; AMD 7900 ou mais novo | Linux, Windows | EXL3 | Via TabbyAPI | Batching dinâmico | MIT (TabbyAPI AGPL) | 1.825 | v1.6.7 | Nenhum |
| TensorRT-LLM | Motor | Não | GPUs NVIDIA de data center | Linux | Safetensors, FP8/FP4 | Sim | Forte | Código aberto da NVIDIA | ~15.100 | v1.2.1 stable | Nenhum |
| Ollama | App + servidor | Sim, mais MLX | NVIDIA, AMD, Apple | macOS, Windows, Linux | GGUF | Subconjunto, mais API da Anthropic | Moderado | MIT | 186.973 | v0.40.16 | Nuvem a partir de US$ 20/mês |
| LM Studio | App de desktop | Sim, mais MLX | NVIDIA, AMD, Apple Silicon | macOS (série M), Windows, Linux | GGUF, MLX | Sim, mais API da Anthropic | Moderado | App fechado; ferramentas MIT | 5.427 (CLI lms) | Bionic 1.2.0 | Nuvem a partir de US$ 20/mês |
| Jan | App de desktop | Sim, mais MLX | NVIDIA, AMD, Apple | macOS, Windows, Linux | GGUF | Sim | Leve | Apache 2.0 | ~45.700 | v0.8.8 | Nenhum |
| LocalAI | Servidor API | Sim, entre mais de 80 backends | CPU, NVIDIA, AMD, Intel, Apple, Jetson | Linux, macOS, Docker, Kubernetes | GGUF e mais | Sim, mais API da Anthropic | Moderado | MIT | ~50.400 | v4.12.1 | Nenhum |
Qual alternativa ao llama.cpp combina com seu hardware?
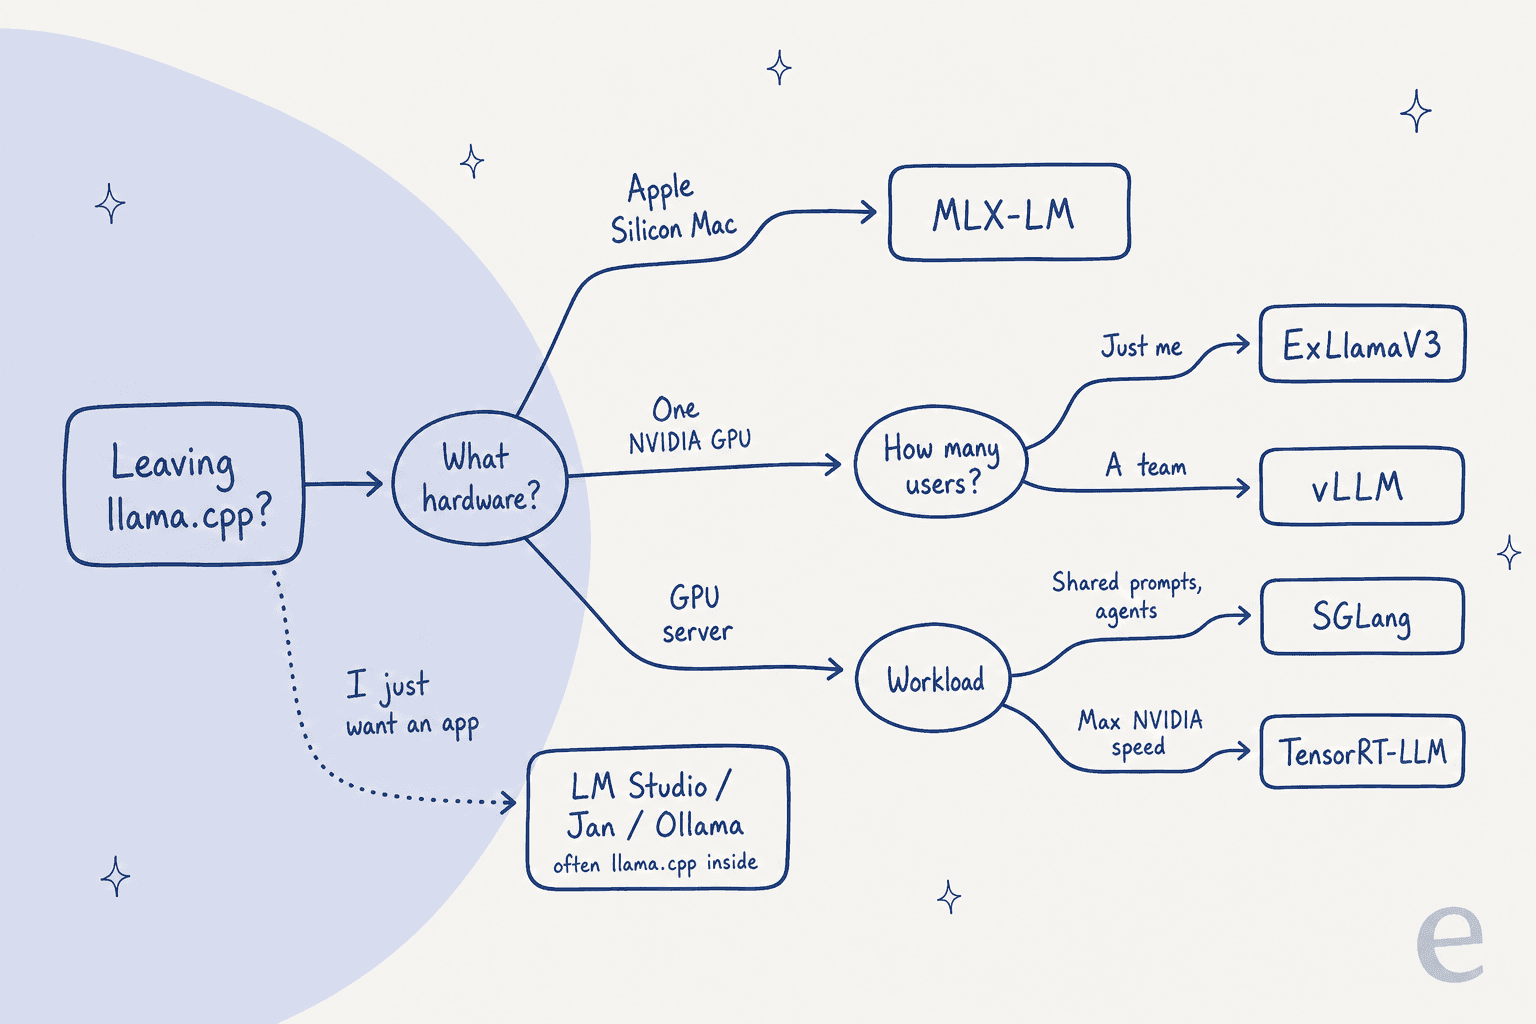
Comece pela máquina, depois pelo número de pessoas que a usam. Um Mac aponta para o MLX-LM. Uma única placa NVIDIA aponta para o ExLlamaV3 se for só você, ou para o vLLM se for uma equipe pequena. Um servidor GPU aponta para o SGLang em cargas de agentes com prompts compartilhados, ou para o TensorRT-LLM se você quer o último pedaço de velocidade em hardware NVIDIA. Se o que você quer é só um app mais agradável, escolha LM Studio, Jan ou Ollama e aceite que o llama.cpp continua fazendo o trabalho.
A pergunta mais útil de todas é quantas pessoas usam o modelo ao mesmo tempo. O llama.cpp tem slots paralelos e um llama-server compatível com OpenAI, mas motores construídos em torno de continuous batching mantêm o throughput quando solicitações simultâneas se acumulam, ao custo de uma inicialização mais lenta e menos flexibilidade com arquivos quantizados.
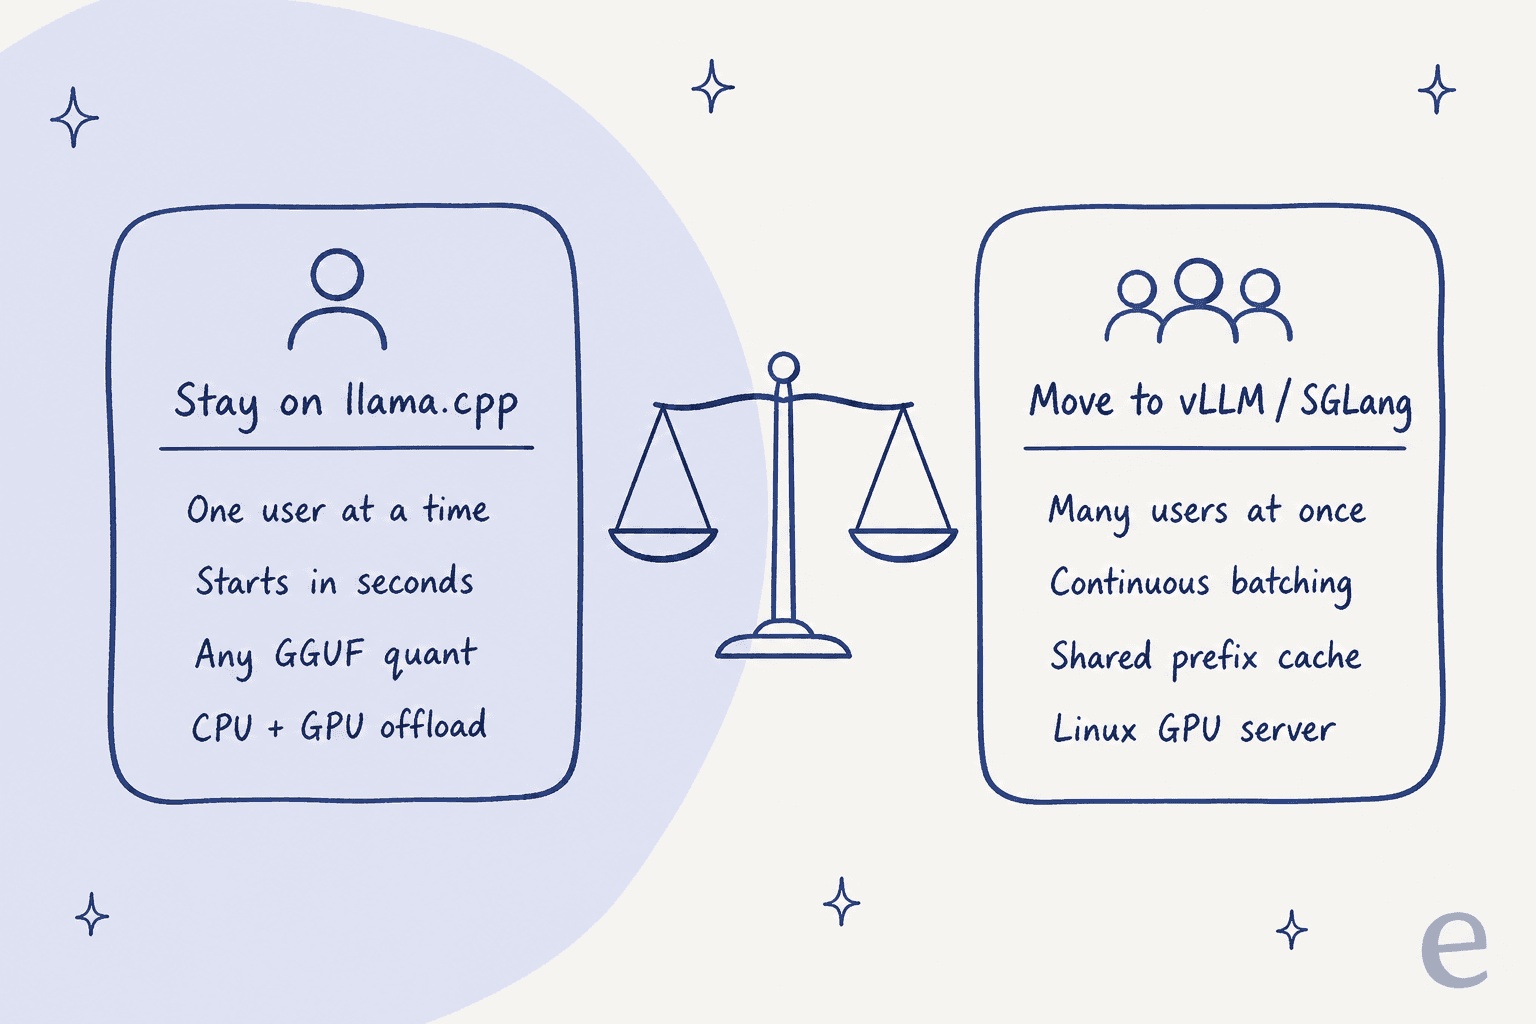
"IME vLLM is quite a bit faster than llama.cpp but where it really wipes the floor with it is in batching concurrent load. The downside is that it is dramatically less flexible in terms of tweaking. It gives you very few options for running quantized weights."
1. vLLM
Melhor para: servir um modelo a muitos usuários a partir de um servidor GPU Linux.
O vLLM se descreve como "a fast and easy-to-use library for LLM inference and serving." Ele começou no Sky Computing Lab da UC Berkeley e hoje conta com mais de 2.000 colaboradores. Se você já ouviu um nome na conversa de "llama.cpp para servidores", é este.
O que ele faz melhor que o llama.cpp
- Tráfego simultâneo. PagedAttention, continuous batching, chunked prefill e prefix caching são todos construídos para muitas solicitações ao mesmo tempo.
- Implantações grandes. Paralelismo de tensor, pipeline, dados, especialistas e contexto para distribuir um modelo entre GPUs e máquinas.
- Cobertura de API. Um servidor compatível com OpenAI, mais uma API de mensagens da Anthropic e gRPC, para que ferramentas como o Claude Code possam apontar para ele.
- Amplitude de hardware para servidores. NVIDIA, AMD ROCm 6.3+, Intel XPU e CPU, com TPU, Gaudi e Ascend via plugins.
Onde ele deixa a desejar
- Só Linux. O guia de instalação em GPU diz "vLLM does not support Windows natively" e aponta para o WSL. O Apple Silicon só funciona via um plugin comunitário vLLM-Metal.
- GGUF é uma porta lateral. A documentação de GGUF o chama de "highly experimental and under-optimized", e agora precisa de um plugin separado. Se sua biblioteca de modelos é de arquivos GGUF, planeje baixar versões em safetensors.
- Início lento. Ele compila grafos CUDA otimizados ao carregar, o que prejudica se você troca de modelo com frequência.
"We use all kinds of different models other than Qwen3, and vLLM startup when switching models is prohibitively slow (several times slower than llama.cpp, which is already 5 sec)"
Custo
Gratuito sob Apache-2.0. Instale com uv pip install vllm e sirva com vllm serve <model>. O custo real é uma máquina Linux com uma GPU compatível e alguém para operá-la.
Veredito
Escolha o vLLM quando uma equipe, um app ou uma frota de agentes compartilham um modelo e throughput importa mais que o tempo de inicialização. Pule se você está no Windows ou em um Mac, ou se troca entre modelos GGUF o dia todo.
2. SGLang
Melhor para: cargas de agentes que reenviam os mesmos prompts longos.
O SGLang é um framework de inferência de código aberto "optimized for agentic workloads, large-scale serving, and RL rollouts," hospedado pela organização sem fins lucrativos LMSYS. Sua documentação começa com "low-latency, high-throughput inference with RadixAttention, prefix caching, and multi-GPU parallelism."
O que ele faz melhor que o llama.cpp
- Reaproveitamento de prefixos compartilhados. O RadixAttention mantém em cache os prefixos de prompt compartilhados, o que compensa quando um agente envia o mesmo prompt de sistema e a mesma lista de ferramentas em cada chamada.
- Receitas de modelo desde o primeiro dia. A documentação tem páginas de cookbook para lançamentos novos como Kimi K3.1 Pro, mais uma receita do primeiro dia para o Qwen3.8-Flash-Next.
- Lista ampla de aceleradores. NVIDIA desde placas RTX 30 até GB300, AMD Instinct, Google TPU, Intel Arc e Xeon, Huawei Ascend, e Macs via MLX.
- Compatível com OpenAI. A documentação diz que ele é "compatible with Hugging Face and OpenAI APIs."
Onde ele deixa a desejar
- Exige CUDA 13. A página de instalação diz que os wheels do CUDA 12 foram descontinuados após a 0.5.19, então pilhas de drivers mais antigas precisam ser atualizadas.
- Linux primeiro. O guia principal de instalação visa Linux com GPUs NVIDIA; o caminho para Mac precisa de macOS 14+ e uma flag de ambiente.
- Offload de memória. Usuários relatam que o offload de pesos e do cache KV para a RAM do sistema é mais fraco do que no llama.cpp.
"My own experience shows that both weight and KV cache offload to ram on sglang and vllm is unavailable or unusable."
Custo
Gratuito sob Apache-2.0. uv pip install --prerelease=allow sglang ou a imagem Docker lmsysorg/sglang.
Veredito
Escolha o SGLang em vez do vLLM quando seu tráfego for de agentes e pipelines de RAG com prefixos longos e repetidos. Se você está construindo agentes de IA com MCP, isso é a maior parte do seu tráfego. Pule para uma única GPU de desktop onde o modelo não cabe sem offload.
3. MLX-LM
Melhor para: rodar e ajustar modelos em um Mac com Apple Silicon.
MLX-LM é o "Python package for generating text and fine-tuning large language models on Apple silicon with MLX" da Apple. Ele se apoia no MLX, o framework de arrays da Apple construído em torno da memória unificada.
O que ele faz melhor que o llama.cpp
- Velocidade no Mac para muitos modelos. Usuários do Hacker News tratam o MLX como a base a ser superada no Apple Silicon. Um usuário mediu cerca de 50 tokens por segundo com MLX contra cerca de 41 com llama.cpp no mesmo modelo de 8B no LM Studio.
- Fine-tuning embutido. LoRA, QLoRA e fine-tuning completo, até em modelos quantizados, mais inferência distribuída entre vários Macs.
- Uma grande biblioteca já pronta. Milhares de modelos convertidos na MLX Community do Hugging Face, e
mlx_lm.convert -qpara quantizar os seus.
"On a Mac the baseline I'd want is MLX, not llama.cpp. llama.cpp isn't the fast path on Apple Silicon for most models people run locally, so a speedup over llama.cpp could still be slower than mlx_lm."
Onde ele deixa a desejar
- Só Mac. Sem caminho de GPU para Linux ou Windows neste pacote.
- Servidor básico. O
mlx_lm.serverfala uma API parecida com OpenAI, mas suas próprias notas de servidor dizem que "is not recommended for production as it only implements basic security checks." - Sem GGUF. Você usa pesos no formato MLX, então sua pasta GGUF existente não é aproveitada.
- Nem sempre mais confiável. Um usuário voltou para o llama.cpp depois que uma configuração MLX ficou repetindo a si mesma.
Custo
Gratuito sob MIT. pip install mlx-lm, depois mlx_lm.chat.
Veredito
Escolha o MLX-LM se você está em um Mac de série M e quer velocidade ou fine-tuning local. Se quiser o mesmo motor com uma interface gráfica, LM Studio, Ollama e Jan todos usam MLX em Macs. Pule para qualquer coisa que precise rodar em servidores Linux.
4. ExLlamaV3
Melhor para: encaixar o máximo de modelo possível em uma única GPU de consumo NVIDIA.
ExLlamaV3 é "an inference library for running local LLMs on modern consumer GPUs, with flexible quantization and parallel inference." Ele substitui o ExLlamaV2, cujo README agora está marcado como arquivado e aponta para a V3. O TabbyAPI é o servidor oficial que roda em cima.
O que ele faz melhor que o llama.cpp
- Qualidade por gigabyte. Seu formato EXL3, baseado em QTIP, suporta taxas de bits fracionárias e quantização de cache de 2 a 8 bits, então você pode ajustar um modelo para encher exatamente sua VRAM.
- Multi-GPU em casa. Paralelismo de tensor e de especialistas entre placas de consumo, mais offload de CPU para modelos grandes de mixture-of-experts.
- Ativo. A v1.6.7 saiu em 13 de novembro de 2026, com commits quase todos os dias.
"ExllamaV3 4.0bpw fits in 12.5G of VRAM and beats IQ4_XS according to the measurements here"
Onde ele deixa a desejar
- NVIDIA primeiro. Precisa de CUDA 12.4 ou mais recente. O suporte a AMD é novo e focado na série Radeon RX 7900. Não há caminho para Mac.
- Precisa de conversão. Os modelos precisam ser convertidos para EXL3; ele não carrega GGUF.
- Escala de servidor amador. O README do TabbyAPI diz que ele "is not meant to run on production servers", e é AGPL-3.0.
Custo
Gratuito. O ExLlamaV3 é MIT, o TabbyAPI é AGPL-3.0. Wheels pré-compilados na página de releases evitam precisar do CUDA toolkit para pip install exllamav3.
Veredito
Escolha o ExLlamaV3 se você tem uma ou duas placas RTX e quer o maior modelo que caiba, só para você. Pule para serviço de produção compartilhado ou qualquer coisa que não seja NVIDIA.
5. TensorRT-LLM
Melhor para: throughput máximo em GPUs NVIDIA de data center.
O TensorRT-LLM é a biblioteca de código aberto da NVIDIA "for accelerating and optimizing inference performance of the latest large language models (LLMs) on NVIDIA GPUs", agora construída sobre o PyTorch com uma API Python de LLM.
O que ele faz melhor que o llama.cpp
- Formatos de baixa precisão em placas novas. FP4 nativo no B200 e FP8 no H100 e mais recentes, que segundo a NVIDIA "can double performance and halve memory consumption compared to 16-bit floating point".
- Funcionalidades de serviço. In-flight batching, cache KV paginado com reuso de blocos, decodificação especulativa (EAGLE, MTP, NGram), LoRA e serviço desagregado em beta.
- A pilha da NVIDIA. A documentação diz que ele se conecta ao NVIDIA Dynamo e ao Triton Inference Server, e o
trtllm-serveexpõe um endpoint compatível com OpenAI.
Onde ele deixa a desejar
- Hardware de data center da NVIDIA. As GPUs suportadas vão do Ampere A100 ao Hopper e Blackwell. Não é uma ferramenta para laptop.
- Ritmo de releases. O último release estável é a v1.2.1, de 20 de abril de 2026, e a documentação já está em candidatas da 1.4.0.
- Configuração mais pesada. O caminho mais rápido é o container NGC da NVIDIA.
"Some GPUs are still better than others like Nvidia GPUs are still the best for token throughput (via TensorRT-LLM), but AMD GPUs are competitive (via vLLM) and even CPUs can run LLMs at decent speeds (via Llama.cpp)."
Custo
Gratuito, sem nível pago. O custo é o hardware classe H100 ou B200 para o qual ele foi construído, ou as horas de nuvem. Equipes que só precisam de throughput às vezes acham um motor hospedado como o Groq mais barato do que operar o próprio.
Veredito
Escolha o TensorRT-LLM se você tem GPUs NVIDIA de data center e o custo de serviço por token é o seu número principal. Pule em hardware de consumo, onde vLLM ou ExLlamaV3 são mais simples.
6. Ollama
Melhor para: a instalação local mais fácil, com modelos na nuvem opcionais.
O Ollama se chama de "the most popular way to build with open models", e seus números sustentam a parte da popularidade: 186.973 estrelas no GitHub e, segundo sua própria página inicial, mais de 9 milhões de instalações por mês.
O que ele faz melhor que o llama.cpp
- Zero compilação. Um script de instalação ou instalador no macOS, Windows e Linux, mais uma imagem Docker.
- Biblioteca de modelos.
ollama runbaixa de ollama.com/library, com modelos como Kimi K3 e DeepSeek V4 Flash. - Conexão com agentes.
ollama launchconecta um modelo local ao Claude Code, Codex, OpenCode e outros, e tem endpoints compatíveis com OpenAI e Anthropic. - MLX em Macs. Seu repositório agora traz um runner MLX ao lado do llama.cpp.
"When I read the llama.cpp repo and see I have to build it, vs ollama where I just have to get it, the choice is already made."
Onde ele deixa a desejar
- O mesmo motor. Para modelos GGUF, ainda é o llama.cpp, então isso não vai resolver um problema de throughput.
- API OpenAI parcial. A documentação de compatibilidade diz que ele "supports a subset of the OpenAI API."
- Menos ajustes. Alguns usuários voltam para o llama.cpp quando querem um controle mais fino, agora que ficou mais fácil instalar.
Custo
Gratuito localmente. Os planos na nuvem na página de preços do Ollama estão abaixo.
| Plano | Preço | O que você recebe |
|---|---|---|
| Pague conforme o uso | Assinatura US$ 0 | Uso em nuvem por token, 3 solicitações simultâneas |
| Pro | US$ 20/mês (US$ 200/ano) | US$ 60 em créditos de uso por mês, modelos Pro maiores |
| Max | US$ 100/mês | US$ 300 em créditos de uso por mês, 10 solicitações simultâneas |
| Team (acesso antecipado) | US$ 500/mês | Usuários ilimitados, US$ 1.000 em créditos compartilhados |
| Enterprise | Personalizado | Controles de acesso a modelos, orçamentos por usuário e chave |
Veredito
Escolha o Ollama se você quer modelos locais rodando em cinco minutos e planeja conectá-los a agentes de código. Pule se o motivo de deixar o llama.cpp era velocidade, porque você manteria o mesmo motor.
7. LM Studio
Melhor para: um app de desktop polido que também deixa você escolher modelos por VRAM.
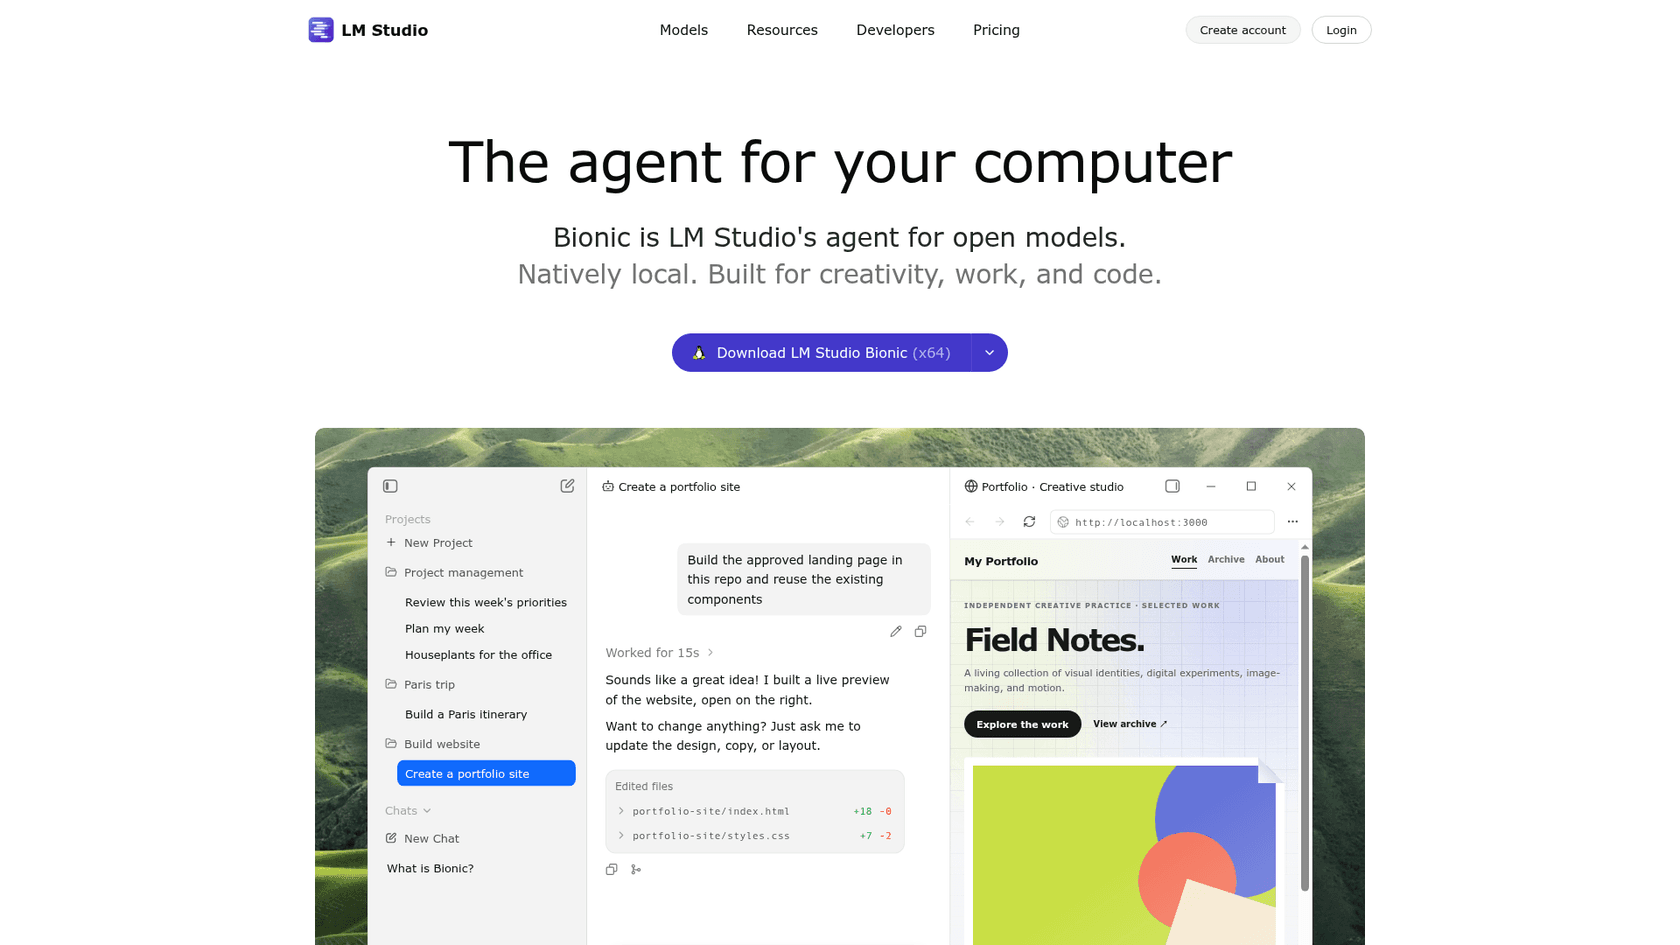
O LM Studio cresceu de um app de chat de modelos para o "Bionic", que ele chama de "LM Studio's agent for open models. Natively local." Por baixo, em suas próprias palavras, ele roda "with MLX and llama.cpp under the hood."
O que ele faz melhor que o llama.cpp
- Descoberta de modelos. A busca mostra o que cabe no seu hardware antes de baixar.
- Os dois motores em um Mac. GGUF via pacotes de extensão do llama.cpp e MLX via seu próprio motor oMLX, escolhido por modelo.
- Superfície para desenvolvedores. Endpoints compatíveis com OpenAI e Anthropic, SDKs de TypeScript e Python, a CLI
lms, e ollmster, um daemon sem interface para servidores e CI que roda sem a GUI.
"LM Studio's model search is pretty good at showing what models will fit in your VRAM."
Onde ele deixa a desejar
- App de código fechado. O app de desktop está sob os termos próprios do LM Studio; só a CLI e os SDKs são MIT no GitHub.
- Fica atrás do llama.cpp. Ele empacota pacotes de motor pré-compilados, então o suporte a modelos muito novos pode chegar alguns dias depois.
- Sem Macs Intel. O macOS precisa de Apple Silicon e macOS 14+.
Custo
Gratuito localmente. Segundo LM Studio Pricing, o Bionic+ custa US$ 20/mês para modelos abertos hospedados nos EUA e busca na web, o Pro custa US$ 100/mês por 5x os limites de uso, e a cobrança para equipes não tem preço divulgado.
Veredito
Escolha o LM Studio se você quer a melhor interface gráfica para modelos locais, especialmente em um Mac, onde ele alterna entre GGUF e MLX para você. Pule se precisar de um app de código aberto ou da build mais recente do llama.cpp no mesmo dia.
8. Jan
Melhor para: um app de desktop de código aberto no estilo ChatGPT que fica local.
Jan é um app de desktop de código aberto para macOS, Windows e Linux. Sua documentação diz "the llama.cpp engine is built into Jan and updates together with the app", com MLX usado no Apple Silicon.
O que ele faz melhor que o llama.cpp
- Código aberto e amigável. Apache 2.0, cerca de 45.700 estrelas, uma interface de chat, e um hub de modelos que baixa um modelo padrão na primeira execução.
- Local mais nuvem em uma janela só. Adicione chaves de OpenAI, Anthropic ou Google ao lado de modelos locais, mais servidores MCP e busca na web.
- Uma API local. Um servidor compatível com OpenAI em
127.0.0.1:1337/v1.
"its open source, has a simple chat interface, it uses llama.cpp, it lets you search for models and downloads them, and it supports .gguf so youre not locked in if you want to use the models with another program later on"
Onde ele deixa a desejar
- O mesmo motor. Como Ollama e LM Studio, não muda a velocidade de inferência.
- Macs Intel. Seu motor llama.cpp embutido não carrega modelos em Macs Intel desde a v0.8.5.
- Recursos novos em preview. O Cowork, o modo de tarefa autônoma, ainda está marcado como preview.
Custo
Gratuito. Sem nível pago; sua plataforma hospedada aparece listada como em breve.
Veredito
Escolha o Jan se você quer a conveniência do LM Studio com uma licença de código aberto. Pule se precisar de serviço de nível servidor.
9. LocalAI
Melhor para: uma única API autogerenciada que cobre texto, imagens, voz e mais.
LocalAI é um motor autogerenciado licenciado em MIT para modelos de texto, visão, voz, imagem e vídeo, com "more than 80 backends", incluindo llama.cpp, vLLM, MLX e whisper.cpp.
O que ele faz melhor que o llama.cpp
- Uma API para muitos tipos de modelo. Compatível com OpenAI, mais formatos da Anthropic e ElevenLabs, uma API em tempo real e gramáticas restritas.
- Backends plugáveis. Cada backend é sua própria imagem, carregada só quando um modelo precisa dela, e a equipe constrói alguns por conta própria, como o vllm.cpp.
- Amplitude de hardware. CPU, NVIDIA CUDA 12 e 13, AMD ROCm, Intel, Apple Metal, Vulkan e Jetson.
Onde ele deixa a desejar
- Principalmente um roteador. Para modelos de texto GGUF, o llama.cpp continua sendo o motor que faz o trabalho.
- Recursos novos em builds de dev. Agentes, arquivos, sandbox e logins de equipe só estão em builds de desenvolvimento a partir da v4.12.1.
- Mais peças móveis. Um container por backend é flexível, mas mais pesado do que um binário só.
"And if you want to use WSL, then I'd suggest using something like LocalAI which gives you a lot more control and support for additional formats (GGML, GGUF, GPTQ, ONNX, etc)."
Custo
Gratuito. Instale com um script, Docker, um app macOS ou Kubernetes.
Veredito
Escolha o LocalAI se você quer um único endpoint estilo OpenAI para um home lab ou uma plataforma interna que atenda mais do que chat. Pule se tudo que você roda são modelos de texto, onde o motor puro é mais simples.
Quando você deve continuar no llama.cpp?
Quando você é uma única pessoa em uma única máquina, e especialmente em hardware misto ou pouco comum. Nenhuma alternativa desta lista cobre tantos backends, do Vulkan em laptops AMD até Snapdragon e Huawei Ascend. Novas arquiteturas de modelo também tendem a chegar lá primeiro: a v1.0.0 adicionou Kimi-K3.1-Pro e Ripple-65B no dia do lançamento, e o llama-server já te dá uma API compatível com OpenAI, uma web UI e ferramentas MCP. O guia de llama.cpp do meu colega cobre a configuração da v1.0.0 em detalhes.
As duas maiores reclamações também são menores do que eram. As compilações agora são opcionais com o app Llama e instalações via Homebrew ou Winget, e o novo cache MoE na v1.0.0 dobrou a velocidade em um teste do release, de 24,2 para 47,6 tokens por segundo no Qwen3.8-Flash-Next, com a maioria dos misses de especialistas tratados na CPU (PR #30966).
"I have been using llama.app, which is the desktop interface built on top of llama.cpp by the same people. It is an alternative to Ollama that might interest people who want to switch given Ollama's reputation and previous decisions."
Se você roda modelos principalmente para alimentar agentes de código, continue, a menos que tenha medido um gargalo. Um agente que espera chamadas de ferramentas raramente precisa do batching de um motor de servidor. O mesmo vale para agentes de código aberto que você roda em casa.
Quanto custa realmente trocar o llama.cpp?
Todos os motores desta lista são software livre, então o preço é hardware e horas. Algumas regras práticas a partir da documentação acima:
- vLLM, SGLang e TensorRT-LLM significam um servidor GPU Linux e alguém para manter CUDA, drivers e containers atualizados. O SGLang já exige CUDA 13.
- MLX-LM não custa nada extra se você já tem um Mac de série M com memória unificada suficiente.
- ExLlamaV3 significa converter modelos para EXL3 e manter uma pasta de modelos separada dos seus arquivos GGUF.
- Ollama e LM Studio são gratuitos localmente, e só cobram pelos modelos na nuvem, a partir de US$ 20/mês.
Se você preferir não ter nada disso, inferência hospedada como Together AI transforma a conta de hardware em uma conta por token. Acompanhe de qualquer forma com uma ferramenta de rastreamento de LLM, porque modelos locais só são mais baratos se a máquina ficar ocupada.
Onde o eesel se encaixa se você quer IA em tickets de suporte?
Muita gente chega ao llama.cpp porque quer uma IA que responda clientes sem mandar dados para todo lado. Um motor de inferência é a infraestrutura para isso, não o trabalho pronto. Você ainda teria que construir a conexão com o helpdesk, a sincronização de conhecimento, os testes, a transferência para pessoas e os relatórios. É esse o trabalho que o eesel faz: um motor roda um modelo; o eesel é o colega que faz o trabalho de suporte.
O colega de IA para helpdesk do eesel entra na sua fila existente no Zendesk ou Freshdesk, responde a partir da sua central de ajuda e de tickets anteriores, e é testado em conversas históricas antes de responder a um cliente real. A SE Ranking roda um agente eesel por produto em três produtos no Zendesk, lidando com 4.650 conversas por mês a partir de cerca de 16.800 páginas de conhecimento, com reembolsos e pedidos de transferência para uma pessoa passados para a equipe. A Orosoft, que desenvolve software para a indústria de metais preciosos, usa como copiloto: a equipe de suporte menciona o eesel em um ticket do Freshdesk e recebe um rascunho baseado em cerca de 6.100 tickets anteriores.
Se você já se sente confortável no terminal, a CLI do eesel é a parte que você vai gostar. Um agente de código como Claude Code ou Codex pode usá-la para enviar conhecimento aprovado, como artigos de ajuda e macros exportados, ajustar as instruções do agente, e fazer perguntas de teste para checar as respostas antes de qualquer coisa entrar no ar. Conectar o helpdesk em si ainda precisa de alguém com acesso de administrador para aprovar.
Teste o eesel
Se o modelo na sua mesa tinha como destino acabar respondendo clientes, o eesel te leva até lá sem escolher um motor ou comprar uma GPU. Ele se conecta ao seu helpdesk em minutos, aprende com seus tickets anteriores, e é testado primeiro em conversas antigas, do mesmo jeito que a SE Ranking roda em três produtos. Veja os preços antes, se quiser. Quando estiver pronto, teste o eesel gratuitamente.