

O llama.cpp v1.0.0 saiu em 13 de novembro de 2026, e a manchete é uma promessa, não um salto de velocidade: uma mudança incompatível na API pública em C agora significa um salto de versão major. Isso importa mais se você constrói sobre a libllama. Usuários de servidor vão notar a segurança primeiro: o llama-server agora recusa expor ferramentas em um endereço de rede sem chave de API. Instale com uma linha a partir do llama.app, ou use o novo app Llama de 1 MB. Quer IA na sua fila de suporte em vez disso? A eesel roda isso sobre modelos hospedados, e a CLI da eesel permite que um agente de código suba artigos de ajuda e teste respostas antes.
O que é o llama.cpp?
O llama.cpp é um motor de código aberto que executa grandes modelos de linguagem e modelos de visão no seu próprio hardware, escrito em C/C++ puro sem dependências. O README descreve o objetivo como inferência de LLM "com configuração mínima e desempenho de ponta em uma ampla gama de hardware", localmente e na nuvem.
Alguns números dão a escala. O repositório no GitHub está em 135,055 estrelas e 25,608 forks sob a licença MIT, foi criado em 10 de março de 2023, e o anúncio da v1.0 diz que agora suporta mais de 150 variantes de arquitetura de modelo. O projeto é liderado pela ggml-org, a equipe comandada por Georgi Gerganov que faz parte da Hugging Face.
Eu construo integrações e APIs para o produto da eesel, então me importo menos com o banner de lançamento e mais com o que um número de versão faz ao código que depende dele. Essa é a lente deste post inteiro. Li as notas de release, a política de versionamento e os pull requests por trás das mudanças; não fiz benchmark na minha própria máquina, então os números de velocidade abaixo vêm dos próprios números dos mantenedores.
O motor principal por baixo é o ggml, uma biblioteca de tensores com backends para quase qualquer chip que você possa citar:
| Backend | Roda em |
|---|---|
| Metal | Apple Silicon |
| CUDA | GPUs NVIDIA |
| HIP | GPUs AMD |
| Vulkan | A maioria das GPUs |
| SYCL | GPUs Intel |
| OpenCL | GPUs Qualcomm Adreno |
| Hexagon | Snapdragon |
| CANN | NPUs Huawei Ascend |
| WebGPU | Navegadores e qualquer dispositivo com WebGPU |
| CPU (AVX, NEON, RVV) | x86, Arm e RISC-V |
Esse alcance explica por que tantas ferramentas de IA local se apoiam nisso. Se você já usou um app de chat de desktop para modelos abertos, há boas chances de que o llama.cpp estivesse fazendo o trabalho. É também por isso que modelos de pesos abertos como Gemma 4 e Qwen3.8-Flash-Next costumam lançar arquivos GGUF, o formato de modelo do llama.cpp, no primeiro dia.
O que a etiqueta v1.0 realmente promete?
Promete fronteiras estáveis, não funcionalidades novas. No anúncio na Hugging Face, a equipe diz que tanto o llama.cpp quanto o ggml "vão refletir incompatibilidades de API e ABI com saltos de versão major". As regras agora se aplicam a todo projeto da ggml-org:
| Salto de versão | Quando acontece |
|---|---|
| Major (2.0.0) | Mudança incompatível na API pública em C em ./include |
| Minor (1.1.0) | Funcionalidade compatível com versões anteriores, atualização de backend, novo suporte a modelo ou adição de API |
| Patch (1.0.1) | Correção de bug sem mudança de API |
Esta é a parte que a maioria das coberturas ignora: a promessa cobre os headers públicos em C, libllama e libggml. Ela não diz nada sobre as flags de linha de comando do llama-server, a interface web, ou o app de desktop. Essa distinção decide se a v1.0 muda algo para você.
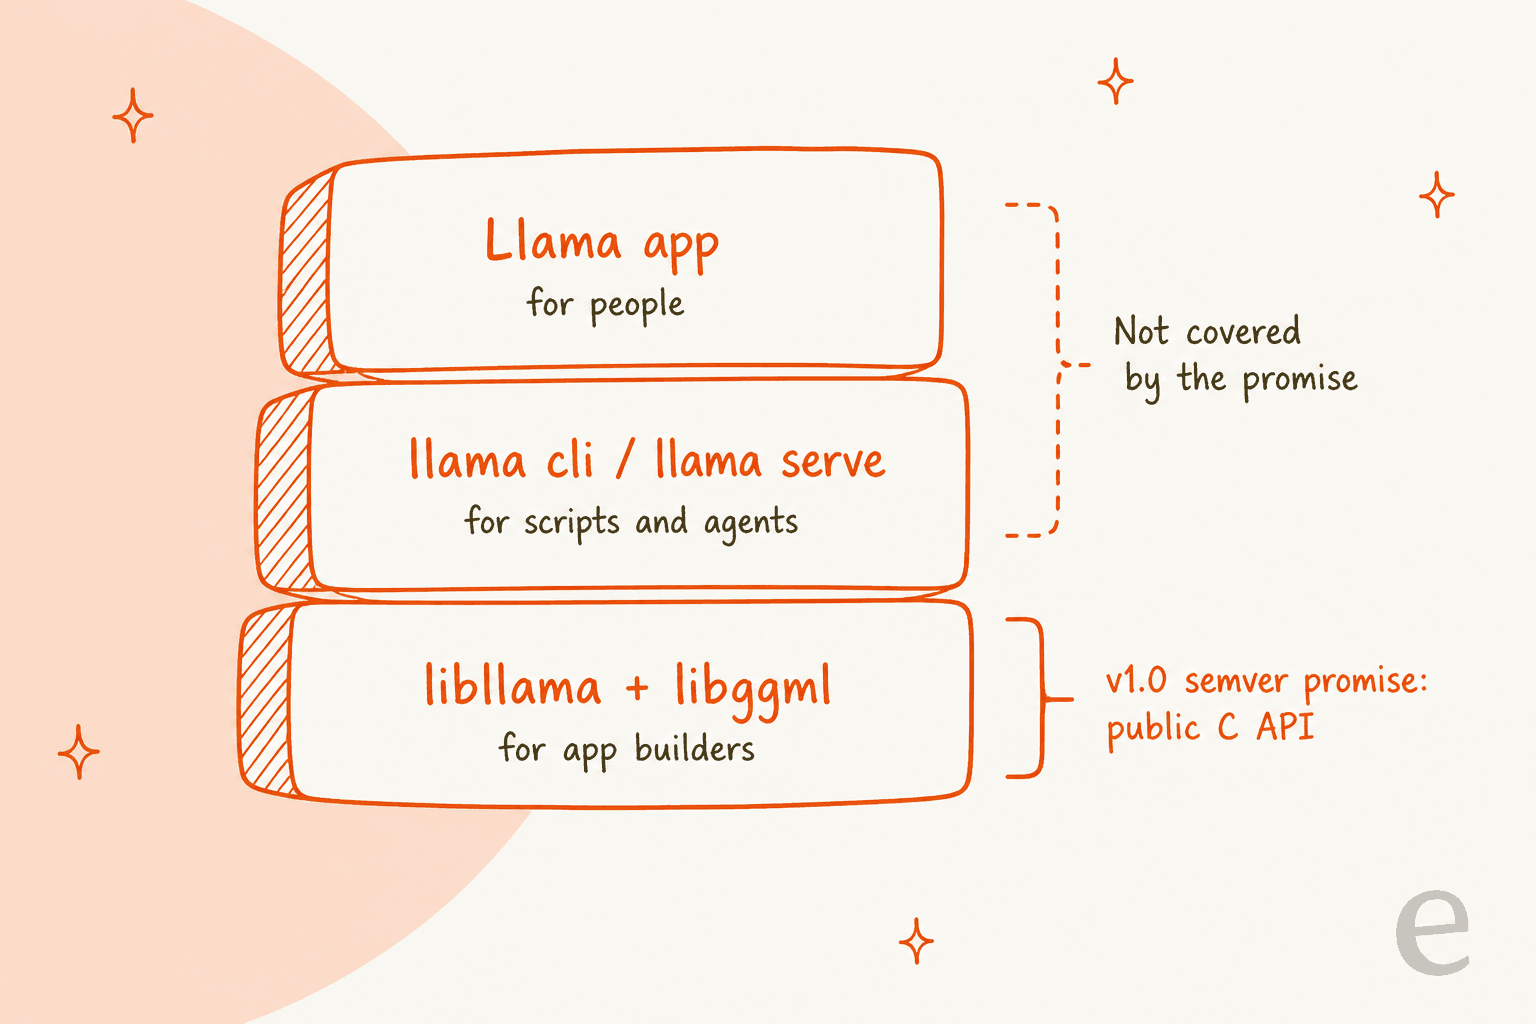
Se você incorpora o llama.cpp em um app, esta é a release que você esperava há três anos. Os empacotadores também a queriam. Na discussão sobre versionamento, alguém que empacota para o Debian escreveu que o versionamento semântico vai "nos permitir no Debian distribuí-lo como biblioteca em caminhos de busca públicos", porque mudanças incompatíveis agora podem ser sinalizadas com saltos de versão de biblioteca. É assim que o llama.cpp deixa de ser algo que você vendoriza no seu repositório e passa a ser uma biblioteca de sistema.
Se você só roda modelos através de um servidor ou app, a v1.0 é principalmente um marco de limpeza. Útil, mas não um motivo para reconstruir sua stack.
As builds noturnas continuam
Um detalhe confunde as pessoas. O llama.cpp continua publicando builds noturnas etiquetadas pelo número de commits, como b12387, e publicou cinco só em 14 de novembro, segundo a página de releases. A tag v1.0.0 é uma trilha separada, mais lenta. As notas de versionamento dizem que uma tag de release só é cortada quando a cópia interna do ggml no llama.cpp coincide com o ggml publicado, então qualquer coisa construída a partir da tag pode ser vinculada com segurança a um ggml do sistema.
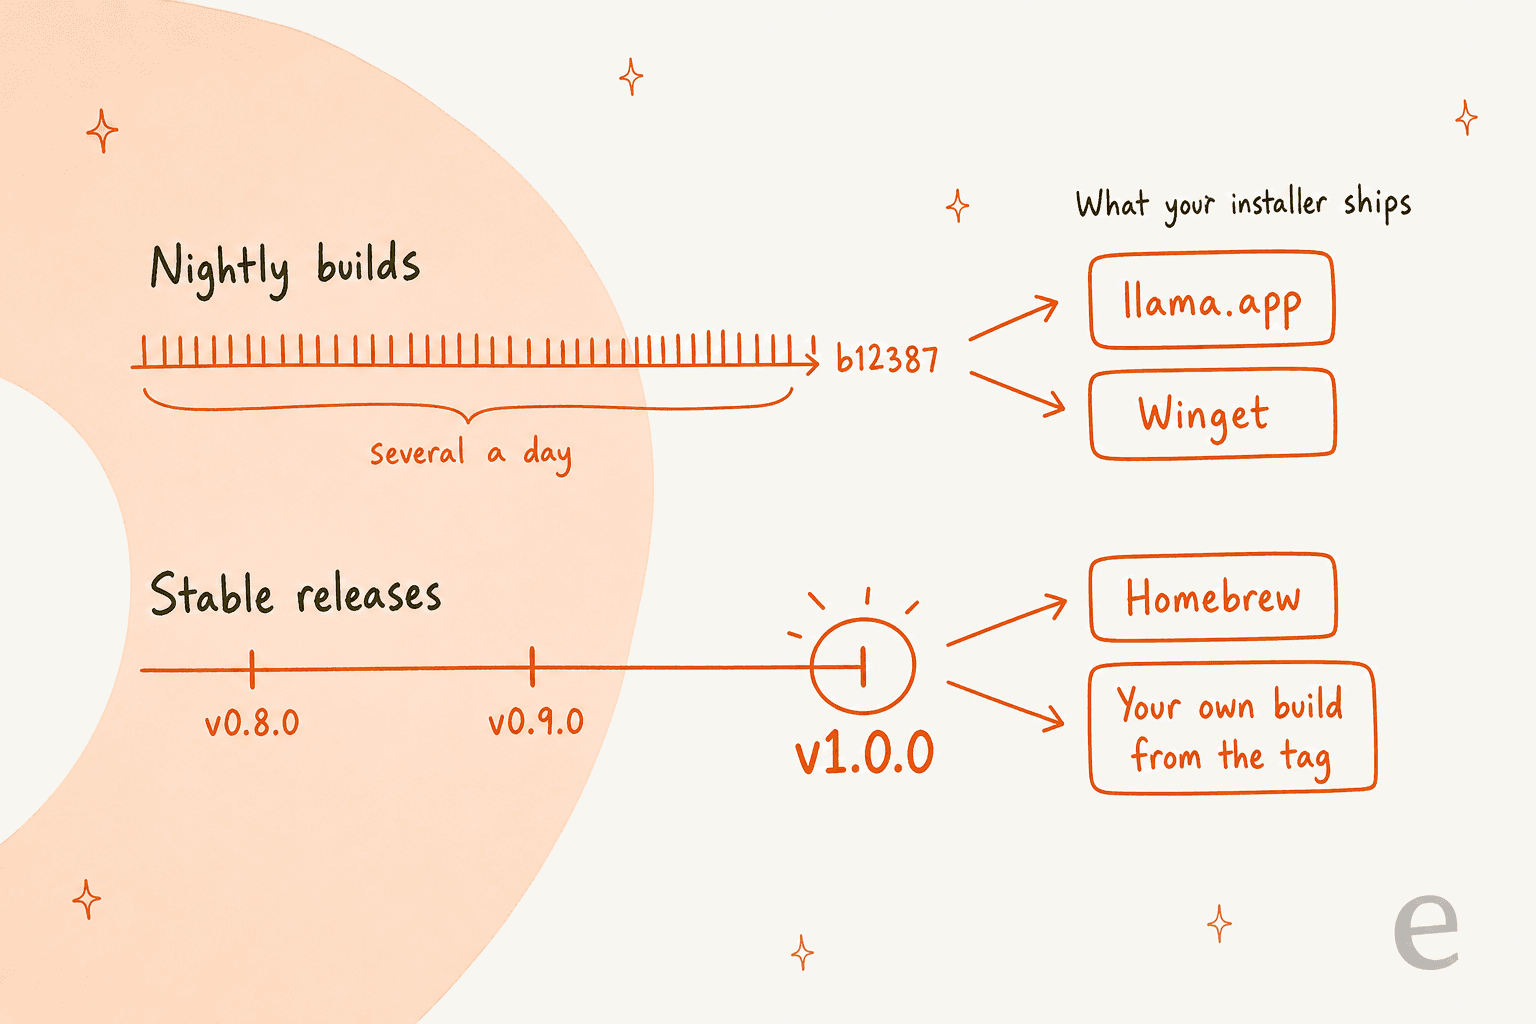
Em qual trilha você está depende de como você instalou. Segundo essas mesmas notas, o instalador do llama.app e o Winget publicam as builds noturnas, não os releases oficiais (marcado como pendente de correção), enquanto a fórmula do Homebrew agora é construída a partir da tag de release. Então "estou na v1.0" só é verdade se você checou.
O que mudou no llama.cpp v1.0.0?
As notas de release cobrem centenas de commits desde a v0.9.0. Estas são as mudanças que valem a pena conhecer, agrupadas por quem elas afetam.
| Área | Mudança | Quem é afetado |
|---|---|---|
| API em C | Remove llama_set_warmup, 35 funções obsoletas e --defrag-thold; move a API NextN (decodificação especulativa) de llama-ext.h para llama.h | Quem vincula a libllama |
| Memória | Caches FP8 KV via -ctk/-ctv f8_e4m3 | Usuários de contexto longo com pouca VRAM |
| Memória | Cache de especialistas MoE em memória do host com uma cota de CPU configurável | Modelos grandes mixture-of-experts em GPUs pequenas |
| Modelos | Kimi-K3.1-Pro, Ripple-65B-Preview, xing4_0, TTS drama-3; visão Kimi-K3.1 e MageVL-Cowork | Quem testa novos modelos abertos |
| Servidor | Endpoint /v1/audio/speech; correções de segurança para CORS, DNS rebinding e SSRF | Quem roda o llama-server |
| Interface web | Grupos de chat, editor de markdown em tempo real, layout para celular, miniaturas de PDF | Pessoas que usam o chat integrado |
Novos modelos no primeiro dia
As novas arquiteturas se alinham com lançamentos recentes que já cobri: o Kimi-K3.1-Pro, que as notas descrevem como o K3 com suas camadas de atenção completa trocadas por DSA, e o Ripple-65B, adicionado como nova arquitetura densa de 65B. Se você leu minha análise do Kimi K3 ou a análise do Ripple-65B, são os mesmos modelos, agora executáveis localmente a partir de arquivos GGUF.
Caches FP8 KV
O cache KV é a memória que um modelo usa para lembrar a conversa até agora, e em contextos longos pode rivalizar com o próprio modelo em tamanho. O PR #28392 adiciona caches FP8 OCP com escalas opcionais por tensor. Nem todo mundo sabe ainda qual opção de 8 bits escolher:
"Sounds like now, 8 bit KV cache is ok for coding, but the question is which one? I see f8_e4m3, q8_0. Would be great to get more info about that."

Minha leitura: as notas de release não respondem a isso, então teste as duas opções em uma sessão longa do seu próprio trabalho antes de trocar uma configuração de código.
O cache de especialistas MoE
Esta é a mudança que eu mais acompanharia. Modelos mixture-of-experts usam só uma fração dos seus pesos por token, então o PR #30966 mantém os especialistas mais usados na memória da GPU e pode processar os cache misses na CPU. O teste de ajuste do autor no Qwen3.8-Flash-Next mostra por que a cota de CPU importa: com um cache de 6,464 MiB, a decodificação foi de 24.2 tokens por segundo sem cota de CPU para 47.6 com uma cota de 0.95. Com um cache maior, de 19,392 MiB, os números se invertem e uma cota de CPU alta fica mais lenta. O PR traz um script de ajuste, scripts/moe-cache-tune.py, para encontrar o seu próprio ponto ideal em vez de adivinhar.
É o mesmo truque por trás de gigantes de GPU única como o Edge0-145B, agora embutido no motor principal.
O que mudou na segurança do llama-server?
Esta é a mudança mais provável de quebrar uma configuração que funcionava no dia da atualização. O PR #32113 significa que ativar ferramentas ou MCP com um --host que não seja loopback e sem chave de API agora é recusado com um erro. Você precisa adicionar --api-key, ou optar explicitamente com --allow-unauthenticated-tools.
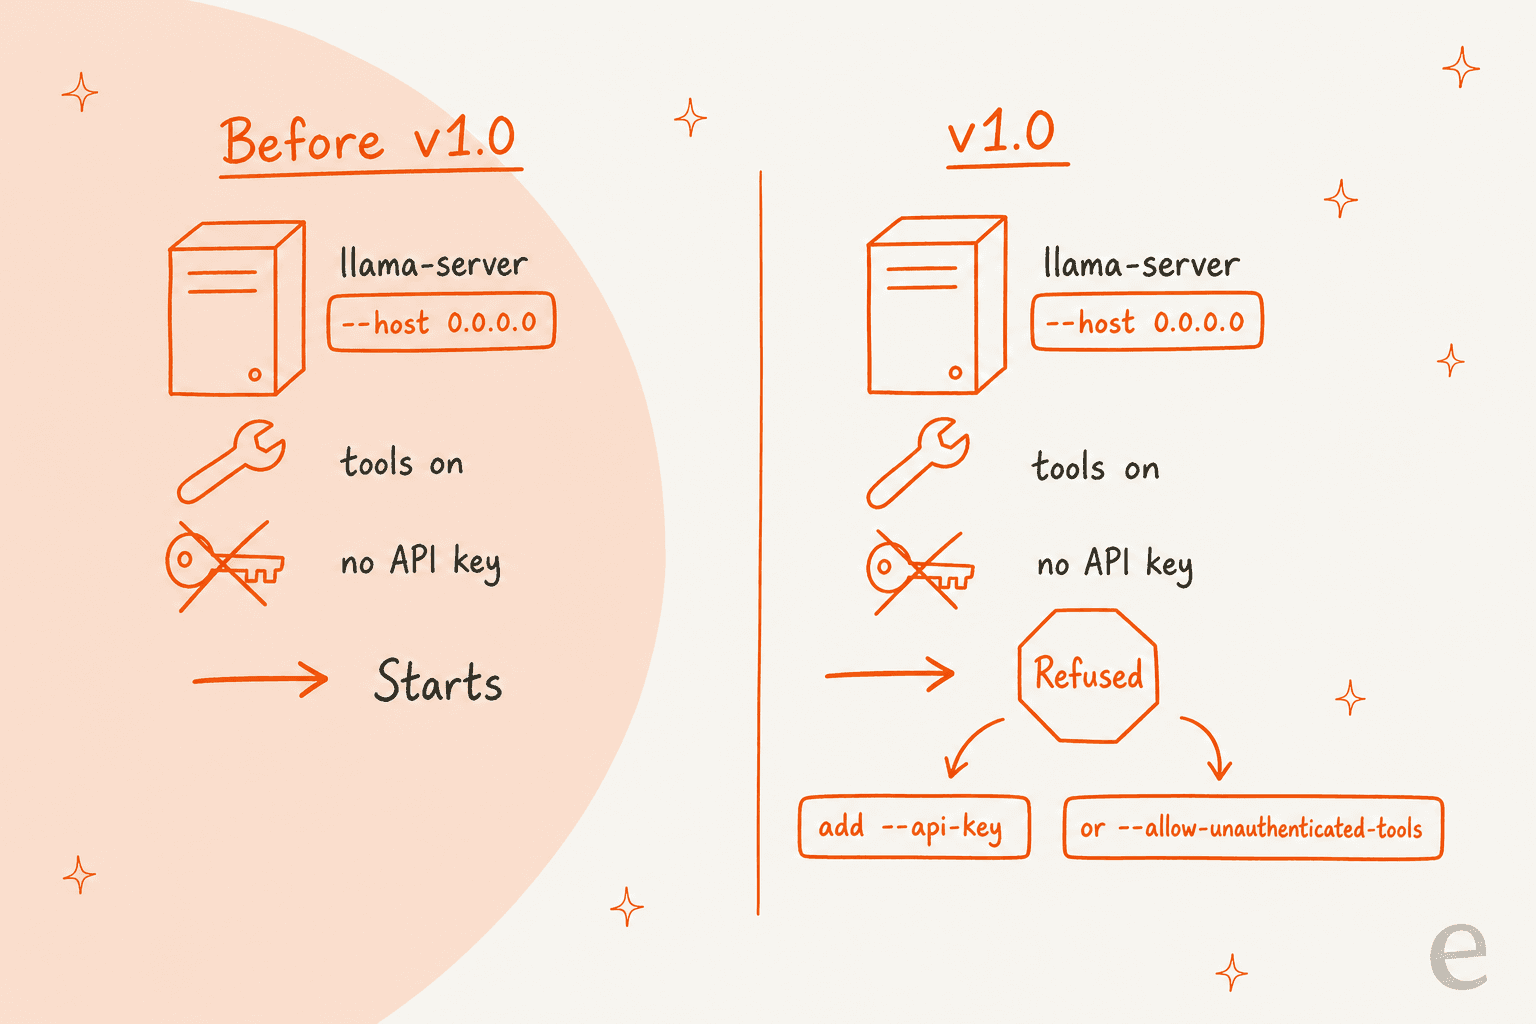
O mantenedor que escreveu isso foi direto sobre o tradeoff na descrição do PR:
"None of those are actually vulnerability, but since people nitpick this too much, we now forced to hurt the UX a bit"
Eu ainda assim ficaria com o padrão mais estrito. Ferramentas no llama-server podem ler arquivos e executar comandos de shell, e o conjunto embutido na interface web inclui read_file, exec_shell_command e write_file. Deixar isso aberto em uma LAN sem chave é o tipo de configuração que fica bem até alguém mais no Wi-Fi encontrar. A mesma release também restringe o HF_TOKEN a hosts huggingface.co, corrige o tratamento de --cors-origins e o DNS rebinding, adiciona uma opção --media-allow-private-urls, e cancela chamadas de ferramentas MCP quando um cliente se desconecta.
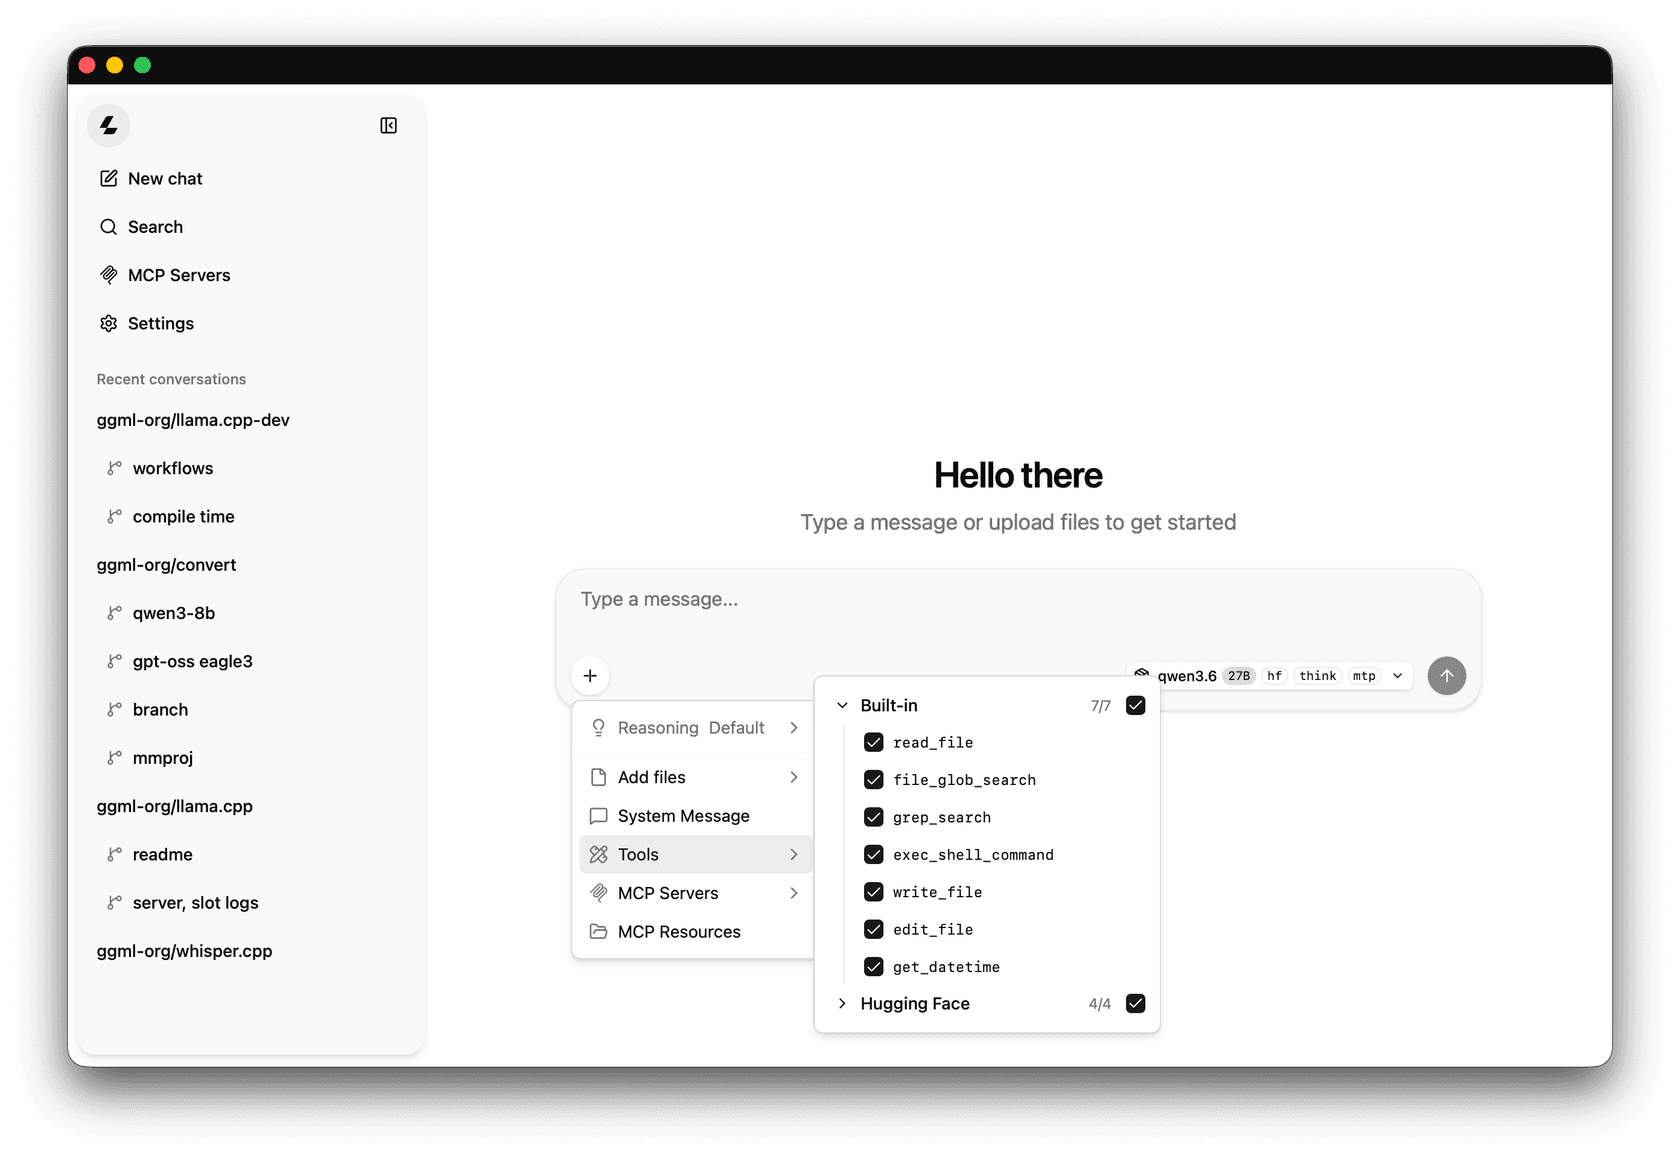
Se você está conectando um modelo local a algo que pode executar ações, minhas notas sobre servidores MCP para agentes de IA e segurança no Claude Code cobrem o mesmo princípio: o acesso a ferramentas é a verdadeira superfície de ataque, não o modelo.
O llama.cpp v1.0 muda algo para você?
Escolha como você usa, e você terá a versão curta.
Como você usa o llama.cpp?
--host que não é loopback e ferramentas ou MCP ativados, a v1.0 recusa iniciar sem --api-key. Adicione uma chave em vez de usar --allow-unauthenticated-tools. Confira também qualquer valor de --cors-origins, já que a porta agora é validada rigorosamente.llama_set_warmup e às 35 funções obsoletas, renomeie llama_set_embd_state_src para llama_set_ctx_state_src, e fixe em v1.x. A partir daqui, uma mudança incompatível na API em C significa um 2.0.libggml do sistema e usar saltos de versão de biblioteca para sinalizar mudanças incompatíveis.Como você instala e roda o llama.cpp?
Existem três caminhos, e o novo é o mais amigável. Todos os comandos abaixo vêm do README e do llama.app.
1. O app de desktop Llama (Mac e Windows). A mesma equipe agora distribui o Llama, um app de barra de menu no Mac e um app de bandeja do sistema no Windows 11. O site lista como um download de 1 MB, 4 MB instalado, gratuito, de código aberto e capaz de funcionar offline. Ele verifica seu hardware e escolhe a quantização, o tamanho de contexto e a decodificação especulativa para cada modelo, e os modelos são descarregados após cinco minutos ociosos.
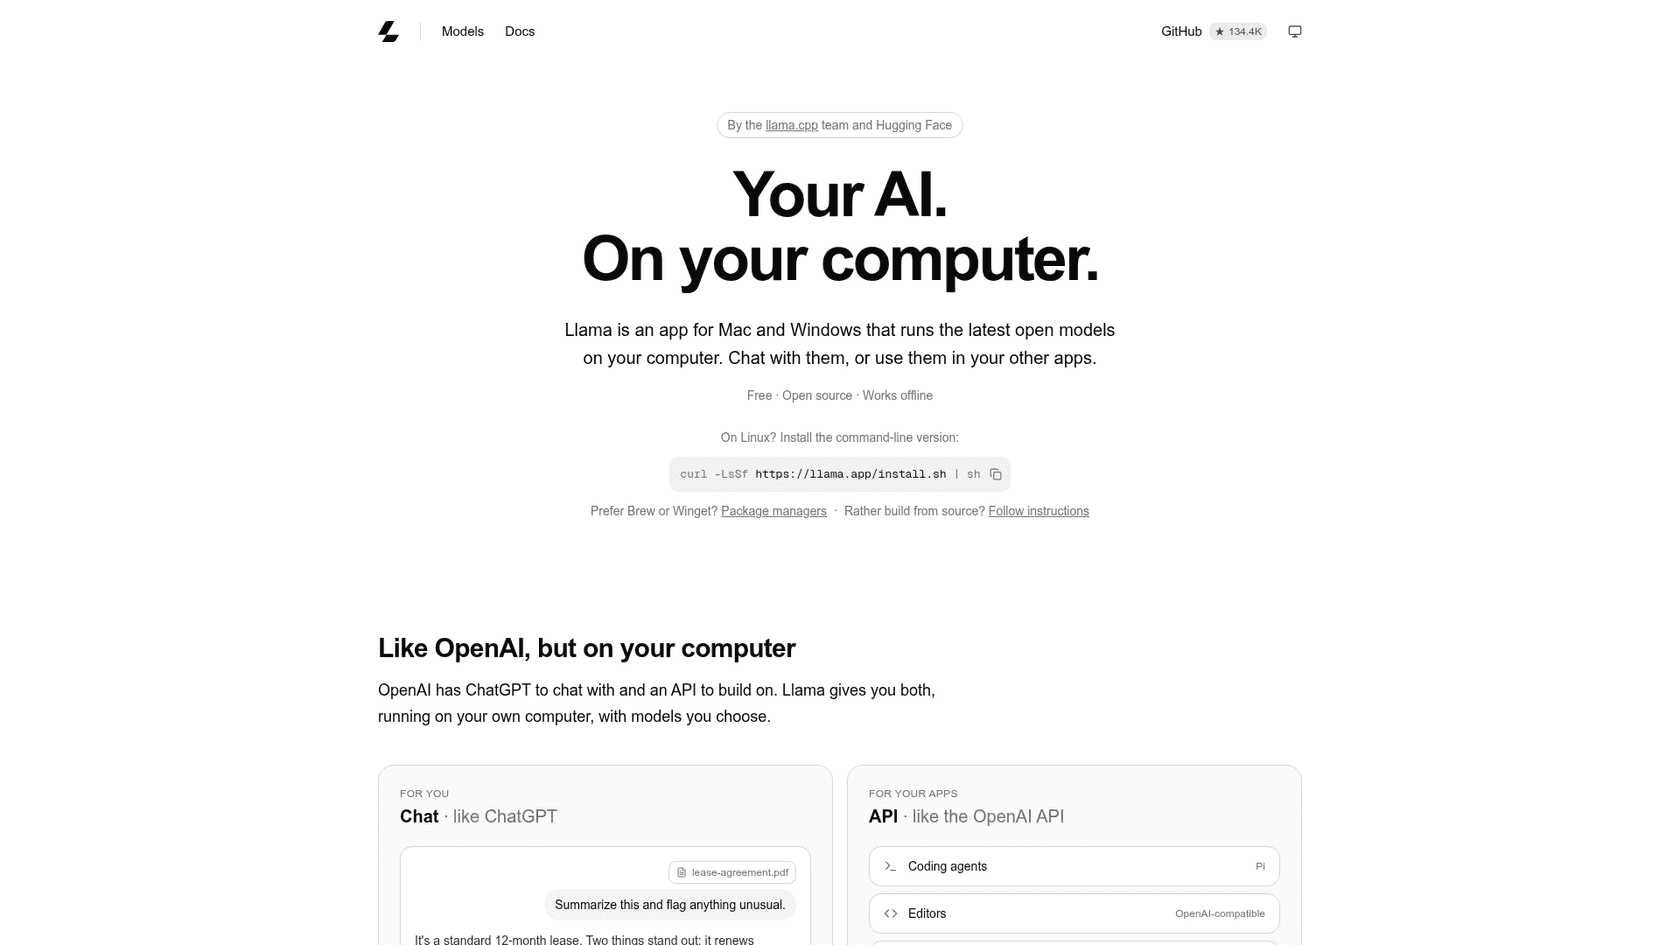
Ele sugere um modelo inicial pela memória disponível: Gemma 4 para um Mac de 16 GB, GPT-OSS a 24 GB, e Qwen 3.8 a 32 GB. No Mac, você também pode instalar com brew install --cask llama-app.
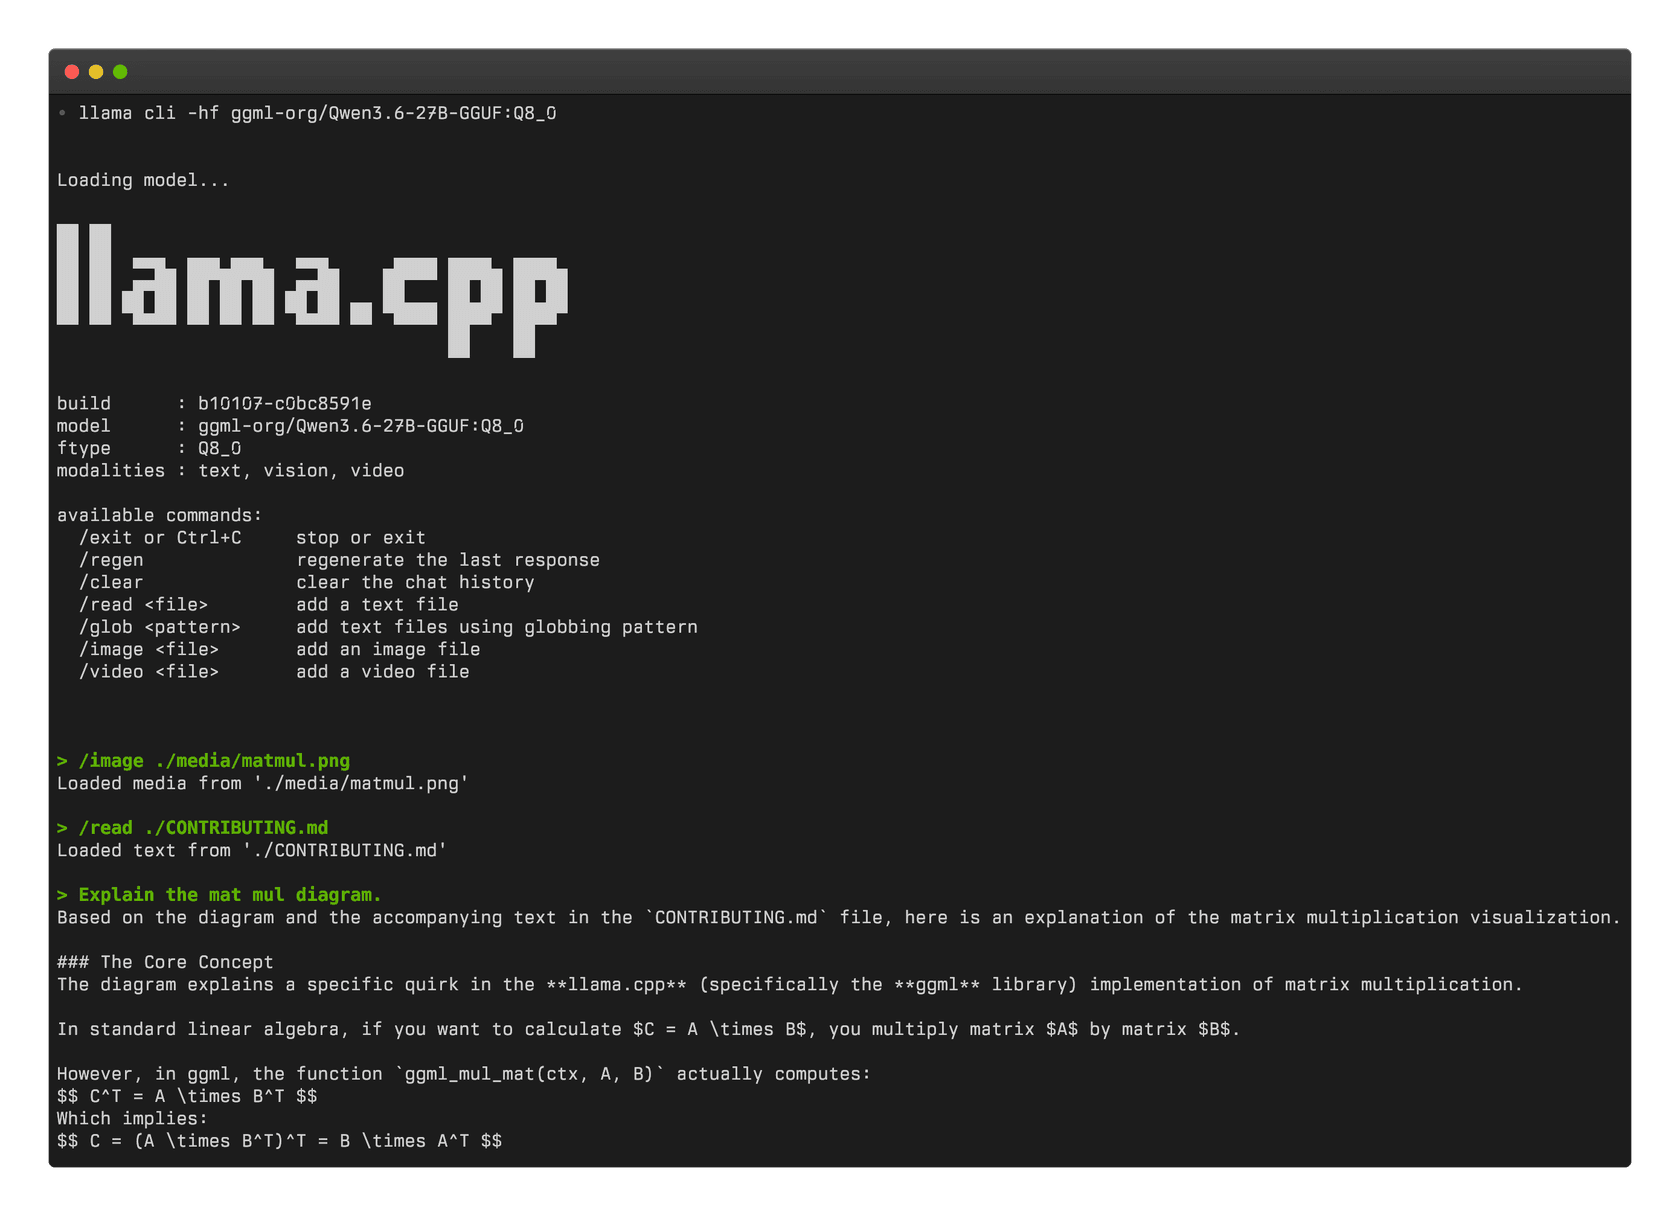
2. A linha de comando (qualquer sistema operacional). Uma linha instala o binário unificado llama:
curl -LsSf https://llama.app/install.sh | sh
No Windows PowerShell, é irm https://llama.app/install.ps1 | iex. Depois, baixe um modelo do Hugging Face e converse, ou inicie um servidor compatível com OpenAI:
llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF
llama serve -hf ggml-org/Qwen3.5-0.8B-GGUF
3. Gerenciadores de pacotes ou código-fonte. O anúncio da v1.0 lista Docker, Debian, Homebrew, conda-forge, MacPorts, Winget e um XCFramework para iOS e macOS, além de binários pré-compilados para Linux, macOS, Windows, Android e iOS. Construir a partir do código-fonte está no guia de build.
Apontando agentes de código para ele
O app Llama expõe sua API em localhost:9931/v1, e o site diz que ele fala endpoints compatíveis tanto com OpenAI quanto com Anthropic, com streaming, chamadas de ferramentas, saída estruturada e visão. Isso significa que ferramentas como Cursor, OpenClaw ou Claude Code podem apontar para um modelo local só trocando a URL base, o mesmo padrão que descrevi no meu guia de variáveis de ambiente do Claude Code. Não testei esse caminho eu mesmo na v1.0, então trate como a rota documentada.
Uma checagem rápida de realidade sobre qualidade: um modelo local pequeno não vai igualar um modelo de fronteira hospedado em trabalho de código difícil. Minhas comparações do DeepSeek V4 Flash e do Qwen 3.8 Max são um guia melhor do que cada nível consegue fazer.
O que ainda está faltando?
Três lacunas se destacam na release e nas reações a ela.
- Sem app de desktop para Linux. O Llama é só para Mac e Windows; usuários de Linux ficam com a linha de comando. Um comentarista no anúncio perguntou exatamente sobre isso.
- Processamento de prompts em entradas enormes. Outro comentarista no mesmo post disse que o llama.cpp "ainda precisa melhorar no processamento de prompts enormes", ou seja, a etapa de prefill antes do primeiro token. A release trouxe trabalho de prefill (um caminho FlashAttention Vulkan para Intel, matmuls de poucas linhas para CUDA), mas sem um número de destaque para apontar.
- Os instaladores ainda não estão na v1.0. Como coberto acima, o instalador do llama.app e o Winget ainda publicam nightlies. Isso é aceitável para a maioria dos usuários, mas significa que a promessa de estabilidade da v1.0 só chega até você se construir a partir da tag ou usar o Homebrew.
Nada disso é motivo para pular essa versão. São motivos para checar em qual build você está antes de confiar na promessa.
O que o llama.cpp significa para equipes de suporte?
O apelo é óbvio: dados de clientes que nunca saem do seu hardware, e nenhuma cobrança por token. É um tema que escuto nas ligações de vendas da eesel. Um comprador de uma empresa dinamarquesa de telemática B2B teve que passar por uma revisão de segurança interna rigorosa antes de qualquer teste, e a primeira pergunta dele foi se os dados de tickets contendo números de cartão e senhas ficariam no ambiente deles.
Um modelo local responde a parte disso. Não responde ao resto: quais artigos de ajuda o agente pode usar, quando ele passa um ticket para uma pessoa, como você sabe que ele está certo antes de os clientes verem. Essas são as perguntas por trás da maioria das revisões de segurança de IA em suporte que já vi, e a checklist de segurança de fornecedores e o guia de SOC 2 e GDPR cobrem isso em detalhe.
Essa camada é o trabalho do colega de equipe de IA da eesel para helpdesk. Ele entra na fila que você já roda no Zendesk ou no Freshdesk, responde a partir do seu próprio conhecimento, e é simulado contra tickets passados antes de entrar no ar. A smava, uma empresa de Berlim de comparação de empréstimos, usa isso em 27,000 tickets do Zendesk por mês, com 15,300 rascunhos de resposta preparados em alemão a partir de 820 macros e artigos da central de ajuda. A SE Ranking roda um agente eesel por produto no Zendesk, com reembolsos e pedidos de atendimento humano passados para a equipe.
Se você está pesando modelos para o seu próprio conteúdo de suporte, meus guias sobre conectar o Claude ao seu helpdesk, transferências de agentes de IA e prevenir alucinações de IA no suporte vão além do que uma nota de release consegue.
Você deveria atualizar para o llama.cpp v1.0?
Sim, se você vincula a libllama: esta é a primeira release com uma promessa de compatibilidade escrita, então fixe em v1.x e pare de correr atrás de mudanças incompatíveis em builds noturnas. Faça a limpeza uma vez e está resolvido.
Sim, com cuidado, se você roda o llama-server em uma rede: adicione uma chave de API antes de atualizar para que a nova verificação de ferramentas não pare seu serviço.
Nenhuma ação necessária se você usa um app de desktop. Você provavelmente já está em uma build noturna que inclui tudo da v1.0, e o novo app Llama da Hugging Face é a forma mais fácil de experimentar modelos locais, se ainda não o fez. Para alternativas hospedadas, meu panorama de alternativas ao Hugging Face e minha lista de ferramentas de rastreamento de LLM são boas próximas leituras.
Experimente a eesel para IA na sua fila de suporte
Se você olhou para o llama.cpp porque quer IA respondendo clientes, a eesel te leva até lá sem escolher uma quantização ou dimensionar uma GPU. É um colega de equipe de IA para helpdesk que se conecta ao Zendesk, Freshdesk e outros helpdesks, responde só a partir da sua central de ajuda e de tickets passados, e é testado em conversas históricas antes de tocar em uma conversa em tempo real, do jeito que a smava roda em 27,000 tickets por mês. Com a CLI da eesel, seu agente de código pode subir artigos de ajuda e macros exportados, fazer perguntas de teste e verificar as respostas; conectar o helpdesk em si ainda precisa de alguém com acesso de administrador. Experimente a eesel gratis.
Perguntas frequentes
O que é o llama.cpp?
O que mudou no llama.cpp v1.0.0?
O llama.cpp é gratuito?
Como instalo o llama.cpp?
curl -LsSf https://llama.app/install.sh | sh; no Windows, execute irm https://llama.app/install.ps1 | iex. Homebrew, Winget, Docker, conda-forge e binários pré-compilados também funcionam. Depois, llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF baixa um modelo do Hugging Face e inicia um chat.O llama.cpp v1.0 quebra minha configuração atual?
llama_set_warmup e a opção --defrag-thold deixaram de existir. Se você roda o llama-server em um endereço de rede com ferramentas ou MCP ativados e sem chave de API, a v1.0 recusa iniciar até você adicionar --api-key, ou optar explicitamente com --allow-unauthenticated-tools. Meu guia sobre MCP para suporte ao cliente explica por que o acesso a ferramentas merece essa barreira.Qual a diferença entre o llama.cpp e o app Llama?
localhost:9931/v1. Ferramentas como Claude Code ou OpenClaw podem apontar para esse endpoint local.O llama.cpp pode rodar um chatbot de suporte ao cliente?
O llama.cpp v1.0 é a versão que recebo pelo instalador?
llama --version, e veja meu post sobre preços do Hugging Face se você pretende hospedar modelos você mesmo.