

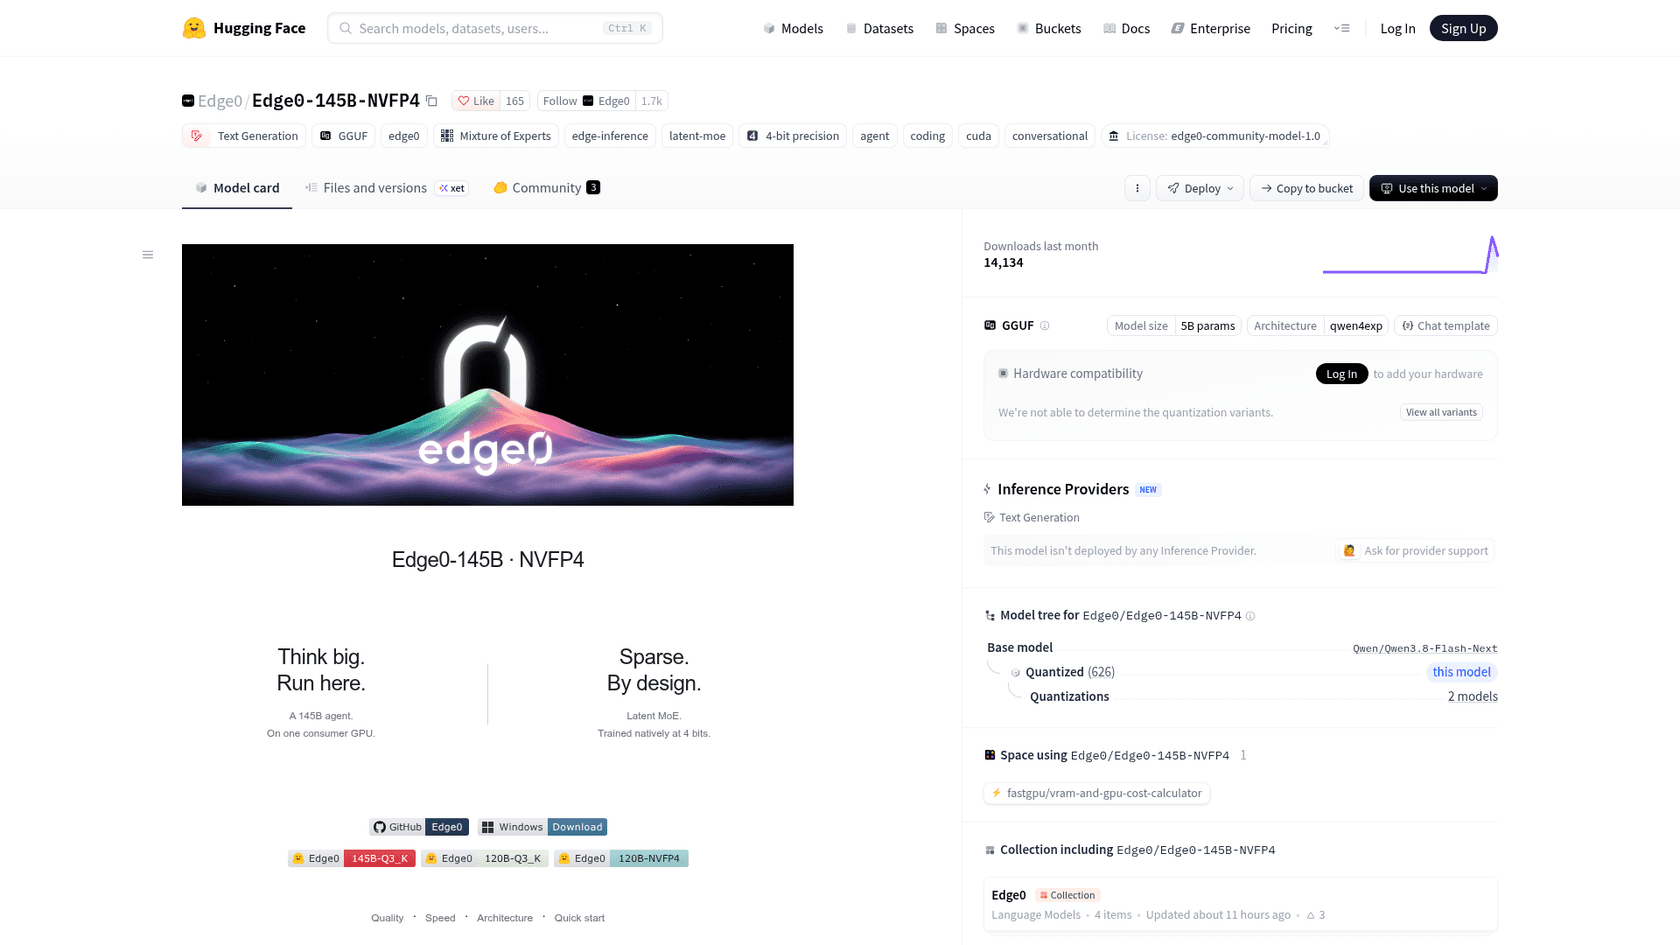
O Edge0-145B é um modelo gratuito de pesos abertos para código e agentes, com 145B de parâmetros, que roda em uma única GPU NVIDIA com 16 GiB de memória mais 20 GiB de RAM do sistema, mantendo os especialistas "quentes" na placa e lendo o resto da RAM e do SSD. É uma versão fortemente retrabalhada do Qwen3.8-Flash-Next, e nos testes próprios da Edge0 ele supera essa base em código. Duas coisas que o post de lançamento passa por cima: o macOS ainda não é suportado, e a licença bloqueia serviços de modelo comerciais sem um acordo separado. Se o seu objetivo é IA nos tickets de suporte em vez de uma GPU local, a eesel faz isso com modelos hospedados, e o CLI da eesel permite que um agente de código envie artigos de ajuda aprovados e teste as respostas antes de qualquer coisa entrar no ar.
O que é o Edge0-145B?
O Edge0-145B é um modelo de linguagem de pesos abertos da Edge0, anunciado em 12 de novembro de 2026 junto com um irmão menor, o Edge0-120B. O post de lançamento da Edge0 o apresenta como o primeiro modelo de 145 bilhões de parâmetros feito para rodar em um computador pessoal, com habilidades de código, raciocínio e agente próximas das de modelos na nuvem.
Eu construo os agentes de IA dentro do produto da eesel, então leio lançamentos assim primeiro pelo mecanismo e só depois pelo marketing. Isso acabou importando aqui, porque o model card do Hugging Face e o repositório no GitHub contam uma história mais precisa que o post de lançamento. Eu não tenho uma placa RTX na minha mesa, então tudo abaixo vem desses documentos e das notas de versão, não de uma execução própria. Para um veredito sobre a qualidade, a análise do Edge0-145B do meu colega entra nisso separadamente.
Eis o que a Edge0 publicou sobre o modelo:
| Especificação | Edge0-145B |
|---|---|
| Parâmetros totais | 145B, cerca de 10.12B ativos por token |
| Modelo base | Derivado do Qwen3.8-Flash-Next |
| Arquitetura | Mistura de especialistas esparsa latente, 48 camadas, 512 especialistas por camada |
| Especialistas por token | 10 roteados mais 1 compartilhado |
| Contexto | 256K tokens (cache KV em int8, 32K mantidos na GPU) |
| Builds | Q3_K com 40.81 GiB, NVFP4 com 47.79 GiB |
| Decodificação especulativa | Draft head embutido de 1.26B |
| Motor | edge0-strata, executado via edge0-infer |
| Plataformas hoje | Linux e Windows, GPU NVIDIA com CUDA 13 |
| Licença | Edge0 Community Model License 1.0 mais a Qwen Community License |
O modelo base é a parte que o post de lançamento enterra. O model card lista o Qwen/Qwen3.8-Flash-Next como base, e os agradecimentos creditam tanto o Qwen quanto o motor de inferência aberto Strata. Essa é a prática normal em pesos abertos, e é útil saber: se você já roda o Qwen3.8-Flash-Next, o Edge0-145B é uma versão rearquitetada e retreinada de um modelo que você conhece, não uma família sem relação.
Como um modelo de 145B cabe em uma GPU?
Não cabe, não tudo de uma vez. O truque é que apenas cerca de 10B dos 145B de parâmetros trabalham em um token qualquer, então o motor só precisa manter esses perto da GPU. A Edge0 combina quatro ideias para fazer isso funcionar:
- Matrizes de especialistas compartilhadas. Em um modelo de mistura de especialistas normal, cada especialista guarda seu próprio conjunto completo de pesos. A Edge0 projeta cada token para uma largura "latente" menor, e as grandes matrizes de projeção são compartilhadas entre especialistas. Cada especialista mantém apenas um pequeno registro (cerca de 1.6 MB), então milhares deles cabem na memória da GPU.
- Três níveis de armazenamento. Especialistas usados com frequência ficam na GPU. O resto fica na RAM do sistema. Uma tabela de consulta de 51.2B de parâmetros, que o modelo lê com moderação, fica no SSD e é lida sob demanda.
- CPU e GPU juntas. A GPU calcula os especialistas que já tem enquanto a CPU lida com os demais em paralelo.
- Decodificação especulativa. Um pequeno draft head de 1.26B propõe vários tokens, e o modelo principal os verifica em uma única passagem, o que distribui o custo de ler pesos por mais saída.
A Edge0 também treinou o modelo nesse formato desde o início, em vez de espremer um modelo de nuvem depois. A arquitetura explica tanto a boa notícia (roda em uma placa gamer) quanto a pegadinha (depende muito da velocidade da RAM do sistema e do SSD), assunto da próxima seção.
Que hardware você realmente precisa?
É aqui que o post de lançamento e os arquivos da versão não concordam. A manchete do post de lançamento é "29GB de pico de memória" em "um laptop pessoal compatível, como um MacBook Pro". Os arquivos dão um retrato mais completo.
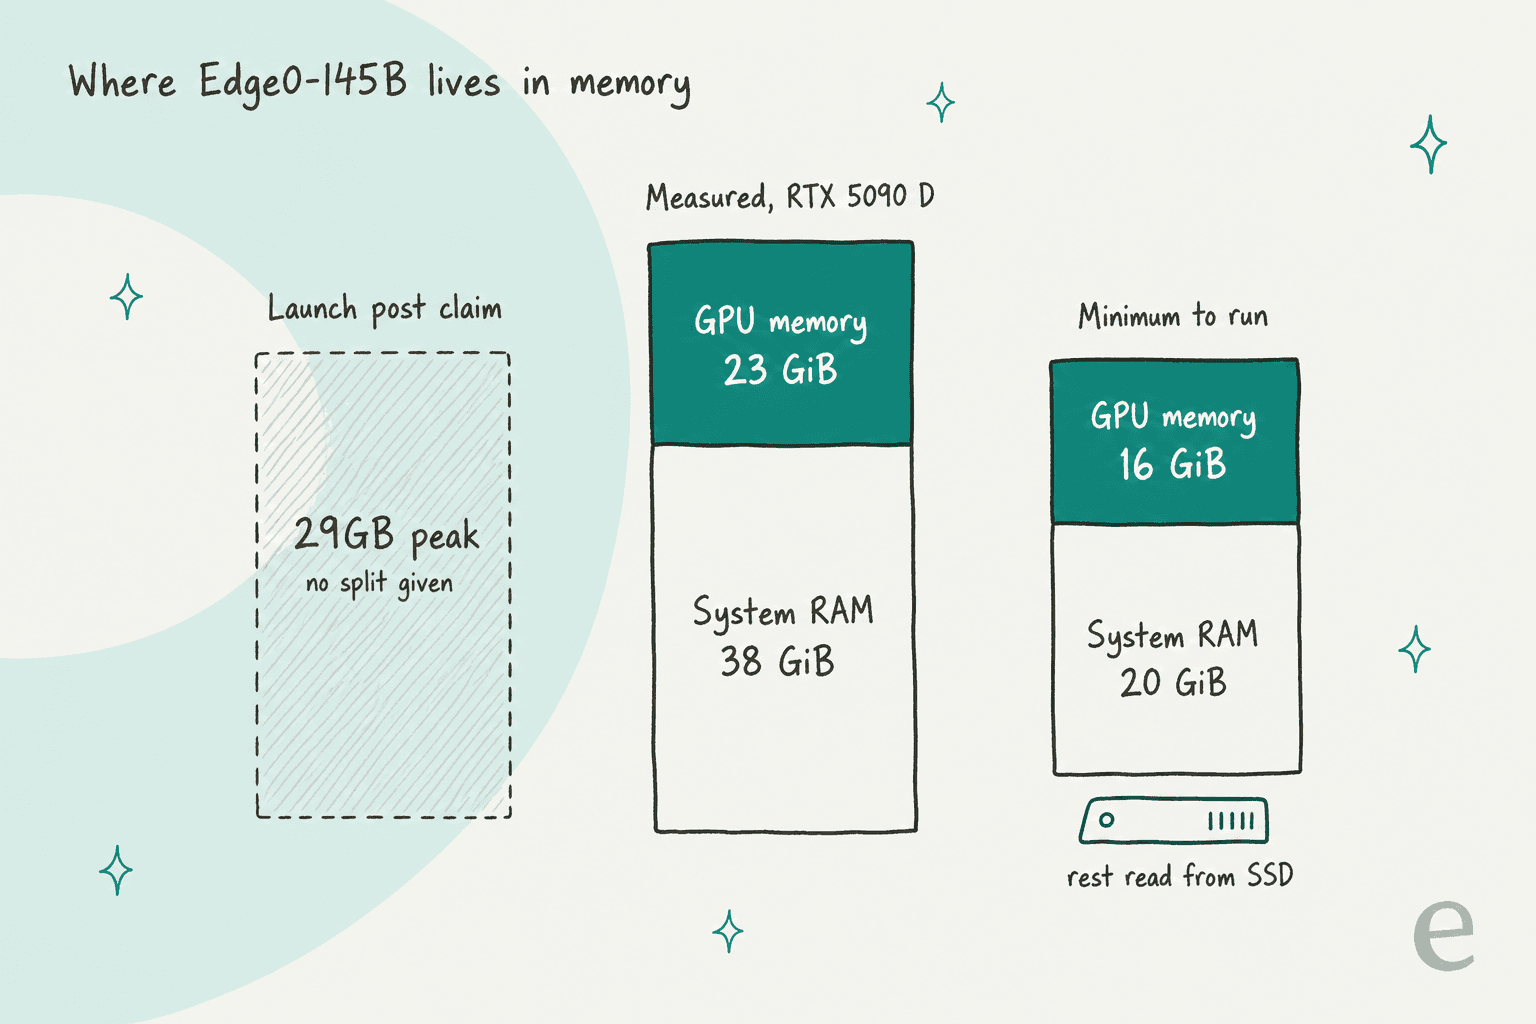
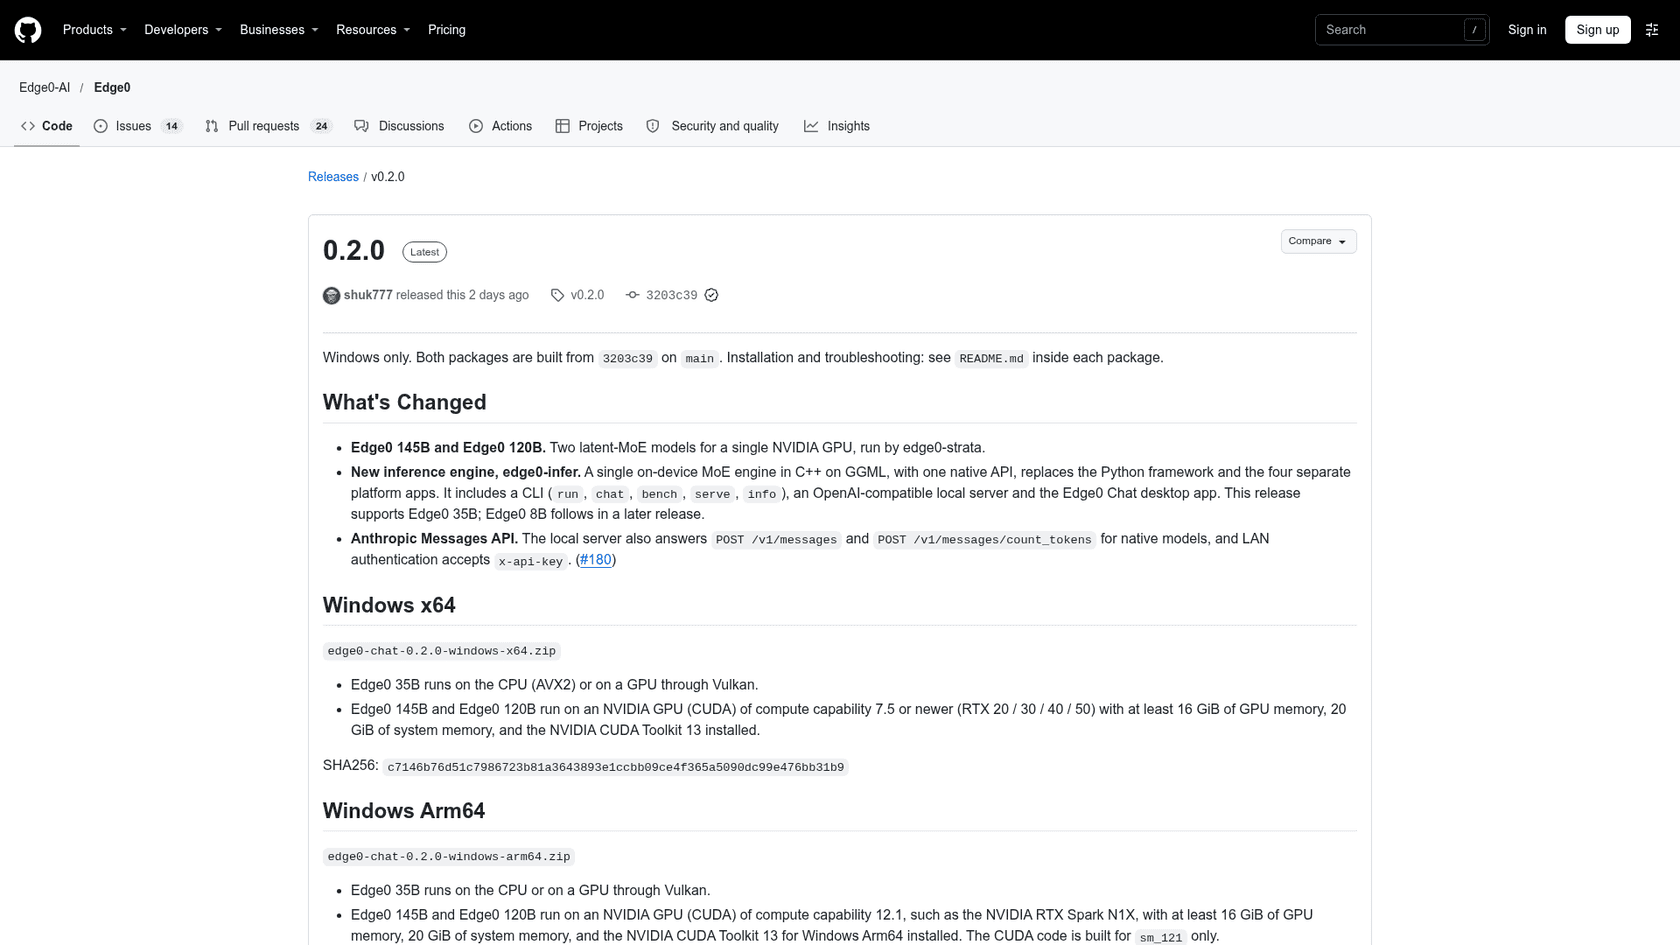
As notas da versão v0.2.0 definem o mínimo para Windows x64: uma GPU NVIDIA com capacidade de computação 7.5 ou mais recente (séries RTX 20, 30, 40 ou 50), pelo menos 16 GiB de memória de GPU, 20 GiB de memória do sistema, e o CUDA Toolkit 13. No Windows Arm64, o alvo é a RTX Spark N1X.
Em velocidade máxima, ele usa mais. O model card diz que, com a residência ativada, o build NVFP4 usou 23.25 GiB de VRAM mais 38.27 GiB de RAM do host em uma RTX 5090 D 24 GB, e o build Q3_K usou 23.14 GiB mais 31.28 GiB. Os números de 16 GiB mais 20 GiB vêm da mesma placa com limites aplicados, em velocidade menor.
A afirmação sobre o Mac é a maior lacuna. A tabela de plataformas do README do GitHub marca o macOS como não suportado para os modelos 145B e 120B, e o model card diz que seu benchmark no Apple M2 Ultra "does not establish macOS release availability". Leitores no Hacker News notaram isso no primeiro dia:
"The blog post mentions Mac repeatedly, saying things like 'day-one support covers macOS'. But the released stuff so far seems to be CUDA only."

Então, se você está no Apple Silicon, o menor Edge0-35B é o modelo da Edge0 que roda hoje. Para algo maior em um Mac, um modelo hospedado como o Qwen 3.8 Max ou o DeepSeek V4.1 Flash é o caminho prático por enquanto.
Escolha sua máquina para ver onde você fica:
Minha máquina roda o Edge0-145B?
Qual é a velocidade do Edge0-145B?
Rápido na placa certa. A tabela de velocidade do model card, toda a partir de medições próprias da Edge0, em tokens por segundo:
| Máquina | Build | Prefill 16K | Decode de chat | Decode de agente |
|---|---|---|---|---|
| RTX 5090 D 24 GB | Q3_K | 3,554.9 | 99.7 | 121.2 |
| RTX 5090 D 24 GB | NVFP4 | 3,165.7 | 79.6 | 98.3 |
| RTX 4090 24 GB | Q3_K | 3,179.4 | 69.9 | 91.7 |
| RTX Spark N1X 60 GiB | NVFP4 | 922.4 | 40.1 | 46.0 |
| Apple M2 Ultra (Metal) | Q3_K | 800.3 | 60.9 | 57.0 |
| 16 GiB VRAM + 20 GiB RAM | Q3_K | 335 | 36.8 | 44.9 |
O "decode de agente" roda mais rápido que o chat porque a saída do agente (código, chamadas de ferramenta) é mais previsível, então os palpites do draft head acertam com mais frequência. Duas notas práticas: o build Q3_K é menor e mais rápido que o NVFP4 na mesma placa, e a RTX 5090 D é uma variante para o mercado chinês da 5090, então uma 5090 padrão deve ser pelo menos igualmente rápida.
Quão bom ele é, segundo a Edge0?
Nas avaliações internas da Edge0, o Edge0-145B lidera sua base Qwen nos dois testes de agente e código e fica um pouco atrás em conhecimento:
| Modelo | DeepSWE 1.1 | Terminal-Bench 2.1 | GPQA-Diamond | IFBench | HLE | AA-LCR |
|---|---|---|---|---|---|---|
| Edge0-145B | 64.6 | 86.5 | 90.4 | 80.6 | 35.4 | 79.3 |
| Qwen3.8-Flash-Next | 58.7 | 83.3 | 91.7 | 81.3 | 35.9 | 79.1 |
| DeepSeek-V4-Flash-0731 | 54.4 | 82.7 | 90.8 | 79.2 | 33.8 | 79.7 |
| Qwen3.8-27B | 42.2 | 73.0 | 89.2 | 79.5 | 30.8 | 82.0 |
| Claude-Opus-4.6 (Max) | n/a | 78.2 | 91.3 | 62.5 | 40.0 | 78.0 |
Três ressalvas antes de confiar nesses números. Primeiro, a própria Edge0 rodou esses testes, e um relatório técnico completo com passos de reprodução foi prometido mas ainda não saiu. Segundo, a comparação com a nuvem é com o Claude Opus 4.6, que está duas gerações atrás do atual Claude Opus 5.5 e do Claude Fable 5.2. Terceiro, as próprias páginas da Edge0 discordam sobre o 120B: o post de lançamento dá a ele 53.6 no DeepSWE e 81.3 no Terminal-Bench, enquanto o README do GitHub diz 51.3 e 75.3.
O Terminal-Bench ainda é um sinal útil para trabalho com agentes, como um desenvolvedor apontou:
"TerminalBench scores often correspond to real world performance for coding agents that rely heavily on bash."
Se você quer uma forma mais ampla de julgar modelos nas suas próprias tarefas, minhas notas sobre benchmarking de agentes de IA de suporte e o panorama de ferramentas de rastreamento de LLM cobrem o método.
Como instalar e executar o Edge0-145B?
Há duas rotas, e ambas precisam da configuração NVIDIA acima.
O app de desktop (só Windows). Baixe o edge0-chat-0.2.0-windows-x64.zip da página de releases, baixe uma pasta de modelo do Hugging Face, abra o Edge0 Chat e escolha a pasta. A Edge0 diz que os recursos principais do app funcionam offline, sem conta nem cota de uso.
A linha de comando (Linux ou Windows). Clone o repositório, compile o motor edge0-strata e o edge0-infer seguindo as instruções do repositório, e depois aponte para uma pasta de modelo:
git clone https://github.com/Edge0-AI/Edge0.git edge0
build/cpu/bin/edge0-infer serve --model /path/to/Edge0-145B-Q3_K
Depois que os pesos carregam, aparece Listening: http://127.0.0.1:8000 e ele serve endpoints compatíveis com OpenAI e Anthropic sob o nome de modelo edge0_145b. O edge0-infer chat abre uma sessão interativa em vez disso.
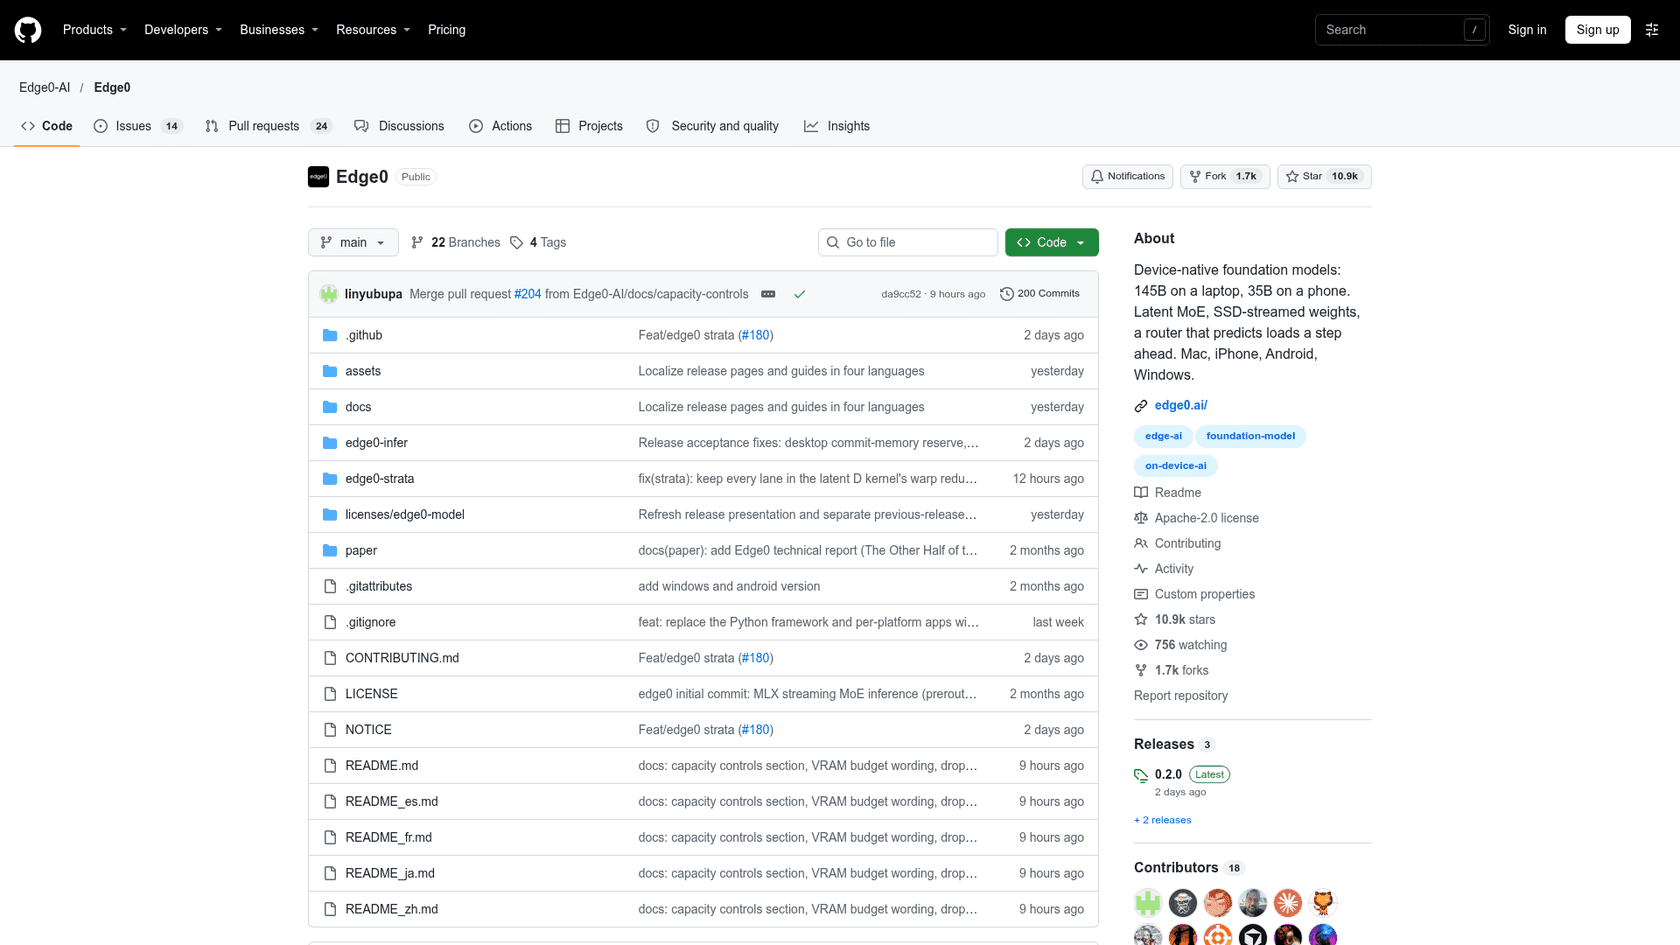
Duas configurações importam mais quando a memória está no limite. --mmap-experts lê especialistas sem cache a partir do SSD em vez de mantê-los na RAM, e --resident-budget-gib 20 limita o cache de especialistas na RAM a 20 GiB, o que exige um arquivo de perfil de especialistas estático. Ambos ficam no model.json da pasta do modelo, então o app e o CLI os pegam.
Usando a partir de um agente de código
Como o servidor local fala o formato Anthropic Messages, ferramentas que aceitam uma base URL própria podem, em princípio, apontar para ele. Para o Claude Code, isso significa definir ANTHROPIC_BASE_URL para http://127.0.0.1:8000 e escolher edge0_145b como modelo, o mesmo padrão de qualquer endpoint próprio. Meus guias de variáveis de ambiente do Claude Code e seleção de modelo cobrem as variáveis.
O OpenClaw e outras ferramentas compatíveis com a OpenAI podem usar o endpoint /v1/chat/completions. Eu não testei nenhum dos dois caminhos pessoalmente, então trate isso como a rota documentada, não como uma verificada.
O que a licença permite?
O post de lançamento chama o Edge0-145B de "open-source". A licença é mais restrita do que essa palavra sugere, um ponto levantado em minutos no Hacker News:
"This is not open source, this is open weights"
Segundo o model card, a Edge0 Community Model License 1.0 permite:
- Uso pessoal, pesquisa e modificação
- Compartilhamento não comercial e uso interno em uma empresa
- Uso comercial das saídas geradas pelo modelo
Ela exige uma licença escrita separada da Edge0 para:
- Vender ou empacotar comercialmente o modelo
- Operar um serviço de modelo comercial
- Oferecer um assistente comercial independente de código ou escritório construído sobre ele
A licença comunitária da Qwen se aplica por cima, já que o modelo é derivado de materiais da Qwen. O código do motor em si é Apache-2.0. Na prática: tudo bem para a máquina própria de um desenvolvedor ou uma ferramenta interna, não tudo bem como motor de um produto que você vende sem falar antes com a Edge0. Meu panorama de agentes de IA open source lista ferramentas com condições mais soltas se isso for um obstáculo.
O que o Edge0-145B significa para equipes de suporte?
O apelo para o suporte é óbvio: dados de clientes que nunca saem do seu hardware, e nenhuma conta por token. Essa é uma preocupação real que eu escuto. Em uma chamada de vendas da eesel, um avaliador técnico em uma empresa de hardware queria a garantia de que a IA responderia apenas a partir de conhecimento aprovado, não da web ou de dados gerais de treinamento, antes de seguir adiante.
Mas um modelo local responde a uma pergunta diferente. Onde o modelo roda decide onde os dados são processados. O que ele diz a um cliente depende da camada em volta dele: quais artigos de ajuda e tickets anteriores ele pode ler, o que faz quando não encontra uma resposta, quando transfere para uma pessoa, e se alguém o testou antes em conversas reais. Um modelo de 145B em uma placa RTX chega sem nada disso, e a licença exclui transformá-lo em um assistente de suporte comercial sem um acordo.
Essa camada é o trabalho do colega de equipe de IA da eesel para o helpdesk. Ele entra na fila que você já roda no Zendesk ou no Freshdesk, responde a partir do seu próprio conhecimento, e é simulado contra tickets anteriores antes de entrar no ar.
A SE Ranking roda um agente eesel por produto no Zendesk em três produtos, lidando com 4,650 conversas por mês a partir de cerca de 16,800 páginas de conhecimento, com reembolsos e pedidos de uma pessoa transferidos para a equipe. A Innr, uma empresa holandesa de iluminação inteligente, faz a eesel redigir respostas do Freshdesk no idioma do próprio cliente a partir de 1,500 artigos de ajuda e tickets anteriores.
Se você está avaliando modelos para o seu próprio conteúdo de suporte, meus guias sobre conectar o Claude ao seu helpdesk, MCP para suporte ao cliente e transferências de agentes de IA vão além do que um model card consegue.
Você deveria testar o Edge0-145B?
Sim, se você tem uma placa RTX com 16 GiB ou mais, 32 GiB ou mais de RAM e um SSD rápido, e quer um modelo de código local forte sem conta por token. Use o build Q3_K, rode-o no Claude Code ou no seu agente habitual em uma tarefa que você já resolveu, e compare com o seu modelo de nuvem.
Espere, se você está em um Mac, em AMD, ou planeja embarcá-lo em um produto comercial. Os dois primeiros precisam de suporte de plataforma que ainda não foi lançado, e o terceiro precisa de uma conversa sobre licença. Nesse meio-tempo, o Qwen3.8-Flash-Next é a base a observar, e meus textos sobre o Qwen em geral e o Kimi K3 cobrem as alternativas abertas mais próximas.
Experimente a eesel para IA na sua fila de suporte
Se o motivo pelo qual você olhou para o Edge0-145B foi IA que responde aos seus clientes, a eesel te leva até lá sem comprar uma GPU. É um colega de equipe de IA de helpdesk que se conecta ao Zendesk, Freshdesk e outros helpdesks, responde só a partir da sua central de ajuda e de tickets anteriores, e é testado em conversas históricas antes de tocar em uma conversa ao vivo, do mesmo jeito que a SE Ranking roda isso em três produtos. Veja os preços ou experimente a eesel de graça.
Perguntas frequentes
O que é o Edge0-145B?
Que hardware o Edge0-145B exige?
Posso rodar o Edge0-145B em um Mac?
O Edge0-145B é open source?
Quanto custa o Edge0-145B?
Como o Edge0-145B se compara ao Qwen3.8-Flash-Next?
Posso usar o Edge0-145B com o Claude Code?
edge0-infer serve expõe endpoints compatíveis com OpenAI e Anthropic em 127.0.0.1:8000 com o nome de modelo edge0_145b, então ferramentas que aceitam uma base URL própria podem apontar para lá. Defina ANTHROPIC_BASE_URL para o servidor local e escolha o modelo, como no meu guia de variáveis de ambiente do Claude Code. Verifique a licença antes de usá-lo dentro de um produto comercial.