

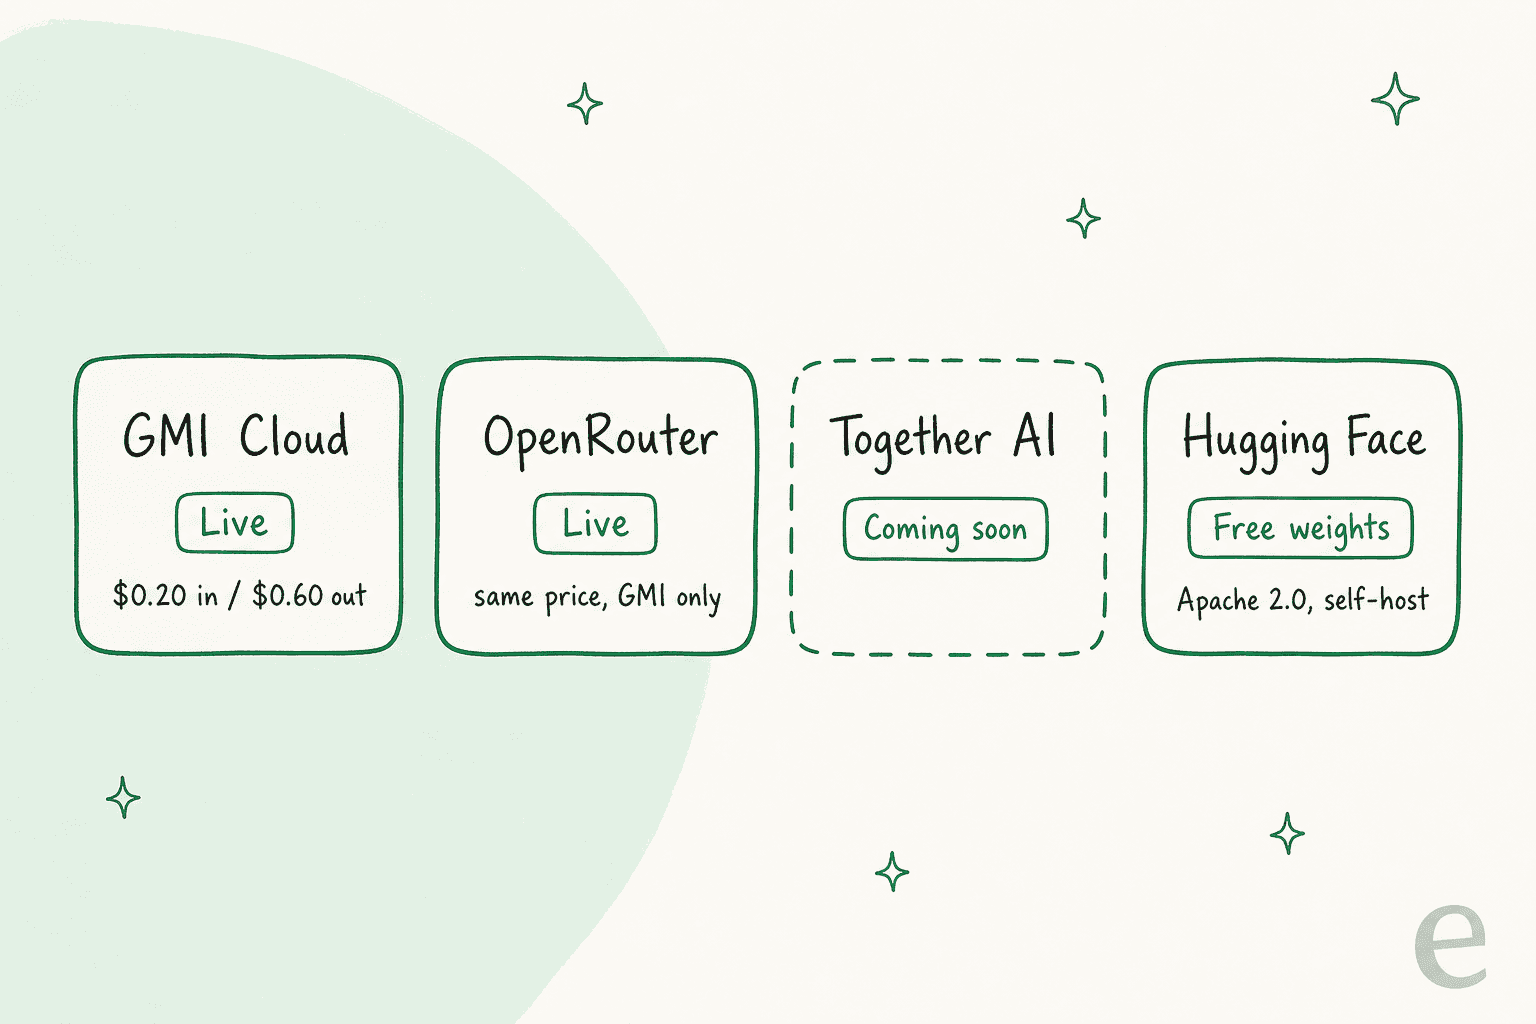
O preço do Ripple-65B é de $0.20 por milhão de tokens de entrada e $0.60 por milhão de saída, com a entrada em cache a $0.05, e há apenas um provedor por trás: a GMI Cloud, diretamente ou pelo OpenRouter. Para uma sessão de agente de programação com 1M de tokens de entrada (80% em cache) e 50K de saída, são cerca de $0.11, um quinto a menos que o Reflection Beam e mais ou menos no mesmo nível do GPT-5.6 Luna. Auto-hospedar raramente compensa: duas B200 alugadas custam cerca de $7,300 por mês, o que só supera a API a cerca de 91 tarefas por hora, sem parar. Se você estava precificando o Ripple para tocar uma fila de suporte, o modelo é a parte barata; o colega de IA de helpdesk da eesel cobre o resto, e a CLI permite que um agente de programação carregue seus documentos de ajuda e teste respostas antes de entrar no ar.
Quanto custa o Ripple-65B?
A Ricursive Intelligence lançou o Ripple-65B Preview em 4 de novembro de 2026 como um modelo de programação denso de 65B sob licença Apache 2.0 (a visão geral do Ripple-65B explica o que ele é e como pontua). Os pesos não custam nada. O acesso hospedado custa o mesmo em todo lugar onde existe, porque todo lugar onde existe são as GPUs de uma única empresa.
| Via | Entrada / 1M | Saída / 1M | Entrada em cache / 1M | Contexto | Status (5 nov. 2026) |
|---|---|---|---|---|---|
| GMI Cloud (direto) | $0.20 | $0.60 | $0.05 | 1,000,000 | No ar, BF16, sem plano gratuito listado |
| OpenRouter | $0.20 | $0.60 | $0.05 | 1,048,576 na API (a página diz 16K) | No ar, a GMI Cloud é o único provedor |
| Together AI | Não listado | Não listado | Não listado | 1M no painel de especificações | "Em breve" |
| Pesos no Hugging Face | Grátis | Grátis | n/d | Até 1M | Apache 2.0, sem provedor de inferência hospedada |
Alguns detalhes importam mais que o preço de tabela:
- A unidade cobrada é o token, nos dois sentidos. A saída custa o triplo da entrada. Um agente de programação que lê muito e escreve pouco fica no lado dos $0.20; um que escreve diffs longos paga mais dos $0.60.
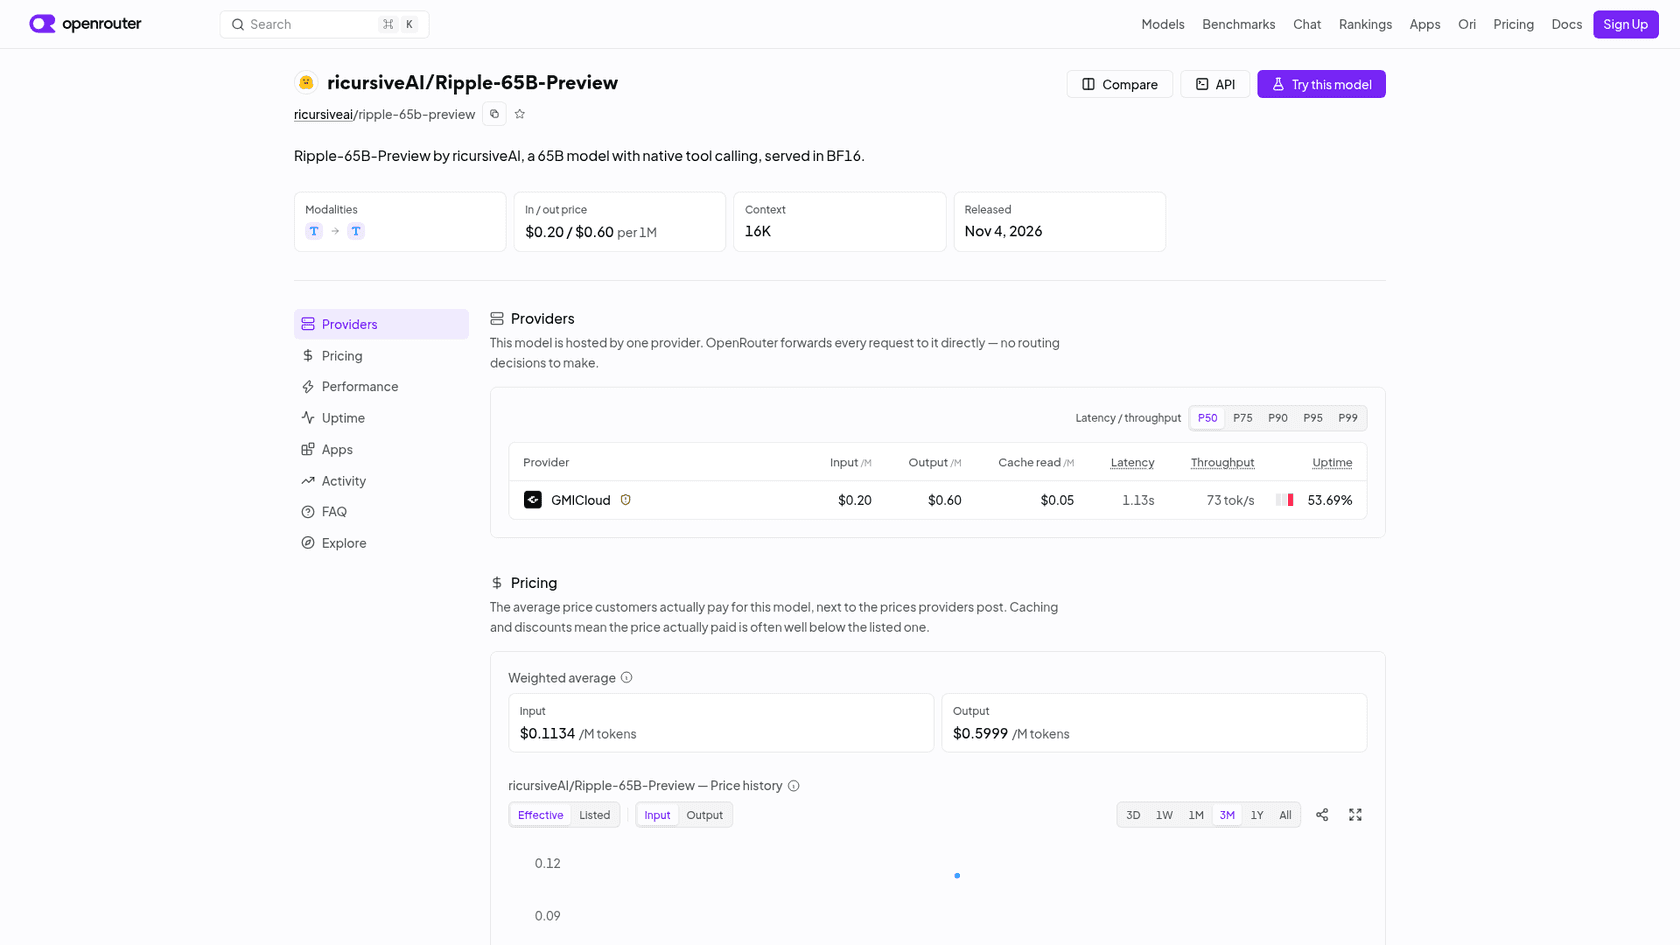
- O cache é uma grande alavanca. A GMI cobra $0.05 por token de entrada em cache e não lista taxa de escrita em cache. O painel de preços do OpenRouter mostrava uma média ponderada de cerca de $0.11 por milhão de tokens de entrada efetivamente pagos, porque prompts repetidos acertam o cache.
- Não há plano gratuito. O OpenRouter não tem variante
:free, e a página do modelo da GMI não mostra nenhuma.
A janela de contexto mudou enquanto eu escrevia isto
Na manhã de 5 de novembro, a API de endpoints do OpenRouter limitava o Ripple a 16,384 tokens de contexto e 14,745 tokens de saída. À tarde, a mesma API informava 1,048,576 tokens de contexto e 131,072 de saída, enquanto a página do modelo acima ainda exibia "16K". A página da GMI dizia 1,000,000 desde o início. Minha leitura: a janela maior está sendo liberada aos poucos e a página ainda não acompanhou. Antes de orçar um agente que precise de uma longa janela de contexto, envie um prompt longo e confirme que ele não é truncado.
Onde comprar o Ripple-65B hoje?
Agora, em exatamente um lugar com duas portas de entrada. O OpenRouter encaminha cada requisição para a GMI Cloud, pelo mesmo preço, então escolher entre eles é questão de conveniência: OpenRouter se você já roteia vários modelos com uma só chave, GMI direto se quiser o endpoint compatível com a OpenAI sem camada intermediária.
Um único host tem um custo que não aparece na tabela de preços: capacidade. O índice de disponibilidade do OpenRouter para o endpoint da GMI ficou entre 51% e 60% ao longo do dia anterior quando verifiquei em 5 de novembro, o que é normal para um modelo adicionado na véspera, mas duro para qualquer coisa voltada ao cliente. A Ricursive disse que o Ripple chegará à Together AI e à Fireworks; a página da Together ainda diz "em breve", com um botão "Notify me" e sem preço.
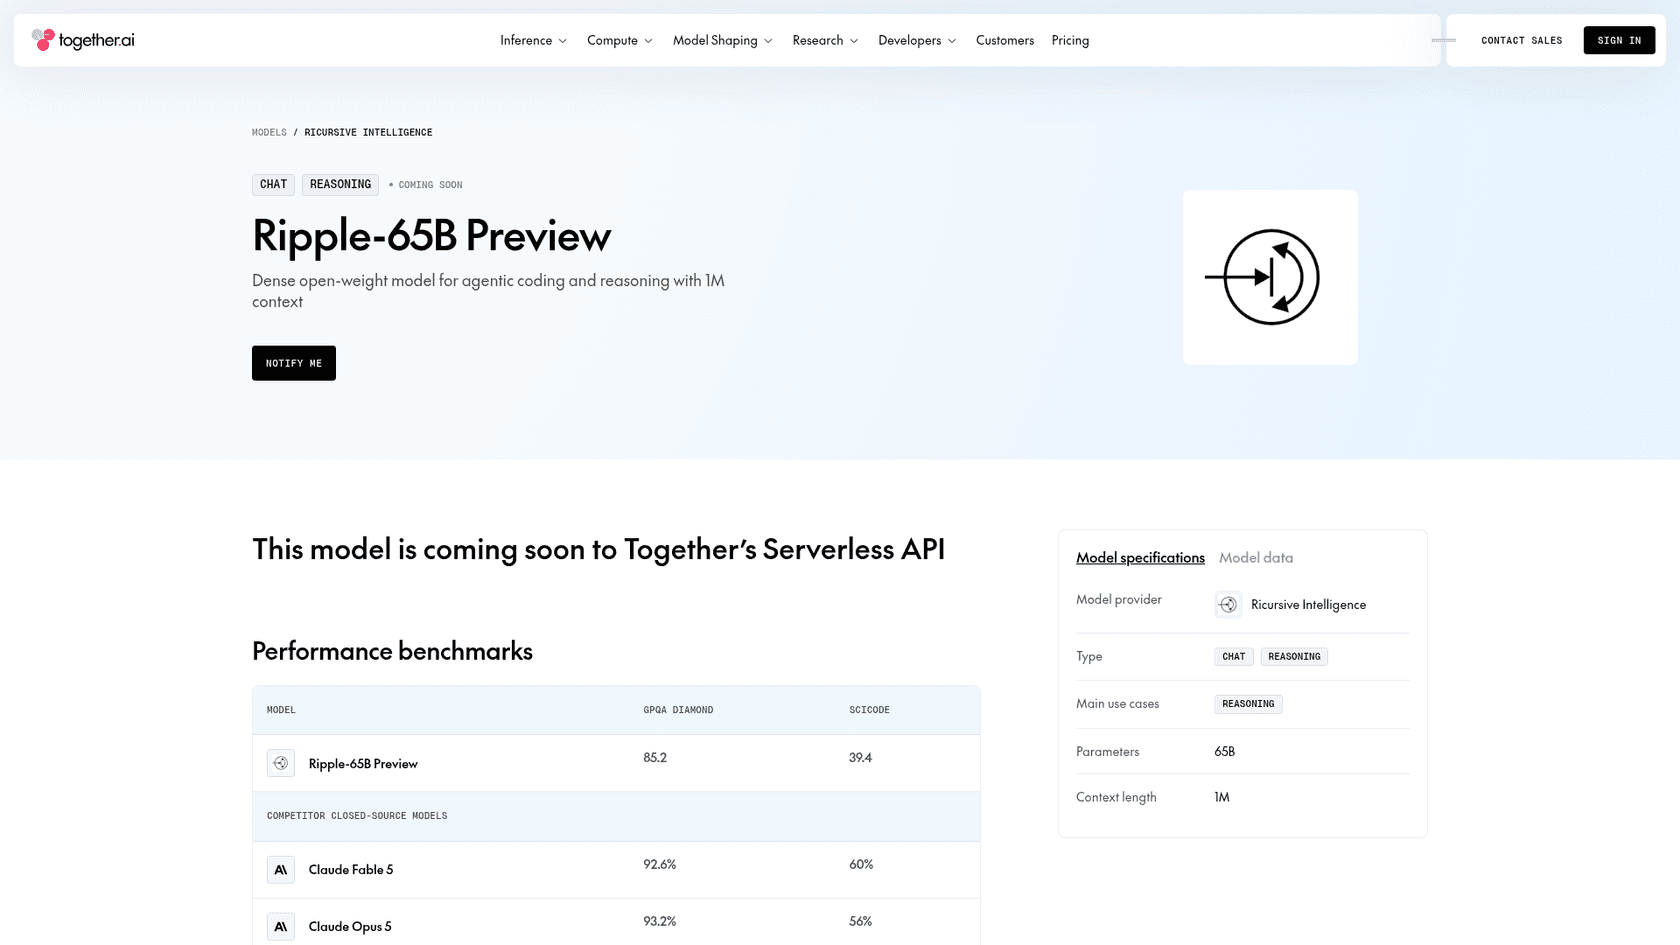
Se você precisa hoje de um segundo provedor para failover, não tem. Esse é o argumento mais forte para esperar algumas semanas antes de o Ripple carregar tráfego de produção, e não tem nada a ver com o preço.
Quanto custa uma tarefa de agente de programação no Ripple-65B?
Preços por milhão não dizem muito até você precificar um trabalho real. Então aqui vai um comprador: uma sessão de agente de IA de programação que envia 1M de tokens de entrada ao longo de todos os turnos, 80% deles acertos de cache, e escreve 50K tokens de saída. É um perfil razoável para um agente que lê um repositório, roda testes e corrige alguns arquivos.
No Ripple, a conta é curta:
- 200K de entrada nova × $0.20 por milhão = $0.04
- 800K de entrada em cache × $0.05 por milhão = $0.04
- 50K de saída × $0.60 por milhão = $0.03
- Total: cerca de $0.11 por tarefa, ou $110 por 1,000 tarefas
Sem cache, a mesma tarefa custa $0.23, mais que o dobro. Aqui está a mesma tarefa em modelos próximos, usando os preços de tabela do OpenRouter de 5 de novembro de 2026:
| Modelo | Entrada / 1M | Saída / 1M | Cache / 1M | Custo por tarefa | Por 1,000 tarefas |
|---|---|---|---|---|---|
| DeepSeek V4.1 Flash | $0.045 | $0.50 | $0.018 | $0.048 | $48 |
| Ripple-65B Preview | $0.20 | $0.60 | $0.05 | $0.110 | $110 |
| GPT-5.6 Luna | $0.20 | $1.20 | $0.02 | $0.116 | $116 |
| Reflection Beam 501B | $0.25 | $1.00 | $0.05 | $0.140 | $140 |
| Qwen3.8 27B | $0.15 | $1.875 | $0.0375 | $0.154 | $154 |
| Inkling Small | $0.45 | $1.20 | $0.10 | $0.230 | $230 |
| Nemotron 3 Ultra 550B | $0.60 | $2.40 | $0.12 | $0.336 | $336 |
| Muse Spark Open | $1.25 | $4.25 | $0.15 | $0.583 | $583 |
| Claude Sonnet 5.5 | $2.00 | $10.00 | $0.10 | $0.980 | $980 |
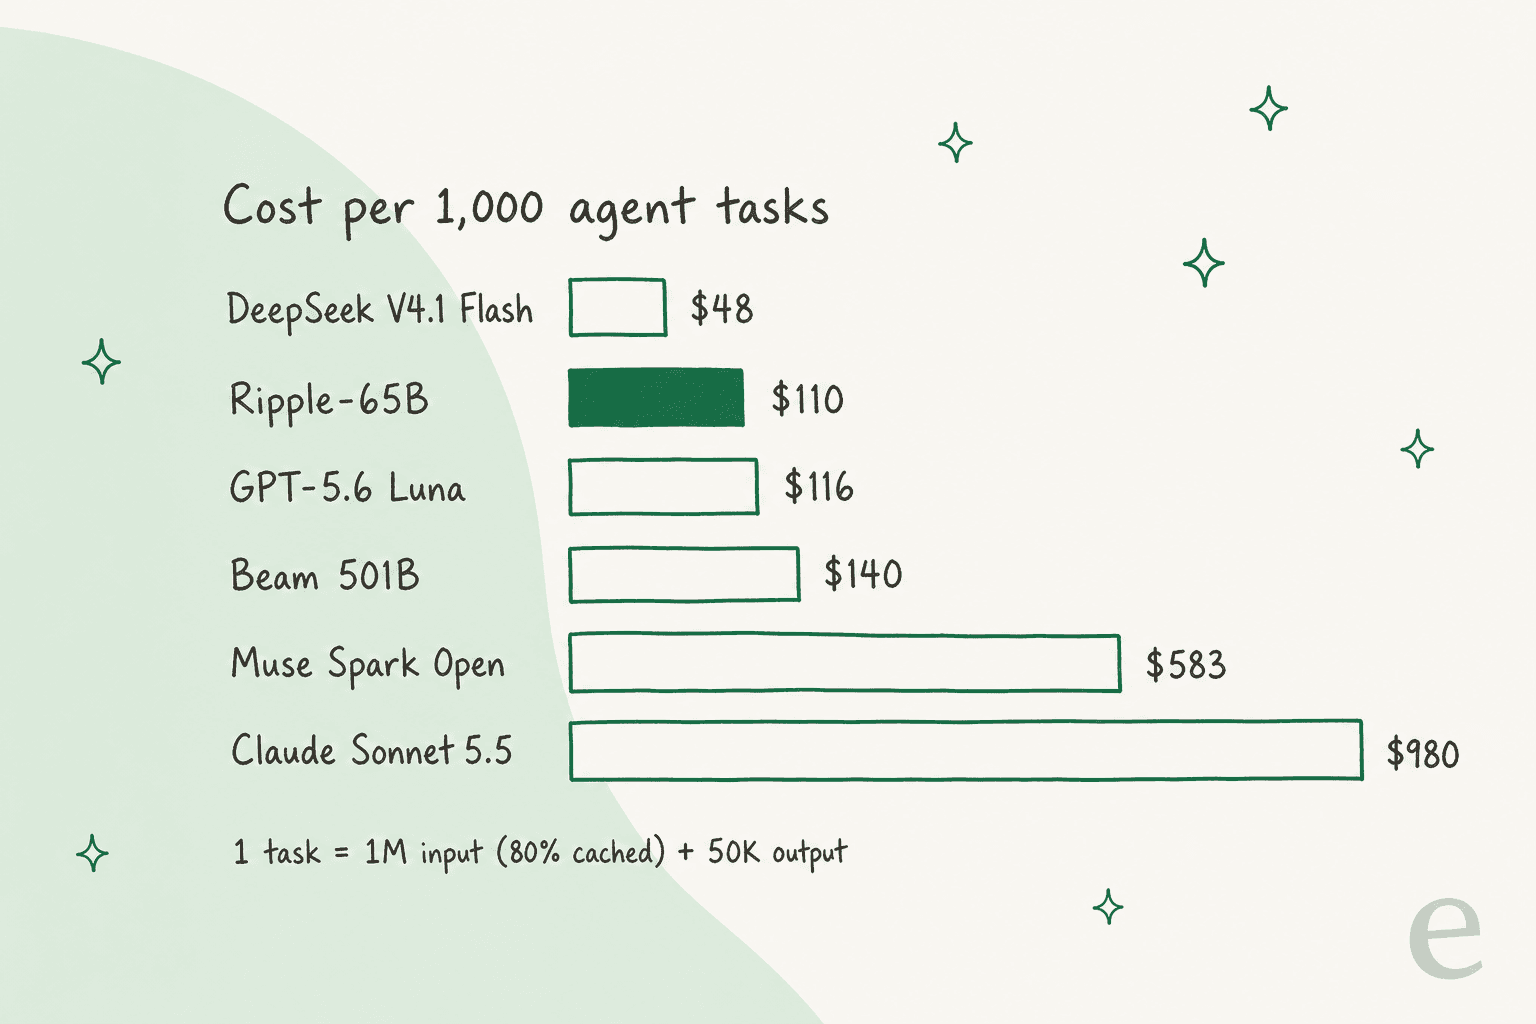
Duas coisas se destacam. Primeiro, o Ripple é o modelo de pesos abertos de fabricação americana mais barato da tabela, cerca de 21% abaixo do Beam, o modelo com o qual empata no Terminal-Bench 2.1 (80.5 contra 80.1 no model card). Se você só pode usar modelos americanos, essa é a comparação que importa, e o Ripple vence no preço.
Segundo, ele não é o modelo mais barato, ponto. O DeepSeek V4.1 Flash faz a mesma tarefa por menos da metade, e o GPT-5.6 Luna fica a menos de um centavo. Então "barato" só é motivo para escolher o Ripple se você já filtrou a lista para pesos abertos americanos. Para o panorama mais amplo, minhas análises dos preços do Kimi K3.1 Pro e dos preços do DeepSeek V4.1 Flash fazem o mesmo tipo de conta.
Quer usar seus próprios números? Esta calculadora reprecifica um mês de trabalho de agente em cada modelo. Defina seu volume de tarefas e a mistura de tokens, e ela mostra onde o Ripple fica e se um servidor 2x B200 alugado venceria a API.
Quando auto-hospedar o Ripple-65B supera a API?
Mais tarde do que você imagina. A Apache 2.0 torna a auto-hospedagem legal e livre de licença, e um modelo denso de 65B é pequeno o bastante para tentar. Mas a API já tem preço bem enxuto, então seu hardware precisa ficar bem ocupado para competir.
A Ricursive publica duas formas de executá-lo, ambas no model card do Hugging Face e no seu repositório NVFP4:
- Data center: BF16 em duas GPUs NVIDIA B200 com SGLang e um modelo rascunho DFlash2, que segundo o card atinge "250 tok/s on 2xB200 batch=8 prior to quantization or custom kernels."
- Mesa: uma versão NVFP4 experimental em um NVIDIA DGX Spark, limitada a uma requisição por vez e 128K de contexto.
Veja quanto cada uma custa frente à API:
| Opção | Custo | O que oferece | Ponto de equilíbrio frente à API |
|---|---|---|---|
| API do Ripple | $0.20 / $0.60 por 1M | Pagamento por token, um provedor | n/d |
| 2x B200, alugadas | GMI Cloud "from $5.00/GPU-hour" = $10/hora, cerca de $7,300 por um mês de 730 horas | 1M de contexto, atendimento em lote | ~66,000 tarefas por mês, ou ~91 por hora, 24 horas por dia |
| DGX Spark, comprado | $6,950 no marketplace da NVIDIA (128 GB) | Uma requisição por vez, 128K de contexto | ~63,000 tarefas ao longo da vida útil do equipamento |
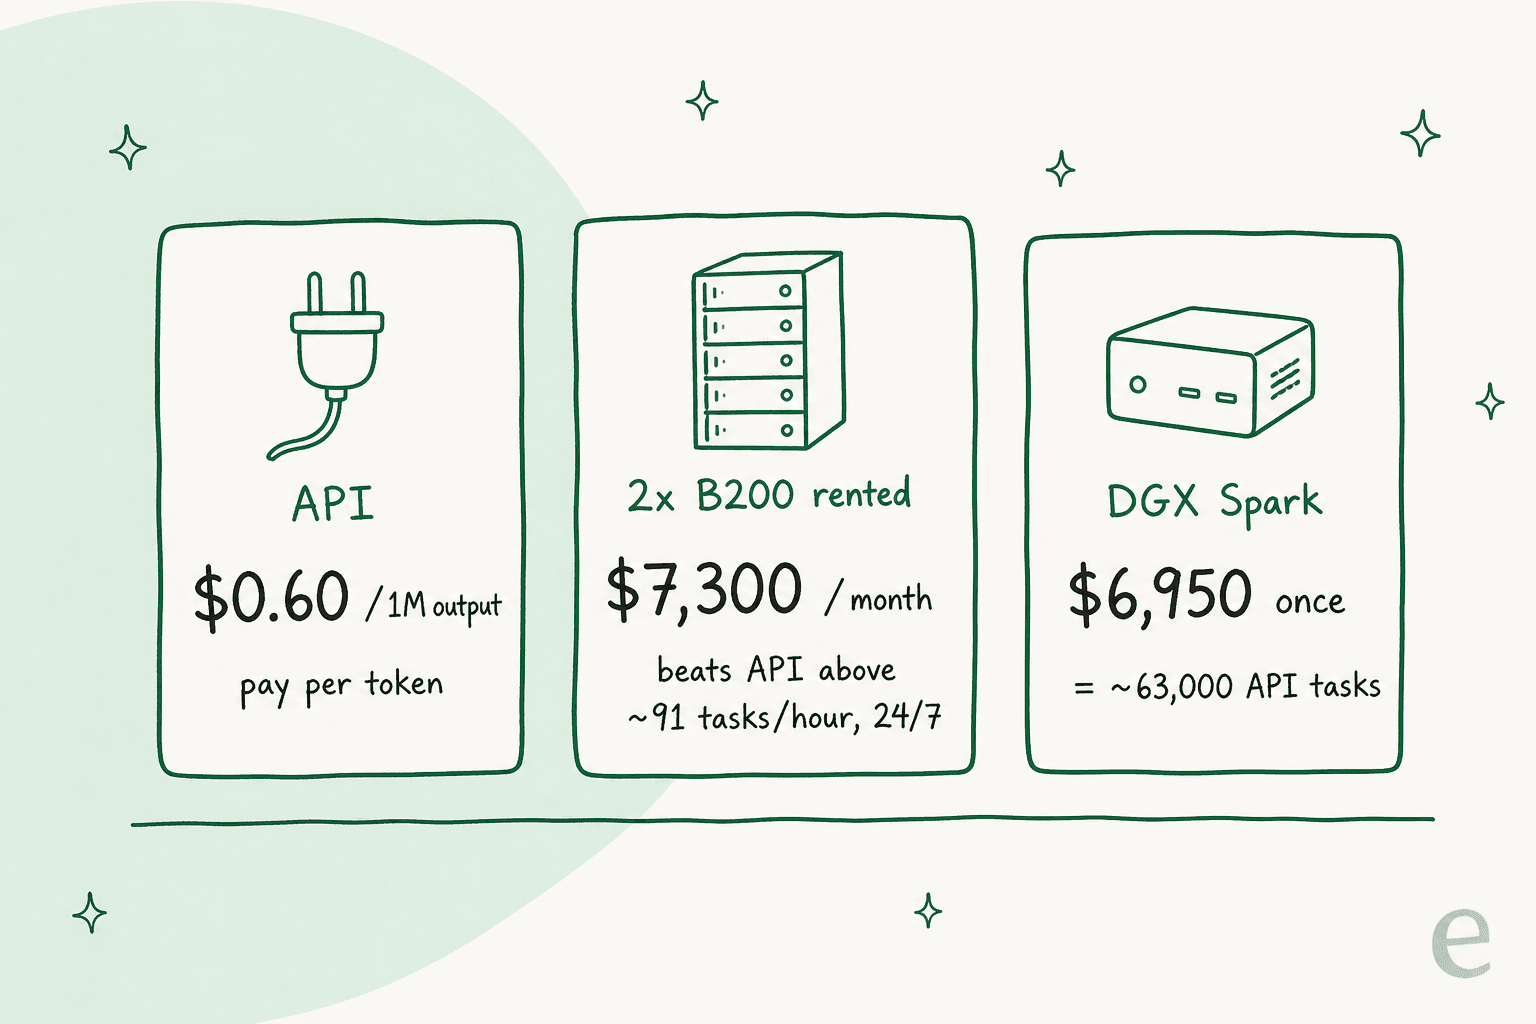
A conta das B200 depende de como se lê esses 250 tok/s. Se for por requisição, oito requisições simultâneas dão cerca de 2,000 tokens de saída por segundo, ou 144 das minhas tarefas de exemplo por hora no melhor caso, então o servidor precisa estar cerca de 63% ocupado, a cada hora do mês, só para empatar com a API (e isso antes do tempo de prefill, das noites ociosas e das horas de um engenheiro). Se for o total entre as oito, o servidor chega a cerca de 18 tarefas por hora no máximo e nunca alcança a API. A Ricursive não diz qual é. As B200 também aparecem como "limited availability" na página da GMI, e $5.00 é um preço "from".
O DGX Spark é outra compra. Por $6,950, equivale a cerca de 63,000 tarefas de agente na API, ou 11.6 bilhões de tokens de saída, e atende uma requisição por vez. Ninguém o compra para economizar com o Ripple. Compra-se para que código e dados nunca saiam do prédio, e alguns comentaristas do HN defenderam exatamente isso:
"There are several situations where some of us are explicitly prohibited from using models from companies not under the jurisdiction of the United States. It doesn't mean these models are competitive when looked at from a global view but it is also not an irrelevant differentiation."

Outros ficaram menos convencidos quanto à velocidade local. Um modelo denso de 65B lê todos os pesos a cada token, ao contrário de um modelo de mistura de especialistas que ativa só uma fatia:
"But as is, it's probably hard to become popular amongst hobbyists and local model enthusiasts like Qwen's 27B class models or MOE models because it's a 65B dense model and inference will be prohibitively slow on consumer grade hardware, and seems like the goal/mission of the company behind this model is to automate chip design."
Minha opinião: auto-hospede o Ripple quando as regras o obrigarem, ou quando você conseguir manter duas B200 ocupadas na maior parte do dia. Para todos os outros, a API a $0.60 é o jeito mais barato de executá-lo, e a análise do Ripple-65B traz o detalhe dos benchmarks para decidir se vale a pena usá-lo.
Por que o Ripple-65B tem um preço tão baixo?
Em parte pelo tamanho. Com 65B de parâmetros densos em BF16, ele cabe em duas B200, enquanto rivais como o Inkling (975B) e o Muse Spark Open (816B) precisam de muito mais memória por cópia. Em parte pelo posicionamento: a Ricursive é um laboratório novo que estreia num campo de modelos chineses mais baratos, e seu argumento é eficiência. Ela disse que o modelo inteiro saiu de um orçamento pequeno:
"Ripple was built on a $32 million compute budget, one-tenth the cost of the previous open-weight SOTA on agentic coding. We're grateful to the open-source community, whose tools and research helped make this possible."
Isso é custo de treinamento, não de serviço, e não define o preço da API; quem define é a GMI Cloud. Mas explica por que o lançamento apostou em valor em vez de pontuações brutas. Trate o preço de hoje como um preço de lançamento de um único host. Quando a Together AI e a Fireworks o listarem, a tarifa pode se mover para qualquer lado, e um segundo provedor importará mais pela confiabilidade do que pelo custo.
O Ripple-65B é barato o bastante para tocar sua fila de suporte?
Os tokens são. Uma resposta de suporte é um trabalho muito menor que uma sessão de programação, geralmente alguns milhares de tokens de entrada e algumas centenas de saída, então 10,000 respostas por mês com 3,000 tokens de entrada e 300 de saída saem por menos de $8 no Ripple. O preço não é o obstáculo.
O encaixe é. O Ripple é um modelo de programação com pós-treinamento leve, e suas pontuações nas linhas mais próximas de suporte da tabela da própria Ricursive são medianas: 31.27 no τ³-bench banking (Beam: 36.1) e 71.67 no uso de ferramentas do MCP Atlas (Muse Spark Open: 89.2), segundo o model card. E o modelo são os 5% baratos de um agente de suporte. O resto é a sincronização da base de conhecimento, as regras de escalonamento, as barreiras de proteção contra respostas inventadas e uma forma de verificar as respostas antes que os clientes as vejam. Esse é o custo real de qualquer decisão de construir ou comprar, e ele é pago em meses de engenharia, não em tokens.
Essa é a parte que a eesel resolve. O colega de IA de helpdesk da eesel entra no seu helpdesk atual, aprende com sua central de ajuda e tickets anteriores e é testado em tickets históricos antes de responder a qualquer pessoa, porque já vi bots confiantes darem respostas erradas em filas reais. A Timengo, que vende software de e-mail seguro e Digital Post na Dinamarca, faz a eesel redigir respostas técnicas em dinamarquês a partir de cerca de 5,300 tickets anteriores, preparando por volta de 300 tickets do Freshdesk por mês. A SE Ranking roda um agente da eesel por produto no Zendesk, e eles atenderam 4,650 conversas em um mês.
Se você chegou ao Ripple porque vive no terminal, a CLI da eesel vai parecer familiar: um agente de programação pode enviar conhecimento aprovado, como artigos de ajuda e macros exportados, ajustar as instruções do colega e executar perguntas de teste antes de qualquer coisa entrar no ar. Conectar o helpdesk em si ainda exige a aprovação de um administrador. Há um passo a passo sobre como gerenciar agentes de IA pelo terminal.
Vale pagar pelo Ripple-65B?
Eis onde chego depois de precificá-lo de todas as formas que consegui:
- Pague pela API se você está testando um modelo de programação de pesos abertos de fabricação americana. Com cerca de $0.11 por tarefa de agente com cache, é o mais barato da sua classe e 21% abaixo do Beam.
- Espere algumas semanas se ele for carregar tráfego de produção. Um host, uma disponibilidade diária de 51-60% e uma janela de contexto que mudou no meio do dia são problemas da semana de lançamento, e um segundo provedor resolverá a maioria deles.
- Auto-hospede apenas quando regras mantiverem os dados em casa ou quando você conseguir manter duas B200 ocupadas cerca de dois terços de cada hora.
- Procure outra opção se o preço for toda a decisão. O DeepSeek V4.1 Flash custa menos da metade, e o panorama dos melhores assistentes de programação com IA cobre o campo mais amplo.
Experimente a eesel
Se você estava precificando um modelo aberto para tirar tickets da sua equipe, a conta de tokens nunca foi a parte cara. O colega de IA de helpdesk da eesel se conecta ao Zendesk, Freshdesk, Gorgias e mais em minutos, aprende com seus tickets anteriores e mostra como teria respondido a eles antes de entrar no ar. Os planos começam em $299 por mês, com um plano gratuito para testar.

Experimente a eesel grátis.