

O Edge0-145B é um modelo de 145 bilhões de parâmetros feito para rodar em uma única placa de vídeo de consumo, e a engenharia por trás dele é real. Nos próprios testes do Edge0, ele marca 86.5 no Terminal-Bench 2.1 e 64.6 no DeepSWE 1.1, na frente do seu modelo base, Qwen3.8-Flash-Next.
As afirmações de lançamento precisam de ressalvas, porém. O número de "29GB" deixa de fora cerca de 31 GiB de RAM do sistema, o suporte a macOS não está no lançamento, e os pesos trazem uma licença que restringe serviços comerciais. Meu veredito: 3/5, vale testar numa máquina NVIDIA, mas ainda não vale reconstruir sua stack em torno dele.
Para equipes de suporte preocupadas com privacidade, o modelo importa menos do que aquilo que o bot tem permissão para ler. O eesel responde apenas com seu conhecimento aprovado, e com o eesel CLI qualquer agente de código pode enviar esse conhecimento e fazer perguntas de teste antes de qualquer coisa entrar no ar.
Como analisei o Edge0-145B
O Edge0 publicou o lançamento em 13 de novembro, então esta análise é de dois dias depois. Eu construo integrações e APIs na eesel, então leio lançamentos como este da mesma forma que leio a documentação de qualquer fornecedor: o post de lançamento diz o que eles querem que você acredite, e o README diz o que realmente é entregue. Trabalhei a partir de três fontes, nesta ordem de confiança:
- Os próprios arquivos de lançamento do Edge0. O README do GitHub, a ficha do modelo no Hugging Face, e o arquivo de procedência de licença no repositório. Esses carregam os números medidos.
- O post de lançamento do Edge0. Útil para intenção e demos, mas onde ele contradiz o README, fico com o README.
- Os primeiros usuários. O tópico de lançamento no Hacker News passou de 330 pontos e 100 comentários, com algumas pessoas testando no próprio hardware.
Não executei minha própria suíte de benchmarks, e nenhum laboratório independente como a Artificial Analysis tinha uma página para o Edge0-145B em 14 de novembro. Trate cada escore abaixo como sendo do Edge0. Se quiser primeiro o panorama mais amplo de modelos, os artigos dos meus colegas sobre DeepSeek V4 Flash e Qwen 4 Max cobrem as duas famílias com as quais o Edge0 se compara.
O que é o Edge0-145B?
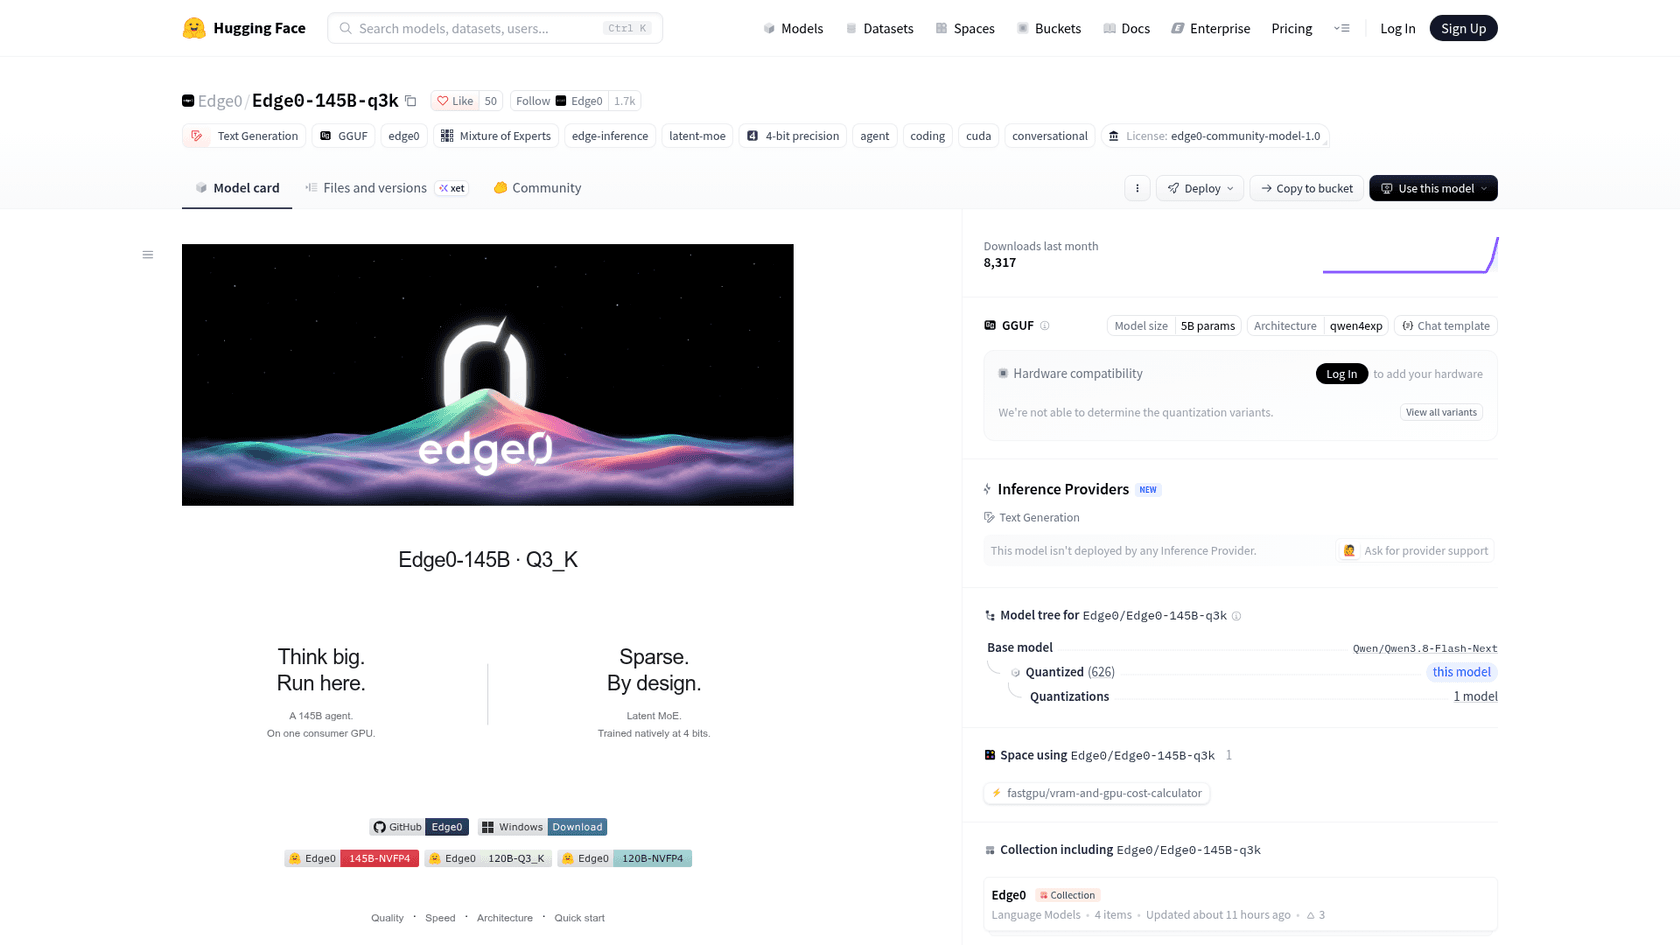
O Edge0-145B é um modelo de mistura de especialistas latente do Edge0, uma equipe que lançou antes o modelo para celular Edge0-35B em setembro e os modelos de voz Audio8. Ele tem 145B de parâmetros totais, mas apenas cerca de 10.12B ativos por token, o que explica como ele cabe em hardware que nunca poderia conter um modelo denso de 145B.
Veja o que a ficha do modelo diz sobre ele:
| Especificação | Edge0-145B | Edge0-120B |
|---|---|---|
| Parâmetros totais / ativos | 145B / 10.12B | 120B / não informado |
| Camadas e especialistas | 48 camadas, 512 especialistas, 10 roteados + 1 compartilhado por token | Igual |
| Largura latente do especialista | 1,792 | 1,280 |
| Janela de contexto | 256K (KV int8, 32K residente) | 256K |
| Builds no Hugging Face | Q3_K (40.81 GiB), NVFP4 (47.79 GiB) | Q3_K (27.98 GiB), NVFP4 (32.96 GiB) |
| Modelo base | Qwen3.8-Flash-Next | Qwen3.8-Flash-Next |
| Motor | edge0-strata (fork do Strata) | edge0-strata |
Duas linhas dessa tabela contam a maior parte da história. O modelo base é o Qwen, e o motor é um fork do projeto de código aberto Strata. O Edge0 diz isso claramente no README, embora o post de lançamento nunca mencione o Qwen. Foi nessa lacuna que a maioria dos primeiros comentaristas se fixou:
"Based on Qwen3.8-Flash-Next and Strata. They made some interesting tweaks and did some fine tuning on the model, but it's interesting how much marketing speak was layered on their website to hide this fact."

Ser um derivado não é uma falha. A maioria dos bons modelos abertos hoje parte da base de outro, e a pergunta real é se as mudanças do Edge0 agregam algo. Nesse ponto, a resposta parece ser sim.
O que o Edge0-145B faz bem
Três coisas se destacaram, e todas têm a ver com engenharia, não com inteligência bruta.
O design de especialistas é engenhoso
O Edge0 compartilha duas matrizes grandes entre cada grupo de 64 especialistas, e cada especialista mantém apenas um pequeno conjunto de seus próprios parâmetros. A ficha do modelo detalha o resultado: cada especialista é um registro fixo de 1,630,720 bytes, então o motor pode manter alguns milhares dos especialistas mais usados na placa de vídeo e transmitir o resto da memória do sistema. O custo dessa transmissão acompanha quantos especialistas permanecem residentes, não quão grande é o modelo.
O Edge0 também treinou o modelo nesse formato desde o início, nativamente em 4 bits, em vez de reduzir um modelo de nuvem depois do fato. A decodificação especulativa por meio de uma cabeça de rascunho de 1.26B espalha o custo de cada leitura de peso em vários tokens de saída. Nada disso é mágica, mas é um trabalho cuidadoso, e é por isso que um modelo de 145B roda em uma placa de 24 GB.
Seus escores de código e agente superam o modelo base
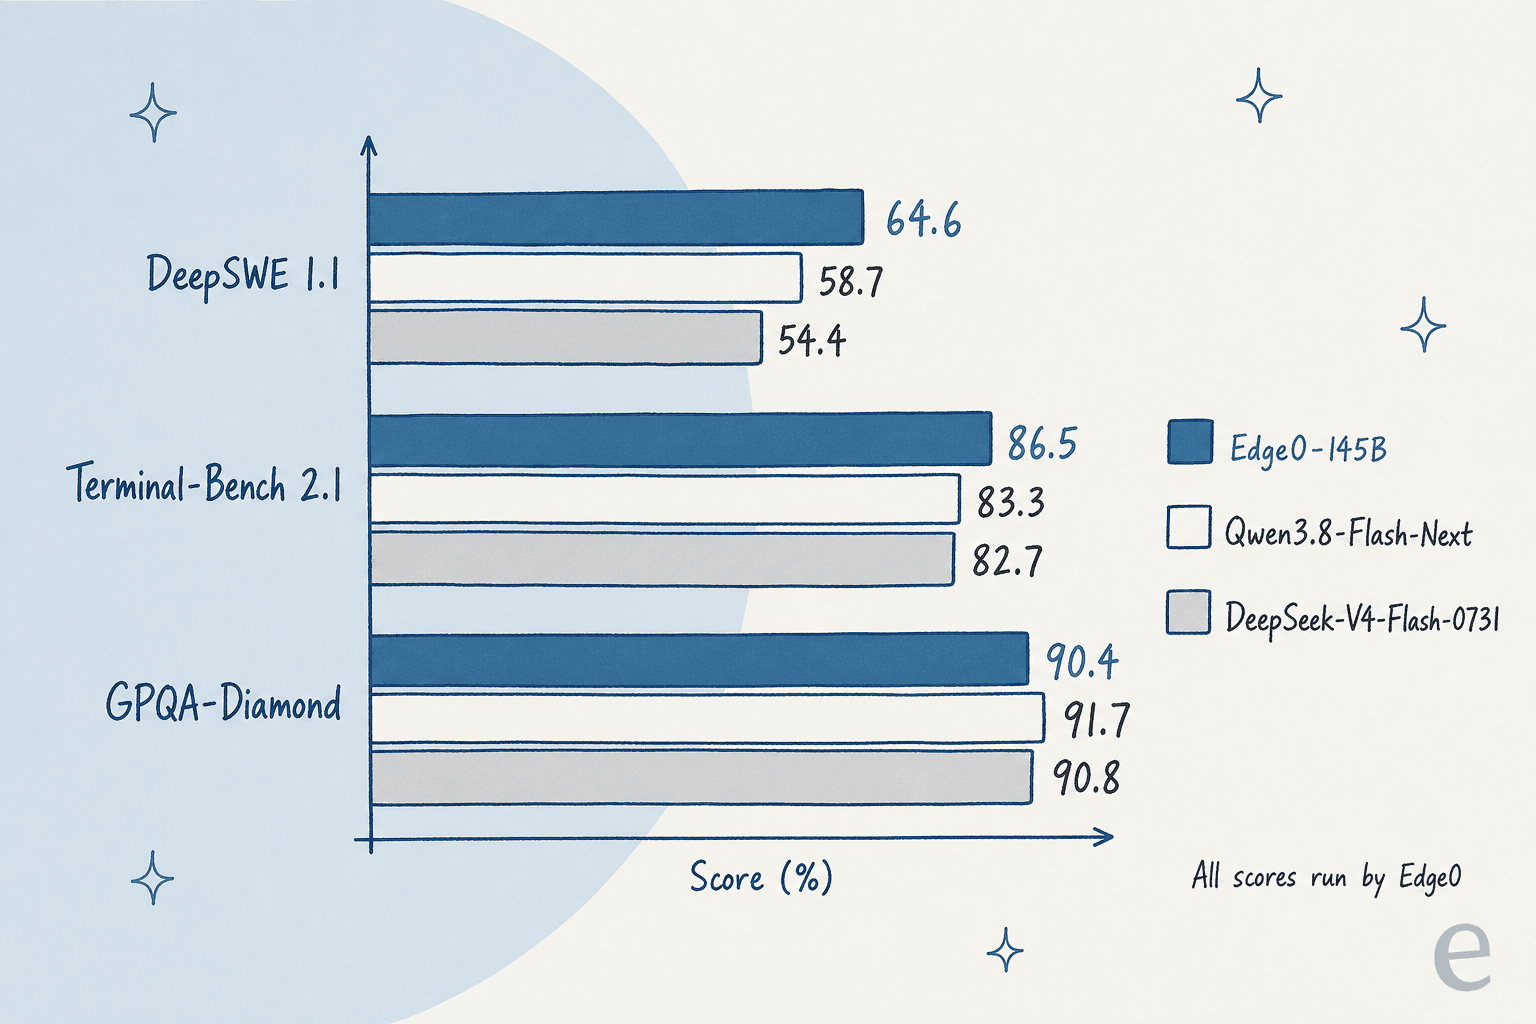
A tabela de benchmarks do Edge0 mostra os maiores ganhos onde eles importam para agentes locais:
| Modelo | DeepSWE 1.1 | Terminal-Bench 2.1 | HLE | GPQA-Diamond | IFBench | AA-LCR |
|---|---|---|---|---|---|---|
| Edge0-145B | 64.6 | 86.5 | 35.4 | 90.4 | 80.6 | 79.3 |
| Edge0-120B | 51.3 | 75.3 | 31.0 | 87.4 | 79.3 | 81.0 |
| Qwen3.8-Flash-Next | 58.7 | 83.3 | 35.9 | 91.7 | 81.3 | 79.1 |
| DeepSeek-V4-Flash-0731 | 54.4 | 82.7 | 33.8 | 90.8 | 79.2 | 79.7 |
| Qwen3.8-27B | 42.2 | 73.0 | 30.8 | 89.2 | 79.5 | 82.0 |
| Claude Opus 4.6 (Max) | n/a | 78.2 | 40.0 | 91.3 | 62.5 | 78.0 |
O padrão é honesto de uma forma: o Edge0-145B supera sua base nos dois benchmarks de agente e fica um pouco atrás em conhecimento e raciocínio (GPQA, HLE, IFBench). É o que se esperaria de um ajuste fino voltado a agentes de código. O Terminal-Bench em particular tende a refletir o quão bem um modelo pilota um shell, e um usuário inicial colocou isso em contexto:
"This score is roughly on par with 5.6 Terra max, which in my direct experience is perfectly capable of driving a cloud agent harness that can do pretty complex knowledge work."
Se preferir comparar com os modelos hospedados atuais, as análises dos meus colegas sobre o GPT-6.1 Terra e o Claude Opus 5.5 têm os números independentes que faltam na tabela do Edge0.
É rápido no hardware certo
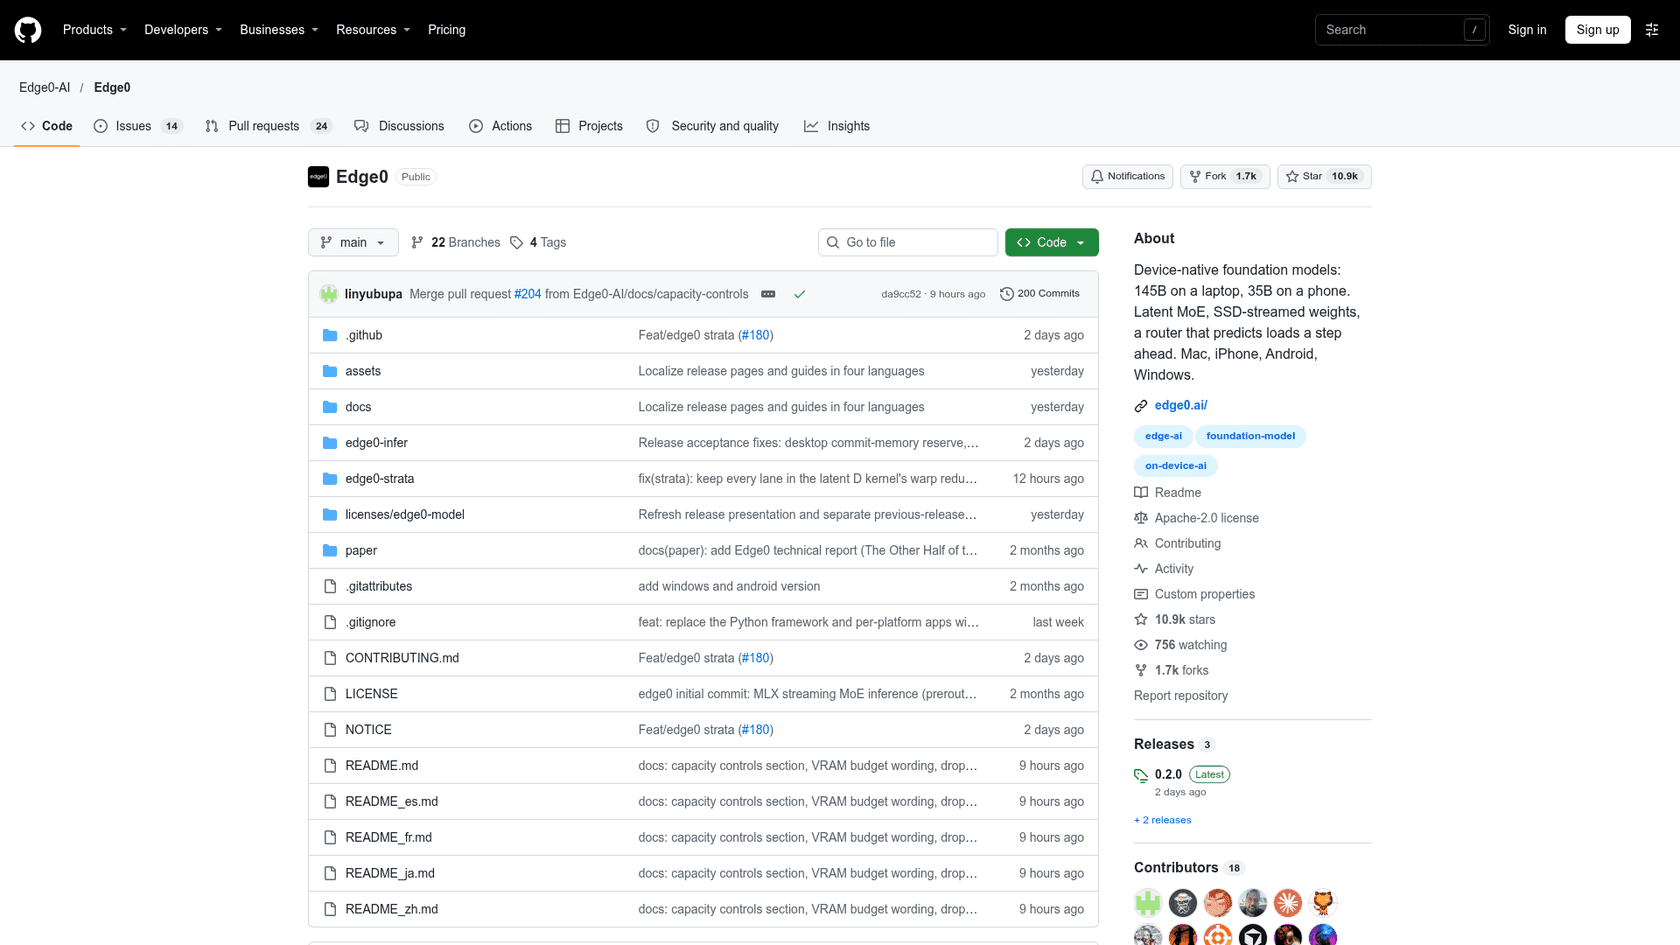
Na própria máquina RTX 5090 D de 24 GB do Edge0, a build Q3_K alcançou 121.2 tokens por segundo na decodificação de agente e 3,554.9 tokens por segundo em um prefill de 16K tokens. Isso é rápido o suficiente para que um ciclo de código local pareça interativo. As demos de lançamento (uma cena de cidade no Blender, um programa de drone, uma placa no KiCad) mostram para que serve essa velocidade: dezenas de rodadas de planejar, executar e verificar sem conta por token. A página do Edge0 no GitHub tem a tabela de velocidade completa e um vídeo de apresentação de dois minutos.
Onde o Edge0-145B deixa a desejar
Aqui o post de lançamento e os arquivos de lançamento contam histórias diferentes. Cada ponto abaixo vem dos próprios documentos do Edge0.
"29GB de memória de pico" não é a pegada toda
O post de lançamento destaca 29GB de memória de pico e diz que o modelo roda num laptop de 48GB. O mesmo post descreve mais adiante uma biblioteca de especialistas de cerca de 40GB em RAM do sistema e cerca de 48GB de dados de vocabulário no SSD. Os números medidos do README resolvem isso:
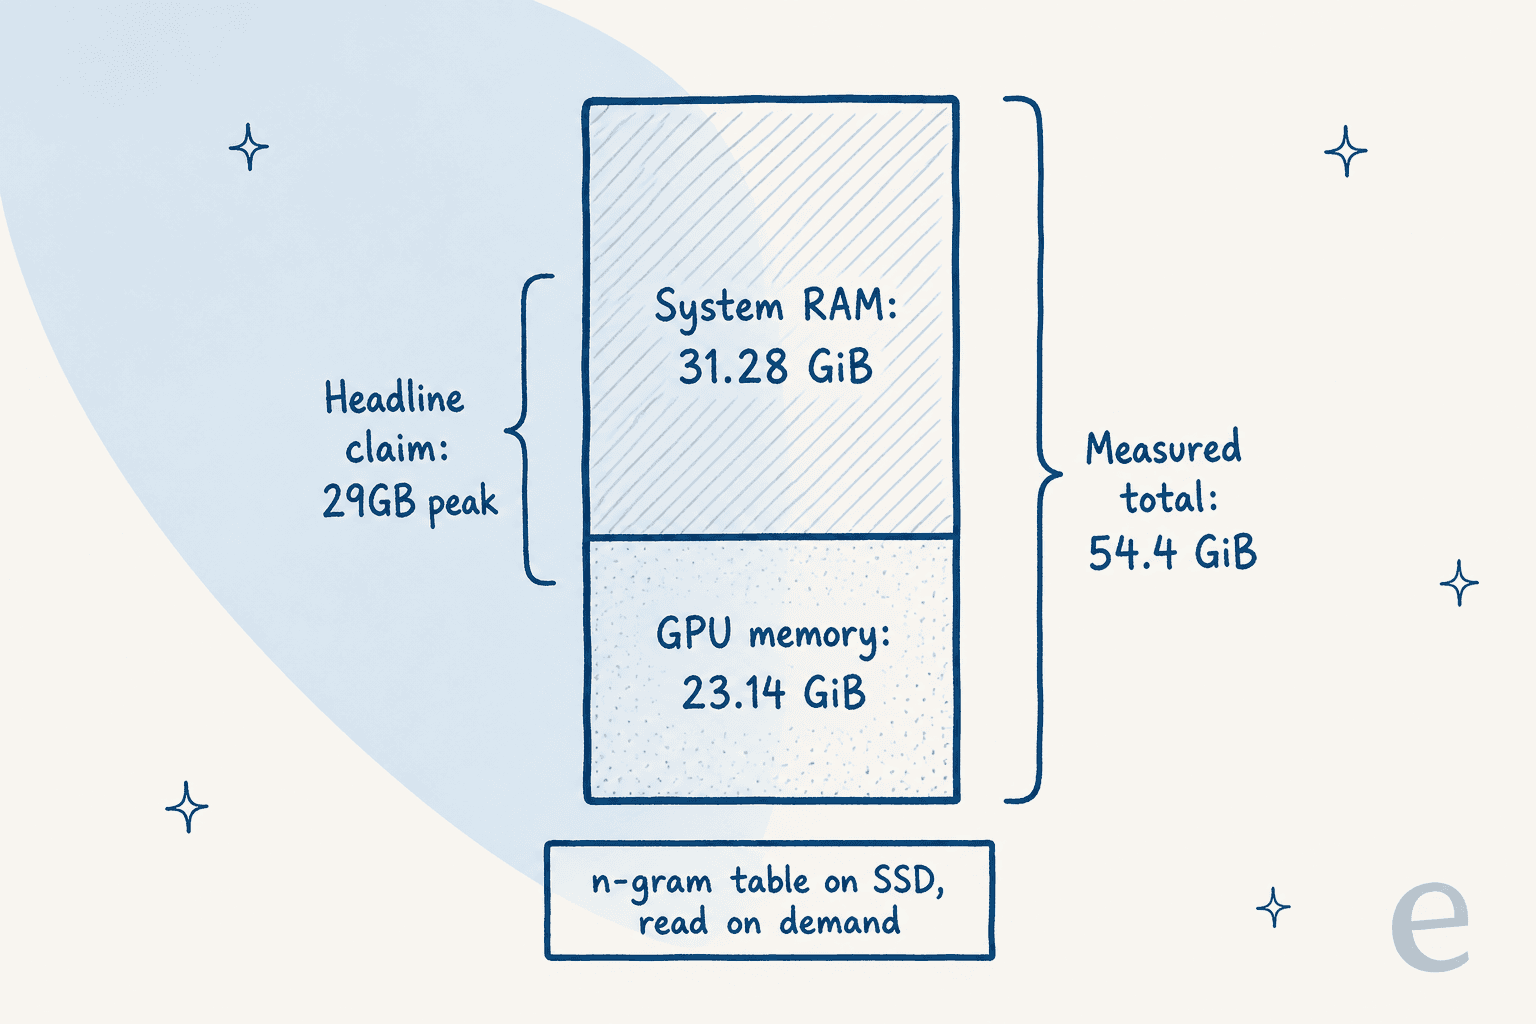
Com a residência de especialistas ativada, a build Q3_K usou 23.14 GiB de memória de GPU mais 31.28 GiB de RAM do sistema. A build NVFP4 usou 23.25 GiB mais 38.27 GiB. O número de 29GB parece ser apenas uma fração disso, provavelmente o lado da GPU mais alguma margem, apresentado como o total.
Para ser justo com o Edge0, ele também rodou o modelo num orçamento mais apertado: 16 GiB de VRAM e 20 GiB de RAM, com especialistas não armazenados em cache lidos do SSD. Ainda assim funcionou, a 36.8 tokens por segundo no chat e 44.9 no modo agente. Então uma máquina menor pode rodá-lo, só que muito mais lento. Um leitor do Hacker News que esperava rodá-lo num MacBook de 48GB resumiu a decepção:
"If we're talking about ~70GB combined RAM footprint then that's not going to cut it. Still very interesting though."
O macOS está no post de lançamento, não no lançamento
O post de lançamento diz que o suporte desde o primeiro dia cobre macOS, Windows e Linux, incluindo chips Apple da série M. A tabela de plataformas do README diz algo mais restrito: os modelos 145B e 120B rodam em Linux ou Windows com uma GPU NVIDIA e CUDA 13, e as colunas de macOS, iOS e Android estão vazias para eles. O Edge0 publicou um resultado num Apple M2 Ultra (57.0 tokens por segundo na decodificação de agente) e acrescenta que isso "não estabelece disponibilidade de lançamento no macOS". O aplicativo de desktop Edge0 Chat é só para Windows por agora.
Veja o que isso significa na prática:
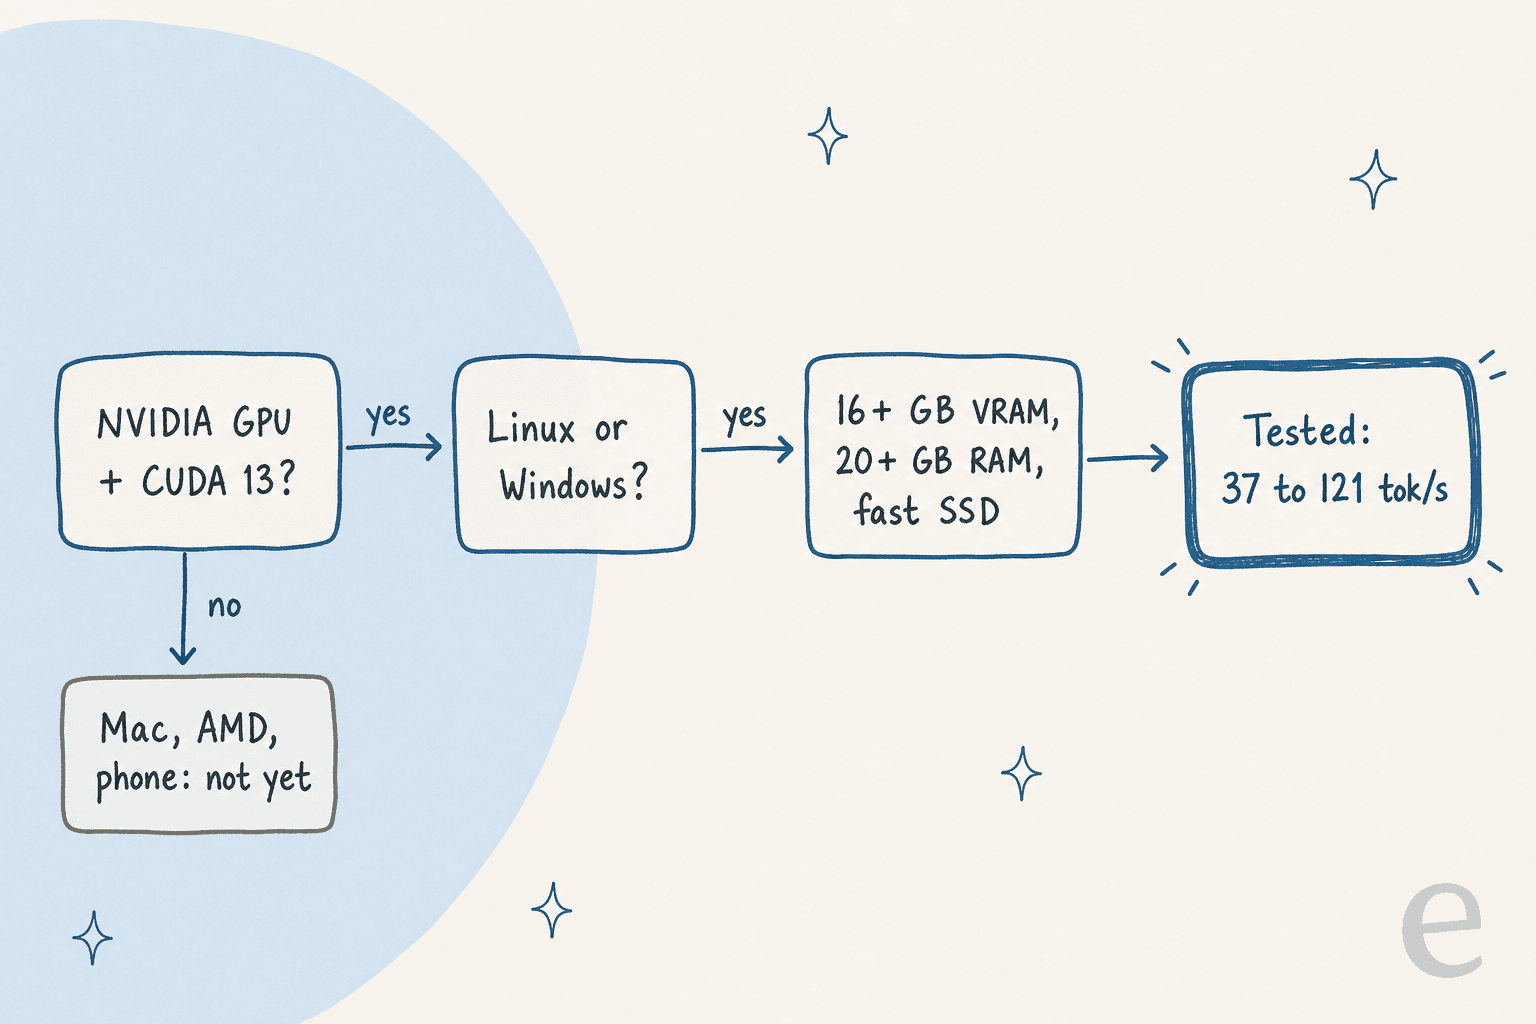
Usuários de Mac ainda podem rodar o mais antigo Edge0-35B no Metal. Para o 145B, você precisa hoje de uma máquina NVIDIA.
Os benchmarks são autorrelatados, e não concordam totalmente
Todos os escores de Edge0, Qwen, DeepSeek e Claude na tabela vêm das avaliações internas do Edge0. O Edge0 diz que a configuração completa e os passos de reprodução estão "sendo publicados com nosso relatório técnico", e o único relatório técnico publicado até agora cobre o modelo 35B. Os números também variam entre documentos: o post de lançamento lista o Edge0-120B em 53.6 no DeepSWE e 81.3 no Terminal-Bench, enquanto o README lista 51.3 e 75.3.
Os primeiros relatos de uso prático são mistos. Um testador numa NVIDIA DGX Spark não conseguiu obter uma resposta útil:
"It spent 8,000+ tokens at default thinking and never produced a coherent answer."
Um teste não é um veredito, mas é um motivo para esperar por uma avaliação independente antes de confiar na tabela. A análise do DeepSeek V4.1 Flash dos meus colegas mostra como isso é quando um laboratório mesmo roda os números.
"Código aberto" vem com uma pegadinha comercial
O post de lançamento diz que o Edge0 está "abrindo o código" dos modelos. O código do framework é Apache 2.0, e o Strata permanece em MIT. Os pesos são diferentes. A ficha do modelo os coloca sob a Edge0 Community Model License 1.0, com os materiais do Qwen ainda sob a Qwen Community License. Uso pessoal, pesquisa, modificação, uso interno e uso comercial das saídas são permitidos. Vender ou empacotar o modelo, operar um serviço de modelo comercial, ou oferecer um assistente comercial de código ou de escritório, precisa de uma licença escrita separada.
Para um hobbyista ou uma equipe de ferramentas internas, isso está bem. Para quem planeja construir um produto sobre ele, leia a licença antes do README. A análise do Hugging Face no nosso blog cobre como essas licenças personalizadas aparecem por todo o hub.
Edge0-145B contra as alternativas
Veja como eu o colocaria ao lado do que um desenvolvedor realmente consideraria esta semana:
| Se você quer... | Escolha | Por quê |
|---|---|---|
| O agente de código local mais forte em uma única placa NVIDIA | Edge0-145B | Melhores escores autorrelatados de Terminal-Bench e DeepSWE na sua classe, 91.7 a 121.2 tok/s em placas de 24 GB |
| A mesma família com menos surpresas | Qwen3.8-Flash-Next | O modelo base, suporte de execução mais amplo, escores próximos em raciocínio |
| Um modelo local num Mac hoje | Edge0-35B ou outro modelo aberto compatível com Metal | O Edge0-145B ainda não tem runtime de macOS |
| Benchmarks independentes e nenhum hardware | DeepSeek V4 Flash ou Kimi K3.1 Pro | Hospedados, medidos por terceiros, preços baixos por token |
| Qualidade de ponta, e você está disposto a pagar por isso | Claude Opus 5.5 ou GPT-6 Sol | Ainda na frente no raciocínio mais difícil |
Se o custo é o que te empurra para o local, faça as contas primeiro. Os guias de preços da API da Anthropic e preços da API da OpenAI ajudam a comparar as contas por token com uma GPU que também consome cerca de 120W enquanto trabalha.
Meu veredito sobre o Edge0-145B
| Área | Nota | Observação |
|---|---|---|
| Engenharia | 4.5/5 | Especialistas de matriz compartilhada e streaming via SSD são um passo real para a inferência local |
| Escores de código e agente | 4/5 | Fortes, mas apenas autorrelatados |
| Honestidade das afirmações de lançamento | 2/5 | 29GB, macOS e "código aberto" precisam todos de ressalvas |
| Facilidade de configuração | 2.5/5 | Compilar a partir do código-fonte, só NVIDIA mais CUDA 13, app só para Windows |
| Licença | 2.5/5 | Boa para uso interno, restritiva para produtos |
No geral: 3/5. Se você tem uma RTX 4090 ou 5090 e quer um agente de código local, vale uma tarde. Se você está no Mac, planejando um produto, ou precisa de prova independente, espere pelo relatório técnico e por uma avaliação de terceiros. Desenvolvedores que já usam o Claude Code podem testá-lo pelo seu endpoint local compatível com a Anthropic, embora eu mesmo não tenha testado essa combinação.
O que esta análise significa para equipes de suporte
O argumento que vai chegar aos líderes de suporte é a privacidade: rodar o modelo no seu próprio hardware, e os dados dos tickets nunca saem do prédio. Eu entendo o apelo. Em chamadas de vendas, a pergunta sobre dados costuma ser a primeira. Um avaliador técnico de uma empresa de hardware de semicondutores nos perguntou se o bot recorreria a "algum outro ChatGPT" quando não soubesse uma resposta, e se isso poderia ser desligado. Um comprador dinamarquês de telemática se preocupava com números de cartão e senhas dentro dos tickets.
Nenhuma das duas preocupações era realmente sobre onde o modelo roda. Ambas eram sobre o que a IA tem permissão para ler e dizer. Um modelo local que responde a partir do seu treinamento geral ainda é o "outro ChatGPT" com que aquele avaliador se preocupava. O que resolveu isso para eles foi um agente que responde apenas com conhecimento aprovado e diz quando não sabe, mais a redação de campos sensíveis.
É assim que o eesel funciona, e é por isso que eu enquadraria o Edge0 como infraestrutura enquanto o eesel é o funcionário. Você contrata um colega de equipe de IA para helpdesk que entra no seu helpdesk existente, aprende com sua central de ajuda, macros e respostas anteriores, e é simulado contra tickets históricos antes de falar com clientes. A licença do Edge0 também bloquearia a maior parte do que um fornecedor de suporte faz com um modelo, já que um serviço de modelo comercial precisa de um acordo separado.
Dois clientes mostram como fica uma configuração cuidadosa. A Dokument 24, um serviço dinamarquês de documentos jurídicos, faz o eesel redigir respostas em dinamarquês como notas internas a partir de cerca de 2.600 páginas da web e itens do Zendesk, e a nota avisa quando o conhecimento não cobre uma pergunta. A smava, uma empresa alemã de comparação de empréstimos em finanças reguladas, faz cerca de 27.000 tickets do Zendesk por mês passarem pelo eesel, que categorizou 14.600 e preparou 15.300 respostas em rascunho que esperam a aprovação de um consultor.
Para mais sobre manter os bots com os pés no chão, veja nosso guia sobre alucinações de IA no suporte, a explicação sobre MCP para suporte ao cliente, e o resumo de plataformas de chatbot de código aberto se o autoalojamento for um requisito obrigatório.
Teste o eesel
Se você está lendo uma análise do Edge0-145B porque sua equipe de suporte quer IA sem entregar os tickets a uma caixa preta, comece pela parte que realmente decide privacidade e precisão: o que o agente lê e quando ele faz o handoff. O eesel se conecta ao Zendesk, Freshdesk e aos outros grandes helpdesks, responde apenas com seu conhecimento aprovado, e deixa você ver como ele responde a tickets reais do passado antes de entrar no ar. Os preços são um plano fixo de créditos mensais, não por assento.
Desenvolvedores podem operar o mesmo espaço de trabalho pelo eesel CLI. Um agente de código, até mesmo um apontado para um modelo local, pode enviar conhecimento aprovado como artigos de ajuda exportados e respostas salvas, ajustar as instruções do colega de equipe, e fazer perguntas de teste para verificar as respostas. Conectar o próprio helpdesk ainda precisa de alguém com acesso de administrador para aprovar.
Teste o eesel gratuitamente, ou agende uma demo para ver como ele roda nos seus próprios tickets.