As 7 melhores alternativas ao Gemini 4 Neon em 2026, por custo por tarefa

Kira

Katelin Teen
Última edição 19 de novembro de 2026
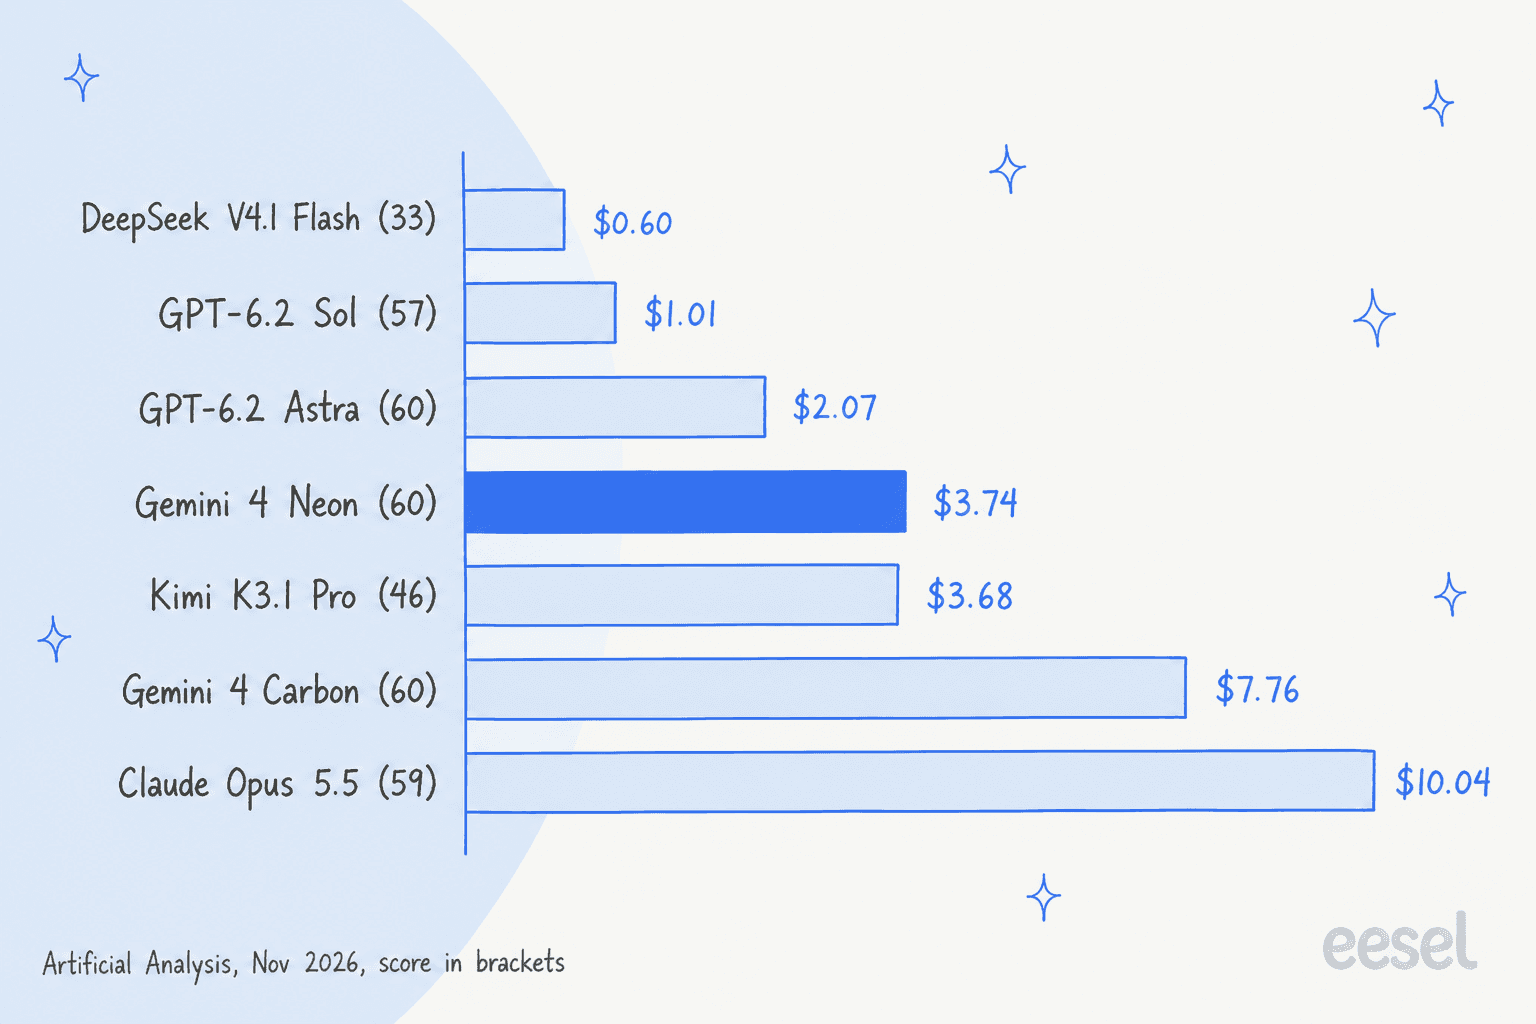
A melhor alternativa ao Gemini 4 Neon é o GPT-6.2 Sol: o Artificial Analysis dá a ele 57,3 por $1,01 por tarefa, contra 59,6 do Neon por $3,74. O Astra iguala a pontuação do Neon por $2,07, o Opus 5.5 custa $10,04, e Carbon, Kimi K3.1 Pro e DeepSeek vencem em honestidade, pesos abertos ou preço em massa. A vantagem do Neon é que ele erra 14% das perguntas sem resposta, não 55%. Para um bot de suporte, um colega de equipe de helpdesk da eesel faz essa escolha por você e a testa nos seus tickets anteriores.
Por que as pessoas procuram alternativas ao Gemini 4 Neon?
O Gemini 4 Neon é o modelo intermediário da família Gemini 4 do Google, lançado em 18 de novembro de 2026. Custa $3 de entrada e $15 de saída por milhão de tokens, tem uma janela de contexto de 1.048.576 tokens e não tem nível gratuito. Minha análise do Neon o considerou um modelo forte: cerca de metade do custo do Carbon por tarefa, e incomumente disposto a dizer "não sei".
Os motivos para olhar outras opções giram todos em torno da conta e da stack. O Neon escreve muitos tokens, então custa mais por tarefa que os modelos da OpenAI, e um leitor do Hacker News notou isso no dia do lançamento:
"That looks to me like OpenAI equals or beats everything Google offers at half the price."

Outros querem um fornecedor que não seja o Google, pesos abertos que possam hospedar eles mesmos, ou um modelo mais rápido em chat ao vivo. São usos diferentes, então ordenei as alternativas por uso e coloquei um único número embaixo de todas: o custo por tarefa.
Se você quer testar qualquer um desses modelos em perguntas de suporte sem montar seu próprio ambiente de teste, o CLI da eesel permite que um agente de código envie artigos de ajuda e macros aprovados a um colega de equipe de helpdesk da eesel, depois faça perguntas de teste e verifique as respostas antes de qualquer coisa ir ao ar. Conectar o próprio helpdesk ainda precisa da aprovação de um administrador.
Como escolhi essas alternativas
Comecei pelo que um comprador vê. Perguntei ao ChatGPT, em uma conversa nova, quais alternativas comparar com o Gemini 4 Neon para um aplicativo. Ele citou seis, nesta ordem: GPT-6.2 Astra, Claude Opus 5.5, GPT-6.2 Sol, Gemini 4 Carbon, Kimi K3 e DeepSeek V4.1 Flash. Também disse a quem perguntou para comparar "custo por tarefa bem-sucedida", chamadas de ferramentas, validade de JSON, latência e novas tentativas, não o preço por milhão de tokens. Segui esse enquadramento e adicionei o Claude Sonnet 5.5, porque ele compartilha o preço do Sol mas se comporta de forma muito diferente.
Para cada modelo usei três fontes, todas verificadas em 19 de novembro de 2026:
- As próprias páginas do fornecedor: preços, página do modelo, janela de contexto e suporte a ferramentas, cada uma vinculada na seção abaixo. Todos os preços deste artigo vêm dessas páginas, não de terceiros.
- Artificial Analysis: seus resultados por configuração para pontuação, custo por tarefa, minutos por tarefa e taxa de alucinação. Uma "tarefa" é uma tarefa de referência do seu Intelligence Index, não um dos seus tickets.
- Hacker News: os tópicos de lançamento de Neon, Astra e Sol, onde desenvolvedores publicaram seus próprios custos e tempos.
Não testei o Neon eu mesmo, porque não tenho uma chave do Google para ele. Fiz um teste de 90 execuções com Astra e Sol em suporte na semana passada, e uso esses resultados onde se aplicam. Trate o ranking como uma pré-seleção, e depois use a seção de testes para verificá-lo no seu trabalho.
O que o custo por tarefa diz sobre as alternativas do Neon?
O preço por token é só metade da história. A conta é o preço multiplicado por quantos tokens o modelo escreve, e tokens de raciocínio contam como saída. O Artificial Analysis publica as duas metades, então esta é a tabela pela qual eu começaria:
| Modelo e configuração | Pontuação do índice | Custo por tarefa | Minutos por tarefa | Tokens de saída por tarefa | Erra quando incerto |
|---|---|---|---|---|---|
| Gemini 4 Neon high (padrão) | 59,6 | $3,74 | 14,8 | 90.188 | 14% |
| Gemini 4 Neon medium | 54,9 | $1,90 | 8,3 | 50.000 | 16% |
| GPT-6.2 Astra max | 62,1 | $4,00 | 13,7 | 41.029 | 59% |
| GPT-6.2 Astra high | 60,1 | $2,07 | 5,9 | 17.828 | 58% |
| GPT-6.2 Sol max | 57,3 | $1,01 | 8,5 | 40.360 | 55% |
| GPT-6.2 Sol high | 54,9 | $0,56 | 4,6 | 20.160 | 60% |
| Claude Opus 5.5 max | 59,1 | $10,04 | 24,5 | 173.313 | 50% |
| Claude Opus 5.5 medium (padrão da API) | 48,2 | $2,45 | 6,9 | 43.817 | 67% |
| Claude Sonnet 5.5 max | 54,5 | $10,02 | 32,6 | 285.387 | 43% |
| Claude Sonnet 5.5 high (padrão da API) | 41,5 | $1,64 | 7,2 | 58.421 | 64% |
| Gemini 4 Carbon high | 60,0 | $7,76 | 37,2 | 122.768 | 11% |
| Kimi K3.1 Pro | 46,5 | $3,68 | 39,4 | 72.239 | 37% |
| DeepSeek V4.1 Flash 1017 max | 32,6 | $0,60 | 13,7 | 138.962 | 64% |
Tudo na tabela foi lido em 19 de novembro de 2026 no Artificial Analysis. "Erra quando incerto" é a taxa de alucinação AA-Omniscience, em que menor é melhor. As páginas dos modelos:
- Gemini 4 Neon e Gemini 4 Carbon
- GPT-6.2 Astra
- Claude Opus 5.5
- Claude Sonnet 5.5
- Kimi K3.1 Pro
- DeepSeek V4.1 Flash 1017
Quatro coisas se destacam:
- Mesma pontuação, conta diferente. O Astra no high chega a 60,1 por
$2,07,45%menos que os$3,74do Neon por 59,6. O Opus 5.5 no máximo custa$10,04por 59,1, cerca de 2,7 vezes o Neon. - Sol no high iguala o Neon no medium. Os dois pontuam 54,9, mas o Sol custa
$0,56e o Neon$1,90. - O DeepSeek não é barato por tarefa. Seu preço de entrada é 13 vezes mais baixo que o do Sol, mas uma tarefa custa
$0,60contra os$0,56do Sol high, com uma pontuação de 32,6 contra 54,9. Ele escreve 138.962 tokens para chegar lá. - O Neon é o modelo honesto. Com
14%, só o Carbon o supera entre os modelos acima que pontuam perto de 60. Sol, Astra e Opus erram entre 50% e 59% das perguntas sem resposta.
O motivo é a verbosidade, e é a parte do mecanismo que as pessoas ignoram. Tokens de saída são o lado caro de qualquer tabela de preços, e cada modelo tem seu próprio hábito de quantos escreve antes de responder:
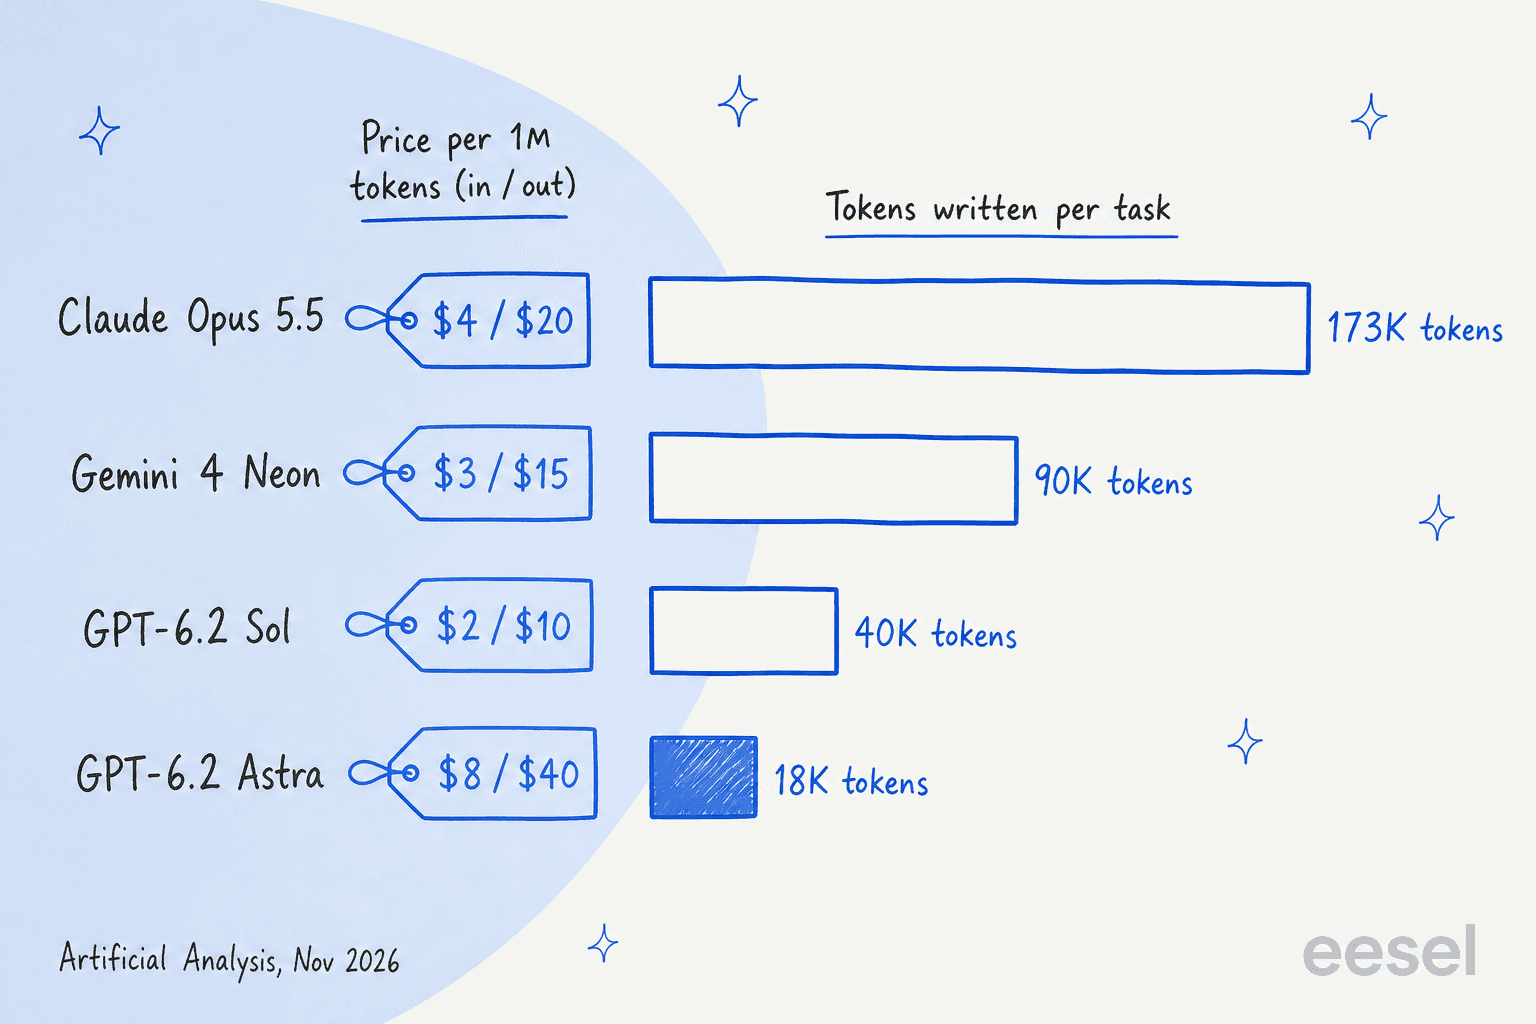
O gráfico usa a configuração de maior pontuação de cada modelo para Opus e Sol, e a configuração padrão high para Neon e Astra. O Astra tem a etiqueta mais cara dos quatro e o hábito mais barato: escreve cerca de um quinto do que o Neon escreve para a mesma pontuação. É por isso que digo às pessoas para não compararem tabelas de preços.
Alternativas ao Gemini 4 Neon em resumo
Aqui está tudo o mais que um comprador pergunta, direto da documentação de cada fornecedor:
| Modelo | Preço por 1M (entrada/saída) | Entrada em cache | Contexto | Melhor pontuação (configuração) | Nível gratuito de API | Pesos abertos | Opção de residência de dados |
|---|---|---|---|---|---|---|---|
| Gemini 4 Neon (referência) | $3 / $15 | $0,15, apenas implícito | 1.048.576 | 61,4 (xhigh) | Nenhum | Não | Região global, us ou eu na plataforma empresarial do Google |
| GPT-6.2 Astra | $8 / $40 | $0,40 | 1.050.000 | 62,1 (max) | Nenhum listado | Não | Endpoints regionais, +10% |
| GPT-6.2 Sol | $2 / $10 | $0,10 | 1.050.000 | 57,3 (max) | Nenhum listado | Não | Endpoints regionais, +10% |
| Claude Opus 5.5 | $4 / $20 | $0,20 | 1M | 59,1 (max) | Créditos de teste grátis para novos usuários | Não | Inferência só nos EUA, +10% |
| Claude Sonnet 5.5 | $2 / $10 | $0,10 | 1M | 54,5 (max) | Créditos de teste grátis para novos usuários | Não | Inferência só nos EUA, +10% |
| Gemini 4 Carbon | $2 / $10 até 30 de nov., depois $4 / $20 | $0,10, depois $0,20, apenas implícito | 1.048.576 | 60,0 (high) | Nenhum | Não | Não verificada para o Carbon (o guia do Neon lista global, us, eu) |
| Kimi K3.1 Pro | $2 / $10 | $0,20 | 1.048.576 | 46,5 | Nenhum listado | Sim, sob a licença própria da Moonshot | Não documentada na página de preços |
| DeepSeek V4.1 Flash | $0,15 / $0,60 fora do pico, $0,30 / $1,20 no pico | $0,003 fora do pico, $0,006 no pico | 1M | 32,6 (max) | Nenhum listado | Sim, MIT | Não documentada na página de preços |
Duas observações. "Nenhum listado" significa que a página de preços do fornecedor não menciona um nível gratuito de API, não que eu confirmei que não existe. E o preço do Carbon dobra em 1º de dezembro, o que importa porque o Artificial Analysis calcula seu custo por tarefa no preço mais alto de dezembro.
Quanto custaria cada alternativa por mês?
Custo por tarefa é um número de referência, e a sua tarefa é menor. Esta calculadora escala o custo por tarefa do Artificial Analysis conforme o tamanho da sua tarefa em comparação com uma tarefa de referência, multiplica pelo seu volume, e mantém apenas as configurações que atingem a pontuação que você precisa. É uma estimativa, então use-a para ver o tamanho da diferença, e depois meça o seu próprio trabalho.
Nos valores padrão, 10.000 respostas curtas de ticket por mês e um limite de pontuação de 55, o Sol max custa cerca de $505 por mês e o Neon high cerca de $1.870. Se você mover o limite de pontuação para 60, o Sol sai do páreo, o que é a troca honesta: você paga pelos últimos cinco pontos.
1. GPT-6.2 Astra
Melhor para: equipes que querem a pontuação do Neon e aceitam pagar uma conta mais baixa por isso.
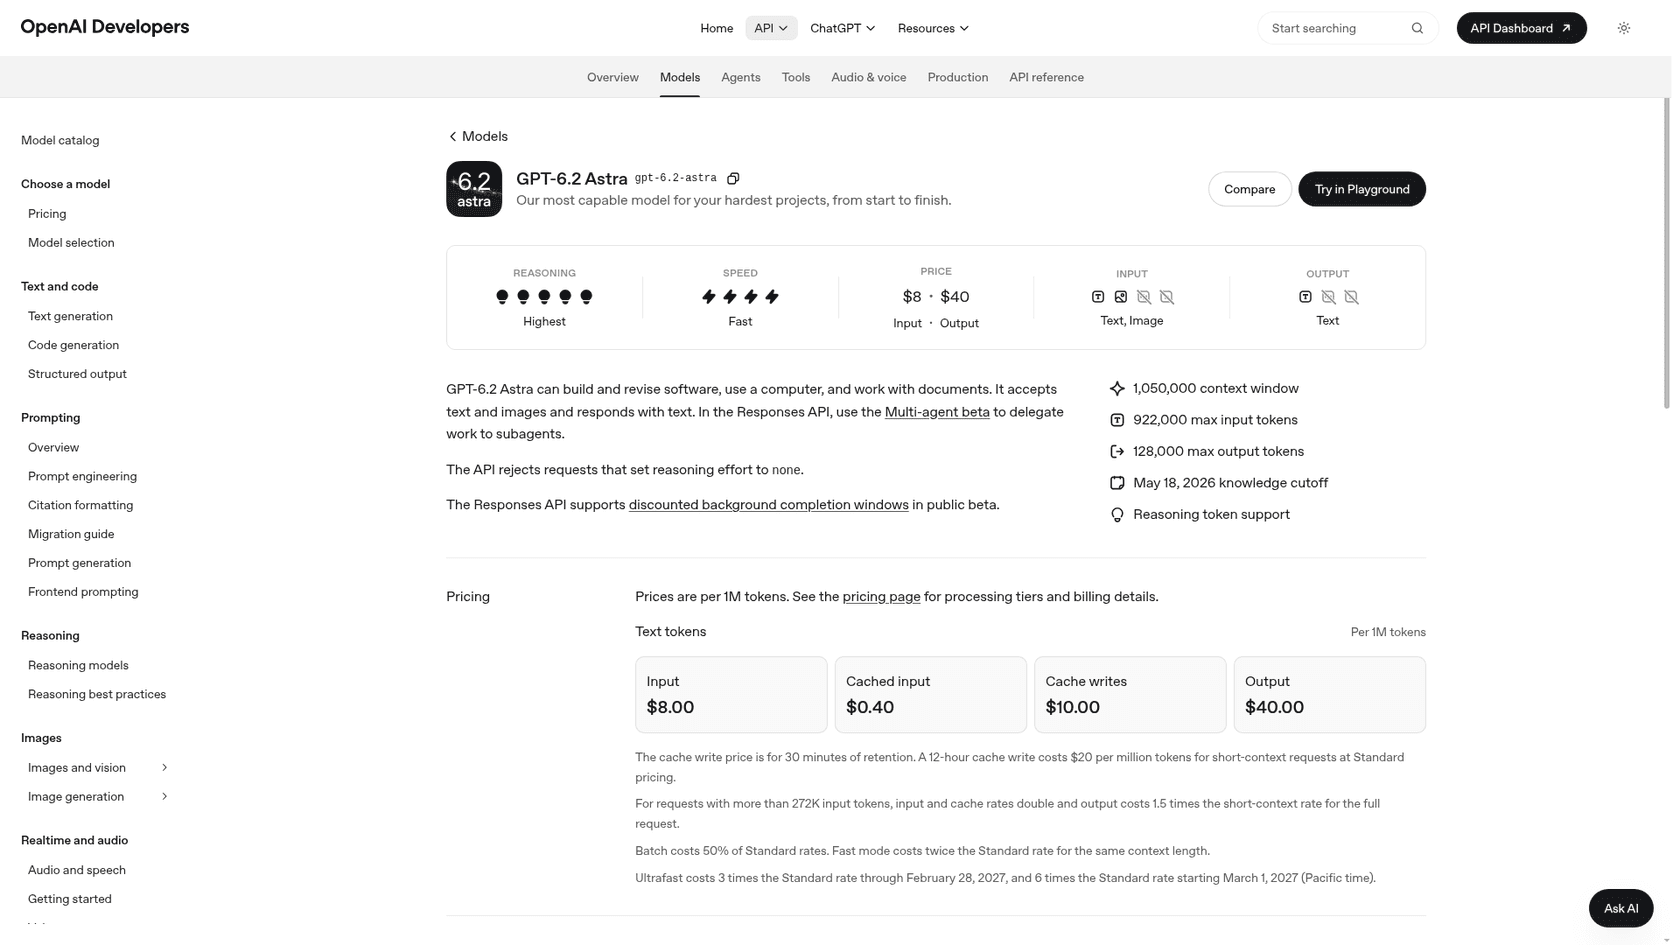
O GPT-6.2 Astra é o modelo principal da OpenAI, lançado em 17 de novembro de 2026, um dia antes do Neon. Tem uma janela de contexto de 1.050.000 tokens, 128.000 tokens máximos de saída e um corte de conhecimento de maio de 2026, e a API rejeita o esforço de raciocínio none. Seu preço é alto, $8 de entrada e $40 de saída por milhão de tokens, 2,7 vezes a taxa de entrada do Neon.
Na conta, porém, o Astra é o modelo que vence o Neon no próprio jogo dele. No esforço alto ele pontua 60,1 por $2,07 por tarefa e termina em 5,9 minutos, contra os 14,8 do Neon. Ele consegue isso escrevendo 17.828 tokens onde o Neon escreve 90.188. No máximo ele sobe para 62,1, pouco acima do melhor valor do Neon de 61,4, por $4,00. Meu próprio teste de 90 execuções de suporte no guia de alternativas ao Astra encontrou o mesmo hábito: o nível de esforço quase não moveu o custo em tickets curtos, de $5,75 a $6,57 por 1.000 tickets do baixo ao alto.
Um leitor do Hacker News fez um benchmark caseiro que mostra como isso se traduz na prática:
"GPT-6.2 Astra scored 92 in 6.6 min for $2.04, vs Kimi K3.1 Pro (93 in 11.5 min for $0.68)"
Vantagens
- Iguala a pontuação do Neon por cerca de 45% menos por tarefa, e é mais do que o dobro da velocidade
- Mesma janela de 1.050.000 tokens e a API Responses que muitas equipes já usam
- Entrada em cache a
$0,40, com lote pela metade da taxa padrão
Desvantagens
- Errou 58% das perguntas sem resposta no AA-Omniscience, contra 14% do Neon, então precisa de uma regra de encaminhamento que não dependa do próprio modelo se recusar
- Solicitações acima de 272K tokens de entrada dobram a taxa de entrada e elevam a de saída para 1,5 vezes a taxa padrão
- O preço de tabela parece caro em qualquer planilha que ignore os tokens por tarefa
Preços: $8 de entrada, $0,40 em cache e $40 de saída por milhão de tokens no nível padrão, segundo a página de preços da OpenAI. O processamento regional adiciona 10%. Veja preços do GPT-6.2 Astra para os níveis.
Veredito: o modelo que eu testaria primeiro se você quer pontuações no nível do Neon e sua conta importa. Pule-o se você precisa que o próprio modelo se recuse quando está incerto, porque é aí que o Neon é melhor.
2. GPT-6.2 Sol
Melhor para: a conta mais baixa que ainda pontua nos 50 altos.
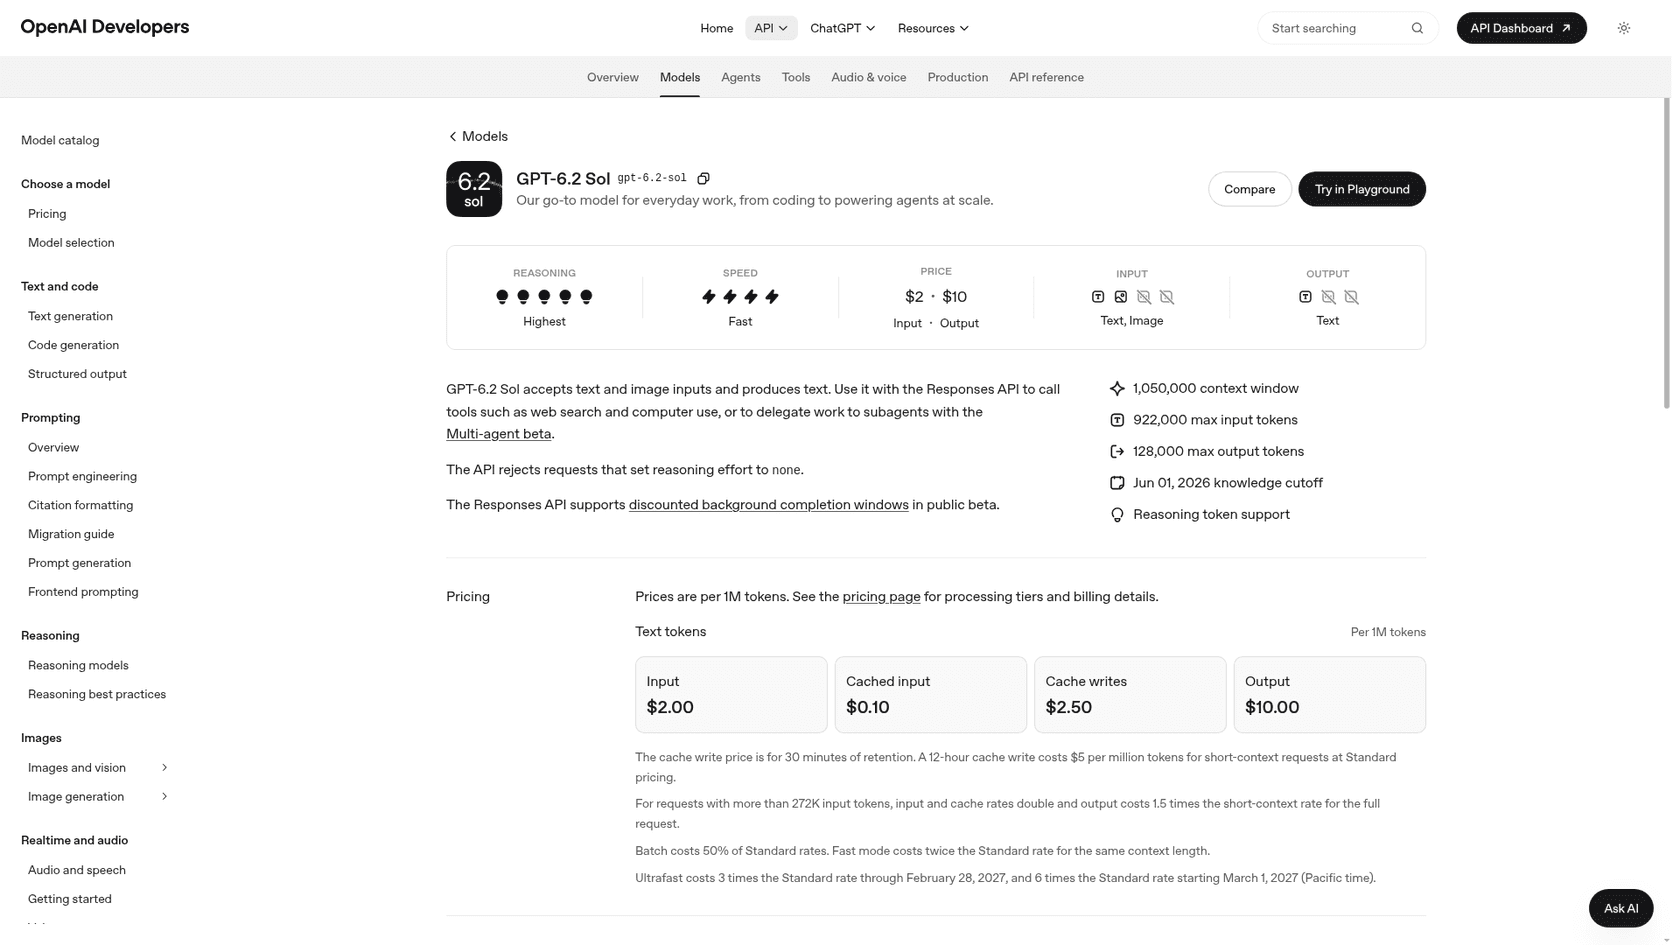
O GPT-6.2 Sol é o modelo do dia a dia da OpenAI, com a mesma janela de 1.050.000 tokens do Astra, um corte de conhecimento de junho de 2026, e $2 de entrada e $10 de saída por milhão de tokens. O Artificial Analysis o pontua em 57,3 no esforço máximo por $1,01 por tarefa, e 54,9 no alto por $0,56. Esse segundo número é aquele ao qual eu sempre volto: a mesma pontuação do Neon no medium, por menos de um terço do custo.
No meu próprio teste, o Sol respondeu corretamente às 45 execuções entre esforço baixo, médio e alto, incluindo um reembolso proporcional que saía em $990 todas as vezes, uma injeção de prompt que recebeu um não educado, e tickets em espanhol e alemão respondidos no idioma do cliente. O custo foi $1,42, $1,40 e $1,54 por 1.000 tickets, cerca de um quarto do Astra. A opinião no campo está dividida nos casos mais difíceis:
"OpenAI's models require constant reprompting for me."
Esse leitor preferia o Sonnet 5.5, e é um aviso justo de que um modelo barato exige mais do seu prompt.
Vantagens
- De
$0,56a$1,01por tarefa, o modelo mais barato aqui que pontua acima de 54 - Rápido: de 4,6 a 8,5 minutos por tarefa no Artificial Analysis
- Mesma superfície de API do Astra, então você pode rotear entre os dois
Desvantagens
- Erra entre 55% e 60% das perguntas sem resposta, então vai responder quando deveria encaminhar
- As escritas em cache são cobradas separadamente a
$2,50por milhão de tokens para uma retenção de 30 minutos, então a taxa em cache não é dinheiro de graça - A API rejeita o esforço de raciocínio
none
Preços: $2 de entrada, $0,10 em cache e $10 de saída por milhão de tokens, segundo a página de preços da OpenAI. Lote reduz isso à metade. O guia de preços do Sol tem os detalhes.
Veredito: minha escolha padrão para a maioria das cargas de trabalho. Comece aqui, e suba para o Astra ou mude para o Neon só nas tarefas em que ele falha visivelmente.
3. Claude Opus 5.5
Melhor para: sessões longas de código e agentes em uma stack da Anthropic.
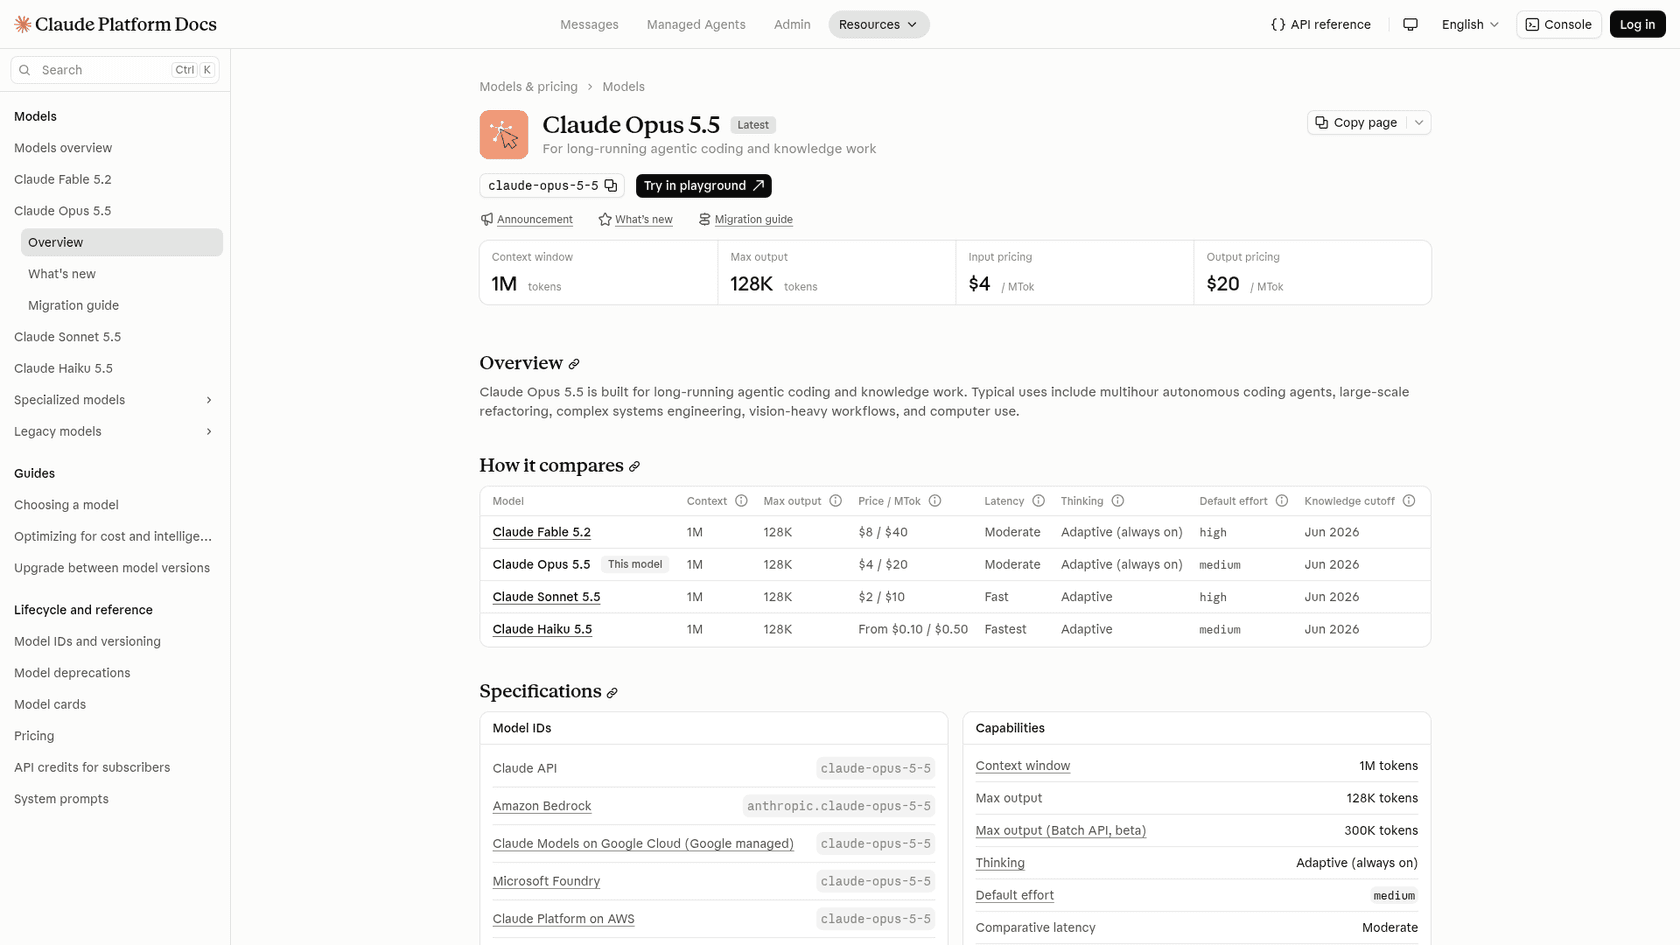
O Claude Opus 5.5 saiu em 22 de setembro de 2026 a $4 de entrada e $20 de saída por milhão de tokens, com uma janela de 1M de tokens, 128K de saída máxima, pensamento adaptativo sempre ativo e um esforço padrão de medium. Funciona na API Claude, Amazon Bedrock, Google Cloud e Microsoft Foundry. A própria tabela comparativa do Google na ficha do modelo Neon coloca o Opus levemente na frente do Neon no Terminal-Bench 4.1 e no FrontierCode 2.0, então esse é o rival de código mais forte da lista.
A pegadinha é o hábito que descrevi antes. No esforço máximo, o Opus escreve 173.313 tokens por tarefa, e isso transforma uma etiqueta de metade do preço na linha mais cara da tabela: $10,04 por tarefa por 59,1, contra os $3,74 do Neon por 59,6. No padrão da API, medium, são $2,45 por 48,2, uma pontuação mais fraca que os 54,9 do Neon medium por um custo maior. Um leitor do Hacker News ainda o coloca na frente do grupo dois meses depois:
"Every day I'm just more and more amazed at Opus 5.5 and how ahead it was."
Vantagens
- Entrada em cache a
$0,20, e lote pela metade do preço - A página de preços da Anthropic só lista inferência nos EUA via
inference_geopor um adicional de 10% - Forte em sessões longas de código, onde a própria tabela do Google dá a ele a vantagem
Desvantagens
$10,04por tarefa no máximo, cerca de 2,7 vezes o Neon pela mesma pontuação- A página de preços da Anthropic só lista
autoenonecomo escolha de ferramenta para o Opus 5.5, então teste qualquer agente que force uma ferramenta específica - Erra 50% das perguntas sem resposta no máximo, e 67% no medium
Preços: $4 de entrada, $0,20 de leitura em cache e $20 de saída por milhão de tokens, segundo a página de preços da Anthropic. O modo rápido custa $8 e $40. Veja preços do Opus 5.5.
Veredito: escolha-o se você já está na Anthropic e seus trabalhos são sessões longas de código. Pule-o se o custo por tarefa é sua restrição, e leia primeiro minha análise do Opus 5.5.
4. Claude Sonnet 5.5
Melhor para: empresas na Anthropic que rodam ciclos curtos de ferramentas com pouco esforço.
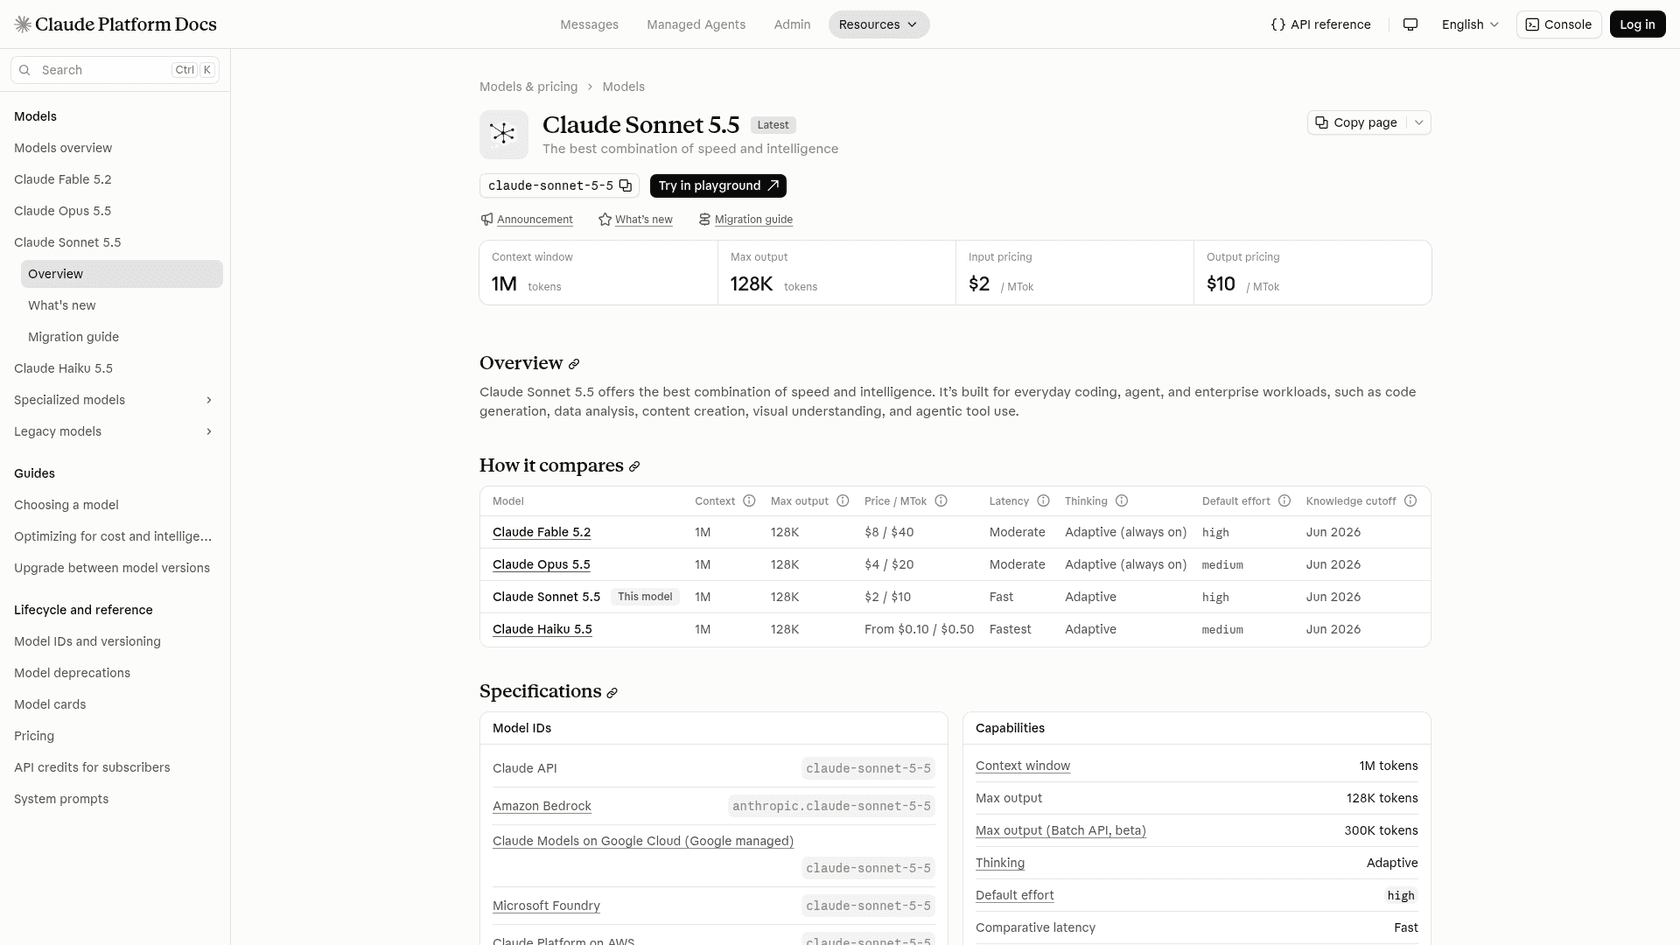
O Claude Sonnet 5.5 tem a mesma etiqueta de $2 e $10 do Sol, uma janela de 1M de tokens, um corte de conhecimento de junho de 2026 e um esforço padrão de high na API. Essa é a pegadinha. No Artificial Analysis ele custa $10,02 por tarefa no máximo por 54,5, dez vezes o Sol, porque escreve 285.387 tokens e leva 32,6 minutos. No padrão high custa $1,64 por 41,5, e o Neon low vence nos dois aspectos com $0,75 por 44,1.
Há um ponto positivo. O Sonnet 5.5 errou 43% das perguntas sem resposta no máximo, melhor que Sol, Astra ou Opus, mas bem atrás do Neon.
Vantagens
- Entrada em cache a
$0,10, e uma taxa de alucinação menor que a dupla da OpenAI - Contexto de 1M de tokens, 128K de saída máxima, e as mesmas plataformas do Opus
- Combina com equipes que já construíram em torno das ferramentas da Anthropic
Desvantagens
- A pontuação varia de 41,5 no high a 54,5 no max, enquanto o custo varia de
$1,64a$10,02 - Mesma lista de
autoenonecomo escolha de ferramenta que o Opus na página de preços da Anthropic - O mais lento dos modelos principais no máximo, com 32,6 minutos por tarefa
Preços: $2 de entrada, $0,10 de leitura em cache e $10 de saída por milhão de tokens, segundo a página de preços da Anthropic. O lote é $1 e $5. Veja preços do Sonnet 5.5.
Veredito: escolha-o só se a Anthropic for uma exigência fixa e você for rodá-lo em esforço baixo ou médio. Caso contrário, o Sol faz o mesmo trabalho por menos, e minha análise do Sonnet 5.5 explica a pegadinha do esforço.
5. Gemini 4 Carbon
Melhor para: equipes que querem o mínimo de respostas inventadas e topam pagar por isso.
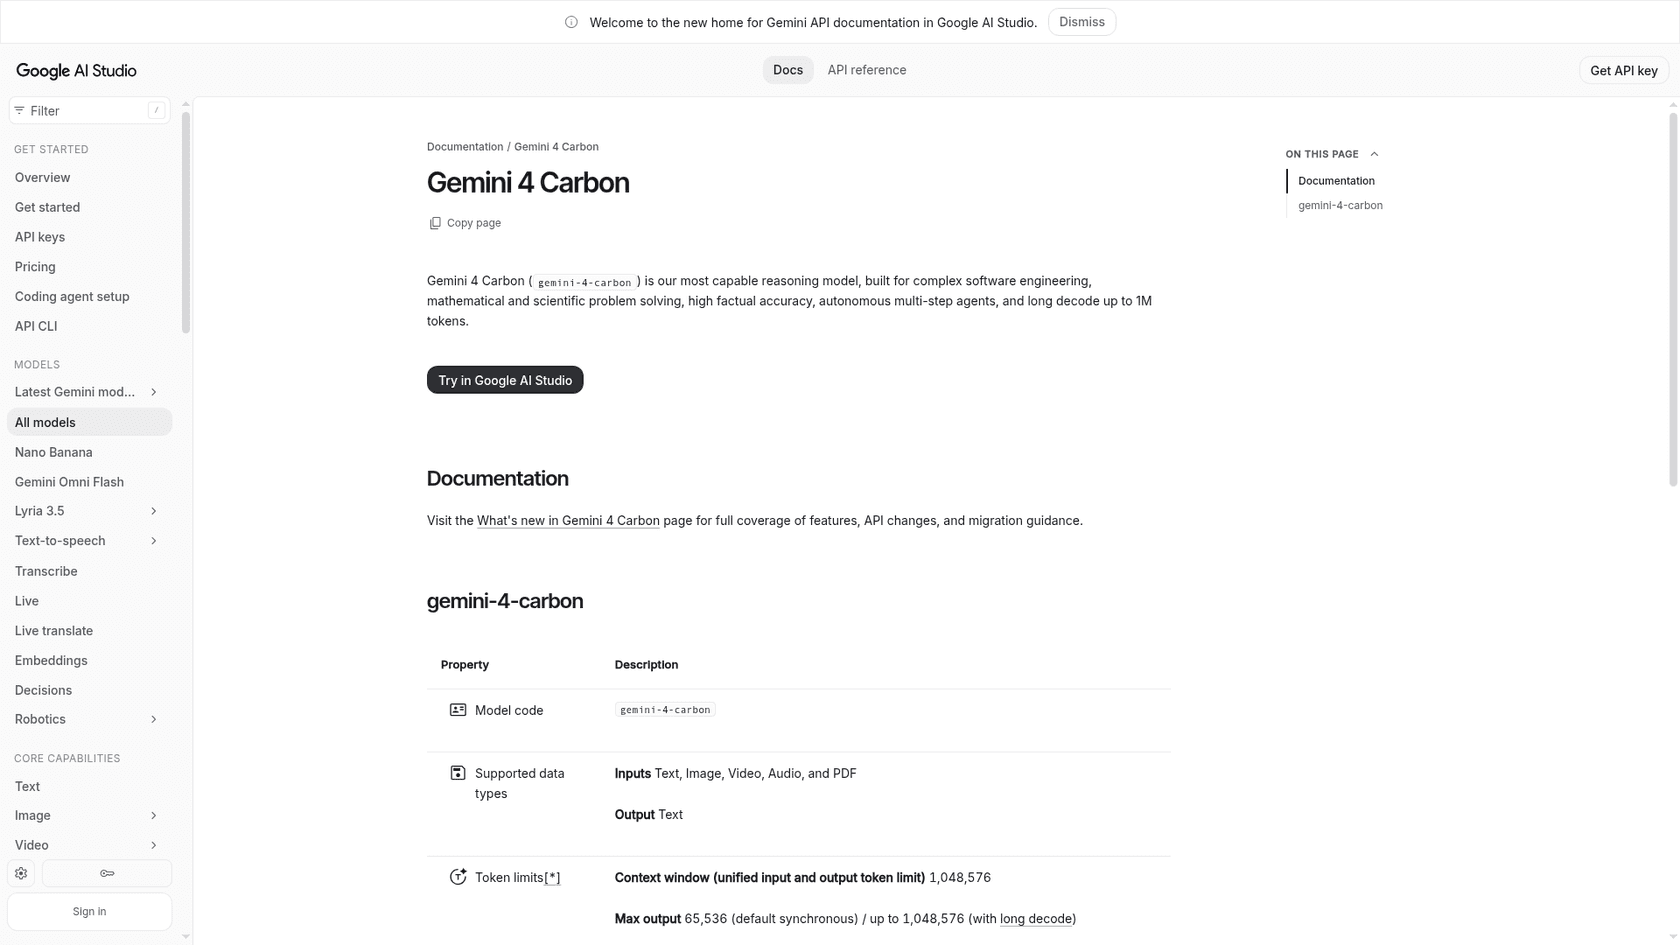
O Gemini 4 Carbon é o modelo do qual o Neon foi adaptado, e o Google o descreve como seu modelo de raciocínio mais capaz, construído para engenharia de software, ciência e agentes longos de várias etapas. Agora está na API Gemini com preços somente pagos: $2 de entrada e $10 de saída até 30 de novembro de 2026, depois $4 e $20 a partir de 1º de dezembro, com entrada em cache a $0,10 subindo para $0,20.
O ponto forte do Carbon é a honestidade. No esforço médio ele errou 4% das perguntas sem resposta, e no alto 11%, contra 14% do Neon. O problema dele é o custo. No high ele pontua 60,0 por $7,76 por tarefa, mais que o dobro dos $3,74 do Neon pela mesma pontuação, e leva 37,2 minutos. Um testador do Hacker News mediu a mesma lentidão de outro ângulo:
"I've tested 75 models so far, and Gemini 4 Carbon is 68th/75 in terms of slowness"
Vantagens
- A menor taxa de alucinação da lista: 4% no medium, 11% no high
- Janela de 1.048.576 tokens e decodificação longa de até cerca de 1M de tokens de saída
- Mesma stack do Google que o Neon, então a migração é só uma troca de nome de modelo
Desvantagens
$7,76por tarefa no high, o dobro do Neon pela mesma pontuação, assim que a promoção acabar- Lento: de 29,6 a 37,2 minutos por tarefa, com uma cauda longa que o testador da HN viu
- Sem nível gratuito
Preços: $2 de entrada e $10 de saída até 30 de novembro, depois $4 e $20, segundo a página de preços do Google. Compare com meu resumo de alternativas ao Carbon.
Veredito: escolha-o se respostas erradas custam mais que tempo, e orce pelo preço de dezembro. Caso contrário, o Neon te dá a mesma pontuação pela metade do dinheiro.
6. Kimi K3.1 Pro
Melhor para: equipes que querem pesos abertos de um fornecedor que não seja dos EUA.
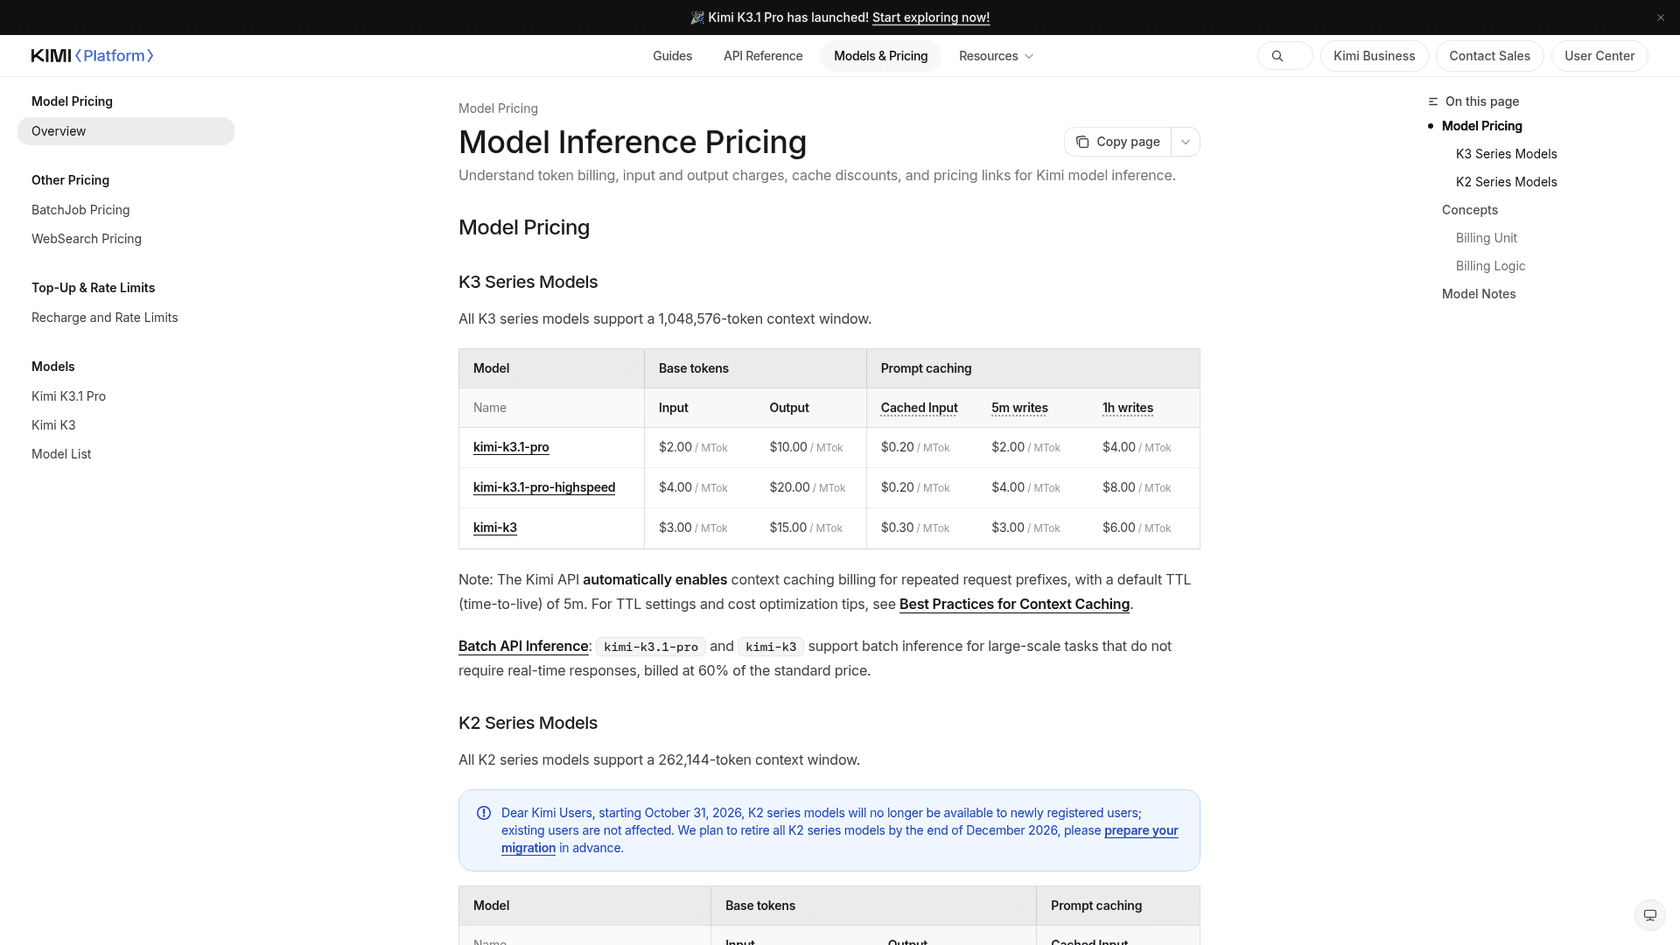
O ChatGPT citou o Kimi K3, mas o modelo que eu testaria hoje é o Kimi K3.1 Pro, que custa menos que o Kimi K3 mais antigo, a $2 de entrada e $10 de saída por milhão de tokens, com entrada em cache a $0,20. O K3 continua em $3 e $15. O K3.1 Pro tem uma janela de 1.048.576 tokens, e uma versão highspeed a $4 e $20. O Artificial Analysis o lista como pesos abertos com 2,8T de parâmetros e 104B ativos.
Onde ele fica atrás é na pontuação: 46,5, contra 54,9 do Neon medium. Também leva 39,4 minutos por tarefa e custa $3,68, então o Neon medium o vence em pontuação, custo e velocidade. O argumento de preço se apoia em outro tipo de tarefa. O resultado do PacBench citado acima tinha o Kimi a $0,68 contra os $2,04 do Astra em um teste caseiro de código, então em trabalhos específicos ele pode ser muito mais barato do que o ranking sugere.
Vantagens
$2/$10por milhão de tokens e pesos abertos sob a licença própria da Moonshot- Inferência em lote a 60% do preço padrão, segundo a página de preços da Kimi
- Errou 37% das perguntas sem resposta, melhor que Sol, Astra e Opus
Desvantagens
- 46,5 no índice, bem abaixo de Neon, Astra e Opus
- 39,4 minutos por tarefa, o modelo mais lento da minha tabela
- Nenhum endpoint regional documentado na página de preços
Preços: $2 de entrada, $0,20 em cache e $10 de saída por milhão de tokens para kimi-k3.1-pro, segundo a página de preços da Kimi. Meu artigo sobre preços do Kimi K3.1 Pro cobre os planos.
Veredito: escolha-o se pesos abertos ou diversidade de fornecedores forem o ponto principal. Pule-o para raciocínio difícil, e leia primeiro minha análise do Kimi K3.1 Pro.
7. DeepSeek V4.1 Flash
Melhor para: classificação e roteamento em massa pelo menor preço de tabela.
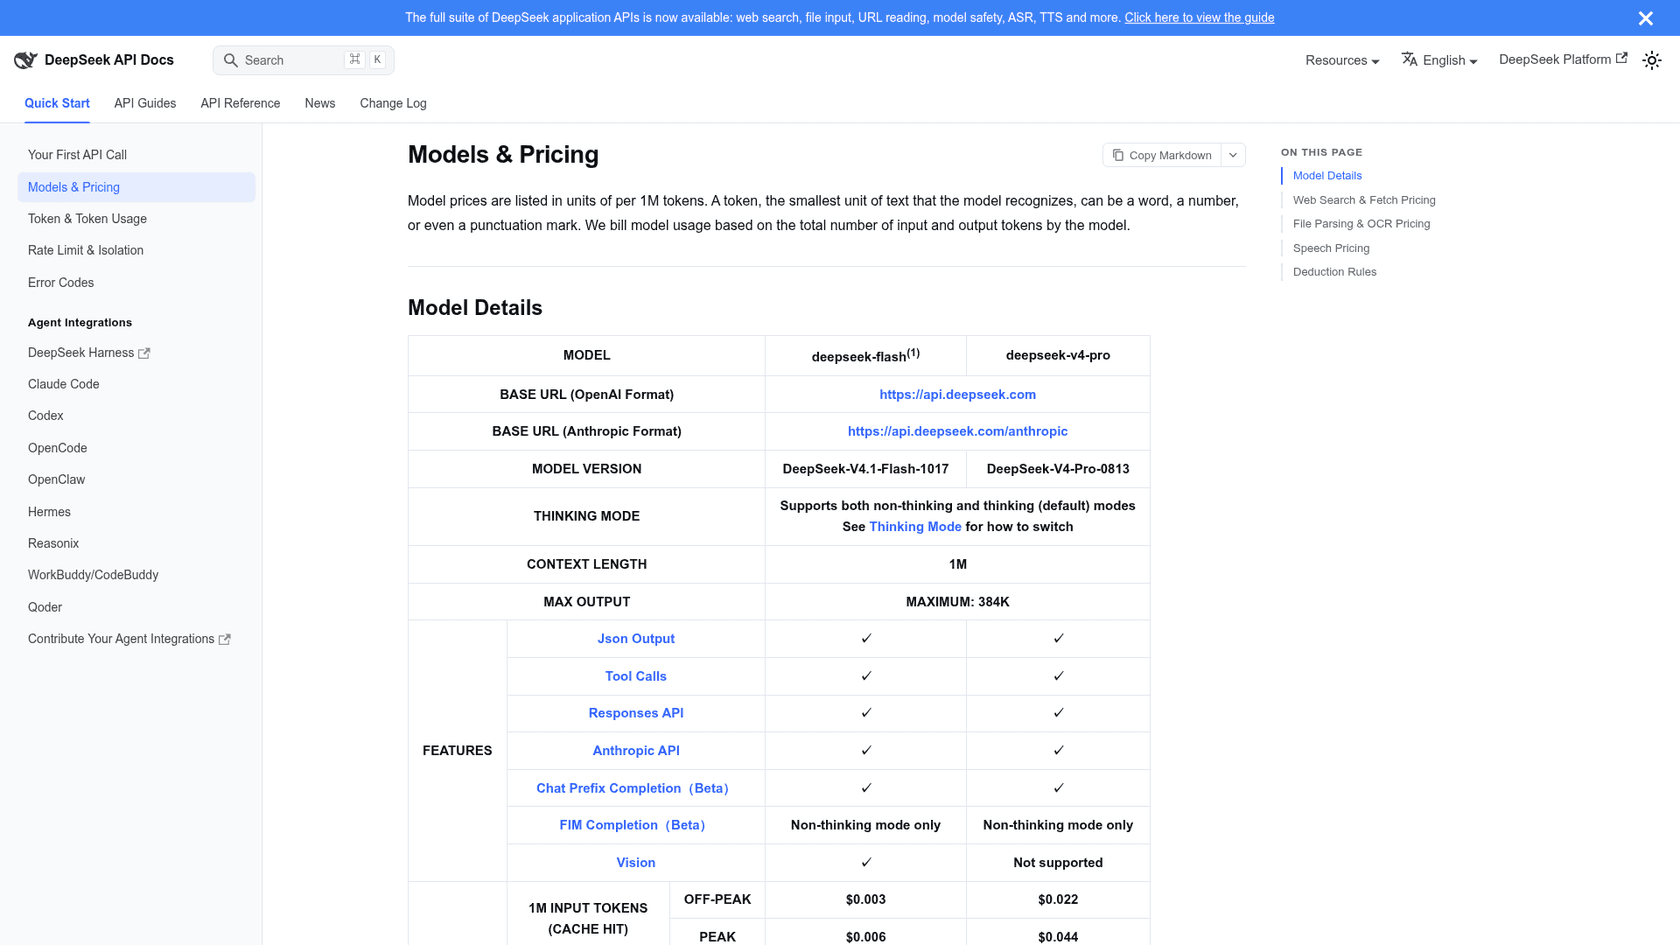
O modelo atual é o DeepSeek V4.1 Flash, que a documentação da DeepSeek lista como deepseek-flash executando DeepSeek-V4.1-Flash-1017. Custa $0,15 de entrada em caso de falha de cache e $0,60 de saída por milhão de tokens fora do horário de pico, e o dobro no pico (das 01h00 às 04h00 e das 06h00 às 10h00 UTC nos dias de semana). Acertos de cache custam $0,003. Tem uma janela de 1M de tokens, 384K de saída máxima, saída em JSON, chamadas de ferramentas, visão e um limite de concorrência de 2.500.
O Artificial Analysis o pontua em 33 no máximo por $0,60 por tarefa, calculado na taxa de pico, então fora do pico seria cerca da metade pelos meus cálculos. A surpresa é que tokens baratos não resultaram em uma tarefa barata: ele escreve 138.962 tokens, então o Sol high a 54,9 custa aproximadamente o mesmo. Um comentarista no tópico de lançamento tinha outro orçamento em mente:
"I don't think it beats Deepseek v4.1 Flash 1017 at cost per task."
Ele está certo nos preços por token e, para trabalho leve, nas contas. Os pesos têm licença MIT, então você pode hospedá-lo você mesmo.
Vantagens
$0,15/$0,60fora do pico, e acertos de cache a$0,003- Pesos abertos com licença MIT, 552B no total e 16B ativos segundo o Artificial Analysis
- Saída em JSON e chamadas de ferramentas listadas na página de preços
Desvantagens
- Pontuação do índice 32,6, então é um modelo de triagem, não de raciocínio
- Erra 64% das perguntas sem resposta no máximo
- Nenhum endpoint regional ou termos de processamento de dados na página de preços, então pergunte antes de enviar dados de clientes
Preços: $0,15 de entrada (falha de cache), $0,003 por acerto de cache e $0,60 de saída fora do pico, segundo a página de preços da DeepSeek. Veja preços do DeepSeek V4.1 Flash para as contas de pico e fora do pico.
Veredito: escolha-o para classificação e roteamento, onde 33 é mais que suficiente. Pule-o para qualquer coisa de contato com o cliente sem um humano no circuito.
Qual alternativa ao Gemini 4 Neon você deve escolher?
Aqui está a decisão da forma como eu a tomaria, por uso:
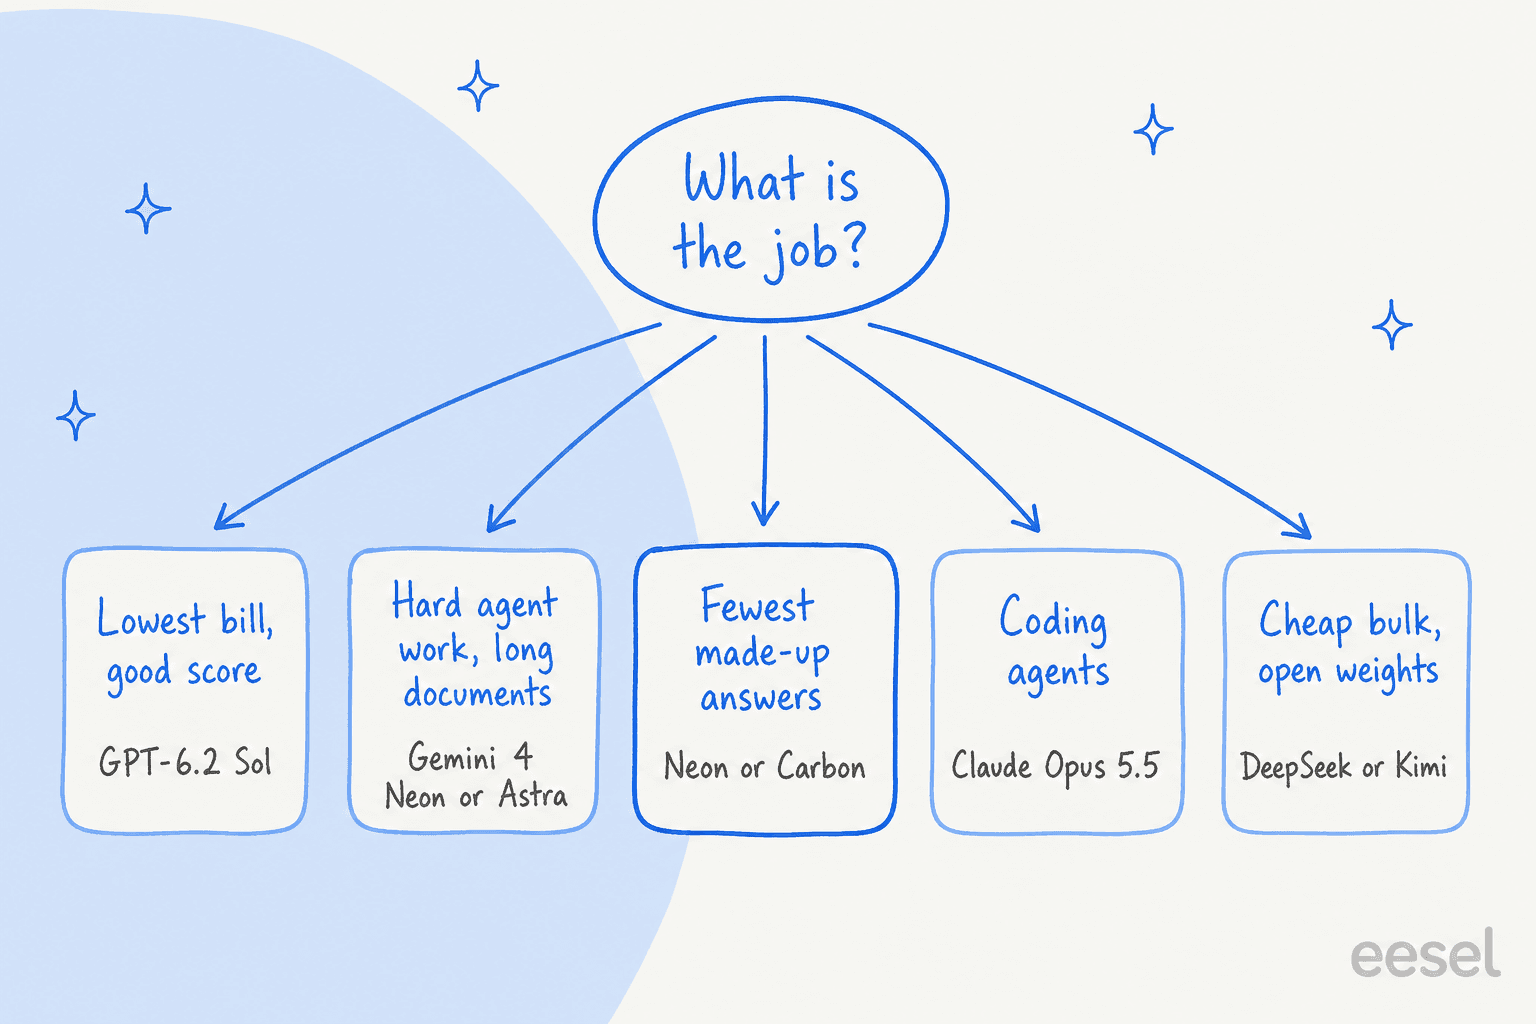
| Se a sua tarefa é... | Minha escolha | Por quê |
|---|---|---|
| a conta mais baixa com pontuação nos 50 altos | GPT-6.2 Sol | de $0,56 a $1,01 por tarefa |
| a pontuação do Neon por um custo menor | GPT-6.2 Astra high | 60,1 por $2,07 |
| agentes difíceis e documentos muito longos | Neon no high, ou Astra | as linhas de contexto longo do Neon lideram na própria tabela do Google |
| um modelo que se recusa quando está incerto | Neon ou Carbon | 14% e de 4% a 11% de erro quando incerto |
| sessões longas de código na Anthropic | Claude Opus 5.5 | código forte, mas $10,04 por tarefa no máximo |
| pesos abertos ou um fornecedor que não seja dos EUA | Kimi K3.1 Pro | $2/$10, pontuação 46,5 |
| triagem e roteamento em volume | DeepSeek V4.1 Flash | $0,60 por tarefa, pesos MIT |
| chat ao vivo | Neon medium ou Hydrogen | 8,3 minutos, não 14,8 |
Minha opinião geral: rotear, não trocar. Envie a maioria das tarefas para o Sol, envie as que precisam de um modelo mais forte para Astra ou Neon, e mantenha um nível mais baixo para triagem. Se você ainda está pesando famílias, minha comparação ChatGPT contra Gemini vai mais a fundo. O resumo de alternativas ao Gemini cobre o resto da linha do Google, e o guia API da OpenAI contra API do Gemini cobre as plataformas.
Como testo as alternativas na minha própria carga de trabalho?
Uma tarefa de ranking não é a sua tarefa. Estas são as cinco verificações que eu faria antes de mover tráfego real, na ordem em que as faria:
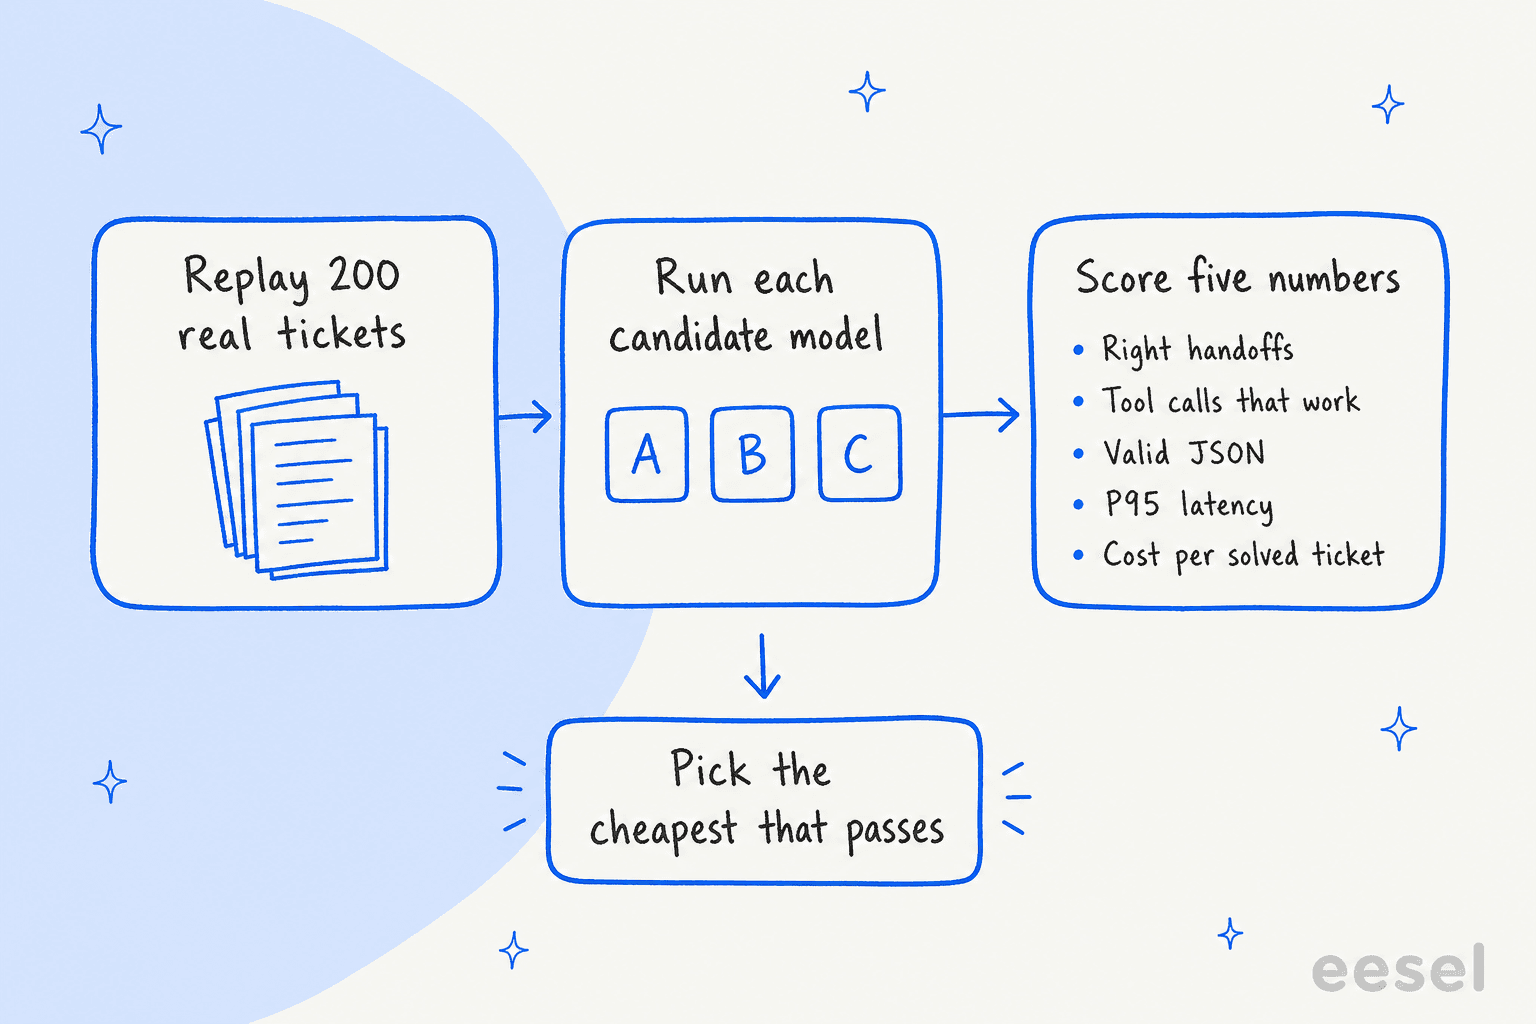
- Chamadas de ferramentas. Reproduza tarefas com suas definições reais de ferramentas, e conte três coisas: a ferramenta correta escolhida, argumentos que validam, e nenhuma chamada quando nenhuma é necessária. Se seu agente força uma ferramenta específica, teste esse modo primeiro. A página de preços da Anthropic só lista
autoenonecomo escolha de ferramenta para Opus 5.5 e Sonnet 5.5, então um design que depende de forçar uma ferramenta precisa de uma verificação antes de uma migração. Meu guia sobre chamadas de função da OpenAI cobre o lado da OpenAI. - Saída estruturada. Meça a proporção de respostas que são analisadas contra seu esquema sem uma etapa de reparo. A página de preços da DeepSeek lista a saída em JSON como suportada, e o modo JSON da OpenAI tem suas próprias regras, então passe o mesmo esquema por cada candidato. Uma resposta inválida em cinquenta se torna uma nova tentativa e um custo.
- Latência, nos extremos. Registre a mediana e o P95 do tempo até o primeiro token e até terminar. O testador da HN citado acima mediu o Carbon com uma mediana de 5 segundos para começar, com uma chamada em 50 segundos e um timeout. Medianas escondem isso, e os clientes sentem o extremo. O Artificial Analysis também mediu 56,5 segundos até o primeiro token de resposta para o Neon no xhigh, então meça cada nível de esforço que você planeja usar.
- Novas tentativas. Conte timeouts, erros de limite de taxa e saídas malformadas por 100 chamadas, e então use
custo por tentativa x (1 + taxa de novas tentativas)como seu custo real. Esse é o número que conecta um modelo barato a um caro. - Respostas erradas contra encaminhamentos. Semeie cerca de 20 tickets cuja resposta não está nos seus documentos, e conte quantas vezes cada modelo responde mesmo assim. É o mesmo comportamento que os números do AA-Omniscience sugerem, medido no seu próprio conteúdo.
Depois coloque tudo em uma linha: custo por ticket resolvido = gasto total / tickets resolvidos corretamente sem edição humana. Esse é o número pelo qual classificar, e é a versão em nível de modelo do custo por ticket. Execute cada candidato nos mesmos 200 tickets, em dois níveis de esforço, duas vezes. Meu teste de 90 execuções em Astra e Sol mostrou que o esforço quase não movia o custo em tickets curtos, o que mudou qual nível de esforço eu usaria em produção.
O que isso significa para um agente de suporte?
Se o seu objetivo é um bot de suporte, esses sete modelos são o motor, não o agente. O que o agente sabe, quando deve encaminhar e se alguém o testou antes de lançar decidem como ele se comporta, e uma resposta confiante mas errada a uma pergunta de reembolso custa mais do que um encaminhamento. A eesel vem colocando agentes de IA em filas de suporte reais há anos, e a lição que ficou é simular todo lançamento em tickets históricos antes de o agente responder a um cliente.
É assim que a smava, uma empresa alemã de comparação de empréstimos, roda a eesel em um único Zendesk. Entre 8 de agosto e 8 de setembro de 2026, três agentes trataram cerca de 27.000 tickets: um categorizou cerca de 14.600, outro redigiu cerca de 15.300 respostas a partir de 820 macros e artigos de ajuda, e agentes por marca prepararam respostas prontas para o cliente. Cada agente tem um único trabalho e uma lista de coisas que nunca deve fazer, e uma pessoa aprova o rascunho antes de qualquer coisa ser enviada. A SamCart divide o trabalho por canal: um agente para tickets do Freshdesk e outro para o chat do site, ambos respondendo a partir dos mesmos 280 artigos da central de ajuda.
Nenhuma das duas histórias é sobre escolher o melhor modelo. Elas mostram que o modelo é uma configuração dentro de um design, e o design inclui conhecimento, regras de encaminhamento e testes. Se você quer comparar modelos na sua própria fila, simule o agente em tickets passados, e observe a taxa de encaminhamento mais de perto que a precisão. Meu guia de benchmarking de agentes de suporte com IA lista os números que acompanho, e custo do atendimento ao cliente com IA mostra o que uma fila custa no total.
Experimente a eesel
Se você está escolhendo um modelo porque quer melhores respostas na sua fila, o colega de equipe de helpdesk de IA da eesel é o funcionário que fica por cima de qualquer modelo que você escolher. Ele aprende dos seus tickets anteriores e da sua central de ajuda, encaminha para uma pessoa quando seus documentos não têm resposta, e pode ser testado no seu histórico real de tickets antes de responder a qualquer um. Funciona dentro do Zendesk e do Freshdesk, e é por aí que eu começaria se a pergunta real para um lançamento de suporte é "qual modelo".
O preço é um plano de créditos mensal fixo, com um plano gratuito de 100 créditos e sem cartão, então uma mudança de preço em um modelo não move sua conta. Experimente a eesel em uma parte da sua fila.