

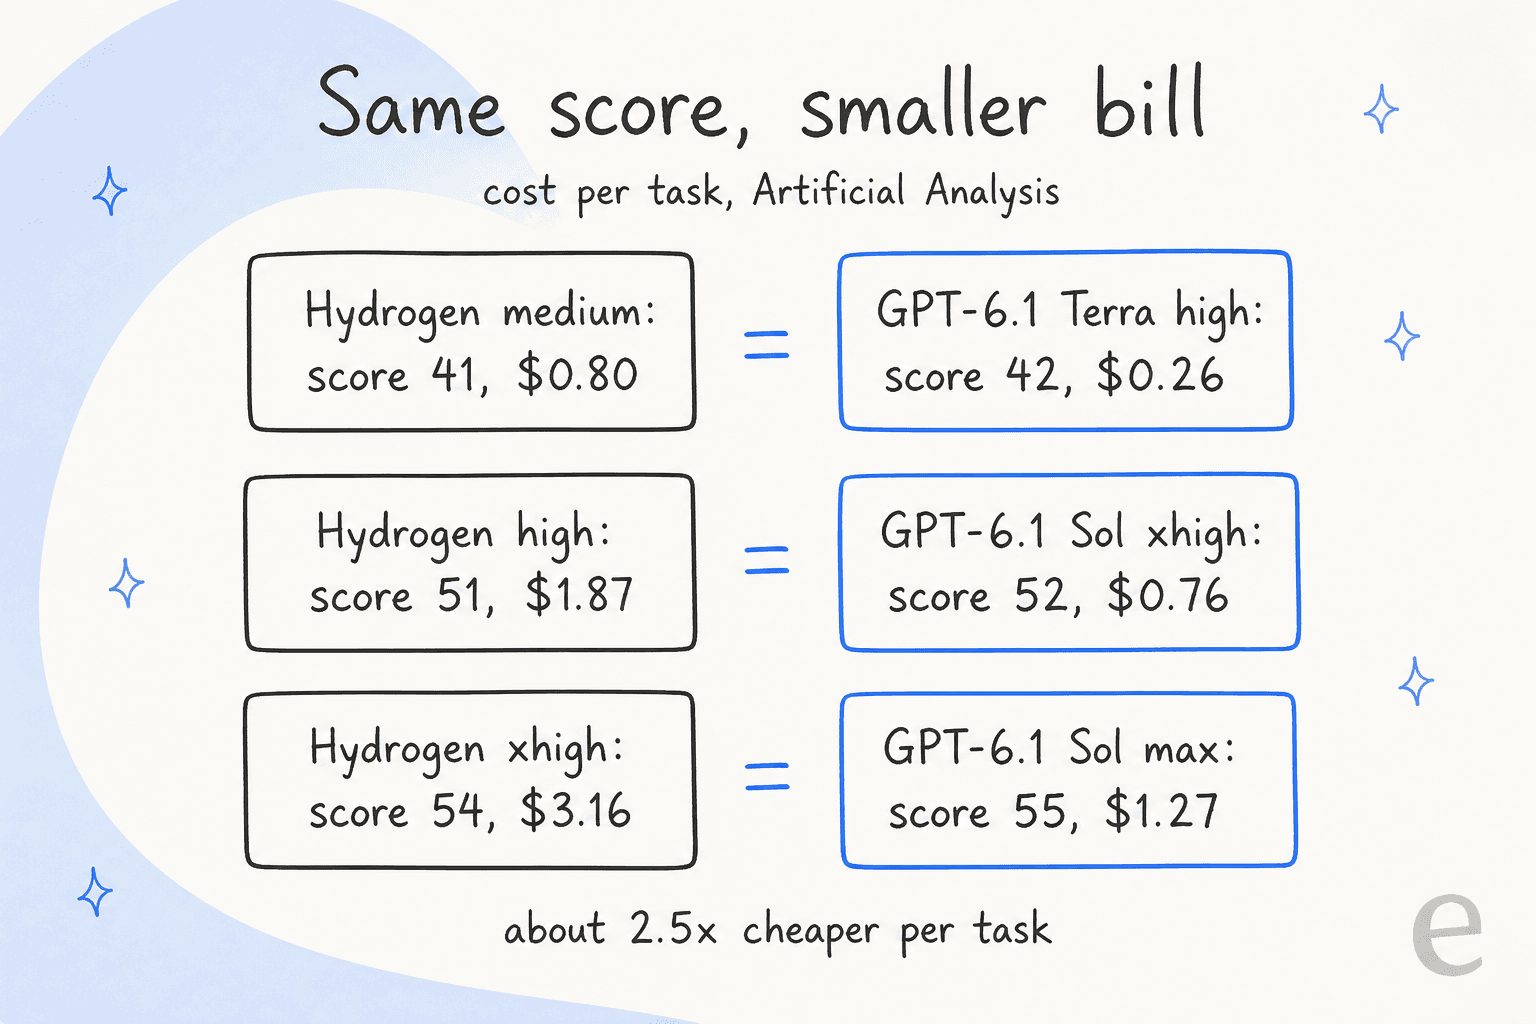
A melhor alternativa ao Gemini 4 Hydrogen para a maioria dos desenvolvedores é o GPT-6.1 Sol em esforço xhigh. Ele custa mais por token que o Hydrogen, mas a Artificial Analysis dá a ele nota 52 por $0,76 por tarefa, enquanto o Hydrogen no seu nível padrão high marca 51 por $1,87. O Hydrogen pensa bastante antes de responder, e você paga por cada um desses tokens.
Escolha o Claude Sonnet 5.5 para agentes de código e de uso de computador, o DeepSeek V4.1 Flash para a menor conta, e o Gemini 4 Carbon só para os problemas mais difíceis. Se você está construindo um agente de suporte, a eesel é um colega de helpdesk já pronto que roda sobre modelos como esses, e seu CLI deixa um agente de código carregar seus artigos de ajuda e testar as respostas dele antes de ir ao ar.
Por que olhar além do Gemini 4 Hydrogen?
Eu começo pela parte boa, porque tem bastante. O Gemini 4 Hydrogen foi lançado em 12 de novembro de 2026 a $1,50 por milhão de tokens de entrada e $7,50 por milhão de saída, com preço fixo em toda a sua janela de 1 milhão de tokens. Ele tem um nível gratuito com limite de taxa, aceita texto, imagens, áudio, vídeo e PDFs, e com pensamento baixo e médio é rápido: 1,3 e 3,7 minutos por tarefa do Intelligence Index na Artificial Analysis. O Google também relata que ele é 2,5 vezes mais rápido que o Gemini 3.8 Flash na configuração padrão, segundo o post de lançamento.
Os desenvolvedores continuam procurando alternativas, e na minha experiência é por um de quatro motivos:
- A conta sobe rápido com pensamento alto. O preço por token nunca muda, mas o custo por tarefa muda sim. A Artificial Analysis coloca o Hydrogen em
$0,29por tarefa em low,$0,80em medium,$1,87em high (o padrão) e$3,16em xhigh. Isso é uma variação de 11 vezes no mesmo modelo, porque a AA o descreve como "very verbose" no nível mais alto. - Código e uso de computador ficam atrás do Claude. O próprio cartão de modelo do Google coloca o Sonnet 5.5 na frente em Terminal-Bench 4.1 (
63,9%contra57,0%) e OSWorld-2.1 (83,9%contra77,6%). - A migração quebra coisas. Segundo as notas de migração do Google, o Hydrogen ignora
temperature,top_petop_k, rejeita o nível de pensamentominimal, abandona o cache de contexto explícito, e pode retornarMALFORMED_FUNCTION_CALLse você pedir para ele escrever chamadas de ferramenta em JSON puro sem declarar ferramentas. - Os preços do Google continuam mudando. Mais sobre isso abaixo, porque isso muda as contas para quem está no Gemini 3.8 Flash.
O tópico de lançamento no Hacker News capturou bem esse dilema:
"My TL;DR is: seems like a better choice than Sonnet in areas outside of coding, and at high reasoning it's smarter than Terra but somewhat more expensive."

O que acontece com os preços do Gemini a seguir?
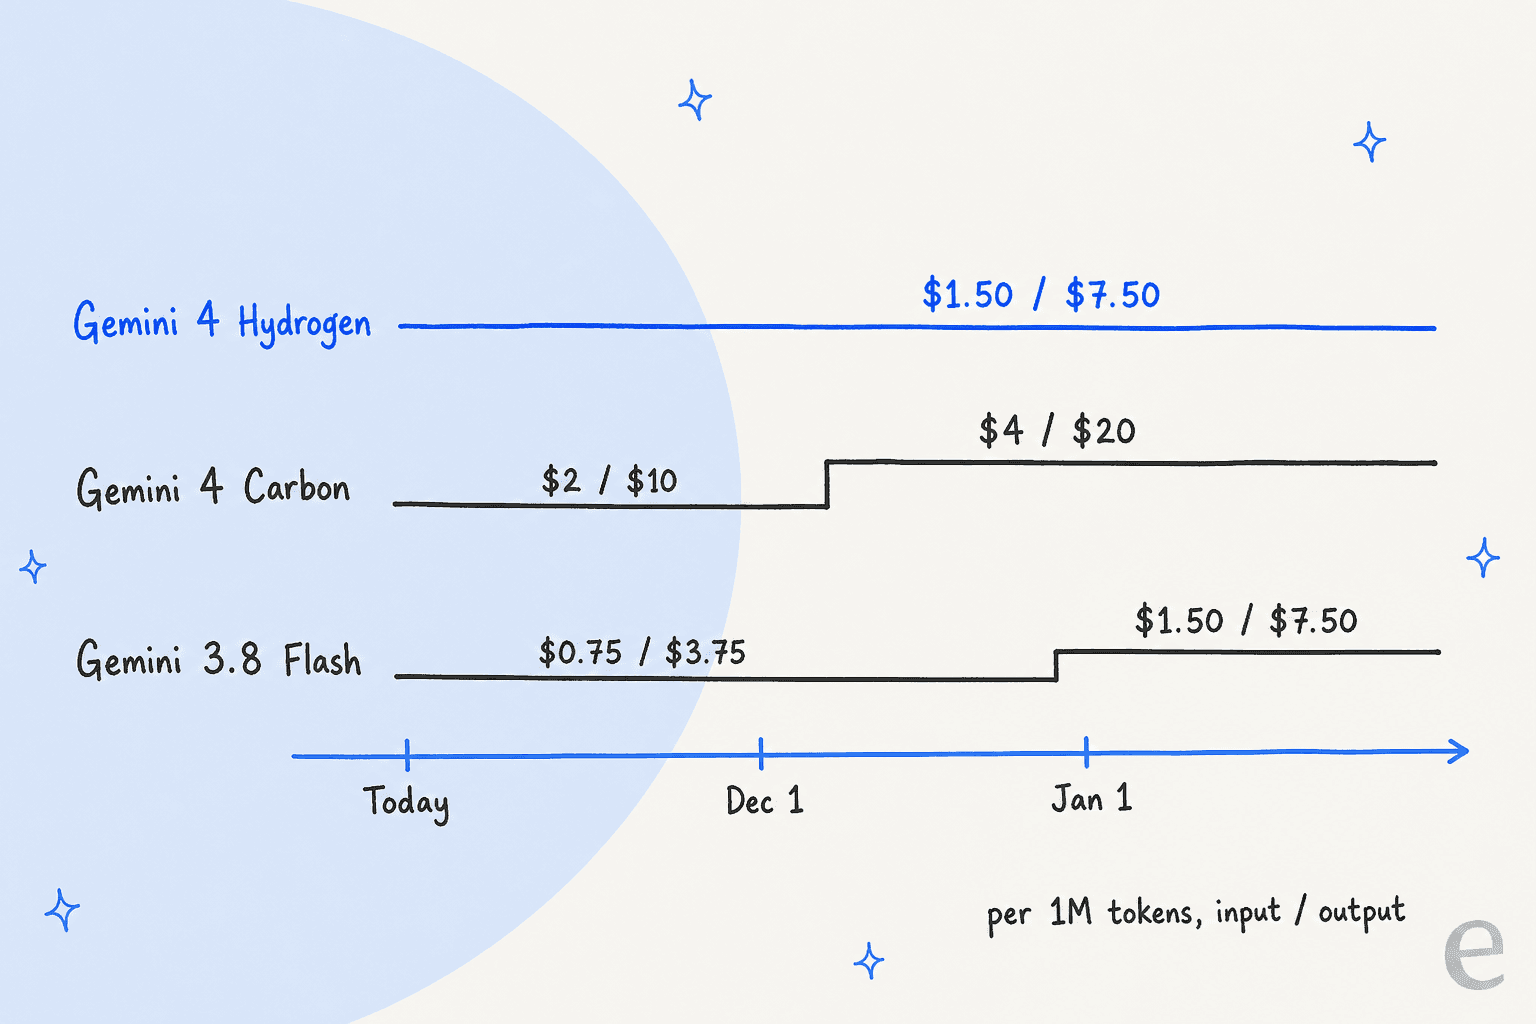
Duas mudanças de preço do Google chegam nas próximas sete semanas. O Gemini 4 Carbon passa de $2/$10 para $4/$20 em 1º de dezembro de 2026, e o Gemini 3.8 Flash passa de $0,75/$3,75 para $1,50/$7,50 em 1º de janeiro de 2027, ambos segundo a página de preços da API do Gemini. A partir de janeiro, o Flash e o Hydrogen terão o mesmo preço de tabela, por isso o Google chama o Hydrogen de upgrade recomendado.
Um usuário do Flash no tópico de lançamento já tinha feito essa conta:
"If this is Google's strategy we'll have to migrate to Luna, because costs are already high for our workload on 3.8 Flash"
Eu ouço a mesma preocupação de equipes de suporte. Uma equipe de hardware B2B com quem falei já tinha se queimado quando os preços de um fornecedor de IA anterior "mais que dobraram", e pediu um contrato anual só para travar a tarifa. O risco de preço é um motivo real para manter um segundo modelo pronto.
Como escolhi e precifiquei estes modelos
Eu construo as integrações e APIs que conectam os agentes de IA da eesel aos helpdesks, então passo bastante tempo trocando modelos debaixo de um agente em funcionamento. Esta é a lição que se repete: um token barato pode gerar uma tarefa cara. É por isso que cada escolha abaixo é julgada por:
- Preço de tabela por 1M de tokens, lido em 13 de novembro de 2026 na própria página de preços de cada fornecedor.
- Custo por tarefa, nota e tempo por tarefa da Artificial Analysis, que roda a mesma suíte Intelligence Index em cada modelo e registra o que cada um realmente gastou, incluindo tokens de pensamento. Eu anoto o nível de esforço entre parênteses, porque um modelo pode cair em qualquer ponto da tabela dependendo desse ajuste.
- Uma conta mensal para um comprador: um agente enviando 1 milhão de requisições por mês, cada uma com 2.000 tokens de entrada e 300 de saída. São 2 bilhões de tokens de entrada e 300 milhões de saída, antes de cache ou tokens de pensamento. É um piso, não uma previsão.
Eu também fiz uma busca nova no ChatGPT com a pergunta que um desenvolvedor digitaria. A lista curta dele foi Claude Sonnet 5.5, GPT-6.1 Terra, GPT-6.1 Sol, Claude Opus 5.5 e DeepSeek, e ele disse que o número a observar é "custo por tarefa bem-sucedida". Mantive os cinco e depois acrescentei Gemini 4 Carbon, Kimi K3.1 Pro e GPT-6 Luna para cobrir as rotas do mesmo fornecedor, de pesos abertos e de orçamento.
Alternativas ao Gemini 4 Hydrogen comparadas
| Modelo | Entrada / saída por 1M | Entrada em cache | Contexto | Pesos abertos | Nota AA (nível) | Custo AA por tarefa | Tempo AA por tarefa | Conta mensal (comprador de exemplo) |
|---|---|---|---|---|---|---|---|---|
| Gemini 4 Hydrogen (referência) | $1.50 / $7.50 | $0.075 | 1M | Não | 51 (high) | $1.87 | 8.3 min | $5,250 |
| GPT-6.1 Sol | $2 / $10 | $0.10 | 1.05M | Não | 52 (xhigh) | $0.76 | 9.8 min | $7,000 |
| GPT-6.1 Terra | $1 / $5 | $0.05 | 1.05M | Não | 42 (high) | $0.26 | 4.2 min | $3,500 |
| Claude Sonnet 5.5 | $2 / $10 | $0.10 | 1M | Não | 55 (max) | $10.02 | 33.0 min | $7,000 |
| Claude Opus 5.5 | $4 / $20 | $0.20 | 1M | Não | 48 (medium) | $2.45 | 7.2 min | $14,000 |
| Gemini 4 Carbon | $2 / $10, depois $4 / $20 a partir de 1º dez. | $0.10 | 1M | Não | 58 (medium) | $4.68 | 23.8 min | $7,000, depois $14,000 |
| DeepSeek V4.1 Flash | $0.15 / $0.60 fora de pico | $0.003 | 1M | Sim (MIT) | 33 (max) | $0.60 | 15.1 min | $480 |
| Kimi K3.1 Pro | $2 / $10 | $0.20 | 1M | Sim | 46 | $3.68 | 38.3 min | $7,000 |
| GPT-6 Luna | $0.10 / $0.50 | $0.01 | 1.05M | Não | 28 (max) | $0.15 | 11.6 min | $350 |
Leia as três últimas colunas antes da primeira. No preço de tabela, o Hydrogen parece mais barato que o Sol. Por tarefa, o Sol faz um trabalho um pouco melhor por cerca de 40% do custo, e em um tempo parecido. As notas, custos e tempos vêm da página da Artificial Analysis de cada modelo em 13 de novembro de 2026.
Quanto cada um custaria por mês?
Informe quantas tarefas de agente você roda por mês, e escolha um tamanho. A calculadora multiplica pelo custo por tarefa da Artificial Analysis de cada modelo, então inclui os tokens de pensamento que a conta no preço de tabela acima deixa de fora. As tarefas da AA são trabalhos agênticos longos, então trate os totais como uma forma de comparar modelos entre si, não como sua conta exata.
1. GPT-6.1 Sol
Melhor para: desenvolvedores que querem trabalho no nível do Hydrogen por menos por tarefa, e podem conviver com o formato de API da OpenAI.
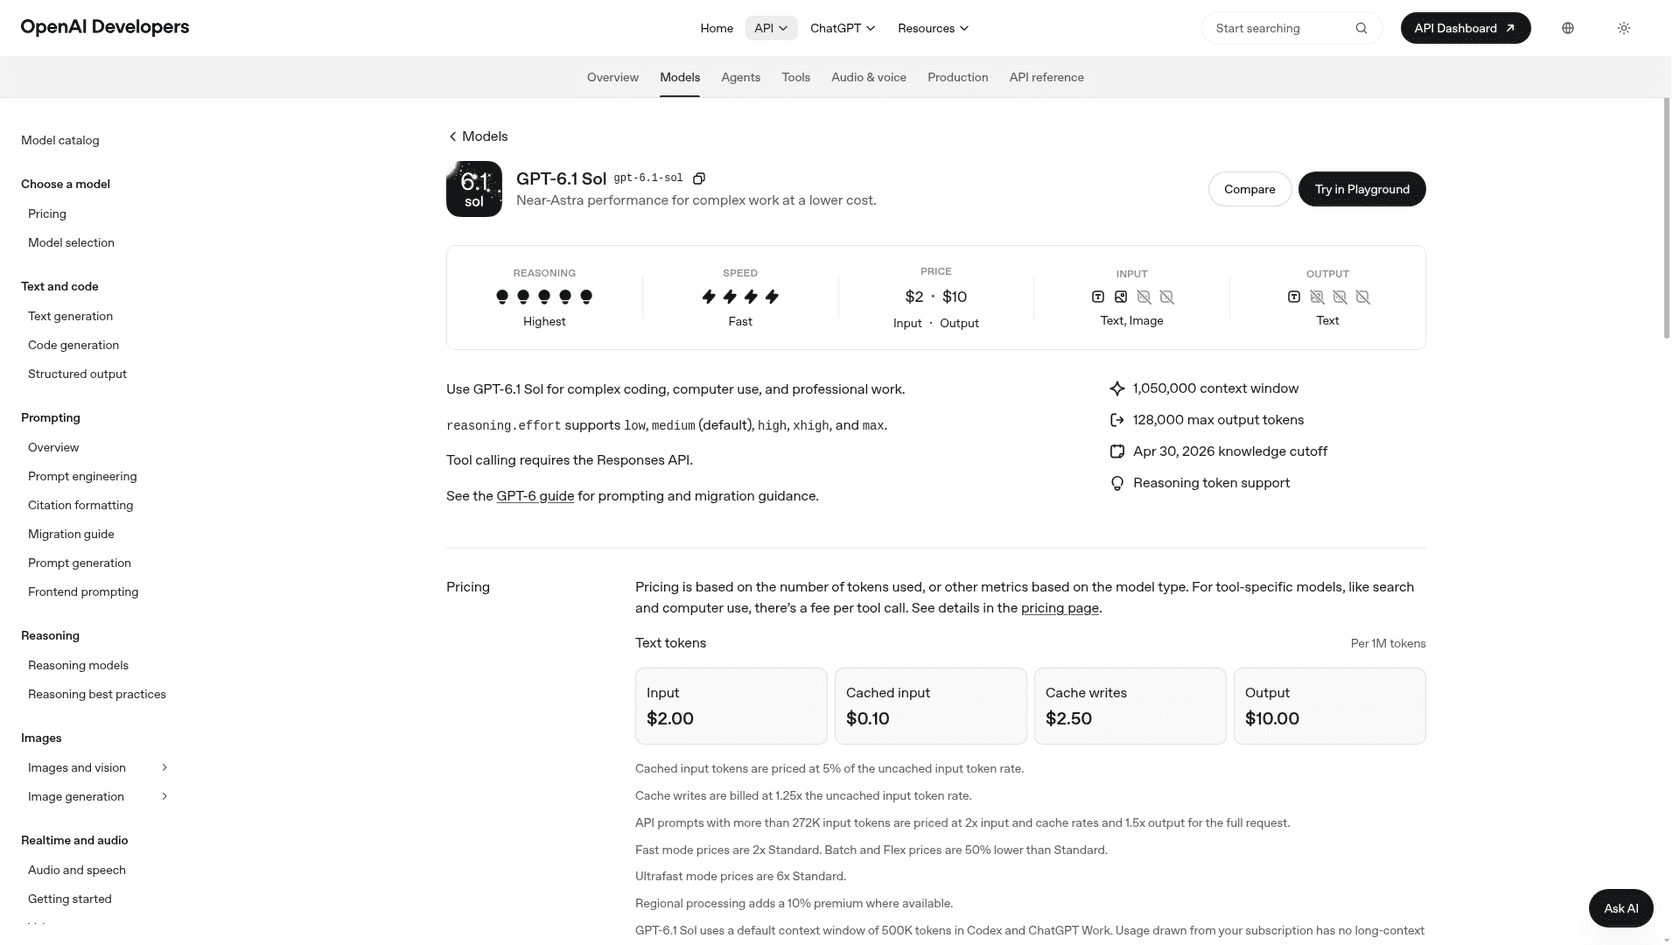
O GPT-6.1 Sol é o segundo degrau da OpenAI, abaixo do GPT-6 Astra. A OpenAI o descreve como "Near-Astra performance for complex work at a lower cost", e por tarefa é o mais próximo de um upgrade direto do Hydrogen nesta lista.
Prós
- Em xhigh, ele marca
52por$0,76por tarefa em9,8minutos. O Hydrogen em high marca51por$1,87em8,3minutos. - Em max, ele marca
55por$1,27, mais barato que o Hydrogen em xhigh (54,$3,16). - Cinco níveis de esforço, de
lowamax, então você pode ajustá-lo do mesmo jeito que ajustaria o nível de pensamento do Hydrogen.
Contras
- O uso de ferramentas exige a Responses API, então uma integração pensada no formato do Gemini precisa de retrabalho real.
- Sem nível gratuito, e prompts acima de 272K tokens de entrada custam 2x a entrada e 1,5x a saída na requisição inteira.
- Seu limite de conhecimento é 30 de abril de 2026.
Preços: $2 de entrada, $0,10 em cache, $10 de saída por 1M de tokens na página de preços da OpenAI. Batch e Flex custam a metade.
Minha opinião: se você estava prestes a colocar o Hydrogen em xhigh, experimente primeiro o Sol em xhigh. Por tarefa, é o caminho mais barato para a mesma nota. A análise do GPT-6.1 Sol tem um teste prático com ticket de suporte.
2. GPT-6.1 Terra
Melhor para: trabalho rápido e barato onde o Hydrogen em low ou medium já é bom o suficiente.
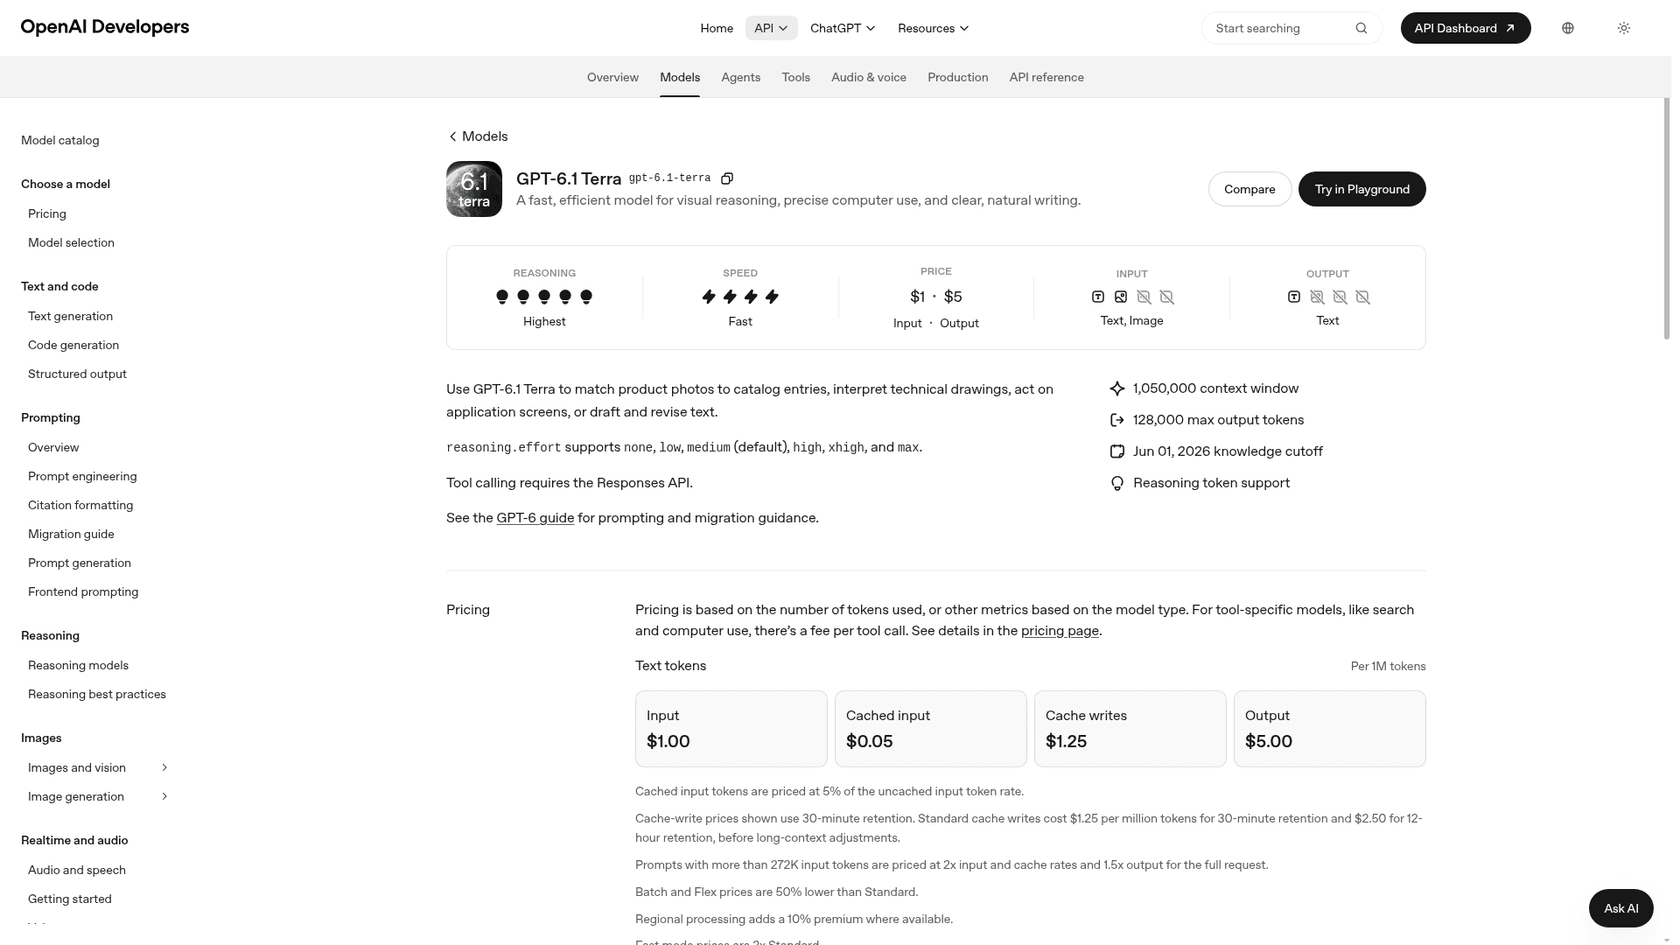
O GPT-6.1 Terra fica um degrau abaixo do Sol, e é o rival mais direto do Hydrogen. O Google até o colocou na própria tabela comparativa, onde o Hydrogen vence em 8 das 9 linhas compartilhadas.
Prós
- Em high, ele marca
42por$0,26por tarefa em4,2minutos. O Hydrogen em medium marca41por$0,80em3,7minutos. Isso é cerca de um terço do custo pela mesma nota. - Ele tem um nível de esforço
nonepara um caminho rápido sem pensamento, que o Hydrogen não oferece. - O preço de tabela é um terço mais baixo que o do Hydrogen, tanto na entrada quanto na saída.
Contras
- A tabela do Google coloca o Hydrogen na frente em SWE-sweep (
13,5%contra5,8%) e AutomationBench (76,1%contra60,2%). - Levá-lo a max (
51,$0,96,14,2minutos) é mais lento que o Hydrogen em high. - Mesma exigência de Responses API para uso de ferramentas que o Sol.
Preços: $1 de entrada, $0,05 em cache, $5 de saída por 1M de tokens, segundo a página de preços da OpenAI.
Minha opinião: a troca para tráfego de alto volume e dificuldade média. Para tarefas difíceis, suba para o Sol em vez de levar o Terra ao máximo. A análise do GPT-6.1 Terra mostra como ele se comportou com tickets reais.
3. Claude Sonnet 5.5
Melhor para: agentes de código, trabalho em terminal e uso de computador.
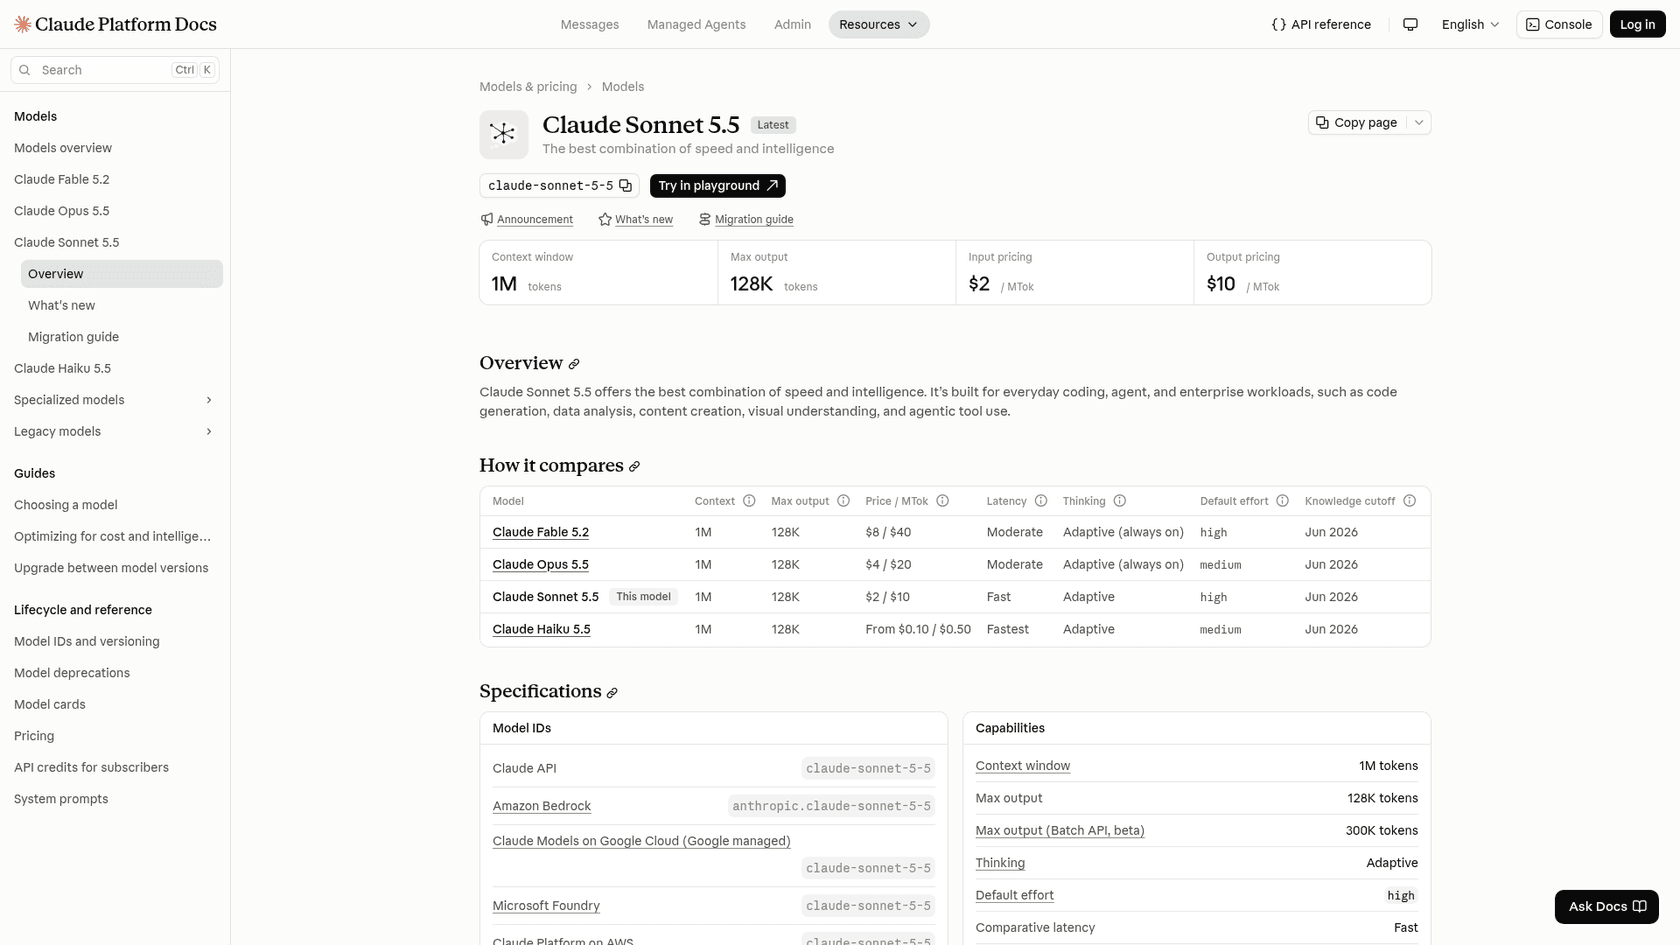
O Claude Sonnet 5.5 é o modelo intermediário da Anthropic, que a Anthropic chama de "the best combination of speed and intelligence". O ChatGPT o classificou como a melhor alternativa ao Hydrogen, e os próprios números do Google explicam por que ele está na conversa.
Prós
- Ele vence o Hydrogen nas duas linhas de agente que mais importam para ferramentas de código: Terminal-Bench 4.1 (
63,9%contra57,0%) e OSWorld-2.1 (83,9%contra77,6%), segundo o cartão de modelo do Google. - Em max, ele marca
55, acima do melhor do Hydrogen (54em xhigh). - Preço fixo em toda a janela de 1M, e leituras de cache a
$0,10.
Contras
- Em max, ele custa
$10,02por tarefa e leva33minutos na Artificial Analysis. Em medium, cai para$0,78, mas a nota cai para31. - O Hydrogen vence as linhas de SWE-sweep (
13,5%contra3,1%) e HLE-Diamond (58,8%contra53,3%) do Google. - API estrita: um
temperaturefora do padrão e umtool_choiceforçado retornam erro, coberto na análise do Sonnet 5.5.
Preços: $2 de entrada, $0,10 de leitura em cache, $10 de saída por 1M de tokens na página de preços da Anthropic. Batch corta pela metade.
Minha opinião: escolha-o quando o agente escreve código ou opera um computador. Para trabalho de conhecimento geral, o Hydrogen é a compra melhor, o que combina com o que concluiu o tópico do HN.
4. Claude Opus 5.5
Melhor para: agentes de longa duração em que fazer certo importa mais do que a conta.
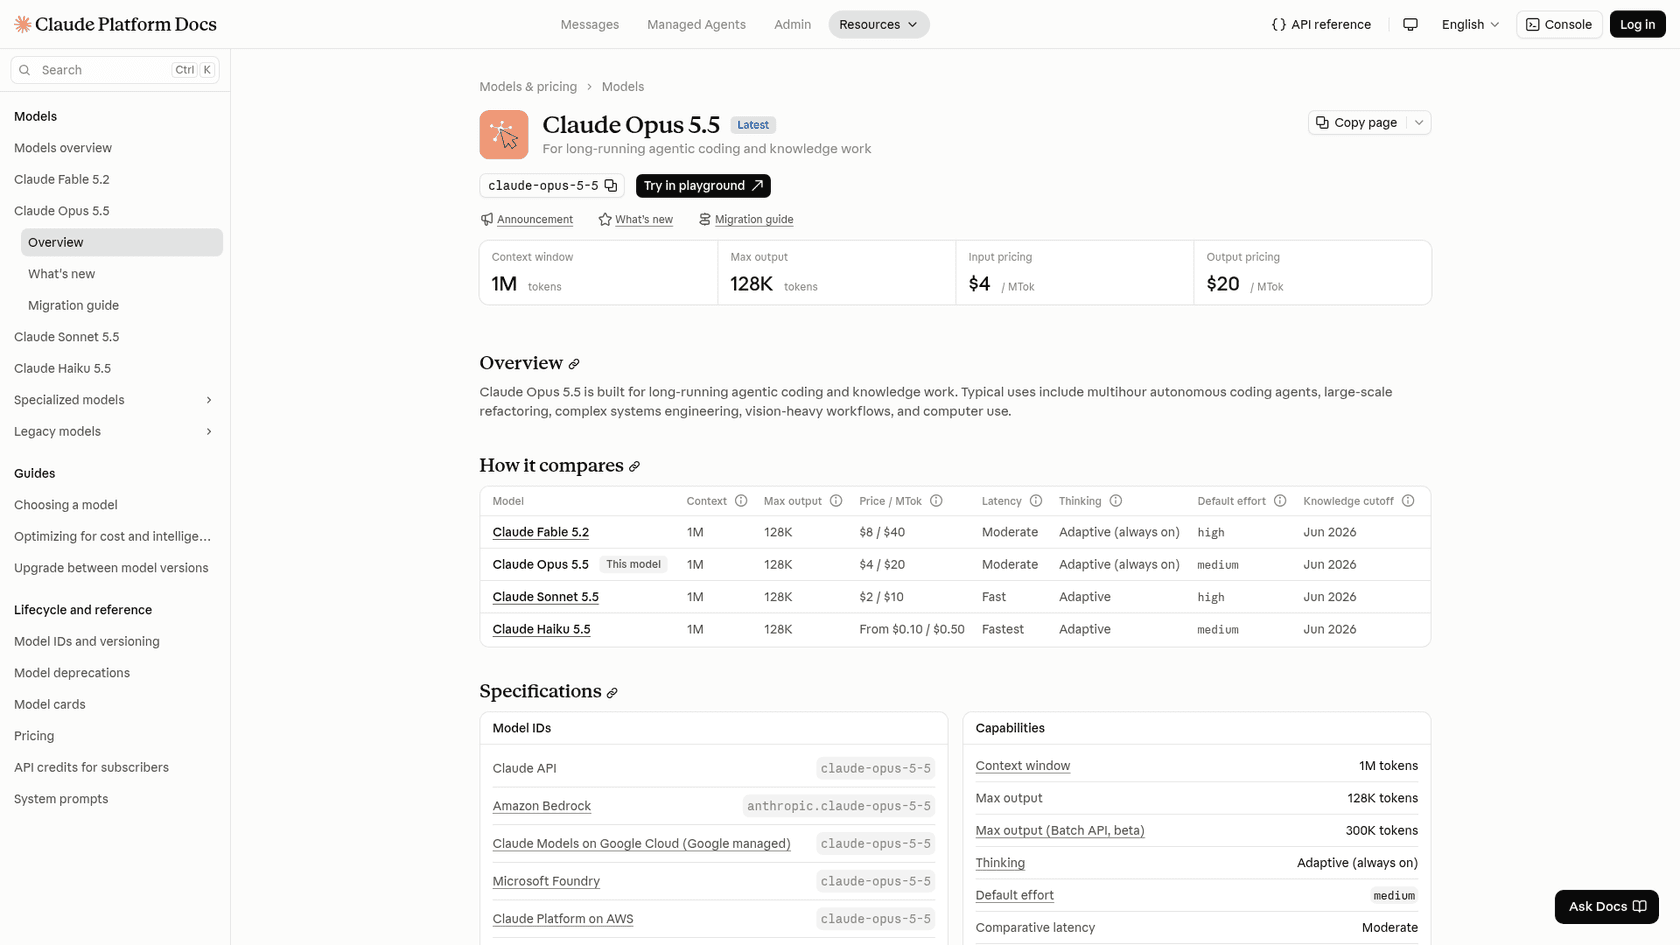
O Claude Opus 5.5 é o modelo grande da Anthropic, feito "for long-running agentic coding and knowledge work". Aqui é a escolha mais cara por token, então ele pertence a esta lista como alvo de escalonamento, não como padrão.
Prós
- Em max, ele marca
59na Artificial Analysis, a segunda maior nota deste comparativo, depois do Carbon em high. - Em medium, seu nível padrão, ele marca
48por$2,45em7,2minutos. - Leituras de cache custam
$0,20, só 5% do preço de entrada, o que ajuda agentes que reenviam um prompt de sistema longo.
Contras
- Preço de tabela de
$4/$20, então a conta de exemplo é$14.000, quase 3 vezes a do Hydrogen. - Em max,
$10,04por tarefa e25,2minutos. - O pensamento está sempre ativo, o que a Anthropic lista como "Adaptive (always on)", e é cobrado como saída.
Preços: $4 de entrada, $0,20 de leitura em cache, $20 de saída por 1M de tokens na página de preços da Anthropic. O modo Fast custa $8/$40.
Minha opinião: um planejador, não um executor. Deixe o Opus planejar ou revisar, e algo mais barato fazer as etapas. A análise do Opus 5.5 tem os números por nível de esforço.
5. Gemini 4 Carbon
Melhor para: equipes que ficam no Google e precisam de mais raciocínio do que o Hydrogen dá.
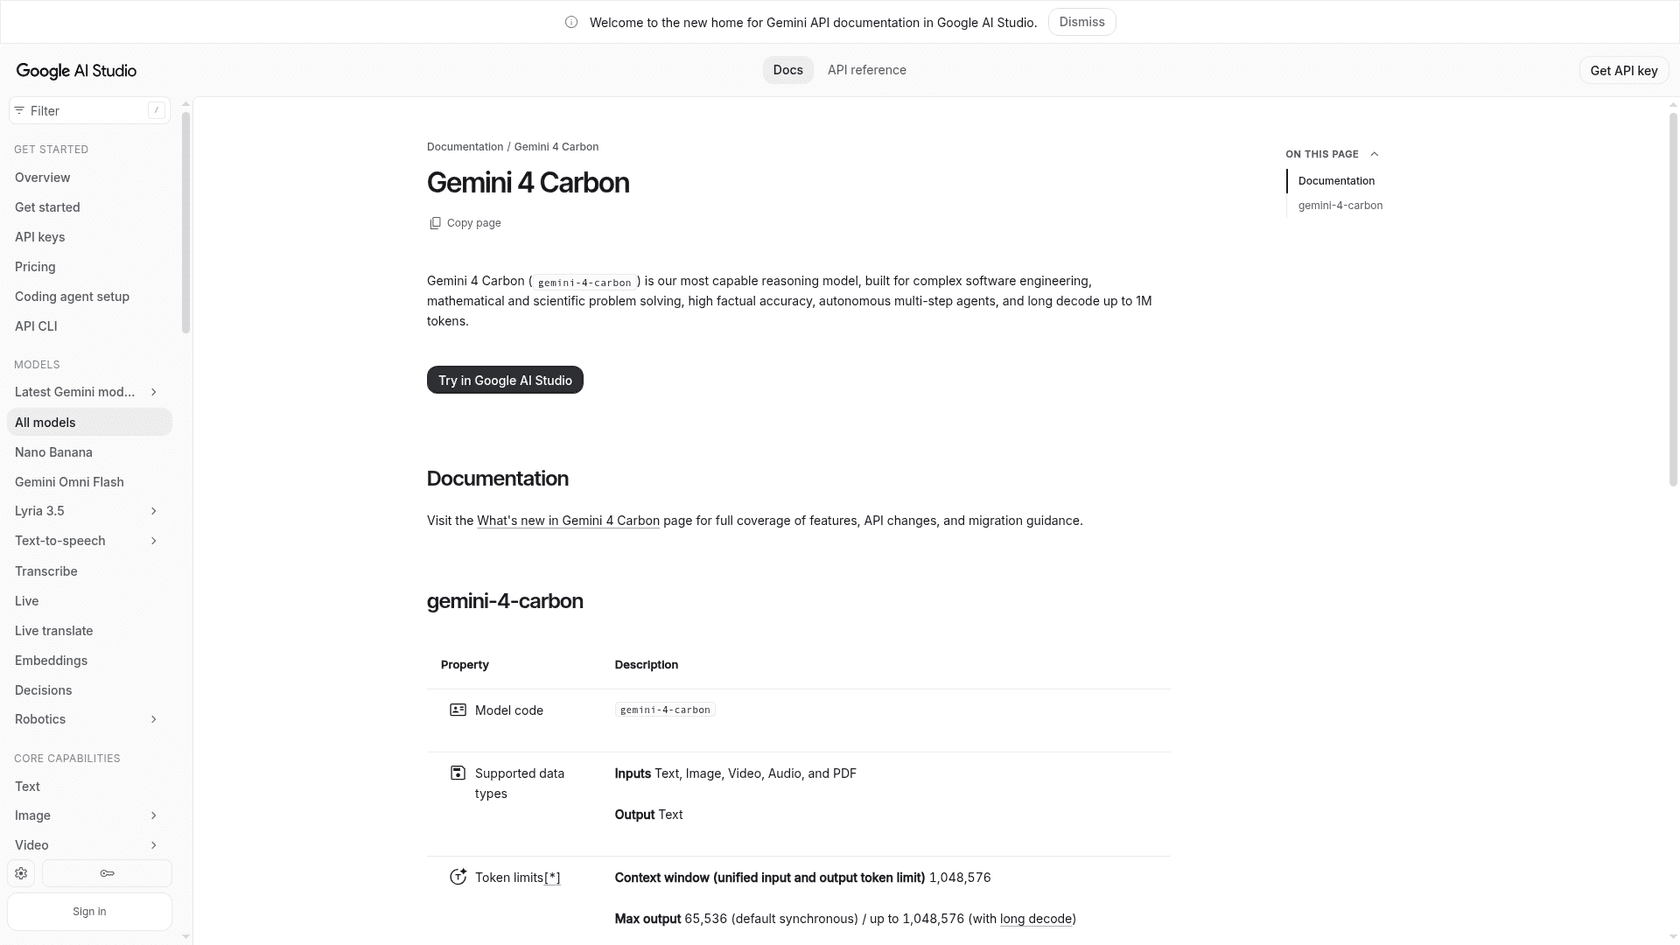
O Gemini 4 Carbon é o irmão maior do Hydrogen e alcançou disponibilidade geral em 10 de novembro de 2026. Mesma API e mesmas entradas, então essa é a troca que exige menos trabalho de toda a lista.
Prós
- Em medium, ele marca
58na Artificial Analysis, e60em high, a maior nota deste comparativo. - Você mantém o SDK do Gemini, o Search grounding e as entradas multimodais que já construiu.
- O Orchestrator no Antigravity do Google combina o Carbon para planejar com o Hydrogen para executar, o que mostra a divisão pretendida.
Contras
$4,68por tarefa em medium,$5,48em high, e de23,8a27,4minutos por tarefa.- O preço dobra para
$4/$20em 1º de dezembro de 2026, e não há nível gratuito. - Por padrão fica em medium e tem teto em high, então não há xhigh.
Preços: $2 de entrada, $0,10 em cache, $10 de saída por 1M de tokens até 30 de novembro de 2026, depois $4/$0,20/$20, segundo a página de preços da API do Gemini. Mais na análise do Gemini 4 Carbon.
Minha opinião: direcione seus 10% mais difíceis para aqui e mantenha o Hydrogen para o resto. Mandar tudo para o Carbon depois de 1º de dezembro é uma conta alta por alguns pontos de nota.
6. DeepSeek V4.1 Flash
Melhor para: a conta mais baixa, e equipes que querem pesos abertos.
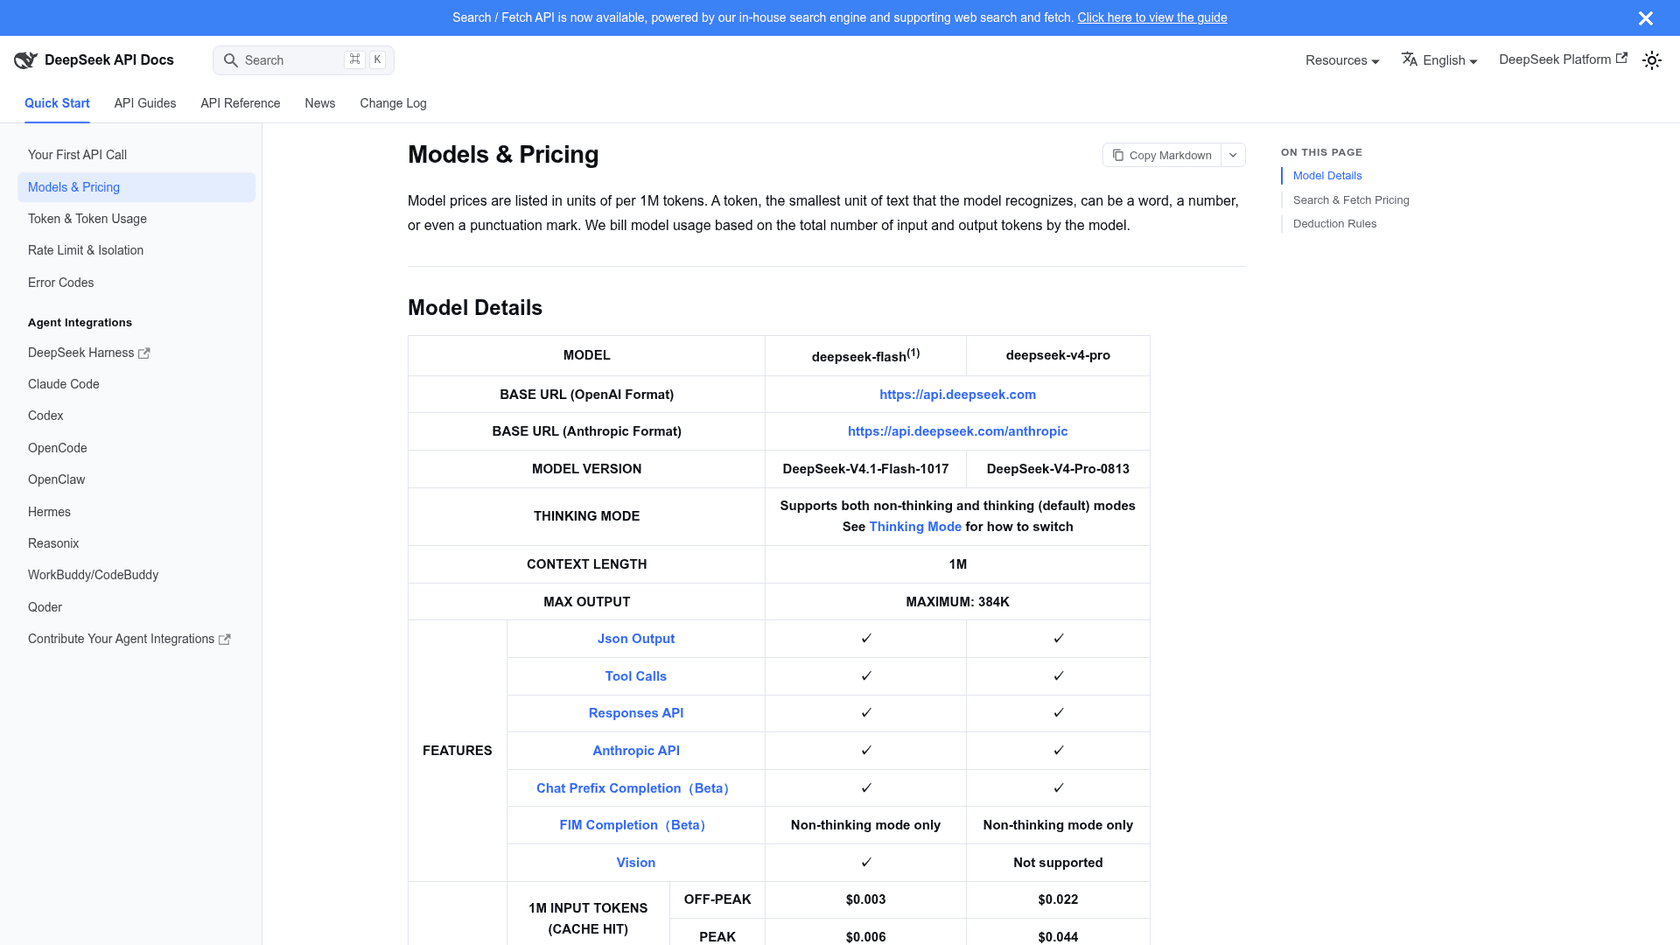
O DeepSeek V4.1 Flash é chamado de deepseek-flash na API da DeepSeek, e o nome antigo deepseek-v4-flash agora também redireciona para ele. É o único modelo aqui que custa menos de um décimo do preço de tabela do Hydrogen.
Prós
$0,15/$0,60por 1M de tokens fora de pico, então a conta de exemplo é$480contra os$5.250do Hydrogen.- Pesos sob licença MIT, então você ou um provedor de hospedagem podem rodá-lo fora da China.
- Entrada de visão, uso de ferramentas, saída JSON, e endpoints tanto no formato OpenAI quanto no formato Anthropic.
Contras
- Ele marca
33em max na Artificial Analysis, bem abaixo do Hydrogen em medium (41). - Horários de pico (
01:00às04:00e06:00às10:00UTC, dias úteis) dobram o preço. - Na própria plataforma da DeepSeek, seus dados vão para uma empresa sediada na China, então verifique isso contra suas regras de dados primeiro.
Preços: $0,15 de entrada, $0,003 de acerto de cache, $0,60 de saída por 1M de tokens fora de pico; $0,30/$0,006/$1,20 no pico, segundo a página de preços da DeepSeek.
Benchmarks não contam a história toda aqui. Um desenvolvedor que fez testes de agentes cara a cara publicou isto:
"Right now DeepSeek Flash 4.1 Flash has a 64% win rate against GPT 6.1 Sol. Small data still, but it has 33 wins vs. 18 losses"
Minha opinião: vale um teste comparativo para qualquer trabalho de alto volume antes de pagar as tarifas do Hydrogen. O guia de preços do DeepSeek V4.1 Flash cobre as contas do horário de pico.
7. Kimi K3.1 Pro
Melhor para: equipes que precisam de um modelo grande de pesos abertos e podem esperar pelas respostas.
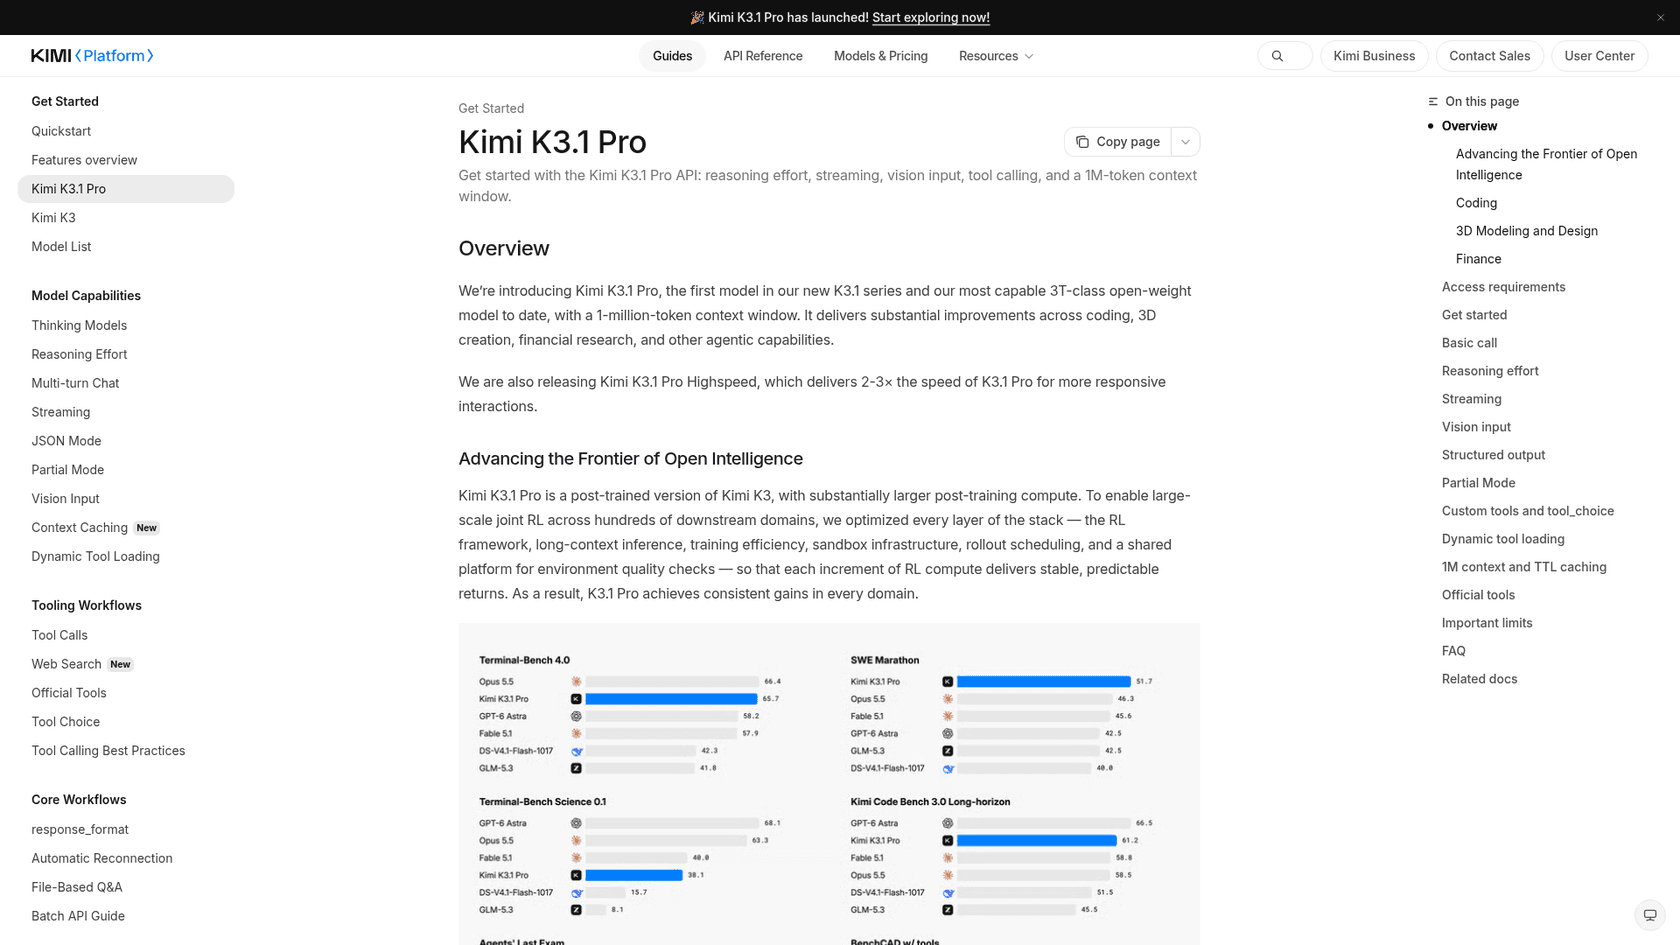
O Kimi K3.1 Pro é o carro-chefe da Moonshot AI, descrito na documentação como "our most capable 3T-class open-weight model to date". Seus pesos já estão no Hugging Face.
Prós
- A Artificial Analysis o classifica em primeiro entre 28 modelos de pesos abertos da sua categoria de tamanho, com
46. - Contexto de 1.048.576 tokens, entrada de imagem, e inferência em lote a 60% do preço padrão.
- Uma versão Highspeed (
$4/$20) roda de 2 a 3 vezes mais rápido, segundo a Moonshot.
Contras
$3,68por tarefa e38,3minutos na Artificial Analysis, o que o marca como lento e caro para um modelo de pesos abertos.- A AA mediu um tempo até o primeiro token de resposta de
172segundos a cerca de31tokens por segundo. - Mesmo preço de tabela de
$2/$10que o Sol, com uma nota mais baixa.
Preços: $2 de entrada, $0,20 de acerto de cache, $10 de saída por 1M de tokens na página de preços da Moonshot.
Minha opinião: uma escolha quando pesos abertos são a exigência, não uma economia em relação ao Hydrogen. Se você só precisa do mais barato, o DeepSeek vence. A análise do Kimi K3.1 Pro vai mais a fundo.
8. GPT-6 Luna
Melhor para: triagem, marcação e roteamento no preço mais baixo possível.
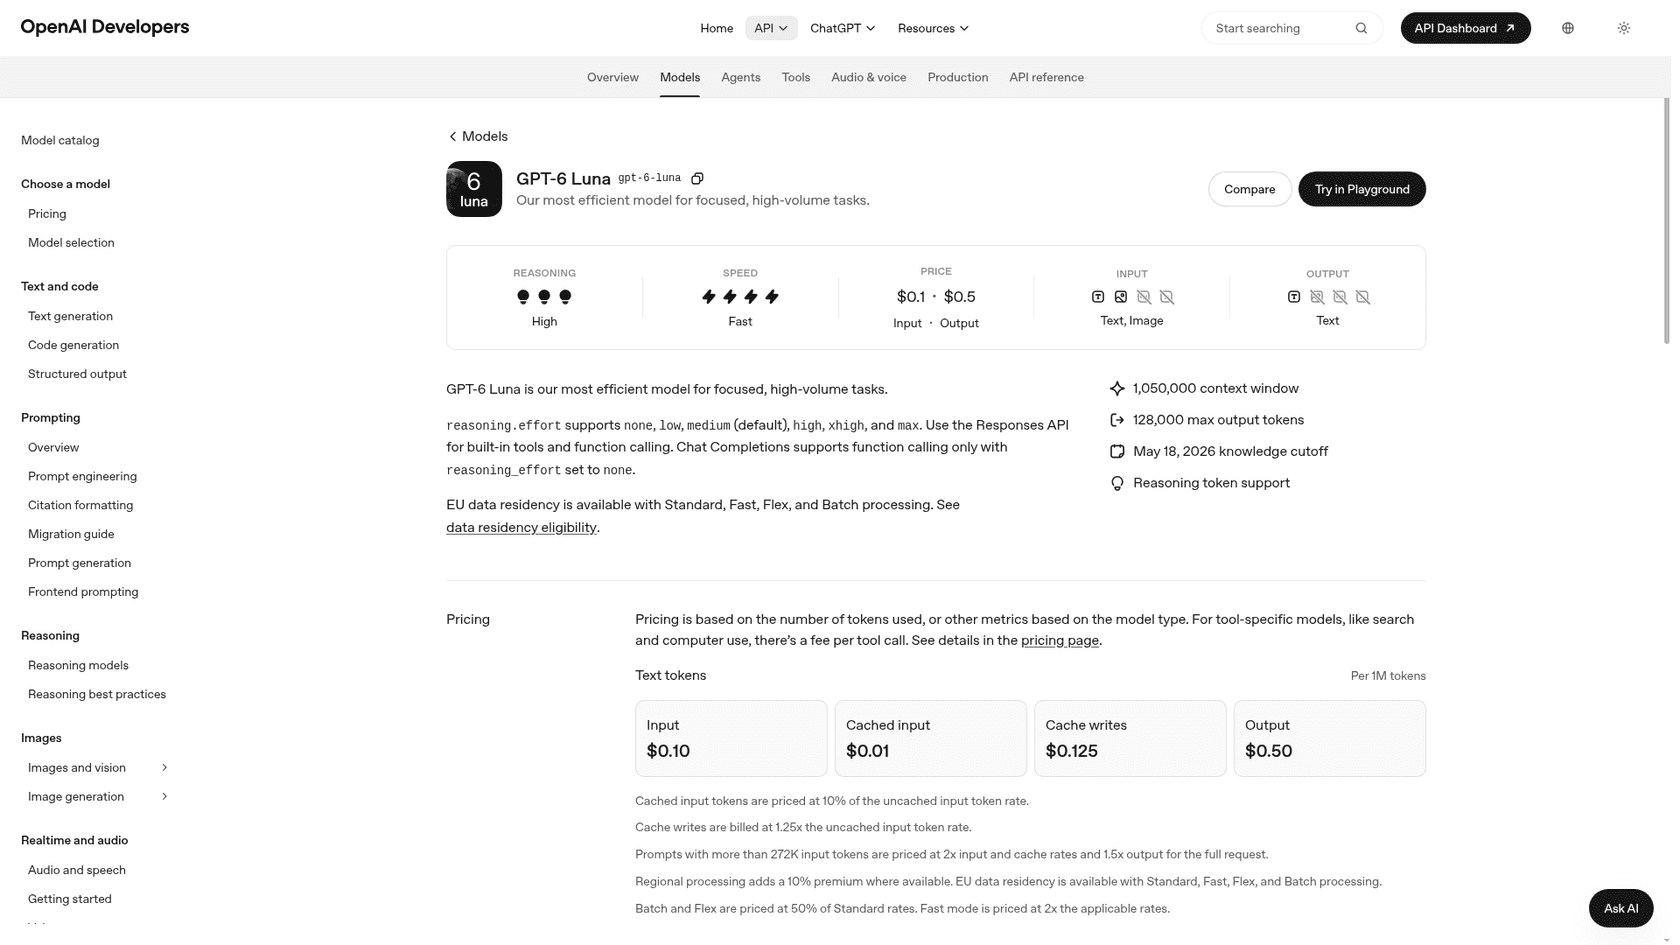
O GPT-6 Luna é o menor modelo da OpenAI, "our most efficient model for focused, high-volume tasks". É onde os usuários do Gemini 3.8 Flash olharam primeiro quando o Hydrogen chegou ao dobro do preço atual do Flash.
Prós
$0,10/$0,50por 1M de tokens, então a conta de exemplo é$350.$0,15por tarefa em esforço max na Artificial Analysis, o mais barato desta lista.- Suporta function calling do Chat Completions quando o esforço está em
none, o que facilita portar código de roteamento simples.
Contras
- Ele marca
28em max, bem abaixo do Hydrogen até mesmo em medium. - Mesma sobretaxa de prompt longo que os outros modelos da OpenAI acima de 272K tokens de entrada.
- Não é um modelo para trabalho de agente em várias etapas por conta própria.
Preços: $0,10 de entrada, $0,01 em cache, $0,50 de saída por 1M de tokens na página de preços da OpenAI.
Minha opinião: a porta de entrada de uma configuração roteada, não um substituto completo do Hydrogen. Deixe-o triar as solicitações e passar as difíceis para cima.
Qual alternativa ao Gemini 4 Hydrogen você deveria escolher?
Parta do motivo pelo qual você está saindo, não do ranking. Cada motivo aponta para um modelo diferente:
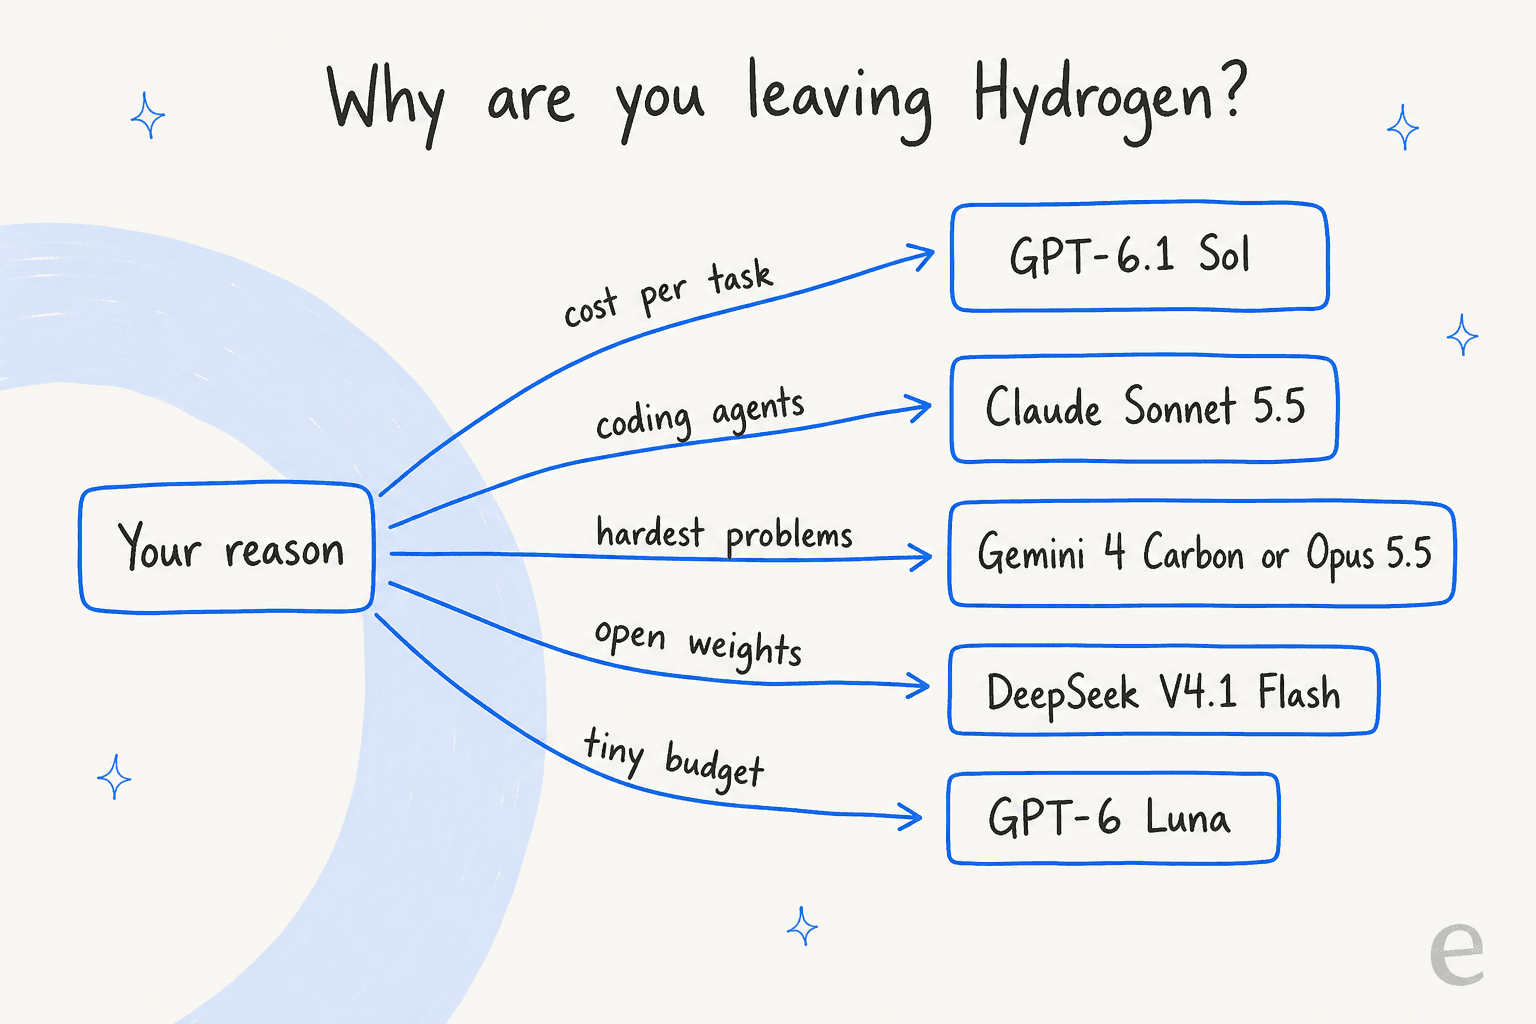
| Se o seu motivo é... | Escolha | Por quê |
|---|---|---|
| A conta em high ou xhigh | GPT-6.1 Sol | 52 por $0.76 contra o 51 do Hydrogen por $1.87 |
| Trabalho rápido e barato de nível médio | GPT-6.1 Terra | 42 por $0.26 contra o 41 do Hydrogen medium por $0.80 |
| Agentes de código ou de uso de computador | Claude Sonnet 5.5 | Vence Terminal-Bench 4.1 e OSWorld-2.1 na própria tabela do Google |
| Problemas mais difíceis, ficando no Google | Gemini 4 Carbon | 58 em medium, mesma API |
| Problemas mais difíceis, qualquer fornecedor | Claude Opus 5.5 | 59 em max, preço baixo de leitura em cache |
| Conta mais baixa | DeepSeek V4.1 Flash | $480 contra $5,250 na conta de exemplo |
| Pesos abertos no topo | Kimi K3.1 Pro | Melhor modelo de pesos abertos da sua categoria na AA |
| Triagem e roteamento | GPT-6 Luna | $0.15 por tarefa |
Você também não precisa escolher só um. Um comentarista no tópico de lançamento descreveu a configuração que eu recomendaria para a maioria dos agentes:
"I have found it a good subagent workhorse for code implementation, with some higher level model doing the spec and review."
Isso é o Hydrogen como executor e algo como o Carbon ou o Opus como planejador, a mesma divisão que o Google colocou no Orchestrator. Se a conta é o problema, troque o executor por Sol ou Terra e mantenha a estrutura.
Como testar uma alternativa antes de trocar?
Benchmarks classificam modelos nas tarefas de outra pessoa. Antes de mover o tráfego de produção, rode os seus próprios testes:
- Pegue de 50 a 100 requisições reais dos seus logs, incluindo as incômodas.
- Teste cada candidato em dois níveis de esforço, porque o nível move o custo mais do que o modelo.
- Meça o custo por tarefa bem-sucedida, contando as repetições, não o custo por milhão de tokens.
- Verifique as armadilhas de migração: o Hydrogen ignora ajustes de amostragem, o Claude rejeita um
temperaturefora do padrão, e a OpenAI quer a Responses API para uso de ferramentas. Um prompt ajustado para um não se transfere sem mudanças. - Mantenha um modelo de reserva conectado, para que a próxima mudança de preço ou queda seja uma troca de configuração, não uma reescrita.
O próprio conselho do Google para o Hydrogen diz o mesmo: rode suas avaliações "at all four levels" antes de se decidir por um.
Se o modelo é para uma fila de suporte
Muita gente que compara alternativas ao Hydrogen está, na real, construindo um bot de suporte. Eu passo anos conectando agentes de IA a helpdesks em produção, e o modelo raramente é o que quebra primeiro; as regras em volta dele são. As falhas que eu vejo são um bot que promete algo que não pode cumprir, ou que não transfere o caso quando deveria. Um modelo maior não resolve isso. Regras claras de escalonamento e respostas fundamentadas na sua própria central de ajuda e tickets anteriores, sim, e é assim também que você mantém as alucinações de IA baixas, qualquer que seja o modelo que escreva as palavras.
A SE Ranking é um bom exemplo dessa camada. Ela roda três produtos no Zendesk com um agente da eesel por produto, respondendo a partir de cerca de 16.800 páginas de conhecimento, e tratou 4.650 conversas em um mês. Reembolsos, extensões de teste e pedidos para falar com uma pessoa vão para a equipe com os detalhes já reunidos. A Swiftreg, uma vendedora de placas de carro privadas, responde cerca de 2.100 tickets do Zendesk por mês a partir de dados de pedidos em tempo real, seguindo regras escritas pela própria equipe. Nenhuma das duas configurações depende de qual modelo é o mais rápido nesta semana.
Se você prefere trabalhar a partir de um terminal, o CLI da eesel controla o mesmo colega que o painel. Um agente de código como o Claude Code pode enviar conhecimento aprovado, como artigos de ajuda exportados e respostas salvas, ajustar as instruções do agente, e fazer perguntas de teste para checar as respostas antes de qualquer coisa ir ao ar. Conectar o helpdesk em si ainda precisa de alguém com acesso de administrador para aprovar, e conhecimento enviado não é a mesma coisa que conhecimento testado, então a etapa de teste permanece.
Experimente a eesel
Hydrogen, Sol e Sonnet são motores. Se o que você está construindo é automação de suporte, a eesel é o colega de helpdesk com IA que faz o trabalho sobre modelos como esses. Ela se conecta ao helpdesk que você já usa, seja Zendesk, Freshdesk ou outro, aprende com seus tickets anteriores, macros e central de ajuda, e segue as regras de transferência que você define. Antes de responder a alguém, você pode rodá-la contra seus tickets reais anteriores e comparar as respostas dela com o que a sua equipe enviou.
O preço é um plano de créditos mensal fixo: um ticket ou chat é um crédito, a partir de $299 por mês para 500 créditos. Não há cobrança por token, então sua conta não muda quando o Google ou a OpenAI mudam as deles. Você pode experimentar a eesel de graça com 100 créditos por 7 dias em uma parte da sua fila.