

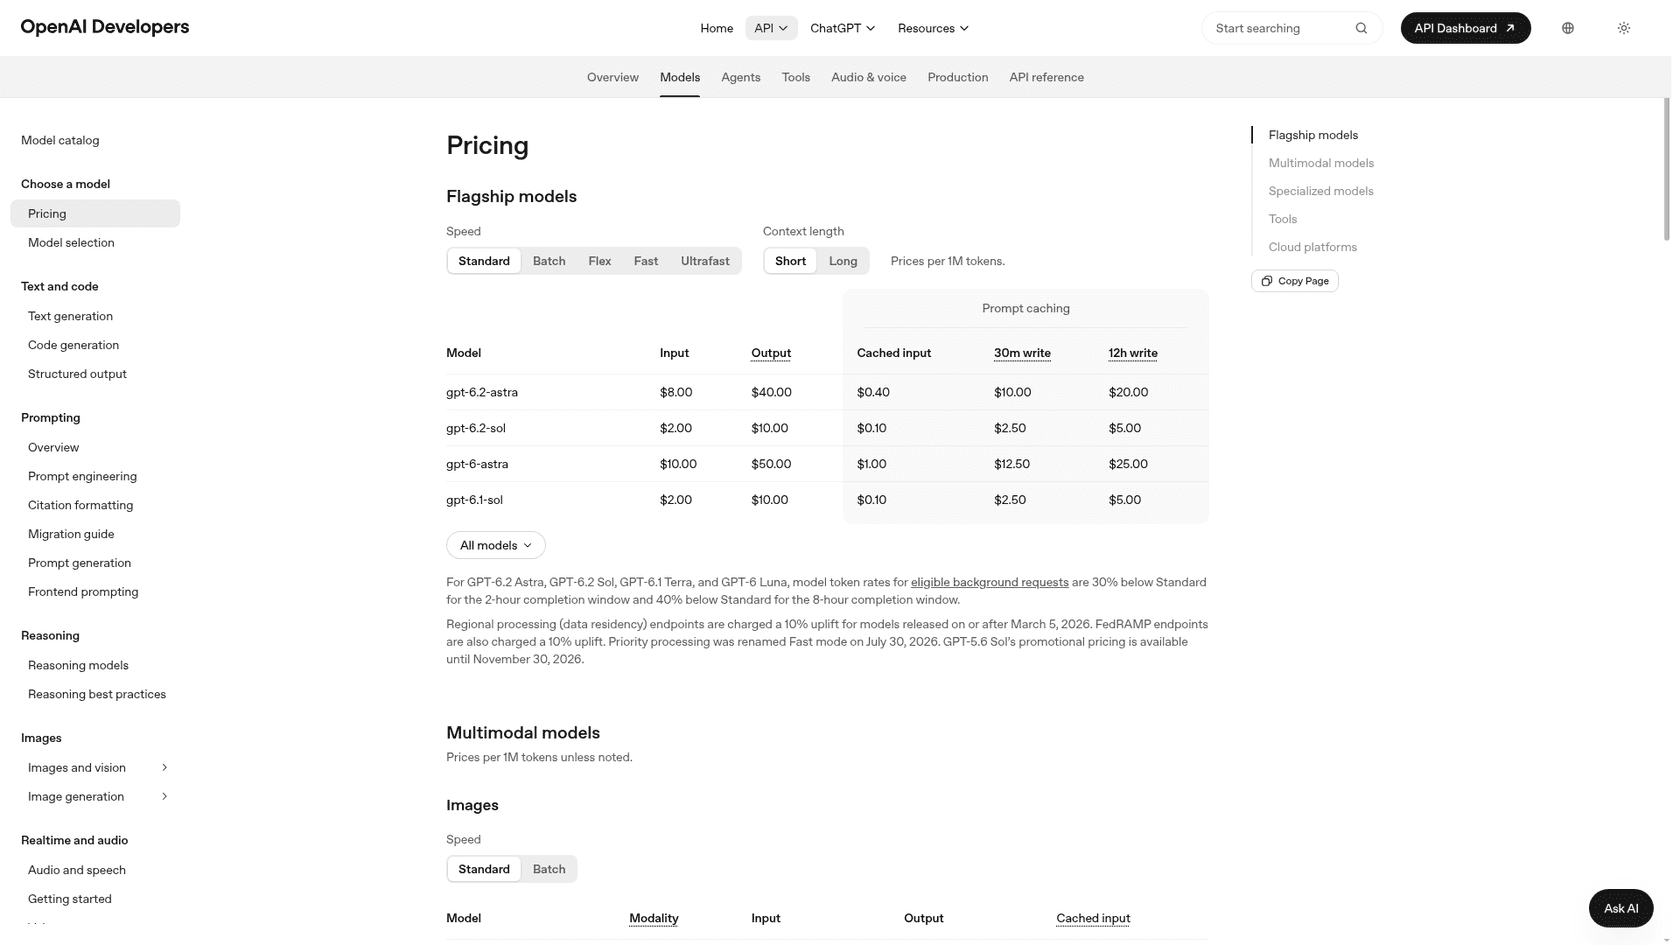
O GPT-6.2 Astra custa US$ 8 por milhão de tokens de entrada, US$ 0,40 em cache e US$ 40 de saída, 20% abaixo do preço de tabela do GPT-6 Astra. A mudança maior é a entrada em cache, que cai 60%. Em um agente de suporte que reaproveita um prompt de 12.500 tokens, isso o torna cerca de 35% mais barato por ticket (US$ 21,80 contra US$ 33,50 por 1.000), mas só se o cache realmente acertar: uma falha custa mais de 5 vezes mais.
Fique de olho em três medidores: prompts com mais de 272.000 tokens, o modo Fast, e o Ultrafast, que passa de 3x para 6x o Standard em 1º de março de 2027. Para a maior parte do trabalho de suporte, o GPT-6.2 Sol faz o mesmo trabalho por um quarto do preço.
Quanto custa o GPT-6.2 Astra?
O GPT-6.2 Astra custa US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de tokens de saída no nível Standard, com a entrada em cache a US$ 0,40. A OpenAI o lançou em 17 de novembro de 2026 junto com o GPT-6.2 Sol, o sucessor do GPT-6.1 Sol. O post de lançamento descreve o preço como "um desconto de 20% em tokens de entrada e saída, e um desconto mais profundo de 60% em tokens de entrada em cache" em relação ao GPT-6 Astra.
Eu construo integrações e a conexão com APIs na eesel, e coloco agentes de IA em filas de suporte em produção há vários anos, então a primeira coisa que faço com o preço de um modelo novo é converter em custo por ticket. O preço de tabela por milhão de tokens quase não diz nada até você saber em qual medidor cada token cai. Aqui está cada medidor da página de preços da OpenAI e da página do modelo GPT-6.2 Astra, por milhão de tokens:
| Nível | Entrada | Entrada em cache | Escrita de cache 30 min | Escrita de cache 12 h | Saída |
|---|---|---|---|---|---|
| Standard | US$ 8,00 | US$ 0,40 | US$ 10,00 | US$ 20,00 | US$ 40,00 |
| Standard, mais de 272.000 na entrada | US$ 16,00 | US$ 0,80 | n/a | n/a | US$ 60,00 |
| Batch | US$ 4,00 | US$ 0,20 | US$ 5,00 | US$ 10,00 | US$ 20,00 |
| Fast | US$ 16,00 | US$ 0,80 | US$ 20,00 | US$ 40,00 | US$ 80,00 |
| Ultrafast (até 28 fev 2027) | US$ 24,00 | US$ 1,20 | US$ 30,00 | US$ 60,00 | US$ 120,00 |
| Ultrafast (a partir de 1º mar 2027) | US$ 48,00 | US$ 2,40 | US$ 60,00 | US$ 120,00 | US$ 240,00 |
| Flex | Não oferecido |
A linha de contexto longo vem da página do modelo, que diz que além de 272.000 tokens de entrada "as taxas de entrada e cache dobram e a saída custa 1,5 vez a taxa de contexto curto para a solicitação inteira". Ela não lista preços de escrita de cache em contexto longo, então deixei esses campos em branco em vez de adivinhar.
O modelo em si tem uma janela de contexto de 1.050.000 tokens, 922.000 tokens de entrada no máximo, e 128.000 tokens de saída no máximo. Outra linha na página do modelo afeta o custo: a API rejeita solicitações que definem o esforço de raciocínio como none, então você não pode desligar o raciocínio para economizar tokens de saída como algumas equipes faziam em modelos antigos. Os tokens de raciocínio são cobrados como saída, segundo o guia de raciocínio da OpenAI.
Pelo que você é cobrado exatamente?
Você é cobrado por token em quatro medidores separados, e eles custam valores muito diferentes. Cada solicitação se divide em:
- Tokens de entrada a US$ 8 por milhão: qualquer coisa nova no prompt, como a mensagem do cliente.
- Entrada em cache a US$ 0,40 por milhão: o início do prompt que coincide exatamente com uma solicitação recente, como suas instruções e o texto do centro de ajuda.
- Escritas de cache a US$ 10 (30 minutos) ou US$ 20 (12 horas) por milhão: a primeira vez que um prefixo reutilizável é salvo.
- Tokens de saída a US$ 40 por milhão: a resposta, mais qualquer raciocínio que o modelo faça antes.
O guia de cache de prompts da OpenAI deixa claro que uma escrita de cache "não é uma taxa adicional". Cada token de entrada é cobrado uma única vez, na taxa sem cache, em cache, ou de escrita. O prefixo mínimo que pode ir para cache é de 1.024 tokens no GPT-5.6 e modelos seguintes.
A diferença entre esses medidores é toda a história. Um token em cache custa um vigésimo de um token de entrada novo e um centésimo de um token de saída. Então o formato do seu prompt importa mais que o preço de tabela do título.
O quanto mais barato ele é na prática que o GPT-6 Astra?
Em qualquer carga de trabalho que reaproveita um prompt longo, o GPT-6.2 Astra é cerca de 35% mais barato que o GPT-6 Astra, não 20%. A economia extra vem do corte na entrada em cache.
Para verificar, calculei o preço de uma chamada típica de agente de suporte. Cada ticket envia um prefixo de 12.500 tokens (instruções mais o conteúdo do centro de ajuda, do mesmo tamanho do teste de cache que fiz no dia do lançamento), 600 tokens de entrada nova, e 300 tokens de saída incluindo raciocínio. Supondo que o prefixo acerte o cache:
| Modelo | Entrada em cache | Entrada | Saída | Por ticket | Por 1.000 tickets |
|---|---|---|---|---|---|
| GPT-6 Astra | US$ 1,00 | US$ 10 | US$ 50 | US$ 0,0335 | US$ 33,50 |
| GPT-6.2 Astra | US$ 0,40 | US$ 8 | US$ 40 | US$ 0,0218 | US$ 21,80 |
| GPT-6.2 Sol | US$ 0,10 | US$ 2 | US$ 10 | US$ 0,0055 | US$ 5,45 |
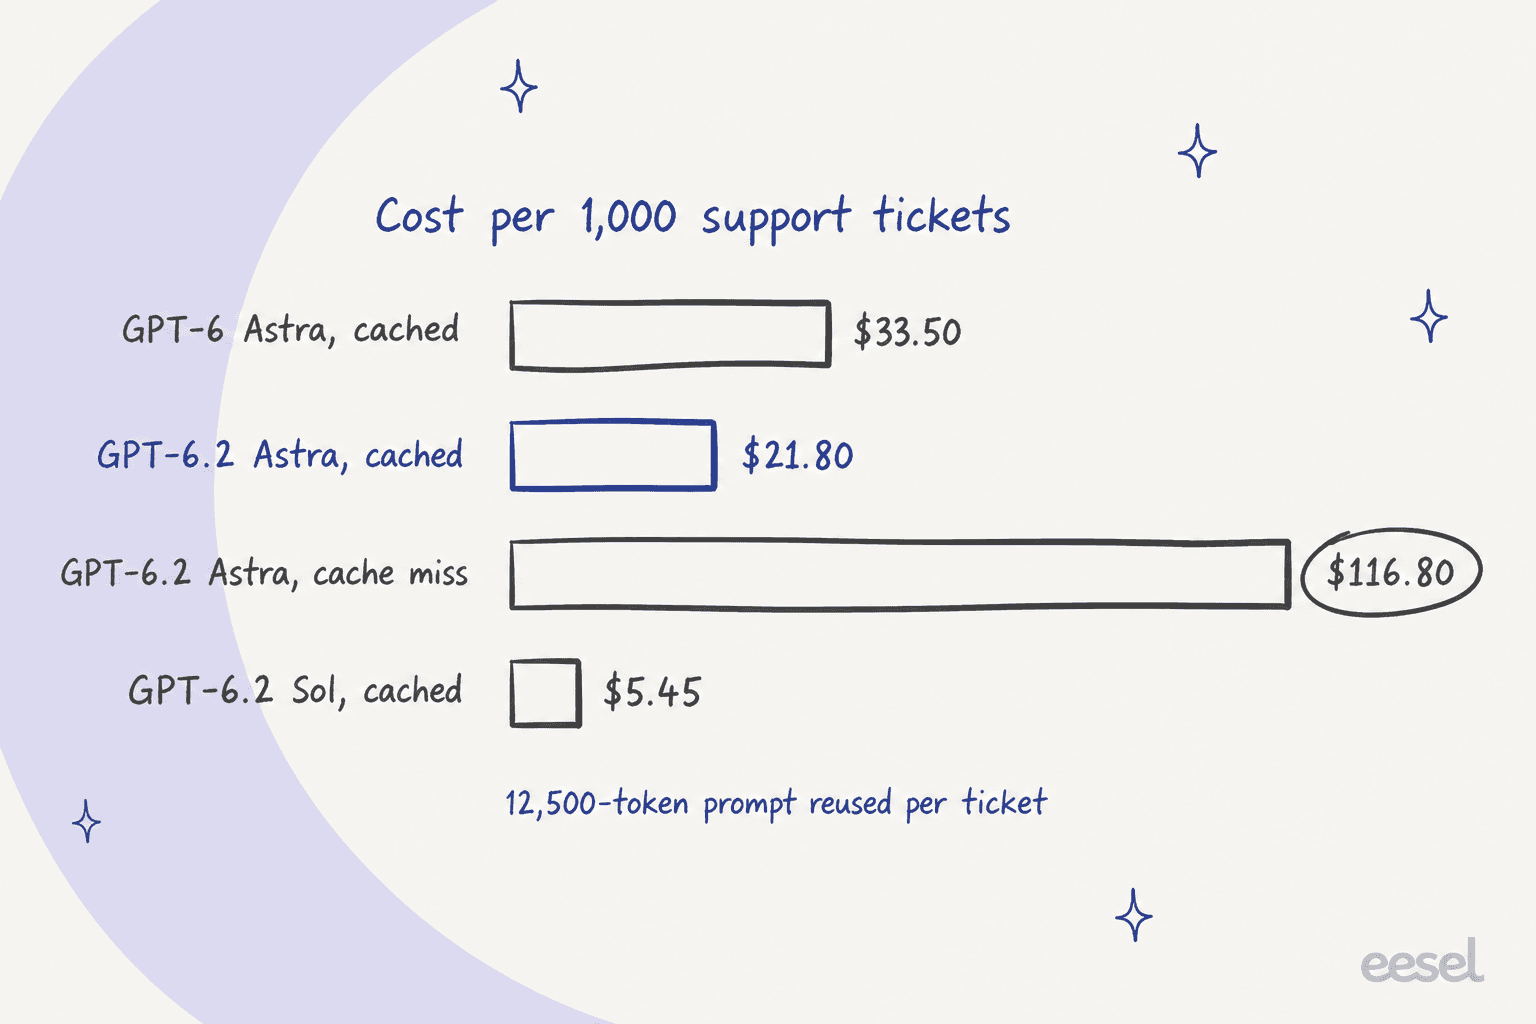
Duas coisas se destacam. A primeira é que o prompt reaproveitado domina a conta. No meu teste do dia de lançamento do GPT-6.2 Astra, com um prompt minúsculo de 278 tokens e sem centro de ajuda, 1.000 tickets custaram US$ 5,79 em esforço médio. Adicione o conhecimento que um agente realmente precisa, e o preço sobe cerca de 4 vezes, mesmo com o cache funcionando.
A segunda é a barra da falha de cache. Se esse mesmo prefixo é cobrado como entrada nova em cada ticket, o GPT-6.2 Astra custa US$ 116,80 por 1.000 tickets, mais de 5 vezes o preço em cache e mais que o GPT-6 Astra com um cache funcionando. Um cache perdido apaga todo o desconto da atualização, e mais ainda.
A Artificial Analysis vê a mesma direção no nível de benchmark: seu Intelligence Index completo custa US$ 4,00 por tarefa no GPT-6.2 Astra contra US$ 6,24 no GPT-6 Astra, uma queda de 36%. Isso vem de tokens mais baratos mais menos tokens, já que a OpenAI diz que o modelo usa menos tokens de saída em tarefas exigentes.
Quanto custa de fato uma falha de cache?
Uma falha de cache custa cerca de 5 vezes mais por ticket no GPT-6.2 Astra, e é mais fácil de provocar do que parece. No meu teste do dia de lançamento, coloquei um centro de ajuda de 12.500 tokens no campo instructions de nível superior da API Responses. Três chamadas seguidas mostraram zero tokens em cache e zero escritas de cache. Mover o mesmo texto para uma mensagem developer resolveu: a primeira chamada escreveu 12.513 tokens no cache, e as duas seguintes leram 12.501 tokens cada.
O guia de cache da OpenAI explica parte do motivo. "As instructions de nível superior não podem conter um ponto de interrupção explícito", diz, e instruções developer reutilizáveis vão "em um bloco input_text dentro de uma mensagem developer". O post de lançamento também recomenda, para os dois modelos 6.2, "manter os prefixos de prompt inalterados e anexar novas instruções" no final. Se sua integração reescreve o prompt do sistema a cada turno para injetar dados do cliente, você está pagando a taxa cheia de entrada em cada token disso.
As escritas de cache têm sua própria matemática. Uma escrita de 30 minutos de um prefixo de 12.500 tokens custa US$ 0,125, contra US$ 0,10 para enviá-lo uma vez sem cache. Então a escrita perde dinheiro se ninguém reaproveitar o prefixo, e se paga a partir do segundo acerto. Nas taxas do GPT-6.2 Astra, uma escrita e nove leituras custam 1,70 vez o preço de entrada normal, contra 10 vezes sem cache nenhum.
A escrita de 12 horas custa o dobro (US$ 0,25 para esse prefixo). Vale a pena para uma fila tranquila: se os tickets chegam com mais de 30 minutos de intervalo durante a noite, um cache de 30 minutos fica expirando, e você paga para escrevê-lo de novo a cada vez. Uma fila movimentada não precisa dele, porque cada leitura renova a janela de 30 minutos. Você pode observar as taxas de acerto no painel de cache de prompts da OpenAI antes de decidir.
Quais níveis e multiplicadores mudam a conta?
Oito multiplicadores se somam à taxa Standard, e dois são grandes o suficiente para importar mais que a escolha do modelo. Aqui estão eles em uma única escada:
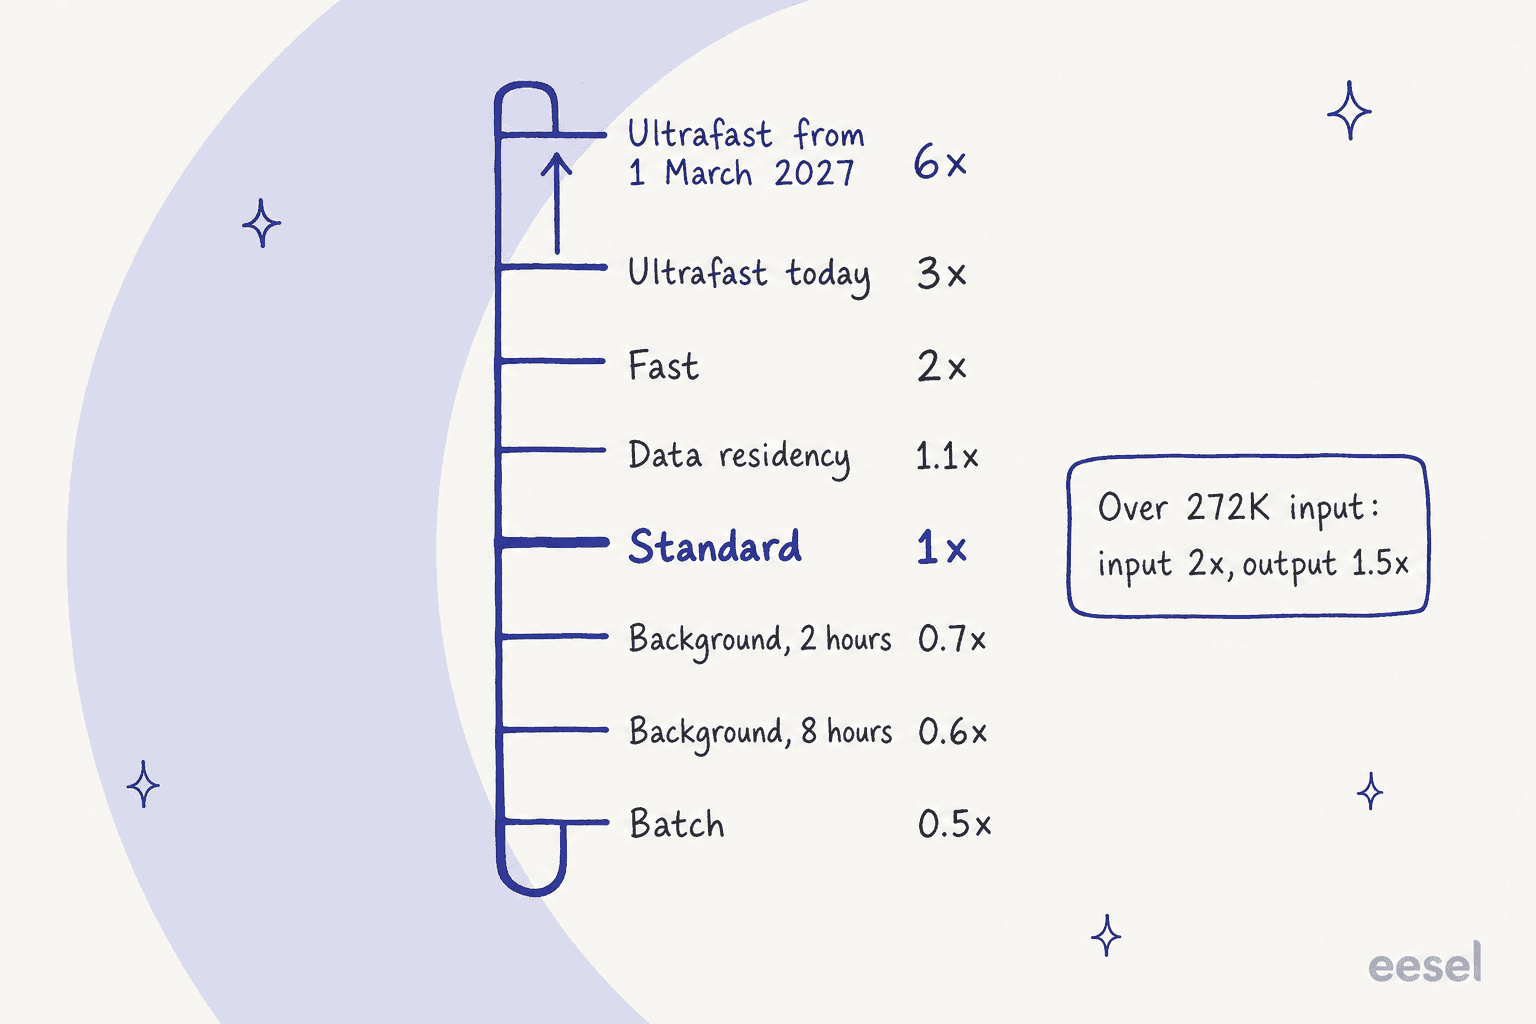
- Batch (0,5x). A API Batch reduz cada taxa à metade, incluindo a entrada em cache e as escritas. Serve para trabalhos noturnos como marcar os tickets do mês passado ou reescrever artigos de ajuda, não para respostas em tempo real.
- Solicitações em segundo plano (0,6x a 0,7x). Segundo a página de preços, solicitações em segundo plano elegíveis na API Responses rodam "30% abaixo do Standard na janela de 2 horas e 40% abaixo do Standard na janela de 8 horas". Está em beta público.
- Residência de dados (1,1x). Endpoints de processamento regional carregam "um acréscimo de 10% para modelos lançados em ou após 5 de março de 2026", o que inclui o GPT-6.2 Astra. Endpoints FedRAMP carregam o mesmo acréscimo de 10%.
- Fast (2x). O modo Fast, que a OpenAI renomeou de Priority Processing em 30 de julho de 2026, dobra cada taxa.
- Ultrafast (3x, depois 6x). O Ultrafast custa 3 vezes o Standard até 28 de fevereiro de 2027 e 6 vezes o Standard a partir de 1º de março de 2027. Se você construir agora uma função sensível à latência sobre ele, sua conta dobra nessa data sem nenhuma mudança de código.
- Contexto longo (2x entrada, 1,5x saída). Ao passar de 272.000 tokens de entrada, a solicitação inteira muda para a taxa mais alta, não só os tokens acima do limite.
O único nível que você talvez espere e não vai encontrar é o Flex. A página de preços lista o Flex para o GPT-6 Astra, GPT-6.1 Sol, GPT-6.1 Terra e GPT-6 Luna, mas não para o GPT-6.2 Astra. Batch e solicitações em segundo plano são, por enquanto, as rotas de desconto.
A regra de contexto longo é a mais traiçoeira. Uma única revisão de contrato de 400.000 tokens com uma resposta de 4.000 tokens custa US$ 6,64 no GPT-6.2 Astra. Os mesmos tokens nas taxas de contexto curto custariam US$ 3,36. Se você conseguir dividir um documento em pedaços com menos de 272.000, você reduz a conta de entrada à metade.
Quanto custaria o GPT-6.2 Astra para o seu volume?
Insira abaixo seu próprio volume de tickets e o formato do seu prompt. Ele calcula a mesma carga de trabalho no GPT-6.2 Astra, GPT-6 Astra e GPT-6.2 Sol, usando as taxas da página de preços da OpenAI. Falhas de cache são cobradas como escritas de cache de 30 minutos, que é o que acontece com o cache implícito quando o prefixo ainda não está salvo.
Arraste a taxa de acerto de cache de 95% para 0%, e a conta do GPT-6.2 Astra em 8.000 tickets salta de US$ 222,40 para US$ 1.134,40 por mês, cerca de 5 vezes mais. Esse único ajuste muda a conta mais do que a atualização do modelo.
Quanto custa em tamanhos diferentes de equipe?
Aqui está a mesma carga de trabalho de suporte em três volumes mensais, nas taxas Standard com uma taxa de acerto de cache de 95%. Falhas são cobradas como escritas de cache de 30 minutos:
| Tickets por mês | GPT-6.2 Astra | GPT-6.2 Astra, Batch | GPT-6 Astra | GPT-6.2 Sol |
|---|---|---|---|---|
| 1.000 | US$ 27,80 | US$ 13,90 | US$ 40,69 | US$ 6,95 |
| 8.000 | US$ 222,40 | US$ 111,20 | US$ 325,50 | US$ 55,60 |
| 50.000 | US$ 1.390,00 | US$ 695,00 | US$ 2.034,38 | US$ 347,50 |
Para dar uma ideia de escala, o cliente da eesel SamCart opera um agente nos tickets do Freshdesk e outro no chat do site, respondendo a partir de cerca de 280 artigos do centro de ajuda, em um plano que cobre 8.000 interações por mês. Essa linha do meio corresponde mais ou menos a esse volume. Só em tokens, a conta do modelo é de algumas centenas de dólares por mês, antes mesmo de alguém ter escrito a recuperação, as chamadas de função para buscas de pedidos, as regras de escalonamento, ou a observabilidade para ver o que ele disse.
Essa é a forma honesta do custo do atendimento com IA: os tokens são a linha pequena, e a camada de recuperação é parte da grande. A engenharia e a manutenção em torno das duas são o item grande, por isso o custo de um agente IA depende muito mais de construir versus comprar do que de qual modelo você escolhe.
O GPT-6.2 Astra é mais barato que o Claude Fable 5.2?
Token por token, não: eles têm o mesmo preço de tabela, e o cache do Fable é mais barato. Por tarefa concluída, o GPT-6.2 Astra é muito mais barato. A página de preços da Anthropic lista o Claude Fable 5.2 a US$ 8 de entrada e US$ 40 de saída por milhão de tokens, exatamente igual ao Astra, com acertos de cache a US$ 0,20.
| Por milhão de tokens | GPT-6.2 Astra | Claude Fable 5.2 | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|---|
| Entrada | US$ 8,00 | US$ 8,00 | US$ 4,00 | US$ 2,00 |
| Saída | US$ 40,00 | US$ 40,00 | US$ 20,00 | US$ 10,00 |
| Leitura de cache | US$ 0,40 | US$ 0,20 | US$ 0,20 | US$ 0,10 |
| Escrita de cache mais barata | US$ 10,00 (30 min) | US$ 10,00 (5 min) | US$ 5,00 (5 min) | US$ 2,50 (30 min) |
| Prompts longos | 2x entrada, 1,5x saída acima de 272.000 | Mesma taxa até 1M | Mesma taxa até 1M | 2x entrada, 1,5x saída acima de 272.000 |
| AA Intelligence Index | 62 | 65 | 59 | 57 |
Na minha carga de trabalho de suporte com um prefixo em cache, o Fable 5.2 sai um pouco mais barato (US$ 19,30 contra US$ 21,80 por 1.000 tickets) por causa dessa leitura de cache de US$ 0,20. E para uma única solicitação de 400K tokens, o Fable custa US$ 3,36 onde o Astra custa US$ 6,64, porque a Anthropic cobra "a mesma taxa por token" em toda a sua janela de contexto de 1M.
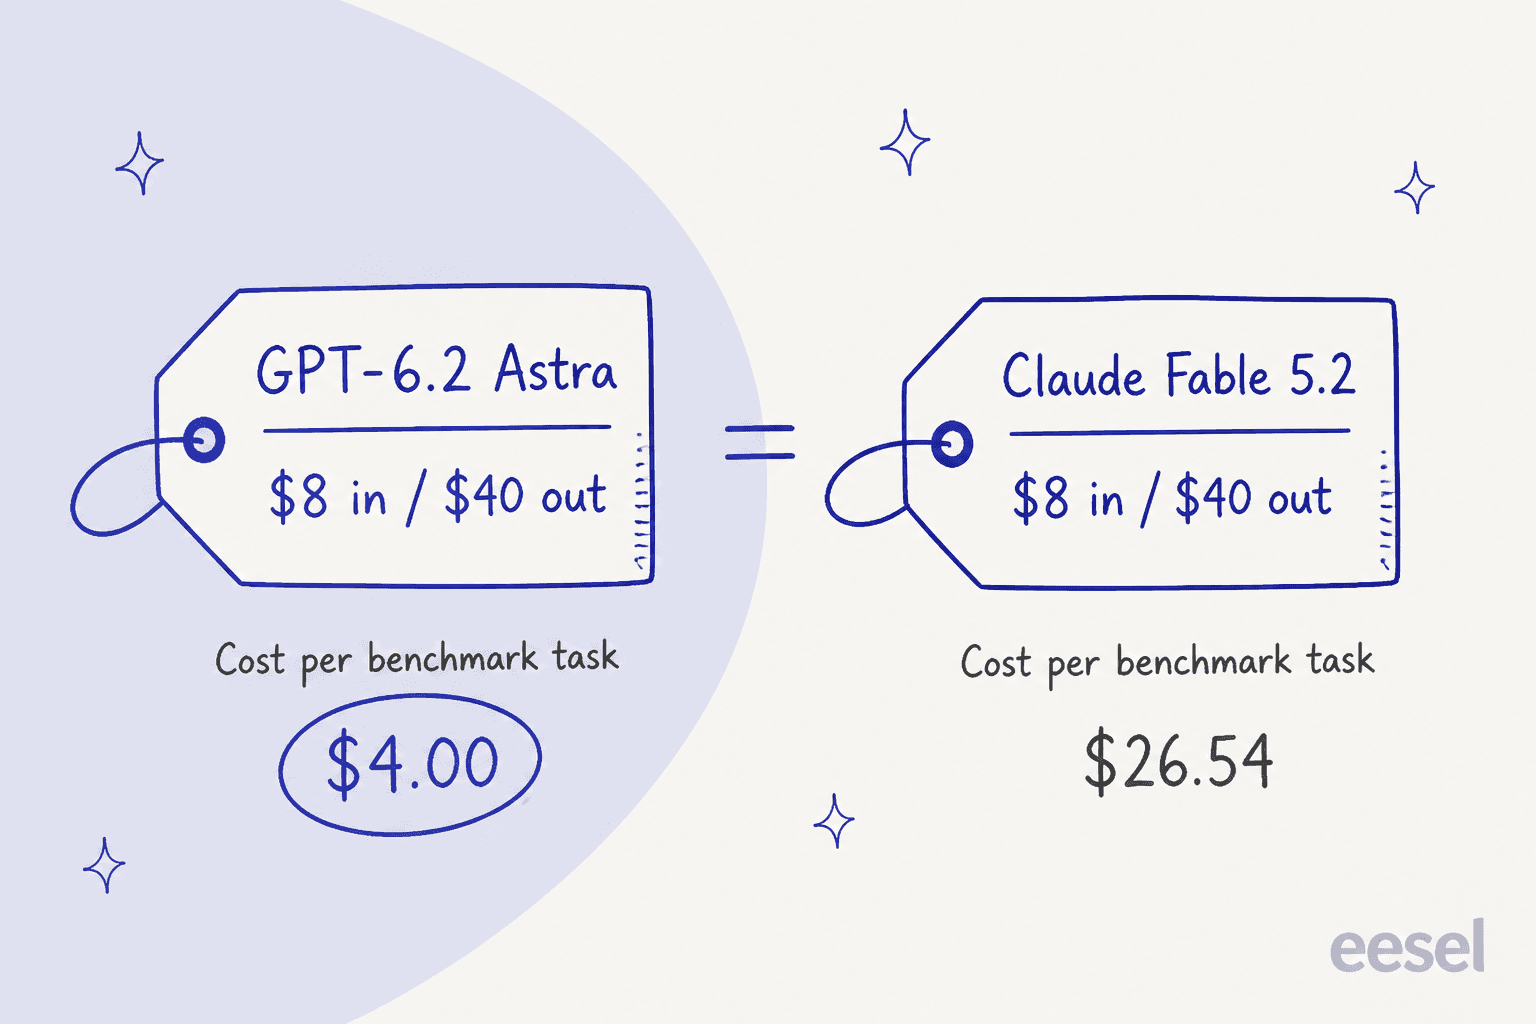
A visão por tarefa inverte tudo. A Artificial Analysis calcula o custo de rodar seu Intelligence Index em US$ 4,00 por tarefa para o GPT-6.2 Astra contra US$ 26,54 para o Claude Fable 5.2, porque o Astra usa muito menos tokens para chegar a uma resposta. O Fable ainda pontua mais alto, 65 contra 62 do Astra. Em tarefas longas de agente em que o modelo escreve e raciocina muito, a contagem de tokens importa mais que a taxa. Em chamadas curtas e ricas em cache como respostas de suporte, a taxa importa mais.
Então a comparação certa depende da sua carga de trabalho. Para respostas curtas com um prompt grande reaproveitado, compare as taxas de cache. Para trabalho longo e aberto, compare o custo por tarefa. O Claude Opus 5.5 fica no meio, pela metade do preço por token do Astra e com uma pontuação mais baixa. O resumo alternativas ao GPT-6 Astra cobre o resto do campo.
Quanto custa o GPT-6.2 Astra no ChatGPT?
No ChatGPT você paga uma assinatura fixa, não por token. A OpenAI diz que o GPT-6.2 Astra e o Sol são "disponíveis para todos os usuários Plus, Pro, Enterprise e Edu no ChatGPT Work e Codex", com acesso Enterprise e Edu depois que um admin do workspace o ativa.
| Plano | Preço | Acesso ao GPT-6.2 Astra |
|---|---|---|
| Free | US$ 0 | Não listado no post de lançamento |
| Go | US$ 8/mês | Não listado no post de lançamento |
| Plus | US$ 20/mês | Sim, no ChatGPT Work e Codex |
| Pro | A partir de US$ 100/mês (Pro 100, Pro 200, Pro 500) | Sim; o Pro 500 também ganha o Ultrafast com ele |
| Enterprise e Edu | Contatar vendas | Sim, depois que um admin o ativa |
Os preços vêm da página de preços do ChatGPT. Os níveis Pro também incluem créditos de API mensais: US$ 100 com o Pro 100, US$ 200 com o Pro 200, ou US$ 500 com o Pro 500. Na minha taxa de suporte em cache de US$ 21,80 por 1.000 tickets, US$ 500 de créditos cobrem cerca de 22.900 tickets de GPT-6.2 Astra por mês, desde que você cumpra os termos de elegibilidade da OpenAI para os créditos. O detalhamento completo dos planos está no guia preços do ChatGPT.
O GPT-6.2 Astra vale o preço para o suporte ao cliente?
Para a maioria das filas de suporte, o GPT-6.2 Astra é mais modelo do que o trabalho precisa. No meu teste do dia de lançamento, o GPT-6.2 Sol e o GPT-6.2 Astra trataram corretamente os 15 tickets de teste, incluindo cálculos de reembolso, uma injeção de prompt, e uma busca de pedido que falhou, e o Sol custou cerca de um quarto do preço. As ferramentas de avaliações de agentes da OpenAI podem rodar o mesmo tipo de verificação nos seus próprios tickets. O Astra justifica seu preço em trabalho longo e com várias etapas, como modelos financeiros, pesquisa jurídica, e construção de planilhas, que é onde a OpenAI o posiciona.
Também há uma razão além do custo para manter o Astra longe de respostas a clientes sem supervisão. A Artificial Analysis descobriu que sua taxa de alucinação em fatos desconhecidos subiu de 50% para 59% em esforço máximo em comparação com o GPT-6 Astra. Isso torna a camada de embasamento e prevenção de alucinações mais importante que a escolha do modelo, qualquer que seja ele.
A questão de orçamento maior é se você quer uma conta de tokens para começo de conversa. O preço dos tokens se move com cada mudança de prompt, cada falha de cache, e cada atualização de preços como a mudança do Ultrafast em março. Um líder de engenharia em uma empresa de hardware cripto com uma base de conhecimento de mais de 300 artigos resumiu a escolha assim ao escolher a eesel:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Essa é a troca entre construir ou comprar em uma frase. Se você construir sobre o GPT-6.2 Astra, orce os tokens e a manutenção. Se você comprar, orce um número mensal fixo e use seu tempo para testar o agente em tickets reais, em vez disso.
Experimente a eesel
Se você está vendo o preço do GPT-6.2 Astra porque quer IA na sua fila de suporte, a eesel te dá isso sem uma conta de tokens para vigiar. O colega de IA do helpdesk se conecta ao helpdesk que você já usa, como o Zendesk ou o Freshdesk, aprende com seus tickets passados e seu centro de ajuda, e roda em um plano mensal fixo. Antes de responder a um cliente real, você pode rodá-lo contra seus tickets históricos e ler cada resposta.

Desenvolvedores podem conduzir a mesma configuração pela CLI da eesel: um agente de código com IA como o Claude Code ou o Codex pode subir conhecimento aprovado, como artigos de ajuda e macros exportados, fazer perguntas de teste ao agente, e verificar as respostas antes que qualquer coisa vá ao ar. Conectar o próprio helpdesk ainda precisa de alguém com acesso de admin para aprovar.
Você pode experimentar a eesel gratis em uma parte da sua fila, ver planos e preços, ou compará-la com usar o ChatGPT diretamente se você ainda está decidindo se constrói você mesmo.