

O Gemini 4 Neon é o modelo da Google que eu usaria para trabalho agêntico difícil e documentos longos, executado em high: a Artificial Analysis dá-lhe 59,6 por $3,74 por tarefa, cerca de metade dos $7,76 do Carbon para a mesma pontuação. Não é o caminho mais barato para essa pontuação. O Astra da OpenAI chega a 60,1 por $2,07, e o Neon escreve cinco a seis vezes mais tokens por tarefa. A sua verdadeira vantagem é a honestidade: errou em 14% das perguntas que não conseguiu responder, contra 54% a 61% do Sol e do Astra.
A CLI da eesel permite que um agente de código carregue artigos de ajuda aprovados para um colega de equipa de helpdesk da eesel e teste as suas respostas nos seus próprios tickets, que é como eu verificaria qualquer modelo antes de ele responder a um cliente.
Como testei o Gemini 4 Neon
Ainda não passei o Neon pela minha própria suite de testes, por isso cada número abaixo vem de três fontes que consegui verificar no dia de lançamento, 19 de novembro de 2026:
- As próprias páginas da Google: o post de lançamento, a ficha do modelo e a página de preços.
- Artificial Analysis: li os resultados por definição para o Neon, Carbon, Hydrogen, Sol, Astra e Opus 5.5 nas respetivas páginas de modelo. O seu índice é uma suite de 9 avaliações, por isso uma "tarefa" abaixo significa uma tarefa de benchmark, não um dos seus tickets.
- O tópico de lançamento no Hacker News, que passou os 460 pontos no dia em que abriu.
Tentei usar o Reddit e o X para a voz dos utilizadores e nenhum dos dois carregou, por isso as citações da comunidade são todas do Hacker News. Se a sua própria carga de trabalho for diferente de um benchmark, trate o meu veredicto como uma pré-seleção, não como um resultado. O guia explicativo do Neon cobre o ID do modelo, o acesso e a migração, por isso mantenho isso breve aqui.
O que é o Gemini 4 Neon, num parágrafo?
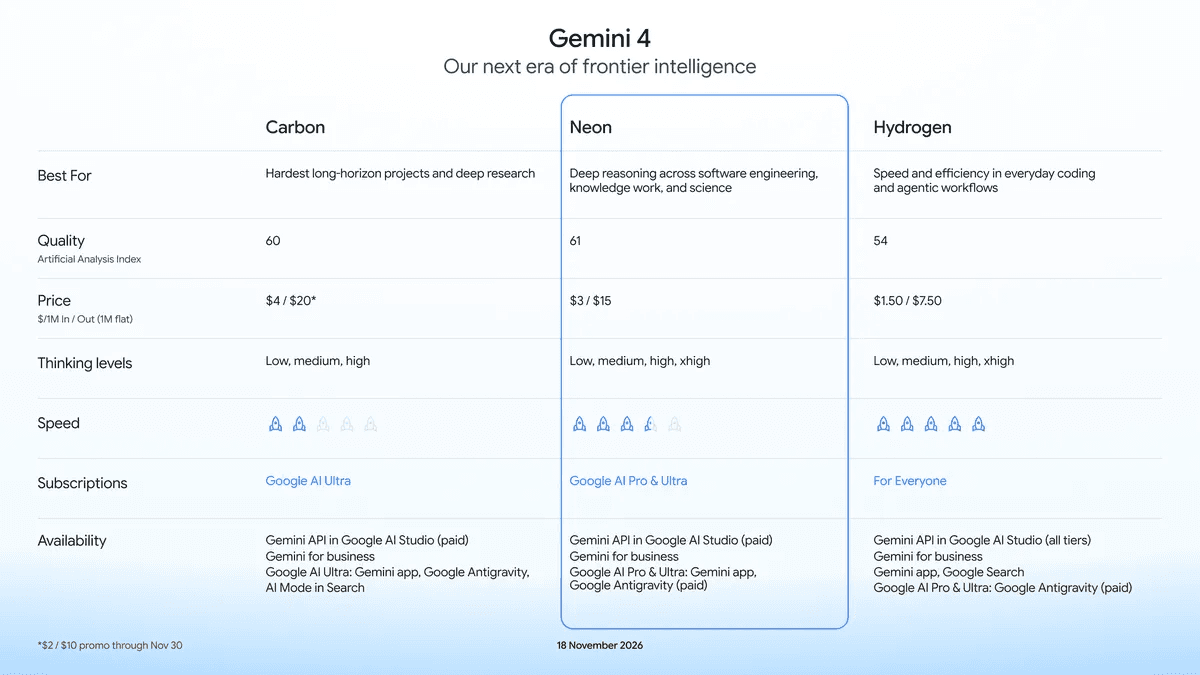
O Neon é o modelo intermédio da família Gemini 4 da Google, lançado em 18 de novembro de 2026 como gemini-4-neon. A Google diz que é adaptado do Carbon, partilha a sua janela de 1.048.576 tokens, e tem quatro níveis de raciocínio: low, medium, high (a predefinição) e xhigh. Custa $3 por milhão de tokens de entrada e $15 por milhão de tokens de saída, sem nível gratuito. A Google chama-lhe o equilíbrio entre "profundidade e eficiência", e o seu próprio gráfico coloca-o entre o Hydrogen e o Carbon:
O Gemini 4 Neon é bom nas tarefas difíceis?
Sim, e a evidência é mais forte do que a maioria das afirmações do dia de lançamento, porque a tabela de classificação e a própria tabela da Google concordam. A Artificial Analysis coloca o Neon em 61,4 em xhigh e 59,6 em high, na frente do Opus 5.5 com 59,1 e do Sol com 57,3 (as suas melhores definições). A tabela reportada pelo próprio fornecedor mostra de onde vem essa vantagem:
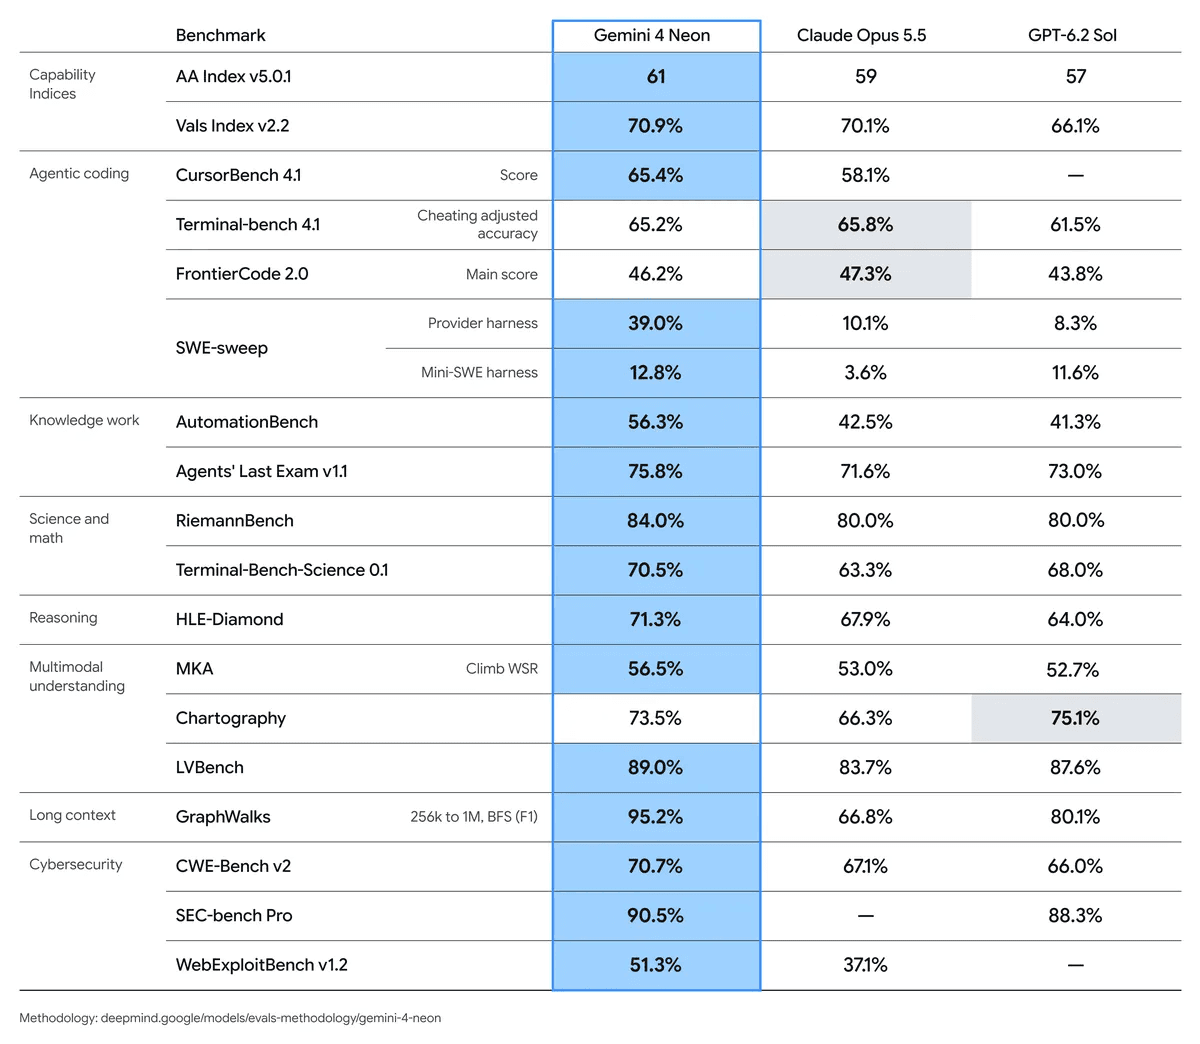
Lendo as colunas em vez das células em negrito:
- Agentes de trabalho de conhecimento: AutomationBench
56.3%contra42.5%do Opus 5.5 e41.3%do Sol. - Contexto longo: GraphWalks de 256k a 1M tokens,
95.2%contra66.8%e80.1%. Se o seu trabalho é "ler um documento muito longo e responder com precisão", esta é a linha que importa. - Codificação, mista: o Opus 5.5 está ligeiramente na frente no Terminal-Bench 4.1 (
65.8%contra65.2%) e no FrontierCode 2.0 (47.3%contra46.2%). A vantagem do Neon no SWE-sweep de39.0%usa o próprio arnês de testes do Antigravity, por isso não confiaria nela.
Estes são números da Google, escolhidos pela Google. Os independentes são as linhas da Artificial Analysis abaixo, e contam uma história mais interessante do que a pontuação em destaque.
Quanto custa o Neon por tarefa em cada definição?
O preço por token esconde a maior parte da conta, porque os tokens de raciocínio são cobrados como saída. Aqui estão os dados da Artificial Analysis por definição para o Neon ao lado dos seus irmãos, tal como os li em 19 de novembro:
| Definição | Pontuação de índice | Custo por tarefa | Minutos por tarefa | Tokens de saída por tarefa |
|---|---|---|---|---|
| Neon low | 44,1 | $0,75 | 3,7 | 21.726 |
| Neon medium | 54,9 | $1,90 | 8,3 | 50.000 |
| Neon high (predefinição) | 59,6 | $3,74 | 14,8 | 90.188 |
| Neon xhigh | 61,4 | $6,44 | 21,5 | 141.631 |
| Carbon high | 60,0 | $7,76 | 37,2 | 122.768 |
| Hydrogen xhigh | 53,9 | $3,16 | 15,2 | 154.406 |
| Opus 5.5 max | 59,1 | $10,04 | 24,5 | 173.313 |
| Astra high | 60,1 | $2,07 | 5,9 | 17.828 |
| Sol max | 57,3 | $1,01 | 8,5 | 40.360 |
Três coisas destacam-se:
- O Neon vence o Carbon no seu próprio terreno. Em high, iguala a pontuação do Carbon com metade de um ponto de diferença, por 52% menos custo e 60% menos tempo. A Google afirma 32% menos custo por tarefa face ao Carbon, por isso, segundo estes dados, a diferença real é maior do que o discurso de vendas.
- High é o ponto ideal. Passar de medium para high compra 4,7 pontos de índice por $1,84 mais. Passar de high para xhigh compra 1,8 pontos por $2,70 mais e 6,7 minutos adicionais.
- O Astra é o problema. Com a mesma pontuação, o Astra custa $2,07 por tarefa e termina em 5,9 minutos. O preço por token do Astra é mais alto ($8 de entrada, $40 de saída), mas ainda assim é cerca de 45% mais barato por tarefa porque escreve 17.828 tokens onde o Neon escreve 90.188.
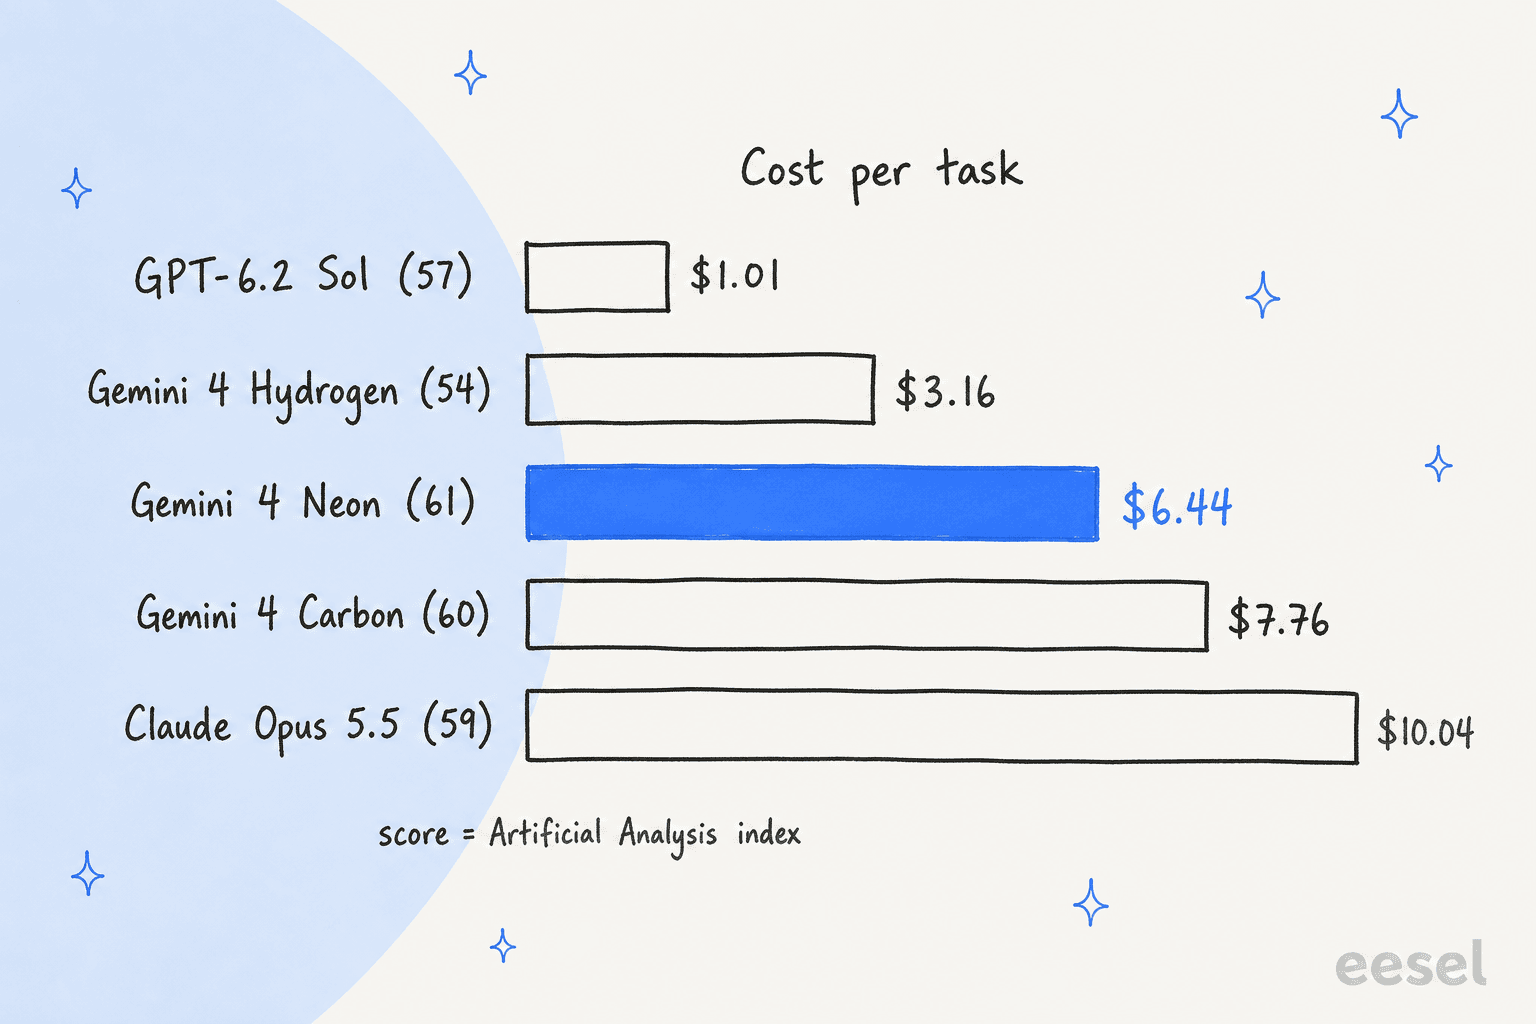
O gráfico usa a melhor definição de cada modelo, que é a forma justa de comparar "o máximo que este modelo consegue fazer" e a forma injusta de comparar "quanto devo pagar". Para a segunda pergunta, use a tabela.
O Gemini 4 Neon alucina menos do que o Sol e o Opus?
Esta é a descoberta que mudou a minha visão do modelo. No teste AA-Omniscience da Artificial Analysis, que avalia a frequência com que um modelo dá uma resposta errada em vez de recusar quando não sabe, a família Gemini 4 está bem distante do resto:
| Modelo e definição | Taxa de alucinação (quanto menor, melhor) | Perguntas respondidas corretamente |
|---|---|---|
| Gemini 4 Argon high | 4% | 48% |
| Gemini 4 Carbon medium | 4% | 49% |
| Gemini 4 Hydrogen xhigh | 8% | 50% |
| Gemini 4 Carbon high | 11% | 58% |
| Gemini 4 Neon high | 14% | 59% |
| Gemini 4 Neon xhigh | 14% | 60% |
| Claude Opus 5.5 max | 50% | 66% |
| GPT-6.2 Sol max | 55% | 62% |
| GPT-6.2 Astra high | 58% | 66% |
| Claude Fable 5.2 high | 58% | 77% |
O Neon diz "não sei" com muito mais frequência do que o Opus, o Sol ou o Astra, e paga por isso em precisão bruta: 59% a 60% de acerto contra 66% do Astra e 77% do Fable 5.2. Entre os modelos da própria Google, também está mais disposto a arriscar do que o Carbon medium, o Argon ou o Hydrogen.
Se essa troca é boa depende do trabalho. Para um agente de investigação que tem sempre de produzir uma resposta, as recusas extra são fricção. Para um agente que lida com clientes e que deve transferir quando não tem certeza, um modelo que recusa está mais próximo do que se quer, e é o comportamento que procuro primeiro. Uma ressalva que quero deixar bem clara: o AA-Omniscience é um teste de conhecimento geral. Não mede como um modelo se comporta com o seu centro de ajuda, por isso teste nos seus próprios tickets antes de acreditar.
Onde o Gemini 4 Neon fica atrás?
Encontrei seis limites reais, por ordem do quanto me incomodariam:
- É verboso. Em xhigh escreveu 283 milhões de tokens de saída em todo o índice, contra 60,9 milhões do Sol. Os tokens de saída são os de $15, por isso a sua conta acompanha os hábitos do modelo, não apenas a tabela de preços.
- A definição mais alta é lenta. A Artificial Analysis mediu 56,5 segundos até ao primeiro token de resposta em xhigh e 110 tokens por segundo depois disso. O Carbon precisa de 73 segundos e 55 tokens por segundo, por isso o Neon é mais rápido do que o Carbon, mas não é um modelo de chat em direto acima de
medium. - O Astra e o Sol são mais baratos por tarefa. Por token, o Neon é mais barato do que o Astra. Por tarefa, não, como mostra a tabela. O Sol max obtém 57,3 por $1,01, que é 6,4 vezes mais barato do que o Neon xhigh.
- É menos preciso quando deveria responder. Veja a tabela de alucinação: a troca é prudência por correção.
- O acesso tem condições. Não há nenhum nível de API gratuito, e a FAQ do Antigravity, tal como citada por um leitor do Hacker News, proíbe ferramentas de terceiros de usar o acesso por subscrição. Chamaram a isso um fator decisivo:
"I'd like to keep my Gmail account, so Google can keep their model and will not get my business."

Outro leitor apontou a solução alternativa, que são simples chaves de API:
"You can't use subsidized tokens in 3rd party apps. Although they just suspend your Gemini account now, not your google account."
- O relatório de segurança está pendente. A ficha do modelo da Google diz que o relatório completo chega nos próximos dias, por isso eu reteria qualquer carga de trabalho regulada até ele chegar.
Que modelo supera o Neon para o seu trabalho?
Eis a decisão como eu a tomaria hoje:
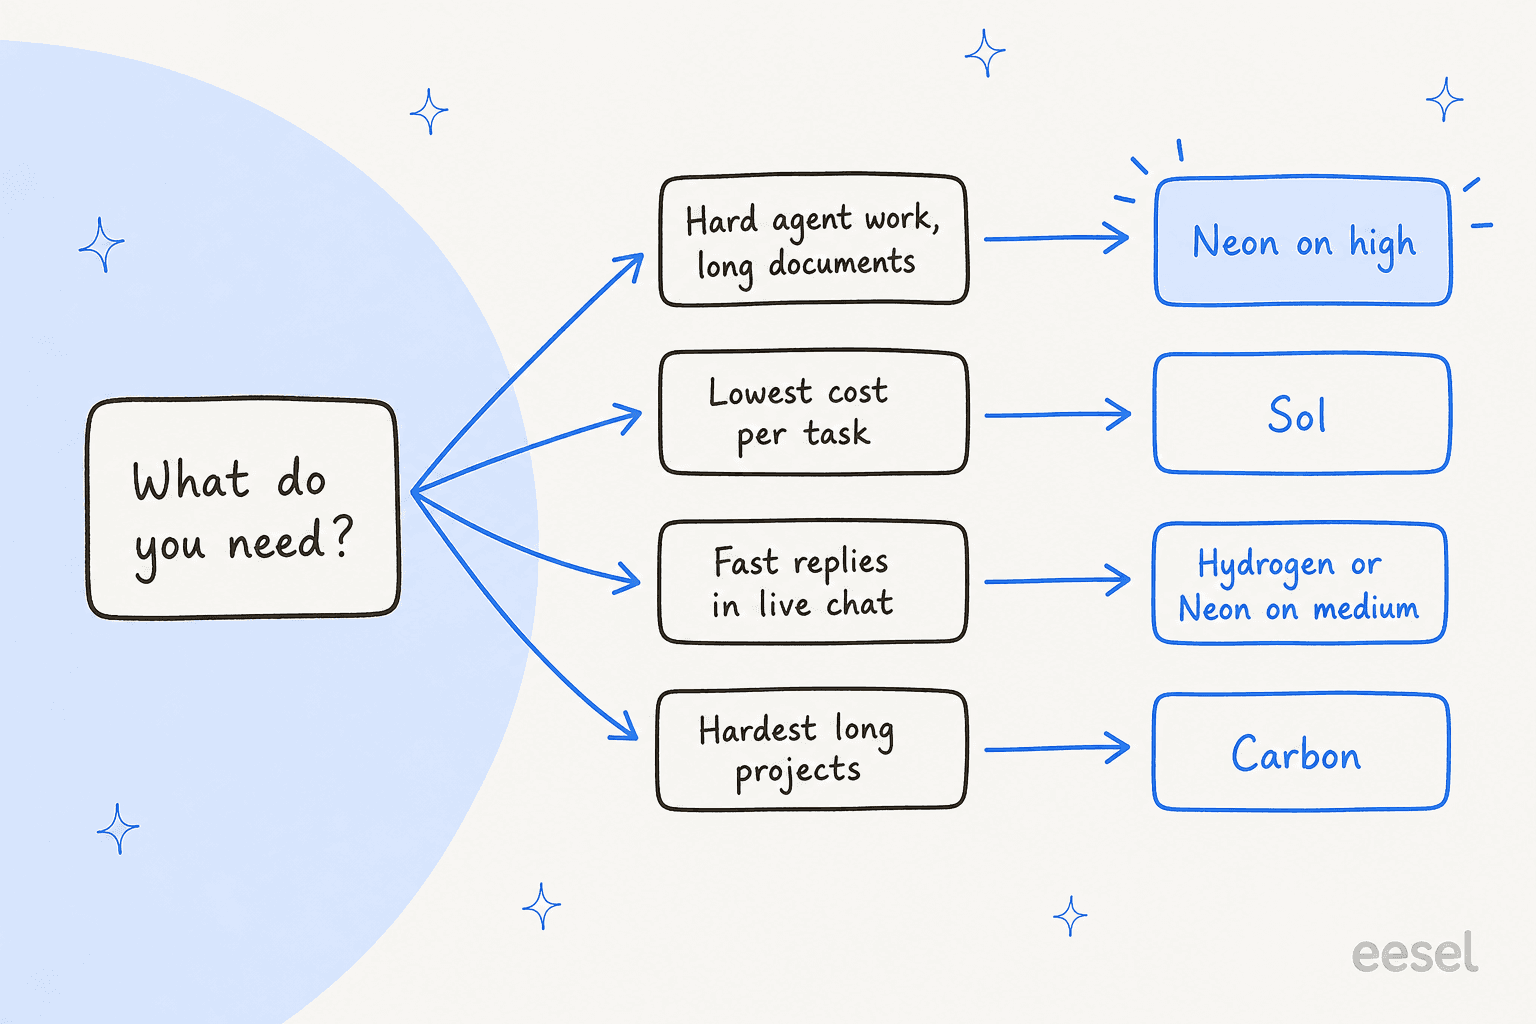
A bifurcação esconde a parte interessante, que é o facto de o custo e a alucinação puxarem em direções opostas. Por isso, aqui estão os dados numa única ferramenta. Defina a pontuação de índice mais baixa que aceita e a taxa de alucinação mais alta que tolera, e ela lista todas as definições da Artificial Analysis que recolhi e que superam ambas as barreiras, a mais barata primeiro:
Experimente os extremos. Peça uma pontuação de 55 sem limite de alucinação e o Sol xhigh ganha no preço a $0,65. Coloque um teto perto de 20% com a mesma pontuação e o Neon high é a resposta mais barata a $3,74, com o Carbon medium como a opção mais prudente a 4%. Baixe a pontuação para 54 e o Neon medium assume a liderança a $1,90. A família Gemini 4 é o único lugar onde se consegue uma pontuação alta e uma taxa de erro baixa juntas, e esse é o argumento honesto a favor do Neon.
Como o Neon se compara com o Carbon, o Hydrogen, o Astra, o Sol e o Opus?
| Modelo | Preço por 1M entrada/saída | Melhor pontuação de definição | Custo por tarefa (melhor) | Taxa de alucinação | A minha opinião numa linha |
|---|---|---|---|---|---|
| Gemini 4 Neon | $3 / $15 | 61,4 | $6,44 | 14% | O melhor Gemini para trabalho difícil; execute-o em high |
| Gemini 4 Carbon | $4 / $20 após a promoção | 60,0 | $7,76 | 11% | O Neon substitui-o para a maior parte do trabalho |
| Gemini 4 Hydrogen | $1,50 / $7,50 | 53,9 | $3,16 | 8% | A predefinição para tarefas pequenas |
| GPT-6.2 Astra | $8 / $40 | 62,1 | $4,00 | 59% | Pontuação mais alta, menos tokens, adivinha mais |
| GPT-6.2 Sol | $2 / $10 | 57,3 | $1,01 | 55% | De longe o mais barato por tarefa |
| Claude Opus 5.5 | $4 / $20 | 59,1 | $10,04 | 50% | O Neon iguala-o por cerca de um terço do custo |
O preço de tabela do Carbon é $4/$20 a partir de 1 de dezembro e $2/$10 até 30 de novembro, o que o torna mais barato por token do que o Neon apenas por mais alguns dias. Isso não altera as contas por tarefa, porque o Carbon raciocina durante muito mais tempo.
O que diz o público sobre o Gemini 4 Neon?
O tópico de lançamento no Hacker News passou os 460 pontos. A resposta mais útil comparou o Neon com os seus rivais no Vals e depois colocou o preço em contexto:
"Latency is by far the best for the level of quality. It's about 2x more expensive than Sol 6.2, but significantly better and faster. You get what you pay for."
A diferença por token face ao Sol é de 1,5 vezes, não de 2, e por tarefa de benchmark situa-se entre 1,9 e 6,4 vezes dependendo da definição, por isso "you get what you pay for" é válido na qualidade mas é mais caro do que parece. Outro leitor leu o mesmo preço como uma perda:
"That looks to me like OpenAI equals or beats everything Google offers at half the price."
Segundo os números da Artificial Analysis, isso está perto de ser correto no custo por tarefa e errado na alucinação, razão pela qual separo as duas coisas nesta análise. Um terceiro comentador, que testa trabalhos agênticos longos, estava menos interessado na pontuação:
"Argon and Carbon both made such discoveries such as "it would seem that i need to be pointing at an enemy to shoot them". Its almost entertaining to read, its like its discovering the world on first principles."
Esse utilizador estava a iniciar a mesma tarefa no Neon quando publicou, por isso ainda não há veredicto. E um leitor resumiu o que muitos querem da Google:
"Hydrogen has already became my default for 80% of small tasks. If Neon is as fast but smarter that would honestly be very cool"
Segundo os dados, o Neon é mais inteligente do que o Hydrogen por 8,8 pontos em high, mas custa o dobro por tarefa ($3,74 contra $1,87). Estes são comentadores isolados, não uma sondagem, e não consegui aceder ao Reddit nem ao X para obter mais opiniões.
Quem deveria usar o Gemini 4 Neon?
| Você é... | A minha opinião |
|---|---|
| Alguém que usa o Carbon ou o Argon para codificação ou análises difíceis | Mude para o Neon em high e compare. Mesma pontuação, cerca de metade do custo e do tempo. |
| Alguém que paga pelo Opus 5.5 em max | Teste o Neon high. A pontuação é equivalente e a conta é cerca de um terço. |
| Alguém que constrói um agente planeador e um agente executor | O Neon planeia, o Hydrogen executa. |
| Alguém que lê documentos muito longos | O Neon, de acordo com a linha GraphWalks da Google e os resultados de trabalho de conhecimento da AA. |
| Alguém que otimiza o custo por tarefa acima de tudo | Salte o Neon. Use o Sol ou o Astra. |
| Alguém que constrói uma resposta de chat em direto | O Neon no máximo em medium, ou o Hydrogen. |
| Alguém que precisa de um nível gratuito | O Hydrogen. O Neon não tem nenhum. |
| Alguém no Gemini 3.8 Flash para tarefas simples | Fique onde está. O Neon é exagerado e mais verboso. |
Se está a escolher entre famílias, a minha comparação ChatGPT contra Gemini e o resumo das alternativas ao Gemini vão mais longe. A minha leitura mais ampla sobre este nível está no artigo sobre frontier AI.
O que esta análise significa para as equipas de suporte?
Um agente de suporte é um lugar onde o resultado "recusar em vez de adivinhar" importa mais do que a pontuação em destaque. Uma resposta errada dada com confiança a uma questão de reembolso custa mais do que uma transferência para uma pessoa. Mas o modelo é apenas uma parte. O que o agente sabe, quando deve transferir, e se alguém o testou antes do lançamento decidem como ele se comporta.
Esse é o padrão de como a smava, uma empresa alemã de comparação de empréstimos, executa a eesel num único Zendesk. Entre 8 de agosto e 8 de setembro de 2026, três agentes da eesel trataram cerca de 27.000 tickets: um categorizou cerca de 14.600 deles, um redigiu cerca de 15.300 respostas a partir de 820 macros e artigos de ajuda, e agentes por marca prepararam respostas prontas para o cliente. Cada agente tem uma tarefa e uma lista de coisas que nunca deve fazer, e as pessoas aprovam cada rascunho antes de ser enviado. A SamCart divide da mesma forma: um agente para o e-mail do Freshdesk, outro para o chat do site, cada um com o seu próprio tom.
A escolha do modelo é uma definição dentro desse desenho, não o desenho em si. Se quiser comparar modelos na sua fila, simule o agente em tickets passados e observe a taxa de transferência, não apenas a precisão. O meu guia sobre qual é o melhor LLM cobre as verificações que eu faria, e o custo do atendimento ao cliente com IA mostra quanto custa uma fila no total.
Se a sua equipa constrói num terminal, a CLI da eesel permite que um agente de código faça as partes repetíveis: carregar artigos de ajuda e macros exportados, ajustar as instruções do agente e fazer perguntas de teste antes de entrar em produção. Ligar o próprio helpdesk continua a precisar da aprovação de um administrador. Veja as CLI de codificação agêntica e o guia de um servidor MCP de agente de IA para saber como essas ferramentas funcionam com modelos como o Neon.
O meu veredicto sobre o Gemini 4 Neon
Use-o se já fosse pagar pelo Carbon ou pelo Opus 5.5, execute-o em high, e meça o custo por tarefa, não por token. Salte-o se o custo por tarefa for a sua única restrição, porque o Sol e o Astra são mais baratos, ou se precisar de um nível gratuito. A sua melhor característica não é a pontuação de 61,4. É o facto de um modelo tão capaz adivinhar mal tão raramente, o que vale a pena testar antes de decidir.
Experimentar a eesel
Se está a escolher um modelo porque quer melhores respostas na sua fila, o colega de equipa de helpdesk de IA da eesel dá-lhe isso sem ter de decidir sobre um modelo. Aprende com os seus tickets passados e o seu centro de ajuda, transfere para uma pessoa quando a resposta não está na sua documentação, e você pode testá-lo no histórico real de tickets antes de ele responder a alguém. Funciona dentro do Zendesk e do Freshdesk, e é a primeira coisa que eu experimentaria para implementar IA no suporte ao cliente.
O preço é um plano de créditos mensal fixo, com um plano gratuito de 100 créditos e sem cartão, por isso uma alteração de preço de um modelo não muda a sua conta. Experimente a eesel numa parte da sua fila.