

Gemini 4 Neon custa $3.00 por 1M de tokens de entrada e $15.00 por 1M de tokens de saída, sem camada gratuita, e os tokens de pensamento são cobrados como saída. O preço de etiqueta esconde a conta real: na Artificial Analysis uma tarefa custa $0.75 em low, $1.90 em medium, $3.74 no high padrão e $6.44 em xhigh. Batch e Flex reduzem a tarifa à metade, Priority soma 80%, e um acerto de cache reduz a entrada para $0.15. O preço de lançamento do Carbon de $2/$10 termina em 30 de novembro, então o argumento para o Neon em vez do Carbon começa em 1º de dezembro.
A CLI da eesel permite que um agente de código envie artigos de ajuda aprovados para um colega de helpdesk da eesel e teste suas respostas em tickets passados, que é como eu verificaria o custo e o comportamento de qualquer modelo antes de ele responder a um cliente.
Como precifiquei o Gemini 4 Neon
Tudo com um sinal de dólar vem da página de preços do Google, que li em 19 de novembro de 2026, o dia depois do lançamento, incluindo as abas Batch, Flex e Priority. As regras de cache vêm da documentação de cache do Google, e as definições de camada da sua página de inferência Flex. O custo por tarefa vem da Artificial Analysis, onde uma "tarefa" é uma tarefa de referência do seu índice, não um dos seus tickets ou pull requests.
Eu não rodei o Neon na minha própria carga de trabalho. Os exemplos mensais abaixo usam contagens de tokens que escolhi e marquei como suposições, então coloque as suas na calculadora. O primeiro panorama do Neon está aqui, e a análise do dia de lançamento tem o lado da qualidade. Este post é só sobre dinheiro.
Quanto custa o Gemini 4 Neon por milhão de tokens?
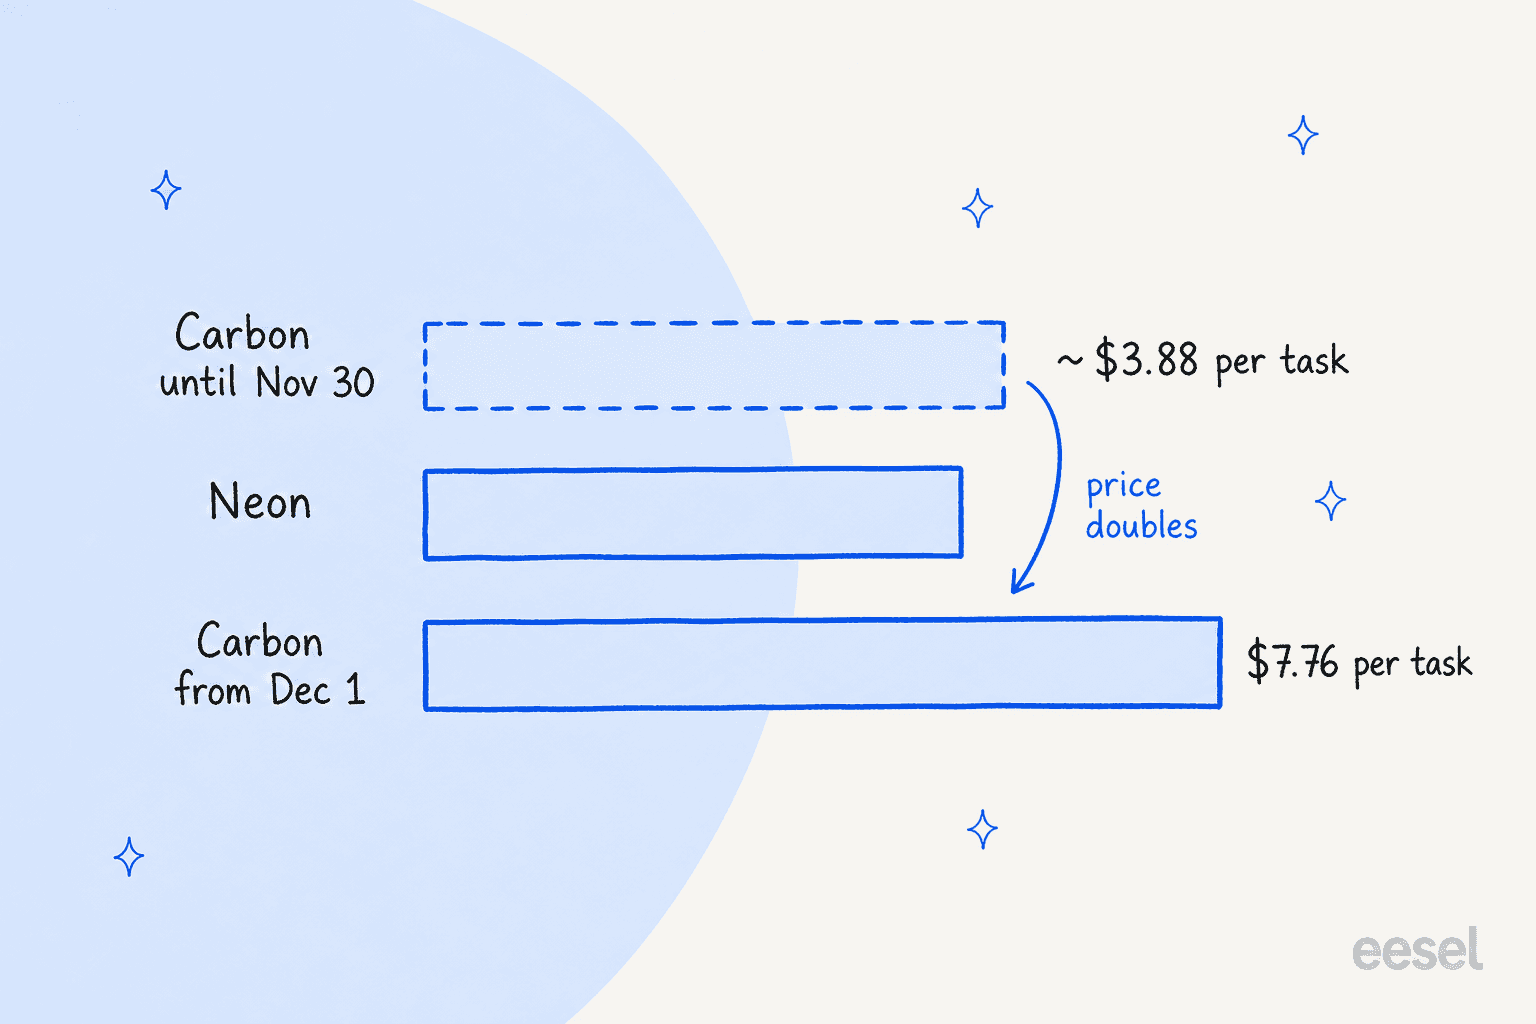
O Neon é cobrado por milhão de tokens em quatro camadas de serviço. A página do Google lista um único preço para toda a janela de contexto de 1,048,576 tokens, sem tarifa mais alta para prompts longos.
| Camada | Entrada | Saída (pensamento incl.) | Entrada em cache | Velocidade e confiabilidade |
|---|---|---|---|---|
| Batch | $1.50 | $7.50 | $0.075 | Assíncrono, até 24 horas |
| Flex (preview) | $1.50 | $7.50 | $0.075 | Síncrono, meta de 1 a 15 minutos, melhor esforço |
| Standard | $3.00 | $15.00 | $0.15 | Segundos a minutos |
| Priority | $5.40 | $27.00 | $0.27 | Segundos, não reduzível |
Três detalhes que eu não pularia:
- Sem camada gratuita. A coluna Free mostra "Not available", e o Google declara que todo token é contado e cobrado. O Gemini 4 Hydrogen tem uma, então é o lugar mais barato para prototipar.
- Priority é a mais cara. O Google a descreve como 75 a 100% mais cara que a Standard. No Neon a página mostra
$5.40e$27.00, que é80%mais. - Flex é uma pechincha com pegadinha. Custa o mesmo
$1.50/$7.50que o Batch, mas é um recurso em preview com disponibilidade de melhor esforço. O Google lista sua economia como voltada para "non-production evals, background agents, and data enrichment", e eu não apoiaria nela uma resposta voltada ao cliente.
Você pode acessar o Neon pela API paga do Gemini ou, segundo a página de novidades do Google, pelos planos Google AI Pro e Ultra no AI Studio. O acesso por assinatura, como o Google AI Ultra, é uma conta diferente da API, então deixo isso fora das contas aqui.
Quanto custa de fato uma tarefa no Gemini 4 Neon?
Os preços por token dizem a tarifa, não a conta, porque um modelo que pensa mais tempo escreve mais tokens de saída. Aqui estão os dados da Artificial Analysis por configuração para o Neon:
| Nível de pensamento | Pontuação no índice | Custo por tarefa | Minutos por tarefa | Tokens de saída por tarefa |
|---|---|---|---|---|
| low | 44.1 | $0.75 | 3.7 | 21,726 |
| medium | 54.9 | $1.90 | 8.3 | 50,000 |
| high (padrão) | 59.6 | $3.74 | 14.8 | 90,188 |
| xhigh | 61.4 | $6.44 | 21.5 | 141,631 |
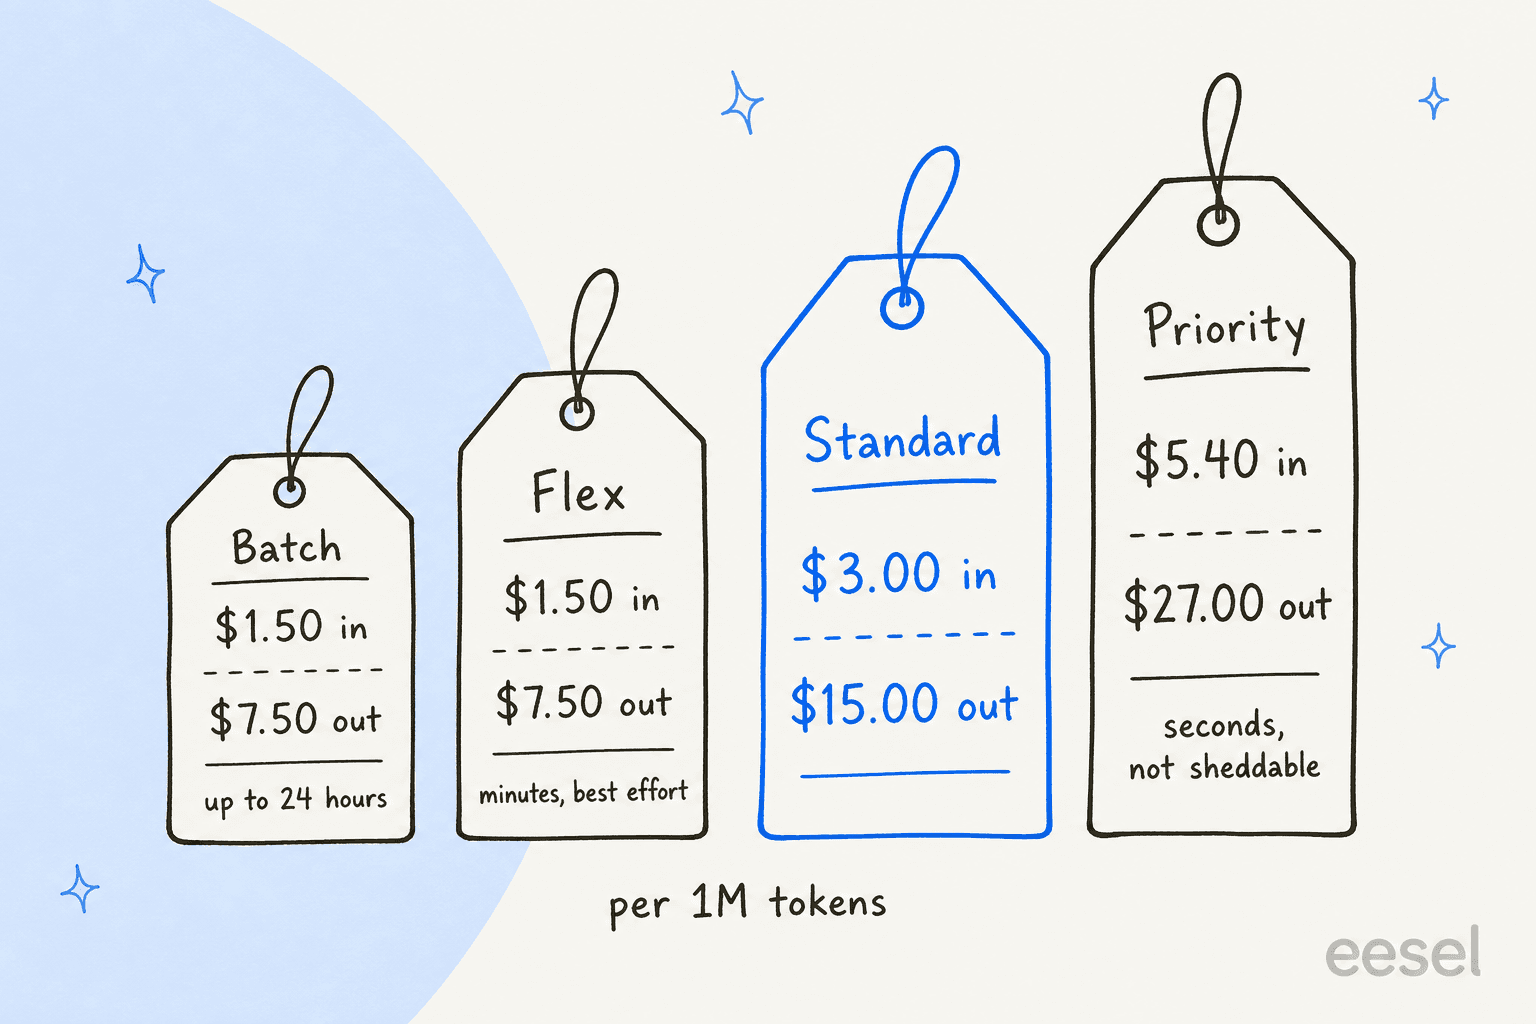
A pontuação por dólar cai rápido. De medium para high você paga $1.84 mais por 4.7 pontos de índice. De high para xhigh você paga $2.70 mais por 1.8 pontos e espera 6.7 minutos extras. A própria orientação do Google é rodar suas avaliações nos quatro níveis e "pick the lowest thinking_level that meets your quality bar", que é a forma certa de ler essa tabela.
Aqui está a parte que achei mais útil. Multiplique os tokens de saída por $15 e o high chega a cerca de $1.35 dos $3.74, perto de 36%. Os outros $2.39 são entrada, o contexto que um agente relê a cada turno. Estou assumindo que a Artificial Analysis cobra no preço de lista, então trate essa divisão como um guia aproximado. Mas ela aponta na mesma direção em cada nível: no trabalho de agentes, o lado da entrada é a conta maior, e a taxa de cache importa mais que o preço de saída.
O Gemini 4 Neon é mais barato que o Carbon?
A partir de 1º de dezembro, sim, por cerca da metade. Até então, está quase empatado.
Gemini 4 Carbon e Argon têm um preço de lançamento na página do Google: $2.00 de entrada e $10.00 de saída "through November 30, 2026", depois $4.00 e $20.00 a partir de 1º de dezembro. A linha do Neon não tem data de fim nem degrau.
O custo da Artificial Analysis para o Carbon, $7.76 por tarefa, é calculado no preço de dezembro. A página do Carbon diz que o Carbon "costs $4.00 per 1M input tokens and $20.00 per 1M output tokens". As duas tarifas dobram em 1º de dezembro, então o mesmo trabalho custa a metade até lá. Pela minha conta, isso dá cerca de $3.88 por tarefa até 30 de novembro, contra os $3.74 do Neon.
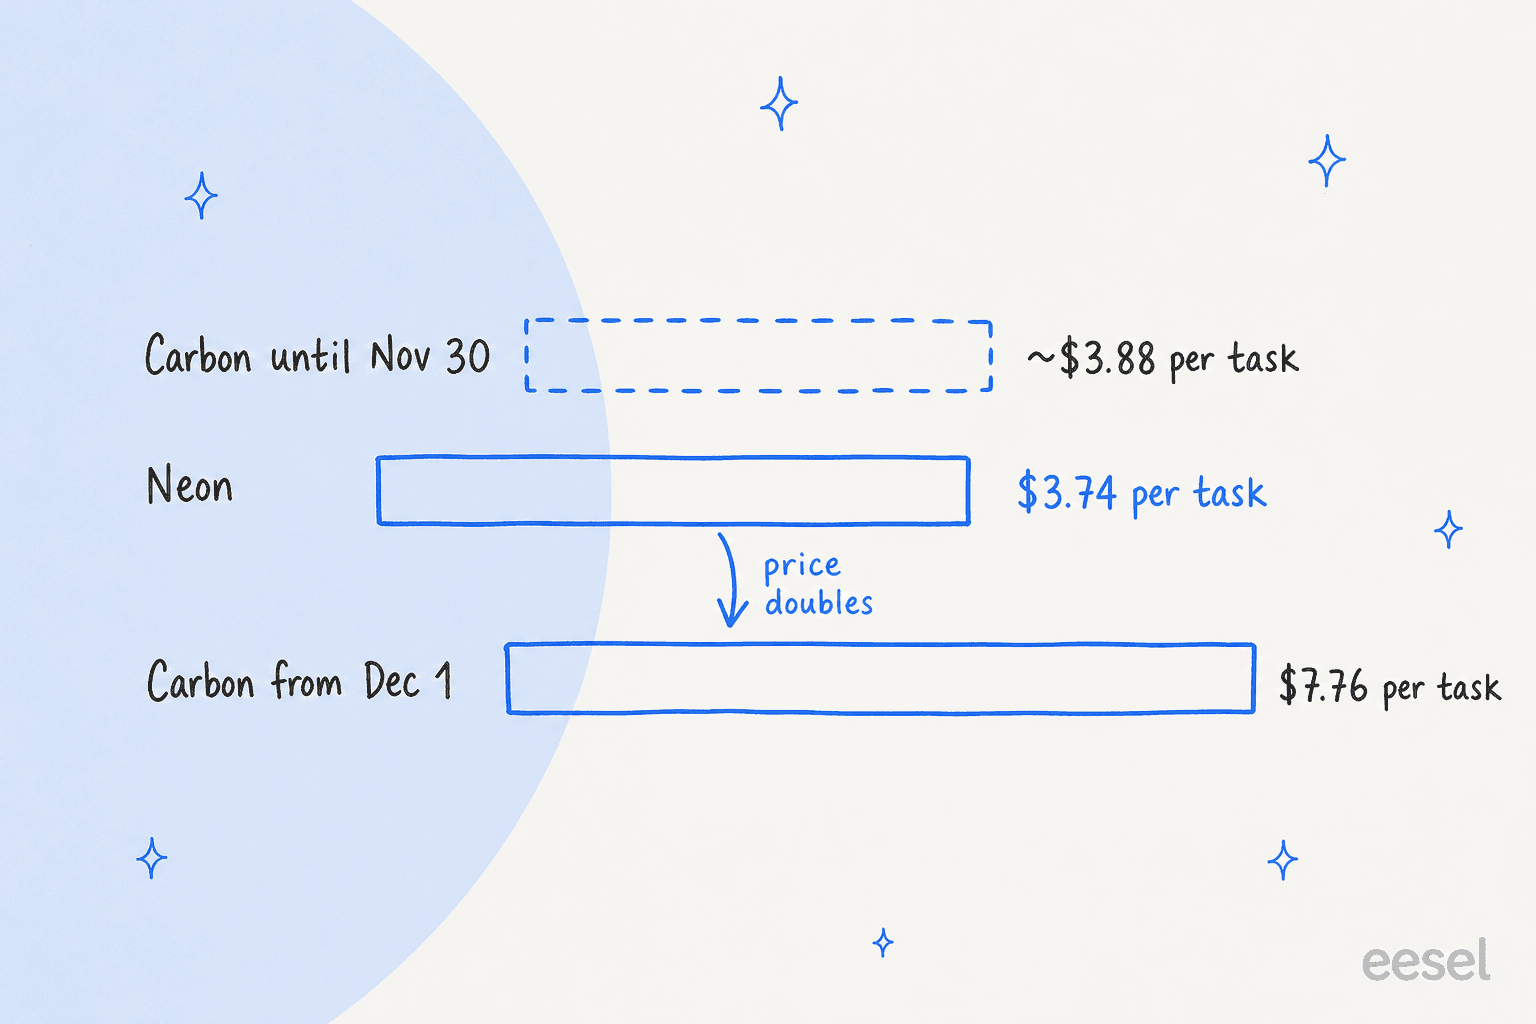
Os $3.88 são minha estimativa, não um número de nenhuma das duas empresas. Isso assume que o Carbon escreve os mesmos tokens por tarefa antes e depois da mudança de preço, o que deveria acontecer já que o modelo não muda. A própria afirmação de lançamento do Google é de 32% menos custo por tarefa que o Carbon, e o preço de lista de dezembro torna essa diferença ainda maior.
O que eu faria: se você está testando o Carbon agora, planeje o orçamento no preço de dezembro, não na promoção. Um leitor do Hacker News notou o posicionamento estranho no dia do lançamento:
"So it's better and cheaper than the recently released Carbon? So Carbon is already deprecated, or?"

Não está obsoleto. Está precificado para ser uma promoção até o fim do mês, e o Neon é o modelo com o preço estável. Minha análise do Carbon cobre onde o Carbon ainda vence, e o post sobre preços do Argon mostra que ele compartilha os degraus de preço do Carbon.
Como o Neon se compara ao Astra, ao Sol e ao Opus em custo?
Não muito bem em preço. Por tarefa, o Neon é mais caro que os modelos da OpenAI e mais barato que a configuração máxima da Anthropic, cujas tarifas estão no guia de preços da API da Anthropic. Aqui estão os mesmos dados da Artificial Analysis, na configuração de melhor pontuação ou padrão de cada modelo:
| Modelo e configuração | Pontuação no índice | Custo por tarefa |
|---|---|---|
| GPT-6.2 Sol max | 57.3 | $1.01 |
| GPT-6.2 Astra high | 60.1 | $2.07 |
| Gemini 4 Neon high | 59.6 | $3.74 |
| Gemini 4 Hydrogen xhigh | 53.9 | $3.16 |
| Gemini 4 Carbon high (preço de dezembro) | 60.0 | $7.76 |
| Claude Opus 5.5 max | 59.1 | $10.04 |
O preço por token do Astra é mais alto que o do Neon, mas ainda assim ele é mais barato por tarefa porque escreve cerca de 17,800 tokens onde o Neon escreve cerca de 90,200. Uma tabela de preços mais barata não significa um modelo mais barato, e um leitor do Hacker News colocou a visão do comprador sem rodeios:
"That looks to me like OpenAI equals or beats everything Google offers at half the price."
No custo, sozinho, eu concordo. O argumento do Neon é sua baixa taxa de alucinação, que cobri na análise. Se sua pergunta é o preço, a análise do GPT-6.2 Sol, meu panorama mais amplo de alternativas ao Gemini e a comparação OpenAI versus API do Gemini são pontos de partida melhores.
Quanto o cache economiza no Neon?
Um acerto de cache é cobrado a $0.15 por milhão de tokens em vez de $3.00, então 95% menos nesses tokens. A pegadinha é que você não pode ativá-lo nem direcioná-lo. A documentação do Google diz que o cache explícito não é suportado nos modelos Gemini 4, e que o cache implícito "is enabled by default". Três regras decidem se você consegue o desconto:
- O mínimo é 4,096 tokens. Prompts mais curtos nunca acertam o cache.
- A ordem importa. O Google diz para colocar "large and common contents at the beginning of your prompt" e enviar prefixos parecidos próximos no tempo.
- Loops de agentes têm um piso. No uso multi-turno, o Gemini só armazena em cache toda a solicitação anterior se a nova solicitação adicionar pelo menos 2,050 tokens. Para adições menores, ele "re-processes the last 2,050 tokens of the previous request at the standard input rate". A maioria dos turnos de agentes passa dessa barra, mas um bot tagarela com respostas curtas pode não passar.
Aqui está o que isso vale em um documento longo. Digamos que você carregue um pacote de contrato de 500,000 tokens e faça 100 perguntas, cada uma respondida em 2,000 tokens. Estas são minhas suposições, precificadas na tarifa Standard:
| Cenário | Custo de entrada | Custo de saída | Total para 100 perguntas |
|---|---|---|---|
| Cada pergunta sem cache | $150.00 | $3.00 | $153.00 |
| Primeira sem cache, 99 acertos de cache | $1.50 + $7.43 | $3.00 | $11.93 |
Essa é uma economia de 92%, mas só se cada pergunta seguinte acertar o cache, o que o cache implícito não garante. Leia usage.total_cached_tokens nas suas primeiras execuções para ver o que você realmente obtém antes de planejar em torno disso.
Quanto custa um mês realista?
Depende de três números que você controla: tokens de entrada, tokens de saída e parcela de cache. Construí uma calculadora para que você coloque os seus. Ela precifica a mesma carga de trabalho no Neon, no Hydrogen e nos dois preços do Carbon.
Os valores padrão são minha carga de trabalho ilustrativa de tickets de suporte: 5,000 solicitações por mês, 6,000 tokens de entrada cada uma com um prefixo em cache de 75%, e 1,500 tokens de saída incluindo pensamento. No Standard, isso dá cerca de $0.028 por solicitação e $138 por mês no Neon. O mesmo ticket custa cerca de $0.014 no Hydrogen e, a partir de dezembro, cerca de $0.037 no Carbon.
Outras três cargas de trabalho, usando o mesmo método:
| Carga de trabalho (minhas suposições) | Neon, Standard | O mesmo no Batch ou Flex |
|---|---|---|
| 5,000 respostas de suporte, 6,000 de entrada (75% em cache), 1,500 de saída | $138 | $69 |
| 5,000 respostas de suporte, sem acertos de cache | $202 | $101 |
200 tarefas de agente em high, aos $3.74 da Artificial Analysis | $748 | $374 (minha divisão pela metade) |
A linha sem cache é a que vale olhar. É a mesma lógica do custo por ticket, onde a unidade pela qual você divide importa mais que a tarifa de manchete. Perder o cache soma 46% à conta de suporte, e isso acontece em silêncio se o seu prompt tiver menos de 4,096 tokens ou o seu prompt de sistema mudar a cada solicitação.
O que mais aparece em uma conta do Neon?
Quatro coisas ficam fora da tarifa por token.
- Grounding de busca. O Google dá 5,000 solicitações de busca gratuitas por mês, compartilhadas entre todos os modelos Gemini 3 e mais novos, depois cobra
$14por 1,000 solicitações, com um limite diário de 1,500 solicitações. O Google também declara que um prompt pode disparar várias buscas, e cada uma é cobrada. O mesmo vale para o grounding do Maps. - Sobrecarga de ferramentas. O Google diz que todo token que o modelo processa é cobrado, "including thinking tokens and internal tool system instructions and function declarations when using grounding". Listas longas de ferramentas também são tokens de entrada.
- Saída que você não leu. Tokens de pensamento são cobrados mesmo quando você só vê uma resposta curta. Defina
max_output_tokensalto o bastante para que o limite não corte uma execução de raciocínio pela metade, mas acompanhe os campos de uso. - Decodificação longa. A saída pode passar de 65,536 tokens até a janela completa, e cada um desses tokens custa
$15por milhão.
Qual camada e nível do Neon escolher?
Escolha a combinação mais barata que atenda à sua barra de qualidade, depois meça por uma semana. Meus pontos de partida:
- Chat de cliente em tempo real ou ferramenta de código interativa: Standard em
medium. O Priority custa80%mais e só compra confiabilidade. - Avaliações noturnas, backfills, enriquecimento de dados: Batch para tudo que pode esperar um dia, Flex para tudo que precisa da resposta em minutos. Os dois saem
50%mais baratos. - Uma tarefa de agente difícil em que
highnão é suficiente:xhigh, por 1.8 pontos de índice extras e72%mais custo por tarefa. Teste antes. - A qualidade não importa muito: use o Gemini 3.8 Flash ou o Hydrogen. O Neon não é o modelo para trabalho barato.
Se você está escolhendo um modelo para um agente de IA de suporte, a conta de tokens é a decisão menor. Meu guia de custo de atendimento ao cliente com IA coloca a linha do modelo ao lado do software, das pessoas e do tempo de revisão que normalmente dominam. A Swiftreg, uma vendedora britânica de placas de carro privadas, rodou dois agentes da eesel no Zendesk e tratou cerca de 2,100 tickets entre 8 de agosto e 8 de setembro de 2026, enviando 1,494 respostas públicas. Seus agentes respondem a partir de consultas de pedidos em tempo real escritas pela equipe e seguem regras rígidas sobre o que deve ir para uma pessoa. Essa configuração, não o modelo, decide se uma resposta está certa, e vale a pena simular em tickets passados antes de pagar por um modelo melhor. Minha lista dos melhores modelos de IA para tickets de suporte é a próxima parada.
Se sua equipe trabalha em um terminal, a CLI da eesel permite que um agente de código envie artigos de ajuda e macros exportados, ajuste as instruções do agente e faça perguntas de teste antes de ir ao ar. Conectar o próprio helpdesk ainda precisa de alguém com acesso de administrador para aprovar. O padrão mais amplo está no meu artigo sobre CLIs de codificação agêntica.
Meu veredito sobre os preços do Gemini 4 Neon
O Neon é precificado de forma justa e não é barato. Sua tarifa é estável, suas camadas são claras, e uma faixa de Batch ou Flex pela metade do preço é útil para trabalho em segundo plano. Mas seu custo por tarefa depende do nível de pensamento que você escolhe e de se seus prompts acertam o cache, então meça os dois antes de se comprometer. Se você está comparando com o Carbon, espere até 1º de dezembro para comparar os preços de lista, e se o custo por tarefa é sua única restrição, o GPT-6.2 Astra e o Sol são mais baratos. Para o panorama completo, comece com o resumo de preços do Gemini, depois a comparação ChatGPT versus Gemini.
Experimentar a eesel
Se você está precificando um modelo porque quer respostas melhores na sua fila, o colega de IA de helpdesk da eesel te dá isso sem uma decisão de modelo. Ele aprende dos seus tickets passados e da sua central de ajuda, passa para uma pessoa quando a resposta não está nos seus documentos, e você pode testá-lo com histórico real de tickets antes de responder a alguém. Ele funciona dentro do Zendesk, Freshdesk e outros helpdesks, como no exemplo do Zendesk abaixo.
O preço é um plano de créditos mensal fixo, com um plano grátis de 100 créditos e sem cartão, então uma mudança de preço de um modelo não move a sua conta. Experimente a eesel em uma parte da sua fila.