Alternativas ao GPT-6 Cyber: 8 opções e como conseguir acesso de verdade

Rama Adi

Katelin Teen
Última edição 6 de novembro de 2026
A melhor alternativa ao GPT-6 Cyber para a maioria das equipes de segurança é o Claude Opus 5.5 pelo Cyber Verification Program da Anthropic. O nível Red Team dele terminou 34 de 50 tarefas ofensivas sem bloqueios, igualando o modelo com as salvaguardas desativadas, a $4/$20 por 1M de tokens, um quinto dos $20/$100 do GPT-6 Cyber. Se você só revisa seu próprio código, o próprio conselho da OpenAI vale: comece no Daybreak Blue, não no Red. O GPT-6 Cyber só é a escolha certa quando você precisa de exploits que funcionem contra alvos remotos e pode esperar uma segunda aprovação.
Por que as pessoas buscam alternativas ao GPT-6 Cyber?
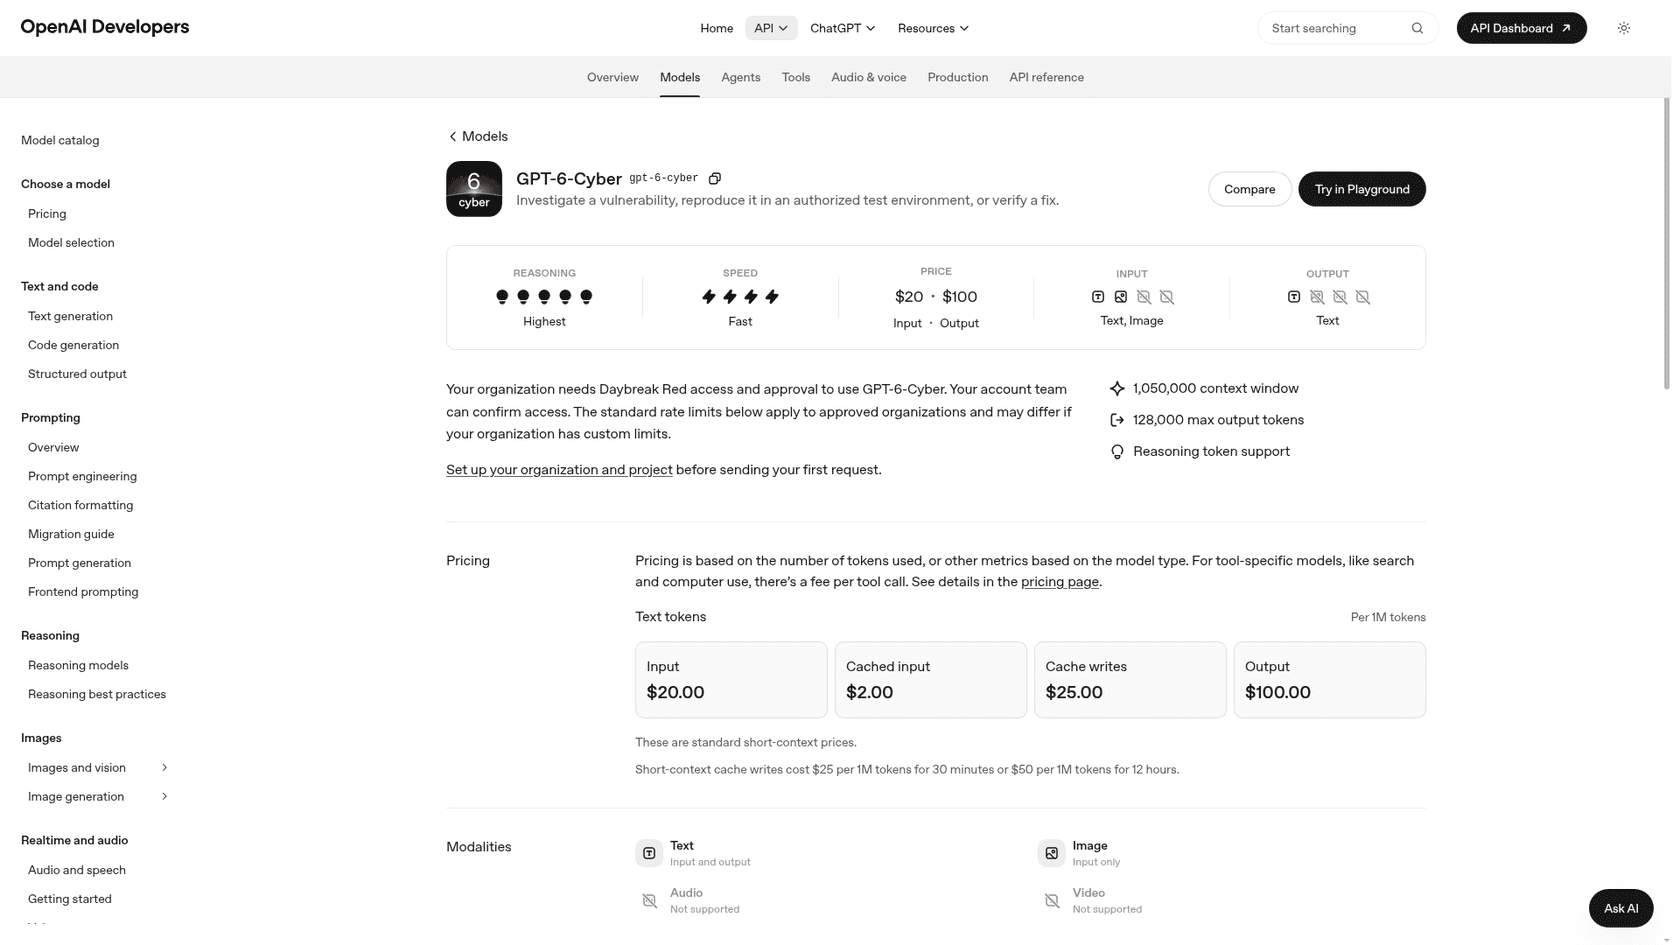
A OpenAI lançou o GPT-6 Cyber em 5 de novembro de 2026, e no papel é o modelo cyber mais forte para o qual alguém já publicou números. No ExploitGym, ele pontua 48,5%, subindo de 32,1% do GPT-5.6 Cyber. No novo RemoteExploitBench da OpenAI, o GPT-6 Astra rodando no Daybreak Blue recusou todas as tarefas, enquanto o GPT-6 Cyber completou 95%.
Três coisas fazem as pessoas procurarem em outro lugar no mesmo dia:
- A barreira é dupla. O guia de acesso do Daybreak diz que o GPT-6 Cyber precisa do Daybreak Red mais uma aprovação separada do GPT-6 Cyber, e o post de lançamento diz que começa com "um grupo seleto" de clientes Red.
- O preço dobrou. A tabela de preços da API da OpenAI lista o
gpt-6-cybera $20 de entrada e $100 de saída por 1M de tokens. Isso é o dobro do GPT-6 Astra, que já era a tarifa padrão mais cara da tabela. - É classificado como Critical. A OpenAI classifica o modelo como Critical em cibersegurança segundo seu Preparedness Framework, e o acesso à API Red exige lista branca de IP por padrão.
Sou o Rama, e construo as integrações e APIs atrás dos colegas de IA do eesel. A maior parte da minha semana vai para conectar modelos a sistemas reais, e na minha experiência a burocracia de acesso costuma levar mais tempo que o código. Essa é a lente desta lista. Um modelo que você não consegue aprovar neste trimestre não ajuda, não importa a nota que tire. É o mesmo motivo pelo qual o eesel lança o eesel CLI: um agente de codificação com IA pode carregar conhecimento aprovado em um colega eesel e testar as respostas dele a partir de um terminal, enquanto conectar o próprio helpdesk ainda espera a aprovação de um administrador.
A reação da comunidade no dia do lançamento dizia a mesma coisa:
"What's the point of delaying Daybreak Blue availability, when high-impact CVEs are being dropped several times a week?"

Como escolhi essas alternativas ao GPT-6 Cyber
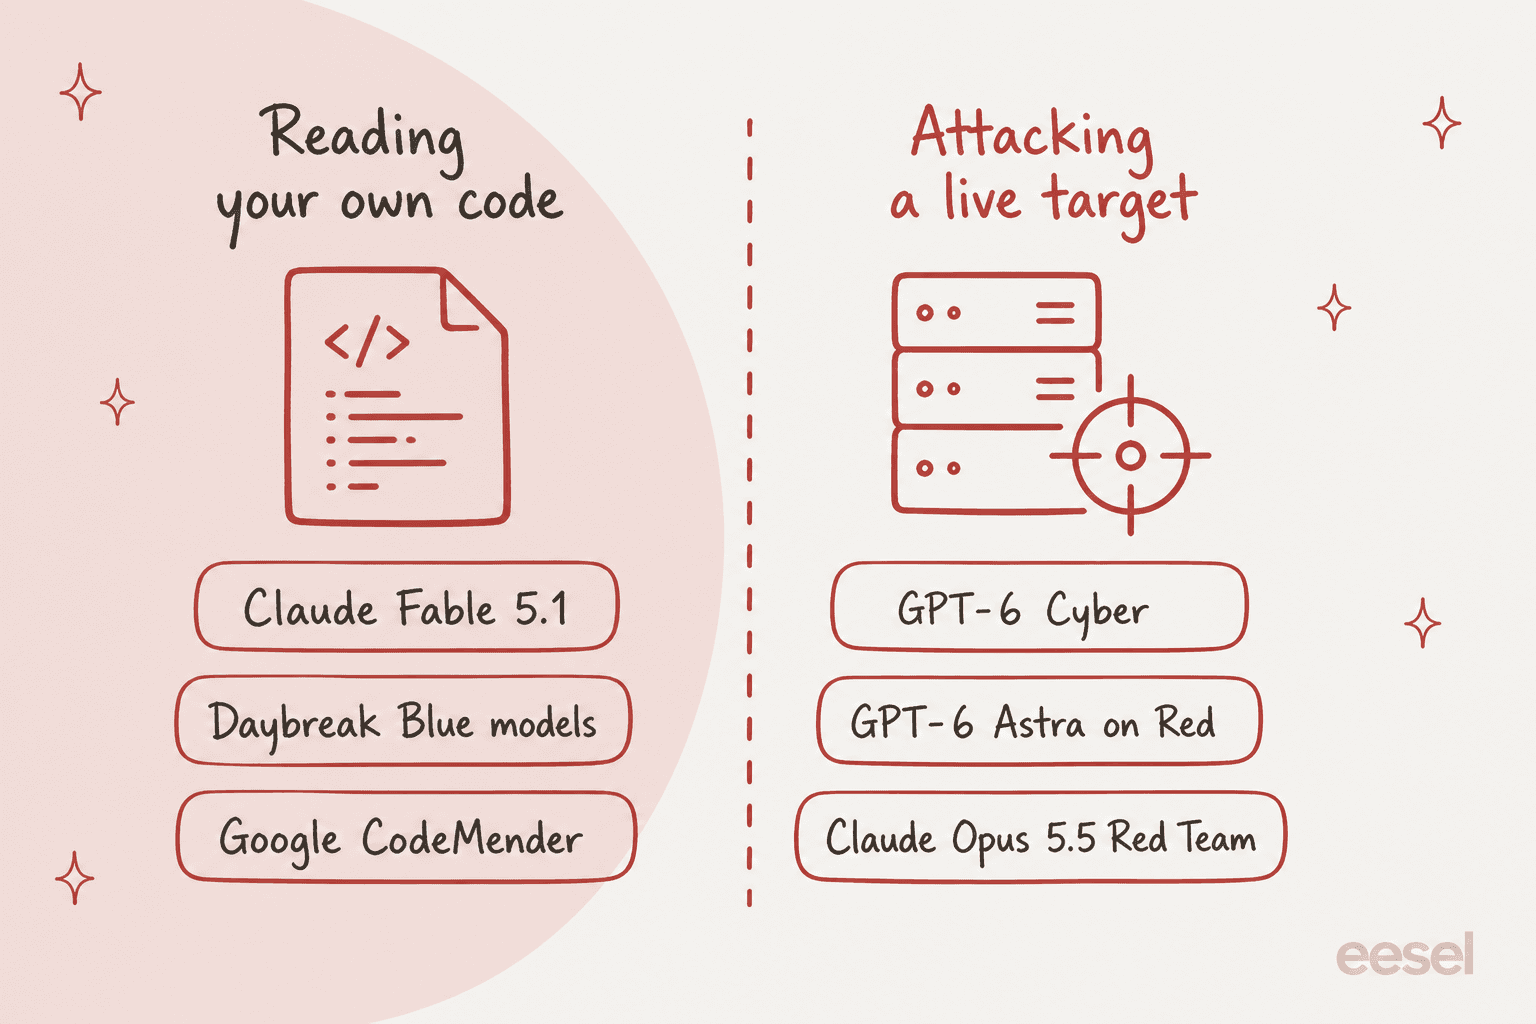
Antes de escrever, fiz ao ChatGPT a pergunta que um líder de segurança faria, e verifiquei quais páginas ele leu. Foi direto ao Cyber Verification Program da Anthropic, ao Claude Mythos e ao Google CodeMender. Ele também dividiu a tarefa em duas: ler o seu próprio código-fonte, e atacar sistemas que já estão em produção. Mantive essa divisão porque ela decide qual barreira você precisa passar.
Cada opção abaixo foi verificada nas próprias páginas do fornecedor em 6 de novembro de 2026. Eu as avaliei por:
- Acesso: quem pode se candidatar, e quanto tempo leva a avaliação.
- Preço: a tarifa publicada por token ou por lugar, da própria página do fornecedor.
- Adequação à tarefa: revisão de código-fonte, ou exploits contra alvos em produção.
- Evidência: benchmarks publicados pelo fornecedor, com a ressalva de que os laboratórios testam principalmente em seus próprios benchmarks.
- Condições de dados: regras de retenção, porque todo programa cyber agora exige alguma.
Alternativas ao GPT-6 Cyber comparadas
| Opção | Fornecedor | Barreira de acesso | Espera típica | Preço por 1M de tokens (entrada / saída) | Exploits contra alvos em produção? | Autoalojável | Regra de retenção de dados | Melhor para |
|---|---|---|---|---|---|---|---|---|
| GPT-6 Cyber (referência) | OpenAI | Daybreak Red + aprovação separada | Primeiro clientes selecionados | $20 / $100 | Sim (95% no RemoteExploitBench) | Não | Usuários ZDR precisam usar Private Safety Processing | Desenvolvimento de exploits remotos |
| Claude Opus 5.5 + CVP | Anthropic | CVP Defense ou Red Team Access | Dias (Defense), semanas (Red Team) | $4 / $20 | Sim, no nível Red Team | Não | Retenção obrigatória | A maioria das equipes de segurança |
| Claude Mythos 5.1 | Anthropic | CVP Specialized Access | Avaliação detalhada com o governo dos EUA | $10 / $50 | Sim | Não | Retenção de 30 dias | Avaliadores de infraestrutura crítica |
| GPT-6 Astra no Daybreak Red | OpenAI | Daybreak Red | Avaliação Red | $10 / $50 | Parcialmente (42,4% ExploitGym) | Não | Condições padrão da OpenAI | Opção da OpenAI pela metade do preço |
| GPT-5.6 Cyber | OpenAI | Só Daybreak Red | Avaliação Red | Não listado pelo nome | Sim (32,1% ExploitGym) | Não | Condições padrão da OpenAI | Organizações Red esperando o GPT-6 Cyber |
| Modelos do Daybreak Blue | OpenAI | Daybreak Blue | Chave de hardware para pessoas físicas | GPT-6 Luna $0,10 / $0,50 | Não | Não | Condições padrão da OpenAI | Revisão defensiva e triagem |
| Claude Fable 5.1 | Anthropic | Nenhuma | Instantâneo | $10 / $50 | Não (redirecionado para o Opus) | Não | Condições padrão da Claude | Revisão de código-fonte, sem burocracia |
| Google CodeMender | Google Cloud | Vendas; modelos cyber via Fairwind | Ciclo de vendas | Falar com vendas | Prova de conceito no seu próprio sandbox | Os exploits rodam localmente | O código fica no seu ambiente | Pipeline de encontrar, provar e corrigir |
| GLM-5.3 | Z.ai | Nenhuma | Instantâneo | Pesos gratuitos | Sim, sem supervisão de nenhum laboratório | Sim | Você define | Pesquisa em air gap |
Qual alternativa ao GPT-6 Cyber combina com sua equipe?
Responda duas perguntas. Cada caminho termina em uma recomendação e no passo de acesso para começar hoje.
Eu reviso código que pertence à minha equipe, ou faço triagem de relatórios de vulnerabilidades
Não posso esperar nenhuma solicitação
Posso esperar alguns dias
Quero um pipeline gerenciado de encontrar e corrigir
Eu faço pen tests autorizados ou exercícios de red team
Somos uma organização e podemos esperar algumas semanas
Já temos Daybreak Red
Testamos redes elétricas, telecom ou sistemas de voo
Nada pode sair do nosso laboratório em air gap
1. Claude Opus 5.5 com o Cyber Verification Program
O que você ganha
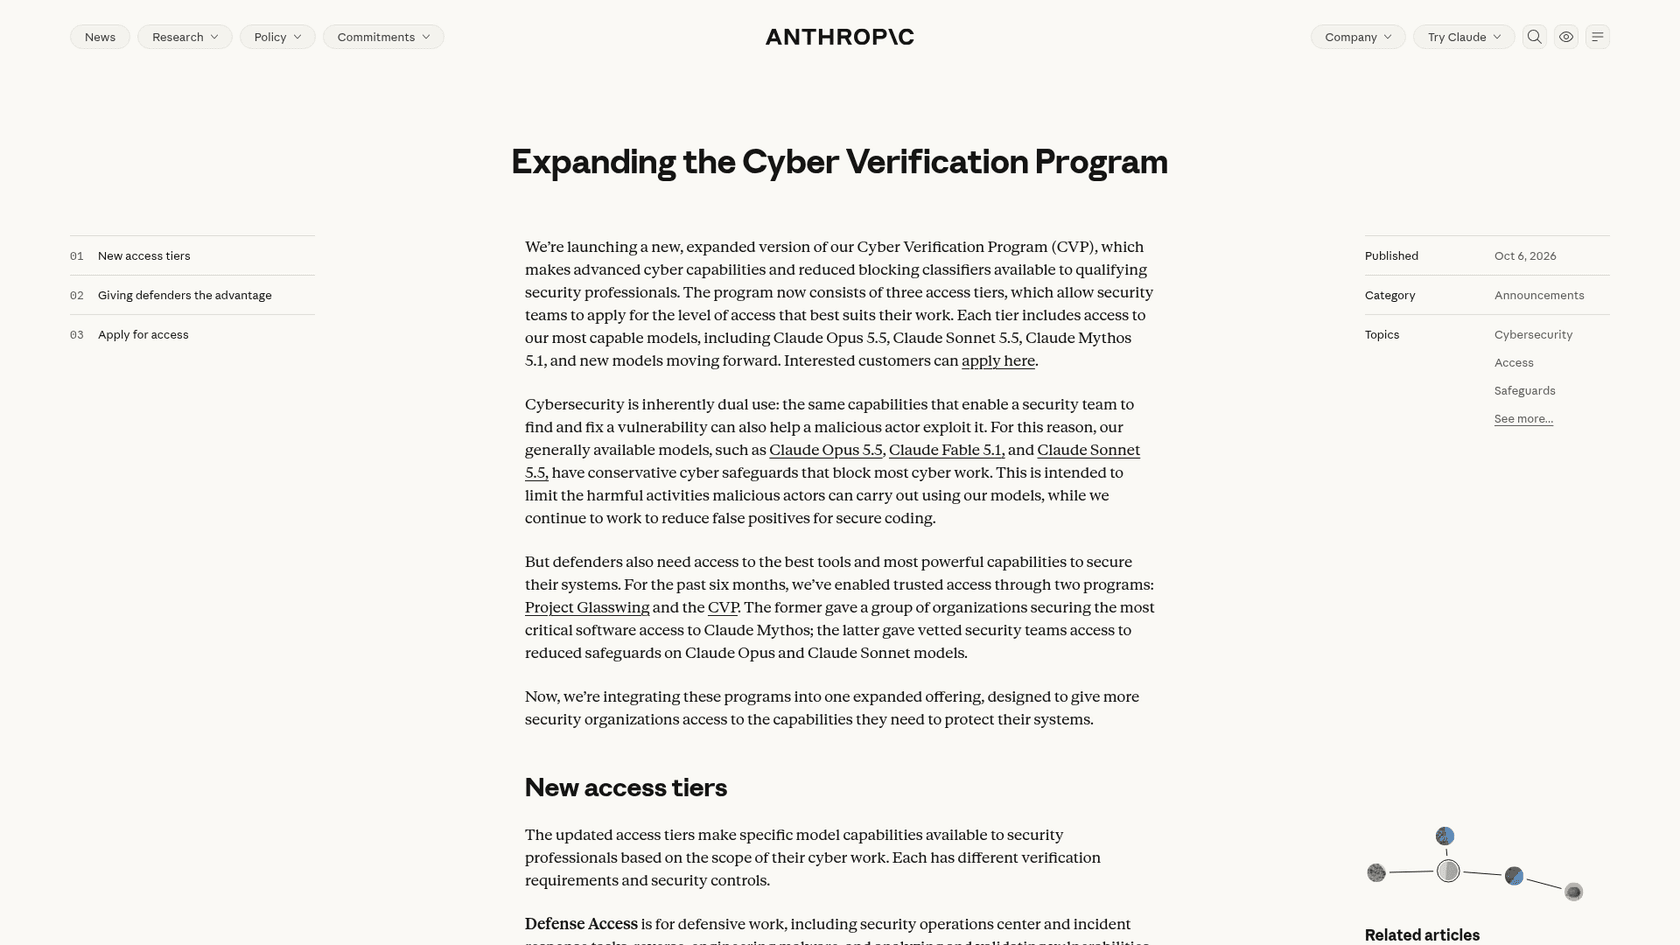
Em 6 de outubro de 2026 a Anthropic uniu o Project Glasswing e seu antigo programa de verificação em um único Cyber Verification Program com três níveis. O Claude Opus 5.5 é o modelo que a maioria das equipes vai rodar nele. A Anthropic testou os níveis no CyScenarioBench, que mede operações cyber em múltiplas etapas:
- Sem CVP: toda tarefa foi bloqueada no primeiro prompt.
- Defense Access: 46 de 50 testes foram bloqueados em algum momento.
- Red Team Access: sem bloqueios, e 34 de 50 tarefas completadas, igualando a taxa de sucesso de 67,6% do Opus 5.5 com as salvaguardas desativadas.
Essa última linha é a que importa. No nível certo, as salvaguardas não custam nada mensurável nesse benchmark.
Como você consegue acesso
O Defense Access cobre trabalho de SOC, resposta a incidentes, engenharia reversa de malware e validação de vulnerabilidades. A Anthropic busca responder essas solicitações "em poucos dias". O Red Team Access adiciona pen testing autorizado e leva algumas semanas, e você fica no Defense Access enquanto espera. O Red Team Access é só para organizações, então pesquisadores individuais não conseguem acesso.
Preço
O Opus 5.5 custa $4 de entrada e $20 de saída por 1M de tokens na página de preços da Claude. Isso é um quinto da tarifa do GPT-6 Cyber, tanto na entrada quanto na saída. Veja os preços do Opus 5.5 para as tarifas de cache e batch.
Onde ele deixa a desejar
A retenção de dados é obrigatória para todo membro do CVP, então uma configuração sem retenção de dados precisa esperar pelas Enterprise Frontier Safeguards da Anthropic, que segundo ela chegam "mais adiante neste outono". O CVP roda na Claude Platform, na Vertex AI e na Microsoft Foundry, mas no Amazon Bedrock só para equipes elegíveis a essas salvaguardas. E o CyScenarioBench é o benchmark próprio da Anthropic, então não se compara diretamente com o ExploitGym da OpenAI.
Escolha esta opção se
você é uma organização que precisa de testes ofensivos e não pode esperar a segunda aprovação da OpenAI. Para uma comparação direta dos modelos gerais, veja GPT-6 Sol contra Opus 5.5.
2. Claude Mythos 5.1
O que você ganha
O Claude Mythos 5.1 é a correspondência direta mais próxima do GPT-6 Cyber: a "classe de modelo mais capaz da Anthropic para pesquisa em cibersegurança e biologia". É o mesmo modelo base do Claude Fable 5.1, com as salvaguardas cyber relaxadas para usuários verificados. A Anthropic diz que parceiros do Glasswing usando modelos Mythos encontraram pelo menos 129.000 vulnerabilidades verificadas entre abril e julho de 2026. Ela chama isso de limite inferior, tirado de 33 relatórios de parceiros. O produto de escaneamento e correção da Anthropic, o Claude Security, também roda agora no Mythos 5.1.
Como você consegue acesso
Pelo nível Specialized Access do CVP. Ele é reservado para organizações que testam sistemas "que poderiam afetar a vida das pessoas ou atrapalhar mercados", como redes elétricas, redes de telecomunicações e transferências interbancárias. A Anthropic avalia cada caso em profundidade junto com o governo dos EUA. Membros existentes do Glasswing migraram sem precisar de nova aprovação.
Preço
$10 de entrada e $50 de saída por 1M de tokens, o mesmo que o GPT-6 Astra e a metade do GPT-6 Cyber. Mais detalhes em preços do Mythos 5.1.
Onde ele deixa a desejar
A maioria das equipes não vai se qualificar. Usar o Mythos 5.1 também significa aceitar por padrão uma política de retenção de dados de 30 dias para monitoramento de segurança. Se você não testa infraestrutura crítica, o Opus 5.5 no Red Team Access é o caminho mais realista da Anthropic.
Escolha esta opção se
você defende sistemas na categoria de infraestrutura crítica e quer a classe de modelo com a qual a OpenAI estava competindo. Minha análise do Mythos 5.1 cobre a diferença de benchmark com o Fable.
3. GPT-6 Astra no Daybreak Red
O que você ganha
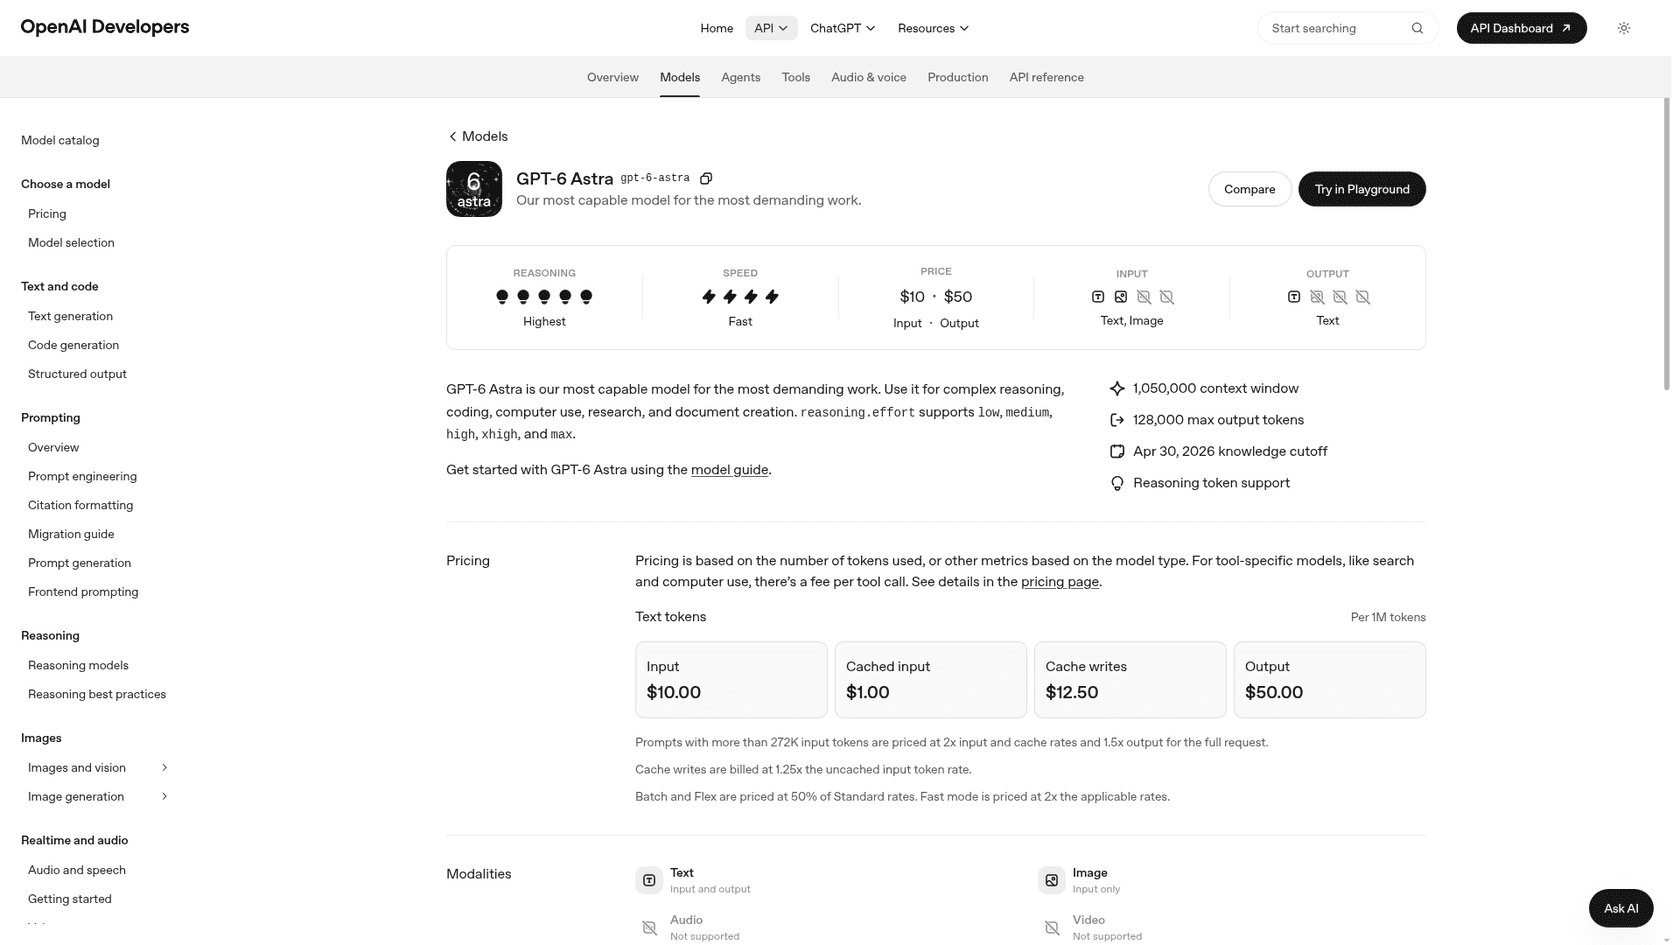
O GPT-6 Cyber é "uma variante especializada em cyber do GPT-6 Astra", segundo seu system card. Então o modelo base já é forte. Na própria tabela do ExploitGym da OpenAI, o Astra rodando sob o Daybreak Blue pontua 42,4% contra 48,5% do GPT-6 Cyber. Isso é cerca de 87% da pontuação pela metade do preço por token. Na avaliação de pen testing web, o Astra encontrou 32,0% das vulnerabilidades contra 40,3% do Cyber.
Como você consegue acesso
O guia de acesso lista as recusas reduzidas no Astra como um recurso do Daybreak Red. No Blue, o Astra mantém as salvaguardas padrão, embora a OpenAI diga que está ampliando um alpha do Blue para o Astra. Note o alerta nos números: com as salvaguardas padrão ativadas, o Astra pontuou 0,0% no ExploitGym.
Preço
$10 de entrada e $50 de saída por 1M de tokens, com entrada em cache a $1. Veja preços do GPT-6 Astra.
Onde ele deixa a desejar
O Astra no Blue recusou 100% das tarefas do RemoteExploitBench, então a exploração remota é exatamente onde ele cede espaço para o GPT-6 Cyber. E ainda assim é preciso o Red para as recusas reduzidas.
Escolha esta opção se
você já tem Daybreak Red, seu trabalho é majoritariamente desenvolvimento de exploits locais, e prefere não pagar o dobro. Minha análise do GPT-6 Astra cobre ele como modelo geral.
"for code review and security checks I think Astra-6 is really great like it'd go so deep and find bugs so small everybody missed that too with using external skills for review."
4. GPT-5.6 Cyber
O que você ganha
A geração anterior, lançada em agosto. Com o lançamento do GPT-6 Cyber, a OpenAI deixou o GPT-5.6 Cyber disponível para todo cliente do Daybreak Red, sem aprovação de modelo separada. Ele pontua 32,1% no ExploitGym, então você perde cerca de 16 pontos em relação ao GPT-6 Cyber. No alinhamento, o GPT-5.6 Cyber ficou dentro do escopo em 94,49% dos testes honeypot da OpenAI, contra 99,93% do GPT-6 Cyber.
Como você consegue acesso
Só a aprovação do Daybreak Red. Se você já está no Red, é a versão que pode usar hoje mesmo.
Preço
A tabela de preços da OpenAI não lista uma linha gpt-5.6-cyber pelo nome. Meu post sobre preços do GPT-5.6 Cyber acompanha como essa linha mudou.
Onde ele deixa a desejar
A taxa fora do escopo importa mais que a diferença de benchmark. Cerca de 5 em cada 100 execuções honeypot foram atrás de serviços que o modelo não devia tocar, então mantenha-o em um sandbox com revisão de ações.
Escolha esta opção se
você tem Red e quer começar esta semana enquanto sua aprovação do GPT-6 Cyber está pendente. A lista antiga de alternativas ao GPT-5.6 Cyber mostra o quanto o cenário mudou em três meses.
5. Modelos do Daybreak Blue (GPT-6 Sol, GPT-6 Luna)
O que você ganha
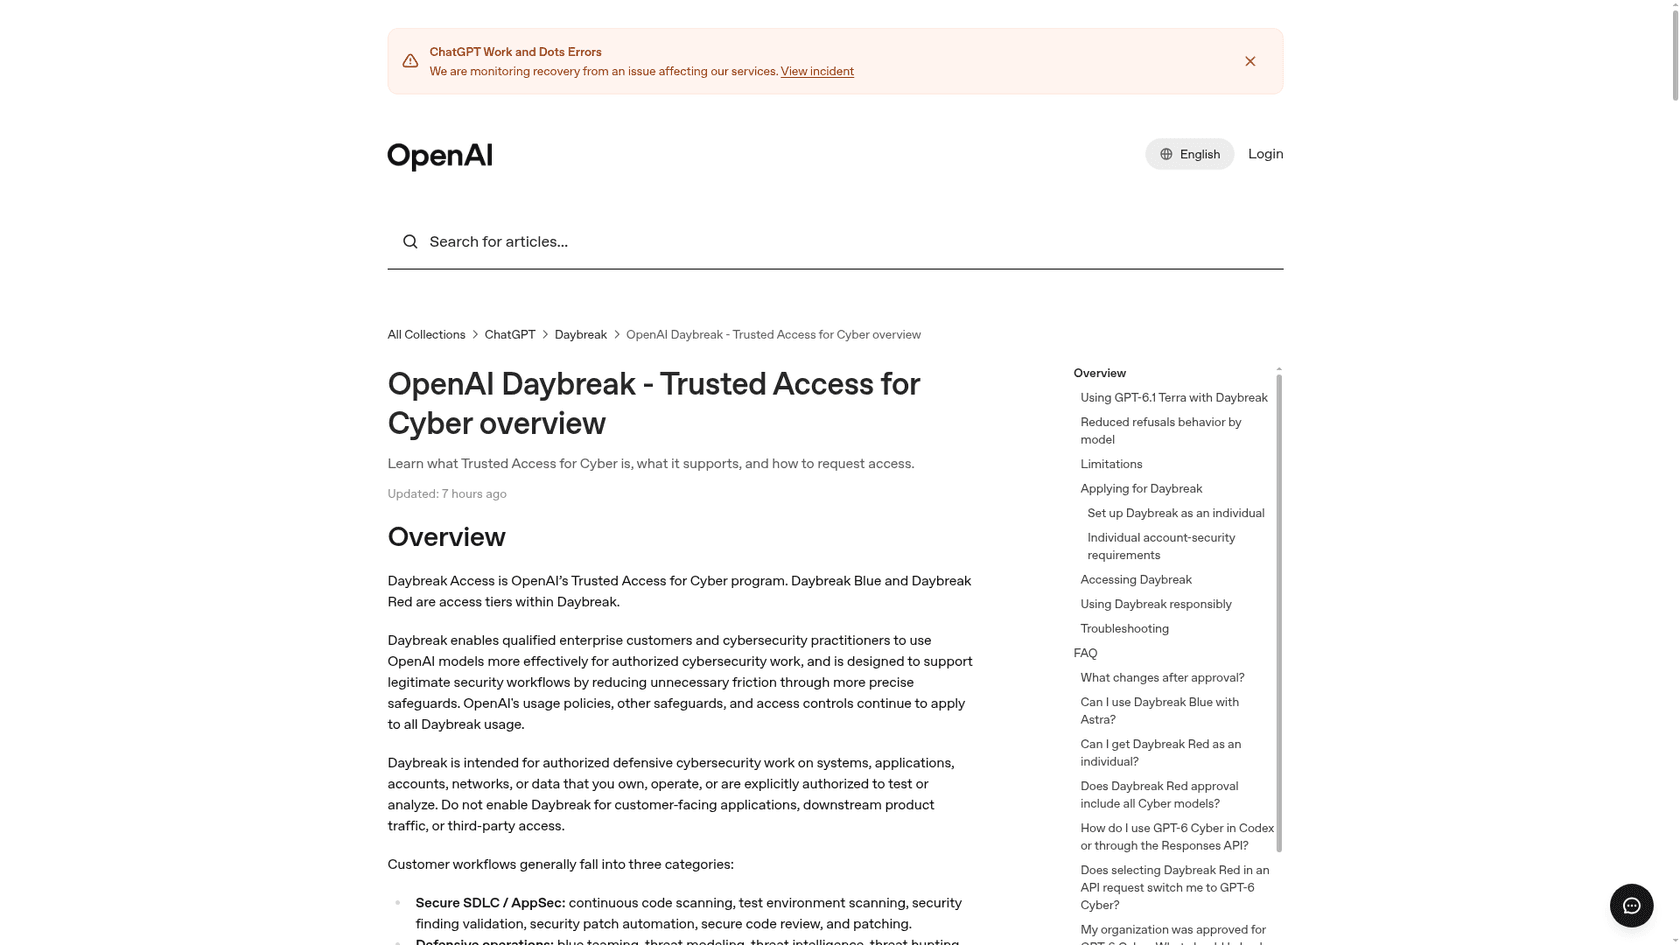
O Daybreak Blue dá recusas reduzidas em modelos principais compatíveis, incluindo GPT-5.5, GPT-5.6 Sol, GPT-6 Sol e GPT-6 Luna. Ele cobre revisão de código segura, triagem de vulnerabilidades, engenharia de detecção, resposta a incidentes, análise de malware e validação de correções. A OpenAI chama isso de o ponto de partida recomendado para a maioria das equipes de segurança.
Como você consegue acesso
Organizações se candidatam pelo formulário do Daybreak. Pessoas físicas se candidatam em chatgpt.com/cyber, e precisam de um plano pago elegível, Advanced Account Security, e pelo menos uma chave de segurança de hardware FIDO2. Uma passkey sincronizada não conta. Outra pegadinha do guia: a aprovação por si só não ativa nada. Você define access_programs.cyber na Responses API, ou ativa a chave do Daybreak no Codex.
Preço
O GPT-6 Luna custa $0,10 de entrada e $0,50 de saída por 1M de tokens. O GPT-6.1 Sol fica em $2 / $10, mas note que o 6.1 Sol mantém as salvaguardas padrão no Blue e só recebe recusas reduzidas no Red.
Onde ele deixa a desejar
Nenhum modelo especializado em cyber, e nenhum exploit contra alvos remotos. O Astra mantém aqui as salvaguardas padrão.
Escolha esta opção se
seu trabalho é defensivo e você vive nas ferramentas da OpenAI, especialmente no Codex ou no Codex Security.
"For defensive purposes, do I only need Daybreak Blue? I assume it's much easier to get Daybreak Blue access than Daybreak Red."
Segundo o guia da OpenAI, a resposta é na maior parte sim.
6. Claude Fable 5.1 (sem solicitação)
O que você ganha
O Claude Fable 5.1 é o mesmo modelo base do Mythos 5.1, lançado com salvaguardas de cyber e biologia. Desde setembro, essas salvaguardas são mais estreitas: o Fable 5.1 já pode identificar vulnerabilidades de software em código-fonte. O post do CVP da Anthropic também diz que seus modelos de disponibilidade geral ainda podem fazer revisão de código, corrigir problemas conhecidos e encontrar bugs em código-fonte próprio.
Como você consegue acesso
Uma chave de API normal. Sem formulário, sem avaliação.
Preço
$10 de entrada e $50 de saída por 1M de tokens, com leituras de cache a $0,25. Detalhes em preços do Fable 5.1.
Onde ele deixa a desejar
Pen testing, geração de exploits e escaneamento de vulnerabilidades baseado em binários ainda são repassados para um modelo Opus quando as salvaguardas são acionadas. Para qualquer coisa voltada a um alvo em produção, você volta a solicitar o CVP.
Escolha esta opção se
você quer um modelo de ponta revisando seu código ainda hoje de tarde. Se sua equipe já trabalha no Claude Code, veja a segurança do Claude Code para as permissões.
7. Google CodeMender
O que você ganha
O CodeMender é um agente, não um modelo. Ele escaneia, depois prova, depois corrige. Ele constrói seu código e executa um exploit de prova de conceito em um sandbox gerenciado pelo cliente para confirmar que uma descoberta é real. Depois escreve uma correção, verifica o patch com um juiz LLM, e entrega aos desenvolvedores um diff para aprovação. Ele suporta C/C++, Java, Python, TypeScript/JavaScript, Go, Rust e Ruby, e funciona com descobertas da Wiz.
Como você consegue acesso
O CodeMender roda na Gemini Enterprise Agent Platform do Google, através de vendas. Os próprios modelos cyber do Google são mais restritos. A página do CodeMender diz que o Gemini 3.8 Flash Cyber é exclusivo para clientes e governos dentro do Fairwind Program. O Fairwind lista mais de 650 parceiros, e um subconjunto deles recebe o Gemini 4 Argon dentro do CodeMender.
Preço
Não publicado. A página só oferece "Contact sales".
Onde ele deixa a desejar
Ele é feito para a sua própria base de código, não para fazer pen testing na rede de outra pessoa. E sem o Fairwind você fica nos modelos gerais, não nos cyber do Google.
Escolha esta opção se
você prefere ter o ciclo de encontrar, verificar e corrigir gerenciado para você, em vez de construir seu próprio arcabouço em torno de um modelo bruto.
8. GLM-5.3 (pesos abertos)
O que você ganha
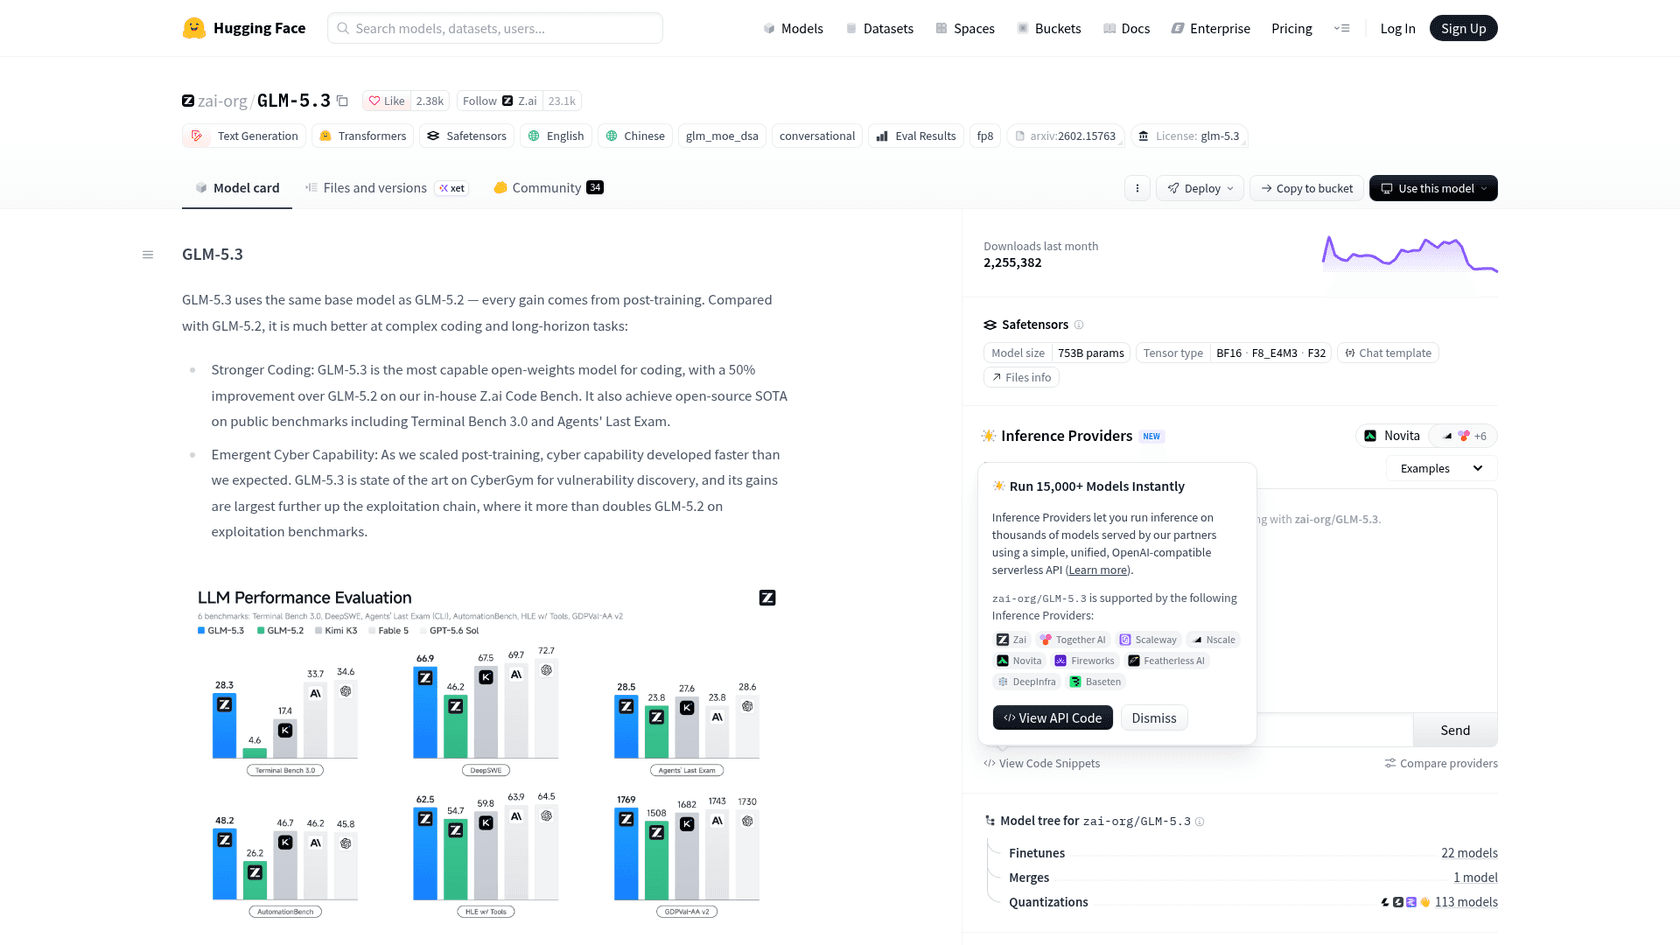
O GLM-5.3 da Z.ai é o modelo mais forte que você pode baixar. Sua ficha de modelo diz que a habilidade cyber "se desenvolveu mais rápido do que esperávamos" durante o pós-treinamento. Na própria tabela da Z.ai, o GLM-5.3 lidera o CyberGym com 84,5, mas no ExploitBench pontua 54,4 contra 76,5 do GPT-5.6 Sol. O CAISI do NIST o chamou de modelo de pesos abertos mais capaz em cyber já lançado até hoje, cerca de quatro meses atrás da fronteira dos EUA, segundo citado na análise da Anthropic.
Como você consegue acesso
Baixe os pesos no Hugging Face. Ninguém avalia seu caso de uso.
Preço
Os pesos são gratuitos. Sua conta é o hardware para rodar um modelo desse tamanho.
Onde ele deixa a desejar
Não há laboratório nenhum vigiando o mau uso, e isso corta dos dois lados. A Anthropic descobriu que as recusas integradas do GLM-5.3 podiam ser contornadas 64% das vezes com uma história de cobertura, 92% com raciocínio pré-preenchido, e 100% uma vez abliterado. Para uma equipe de segurança, o problema é o controle de escopo, não a ética. O GPT-6 Cyber ficou dentro do escopo em 99,93% dos testes honeypot da OpenAI. Com o GLM-5.3, seu próprio sandbox e suas regras de engajamento é que fazem esse trabalho.
Escolha esta opção se
seu trabalho não pode sair de um laboratório em air gap, ou você precisa de engenharia reversa sem recusa nenhuma. O GLM-5.3 Flash, menor, roda com menos hardware.
"Full 5.3 has a scary-good grasp of debugging assembly, QEMU and hex dumps in my experience, it would make for a good “sleuth” model to find potential vulns."
Quanto cada opção realmente custa?
Preços por token só se comparam entre iguais. Aqui estão as tarifas de saída publicadas, lado a lado:
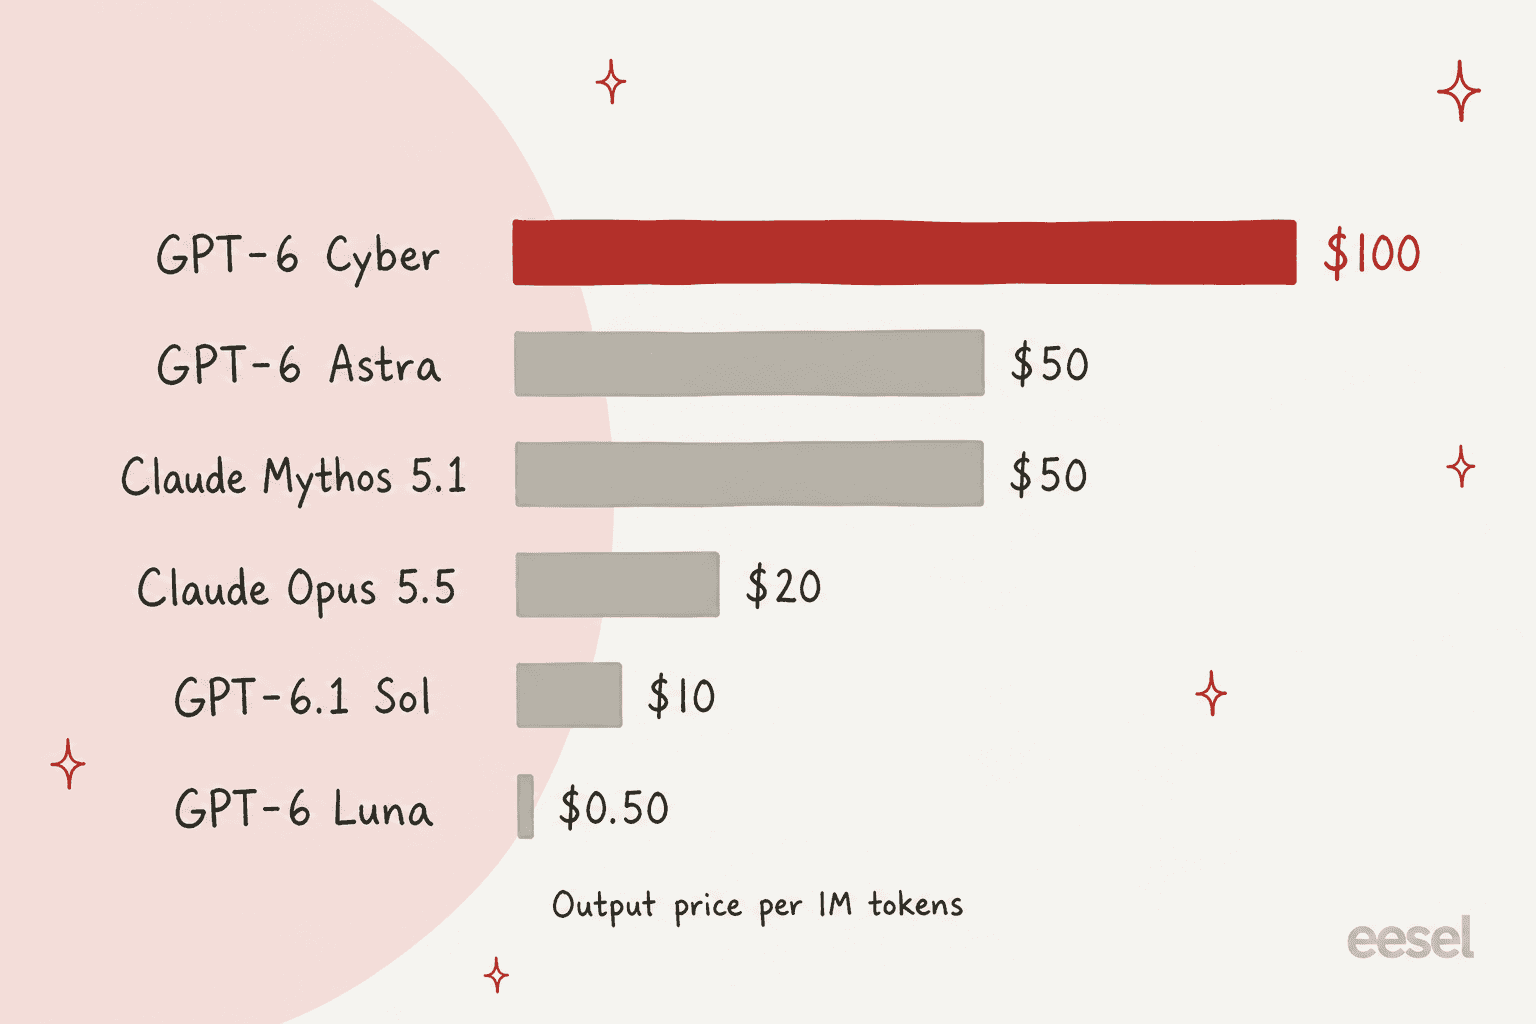
O gráfico esconde duas coisas. Primeiro, trabalho cyber consome muita saída porque o modelo escreve código de exploit e relatórios, então a coluna de saída é a que pesa. Segundo, um modelo mais barato que recusa metade das suas tarefas não é mais barato. É por isso que o nível de acesso importa tanto quanto a tarifa.
Se você prefere comprar um produto em vez de um modelo, algumas ferramentas de segurança publicam preços nos próprios sites:
| Produto | Preço publicado | O que é |
|---|---|---|
| Strix | Pro $29 por lugar ao mês, pentests cobrados por teste | Agente de pentest e revisão de PR, teste de 7 dias |
| MindFort | Starter $499/mês (250 créditos), Scale $999/mês (800 créditos) | Agentes de pentest contínuo |
| GitHub security | Secret Protection $19, Code Security $30 por committer ativo ao mês | Escaneamento e autofix no repositório |
| XBOW | Pedir uma cotação | Pentesting autônomo |
| Anthropic OSS Scanner | Gratuito para projetos aceitos | Escaneamentos periódicos para projetos críticos de código aberto |
Mantenedores de código aberto têm uma segunda via gratuita pelo Patch the Planet da OpenAI, feito com Trail of Bits, Calif e HackerOne.
Quão difícil é abrir cada porta?
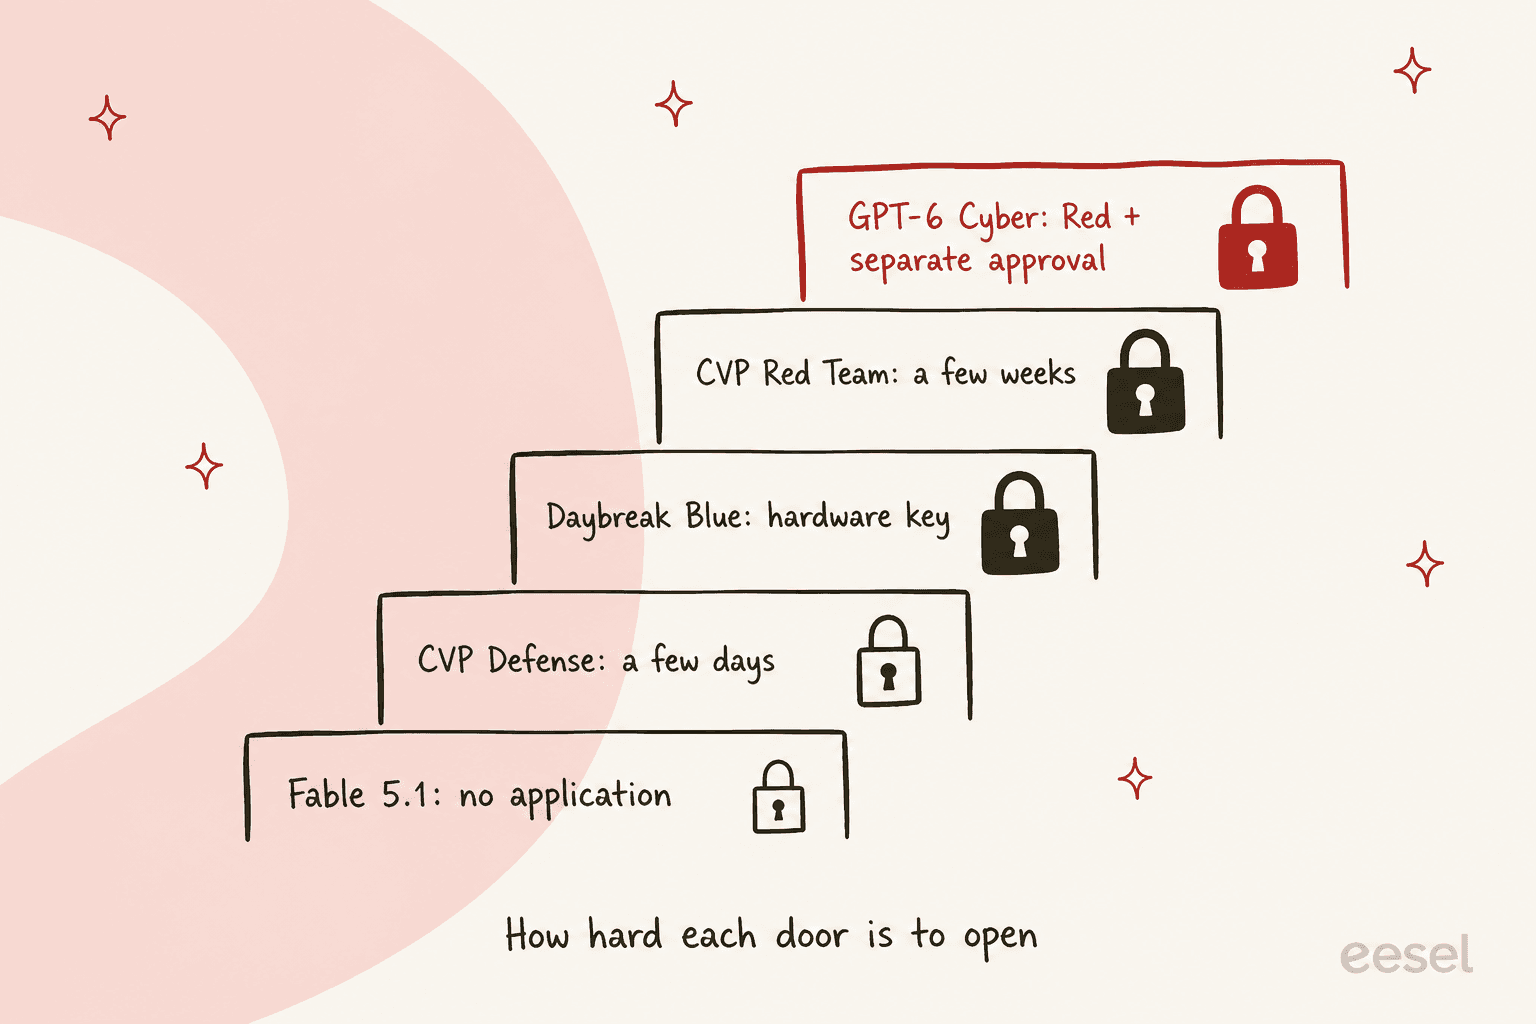
Meu conselho é se candidatar em paralelo. Comece o Defense Access da Anthropic e o Daybreak Blue da OpenAI no mesmo dia, e suba de nível quando seu trabalho precisar. Os dois laboratórios agora pedem provas de controles de segurança e alguma retenção de dados. É a mesma avaliação que vejo do lado do suporte: a checklist de segurança de fornecedores de IA que um cliente aplica ao eesel se parece muito com o que a Anthropic pede a um candidato do Red Team.
O que acontece depois que a vulnerabilidade é encontrada?
Os modelos cyber estão ficando muito bons na primeira metade do trabalho. O GPT-6 Cyber produziu testes reproduzíveis para 81 vulnerabilidades de alta severidade do Firefox. Parceiros do Mythos registraram 129.000. Cada uma dessas se torna um aviso, depois um patch, depois uma onda de e-mails "isso nos afeta?" na caixa de suporte de alguém.
Essa segunda metade é onde passo meu tempo. Um modelo cyber é infraestrutura. O eesel é o colega que cuida das conversas que vêm depois. O colega de IA de helpdesk do eesel entra no seu helpdesk existente, aprende com seus tickets anteriores, sua central de ajuda e o aviso que você acabou de publicar, e é testado contra tickets históricos antes de responder a qualquer pessoa.
A Timengo é um bom exemplo. É uma empresa dinamarquesa de e-mail seguro e Digital Post que roda o eesel no Freshdesk. O colega redige respostas de suporte técnico em dinamarquês a partir de cerca de 5.300 tickets e artigos de ajuda anteriores, preparou 300 tickets em um mês, e escreveu 180 rascunhos, que um engenheiro de suporte revisa antes de enviar. Em escala maior, a SE Ranking roda um agente por produto em três conexões do Zendesk e tratou 4.650 conversas em um mês.
Durante um incidente isso importa, porque o novo aviso e suas perguntas frequentes podem entrar como conhecimento na mesma hora, e você pode fazer perguntas de teste ao colega antes dos clientes fazerem. Há um passo a passo em gerenciar agentes de IA pelo terminal.

Vai lançar uma correção esta semana? Experimente o eesel na sua central de ajuda e veja como ele responde às perguntas sobre a vulnerabilidade antes que seus clientes comecem a perguntar. Mais sobre como esses colegas funcionam em colegas de IA.
Então, qual alternativa ao GPT-6 Cyber você deveria escolher?
- A maioria das equipes de segurança: solicite hoje mesmo o CVP Defense Access e rode o Claude Opus 5.5. Suba para o Red Team Access se fizer pen testing.
- Empresas da OpenAI com trabalho defensivo: Daybreak Blue no GPT-6 Sol ou Luna, como a própria OpenAI recomenda.
- Já no Daybreak Red: GPT-5.6 Cyber agora, Astra para trabalho de exploits pela metade do preço, GPT-6 Cyber depois de aprovado.
- Infraestrutura crítica: Mythos 5.1 via CVP Specialized Access, ou Daybreak Red for Critical Infrastructure.
- Em air gap ou sem solicitação: Fable 5.1 para código-fonte, GLM-5.3 se nada puder sair do laboratório.
O GPT-6 Cyber é a ferramenta certa quando seu trabalho é fazer exploits funcionarem contra alvos remotos e você pode esperar a segunda aprovação da OpenAI. Para tudo o resto, a porta que você pode abrir esta semana vence o modelo que você não pode.