As 8 melhores alternativas ao Claude Sonnet 5.5 em 2026 (conforme o motivo da saída)

Kurnia Kharisma

Katelin Teen
Última edição September 29, 2026
Por que as pessoas olham além do Claude Sonnet 5.5
Primeiro, a parte justa. O Sonnet 5.5 é um grande salto sobre o Claude Sonnet 5. A tabela de lançamento da Anthropic o coloca em 70,6% no Terminal-Bench 4.0, à frente dos 66,4% do Opus 5.5, e a Zendesk disse à Anthropic que os tickets foram processados 20% mais rápido com ele. A análise do Sonnet 5.5 passa por tudo isso, e o veredito do meu colega continua valendo: ótimo com esforço médio.
Trabalho com SEO há dois anos, então o comportamento de busca em torno deste modelo me disse algo antes mesmo de qualquer benchmark. "Alternativas ao Sonnet 5.5" começou a aparecer no dia seguinte ao lançamento, cedo demais para alguém ter superado o modelo. As pessoas estavam pesquisando porque algo quebrou, ou porque uma conta as surpreendeu. São os quatro motivos em torno dos quais organizo o resto do post.
Motivo 1: cinco mudanças incompatíveis, e uma atinge os bots com mais força
A Anthropic lista cinco mudanças incompatíveis para o código que rodava no Sonnet 5. thinking: disabled agora retorna 400 e aponta para between_tools. A antiga ferramenta computer_20251124 é rejeitada na API do Claude e no Google Cloud. Algumas combinações da ferramenta advisor também são recusadas.
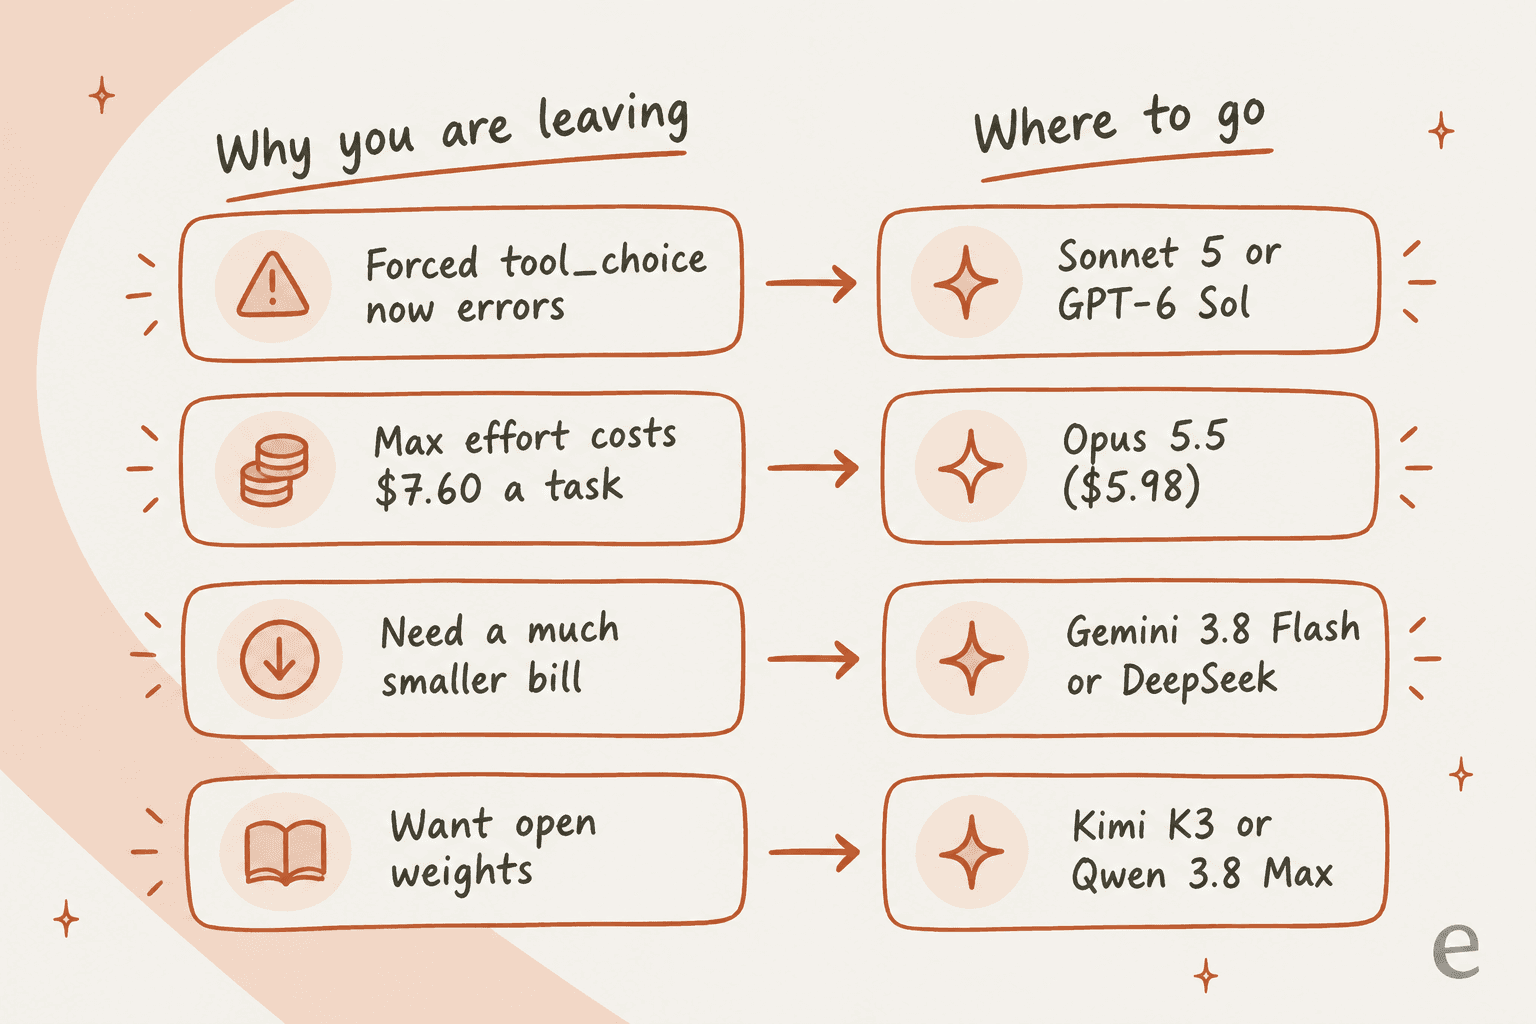
A que quebra bots em produção é o uso forçado de ferramentas. tool_choice em any ou em uma ferramenta específica retorna um invalid_request_error 400 no Sonnet 5.5. A correção sugerida pela Anthropic é manter auto, definir strict: true ou migrar para saídas estruturadas, e "dizer no prompt quando a ferramenta se aplica". Funciona, mas no fim troca uma garantia por um pedido. Se a sua etapa de triagem de tickets ou de extração dependia de o modelo sempre chamar classify_ticket, agora você tem um comportamento para retestar e não uma linha para mudar. E subir para o Opus 5.5 não ajuda aqui: as notas de migração dele listam o mesmo 400.
Motivo 2: o esforço máximo custa mais que o Opus
O esforço padrão da API do Sonnet 5.5 é high. No topo da escada, ele fica caro. No Intelligence Index da Artificial Analysis, o Sonnet 5.5 em max marcou 56 por $7.60 por tarefa, enquanto o Opus 5.5 em max marcou 58 por $5.98. O Sonnet só usou mais tokens para chegar a essa nota.
"I'm a bit confused myself. On artificial analysis, sonnet 5.5 max has a cost per task of $7.60 while opus 5.5 max has $5.98. Sonnet 5.5 max was using 193k tokens per task while opus 5.5 max was using 119k."

Simon Willison viu o mesmo padrão, só que em um único prompt. A tabela de esforço dele ia de 1,6 centavo em low a $1.28 em max, onde o modelo "burned through 128,000 thinking tokens" em cerca de 15 minutos e não terminou (simonw no Hacker News).
Motivo 3: leituras de cache custam o mesmo que no Opus
O Sonnet 5.5 custa metade do Opus 5.5 em entrada, saída e escritas de cache. Leituras de cache são a exceção, $0.20 por milhão nos dois, porque o Opus 5.5 cobra leituras de cache a 0,05x. Em um loop longo de agente, a maior parte dos tokens vai para leituras de cache, então a diferença some. A página de preços da API da Anthropic traz os multiplicadores.
"Cache read is the same as Opus as well where most agentic workflow cost comes from. Not quite sure where this fits well."

Motivo 4: o mesmo preço de tabela compra trabalho muito diferente
Este é o gráfico que mais me surpreendeu durante a pesquisa. Três modelos têm exatamente o mesmo preço de $2 de entrada / $10 de saída. Com esforço máximo, ainda assim geram contas bem diferentes para cada tarefa concluída.
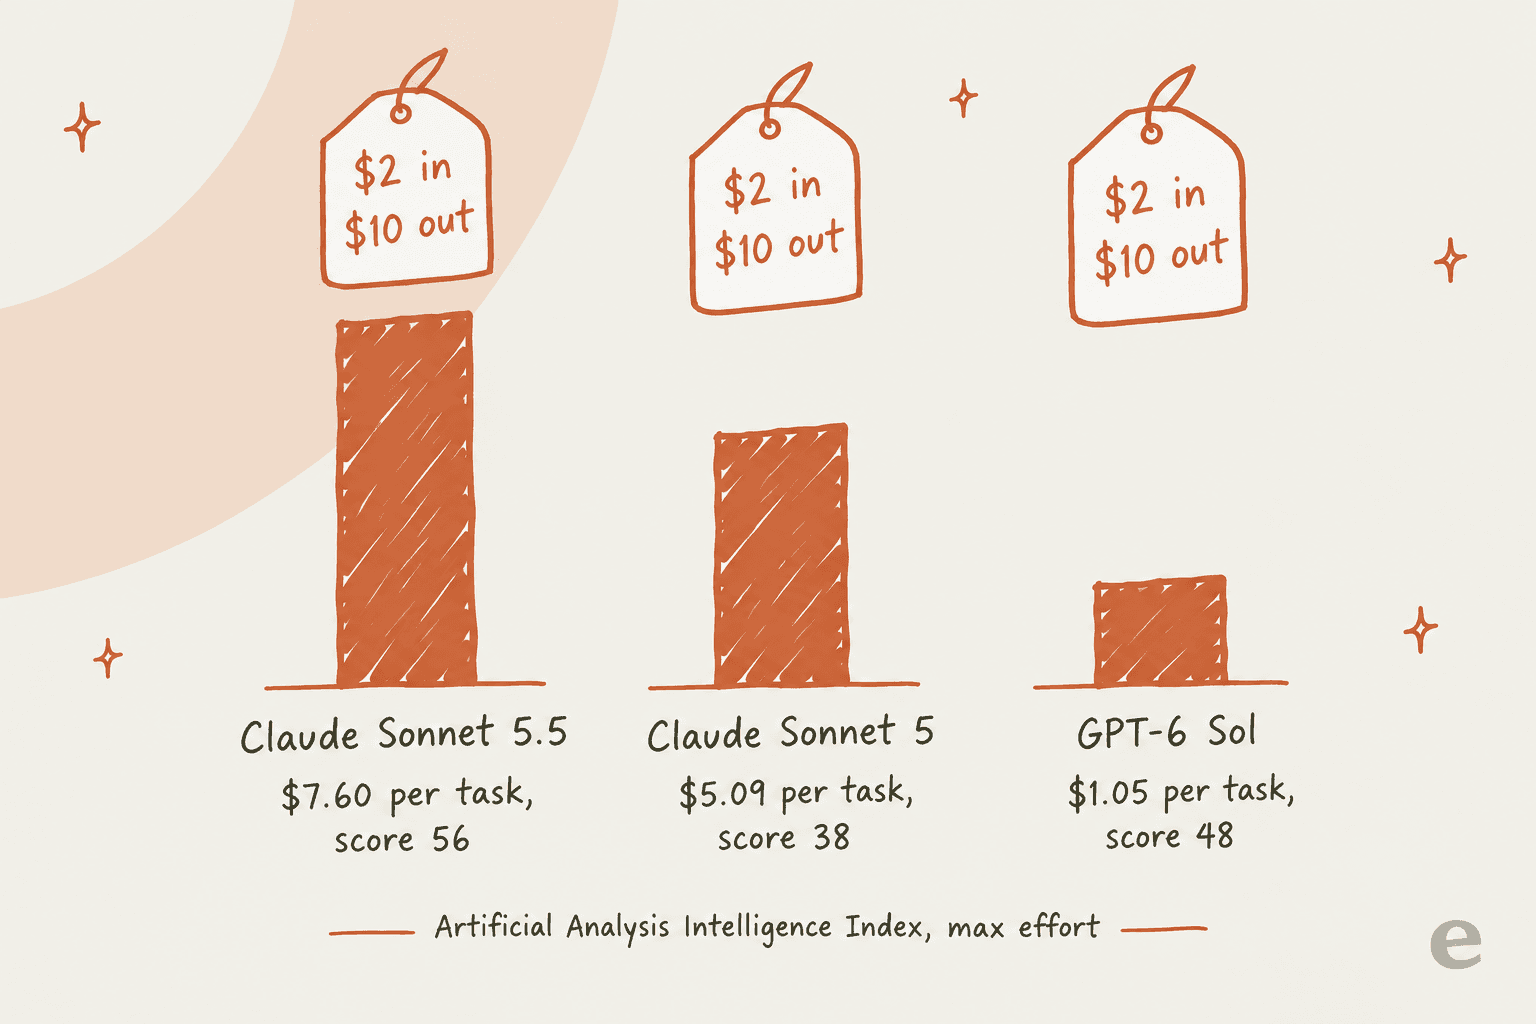
O Sonnet 5.5 é o mais inteligente dos três. Também é o mais caro por tarefa, por uma margem grande. O preço por token diz quase nada sobre a conta. O que importa são os tokens por tarefa, uma propriedade do modelo que só se descobre rodando.
Alternativas ao Claude Sonnet 5.5 em resumo
Os preços são por milhão de tokens na página de preços de cada fornecedor, conferidos em 2026-09-29. A coluna da Artificial Analysis usa a escala atual do Intelligence Index, com o ajuste de esforço que a AA testou entre parênteses. Deixei uma célula em branco em vez de misturar uma nota da escala antiga.
| Modelo | Entrada / saída | Leitura de cache | Contexto | Nota AA, custo por tarefa | Escolha forçada de ferramenta | Pesos abertos | Melhor para |
|---|---|---|---|---|---|---|---|
| Claude Sonnet 5.5 (referência) | $2 / $10 | $0.20 | 1M | 56, $7.60 (max) | Não, retorna 400 | Não | Programação rápida em Low/Medium |
| Claude Opus 5.5 | $4 / $20 | $0.20 | 1M | 58, $5.98 (max) | Não, retorna 400 | Não | Tarefas difíceis com esforço alto |
| Claude Sonnet 5 | $2 / $10 | $0.20 | 1M | 38, $5.09 (max) | Sim | Não | Plano B sem reescrita |
| GPT-6 Sol | $2 / $10 | $0.20 | 1.05M | 48, $1.05 (max) | Sim (Responses API) | Não | Mesmo preço, conta menor |
| Gemini 3.8 Flash | $0.75 / $3.75 | $0.075 | 1M | 41, $1.24 (high) | Sim (modo any) | Não | Trabalho em lote multimodal barato |
| Grok 4.7 | $2 / $6 | $0.50 | 500K | 46, $3.74 (xhigh) | Sim (required ou nomeada) | Não | Loops longos de agentes |
| Qwen 3.8 Max | $2 / $6 | $0.25 | 1M | - | Ferramenta nomeada, só sem thinking | Modelo base, licença própria | Saída mais barata, base aberta |
| Kimi K3 | $3 / $15 | $0.30 | 1M | - | Só required | Sim, licença própria | Pesos abertos com visão |
| DeepSeek V4.1 Flash | $0.15 / $0.60 fora do pico | $0.003 | 1M | 39, $0.27 (max) | Só modo sem thinking | Sim, MIT | O piso de custo |
A coluna de escolha forçada de ferramenta vem da documentação de function calling de cada fornecedor. Leia com atenção, porque é a coluna que a maioria erra. A documentação de definição de ferramentas da Anthropic lista Opus 5.5, Sonnet 5.5 e Fable 5.1 juntos como modelos em que any e tool retornam 400. DeepSeek e Qwen só permitem ferramentas forçadas com o thinking desligado, e o Kimi K3, que sempre pensa, aceita required mas não uma ferramenta nomeada. Só Sonnet 5, GPT-6 Sol, Gemini 3.8 Flash e Grok 4.7 forçam uma chamada de ferramenta com o raciocínio ligado.
Como escolhi estas
Parti dos quatro motivos acima e fiz uma pergunta para cada candidato: este modelo resolve um motivo específico para sair do Sonnet 5.5, sem criar um pior? Todo preço vem da página de preços do próprio fornecedor. Todo número de custo por tarefa vem da Artificial Analysis, que roda o mesmo Intelligence Index em cada modelo e publica o que gastou. As citações da comunidade vêm de threads do Hacker News e do Reddit em que as pessoas rodaram os modelos por conta própria.
Deixei o Claude Haiku 4.5 de fora como escolha principal. É uma opção real a $1/$5, mas a Anthropic lista a aposentadoria mais próxima em 15 de outubro de 2026, daqui a cerca de duas semanas, e eu não começaria uma migração para um modelo com essa data.
Encontre sua alternativa em dez segundos
Toque no motivo que trouxe você aqui.
Por que você está saindo do Claude Sonnet 5.5?
Escolha um para ver para onde eu iria.
1. Claude Opus 5.5
Melhor para: equipes que rodam o Sonnet 5.5 com esforço xhigh ou max e estão pagando por isso.
Coloco primeiro a escolha contraintuitiva. O Claude Opus 5.5 custa o dobro por token e ainda assim pode ser o modelo mais barato. Com esforço máximo na Artificial Analysis, o Opus 5.5 marcou 58 por $5.98 a tarefa, o Sonnet 5.5 marcou 56 por $7.60. O Opus chegou como o primeiro Opus da Anthropic a ficar mais barato, $4/$20 em vez de $5/$25, e suas leituras de cache são cobradas a 0,05x, por isso igualam os $0.20 do Sonnet.
Ele também recompensa descer de nível. O detalhamento dos preços do Sonnet 5.5 mostrou o Opus 5.5 em Medium marcando 51 por $1.34 a tarefa, contra o Sonnet 5.5 em Xhigh marcando 52 por $2.74. Quase a mesma nota, por cerca de metade do dinheiro.
Prós
- Teto mais alto que o Sonnet 5.5 no Intelligence Index, 58 a 56 em max.
- Mais barato por tarefa que o Sonnet 5.5 com esforço máximo.
- Mesma API do Claude, mesmas ferramentas, mesmos fluxos do Claude Code.
Contras
- O dobro do preço por token do Sonnet em entrada, saída e escritas de cache, então em Low e Medium o Sonnet 5.5 ganha.
- Mais lento, algo que o pessoal da thread de lançamento notou de cara.
- Rejeita
tool_choiceforçado exatamente como o Sonnet 5.5, então não resolve essa mudança incompatível. - O Sonnet 5.5 não lê os blocos de raciocínio do Opus 5.5 e vice-versa, então misturá-los em uma conversa descarta raciocínio.
Preços
$4 de entrada, $20 de saída, $0.20 de leitura de cache por milhão de tokens, com Batch pela metade do preço. Veja o post de preços do Claude Opus 5.5 para cada linha.
Minha opinião: Se a sua carga vive em xhigh ou max, suba para o Opus 5.5 e desça um nível de esforço. Você provavelmente pagará menos e terá uma resposta melhor. Se roda em Low ou Medium, fique no Sonnet 5.5; esta escolha não se aplica a você.
2. Claude Sonnet 5
Melhor para: quem teve o código de produção quebrado pelo uso forçado de ferramentas do Sonnet 5.5 ou pela mudança em thinking: disabled.
É a resposta sem graça, mas no dia em que o seu pipeline começa a jogar 400 ela é a certa. O Claude Sonnet 5 é o modelo contra o qual as cinco mudanças incompatíveis são medidas, então, por definição, nenhuma se aplica. Tem o mesmo preço de $2/$10. A página de descontinuações da Anthropic o lista como ativo, sem aposentadoria antes de 30 de junho de 2027.
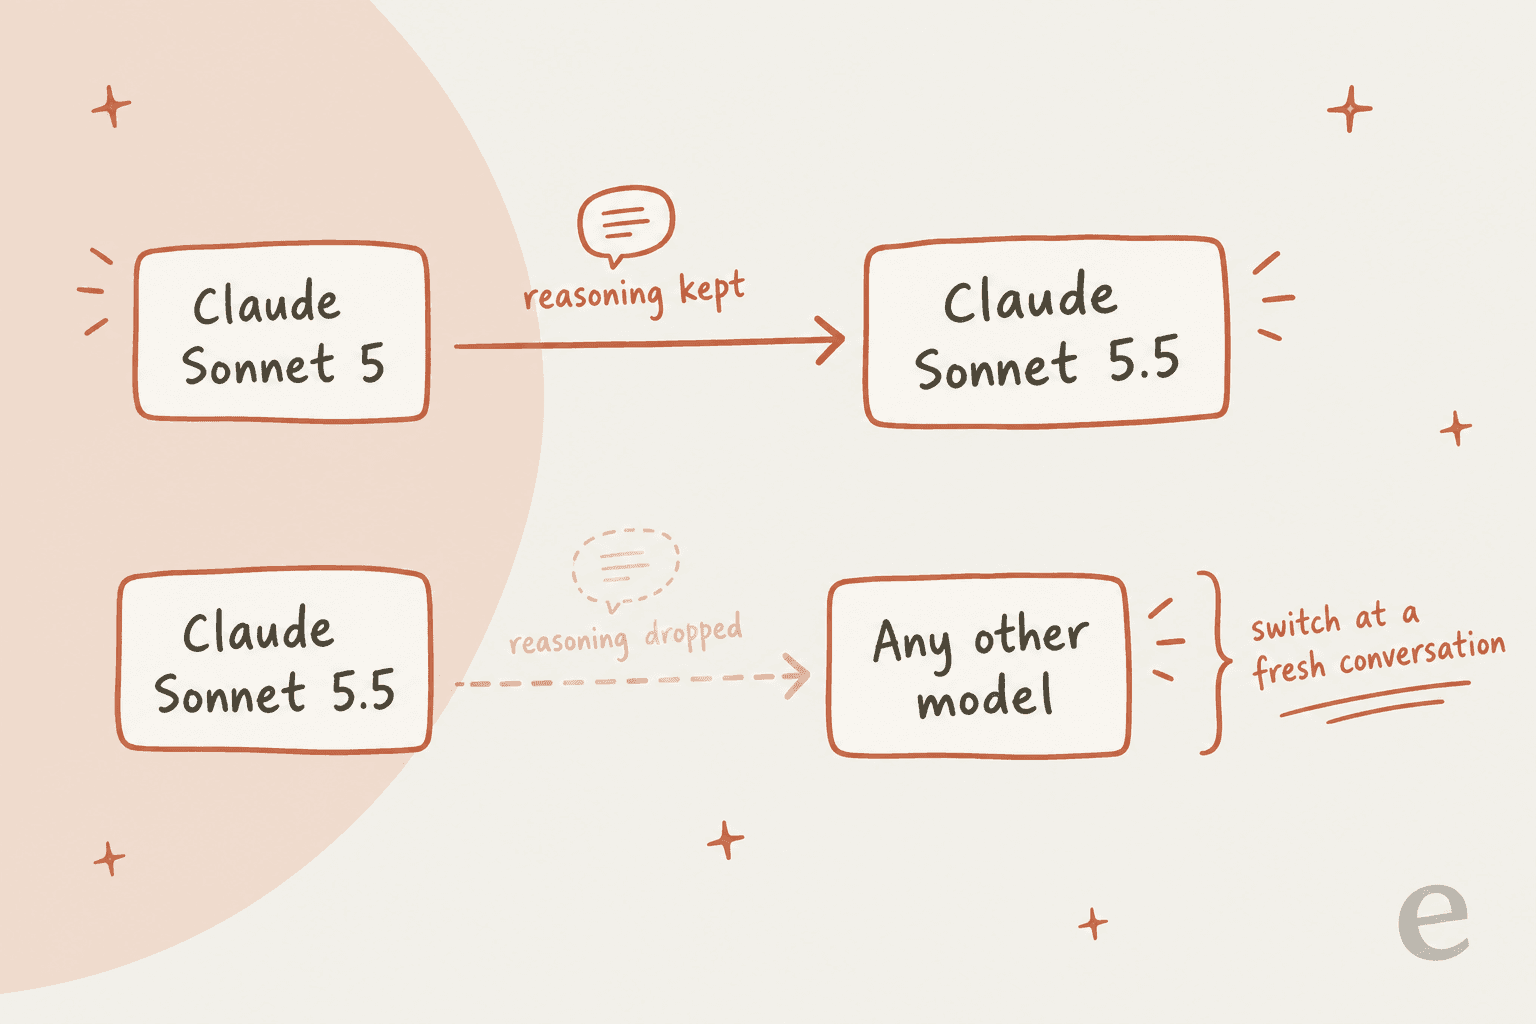
Há um detalhe legal na documentação para quem planeja uma migração em etapas. O Sonnet 5.5 consegue ler os blocos de raciocínio do Sonnet 5, então uma conversa que começa no Sonnet 5 e sobe mantém o raciocínio. O contrário não funciona.
Prós
- Um rollback de uma linha: troque o ID do modelo, nada mais.
- Mantém
tool_choiceforçado, orçamentos manuais de thinking e a ferramenta de computer use anterior. - Piso de aposentadoria a mais de 20 meses.
Contras
- Claramente menos capaz. O Terminal-Bench 4.0 é 10,3% contra 70,6% do Sonnet 5.5 na tabela de lançamento da Anthropic.
- Também não é mais barato por tarefa. Em max mediu
$5.09para uma nota de 38. - Não está mais na tabela de modelos atuais da Anthropic, então as novidades chegam primeiro ao 5.5.
Preços
$2 de entrada, $10 de saída, $0.20 de leitura de cache por milhão de tokens. O post de preços do Claude Sonnet 5 traz detalhes de planos e Batch.
Minha opinião: Use o Sonnet 5 como estacionamento, não como destino. Faça o rollback hoje, conserte suas chamadas de ferramenta em uma branch contra o Sonnet 5.5 ou o GPT-6 Sol e depois avance. A lista de alternativas ao Claude Sonnet 5 vale uma olhada se você for ficar estacionado por mais tempo.
3. GPT-6 Sol
Melhor para: equipes que querem preço de nível Sonnet com chamadas forçadas de ferramenta e uma conta menor por tarefa.
O GPT-6 Sol tem o mesmo preço de tabela do Sonnet 5.5: $2 de entrada, $0.20 em cache, $2.50 de escritas de cache, $10 de saída (preços da OpenAI). A diferença é quantos tokens ele gasta. Com esforço máximo na Artificial Analysis, o GPT-6 Sol marcou 48 por $1.05 a tarefa, cerca de um sétimo da conta do Sonnet 5.5 com esforço máximo. É menos capaz no topo: 48 contra 56.
Para quem precisa de uso forçado de ferramentas, o guia de function calling da OpenAI documenta required e a escolha de ferramenta por nome de função. Um porém na página do modelo: via Chat Completions, o GPT-6 Sol só suporta function calling com reasoning_effort em none. Use a Responses API se quiser ferramentas e raciocínio juntos.
Prós
- Mesmo preço por token do Sonnet 5.5, custo por tarefa bem menor em max.
- Escolha forçada de ferramenta documentada.
- Contexto de 1.050.000 tokens e um conjunto completo de ferramentas da Responses API.
Contras
- Teto menor: 48 no Intelligence Index contra 56 do Sonnet 5.5.
- Prompts acima de 272K tokens de entrada são cobrados a 2x na entrada e 1,5x na saída para a requisição inteira.
- Trocar de fornecedor significa código de SDK novo, ajuste de prompt novo e evals novos.
"Sonnet 5.5 is way better than GPT 6 Sol. Does that even make sense?"
Esse comentário é um contrapeso honesto aos números. Em trabalho difícil de programação, muita gente prefere o Sonnet 5.5, e os benchmarks concordam.
Preços
$2 de entrada, $0.20 em cache, $10 de saída, com Batch e Flex pela metade. O post de preços do GPT-6 Sol e a lista de alternativas ao GPT-6 Sol aprofundam.
Minha opinião: A melhor troca direta para trabalho de alto volume e muitas ferramentas, onde "bom e barato por tarefa" vale mais que "o melhor". Para a qualidade máxima em programação, fique com a Anthropic.
4. Gemini 3.8 Flash
Melhor para: trabalho em lote e multimodal de alto volume em que ninguém espera pelo primeiro token.
O Gemini 3.8 Flash custa $0.75 de entrada e $3.75 de saída por milhão de tokens, tokens de thinking incluídos, até 31 de dezembro de 2026 (preços da API do Gemini). É menos de 40% das tarifas do Sonnet 5.5. Aceita texto, imagem, áudio, vídeo e PDF como entrada, o que o Sonnet não acompanha em áudio e vídeo. Na Artificial Analysis com esforço alto, marcou 41 por $1.24 a tarefa.
Há duas coisas para planejar. O preço dobra para $1.50/$7.50 em 1º de janeiro de 2027. E a Artificial Analysis mediu o tempo até o primeiro token em 13,3 segundos, bem acima da mediana da classe, embora a velocidade de saída esteja entre as melhores. Bom para um trabalho noturno, ruim para uma resposta de chat ao vivo.
Prós
- Bem mais barato por token, com Batch e Flex pela metade de novo.
- Os tipos de entrada mais amplos desta lista.
- Um nível gratuito para prototipar.
Contras
- O preço dobra em três meses.
- O primeiro token lento o descarta para qualquer coisa que uma pessoa espere.
- O Google diz que o 3.8 "works harder" e usa mais tokens, e ainda recomenda o 3.7 Flash para trabalho focado em eficiência.
Preços
$0.75 de entrada, $3.75 de saída, $0.075 de leitura de cache até o fim do ano. Veja os preços do Gemini 3.8 Flash e a análise do Gemini 3.8 Flash.
Minha opinião: Uma escolha forte para processamento de documentos, transcrições e qualquer coisa com vídeo. Orce a mudança de preço de janeiro agora, não em dezembro.
5. Grok 4.7
Melhor para: loops longos de agentes em que tokens de saída mais baratos se acumulam.
O Grok 4.7 custa $2 de entrada e $6 de saída por milhão abaixo de 200K tokens de prompt (preços da xAI). É uma saída 40% mais barata que a do Sonnet 5.5, e a saída é onde os modelos de raciocínio gastam. A xAI o construiu sobre um modelo base maior com um treino de RL mais longo voltado a tarefas de várias horas, e ele quase dobrou o Grok 4.6 no Terminal-Bench 4.0, 37,6 contra 20,3 na tabela da própria xAI. Na Artificial Analysis com xhigh, marcou 46 por $3.74 a tarefa.
Prós
- Saída a
$6, 40% abaixo do Sonnet 5.5. - Contexto de 500K e uma API de Context Compaction para sessões longas.
- Boas notas agênticas nos números de EEBench e Briefcase da xAI.
Contras
- Passou de 200K tokens de prompt, a requisição inteira é cobrada a
$4/$12, não só o excedente. - O Terminal-Bench 4.0 em 37,6 fica bem abaixo dos 70,6 do Sonnet 5.5.
- Leituras em cache a
$0.50custam mais que os$0.20da Anthropic.
Preços
$2 de entrada, $0.50 em cache, $6 de saída abaixo de 200K. O post de preços do Grok 4.7 cobre os medidores de chamadas de ferramenta.
Minha opinião: Vale testar se seus agentes geram muita saída e ficam abaixo de 200K de contexto. Mantenha os prompts enxutos, porque o precipício do contexto longo é íngreme.
6. Qwen 3.8 Max
Melhor para: equipes que querem preço de entrada no nível do Sonnet, saída mais barata e um modelo base para baixar.
O Qwen 3.8 Max custa $2 de entrada e $6 de saída por milhão na Qwen Cloud, com 1M de contexto, 131K de saída máxima e até 262K tokens de raciocínio. É um modelo de mistura de especialistas com 2,4T de parâmetros e 95B ativos. Os pesos base estão no Hugging Face como Qwen3.8-2.4T-A95B, sob uma licença própria da Qwen em vez de Apache.
Vale ler a licença e a lista de recursos juntas. O Max hospedado traz entrada de visão, um modo sem thinking e ferramentas integradas que a base aberta não tem. "Aberto" aqui significa que você pode rodar o modelo base, não que recebe o produto hospedado.
Prós
- Mesmo preço de entrada do Sonnet 5.5, saída 40% mais barata.
- Bons rankings de preferência humana, incluindo o 5º lugar em Texto no LMArena em agosto.
- Um caminho de auto-hospedagem se um dia você precisar.
Contras
- A base aberta não tem os mesmos recursos do modelo hospedado.
- Licença própria, então confira com o jurídico antes de lançar com ela.
- Os dados vão para a nuvem da Alibaba, a menos que você hospede por conta própria.
Preços
$2 de entrada, $6 de saída, $0.25 de leitura de cache implícita. Veja os preços do Qwen 3.8 Max e a análise do Qwen 3.8 Max.
Minha opinião: Uma boa opção intermediária se o preço de saída do Sonnet é o que dói e você quer uma saída futura de qualquer fornecedor único.
7. Kimi K3
Melhor para: equipes que precisam de pesos abertos com visão nativa e estão prontas para rodar hardware pesado.
O Kimi K3 é o carro-chefe da Moonshot AI: 2,8T de parâmetros com 104B ativos, 1M de contexto e compreensão nativa de imagem e vídeo. Os pesos estão no Hugging Face, algo que nenhum dos modelos ocidentais daqui oferece. Na API custa $3 de entrada, $0.30 em cache e $15 de saída por milhão (preços da Moonshot), com escritas de cache cobradas à parte a $3 ou $6 conforme o TTL.
Isso o torna mais caro que o Sonnet 5.5 na API. O motivo para escolhê-lo é o controle, não o custo.
Prós
- Pesos abertos em escala de fronteira, com visão integrada.
- 1M de contexto e saída configurável até 1M de tokens.
- Um caminho de auto-hospedagem para dados que não podem sair da sua rede.
Contras
- Mais caro que o Sonnet 5.5 por token na API hospedada.
- O raciocínio não pode ser desligado em nenhum nível de esforço.
- O repositório de pesos tem cerca de 1,5 TB, então auto-hospedar é trabalho de cluster.
Preços
$3 de entrada, $0.30 em cache, $15 de saída. Veja os preços do Kimi K3 e as alternativas ao Kimi K3.
Minha opinião: Só escolha o Kimi K3 se for mesmo auto-hospedar. Se você vai chamar a API de qualquer jeito, o Sonnet 5.5 em Medium é mais barato e mais fácil.
8. DeepSeek V4.1 Flash
Melhor para: a menor conta possível, e a única licença aberta permissiva desta lista.
O DeepSeek V4.1 Flash custa $0.15 de entrada e $0.60 de saída por milhão fora do pico, e $0.30/$1.20 nos horários de pico (preços da DeepSeek). O nome na API agora é deepseek-flash. Na Artificial Analysis com esforço máximo, marcou 39 por $0.27 a tarefa, calculado a tarifa de pico, então fora do pico fica em cerca de metade disso. Os pesos têm licença MIT.
É também o modelo para o qual a DeepSeek moveu o tráfego do V4 Pro, o que mostra o quanto confiam nele. Suporta chamadas de ferramenta, o formato da API da Anthropic e a Responses API, então uma base de código com o SDK da Anthropic muitas vezes pode apontar para ele trocando a URL base.
Prós
- Cerca de 28x mais barato por tarefa que o Sonnet 5.5 em max, pelos números da AA.
- Pesos MIT e um endpoint compatível com a Anthropic.
- Visão integrada ao modelo principal.
Contras
- Um teto bem menor: 39 no Intelligence Index.
- Os termos da API paga não publicam um acordo de processamento de dados nem uma opção de retenção zero, e os dados são processados na China.
- O preço de pico dobra a tarifa de 01:00-04:00 e 06:00-10:00 UTC em dias úteis.
"I have been using DeepSeek since forever and it's so good I was able to write a compiler and native desktop applications with it."
Preços
Fora do pico $0.15 de entrada, $0.60 de saída, $0.003 por acerto de cache; no pico é o dobro. Veja os preços do DeepSeek V4.1 Flash.
Minha opinião: Excelente para ferramentas internas, geração de código e trabalhos em lote. Para qualquer coisa que carregue dados de clientes, pense duas vezes nos termos de dados antes de olhar o preço.
O que os desenvolvedores dizem sobre o Sonnet 5.5 frente ao resto
A thread de lançamento no Hacker News chegou a 556 comentários, e a divisão foi clara. As pessoas gostam da velocidade e do salto nos benchmarks. Não têm certeza de onde ele se encaixa ao lado do Opus 5.5.
"Per the charts, there is largely no point to using Sonnet 5.5 at high+ as opus low generally will give similar performance at similar or lower cost. But Sonnet 5.5 at medium and below gives you a cheaper option at a performance worse than the lowest thinking Opus (low), which may be viable for "low intelligence" use cases."
O padrão em que várias pessoas se acomodaram não é "deixar o Sonnet 5.5" de jeito nenhum. É dividir o trabalho: o Opus planeja, o Sonnet constrói em Low ou Medium, o Opus finaliza. Um comentarista resumiu como "80% Sonnet 5.5, Opus 5.5 to finish the last 20%" (vektormemory no Hacker News). Se isso combina com a sua configuração, o guia de subagentes do Claude Code mostra como montar.
Há também uma regressão de qualidade que vale conhecer. Um desenvolvedor rodando um benchmark adversarial viu o Sonnet 5.5 marcar 7,4% contra 17,8% do Sonnet 5, porque ele "returns to ask the user questions whether to keep going" (dom96 no Hacker News). Para um agente sem supervisão, é uma mudança de comportamento que você deve testar.
Trocar é um problema de suporte, não só de modelo
Todo modelo desta lista lançará uma versão nova em poucos meses, e algumas dessas versões quebrarão algo. O Sonnet 5.5 chegou com cinco mudanças incompatíveis. O preço do Gemini 3.8 Flash dobra em janeiro. O Haiku 4.5 tem uma data de aposentadoria em duas semanas. Seja qual for a sua escolha hoje, alguém da sua equipe é dono de retestar no próximo trimestre.
É a parte que os compradores subestimam. Em uma chamada de vendas da eesel que revisei, um comprador atento ao orçamento, de uma pequena empresa de hardware, disse que já tinha se queimado quando o preço de um fornecedor anterior "more than doubled", e que queria travar o preço em contrato antes de assinar qualquer coisa. A camada de modelos tem o mesmo risco, só que em um relógio mais rápido.
Para uma fila de suporte especificamente, é aqui que eu deixaria de escolher modelos. A eesel roda colegas de IA em filas de helpdesk ao vivo, e cada implantação é simulada com os tickets históricos da equipe antes de responder a um cliente de verdade. Quando o modelo por baixo muda, essa simulação é como você encontra a regressão no estilo de chamadas forçadas de ferramenta antes que um cliente encontre. O panorama do melhor modelo para tickets de suporte compara os modelos nessa tarefa, e o guia do custo de um agente de suporte com IA cobre o lado do orçamento.
Experimente a eesel se o modelo vai para o seu helpdesk
Um modelo bruto é infraestrutura. Você o escolhe, liga suas chamadas de ferramenta, escreve os evals e os roda de novo quando uma mudança incompatível chega. A eesel é o funcionário por cima: um colega de IA para helpdesk que entra no seu Zendesk ou outro helpdesk, aprende com seus tickets anteriores e sua central de ajuda, e é testado com seus tickets históricos antes de responder a qualquer pessoa. Você nunca define tool_choice, e a mudança incompatível de um modelo é algo que a eesel absorve em vez da sua fila de suporte.
Se você chegou aqui de um terminal, a CLI da eesel controla o mesmo colega. Instale com npm i -g @eesel/cli, conecte um helpdesk com eesel integrations connect, edite as regras permanentes com eesel instructions e leia cada execução como JSON com eesel activity. As escritas aceitam --dry-run, e cada workspace também é um servidor MCP, então Claude Code, Codex ou Cursor podem operá-lo por você. É o controle programável que você gostaria de ter numa API de modelo, apontado para um colega que já faz o trabalho.

Os preços da eesel são um plano fixo mensal de créditos, com um nível gratuito para testar nos seus próprios tickets. Experimente a eesel e veja sua fila respondida sem escolher um modelo antes.
Perguntas frequentes
Qual é a melhor alternativa ao Claude Sonnet 5.5?
Existe alguma alternativa ao Claude Sonnet 5.5 que suporte uso forçado de ferramentas?
tool_choice com any ou com uma ferramenta específica, e não tem aposentadoria antes de 30 de junho de 2027. GPT-6 Sol, Gemini 3.8 Flash e Grok 4.7 também forçam chamadas de ferramenta. Atenção: o Claude Opus 5.5 também rejeita isso, então subir na linha Claude não resolve. O guia da API de helpdesk com IA mostra onde as chamadas forçadas importam no suporte.O Claude Opus 5.5 é mais barato que o Claude Sonnet 5.5?
Qual é a alternativa mais barata ao Claude Sonnet 5.5?
Existem alternativas open source ao Claude Sonnet 5.5?
Posso trocar do Claude Sonnet 5.5 para outro modelo no meio de uma conversa?
Qual alternativa ao Claude Sonnet 5.5 é melhor para um bot de atendimento ao cliente?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.