As 8 melhores alternativas ao Laya AI em 2026

Rama Adi

Katelin Teen
Última edição September 21, 2026
Por que as pessoas procuram alternativas ao Laya AI
Eu construo integrações e APIs para viver, então tenho um carinho pelo Laya. O design é engenharia honesta: em vez de pedir a um modelo autorregressivo gigante que "responda só em JSON" e rezar, o Laya roda um encoder bidirecional sobre o seu estado, avalia perguntas tipadas em uma única passada e devolve probabilidades calibradas. Sem geração de tokens, não há campos alucinados nem JSON malformado, por construção. É Apache 2.0, roda a US$ 0,00 por 1M de tokens auto-hospedado e é posicionado como a resposta aberta ao Jev fechado da TypeSafe.
O problema começa na própria seção de limitações do Laya, em que o tópico do Hacker News se concentrou de imediato. Fora da caixa, o modelo base pontua cerca de 0,35 no benchmark de decisões tipadas, mal acima da linha de base aleatória de 0,318. O impressionante 0,766 só aparece depois do fine-tuning na partição de treino do benchmark. É um asterisco enorme, e os profissionais no tópico disseram isso sem rodeios:
"Idk, your limitations section sure makes it seem less drop in and less general than Jev. Like the point here isn't your ML aptitude it's how easy is it for developers to drop this into a product and use it. I'm more than capable of training a bert classifier... I don't want to manage GPUs / CPUs now. I don't want to maintain my corpus and retrain as my product's data distribution shifts... I do just want a reasonably good general classifier served to me with a great devex and calibrated confidence scores."

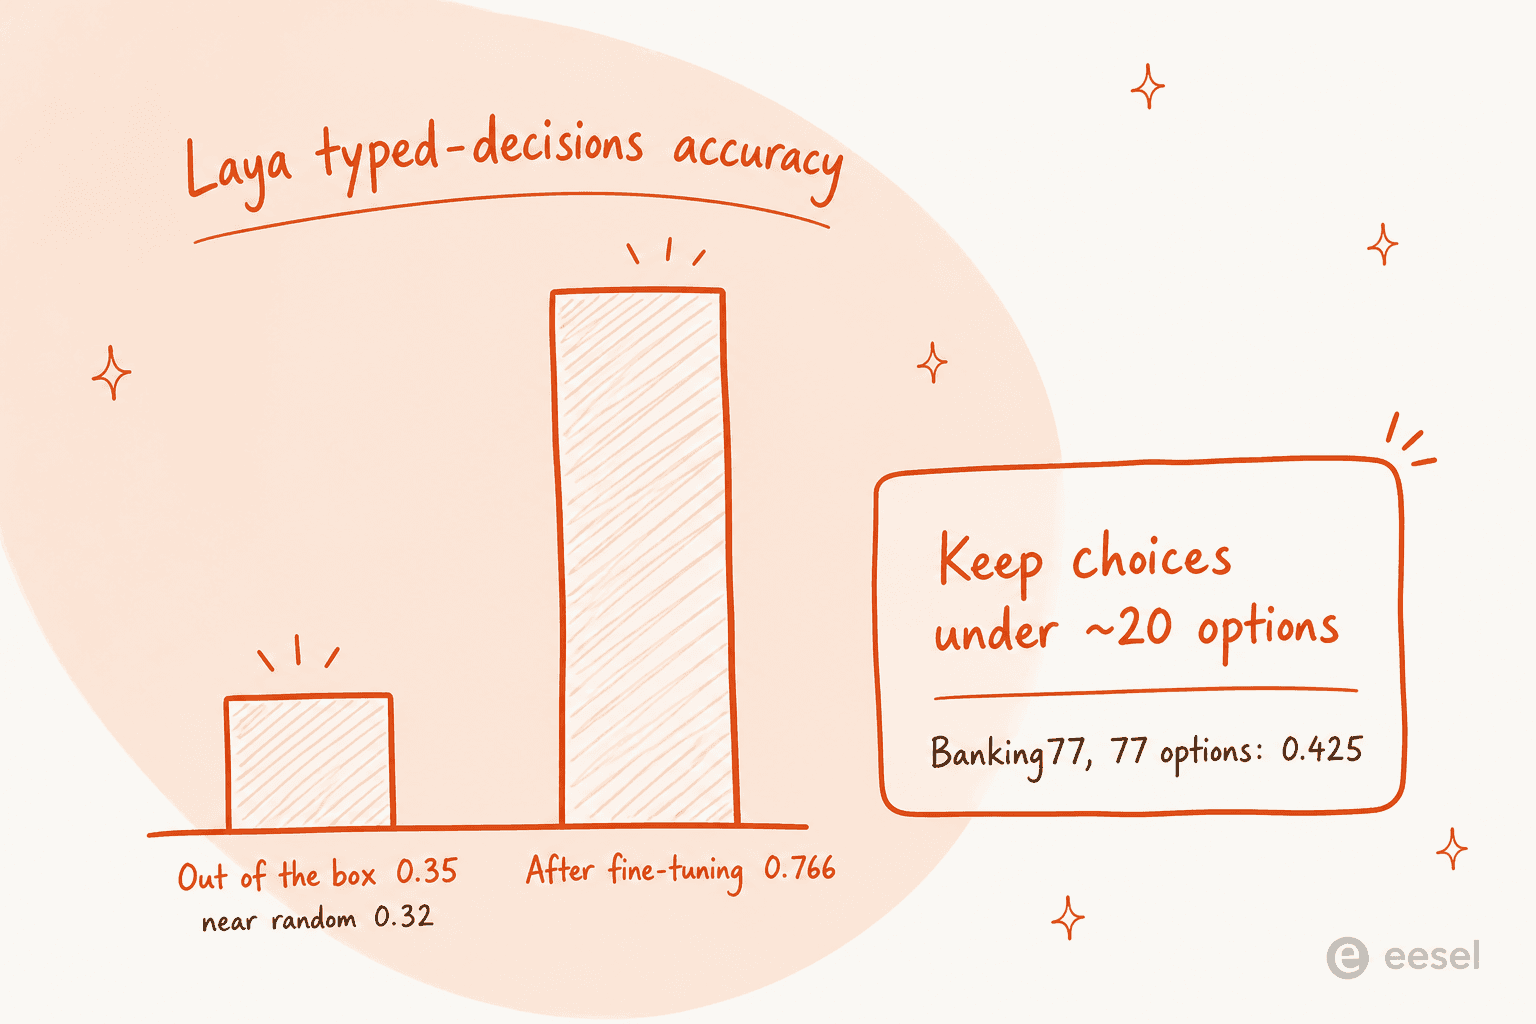
Há um segundo teto que vale conhecer antes de se comprometer. As perguntas de escolha do Laya pioram a partir de cerca de 20 opções, porque os rótulos candidatos dividem um orçamento fixo de tokens. No Banking77, um conjunto de intenções com 77 rótulos, o Laya fez 0,425 enquanto o Jev chegou a 0,870. Muitos problemas reais de roteamento têm mais de 20 categorias, então não é um caso extremo para todo mundo.
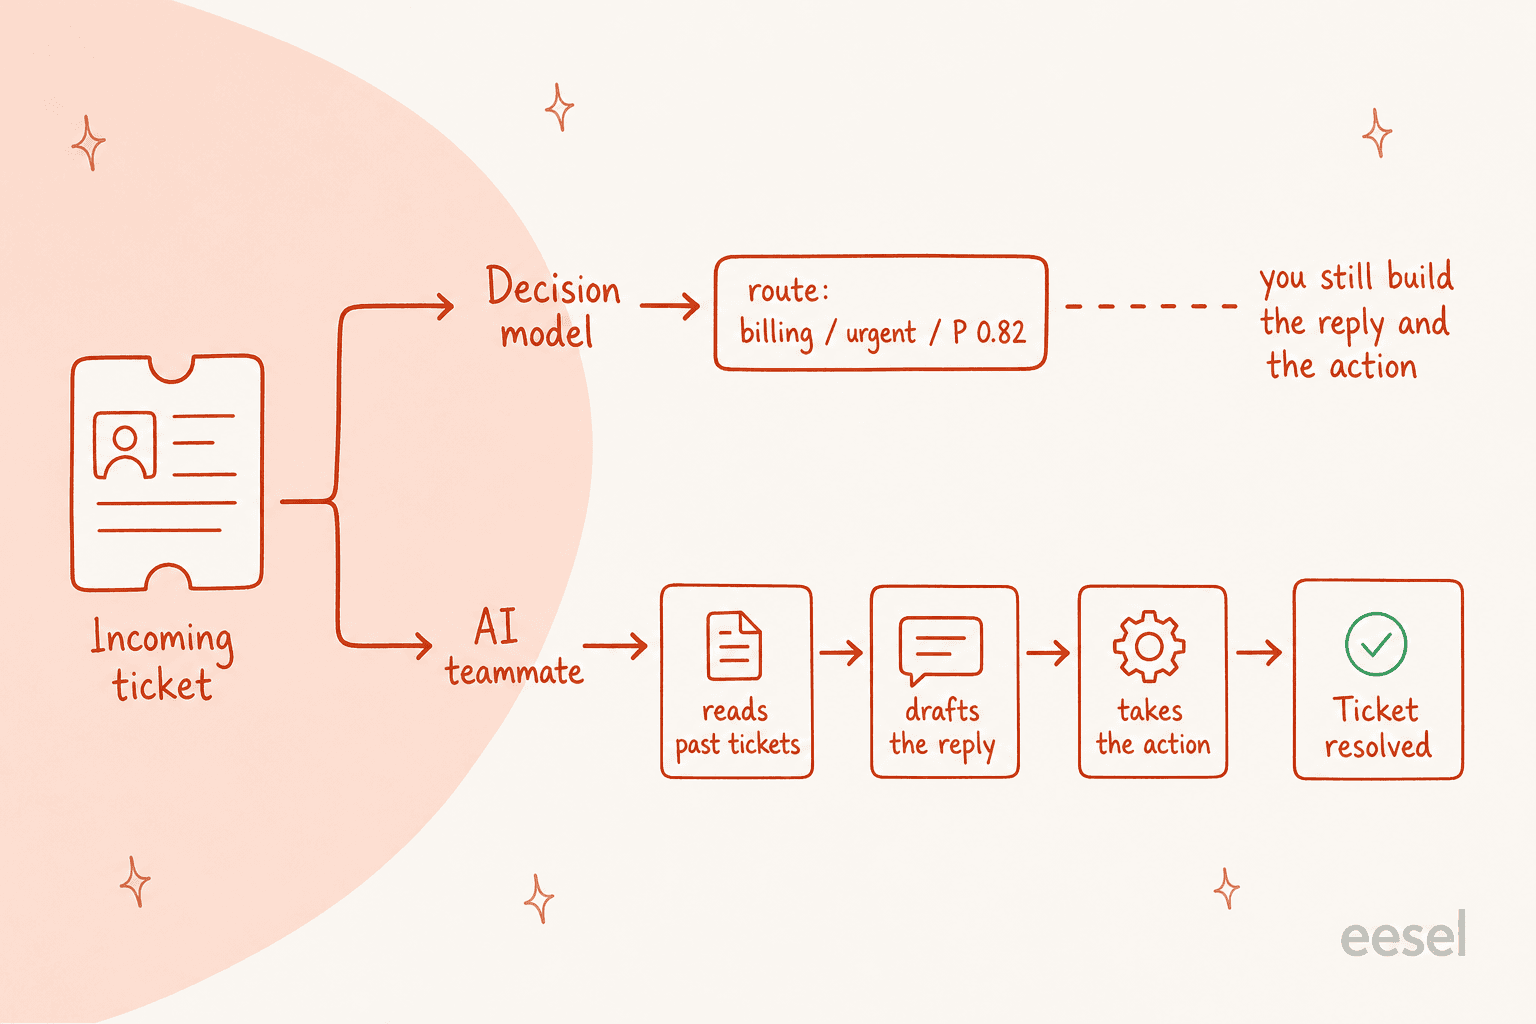
E então o ponto de enquadramento, o que mais me importa. Mesmo no melhor cenário, o Laya responde a uma pergunta. Ele diz este ticket é de cobrança, urgente, P(0,82). Não escreve a resposta, não reembolsa o pedido nem escala para uma pessoa. Tudo bem se você vai construir o produto em volta, e é um impeditivo se você achava que estava comprando um resultado. Um comentarista resumiu bem o apelo de toda a categoria:
"The ability to knock out any arbitrary classification problem in minutes instead of in a week is a big deal... I don't want to spend a week to create a dataset, finetune a model, and set up infrastructure to run the model, every time I have a small routing or classification problem."
Essa é a tensão que cada alternativa abaixo resolve de um jeito: quanto você quer rodar por conta própria, e se você quer uma decisão ou uma resolução.
Como escolhi essas alternativas
Avaliei cada opção em cinco critérios:
- O que ela realmente faz - classificador puro, API de decisão tipada, biblioteca de saída restrita ou um colega completo que age.
- Auto-hospedado vs. gerenciado - você roda os pesos ou chama um endpoint?
- A história da confiança - dá para confiar na pontuação o bastante para agir automaticamente, ou é uma caixa-preta? Todo o argumento do Laya é calibração, então as alternativas são medidas por essa régua.
- Custo real - licença, preço por chamada e o tempo de engenharia que ninguém coloca no orçamento.
- Alcance multilíngue - o Laya cobre mais de 100 idiomas, então equipes de suporte globais precisam saber do que abririam mão.
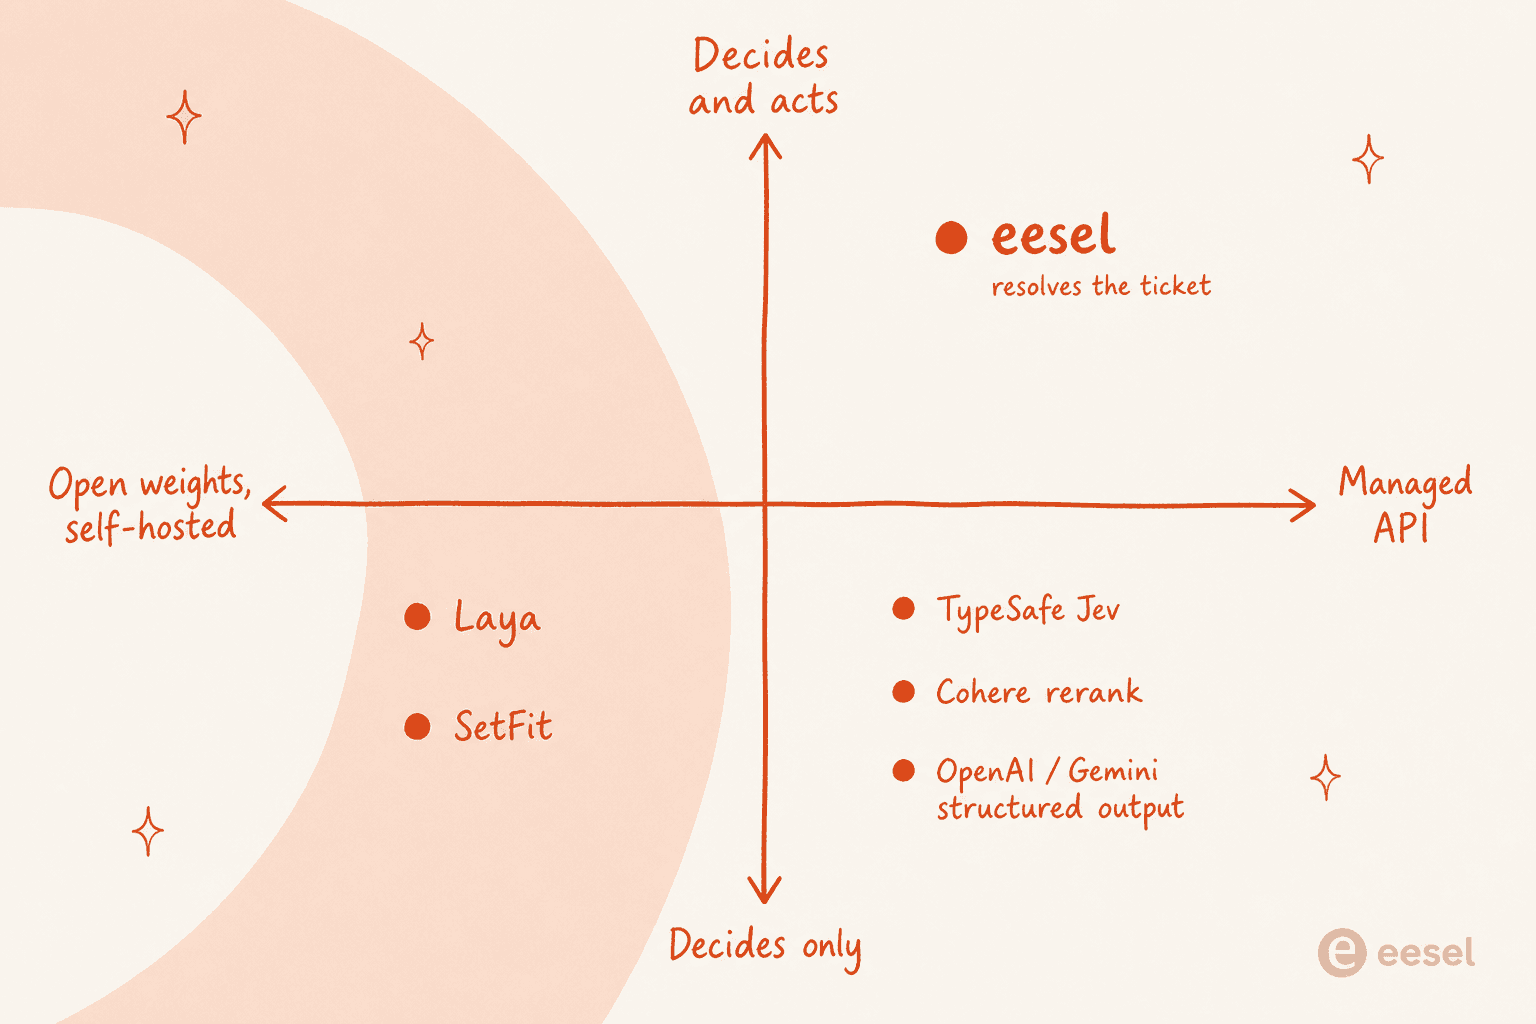
Aqui está o panorama em uma imagem antes de entrarmos em cada ferramenta.
Alternativas ao Laya AI em resumo
| Ferramenta | Melhor para | Tipo | Auto-hospedável? | Decide ou age | Unidade de cobrança | Preço inicial |
|---|---|---|---|---|---|---|
| eesel | Resolver de fato tickets de suporte | Colega de IA | Gerenciado | Decide e age | Planos de créditos a partir de US$ 299/mês | Plano gratuito (100 créditos) |
| TypeSafe Jev | Um gêmeo gerenciado do Laya | API de decisão | Gerenciado | Decide | Por 1M de tokens | US$ 0,042 / 1M de entrada, saída grátis |
| SetFit | Classificação few-shot própria | Classificador OSS | Sim | Decide | Nenhuma (computação) | US$ 0 (Apache 2.0) |
| Cohere | Relevância RAG + classificação | API gerenciada | Opção VPC / on-prem | Decide | Por busca / por 1M | ~US$ 2,00 / 1K buscas |
| OpenAI Structured Outputs | Equipes que já usam GPT | Recurso de LLM | Gerenciado | Decide | Por 1M de tokens | Sem acréscimo sobre o modelo |
| Google Gemini | Classificação estruturada gerenciada mais barata | Recurso de LLM | Gerenciado | Decide | Por 1M de tokens | Flash-Lite é o mais barato |
| Outlines / Instructor | Segurança de esquema sobre o seu próprio LLM | Bibliotecas OSS | Sim | Decide | Nenhuma (computação) | US$ 0 (Apache-2 / MIT) |
| Cloudflare Workers AI | Inferência na borda, inclusive Jev | Catálogo gerenciado | Gerenciado | Decide | Neurons | Nível gratuito, depois por uso |
1. eesel
Melhor para: equipes que percebem que a decisão era só o passo um, e o que realmente precisam é do ticket de suporte resolvido.
Serei honesto desde o início, porque o skill de blog sob o qual escrevo insiste nisso: a eesel não é um modelo de decisão, e se você precisa especificamente de uma primitiva de classificação tipada de 33 ms para encaixar no seu próprio pipeline, uma das ferramentas abaixo é uma troca literal melhor. Mas a maioria das pessoas que avalia o Laya para suporte não quer um rótulo, quer o resultado ao qual o rótulo deveria levar. Esse é o vazio que a eesel preenche.

A eesel é uma plataforma de colegas de IA: você contrata colegas prontos para trabalhar em tarefas específicas, e o time atual é um colega de helpdesk com IA e um redator de blog com IA. O colega de helpdesk faz o ciclo inteiro que um modelo de decisão não consegue: lê anos de tickets anteriores e a sua central de ajuda, redige a resposta, executa a ação e encaminha ou escala quando não tem certeza. O roteamento é um recurso dele, não o produto inteiro.
É aqui que nossos anos rodando IA em filas de suporte reais importam para esta comparação. Os próprios dados do Laya mostram algo que merece uma pausa: no teste multilíngue, o modelo em inglês teve 0,000 de precisão em khmer enquanto relatava 0,952 de confiança média. Um modelo pode estar confiantemente e calibradamente errado. Aprendemos isso do jeito difícil vendo bots darem respostas seguras e totalmente erradas, e é exatamente por isso que cada implantação da eesel é simulada com seus tickets históricos antes de tocar em qualquer conversa ao vivo. Você vê primeiro a taxa real de resolução automática nos seus próprios dados, não um número de benchmark.
Para os desenvolvedores que gostaram da programabilidade do Laya, a eesel expõe o mesmo colega pela CLI da eesel e por MCP, então você pode instalá-lo, conectar fontes de conhecimento, definir instruções, rodar uma simulação e checar a atividade num terminal ou script. Agentes de código como Claude Code, Codex e Cursor podem operá-lo do mesmo jeito. É o mesmo colega que um líder de suporte não técnico configura no painel, só que operado como código.
Prós:
- Decide e resolve, em Zendesk, Freshdesk, Slack, e-mail e mais de 100 outras ferramentas.
- Simula com o seu histórico real de tickets antes de entrar no ar, então a confiança se apoia nos seus dados.
- Treinável em linguagem natural, além de uma superfície completa de CLI e MCP para o pessoal que programa.
Contras:
- Não é uma primitiva de classificação pura; se você realmente precisa de uma única chamada de modelo no seu próprio stack, o formato é errado.
- É um colega gerenciado, não pesos que você possa rodar isolados da rede.
Preço: Grátis para começar, depois um valor mensal fixo a partir de US$ 299/mês por 500 créditos (1 crédito por ticket ou chat), então você paga por tickets atendidos e não por token adivinhado.
Veredito: se a decisão de roteamento sempre foi para resolver uma fila de suporte, pule a primitiva e contrate o colega. Se você realmente precisa de um classificador independente, continue lendo.
2. TypeSafe Jev
Melhor para: exatamente o caso de uso do Laya, mas gerenciado, sem nada para ajustar ou hospedar por conta própria.
O Jev é o modelo ao qual o Laya foi feito para responder, então é a alternativa mais natural da lista. A TypeSafe, fundada por Diogo Almeida (coinventor do RLHF na OpenAI), o chama de primeiro "modelo System 1" público: você envia estado não estruturado mais perguntas tipadas, e ele devolve decisões probabilísticas tipadas em uma passada paralela, com as mesmas três primitivas que o Laya tomou emprestadas: noul, choice e score.
A troca em relação ao Laya é clara. O Jev é fechado e pago, mas é realmente plug-and-play, sem etapa de treino, exatamente o que o pessoal do Hacker News repetia que faltava ao Laya. Os benchmarks do Laya afirmam que ele é 7,8x mais rápido e melhor calibrado que o Jev, mas são números do Laya no setup do Laya, e só valem após o fine-tuning que o Jev não exige de você. Numa tarefa de 77 classes, lembre-se, o Jev na verdade venceu o Laya por 0,870 a 0,425.
Prós:
- Sem pesos, sem GPU, sem fine-tuning, a experiência plug-and-play que o Laya não oferece.
- Forte em tarefas de escolha de alta cardinalidade onde o Laya despenca.
- Tokens de saída são grátis, então decisões com muita leitura saem baratas.
Contras:
- Fechado e proprietário, sem opção isolada ou on-prem.
- Ainda em acesso antecipado, sem página pública de preços além da tarifa abaixo, e com lista de espera.
Preço: US$ 0,042 por 1M de tokens de entrada, saída grátis, cobrado pela API.
Veredito: se você gostou do conceito do Laya mas não da lição de casa de fine-tuning nem da GPU, o Jev é a versão gerenciada da mesma ideia. Só saiba que você troca abertura por conveniência. Para um comparativo completo do lado gerenciado, meu guia de alternativas ao Jev vai mais fundo.
3. SetFit
Melhor para: equipes que topam rotular alguns exemplos e treinar, e querem um classificador totalmente seu.
Se a exigência de fine-tuning do Laya é o problema, o SetFit a reformula como o recurso. É um framework da Hugging Face (com a Intel Labs e o UKP Lab) para classificação de texto few-shot: ele faz fine-tuning contrastivo do corpo de um sentence-transformer e depois treina uma pequena cabeça de classificação sobre os embeddings. Sem prompts, sem verbalizers.
O resultado de destaque é a parte boa: com apenas 8 exemplos rotulados por classe, o SetFit é competitivo com o fine-tuning do RoBERTa Large num conjunto completo de 3.000 exemplos, com uma ordem de grandeza menos parâmetros e treino bem mais rápido. Roda em CPU ou numa GPU modesta, é Apache-2.0, e o suporte multilíngue vem de graça ao trocar por um corpo de sentence-transformer multilíngue. Como você ia fazer fine-tuning no Laya de qualquer jeito, o SetFit é provavelmente o caminho mais maduro e melhor documentado para o mesmo destino de "classificador pequeno e rápido".
Prós:
- Realmente few-shot, ~8 exemplos por classe já colocam você em movimento.
- Totalmente aberto (Apache-2.0), auto-hospedado, inferência a US$ 0, igual ao Laya.
- Pequeno o bastante para treinar e servir em hardware comum.
Contras:
- Só classificador, sem API de "decisões" calibrada, sem primitivas noul/choice/score.
- Sem roteador de idiomas embutido; você escolhe o corpo multilíngue.
- Você ainda traz dados rotulados e roda o ajuste em duas etapas.
Preço: grátis, Apache-2.0. pip install setfit e pronto.
Veredito: o irmão de espírito open source mais próximo do Laya para classificação. Se a camada de confiança calibrada e o roteador multilíngue não são decisivos, o SetFit é um jeito com menos drama de ter um classificador próprio.
4. Cohere
Melhor para: as tarefas de relevância RAG e classificação para as quais as pessoas recorrem ao Laya, entregues como uma API gerenciada e amigável para empresas.
Vários dos casos de uso de vitrine do Laya, sobretudo a filtragem de relevância de trechos RAG, são exatamente o que a Cohere domina discretamente há anos. Seus modelos Rerank pontuam o quão relevante cada trecho é para uma consulta, e seus endpoints Embed e Classify cuidam do trabalho de "em que categoria este texto se encaixa", tudo sem você treinar ou hospedar nada.
A pilha de recuperação da Cohere é a parte que os profissionais realmente adoram. As equipes costumam descrever o Rerank como o motivo de ficarem, mesmo quando geram com o modelo de outro fornecedor, porque o ranqueamento por relevância é o trabalho para o qual ele foi feito.
Onde difere do Laya: é uma API gerenciada, não pesos, embora a Cohere seja incomumente flexível nesse ponto, oferecendo implantações "Model Vault" em VPC e on-prem para equipes que precisam manter os dados no lugar. É um meio-termo que o Laya (totalmente auto-hospedado) e o Jev (totalmente fechado) não oferecem.
Prós:
- O Rerank é o melhor da categoria em relevância RAG, um caso de uso de destaque do Laya.
- Suporte a mais de 100 idiomas no Embed 4 e no Rerank 4.
- Opção VPC / on-prem para equipes reguladas, além de um nível gratuito para desenvolvedores.
Contras:
- Gerenciado e cobrado por uso por padrão, não o auto-hospedado a US$ 0 que o Laya oferece.
- Voltado a empresas, então colocar a pilha de recuperação em produção é trabalho real de engenharia, não uma instalação de uma linha.
Preço: Rerank 4 Fast custa US$ 2,00 / 1K buscas, Rerank 4 Pro US$ 2,50 / 1K, Embed 4 US$ 0,12 / 1M de tokens (texto). Nível de teste gratuito para desenvolvedores.
Veredito: se o que você queria do Laya era ranqueamento por relevância ou classificação e prefere não rodar uma GPU, a Cohere é a resposta gerenciada e madura, principalmente se você precisa de uma opção on-prem.
5. OpenAI Structured Outputs
Melhor para: equipes que já usam GPT e querem decisões tipadas com esquema garantido sem adicionar um modelo novo.
Você não precisa estritamente de um modelo de decisão dedicado para obter saída tipada. O recurso Structured Outputs da OpenAI faz um modelo GPT-5.6 seguir um JSON Schema que você fornece, de modo que a resposta tem garantia de corresponder aos seus tipos (ou devolve uma recusa explícita), e se encaixa direto em Pydantic ou Zod.
A ressalva honesta é a que todo o debate sobre "não consegue alucinar" girou: válido pelo esquema não é o mesmo que correto. Um modelo pode entregar uma resposta perfeitamente tipada que simplesmente está errada, e ao contrário do Laya, um LLM geral dá um sinal de confiança mais difuso (você pode ler logprobs, mas não é a distribuição calibrada que o Laya foi feito para produzir). Você também paga a latência e o custo completos de um LLM por chamada, o exagero de mais de 500 ms que o Laya se propôs explicitamente a substituir em decisões simples de reflexo.
Prós:
- Nenhum modelo novo a adotar se você já usa a OpenAI.
- Aderência garantida ao esquema, com recusas explícitas por segurança.
- O Structured Outputs em si não acrescenta nada à tarifa base de tokens.
Contras:
- Custo e latência completos de LLM para o que o Laya faz em 33 ms.
- Confiança via
logprobsé uma aproximação, não probabilidades de decisão calibradas.
Preço: sem acréscimo pelo recurso, você paga as tarifas de tokens do modelo subjacente (os GPT-5.6 de ponta vão de US$ 0,20 a US$ 5,00 por 1M de entrada).
Veredito: o caminho de menor resistência se o GPT já está no seu stack e o volume de decisões é modesto. Em alto volume, o custo por chamada é exatamente o que empurra as pessoas para um modelo de decisão feito sob medida.
6. Google Gemini
Melhor para: o caminho gerenciado mais barato para classificação estruturada, com um modelo que a cita como caso de uso de primeira classe.
A saída estruturada do Gemini funciona no mesmo princípio da da OpenAI: você passa um esquema de resposta e o Gemini o segue, e a documentação do Google cita explicitamente a "classificação estruturada" como caso de uso suportado, e não como um truque.
O Gemini ganha seu próprio espaço sobre a OpenAI pelo preço na ponta de baixo: o nível Flash-Lite mira em classificação de alto volume e baixo custo, que é a pressão econômica que leva as pessoas ao Laya em primeiro lugar. Se você quer decisões estruturadas gerenciadas mas a conta de tokens de um modelo de ponta assusta, os modelos pequenos do Gemini são a alavanca gerenciada mais barata aqui. Vale a mesma ressalva de "tipado, mas não necessariamente correto" da seção da OpenAI: é um LLM geral, não um modelo de decisão calibrado.
Prós:
- Classificação estruturada é um caso de uso documentado e de primeira classe.
- O preço do Flash-Lite é feito para decisões baratas de alto volume.
- Grande cobertura multilíngue sem configuração extra.
Contras:
- Ainda há latência de LLM e um sinal de confiança aproximado, não a calibração do Laya.
- Prende você à superfície de API do Google.
Preço: sem acréscimo pelo recurso sobre as tarifas de tokens dos modelos Gemini, com o Flash-Lite como nível mais barato.
Veredito: a melhor escolha gerenciada quando o custo por decisão é tudo e você não precisa de confiança calibrada. Na prática, a saída estruturada da OpenAI com um piso mais barato.
7. Outlines e Instructor
Melhor para: equipes que querem manter o próprio LLM (aberto ou hospedado), mas impor um esquema na decodificação.
Se a sua objeção ao Laya é "não quero um modelo separado, só quero que meu modelo atual pare de devolver lixo", duas bibliotecas open source resolvem isso diretamente. O Outlines (da dottxt) impõe a estrutura na decodificação, então o modelo só pode emitir tokens que se encaixem no seu esquema, funcionando com OpenAI, Ollama e vLLM. O Instructor envolve as chamadas ao modelo com Pydantic e validação, e virou o jeito padrão de obter saída tipada em mais de 15 provedores.
Esses não são modelos de decisão, são proteções em volta do modelo que você já roda. Essa é a força deles (traga seus próprios pesos, sem nova dependência para servir) e o limite (você herda a latência, o custo e a falta de confiança calibrada do seu modelo base). O Outlines é Apache-2, o Instructor é MIT, ambos grátis. Note que a dottxt também vende uma API hospedada paga sobre a biblioteca aberta, caso você prefira não rodá-la.
Prós:
- Mantenha seu modelo atual, só torne a saída segura em tipos.
- Totalmente abertos (Apache-2 / MIT), auto-hospedados, projetos ativos.
- A imposição na decodificação do Outlines é realmente difícil de quebrar.
Contras:
- Não é um modelo, sem ganho de velocidade ou custo sobre o LLM por baixo.
- Sem probabilidades de decisão calibradas, sem roteador multilíngue.
Preço: grátis e de código aberto. O Outlines tem uma API hospedada da dottxt paga se você a quiser gerenciada.
Veredito: a ferramenta certa se o problema real era segurança de esquema, não velocidade de decisão. Combine com um modelo local pequeno e você obtém a maior parte da garantia de "nunca malformado" do Laya sem adotar um modelo novo.
8. Cloudflare Workers AI
Melhor para: equipes que querem modelos pequenos (incluindo o próprio Jev) rodando na borda, cobrados por uso.
O Cloudflare Workers AI é um bicho um pouco diferente: um catálogo de mais de 65 modelos hospedados que você roda na borda, perto dos seus usuários, sem infraestrutura própria. É relevante aqui por um motivo específico: ele hospeda o typesafe/jev, então se o conceito de modelo de decisão é o que você procura, a Cloudflare é uma das formas de realmente chamá-lo.
O argumento contra auto-hospedar o Laya é latência e operação: sua decisão roda num local de borda perto da requisição, e você nunca encosta numa GPU. O argumento contra o custo de US$ 0 do Laya é a honestidade: você paga por uso (na unidade "Neurons" da Cloudflare), embora haja um nível gratuito para começar. É menos uma troca equivalente do Laya e mais uma superfície de implantação para toda a categoria.
Prós:
- Inferência na borda, baixa latência de rede, zero infraestrutura para gerenciar.
- Hospeda o Jev e dezenas de outros modelos pequenos numa única superfície de cobrança.
- Nível gratuito, depois medição transparente baseada em Neurons.
Contras:
- Cobrado por uso, não o auto-hospedado gratuito que o Laya dá.
- Você escolhe do catálogo da Cloudflare, não roda pesos personalizados arbitrários.
Preço: franquia gratuita, depois medido em Neurons.
Veredito: mais uma resposta de "onde rodar" do que de "o que rodar". Se latência na borda e zero operação importam mais que o último centavo, é uma forma limpa de implantar um modelo de decisão sem GPU.
Qual você deve realmente escolher?
O mapa lá do topo diz melhor: suas duas perguntas reais são quanto você quer rodar por conta própria e se você quer uma decisão ou uma resolução. Este pequeno seletor leva você à lista curta.
Experimente a eesel
Se você encontrou o Laya tentando deixar uma fila de suporte mais inteligente, aqui vai o atalho: a decisão de roteamento nunca foi o objetivo, fechar o ticket era. A eesel é o colega de helpdesk com IA que faz a triagem e age sobre ela, redigindo a resposta, executando a ação e escalando quando não tem certeza, ao vivo dentro de Zendesk, Freshdesk, Slack e mais de 100 outras ferramentas.
A parte que responde à maior ressalva do Laya: como um modelo confiante ainda pode estar errado, a eesel simula cada implantação nos seus tickets históricos antes de tocar num cliente real, então você vê a verdadeira taxa de resolução nos seus dados, não num benchmark. E para os desenvolvedores que gostaram da programabilidade do Laya, a CLI e o MCP da eesel deixam você operar o mesmo colega a partir de um terminal, um script ou um agente de código. Comece grátis.