

A melhor alternativa ao Qwen 4 Max para a maior parte do trabalho de código e agentes é o Claude Sonnet 5.5, a US$ 2/US$ 10 por milhão de tokens, com o Claude Opus 5.5 para tarefas difíceis e o DeepSeek V4.1 Flash (US$ 0,15/US$ 0,60 fora do horário de pico) para trabalho em massa. Mas confira uma coisa antes de trocar: a Alibaba lançou o GA qwen4-max em 16 de novembro, a US$ 1,50/US$ 4,50. Se você gostava da prévia, trocar um único ID de modelo custa menos do que qualquer outra mudança.
Se a prévia estava rodando um bot de suporte, a eesel faz esse trabalho sem que você precise escolher um modelo, e a CLI da eesel permite que um agente de código carregue sua documentação de ajuda e teste respostas antes de ir ao ar.
O que acontece com o Qwen 4 Max em 25 de novembro?
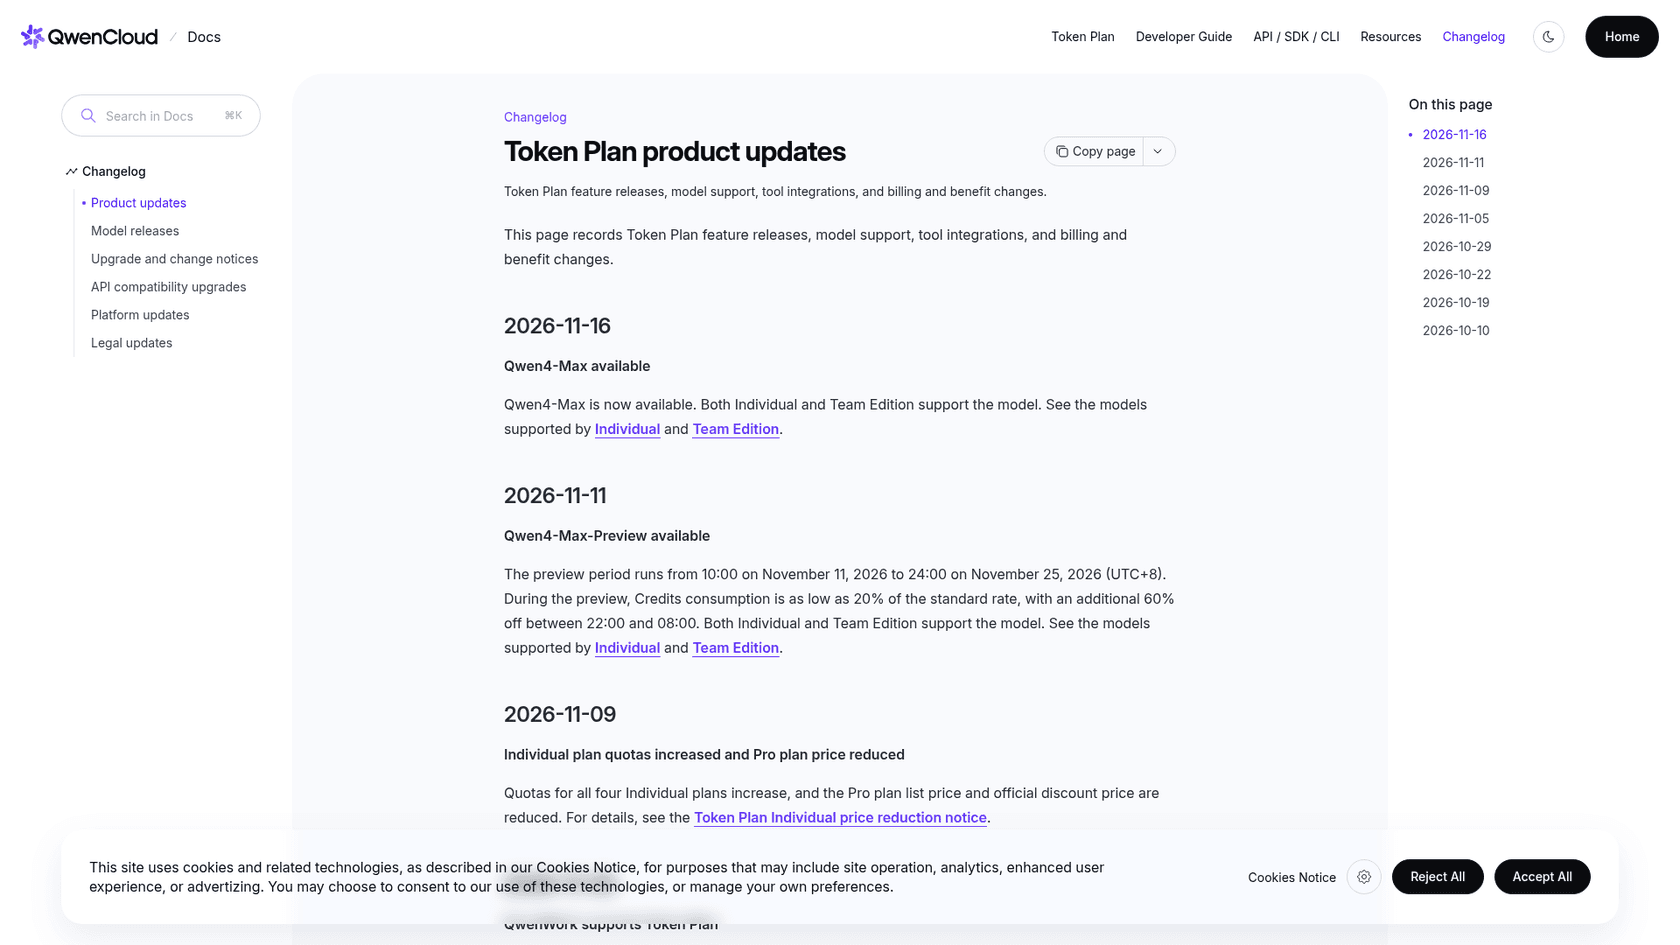
A prévia é desativada. O changelog do Token Plan da Alibaba diz que o qwen4-max-preview roda das 10h00 de 11 de novembro até as 24h00 de 25 de novembro de 2026 (UTC+8), e a documentação do Token Plan diz que o modelo será desativado quando a prévia terminar. Qualquer agente, script ou configuração do Claude Code que ainda apontar para esse ID para de funcionar no dia 26.
O que a maioria das coberturas deixa passar é a próxima entrada no mesmo changelog. Em 16 de novembro, a Alibaba colocou o qwen4-max em disponibilidade geral (GA) no Token Plan Personal, Token Plan Team e na API por uso. Então a pergunta não é mais "Qwen ou outra coisa". É "o Qwen GA, ou algo melhor para a minha carga de trabalho".
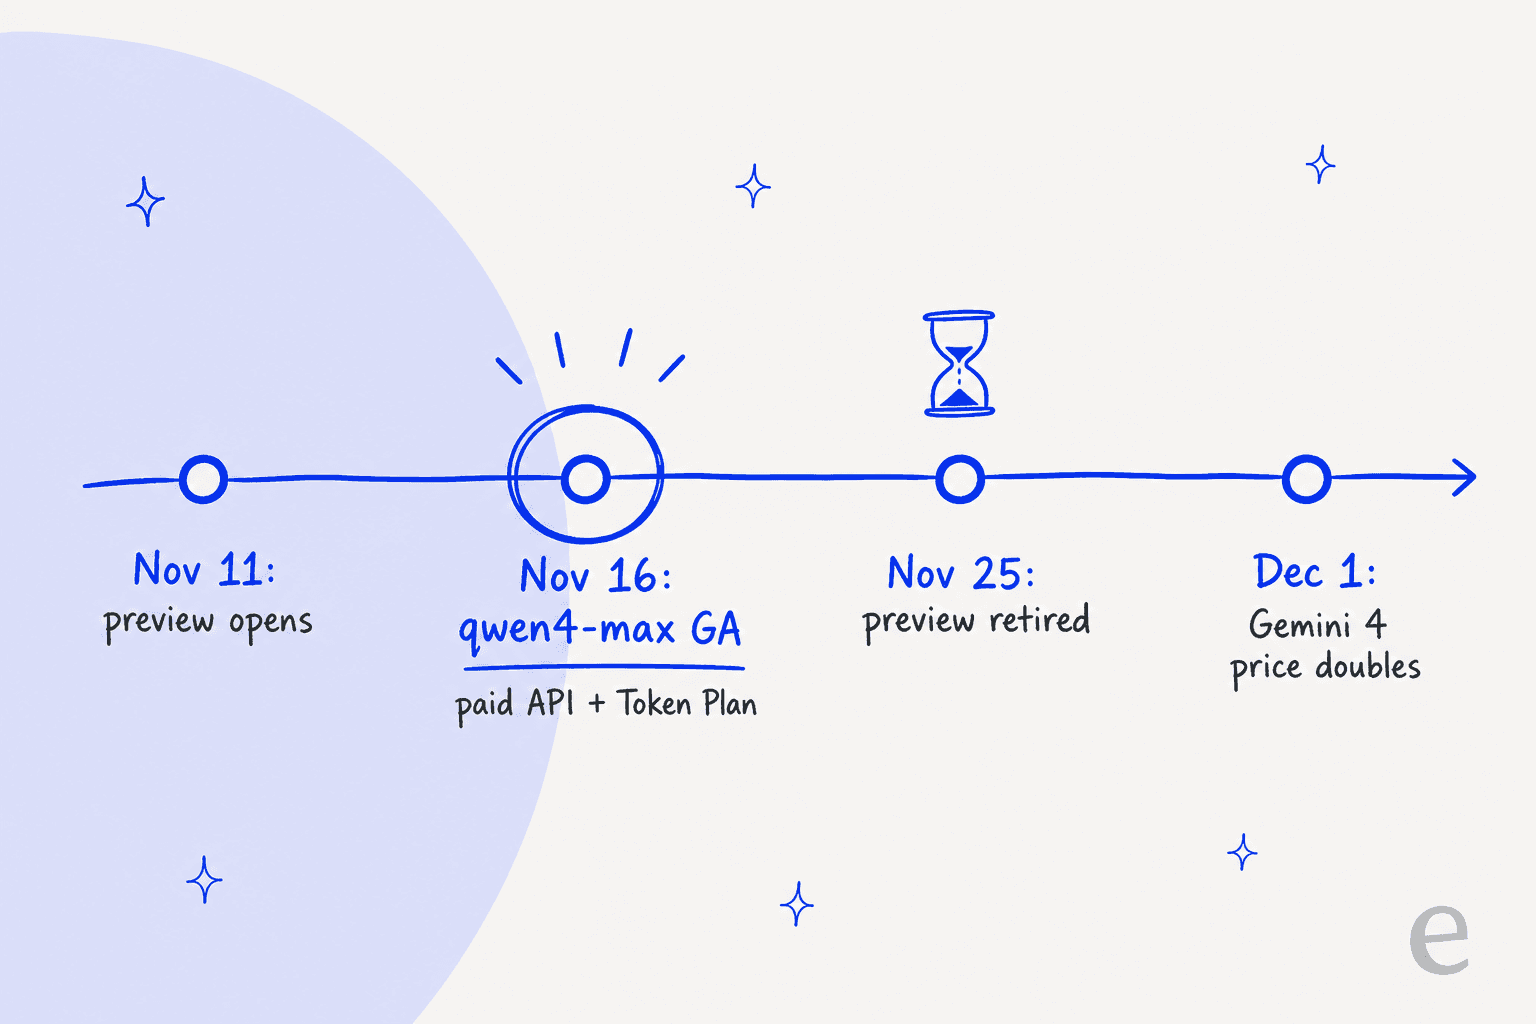
Essa última data também importa. Duas das alternativas abaixo, Gemini 4 Argon e Gemini 4 Carbon, têm preços de lançamento que dobram em 1 de dezembro, então uma decisão tomada com a tabela de preços desta semana pode mudar duas vezes em duas semanas.
Eu sou a Alicia, e construo recursos e agentes de IA na eesel. Colocamos modelos atrás de filas de suporte reais há anos, e a lição de cada migração forçada é a mesma: para qual modelo você muda importa menos do que se você testou nele primeiro, no seu próprio trabalho. Cada escolha abaixo vem com o preço para um comprador definido, para você comparar com um único número antes de testar.
Você deveria simplesmente migrar para o qwen4-max GA?
Para a maioria das pessoas que gostavam da prévia, sim. Veja o que muda entre os dois modelos, tudo retirado da documentação do Qwen4-Max da Alibaba:
| qwen4-max-preview | qwen4-max (GA) | |
|---|---|---|
| Status | Desativado após 25 de nov. | Disponibilidade geral desde 16 de nov. |
| Onde você pode usar | Só no Token Plan | Token Plan Personal, Token Plan Team, API por uso |
| Preço | Créditos a 20% da tarifa padrão (8% à noite) | US$ 1,50 entrada / US$ 4,50 saída por 1 milhão de tokens (Singapura) |
| Janela de contexto | 1 milhão de tokens | 1 milhão de tokens |
| Raciocínio + resposta máx. | 393.216 tokens | 262.144 tokens |
| Esforço de raciocínio | low, medium, xhigh | low, high (padrão), xhigh |
| Ferramentas de código | Claude Code via Token Plan | Claude Code, Codex, OpenCode |
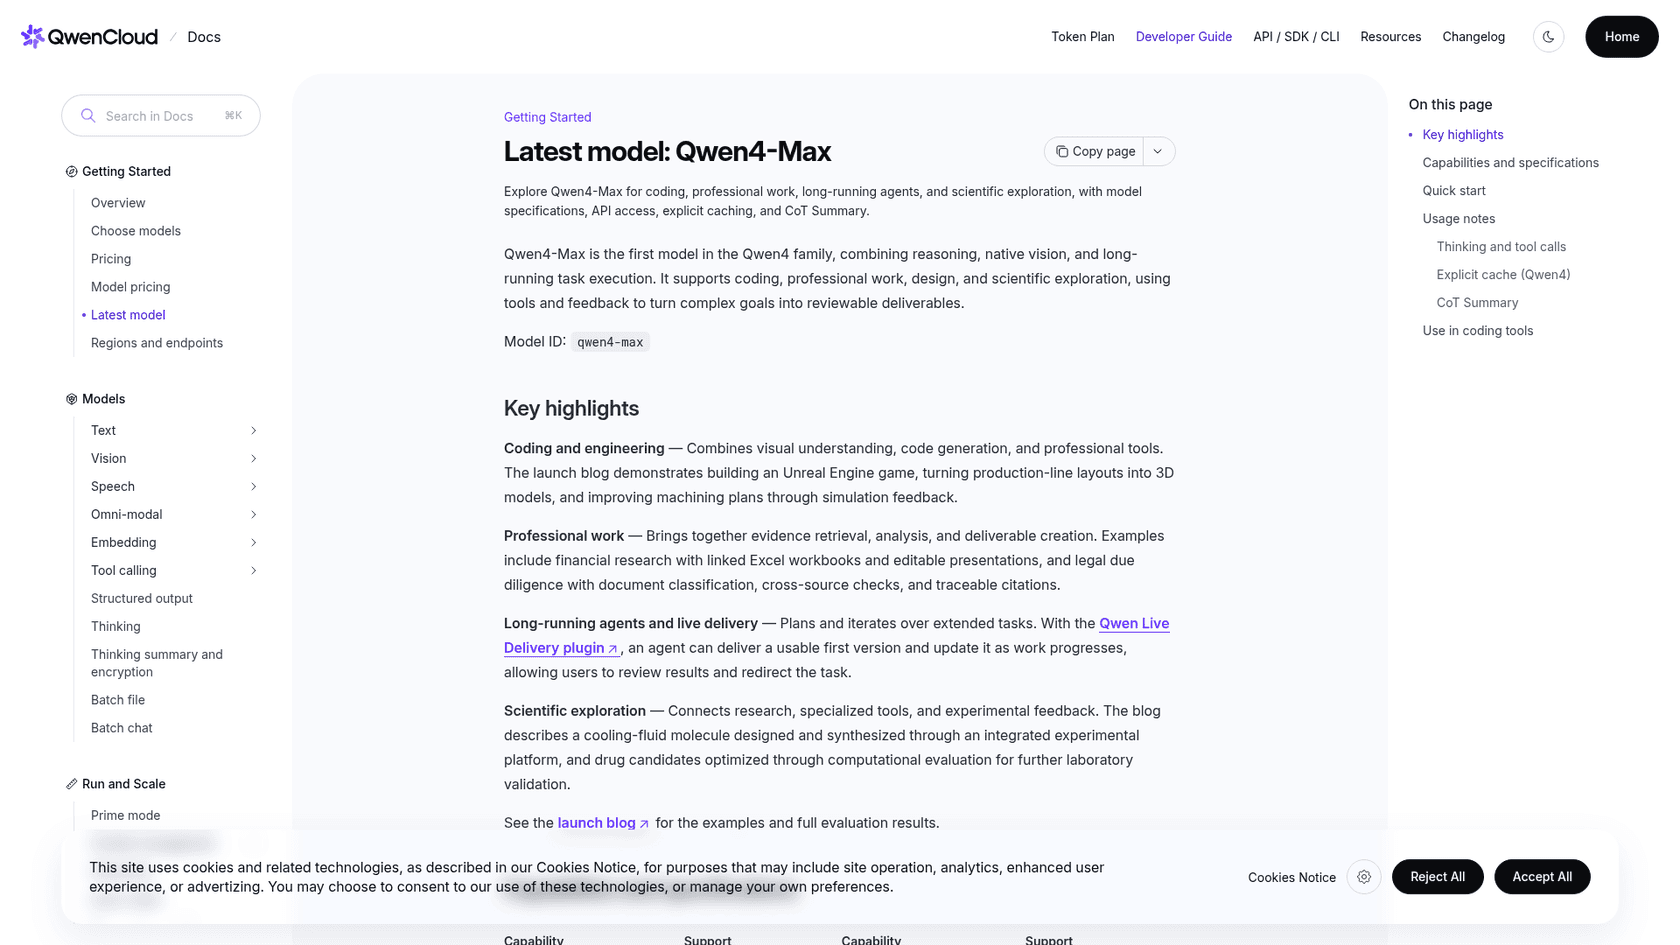
Três coisas se destacam. Primeiro, o modelo GA é mais barato que o Qwen3.8-Max: a Alibaba lista o qwen3.8-max a US$ 2/US$ 6 em Singapura contra US$ 1,50/US$ 4,50 do qwen4-max, então o carro-chefe mais novo também é o mais barato. Segundo, o modelo GA adiciona cache explícito com TTL de 5 minutos ou 1 hora e leituras de cache a US$ 0,075. Terceiro, você perde o desconto da prévia. Os usuários do Token Plan pagavam só 20% da tarifa padrão de créditos durante a prévia, e 8% à noite, segundo a visão geral do Token Plan. Esse acordo não continua, então espere que os créditos se esgotem várias vezes mais rápido no mesmo trabalho.
A migração em si é uma linha. Na configuração do Claude Code que documentamos na semana passada, o slot do Opus apontava para qwen4-max-preview; troque por qwen4-max e mantenha a mesma chave e endpoint do Token Plan. Se a saída vier truncada, verifique o max_completion_tokens, porque o modelo GA limita raciocínio mais resposta a 262.144 tokens.
Quando você deveria sair em vez disso? Quando a prévia nunca mereceu seu lugar. A Alibaba ainda não publicou resultados de benchmarks independentes na documentação além do blog de lançamento, e a opinião da comunidade durante a prévia foi dividida:
"No benchmarks yet. The smaller Qwen models are extremely popular for people running things locally, yet I don't know absolutely anyone running Qwen Max."

"It's preview; Qwen4-max-preview. It's not disappointing at all, at least so far in my one-shots, but more testing is going on and i'll have a clear answer."
Se você estava na prévia principalmente pelo desconto de 80%, ou precisa de um provedor fora da Alibaba Cloud, continue lendo.
Como escolhi e precifiquei estas alternativas
Escolhi modelos que cobrem as três mesmas tarefas para as quais as pessoas usavam a prévia do Qwen 4 Max: código agêntico em ferramentas como o Claude Code, trabalho de contexto longo em uma janela de 1 milhão, e chamadas de ferramentas em agentes de múltiplas etapas. Cada preço vem da própria página de preços do fornecedor, verificada em 17 de novembro de 2026.
Para tornar os preços por token comparáveis, precifiquei cada modelo para um comprador: um desenvolvedor que usa 10 milhões de tokens de entrada e 1 milhão de saída por mês, no preço de tabela padrão, sem descontos de cache ou de lote. Isso equivale aproximadamente a um mês intenso de trabalho de agente individual. O cache muda bastante o cenário em loops de agentes, então a calculadora mais abaixo permite adicionar sua própria taxa de acerto de cache.
Alternativas ao Qwen 4 Max em resumo
| Modelo | Melhor para | Entrada / saída por 1 M | Leitura de cache por 1 M | Custo mensal (10 M de entrada, 1 M de saída) | Contexto | Pesos abertos | Opção de assinatura | Mudança de preço em breve |
|---|---|---|---|---|---|---|---|---|
| Claude Sonnet 5.5 | Modelo de código do dia a dia | US$ 2 / US$ 10 | US$ 0,10 | US$ 30 | 1 M | Não | Planos Claude | Não |
| Claude Opus 5.5 | Tarefas de agentes difíceis | US$ 4 / US$ 20 | US$ 0,20 | US$ 60 | 1 M | Não | Planos Claude | Não |
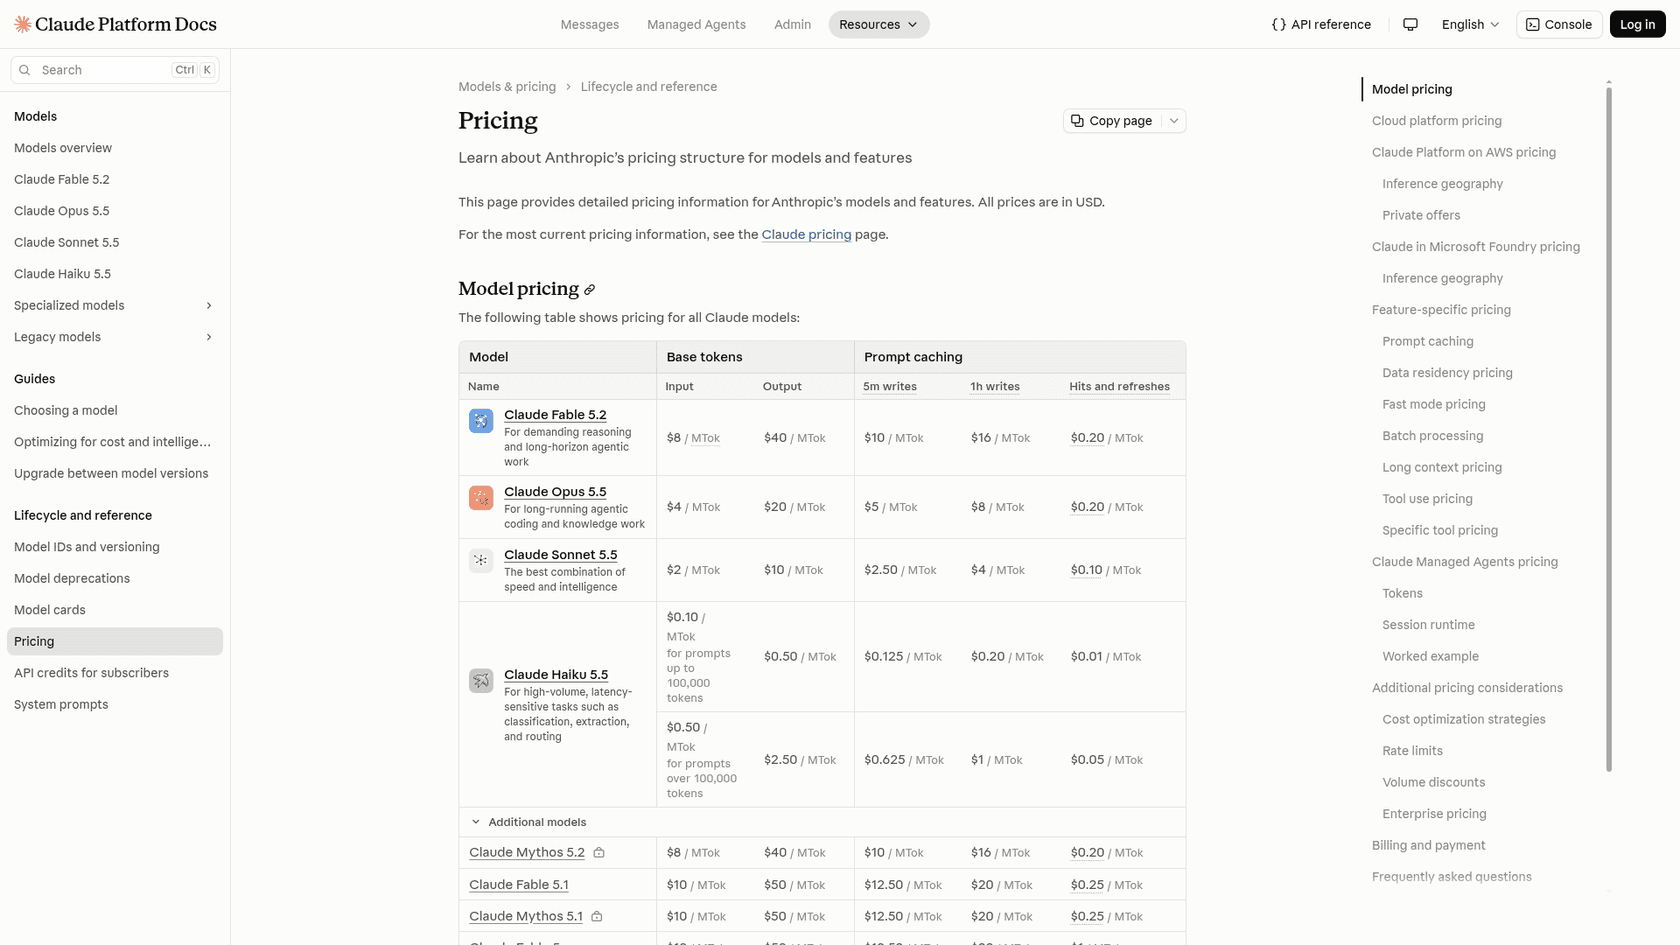
| Claude Fable 5.2 | Os trabalhos mais difíceis | US$ 8 / US$ 40 | US$ 0,20 | US$ 120 | 1 M | Não | Créditos de uso no Pro | Não |
| GPT-6.1 Terra | Trabalho de fronteira barato | US$ 1 / US$ 5 | US$ 0,05 | US$ 15 | Acima de 272K custa 2x a entrada | Não | Planos ChatGPT | Não |
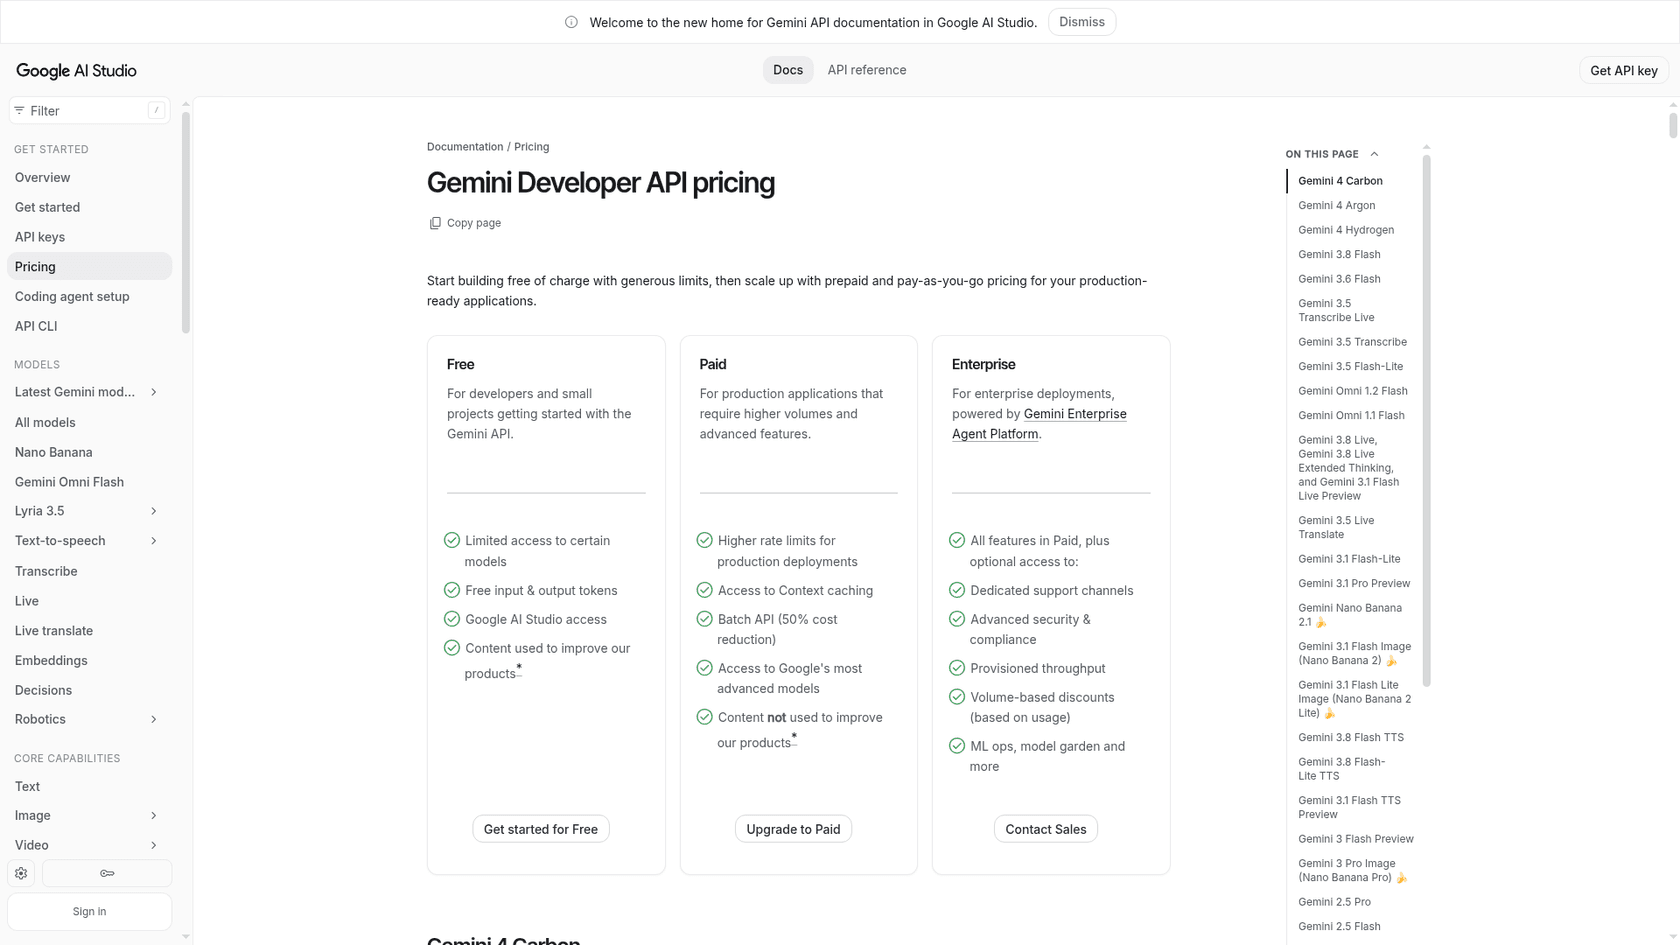
| Gemini 4 Argon | Trabalho rápido com o Gemini 4 | US$ 2 / US$ 10 | US$ 0,10 | US$ 30 (US$ 60 a partir de 1 de dez.) | 1 M | Não | Não | Dobra em 1 de dez. |
| Gemini 4 Carbon | Agentes de longo prazo | US$ 2 / US$ 10 | US$ 0,10 | US$ 30 (US$ 60 a partir de 1 de dez.) | 1 M | Não | Não | Dobra em 1 de dez. |
| DeepSeek V4.1 Flash | Trabalho em massa e econômico | US$ 0,15 / US$ 0,60 fora do pico | US$ 0,003 | US$ 2,10 (US$ 4,20 no pico) | 1 M | Sim | Também no Token Plan | Não |
| Kimi K3.1 Pro | Opção de fronteira não americana | US$ 2 / US$ 10 | US$ 0,20 | US$ 30 | 1 M | Não | US$ 19 a US$ 199/mês | Não |
| Qwen3.8-Max | Continuar no Token Plan | US$ 2 / US$ 6 | US$ 0,25 | US$ 26 | 1 M | Não | Token Plan | Não |
| qwen4-max (GA, de referência) | Mesmo modelo, sem mudanças | US$ 1,50 / US$ 4,50 | US$ 0,075 | US$ 19,50 | 1 M | Não | Token Plan | Não |
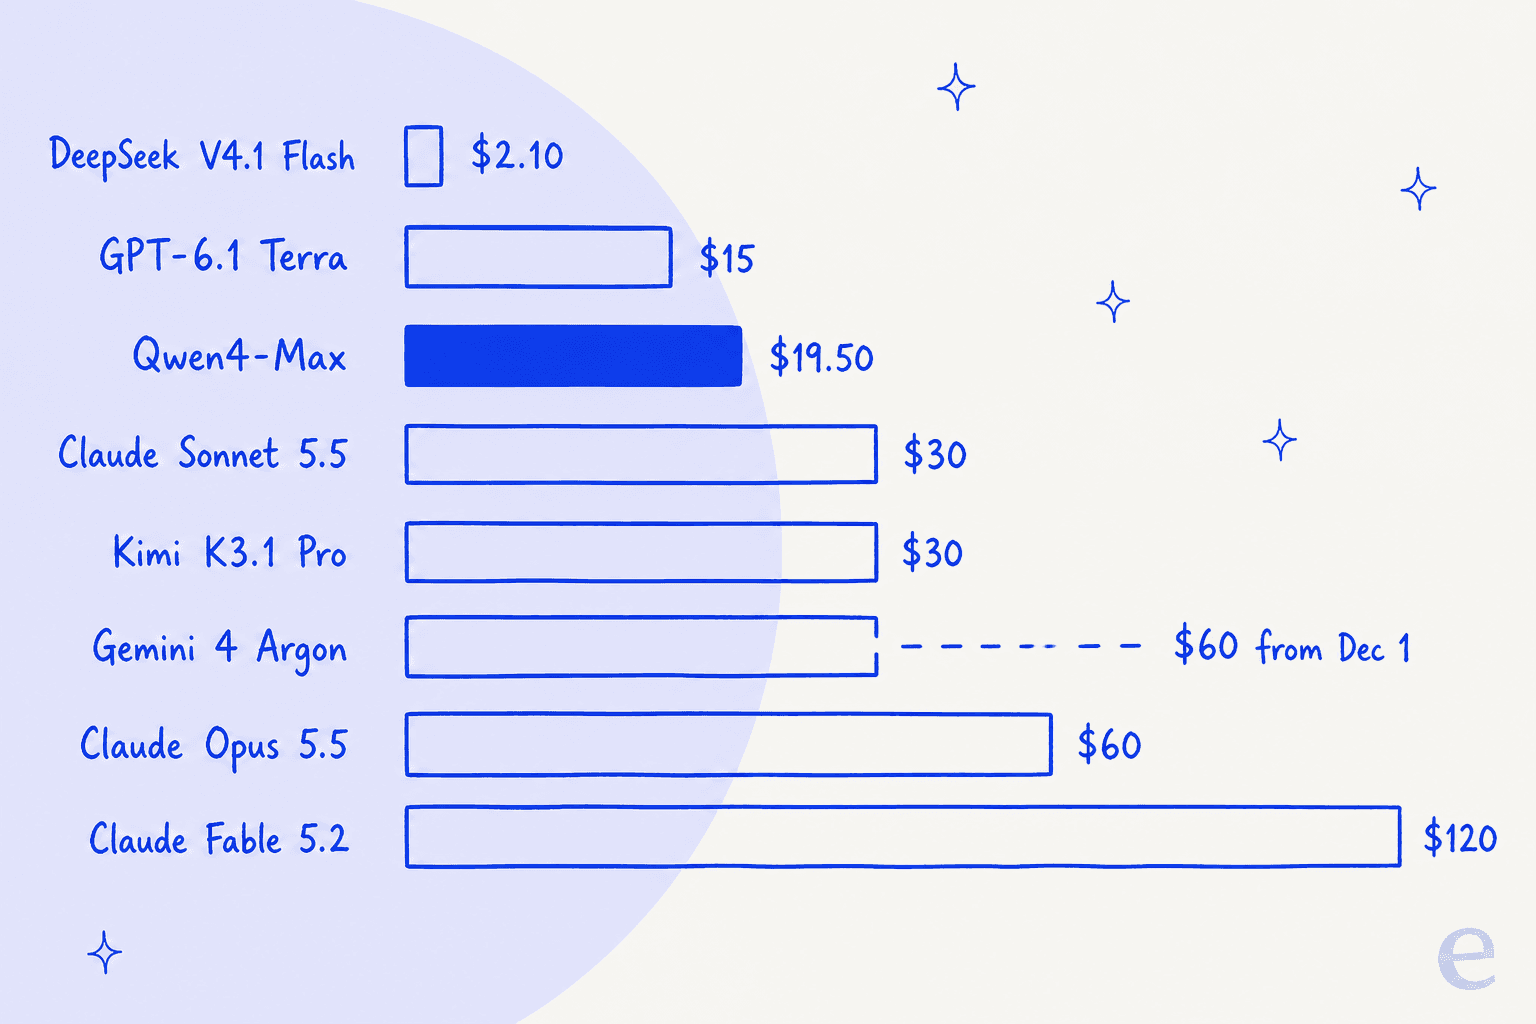
O gráfico é a surpresa que a maioria de quem troca não espera: só duas alternativas são mais baratas que o GA Qwen 4 Max no preço de tabela. Tudo o resto custa mais por mês, então uma troca precisa se justificar por qualidade, risco de fornecedor ou ferramentas, não por economia.
Calcule seu próprio custo mensal
O comprador de 10 M/1 M é um substituto. Insira seu próprio volume e taxa de acerto de cache abaixo. A entrada em cache é cobrada no preço de leitura de cache de cada fornecedor; descontos de escrita em cache e de lote ficam de fora para manter a comparação simples.
Tente uma taxa de acerto de cache de 70%, normal para um agente que reenvia o mesmo prompt de sistema e contexto do repositório a cada turno. O Claude Sonnet 5.5 cai de US$ 30 para cerca de US$ 16,70, e o qwen4-max cai para cerca de US$ 9,53, então a diferença encolhe para cerca de US$ 7.
Por que trocar o Qwen 4 Max de qualquer forma?
Para ser justo com a Alibaba, o modelo GA resolve a maioria dos problemas da prévia: tem um preço real por token, uma API por uso, e suporte no Claude Code, Codex e OpenCode. Os motivos pelos quais as pessoas ainda saem são mais específicos:
- O desconto era o atrativo. A 20% da tarifa padrão, a prévia era quase gratuita para quem usava muito. Um comentarista do HN resumiu o atrativo assim: "By November 25th, Beijing time daytime (8am-22pm) -80%, and at night (Western daytime) even -92%!" (linzhangrun, Hacker News). Nas tarifas GA, outros modelos voltam a competir em preço.
- Pouca evidência pública. Não havia nenhuma entrada independente em tabelas de classificação para o
qwen4-maxquando verifiquei, então equipes que precisam de números antes de ir para produção têm pouco em que se apoiar. - Concentração de fornecedor. O Token Plan Personal é vendido a partir de Singapura e, segundo nosso artigo sobre preços, é pensado para uso interativo, não para automação de backend. Se você precisa de um segundo fornecedor de qualquer forma, agora é um bom momento para escolher um.
- Um teto de saída mais curto. O limite de raciocínio mais resposta do modelo GA, de 262.144 tokens, é menor que os 393.216 da prévia, o que importa em gerações de um único turno muito longas.
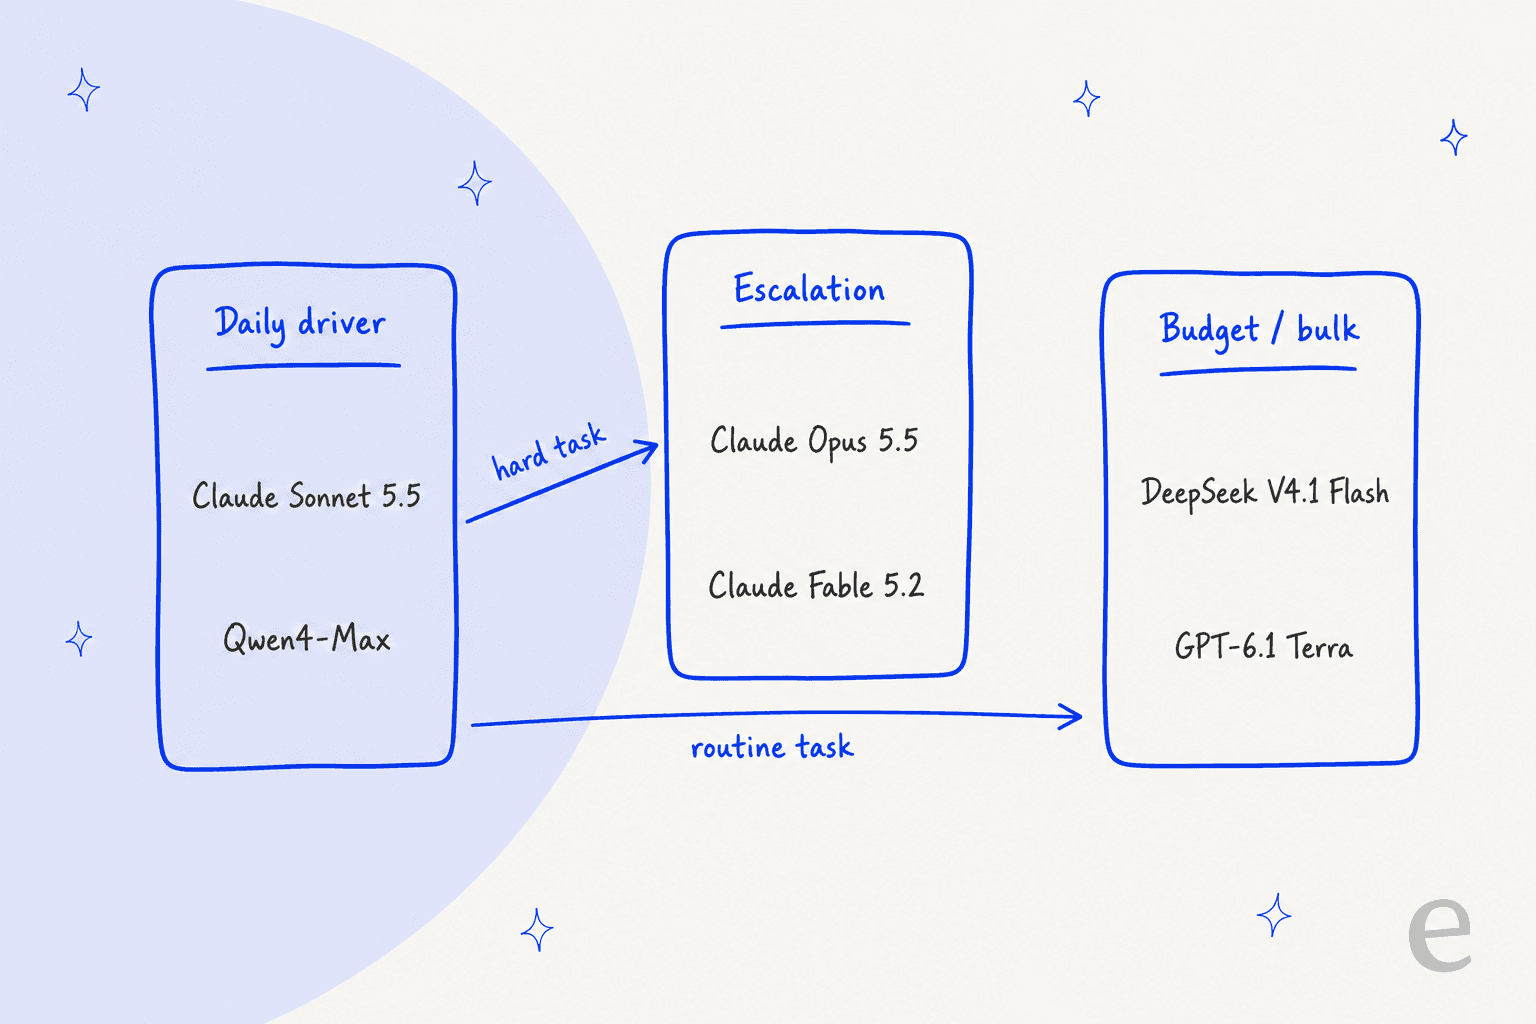
A forma como a maioria deveria pensar nisso não é um único substituto, mas três posições. O ChatGPT deu o mesmo conselho quando fiz exatamente essa pergunta: um modelo diário, um modelo de escalonamento e um modelo econômico.
1. Claude Sonnet 5.5
Melhor para: seu modelo de código e agentes do dia a dia, especialmente dentro do Claude Code.
O que faz bem
O Sonnet 5.5 é a substituição mais próxima da forma como a maioria usava a prévia do Qwen 4 Max: um bom codificador agêntico com uma janela de contexto de 1 milhão de tokens. A página do Sonnet da Anthropic diz que ele roda 30% mais rápido e custa até 30% menos que o Sonnet 5 na maior parte do trabalho. Se sua configuração era o Claude Code apontando para o endpoint da Alibaba, este é o modelo em torno do qual o Claude Code foi construído, então as chamadas de ferramentas e edições de arquivos se comportam como o harness espera.
Vantagens
- Mesmo preço de
US$ 2/US$ 10em toda a janela de 1 M, sem sobretaxa de contexto longo - Leituras de cache a
US$ 0,10por milhão, mais baratas que o Opus 5.5 e o Fable 5.2 - Incluído no plano gratuito do Claude para uso em chat
Desvantagens
- No esforço máximo, a Artificial Analysis mediu em
US$ 7,60por tarefa, mais que osUS$ 5,98do Opus 5.5, segundo nossa análise de preços do Sonnet 5.5 US$ 30por mês para o comprador de 10 M/1 M, cerca de 50% mais que o GAqwen4-max
Preço
US$ 2 de entrada e US$ 10 de saída por milhão de tokens, US$ 0,10 de leituras de cache, segundo a página de preços da Anthropic. Para o comprador de 10 M/1 M: 10 x US$ 2 + 1 x US$ 10 = US$ 30 por mês.
Nossa opinião: escolha o Sonnet 5.5 como padrão se você quer um modelo que simplesmente funcione no Claude Code. Mantenha-o em esforço Low ou Medium, e escale para o Opus 5.5 em vez de colocar o Sonnet no Max.
2. Claude Opus 5.5
Melhor para: os 10% de tarefas mais difíceis: refatorações em todo o repositório, depuração complicada, execuções autônomas longas.
O que faz bem
O Opus 5.5 é a posição de escalonamento. A Anthropic diz, na sua página do Opus, que ele tem desempenho no nível do Claude Fable 5.1 na maior parte do trabalho e custa 40% menos para rodar que o Opus 5, em parte porque termina com menos tokens e turnos. Esse último ponto é o que importa para agentes: o preço por token é só metade da conta, e a análise do Opus 5.5 cobre o quanto o número de passos cai.
Vantagens
- Menos passos por tarefa, então a conta real é menor do que a tabela de preços sugere
- A API em lote reduz as duas tarifas pela metade, para
US$ 2/US$ 10 - Modo rápido disponível quando a latência importa
Desvantagens
US$ 4/US$ 20é 2,7 vezes o preço de entrada do GA Qwen 4 Max e 4,4 vezes o de saídaUS$ 60por mês para o comprador de 10 M/1 M se você rodar tudo por ele
Preço
US$ 4 de entrada, US$ 20 de saída, US$ 0,20 de leituras de cache por milhão de tokens, segundo a página de preços da Anthropic. Para o comprador de 10 M/1 M: US$ 40 + US$ 20 = US$ 60. Mais detalhes no nosso guia de preços do Opus 5.5.
Nossa opinião: não faça do Opus seu padrão. Direcione para o Opus 5.5 em esforço Medium as tarefas em que o Sonnet ou o Qwen travam, e você terá a maior parte da qualidade por uma fração da conta de usar só o Opus.
3. Claude Fable 5.2
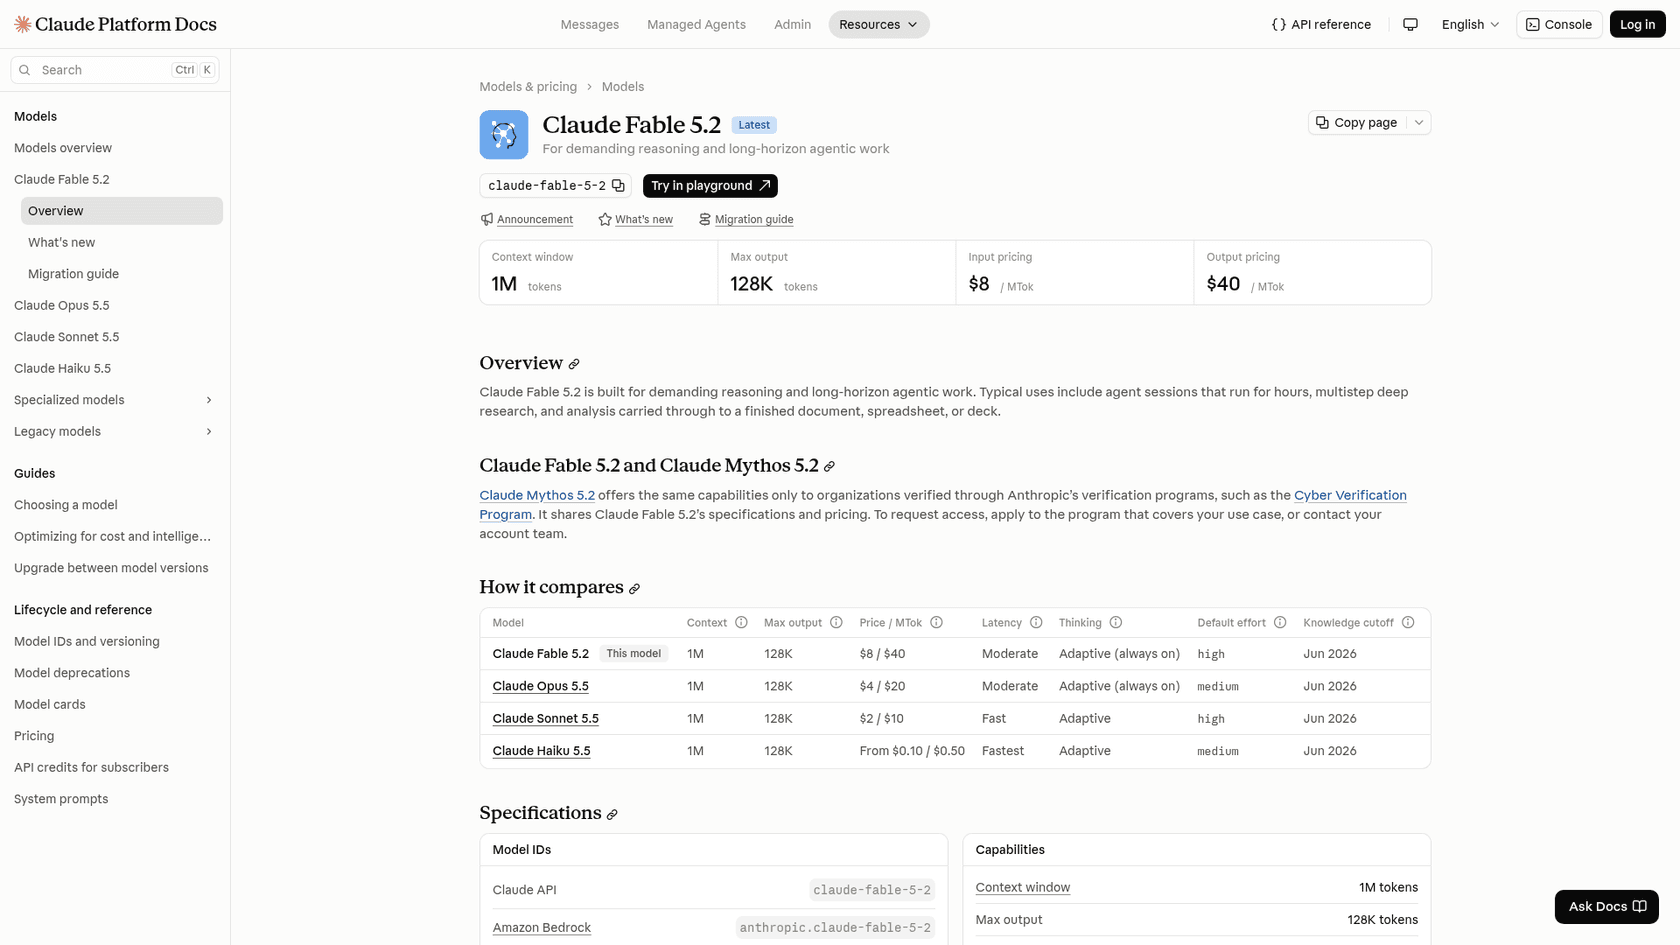
Melhor para: os trabalhos de agentes mais difíceis e longos, onde uma execução falha custa mais que os tokens.
O que faz bem
O Fable 5.2 fica acima do Opus 5.5, e a resposta do ChatGPT à minha pergunta apontou que ele lidera a tabela de classificação de código que verificou. O dado útil é o custo, não a posição: a Anthropic mediu que o Fable 5.2 em High iguala o Opus 5.5 em Max por cerca da metade do custo por tarefa, como cobrimos no nosso detalhamento de preços do Fable 5.2. Então, para trabalhos em que você colocaria o Opus no Max, o Fable em High pode ser a escolha mais barata.
Vantagens
- O modelo mais forte desta lista para trabalho de longo prazo
- Leituras de cache a
US$ 0,20, igual ao Opus 5.5 - Pode superar o Opus em custo por tarefa com qualidade equivalente
Desvantagens
- Preço de
US$ 8/US$ 40, o mais caro por token aqui - Limites de taxa separados e mais baixos que o Opus e o Sonnet
- No plano Pro, roda com créditos de uso, não com a cota normal
Preço
US$ 8 de entrada, US$ 40 de saída por milhão de tokens, segundo a página de preços da Anthropic. Para o comprador de 10 M/1 M: US$ 80 + US$ 40 = US$ 120.
Nossa opinião: um especialista, não um modelo do dia a dia. Use-o onde você colocaria o Opus no Max, e leia a análise do Fable 5.2 antes de confiar nele execuções sem supervisão.
4. GPT-6.1 Terra
Melhor para: equipes que querem um modelo de fronteira barato de um segundo fornecedor.
O que faz bem
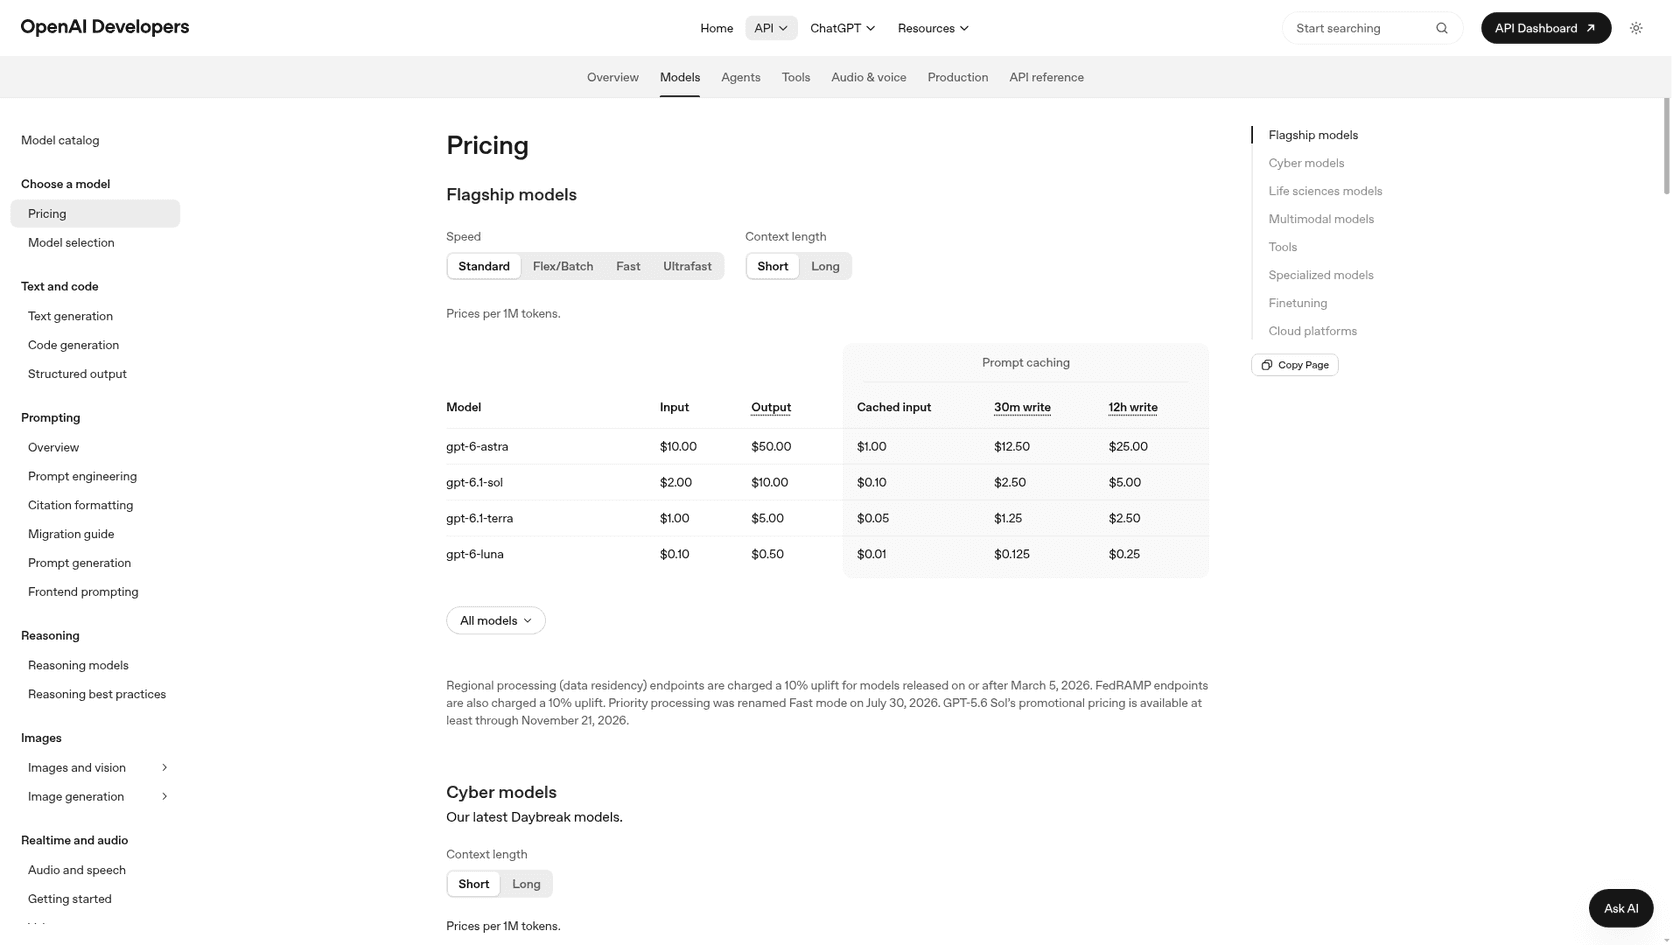
O Terra é a única alternativa que supera o GA Qwen 4 Max em preço sem cair para um modelo de classe Flash. A US$ 1/US$ 5, custa a metade por token do GPT-6.1 Sol, e a Artificial Analysis o colocou em US$ 0,05 por tarefa com esforço baixo e US$ 0,40 no máximo, segundo nosso artigo sobre preços do Terra. Se você quer um modelo da OpenAI na sua rotação, este é o que vale começar.
Vantagens
US$ 15por mês para o comprador de 10 M/1 M, mais barato que oqwen4-max- Entrada em cache a
US$ 0,05, um desconto de 95% - Batch e Flex reduzem o preço pela metade, para
US$ 0,50/US$ 2,50
Desvantagens
- Prompts acima de 272K tokens cobram toda a requisição a
US$ 2de entrada eUS$ 7,50de saída - Não é a escolha certa se você precisa de toda a janela de 1 M a preço fixo
Preço
US$ 1 de entrada, US$ 5 de saída, US$ 0,05 de entrada em cache por milhão de tokens, segundo a página de preços da OpenAI. Para o comprador de 10 M/1 M: US$ 10 + US$ 5 = US$ 15.
Nossa opinião: a melhor escolha em custo-benefício se seus prompts ficarem abaixo de 272K. Para contexto de um repositório inteiro, o Sonnet 5.5 ou o qwen4-max mantêm o preço fixo em todo o 1 M.
5. Gemini 4 Argon
Melhor para: trabalho rápido com o Gemini 4, se você conseguir conviver com a mudança de preço de dezembro.
O que faz bem
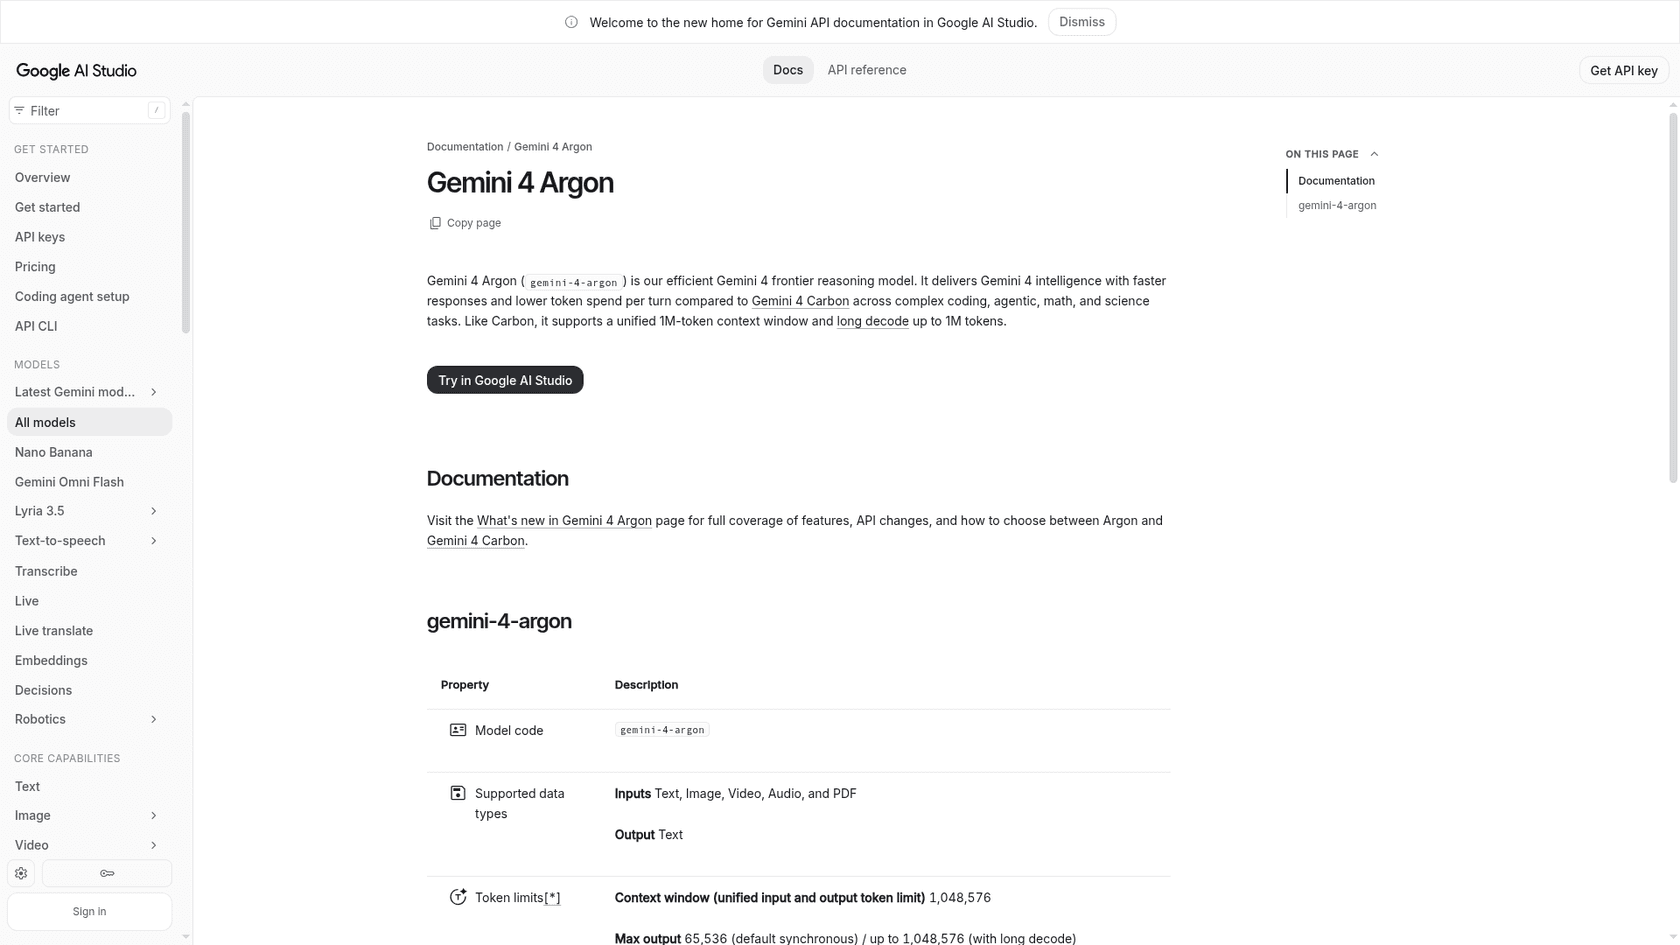
A página de preços do Google descreve o Argon como o modelo eficiente do Gemini 4, com respostas mais rápidas e menor gasto de tokens por turno que o Carbon em tarefas de código, agentes, matemática e ciência. Sua janela de contexto é de 1.048.576 tokens, a mesma classe do Qwen 4 Max. A lista reduzida do próprio ChatGPT sugeriu o Argon para trabalho regular e o Carbon para tarefas autônomas difíceis, o que combina com o posicionamento do Google.
Vantagens
US$ 2/US$ 10comUS$ 0,10de entrada em cache até 30 de novembro- Contexto de 1 M, com decodificação longa de até 1 M de tokens de saída segundo a documentação
- Mesma conta do Google e chave de API que outros modelos Gemini
Desvantagens
- O preço dobra para
US$ 4/US$ 20em 1º de dezembro de 2026 - Sem nível gratuito para este modelo
- Só cache implícito; cache explícito não é suportado
Preço
US$ 2 de entrada e US$ 10 de saída até 30 de novembro, depois US$ 4 e US$ 20 a partir de 1º de dezembro, segundo a página de preços do Google. Para o comprador de 10 M/1 M: US$ 30 agora, US$ 60 a partir de dezembro. Veja nosso guia de preços do Argon para a conta de custo por tarefa.
Nossa opinião: faça seu orçamento com US$ 4/US$ 20, não com a promoção. Nesse preço, custa o mesmo que o Opus 5.5, então teste os dois na sua carga de trabalho antes de decidir.
6. Gemini 4 Carbon
Melhor para: agentes de longo prazo e o raciocínio mais difícil na pilha do Google.
O que faz bem
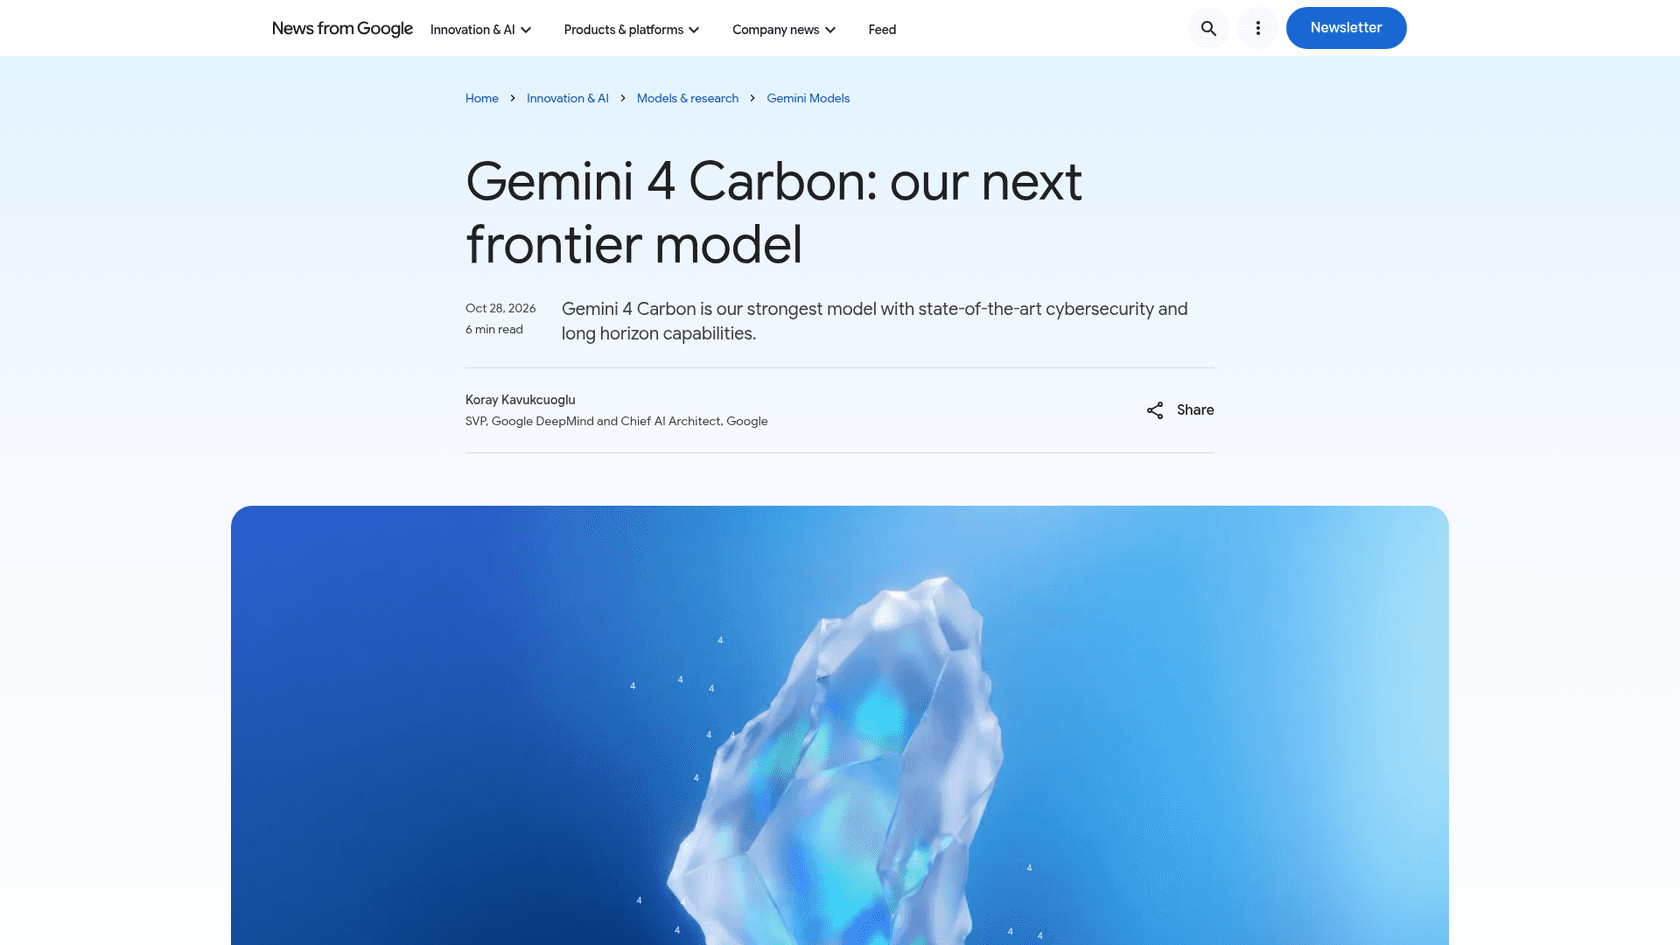
O Carbon é o modelo de raciocínio mais capaz do Google, construído para engenharia de software complexa, agentes autônomos de múltiplas etapas e decodificação longa de até 1 M de tokens, segundo a página de preços. O número interessante: na Artificial Analysis, o Carbon custou US$ 7,76 por tarefa no preço de tabela contra US$ 7,68 do Argon, mas pontuou 59 em vez de 50. Mesma conta, nove pontos a mais.
Vantagens
- Mesmo preço do Argon, então você não paga nada extra pelo modelo mais forte
- Contexto de 1 M e até 1 M de tokens de saída
Desvantagens
- A mesma duplicação de preço de 1º de dezembro que o Argon
- Escreve muitos tokens por tarefa, então o custo por tarefa sai alto
Preço
US$ 2/US$ 10 até 30 de novembro, US$ 4/US$ 20 a partir de 1º de dezembro, segundo a página de preços do Google. Para o comprador de 10 M/1 M: US$ 30, depois US$ 60. Detalhes no nosso artigo sobre preços do Carbon.
Nossa opinião: se você for migrar para o Gemini, vá para o Carbon em vez do Argon para trabalho de agentes. A análise do Carbon tem o detalhe dos benchmarks.
7. DeepSeek V4.1 Flash
Melhor para: passos de agentes rotineiros e de alto volume, onde o preço importa mais que a qualidade de ponta.
O que faz bem
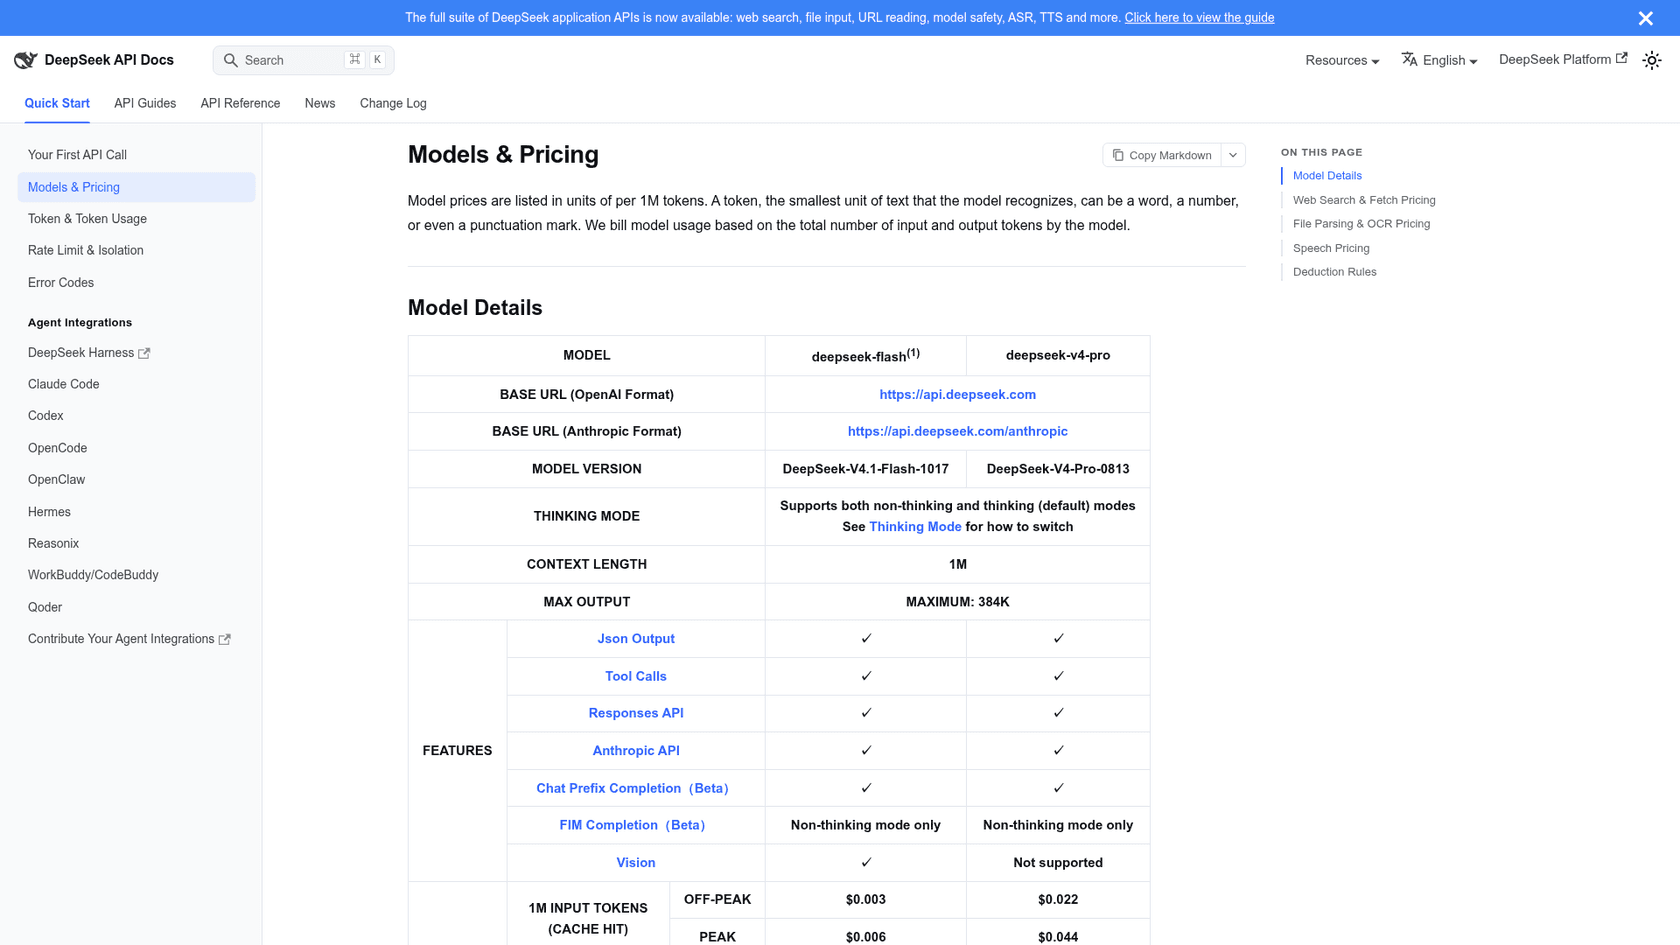
O DeepSeek V4.1 Flash é, de longe, o modelo sério mais barato desta lista. Na página de preços da DeepSeek, o modelo deepseek-flash (DeepSeek-V4.1-Flash-1017) custa US$ 0,15 de entrada e US$ 0,60 de saída fora do horário de pico, com uma janela de contexto de 1 M e até 384K de saída. Ele suporta chamadas de ferramentas, saída em JSON, visão, e tanto o formato de API da OpenAI quanto o da Anthropic, então entra em configurações no estilo do Claude Code. E se você quiser ficar na conta da Alibaba, a documentação do Token Plan também lista o deepseek-v4.1-flash, com 50% de desconto à noite.
Vantagens
US$ 2,10por mês para o comprador de 10 M/1 M fora do horário de pico- Acertos de cache a
US$ 0,003por milhão - Disponível no Token Plan além da própria API da DeepSeek
Desvantagens
- Os horários de pico (01h00 às 04h00 e 06h00 às 10h00 UTC, dias úteis) dobram todas as tarifas
- Um modelo de classe Flash, então mantenha um modelo mais forte para tarefas difíceis
Preço
US$ 0,15 de entrada (erro de cache), US$ 0,003 (acerto de cache), US$ 0,60 de saída por milhão de tokens fora do horário de pico; o dobro no pico, segundo a DeepSeek. Para o comprador de 10 M/1 M: US$ 1,50 + US$ 0,60 = US$ 2,10 fora do pico, US$ 4,20 no pico. Veja nosso guia de preços do V4.1 Flash.
Nossa opinião: a posição econômica. Direcione para aqui o trabalho em massa, como resumir logs, escrever testes e fazer edições simples, e mantenha o Sonnet 5.5 ou o qwen4-max para tudo o que exigir julgamento.
8. Kimi K3.1 Pro
Melhor para: desenvolvedores que querem um modelo de fronteira não americano forte com opção de preço fixo.
O que faz bem
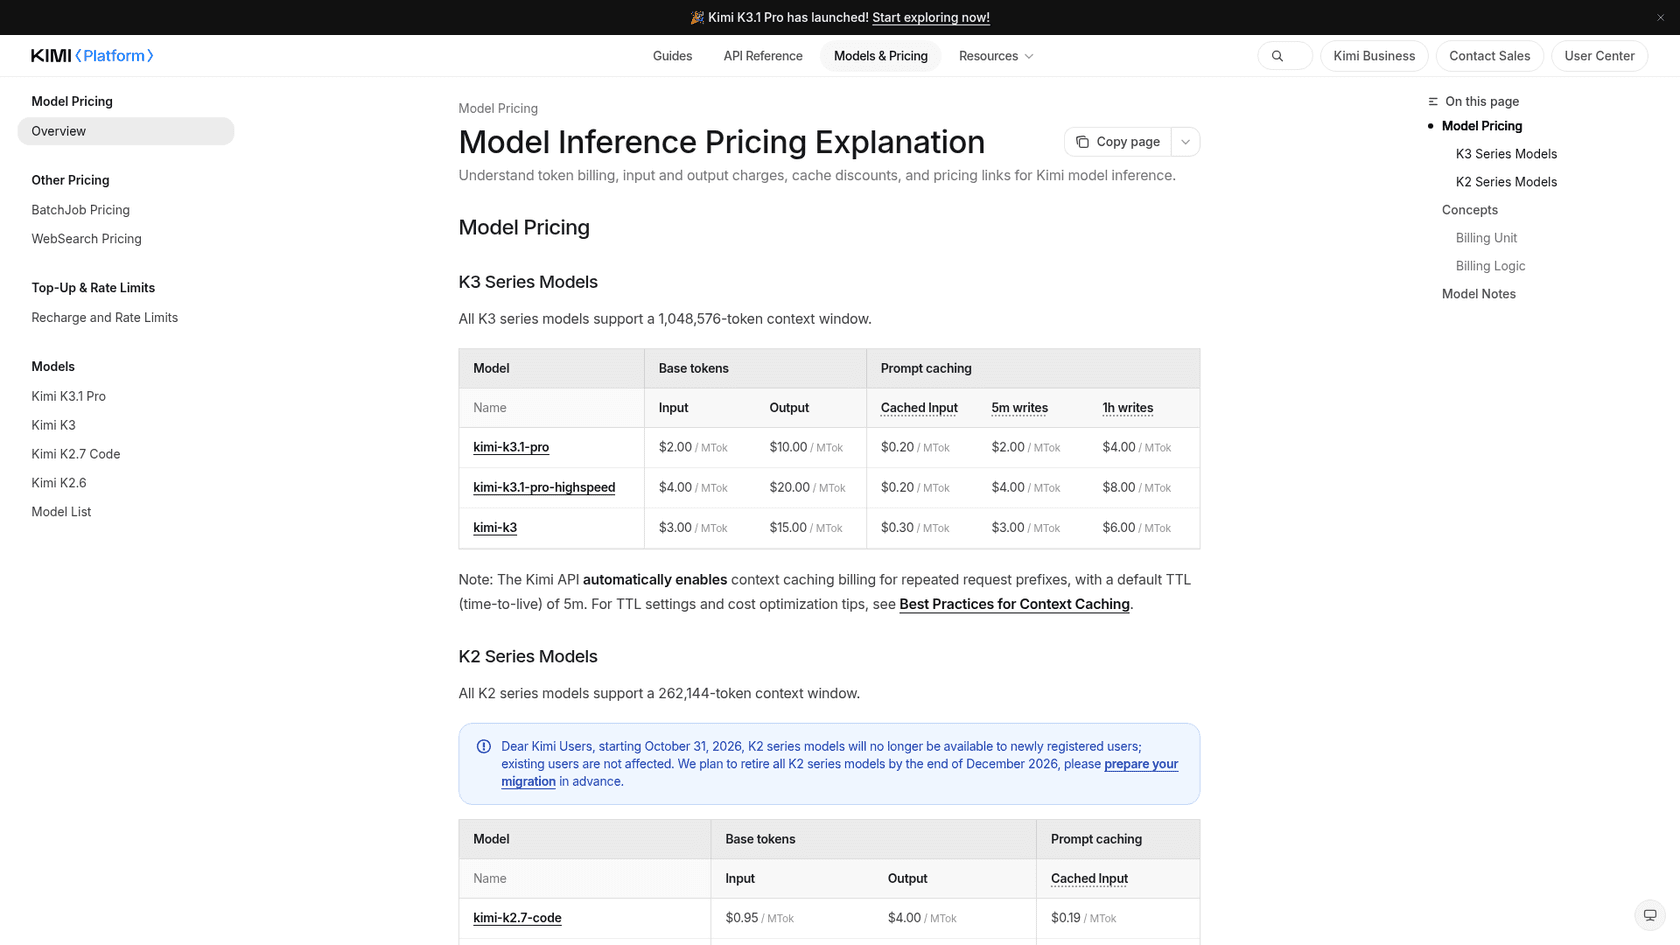
O Kimi K3.1 Pro é a escolha óbvia se o que você gostava no Qwen era ter um modelo capaz fora dos grandes laboratórios americanos. O guia rápido da Moonshot o descreve como um modelo de classe 3T com janela de contexto de 1 M, e a API fala tanto o formato da OpenAI quanto o da Anthropic, então funciona no Claude Code. Segundo nossa análise de preços do K3.1 Pro, ele teve média de US$ 2,11 por tarefa na Artificial Analysis, menos da metade do custo por tarefa do Sonnet 5.5 ou do Opus 5.5 no esforço máximo.
"So their base price is 1/5th of Opus 5.5 per token, but if you want "highspeed" it's 2x that and then I guess it generates 2x the number of tokens as well? That might suggest that Opus is competitively priced after all."
Vantagens
US$ 2/US$ 10por token, ou planos de preço fixo deUS$ 19aUS$ 199por mês- Variante highspeed com cerca de 2 a 3 vezes a velocidade
- A Moonshot cita grandes avanços em código, criação 3D e pesquisa financeira
Desvantagens
- Escreve muitos tokens, então a economia por tarefa é menor do que o preço de tabela sugere
- Os planos de assinatura têm um limite rotativo de 5 horas que os primeiros compradores alcançam rápido
Preço
US$ 2 de entrada, US$ 10 de saída, US$ 0,20 de entrada em cache por milhão de tokens; Highspeed US$ 4/US$ 20, segundo a página de preços da Kimi. Para o comprador de 10 M/1 M: US$ 30.
Nossa opinião: um bom segundo fornecedor se você quer evitar tanto a Alibaba quanto os laboratórios americanos. Leia a análise do K3.1 Pro antes de comprar um plano de assinatura para uso intenso de agentes.
9. Qwen3.8-Max
Melhor para: usuários do Token Plan que querem um carro-chefe mais antigo e mais bem documentado da Qwen, com desconto noturno.
O que faz bem
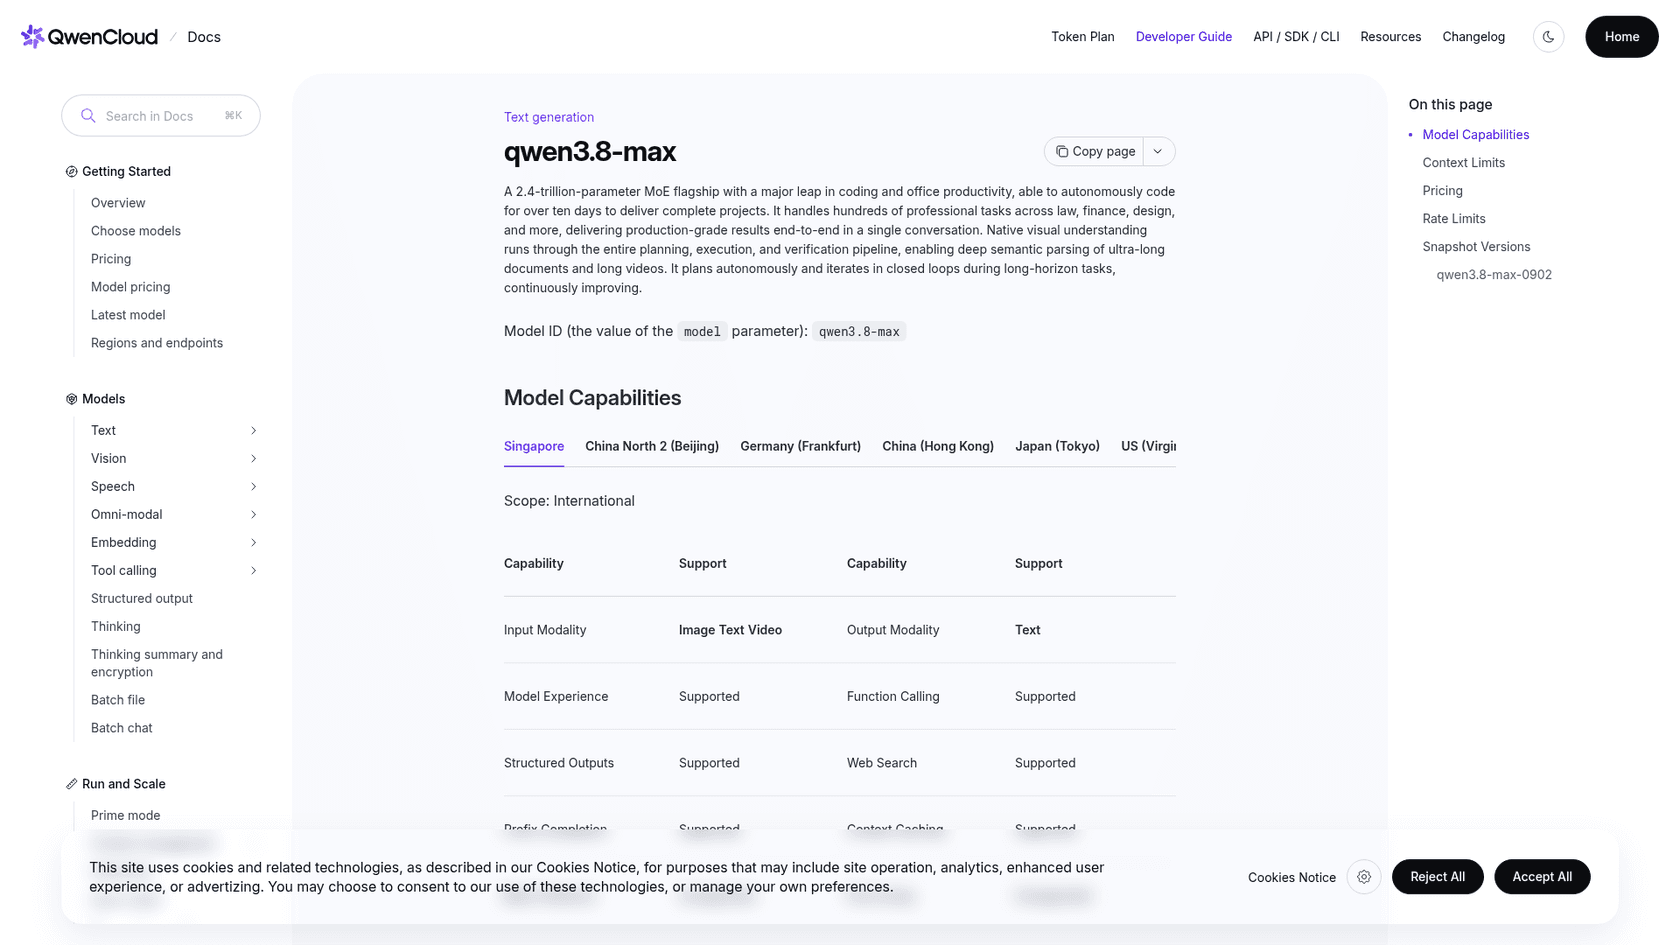
O Qwen3.8-Max é a opção de respaldo dentro da família. A Alibaba o descreve como um carro-chefe MoE de 2,4 trilhões de parâmetros capaz de programar de forma autônoma por longos períodos, e roda no mesmo Token Plan que o Qwen 4 Max, então suas chaves e endpoints não mudam. No Token Plan, ele ainda recebe 60% de desconto entre 22h00 e 08h00 UTC+8, que corresponde ao horário comercial dos EUA. Nossa análise do Qwen3.8-Max cobre como ele se saiu depois do lançamento.
Vantagens
- Nenhuma mudança de configuração além do ID do modelo se você já está no Token Plan
- O desconto noturno continua rodando no Token Plan
- Meses de uso pela comunidade por trás dele
Desvantagens
- Mais caro que o GA
qwen4-maxna API por uso (US$ 2/US$ 6contraUS$ 1,50/US$ 4,50) - Uma geração mais antiga que o modelo que você está substituindo
Preço
US$ 2 de entrada e US$ 6 de saída por milhão de tokens em Singapura, US$ 1,65 e US$ 4,951 em Pequim, segundo a página do qwen3.8-max da Alibaba. Para o comprador de 10 M/1 M: US$ 26.
Nossa opinião: só vale a pena no Token Plan, pelo desconto noturno. Na API, o GA qwen4-max é mais novo e mais barato, então há pouco motivo para dar um passo atrás.
Qual alternativa ao Qwen 4 Max combina com a sua configuração?
Sua resposta depende principalmente de onde você estava rodando a prévia:
- Claude Code no Token Plan: mude primeiro o ID do modelo para
qwen4-max. Se os resultados decepcionarem, mova o slot do Opus para o Claude Opus 5.5 e o do Sonnet para o Claude Sonnet 5.5. - Seu próprio agente sobre uma API: adicione um segundo fornecedor. Sonnet 5.5 ou GPT-6.1 Terra como modelo diário, DeepSeek V4.1 Flash para chamadas em massa.
- Principalmente pelo desconto: o DeepSeek V4.1 Flash fora do horário de pico é o mais próximo do preço da prévia.
- Execuções autônomas de longo prazo: Claude Fable 5.2 ou Gemini 4 Carbon, testados lado a lado antes de 1º de dezembro.
- Um bot de suporte ou voltado ao cliente: não coloque nenhum modelo de prévia na frente de clientes. Esse é o caso de um agente gerenciado, que cobrimos a seguir.
| Se você precisa de | Escolha | Custo mensal (10 M de entrada, 1 M de saída) |
|---|---|---|
| Menor mudança | qwen4-max (GA) | US$ 19,50 |
| Melhor modelo de código diário | Claude Sonnet 5.5 | US$ 30 |
| Tarefas mais difíceis | Claude Opus 5.5 ou Fable 5.2 | US$ 60 ou US$ 120 |
| Menor preço | DeepSeek V4.1 Flash | US$ 2,10 fora do pico |
| Segundo fornecedor com orçamento curto | GPT-6.1 Terra | US$ 15 |
| Modelo de fronteira não americano | Kimi K3.1 Pro | US$ 30 |
E se a prévia estivesse rodando sua fila de suporte?
Então o ID do modelo nunca foi o verdadeiro problema. Uma prévia de duas semanas que é desativada numa data fixa é o exemplo mais claro de por que equipes de suporte não deveriam conectar um modelo bruto direto no helpdesk: cada mudança do fornecedor se torna sua migração, seu novo teste e seu risco.
É essa a lacuna que a eesel preenche. Modelos como os de cima são infraestrutura; a eesel é a funcionária. Sua colega de equipe de IA para o helpdesk se conecta ao Zendesk ou ao Freshdesk, aprende com seus tickets passados e sua central de ajuda, e é testada com conversas históricas antes de responder a um cliente real. Quando um modelo melhor é lançado, a troca acontece do lado da eesel.
Dois clientes mostram como isso funciona na prática:
- A SE Ranking opera três produtos a partir de uma única equipe no Zendesk, com um agente da eesel por produto buscando em cerca de 16.800 páginas de conteúdo de ajuda. Ela tratou cerca de 4.650 conversas em um mês, e nada disso dependia de qual modelo estava por trás.
- A OroSoft fabrica software para negociação de metais preciosos e atende clientes pelo Freshdesk. A eesel redige respostas a partir de 6.100 tickets passados e 20 arquivos de central de ajuda e referência, indica qual ticket ou artigo usou, e sinaliza uma pessoa quando não encontra base para uma resposta.
Experimente a eesel
Se você estava testando a prévia do Qwen 4 Max para responder clientes, a eesel te dá esse agente sem a troca de modelo: ela entra no seu helpdesk em minutos, redige ou envia respostas a partir do seu próprio conteúdo de ajuda, e você vê como ela teria respondido aos seus tickets passados antes de ir ao ar. Os planos começam em US$ 299 por mês na página de preços da eesel, com 100 créditos grátis para testar. Um agente de código pode conduzir a configuração pela CLI da eesel, enviando artigos de ajuda aprovados e fazendo perguntas de teste, enquanto conectar o próprio helpdesk ainda precisa da aprovação de um administrador.
Experimente a eesel de graça, ou leia primeiro como funciona a IA para o Zendesk.