

SeedRealtime é o modelo nativo audiovisual full-duplex da ByteDance Seed, anunciado em 5 de agosto de 2026. Áudio, vídeo e texto entram em uma única arquitetura, então o modelo observa sua câmera, escuta você e fala, tudo no mesmo ciclo, sem um detector de atividade de voz separado decidindo quando é a vez dele. As demonstrações práticas são sobre resolução de referentes, não velocidade: ele descobre a qual gráfico você se referia com "aquele gráfico de agora".
Aqui está a parte que a cobertura do lançamento deixou de lado. A ByteDance publicou exatamente um número sobre isso, uma avaliação humana própria segundo a qual os problemas de ritmo conversacional caíram pela metade em comparação com "modelos em cascata" não identificados. Não há artigo técnico, nem pesos abertos, nem tabela de benchmark, nem API, nem preço. Ele também está ausente do ranking de voz para voz da Artificial Analysis, onde aparecem tanto o Qwen da Alibaba quanto o StepFun, o que torna isso uma lacuna de submissão da ByteDance, não uma lacuna da China.
E a parte incômoda: o eixo em que o SeedRealtime está otimizando é justamente o que o setor já quase resolveu. A melhor pontuação em dinâmica conversacional é 98,4%. A melhor pontuação em resolver de fato uma tarefa de suporte é 56,5%. Se você está procurando algo para colocar em uma fila real, eu passei os últimos três anos e meio observando agentes de IA tratarem tickets de suporte reais na eesel, e o que decide se um rollout sobrevive nunca foi a elegância com que o bot assume a vez de falar.
O que o SeedRealtime realmente é
O SeedRealtime está classificado em GenMedia no índice de modelos da Seed, junto com Seedance, Seedream e Seeduplex. A versão em uma frase da ByteDance: um LLM nativo audiovisual full-duplex que consegue "entender conjuntamente áudio, visual e informação temporal", identificar a qual coisa no ambiente você está se referindo e responder sem esperar um sinal claro de fim de turno.
"Full-duplex" vale a pena desmembrar, porque o termo é usado de forma vaga. Um modelo de voz half-duplex funciona como um walkie-talkie: você fala, ele espera, você para, ele responde. Um modelo full-duplex escuta enquanto fala, então pode ser interrompido, perceber que você ficou em silêncio, ou decidir ficar quieto porque você estava falando com outra pessoa no ambiente. A maior parte do setor alcançou o full-duplex de áudio nos últimos dois anos, incluindo o GPT Realtime. A afirmação do SeedRealtime é que o fluxo de vídeo está no mesmo ciclo duplex, em vez de ser acoplado como um canal secundário.
O post de lançamento organiza as capacidades em três partes, e cada uma pede algo diferente de um modelo:
- Compreensão audiovisual conjunta. Resolver um homófono usando o que aparece na tela, acompanhar um referente visual ao longo de vários turnos e associar uma voz a uma pessoa para saber quem disse o quê.
- Interação proativa. Agir diante de uma mudança na cena, e não só diante de uma pergunta, e encaixar chamadas de ferramentas no meio de uma resposta.
- Temporização conversacional. Decidir quando entrar, pausar ou se conter, e filtrar conversas paralelas e ruído de fundo em vez de tratar todo som como entrada.
Sete vídeos de demonstração acompanham o anúncio: identificar quem fala em volta de uma mesa de jantar, traduzir um cardápio de Sichuan, lembrar alguém no Museu de Hebei de que já está em pé há muito tempo, corrigir a extração de um espresso, localizar uma seção do artigo do ResNet, resistir a falsos acionamentos no ruído do Aeroporto de Daxing, e orientar a pronúncia de uma criança em meio à agitação de fundo. É um bom carretel de demonstração. Também é, como vou mostrar, toda a base de evidências publicada.
Em que a arquitetura difere de uma pilha de voz em cascata
A maioria dos assistentes de voz que você já usou funciona como uma corrida de revezamento. O reconhecimento de voz transforma seu áudio em texto, um modelo de visão descreve separadamente a imagem da sua câmera, um modelo de linguagem lê as duas transcrições, e um motor de texto para voz lê a resposta em voz alta. Um detector de atividade de voz fica fora de toda essa cadeia e decide quando seu turno terminou.
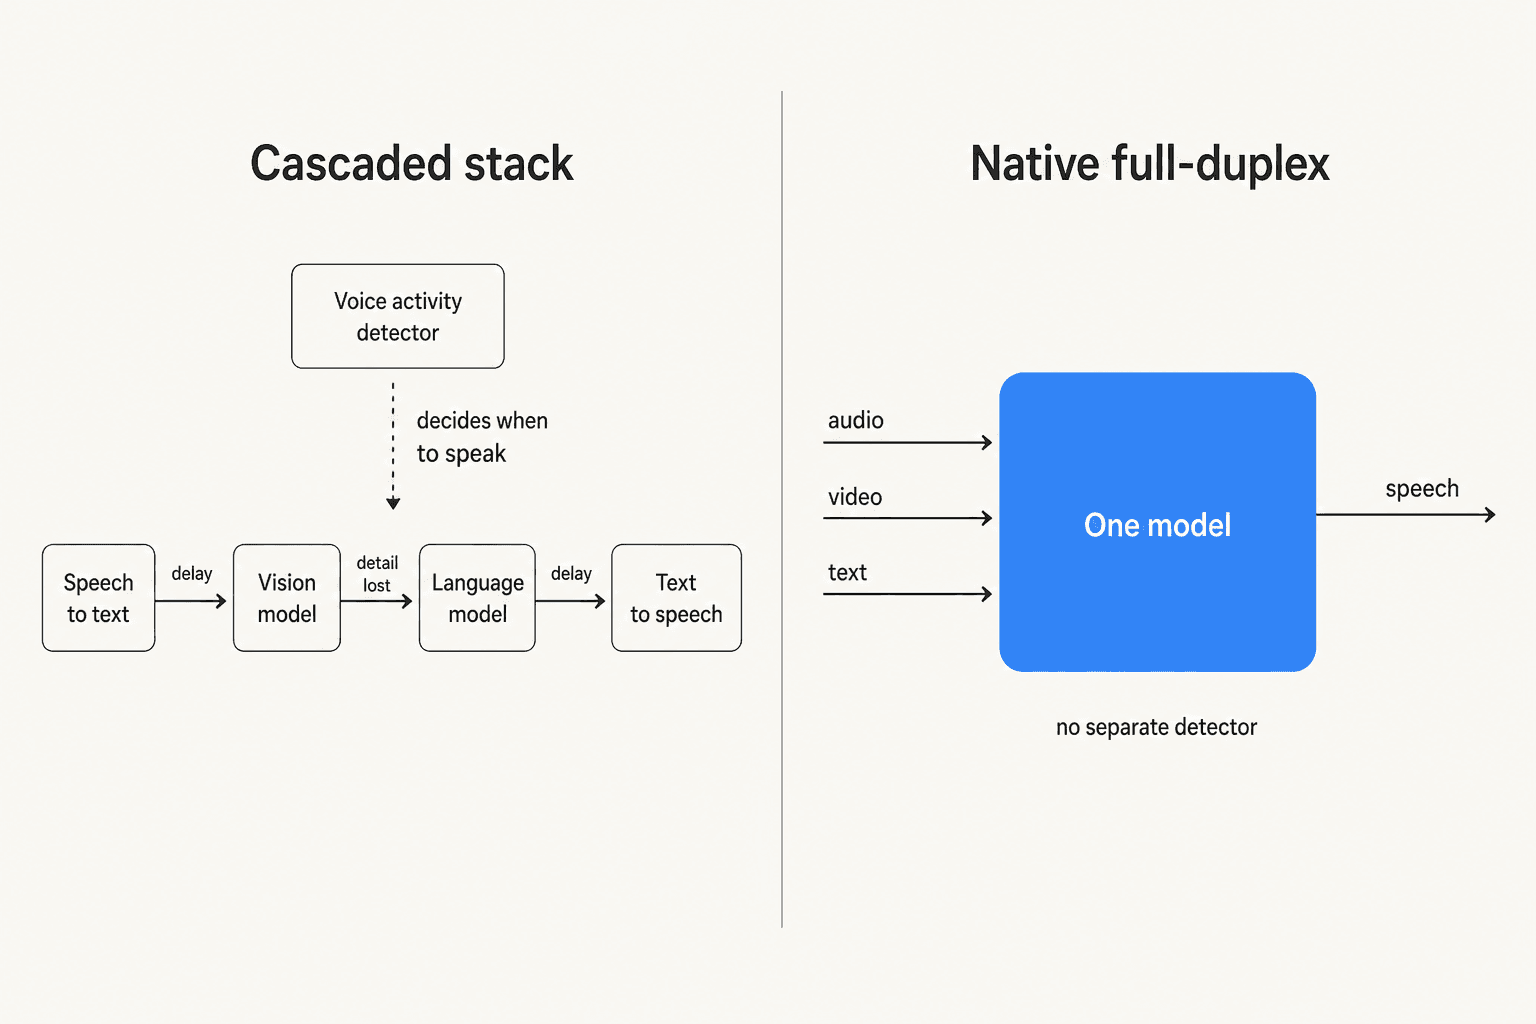
Esse design tem dois custos, e a ByteDance nomeia os dois. Cada junção acrescenta atraso, e cada junção descarta informação. O tom, a hesitação, o fato de você estar apontando para algo enquanto falava: nada disso sobrevive à passagem por uma transcrição. A proposta do SeedRealtime é que percepção, compreensão, tomada de decisão e expressão acontecem todas dentro de um único modelo sobre fluxos contínuos, então nada precisa ser achatado em texto no caminho. A baixa latência vem da entrada audiovisual fragmentada, da geração em streaming, da quantização e da otimização de inferência, não de um único truque.
O detalhe arquitetônico mais afiado é o que recebe menos atenção: não existe detector de atividade de voz externo. Assumir a vez de falar é uma decisão que o modelo toma a partir do próprio sinal multimodal. É por isso que a demo do museu funciona, já que "essa pessoa está em pé há um tempo" não é uma frase que alguém disse em voz alta. É também por isso que a demo do aeroporto importa mais do que parece, porque um modelo que decide seus próprios turnos também pode decidir errado, e falsos acionamentos em um ambiente ruidoso são exatamente o modo de falha.
Uma conta de recapitulação no X colocou o contraste com a OpenAI de forma mais precisa do que boa parte da cobertura em inglês:
"除了有视觉能力外,跟GPT-Live的委派推理方式不同的是 SeedRealtime将声音、画面、时序与表达纳入到同一个模型实时决策,听、看、理解、推理、说话全在一个模型里"
A tradução: além de adicionar visão, a diferença em relação à abordagem de raciocínio delegado do GPT Live é que o SeedRealtime coloca som, imagem, temporização e expressão em um único modelo que decide em tempo real, de modo que ouvir, ver, entender, raciocinar e falar vivem todos no mesmo lugar. É uma descrição justa do design, e vem de uma conta que resume o anúncio, não que o testou.
O único número que a ByteDance publicou
Fui procurar uma tabela de benchmark e encontrei uma frase. A única afirmação quantitativa em todo o lançamento é que a avaliação humana de ponta a ponta mostrou que os problemas de ritmo conversacional caíram pela metade em comparação com modelos em cascata, junto com reduções qualitativas em interrupções, latência e falsos acionamentos.
Leve essa afirmação a sério, e ela ainda fica rasa em todos os eixos que permitiriam verificá-la. Sem número de avaliadores. Sem tamanho de amostra. Sem conjunto de avaliação nomeado. Sem protocolo. E a linha de base é a categoria genérica "modelos em cascata", não um concorrente nomeado que você pudesse ir medir você mesmo. Não estou dizendo que é falsa. Estou dizendo que é uma afirmação do fornecedor, e deveria ser atribuída como tal toda vez que for repetida.
Outros dois números circulam pela cobertura, e os dois são armadilhas. Os "2 a 3 segundos" da demo do espresso são o conselho do modelo sobre a extração do espresso, não uma cifra de latência do sistema. E o ID do arXiv que circulou como sendo o artigo do SeedRealtime, 2508.02193, pertence a algo completamente diferente: Seed Diffusion, um modelo de código de difusão de estados discretos, sem qualquer conexão com áudio ou vídeo.
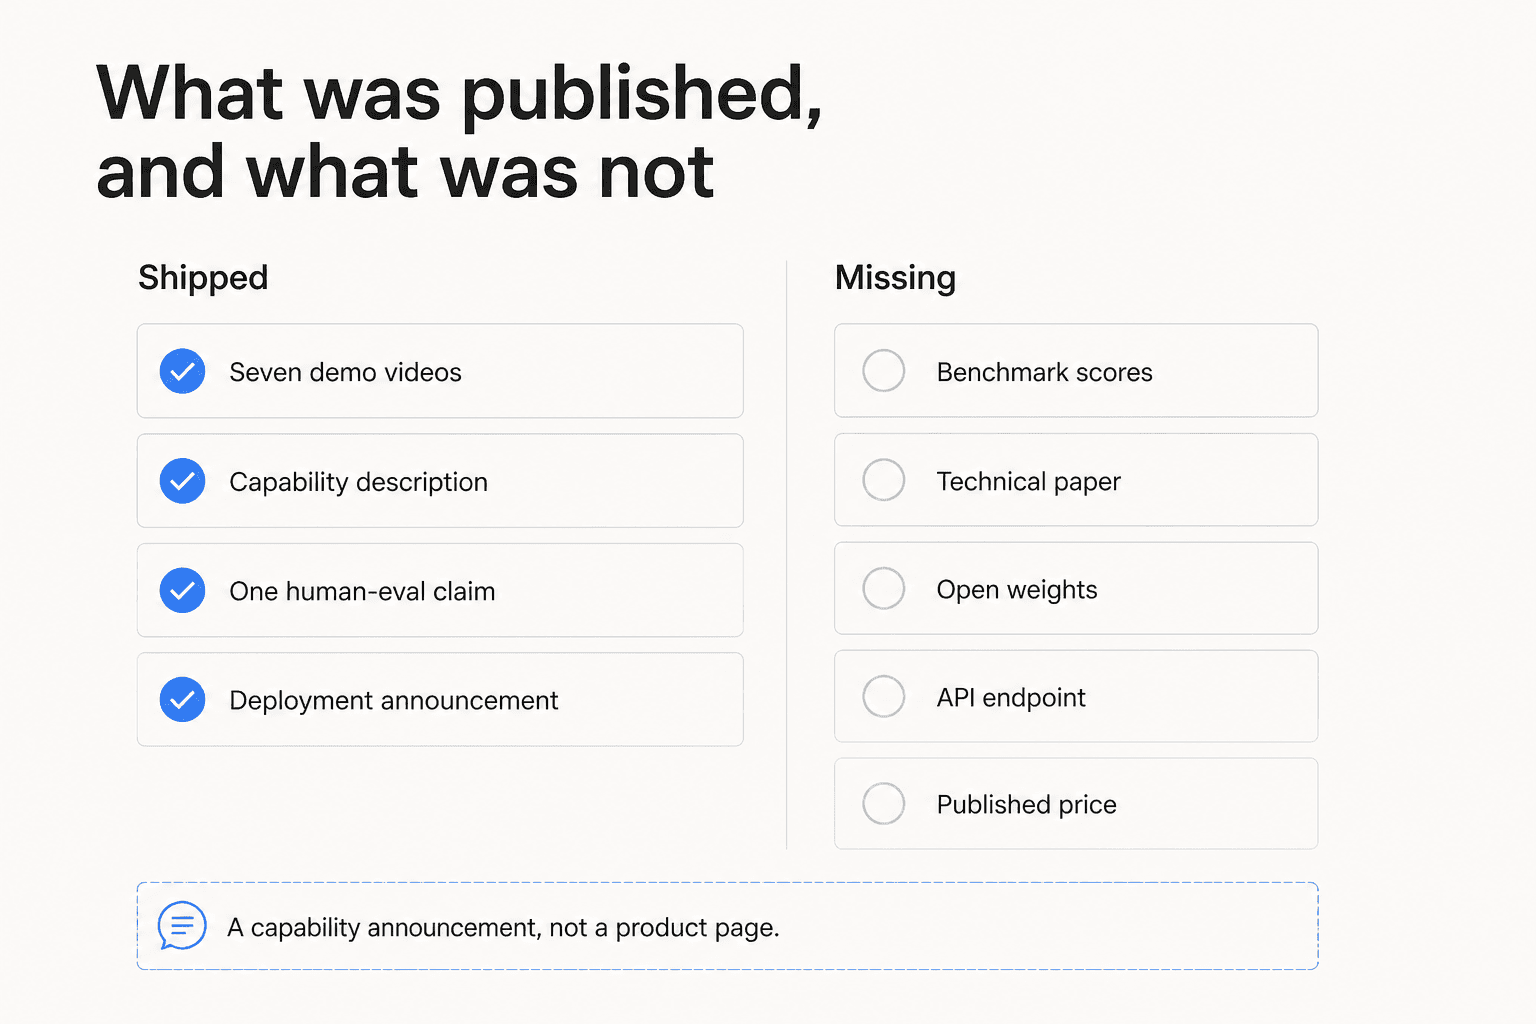
Não existe artigo do SeedRealtime. Uma busca de texto completo no arXiv retorna zero resultados, com buscas de controle funcionando bem na mesma sessão. O sinal mais revelador vem de dentro da própria equipe: o pesquisador da Seed Panwang Pan lista o SeedRealtime entre seus próprios trabalhos selecionados com links para Project, ModelCard e Blog, e nenhum link para artigo, enquanto todas as outras entradas dessa página têm um. Os pesos são fechados, sem repositório na organização ByteDance-Seed no GitHub nem no Hugging Face.
Isso é uma escolha, não uma norma. O Kimi K3 foi lançado com uma tabela de benchmark completa. O DeepSeek V4 Flash também. Um laboratório chinês publicar pontuações que você pode verificar não é nada excepcional em 2026.
O benchmark que ninguém rodou
Aqui está a descoberta que reformulou todo o artigo para mim. O SeedRealtime não aparece em nenhum lugar do ranking de voz para voz da Artificial Analysis. Nenhum modelo da ByteDance, Doubao, Seed ou Volcengine aparece também, em cinco gráficos e uma tabela-resumo de 36 linhas, obtida em 18 de agosto de 2026. Alibaba Cloud e StepFun estão listados, e o Qwen atualmente lidera dois dos três benchmarks componentes, então "laboratório chinês, logo ausente" não é a explicação.
Isso importa por causa do que os dois benchmarks principais medem.
O Full Duplex Bench pontua a mecânica de uma conversa em tempo real: não interromper durante uma pausa, assumir a vez corretamente, lidar com um usuário que interrompe, e continuar mesmo com um "uhum" no meio. É exatamente disso que trata a afirmação de ritmo do SeedRealtime. O teto é 98,4%, mantido pelo Qwen Audio 3.0 Realtime Plus, e a família atual do GPT Realtime fica na faixa de 91% a 96%. O topo desse gráfico está comprimido, o que é a forma educada de dizer que, entre os líderes, a dinâmica conversacional já não distingue mais ninguém. O Gemini 3.1 Flash Live, com 74,3%, é o único modelo de ponta que ele ainda distingue.
O 𝜏-Voice pontua outra coisa: a proporção de cenários replicados de atendimento ao cliente resolvidos agindo como agente de suporte. Um simulador de usuário por voz liga para o modelo com uma mudança de voo, uma cobrança contestada, uma falha de telecom. Cada tarefa tem um único estado final válido no banco de dados, e a pontuação compara o estado final com o gabarito. Ela mede se o trabalho foi feito, não se o modelo pareceu solícito. O teto ali é 56,5%, mantido pelo Grok Voice Think Fast 2.0 High.
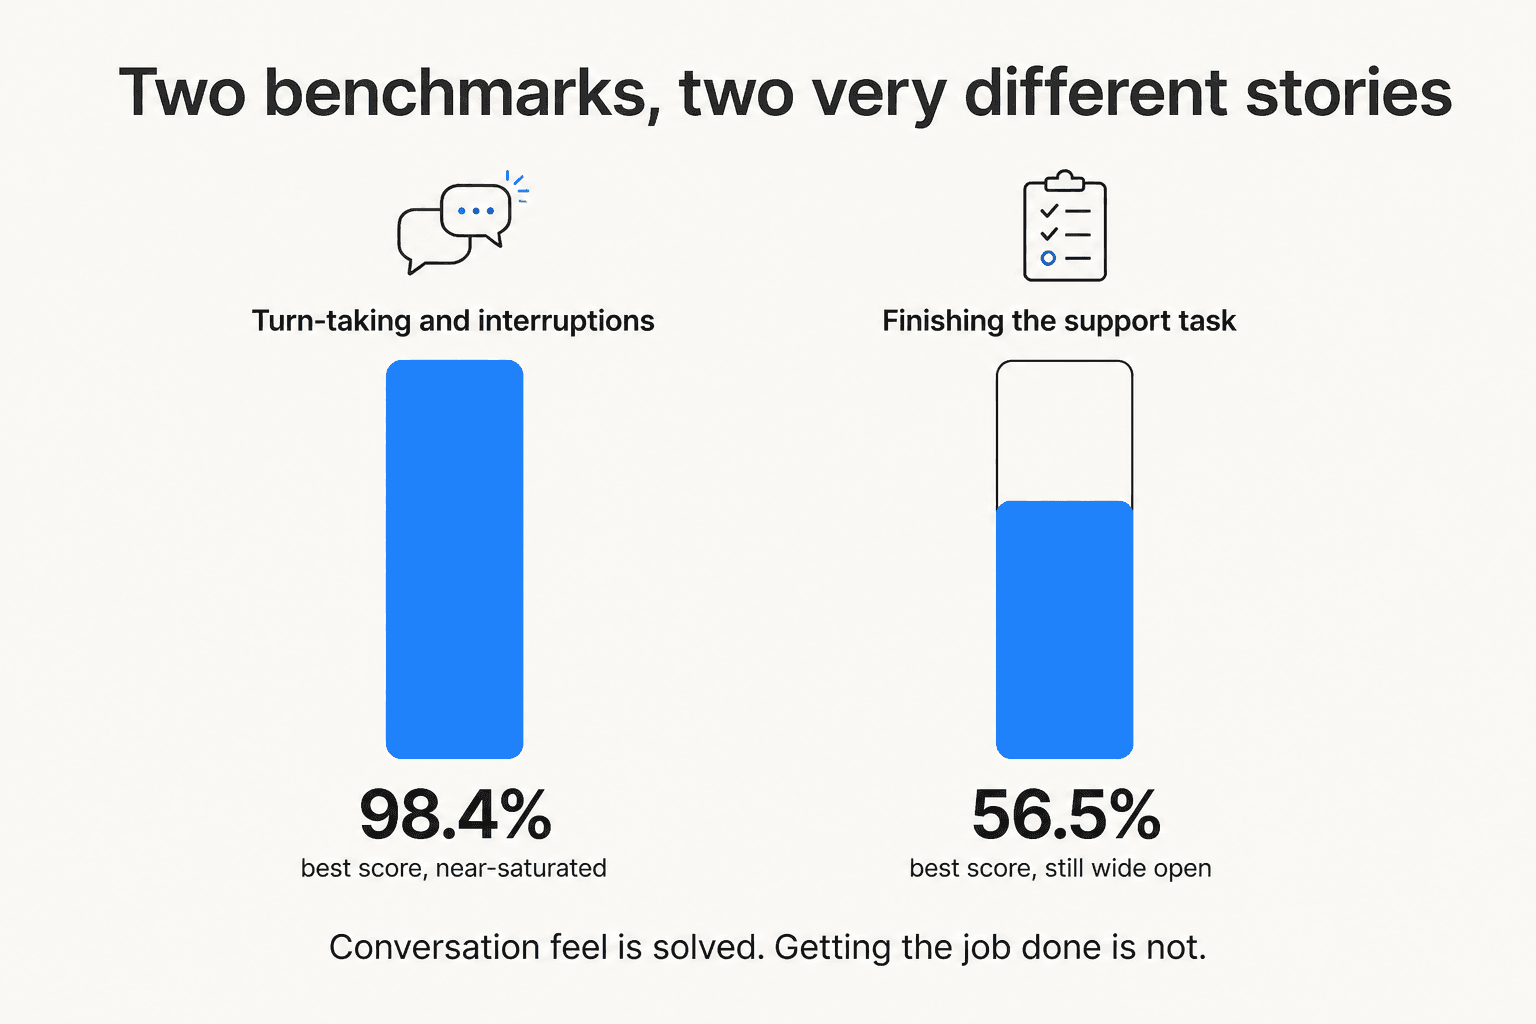
Pare para pensar nessa diferença. O melhor agente de voz disponível falha em cerca de 43% das tarefas de suporte replicadas, enquanto quase todo modelo de ponta lida com o ritmo da conversa quase perfeitamente. O setor resolveu como uma IA de voz soa, mas não resolveu se ela termina o trabalho. Ranking completo, para os modelos que são medidos:
| Modelo | Índice S2S | Raciocínio de fala | Dinâmica conversacional | 𝜏-Voice (conclusão de tarefas) | Tempo até o primeiro áudio |
|---|---|---|---|---|---|
| Qwen Audio 3.0 Realtime Plus | 84,1% | 99% | 98,4% | 54,6% | 1,54s |
| Grok Voice Think Fast 2.0 High | 82,9% | 97% | 95,1% | 56,5% | 0,70s |
| GPT-Realtime-2.1 High | 79,1% | 96% | 95,7% | 45,7% | 1,21s |
| Qwen Audio 3.0 Realtime Flash | 76,3% | 96% | 96,9% | 35,9% | 1,55s |
| Gemini 3.1 Flash Live High | 69,5% | 97% | 74,3% | 37,7% | 2,99s |
| Deepslate Opal | 62,8% | 85% | 85,7% | 17,5% | 0,44s |
| SeedRealtime | não avaliado | não avaliado | não avaliado | não avaliado | não publicado |
Note onde fica o modelo mais rápido. O Deepslate Opal responde em 0,44 segundo e resolve 17,5% das tarefas. A latência parou de ser o gargalo há um tempo, a mesma conclusão a que cheguei por outro ângulo no meu comparativo de modelos para tickets de suporte.
O que dizem as pessoas que realmente usaram
O sinal da comunidade sobre esse lançamento é escasso e desigual, e isso por si só já é revelador. O Reddit não tem nada: o r/LocalLLaMA estava discutindo ativamente opções full-duplex no mesmo período e nunca mencionou o SeedRealtime, o que é esperado quando não há pesos para baixar. O Hacker News tem uma submissão com 1 ponto e 0 comentários. O LinkedIn tem cerca de dez repostagens da mesma manchete de recapitulação. É o X que carrega a reação real.
A voz com mais credenciais pertence a alguém que trabalha com modelos de voz profissionalmente, e ela também funciona como a reclamação sobre acesso:
"why aren't more people talking about this?? audio-visual native FDX model is impressive, especially its ability to proactively detect and interact with the user based on visual cues.
GPT Live 1 is pure audio-only and doesn't have this capability.
has anyone tried it on Doubao? i don't have a Chinese phone number but really want to try 🥹"
A conta que divulgou a notícia em inglês disse a mesma coisa com menos palavras: "I wish it would be testable globally 😬".
O único relato substancial de uso real que encontrei está em chinês, e o que ele elogia não é o que a manchete vende:
"测试让豆包陪我一起看一个Youtube视频,画面出现个人,直接问这人是谁,竟然答对了!画面有个一闪而过的图表,问:"刚才有个图表,你能给我解读下吗?"。它竟然知道我指的是哪个图,并完整解释。"
Ele fez o Doubao assistir a um vídeo do YouTube com ele, perguntou quem era uma pessoa na tela e recebeu a resposta certa, depois perguntou sobre um gráfico que tinha passado rapidamente, e o modelo sabia a qual gráfico ele se referia e explicou por completo. Isso é resolução de referentes, não velocidade, e é a afirmação mais específica e verificada que alguém já fez sobre esse modelo. Uma continuação mostra ele apontando o dedo para um botão em um amplificador físico e recebendo uma resposta sensata.
Duas ressalvas surgiram, ambas de contas isoladas com pouco engajamento, então devem ser lidas como opiniões individuais, não como uma tendência. Alex Volkov, da ThursdAI, sobre o enquadramento de "gratuito no Doubao": "Free or charge... holy surveilance" (o erro de digitação é do original). E um ponto metodológico mais afiado sobre a demo do jantar:
"holding onto four names through overlapping crosstalk is a harder party trick than watching and listening at the same time, most "multimodal" demos never actually test the crosstalk part."
Esse é o instinto certo. O caso das conversas sobrepostas é o caso interessante, e um carretel de demonstração não é teste adversarial.
Dá para construir sobre isso? A armadilha dos três nomes de modelo
É aqui que a maioria dos textos erra, então vale a pena ser preciso. A ByteDance tem três modelos em tempo real com nomes confusamente parecidos, e só dois deles estão à venda.
| Modelo | O que é | Pode ser usado hoje? |
|---|---|---|
| SeedRealtime | Full-duplex audiovisual nativo: áudio, vídeo e texto em um único modelo | Não. Só no aplicativo Doubao. Sem API, sem preço. |
Seeduplex (豆包实时语音模型 3.0, modelo 1.2.6.1) | Full-duplex nativo apenas de voz, escuta enquanto fala, detecção adaptativa de fim de turno | Sim, via WebSocket |
| Doubao-Seed-RealtimeVoice (O2.0 / SC2.0) | Half-duplex mais antigo, voz para voz apenas em áudio | Sim, mas sua documentação já está classificada como legado |
A versão simples: a única coisa que você pode comprar é apenas voz. A visão, que é o que torna o SeedRealtime interessante, não está à venda. Verifiquei a especificação de cobrança de voz da Volcengine, que lista cada SKU de voz que pode ser comprado, a lista de preços de modelos da Ark, e a tabela de preços de produtos da Doubao. O SeedRealtime não tem nenhuma linha em nenhuma delas, nem pré-pago nem pós-pago. Toda referência à sua disponibilidade é dentro do aplicativo.
A documentação da Volcengine também observa que as versões O e SC do modelo mais antigo pararam de ter iteração independente, com as capacidades convergindo para a linha 2.0. Então, se você está começando hoje, o Seeduplex é o modelo para usar como base.
Quanto o Seeduplex realmente custa
O modelo em tempo real que pode ser comprado é cobrado por token, não por minuto, e apenas em modo pós-pago. É a única SKU de voz sem nenhum pacote de recursos pré-pago em toda a escala de descontos da Volcengine, o que significa que você paga o preço de tabela independente do seu volume. Taxas abaixo, convertidas a ¥6,74 por dólar (USD/CNY 6,7411, 17 de agosto de 2026); a Volcengine cobra apenas em yuans.
| Medidor | Preço (CNY) | Aprox. em USD |
|---|---|---|
| Entrada, texto | ¥10 / M de tokens | US$ 1,48 / M |
| Entrada, áudio | ¥80 / M de tokens | US$ 11,87 / M |
| Entrada, em cache (texto ou áudio) | ¥5 / M de tokens | US$ 0,74 / M |
| Saída, texto | ¥80 / M de tokens | US$ 11,87 / M |
| Saída, áudio | ¥300 / M de tokens | US$ 44,51 / M |
A Volcengine publica a conversão de áudio para token, o que é o que torna isso comparável a uma taxa por minuto: o áudio de entrada roda a cerca de 6,25 tokens por segundo, o áudio de saída a cerca de 25 tokens por segundo. Faça a conta e o formato da fatura fica evidente.
| Unidade derivada | CNY | USD |
|---|---|---|
| 1 minuto de fala do usuário, entrando | ¥0,030 | US$ 0,0045 |
| 1 minuto de fala do modelo, saindo | ¥0,450 | US$ 0,067 |
| 1 hora de diálogo, divisão igual, só áudio | ¥14,40 | US$ 2,14 |
| 1 hora de fala contínua do modelo | ¥27,00 | US$ 4,01 |
Essas linhas derivadas são minha própria conta a partir da conversão declarada pela própria ByteDance, não um preço por minuto publicado, e uma fatura real sai mais alta porque cada turno também carrega tokens de texto e o contexto que se acumula. O próprio exemplo calculado pela Volcengine precifica uma única troca de 40 segundos em ¥0,0974, cerca de US$ 0,014.
Para dar contexto sobre se isso é caro: a OpenAI lista o áudio do GPT Realtime a US$ 32 por milhão de tokens de entrada e US$ 64 por milhão de saída, enquanto o Gemini 3.1 Flash Live do Google fica em US$ 3,00 de entrada e US$ 12,00 de saída por milhão, o que dá aproximadamente US$ 0,005 e US$ 0,018 por minuto. A ByteDance fica entre os dois na entrada e acima do Google na saída, e meu comparativo de preços do Gemini tem a tabela completa do Google. Preços do GPT Realtime Mini cobre a camada mais barata da OpenAI.
A alavanca está bem ali, na tabela. O áudio de saída custa quinze vezes mais por segundo que o áudio de entrada, então a maior coisa que você controla é quanto o modelo fala. Uma ressalva sobre a própria tabela de preços: a tabela lista o texto de saída a ¥80 por milhão de tokens, mas o exemplo calculado na mesma página o conta a ¥30, e só ¥30 bate com o total informado. Trate essa linha como não resolvida até você ver uma fatura real.
Os detalhes de acesso que decidem se isso é real para você
O custo é a parte fácil. O atrito está em todo o resto, e vale a pena listá-lo claramente, porque nada disso aparece no anúncio.
- Só WebSocket, em
wss://openspeech.bytedance.com/api/v3/duplex/realtime/dialogue, com um único cabeçalhoX-Api-Keyemodelfixo em1.2.6.1. - No formato do OpenAI-Realtime, mas não compatível com a OpenAI. Os nomes dos eventos são emprestados (
session.create,conversation.item.create,response.cancel), mas é o endpoint da Volcengine com a autenticação da Volcengine. Familiar de ler, mas não um substituto direto, o que é uma situação diferente da descrita no meu guia sobre a Realtime API e o WebRTC. - Limites que o dinheiro não compra passagem. 60 sessões por minuto, 100.000 tokens por minuto, e o modelo em tempo real está ausente da tabela de complementos de concorrência que cobre texto para voz e reconhecimento de voz. Aumentar os limites passa pelo time de vendas.
- Pensado primeiro para o chinês, e a documentação diz isso. Uma página indica suporte a chinês e inglês; a seção de limitações na mesma página diz que o modelo de ponta a ponta só tem bom suporte ao chinês e não garante qualidade em outros idiomas. Quatro vozes chinesas premium, três vozes em inglês americano disponíveis apenas em uma versão de modelo mais antiga.
- Na prática, uma conta da China continental. Preços só em yuans, uma região fixa cn-beijing, ativação explícita do serviço e moderação de conteúdo ativada por padrão.
- O contexto é de 12K no total, cobrindo o prompt de sistema mais o histórico da conversa.
Para um time de suporte fora da China, essa lista é a resposta. Isso ainda não é uma decisão de plataforma.
O que isso significa se você for colocar IA em uma fila de suporte
Eu construo agentes de IA para helpdesks, então deixe-me ser direto sobre por que nada disso muda minha semana.
O motivo pelo qual um rollout de suporte falha quase nunca é a vez de falar da IA parecer rígida. É a IA responder com confiança e errar, ou responder a um ticket que deveria ter sido passado para um humano, o que é um problema de design de escalonamento. Um cliente, um time dinamarquês de telemática veicular no Zendesk tratando cerca de 200 tickets por mês e crescendo para 2.000, caiu exatamente nessa: sua base de conhecimento dizia que eles davam suporte a todos os modelos, então o bot confirmava alegremente suporte para marcas de carro que nem estavam no banco de dados. Nada em um ritmo conversacional mais suave resolve isso. Um retrieval e embasamento melhor, sim.
O segundo motivo é controle, e é de longe a objeção mais comum que eu ouço. Um líder de CX de uma marca de suplementos DTC no Gorgias e Shopify, tratando cerca de 7.000 tickets por mês contra 30.000 pedidos, colocou assim para mim:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Isso é um problema de 𝜏-Voice disfarçado de cotidiano. Ele está perguntando sobre os 43%. Um modelo que marca 98,4% em dinâmica conversacional e 56,5% em conclusão de tarefas é, do ponto de vista dele, um colega muito educado que erra em quatro de cada dez casos e nunca diz isso. É por isso que a alavanca útil são limiares de confiança e um caminho de escalonamento claro, não um modelo mais rápido.
Então uma leitura prática do SeedRealtime, se você trabalha com suporte:
- Não espere por ele. Sem API, sem preço, sem benchmark, só um aplicativo chinês. Não é uma opção de compra.
- Observe o eixo da visão, não o eixo do duplex. Resolver "aquele gráfico de agora" a partir do que está na tela é uma capacidade nova de verdade, e onde ela vai aparecer primeiro é no suporte por compartilhamento de tela e na solução visual de problemas, não nas filas de telefone.
- Julgue cada modelo de voz pela conclusão de tarefas. Pergunte a qualquer fornecedor sua pontuação de 𝜏-Voice. Se não houver uma, essa é a resposta. Meu panorama de IA para suporte por voz passa pelos que são medidos, e IA atendendo chamadas de suporte cobre o lado operacional.
- Comece onde está o volume. A maioria das filas ainda é predominantemente de texto, e só a triagem de tickets já traz mais retorno que um piloto de voz, por uma fração do risco. A deflexão de tickets é a outra coisa que vale a pena fazer primeiro.
Para o panorama mais amplo, o comparativo dos melhores softwares de helpdesk com IA cobre o que realmente está saindo este ano.
Se você está antes desse ponto e ainda entendendo o que esses agentes fazem, software de atendimento ao cliente com IA é a introdução à categoria.
Experimente o eesel
Se você está avaliando tudo isso para uma fila de suporte real, a pergunta que realmente decide o resultado não é qual modelo observa sua câmera. É se a coisa vai estar certa nos seus tickets, usando sua central de ajuda e suas conversas passadas, antes que um cliente a encontre.
Essa é a parte em torno da qual o eesel é construído. Ele se conecta ao helpdesk que você já usa, aprende com suas macros existentes e seu histórico de tickets em vez de precisar de uma base de conhecimento nova, e reproduz seus tickets passados reais em simulação para que você veja a taxa de resolução e as respostas exatas antes de qualquer coisa ir ao ar. Você define quais tipos de ticket ele toca e para onde ele transfere, então o problema de "deixar o resto em paz" mencionado acima se torna uma configuração, não uma esperança. É gratuito testar, e você pode estar vendo resultados simulados no seu próprio histórico já nesta tarde.

A voz full-duplex vai chegar ao suporte eventualmente, e quando isso acontecer, os modelos que vencerem serão os que conseguirem provar um número de conclusão de tarefas. Até então, o trabalho nada glamouroso de embasar um agente de suporte com IA no seu próprio conhecimento é de onde vem a taxa de resolução.