

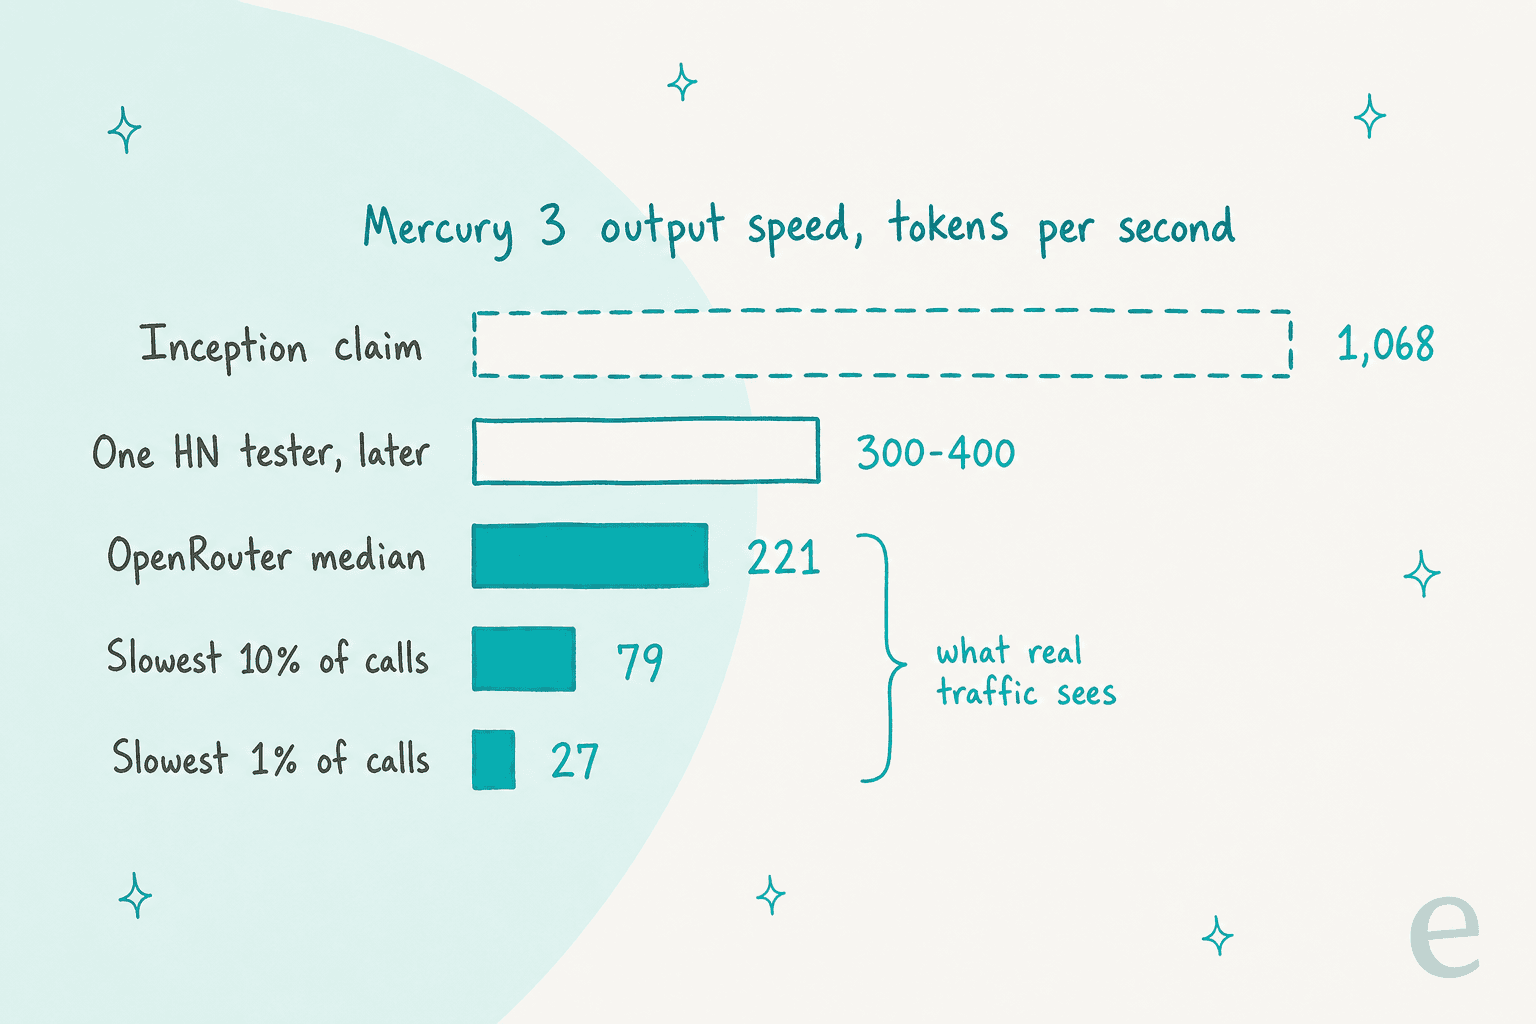
Meu veredito: 3,7 de 5. O Mercury 3 é o melhor argumento até agora de que um modelo de linguagem de difusão pode ser inteligente além de rápido. Na tabela da própria Inception, ele supera o GPT-6 Luna e o Claude Haiku 5.5 em 10 de 12 benchmarks, e no tráfego ao vivo do OpenRouter roda a uma mediana de 221 tokens por segundo, mais rápido que os dois rivais, mas um quinto dos 1.068 que a Inception anuncia.
O que segura a nota: os 10% de requisições reais mais lentas se arrastam a 79 tokens por segundo ou menos, todos os benchmarks rodaram em esforço médio enquanto a API usa low por padrão, ainda não há um ranking independente, e ele aceita só texto, com piso de temperatura de 0,5. No lançamento custa US$ 0,10 de entrada e US$ 0,35 de saída por milhão de tokens; planeje o orçamento com o preço de tabela de US$ 0,20 / US$ 0,70.
Para quem serve: quem constrói agentes com longas cadeias de chamadas ao modelo, agentes de busca e de navegador e subagentes de código. Quem deve esperar: quem precisa de imagens, pesos abertos, saída determinística ou recuperação comprovada em documentos longos. Para equipes de suporte, é um motor forte, mas ainda é só um motor. O colega de IA para o helpdesk da eesel é o funcionário que transforma um modelo em tickets respondidos, como a Lesson Pro o faz anotar e redigir cerca de 1.900 tickets do Zendesk por mês.
Como analisei o Mercury 3
Eu construo funcionalidades e agentes de IA na eesel, então leio o lançamento de um modelo de forma diferente de uma tabela de benchmarks. Eu me importo com as emendas: o que a API faz por padrão, como a saída é transmitida, o que acontece nas requisições lentas e onde um agente quebra quando o modelo é o elo fraco. A eesel roda IA em filas de suporte reais há anos, e o hábito que ficou é que nenhum modelo chega perto de um cliente antes de reproduzir tickets reais do passado. Números de laboratório nunca nos disseram se algo funciona.
Esta análise se apoia em quatro coisas. O post de lançamento da Inception e a documentação da API. A página de desempenho do OpenRouter, que publica percentis de tráfego real. O tópico de lançamento no Hacker News, onde as pessoas o testaram no próprio trabalho em poucas horas. E o app de chat da própria Inception, que mostra o processo de difusão na tela.
Se você quer primeiro o básico do lançamento (especificações, a tabela completa de benchmarks, formas de acesso), comece pela minha visão geral do Mercury 3. Se só se importa com custo, o detalhamento dos preços do Mercury 3 feito por Rama calcula por tarefa. Este post é o veredito.
Placar do Mercury 3
Veja como pontuei, e por quê.
| Categoria | Nota | Por quê |
|---|---|---|
| Velocidade real | 4,0 / 5 | Mediana de 221 tok/s no OpenRouter supera Luna e Haiku, mas a cauda é lenta |
| Qualidade para a categoria | 4,0 / 5 | À frente em 10 de 12 benchmarks do fabricante, nível Luna ou Haiku no uso diário |
| Preço | 3,5 / 5 | Saída mais barata da categoria no lançamento, a mais cara a preço de tabela |
| Confiabilidade | 3,5 / 5 | 0,58% de erros em chamadas de ferramenta, 2,51% de erros em saída estruturada no OpenRouter |
| Maturidade e abertura | 3,5 / 5 | Sem benchmarks independentes, só texto, pesos fechados, tamanho não divulgado |
| Geral | 3,7 / 5 | Um passo real para os LLMs de difusão, melhor como modelo auxiliar rápido |
A nota subiria rápido se duas coisas acontecerem: um ranking independente como o Artificial Analysis confirmar a tabela de benchmarks e a cauda lenta do OpenRouter se estreitar conforme a Inception adiciona capacidade. Nenhuma das duas é verdade no dia do lançamento.
O que a difusão muda na prática
Quase todo modelo que você já usou, do GPT-6.1 Sol ao DeepSeek V4.1 Flash, escreve um token por vez, da esquerda para a direita. O Mercury 3 rascunha a resposta inteira como texto ruidoso e a refina em algumas passadas. Minha explicação sobre modelos de difusão cobre a teoria. Para uma análise, o que importa é o que isso faz com o seu código e com os seus usuários.
O texto chega em blocos, não em tokens
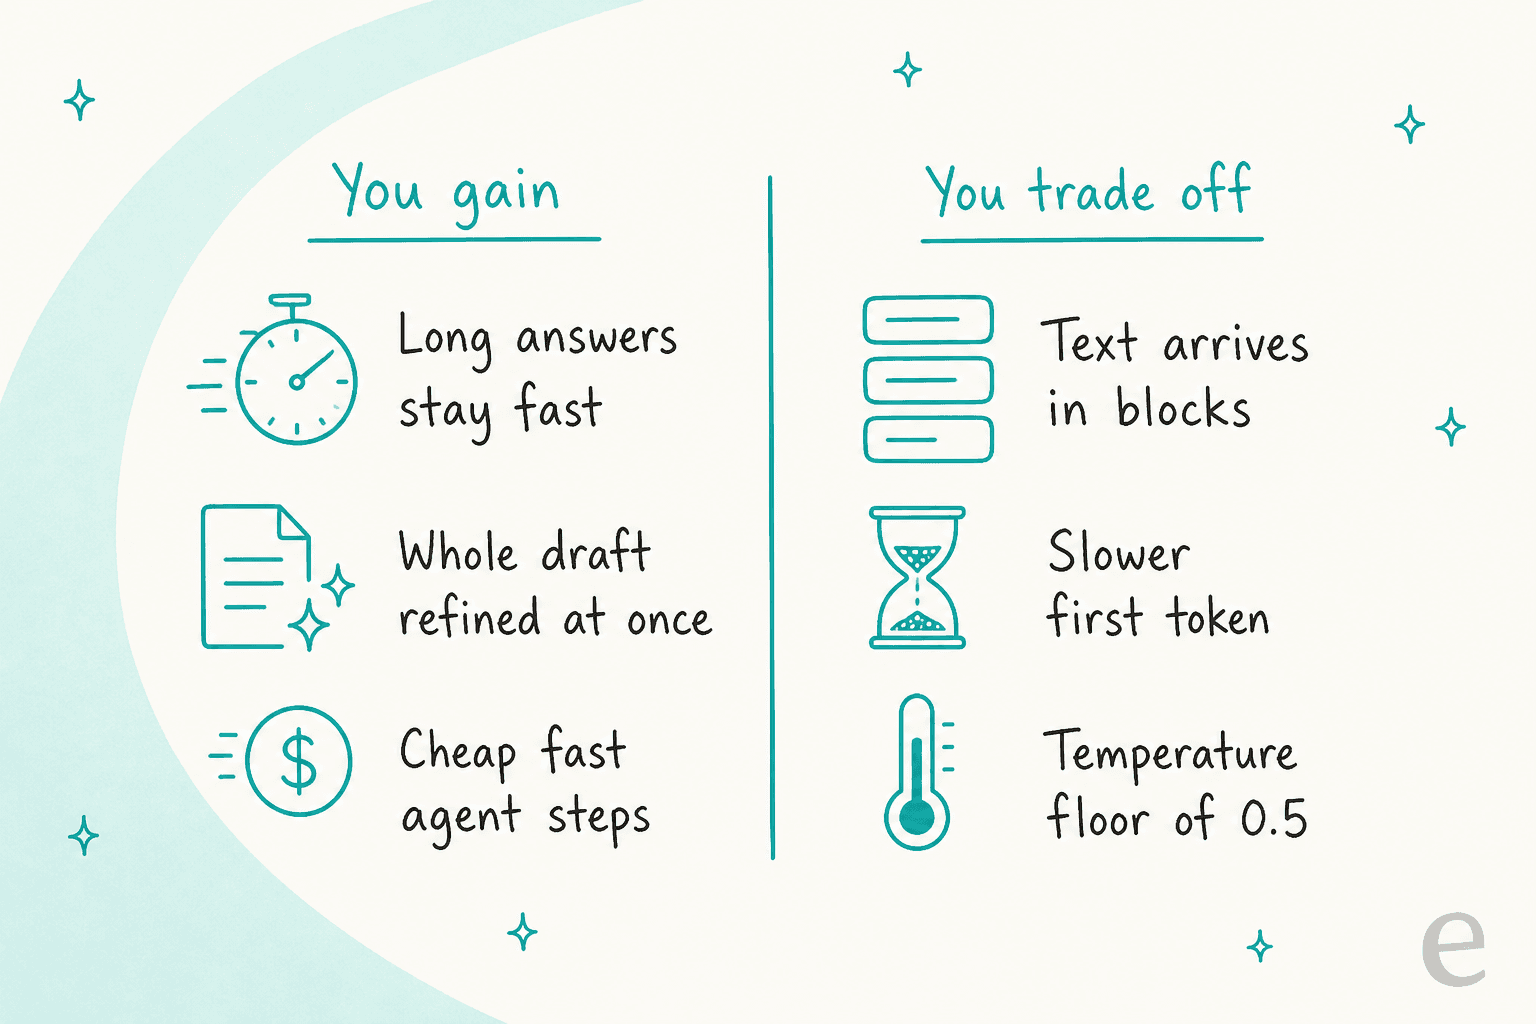
A documentação de streaming da Inception diz que as respostas são transmitidas "block-by-block", em que um bloco é um pedaço de texto refinado, não um único token. Numa janela de chat isso parece diferente do pingar palavra por palavra a que estamos acostumados: nada, depois uma frase, depois a próxima. Há também um modo opcional diffusing em que cada pedaço é a resposta inteira até ali, então sua interface precisa sobrescrever o texto a cada passo em vez de acrescentar. É uma demo divertida e um bug fácil se o seu front end presume que se acrescenta.
Este também é meu melhor palpite para explicar por que os testadores do Hacker News ficavam mencionando o tempo até o primeiro token. Um escreveu "Ttft is quite slow with mercury" no tópico de lançamento, e outro testador disse "the issue with speed seems to be that ttft is still high." Tokens por segundo dizem a que velocidade a resposta termina, não quão cedo o usuário vê algo.
Respostas longas quase não custam mais tempo
A vantagem é o outro lado da moeda. Um modelo token a token leva o dobro do tempo para escrever o dobro. Um modelo de difusão refina o bloco inteiro em paralelo, então a diferença aumenta conforme respostas e raciocínio ficam mais longos. O cofundador da Inception, Volodymyr Kuleshov, destacou isso no dia do lançamento: quanto mais os modelos de raciocínio pensam por resposta, mais a vantagem de velocidade cresce. Por isso o modelo combina mais com agentes de vários passos do que com respostas de uma linha.
Os padrões não são o modelo avaliado
Este é o detalhe que eu apontaria a qualquer equipe que o experimente. Toda pontuação da tabela de lançamento da Inception foi obtida com esforço de raciocínio medium. Mas a documentação do esforço de raciocínio diz que, se você omitir reasoning_effort, o mercury-3 usa low por padrão. O Mercury 2 e o 2.5 usavam medium.
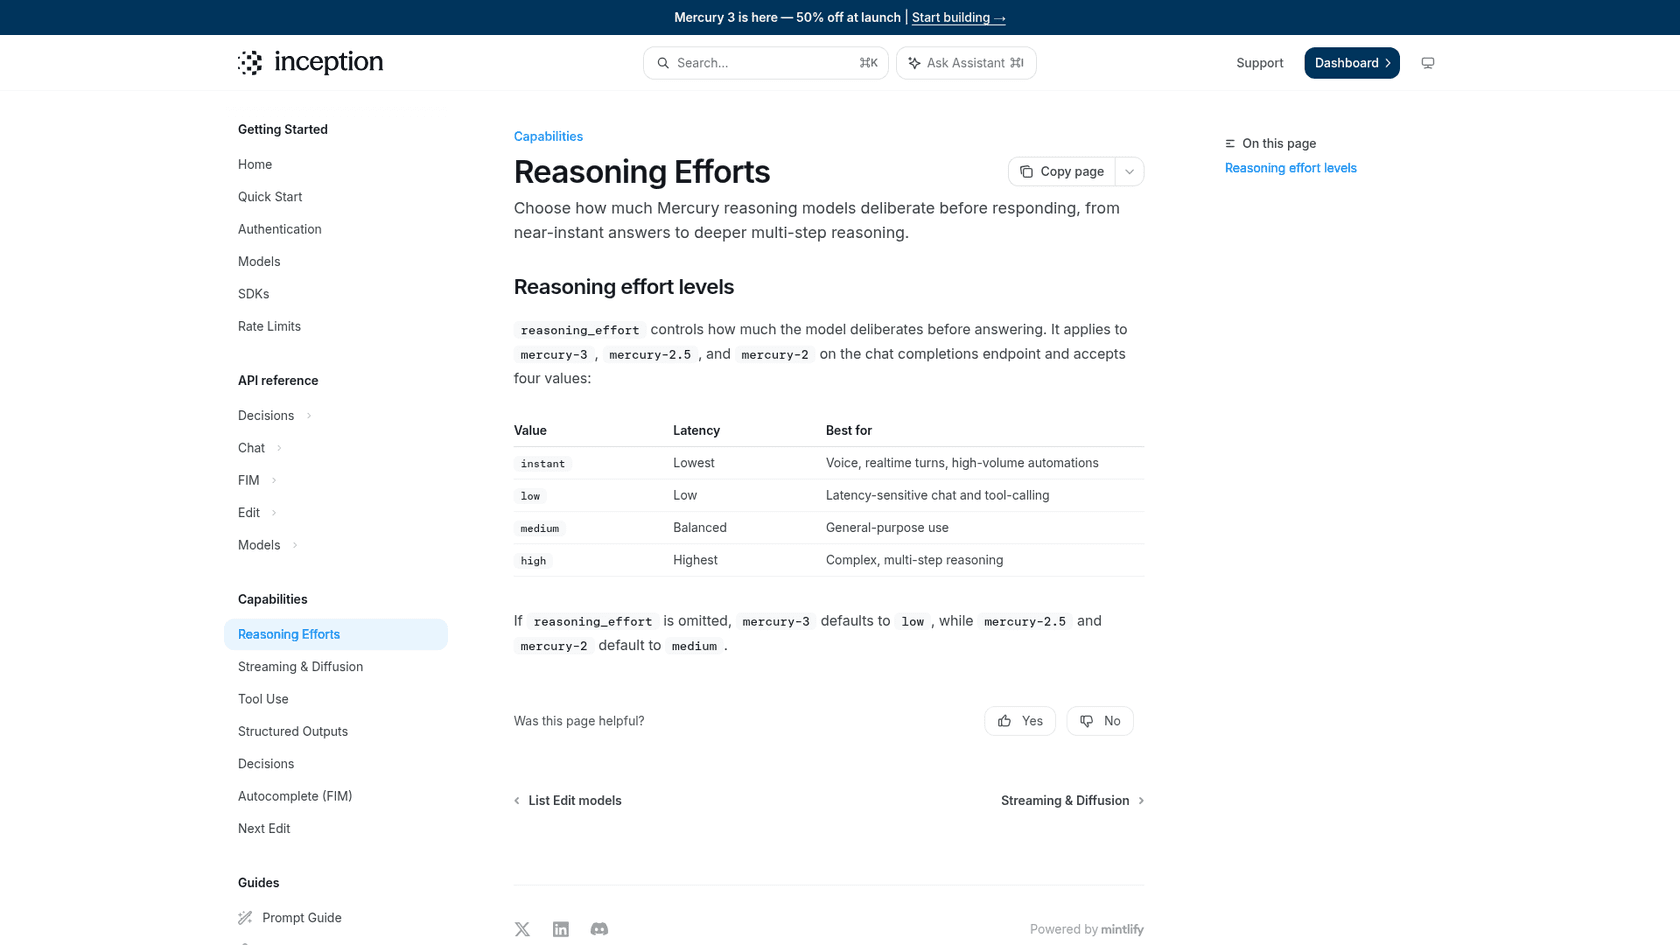
Então um teste rápido sem esforço definido está testando uma configuração mais rápida e leve que a da tabela. É um padrão sensato para velocidade, mas defina medium explicitamente antes de comparar qualidade. E não presuma que high é melhor: um testador notou, nos desenhos de pelicano de Simon Willison, que "the medium pelican is better than the high". É um rabisco, não um benchmark, mas é um bom motivo para testar cada nível na sua própria tarefa.
A temperatura começa em 0,5
A documentação de modelos da Inception lista a temperatura do Mercury 3 como ajustável de 0,5 a 1,0. Se o seu pipeline define temperatura 0 para saída repetível (classificação, extração, dados de teste), aqui não dá. Combine-o com saídas estruturadas e uma verificação de esquema. Para tarefas de rotulagem pura, o modelo separado da Inception, o Mercury Decide, é feito para classificação.
Velocidade anunciada contra velocidade medida
O número da Inception é de 1.068 tokens de saída por segundo em GPUs NVIDIA. Minha visão geral cobriu a diferença na mediana. O que eu queria nesta análise era a dispersão, porque a espera total de um agente é definida pelas chamadas lentas, não pelas médias.
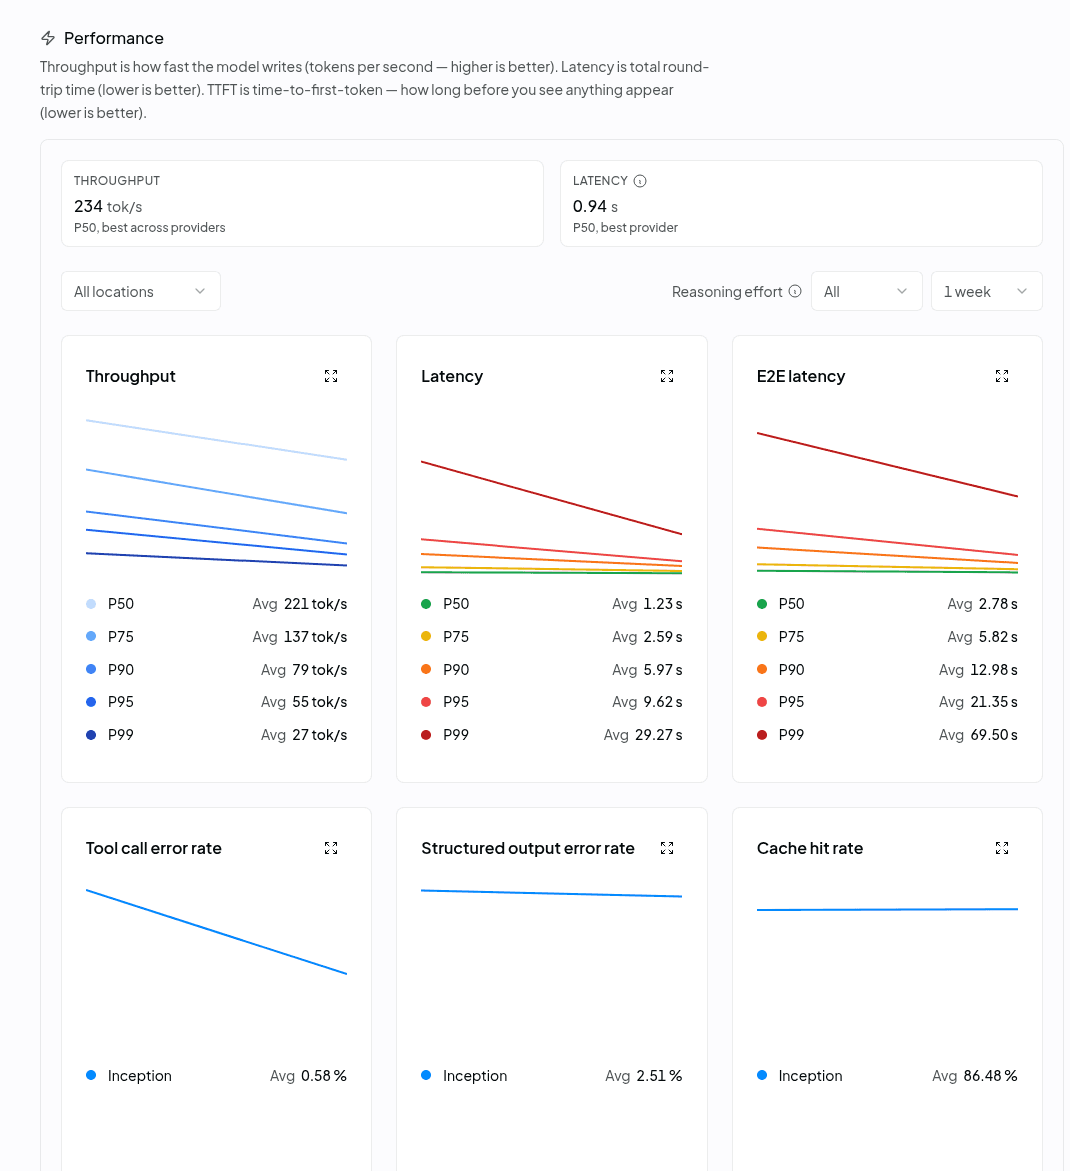
O OpenRouter encaminha toda requisição do Mercury 3 para a Inception e publica percentis. Foi isto que a página de desempenho mostrou em 20 de outubro de 2026, em média de uma semana:
| Percentil | Vazão | Latência | Ponta a ponta |
|---|---|---|---|
| P50 | 221 tok/s | 1,23 s | 2,78 s |
| P75 | 137 tok/s | 2,59 s | 5,82 s |
| P90 | 79 tok/s | 5,97 s | 12,98 s |
| P95 | 55 tok/s | 9,62 s | 21,35 s |
| P99 | 27 tok/s | 29,27 s | 69,50 s |
A mediana é boa. A tabela da própria Inception coloca o GPT-6 Luna em cerca de 130 tokens por segundo e o Haiku 5.5 em cerca de 240, então o Mercury 3 no tráfego real fica mais ou menos no nível do Haiku e bem à frente do Luna. O problema é a cauda: uma em cada dez requisições roda a 79 tokens por segundo ou menos, e uma em cada cem leva mais de um minuto de ponta a ponta.
Duas ressalvas mantêm isso justo. O OpenRouter mistura todos os níveis de esforço que seus usuários escolhem, e o tráfego da semana de lançamento é irregular. As velocidades já estavam melhorando para alguns usuários no fim do primeiro dia:
"I've been trialing this for the last few hours. It was quite slow at first, but now I'm getting around 300-400tps. Still nowhere near 1000tps, but it's still incredibly fast compared to what I'm used to with other models."

Simon Willison, por outro lado, achou a velocidade "a bit disappointing" e não viu ganho ao chamar a API da Inception diretamente em vez de pelo OpenRouter. Minha leitura: a mediana é real e útil hoje, o número de 1.068 é o melhor caso no hardware da própria Inception, e a cauda é o número a acompanhar no próximo mês. Se você compara opções de velocidade pura, meu post sobre o Groq 3 LPX cobre o caminho do hardware em vez do caminho do modelo.
Checagem de realidade dos benchmarks
A tabela de lançamento é forte. O Mercury 3 supera Luna e Haiku 5.5 em 10 de 12 testes cada, e as maiores diferenças estão no trabalho de agentes: SWE-Bench Atlas com 51,08 contra 33,33 do Luna, e τ³-bench Banking com 30,24 contra 23,00 e 13,06. A tabela completa está na minha visão geral do Mercury 3, então aqui me concentro em quanto peso ela aguenta.
- É a execução da Inception. Ainda não há página do Artificial Analysis para o Mercury 3, e Kuleshov disse no Hacker News que benchmarks de terceiros e tempos de conclusão de tarefas ainda virão.
- Um único nível de esforço. Todas as 12 linhas estão em medium. Um comentarista perguntou por quê, observando que não há uma curva de low a max. Não sabemos se Luna ou Haiku diminuem a diferença com esforço maior.
- As derrotas são apertadas; algumas vitórias são largas. Fica atrás do Luna no AA-Omniscience (46,44 vs 46,94) e no AA-LCR (77,67 vs 78,30) por pouco, e atrás do Haiku 5.5 no MRCR v2 (75,50 vs 78,40) e no DeepSWE (46,31 vs 51,62). Recuperação em documentos longos é a área que eu testaria com mais rigor.
- A leitura do próprio fabricante é modesta. Kuleshov o descreveu como nível Haiku ou Luna no uso diário, que acho ser o enquadramento honesto.
"That means that it won't yet replace Opus or Fable as the primary driver of a harness, but we have used it successfully for subagents"
Os relatos práticos batem com isso. Um desenvolvedor construiu um pequeno app de macOS de ponta a ponta com ele:
"I made it come up with a plan for this tool and had it implement the thing end to end in about 8 or 9 steps. It originally messed up the coordinate calculation but quickly corrected that when I pointed it out and other than that it one-shotted all the other steps."
O mesmo testador disse que o trabalho usou 26 milhões de tokens, 1,3 milhão deles sem cache, a cerca de 160 tokens por segundo. É um retrato real útil: um harness de código reenvia muito contexto, e por isso o preço do cache importa tanto quanto a tarifa principal. Outro testador reconstruiu um renderizador de UML em três turnos e disse que ele atualizou o HTML corretamente.
Pontos fortes e limites
Aqui está a versão equilibrada, na ordem em que eu os pesaria.
Onde é forte:
- Loops de agentes. A velocidade se acumula quando uma tarefa faz uma dúzia de chamadas seguidas ao modelo. A TinyFish, parceira de lançamento da Inception, diz ter concluído metade de 50 tarefas web ao vivo do Mind2Web, "significantly more than GPT-6.1-Sol."
- Trabalho auxiliar e de subagentes. Compactação de contexto, roteamento, resumo da saída de ferramentas. No antigo Mercury 2, a Augment Code relatou queda de 82% na latência de compactação e de 90% no custo em relação ao modelo anterior. Isso é o Mercury 2, mas o Mercury 3 traz a mesma proposta com um modelo maior.
- Contextos longos a preço fixo. Uma janela de 1M de tokens a uma tarifa só, enquanto o Haiku 5.5 cobra 5x acima de 100K tokens. Meu guia de preços do Haiku 5.5 tem os detalhes.
- Fácil de testar. É compatível com a OpenAI, com 100 milhões de tokens grátis em chaves novas e guias de configuração para Cursor, LangChain e Vapi.
Onde é limitado:
- A cauda lenta. Vazão P90 de 79 tok/s e tempo de ponta a ponta P99 de 69,5 segundos na visão de uma semana do OpenRouter.
- A saída estruturada não é perfeita. O OpenRouter mostra taxa de erro de 2,51% em saída estruturada, então mantenha um validador no fluxo.
- Só texto, pesos fechados, tamanho não divulgado. A Inception diz que o multimodal está em protótipos internos. Para pesos de difusão abertos, a alternativa é o DiffusionGemma.
- Preço depois da promoção. A US$ 0,70 por milhão de tokens de saída, o preço de tabela fica acima dos US$ 0,50 de Luna e Haiku, e a Inception não anunciou data de fim para o desconto de 50%.
- A disponibilidade ainda está se acertando. A disponibilidade de três dias do OpenRouter foi de 99,26%, com quedas visíveis no dia do lançamento.
O Mercury 3 serve para a sua carga de trabalho?
A maior parte da decisão de "trocar ou não" se resume a três perguntas: quantas chamadas ficam em sequência, se há uma pessoa esperando e se você precisa de algo que o Mercury 3 não oferece. O seletor abaixo guia você por elas.
Responda a três perguntas para ver se o Mercury 3 serve para uma carga de trabalho e o que testar antes de trocar.
O padrão é simples: quanto mais chamadas em sequência e quanto mais uma pessoa espera, mais o Mercury 3 merece seu lugar. Para uma única chamada em segundo plano, a velocidade não muda nada, e a preço de tabela Luna ou Haiku são a opção mais barata. Meu detalhamento dos preços do GPT-6 Luna tem o lado deles dessa conta.
Como o Mercury 3 se encaixa em uma carga de suporte
O suporte é um dos quatro usos em produção que a Inception cita, e o lançamento traz a Lorikeet, fornecedora de IA para suporte, dizendo que o Mercury 3 "beat other models on latency while also performing higher on evals and in production." O benchmark mais próximo de suporte, o τ³-bench Banking, é também onde a vantagem do Mercury 3 é maior.
Mas leia essa nota com cuidado. Um 30,24 significa que o modelo falhou na maioria dessas tarefas bancárias simuladas, só que menos que seus rivais. Isso é normal em modelos pequenos e rápidos, e é a razão pela qual um modelo nunca é o agente de suporte inteiro. A velocidade ajuda mais em canais ao vivo, como o chat ao vivo com IA e os agentes de voz, em que um cliente está olhando a tela. Em tickets de e-mail, uma diferença de dois segundos não muda nada.
Onde um modelo auxiliar rápido melhor se encaixa em suporte é na pilha de pequenas tarefas em volta de cada resposta. Pense em triagem de tickets, etiquetagem, resumo de conversas longas e busca de detalhes de pedidos. É o mesmo padrão de subagentes que a Inception descreve para código. E é também como uma implantação real de suporte se parece quando você a abre.
A Lesson Pro, que opera marcas de aulas particulares como a GOSKATE, é um bom exemplo. Seus agentes eesel trabalham em duas contas do Zendesk. Em cada ticket, o agente primeiro descobre a qual marca o cliente pertence, depois deixa uma nota interna e redige uma resposta assinada por essa marca. Candidaturas a vagas, mensagens de voz e formulários de pedido são ignorados de propósito. Entre 8 de agosto e 8 de setembro de 2026, ele trabalhou cerca de 1.900 tickets, deixou cerca de 1.700 notas e redigiu cerca de 560 respostas para a equipe enviar. Quando um colega escreve "@eesel find instructors near this lesson", ele busca em tickets passados das cidades próximas instrutores que deram aula ali.
Nada disso depende de o modelo por trás escrever a 221 ou a 1.068 tokens por segundo. Depende da regra de marca, da lista de exclusão, dos rascunhos que vão primeiro para uma pessoa e dos testes. Essa é a diferença a que sempre volto: o Mercury 3 é infraestrutura; a eesel é o funcionário. Se você escolhe a camada de modelo por conta própria, meus guias do melhor modelo para tickets de suporte e da prevenção de alucinações de IA cobrem as salvaguardas, e testar um agente de IA cobre o passo que a maioria das equipes pula.
Quem deve usar o Mercury 3 e quem deve esperar
Use agora se você:
- Constrói agentes com longas cadeias de chamadas: agentes de navegador, agentes de busca, loops de pesquisa. É onde a velocidade dele se acumula.
- Roda harnesses de código e quer um ajudante rápido. O próprio conselho de Kuleshov é subagentes, não o modelo principal, o que combina com setups de Claude Code ou Cursor em que um modelo maior planeja.
- Paga por Luna ou Haiku em chamadas de alto volume e baixo risco e pode conviver depois com o preço de tabela. Teste em esforço medium antes de trocar.
Espere ou escolha outra coisa se você:
- Precisa de entrada de imagem, pesos abertos ou temperatura 0. O Gemini 3.8 Flash lida com imagens, e os modelos de linguagem pequenos cobrem a hospedagem própria.
- Depende de recuperação exata em documentos longos. Faça primeiro a sua própria avaliação.
- Faz uma chamada ao modelo por requisição sem ninguém esperando. A velocidade não mudará seus números, então escolha por qualidade e preço.
- Precisa de latência garantida. Até P90 e P99 se estreitarem, mantenha um modelo de reserva ou um timeout em volta.
Se você ainda está mapeando as opções, meu panorama dos melhores agentes de IA e a análise do Claude Haiku 5.5 são as próximas leituras naturais.
Experimente a eesel
Um modelo rápido te dá um token rápido. Ele não te dá uma conexão com o Zendesk, uma regra de marca, uma lista de tickets a ignorar nem uma forma de reproduzir as conversas do mês passado antes de qualquer coisa entrar no ar. O colega de IA para o helpdesk da eesel já chega com isso. Ele se junta ao seu Zendesk ou a outro helpdesk existente, lê sua central de ajuda, suas macros e tickets passados, e roda nos gatilhos que você ativar, como uma menção a @eesel em uma nota interna.
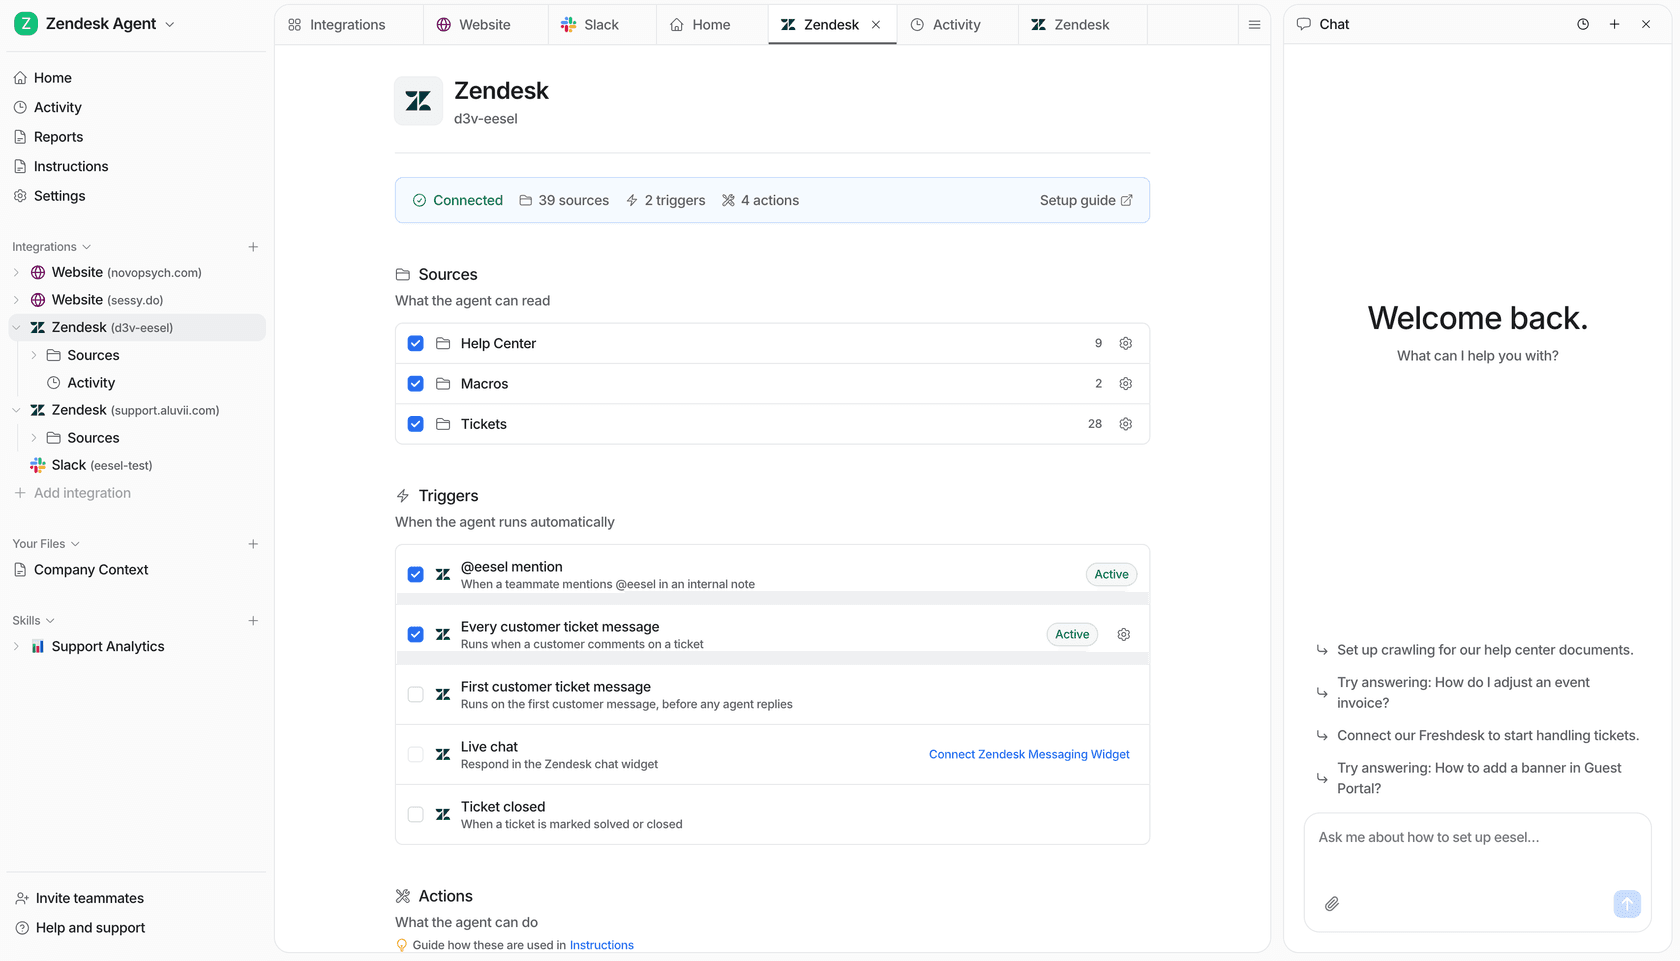
Se você testa modelos pelo terminal, vai gostar da CLI da eesel. Ela controla o mesmo colega do painel: eesel integrations connect zendesk inicia a conexão com o helpdesk, eesel automations lista e liga o que o agente faz sozinho, e eesel chat "how do I reset a password?" faz uma pergunta a ele e transmite a resposta. Todo comando imprime JSON, então um agente de código pode executar a configuração por você. Meu guia da CLI de agente de IA vai além.
Os planos começam em US$ 299 por mês por 500 créditos, e o teste grátis inclui 100 créditos sem cartão. Experimente a eesel nos seus próprios tickets passados, ou veja antes a página de preços. Se o seu trabalho é conteúdo e não tickets, a equipe também conta com um redator de blog com IA.