

Resumo
O Cactus Whistle é um modelo aberto e gratuito de fala para texto que cabe em um único arquivo de 16,9 MB e roda em uma CPU comum. Em um trecho de 10 segundos, ele chega à primeira palavra em 11,1 ms e, em fala lida e limpa, supera por pouco o Whisper base, um modelo 8,6 vezes maior.
O porém está no próprio gráfico da Cactus: o Whisper base ainda vence em reuniões, palestras do TED e na média multilíngue do MLS, e um testador no Hacker News viu uma precisão em fala livre de apenas 70 de 170 comandos. O mesmo testador chegou a 164 de 170 ao limitar o Whistle a uma lista fixa de comandos. Essa é a lição de verdade: o Whistle é uma porta de entrada para comandos de voz, não um substituto do Wispr Flow.
Se você é de uma equipe de suporte de olho em voz, a transcrição agora é a parte barata. O trabalho é responder ao que o cliente disse, e é aí que entra um colega de equipe de IA para helpdesk como a eesel.
O que é o Cactus Whistle?
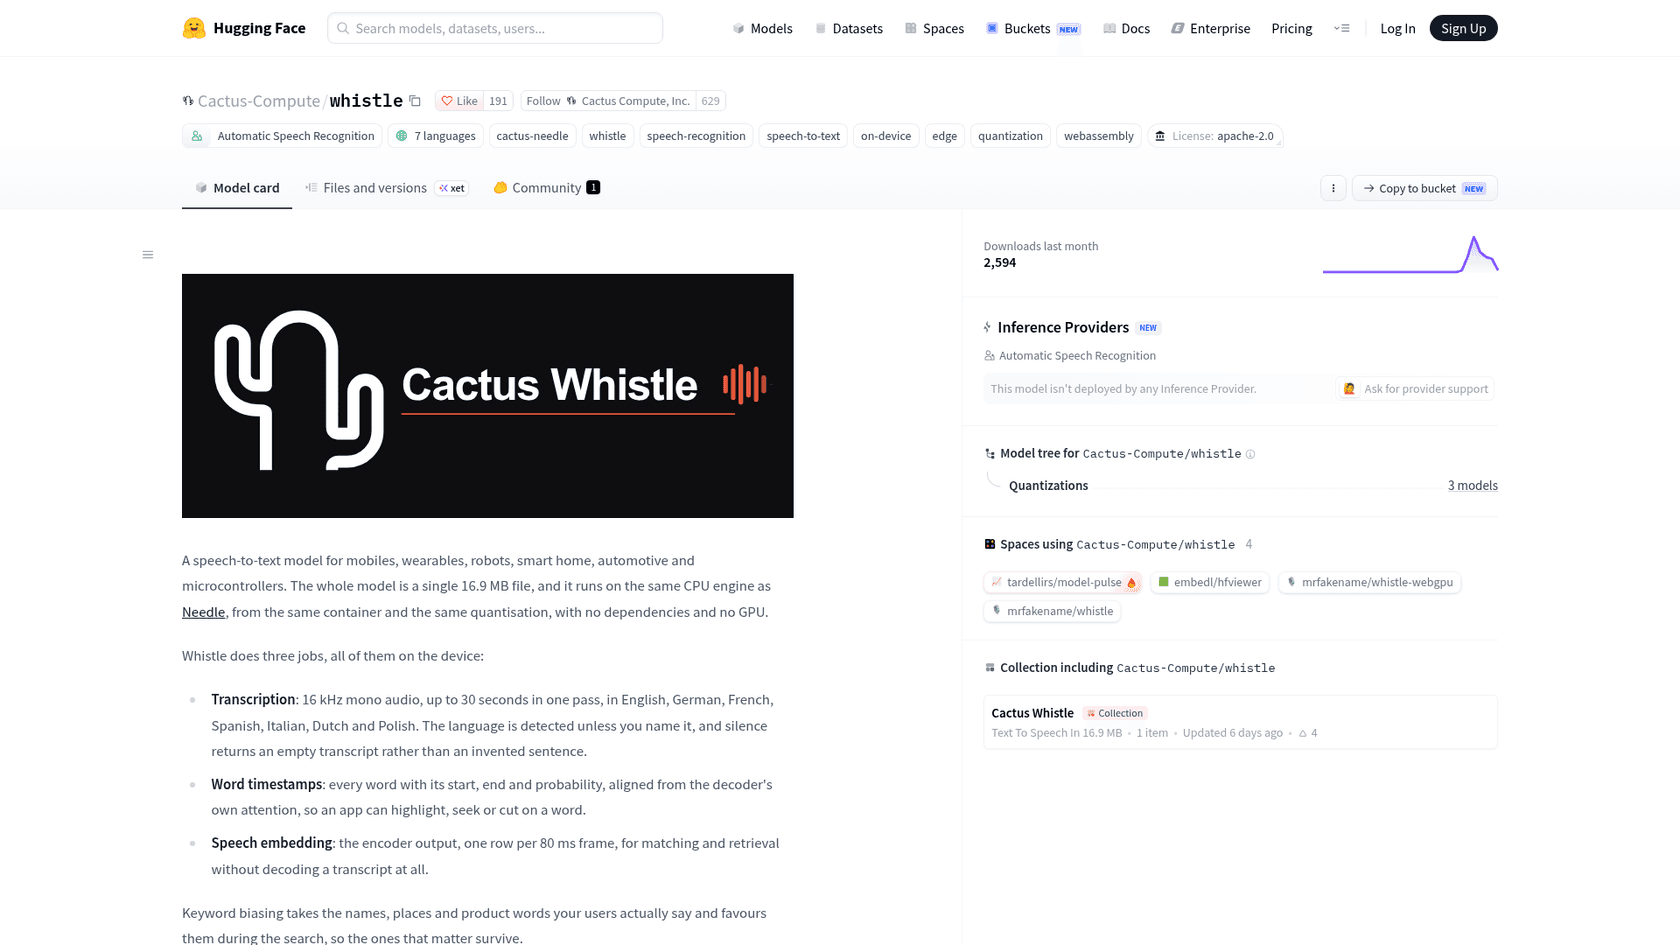
O Whistle é um modelo de reconhecimento de fala da Cactus Compute, uma startup de São Francisco da turma do verão de 2025 da Y Combinator, com uma equipe de 8 pessoas. A Cactus é dirigida pelo CEO Roman Shemet e pelo CTO Henry Ndubuaku, e toda a proposta dela é IA para dispositivos que não têm GPU: celulares básicos, relógios, óculos, robôs, carros e placas do porte de microcontroladores.
O Whistle é a metade de fala dessa aposta e um bom exemplo de quanto os modelos de linguagem pequenos evoluíram. Ele foi lançado em 2 de outubro de 2026, e a discussão de lançamento no Hacker News chegou a 549 pontos e 121 comentários em 8 de outubro, e é por isso que ele está em todo lugar de repente. O cartão do modelo no Hugging Face mostra 2.594 downloads no primeiro mês e uma licença Apache 2.0.
Eu crio integrações e APIs para a eesel, então o anúncio de um modelo me faz perguntar uma coisa primeiro: o que o desenvolvedor realmente recebe de volta em uma chamada? Com o Whistle a resposta é refrescantemente concreta, então vamos começar por aí.
O que o Whistle realmente faz?
A Cactus lista três tarefas, todas feitas no dispositivo:
- Transcrição. Áudio mono de 16 kHz, até 30 segundos de uma vez, em inglês, alemão, francês, espanhol, italiano, holandês e polonês. O idioma é detectado, a menos que você o informe.
- Marcas de tempo por palavra. Cada palavra com início, fim e probabilidade, para que um app possa destacar, buscar ou cortar em uma palavra.
- Embedding de fala. A saída bruta do codificador, uma linha a cada 80 ms de áudio, para comparação e busca sem produzir transcrição alguma.
Dois recursos menores importam mais do que parecem. O keyword biasing permite passar os nomes que seus usuários realmente falam ("Siobhan", "Krzysztof", os nomes dos seus produtos) e inclina a busca em direção a eles. E o silêncio retorna uma transcrição vazia em vez de uma frase inventada, o que é um tiro direto em um hábito pelo qual os modelos no estilo Whisper são conhecidos.
Essa última afirmação foi testada em público. Um usuário do Hacker News rodou o Whistle em um episódio de TV e relatou isto:
“Tried it on a random TV episode and it seems to get stuck sometimes where it just outputs "Thank you." as a default - at one point emitting that for 60s of dialogue”

Ou seja, o silêncio é tratado, mas áudios longos e bagunçados que não cabem na janela de 30 segundos do Whistle ainda podem gerar texto de preenchimento. Tenha isso em mente para os benchmarks.
Como o Whistle funciona por dentro?
A versão curta: o Whistle é uma entrada de áudio acoplada ao modelo de texto que a Cactus já tinha, o Needle, e compartilha quase tudo com ele. O Needle é o minúsculo modelo de chamada de ferramentas que tornou a Cactus conhecida (o lançamento dele em maio no Hacker News se chamava "We Distilled Gemini Tool Calling into a 26M Model"). O Needle 3 agora ocupa de 8 a 29 MB, dependendo da profundidade.
Segundo o post de lançamento, o pipeline funciona assim:
- O áudio vira 80 bins log-mel com salto de 10 ms, então 30 segundos são 3.000 quadros.
- Uma camada convolucional reduz isso para 375 quadros, um a cada 80 ms.
- Um codificador de 8 blocos lê todos os quadros de uma vez (ele não é causal, então uma palavra aos 12 segundos pode informar uma palavra aos 3 segundos).
- Um decodificador no formato do Needle lê o codificador por meio de uma atenção cruzada com portas em cada camada, e 5 beams escolhem a transcrição.
O truque de engenharia de que mais gosto: as chaves e os valores do codificador são calculados uma vez por trecho e compartilhados por todos os beams, então cinco beams custam cinco caches de texto curtos, não cinco passagens pelo áudio. O decodificador também é "em escada", ou seja, cada profundidade a partir de 2 camadas foi treinada como um modelo próprio, e você escolhe uma no momento do carregamento com --audio-depth.
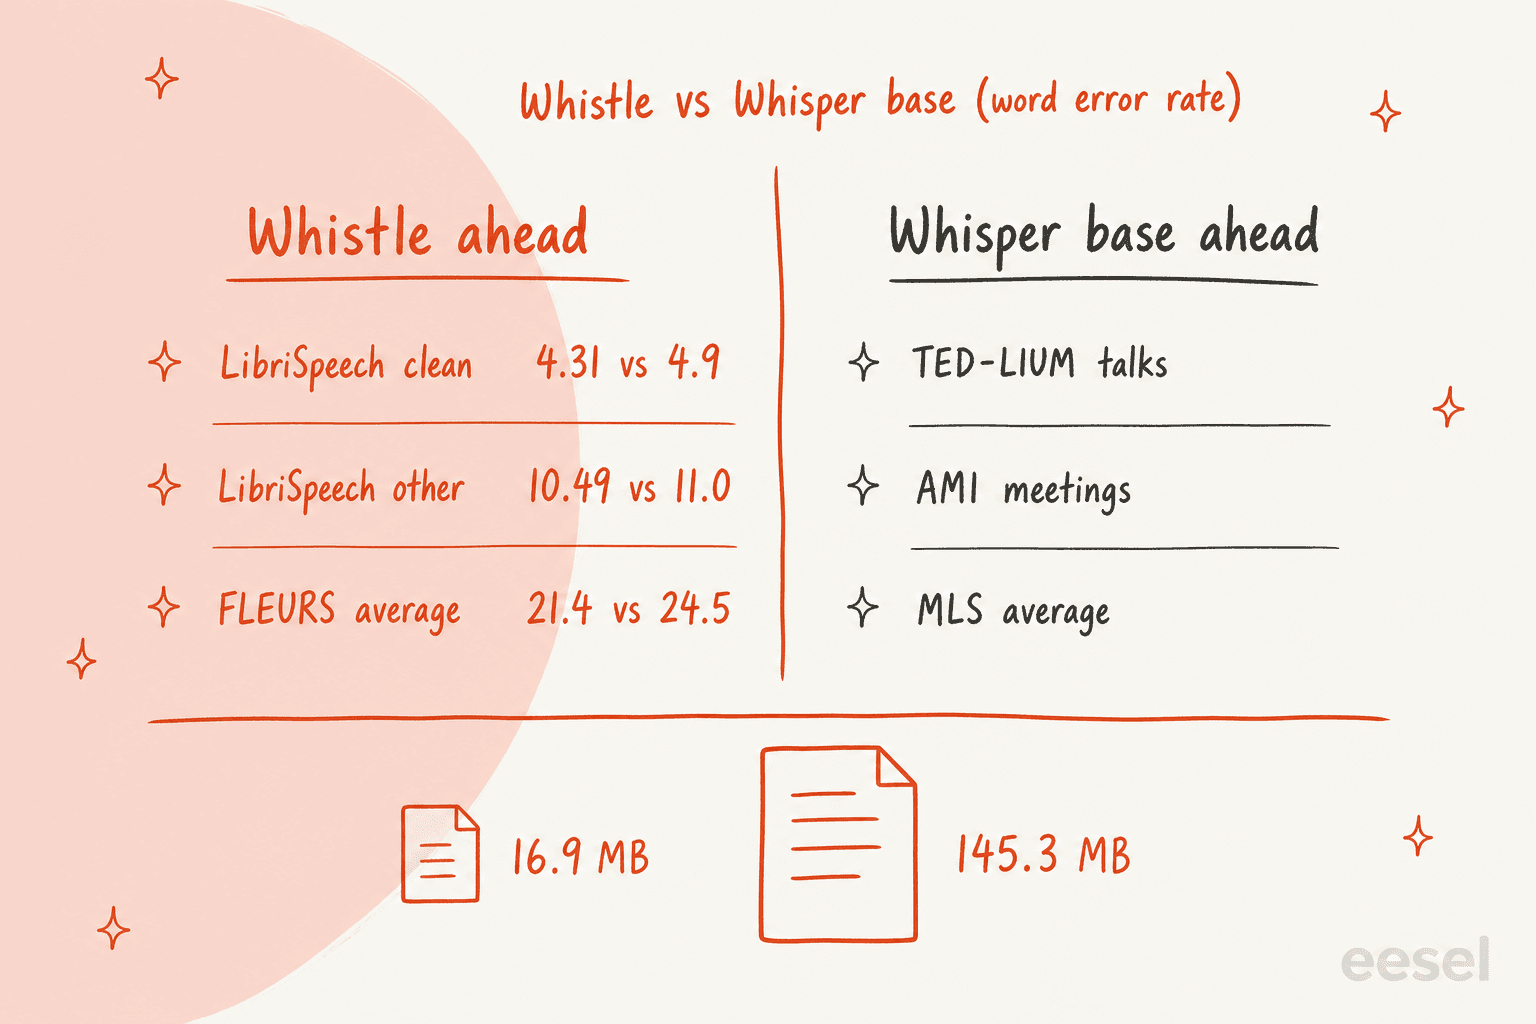
Esse motor compartilhado é o produto de verdade. Carregue os dois modelos no mesmo binário e uma chamada recebe áudio e devolve uma chamada de função. Este é o exemplo exato do post da Cactus:
needle --model needle3.cact --model whistle.cact --tools tools.json --audio clip.wav
{"function_calls":[{"name":"set_lights","arguments":{"room":"kitchen","on":false}}],
 "confidence":0.94,
 "audio_text":"turn off the kitchen lights",
 "audio_language":"en"}
Nenhuma transcrição chega ao código do seu app. Se você já ligou chamadas de ferramentas em tempo real a uma API na nuvem, vai notar o que falta aqui: a ida e volta pela rede, a chave de API e a fatura.
Benchmarks do Whistle contra o Whisper base e o Moonshine
A Cactus compara o Whistle com dois modelos: o Whisper base da OpenAI (o checkpoint multilíngue, de 145,3 MB) e o Moonshine tiny v2 (41,9 MB). A taxa de erro de palavras (WER) é a parcela de palavras que o modelo erra, então quanto menor, melhor.
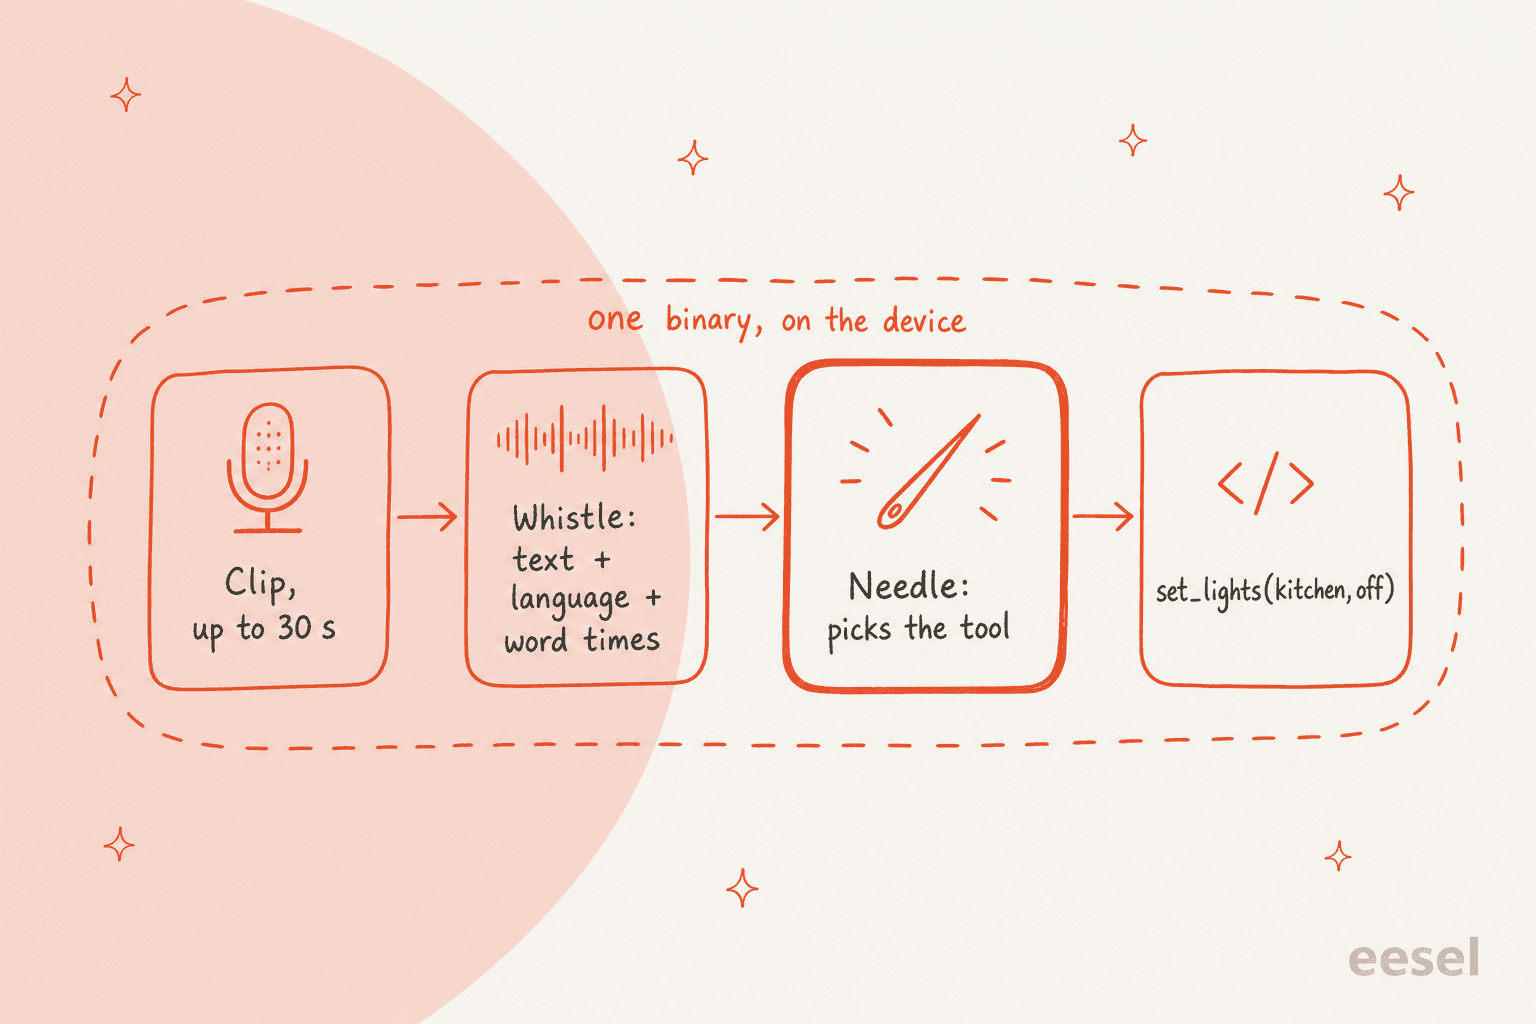
Aqui está o quadro completo da taxa de erro de palavras, com os números do Whistle vindos do cartão do modelo e os do Whisper base citados pela Cactus na discussão de lançamento no X:
| Benchmark | Que áudio é | WER do Whistle | WER do Whisper base | Quem está na frente |
|---|---|---|---|---|
| LibriSpeech test-clean | Leitura limpa de audiolivro | 4,31% | 4,9% | Whistle |
| LibriSpeech test-other | Leitura mais difícil de audiolivro | 10,49% | 11,0% | Whistle |
| SPGISpeech | Ligações financeiras | 7,65% | Não publicado | Whistle (vs Moonshine) |
| Earnings-22 | Ligações de resultados, sotaques | 19,01% | Não publicado | Whistle (vs Moonshine) |
| FLEURS (média de 7 idiomas) | Frases lidas, vários idiomas | 21,4% | 24,5% | Whistle |
| TED-LIUM | Palestras gravadas | 7,61% | Menor | Whisper base |
| AMI | Gravações de reuniões | 26,07% | Menor | Whisper base |
| MLS (média de 6 idiomas) | Audiolivros, fora do inglês | 24,9% | Menor | Whisper base |
O post de lançamento diz essa divisão com clareza, e respeito que o faça. Leia a tabela por tipo de áudio e um padrão salta aos olhos: o Whistle é mais forte em fala lida, limpa e de um único falante, e mais fraco em reuniões, onde as pessoas falam umas por cima das outras. Uma taxa de erro de 26% no AMI significa que cerca de uma palavra em quatro está errada.
Velocidade e tamanho são outra história, e é aqui que o Whistle dispara na frente. Dez segundos de áudio na CPU de um Apple M4 Pro:
| Whistle | Whisper base | Moonshine tiny v2 | |
|---|---|---|---|
| Tamanho do arquivo | 16,9 MB | 145,3 MB | 41,9 MB |
| Tempo até o primeiro token | 11,1 ms | 73,2 ms | 22,8 ms |
| Velocidade de decodificação | 1.319 tokens/s | 266 tokens/s | 262 tokens/s |
| Precisão | 2 a 4 bits | fp32 | int8 |
O título da Cactus diz "9x menos tamanho de arquivo e 6x de velocidade". Conferi a conta: a diferença de tamanho é de 8,6x, a de tempo até o primeiro token é de 6,6x e a de decodificação é de cerca de 5x. Um arredondamento justo. O tempo até o primeiro token do Whistle também cresce com o trecho, de 5,9 ms aos 5 segundos a 36,3 ms aos 30, enquanto o Whisper preenche tudo até 30 segundos, então a diferença é maior nos trechos curtos para os quais o Whistle foi feito.
Uma comparação que a Cactus não faz: os modelos abertos maiores que as pessoas realmente rodam em notebooks. No Hacker News, os usuários não paravam de perguntar sobre o Parakeet da NVIDIA, e a resposta mais útil resumiu bem a troca:
“It might not be as good as parakeet, but it gets you 80% of the way there.”
O que as pessoas dizem depois de testar o Whistle?
A discussão no Hacker News é o melhor teste do mundo real até agora, porque a Cactus colocou um sandbox no navegador na página de lançamento e centenas de pessoas falaram com ele. As reações se dividiram exatamente nas linhas que os benchmarks previam.
Inglês claro, frases curtas, termos técnicos: as pessoas ficaram impressionadas. Um desenvolvedor achou que ele superou o ditado do próprio celular em jargão:
“This works much better than the speech recognition in iOS when you use technical terms.”
A fala natural nos outros seis idiomas recebeu críticas mais duras. Um falante de espanhol de Madri escreveu que ele só se saía bem quando ditava devagar:
“If I use a more natural/conversational rhythm (no slang, no abbreviations...) it easily confuses words.”
Um testador polonês disse algo parecido, e outro comentarista apontou o que a demonstração não mostra: a saída em streaming enquanto você ainda está falando, da qual a maioria dos apps de ditado ao vivo depende. Uma equipe concorrente também deu sua alfinetada no Reddit, afirmando em seu próprio benchmark que Whistle mais Needle chegavam a 20,7% de acurácia em ferramentas a partir de fala bruta. Esse é o teste de um rival, então pese isso, mas ele aponta na mesma direção de tudo o mais aqui.
Do lado de quem constrói, um desenvolvedor já tinha ligado o Whistle a um plugin de fala para texto para o DeepSeek Harness poucos dias após o lançamento.
A lição de verdade: restrinja o vocabulário
O comentário mais útil de toda a discussão veio de alguém que já tinha colocado o Whistle em produção. Essa pessoa o usou para desligar um Amazon Echo Show da nuvem da Amazon, trocando o assistente de voz original por uma automação residencial que roda localmente, e compartilhou os números.
Com transcrição livre, o Whistle acertou 70 de 170 comandos falados, contra 168 do modelo de fala de 1,7B do Qwen rodando em uma GPU RTX 5080. Então a pessoa parou de pedir ao Whistle que transcrevesse qualquer coisa que alguém pudesse dizer e treinou uma rede minúscula para mapear a saída do Whistle em um conjunto fixo de modelos de comando. O resultado: 164 de 170, a partir de uma configuração feita para rodar na própria CPU do Echo.
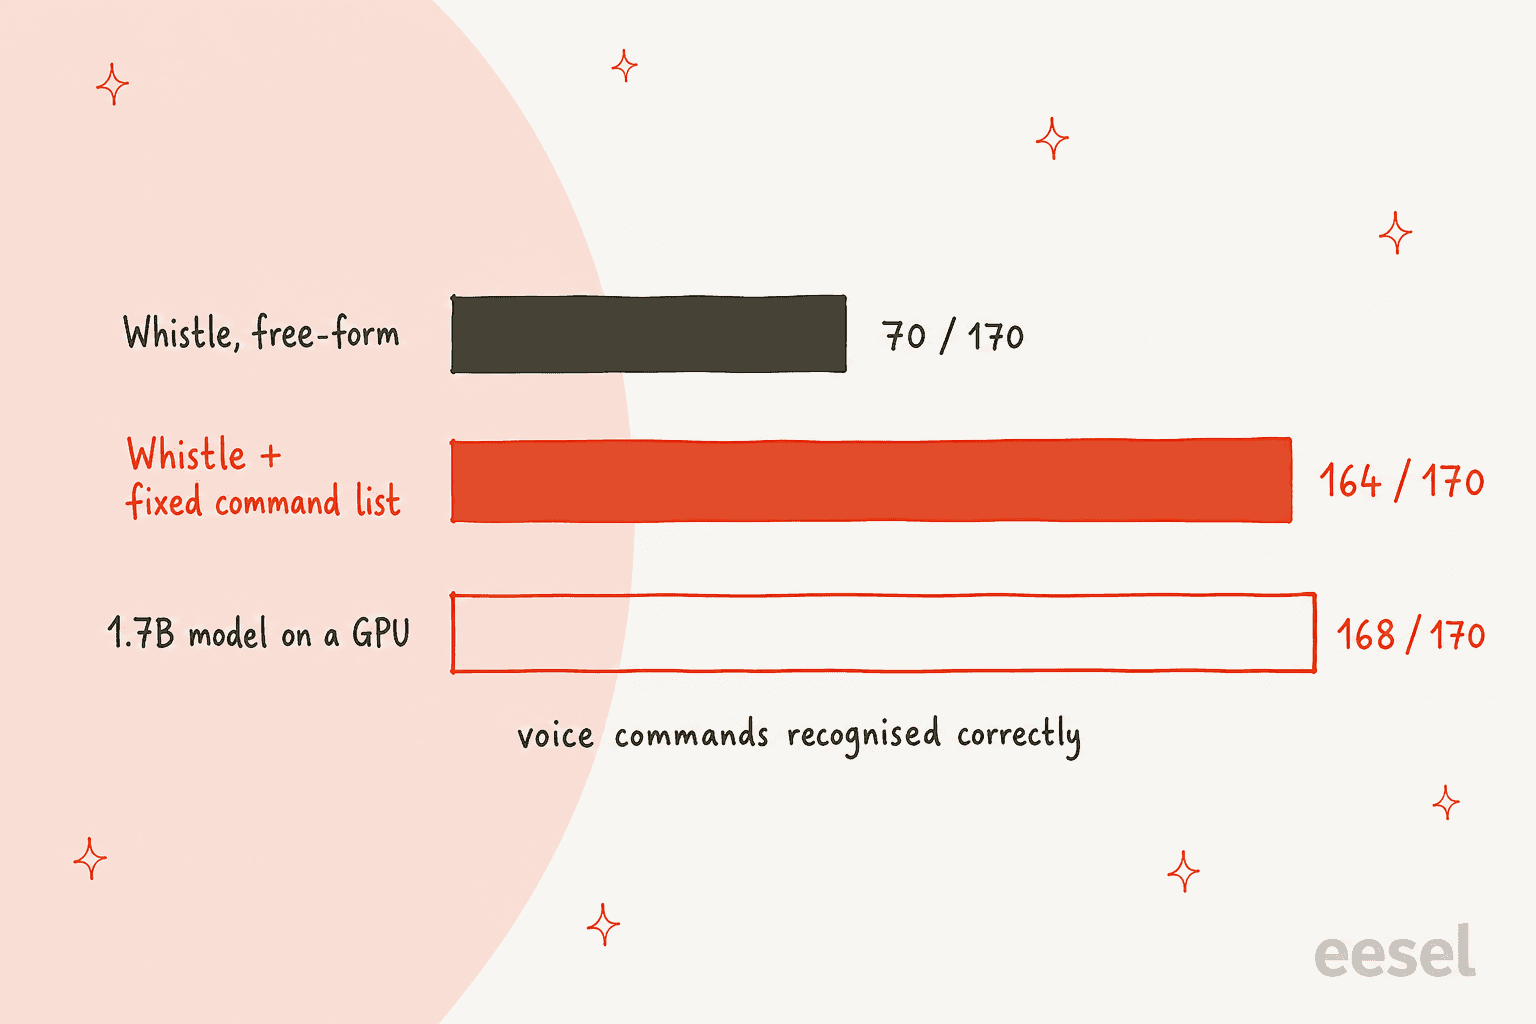
Essa é a mudança que eu levaria daqui. Um modelo de 16,9 MB não tem espaço para conhecer todas as palavras em sete idiomas, então quanto mais você puder dizer a ele o que esperar, mais perto ele chega de modelos muito maiores. A Cactus criou ferramentas exatamente para isso: o keyword biasing para nomes e termos de produto, e a lista de ferramentas do Needle, que por si só é um vocabulário fixo de ações. O mesmo testador depois rodou 208 frases e acertou 206, à frente de configurações com Vosk e Kaldi no mesmo conjunto.
Então, se você está avaliando o Whistle falando com o sandbox sobre o seu fim de semana, está testando a coisa errada. Avalie-o pelos 20 comandos que o seu dispositivo realmente precisa entender.
Vale lançar o Whistle?
Assim eu decidiria, com base nos benchmarks e nos relatos de campo acima. Escolha a tarefa que você tem em mente:
O que você quer que o Whistle faça?
Como testar o Whistle em cinco minutos
O caminho mais rápido é o sandbox no navegador do post de lançamento: o primeiro clique baixa o modelo de 16,9 MB para a aba e nada sai da sua máquina. Para um teste de verdade, o pacote Python leva uma linha:
pip install cactus-needle
import needle

print(needle.transcribe("clip.wav")["text"])
A partir daí, segundo o cartão do modelo:
word_timestamps=Trueadiciona início, fim e probabilidade de cada palavra.keywords=[...]inclina a busca em direção aos nomes que seus usuários falam.language="de"força um idioma em vez de detectá-lo.needle whistle compareroda o mesmo trecho no Whistle, no Whisper e no Moonshine com tempos, o que é o comando mais útil para decidir.
O motor vem pré-compilado para dezessete alvos, de macOS, Windows e Linux (incluindo RISC-V e MIPS) a Android, iOS, watchOS, tvOS e o navegador via WebAssembly. Cada pasta de plataforma nativa tem um binário needle, uma biblioteca estática e um header. O código-fonte está no GitHub. Se você está montando uma stack totalmente local, ele se encaixa ao lado dos agentes de IA de código aberto que as pessoas já rodam no próprio hardware.
O custo é simples: os pesos e o motor são Apache 2.0, e o Hugging Face lista nenhum provedor de inferência hospedada para o Whistle, então você mesmo o executa. Compare isso com o preço por minuto do Gemini 3.5 Transcribe ou do MAI-Transcribe 2, que são a escolha certa quando a precisão em áudio longo e bagunçado importa mais que o tamanho.
Onde o Whistle deixa de ser a ferramenta certa
Para ser justo com a Cactus, ela nunca afirmou que o Whistle substitui o Whisper large ou um serviço de transcrição na nuvem. Ainda assim, estes são os limites que eu apontaria antes de alguém construir em cima dele:
| Limite | O que significa na prática |
|---|---|
| Limite de 30 segundos por trecho | Áudios mais longos precisam ser divididos pelo seu app (um usuário do HN esbarrou em "audio limit is 30 s" logo de cara) |
| Sem saída em streaming | O texto aparece depois que o trecho termina, não enquanto alguém fala |
| 7 idiomas | Sem japonês, norueguês, hindi, português e assim por diante |
| Áudio de reuniões | 26,07% de WER no AMI, atrás do Whisper base |
| Rótulos de falante | A documentação não lista separação de falantes (diarização) |
Nenhum deles é um bug. É o preço de encaixar um modelo de fala em 16,9 MB, e a Cactus publica detalhes suficientes para você enxergá-los antes de lançar. Para a maior parte do trabalho de longa duração, o Otter e as ferramentas da minha lista de alternativas ao Otter ainda são a escolha prática.
O que o Whistle significa para equipes de suporte ao cliente
Aqui eu trago o assunto para o trabalho que faço. No suporte, a fala é em sua maioria ligações, mensagens de voz e tutoriais gravados, e eles são longos, têm dois falantes e fogem do roteiro. Isso é o lado AMI da tabela de benchmarks do Whistle, não o lado LibriSpeech. Para automação de suporte por telefone ou agentes de IA para call center, o Whistle não é a camada de transcrição que eu escolheria hoje. Os agentes de voz com IA feitos para ligações usam modelos maiores e com streaming por um bom motivo.
O ponto maior é que a transcrição fica cada vez mais barata e menor, e nunca foi a parte difícil. Em uma ligação de vendas da eesel, uma marca DTC de suplementos no Gorgias e no Shopify, com cerca de 7.000 tickets por mês, disse que queria que a IA resolvesse automaticamente metade das perguntas sobre status de pedido, assinatura e produto. O obstáculo não era transformar fala em texto. As respostas estavam espalhadas por ferramentas de SOP, macros desatualizadas e tutoriais no Loom que ninguém havia transcrito para texto. A transcrição de um vídeo do Loom é só mais texto; alguém ainda precisa ler o ticket, achar a resposta certa e responder na voz da marca.
Essa é a linha que eu traçaria: o Whistle é infraestrutura, e a eesel é a funcionária. Um modelo como o Whistle ouve as palavras. Um colega de equipe de IA para helpdesk trabalha a fila: aprende com a sua base de conhecimento e com tickets anteriores, redige ou envia respostas dentro do Zendesk ou do Gorgias e repassa os tickets em que não deve mexer.
Se você já tem transcrições de ligações chegando ao seu helpdesk, meus guias sobre como resumir transcrições de ligações e como remover dados pessoais de transcrições cobrem os passos depois do modelo de fala.
E como todo o apelo do Whistle é que você o controla pelo terminal: a eesel funciona assim também. A CLI da eesel (npm i -g @eesel/cli) permite conectar um helpdesk, editar as instruções permanentes do colega de equipe, aprovar ou negar suas ações pendentes e ler seu registro de atividade, com cada comando imprimindo JSON e uma flag --dry-run que mostra a chamada exata que uma escrita faria. Agentes de código como Claude Code, Codex e Cursor podem controlá-la como uma pessoa faria, então o mesmo colega de equipe que você vê no painel pode ser automatizado a partir do CI.
Experimente a eesel
Se voz está no seu roadmap porque você quer menos tickets sem resposta, comece pela parte que os responde. O colega de equipe de IA para helpdesk da eesel se conecta ao Zendesk, ao Gorgias ou ao Freshdesk em minutos, aprende com a sua central de ajuda e com tickets anteriores e é testado contra os seus próprios tickets históricos antes de responder a um cliente de verdade. Você pode experimentar a eesel grátis, sem cartão, ou comparar antes com outros colegas de equipe de IA.
