

O MAI Code 2 é o novo modelo de código da Microsoft dentro do GitHub Copilot, a $0.50/$2.50 por milhão de tokens até 17 de maio de 2027. Os próprios testes da Microsoft dão a ele 98% da pontuação do GPT-6.1 Sol a 40% do custo por tarefa, mas esse custo usa o preço promocional. No preço de tabela de $1/$5, as mesmas tarefas custam cerca de 81% do que o Sol cobra.
Então é uma boa escolha padrão hoje para trabalho rotineiro em vários arquivos no Copilot. Mantenha um modelo maior para tarefas longas e difíceis em repositórios, onde ele fica 14 pontos atrás do Claude Opus 5.5 no SWE Atlas.
O que é o MAI Code 2?
O MAI Code 2 é um modelo de código que a Microsoft AI treinou do zero e lançou no Ignite em 17 de novembro de 2026. O post de lançamento o apresenta para "tarefas de codificação corporativa do dia a dia" e diz que ele "se destaca em levar código à produção, depuração profunda, implementação em vários arquivos, raciocínio em todo o repositório e UI". Um irmão menor, o MAI Code 2 Flash, saiu no mesmo dia para edições rotineiras de alto volume.
É a segunda geração da linha própria de modelos de código da Microsoft. O MAI-Code-1-Flash chegou ao GitHub Copilot em junho, e o MAI Code 1.1 Flash veio depois em agosto. O salto desta vez é em tamanho e alcance. Segundo o model card, os dois novos modelos ganham uma janela de contexto de 1.050.000 tokens (922.000 de entrada, 128.000 de saída) e cinco níveis de esforço de raciocínio, de baixo a máximo.
Sou engenheiro no produto da eesel, e a maior parte do meu dia é integrações e trabalho de API, então vivo em um editor com um modelo de IA no painel lateral. Também trabalho nos agentes de IA da eesel que rodam em filas de suporte reais, e com a CLI da eesel, um agente de código nesse mesmo editor pode enviar artigos de ajuda aprovados para um agente da eesel, ajustar suas instruções e rodar perguntas de teste antes de qualquer coisa ir ao ar. Então, quando um novo modelo de código chega, a pergunta que me interessa é simples: quanto custa uma tarefa normal, e onde ela quebra?
Qual é a diferença entre o MAI Code 2 e o MAI Code 2 Flash?
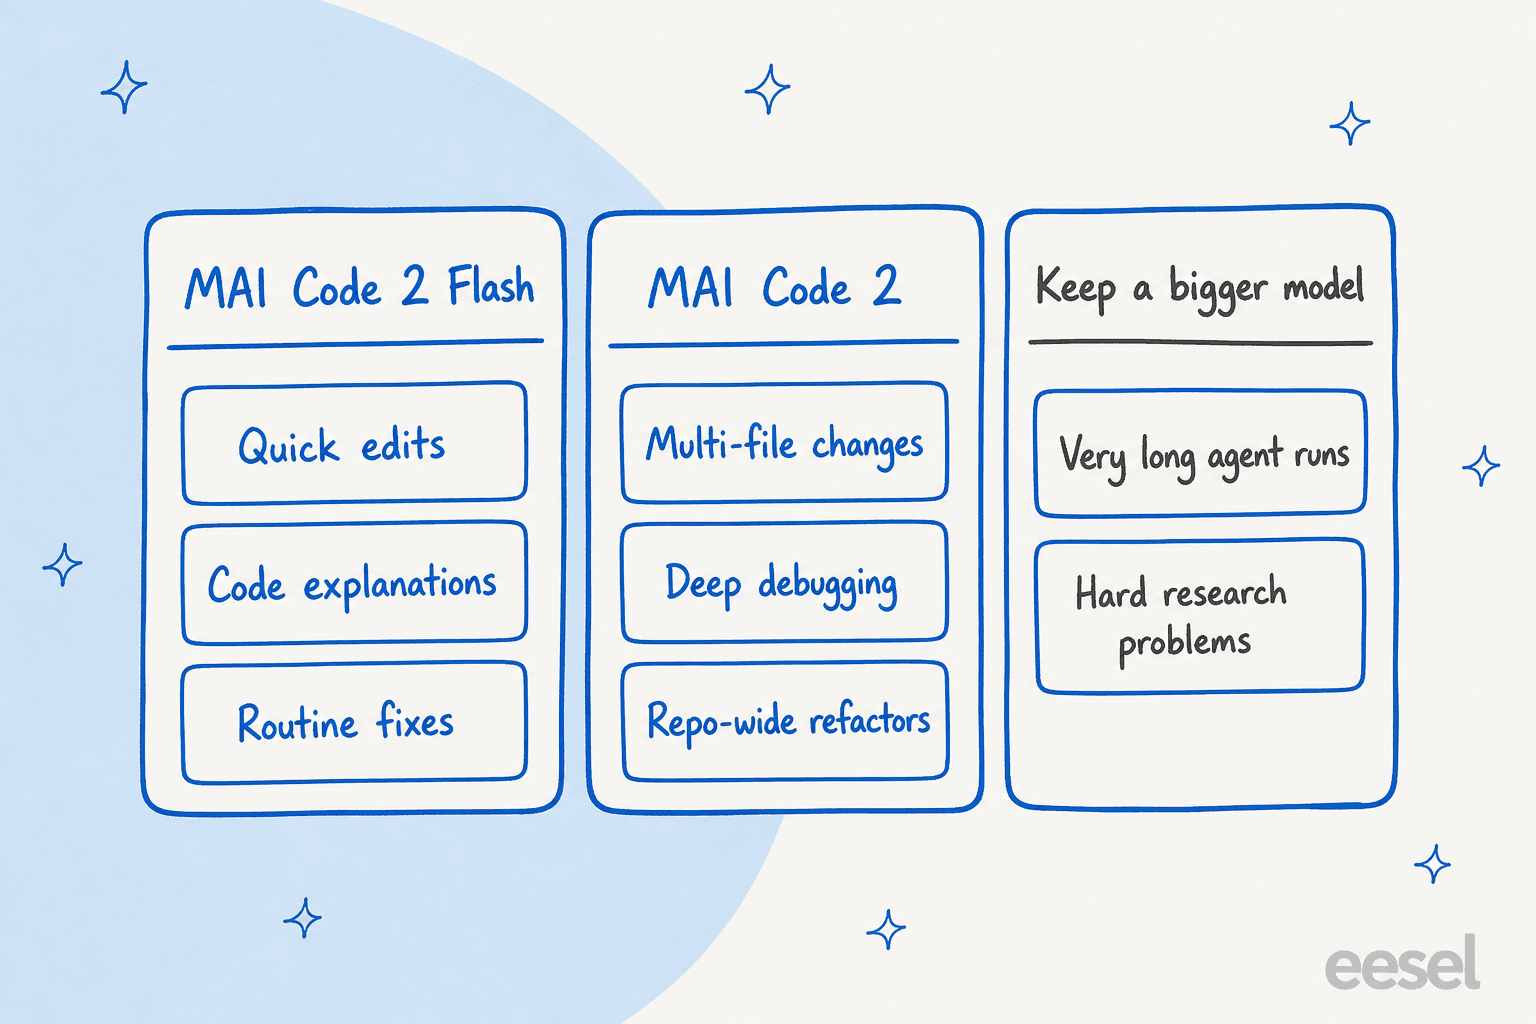
Os dois modelos dividem o trabalho pela dificuldade. O changelog do GitHub da Microsoft descreve o MAI Code 2 como um modelo de uso geral "ideal para tarefas complexas como depuração profunda, implementação em vários arquivos, refatoração e raciocínio em todo o repositório". O Flash é "um modelo de código leve e econômico, otimizado para os fluxos de trabalho de desenvolvimento do dia a dia".
| MAI Code 2 | MAI Code 2 Flash | |
|---|---|---|
| Feito para | Mudanças em vários arquivos, depuração profunda, raciocínio em todo o repositório | Edições rápidas, explicações de código, correções de rotina |
| Parâmetros ativos | 77 bilhões (cerca de 2,8 trilhões no total) | 12 bilhões (cerca de 398 bilhões no total) |
| Janela de contexto | 1.050.000 tokens | 1.050.000 tokens |
| Preço promocional por 1M de tokens (entrada/saída) | $0.50 / $2.50 | $0.05 / $0.25 |
| Planos do Copilot | Pro, Pro+, Max, Business, Enterprise | Igual, mais Free e Student |
| Microsoft Foundry | Ainda não | Prévia de acesso limitado |
| Comparação da Microsoft | GPT-6.1 Sol, Claude Opus 5.5 | GPT-6 Luna, Claude Haiku 5.5 |
Os números de parâmetros vêm da seção 1 do model card. A própria tabela-resumo do card diz "80B ativos" para o MAI Code 2, então trate o número exato como aproximado. De todo modo, ambos são modelos de mistura de especialistas esparsa, o que significa que só uma fração da rede roda a cada token. Esse design ajuda a manter o preço baixo.
Um detalhe que eu não esperava: o Flash supera seu irmão maior em um benchmark. No SWE Atlas, o Flash marca 44,8% contra 43,1% do MAI Code 2, segundo o post de lançamento. É uma diferença pequena, mas mostra que a vantagem do modelo maior não é uniforme.
Quanto custa o MAI Code 2?
No GitHub Copilot, o MAI Code 2 custa $0.50 por milhão de tokens de entrada e $2.50 por milhão de tokens de saída até 17 de maio de 2027. Depois disso, o preço dobra para $1.00 e $5.00, segundo a documentação de preços do GitHub. O Copilot cobra isso em créditos de IA, em que um crédito equivale a um centavo.
| Modelo | Entrada (por 1M) | Entrada em cache (por 1M) | Saída (por 1M) |
|---|---|---|---|
| MAI Code 2, promoção até 17 de maio de 2027 | $0.50 | $0.025 | $2.50 |
| MAI Code 2, a partir de 17 de maio de 2027 | $1.00 | $0.05 | $5.00 |
| MAI Code 2 Flash, promoção | $0.05 | $0.005 | $0.25 |
| MAI Code 2 Flash, a partir de 17 de maio de 2027 | $0.10 | $0.01 | $0.50 |
| GPT-6.1 Sol (até 272K) | $2.00 | $0.10 | $10.00 |
| GPT-6.2 Sol (até 272K) | $2.00 | $0.10 | $10.00 |
| Claude Opus 5.5 | $4.00 | $0.20 | $20.00 |
| GPT-6 Luna (até 272K) | $0.10 | $0.01 | $0.50 |
| Claude Haiku 5.5 (até 100K) | $0.10 | $0.01 | $0.50 |
Todas essas linhas vêm da mesma página do GitHub. Se você está em um plano anual Copilot Pro ou Pro+ ainda na cobrança antiga por requisição, os multiplicadores legados são 1x para o MAI Code 2 e 0.33x para o Flash. A lista completa de planos está no guia de preços do GitHub Copilot.
Quanto custa realmente uma tarefa de codificação?
Os preços por token são só a metade da conta. A outra metade é quantos tokens um modelo gasta para terminar uma tarefa, e a Microsoft também publicou isso. No esforço de raciocínio máximo, em média sobre quatro benchmarks, o post de lançamento lista estes custos por tarefa:
| Modelo | Taxa média de acerto | Custo por tarefa (Microsoft) | Custo por tarefa no preço de tabela (meu cálculo) |
|---|---|---|---|
| MAI Code 2 | 63,2% | $0.309 (preço promocional) | $0.618 |
| GPT-6.1 Sol | 64,1% | $0.761 | $0.761 |
| Claude Opus 5.5 | 65,3% | $6.306 | $6.306 |
| MAI Code 2 Flash | 61,0% | $0.052 (preço promocional) | $0.104 |
| GPT-6 Luna | 55,1% | $0.080 | $0.080 |
| Claude Haiku 5.5 | 53,9% | $0.319 | $0.319 |
As linhas do Flash são a média de três benchmarks, não quatro, porque a tabela da Microsoft para o modelo pequeno deixa de fora o FrontierCode. Minha coluna de preço de tabela simplesmente dobra o número da Microsoft, porque toda tarifa do MAI dobra em 17 de maio de 2027 e o número de tokens por tarefa não muda.
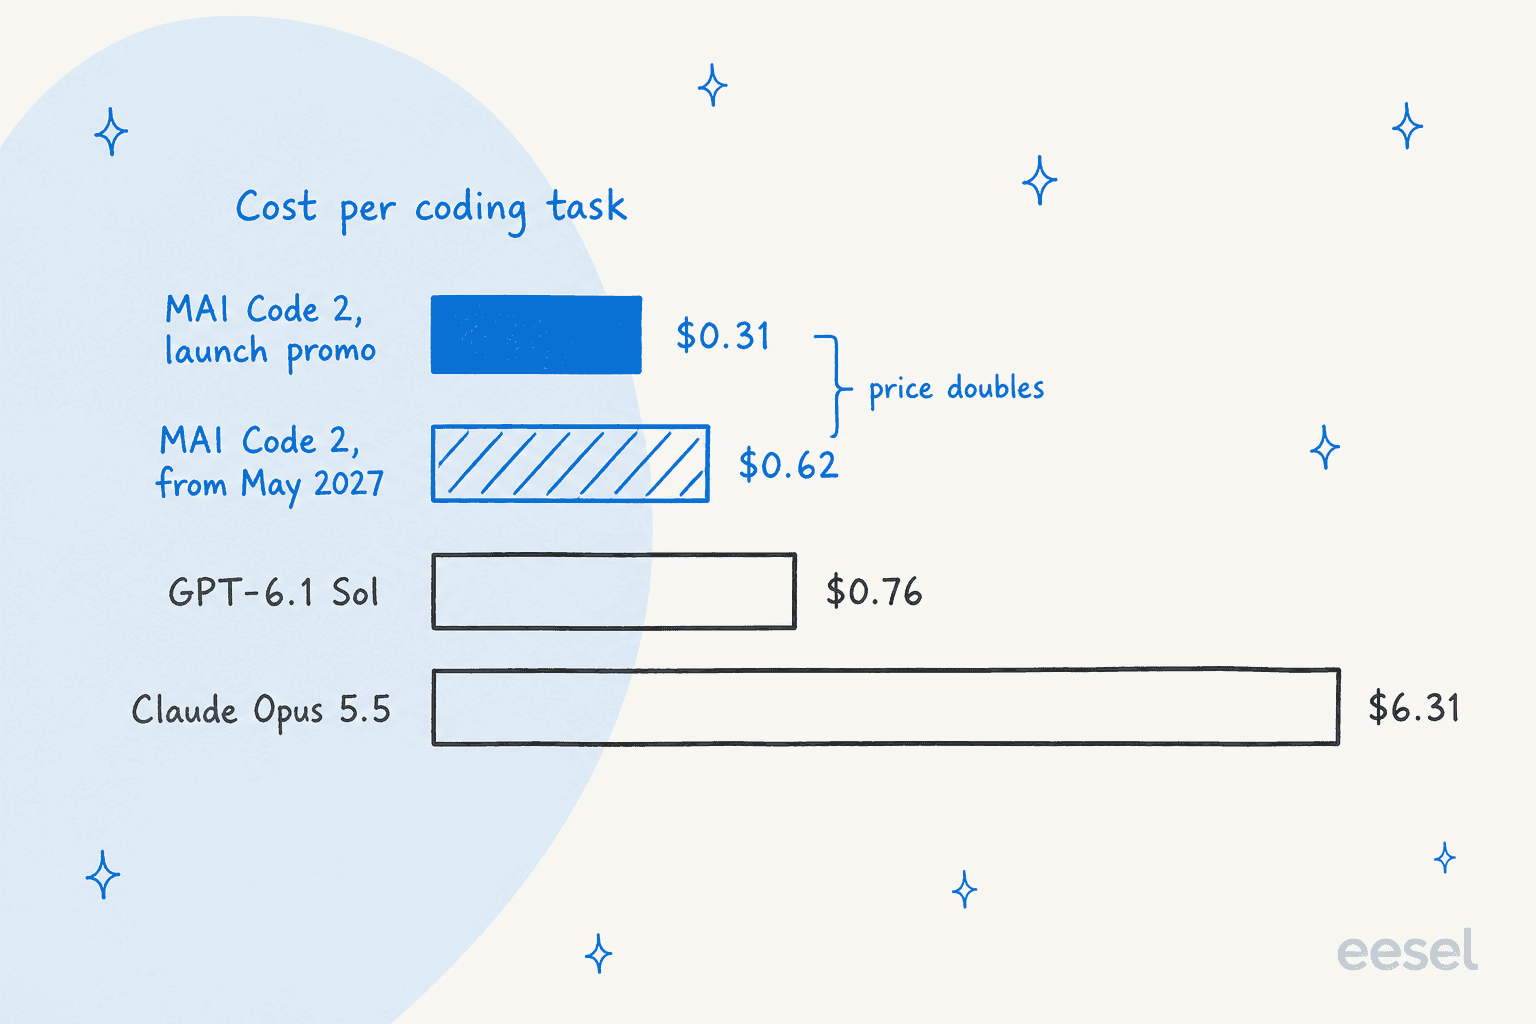
Essa é a parte que a maioria da cobertura do lançamento deixa passar. O preço por token do MAI Code 2 é um quarto do GPT-6.1 Sol durante a promoção, mas seu custo por tarefa é 40% do de Sol. Essa diferença significa que o MAI Code 2 usou cerca de 1,6 vez mais tokens por tarefa que o Sol nas execuções da própria Microsoft. Quando a promoção terminar, esse apetite por tokens come a maior parte do desconto, e a manchete de "40% do custo" passa a ser cerca de 81%.
Um comentarista no Hacker News fez a pergunta óbvia sobre a promoção:
"The promotional period lasts until May 2027. Why not just make the price lower if they'll be irrelevant by the time the "real" price kicks in?"

É um ponto justo. Seis meses é muito tempo nesse mercado, e o modelo com o qual se vai comparar em maio de 2027 provavelmente já não será o GPT-6.1 Sol.
Os benchmarks do MAI Code 2 se sustentam?
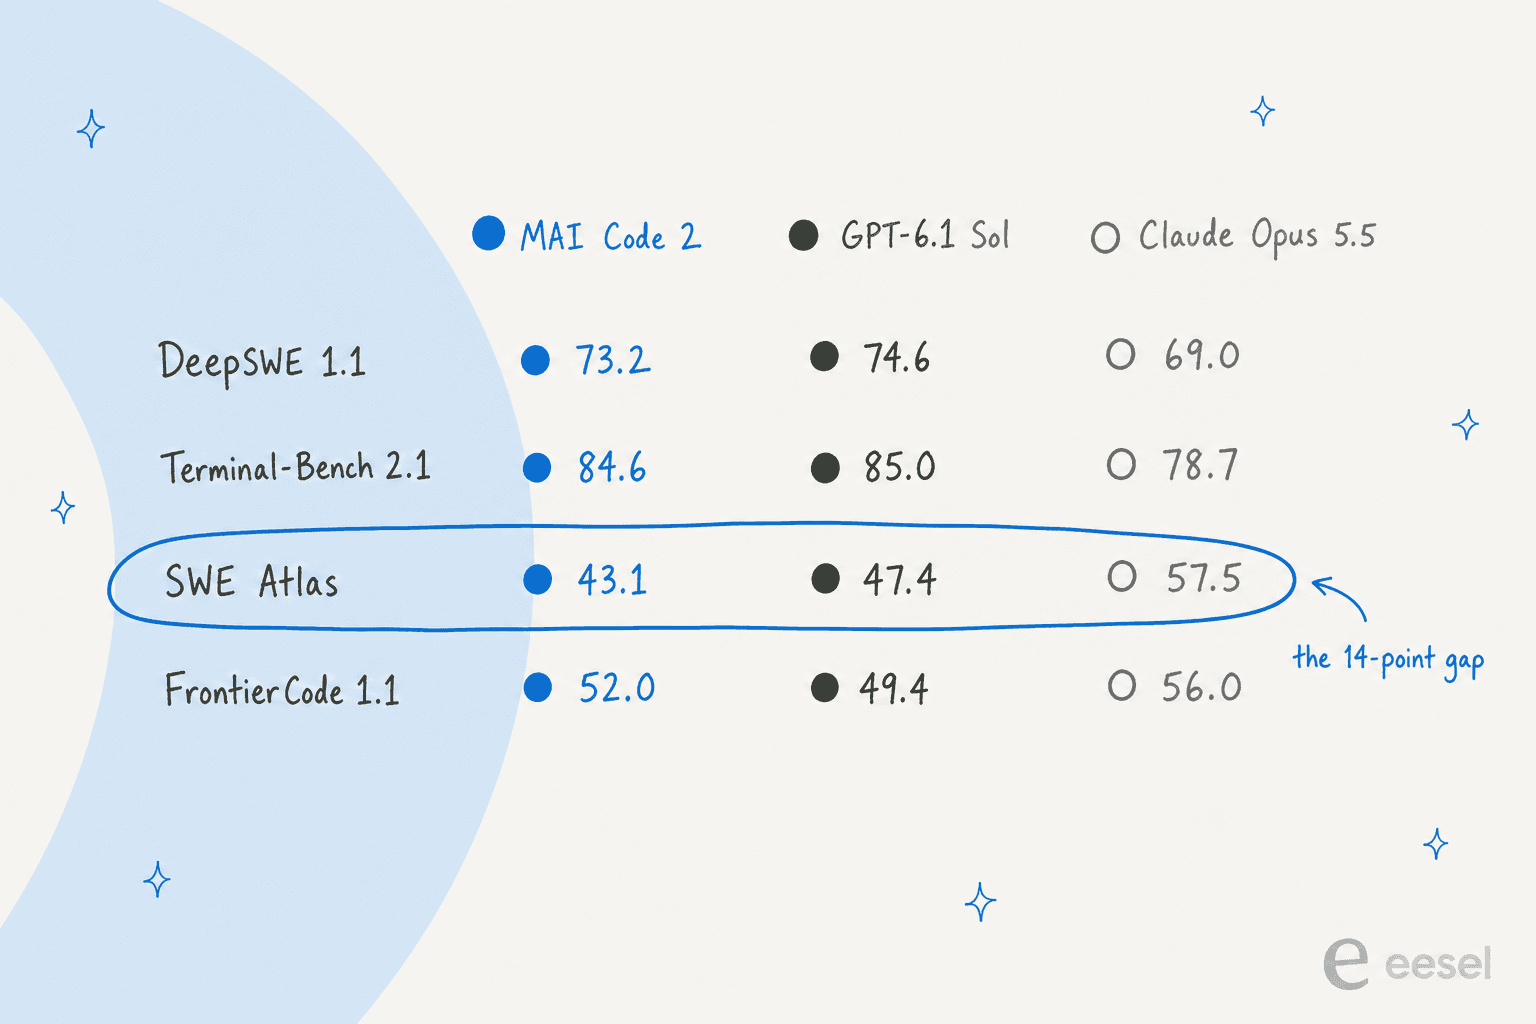
Na maior parte, com três ressalvas que vale a pena conhecer antes de confiar na manchete dos 98%. Aqui está a tabela completa da Microsoft, tudo no esforço de raciocínio máximo, de o post de lançamento:
| Benchmark | MAI Code 2 | GPT-6.1 Sol | Claude Opus 5.5 | Quem executou |
|---|---|---|---|---|
| DeepSWE 1.1 | 73,2% | 74,6% | 69,0% | Microsoft |
| Terminal-Bench 2.1 | 84,6% | 85,0% | 78,7% | Microsoft |
| SWE Atlas | 43,1% | 47,4% | 57,5% | Microsoft |
| FrontierCode v1.1 | 52,0% | 49,4% | 56,0% | Artificial Analysis |
| Média | 63,2% | 64,1% | 65,3% |
Ressalva 1: a Microsoft rodou três dos quatro testes ela mesma. DeepSWE, Terminal-Bench e SWE Atlas rodaram no MSBench, a plataforma interna de avaliação da Microsoft, usando a CLI do Copilot sem subagentes. Só o FrontierCode veio de um terceiro externo. Isso não torna os números errados, mas ninguém independente os refez ainda. Quando verifiquei em 18 de novembro, a Artificial Analysis ainda não tinha uma página de modelo para o MAI Code 2.
Ressalva 2: a média esconde uma diferença real. O MAI Code 2 supera o Opus 5.5 no DeepSWE e no Terminal-Bench. No SWE Atlas, ele marca 43,1% contra 57,5% do Opus, uma diferença de 14,4 pontos. Se seu trabalho se parece com mudanças longas e extensas em repositórios, essa linha importa mais do que a média.
Ressalva 3: as comparações estão um pouco desatualizadas. A Microsoft comparou com o GPT-6.1 Sol no mesmo dia em que a OpenAI lançou o GPT-6.2 Sol. O guia do GPT-6.2 Sol cobre esse lançamento. O Hacker News notou isso:
"They are comparing to Sol 6.1's API prices. With Sol 6.2, and especially if you consider subsidization from Codex subscriptions, it's probably no longer on the Pareto frontier."
Outros apontaram para as versões dos benchmarks. Um comentarista notou que o Terminal-Bench está "atualmente na versão 4 (que é substancialmente mais difícil)" e o FrontierCode "na 2.0", enquanto a Microsoft reportou 2.1 e 1.1. Os três modelos foram avaliados nas mesmas versões, então o ranking se mantém, mas os números absolutos vão parecer mais baixos nos testes mais novos.
Há um resultado que eu levaria ao pé da letra: em trabalho de frontend, avaliadores às cegas preferiram a saída do MAI Code 2 em relação à do GPT-6 Sol em 64% das vezes, entre 258 avaliadores. A qualidade de UI é difícil de forjar escolhendo o benchmark, e é exatamente o tipo de tarefa do dia a dia para a qual a Microsoft diz tê-lo construído.
Como se obtém acesso ao MAI Code 2?
Por agora, só pelo GitHub Copilot e em nenhum outro lugar. Os dois modelos estão disponíveis de forma geral, não em prévia, segundo o changelog do GitHub.
- Planos: o MAI Code 2 está no Copilot Pro, Pro+, Max, Business e Enterprise. O Flash soma Free e Student, mas esses planos só o alcançam pela seleção automática de modelo.
- Onde: o seletor de modelo no VS Code, Visual Studio, JetBrains, Xcode, Eclipse, na CLI do Copilot, no agente de nuvem, no app do Copilot, no github.com e no GitHub Mobile.
- Administradores: no Business e no Enterprise, os modelos novos vêm ativados por padrão, a menos que um administrador tenha desativado o padrão global. Essa é uma mudança em relação ao MAI Code 1.1 Flash, que estava desativado por padrão em agosto.
- API: só o Flash está no Microsoft Foundry, como prévia de acesso limitado e sem preço publicado ainda. O MAI Code 2 em si não está lá.
- Em breve: a Microsoft cita OpenRouter, Vercel, Hermes, Open Code e Kilo, sem datas.
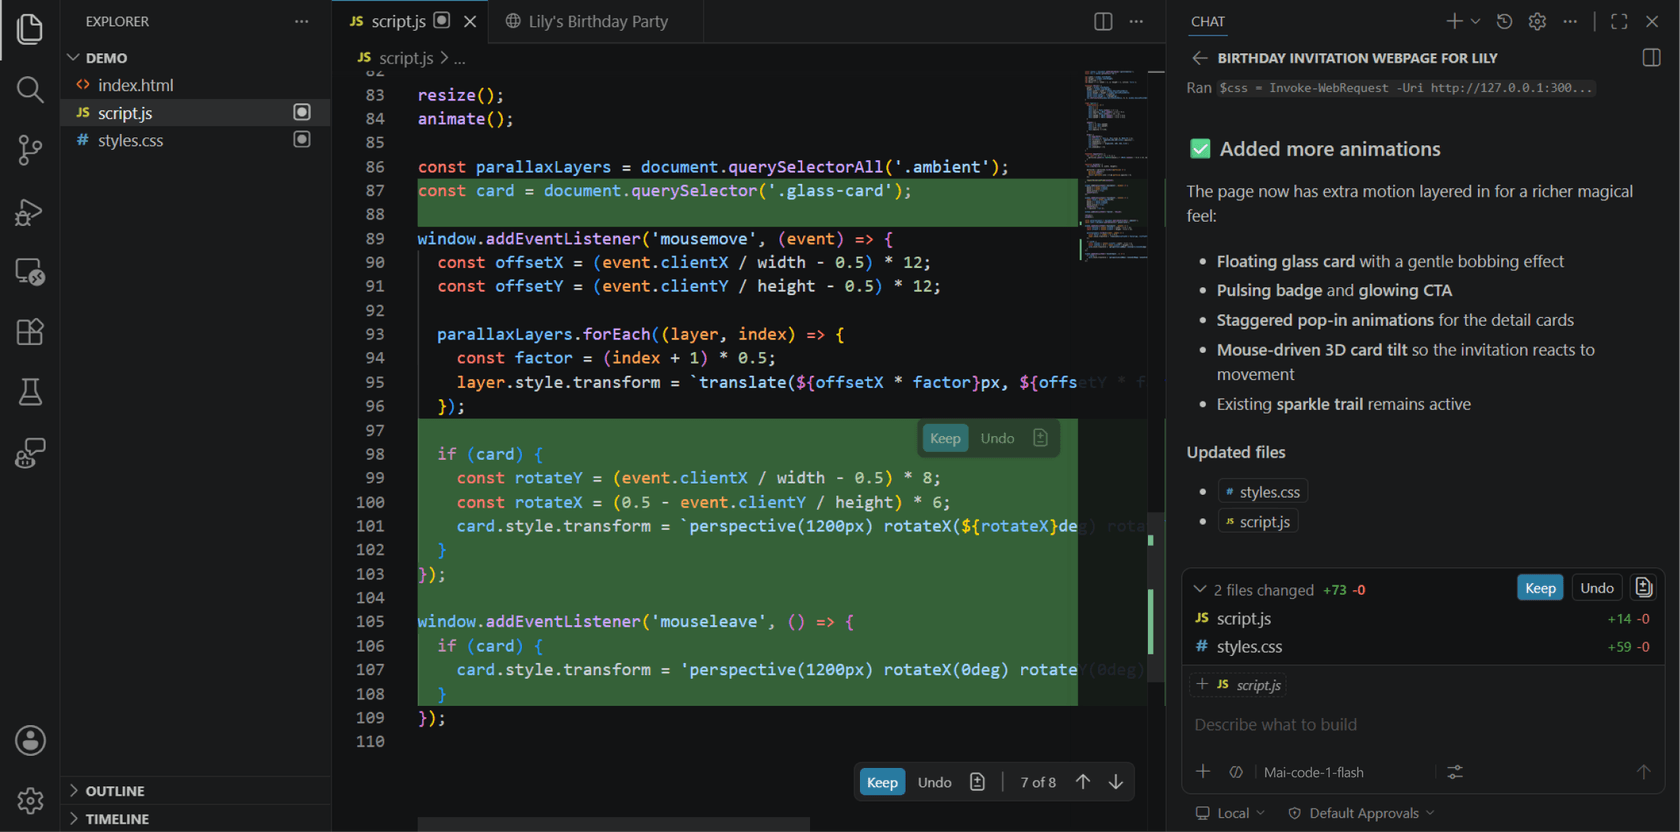
Essa captura é do lançamento anterior do MAI-Code-1-Flash, mas o fluxo é o mesmo para o MAI Code 2: abra o chat do Copilot, escolha o modelo na parte inferior e trabalhe como sempre. Se você é administrador, revise agora sua política de modelos. Um modelo que sua equipe não validou e que aparece ativado por padrão merece um olhar de cinco minutos.
O acesso é o ponto fraco para quem está fora do Copilot. Se você constrói sobre APIs diretas, ou vive no Claude Code ou no OpenAI Codex, ainda não pode conectar o MAI Code 2. Um usuário do Hacker News resumiu a frustração sem rodeios:
"What annoys me a lot about MSFT releases are, that is not possible to find how to use these models and where to try them. I didn't hear anyone in my circle using MAI models, none."
O MAI Code 2 é open source?
Não. O model card diz que "os pesos do modelo não são distribuídos, e os modelos são servidos em infraestrutura de GPU do Microsoft Azure". Algumas matérias iniciais o chamaram de um pequeno modelo de pesos abertos sob licença MIT. Isso parece vir do repositório microsoft/MAI-Code, que tem licença MIT mas só contém um README e modelos de issue para feedback.
Para empresas que querem controle sobre os pesos, a Microsoft anunciou o MAI Licensed Weights no mesmo dia. Isso permite que uma empresa rode e ajuste modelos MAI em seu próprio ambiente Azure, e está "disponível em breve" pelas equipes de conta da Microsoft. As citações de parceiros na página do modelo vêm desse caminho. A AT&T diz que sua versão personalizada do Flash superou o GPT-6.1 Sol em análise padrão de rede 5G "custando 50 vezes menos", segundo a página do modelo. Esses são modelos ajustados, porém, não o que você vai escolher no Copilot.
O que os desenvolvedores estão dizendo sobre o MAI Code 2?
A thread de lançamento no Hacker News chegou a 278 pontos e 131 comentários em um dia. A maior parte do burburinho foi sobre benchmarks e cobrança, não sobre o modelo em si, já que quase ninguém tinha tido tempo real com ele ainda.
A reclamação mais comum foi sobre a montagem da comparação:
"While showing MAI Code 2 at a 50% promotional discount, and comparing to Max reasoning effort for Opus 5.5 and 6.1 Sol..."
A segunda foi a cobrança do Copilot. Desde que o GitHub passou para a cobrança por uso em junho, um modelo barato só ajuda se seus créditos durarem:
"I think they won't help if they're billed at the announced rate on your Copilot quota. Microsoft would need to do something like Devin does and offer its own models with separate limits."
O interesse foi real, porém, principalmente de quem já trata a escolha de modelo como uma palanca de custo:
"Price and performance look good based on benchmarks. Am definitely interested in trying this to see given a lot of my workload of actual coding is handed over to Haiku/Luna right now."
Esse último bate com minha leitura. Quem mais ganha é quem já trata a escolha de modelo como uma alavanca de custo. Se você está decidindo entre Copilot, Cursor e uma ferramenta de código em terminal, o MAI Code 2 é um motivo para olhar o Copilot de novo, não um motivo para trocar só por isso.
No que você deve ficar atento?
A Microsoft é inusitadamente transparente sobre os limites, o que eu aprecio. O post de lançamento diz que os dois modelos "explicitamente ainda não estão ajustados para problemas mais difíceis, como pesquisa científica fundamental e trabalho agêntico de horizonte muito longo". O model card acrescenta mais alguns pontos:
- Sessões longas saem do rumo. "Em sessões agênticas longas, os modelos podem repetir chamadas de ferramentas, subutilizar a base de código existente, desviar das instruções ou parar antes de verificar completamente seu trabalho." Se você roda agentes autônomos longos a partir de uma CLI de codificação, verifique a saída.
- Só inglês. "No lançamento, o modelo é otimizado apenas para produção de código em inglês." Comentários e documentação em outros idiomas podem sair mais fracos.
- Mais esforço não é sempre melhor. O card diz que um esforço de raciocínio maior "não melhora sempre os resultados". Comece em médio e suba só quando uma tarefa falhar.
- Alinhamento. A Microsoft classifica os dois modelos como "semelhantes em alinhamento ao GPT-5.6 Sol, mas menos alinhados que o GPT-6". Mantenha suas barreiras de revisão de sempre sobre qualquer coisa que ele faça commit.
- Seus prompts podem ter treinado o modelo. Segundo o data card, o pós-treinamento usou contextos de conversa de usuários do Copilot Free, Pro e Pro+ que não haviam optado por sair. Se isso importa para você, revise suas configurações de dados do Copilot.
O card também classifica os dois modelos como "Alto" risco para uso cibernético ofensivo e uso indevido químico, biológico, radiológico e nuclear, e diz que eles vêm com um classificador que filtra esses pedidos. Isso é padrão hoje para um modelo próximo da fronteira, e não vai afetar o trabalho normal de codificação.
Você deveria usar o MAI Code 2?
Se você está no Copilot e a maior parte do seu trabalho são mudanças bem delimitadas, sim, pelo menos enquanto a promoção durar. Veja como eu dividiria o trabalho:
| Se você usa | Minha opinião |
|---|---|
| GPT-6.1 Sol ou GPT-6.2 Sol no Copilot | Experimente o MAI Code 2 para trabalho rotineiro em vários arquivos. Pontuações parecidas a cerca de 40% do custo por tarefa até maio de 2027. Reavalie depois que o preço dobrar. |
| Claude Opus 5.5 | Mantenha o Opus para tarefas longas e difíceis em repositórios, onde ele lidera o SWE Atlas por 14 pontos. Mova as correções bem delimitadas para o MAI Code 2 e economize cerca de 95% nelas. |
| GPT-6 Luna ou Claude Haiku 5.5 | Experimente o Flash. Ele marcou de seis a sete pontos mais e custa menos por tarefa durante a promoção. No preço de tabela, custa mais por tarefa que o Luna. |
| Claude Code, Codex ou APIs diretas | Espere. O MAI Code 2 ainda não está acessível fora do Copilot, e o Flash é só prévia no Foundry. |
| Agentes autônomos longos | Fique com um modelo maior. A Microsoft diz que ele não está ajustado para trabalho agêntico muito longo. |
Se você está avaliando ferramentas de codificação de forma mais ampla, o resumo das melhores ferramentas de IA e o guia de alternativas ao Copilot vão além de um único modelo. Os outros modelos próprios da Microsoft, como o MAI-Transcribe-2 para voz e o Decision 1, seguem a mesma cartilha: uma tarefa estreita a um preço baixo.
O que o MAI Code 2 significa para uma equipe de suporte?
Um modelo de código mais barato é infraestrutura mais barata. Não é um agente de suporte. O MAI Code 2 não conhece sua política de reembolso, não consegue ver seu helpdesk, e a Microsoft o ajustou para escrever código em inglês, não para responder clientes. Se você está construindo automação de suporte, o modelo é só uma peça do trabalho. O resto é conhecimento, tom, barreiras de segurança e regras de transferência, algo que uma comparação de modelos para suporte não resolve por si só.
Essa é a camada que a eesel constrói. O MAI Code 2 é infraestrutura; a eesel é a funcionária. Você contrata um colega de IA de helpdesk para sua fila, ou um redator de blog com IA para conteúdo, e cada um chega com as integrações, o conhecimento da empresa e os limites do seu papel. Onde um modelo de código realmente ajuda é em construir em torno dele: um desenvolvedor pode apontar o Copilot ou o Claude Code para a CLI da eesel para carregar conhecimento aprovado e testar respostas, enquanto conectar o helpdesk em si ainda precisa que um administrador aprove.
O SE Ranking mostra como isso se parece em escala. A empresa de software de SEO opera três produtos com uma única equipe de suporte, então ela roda três agentes da eesel, um por produto, em três conexões Zendesk. Entre 8 de agosto e 8 de setembro de 2026, esses agentes trataram 4.650 conversas, responderam primeiro a 2.100 chats em tempo real e usaram cerca de 16.800 páginas de conhecimento. Nada disso depende de qual modelo está em alta nesta semana, e esse é o ponto: o modelo por trás pode mudar sem que o cliente perceba.
Se você está comparando ferramentas para essa tarefa, o resumo do melhor software de helpdesk IA cobre o terreno, e os benchmarks de custo por ticket colocam os preços dos modelos ao lado do custo total de um ticket.
Testar a eesel
Se o MAI Code 2 fez você pensar no que modelos baratos podem fazer pela sua fila de suporte, comece pela parte que decide se funciona: o colega de equipe em torno do modelo. A eesel se conecta ao helpdesk que você já usa, aprende com seus tickets passados e sua central de ajuda, e permite que você a rode contra tickets históricos reais para que possa ler as respostas antes de um cliente ver uma. Os planos são pacotes fixos de créditos a partir de 299 $ por 500 créditos, então sua fatura não varia quando o preço por token de um modelo dobrar em maio.

Você pode testar a eesel gratuitamente em uma parte da sua fila, ou compará-la com usar o ChatGPT diretamente se ainda estiver decidindo se deve construir isso você mesmo.