

Resumo
O DeepInfer é o motor que roda a API da própria DeepSeek e, desde 20 de outubro de 2026, é gratuito no GitHub sob a licença Apache 2.0. O código não custa nada; o ingresso para rodá-lo com eficiência é cerca de 128 GPUs Blackwell, que a própria DeepSeek aponta como a menor unidade eficiente. Na tarifa Blackwell mais barata listada pela AWS, isso dá aproximadamente US$ 32.500 por dia, o mesmo dinheiro que compra 54 bilhões de tokens de saída na API da DeepSeek a preços fora do pico.
Então o lançamento importa, só que não como um kit para "rodar a DeepSeek por conta própria". Ele suporta um modelo (V4.1 Flash), duas famílias de chips e vem sem o sistema de cache KV e os balanceadores de carga que tornam possíveis os números da DeepSeek. O público real são provedores de inferência e laboratórios, e o efeito real está nos preços de API de todos os outros.
Se você chegou ao DeepInfer porque quer IA atendendo clientes, pode pular a conta das GPUs por completo. Eu construo os agentes por trás da eesel, e a SE Ranking roda três deles no Zendesk, atendendo 4.650 conversas em um mês sem nenhuma pilha de inferência própria.
O que é o DeepInfer?
O DeepInfer é o framework de inferência interno da DeepSeek: o software que pega um modelo treinado e o serve a milhões de usuários de forma rápida e barata. O README no GitHub o chama de "the high-performance inference framework that powers DeepSeek's large-scale production services." A DeepSeek anunciou no X em 20 de outubro de 2026, e a discussão no Hacker News chegou a 2.353 pontos e 892 comentários em poucos dias.
Se "framework de inferência" é novidade para você: o treinamento constrói o modelo, a inferência é cada vez que alguém pergunta algo a ele. Motores de código aberto como vLLM e SGLang já fazem esse trabalho para a maioria dos modelos abertos. O DeepInfer é a versão própria da DeepSeek dessa ideia, e o README deixa claro que ele "was originally built primarily on vLLM, with additional inspiration from SGLang and TensorRT-LLM."
Aqui está a versão curta do que foi lançado, direto do README:
| DeepInfer, lançamento de outubro de 2026 | |
|---|---|
| Licença | Apache 2.0 |
| Modelos suportados | Apenas DeepSeek-V4.1-Flash |
| Hardware suportado | GPUs NVIDIA SM100, NPUs Huawei Ascend 950 |
| Software | Linux, GCC 13+, Python 3.12, CUDA 13 ou CANN 9.2 |
| Modo | Inferência offline (em lote), não é um servidor de API pronto |
| Linguagem | Python 89,1%, C++ 10,6% |
| Lançamento complementar | deepseek-recipe, o codificador de API para tokens |
O modelo que ele serve é o DeepSeek V4.1 Flash, um modelo com contexto de 1M, visão e chamadas de ferramentas que cobri na minha análise do V4.1 Flash 1017. A DeepSeek diz que o "inference code for future DeepSeek models" chegará ao mesmo repositório.
O que a DeepSeek realmente lançou?
A manchete diz "totalmente open source". O README é mais cuidadoso, e essa diferença é a coisa mais útil para entender o DeepInfer.
O que há na caixa, segundo o README:
- Kernels otimizados dos lançamentos abertos anteriores da DeepSeek: FlashMLA, DeepGEMM, DeepEP, TileKernels e DeepSelect, além de kernels TileLang próprios.
- Paralelismo: paralelismo de dados de atenção, paralelismo de especialistas MoE com balanceamento de carga de especialistas (EPLB).
- Decodificação especulativa DSpark com verificação agendada por confiança.
- SWA bounded replay, um truque que reduz o trabalho de prefill (mais sobre isso abaixo).
- Agendamento assíncrono, para que a GPU nunca espere a CPU entre os passos.
- Inferência invariante ao lote e amostragem determinística, apenas NVIDIA. Mesma entrada, mesma saída, independentemente do que mais esteja no lote.
- Saídas estruturadas: restrições por regex, esquema JSON ou gramática EBNF.
E o que não há. O README lista três itens "required for a complete inference service (not included in this release)":
- Um sistema de cache KV.
- Desagregação de codificador de visão / prefill / decode ("most required engine functionality is already implemented").
- Balanceamento de carga entre réplicas de paralelismo de dados, tanto para prefill quanto para decode.
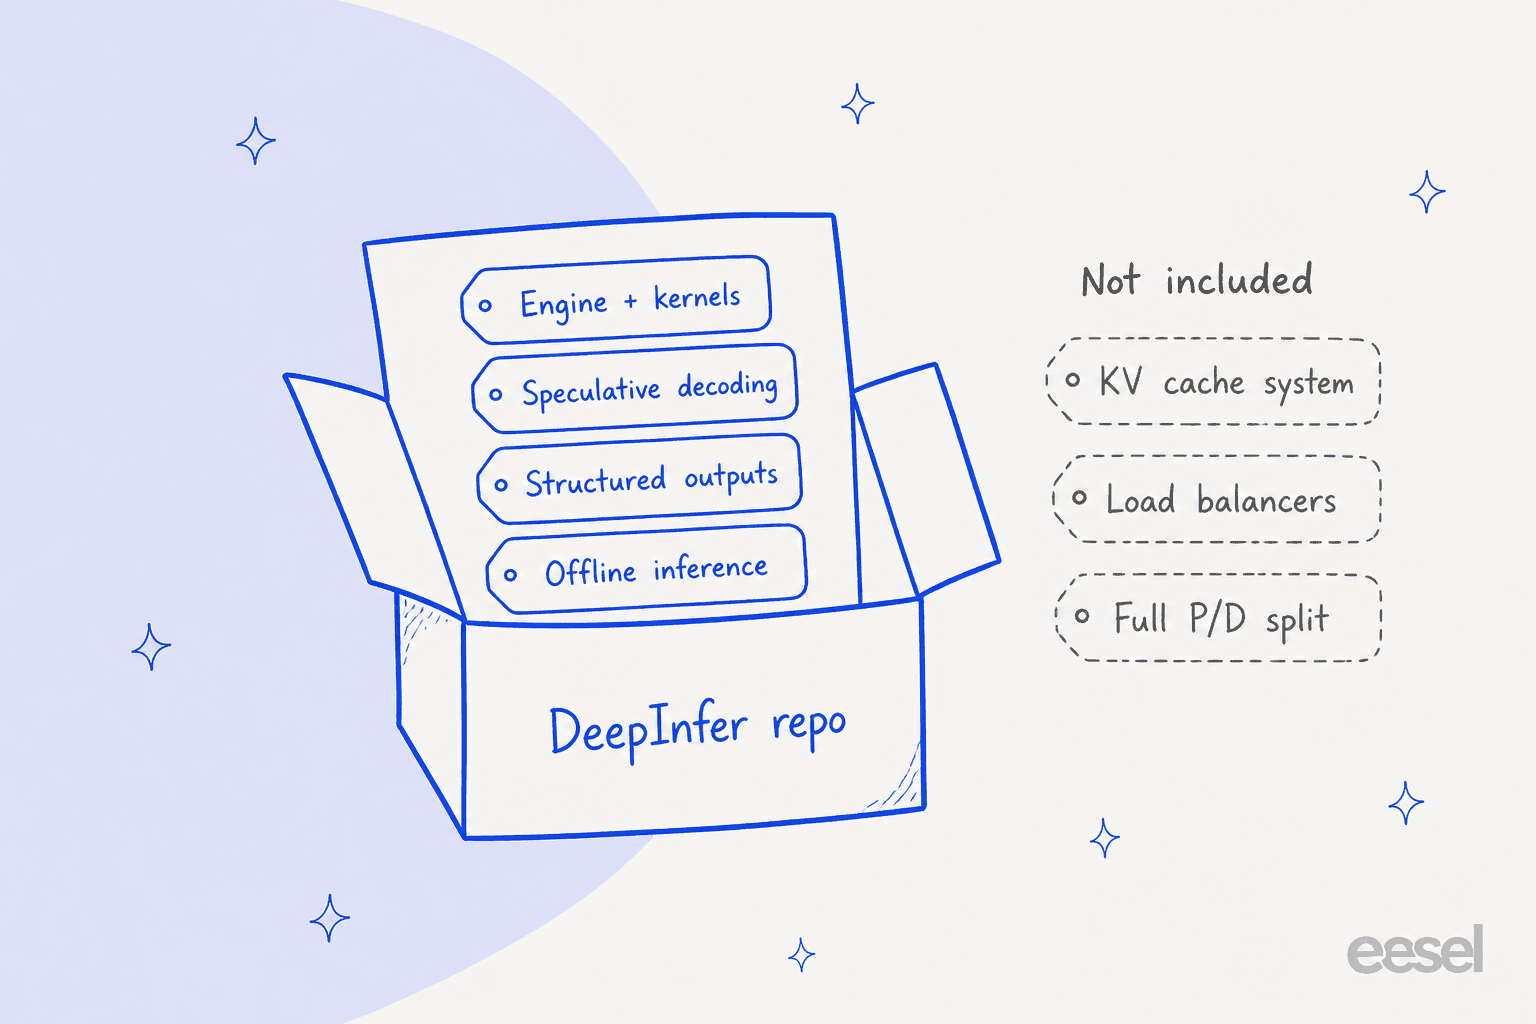
O Q&A de implantação da DeepSeek explica o motivo: as peças de cache KV e balanceamento de carga "are tightly coupled to our internal infrastructure, so that code is not yet fully open-sourced." O mesmo documento então descreve com bastante detalhe como essas peças ausentes funcionam, o que é generoso. É um documento de projeto das partes que você teria de construir por conta própria.
O Hacker News percebeu isso rápido. A versão mais compacta:
"Notably missing their kv cache system"

Isso importa porque o cache KV é de onde vêm os preços baixos da DeepSeek. A API cobra US$ 0,003 por milhão de tokens de entrada em cache fora do pico contra US$ 0,15 sem cache, uma diferença de 50x, e o motor que gera essa diferença é a parte que você não recebe.
Como o DeepInfer funciona?
O DeepInfer divide o serviço em etapas separadas que rodam em grupos separados de GPUs e depois as une com balanceadores de carga e um cache compartilhado. Esta é a arquitetura que a DeepSeek publicou no seu Q&A:
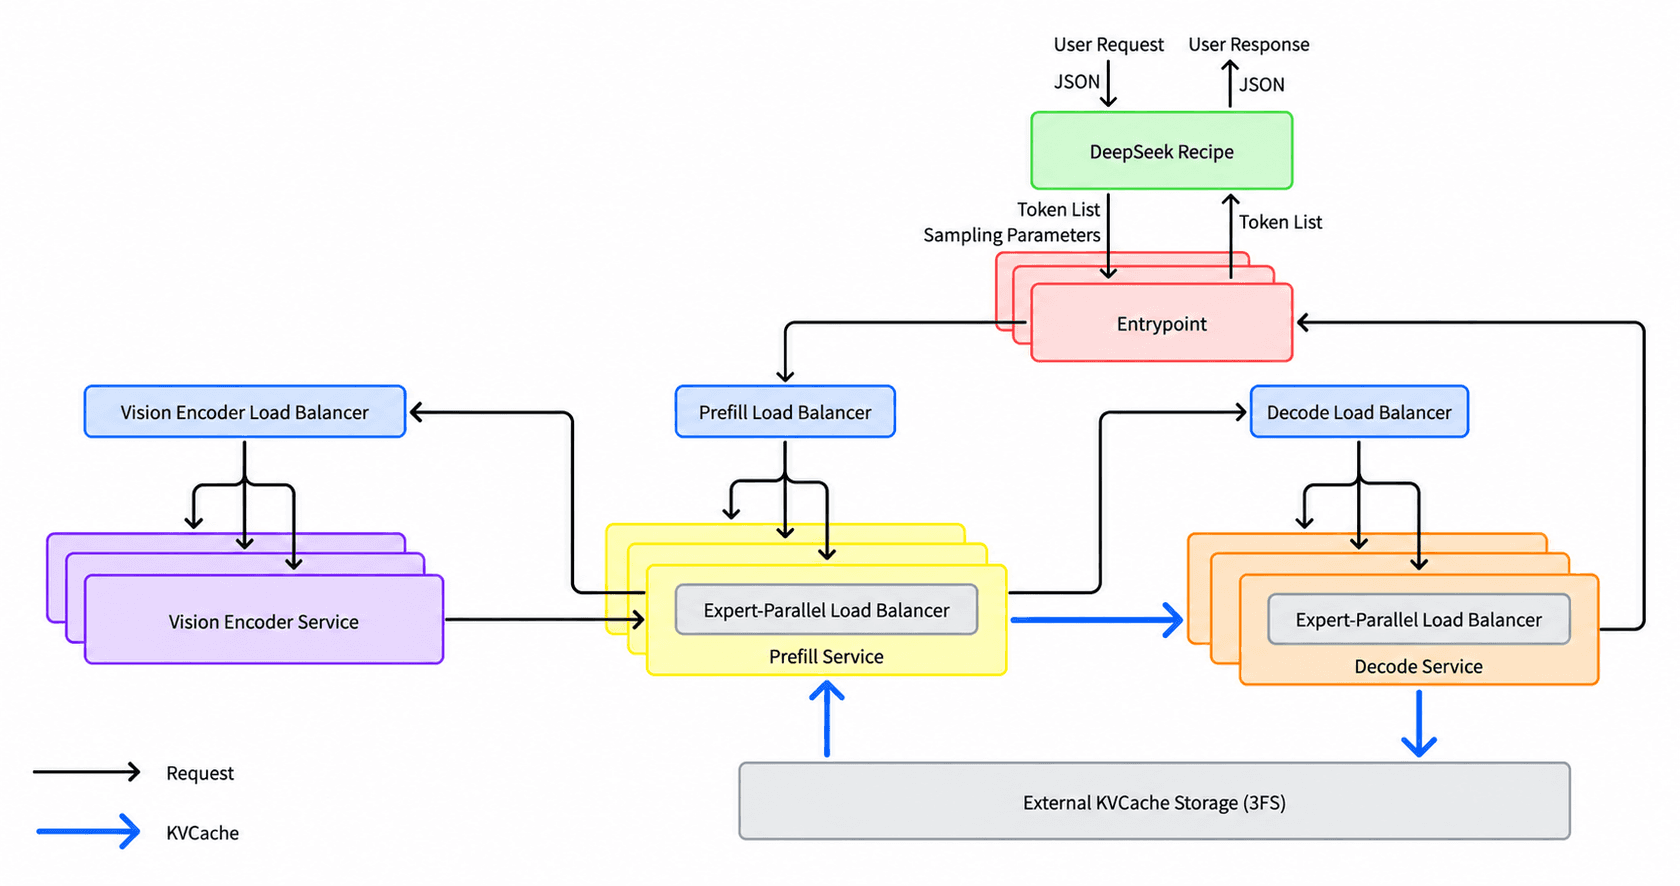
Lendo de cima para baixo:
- DeepSeek Recipe transforma uma requisição JSON de entrada (no formato Chat Completions, Responses ou Messages API) em tokens e transforma os tokens de saída de volta em uma resposta em streaming. É escrito em Rust com bindings para Python.
- O ponto de entrada verifica no cache se há um prefixo correspondente e então roteia a requisição.
- O prefill lê o prompt inteiro e constrói o estado de atenção. A DeepSeek o executa em "ordinary 8-GPU machines", com paralelismo de especialistas de 2 a 8.
- O decode gera a resposta token por token. Roda em largura: paralelismo de especialistas de 64 a 128 GPUs.
- O cache KV é gravado em um cluster de armazenamento dedicado para que a próxima requisição com o mesmo prefixo pule o prefill.
A separação existe porque os dois trabalhos pressionam o hardware de formas diferentes. O prefill é uma grande rajada de cálculo sobre um prompt longo; o decode é um longo gotejar de passos minúsculos em que o tráfego de memória é o gargalo. Rodá-los em grupos de GPUs separados permite à DeepSeek ajustar cada um, de modo que o tempo até o primeiro token e a velocidade de cada token seguinte podem ser controlados de forma independente.
Paralelismo de especialistas em largura
O V4.1 Flash é um modelo de mistura de especialistas: cada token ativa apenas algumas das sub-redes "especialistas" do modelo. Espalhar esses especialistas por 64 GPUs em vez de 8 significa que cada GPU guarda menos especialistas e move menos memória por passo. O gráfico da própria DeepSeek mostra o ganho:
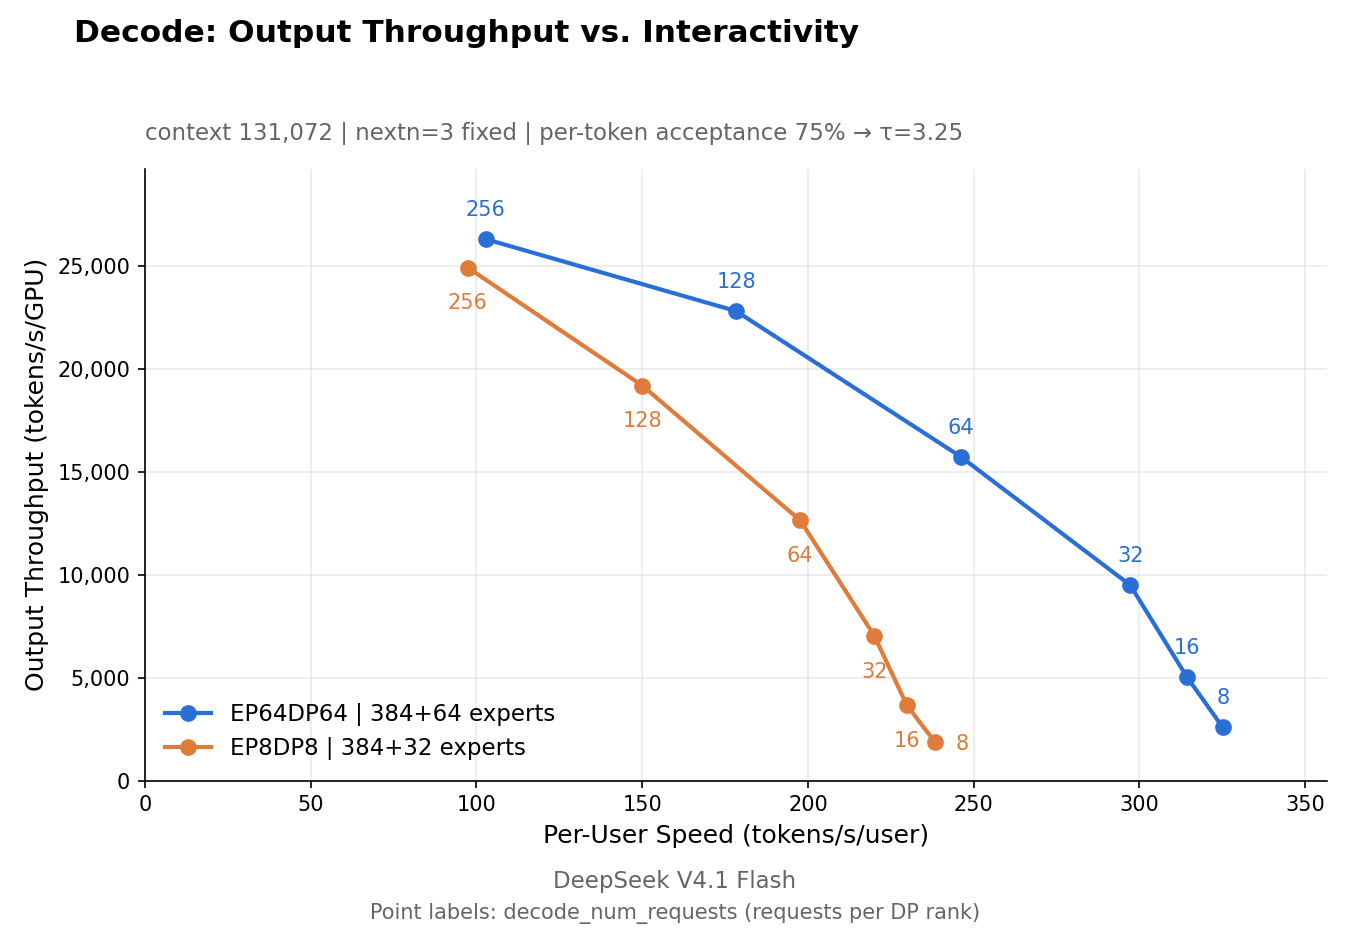
Com 64 requisições por rank, a configuração EP64 faz cerca de 15.700 tokens por segundo por GPU a aproximadamente 246 tokens por segundo por usuário. O EP8 chega a cerca de 12.600 a 198 por usuário, mais lento. Ir em largura é o que permite à DeepSeek ser rápida e barata ao mesmo tempo, e também é o motivo de a implantação mínima ser tão grande.
Decodificação especulativa DSpark
Na decodificação especulativa, um pequeno modelo rascunho adivinha os próximos tokens e o modelo principal os confere de uma só vez. O diferencial da DeepSeek é que uma "Confidence Head" prevê quais palpites provavelmente estão certos, então só gasta computação de verificação com os promissores. Segundo o Q&A, isso reduz os tokens de rascunho verificados por passo em cerca de 30% (de 5,00 para 3,2-4,4) quase sem mudança no comprimento aceito (3,29 vs. 3,20). O resultado é +4-7% de vazão no ponto de operação de produção. Modesto, mas com 155 trilhões de tokens por dia, 5% são muitas GPUs.
SWA bounded replay
Esta é a parte mais engenhosa. Quando a um prefixo em cache falta parte do estado de atenção de janela deslizante, o DeepInfer recalcula apenas os últimos 128 tokens em vez da janela inteira. O Q&A diz que o custo de recálculo passa a ser "a constant, independent of context length and layer count", e que a versão do lado do decodificador está "nearly halving total prefill computation". No README, você a ativa com DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact.
O cache KV que você teria de construir
A camada de cache da DeepSeek é enorme. O Q&A descreve cerca de 100 PiB de armazenamento SSD no sistema de arquivos 3FS, com prompts em cache mantidos por 3 dias para tráfego de agentes e 7 dias para tráfego de chatbots, e cerca de 14,4 TB de cache lógico por GPU online. Essa longa retenção é o motivo de uma conversa que volta à DeepSeek ser tão barata, e é a peça "tightly coupled to our internal infrastructure."
O que é preciso para rodar o DeepInfer?
Dois números decidem se o DeepInfer é para você: a lista de hardware e o tamanho mínimo do cluster.
Hardware. Apenas GPUs NVIDIA SM100 (Blackwell) e NPUs Huawei Ascend 950. Sem Hopper (H100/H200), sem placas de consumo. Um repositório da comunidade, o Deepinfer-SM80, já porta as ideias para GPUs Ampere mais antigas, o que mostra a demanda por uma versão que rode no hardware que as pessoas realmente têm.
Configuração. O caminho para começar é curto se você tem as máquinas:
# Use `ascend` instead for the Ascend platform
export DEEPINFER_ACCELERATOR=nvidia
./build.sh
python examples/offline_inference.py --ep 8
A primeira execução baixa o checkpoint deepseek-ai/DeepSeek-V4.1-Flash-1017 do Hugging Face. Isso é inferência offline (em lote): você entrega prompts e ele devolve saídas. Não há servidor compatível com OpenAI na caixa.
Cluster mínimo. Este é o ponto que a maior parte da cobertura pula. Do Q&A: "the smallest efficient deployment unit is 64 GPUs of prefill plus 64 GPUs of decode." Tecnicamente dá para rodar um nó de prefill e um de decode, mas o decode é ajustado para EP64 e acima, e os números de eficiência acima assumem isso.
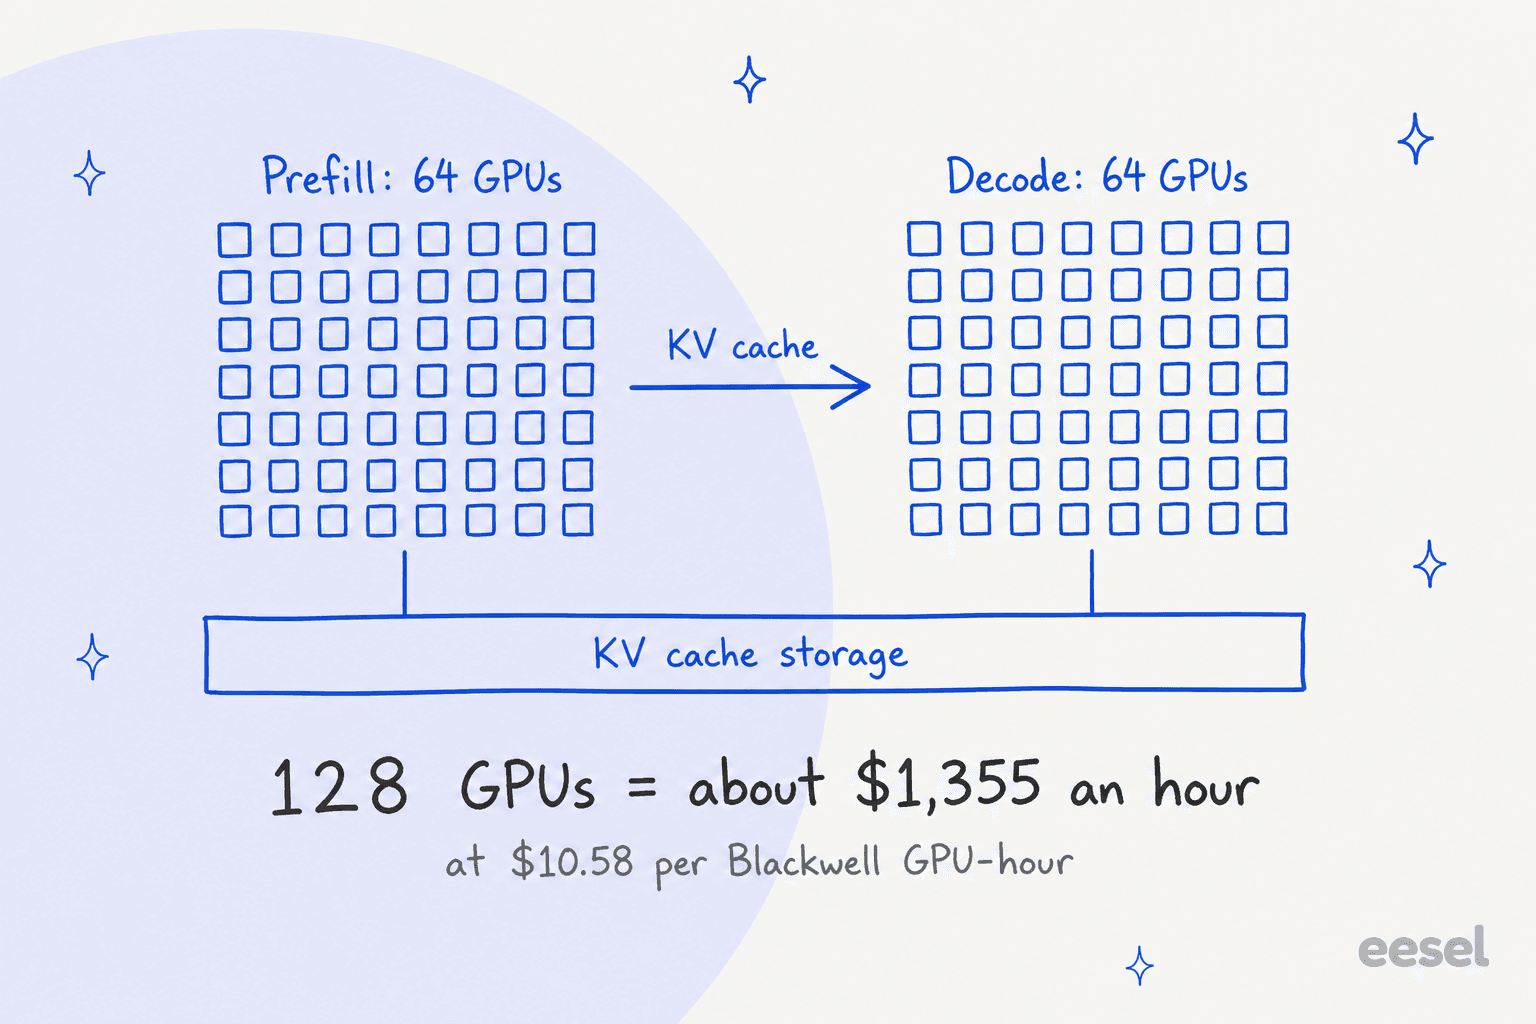
Mais o armazenamento. A DeepSeek recomenda 20 SSDs de 30,73 TB por servidor de armazenamento de cache KV, cada um entregando pelo menos 40 GB/s de leitura, dimensionados para guardar 24 horas de dados. A maioria das equipes que leem o README não tem isso sobrando.
Quanto custa o DeepInfer?
O DeepInfer em si custa US$ 0. Todo o resto é hardware, e a comparação honesta é com simplesmente chamar a API da DeepSeek.
Veja o que a DeepSeek cobra pelo mesmo modelo que o DeepInfer serve, segundo a página de preços:
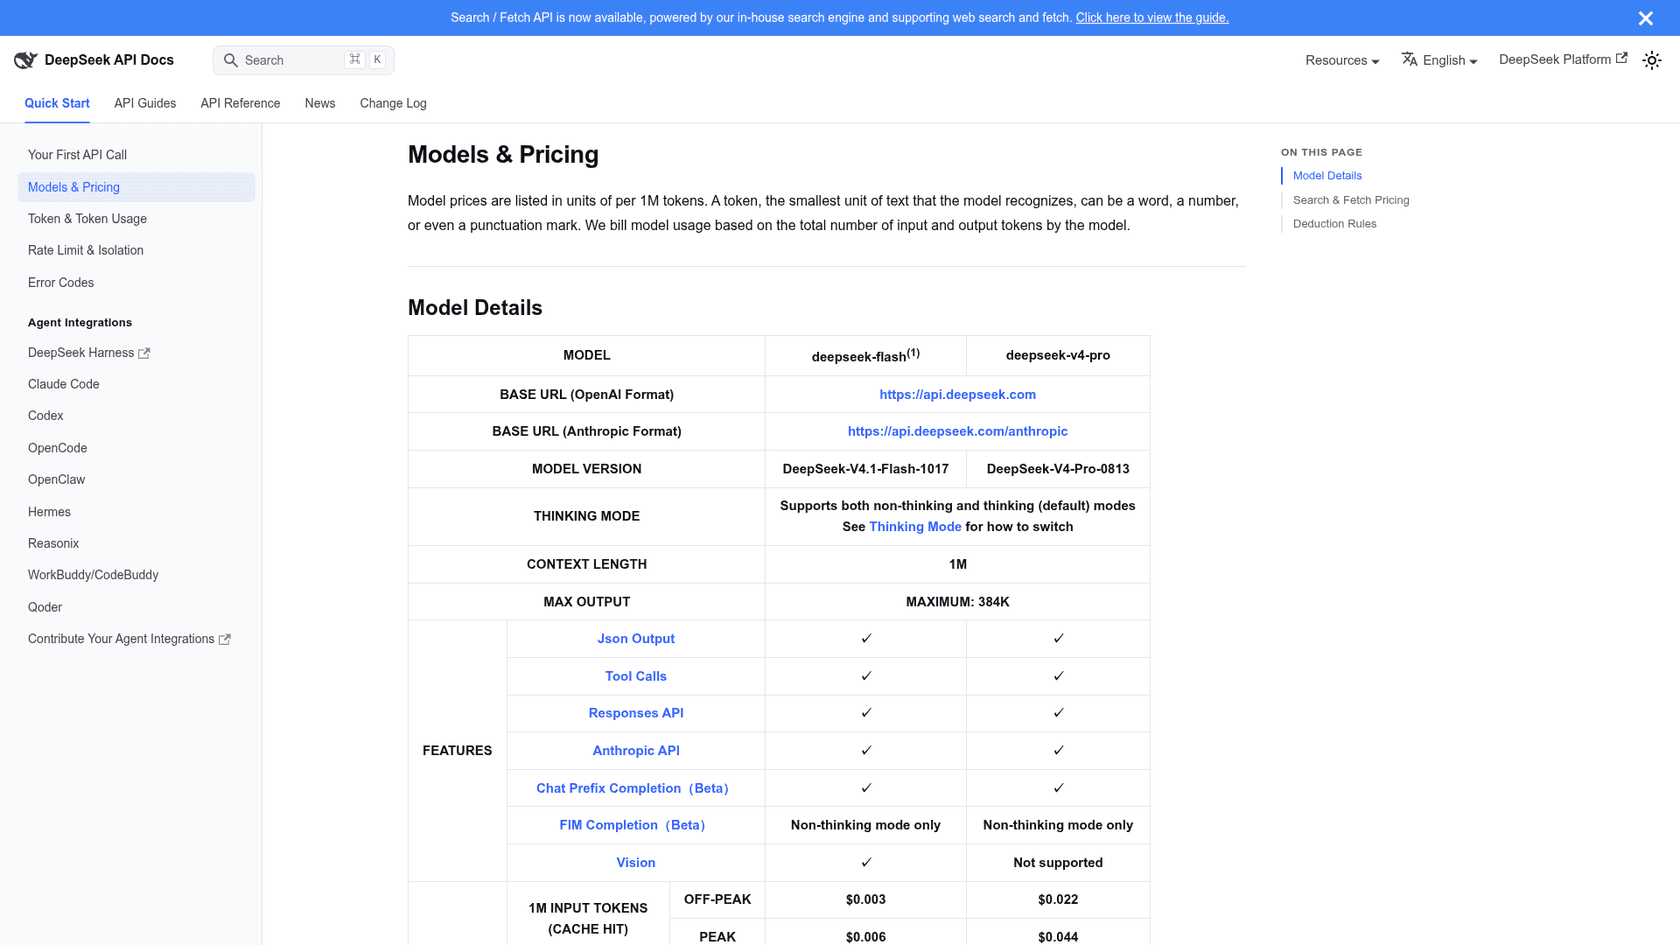
| Por 1M de tokens | V4.1 Flash, fora do pico | V4.1 Flash, pico | V4 Pro, fora do pico | V4 Pro, pico |
|---|---|---|---|---|
| Entrada, acerto de cache | $0.003 | $0.006 | $0.022 | $0.044 |
| Entrada, falha de cache | $0.15 | $0.30 | $0.66 | $1.32 |
| Saída | $0.60 | $1.20 | $1.98 | $3.96 |
Os horários de pico são 01:00-04:00 e 06:00-10:00 UTC em dias úteis; todo o resto, inclusive fins de semana, custa metade. Meu guia de preços do V4.1 Flash detalha essas janelas, e a comparação V4 Flash vs V4 Pro mostra quando o modelo maior vale a pena.
Agora o lado do autohospedagem. Os AWS EC2 Capacity Blocks listam o GB200 a US$ 10,582 por hora de acelerador (US East Dallas Local Zone) e o B200 a US$ 14,208 (Ohio, Virgínia, Oregon e outras). Ambos são SM100 Blackwell.
| Cluster de 128 GPUs | Por hora | Por dia | Por 30 dias |
|---|---|---|---|
| GB200 a $10.582/hora de GPU | $1,354 | $32,508 | $975,240 |
| B200 a $14.208/hora de GPU | $1,819 | $43,647 | $1,309,402 |
Isso é antes dos servidores de armazenamento, da rede e dos engenheiros para construir o cache KV e os balanceadores de carga que faltam. US$ 32.508 por dia compram 54,2 bilhões de tokens de saída da DeepSeek a tarifas fora do pico, ou 27 bilhões no pico.
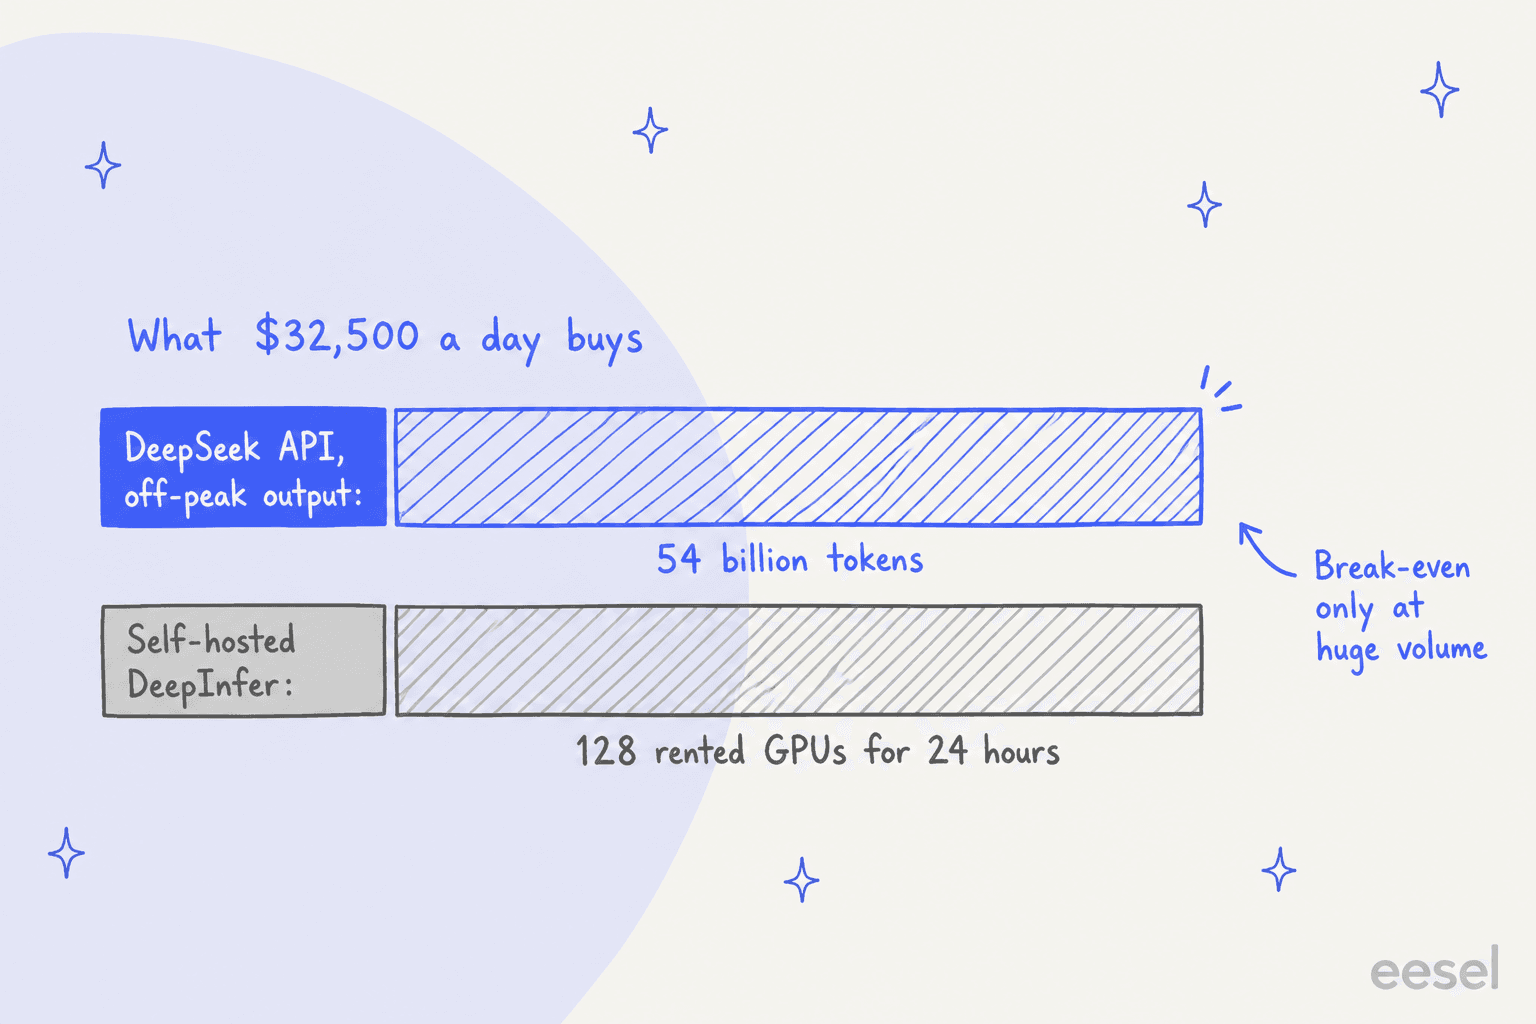
As 128 GPUs conseguem mesmo produzir tanto? Usando o próprio benchmark de decode da DeepSeek (cerca de 15.700 tokens por segundo por GPU com 64 requisições por rank) em 64 GPUs de decode, o teto é de cerca de 87 bilhões de tokens de saída por dia. A DeepSeek diz que seu balanceamento de carga atinge "roughly 80% of a perfectly balanced offline benchmark", o que leva a cerca de 69 bilhões. Portanto, autohospedar só vence a API fora do pico se você mantiver o cluster em cerca de 80% da eficiência de produção da própria DeepSeek, 24 horas por dia, com uma infraestrutura que a DeepSeek não liberou. É um teto aproximado, não uma cotação, mas mostra o formato da decisão.
Insira o seu próprio volume:
Com os valores padrão, um produto bem movimentado usando 500 milhões de tokens de saída e 3 bilhões de tokens de entrada por dia, a API custa cerca de US$ 680 por dia contra US$ 32.508 das GPUs. Você precisaria de cerca de 48 vezes esse tráfego para o cluster vencer só no hardware.
O que o número de US$ 38 por hora de GPU revela
A frase mais citada do lançamento não está no README. Está no Q&A: "A single cluster currently serves 155 trillion tokens per day, with overall revenue of US$38 per GPU-hour (at valley pricing)." Valley pricing significa a tarifa fora do pico.
Colocando isso ao lado das tarifas da AWS acima, a DeepSeek fatura cerca de 2,7 a 3,6 vezes o que custaria alugar uma GPU Blackwell pela mesma hora, e ainda cobra US$ 0,60 por milhão de tokens de saída fora do pico. A DeepSeek não diz a qual placa o número se refere, e não informa os próprios custos, então trate-o como receita, não como margem. O HN também notou a diferença:
"For comparison, rental prices seem to be ~$2.75/ per H-100-hour [1]. Meanwhile, Deepseek says "38 USD per hour per card". They haven't specified which card as far as I can tell."
O ponto não é que a DeepSeek seja rica. É que preços baixos de API podem ser um negócio de verdade quando a pilha de serviço é tão eficiente. Isso pressiona todo provedor que cobra mais pelos mesmos pesos abertos, e o DeepInfer entrega o manual a eles.
O que os desenvolvedores estão dizendo sobre o DeepInfer
A reação se dividiu em três: empolgação com a abertura, ceticismo sobre o que falta e um comentário afiado sobre quem se beneficia.
O caso cético, da discussão no HN:
"Deepseek released just enough to stir the pot but not enough to cook your own from scratch. Wake me up when we can clone, point it at a dozen H100s we own, and get a working production service."
Isso é justo nos dois pontos: as H100 não são suportadas e as peças de produção não estão lá. Por outro lado, hosts de terceiros já competiam forte com os modelos da DeepSeek antes deste lançamento:
"Together.ai, Baseten, and others have already achieved higher throughput, lower latency, and lower E2E latency for DeepSeek V4.1 Flash 1017 than DeepSeek's own inference service."
Provedores como Together AI, Baseten e Fireworks AI são os que realmente podem usar os kernels do DeepInfer e o codificador deepseek-recipe, que a DeepSeek diz estar "fully aligned with the official DeepSeek API, so third-party deployments get the same API behavior as the official one." Para um desenvolvedor, isso significa que um modelo da DeepSeek num host de terceiros deve interpretar chamadas de ferramentas e raciocínio da mesma forma que na DeepSeek. É uma correção discreta, mas real.
E um ponto sobre modelos de preço que nada tem a ver com motores:
"Even though their API price is cheap compared to OpenAI/Anthropic, I still can't "afford" to use their API because the subscriptions from OAI/Anthropic provide far higher value and peace of mind. I know for sure how much I need to pay each month."
O próprio anúncio da DeepSeek apresentou o objetivo como ajudar "the community lower compute costs, reduce energy use, and make AI more affordable." O post recebeu 43.339 curtidas no X.
Como o DeepInfer se compara ao vLLM e ao SGLang?
O DeepInfer ainda não é um rival de uso geral do vLLM ou do SGLang. É um especialista construído a partir deles. Veja como os três se alinham, segundo o README de cada projeto:
| DeepInfer | vLLM | SGLang | |
|---|---|---|---|
| Modelos | Apenas DeepSeek V4.1 Flash | Muitas famílias de modelos abertos | Muitas famílias de modelos abertos |
| Hardware | Blackwell (SM100), Ascend 950 | Vários fabricantes de GPU e aceleradores | Vários fabricantes de GPU e aceleradores |
| Servidor de API online | Não neste lançamento | Sim, compatível com OpenAI | Sim, compatível com OpenAI |
| Origem | Construído principalmente sobre o vLLM | Projeto original | Projeto original |
| Melhor para | Estudar ou reutilizar os truques de produção da DeepSeek | Servir a maioria dos modelos abertos | Servir a maioria dos modelos abertos |
Se você está escolhendo um motor para servir um modelo aberto esta semana, vLLM ou SGLang ainda é a resposta. O DeepInfer é onde procurar ideias (EP em largura, DSpark, bounded replay) que provavelmente aparecerão nesses projetos em seguida. O TorchTPU do Google foi lançado no mesmo dia e tem o mesmo perfil: encanamento importante para quem opera chips, invisível para todos os outros.
Quem deveria se importar com o DeepInfer?
Resposta curta: menos gente do que o número de estrelas sugere.
- Provedores de inferência e grandes laboratórios: sim. É uma referência funcional para servir barato um modelo MoE de escala de fronteira, com o projeto das peças ausentes documentado.
- Pesquisadores e engenheiros de infraestrutura: sim, como material de estudo. O documento de Q&A é um dos relatos públicos mais detalhados de serviço de LLMs em produção que já li.
- Equipes com regras rígidas de dados que querem a DeepSeek no próprio hardware: talvez, se você já opera Blackwell ou Ascend em escala. O modo de amostragem determinística é um ponto positivo real para auditorias.
- Startups e criadores de apps: não. Use a API, ou um host como a Fireworks AI servindo modelos abertos por você. Compare com o Kimi K3.1 Pro ou o Qwen 3.8 Max antes de se comprometer com uma família de modelos.
- Equipes de suporte e operações: não. Vocês precisam de respostas, não de um motor.
O DeepInfer baixa o piso do custo de servir IA; ele não baixa o que custa a você rodar IA por conta própria. São coisas diferentes, e a maior parte da cobertura empolgada as confunde.
Onde a eesel se encaixa: isto é infraestrutura, a eesel é o funcionário
O DeepInfer é infraestrutura: torna os tokens mais baratos de produzir. A eesel é a outra ponta dessa pilha, um colega de IA que você contrata para uma função. Hoje são o colega de IA para helpdesk e o redator de blog com IA, cada um com as habilidades, integrações e contexto da empresa do seu papel já embutidos.
Para uma equipe de suporte, o custo do modelo nunca foi a parte difícil. Nas tarifas fora do pico da DeepSeek, um ticket com 6.000 tokens de entrada sem cache e 800 de saída custa cerca de US$ 0,0014, aproximadamente um sétimo de centavo. O que custa tempo de verdade é fazer o agente responder como o seu melhor atendente: ler sua central de ajuda e tickets passados, saber quando passar para um humano e provar isso no histórico real antes de os clientes verem. Já vi bots confiantes darem respostas erradas em filas ao vivo, e é por isso que toda implantação da eesel é primeiro simulada em tickets históricos.
A SE Ranking é um bom retrato de como isso fica. Ela vende três produtos a partir de uma equipe de suporte, então roda três agentes da eesel em três conexões do Zendesk, cada um respondendo pelo seu produto a partir de cerca de 16.800 páginas de conhecimento. Ao longo de um mês (de 8 de agosto a 8 de setembro de 2026) eles atenderam 4.650 conversas: 2.554 tickets do Zendesk e 2.102 chats ao vivo, com cerca de 2.100 chats respondidos primeiro pela eesel. Nenhum cluster de GPUs envolvido.

Se você quer comparar quanto a IA custa dentro do seu helpdesk, minha análise dos preços do Zendesk AI e o guia de atendimento ao cliente com IA são pontos de partida melhores do que qualquer motor de inferência. E se você tem curiosidade sobre quais modelos são realmente bons em suporte, mantenho uma visão atualizada sobre o melhor LLM para suporte.
Para desenvolvedores que gostam do terminal, a eesel tem uma CLI que opera o mesmo colega e espaço de trabalho do painel. Você, um script ou um agente de código como o Claude Code pode conectar um helpdesk, adicionar conhecimento e testar o agente em tickets passados sem abrir um navegador. Esse é o acesso amigável a agentes que a maioria das equipes realmente quer de uma "infraestrutura aberta".
Experimente a eesel
O DeepInfer é para quem opera clusters de GPUs. Se o seu objetivo é IA atendendo clientes no Zendesk, Freshdesk ou Gorgias, a eesel é um colega de helpdesk que aprende com seus tickets passados e sua central de ajuda, é testado no seu histórico real antes de entrar no ar e começa em US$ 299 por mês para 500 tickets ou chats na página de preços. Experimente a eesel grátis com 100 créditos, ou comece pelo terminal com npx @eesel/cli.
