

O TorchTPU é o backend de PyTorch de código aberto do Google para Cloud TPUs, criado com a equipe de PyTorch da Meta e aberto ao público em 20 de outubro de 2026. Ele registra a TPU como um dispositivo PyTorch normal chamado tpu, então para a maioria dos códigos a migração começa com device="cuda" virando device="tpu". Ele substitui o PyTorch/XLA, que o Google agora chama de obsoleto.
A biblioteca é gratuita sob Apache 2.0, e você paga pelo tempo de TPU: $12.00 por hora de chip Ironwood sob demanda, $6.00 com flex-start e $2.70 para Trillium. O Google informa que 98% de quase 5,000 modelos do Hugging Face rodam de imediato. O porém: é a versão 0.2.0, o torch.compile ainda força formatos estáticos, e o Google diz com clareza que "roda" e "roda rápido" são duas quantidades diferentes de trabalho.
Se você treina ou serve seus próprios modelos PyTorch, é a primeira vez que vale a pena pilotar TPUs sem aprender JAX. Se você só quer uma IA fazendo um trabalho, como responder tickets, pule a questão do chip: um colega de IA da eesel cuida da camada de modelos, e a SamCart opera quatro deles no Freshdesk e no chat do site.
O que é o TorchTPU?
O TorchTPU é um backend nativo de PyTorch para Google Cloud TPUs, os chips de IA customizados que o Google usa para treinar e servir o Gemini. O Google começou o projeto em meados de 2025 com a equipe de PyTorch da Meta, descreveu-o no Google Developers Blog em abril de 2026 e abriu o código na PyTorch Conference 2026, em 20 de outubro. O código está em google-pytorch/torch_tpu sob Apache 2.0, e a versão atual é a 0.2.0 no PyPI.
Eu construo funcionalidades e agentes de IA na eesel, e passo a maior parte da semana na parte da pilha acima do chip. Então, quando um lançamento diz "mude uma linha", vou ler como essa linha realmente é executada. A versão curta aqui é uma boa notícia com asterisco: a linha de fato faz seu modelo rodar, e a documentação é incomumente honesta sobre o trabalho que vem depois.
O anúncio do Google Cloud descreve o objetivo de forma simples: TPUs se juntam a GPUs e CPUs como opção nativa para o PyTorch. A Meta é a principal parceira, e o diretor de engenharia de PyTorch dela explica o motivo na publicação de lançamento:
"We cannot be constrained by a single hardware architecture."
Jana van Greunen, Director of PyTorch Engineering at Meta, no blog do Google Cloud
Quando capturei o repositório em 28 de outubro, ele tinha 782 estrelas, 105 contribuidores e 4,677 commits, com commits chegando a cada hora. Segundo o blog do PyTorch, ele já está "used in production for both inference and training workloads for some of the largest Google Cloud customers."
O que há de novo: adeus, PyTorch/XLA
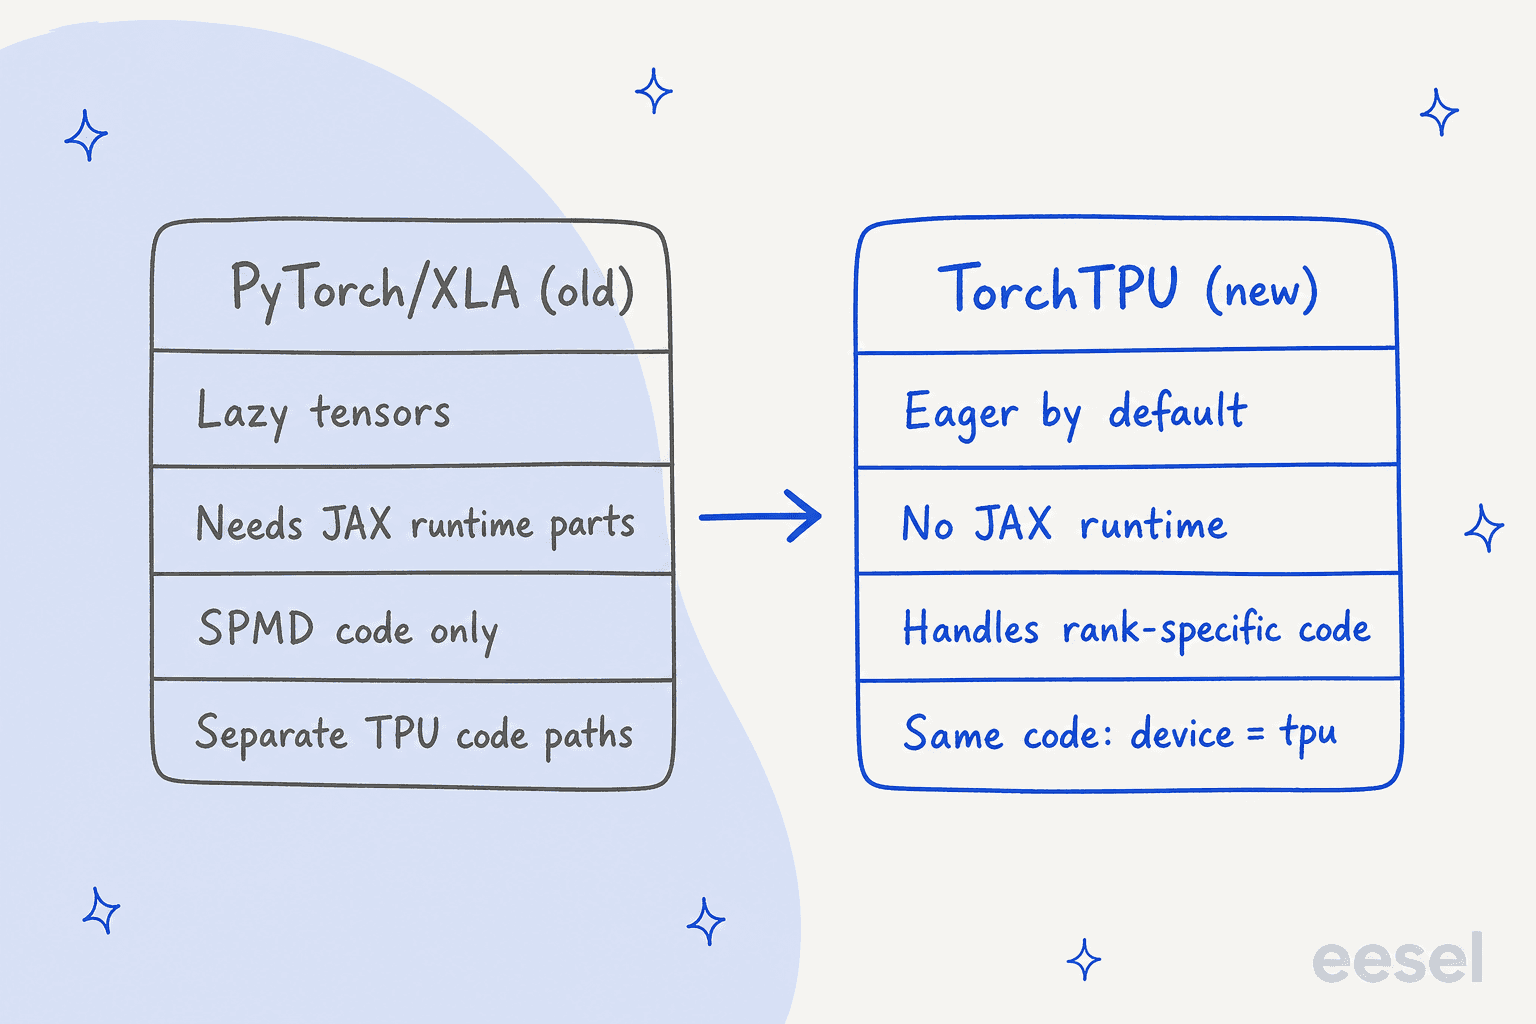
O PyTorch roda em TPUs desde 2020 por meio do PyTorch/XLA, então é justo perguntar o que mudou. A resposta do próprio Google no blog do PyTorch é direta: o PyTorch/XLA usava lazy tensors, exigia mudanças invasivas no código para marcar regiões compiláveis, tinha latência de compilação severa e não tinha um modo eager de verdade. O FAQ do TorchTPU agora diz que o PyTorch/XLA está obsoleto e foi substituído pelo TorchTPU.
Quem conviveu com a pilha antiga lembra dela do mesmo jeito. Do tópico do Hacker News sobre a prévia de abril:
"I did trained some research models using the existing PyTorch/XLA on TPUs, and it was a mess of undocumented behavior and bugs (silently hanging after 8 hours of training!)."

O TorchTPU se encaixa no PrivateUse1, o espaço oficial do PyTorch para hardware externo, de modo que um tensor de TPU é um tensor PyTorch comum. Ele não depende do runtime do JAX, segue o modelo de um processo por dispositivo do PyTorch e lida com código em que o rank 0 faz um pouco de trabalho extra, algo que a antiga pilha apenas SPMD não conseguia.
A outra mudança notável é o ecossistema em volta. O Google lançou o TorchTPU junto com backends para vLLM (com a Inferact), SGLang (com a RadixArk), TorchTitan, Ray (com a Anyscale), TorchRec e suporte nativo no Transformers v5 e no Diffusers do Hugging Face. O Hugging Face diz que seu wrapper Optimum TPU não é mais necessário.
O momento também merece atenção. A AWS lançou o TorchNeuron, seu backend nativo de PyTorch para o Trainium, no mesmo dia, na mesma conferência. As duas nuvens chegaram à mesma conclusão: o PyTorch é onde o código vive, então o chip precisa parecer um dispositivo PyTorch.
Como o TorchTPU funciona
Por baixo dos panos, o TorchTPU tem dois caminhos, ambos terminando no compilador XLA do Google. O caminho eager é um backend em C++ registrado no dispatcher do PyTorch. O caminho compilado é um backend do TorchDynamo que transforma um grafo FX inteiro em um único programa StableHLO, em vez de passar pelo TorchInductor como nas GPUs.
O modo eager tem três configurações, segundo a documentação de introdução ao TorchTPU:
- Strict (padrão) envia uma operação ATen por vez para a TPU, de forma assíncrona, como o PyTorch em uma GPU.
- Debug (
TORCH_TPU_LAUNCH_BLOCKING=1) executa cada operação de forma síncrona com verificação de limites, a versão TPU doCUDA_LAUNCH_BLOCKING. - DeferAndFuse (
TORCH_TPU_DEFER_AND_FUSE=1) segura as operações até que algo como.cpu()ou.item()precise de um valor, e então as funde e compila juntas. O Google diz que pode ser 50% ou mais rápido que o Strict e usa menos memória HBM.
Os três compartilham um cache de compilação com três camadas: por processo, compartilhado entre processos em um host e uma camada persistente opcional no Cloud Storage para que uma frota não recompile os mesmos grafos a cada reinício.
torch.compile(model, backend="tpu") é o caminho de produção. A troca é o rigor: o TorchTPU atualmente define dynamic=False para você, porque o XLA quer formatos estáticos. O Google está construindo o "bounded dynamism", em que você informa um tamanho máximo e o grafo compila uma vez. Em testes iniciais, ele obteve resultados corretos em 834 de 839 LLMs causais, mas a tabela de recursos ainda o lista como experimental.
Há também uma diferença de precisão que vale conhecer antes de comparar curvas de perda. As unidades de matriz da TPU multiplicam em bfloat16 e acumulam em FP32, então o TorchTPU usa por padrão a precisão "medium", enquanto o PyTorch em CUDA usa FP32 completo por padrão. Você pode pedir "high" ou "highest", mas elas custam cerca de 3x e 6x o cálculo matricial.
Para kernels customizados, o TorchTPU suporta Pallas (a linguagem de kernels do Google, vinda do JAX) e a biblioteca de kernels Tokamax como prontos para produção, além do Helion, a DSL de kernels portátil do PyTorch, como experimental. Kernels CUDA customizados não são aproveitados.
Para ver quanto cada camada importa, o blog do PyTorch leva um modelo de imagens FLUX pela pilha passo a passo:
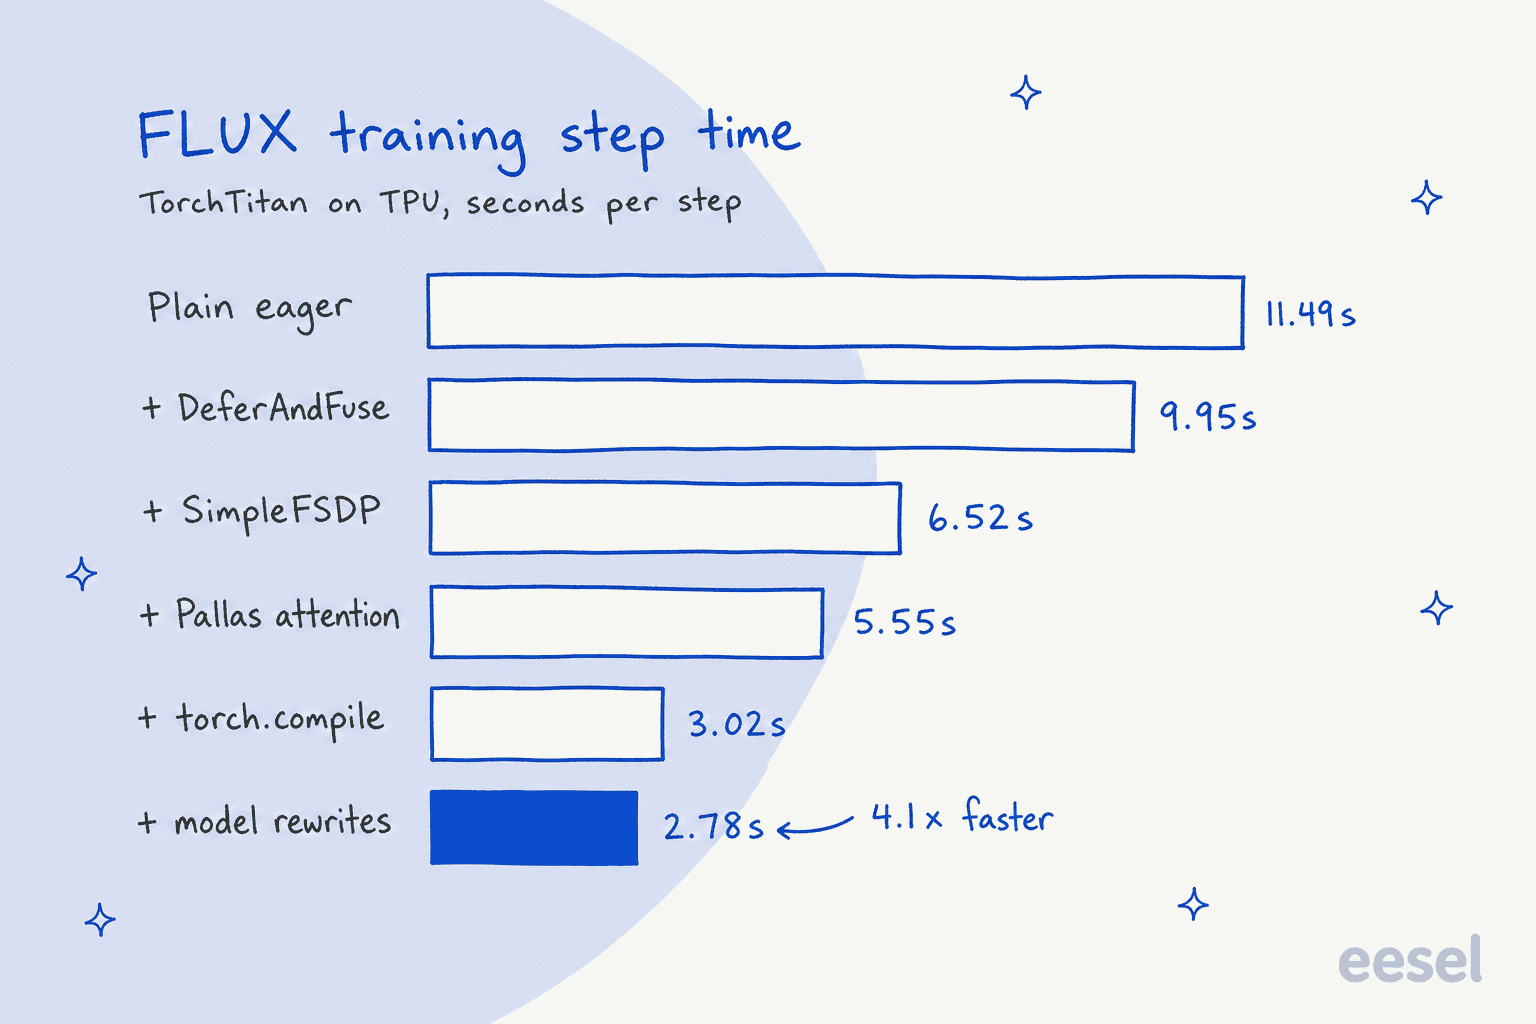
Para mim, esse gráfico é a versão honesta da promessa de "uma linha". A única linha leva ao passo de 11.49 segundos. O passo de 2.78 segundos exige mais cinco rodadas de trabalho, e o torch.compile sozinho é o maior salto individual.
Como fica a mudança no código
O guia de primeiros passos roda em uma VM de TPU (uma v6e é a mais fácil), com Python 3.11 ou superior:
pip install torch_tpu==0.2.0 --extra-index-url https://download.pytorch.org/whl/cpu
Mantenha o índice extra: sem ele, o pip baixa a versão do PyTorch com CUDA, que é muito maior e inútil em uma TPU. Depois, a troca de dispositivo:
import torch
device = torch.device("tpu")          # was "cuda"
model = MyModel().to(device)
compiled = torch.compile(model, backend="tpu")   # optional, for speed
Para jobs distribuídos há uma segunda edição. dist.init_process_group(backend="nccl") vira backend="tpu_dist", e o TorchTPU precisa de duas configurações específicas de TPU (a topologia do slice e os endereços dos chips) que o torchrun comum não conhece. Um comando as imprime para você:
eval $(python -m torch.tpu.distributed | sed 's/^/export /')
torchrun --nproc_per_node=8 train.py
Para modelos do Hugging Face é ainda mais curto. Segundo a publicação de lançamento do Hugging Face, AutoModelForCausalLM.from_pretrained(model_id, device_map="tpu") carrega os pesos direto na TPU, e um pipeline do Diffusers só precisa de pipe.to("tpu").
Isso significa que a maioria dos modelos abertos que já cobri, como Qwen, Gemma 4 ou DeepSeek V4 Flash, está a um device_map de uma TPU.
O Google também lançou em prévia uma suíte de agentes para TPU: skills que se instalam em agentes de programação (Claude Code e Antigravity hoje, Codex e Cursor "coming soon") para cuidar de integração, profiling e ajuste de inferência. É um sinal de para onde esse tipo de migração caminha. Uma troca mecânica como essa é exatamente o que o Claude Code ou o OpenAI Codex fazem bem, desde que você leia os logs de compilação por conta própria.
Quanto custa o TorchTPU?
A biblioteca é gratuita. O TorchTPU usa Apache 2.0 e é instalado pelo PyPI. O que você paga é o tempo de TPU, que o Google precifica por hora de chip na sua página de preços do Cloud TPU. As cobranças correm enquanto um nó de TPU está no estado READY, então um nó ocioso que você esqueceu continua cobrando.
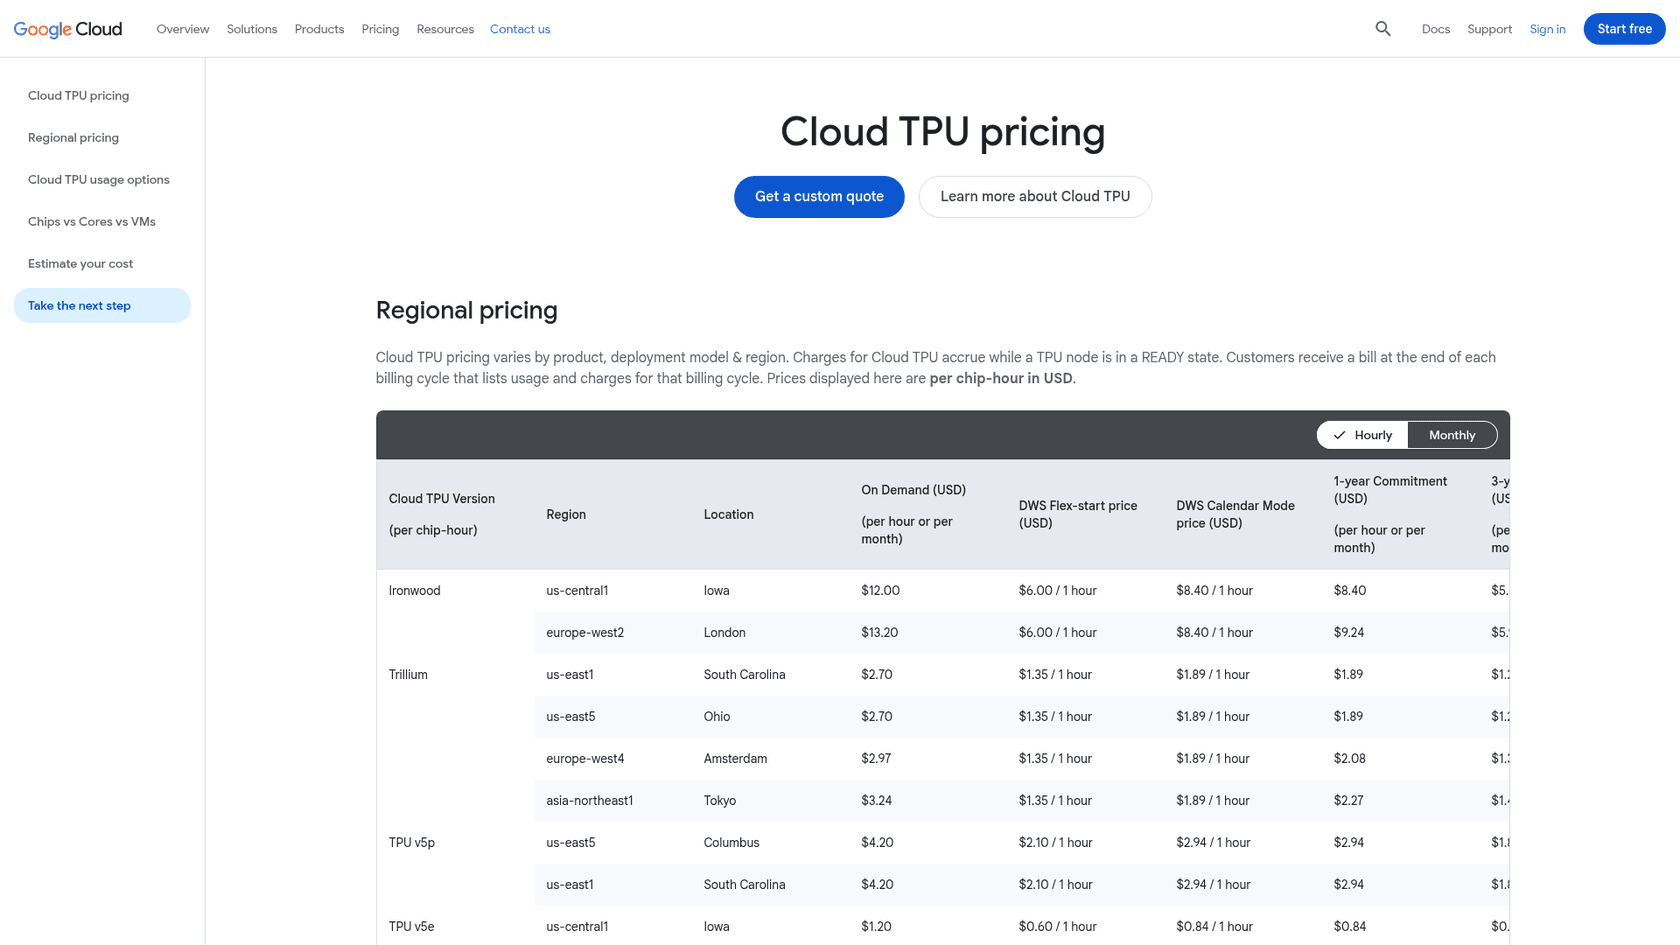
Estas são as taxas dos EUA para as quatro gerações que o TorchTPU suporta, conferidas em 28 de outubro de 2026:
| TPU | Região | Sob demanda | DWS Flex-start | Compromisso de 1 ano | Compromisso de 3 anos |
|---|---|---|---|---|---|
| Ironwood (v7) | us-central1 | $12.00 | $6.00 | $8.40 | $5.40 |
| Trillium (v6e) | us-east1 | $2.70 | $1.35 | $1.89 | $1.22 |
| TPU v5p | us-east5 | $4.20 | $2.10 | $2.94 | $1.89 |
| TPU v5e | us-central1 | $1.20 | $0.60 | $0.84 | $0.54 |
O Flex-start (parte do Dynamic Workload Scheduler do Google) custa metade da tarifa sob demanda em todas as gerações, em troca de esperar até que haja capacidade livre. O console do Google Cloud cobra em horas de VM, não em horas de chip, então uma VM com vários chips mostra um número maior que o da tabela. Regiões da Europa e da Ásia custam mais: o Ironwood custa $13.20 sob demanda em Londres.
Ainda assim, uma hora de chip não é uma unidade de trabalho, e essa é a parte que as pessoas pulam. Um chip Ironwood expõe dois dispositivos PyTorch, e uma GPU, um chip Trainium2 e uma TPU concluem cada um uma quantidade diferente de trabalho por hora. O único número de terceiros que o Google cita vem do benchmark InferenceX da SemiAnalysis, em que a TPU v7 com vLLM-TorchTPU serviu o Qwen 3.5 a 2.01 centavos por milhão de tokens no teste 8K/1K. Veja isso como um motivo para fazer benchmark do seu próprio modelo, não como o seu preço.
Para comparar preços por chip entre os backends nativos de PyTorch que agora existem, escolha um acelerador:
Escolha um chip para comparar preços de tabela e backends. Os preços vêm das páginas de preços do Google Cloud TPU e do AWS Capacity Blocks; uma hora de chip rende uma quantidade diferente de trabalho em cada um.
Para o lado das GPUs na comparação, meus detalhamentos de preços da CoreWeave e preços da Lambda cobrem as neoclouds, e o guia de preços da AWS cobre a casa do Trainium.
Benchmarks e cobertura de modelos
O Google publicou mais números com este lançamento do que a AWS com o TorchNeuron, e a maioria deles é realmente útil. Comecemos pela cobertura, porque em uma versão 0.2.0 "meu modelo roda?" importa mais que velocidade. Segundo o blog do PyTorch, o Google testa continuamente cerca de 5,000 modelos populares do Hugging Face nos modos eager e compilado:
| Teste | Resultado |
|---|---|
| Modelos testados de ponta a ponta | 4,917 em mais de 500 famílias de arquitetura |
| Rodam sem travar | 98% (4,821 de 4,917) |
| Números batem com a GPU | 97% (638 de 657 modelos representativos) |
| Bounded dynamism, numérica correta | 99% (834 de 839 LLMs causais) |
A linha de paridade numérica é a que eu olharia primeiro. Na eesel, aprendi do jeito difícil que "roda" e "dá a resposta certa" são testes diferentes: um agente de suporte pode brilhar em uma demo e ainda assim dar respostas erradas com confiança em tickets reais, e é por isso que cada implantação é simulada primeiro com os tickets históricos de um cliente. O Google comparar a saída com uma linha de base de GPU, e não só verificar travamentos, é a versão de compilador do mesmo hábito.
Em velocidade, três resultados se destacam:
- PyTorch puro, sem kernels customizados. Um Muse Glimmer 30B escrito em PyTorch puro com módulos padrão alcançou 59% de MFU no prefill em um chip TPU v7 e 38% de MFU no treinamento em quatro. Uma versão escrita para GPUs pela equipe do TorchTitan, migrada minimamente, chegou a 36%.
- Perto do JAX. O Qwen3 MoE 235B no TorchTitan rodou a 1,828 tokens por segundo em 64 chips TPU v7, contra 1,937 para o mesmo modelo em JAX no MaxText. Isso é cerca de 94% do framework próprio do Google.
- Escala. O mesmo modelo escalou de 1,024 para 8,192 chips Ironwood com a MFU variando apenas de 28.8% para 27.1%. O blog do Google Cloud também cita até 52% de MFU no Qwen 3 8B.
Os modelos de recomendação tiveram um resultado próprio: um DLRM v2 em 32 chips TPU v7x igualou a versão JAX ajustada do Google com tempo de passo de 18.3 ms, usando os SparseCores da TPU para as consultas de embeddings. Todos esses são números do próprio Google em hardware do próprio Google, então eu os trataria como um limite superior até que apareçam resultados independentes.
O que o TorchTPU ainda não faz
O Google é direto sobre as lacunas. A tabela de recursos divide tudo em "Validated" e "Experimental", e o blog do PyTorch lista as arestas em detalhe.
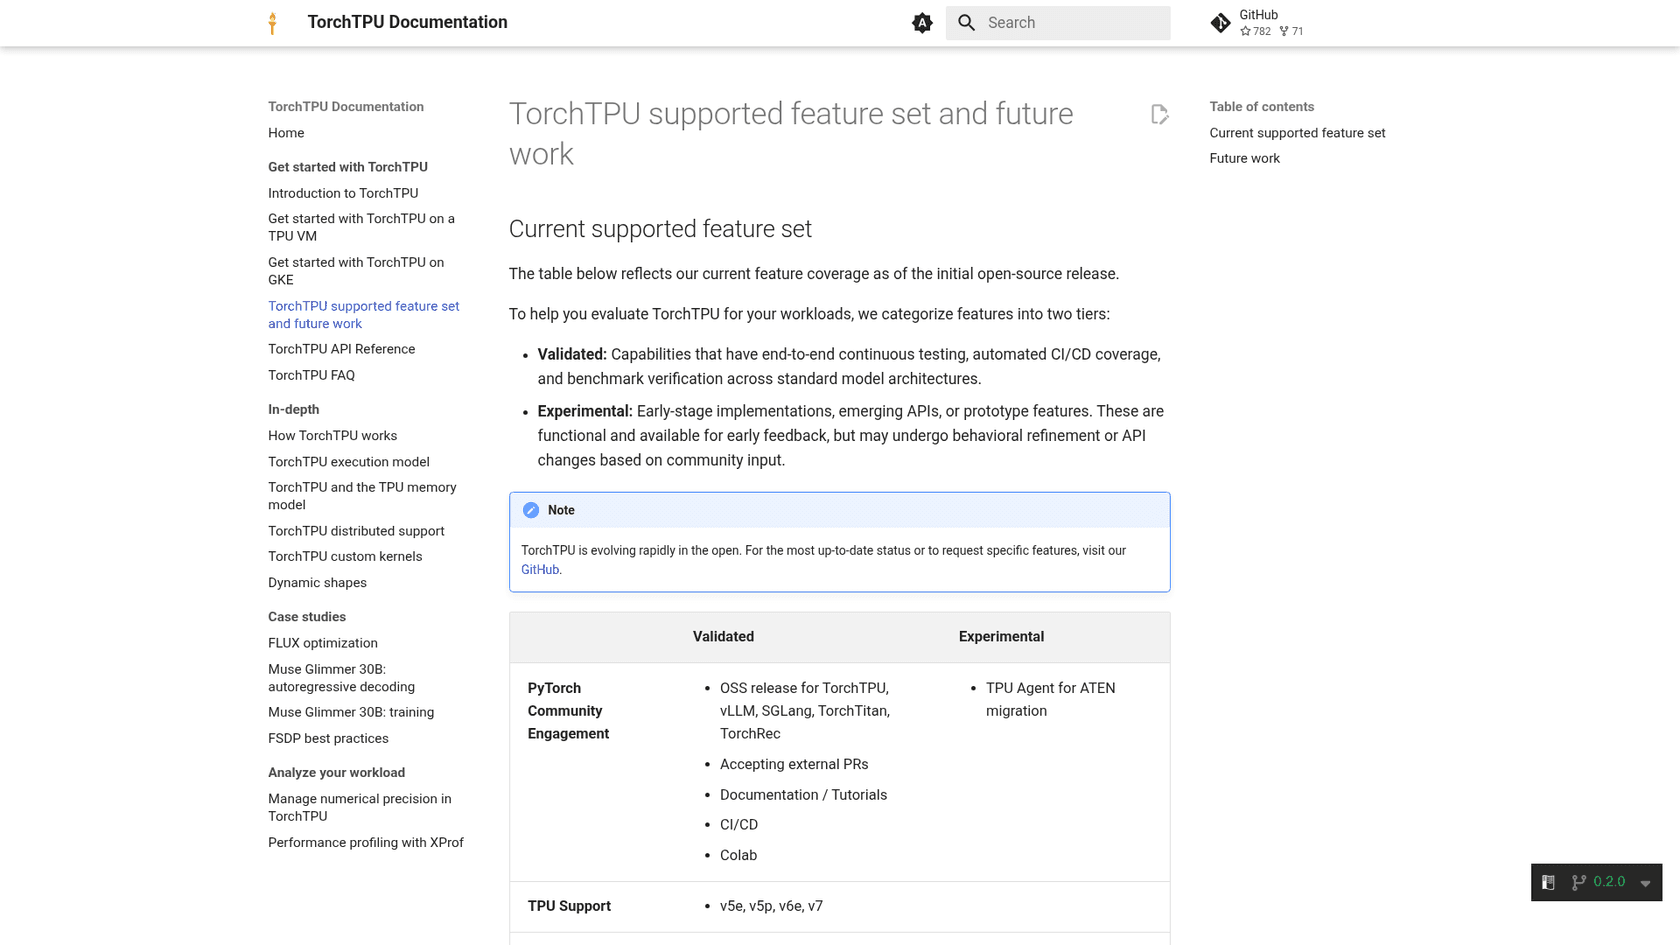
- Formatos dinâmicos sob compile. O
torch.compileroda hoje comdynamic=False. Tamanhos de lote ou comprimentos de sequência variáveis significam padding, bucketing ou recompilações até que o bounded dynamism chegue. - FlexAttention. Ainda não suportado; o Google o trocou por
F.scaled_dot_product_attentionao migrar um modelo de GPU. - Casos de borda distribuídos. FSDPv2 e código que difere por rank (MPMD) funcionam, mas estão marcados como "low perf". Os "skinny collectives" padrão podem custar 30-40% de ponta a ponta; você recupera isso com um decorador
@spmd_safeou com o SimpleFSDP. - Um processo por dispositivo TPU. Uma TPU só pode ser aberta por um processo, então configurações de RL que colocam um treinador e um amostrador nos mesmos chips não funcionam de saída.
- Modelos moldados para GPU. As unidades de matriz da TPU preferem dimensões de 128 ou 256. Modelos que fixam as cabeças de atenção em 64, o que é comum, rodam, mas deixam velocidade na mesa.
- Famílias de modelos ainda em ajuste. GLM, Kimi, DeepSeek, GPT OSS, Mamba e LSTM/GRU estão listados como experimentais. O pré-treinamento em escala total é "future exploration"; inferência e ajuste fino são os trabalhos prontos para produção.
O limite maior não está no código. TPUs são chips do Google Cloud (mais acordos locais para clientes muito grandes), e o tópico de lançamento no Hacker News, com 379 pontos e 93 comentários, voltava sempre a isso:
"TPUs are unobtanium so while I appreciate Google's effort here I also recognize that it is not something that will be useful to me."
Outro comentarista, de uma equipe que avaliou TPUs locais, resumiu a visão do comprador em uma linha:
"We've evaluated them but decided to stick with Nvidia, at least for one more generation."
E, sobre a prévia de abril, uma resposta formulou a promessa com mais precisão que o marketing: "just change one line and it works" nunca foi a mesma promessa que "just change one line and you will get peak performance on the TPU" (xrikcus, Hacker News). Isso bate com a documentação do próprio Google, o que é um bom sinal.
Como o TorchTPU se compara a outras formas de rodar modelos
Para uma equipe que treina ou serve seus próprios modelos PyTorch, as opções agora são estas:
| Opção | O que você gerencia | Mudanças de código | Melhor para |
|---|---|---|---|
| TorchTPU em Cloud TPUs | VMs de TPU ou GKE, cache de compilação, formatos | "tpu", tpu_dist, formatos estáticos para compile | Equipes de Google Cloud com jobs grandes e constantes |
| TorchNeuron no AWS Trainium | Instâncias, cache de compilação, formatos | "neuron", formatos estáticos para compile | Equipes comprometidas com a AWS |
| GPUs NVIDIA (CoreWeave, hyperscalers) | Instâncias ou clusters | Nenhuma para código CUDA | Kernels CUDA customizados, início mais rápido |
| GPUs serverless (Modal, Baseten) | Seu código de modelo | Pequenos wrappers | Inferência em picos sem planejamento de capacidade |
| APIs de modelos hospedados (Groq, Fireworks AI) | Nada | Só chamadas de API | Modelos abertos sem tocar em hardware |
As duas primeiras linhas costumavam dizer "reescreva em JAX" e "reescreva sua pilha de treinamento". Agora se parecem muito com as linhas de GPU, que é o objetivo dos dois lançamentos. Na hora de escolher entre elas, o que pesa é principalmente qual nuvem você já paga, e também qual chip está livre quando você precisa.
Se o seu objetivo final é um agente no Google Cloud e não a sua própria pilha de serving, o Agent Development Kit do Google e a API do Gemini ficam uma camada acima de tudo isso, e o próprio Gemini é treinado e servido em TPUs.
Para quem é o TorchTPU
O TorchTPU é para equipes que já escrevem PyTorch, conseguem capacidade de TPU no Google Cloud e gastam em aceleradores o bastante para que um piloto se pague. Equipes de pesquisa aproveitam mais o modo eager e a configuração Debug, já que as TPUs finalmente se comportam como qualquer outro dispositivo em um depurador. Equipes de inferência aproveitam mais o vLLM-TorchTPU e o SGLang-TorchTPU, que mantêm os mesmos servidores e APIs enquanto trocam o hardware por baixo.
Não é para você se o seu código depende de kernels CUDA customizados, se você precisa hoje de formatos dinâmicos no modo compilado ou se não consegue cota de TPU. E também não é para você se nunca mexe em pesos de modelos. A maioria das empresas com que converso na eesel está nesse último grupo: querem que a IA faça um trabalho, e em qual chip ela roda é decisão de outra pessoa.
Onde a eesel se encaixa: isto é infraestrutura, a eesel é o funcionário
O TorchTPU torna a camada de hardware mais barata de testar e mais fácil de trocar. Isso é bom para todos que constroem modelos e, com o tempo, reduz o custo de operar produtos de IA. Mas ele não responde um ticket nem escreve um post de blog por você. Esses são trabalhos, e trabalhos precisam de contexto: sua central de ajuda, seus tickets passados, suas regras de reembolso.
É nessa camada que a eesel trabalha. A eesel é uma plataforma de colegas de IA: você contrata colegas prontos para trabalhar para tarefas específicas, hoje um colega de IA para helpdesk e um redator de blog com IA. O colega de helpdesk entra na sua fila existente, aprende com sua central de ajuda e tickets passados e é testado nas suas conversas históricas antes de responder a um cliente real.
A SamCart mostra como isso fica na prática. Ela usa a eesel no Freshdesk e no chat do site, com um agente separado por canal respondendo a partir de cerca de 280 artigos da central de ajuda. O agente do Freshdesk envia apenas a primeira resposta até que uma pessoa assuma o ticket, e um plano de 8,000 interações por mês cobre isso.
A OroSoft, que faz software de negociação para negócios de barras de ouro, usa de forma cuidadosa: a equipe de suporte menciona a eesel em um ticket do Freshdesk e recebe um rascunho baseado em cerca de 6,100 tickets resolvidos, com a fonte indicada. Quando nada sustenta uma resposta, ela deixa uma nota pedindo uma pessoa em vez de chutar. É a mesma disciplina das verificações de paridade numérica do Google, aplicada a respostas a clientes.
Se você é do tipo de leitor que acabou de instalar um backend a partir de um índice pip fixado, provavelmente vai querer configurar isto também pelo terminal. A CLI da eesel opera o mesmo colega e espaço de trabalho que o painel. npx @eesel/cli init chat-bubble --site https://your-site.com cria um agente, adiciona um balão de chat ao site e começa a ler seu site sem conta, e eesel login mantém o espaço de trabalho depois. A partir daí, eesel integrations connect freshdesk conecta o helpdesk, eesel files upload adiciona conhecimento, eesel chat conversa com o agente e eesel approvals permite aprovar ações retidas.
Esse desenho é o motivo de funcionar com agentes de programação, do mesmo jeito que a suíte de agentes para TPU do Google se conecta a eles. Um agente como o Claude Code ou o Cursor pode executar a configuração, ler os resultados e corrigir o que falhou. Todo espaço de trabalho também é um servidor MCP, então o mesmo agente pode consultar a eesel diretamente; veja minha referência da CLI do Claude Code se você estiver configurando isso.

O log acima é o que o eesel activity imprime no terminal, do mais recente para o mais antigo. O preço é dado em unidades que as equipes de suporte já contam: na página de preços, um ticket ou um chat é 1 crédito, os planos começam em $299 por mês por 500 créditos, e o plano gratuito dá 100 créditos para testar tudo.
Experimente a eesel
O TorchTPU permite escolher o chip mais barato para os seus próprios modelos. A eesel permite pular essa decisão no trabalho de suporte: um colega de helpdesk que se conecta ao Freshdesk, Zendesk ou Gorgias, aprende com seus tickets passados e se prova em conversas históricas antes de tocar em uma ao vivo. Para equipes SaaS com perguntas técnicas, a API de helpdesk com IA e a CLI permitem automatizar toda a configuração por script. Experimente a eesel de graça, ou comece pelo terminal com npx @eesel/cli.
Perguntas frequentes
O que é o TorchTPU?
tpu ao PyTorch padrão, de modo que o modo eager, o torch.compile e o torch.distributed rodam em TPU v5e, v5p, Trillium e Ironwood. Foi aberto ao público em 20 de outubro de 2026. É a camada do chip; se você quer uma IA que faça um trabalho, um colega de IA fica na outra ponta da pilha.O TorchTPU é gratuito?
torch_tpu. Você paga pelo tempo de TPU em que ele roda, de $1.20 por hora de chip para TPU v5e a $12.00 para Ironwood sob demanda em us-central1. Meu guia de preços do Gemini cobre a parte de modelos da conta do Google, caso você não queira operar chips.O TorchTPU substitui o PyTorch/XLA?
torch.compile usam. A AWS fez o mesmo movimento para o Trainium com o TorchNeuron.O TorchTPU realmente exige mudar só uma linha de código?
"cuda" por "tpu" e backend="nccl" por backend="tpu_dist". Para rodar rápido, não. A própria documentação do Google diz que formatos, sharding e operações de um modelo podem estar ajustados para GPUs, então o desempenho máximo exige trabalho de compilação, cabeças de atenção mais largas ou kernels Pallas. Agentes de programação como o Claude Code conseguem fazer boa parte dessa migração, e o Google oferece uma suíte de agentes para TPU com esse fim.Quais gerações de TPU o TorchTPU suporta?
O TorchTPU funciona com o Hugging Face Transformers?
device_map="tpu", e o Diffusers roda com pipe.to("tpu"). O Google informa que 98% dos 4,917 modelos do Hugging Face testados rodam sem travar, e o Hugging Face diz que o Optimum TPU não é mais necessário. Mais sobre a plataforma na minha visão geral do Hugging Face.Como o TorchTPU se compara ao TorchNeuron no AWS Trainium?
torch.compile para velocidade e formatos estáticos por enquanto. O TorchTPU cobre quatro gerações de TPU e converte para XLA; o TorchNeuron cobre Trainium2 e Trainium3 e converte para o compilador Neuron. Uma hora de chip Trainium2 custa $2.235 em EC2 Capacity Blocks, entre Trillium e v5p sob demanda. Veja meu detalhamento de preços da AWS para o resto dessa conta.