

Por que li este lançamento com atenção
Na eesel construo funcionalidades e agentes de IA, e um pedido não para de aparecer no nosso roteiro: ler a imagem. Nas chamadas de vendas da eesel este ano, equipas de suporte de produtos técnicos pediam sempre uma IA capaz de ler as imagens e diagramas dentro dos seus PDFs e as fotos que os clientes anexam aos tickets. Uma marca DTC de suplementos, com cerca de 7.000 tickets por mês, contou-nos que parte do seu conhecimento de produto estava em vídeos do Loom que ninguém transcreveu.
A maioria dos modelos de visão resolve isso escrevendo uma legenda para a imagem e raciocinando depois sobre a legenda. Funciona até o detalhe que importa não estar na legenda. O Glimpse é o primeiro modelo que vi construído exatamente para corrigir isso, por isso percorri a publicação de lançamento, a ficha do modelo na Together AI, os termos da plataforma e as reações do dia do lançamento. Aqui está o que se sustenta e o que precisa de uma nota de rodapé.
O que é o Elorian Glimpse?
O Glimpse é o que a Elorian chama de "a new category of visual thinking model: a system that reasons about the physical world from what it sees." Em termos simples, é um modelo de raciocínio multimodal afinado para tarefas em que a resposta está na imagem e é difícil de pôr em palavras: a que velocidade algo se move, se um plano é uma única panorâmica contínua ou dois cortes, quantos destes objetos estão realmente abertos.
A empresa por trás dele é pequena e bem apoiada. A Elorian diz ter 55 milhões de dólares em financiamento da Striker Ventures, Menlo Ventures e Altimeter, com a NVIDIA e Jeff Dean entre os outros apoiantes. O cofundador e CEO Andrew Dai passou quase 12 anos no Google Brain e na DeepMind. A Elorian diz que construiu o Glimpse "as a small team with only a few hundred GPUs, post-trained on an open weights base model."
Aqui está a ficha técnica, com as lacunas assinaladas:
| Item | Elorian Glimpse |
|---|---|
| Lançamento | 16 de outubro de 2026 (a Together indica 15 de outubro) |
| Estado | Pré-visualização de pesquisa |
| Entradas | Texto, imagem, vídeo |
| Saída | Texto |
| Modelo base | Um modelo de pesos abertos sem nome, treinado posteriormente pela Elorian |
| Pesos | Não divulgados |
| Preço (API da Elorian) | $0.60 / 1M de entrada, $3.00 / 1M de saída, sem cache |
| Janela de contexto, limites de taxa | Não publicados |
| Acesso | Chat gratuito, API da Elorian, implementação dedicada na Together AI |
| Benchmarks independentes | Nenhum ainda (não está na Artificial Analysis) |
A página da Together AI também o lista em Chat, Reasoning, Vision e Video, e mostra Dedicated como único tipo de implementação. Isso importa para o orçamento, e voltarei a isso.
Como funciona o "pensamento visual"?
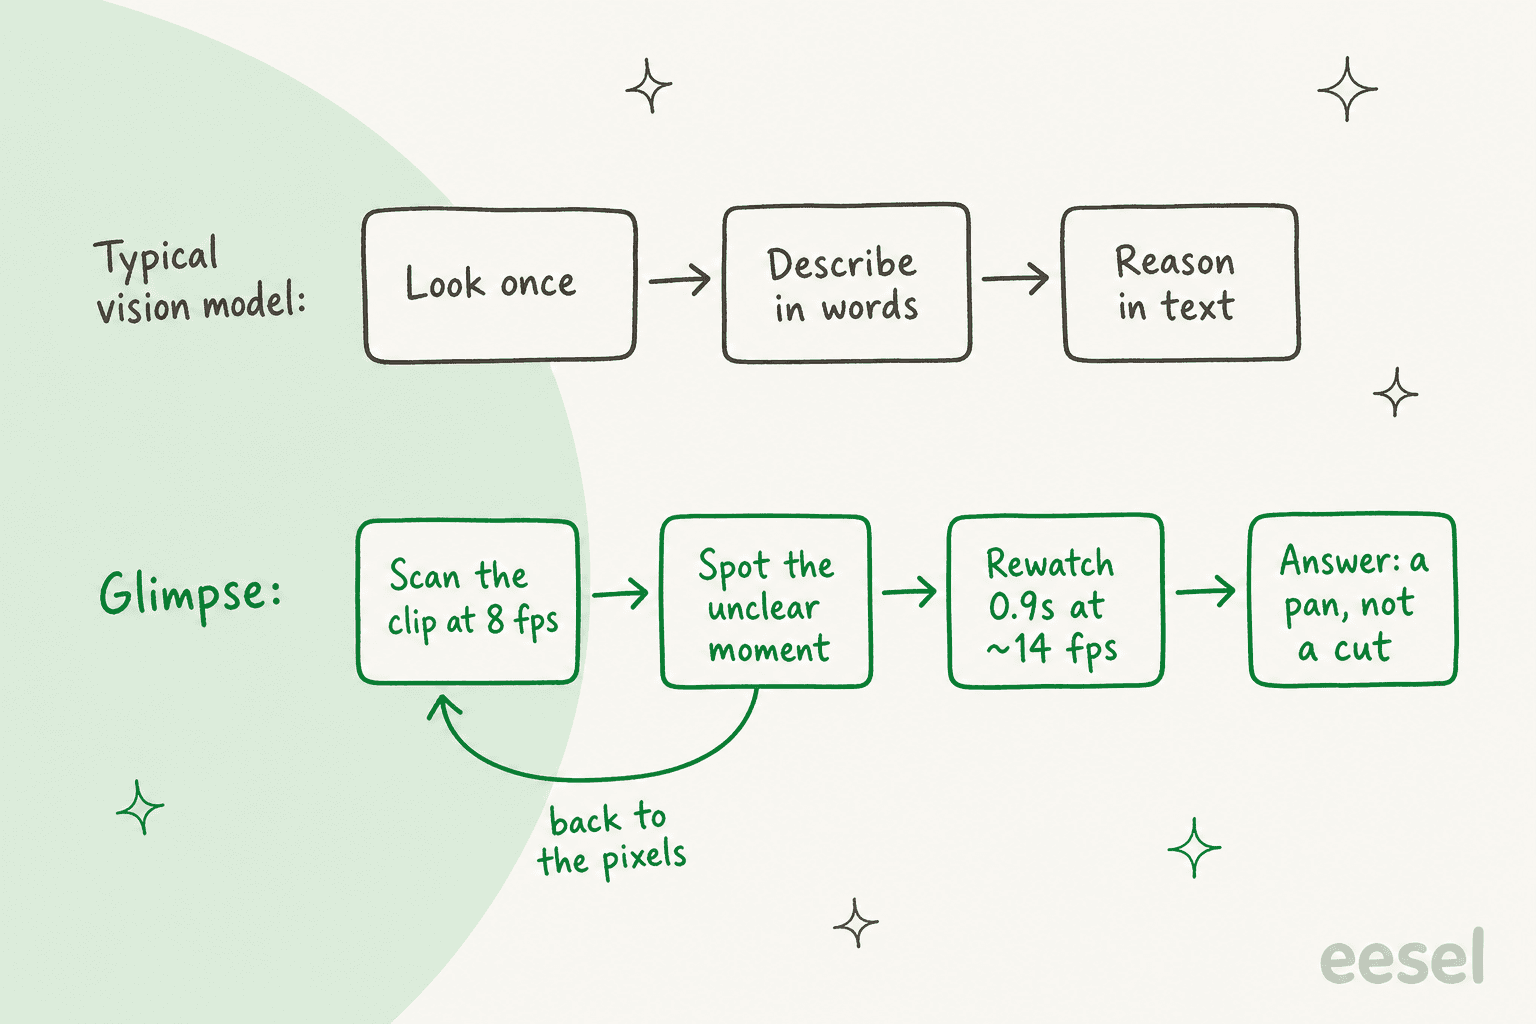
O argumento da Elorian é que os modelos de visão atuais raciocinam em dois passos: primeiro traduzem a imagem para linguagem, depois raciocinam em texto. "No matter how advanced the subsequent reasoning, this chain is fragile", diz a sua página inicial, porque muito detalhe visual não pode ser descrito com precisão nem brevidade.
O Glimpse traz a imagem para dentro do próprio raciocínio. Ele "can reason in visual space, revisiting and refining internal visual representations as thinking unfolds." Na prática, a publicação de lançamento mostra três movimentos que o modelo faz a meio da resposta: dar zoom numa região, rever um intervalo curto com uma taxa de fotogramas mais densa e seguir uma característica ao longo do tempo.
O melhor exemplo é um clipe de dois pássaros a saírem de uma maçaneta enquanto a câmara gira. Para perceber se o plano corta ou faz uma panorâmica, o Glimpse primeiro mapeia os 6,13 segundos inteiros a 8 fotogramas por segundo, depois revê a janela de 0,9 segundo que decide a resposta a cerca de 14 fotogramas por segundo. O olhar extra vai só para onde a resposta é incerta, que é toda a ideia.
Há mais duas escolhas de design que vale a pena conhecer:
- O uso de ferramentas vem treinado. Segundo a ficha do modelo da Together, o Glimpse é "trained end to end to use multimodal tools that write code, transform images, and watch videos." É semelhante no espírito à visão agêntica do Gemini, em que o modelo recorta e executa código sobre imagens.
- Pode dividir o trabalho entre subagentes. O Glimpse "can spawn and coordinate subagents that exchange text, visual artifacts, and internal representations." Passar artefactos visuais entre agentes, e não só resumos de texto, é a parte incomum. Se já usou subagentes no Claude Code, imagine o mesmo padrão com imagens na passagem de testemunho.
A interface de chat torna tudo isto visível. Enquanto conversa com ele, a plataforma mostra o que a Elorian chama de "visual scratch space": os zooms, as revisões e as características seguidas, em direto.
Onde fica preciso: contar
Contar parece trivial até acrescentar objetos parecidos. O exemplo da Elorian pergunta "How many open pliers are there?" sobre uma foto que também contém alicates fechados e tesouras. A resposta certa, segundo a referência revista da Elorian, é quatro. Alicates fechados são a ferramenta certa no estado errado, e as tesouras têm dois cabos e uma dobradiça, mas são outra ferramenta.
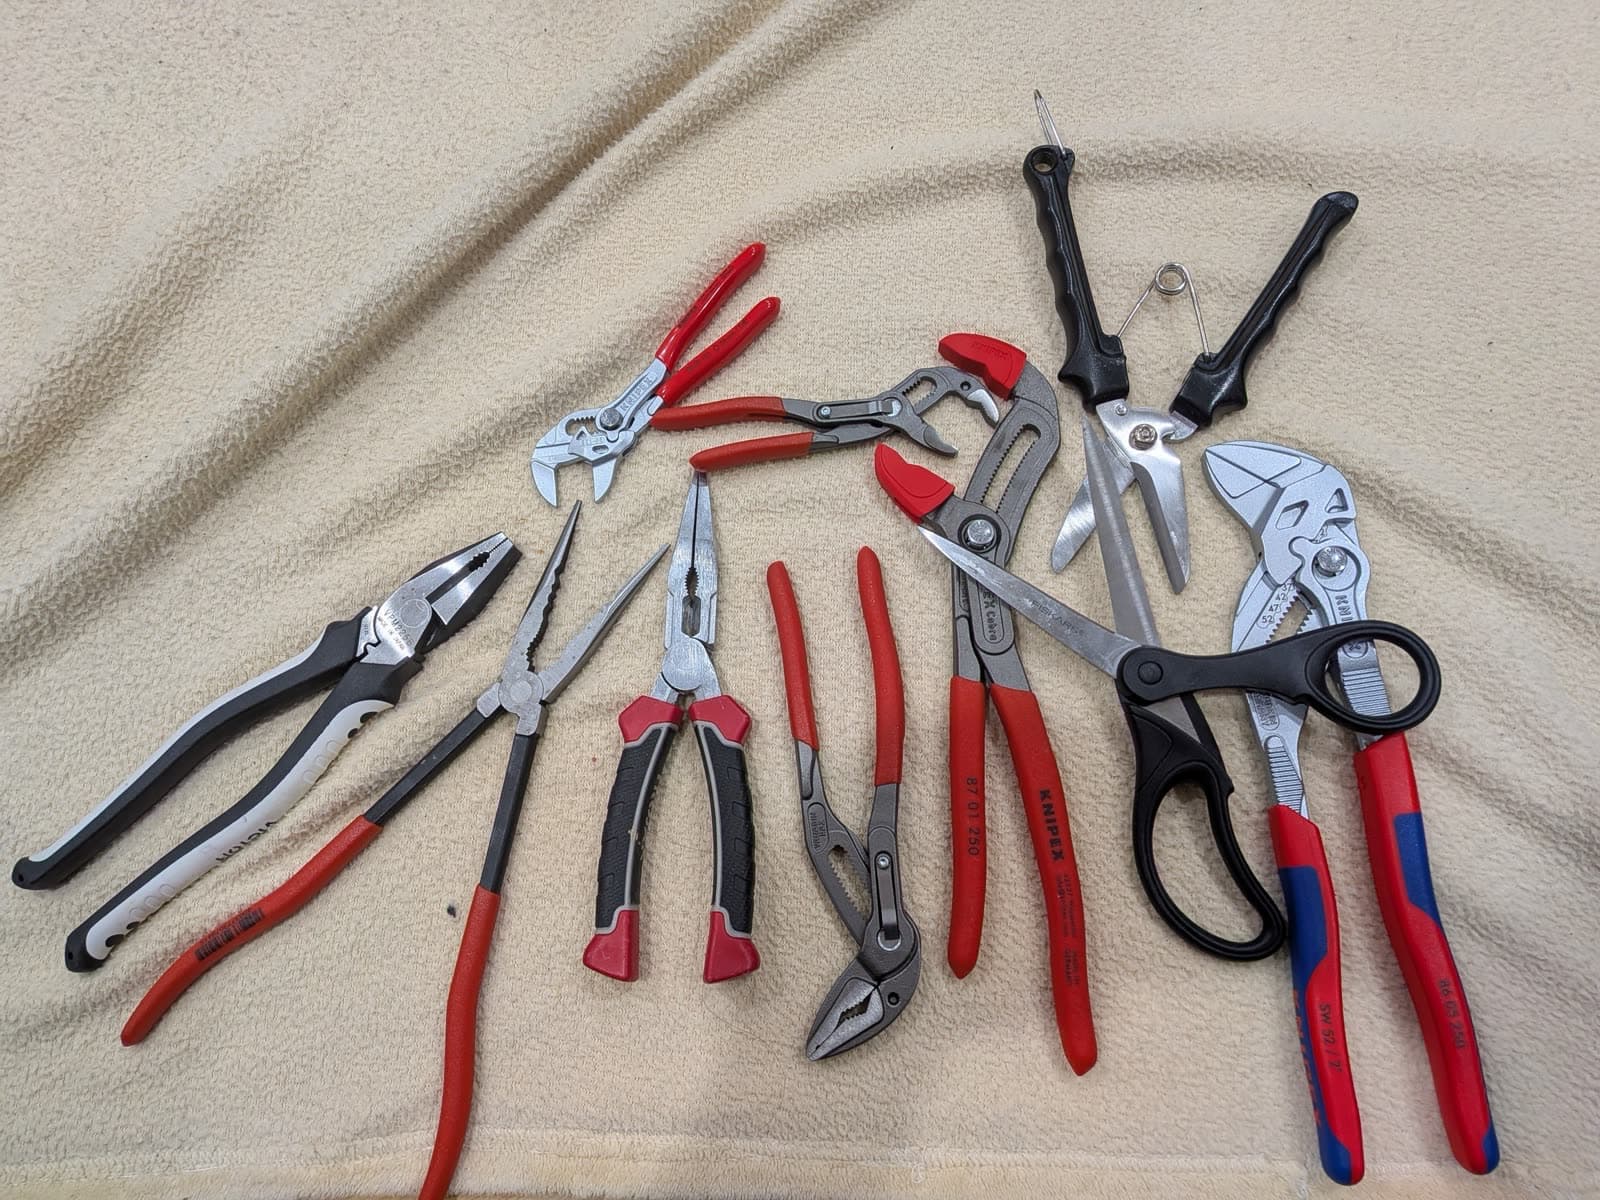
Uma nota justa: a Elorian classifica este exemplo como uma resposta de referência revista, "not a recorded model trace." Os registos gravados na publicação são os clipes do comboio e dos pássaros, as imagens do robô e a contagem na obra. Essa distinção passa facilmente despercebida e vale a pena lembrá-la ao partilhar as demos.
Quão bom é o Glimpse, de facto?
Todos os números abaixo vêm da Elorian, executados com esforço máximo de raciocínio e com o conjunto de ferramentas nativo de cada modelo. Ninguém independente o testou ainda: não há página da Artificial Analysis para o Glimpse a 19 de outubro. Com essa ressalva, aqui está a tabela do lançamento.
| Teste | O que mede | Glimpse | GPT-6 Astra | GPT-6.1 Sol | Opus 5.5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| WGO Bench | Eventos de manipulação robótica | 42.70 | 39.42 | 38.91 | 12.34 | 33.99 |
| ERQA | Raciocínio espacial incorporado | 83.75 | 83.75 | 82.45 | 82.20 | 81.20 |
| BabyVision | Raciocínio visual detalhado | 95.36 | 97.68 | 97.16 | n/a | 83.25 |
| HSS | Compreensão de cenas, imagem + vídeo | 46.36 | 53.6 | 46.6 | 49.81 | 41.6 |
| CharXiv-R | Raciocínio sobre gráficos científicos | 92.90 | 92.10 | 92.60 | 93.40 | 91.80 |
| UGC-VideoCap | Legendas de vídeos curtos | 82.66 | 80.32 | 80.41 | 76.35 | 78.33 |
| DREAM-1K | Legendas densas de vídeo | 76.04 | 79.05 | 77.93 | 72.05 | 70.00 |
| TOMATO | Raciocínio temporal detalhado | 93.60 | 96.02 | 89.02 | 72.44 | 83.02 |
| Video-MME v2 | Perguntas sobre vídeo com legendas | 56.68 | 64.06 | 65.27 | n/a | 59.58 |
| E.T. Bench | Compreensão de eventos | 63.55 | n/a | 59.79 | n/a | 63.45 |
| FSC-147 | Contagem de vocabulário aberto | 83.36 | 82.02 | 82.69 | 73.78 | 67.06 |
| CountQA | Contagem em imagens de produto | 82.66 | 86.42 | 86.42 | 82.20 | 81.09 |
O negrito marca a melhor pontuação de cada linha. Lendo-a contra o GPT-6 Astra, surge um padrão:
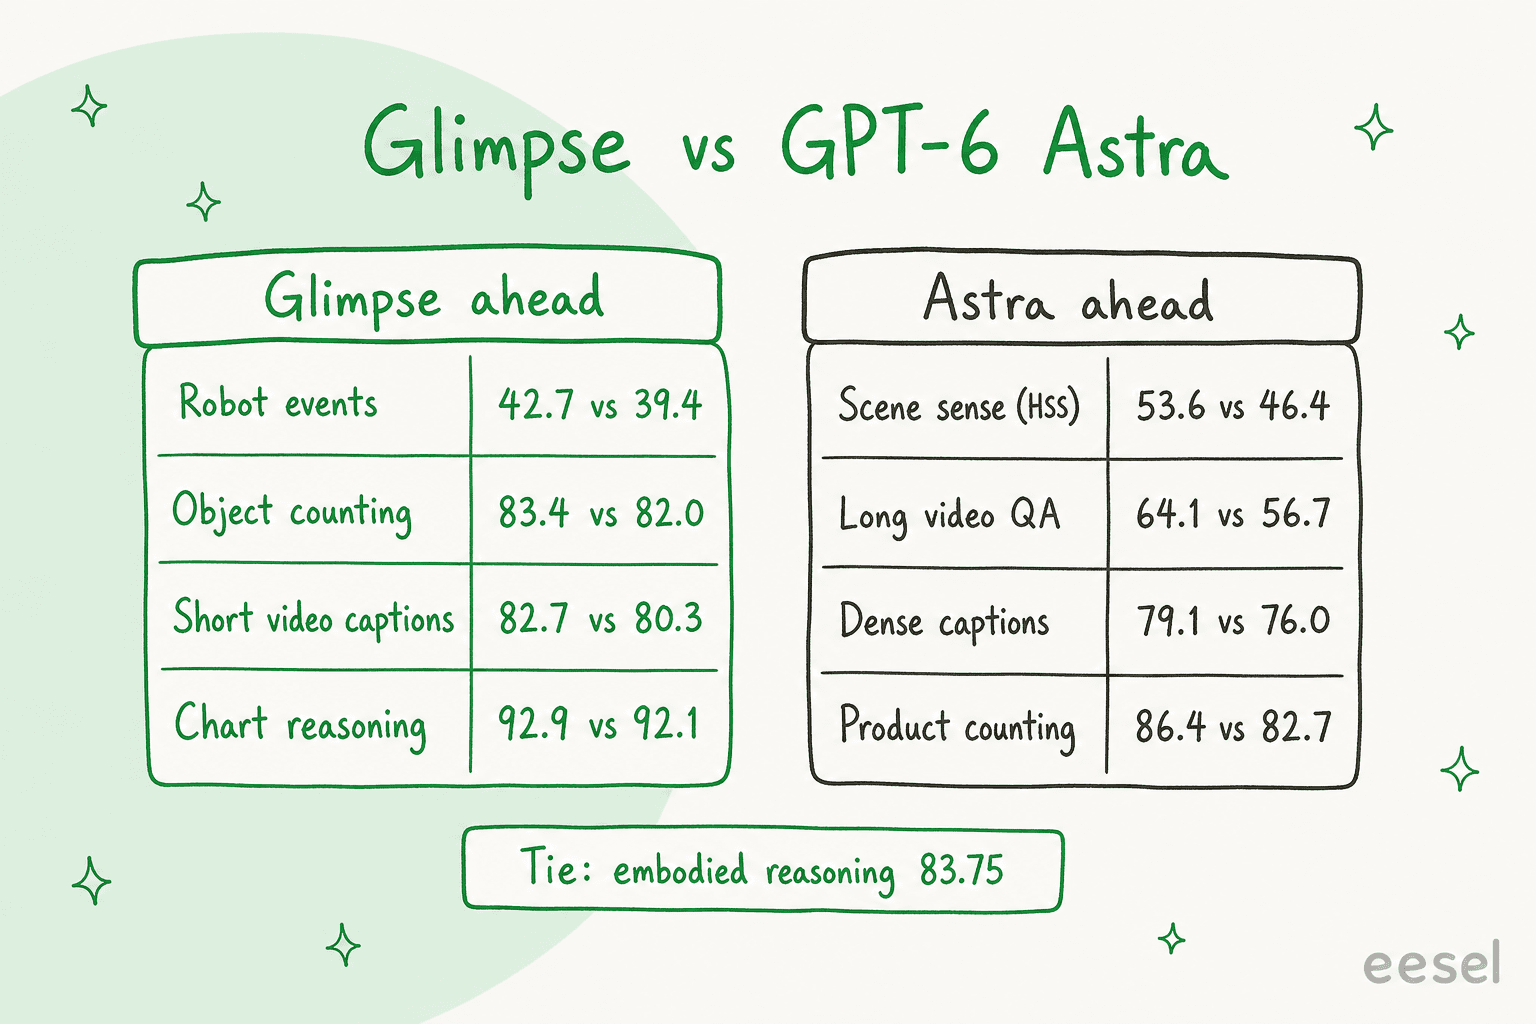
As vitórias do Glimpse são pequenas (0,8 ponto em raciocínio sobre gráficos, 1,3 em contagem) e as derrotas maiores (7,2 pontos no HSS, 7,4 no Video-MME v2). Por isso, a manchete honesta não é "supera o Astra". É perto do Astra na maioria dos testes visuais por cerca de um dezesseis avos do preço. Continua a ser muito importante, e é assim que a própria Elorian o apresenta: "frontier-level performance at the level of (and sometimes exceeding)" o Astra e o Claude Opus 5.5.
Também supera claramente a gama barata. Contra o Gemini 3.8 Flash, o seu rival mais próximo em preço, o Glimpse ganha 11 das 12 linhas, e no WGO Bench obtém 42.70 contra 33.99.
Uma palavra sobre o benchmark HSS
HSS, sigla de Humanity's Sixth Sense, é um novo teste que a Elorian criou com a Scale AI. Tem 522 perguntas abertas (288 imagens e 234 clipes de vídeo) sobre o que uma cena sugere mas não mostra: para onde sopra o vento, se um livro caberia numa prateleira, se as pessoas são visitantes ou equipa. Uma resposta só conta se cumprir todos os pontos de uma rubrica escrita por humanos.
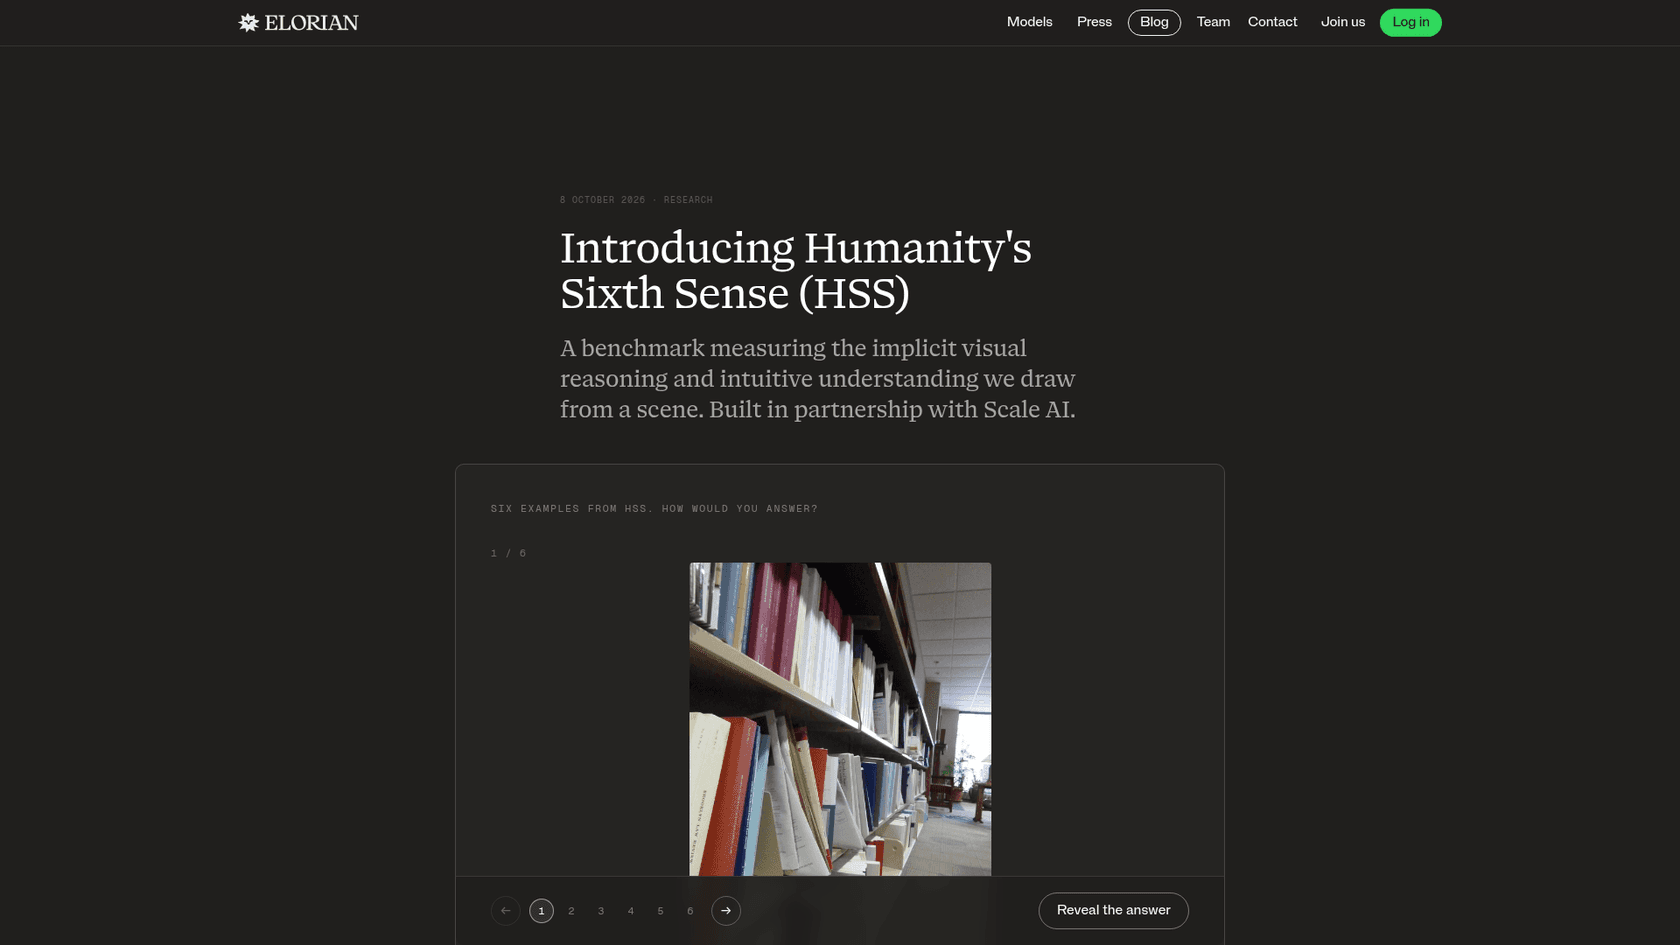
Os humanos pontuam 93,1. O melhor modelo no ranking da Elorian, o GPT 6 Astra, pontua 53,6, e o Glimpse pontua 46,36. Vale manter duas coisas em mente ao mesmo tempo: é um benchmark útil porque aponta para uma lacuna real, e é um benchmark da própria Elorian, por isso trate-o como qualquer teste criado pelo fornecedor. Mérito para a Elorian por publicar um teste que o seu próprio modelo não ganha. Ter a Scale AI como parceira dá algum peso ao conjunto de perguntas.
Quanto custa o Elorian Glimpse?
A tabela de preços é curta, porque a Elorian publicou apenas uma linha:
| Via | Entrada | Saída | Notas |
|---|---|---|---|
| API da Elorian | $0.60 / 1M de tokens | $3.00 / 1M de tokens | Sem cache; sem preços publicados de cache, lote ou níveis de contexto |
| Chat da Elorian | Grátis | Grátis | Entrada com Google ou e-mail; a Wall St Engine relatou uma lista de espera no lançamento |
| Together AI | Contactar as vendas | Contactar as vendas | Só implementação dedicada, sem tarifa serverless por token |
| Enterprise | Contactar as vendas | Contactar as vendas | Através da equipa de vendas da Elorian |
Para contexto, eis como a tabela de lançamento da Elorian alinha os preços de saída dos modelos com que se comparou:
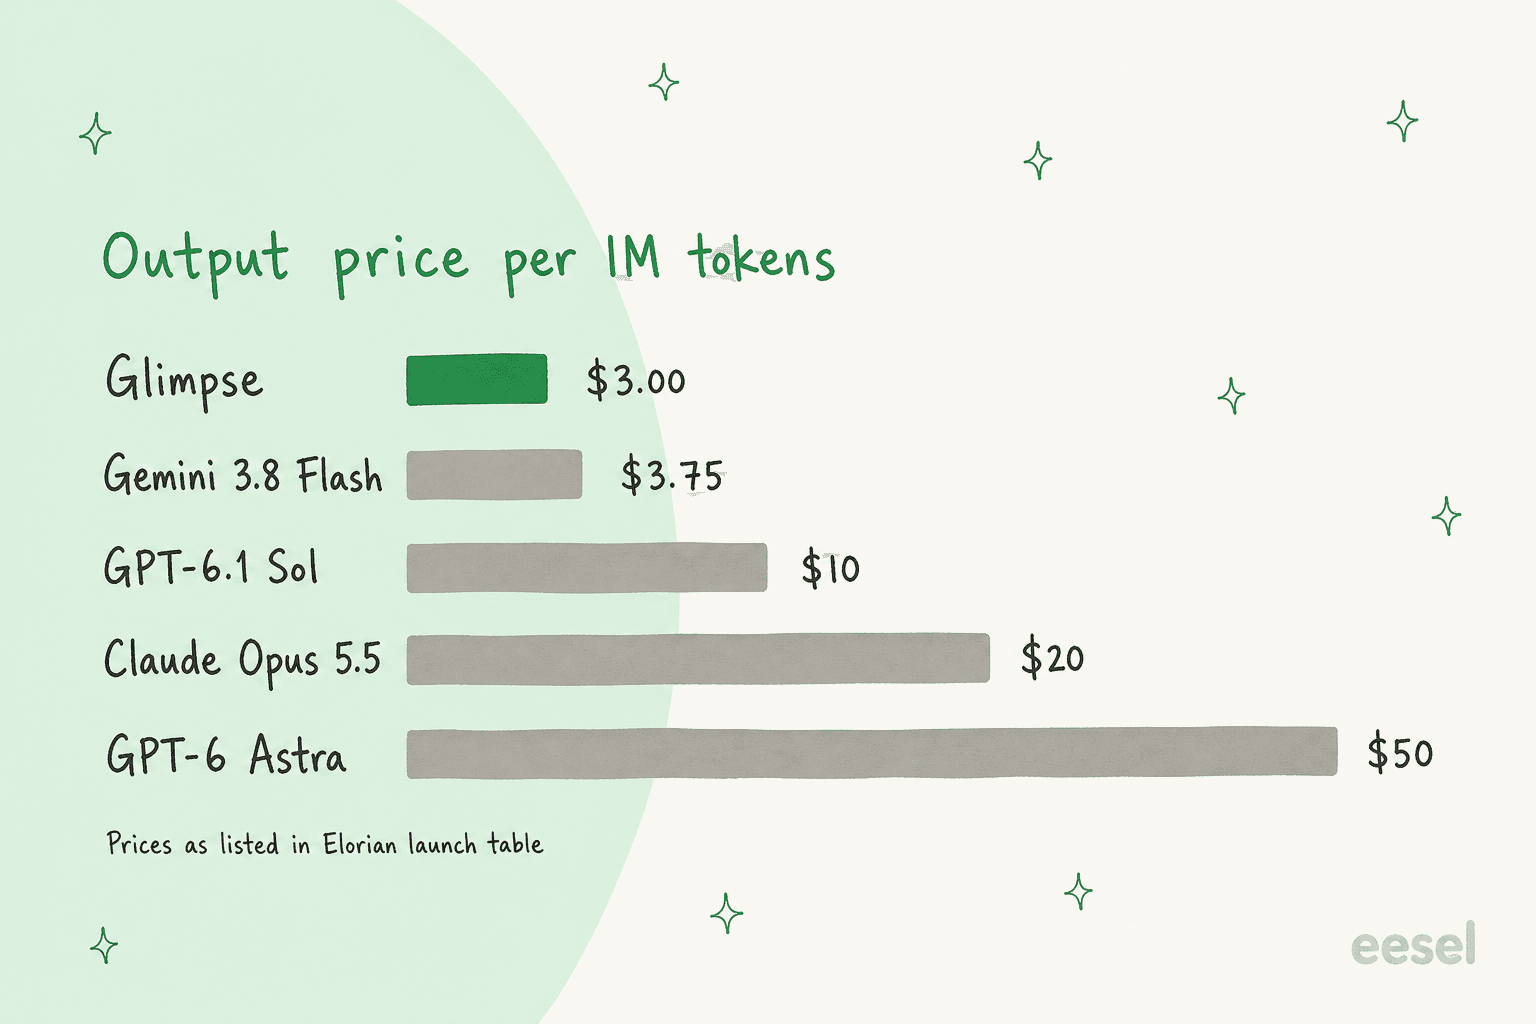
Esses preços da concorrência são os que a Elorian listou; as minhas análises de GPT-6 Astra pricing e Opus 5.5 pricing cobrem as tabelas completas, incluindo cache. A afirmação da Elorian é que o Glimpse é 94 % mais barato do que o Astra e 20 % mais barato do que a tarifa de introdução do Gemini 3.8 Flash, tanto na entrada como na saída.
Duas coisas mudam a fatura real:
- O Glimpse pensa com muitos tokens. A própria Elorian o diz: "Looking that closely takes time, and tokens. Token efficiency is our next highest focus." Uma tarifa baixa por token num modelo que raciocina muito pode ainda custar mais por tarefa do que espera, por isso teste com os seus próprios clipes antes de orçamentar.
- Os números por tarefa parecem melhores do que os por token. Na demo de planeamento robótico da Elorian, o episódio inteiro custou $0.035 com o Glimpse contra $0.249 com o Astra, cerca de 7 vezes menos. O investidor Brian Zhan calculou o que isso significa para um robô que verifica as câmaras a cada 2 segundos: 1.800 chamadas por hora de robô, em que "the same budget on Astra buys one check every 14s."
Na Together, a listagem apenas dedicada significa que paga por GPUs reservadas, não por chamada. Isso convém a uma equipa com volume estável e uma razão para manter o tráfego numa infraestrutura que já usa; o meu guia de Together AI pricing explica como os endpoints dedicados são faturados. Para um primeiro teste, a API da Elorian é mais simples. Um desdobramento completo de custos por cenário virá numa publicação separada sobre os preços do Glimpse.
Para que serve, na prática?
A Elorian e a Together listam os mesmos três grupos de casos de uso, e coincidem com os pontos onde os benchmarks são mais fortes.
Dados e planeamento em robótica. O Glimpse consegue etiquetar imagens de teleoperação, nomear e enquadrar objetos e dividir um episódio em eventos de pegar e pousar com marcas temporais. Também pode atuar como planeador de uma política robótica de visão-linguagem-ação, verificando as câmaras para decidir quando um passo termina. Na demo de lançamento, planeou para a política π0.5 da Physical Intelligence numa tarefa LIBERO. Se a robótica é o seu mundo, compare-o com o Gemini Robotics 2 e o Gemini 4 Argon for robotics da Google.
"Most teleop footage sits unlabelled because segmenting every step by hand is slow and expensive."
Vídeo em escala. Legendas densas que captam movimentos finos e dinâmicas emocionais, etiquetagem de vídeo curto e de redes sociais para pesquisa, e seguimento ou contagem de objetos em imagens feitas à mão. A demo dos cachorros da Elorian mantém o número de cada cachorro quando a câmara se afasta e volta, que é a parte difícil de contar em vídeo.
Inspeção científica e operacional. Ler gráficos e dados de laboratório, contar equipamento e inventário separando objetos parecidos e raciocinar sobre consequências físicas a partir de uma foto. A demo da obra da Elorian conta veículos num pátio e devolve as marcas temporais em que se apoiou, o tipo de rasto de evidência que um auditor quereria.
O que dizem os primeiros utilizadores?
As reações ao lançamento no X giraram sobretudo em torno do processo visível. O anúncio de Andrew Dai teve mais de 5.700 gostos:
"Spent years watching models ace a single image and completely whiff on anything that moves or changes angle. Today we're fixing that."
Um testador com acesso antecipado fez um teste de contagem numa pintura e gostou de como o modelo trabalhou, não só da resposta:
"Glimpse broke the image into four sections, zoomed in to examine the details, and analyzed the visual clues before reaching its final answer: 5 horses."
A crítica mais afiada veio nas respostas, e é a pergunta certa a fazer a qualquer demo:
"Counting is the easy thing to check, but the footage use is where it gets hard. Asking why something changed means tracking the same object across frames and tying it to a cause, and that is where a lot of vision models start guessing. I'd want to see it on a long clip where the key change happens off to one side of the frame."
Vale notar que várias das publicações de lançamento mais entusiastas, incluindo o fio de robótica de Brian Zhan e a publicação "1/16 the price of Astra" da Striker, vêm de investidores da Elorian. São úteis para as contas, mas não são análises neutras. Atualizarei esta publicação quando testadores independentes divulgarem resultados com clipes longos.
Onde o Glimpse fica a dever
Nenhum destes pontos é impeditivo para um primeiro modelo, mas convém conhecê-los antes de construir sobre ele:
- É uma pré-visualização de pesquisa. Palavras da própria Elorian. Espere mudanças no modelo, nos limites e no preço.
- Ainda sem benchmarks independentes. Cada pontuação é uma execução da Elorian, com esforço máximo, numa tabela que inclui um benchmark criado pela Elorian.
- Faltam o básico. Sem janela de contexto, saída máxima, limites de taxa, preço de entrada em cache nem nível de lote publicados. Para quem compra a API, isso decide se funciona em produção.
- Sem pesos. Foi construído sobre uma base de pesos abertos, mas o próprio Glimpse é fechado. Se precisa de alojar visão por conta própria, o Nemotron 3.5 Super VL e a experiência de visão do DeepSeek V4 Flash são as opções abertas.
- Treina com os seus envios por padrão. Os termos da Elorian licenciam o conteúdo enviado para "train, test, evaluate, and improve" os seus modelos. Os utilizadores pagos podem recusar por e-mail; os termos não dão essa opção aos utilizadores gratuitos. Os mesmos termos também proíbem usar as saídas para treinar ou avaliar outro modelo.
- Só texto à saída. Lê imagens e vídeo mas devolve texto, e a Elorian diz que as saídas de ação para robôs ainda são "work ahead."
O Glimpse é útil para o atendimento ao cliente?
Esta é a pergunta que mais me importa, por isso serei direto. A parte de visão é uma boa adequação. Os clientes enviam fotos de produtos danificados, capturas de ecrã de mensagens de erro e gravações de ecrã de erros. Um modelo de texto vê "ver anexo" e mais nada. Um modelo que consiga contar, comparar e seguir o que mudou num clipe poderia transformar esses anexos em respostas.
Mas para uma equipa de suporte hoje, o Glimpse é um componente, não uma solução. Não há integração com helpdesks, nem janela de contexto publicada para longos históricos de tickets, e com o treino por padrão sobre os envios, você quereria um plano pago antes de qualquer foto de cliente se aproximar dele. Os helpdesks também estão a acrescentar a sua própria leitura de imagens, como o Gorgias AI Agent Vision, e o tratamento de anexos tem os seus limites, como os limites de tamanho de anexos do Zendesk.
A lição que a eesel aprendeu da pior maneira aplica-se a qualquer modelo novo: não se pode confiar que um modelo se fiscalize a si próprio numa fila real. Uma resposta errada e confiante sobre a foto de um artigo danificado é pior do que uma resposta humana lenta. É por isso que cada implementação da eesel é simulada com tickets históricos antes de a IA responder a um cliente real. O meu guia do best support ticket model explica como escolher a camada do modelo, e a AI ticket classification é um primeiro trabalho de menor risco para qualquer modelo novo.
Quem deve experimentar o Elorian Glimpse?
Assim decidiria eu:
- Equipas de robótica que etiquetam imagens ou verificam o trabalho de uma política. É aqui que o Glimpse é mais forte na tabela da Elorian e mais barato por verificação. Experimente primeiro.
- Equipas que etiquetam ou legendam vídeo curto em escala. Pontuação forte no UGC-VideoCap e preço de saída baixo. Execute-o com os seus próprios clipes.
- Inspeção e contagem de inventário. Bom na contagem aberta, mais fraco na contagem em imagens de produto (CountQA), por isso teste com as suas fotos de produto reais.
- Perguntas sobre vídeos longos. O Astra e o GPT-6.1 Sol pontuam claramente mais alto no Video-MME v2. Comece por aí se a precisão importar mais do que o custo.
- Qualquer coisa que precise de pesos, contratos ou limites publicados. Espere. Veja modelos abertos ou as outras opções da Together até o Glimpse sair da pré-visualização.
Se acompanha o panorama mais amplo de novos modelos com visão este mês, o Meta Muse Wonder, o Reflection AI Beam e o GLM-5.3-Flash são os outros lançamentos sobre os quais escrevi.
Experimente a eesel
O Glimpse é infraestrutura: um modelo, uma API e uma fatura por token. Para o usar em tickets de suporte, você ainda teria de construir a ligação ao helpdesk, a recuperação sobre o seu centro de ajuda, as regras de escalonamento e os testes. A eesel é o funcionário. O nosso colega de IA para o helpdesk junta-se à sua fila atual no Zendesk, Freshdesk, Gorgias e outros helpdesks, aprende com os seus tickets e documentos passados, e você pode reproduzi-lo contra centenas dos seus tickets históricos antes de ele responder a um único cliente. Essa reprodução é onde se apanha a resposta errada e confiante sobre a foto de um cliente antes que o cliente o faça.
Se preferir trabalhar a partir de um terminal, como faria para testar um modelo novo, a CLI da eesel controla esse mesmo colega. eesel instructions lê e edita as suas regras permanentes, eesel approvals lista as ações que aguardam uma pessoa, e eesel activity mostra cada execução e porque fez o que fez, para que um agente de código como o Claude Code possa gerir o seu colega de suporte da mesma forma que gere o seu repositório. Se escreve conteúdo em vez de responder a tickets, a mesma equipa tem um redator de blog com IA.

Começar é grátis, sem cartão. Experimente a eesel nos tickets do mês passado e veja o que teria respondido, antes de calcular o preço de um único endpoint dedicado. Os planos estão na página de preços.