

O GLM-5.3-Flash é o primeiro modelo nativamente multimodal da Z.ai na família GLM-5, lançado em 26 de agosto de 2026. É um modelo de mistura de especialistas com 320B de parâmetros e apenas 18B ativos, uma janela de contexto de 1M de tokens, entrada de imagem e vídeo e pesos abertos no HuggingFace.
A manchete é o preço. Ele marca 57 no Artificial Analysis Intelligence Index a cerca de $0,045 por tarefa, e os preços da API começam em $0,075 por milhão de tokens de entrada (uma promoção de lançamento até 9 de setembro de 2026; preço de tabela $0,15/$0,50). É aproximadamente inteligência de nível GLM-5.2 a um décimo do custo.
Não o confunda com o modelo principal GLM-5.3. O Flash é o irmão barato, multimodal e de alta vazão; o principal é o modelo apenas de texto para programação e cibersegurança, a $1,40/$4,40 por milhão de tokens.
Para equipes de suporte e de conteúdo, o modelo é o motor, não o produto final. Um modelo barato e capaz ainda precisa de recuperação, integrações, o conhecimento da sua empresa e testes antes de responder com segurança a um cliente. Essa última etapa é exatamente o que a eesel resolve.
O que o GLM-5.3-Flash realmente é
Eu construo agentes de IA para viver, e quase toda semana aparece um novo modelo de "nível de fronteira por uma fração do custo". O GLM-5.3-Flash é um dos poucos recentes em que a afirmação se sustenta, em grande parte, quando você olha os números.
A Z.ai (a empresa antes conhecida como Zhipu AI, de Pequim) o lançou no lançamento do GLM-5.3-Flash em 26 de agosto de 2026, com o slogan "Frontier Intelligence, Flash Cost". É o primeiro modelo da série GLM-5 que é nativamente multimodal: imagem e vídeo entram junto com o texto, e texto sai. Por baixo, é um modelo de mistura de especialistas com 320B de parâmetros no total, mas apenas 18B ativos em cada token, que é o truque que o mantém rápido e barato de servir.
Algumas especificações para fixar antes de tudo, todas da documentação do modelo da Z.ai:
- Janela de contexto: 1M de tokens, com 128K de saída máxima.
- Entradas: texto, imagem, vídeo e arquivos. A saída é apenas texto.
- Raciocínio: o modo de pensamento está sempre ativado e, ao contrário dos modelos GLM mais antigos, não pode ser desativado.
- Ferramentas: chamada de funções, saída JSON estruturada, streaming e cache de contexto são suportados.
- Pesos: públicos no HuggingFace, podem ser hospedados por conta própria via SGLang, vLLM ou TokenSpeed.
O gráfico que resume por que todo mundo fala deste modelo é o de custo versus inteligência da Artificial Analysis. O GLM-5.3-Flash cai no canto superior esquerdo de "barato e inteligente", que quase nada mais ocupa.
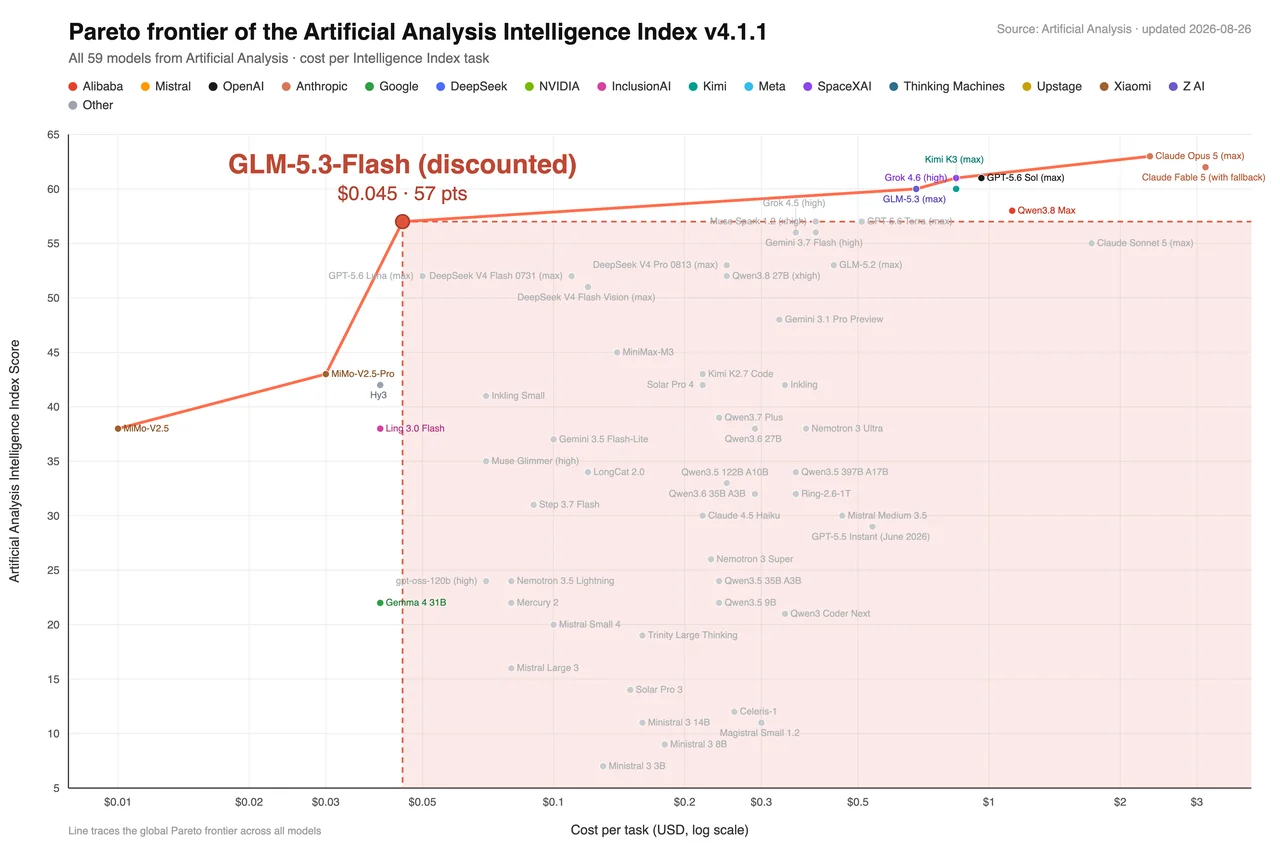
O enquadramento da própria Z.ai é que ele entrega "um nível de inteligência antes disponível apenas a cerca de 10x o custo". O interessante é que isso não é marketing de um agregador, é o número de um agregador de benchmarks independente, algo bem mais difícil de falsificar.
O lançamento furtivo "Ox Alpha"
Este é o detalhe que achei mais revelador. Antes do lançamento oficial, a Z.ai o executou de forma anônima no OpenCode e no OpenRouter como "ox-alpha" para coletar feedback de uso real. Ele se tornou discretamente o modelo mais usado da semana, processando mais do dobro de tokens do modelo seguinte, tudo servido em chips de IA chineses em vez de hardware da Nvidia.
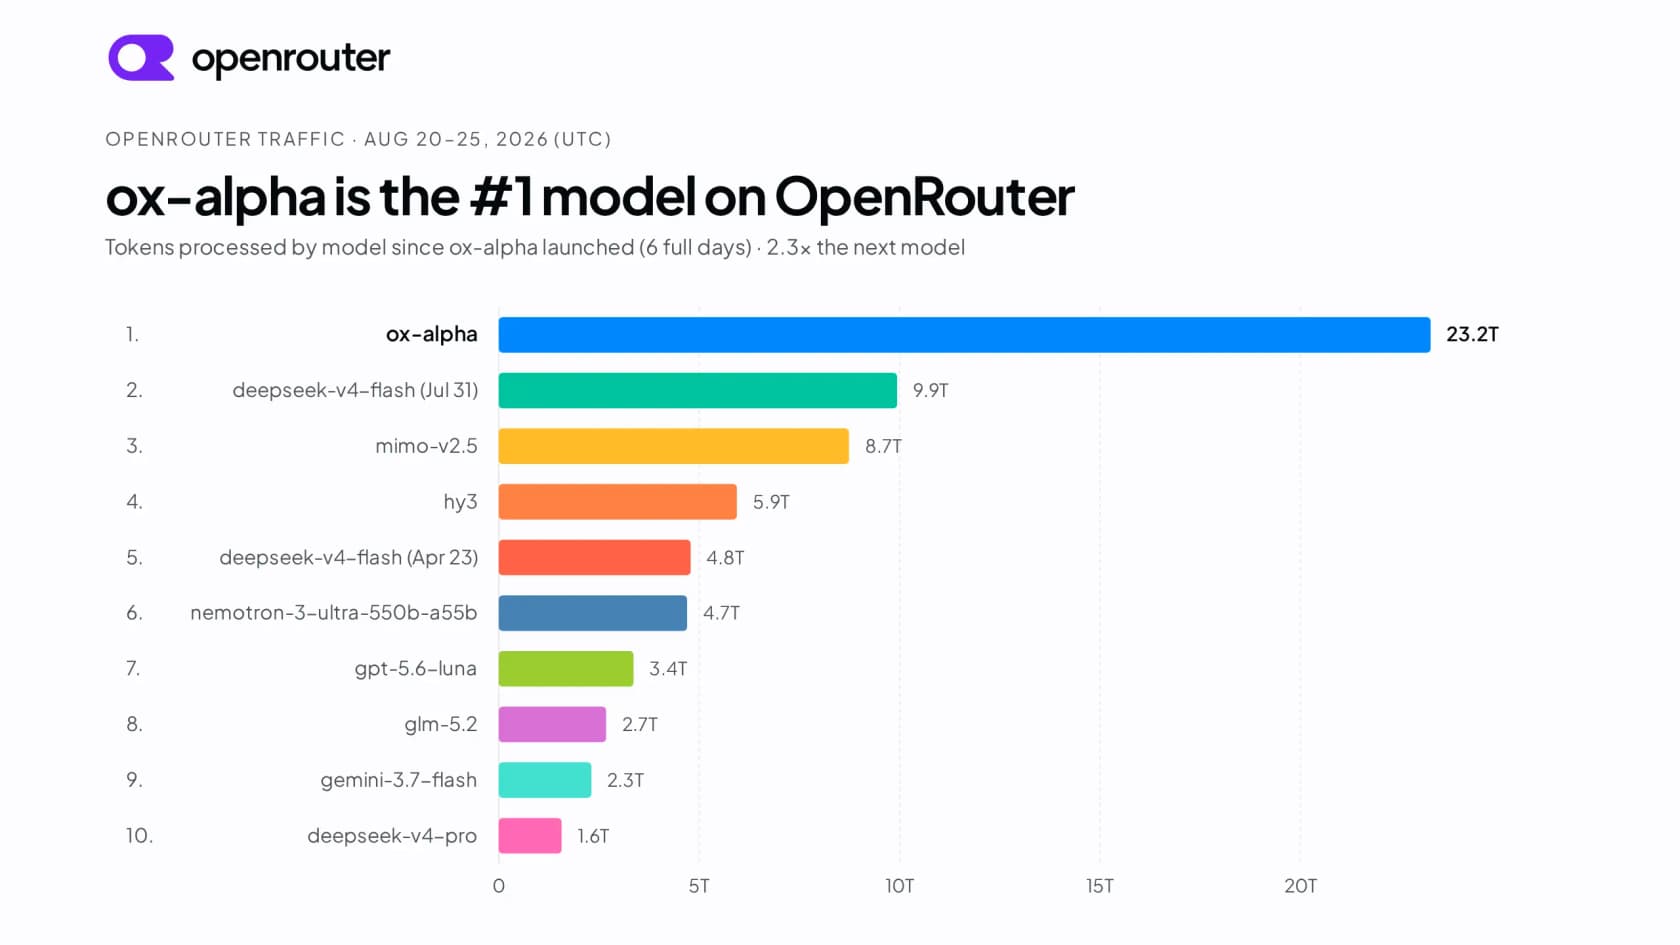
Duas coisas importam aqui. Primeiro, um teste cego em plataformas públicas é quase o sinal mais honesto que um laboratório pode produzir, porque ninguém escolhia o modelo pela marca. Segundo, o ângulo dos chips chineses é uma história real. A Z.ai afirma que isso "demonstra que chips chineses conseguem sustentar inferência de modelos de fronteira de forma eficiente e econômica em escala", o que, se for verdade, muda a conta para boa parte do mercado que assumia que inferência de fronteira significava as GPUs de um fornecedor específico.
Como o GLM-5.3-Flash mantém os custos baixos
Esta é a parte que realmente me interessa, porque "é barato" só é interessante se o preço baixo for estrutural e não um subsídio que some em seis meses.
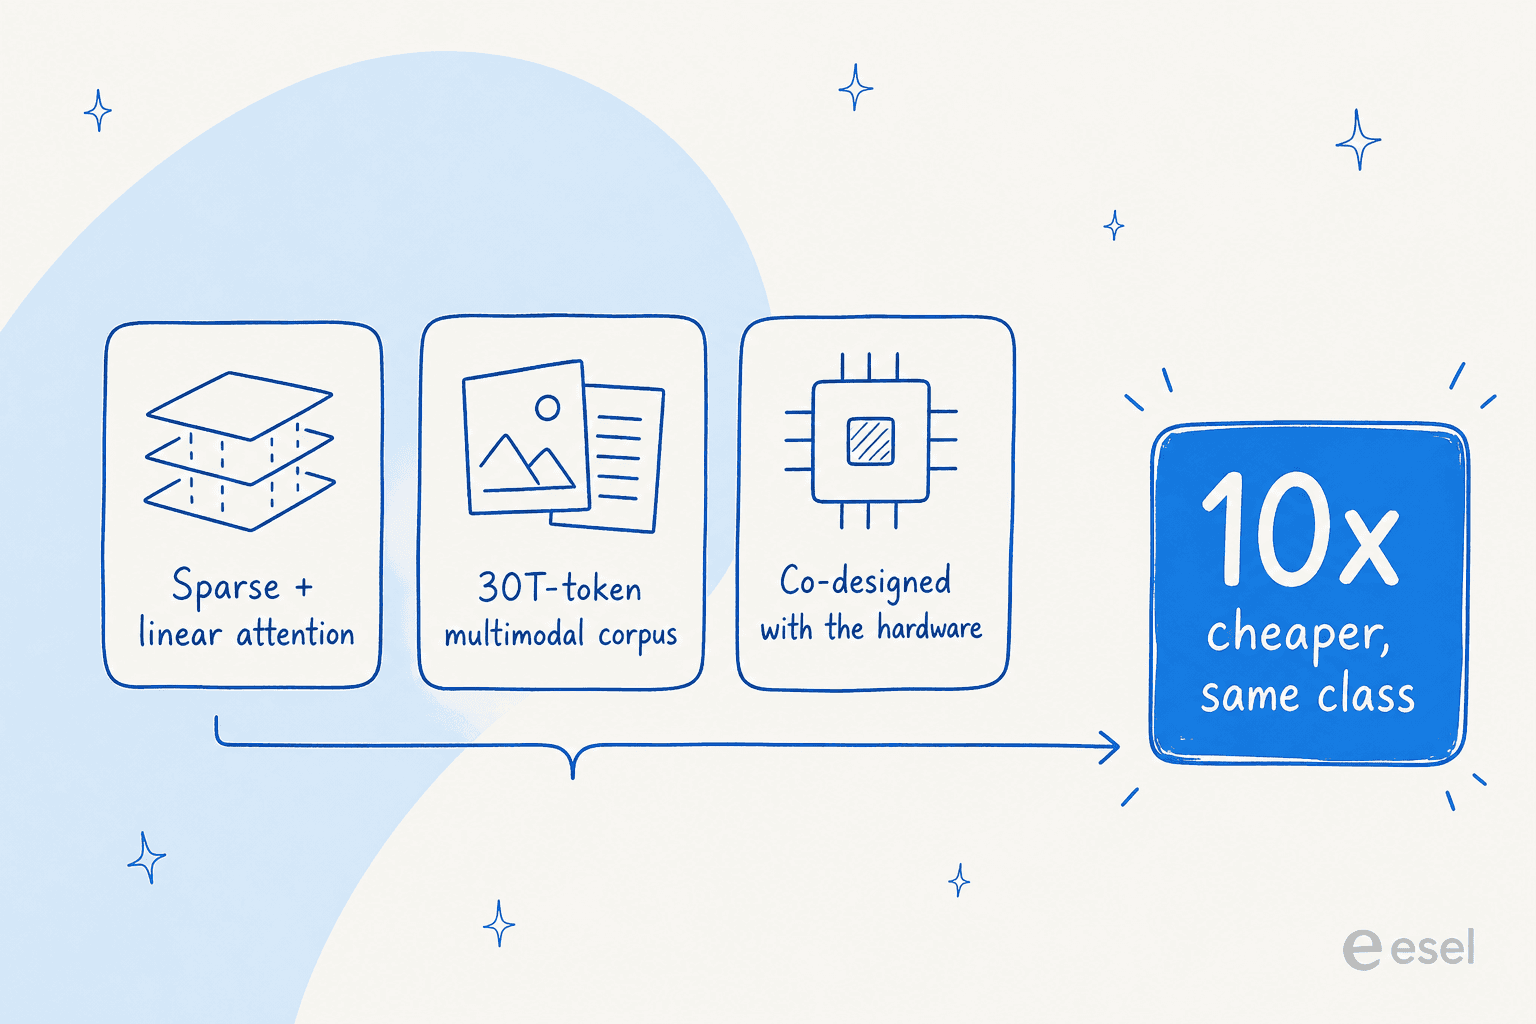
A Z.ai divide a economia em três camadas, e o diagrama de arquitetura merece um momento de atenção.
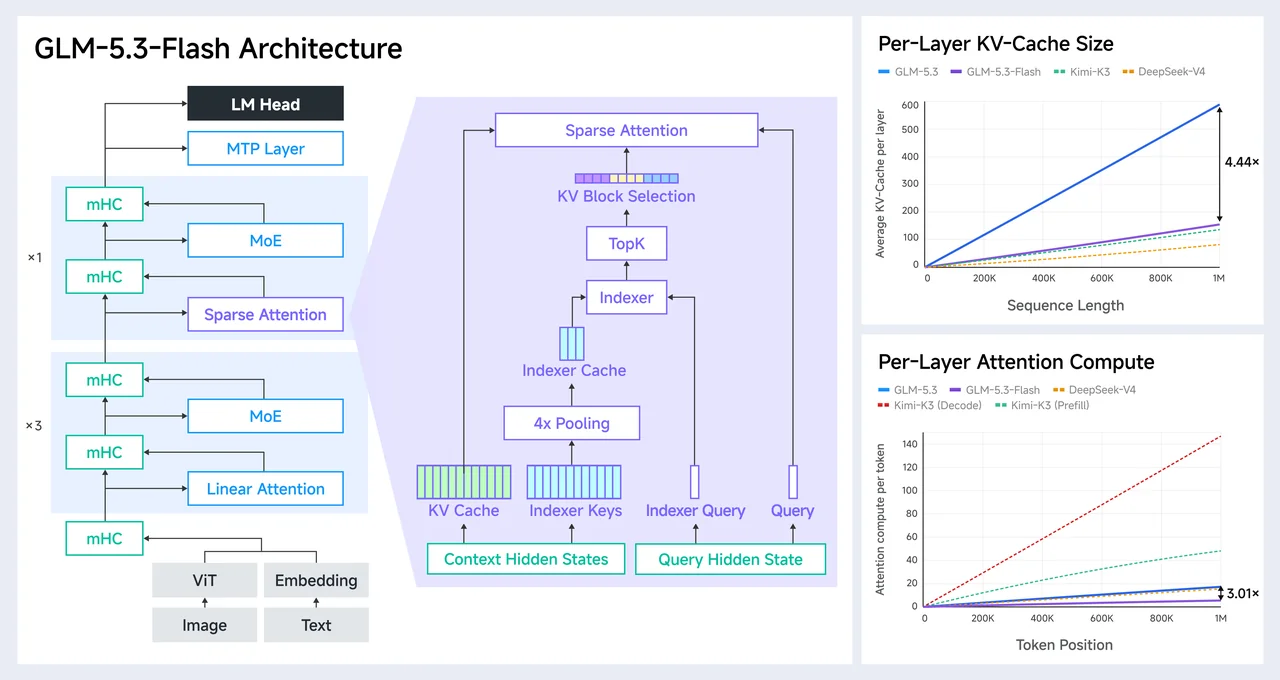
A primeira camada é o design da atenção. O GLM-5.3-Flash combina atenção esparsa e linear: a atenção linear cuida do contexto local por meio de modelagem de estado, e um indexador leve recupera o contexto global que realmente importa. O ganho é concreto: em comparação com o modelo principal GLM-5.3, ele reduz a computação de atenção em 3,0x e o tamanho do cache KV em 4,4x. O contexto longo é onde os custos de serviço costumam explodir, então encolher o cache KV é a diferença entre uma janela de 1M de tokens ser um recurso de demonstração ou algo acessível.
A segunda camada são os dados de treinamento, um corpus multimodal de 30 trilhões de tokens que incorpora a compreensão de imagem e vídeo desde o início, em vez de acoplar um codificador de visão depois. A terceira é o co-design de tudo com o hardware de inferência em que roda.
Para comparar, o GLM-5.3-Flash reduz quase pela metade tanto a contagem de parâmetros ativos (18B vs 32B) quanto a de camadas (45 vs 92) da série GLM-4.5 mais antiga, mantendo um tamanho total parecido. Menos parâmetros ativos por token é a alavanca mais direta sobre o custo, e é por isso que um modelo de 320B pode ter preço de um pequeno.
Benchmarks do GLM-5.3-Flash
É nos benchmarks que o "barato" costuma ser exposto, então esta é a seção que eu leria duas vezes. A comparação da própria Z.ai coloca o GLM-5.3-Flash contra GLM-5.2, DeepSeek-V4-Vision-Exp, Claude Opus 4.8, GPT-5.6 Terra e Gemini 3.7 Flash.
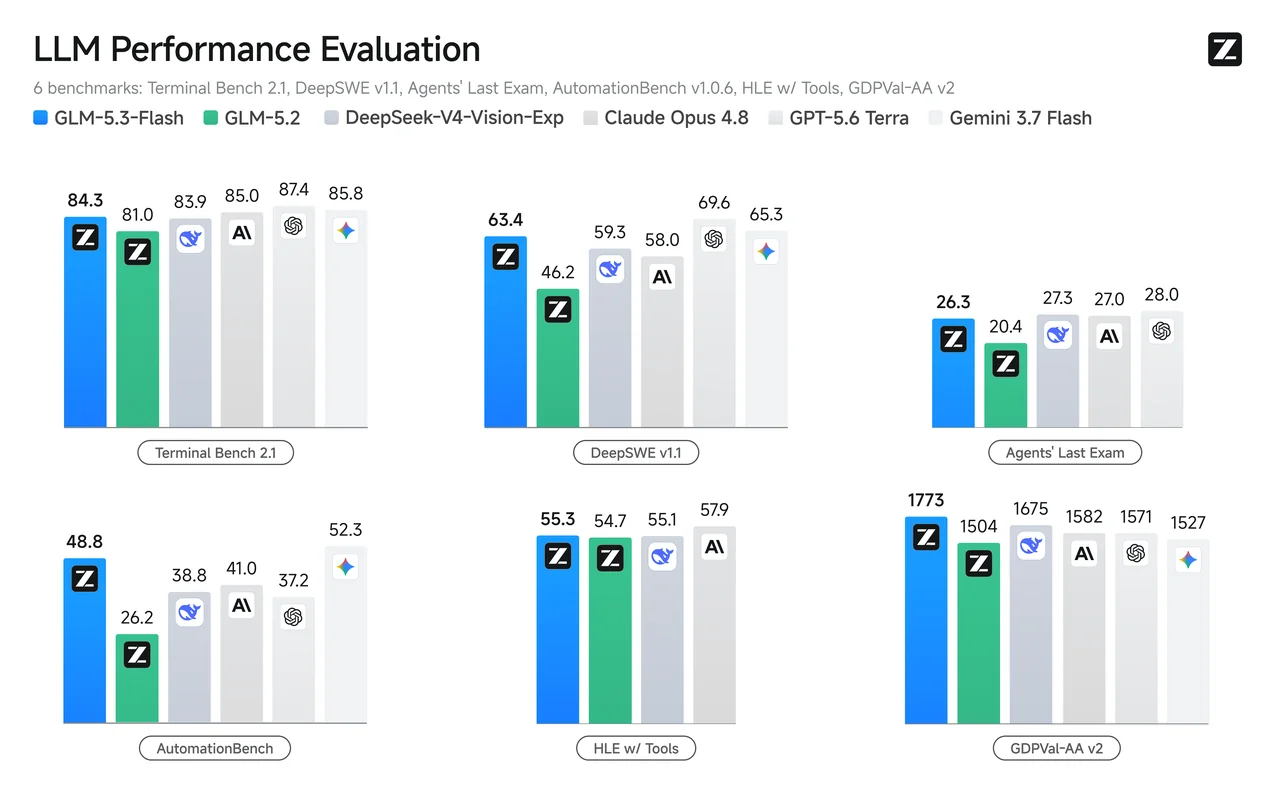
O salto em relação à geração anterior é a verdadeira história:
| Benchmark | GLM-5.3-Flash | GLM-5.2 | Opus 4.8 | GPT-5.6 Terra |
|---|---|---|---|---|
| DeepSWE v1.1 (programação) | 63.4 | 46.2 | 58.0 | 69.6 |
| AutomationBench v1.0.6 | 48.8 | 26.2 | 41.0 | 37.2 |
| Toolathlon Verified | 78.4 | 59.9 | 76.2 | 74.9 |
| Terminal Bench 2.1 | 84.3 | 81.0 | 85.0 | 87.4 |
| GDPval-AA v2 | 1773 | 1504 | 1582 | 1571 |
Fonte: benchmarks do GLM-5.3-Flash da Z.ai.
Lendo com honestidade, duas coisas são verdadeiras ao mesmo tempo. O GLM-5.3-Flash supera o GLM-5.2 em tudo, muitas vezes por margens enormes (quase dobrando no AutomationBench), e passa o Claude Opus 4.8 em várias tarefas de agentes. Também ainda fica atrás dos melhores modelos fechados de fronteira, como o GPT-5.6 Terra, em programação pura. No Code Bench da própria Z.ai com esforço máximo, ele marcou 29,0 contra 29,5 do Opus 4.8, então "quase iguala o Opus 4.8" é uma descrição justa, não exagero. Para um modelo a um décimo do preço, igualar os modelos principais da geração passada é exatamente o ponto.
No lado multimodal o quadro é mais misto. Ele tem pontuações fortes em raciocínio sobre gráficos e documentos (89,4 no CharXiv, 78,0 no Chartography), mas fica atrás do Gemini 3.7 Flash em benchmarks de vídeo puro como MVbench e MMVU. Se sua carga de trabalho é compreensão de documentos e interfaces, isso é animador; se é análise pesada de vídeo, teste primeiro contra o Gemini.
Preços do GLM-5.3-Flash
Aqui está a tabela completa, direto da documentação de preços da Z.ai. Os preços são por milhão de tokens.
| Modelo | Entrada | Entrada em cache | Saída | Observações |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.075 (tabela $0.15) | $0.015 | $0.25 (tabela $0.50) | 50% de desconto de lançamento até 9 set 2026 |
| GLM-5.3 (principal) | $1.40 | $0.26 | $4.40 | Programação e cyber |
| GLM-5.2 | $1.40 | $0.26 | $4.40 | 1M de contexto |
| GLM-4.7-FlashX | $0.07 | $0.01 | $0.40 | Texto |
| GLM-4.7-Flash | Grátis | Grátis | Grátis | Texto, totalmente grátis |
Alguns avisos para ninguém se surpreender. O preço de entrada de $0,075 é uma promoção de lançamento que termina à meia-noite de 9 de setembro de 2026 (horário de Singapura), voltando depois a $0,15. Mesmo a preço de tabela, é de longe o modelo pago mais barato da série GLM-5. A entrada em cache tem mais ~80% de desconto, o que pesa muito em cargas de agentes que reenviam o mesmo prompt de sistema a cada turno. A busca na web integrada é cobrada à parte, a $0,01 por chamada.
Há também a opção de assinatura. O GLM Coding Plan começa em $18/mês (Lite), $80/mês (Pro) e $168/mês (Max), funciona dentro do Claude Code, Cline, OpenCode, Cursor e mais de 20 outras ferramentas, e dá ao GLM-5.3-Flash 3x a cota do modelo principal. Os horários de baixa demanda (que incluem todo o fim de semana) são cobrados pela metade da taxa de créditos.
Para tornar o lado da API concreto, aqui vai uma calculadora rápida. Informe seu volume diário de tokens e veja a conta mensal em comparação com o modelo principal.
GLM-5.3-Flash vs o modelo principal GLM-5.3 (e os planos gratuitos)
Os nomes confundem as pessoas, então vou ser direto sobre qual modelo escolher.
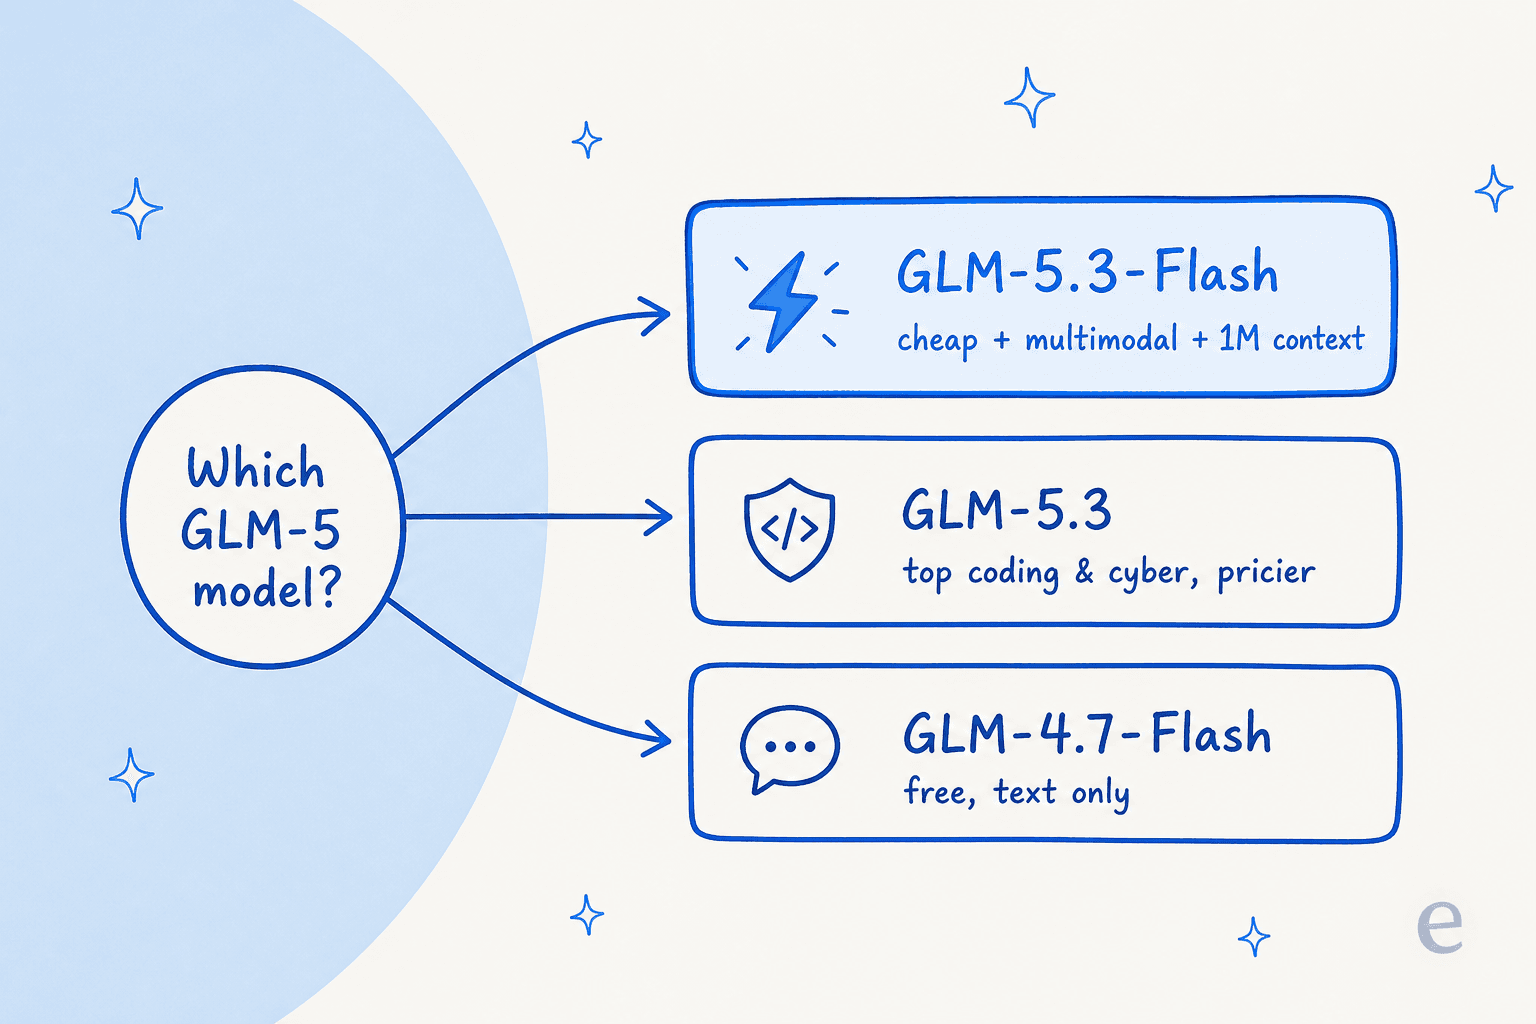
- GLM-5.3-Flash é o que você usa por padrão: barato, multimodal, 1M de contexto, alta vazão em hosts de terceiros. Ideal para cargas de alto volume, tarefas de visão e documentos, e tudo em que o custo por token decide.
- GLM-5.3 (o principal) é um modelo realmente diferente, apenas de texto, criado para programação e cibersegurança. Ele lidera sua classe no CyberGym e, em um estudo de segurança da Z.ai, apontou 2.436 vulnerabilidades reais em 269 projetos, algumas das quais passaram décadas despercebidas. Se você faz trabalho difícil no estilo SWE-bench ou revisão de segurança, pague o prêmio.
- GLM-4.7-Flash e GLM-4.6V-Flash são totalmente gratuitos (texto e visão, respectivamente), mas são mais antigos e menos capazes. Servem para prototipar, não para qualidade de produção.
Uma ressalva que aparece o tempo todo: a velocidade depende de onde você o executa. Na API da própria Z.ai, o GLM-5.3-Flash é lento (~49 tokens/segundo), e a comunidade foi direta sobre isso. Em hosts de terceiros é outra história, com a Databricks registrando 272,9 tokens/segundo na Artificial Analysis. Se a vazão importa, escolha seu provedor com critério.
O que as pessoas estão dizendo
A reação da comunidade tem sido barulhenta e se agrupa em duas coisas: descrença com o preço e reclamações sobre a velocidade do provedor original.
Sobre custo, a comparação recorrente é com os outros modelos de pesos abertos baratos ao lado dos quais ele agora está, como o Qwen e o Kimi K2.5. De um tópico muito compartilhado no Reddit:
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

Pesquisadores de segurança estiveram entre os mais rápidos a fazer testes reais. Um publicou um número concreto de custo por achados, exatamente o tipo de resultado específico em que confio mais do que numa impressão:
"We benchmarked the new GLM-5.3 Flash on VulnPR-100. It found 34/100 vulnerabilities at a total model-review cost of just $4.21. That makes it the strongest sub-$10 model we've tested."
E sobre a nova capacidade de visão, um testador independente a submeteu a uma amostra considerável:
"GLM-5.3-Flash vision. With 1,500 samples it scored an 81% accuracy rate, which is reasonable. It works very well."
O contrapeso honesto é a velocidade. Um tópico do r/opencode chamou o endpoint original de "one of the slowest models AA [has ever seen]", o que bate com o número de ~49 t/s da própria Z.ai. É uma limitação real, e é específica do provedor, não uma propriedade dos pesos.
Onde um modelo bruto termina e um colega de equipe começa
Esta é a parte que passa em branco em todo lançamento de "modelo de fronteira barato", e é o que aprendi da forma difícil em mais de três anos colocando IA em filas de suporte ao vivo: um modelo não é uma solução.
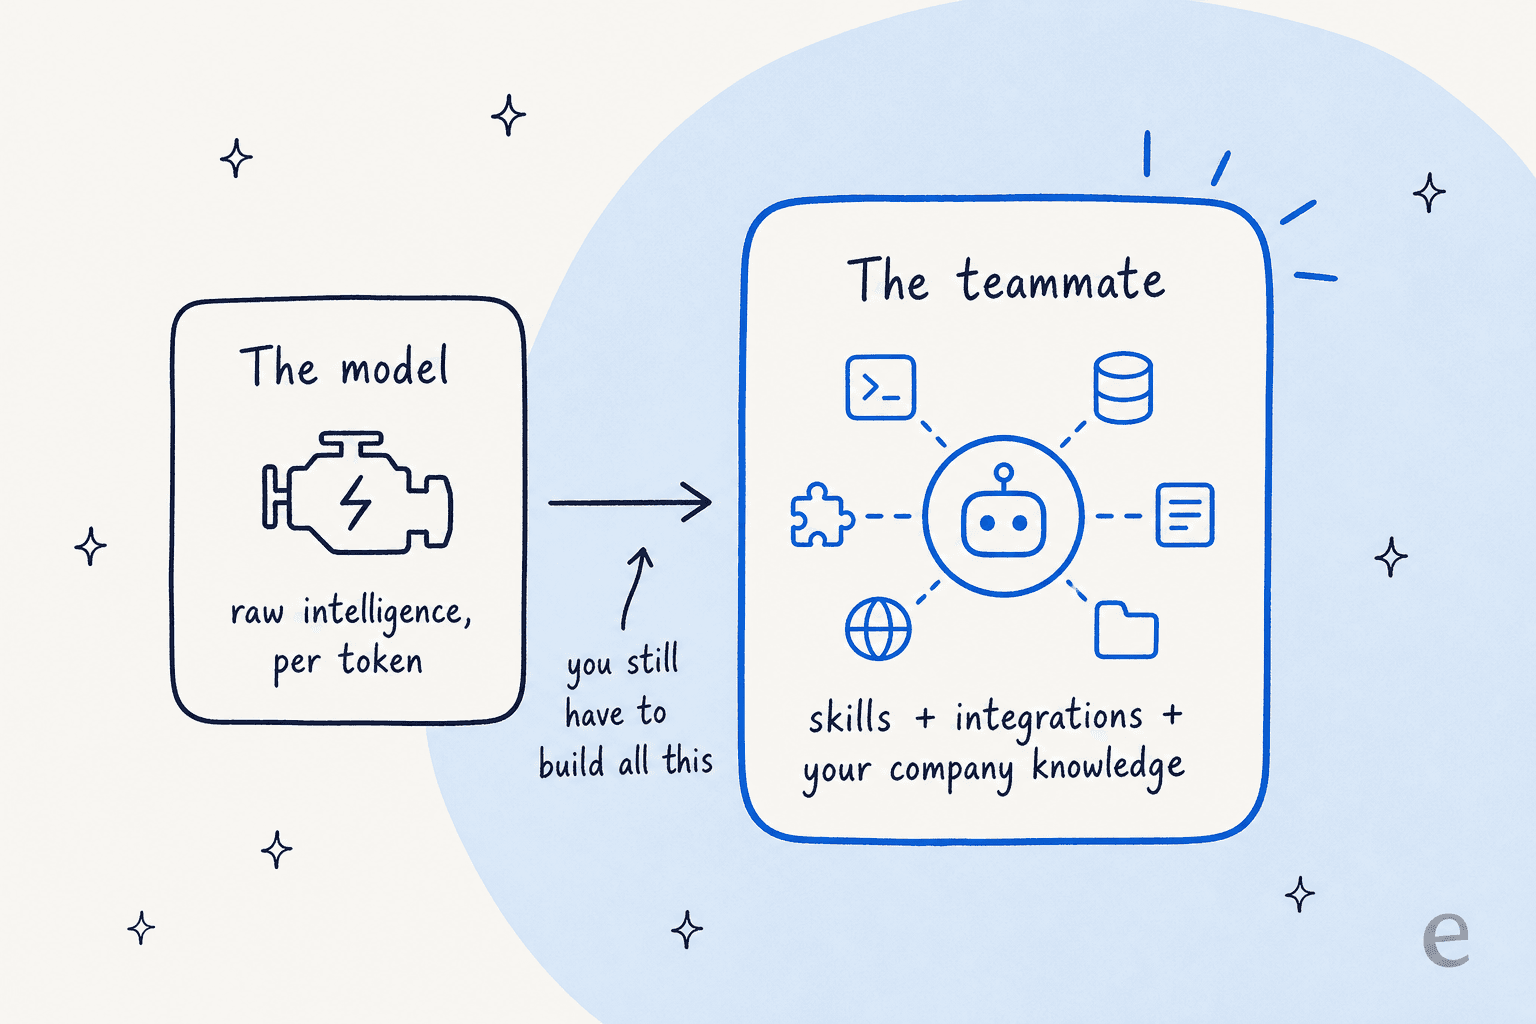
O GLM-5.3-Flash dá inteligência barata e capaz por token. Ele não dá um sistema que conhece sua política de reembolso, consegue ler o histórico de um cliente no Zendesk, recupera o documento de ajuda certo via RAG, executa uma ação no seu helpdesk e é testado antes de falar com uma pessoa real. Cada um desses pontos é um projeto. Construímos todo o nosso produto em torno dessa lacuna, e o hábito mais importante que adquirimos é simples: nunca confie em um modelo com tickets reais antes de simulá-lo contra o seu próprio histórico. Uma resposta confiante, mas silenciosamente errada, custa mais do que uma lenta.
Então, se você é um desenvolvedor que quer inteligência bruta para plugar na sua própria stack, o GLM-5.3-Flash é uma escolha realmente ótima e barata, e eu o usaria com prazer. Se você é uma equipe de suporte ou de conteúdo que só quer o resultado, o modelo é a parte fácil e a última etapa é o trabalho. É aí que uma plataforma de agentes de IA mostra seu valor. É o mesmo motivo pelo qual dizemos para comparar agentes prontos, e não modelos brutos, ao avaliar a IA para automação de atendimento ao cliente.
Experimente a eesel
Se você gosta do que o GLM-5.3-Flash representa (respostas de nível de fronteira sem contas de nível de fronteira), mas precisa dele fazendo um trabalho em vez de parado atrás de uma API, é isso que a eesel é. Você contrata um colega de IA, conecta aos seus apps e ele começa a trabalhar desde o primeiro dia: um colega de IA para o helpdesk que entra na sua fila existente no Zendesk, Freshdesk ou Gorgias, e um redator de blog de IA que entrega posts pesquisados e prontos para publicar.
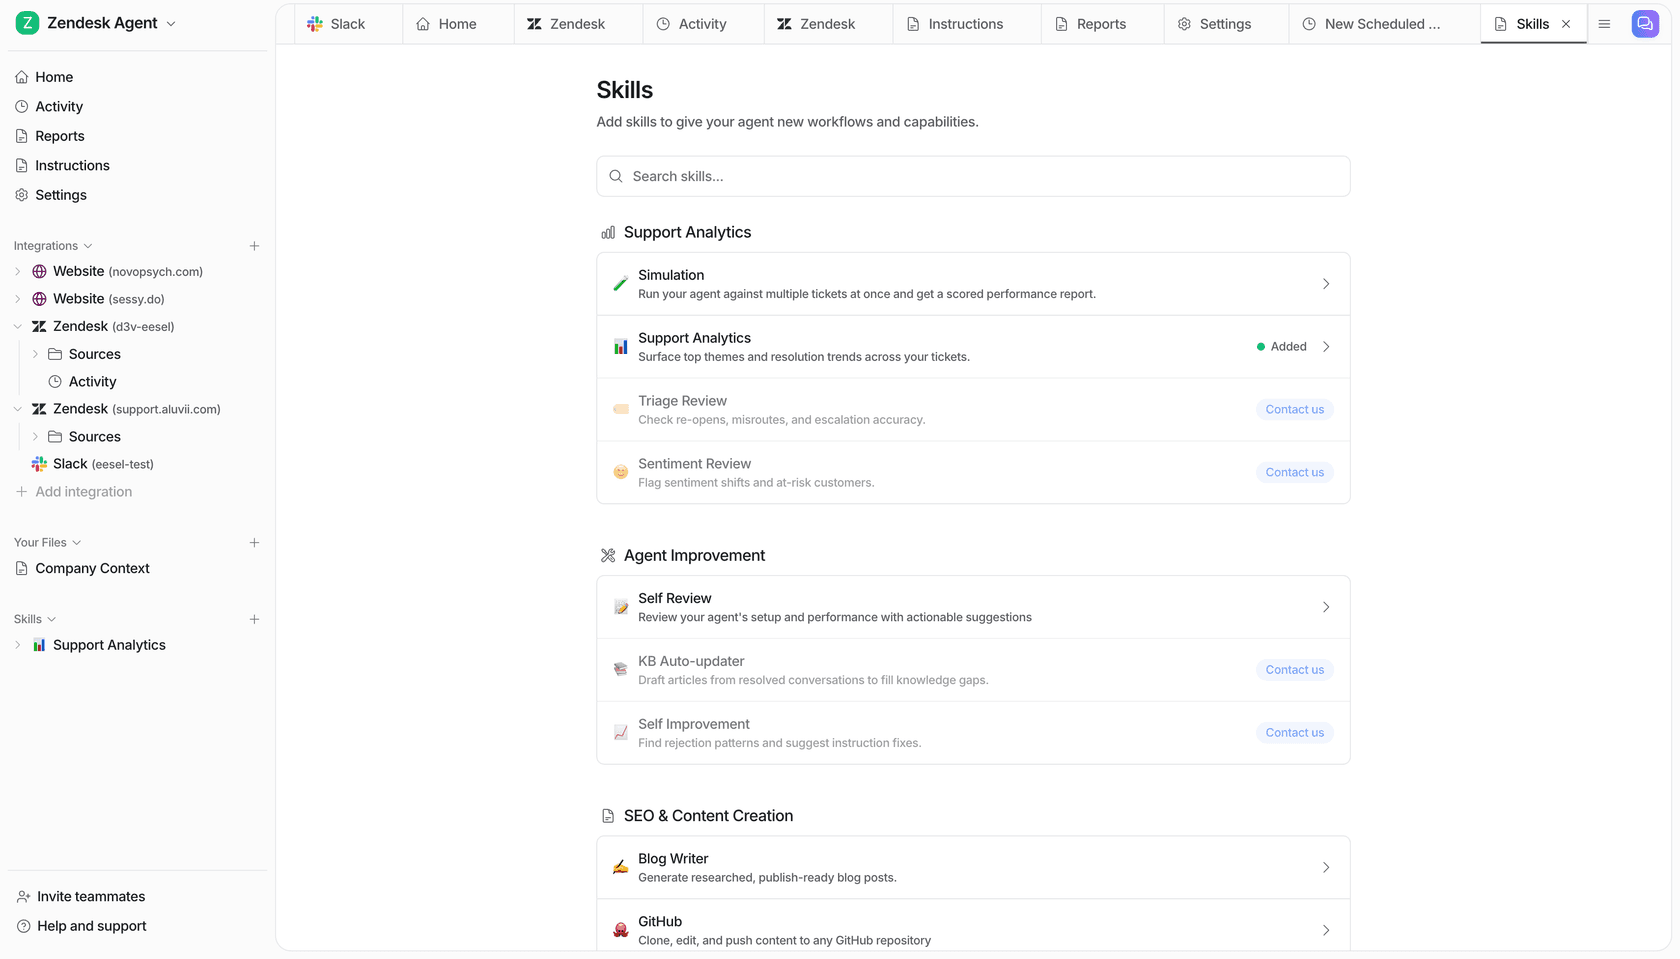
A diferença para um modelo bruto é a parte de integração que já está pronta: ele lê sua base de conhecimento e tickets passados, vem com as integrações e habilidades para a função e (a parte que mais me importa) você pode simulá-lo contra milhares dos seus tickets históricos antes de ele responder um único ticket ao vivo. Você leva a inteligência do modelo com a rede de segurança que uma API bruta não entrega. É grátis para testar, sem ligação de vendas.
Perguntas frequentes
O que é o GLM-5.3-Flash?
O GLM-5.3-Flash é o primeiro modelo nativamente multimodal da série GLM-5 da Z.ai, um modelo de mistura de especialistas com 320B de parâmetros e 18B de parâmetros ativos, uma janela de contexto de 1M de tokens e pesos abertos no HuggingFace. A Z.ai o posiciona como inteligência de nível GLM-5.2 por cerca de um décimo do preço.
Quanto custa o GLM-5.3-Flash?
O preço da API do GLM-5.3-Flash é uma promoção de lançamento de $0,075 por milhão de tokens de entrada e $0,25 por milhão de tokens de saída até 9 de setembro de 2026, depois um preço de tabela de $0,15/$0,50, segundo a documentação de preços da Z.ai. Ele também está incluído no GLM Coding Plan a partir de $18/mês. Se você está comparando custos de modelos para suporte, nosso guia do modelo de IA para tickets de suporte faz as contas.
O GLM-5.3-Flash é de código aberto?
Os pesos podem ser baixados publicamente no HuggingFace e você pode hospedá-lo por conta própria com SGLang, vLLM ou TokenSpeed, então é um lançamento de pesos abertos. Confira o arquivo de licença para ver os termos exatos antes do uso comercial. Se pesos abertos são importantes para você, nosso resumo de plataformas de chatbot de código aberto cobre as ferramentas ao redor.
GLM-5.3-Flash vs GLM-5.3: qual é a diferença?
São dois modelos diferentes. O GLM-5.3-Flash é o irmão barato, multimodal e de alta vazão (entrada de imagem e vídeo, 1M de contexto). O modelo principal GLM-5.3 é a potência de programação e cibersegurança apenas de texto, com preço de $1,40/$4,40 por milhão de tokens. Escolha o Flash por custo e visão, e o modelo principal para os trabalhos de programação mais difíceis.
Posso usar o GLM-5.3-Flash para atendimento ao cliente?
Pode, mas um modelo bruto não é um agente de suporte. Ele não tem acesso à sua base de conhecimento, ao seu helpdesk nem aos seus tickets anteriores até que alguém conecte tudo isso. A eesel oferece um colega de IA para o helpdesk que já faz essa integração, então você aproveita a inteligência do modelo sem construir por conta própria a recuperação, as integrações e os testes.