

O Qwen 3.8 Flash Next é a prévia open-weight da equipe Qwen da sua arquitetura Qwen4 de nova geração, lançada em 26 de agosto de 2026. O nome confunde as pessoas, então comece por aqui: o Flash Next é a prévia de pesquisa com pesos abertos que você hospeda por conta própria; o Qwen3.8-Flash é a futura API hospedada, com janela de contexto de 1M e ferramentas integradas. São duas faces do mesmo modelo.
As especificações são a história. É um modelo de mistura de especialistas de 125B que ativa apenas 6B parâmetros por token, acoplado a uma tabela de consulta de N-gramas de 51B que você pode descarregar para a RAM comum do sistema. Esse design explica por que ele roda rápido em hardware que nunca comportaria um modelo denso desse tamanho, e por que a versão hospedada custa apenas $0.15 de entrada / $0.47 de saída por milhão de tokens.
Testes independentes sustentam o hype até certo ponto: a Artificial Analysis o coloca entre os primeiros modelos em inteligência para o seu preço. O porém, repetido em todos os tópicos da comunidade, é que esta é uma prévia de P&D propositalmente subtreinada, não um modelo de produção finalizado. O GLM 5.3 Flash é o rival mais polido se você precisa de algo estável hoje.
Se você está aqui porque quer IA barata para atendimento ao cliente, escolher o modelo é a parte fácil. Um modelo bruto não lê seus tickets, não redige respostas nem escala casos. Isso é trabalho de plataforma, e é exatamente o que a eesel faz em cima de modelos como este.
O que o Qwen 3.8 Flash Next realmente é
Eu construo agentes de IA na eesel, o que significa que vejo a camada de modelos mudar a cada duas semanas e aprendi a ler além dos gráficos de lançamento. Então, quando a equipe Qwen soltou o Qwen 3.8 Flash Next em 26 de agosto de 2026, a primeira coisa que fiz foi desembaraçar o nome, porque ele é genuinamente confuso.
Aqui está a versão clara. "Flash" é a faixa barata e rápida da Qwen. "Next" não é um Flash maior ou mais novo. É o rótulo que a Qwen dá a uma prévia de arquitetura, o mesmo papel que o Qwen3-Next teve antes do Qwen3.5. O Flash Next existe para que a comunidade possa mexer na nova estrutura antes que a família Qwen4 completa seja construída sobre ela.
A divisão prática importa porque muda o que você pode fazer com ele:
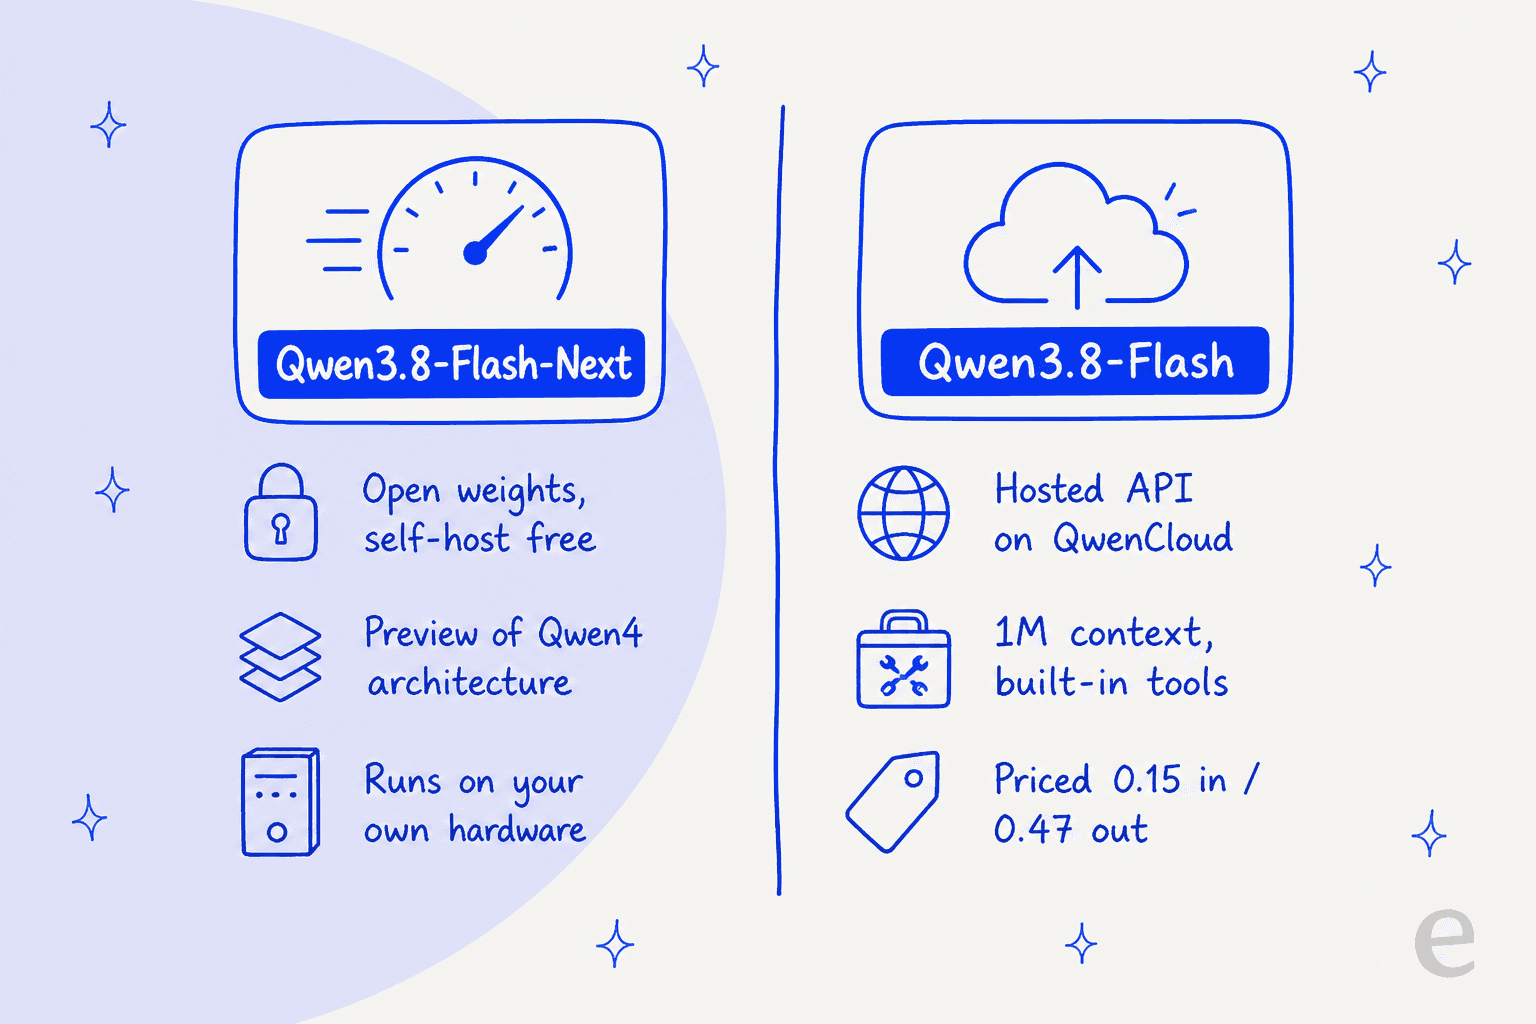
- Qwen3.8-Flash-Next é o lançamento com pesos abertos no Hugging Face e no ModelScope, sob a Qwen Community License 1.0. Você baixa e roda por conta própria.
- Qwen3.8-Flash é a versão de produção servida no QwenCloud, com 1M de contexto por padrão e ferramentas integradas oficiais. É essa que você acessa por API.
Isso já é uma mudança real em relação ao Qwen 3.7 Flash, que saiu fechado, sem pesos e sem nenhum benchmark. Desta vez você recebe pesos abertos e uma tabela detalhada de benchmarks desde o primeiro dia. É um modelo de raciocínio multimodal: recebe texto, imagens e vídeo, produz texto, e o modo de raciocínio vem ativado por padrão.
A arquitetura que merece o "Next"
Esta é a parte que realmente me interessa, porque a arquitetura é a razão de o preço poder ser o que é. O Flash Next estende o design híbrido do Qwen3-Next em quatro eixos, e cada um é uma aposta em trocar memória por computação.
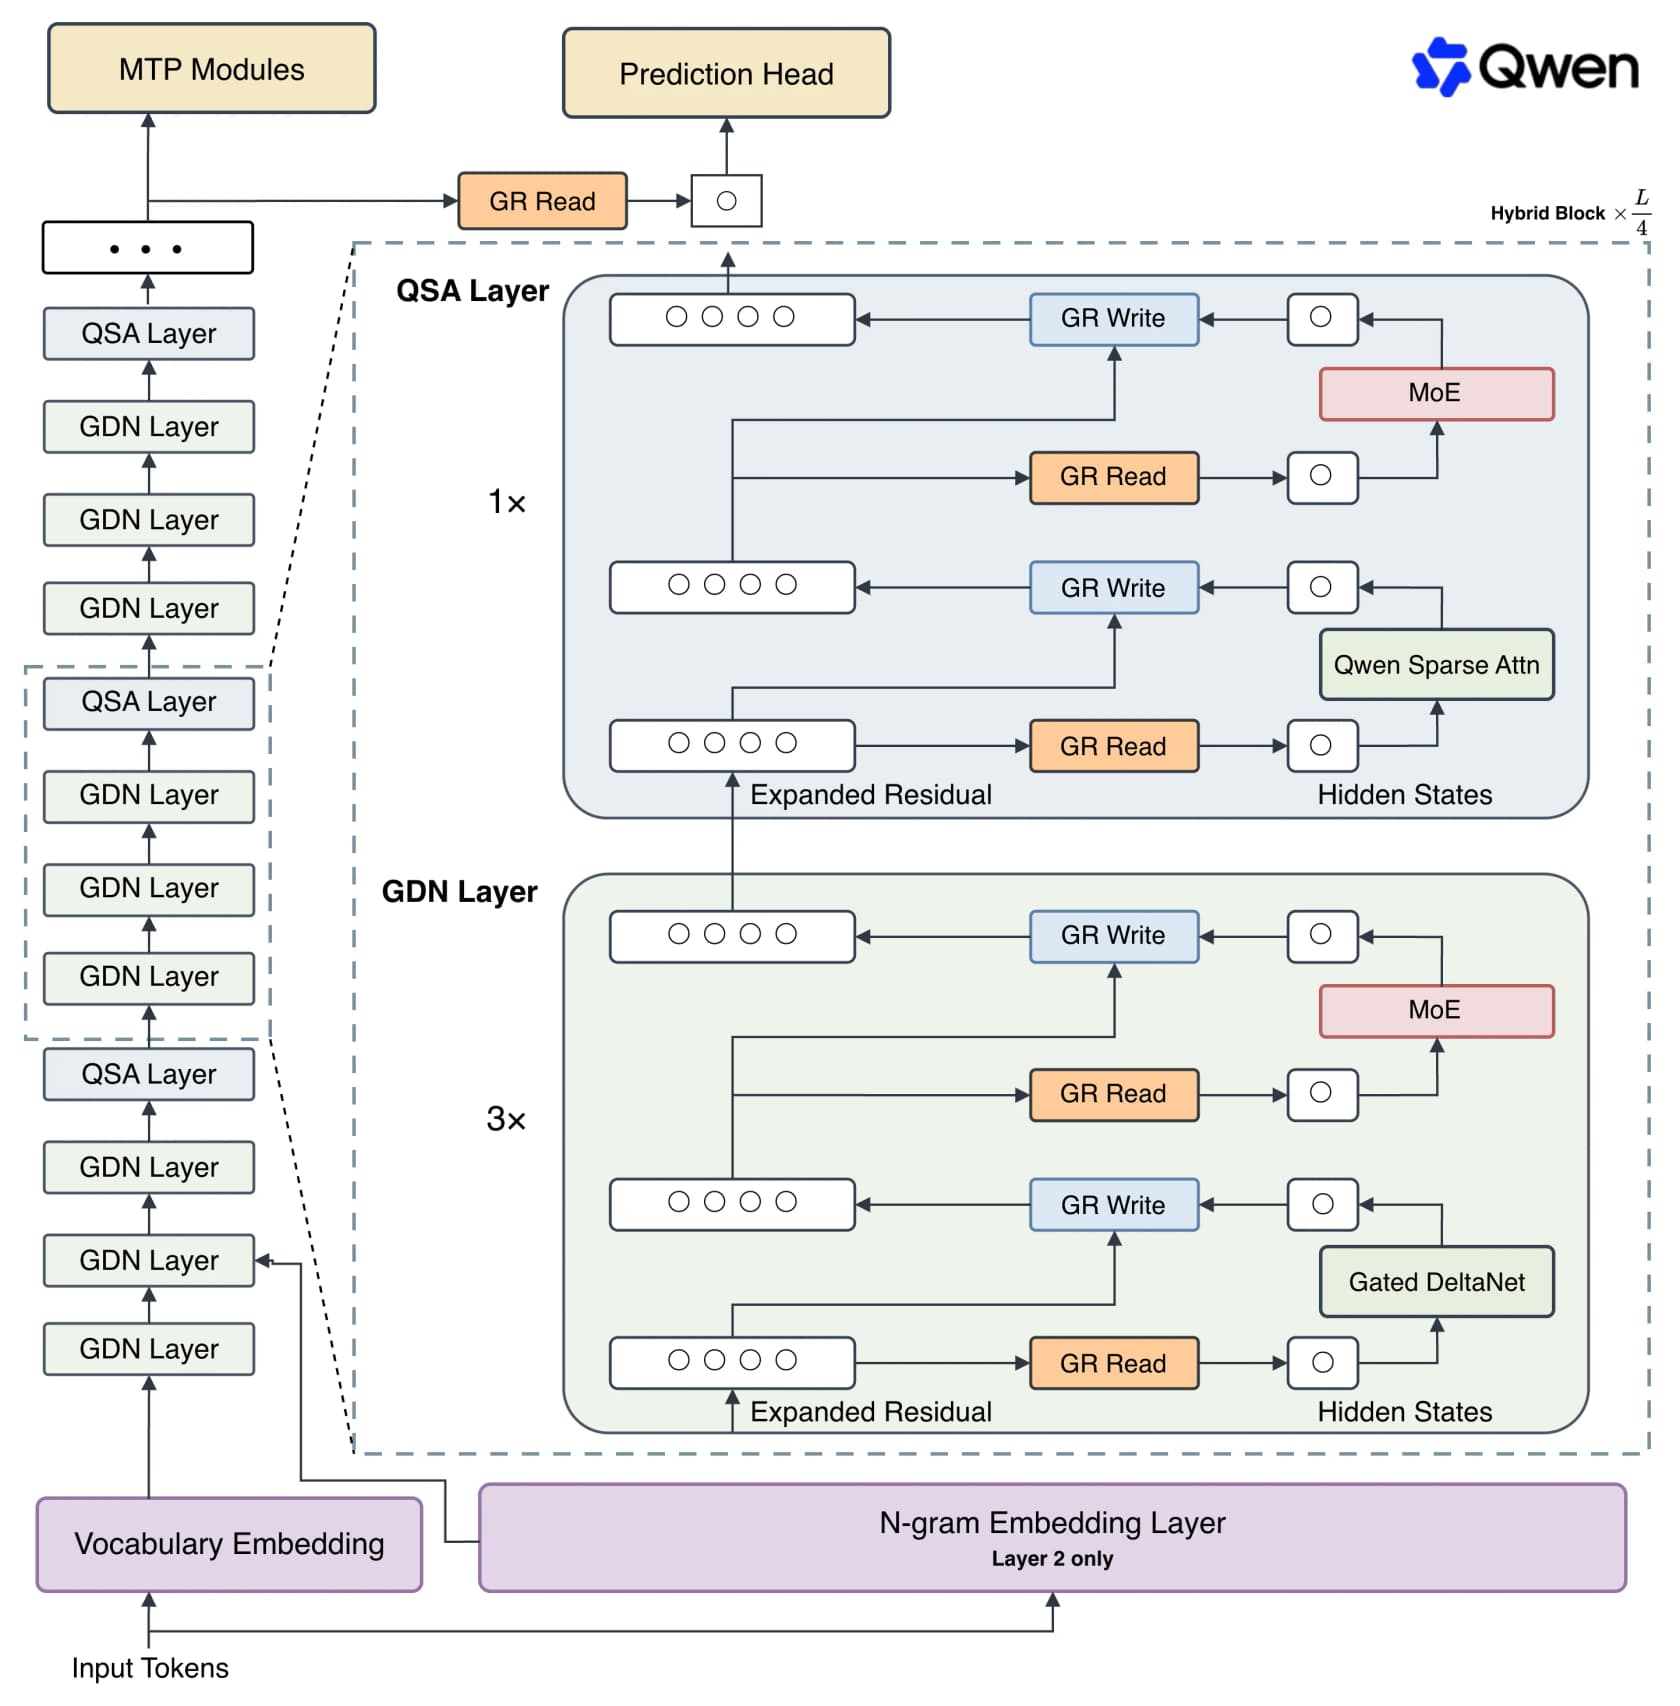
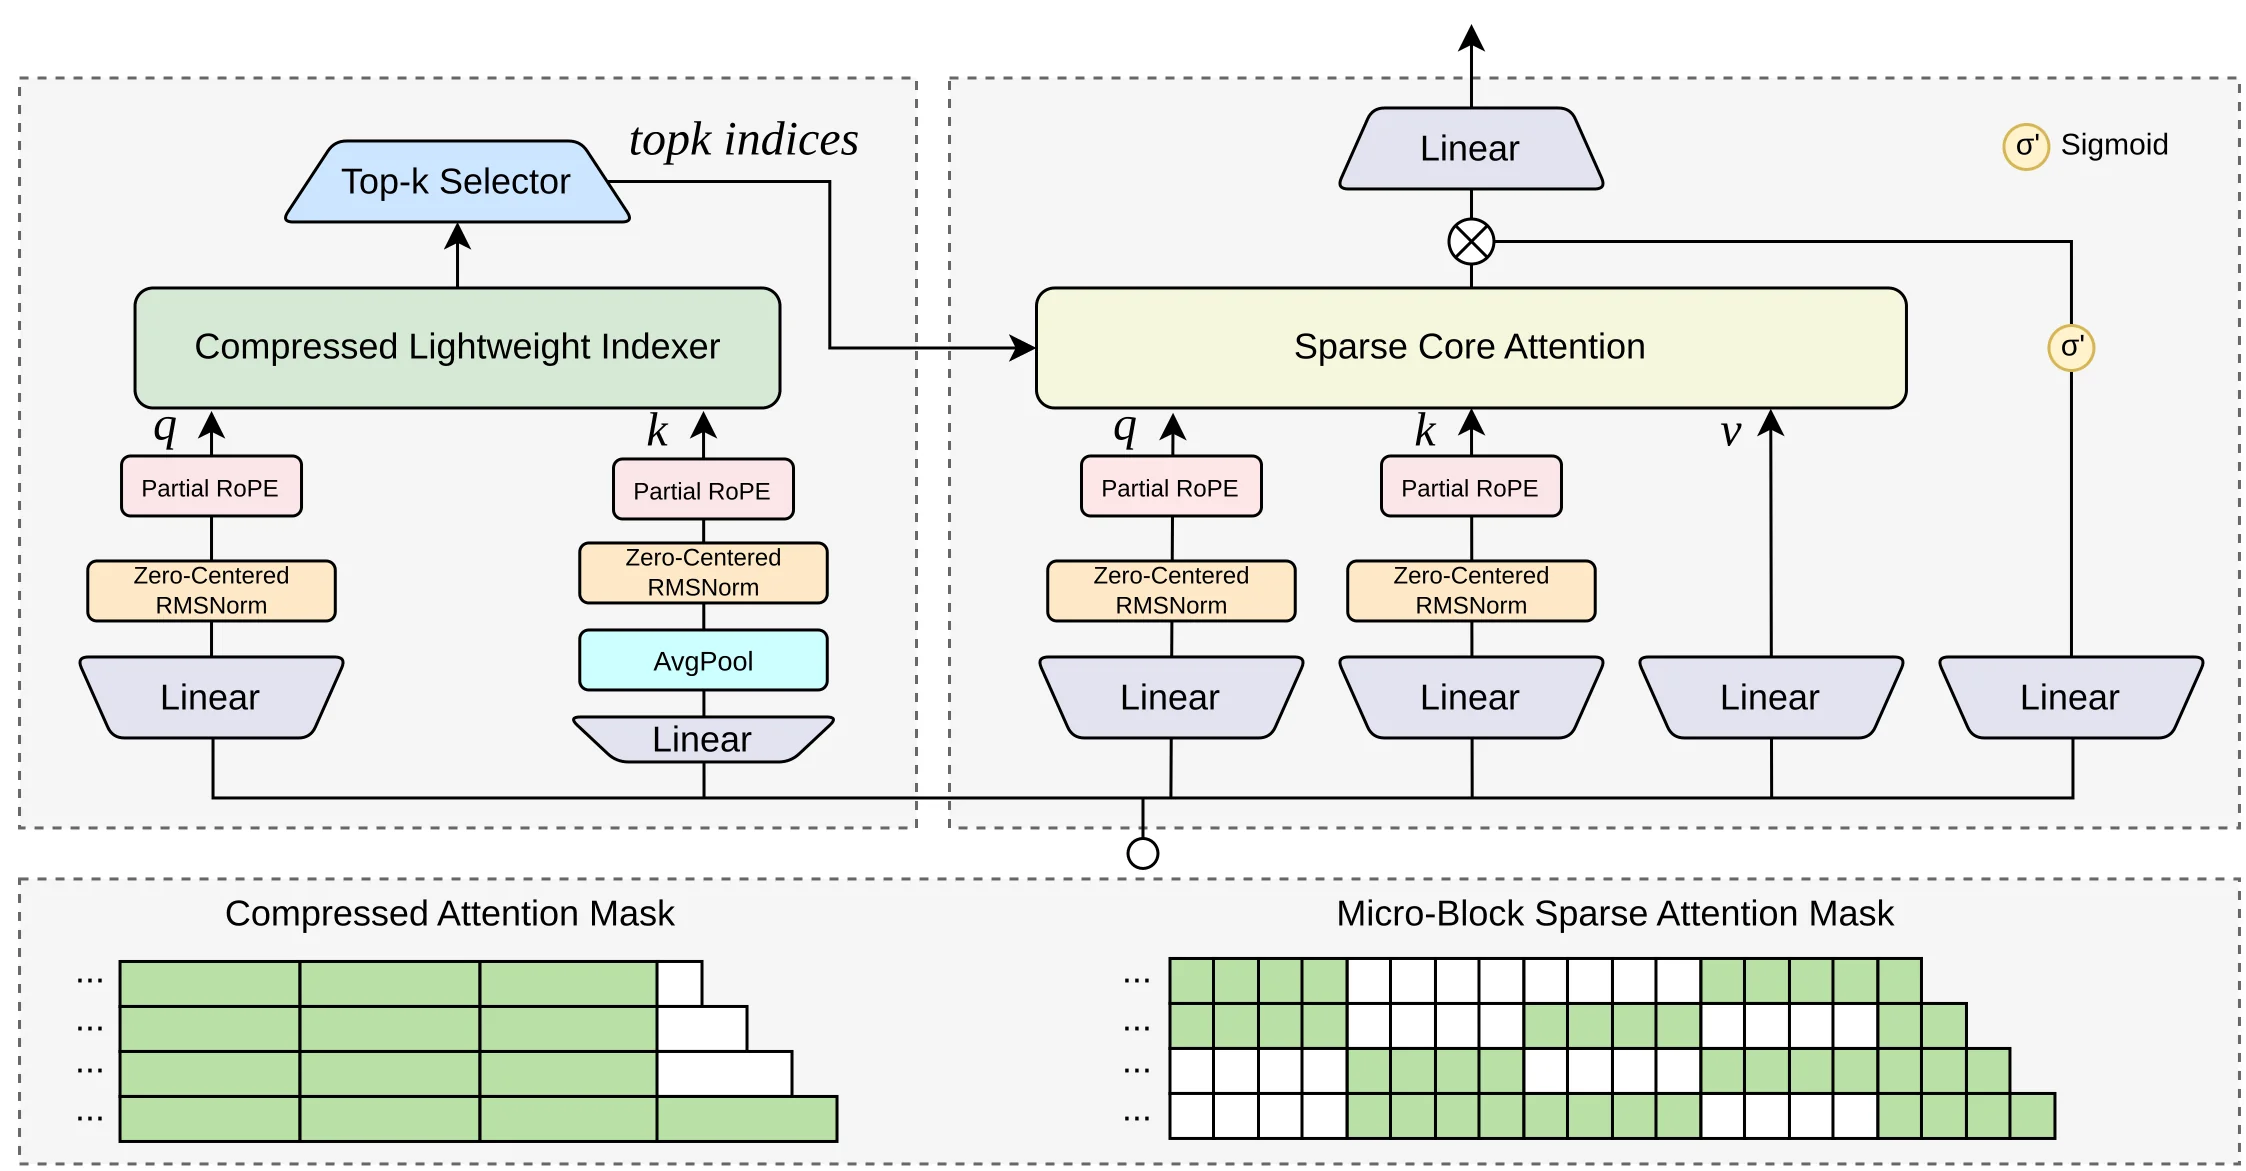
Atenção: um híbrido de GDN e QSA. Três de cada quatro camadas usam o Gated DeltaNet para comprimir o histórico em um estado de tamanho fixo, o que é bem mais barato do que armazenar um cache completo de chave-valor. A quarta camada usa atenção global, mas ela é substituída pela Qwen Sparse Attention, que escolhe o contexto importante em granularidade de microbloco em vez de token a token.
Embedding: uma tabela de N-gramas de 51B. Esta é a parte esperta. A Qwen adiciona 51 bilhões de parâmetros de consultas de bigramas e trigramas baseadas em contexto, que podem ser descarregadas para a memória do host e pré-carregadas de forma assíncrona. Você ganha um grande aumento de capacidade com quase nenhuma computação extra por token, e por isso as pessoas estão rodando um modelo "de uns 180B" em máquinas com GPUs modestas.
Os outros dois eixos são um fluxo residual com portas, que alarga o residual em quatro ramos paralelos com armazenamento FP8, e a troca para o otimizador Muon nos mapas lineares 2D. A Qwen diz que a combinação reduziu o custo de treinamento para aproximadamente um nono do Qwen3.7-Plus e ainda o superou em programação e tarefas de escritório.
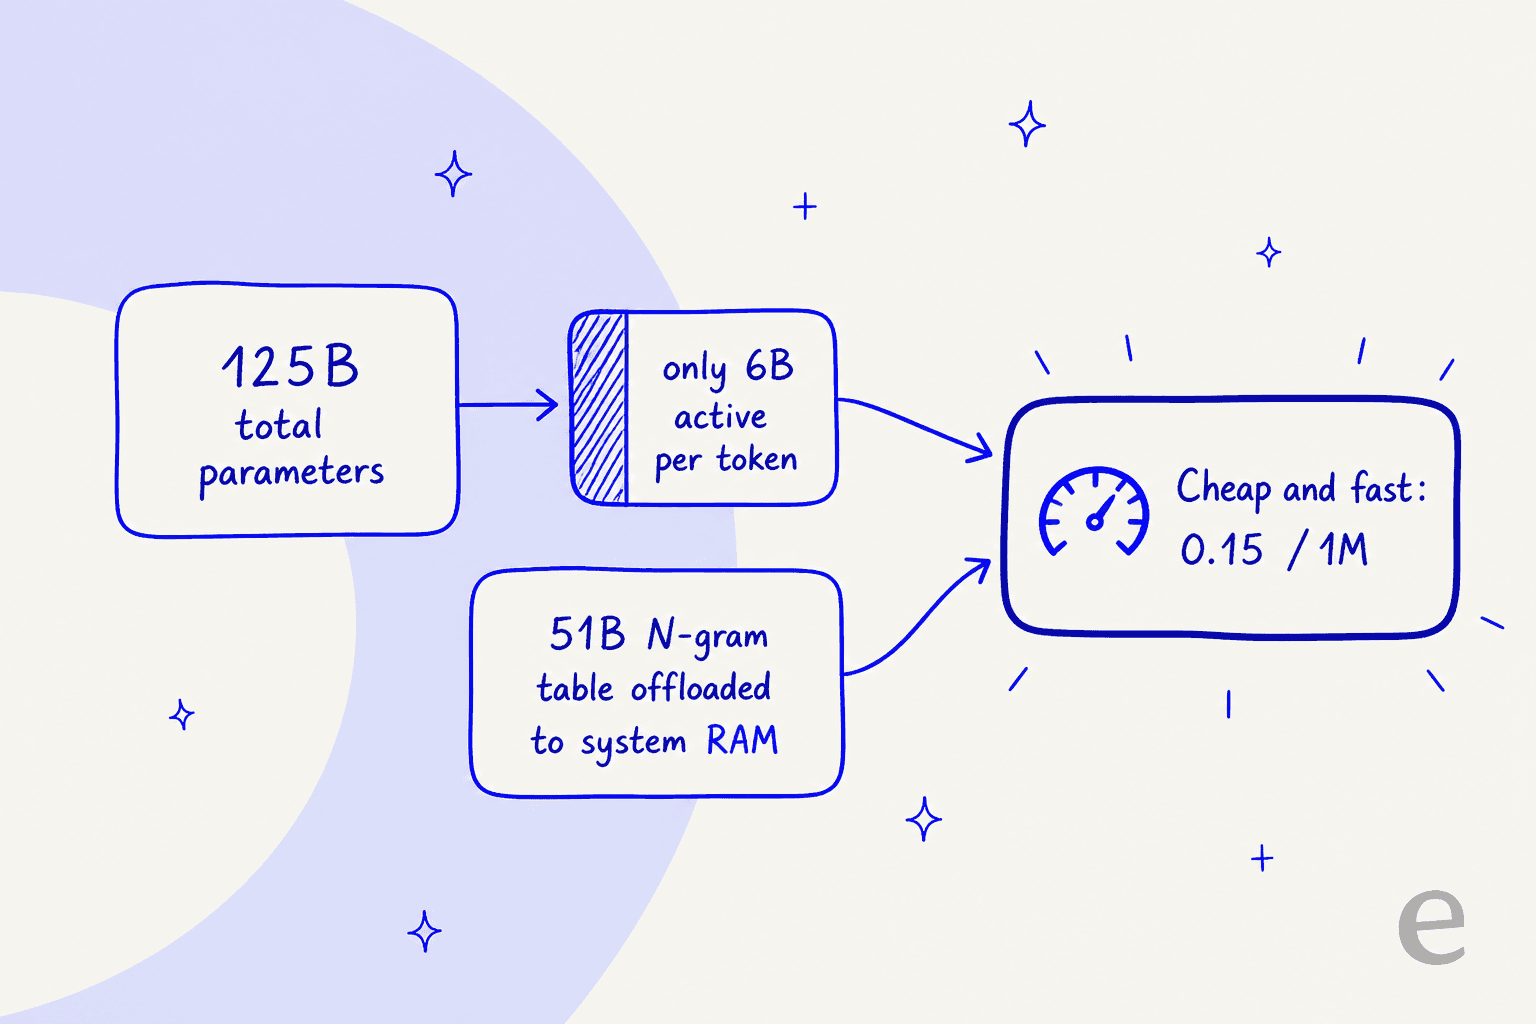
Junte as especificações e o formato fica claro: 125B de parâmetros principais, 6B ativados por token, mais o embedding de N-gramas de 51B e uma cabeça de predição multitoken de 4B (a Artificial Analysis arredonda o total para 180B). Ele usa 512 especialistas com 10 roteados mais 1 compartilhado ativos, um contexto nativo de 262.144 tokens extensível a 1M via YaRN. Uma ressalva honesta: o número de contexto é inconsistente entre as fontes, com o model card dizendo 262K nativo, o QwenCloud rodando 1M por padrão e a Artificial Analysis listando 256K. Leia como "muito longo, o teto exato depende de onde você o roda."
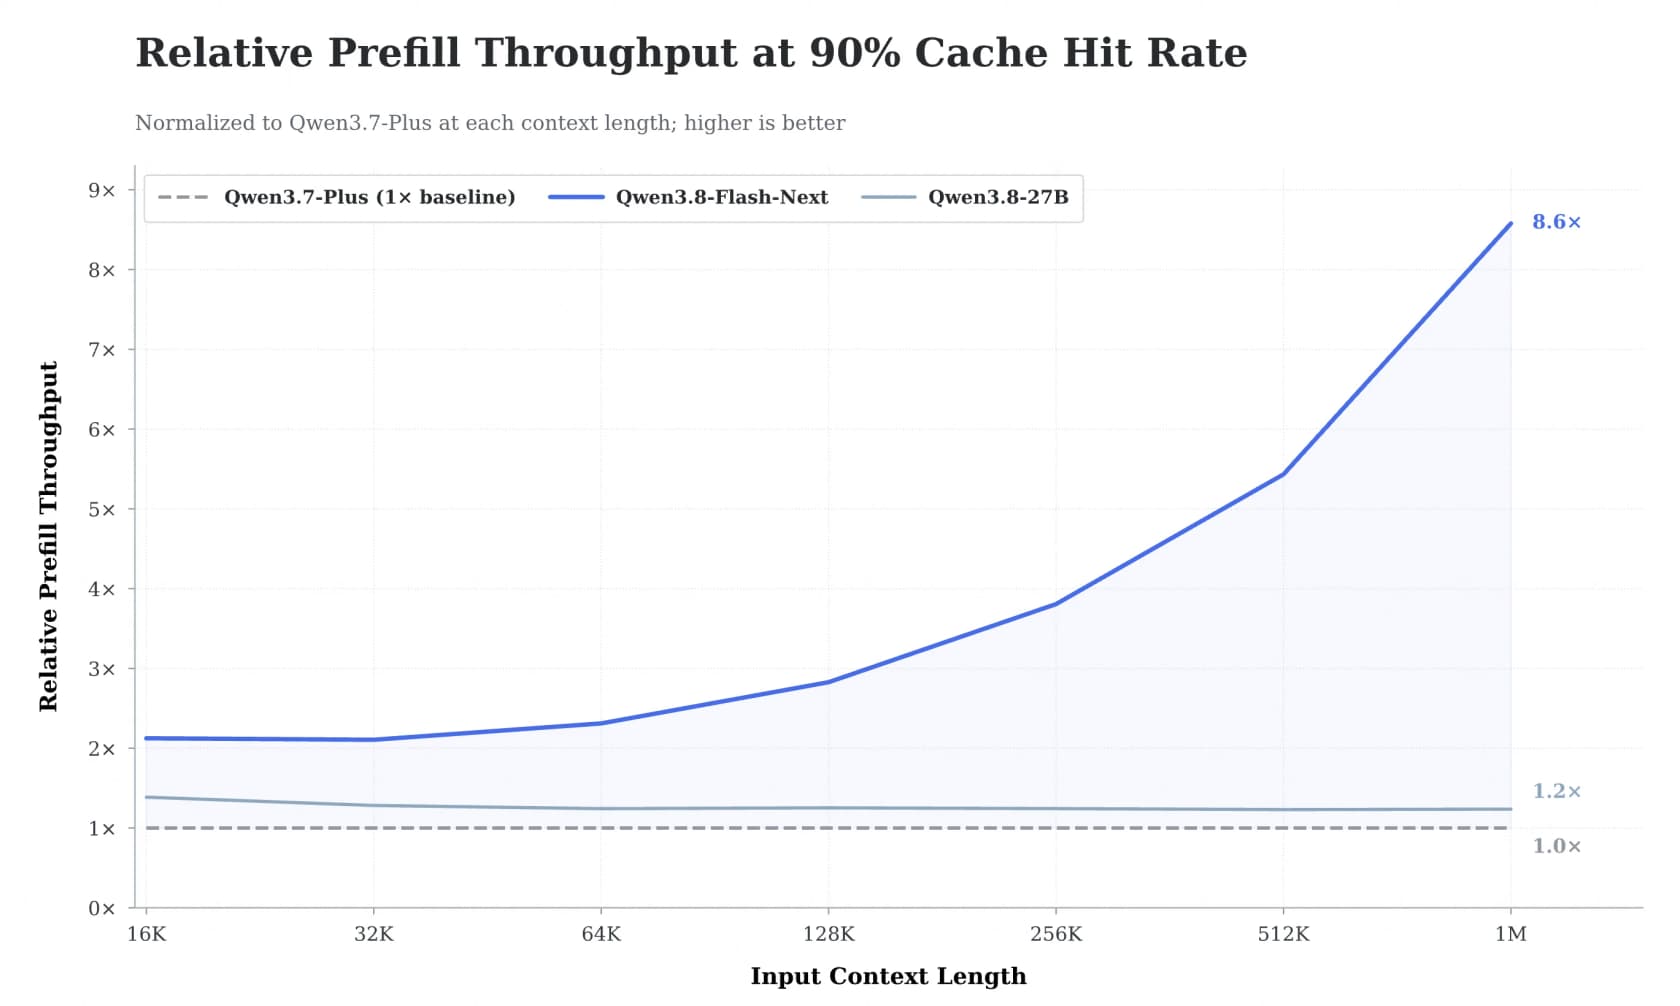
O ganho de eficiência aparece mais em contexto longo. A Qwen relata que o kernel QSA chega a acelerações de até 7,6x no prefill e 4,9x no decode com 1M de tokens, e 8,6x a vazão de prefill do Qwen3.7-Plus com 1M e 90% de acertos de cache.
O que o Qwen 3.8 Flash Next realmente consegue fazer
Os benchmarks vêm em dois sabores aqui, e a diferença importa. Há a tabela da própria Qwen, impressionante mas reportada pelo fornecedor, e há uma âncora genuinamente independente.
Comece pela independente. A Artificial Analysis dá ao Flash Next 56 no seu Intelligence Index, o que o coloca em 5º de 111 na sua classe, contra uma mediana de 29. Ele atinge 77 tokens de saída por segundo e custa cerca de $0.10 por tarefa do Index. O veredito deles em uma linha é que ele está "entre os modelos líderes em inteligência e com preço razoável", mas é "muito verboso", queimando 200M de tokens de saída para concluir o Index contra uma mediana de 110M. Guarde o ponto da verbosidade, porque ele infla silenciosamente as contas reais.
Os números da própria Qwen, que você deve ler como "a Qwen relata" e não como fato neutro, o colocam à frente dos seus irmãos na maioria das linhas:
| Benchmark | Qwen3.8-Flash-Next | Qwen3.8-27B | Qwen3.7-Plus | DeepSeek-V4-Flash | Claude-Opus-4.6 |
|---|---|---|---|---|---|
| SWE-bench Pro | 62.5 | 61.7 | 55.8 | 56.0 | 53.4 |
| SWE-bench Multilingual | 81.0 | 73.8 | 75.8 | - | 77.5 |
| LiveCodeBench v6 | 91.9 | 90.3 | 89.6 | 90.6 | 88.8 |
| GPQA Diamond | 91.7 | 89.2 | 90.3 | 90.8 | 91.3 |
| IFBench (seguir instruções) | 81.3 | 79.5 | 79.1 | 79.2 | 62.5 |
| CoWorkBench (tarefas longas de escritório) | 73.9 | 70.7 | 65.1 | 45.1 | 68.2 |
| Humanity's Last Exam | 35.9 | 30.8 | 34.7 | 33.8 | 40.0 |
Fonte: as tabelas de benchmarks da Qwen. Duas coisas se destacam. Ele é genuinamente forte em programação e tarefas agênticas, superando por pouco modelos muito maiores no SWE-bench Pro. E não é uma vitória completa: o Claude Opus 4.6 ainda vence o Humanity's Last Exam, e o DeepSeek V4 Flash o supera na geração em nível de repositório. Na parte de visão, a Qwen relata 84,5 no AndroidWorld e 88,5 no RealWorldQA, ambos liderando o conjunto de comparação.
Preço do Qwen 3.8 Flash Next
Os pesos abertos são gratuitos. Se você tem o hardware, paga computação e nada mais, que é todo o apelo para quem hospeda por conta própria.
Para a API hospedada do Qwen3.8-Flash, o preço é fixo, sem faixas por tamanho de contexto como o Qwen 3.7 Flash tinha:
| Item | Tarifa (USD / 1M tokens) |
|---|---|
| Entrada | $0.15 |
| Saída | $0.47 |
| Entrada, leitura em cache | $0.016 |
| Criação de cache explícita | $0.20 |
| Leitura de cache explícita | $0.016 |
Essa leitura em cache é cerca de 89% mais barata que a entrada nova, e não é teórico: a OpenRouter observou uma taxa de acerto de cache de 91,1% em tráfego real, o que derruba o preço efetivo de entrada para algo em torno de $0.028 por milhão. Então o que você realmente paga em cargas repetitivas e amigáveis ao cache fica bem abaixo do preço de tabela.
Um asterisco sobre a manchete de "barato". Como o modelo é muito verboso, cargas pesadas em saída pagam mais do que a baixa tarifa por token sugere, já que você é cobrado por todos aqueles tokens de raciocínio. Para uma resposta de suporte conversada isso é arredondamento; para execuções agênticas longas, soma. Se você está comparando preço com o DeepSeek V4 Flash ou o Kimi K3, modele os tokens de saída, não só a tarifa de entrada.
Também há, por enquanto, apenas um provedor de API: a Alibaba Cloud International. A OpenRouter encaminha direto para ela, então ainda não há roteamento entre múltiplos provedores nem failover.
O que as pessoas estão realmente dizendo
A reação da comunidade foi barulhenta, e é quase inteiramente uma história de inferência local, não de API ou de empresas. O tópico de lançamento no Hacker News chegou a 698 pontos, e o r/LocalLLaMA teve um megatópico de lançamento com mais de 650 comentários. As pessoas estão obcecadas em rodá-lo nas próprias máquinas.
O pessoal de ferramentas deu o tom. A Unsloth o colocou para rodar rápido e fez uma afirmação grande:
"Qwen3.8-Flash can now be run locally! The 125B MoE model outperforms Claude-Opus-4.6 (Max). Run on 75GB RAM via Unsloth GGUFs. Qwen3.8-Flash-Next enables CPU RAM / unified mem setups to deliver near VRAM speeds."
Essa frase de "supera o Opus 4.6" é deles e não foi avaliada de forma independente, então trate como entusiasmo, não como fato. As vozes mais fundamentadas acrescentaram a ressalva que não para de aparecer. Aqui está a explicação mais clara do que "Next" realmente significa, do tópico do HN:
"This model is a preview of Qwen's upcoming Qwen4 architecture... They said the model is intentionally under-trained since it is mainly for R&D purposes of proving the new architecture."

E o contratempo prático, de Simon Willison, que o rodou em vários níveis de raciocínio em um DGX Spark e acabou preferindo o modelo denso menor, culpando a quantização de poucos bits necessária para fazê-lo caber. Esse é o tema recorrente: a arquitetura é empolgante, mas este checkpoint específico é uma prévia, e espremê-lo em hardware de consumo custa qualidade. Se você quer hoje a opção com cara de acabada nessa faixa de peso, muitos tópicos apontam para o GLM 5.3 Flash.
Então, você deve usá-lo?
Aqui é onde eu chego depois de uma semana observando.
Use se você é um entusiasta de inferência local com uma máquina de memória unificada ou uma GPU sobrando, quer uma prévia da arquitetura Qwen4, ou tem uma carga amigável ao cache e focada em programação em que o baixo preço hospedado e os fortes números de SWE-bench compensam. O design de ativação esparsa realmente o deixa render acima do seu tamanho de hardware.
Espere se você precisa agora de um modelo estável e pronto para produção. Ele é uma prévia subtreinada por admissão da própria Qwen, a quantização prejudica, e a API hospedada do Qwen3.8-Flash tem um único provedor. Para trabalho crítico, um modelo mais acabado, seja o GLM 5.3 Flash, uma faixa do Claude Opus 5 ou o Qwen 3.8 Max, é a escolha mais segura até a linha Qwen4 completa chegar.
De qualquer forma, o ponto mais importante é o que um modelo realmente é: um componente. O que me leva ao que eu preciso explicar o tempo todo para equipes que procuram "IA barata".
Onde um modelo assim se encaixa no trabalho real de suporte
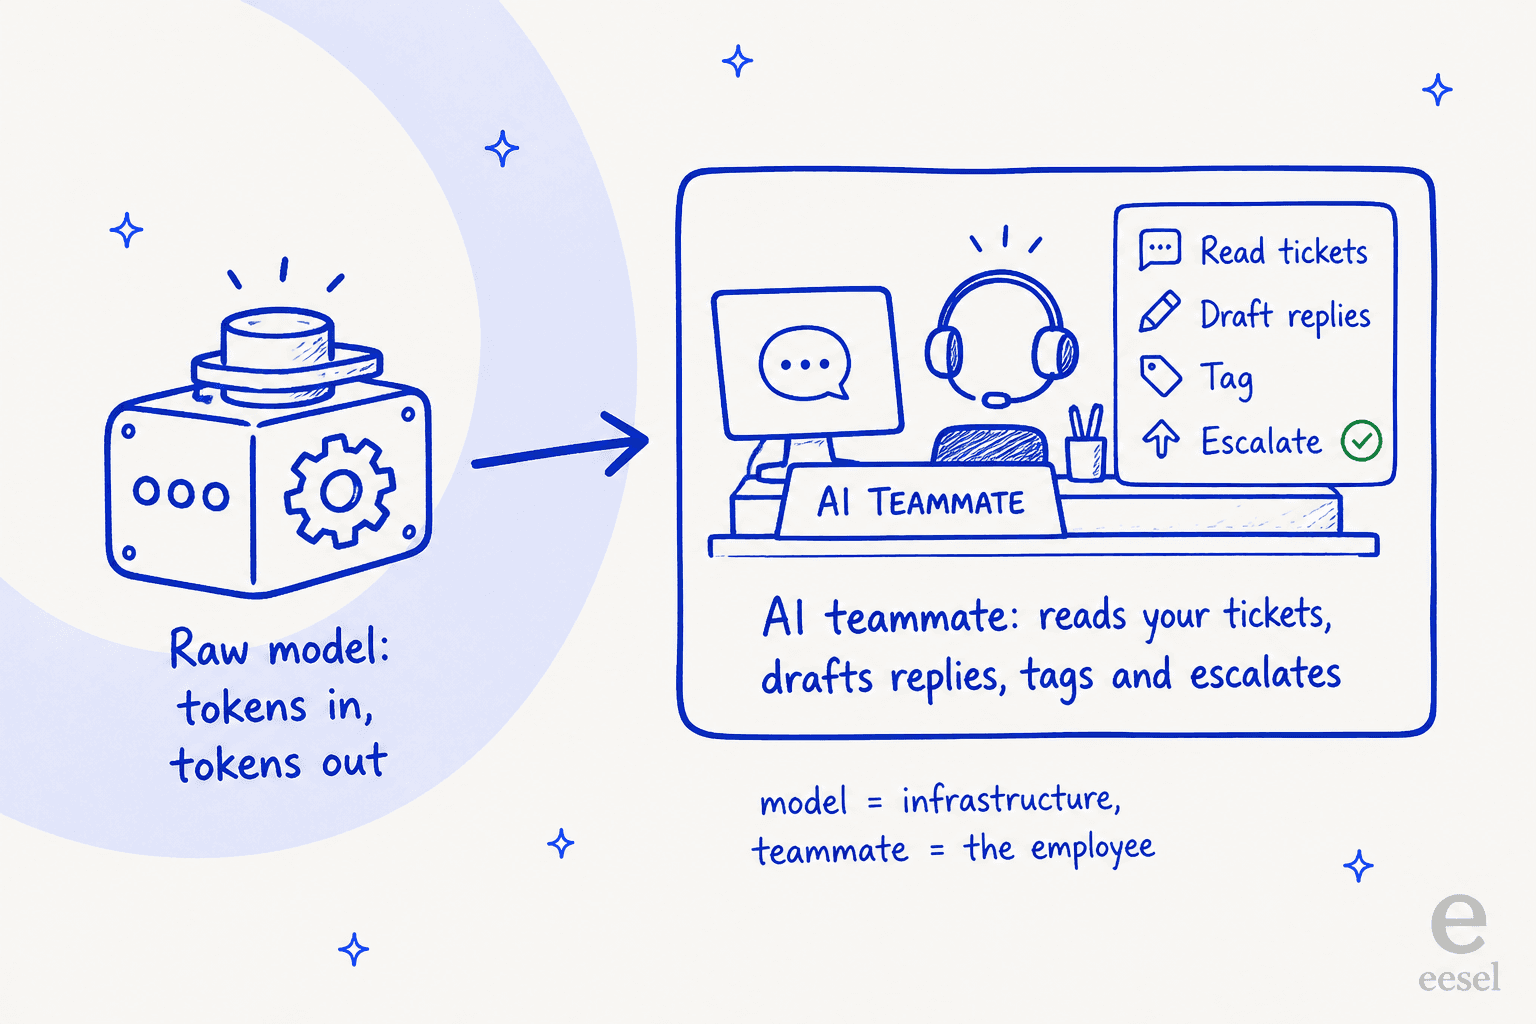
Muita gente lê um lançamento como este e pensa "ótimo, vou apontar minha caixa de entrada de suporte para o Qwen 3.8 Flash Next e cortar minha conta de IA". Isso é um erro de categoria. Um modelo bruto recebe tokens e devolve tokens. Ele não conhece sua política de reembolso, não consegue ler o histórico de pedidos de um cliente, não redige uma resposta no seu helpdesk e não faz ideia se sua resposta confiante está realmente correta. O modelo é infraestrutura; quem faz o trabalho é o funcionário.
Essa camada de funcionário é o que construímos na eesel. A forma que usamos é simples: a eesel é uma plataforma de colegas de IA, e você contrata colegas prontos para trabalhar em tarefas específicas, atualmente um colega de IA para helpdesk e um redator de blog com IA. Cada um chega com as habilidades, integrações e contexto da empresa para o seu papel, então a pergunta de qual modelo roda por baixo vira um detalhe de implementação, e não um problema seu.

A parte que eu mais destacaria, porque já vi queimar gente, são os testes. Todos nós já vimos um bot de tom confiante dar silenciosamente uma resposta errada, e é por isso que o colega de helpdesk da eesel simula cada implantação com seus tickets históricos antes de tocar em um cliente real. Você vê a taxa de resolução e as respostas exatas que ele teria enviado em conversas passadas reais, e então decide o que automatizar. Um modelo novo e subtreinado é exatamente o tipo de coisa que você quer passar por esse portão em vez de confiar em uma tabela de benchmarks. E como a eesel se conecta ao seu helpdesk atual e lê da sua base de conhecimento e de tickets passados, o problema de contexto, aquele que um modelo bruto nunca resolve sozinho, fica coberto.
A versão curta: modelos como o Qwen 3.8 Flash Next estão ficando baratos e capazes rapidamente, o que é ótima notícia, mas escolher um é os 10% fáceis do trabalho. Os outros 90% são transformá-lo em um colega que realmente resolva tickets, e essa é a camada que vale a pena dedicar seu tempo.